
Scrapy JOBDIR tiếp tục crawl: dừng, resume và đối soát
Scrapy JOBDIR tiếp tục crawl là cơ chế lưu hàng đợi request, tập request đã thấy và trạng thái spider xuống một thư mục, để lần chạy sau đi tiếp đúng chỗ đã dừng thay vì tải lại từ đầu. Tài liệu Scrapy mô tả nó trong vài đoạn ngắn, nhưng hành vi khi dừng sạch và khi tiến trình bị giết khác nhau rất xa. ProxyVN chạy Scrapy 2.19.0 ngày 03/11/2026 trên một website giả lập 330 trang, dừng giữa chừng theo nhiều cách rồi đếm từng request và từng item để xem JOBDIR giữ được gì, mất gì.
Scrapy JOBDIR tiếp tục crawl: mục tiêu và phạm vi không lặp
Phần đầu chốt bài toán, đầu ra và những phần bài không nhắc lại.
Bài toán
Một job Scrapy chạy vài giờ có thể dừng vì nhiều lý do: hết giờ bảo trì, người vận hành bấm Ctrl+C, máy chủ khởi động lại, tiến trình bị hệ điều hành giết vì hết RAM. Câu hỏi luôn là: chạy lại thì đi tiếp hay làm lại, và nếu đi tiếp thì có tải trùng, có sót, có ghi item hai lần không.
JOBDIR được thiết kế để trả lời câu hỏi đó cho một job. Bài này kiểm tra lời hứa ấy bằng số liệu thay vì tin vào tên tham số.
Đầu ra cần nghiệm thu
Đầu ra gồm bốn con số cho mỗi kịch bản dừng: tổng dòng item ghi ra, số id duy nhất, số request máy chủ nhận và số request bị tải lại. Kèm theo là nội dung thư mục JOBDIR ngay sau khi dừng, để biết trạng thái nào đã xuống đĩa.
Một kịch bản đạt khi tổng id duy nhất bằng 300, số dòng trùng bằng 0 và số lần tải lại gần bằng 0.
Phạm vi không lặp
Bài Scrapy proxy đã nói cấu hình proxy, middleware và retry. Bài này không nhắc lại phần đó. Bài cũng không phải hướng dẫn Scrapy từ đầu: ai cần nền tảng có thể xem bài xây dựng web crawler Python.
Ranh giới với DeltaFetch cũng cần rõ. JOBDIR giúp một job dang dở chạy tiếp. DeltaFetch bỏ qua item đã thấy qua nhiều job khác nhau. Hai thứ giải hai bài toán khác nhau và bài này chỉ nói JOBDIR.
Nguồn kiểm chứng
Hành vi được đối chiếu với trang Jobs: pausing and resuming crawls trong tài liệu chính thức. Phần nào tài liệu không nói, mình đọc mã nguồn Scrapy 2.19.0 trong môi trường lab và ghi rõ.
Khôi phục spider sau khi dừng bằng Scrapy JOBDIR tiếp tục crawl và ranh giới trạng thái không được lưu
JOBDIR lưu ba thứ, và mỗi thứ được ghi xuống đĩa ở một thời điểm khác nhau.
Ba thành phần trong thư mục
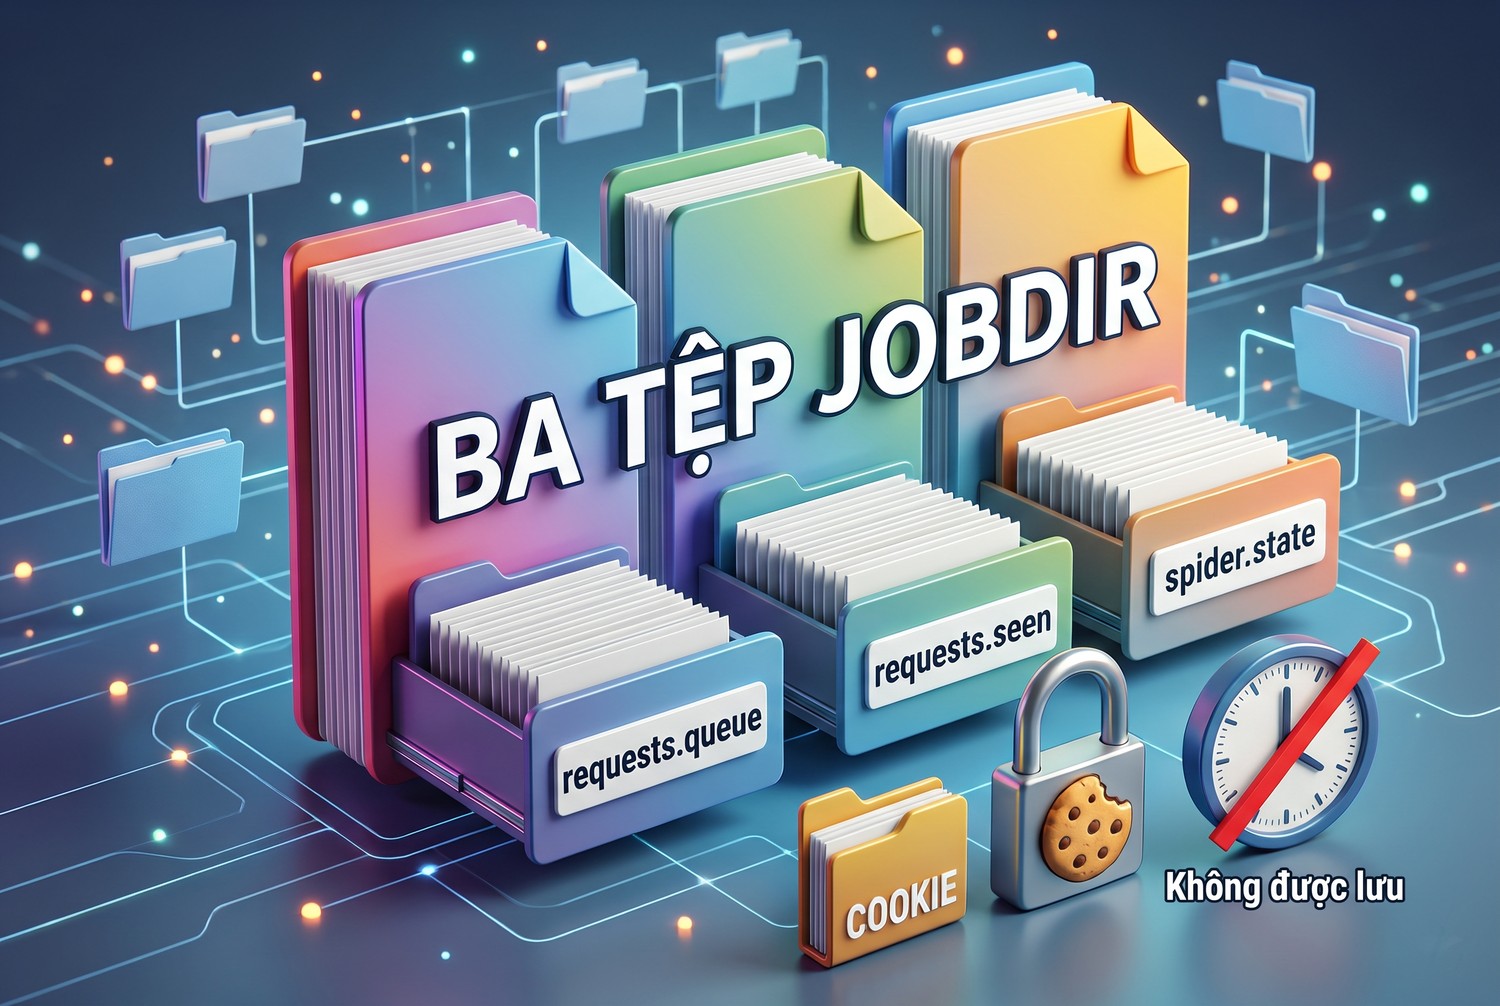
Ba tệp JOBDIR
Sau một lần dừng sạch, thư mục JOBDIR trong lab có ba mục: requests.queue, requests.seen và spider.state. Trong requests.queue có tệp active.json và một thư mục con theo khóa slot tải, ở đây là 127.0.0.1 cộng một mã băm.
requests.queue chứa các request còn chờ, đã tuần tự hóa bằng pickle. requests.seen là danh sách dấu vân tay của request đã đưa vào lịch, mỗi dòng một dấu. spider.state là từ điển self.state của spider, cũng pickle.
Cái không được lưu
Tài liệu nói rõ mỗi request phải pickle được. Tài liệu không nhấn mạnh rằng những thứ ngoài ba mục trên đều không được lưu: cookie của CookiesMiddleware, bộ đếm thống kê, kết nối mở, biến toàn cục trong module. Lab cho thấy cookie là thứ gây hậu quả nặng nhất.
Item đã ghi ra feed cũng không phải trạng thái của JOBDIR. Feed do exporter quản lý. Nếu dùng -O để ghi đè thay vì -o để nối, lần resume sẽ xóa sạch item của lần trước.
Self.state chỉ tồn tại khi có JOBDIR
Một điều dễ vấp: thuộc tính self.state do extension SpiderState gắn vào spider khi có JOBDIR. Chạy cùng spider mà không có JOBDIR, mọi dòng dùng self.state báo AttributeError: 'S' object has no attribute 'state'. Lab gặp đúng lỗi này ở lần chạy đối chứng.
Cách an toàn là khai báo state = {} ở cấp lớp. Khi có JOBDIR, extension gán đè bằng từ điển đọc từ đĩa. Khi không có, spider dùng từ điển rỗng.
Dấu vân tay request là gì
Mỗi dòng trong requests.seen là dấu vân tay của một request, tính bằng hàm fingerprint của Scrapy. Hàm này băm phương thức, URL đã chuẩn hóa và thân request. Theo docstring trong mã nguồn, tham số truy vấn được sắp xếp lại, fragment bị bỏ, và header không được tính, trừ khi khai báo riêng.
Vì vậy hai URL chỉ khác thứ tự tham số được coi là một. Hai request cùng URL nhưng khác cookie hay khác header Authorization cũng là một. Điều này hợp lý với đa số website, nhưng sẽ sai nếu nội dung phụ thuộc header, ví dụ ngôn ngữ chọn qua Accept-Language.
dont_filter đi qua bộ lọc
Request có dont_filter=True không bị kiểm tra trong requests.seen. Nó luôn được lên lịch, kể cả khi resume. Đây là công cụ để buộc chạy lại những request có tác dụng phụ cần thiết, như trang đăng nhập hay trang đặt cookie.
Dùng quá tay thì ngược lại: request phân trang mà mang dont_filter có thể tạo vòng lặp vô tận trên website có link quay về trang trước. Chỉ dùng cho số ít request khởi động.
Thời điểm ghi xuống đĩa
Trong lab, request trong requests.queue được ghi gần như ngay khi vào lịch. requests.seen thì mở ở chế độ nối và được đệm. active.json và spider.state chỉ ghi khi spider đóng. Thứ tự này quyết định số phận của mỗi kiểu dừng.
Chọn JOBDIR riêng cho từng spider và từng job trong Scrapy JOBDIR tiếp tục crawl
Đặt thư mục sai là cách nhanh nhất để làm hỏng dữ liệu của hai job một lúc.
Một thư mục cho một job
Tài liệu nói một thư mục chỉ dùng cho một job của một spider. Nếu hai spider dùng chung, chúng đọc queue của nhau. Nếu cùng spider nhưng hai job khác nhau dùng chung, job sau tưởng phần lớn URL đã thấy và bỏ qua.
Quy ước dễ dùng là đặt tên theo spider, ngày và tham số chính, ví dụ crawls/catalog-2026-11-03-vn. Khi job xong hẳn, chuyển thư mục sang khu lưu trữ hoặc xóa.
Truyền JOBDIR từ dòng lệnh
scrapy crawl catalog -s JOBDIR=crawls/catalog-2026-11-03 -o items.jsonlLab dùng runspider với cùng tham số. Không ghi JOBDIR vào settings.py của dự án, vì như vậy mọi lần chạy, kể cả lần thử nghiệm, đều dùng chung một thư mục.
Feed phải nối, không ghi đè
Trong lab, mỗi lần chạy ghi ra một tệp riêng, rồi gộp khi đối soát. Nếu dùng chung một tệp, phải dùng -o (nối) chứ không phải -O (ghi đè). Định dạng jsonlines hợp với việc nối vì mỗi dòng là một item độc lập. Định dạng json một mảng sẽ hỏng cú pháp khi nối hai lần chạy.
Đổi code giữa hai lần chạy
Request trong queue lưu tên callback dưới dạng chuỗi, không lưu mã. Khi nạp lại, Scrapy tìm phương thức cùng tên trên spider. Nếu giữa hai lần chạy anh em đổi tên parse_item thành parse_product, hàm _get_method trong mã nguồn sẽ báo ValueError: Method not found.
Đổi logic bên trong callback thì không sao, request cũ sẽ chạy với logic mới. Nhưng đó cũng là điểm cần ghi nhớ: một nửa job chạy logic cũ, nửa sau chạy logic mới. Nếu thay đổi ảnh hưởng tới cấu trúc item, nên kết thúc job cũ rồi mới chạy job mới với thư mục mới.
Đổi settings giữa hai lần chạy
Thay đổi tốc độ như CONCURRENT_REQUESTS hay DOWNLOAD_DELAY giữa hai lần resume là an toàn. Thay đổi lớp queue như SCHEDULER_DISK_QUEUE hay SCHEDULER_PRIORITY_QUEUE thì không: định dạng tệp khác nhau và queue cũ có thể không đọc được.
Thay đổi REQUEST_FINGERPRINTER_CLASS cũng nguy hiểm. Dấu vân tay mới sẽ không khớp với dòng cũ trong requests.seen, và mọi URL đã thấy sẽ được coi là mới.
Thư mục trên ổ nào
JOBDIR ghi nhiều tệp nhỏ liên tục. Đặt trên ổ cục bộ, không đặt trên ổ mạng hay thư mục đồng bộ đám mây. Thư mục đồng bộ có thể khóa tệp giữa chừng và làm việc ghi thất bại.
Kích thước theo thời gian
requests.seen tăng theo số request đã lên lịch, mỗi dòng 40 ký tự hex. Một triệu request là khoảng 41 MB. Queue lớn hay nhỏ tùy số request chờ. Với job dài, theo dõi dung lượng thư mục như theo dõi dung lượng cơ sở dữ liệu.
Kiểm requests.queue, requests.seen và spider.state trong Scrapy JOBDIR tiếp tục crawl
Phần này mô tả fixture và các kịch bản dừng.
Website giả lập
Máy chủ lab là http.server của Python, nghe 127.0.0.1 cổng 9821, mỗi phản hồi chậm 30 ms để có thời gian dừng giữa chừng. Có 30 trang danh sách /list?page=1 đến 30, mỗi trang trỏ 10 trang chi tiết /item/k. Mỗi trang chi tiết có một link liên quan trỏ tới item khác, tạo vòng.
Tổng cộng 330 URL khác nhau và 300 item. Máy chủ ghi mỗi request vào nhật ký, kèm việc request có mang cookie sid hay không. Trang danh sách đầu tiên đặt cookie sid.
Spider
class S(scrapy.Spider):
    name = "lab307"
    state = {}  # mặc định khi không có JOBDIR
    start_urls = ["http://127.0.0.1:9821/list?page=1"]
    custom_settings = {"CONCURRENT_REQUESTS": 4, "ROBOTSTXT_OBEY": False}

    def parse(self, r):
        self.state["lists"] = self.state.get("lists", 0) + 1
        for a in r.css("a.it::attr(href)").getall():
            yield r.follow(a, self.item)
        n = r.css("a.next::attr(href)").get()
        if n:
            yield r.follow(n, self.parse)

    def item(self, r):
        self.state["items"] = self.state.get("items", 0) + 1
        yield {"id": int(r.css("h1::text").get()), "url": r.url}
        yield r.follow(r.css("a.rel::attr(href)").get(), self.item)
Sáu kịch bản
S1 chạy một mạch không JOBDIR, làm mốc. S2 có JOBDIR, dừng sạch sau 150 trang bằng CLOSESPIDER_PAGECOUNT rồi resume. S3 dừng sạch như S2 nhưng lần sau quên JOBDIR. S4 có JOBDIR, giết tiến trình sau 4 giây rồi resume. S5 giống S2 nhưng máy chủ đòi cookie cho trang chi tiết. S6 giống S2 nhưng một số request mang meta không pickle được.
Vì sao dùng CLOSESPIDER_PAGECOUNT
Trên Windows, gửi Ctrl+C cho tiến trình con từ script không ổn định. CLOSESPIDER_PAGECOUNT kích hoạt đúng đường đóng spider có trật tự mà Ctrl+C lần đầu kích hoạt: ngừng lên lịch mới, chờ request đang chạy, ghi trạng thái. Nên mình dùng nó để mô phỏng dừng sạch.
Ctrl+C lần hai và lệnh kill thì khác: Scrapy không có cơ hội dọn dẹp. Kịch bản S4 đại diện cho nhóm này.
Nội dung thư mục sau dừng sạch
Sau lần chạy đầu của S2, thư mục có requests.queue chứa active.json và thư mục con slot, requests.seen và spider.state. spider.state ghi lists 25, items 128 với lý do đóng closespider_pagecount.
Dừng đúng cách rồi resume với cùng thư mục trạng thái trong Scrapy JOBDIR tiếp tục crawl
Bảng dưới đây tổng hợp sáu kịch bản, đếm từ nhật ký máy chủ và tệp item.
Bảng kết quả
Kịch bản |
Dòng item |
Id duy nhất |
Dòng trùng |
Request máy chủ nhận |
Tải lại |
|---|---|---|---|---|---|
S1 một mạch, không JOBDIR |
300 |
300 |
0 |
330 |
0 |
S2 dừng sạch, resume JOBDIR |
300 |
300 |
0 |
331 |
1 |
S3 dừng sạch, chạy lại không JOBDIR |
428 |
300 |
128 |
483 |
153 |
S4 kill sau 4 giây, resume JOBDIR |
455 |
300 |
155 |
533 |
203 |
S5 cần cookie, resume JOBDIR |
127 |
127 |
0 |
331 |
1 |
S6 meta không pickle được, resume |
300 |
300 |
0 |
331 |
1 |
S2: trường hợp JOBDIR làm đúng việc
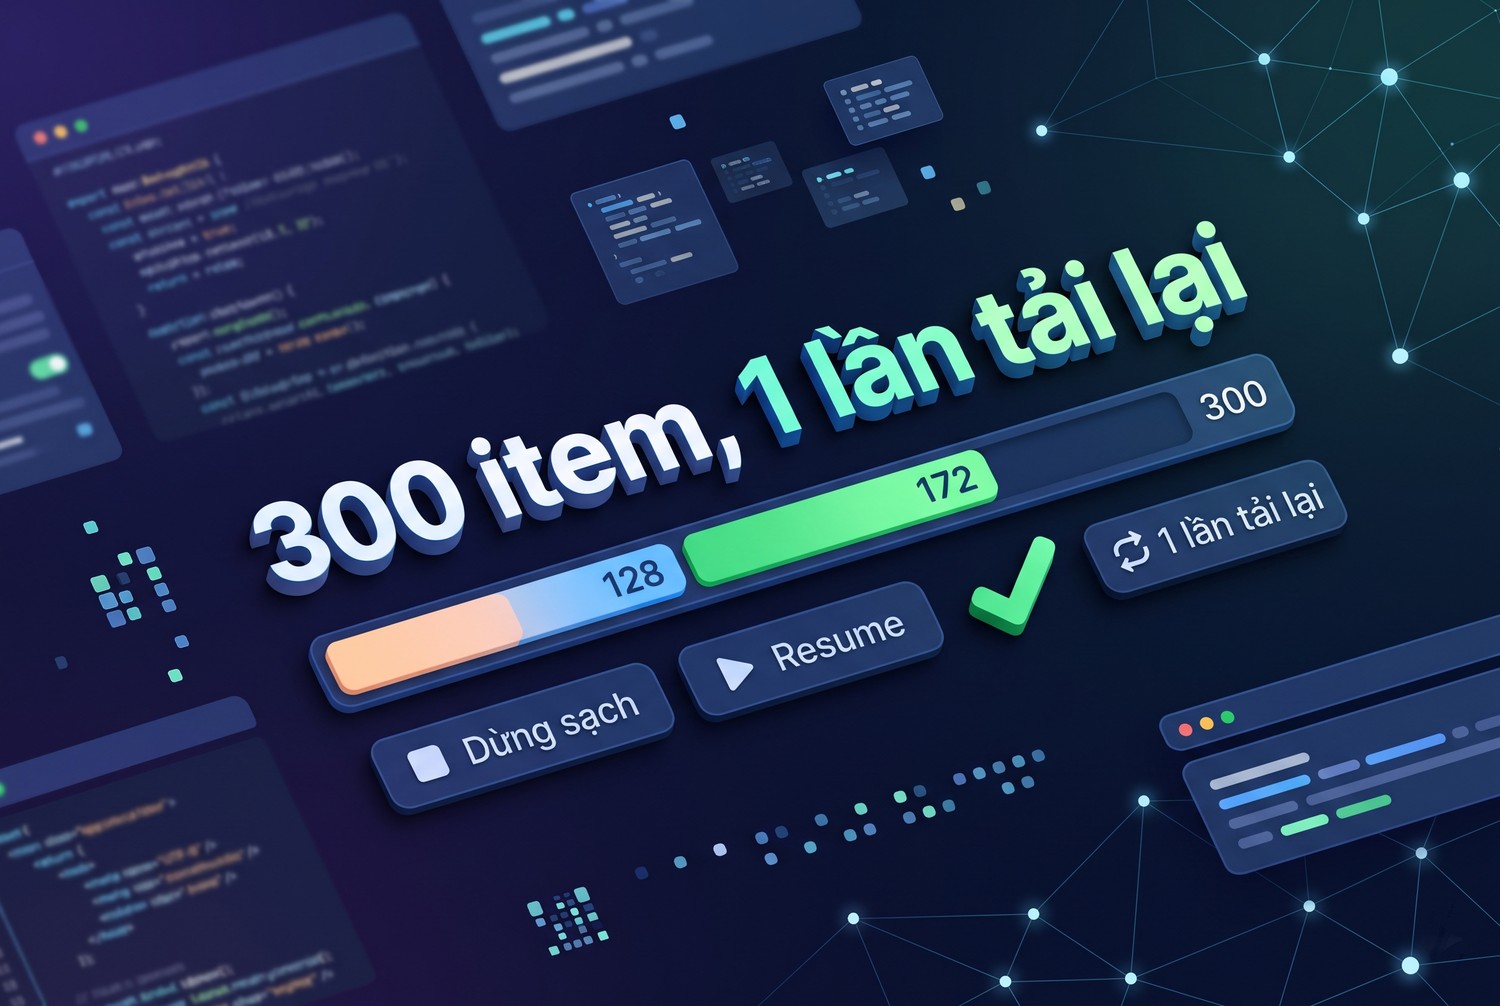
300 item, 1 lần tải lại
Lần đầu ghi 128 item rồi dừng. Lần resume ghi thêm 172 item, tổng 300, không dòng nào trùng. Máy chủ nhận 331 request cho 330 URL, chỉ một request bị tải lại.
spider.state cộng dồn qua hai lần: lists 31, items 300. Con số lists 31 cho 30 trang danh sách khớp với một lần tải lại. Đó là request đã đưa xuống tải nhưng phản hồi chưa được xử lý xong lúc dừng, lần sau lấy lại từ queue.
S3: quên JOBDIR lần hai
Lần thứ hai không có JOBDIR nên bắt đầu lại từ trang 1. Kết quả 428 dòng cho 300 id, 128 dòng trùng, 153 request tải lại. Không có gì báo lỗi. Chỉ có đối soát id mới phát hiện được.
Lỗi này hay gặp khi lệnh chạy lại được gõ tay hoặc khi script khởi động lại quên truyền tham số. Nên đặt JOBDIR trong một script bọc, kèm kiểm tra thư mục đã tồn tại hay chưa và in rõ chế độ mới hay resume.
S4: kill đột ngột gần như làm lại từ đầu
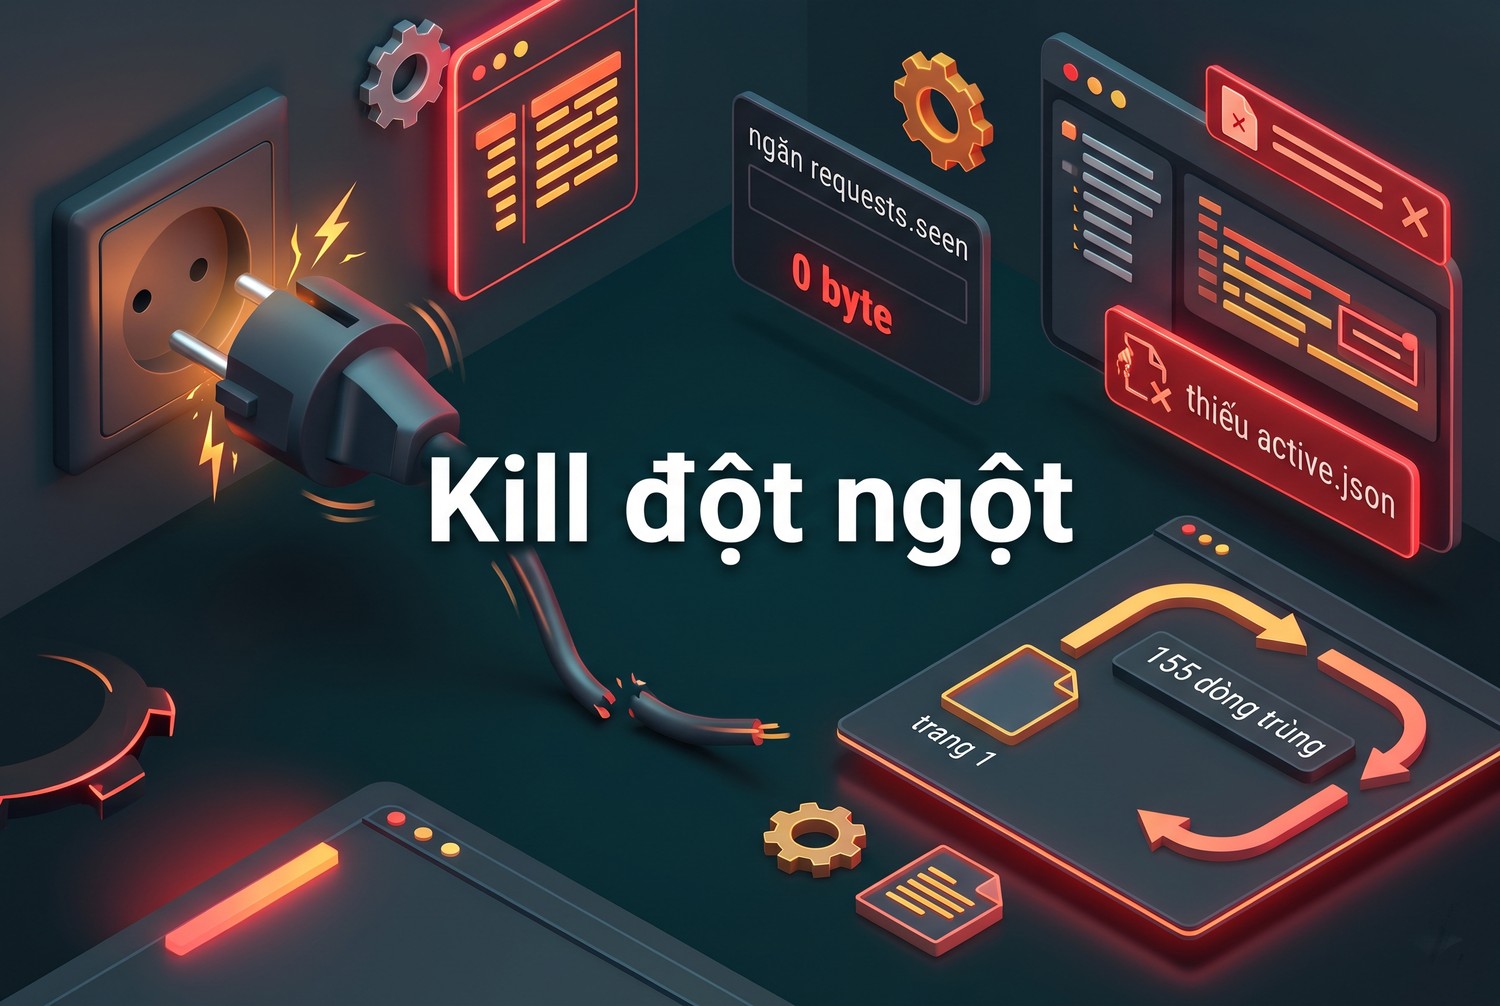
Kill đột ngột
Tiến trình bị giết sau 4 giây đã ghi 155 item. Lần resume ghi lại đủ 300 item, nghĩa là gần như toàn bộ job chạy lại. Tổng 455 dòng, 155 dòng trùng, 203 request tải lại.
Mình chạy lại riêng kịch bản kill để chụp thư mục ngay sau khi giết. requests.seen có kích thước 0 byte. requests.queue có thư mục slot với một tệp 37.353 byte nhưng không có active.json. spider.state không tồn tại.
Vì sao kill làm JOBDIR vô dụng
requests.seen được đệm trong bộ nhớ và chưa kịp xả xuống đĩa. Không có active.json thì lần sau không biết hàng ưu tiên nào đang có dữ liệu. Không có spider.state thì bộ đếm bắt đầu từ 0. Kết quả là Scrapy coi đây gần như một job mới.
Điều này không mâu thuẫn với tài liệu, vốn chỉ hứa resume sau khi dừng an toàn. Nhưng nó có nghĩa là JOBDIR không bảo vệ trước việc máy chủ sập hay tiến trình bị giết vì hết RAM.
Đọc thống kê cuối log
Mỗi lần chạy, Scrapy in một khối thống kê khi đóng. Với JOBDIR, các dòng đáng xem là finish_reason, item_scraped_count, downloader/response_status_count theo từng mã, dupefilter/filtered và scheduler/unserializable. Ở S2, dupefilter/filtered của lần resume cao vì nhiều link liên quan trỏ tới item đã tải ở lần đầu.
Nên ghi khối thống kê này vào tệp riêng theo từng lần chạy, kèm thời điểm bắt đầu và kết thúc. Gộp các tệp đó lại là có ngay bảng đối soát như bảng trên mà không cần đọc lại log dài.
Đọc đúng con số S2
Một lần tải lại trên 330 là chấp nhận được. Nhưng nếu item đó được ghi ở cả hai lần, sẽ có một dòng trùng. Trong S2 không có dòng trùng vì request bị lặp là trang danh sách. Với job thật, luôn khử trùng item theo id ở bước sau, không giả định số trùng bằng 0.
Kiểm giới hạn serialization, cookie hết hạn và ca dừng đột ngột trong Scrapy JOBDIR tiếp tục crawl
Hai kịch bản S5 và S6 chạm vào phần JOBDIR không lưu.
S5: cookie không đi qua resume
Máy chủ đặt cookie sid ở trang danh sách đầu tiên và trả 403 cho trang chi tiết nếu thiếu cookie. Lần đầu ghi 127 item. Lần resume không ghi được item nào: 173 request trang chi tiết đều không mang cookie và nhận 403.
Lý do là CookiesMiddleware giữ cookie trong bộ nhớ. Khi resume, request đầu tiên tới trang 1 đã nằm trong requests.seen nên bị lọc, cookie không bao giờ được đặt lại. Spider kết thúc với lý do finished, không có lỗi nào nổi bật ngoài các dòng 403 bị bỏ qua.
Cách xử lý cookie khi resume
Có ba hướng. Hướng một: trong hàm start, gửi request đăng nhập hoặc trang đặt cookie với dont_filter=True để nó luôn chạy, kể cả khi resume. Hướng hai: lưu cookie vào self.state lúc nhận và gắn lại vào request khi khởi động. Hướng ba: với phiên có hạn ngắn, chấp nhận chạy lại từ đầu thay vì resume.
Hướng một đơn giản và đúng với đa số website. Nhưng nếu cookie hết hạn sau vài giờ, request trong queue vẫn có thể nhận 403 giữa chừng. Khi đó cần middleware phát hiện 403 hàng loạt, làm mới phiên rồi thử lại.
Lưu cookie vào self.state
def parse(self, r):
    sid = r.headers.getlist("Set-Cookie")
    if sid:
        self.state["cookie"] = sid[0].decode().split(";")[0]
Ở hướng hai, spider đọc header Set-Cookie và lưu cặp tên giá trị vào self.state. Khi resume, hàm khởi động đọc lại giá trị này và gắn vào request đầu tiên. Vì spider.state chỉ được ghi khi đóng sạch, hướng này cũng thất bại sau kill, giống mọi thứ khác trong JOBDIR.
Cookie là dữ liệu nhạy cảm. Nếu lưu vào spider.state thì thư mục JOBDIR chứa phiên đăng nhập, cần phân quyền thư mục và xóa ngay khi job xong.
Đếm 403 sau resume
Bài học lớn hơn là phải đếm mã trạng thái theo từng lần chạy. Spider ở S5 báo finished như mọi lần khác. Nếu chỉ nhìn lý do đóng, mình sẽ tưởng job thành công. Thống kê downloader/response_status_count/403 trong log cuối mới cho thấy vấn đề.
S6: request không pickle được
Ở S6, request tới các item có số cuối là 5 mang meta chứa một threading.Lock, thứ pickle không tuần tự hóa được. Log cuối lần đầu ghi scheduler/unserializable: 5. Scrapy không dừng, mà đưa các request đó vào hàng trong bộ nhớ.
Kết quả cuối vẫn đủ 300 item. Lý do là scheduler ưu tiên lấy từ hàng bộ nhớ trước, nên năm request đó đã chạy xong trước khi dừng. Nếu dừng sớm hơn, chúng sẽ mất mà không có dấu vết trong JOBDIR.
Quy tắc cho meta và callback
Callback phải là phương thức của spider, không dùng lambda hay hàm lồng. Meta và cb_kwargs chỉ chứa kiểu dữ liệu đơn giản: chuỗi, số, danh sách, từ điển. Đối tượng phức tạp như kết nối, khóa, trình phân tích cú pháp thì lưu ở spider và tra theo khóa.
Theo dõi chỉ số scheduler/unserializable sau mỗi lần chạy thử. Khác 0 là có request không được bảo vệ bởi JOBDIR.
Muốn biết request nào không pickle được, bật SCHEDULER_DEBUG trong lần chạy thử. Scrapy sẽ ghi chi tiết từng request bị đưa vào hàng bộ nhớ thay vì chỉ cộng bộ đếm. Sau khi sửa xong, tắt lại để log gọn. Cách kiểm tra nhanh hơn là gọi pickle.dumps trên một request mẫu trong unit test của spider, lỗi sẽ hiện ngay khi chạy test.
Đầu ra nghiệm thu: thử dừng, resume và đối soát request cùng item trùng với Scrapy JOBDIR tiếp tục crawl
Phần cuối gom lại quy trình bàn giao và vai trò của proxy.
Quy trình dừng an toàn
Dừng bằng một lần Ctrl+C rồi chờ Scrapy tự đóng. Với hệ thống quản lý tiến trình như systemd hay Supervisor, gửi SIGINT hoặc SIGTERM và đặt thời gian chờ đủ dài trước khi gửi SIGKILL. Thời gian chờ nên lớn hơn timeout tải cộng thời gian xử lý một trang.
Trên Windows, cách tương đương là để job tự dừng theo CLOSESPIDER_TIMEOUT hay CLOSESPIDER_PAGECOUNT, rồi lên lịch chạy tiếp. Cách này cho điểm dừng có trật tự mà không phụ thuộc tín hiệu.
Chia nhỏ job để giảm thiệt hại khi kill
Vì kill làm mất gần hết tiến độ, job dài nên được chia thành nhiều đợt có điểm dừng sạch. Ví dụ CLOSESPIDER_TIMEOUT 1800 giây, chạy lặp đến khi queue rỗng. Mỗi đợt mất tối đa 30 phút nếu máy sập, thay vì mất cả đêm.
Script bọc kiểm tra chế độ chạy
JOB=crawls/catalog-2026-11-03
if [ -d "$JOB" ]; then echo "RESUME $JOB"; else echo "NEW $JOB"; fi
scrapy crawl catalog -s JOBDIR="$JOB" -s CLOSESPIDER_TIMEOUT=1800 -o "out/$(date +%H%M).jsonl"
Script in rõ là chạy mới hay resume trước khi gọi Scrapy. Mỗi lần chạy ghi một tệp feed riêng theo giờ, gộp và khử trùng sau. Cách đặt tên này cũng giúp biết item nào thuộc đợt nào khi cần truy lại.
Khi job xong, tức là lần chạy kết thúc với lý do finished và queue rỗng, script nên đổi tên thư mục JOBDIR thành dạng đã hoàn tất. Lần chạy sau sẽ thấy thư mục mới và bắt đầu job mới, không vô tình resume một job đã xong.
Khi nào nên bỏ JOBDIR và chạy lại
JOBDIR không phải lúc nào cũng đáng giữ. Nếu job ngắn dưới nửa giờ, chạy lại từ đầu đơn giản hơn. Nếu website thay đổi cấu trúc giữa hai lần chạy, queue cũ chứa URL không còn hợp lệ. Nếu phiên đăng nhập đã hết hạn và khó làm mới, resume chỉ tạo ra một loạt 403.
Trong các trường hợp đó, xóa thư mục, ghi lý do vào nhật ký vận hành và chạy job mới. Khử trùng theo id ở bước sau sẽ xử lý phần item đã có từ job dở.
Bàn giao gồm những gì
Bàn giao gồm script chạy có JOBDIR cố định theo job, bảng đối soát như bảng trên cho lần thử dừng, nhật ký cuối mỗi lần chạy với lý do đóng, số mã 403, số unserializable. Kèm một bước khử trùng item theo id trước khi nạp vào kho dữ liệu.
Với job lặp lại hằng ngày, bài Scrapy Contracts kiểm tra dữ liệu crawl giúp phát hiện sớm khi website đổi cấu trúc.
Giới hạn của lab
Lab chạy trên máy cục bộ với một slot tải. Chưa thử nhiều slot, chưa thử scheduler tùy biến, chưa thử Scrapy chạy trong Docker nhận SIGTERM. Kịch bản kill chỉ thử ở mốc 4 giây. Ở mốc khác, lượng dữ liệu trong bộ đệm khác, nhưng requests.seen vẫn có nguy cơ chưa được xả.
Khi nào cần proxy với Scrapy JOBDIR tiếp tục crawl
JOBDIR không liên quan tới proxy: nó lưu request, không lưu kết nối. Proxy cần khi máy chạy crawler phải ra Internet qua proxy công ty, hoặc khi website đối tác yêu cầu một IP cố định trong danh sách cho phép.
Một lưu ý nhỏ: nếu proxy được gán qua request.meta, giá trị proxy cũng được pickle vào queue cùng request. Đổi proxy giữa hai lần chạy thì request cũ vẫn mang proxy cũ, trừ khi middleware gán lại lúc tải. Chuỗi proxy có mật khẩu cũng nằm trong tệp queue, nên bảo vệ thư mục JOBDIR như bảo vệ tệp cấu hình. Cách viết chuỗi proxy đúng chuẩn có trong bài định dạng proxy.
Với job chạy nhiều đợt cần IP thoát ổn định, proxy tĩnh dễ đối soát hơn proxy xoay. Anh em có thể mua proxy Việt Nam tại trang chủ ProxyVN, có HTTP và SOCKS5. Proxy không thay quyền truy cập: robots.txt và điều khoản của website vẫn áp dụng, như bài Web Scraping proxy là gì đã phân tích.
Checklist Scrapy JOBDIR tiếp tục crawl
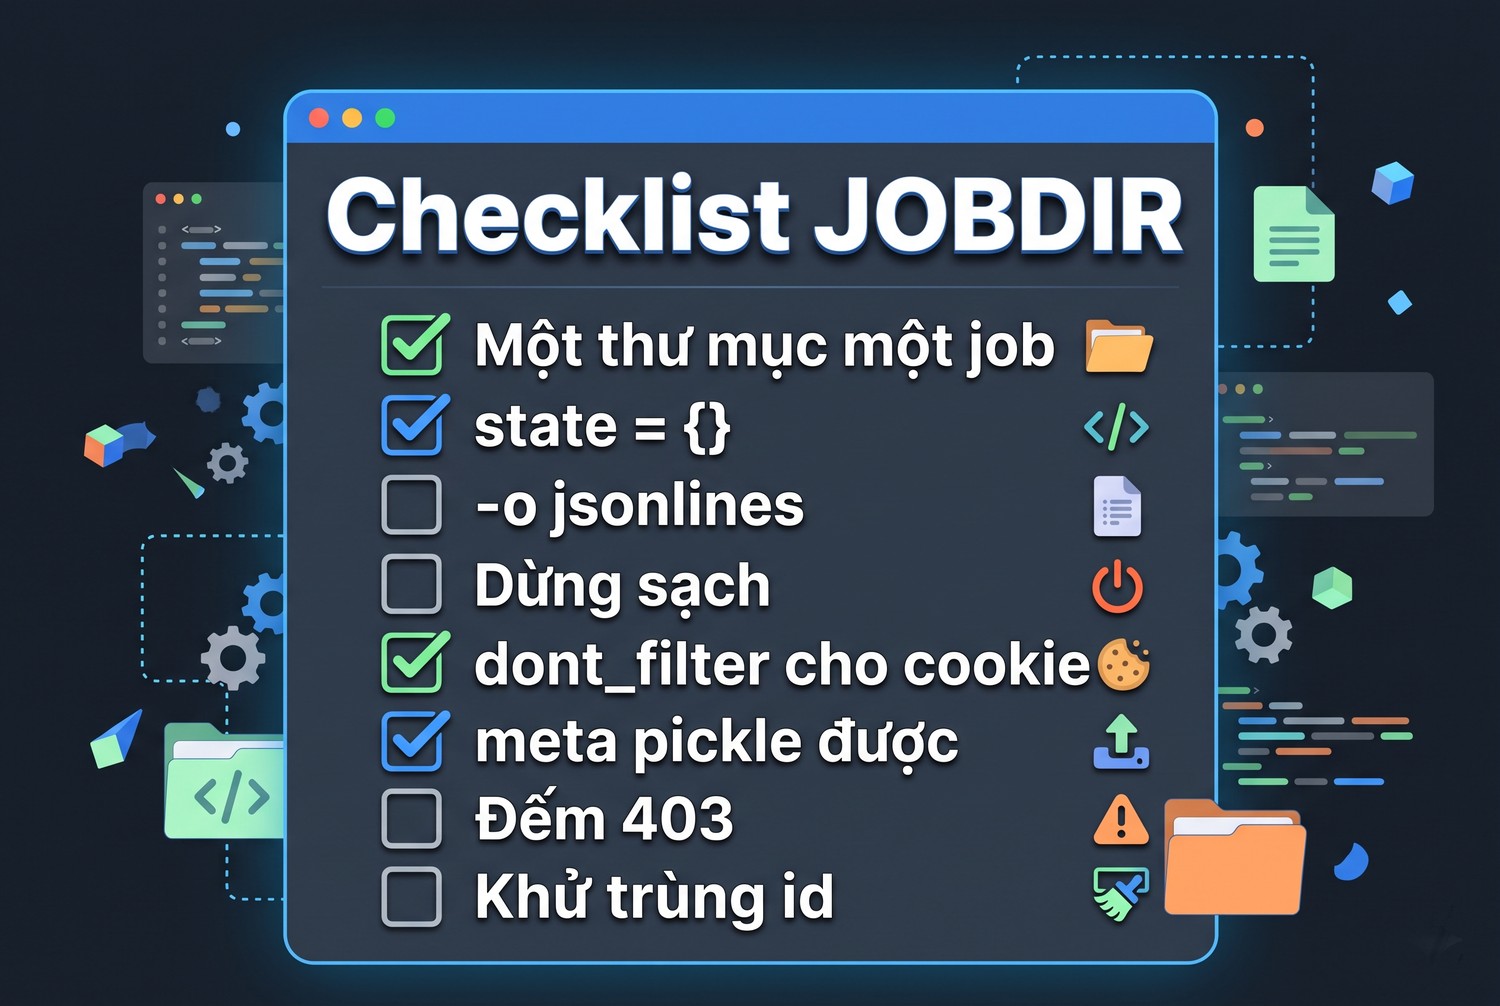
Checklist JOBDIR
- Một thư mục JOBDIR cho một job của một spider, đặt trên ổ cục bộ.
- Khai báo state = {} ở cấp lớp để spider chạy được cả khi không có JOBDIR.
- Feed dùng -o với jsonlines, không dùng -O.
- Dừng bằng một tín hiệu và chờ đóng, không kill.
- Request đặt cookie hay đăng nhập dùng dont_filter=True.
- Callback là phương thức spider, meta chỉ chứa kiểu đơn giản.
- Đếm 403 và scheduler/unserializable sau mỗi lần chạy.
- Khử trùng item theo id trước khi nạp kho.
Câu hỏi thường gặp về Scrapy JOBDIR tiếp tục crawl
JOBDIR có cứu được job bị kill không?
Trong lab thì không. Sau kill, requests.seen rỗng, không có active.json, lần sau tải lại gần như toàn bộ.
Vì sao resume xong mà toàn 403?
Cookie không được lưu trong JOBDIR. Request đặt cookie bị lọc vì đã thấy. Dùng dont_filter=True cho request đó.
Có dùng chung JOBDIR cho hai spider được không?
Không. Mỗi job một thư mục riêng, nếu không job sau sẽ đọc queue và tập đã thấy của job trước.
Self.state báo AttributeError là sao?
self.state chỉ được gắn khi có JOBDIR. Khai báo state = {} ở cấp lớp để tránh lỗi.
Resume có làm item trùng không?
Dừng sạch thì gần như không, lab có một request tải lại. Quên JOBDIR hay kill thì trùng nhiều.
Proxy có ảnh hưởng tới JOBDIR không?
Không trực tiếp. Proxy gán qua meta được lưu cùng request, nên đổi proxy phải gán lại lúc tải.
Scrapy JOBDIR tiếp tục crawl và những điều cần nhớ
Scrapy JOBDIR tiếp tục crawl chỉ đáng tin khi dừng sạch: lab ngày 03/11/2026 cho 300/300 item, một lần tải lại. Kill đột ngột hay quên tham số dẫn tới 128 đến 155 dòng trùng, và cookie mất làm 173 request nhận 403. Chia job thành đợt, đếm mã trạng thái, khử trùng theo id. Cần IP thoát ổn định cho job dùng Scrapy JOBDIR tiếp tục crawl, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


