
Scrapy contracts kiểm tra dữ liệu crawl khi layout đổi
Scrapy contracts kiểm tra dữ liệu crawl giúp chạy callback trên URL mẫu và phát hiện đầu ra không còn đúng hợp đồng. Tuy nhiên có đủ tên trường chưa đồng nghĩa giá trị hợp lệ. Bài này dùng site loopback, tạo lỗi mất giá có chủ đích và thêm contract kiểm không rỗng sau khi quan sát giới hạn của kiểm tra có sẵn. ProxyVN hướng dẫn cách kiểm trên dữ liệu mẫu.
Scrapy contracts kiểm tra dữ liệu crawl ở callback
Contracts là cách gắn điều kiện kiểm vào callback của spider rồi chạy trên URL mẫu. Nó phù hợp để bắt một số hồi quy khi selector hoặc layout thay đổi. Nó không tự chạy mọi trang mà spider có thể gặp và không thay toàn bộ kiểm định dữ liệu cuối pipeline.
Tài liệu Spiders Contracts mô tả cơ chế docstring và các contract có sẵn. Bài này xây fixture riêng với một sản phẩm để expected output dễ nhìn. Không dùng một lượt check đạt để khẳng định toàn website đã được crawl chính xác.
Phạm vi riêng là kiểm callback trả item, số lượng và trường cần giữ. Cấu hình proxy Scrapy thuộc nhiệm vụ khác và không được dùng làm thân bài này. Lab chạy một URL loopback có quyền kiểm soát, không tải website bên ngoài.
Hợp đồng cần phản ánh mục tiêu dữ liệu
Nếu callback cần trả đúng một sản phẩm trong fixture, đặt khoảng số item tương ứng. Nếu nó không được sinh request tiếp theo ở ca đó, kiểm số request bằng không. Hai điều kiện giúp phát hiện callback không yield hoặc vô tình đổi luồng điều hướng.
Các trường SKU, price và source_url giúp nối giá với nguồn của record. Tuy nhiên chỉ yêu cầu tên trường vẫn chưa kiểm kiểu hoặc ý nghĩa. Một price bằng None có thể tồn tại trong dict và qua một kiểm tra hiện diện khóa.
Định nghĩa expected trước khi chạy giúp test có khả năng báo sai. Nếu sửa điều kiện theo output hiện tại chỉ để mọi thứ pass, bộ kiểm sẽ không bảo vệ dữ liệu. Giữ fixture lỗi chủ đích bên cạnh fixture tốt để xác nhận test thật sự nhạy với vấn đề.
Scrapy contracts kiểm tra dữ liệu crawl với fixture loopback
Site lab có một div product, một span sku và một span price. Bản gốc dùng lớp price; bản đổi layout dùng cost trong khi spider vẫn tìm price. Đây là thay đổi tự tạo để kiểm phản ứng của hợp đồng, không phải sự cố của một nguồn thật.
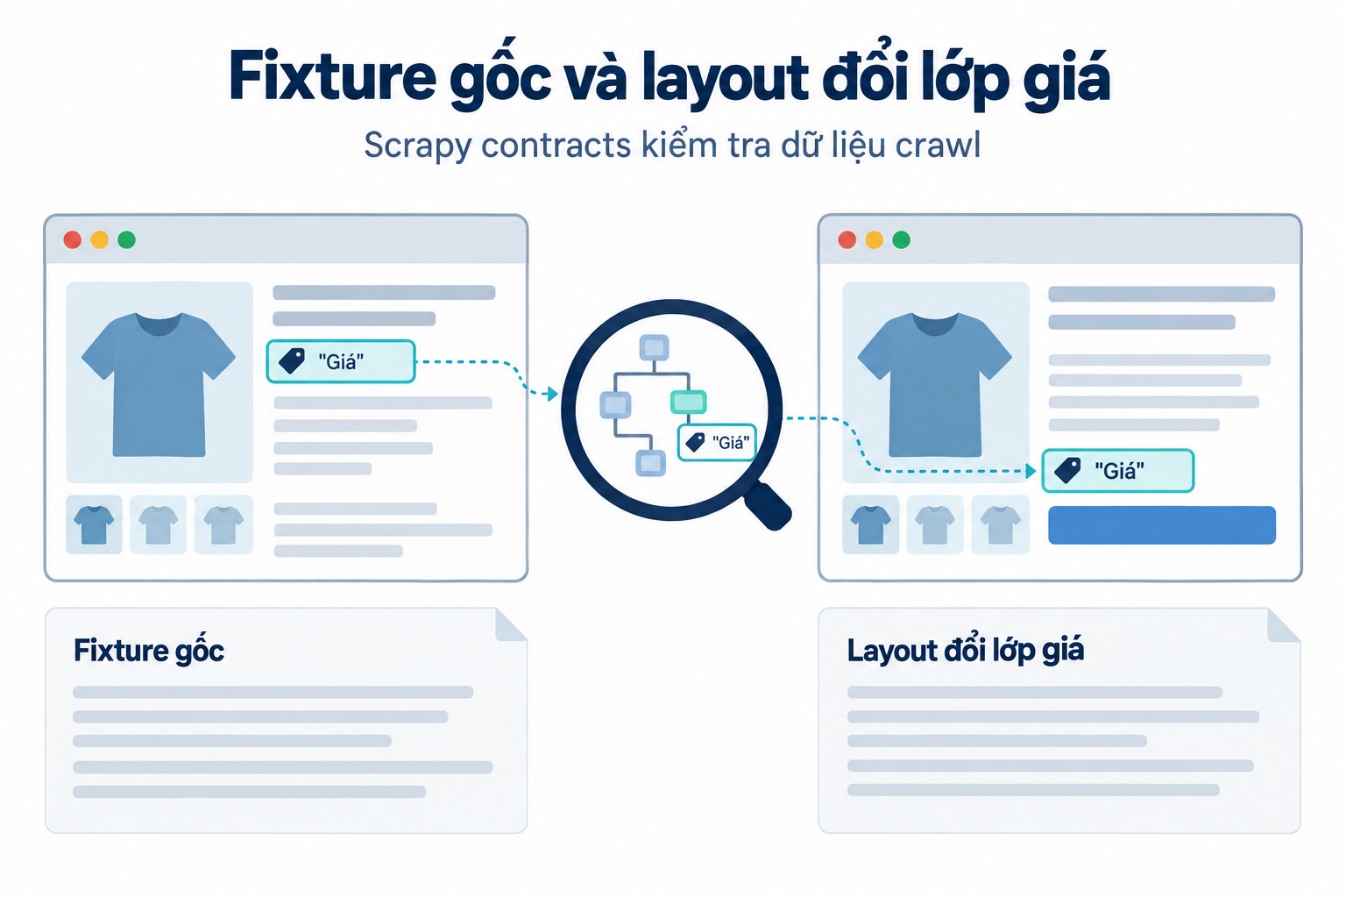
Fixture gốc và layout đổi lớp giá
Spider nhỏ có điều kiện đếm và trường
Ví dụ dưới giả định server lab đang phục vụ URL đã chỉ định. Nếu dùng cổng khác, sửa @url cho khớp trước khi chạy. Callback chỉ thêm khóa price khi selector thật sự lấy được giá, để ca layout đổi tạo trạng thái thiếu khóa rõ ràng.
import scrapy
class LabSpider(scrapy.Spider):
    name = 'lab_contract'
    def parse(self, response):
        """
        @url http://127.0.0.1:8789/products
        @returns items 1 1
        @returns requests 0 0
        @scrapes sku price source_url
        """
        for node in response.css('.product'):
            item = {'sku': node.css('.sku::text').get(),
                    'source_url': response.url}
            price = node.css('.price::text').get()
            if price is not None:
                item['price'] = price
            yield item
Trong một project Scrapy đã cấu hình loader, chạy lệnh check cho spider mục tiêu. Lab cần tắt những dịch vụ hoặc middleware không phục vụ phép thử nếu chúng làm đổi tuyến ngoài ý muốn. Không sửa settings production để chạy một fixture nhỏ.
scrapy check lab_contractCommand line của Scrapy là nguồn đối chiếu cách gọi trong project. Giữ tên spider và cấu hình được nạp trong report. Một lệnh kết thúc không lỗi vì không tìm thấy callback được kiểm không có cùng ý nghĩa với các assertion đã chạy đạt.
URL mẫu là một phần của test
@url xác định input để callback được kiểm theo contract. Nếu URL không truy cập được hoặc trả trang khác, lỗi không còn là ca layout đã thiết kế. Ghi status và payload fixture để biết request mẫu thực nhận gì.
Không dùng URL production có dữ liệu đổi liên tục cho mọi lần CI nếu không có quyền và kế hoạch phù hợp. Fixture loopback giữ input ổn định và không gây tải nguồn. Các ca tích hợp với nguồn thật, nếu cần, nên có phạm vi riêng.
Nếu callback dùng tham số hoặc metadata, cung cấp input đúng theo tài liệu contract và version. Đừng giả định môi trường check tự tạo mọi trạng thái như lúc spider chạy đầy đủ. Một test callback cần mô tả rõ phần context nó đã dựng.
Scrapy contracts kiểm tra dữ liệu crawl khi mất trường
Khi fixture đổi lớp price thành cost, selector cũ không lấy được giá. Callback vẫn yield một item có SKU và source_url nhưng không có khóa price. Điều kiện đếm item vẫn có thể đạt; kiểm trường mới là phần phát hiện lỗi.
Đọc từng kết quả thay vì chỉ nhìn mã thoát
Bộ lab chạy scrapy check thật trong tiến trình con. Fixture gốc đạt; fixture đổi layout thất bại với trường price thiếu theo hợp đồng. Kết quả này chứng minh bộ kiểm bắt ca được thiết kế, không chứng minh mọi layout mới sẽ bị phát hiện.
Log cần nối tên callback, contract và lỗi cụ thể. Một fail do không kết nối được server khác fail do thiếu price. Nếu gom cả hai thành “selector hỏng”, người bảo trì sẽ sửa sai nơi và có thể bỏ qua vấn đề hạ tầng của test.
Giữ mã thoát để CI có thể dừng bước tiếp theo theo chính sách. Đồng thời giữ output đủ đọc để biết assertion nào thực chạy. Chỉ nhìn một biểu tượng xanh của job tổng không cho biết có bao nhiêu contract hoặc callback đã được kiểm.
Đừng sửa bằng giá mặc định để làm test xanh
Điền price bằng không khi thiếu không khôi phục dữ liệu. Nó đổi lỗi selector thành một giá trị có thể được hiểu là giá thật. Nếu source không công bố giá hoặc parser không hiểu, giữ trạng thái thiếu hoặc đưa record vào quarantine theo schema.
Thêm khóa price với None cũng không tự giải quyết mục tiêu chất lượng. Nó có thể làm kiểm tên trường đạt dù downstream vẫn không dùng được giá. Đây là lý do bài bổ sung ca có khóa nhưng rỗng trước khi thiết kế custom contract.
Nếu nguồn thực thay selector, sửa theo snapshot có nhãn và chạy lại cả ca gốc cùng ca mới. Không mở selector thành lấy mọi số trên trang để thu được một giá bất kỳ. Giá phải còn gắn đúng product và source_url của fixture.
Scrapy contracts kiểm tra dữ liệu crawl với khóa có giá trị None
Trong phép thử thứ ba, callback luôn tạo khóa price dù selector trả None. Fixture vẫn dùng cost nên không có giá ở selector cũ. Contract có sẵn kiểm hiện diện trường đã cho ca này qua trong môi trường lab.
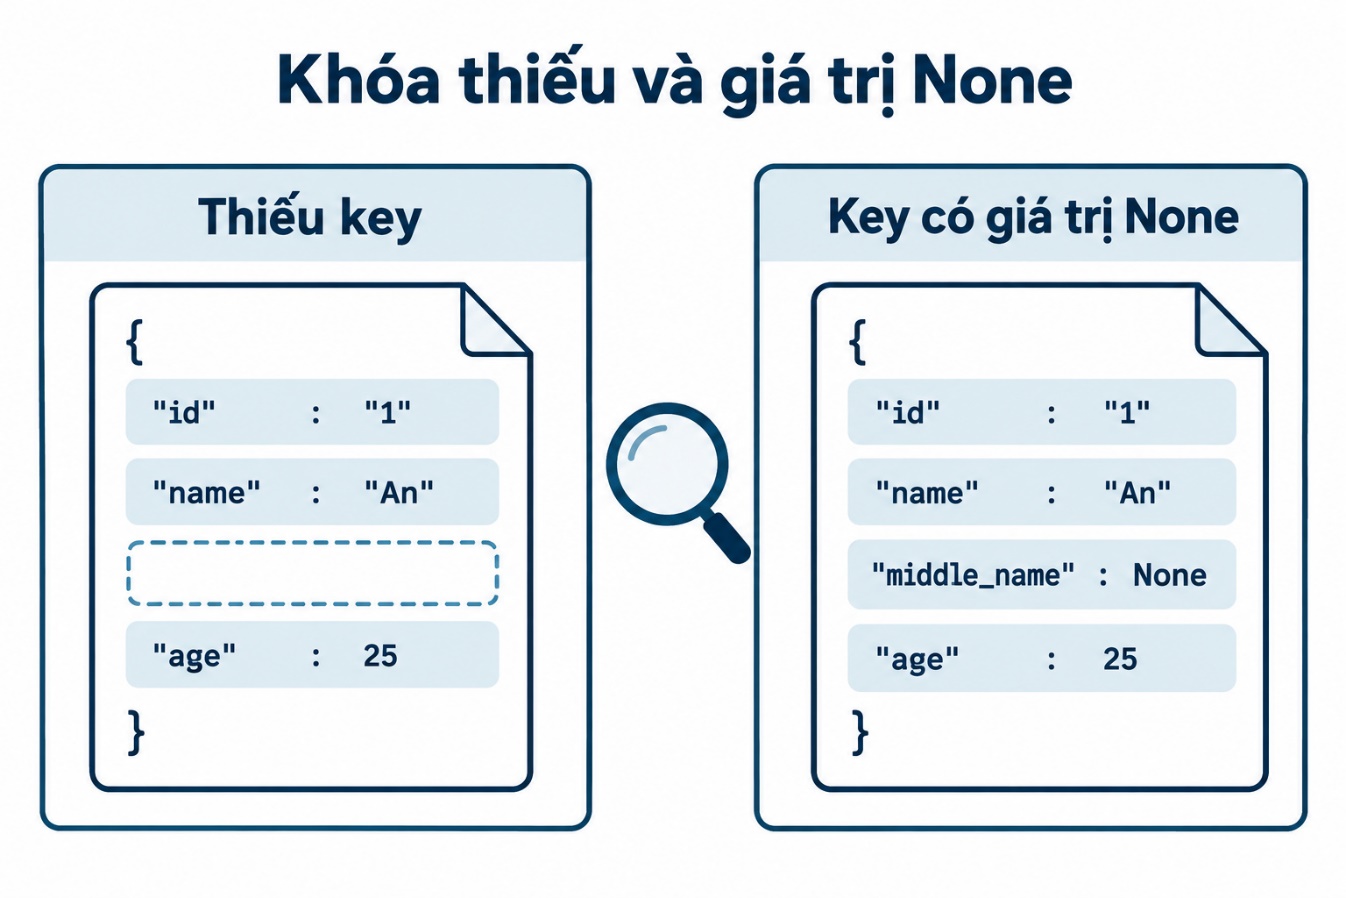
Khóa thiếu và giá trị None
Ca đã chạy |
Đầu ra callback |
Kết quả phù hợp mục tiêu |
|---|---|---|
Layout gốc |
Đủ khóa và giá |
Built-in check đạt |
Layout đổi, bỏ khóa thiếu |
Không có price |
Built-in check báo lỗi |
Layout đổi, giữ price None |
Có khóa nhưng rỗng |
Built-in check chưa đủ |
Thêm custom nonempty |
Price None |
Custom check báo lỗi |
Hiện diện khóa là một điều kiện hẹp
Một dict có price không có nghĩa price là số hoặc chuỗi dùng được. Nó có thể là None, chuỗi trắng hoặc object không đúng kiểu. Kiểm schema cần được chia thành các điều kiện có tên rõ để người đọc không gán nhiều ý nghĩa hơn test thực làm.
Không gọi ca None qua built-in là lỗi của Scrapy khi hợp đồng được chọn chỉ kiểm trường theo chức năng của nó. Vấn đề là test chưa phản ánh yêu cầu dữ liệu. Mở rộng điều kiện một cách có chủ đích sẽ rõ hơn sửa framework hoặc bỏ assertion.
Giữ ca này trong bộ hồi quy để lần sau người bảo trì không thay callback rồi tưởng @scrapes đã kiểm giá hợp lệ. Một phản ví dụ nhỏ có thể giải thích giới hạn tốt hơn nhiều dòng ghi chú chung về chất lượng dữ liệu.
Tách kiểu và miền giá trị
Kiểm nonempty chỉ xử lý rỗng theo quy tắc đã định. Nó chưa xác nhận price là số thập phân, không âm hoặc đúng currency. Những điều kiện đó có thể nằm trong custom contract khác hoặc validator downstream theo schema dự án.
Một giá bằng số không có thể hợp lệ theo một tác vụ, nên không dùng if not value cho mọi field. Điều kiện rỗng cần phân biệt None, chuỗi trắng và các giá trị số. Bài dùng quy tắc rõ để không biến số không thành lỗi rỗng.
Nếu có nhiều loại item, chọn schema theo loại thay vì buộc mọi item có cùng trường. Một Request được callback trả không phải item sản phẩm để kiểm price. Cấu trúc output cần được hiểu trước khi áp điều kiện chung.
Scrapy contracts kiểm tra dữ liệu crawl bằng custom contract
Custom contract giúp biểu diễn yêu cầu mà kiểm có sẵn chưa đáp ứng. Nó cần nhỏ, có tên dễ hiểu và được thử bằng ca sai chủ đích. Một hàm phức tạp chứa cả logic chuẩn hóa có thể làm test khó hiểu và tự che lỗi của callback.
Ví dụ kiểm không rỗng cho dict item
Lớp dưới kiểm None và chuỗi chỉ có khoảng trắng trên các trường được chỉ định. Nó chỉ hỗ trợ dict trong ví dụ, không tự nhận mọi lớp item hoặc request. Nếu dùng ItemAdapter cho nhiều loại, thêm bộ test cho nhánh đó trước khi mở rộng.
from scrapy.contracts import Contract
from scrapy.exceptions import ContractFail
class NonEmptyContract(Contract):
    name = 'nonempty'
    def post_process(self, output):
        for item in output:
            if isinstance(item, dict):
                for field in self.args:
                    value = item.get(field)
                    if value is None or (
                        isinstance(value, str) and not value.strip()):
                        raise ContractFail(field + ' is empty')
Đăng ký lớp trong SPIDER_CONTRACTS của project lab theo module path thực, rồi thêm @nonempty price vào docstring callback. Không chỉ viết lớp mà quên đăng ký, vì lúc đó assertion mới có thể chưa chạy. Report cần thể hiện tên contract được gọi.
Trong ca thứ tư đã chạy, custom contract báo price is empty và tiến trình check trả trạng thái thất bại như kỳ vọng. Đây là một expected failure của fixture lỗi, được tính là bộ kiểm phát hiện đúng. Không sửa fixture lỗi cho pass rồi mất bằng chứng test có tác dụng.
Giữ kiểm định downstream độc lập
Contract giúp kiểm callback trên input mẫu, còn dữ liệu batch thực vẫn cần validator nếu yêu cầu. Một callback có thể đạt trên fixture nhưng gặp một giá trị mới ngoài mẫu. Không bỏ kiểm schema cuối chỉ vì scrapy check đã xanh.
Item pipeline của Scrapy là nguồn đối chiếu một lớp xử lý khác trong dự án. Nếu mục tiêu là kiểm pipeline, cần test lớp đó theo cấu hình thực. Không gán kết quả contract callback thành xác nhận mọi bước lưu đã chạy.
Khi dùng Pandera hoặc Pydantic ở downstream, giữ lỗi có nguồn URL để nối về input. Contract và validator không cần làm cùng một việc lặp lại, nhưng nên có ranh giới trách nhiệm rõ. Một lớp bắt hồi quy layout, lớp khác bảo vệ schema của dữ liệu thực.
Scrapy contracts kiểm tra dữ liệu crawl trong CI
Một bộ check có ích khi input ổn định, cấu hình rõ và lỗi được đưa đến người xử lý. Fixture loopback phù hợp cho ca chức năng nhỏ. Các kiểm nguồn thật có quyền nên tách để không làm mọi lần sửa code gây truy cập ngoài dự án.
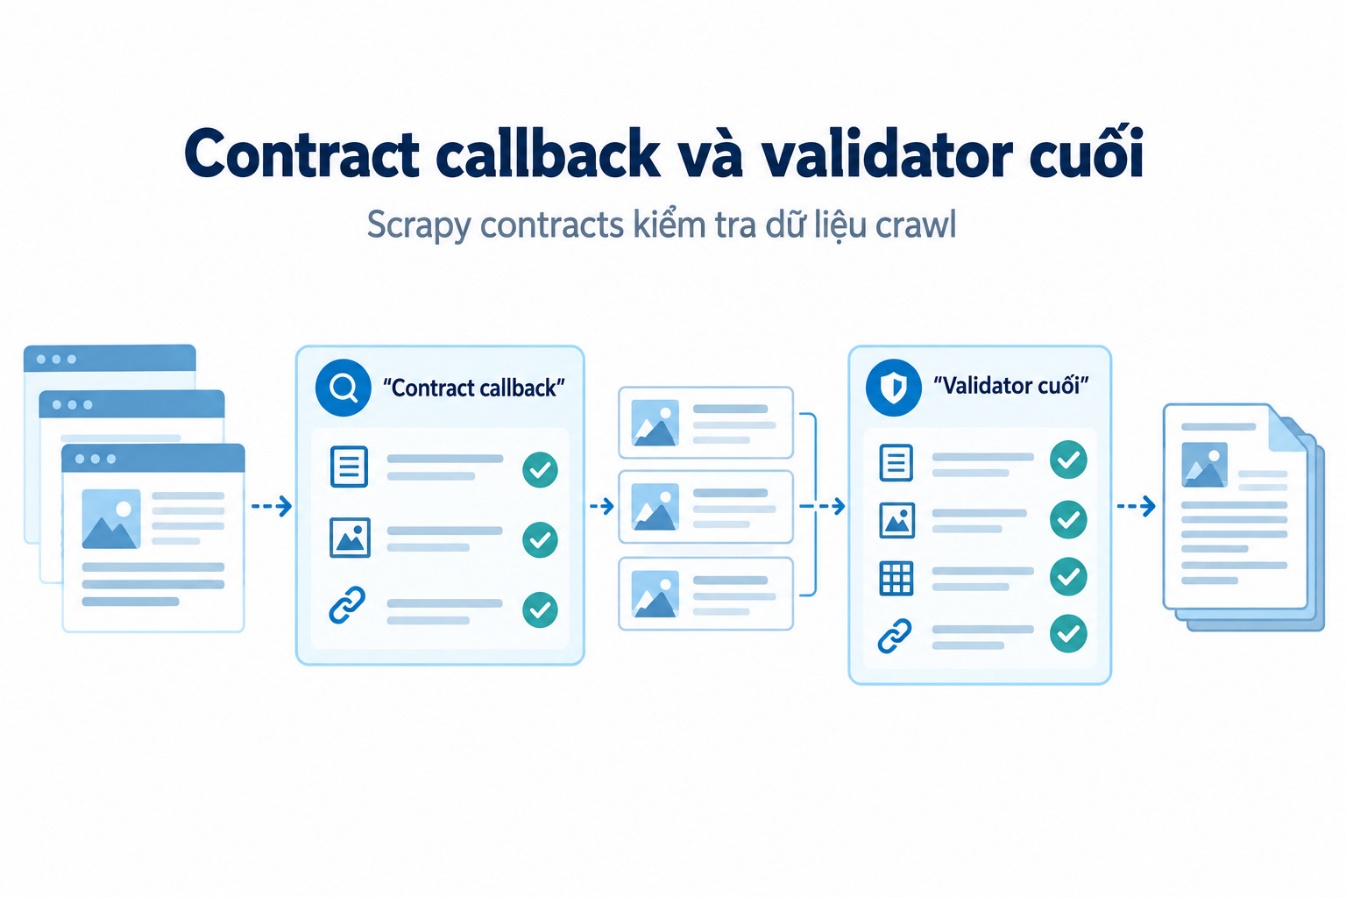
Contract callback và validator cuối
Chuẩn bị môi trường tái lập
Khóa Python, Scrapy và dependency quan trọng; lưu settings riêng cho lab. Server fixture dùng cổng khả dụng và dọn sau test. Không dừng tiến trình khác đang giữ cổng chỉ vì ví dụ viết một số cố định.
Nếu cổng được cấp động, đưa URL thực vào spider fixture trước khi chạy tiến trình check. Ghi URL đó trong report để đối chiếu log server. Không để @url trỏ cổng cũ khiến test thất bại vì một môi trường đã thay đổi ngoài ý muốn.
Giữ import module và project path đúng để Scrapy tìm được spider cùng custom contract. Một lỗi loader không phải lỗi dữ liệu. Kiểm danh sách contract hoặc output thực theo công cụ để biết assertion đã được thực thi.
Phân loại lỗi phục vụ hành động
Lỗi tải fixture cần kiểm listener và cấu hình test. Lỗi số item cần kiểm selector product hoặc luồng yield. Lỗi thiếu khóa cần kiểm cách tạo item. Lỗi nonempty cần xem giá trị selector và trạng thái nguồn. Những nhãn này dẫn đến bước điều tra khác nhau.
Không retry một fail dữ liệu cố định nhiều lần để hy vọng pass ngẫu nhiên. Giữ snapshot, seed và kết quả để sửa có bằng chứng. Nếu dữ liệu mẫu cố ý thay đổi theo thời gian, ghi đó là kiểm tích hợp với kỳ vọng phù hợp, không phải fixture ổn định.
Khi mua proxy cho spider production, giữ kiểm tuyến riêng với contract dữ liệu. Bộ lab hiện tại không dùng gateway thương mại. Một tuyến hoạt động không làm field price tự hợp lệ, còn một contract đạt không chứng minh spider đã đi qua proxy.
Scrapy contracts kiểm tra dữ liệu crawl và bộ ca mở rộng
Bộ bốn ca của bài cho thấy sự khác nhau giữa trường thiếu và trường rỗng. Trước production, thêm các biến thể mà nguồn thực có thể tạo. Mỗi ca cần expected output được định nghĩa trước, không chỉ một trang giúp tăng số test.
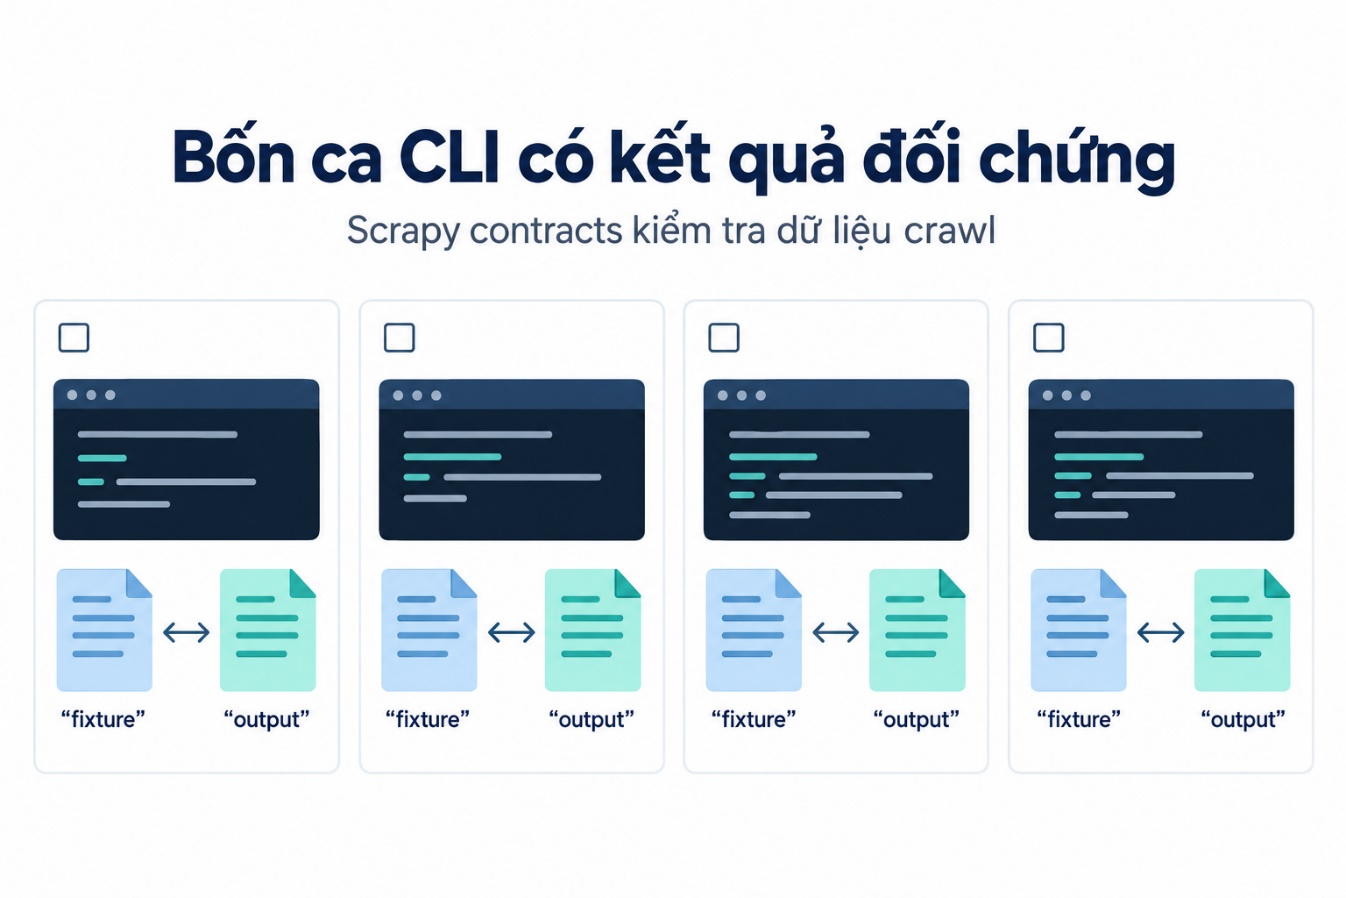
Bốn ca CLI có kết quả đối chứng
Số lượng và quan hệ item
Thêm fixture không có product để kiểm @returns báo không đạt theo hợp đồng một item. Thêm hai product để xem callback không gộp tên của một item với giá item kia. Số lượng đúng chưa đủ; mapping theo SKU và source_url cũng cần được kiểm theo mục tiêu.
Thêm một giá bằng không để custom nonempty không từ chối nhầm. Thêm chuỗi trắng và kiểu dữ liệu sai để kiểm ranh giới validator. Nếu contract chỉ kiểm không rỗng, giữ các lỗi kiểu cho lớp kiểm phù hợp thay vì gọi tất cả đã được bao phủ.
Nếu callback trả Request theo logic thật, tạo một bộ ca khác có số request kỳ vọng. Không giữ @returns requests 0 0 cho mọi callback chỉ vì fixture nhỏ của bài dùng nó. Hợp đồng cần theo vai trò callback, không theo một mẫu sao chép.
Giới hạn của bộ kiểm đã chạy
Bộ thử chạy scrapy check CLI trên một URL loopback với layout gốc và layout đổi có chủ đích. Nó chưa kiểm toàn bộ spider production, middleware proxy, pipelines lưu dữ liệu hoặc website bên ngoài. Những giới hạn này cần giữ trong ghi chú trước xuất bản.
Tài liệu Spiders giúp đối chiếu vòng đời callback và output. Với phiên bản mới, kiểm những thay đổi API liên quan trước khi nâng. Không nhận một docstring đúng cú pháp là bằng chứng mọi contract đã được đăng ký và chạy.
Giữ source fixture, settings, custom class, stdout và mã thoát theo từng ca. Một expected failure cần được mô tả để người tiếp nhận không nhầm là test chưa sửa. Khi mọi nhánh có thể giải thích, bộ kiểm trở thành tài sản bảo trì thay vì một lệnh chạy để lấy dấu xanh.
Scrapy contracts kiểm tra dữ liệu crawl trong project lab riêng
Để tái hiện, tạo project chỉ chứa spider, settings và custom class của phép thử. Không cần mang middleware xác thực hoặc pipeline production vào một ca kiểm selector. Cấu hình tối thiểu giúp output lỗi có ít nguyên nhân ngoài nhiệm vụ hơn và dễ nối với fixture.
Cấu trúc module và phần đăng ký
Trong lab đã chạy, labspiders là module chứa LabSpider, còn labcontracts chứa NonEmptyContract. Settings trỏ loader đến module spider và đăng ký custom class bằng module path. Nếu đặt tên file khác, đổi đường dẫn tương ứng thay vì giữ một chuỗi trỏ tới module không tồn tại.
SPIDER_MODULES = ['labspiders']
SPIDER_CONTRACTS = {'labcontracts.NonEmptyContract': 10}
TELNETCONSOLE_ENABLED = False
DOWNLOAD_TIMEOUT = 5
Thứ tự và cấu hình contract cần theo API của phiên bản đang dùng. Giá trị trong ví dụ là cấu hình lab, không phải một chuẩn ưu tiên áp dụng mọi project. Khi có nhiều custom class, giữ expected về những tên contract đã được nạp trong báo cáo.
Docstring callback sau khi thêm lớp riêng cần dòng @nonempty price. Nếu chỉ đăng ký class nhưng không yêu cầu trong callback, điều kiện đó chưa nhất thiết được áp cho ca đang kiểm. Ngược lại, có dòng yêu cầu mà class không được nạp cũng không phải kết quả đã được nghiệm thu.
Khi đọc log, xác nhận callback parse là callback mục tiêu. Một spider có nhiều callback có thể chỉ có một phần được gắn URL mẫu. Số test đạt không tự mô tả độ bao phủ của toàn bộ đồ thị crawl, vì những callback không được dựng input chưa được kiểm trong lượt đó.
Giữ project lab trong thư mục riêng để các lần thay settings không ảnh hưởng spider khác. Môi trường chạy cần tìm được đúng module bằng đường dẫn Python hoặc cơ chế project. Không sửa PYTHONPATH toàn hệ thống để chạy ví dụ; cấu hình trong tiến trình test là đủ.
Một thay đổi input và một thay đổi callback
Bộ bốn ca cố ý tách thay đổi HTML khỏi thay đổi cách tạo item. Ở ca hai, chỉ lớp CSS đổi còn callback giữ logic bỏ khóa khi không có giá. Ở ca ba, HTML vẫn lỗi theo selector cũ nhưng callback giữ khóa None. Cách chia giúp biết vì sao kết quả contract khác.
Nếu đồng thời sửa HTML, selector và contract, một lượt pass cuối sẽ không cho biết phần nào đã giải quyết yêu cầu. Giữ từng phiên bản fixture và source trong hồ sơ giúp người nhận chạy lại chuỗi lập luận. Một diff nhỏ có mục tiêu dễ kiểm hơn một bản spider mới dài không có đối chứng.
Ca bốn chỉ thêm điều kiện nonempty vào cấu hình và docstring trong khi giữ output None. Fail là kỳ vọng đúng vì yêu cầu mới đã được biểu diễn. Không tính nó là lỗi còn tồn của bộ thử; lỗi dữ liệu là input cố ý dùng để kiểm khả năng phát hiện.
Mã thoát khác không ở ca dự kiến fail cần được wrapper kiểm đúng loại lỗi. Nếu tiến trình thất bại vì import module, đó không phải pass cho ca nonempty. Bộ lab còn kiểm thông báo price is empty để không nhầm hai loại thất bại.
Với ca baseline, kiểm cả số assertion hoặc nội dung output đủ để biết hợp đồng đã chạy. Một tiến trình kết thúc thành công nhưng không có callback được kiểm không bảo vệ dữ liệu. Chính sách CI nên xem thiếu ca là trạng thái khác với các ca đã đạt.
Scrapy contracts kiểm tra dữ liệu crawl theo miền giá trị
Sau khi phân biệt thiếu và rỗng, cần quyết định điều kiện giá trị thuộc lớp nào. Một custom contract nhỏ nên làm một việc có thể giải thích. Khi logic dữ liệu lớn hơn, validator riêng thường giúp giữ schema và báo lỗi theo trường rõ hơn.
Số không và chuỗi trắng là hai phản ví dụ
Với quantity hoặc price theo một số tác vụ, số không có thể là giá trị hợp lệ. Một điều kiện bool sẽ xem nó là false cùng với None, nên không phù hợp để gọi chung là thiếu. Custom class của bài chỉ từ chối None và chuỗi trắng theo quy tắc được viết rõ.
Chuỗi chứa ký tự số như 12.50 vượt qua nonempty nhưng vẫn là chuỗi cần parse ở bước khác. Một chuỗi không phải số cũng có thể vượt qua điều kiện này. Vì vậy report không được đặt tên ca là giá hợp lệ nếu assertion chỉ kiểm không rỗng.
Nếu tác vụ yêu cầu số không âm, thêm một validator với kiểu Decimal hoặc kiểu số phù hợp và phản ví dụ âm. Nếu cần currency, kiểm nó cùng record. Không tự điền đơn vị theo ngôn ngữ giao diện chỉ để mọi trường đều có giá trị.
Một record sai kiểu nên được giữ trong báo cáo lỗi theo URL và SKU nếu có. Lỗi theo record giúp biết phạm vi ảnh hưởng khi một layout chỉ thay ở một số biến thể. Đếm fail theo callback thôi có thể chưa đủ cho kiểm dữ liệu batch thực.
Không để test lặp nguyên logic selector
Nếu expected price cũng được lấy bằng chính selector đang kiểm, cả callback và test có thể sai theo cùng cách. Fixture nên có giá trị nhãn độc lập được biết trước. Assertion so giá với nhãn mới giúp phát hiện trường lấy nhầm giá từ sản phẩm khác.
Tương tự, một kiểm số item được suy từ cùng danh sách node của callback không tạo đối chứng độc lập. Với fixture tự tạo, expected một item là thông tin từ thiết kế HTML. Khi mở rộng nhiều sản phẩm, giữ danh sách SKU và giá mục tiêu trong dữ liệu nhãn riêng.
Một bộ kiểm tốt không cần nhiều assertion trùng nhau. Nó cần những assertion bắt được sai khác có ý nghĩa như thiếu record, gán chéo giá hoặc mất nguồn. Chọn theo lỗi mà dữ liệu đã hoặc có khả năng gặp, rồi giữ ca phản ví dụ đủ nhỏ để đọc.
Bàn giao kết quả với đúng nhãn
Report bốn ca nên ghi expected pass hoặc expected fail, mã thoát thực và điều kiện đã quan sát. Khi ca lỗi chủ đích được phát hiện, wrapper ghi bộ kiểm đạt cho mục tiêu đó nhưng vẫn giữ output lỗi để đọc. Hai tầng trạng thái giúp người nhận không nhầm dữ liệu fixture lỗi là dữ liệu có thể dùng.
Những ca chưa chạy như middleware proxy hoặc pipeline lưu cần tiếp tục mang trạng thái ngoài phạm vi. Không dùng tổng số bốn ca để khẳng định mọi lớp đã được bao phủ. Nếu triển khai thêm lớp, bổ sung fixture và expected output của đúng lớp đó.
Khi đổi tên module, chạy lại ca baseline trước. Một import cũ trong settings có thể khiến lớp mới chưa được nạp dù tệp code đã được lưu đúng chỗ.
Có khóa price và có giá dùng được là hai điều kiện khác nhau; contract cần phản ánh đúng yêu cầu dữ liệu.
Anh em hãy lưu dữ liệu mẫu cùng cấu hình và kết quả đối chiếu để lần cập nhật sau có cơ sở kiểm lại. Tham khảo thêm tại Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam. Bắt đầu từ phạm vi nhỏ và tiêu chí rõ ràng khi triển khai Scrapy contracts kiểm tra dữ liệu crawl.


