Proxy Scrapy: Cấu Hình Và Xoay IP Khi Crawl Dữ Liệu
Proxy Scrapy là phần cấu hình để framework crawl này gửi request qua một hoặc nhiều địa chỉ IP thay cho IP máy chủ. Scrapy gửi request nhanh và song song, nên rất dễ chạm ngưỡng chống bot nếu chỉ dùng một IP. Bài viết này ProxyVN trình bày cách gắn proxy qua request.meta, cấu hình middleware, viết middleware xoay IP và điều tiết tải.
Vì sao cần proxy Scrapy khi crawl dữ liệu
Scrapy được thiết kế để crawl nhanh và ở quy mô lớn. Chính điểm mạnh đó khiến nó dễ bị chặn nếu không phân tán qua nhiều IP.
Scrapy gửi request nhanh và song song
Mặc định Scrapy mở nhiều kết nối cùng lúc và không nghỉ giữa các request. Một máy chủ đích thấy hàng chục request mỗi giây từ một địa chỉ sẽ coi đó là bot và chặn. Proxy chia tải này ra nhiều IP, mỗi IP chỉ gánh một phần nhỏ.
Site chặn theo tần suất IP
Phần lớn website đếm số request theo địa chỉ IP trong một cửa sổ thời gian. Vượt ngưỡng thì trả về mã 403 hoặc 429. Với một job crawl vài chục nghìn trang, ước lượng tổng request mỗi giờ rồi chia cho mức an toàn một IP chịu được để ra số proxy cần. Một quy tắc ngón tay cái hay dùng là giữ mỗi IP dưới vài trăm request mỗi giờ, rồi nhân thêm hệ số dự phòng vì luôn có IP tạm bị chặn hoặc phản hồi chậm. Bao nhiêu request mỗi IP thì bắt đầu dính 429 được bàn cụ thể trong bài lỗi 429 khi mua proxy.
Nội dung khác nhau theo vùng
Nhiều trang hiển thị giá, ngôn ngữ hoặc danh mục khác nhau tùy vị trí người xem. Muốn crawl đúng nội dung một thị trường, cần proxy đặt trong vùng đó. Đây là lý do thứ hai để dùng proxy, ngoài việc tránh bị chặn.
Scrapy khác thư viện requests ở chỗ nào
Với thư viện requests, anh em truyền proxy qua tham số proxies trong từng lệnh gọi. Scrapy tách việc này ra một tầng riêng gọi là downloader middleware. Mọi request đi qua chuỗi middleware theo thứ tự, và proxy được gắn ở một mắt xích trong chuỗi đó. Nhờ vậy logic xoay proxy nằm gọn một chỗ, không rải khắp spider, và áp cho cả request phân trang lẫn request theo liên kết mà không phải truyền thủ công. Cách gắn proxy cho thư viện requests đơn giản hơn được hướng dẫn trong bài cài đặt Python proxy từ thư viện requests.
Hệ quả thực tế: cấu hình proxy cho Scrapy chủ yếu là việc của file settings.py và một file middleware, còn spider gần như không cần biết đến proxy. Đây là điểm khác biệt lớn nhất so với viết script cào bằng requests thuần.
Cách gắn proxy Scrapy đơn giản qua request.meta
Cách nhanh nhất để thử là gán proxy cho từng request bằng khóa proxy trong request.meta. Không cần cấu hình middleware phức tạp.
Đặt proxy cho một request
Bài của IPRoyal về crawl web bằng Scrapy chỉ ra cách gán trực tiếp: đặt request.meta['proxy'] bằng chuỗi dạng http kèm địa chỉ và cổng. Scrapy có sẵn HttpProxyMiddleware đọc giá trị này và định tuyến request qua proxy đó.
Đặt proxy trong start_requests
Để mọi request của spider đi qua cùng một proxy, sinh request trong start_requests và truyền meta proxy, rồi truyền lại meta đó cho các request phân trang. Hướng dẫn cào web bằng Scrapy của Webshare nhắc thêm rằng dù dùng proxy, vẫn nên đặt USER_AGENT trong settings.py giống một trình duyệt thật, vì thiếu nó nhiều site trả về mã 403 ngay cả khi IP sạch. Đoạn dưới là ví dụ triển khai chung.
import scrapyclass SachSpider(scrapy.Spider): name = "sach" start_urls = ["https://sach.example/danh-muc/1"] PROXY = "http://user:[email protected]:12321" def start_requests(self): for url in self.start_urls: yield scrapy.Request(url, callback=self.parse, meta={"proxy": self.PROXY}) def parse(self, response): for sp in response.css("article.product"): yield { "ten": sp.css("h3 a::attr(title)").get(), "gia": sp.css("p.price::text").get(), } tiep = response.css("li.next a::attr(href)").get() if tiep: yield response.follow(tiep, callback=self.parse, meta={"proxy": self.PROXY})
Giới hạn của cách này
Gán meta thủ công dùng chung một IP cho cả job. Không có xoay, không có thử lại proxy khác khi một IP chết. Đủ để kiểm tra nhanh hoặc cho job nhỏ, nhưng crawl quy mô lớn cần một middleware xoay.
Một biến thể là truyền tên proxy khác nhau cho từng nhóm URL ngay trong spider, ví dụ nhóm danh mục A dùng proxy vùng Mỹ, nhóm danh mục B dùng proxy vùng Nhật. Cách này vẫn thủ công nhưng đủ cho các job cần cố định vùng theo nhánh dữ liệu mà không cần logic xoay phức tạp.
Cấu hình proxy Scrapy trong settings.py với HttpProxyMiddleware
HttpProxyMiddleware là thành phần có sẵn của Scrapy, chịu trách nhiệm gắn proxy vào kết nối. Hiểu vai trò và thứ tự của nó là nền để làm phần xoay.
HttpProxyMiddleware đọc biến môi trường và meta
Middleware này lấy proxy từ hai nguồn: biến môi trường http_proxy và https_proxy của hệ thống, hoặc giá trị request.meta['proxy'] nếu có. Nếu chỉ cần một proxy cho cả job, đặt biến môi trường trước khi chạy scrapy crawl là đủ, không cần sửa code.
Thứ tự middleware trong DOWNLOADER_MIDDLEWARES
Trong DOWNLOADER_MIDDLEWARES, số nhỏ chạy trước ở chiều đi ra. Middleware xoay của anh em phải chạy trước HttpProxyMiddleware để kịp đặt request.meta['proxy'], nên gán cho nó số nhỏ hơn. Ví dụ middleware xoay ở 100, HttpProxyMiddleware ở 110.
# settings.pyDOWNLOADER_MIDDLEWARES = { "scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware": 110, "myproject.middlewares.ProxyXoayMiddleware": 100,}PROXY_LIST = [ "http://user:[email protected]:8000", "http://user:[email protected]:8000",]RETRY_ENABLED = TrueRETRY_TIMES = 5DOWNLOAD_TIMEOUT = 30USER_AGENT = "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"
Middleware sẵn có của nhà cung cấp
Nhiều nhà cung cấp phát hành sẵn một file middleware để tải về. Tài liệu middleware proxy cho Scrapy của Decodo hướng dẫn tải file middleware, khai báo trong DOWNLOADER_MIDDLEWARES cùng HttpProxyMiddleware, rồi điền bốn biến gồm user, password, endpoint và port. Cách này nhanh nhưng logic xoay do file đó quyết định.
Một điểm dễ nhầm: middleware xoay của nhà cung cấp và middleware xoay tự viết không nên bật cùng lúc, vì cả hai cùng ghi vào request.meta['proxy'] và cái chạy sau ghi đè cái trước. Chọn một trong hai.
HttpProxyMiddleware chỉ đọc giá trị request.meta['proxy']. Nó không tự xoay. Muốn mỗi request một IP, phải có thêm một middleware của anh em đặt giá trị đó.
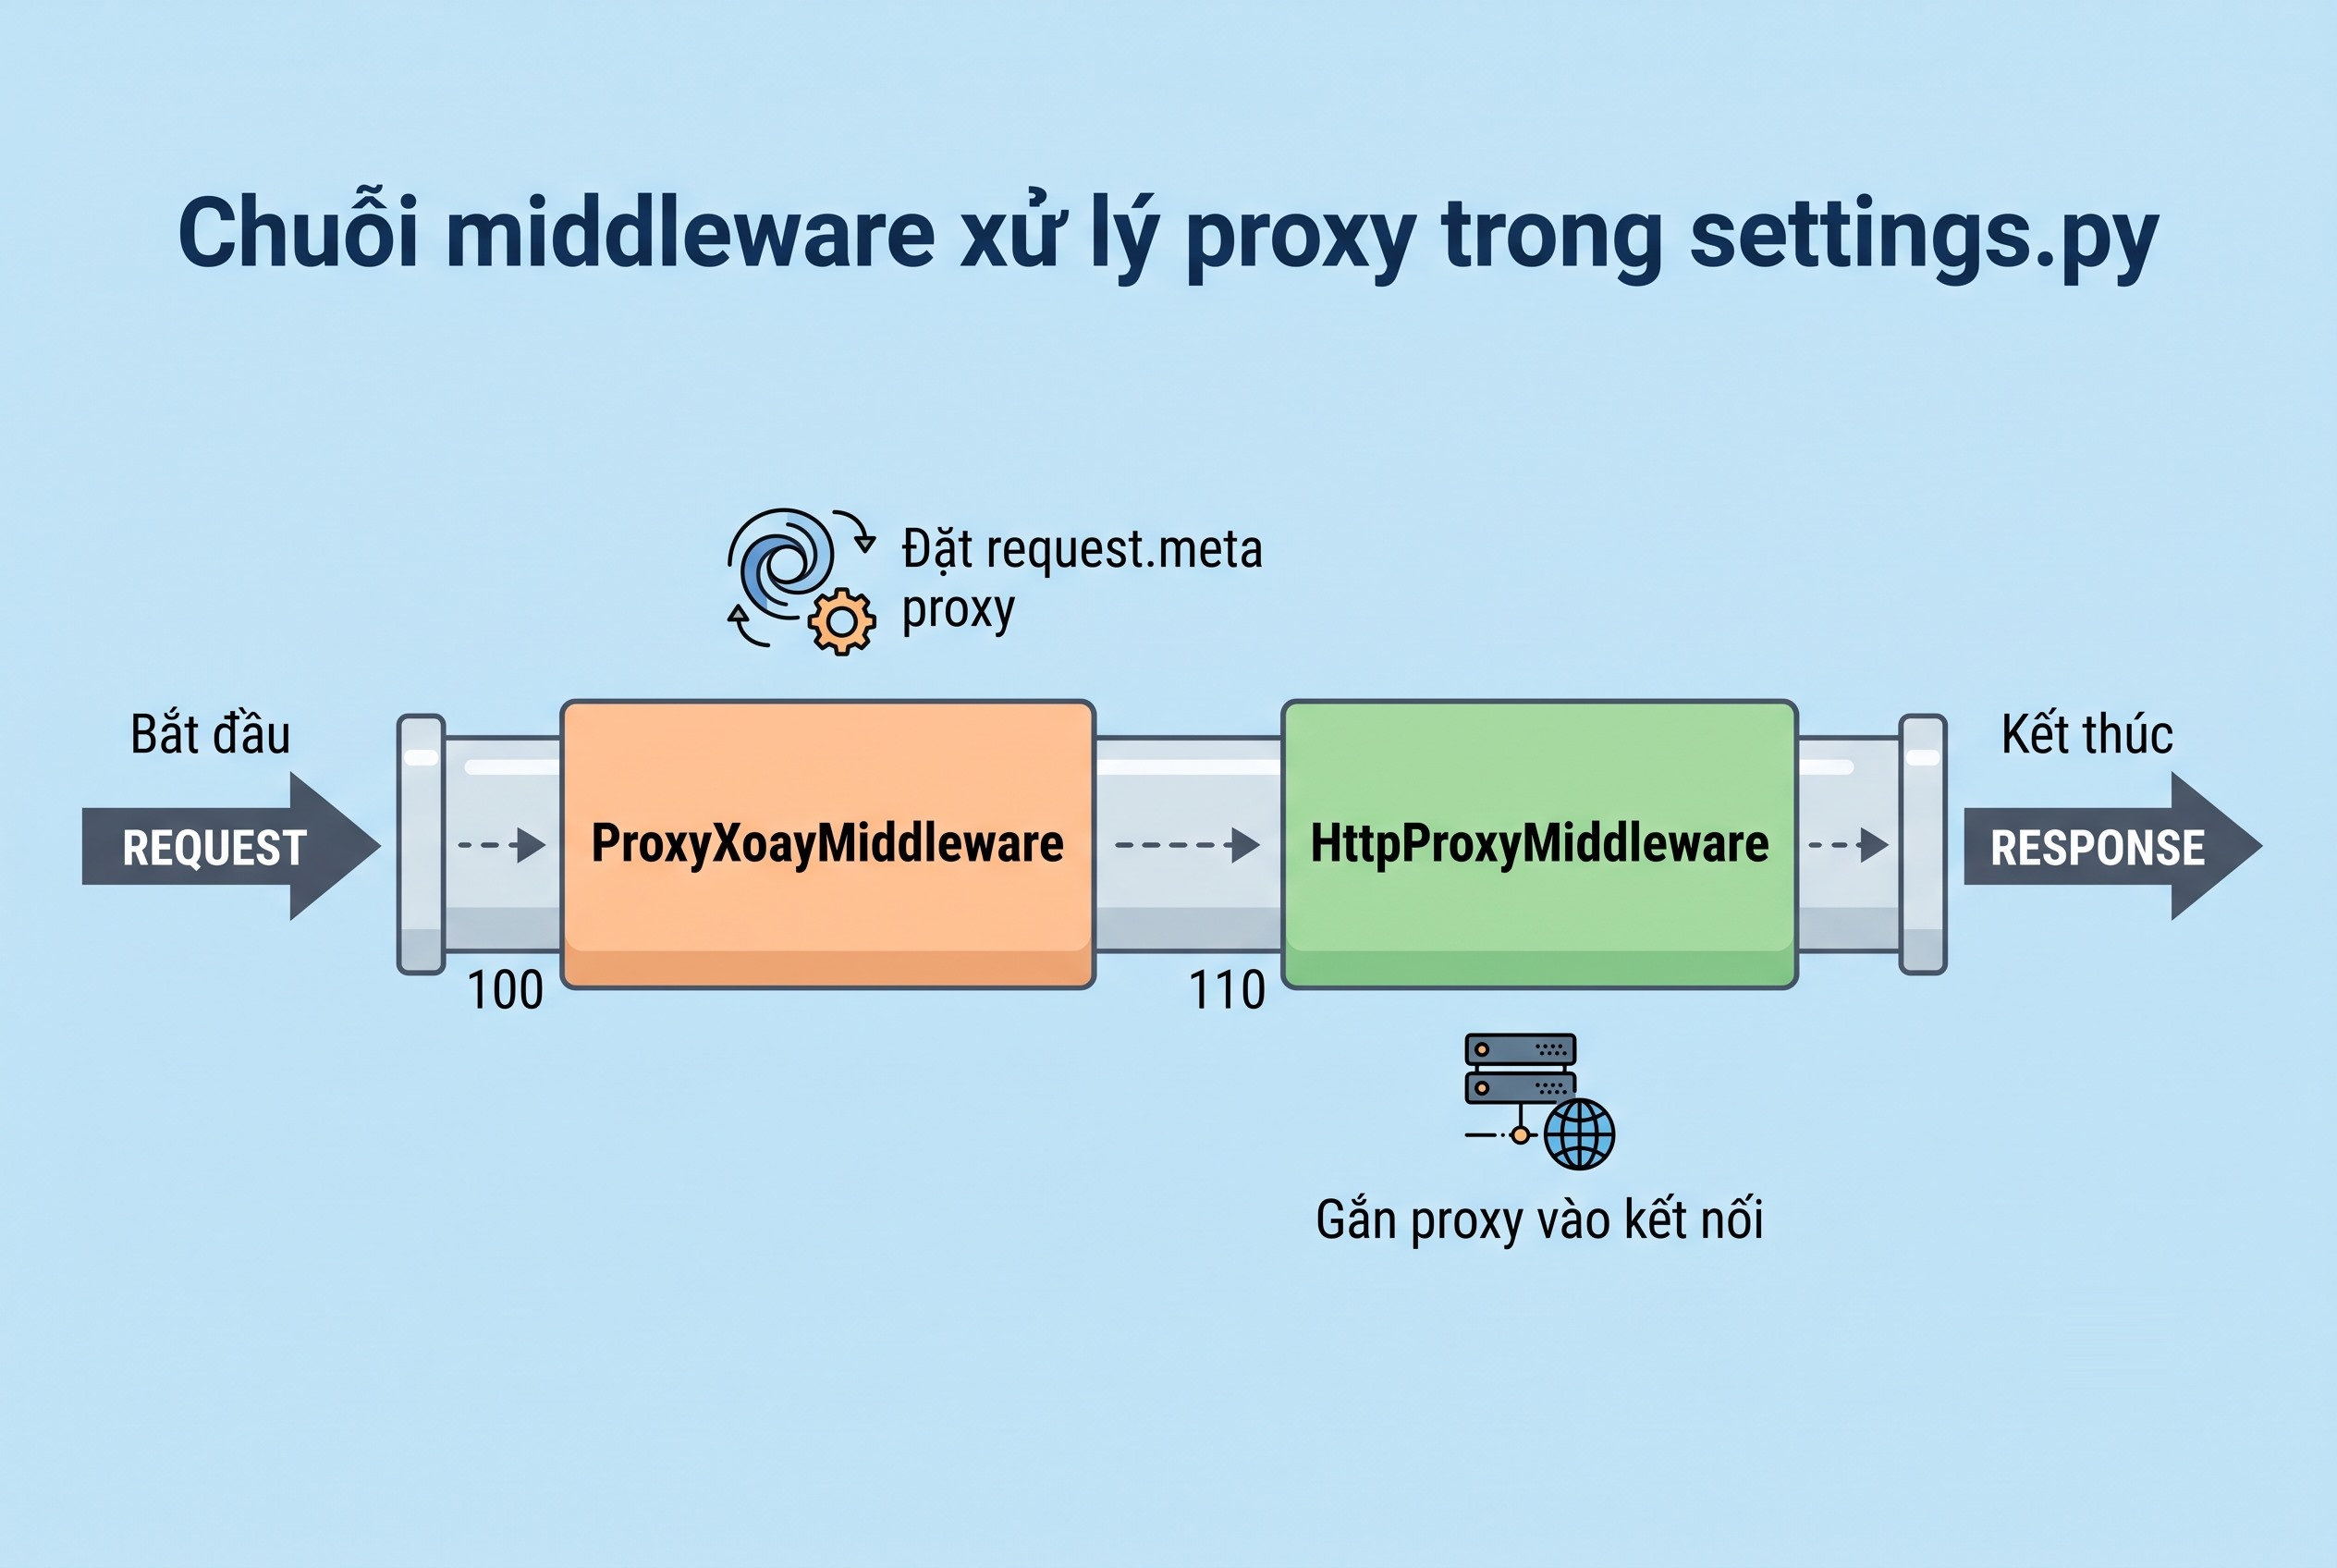
Chuỗi middleware xử lý proxy trong settings.py
Viết middleware xoay proxy Scrapy theo request
Middleware tự viết cho toàn quyền chọn cách xoay, cách xử lý lỗi và cách gắn với danh sách proxy. Đây là cách phổ biến cho crawl quy mô lớn. Nguyên tắc bố trí vòng xoay IP và ngưỡng request cho mỗi IP được nói trong bài rotating proxy là gì.
Lớp middleware với from_crawler và process_request
Hướng dẫn xoay proxy trong Scrapy của Webshare dùng một lớp có phương thức from_crawler để đọc danh sách proxy từ settings, và process_request để chọn một proxy rồi gán vào request.meta cho từng request. Thêm process_exception để đổi proxy và thử lại khi kết nối lỗi.
# myproject/middlewares.pyimport randomclass ProxyXoayMiddleware: def __init__(self, danh_sach): self.danh_sach = danh_sach @classmethod def from_crawler(cls, crawler): return cls(danh_sach=crawler.settings.getlist("PROXY_LIST")) def process_request(self, request, spider): request.meta["proxy"] = random.choice(self.danh_sach) def process_exception(self, request, exception, spider): # doi proxy roi thu lai khi ket noi loi request.meta["proxy"] = random.choice(self.danh_sach) return request
Chọn ngẫu nhiên hay xoay vòng
Chọn ngẫu nhiên bằng random.choice đơn giản và đủ tốt cho danh sách lớn. Xoay vòng theo thứ tự đảm bảo tải rải đều chính xác nhưng cần giữ một chỉ số chung an toàn khi chạy nhiều luồng. Với crawl thường, ngẫu nhiên là lựa chọn hợp lý. Với danh sách nhỏ dưới mười proxy, xoay vòng công bằng hơn vì ngẫu nhiên dễ dồn nhiều request vào cùng một IP trong thời gian ngắn.
Đọc danh sách proxy từ file
Với danh sách dài hàng trăm proxy, để trong settings.py không tiện. Cho middleware đọc từ một file văn bản, mỗi dòng một proxy, đường dẫn khai báo trong settings. Cách này còn cho phép cập nhật danh sách mà không cần sửa mã, chỉ thay file rồi chạy lại job. Cách dựng và quản lý pool proxy cho một job crawl lớn được nói trong bài proxy pool là gì.
Đăng ký middleware trong settings.py
Thêm dòng cho lớp middleware vào DOWNLOADER_MIDDLEWARES với số thứ tự nhỏ hơn HttpProxyMiddleware, và khai báo PROXY_LIST hoặc đường dẫn file. Chạy lại scrapy crawl, mỗi request giờ đi qua một proxy ngẫu nhiên từ danh sách. Xem log ở dòng thống kê cuối job để biết bao nhiêu request thành công, bao nhiêu bị thử lại. Nguồn proxy datacenter và dân cư xoay số lượng lớn để nạp vào PROXY_LIST có tại trang mua proxy.
|
Cách đặt proxy |
Phạm vi |
Hợp khi |
|---|---|---|
|
request.meta trong spider |
Từng request do anh em kiểm soát |
Thử nhanh, một proxy cố định |
|
Biến môi trường http_proxy |
Mọi request, HttpProxyMiddleware tự đọc |
Một proxy cho cả job |
|
Middleware xoay tự viết |
Mỗi request một IP theo logic |
Crawl quy mô lớn, cần phân tán |
|
Middleware của nhà cung cấp |
Theo cấu hình gói proxy |
Muốn dùng nhanh, ít tự code |
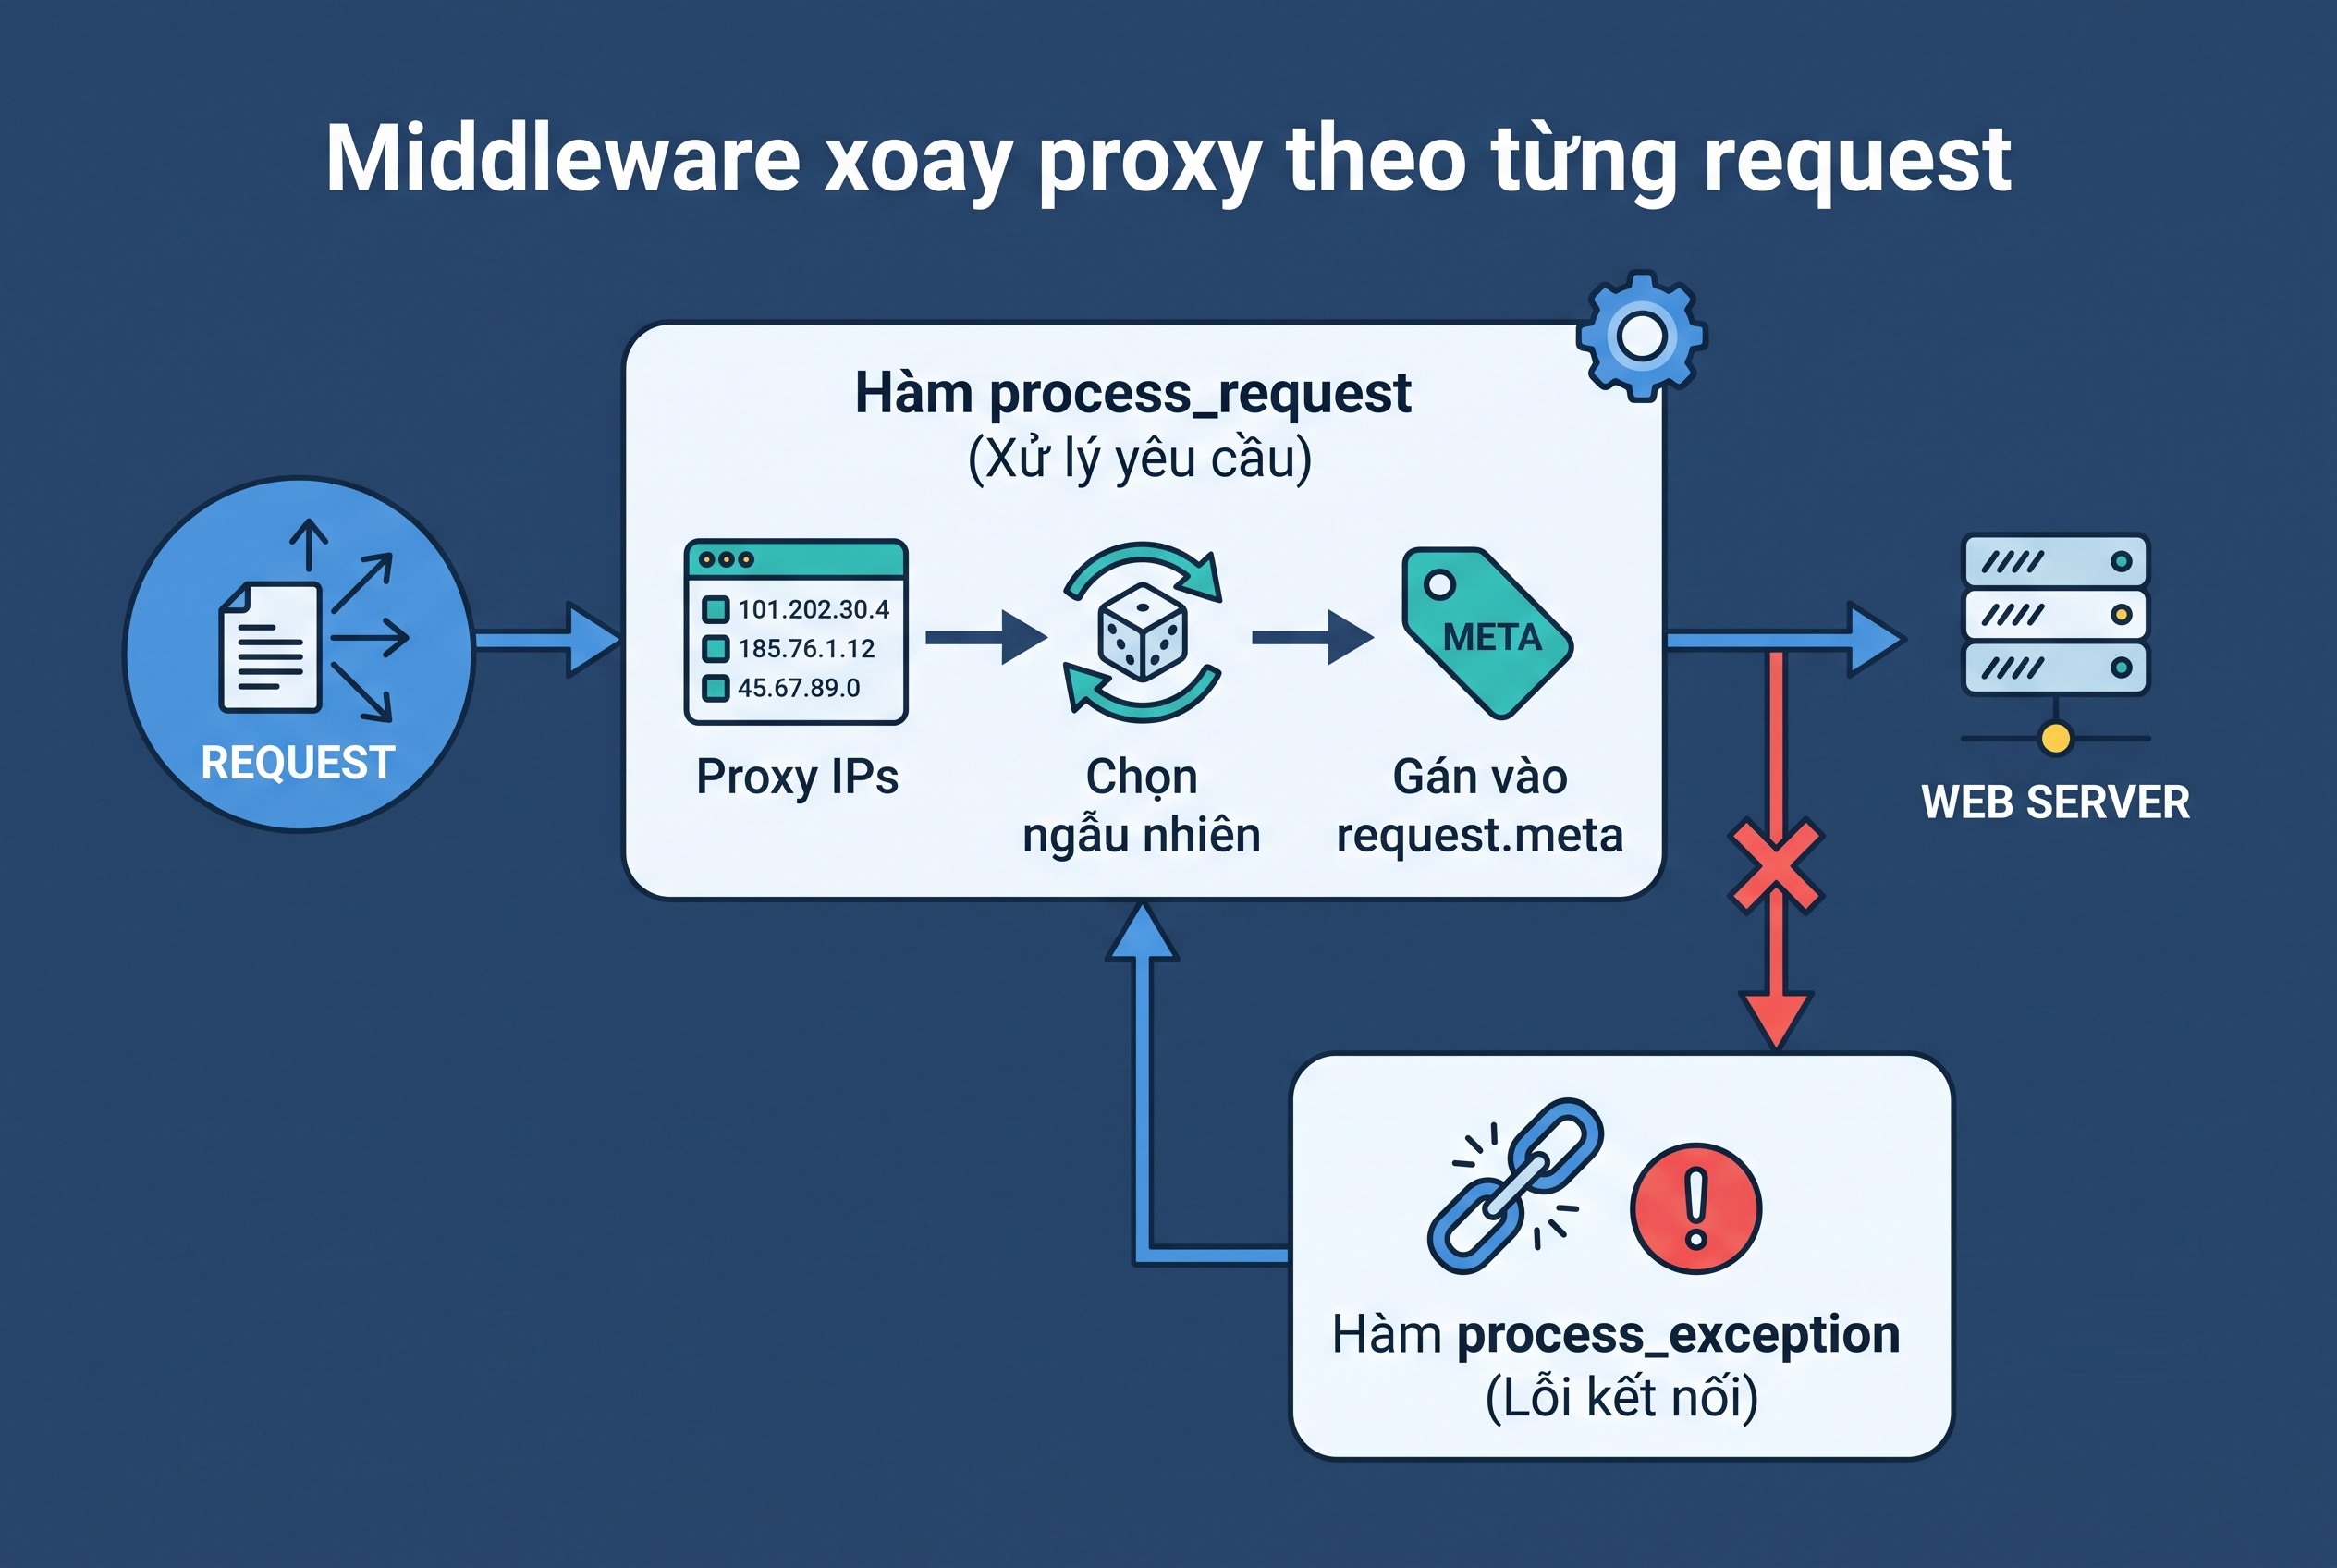
Middleware xoay proxy theo từng request
Xác thực proxy Scrapy và phiên sticky
Proxy có xác thực cần thông tin đăng nhập đi kèm request. Có hai cách nhúng, và một cách giữ một IP cho nhiều request.
Nhúng user và mật khẩu vào URL proxy
Cách gọn nhất là viết chuỗi proxy dạng http kèm username và mật khẩu trước dấu at, rồi tới địa chỉ và cổng. Scrapy tự tách phần đăng nhập và chuyển thành header xác thực. Username và mật khẩu proxy khác với email tài khoản dịch vụ.
Header Proxy-Authorization
Cách thứ hai là để URL proxy không kèm đăng nhập, rồi tự đặt header Proxy-Authorization bằng chuỗi Basic cộng phần user và mật khẩu mã hóa base64. Cách này hữu ích khi cần giữ URL proxy sạch để ghi log mà không lộ mật khẩu.
Đặt header này trong process_request của middleware xoay, ngay sau khi chọn proxy. Nếu mỗi proxy có một cặp đăng nhập khác nhau, lưu danh sách dạng cặp gồm URL và header tương ứng, rồi chọn cả cặp cùng lúc để header luôn khớp proxy vừa chọn.
Phiên sticky qua tham số username
Nhiều cổng proxy dân cư cho giữ một IP trong một khoảng thời gian bằng cách thêm một mã phiên vào username, ví dụ user-session-abc123. Dùng cùng một mã phiên cho các request thuộc cùng một luồng đăng nhập hoặc một chuỗi phân trang cần giữ trạng thái. Cách chọn thời gian giữ IP cho phiên sticky được hướng dẫn trong bài sticky session proxy là gì.
Điều tiết tải: DOWNLOAD_DELAY, AUTOTHROTTLE và proxy Scrapy
Xoay proxy chưa đủ. Vẫn cần giữ nhịp request trên mỗi IP đủ giống người thật, nếu không từng IP vẫn bị đốt nhanh.
CONCURRENT_REQUESTS và CONCURRENT_REQUESTS_PER_IP
CONCURRENT_REQUESTS giới hạn tổng số request song song của cả job. CONCURRENT_REQUESTS_PER_IP giới hạn số request song song tới cùng một IP đích, và khi đặt lớn hơn 0 thì nó vô hiệu hóa giới hạn theo tên miền. Giữ giá trị per IP ở mức 2 đến 5 cho phần lớn site.
DOWNLOAD_DELAY và AUTOTHROTTLE
DOWNLOAD_DELAY chèn một khoảng nghỉ cố định giữa các request tới cùng một site. AUTOTHROTTLE tự điều chỉnh khoảng nghỉ theo tốc độ phản hồi của máy chủ: máy chủ chậm thì Scrapy nghỉ dài hơn. Bật AutoThrottle giúp job vừa nhanh khi được phép, vừa lịch sự khi site quá tải.
Lưu ý một điểm dễ hiểu nhầm: DOWNLOAD_DELAY tính theo tên miền đích, không tính theo IP proxy. Khi xoay proxy, nhiều IP cùng gọi một site trong khoảng delay đó, nên tần suất thực tế lên site cao hơn con số delay gợi ý. Điều chỉnh CONCURRENT_REQUESTS_PER_IP và số lượng proxy để tổng tải lên site nằm trong ngưỡng an toàn.
# settings.pyCONCURRENT_REQUESTS = 16CONCURRENT_REQUESTS_PER_IP = 2DOWNLOAD_DELAY = 1.5AUTOTHROTTLE_ENABLED = TrueAUTOTHROTTLE_START_DELAY = 1AUTOTHROTTLE_MAX_DELAY = 20AUTOTHROTTLE_TARGET_CONCURRENCY = 2.0ROBOTSTXT_OBEY = True
RETRY_TIMES và phát hiện bị chặn
Đặt RETRY_ENABLED bật và RETRY_TIMES khoảng 5 để Scrapy tự thử lại khi gặp lỗi mạng hoặc mã 5xx. Với mã 403 và 429, thêm chúng vào danh sách mã cần thử lại và để process_exception hoặc một middleware đổi proxy trước khi thử lại, thay vì thử lại cùng IP đã bị chặn.
Có trường hợp site trả về mã 200 nhưng nội dung là trang chặn hoặc trang xác minh. Scrapy không tự coi đó là lỗi. Viết một middleware xử lý phản hồi, kiểm tra dấu hiệu trong nội dung như từ khóa xác minh hoặc độ dài bất thường, rồi đánh dấu request để thử lại với proxy khác.
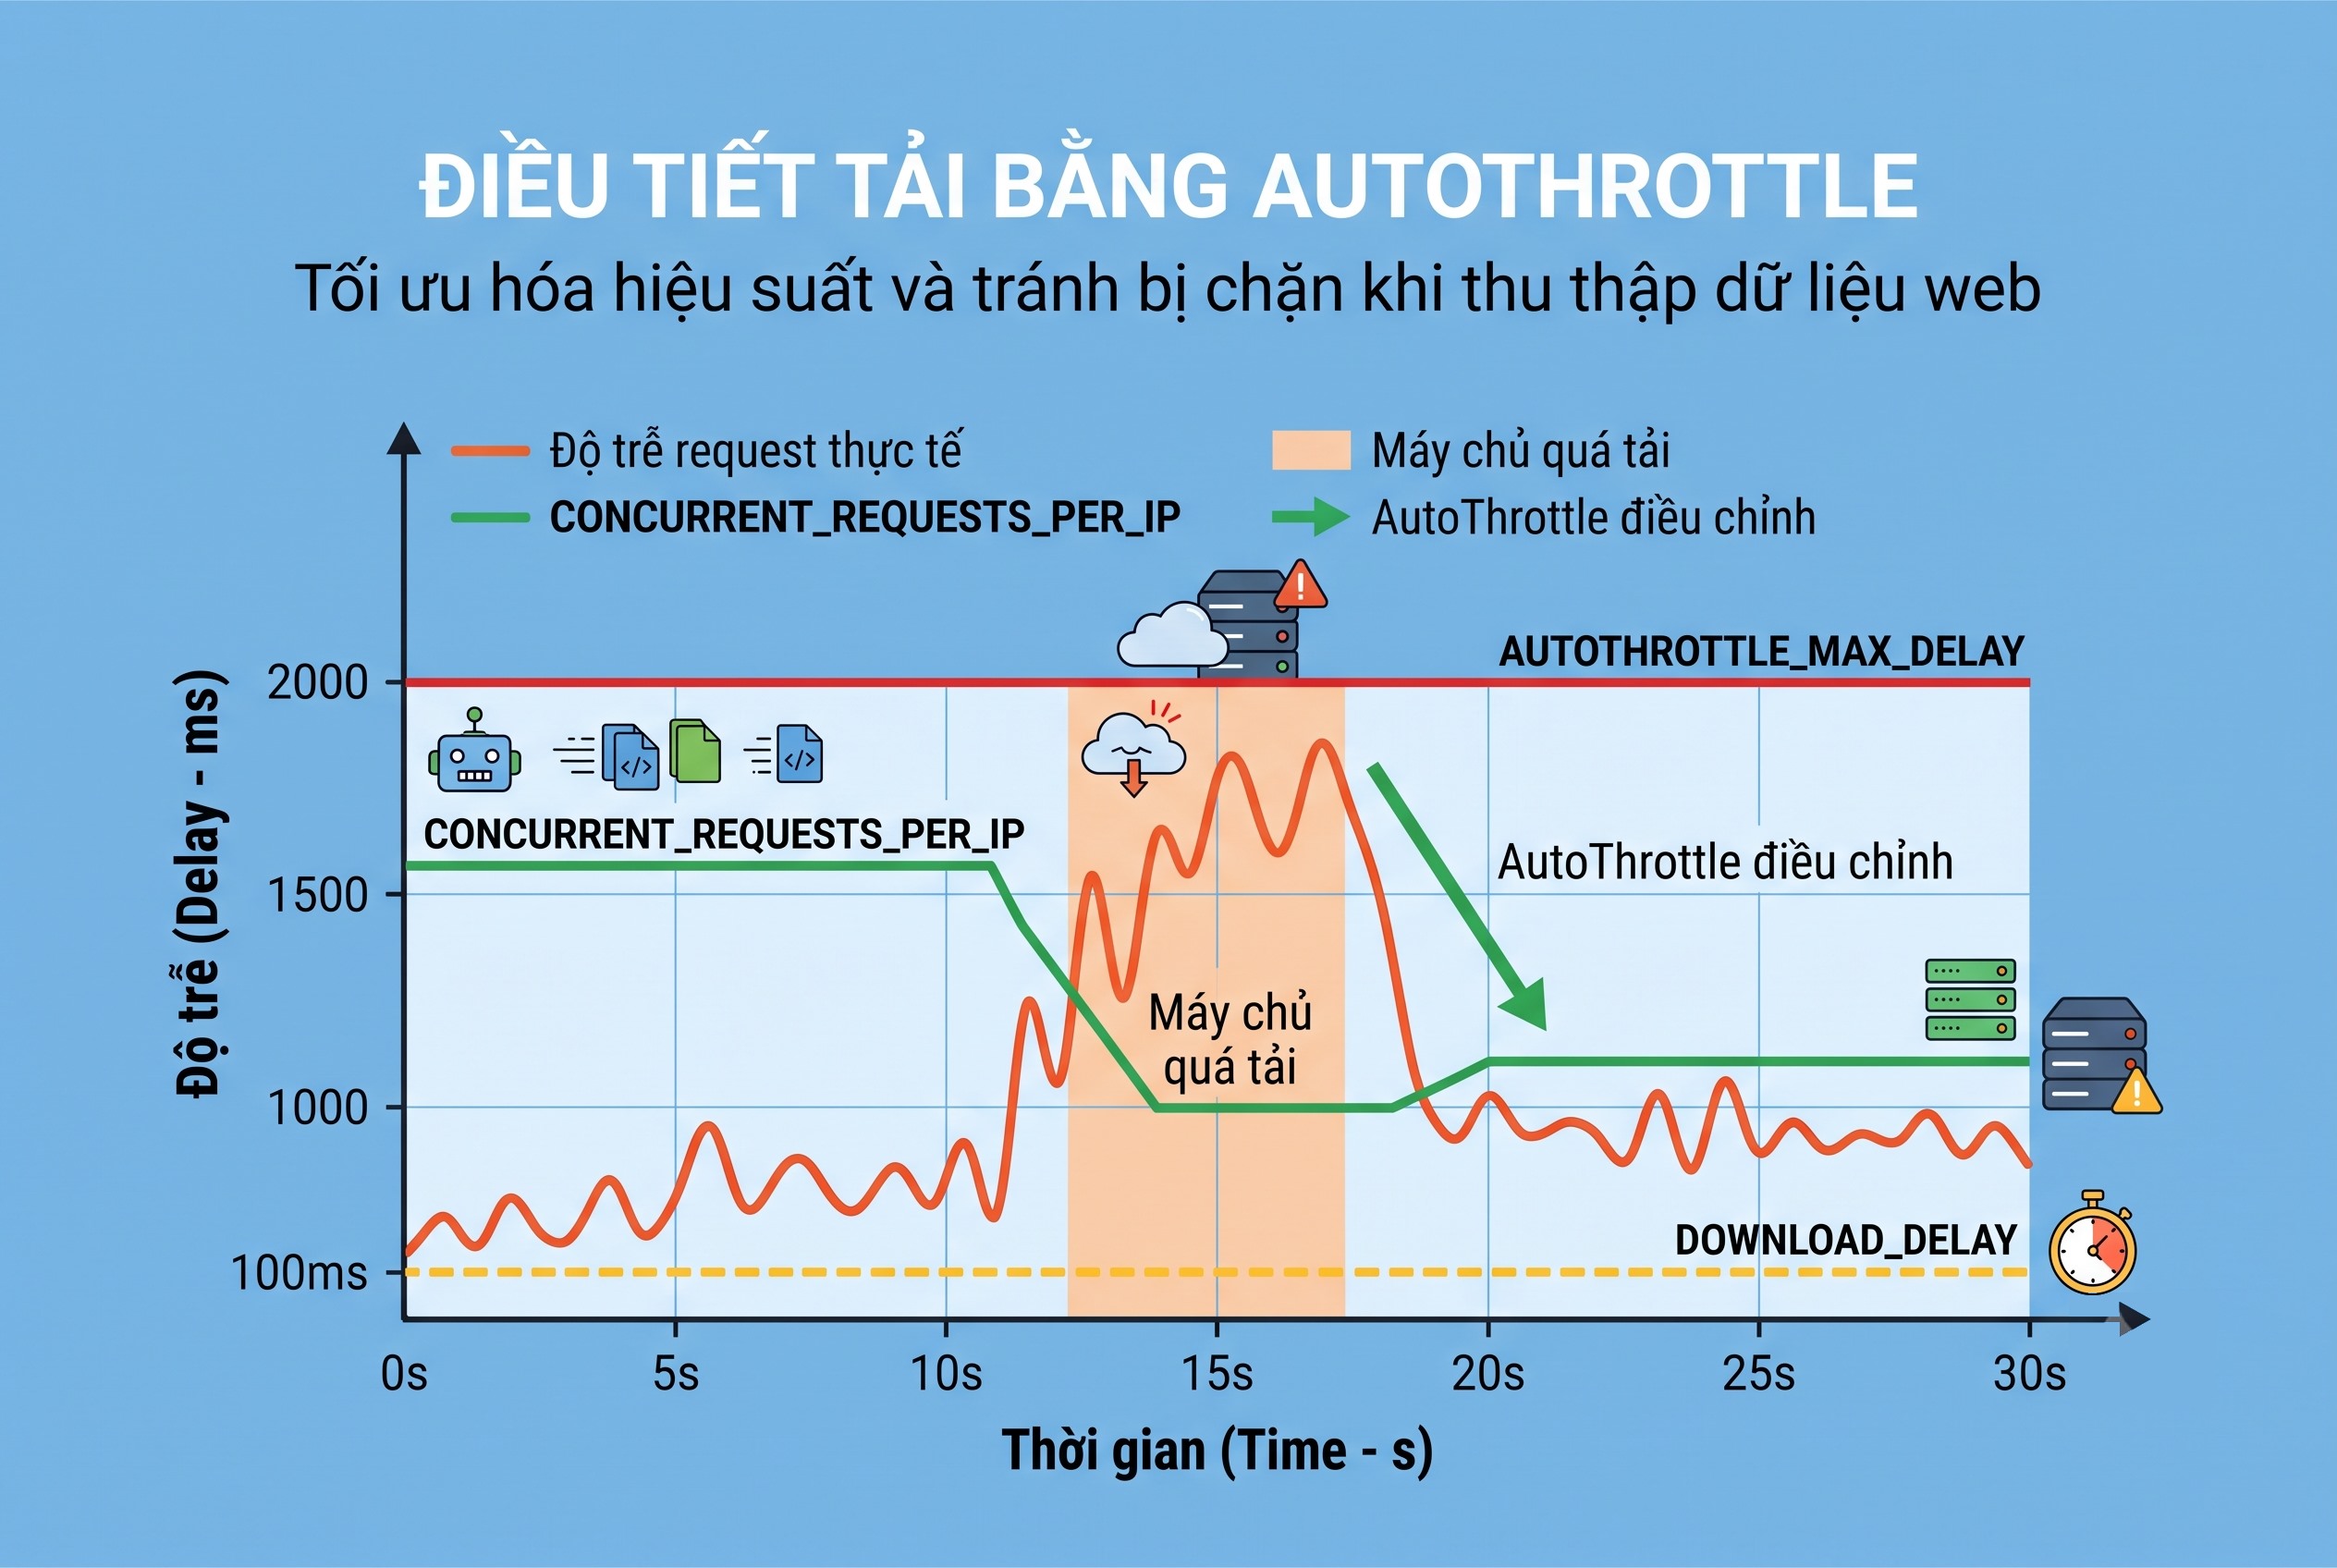
Điều tiết tải bằng AutoThrottle
Kiểm tra proxy Scrapy hoạt động và ghi log
Cấu hình xong phải xác nhận request thực sự đi qua proxy, và theo dõi proxy nào đang yếu để loại.
Ghi lại IP thoát ra của mỗi request
Cách nhanh nhất để kiểm tra là cho spider gọi thử một trang trả về IP người gọi, rồi in ra IP thấy được. Nếu IP đó khớp proxy chứ không phải máy chủ chạy Scrapy, cấu hình đã đúng. Với job dài, ghi IP thoát ra kèm mã trạng thái vào log để về sau đối chiếu.
Đếm tỉ lệ thành công theo từng proxy
Trong middleware xử lý phản hồi, tăng một bộ đếm cho cặp proxy và mã trạng thái. Sau vài nghìn request, bảng đếm cho thấy proxy nào trả 403 hoặc 429 nhiều, proxy nào chậm. Đó là căn cứ để loại proxy yếu khỏi danh sách.
Loại proxy chết khỏi danh sách khi đang chạy
Giữ danh sách proxy trong một cấu trúc có thể sửa khi đang chạy. Khi một proxy vượt ngưỡng lỗi, tạm bỏ nó khỏi vòng chọn trong một khoảng thời gian rồi đưa lại. Cách này giữ job không dừng vì vài IP hỏng, và cũng không đốt mãi một IP đã xuống sức.
Gói scrapy-rotating-proxies làm sẵn việc này: nó theo dõi proxy nào còn sống, tạm nghỉ proxy bị chặn, và thử lại request qua proxy khác. Nếu không muốn tự viết phần quản lý trạng thái, dùng gói đó và chỉ cần khai báo danh sách proxy cùng vài tham số về số lần thử lại.
Lỗi thường gặp khi dùng proxy Scrapy
Vài lỗi khiến proxy không có tác dụng hoặc job bị chặn sớm.
Quên bật HttpProxyMiddleware hoặc sai thứ tự
Nếu HttpProxyMiddleware bị tắt, giá trị request.meta['proxy'] không được dùng và request đi thẳng. Nếu middleware xoay có số thứ tự lớn hơn HttpProxyMiddleware, nó chạy sau và việc đặt proxy trở nên vô nghĩa. Kiểm tra cả hai khi proxy có vẻ không ăn.
Nhầm email tài khoản với đăng nhập proxy
Username và mật khẩu proxy khác với email và mật khẩu tài khoản dịch vụ. Lấy đúng cặp đăng nhập proxy ở trang danh sách proxy. Lỗi xác thực proxy lặp lại gần như luôn là do nhầm cặp này.
Xoay proxy mà không xoay User-Agent
Đổi IP mỗi request nhưng giữ nguyên một User-Agent cho mọi request vẫn để lộ mẫu bot. Thêm một middleware xoay User-Agent theo một danh sách trình duyệt thật, chạy song song với middleware xoay proxy.
Bỏ qua robots.txt và giới hạn tần suất
Đặt ROBOTSTXT_OBEY thành False để crawl các đường dẫn bị chặn trong robots.txt là lựa chọn có rủi ro pháp lý và đạo đức, tùy quy định từng nơi và điều khoản của site. Cân nhắc kỹ, và luôn giữ tần suất thấp để không gây tải nặng cho máy chủ đích.
Dùng chung một mã phiên sticky cho mọi request
Nếu để mọi request đi qua cùng một mã phiên sticky, tất cả cùng thoát ra một IP và lợi ích của việc xoay biến mất. Mã phiên chỉ nên cố định trong phạm vi một luồng cần giữ trạng thái, ví dụ một chuỗi đăng nhập rồi lấy dữ liệu. Các request độc lập thì để xoay tự do.
Checklist rút gọn
-
HttpProxyMiddleware bật, middleware xoay có số thứ tự nhỏ hơn.
-
PROXY_LIST chứa proxy còn hạn, đúng định dạng http kèm đăng nhập.
-
process_exception đổi proxy rồi thử lại khi kết nối lỗi.
-
Bật AutoThrottle, giữ CONCURRENT_REQUESTS_PER_IP ở 2 đến 5.
-
Xoay User-Agent song song với xoay proxy.
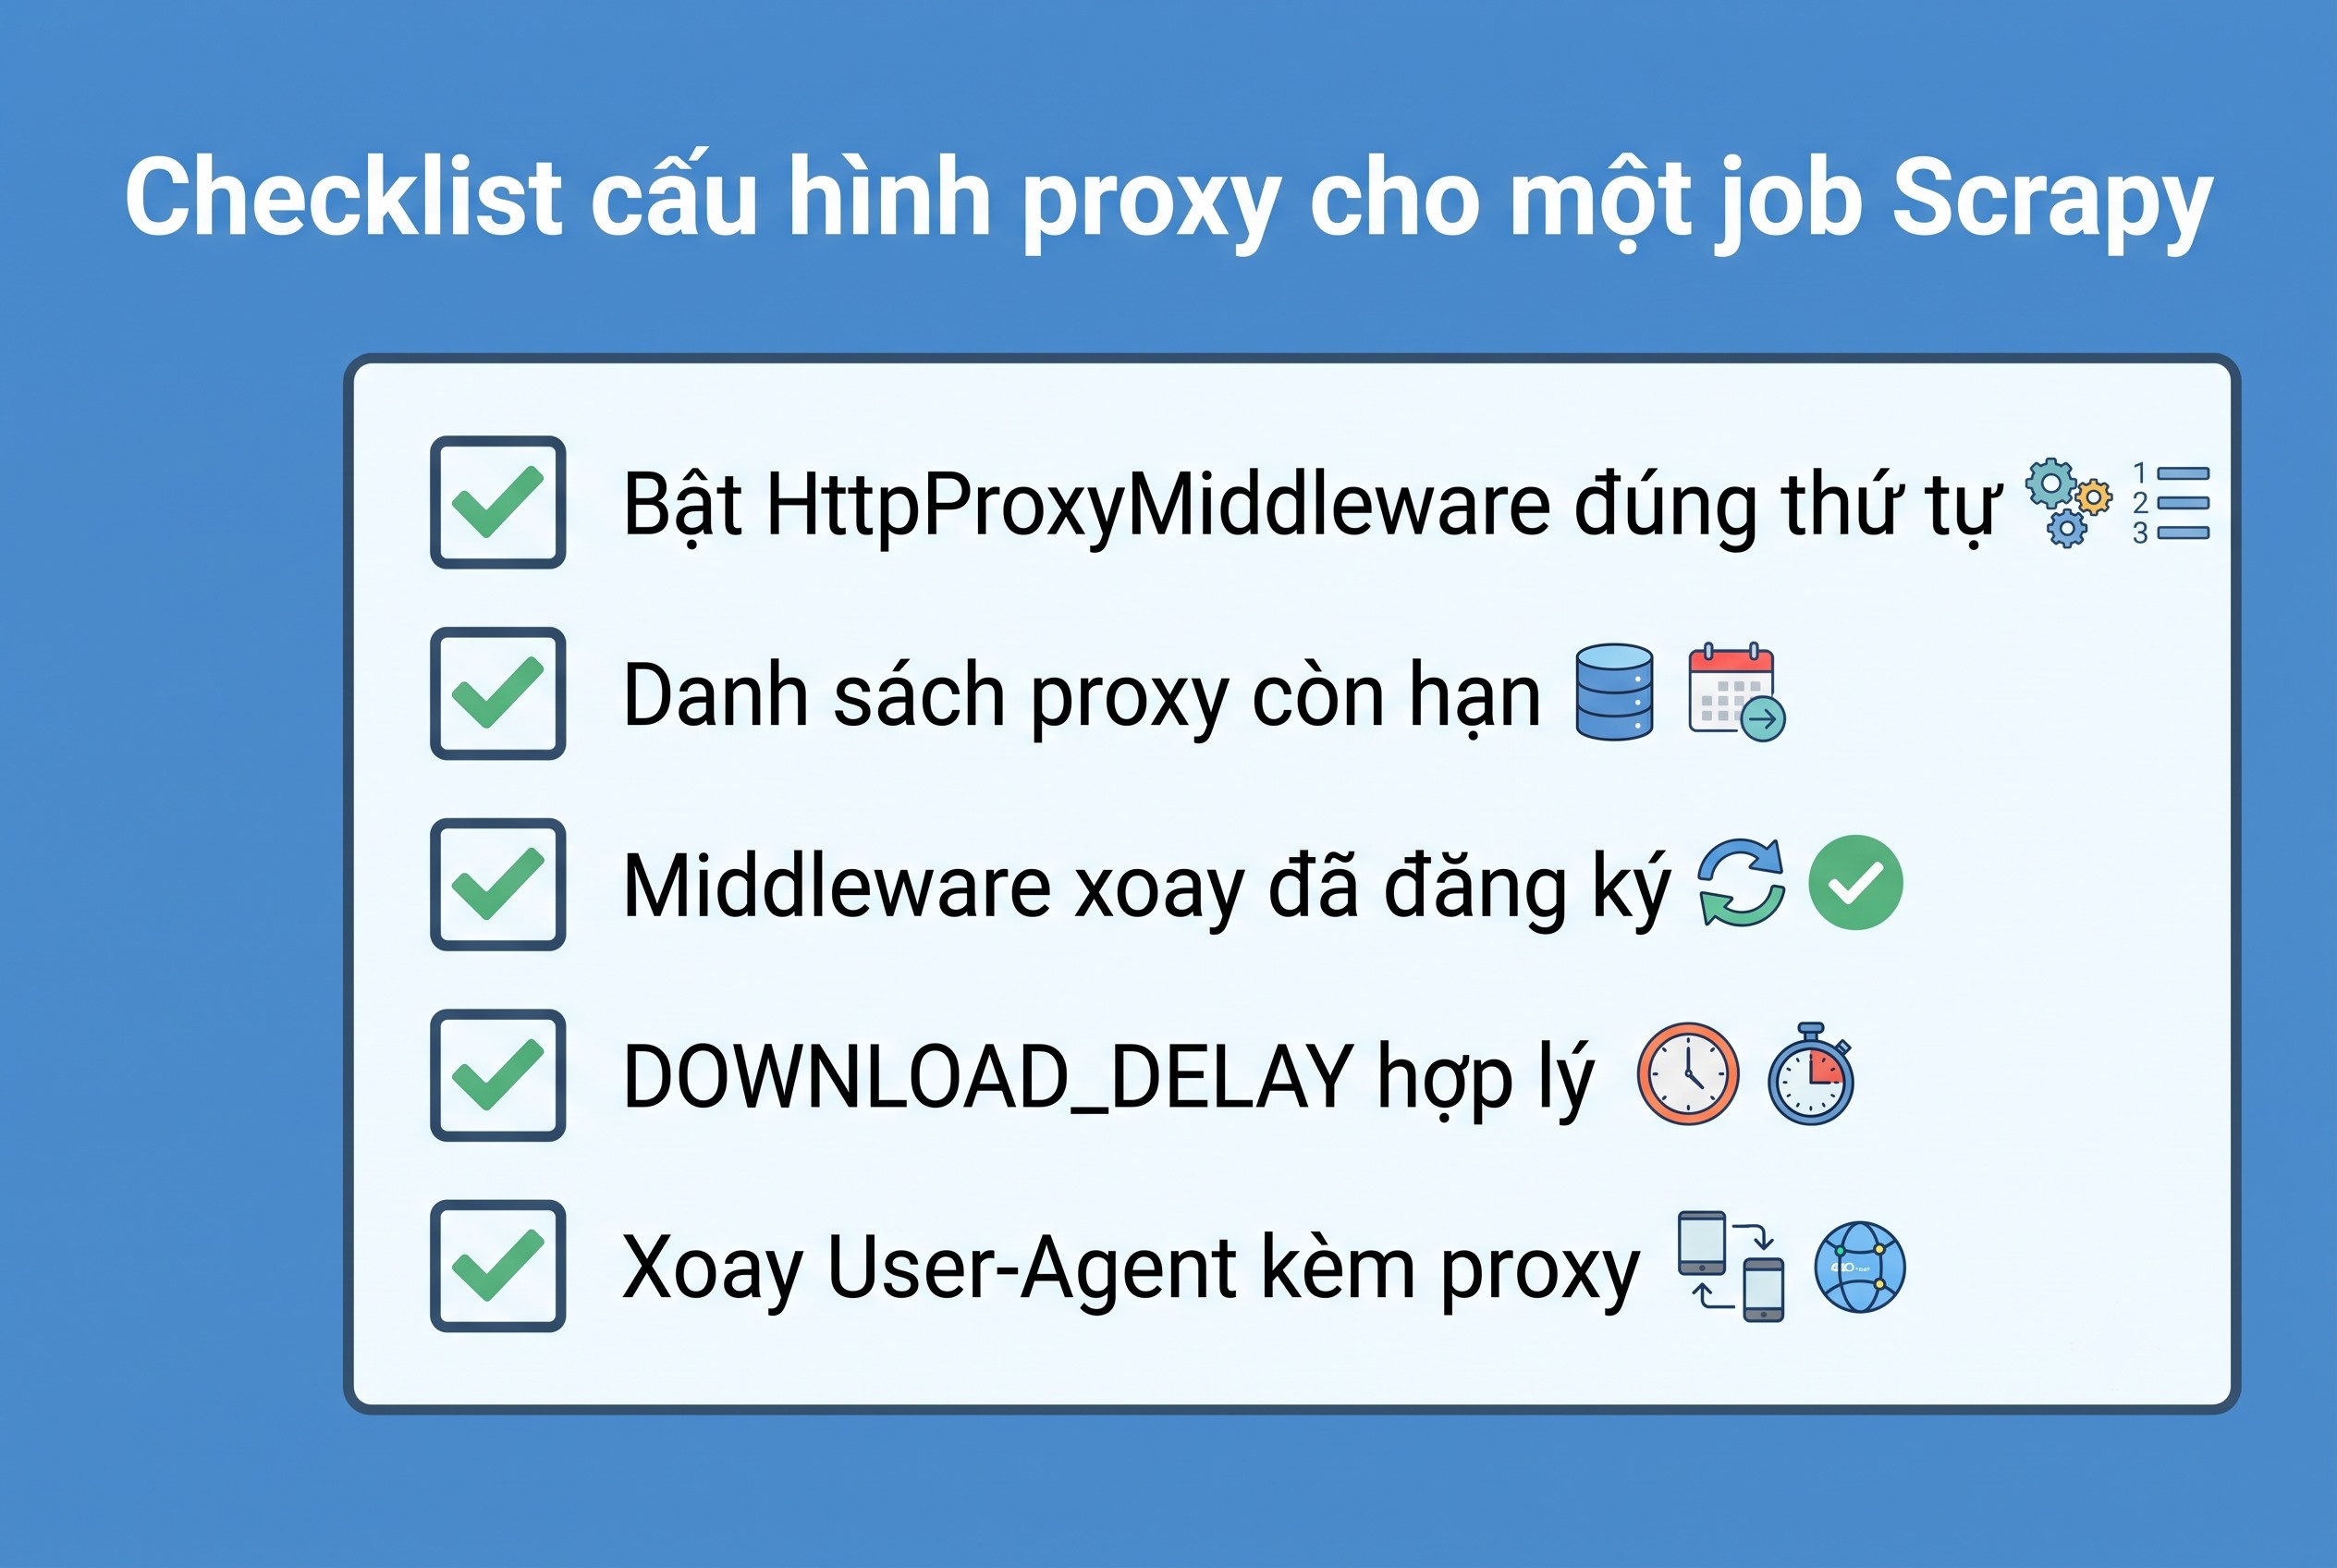
Checklist cấu hình proxy cho một job Scrapy
Proxy Scrapy gói gọn trong việc để HttpProxyMiddleware bật, viết một middleware xoay đặt request.meta['proxy'] với số thứ tự nhỏ hơn, nhúng đăng nhập vào URL proxy, và bật AutoThrottle để giữ nhịp request giống người. Với job lớn, xoay proxy và xoay User-Agent phải đi cùng nhau. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam hỗ trợ anh em chọn số lượng và loại proxy khớp với quy mô job Scrapy.


