
Xây dựng web crawler Python chạy lại không mất dữ liệu
Xây dựng web crawler Python không khó ở phần tải trang mà khó ở chỗ chạy lâu vẫn đúng: không tải trùng, không bỏ sót, tắt máy giữa chừng thì chạy tiếp được. ProxyVN chia sẻ một crawler khoảng 150 dòng, lưu trạng thái bằng SQLite, tôn trọng robots.txt và tự lùi lại khi gặp 429. Toàn bộ code đã được chạy thử trên một website giả lập ngay trên máy.
Xây dựng web crawler Python: mục tiêu và phạm vi của bài
Crawler trong bài này dành cho việc thu thập trang trên một website mà anh em được phép truy cập: website của chính công ty, website khách hàng thuê kiểm tra, hoặc nguồn dữ liệu công khai có điều khoản cho phép. Mục tiêu là lấy danh sách URL hợp lệ kèm tiêu đề, đủ để làm kiểm kê nội dung, tìm trang lỗi hay chuẩn bị dữ liệu cho bước phân tích sau.
Mình cố ý giữ phạm vi hẹp. Crawler chỉ đi trong một tên miền, không chạy JavaScript, không đăng nhập. Ba việc đó mỗi việc đáng một bài riêng, gộp vào đây chỉ làm code dài mà khó hiểu cái lõi.
Những thứ một crawler chạy lâu phải có
Một script vài dòng requests.get trong vòng lặp chạy được với 20 trang. Tới 20.000 trang thì các vấn đề khác bắt đầu lộ ra. Danh sách dưới đây là những phần mình coi là bắt buộc trước khi cho crawler chạy qua đêm.
- Frontier: hàng đợi URL chờ tải, có thứ tự ưu tiên rõ ràng.
- Visited set: tập URL đã biết, để không tải lại một trang hai lần.
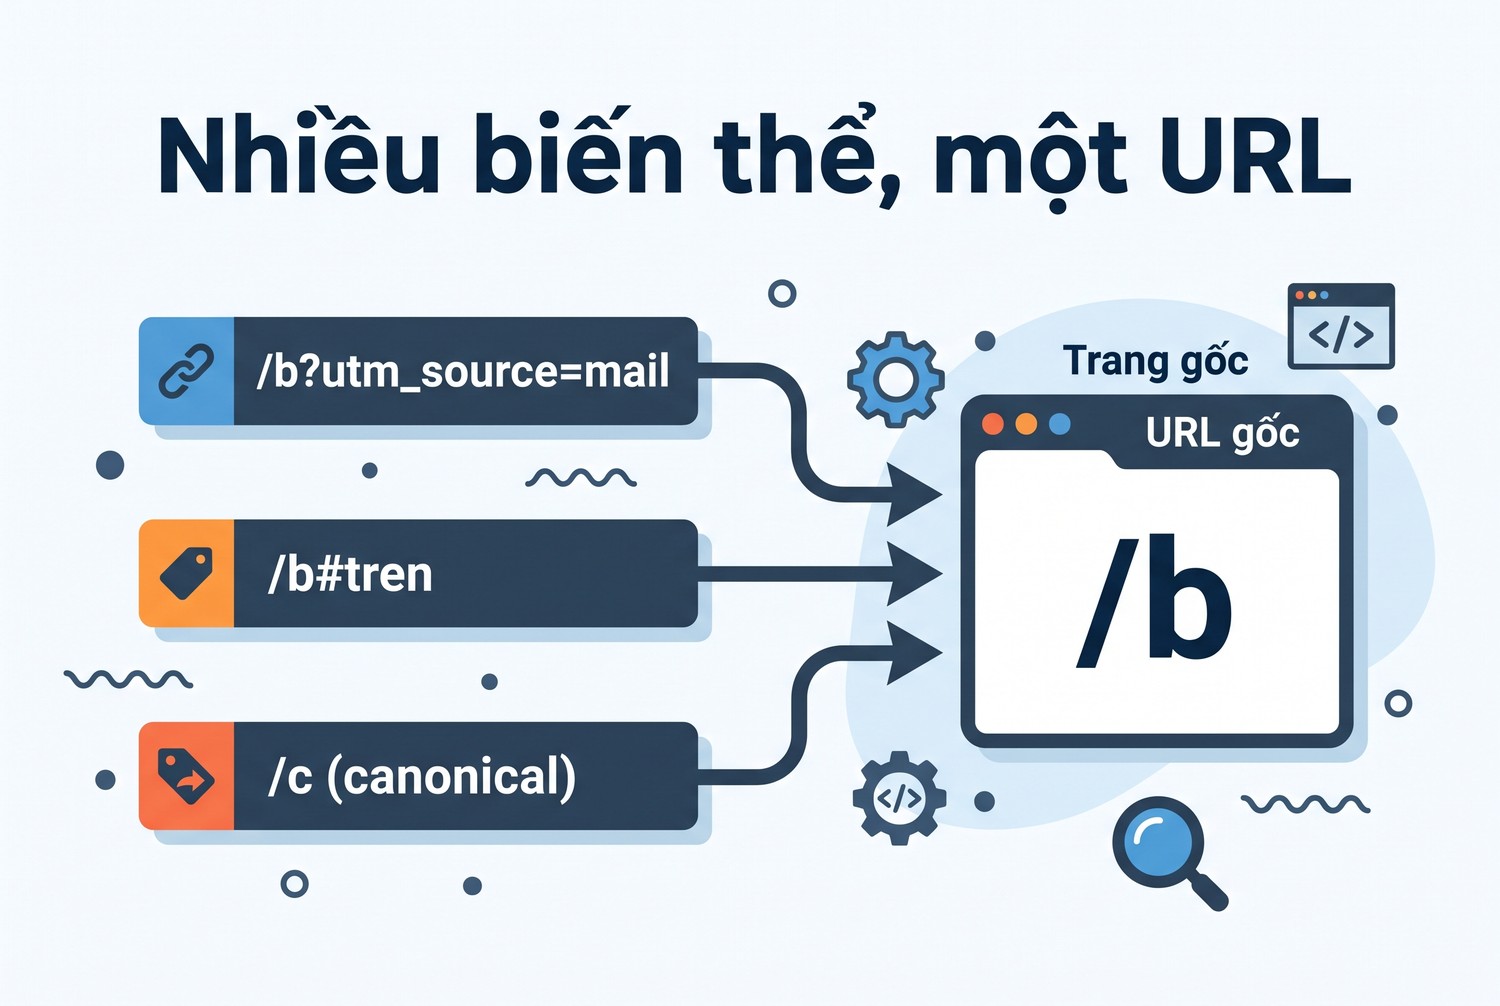
- Chuẩn hóa URL: gộp các biến thể như có dấu # hay có tham số utm về một URL.
- Đọc canonical: nhận ra trang in, trang lọc là bản sao của trang khác.
- Lịch request: giãn cách giữa các lần gọi, tôn trọng Crawl-delay nếu có.
- Xử lý lỗi: phân biệt lỗi tạm thời để thử lại với lỗi cố định để bỏ qua.
- Checkpoint: trạng thái nằm trên đĩa, tắt chương trình rồi chạy lại vẫn tiếp tục đúng chỗ.
Điều crawler này không làm
Code không vượt CAPTCHA, không giả dạng trình duyệt để qua lớp chống bot, cũng không đổi IP liên tục để né giới hạn tốc độ của website. Nếu website trả 429 hay chặn, crawler chậm lại hoặc dừng. Với dự án cần dữ liệu từ website bên thứ ba, anh em đọc điều khoản sử dụng và hỏi chủ website trước, nhất là khi dữ liệu có thông tin cá nhân.
Thiết kế frontier và visited set khi xây dựng web crawler Python
Phần thiết kế quyết định crawler có chạy lại được hay không. Mình gộp frontier và visited set vào cùng một bảng SQLite thay vì giữ hai cấu trúc trong bộ nhớ. Mỗi URL là một dòng, cột status cho biết nó đang ở trạng thái nào.
Một bảng thay cho hai cấu trúc
Cách phổ biến trong các bài hướng dẫn là dùng deque cho frontier và set cho visited. Nhanh, gọn, nhưng nằm trong RAM. Chương trình bị tắt là mất sạch, chạy lại phải đi từ trang chủ, tải lại hàng nghìn trang đã có.
Với bảng SQLite, khóa chính là URL đã chuẩn hóa. Lệnh INSERT OR IGNORE vừa là thao tác thêm vào frontier vừa là phép kiểm tra visited: URL đã có thì bỏ qua, chưa có thì thêm với trạng thái queued. Mỗi lần tải xong một trang, crawler cập nhật dòng đó và commit ngay.
Trạng thái |
Ý nghĩa |
Khi chạy lại |
|---|---|---|
queued |
Đang chờ tải |
Được lấy ra tiếp |
fetching |
Đang tải dở |
Trả về queued |
done |
Đã tải xong |
Bỏ qua |
failed |
Hết số lần thử |
Bỏ qua, xem lại bằng tay |
blocked_robots |
Bị robots.txt chặn |
Bỏ qua |
Dòng fetching là chi tiết hay bị quên. Nếu chương trình chết đúng lúc đang tải một trang, dòng đó kẹt ở fetching mãi mãi. Khi khởi động, crawler chạy một lệnh UPDATE đưa toàn bộ dòng fetching về queued, nên không trang nào bị bỏ rơi.
Vì sao chọn SQLite cho checkpoint
Có ba lựa chọn hay được nhắc tới: file JSON, Redis và SQLite. File JSON phải ghi lại toàn bộ mỗi lần lưu, khi danh sách lên vài chục nghìn URL thì mỗi lần ghi mất cả giây, và nếu máy tắt đúng lúc ghi thì file hỏng luôn. Redis nhanh và hợp với nhiều máy cùng crawl, nhưng phải cài và vận hành thêm một dịch vụ.
SQLite nằm sẵn trong Python, dữ liệu là một file duy nhất, ghi theo giao dịch nên không bị hỏng nửa chừng. Với một crawler chạy trên một máy, giãn cách cỡ một giây mỗi request, SQLite dư sức. Khi nào cần nhiều máy cùng lấy từ một hàng đợi, lúc đó mới đáng chuyển sang Redis hay một hàng đợi chuyên dụng.
Một lợi ích ít được nói tới: anh em mở file crawl.db bằng bất kỳ công cụ SQLite nào để xem, sửa, đếm. Muốn biết còn bao nhiêu URL chờ, chỉ cần một câu SELECT COUNT. Muốn bỏ một nhánh không cần thiết, một câu DELETE với điều kiện LIKE là xong, không phải sửa code.
Thứ tự lấy URL ra khỏi frontier
Truy vấn lấy URL kế tiếp sắp theo độ sâu trước, rồi theo thứ tự thêm vào. Kết quả là crawler đi theo chiều rộng: hết các trang cách trang chủ một bước rồi mới tới trang cách hai bước. Với website lớn bị giới hạn số trang, cách này cho tập kết quả cân đối hơn là lao sâu vào một nhánh danh mục.
Cột next_at cho phép hoãn một URL tới thời điểm nhất định. Trang trả 429 kèm Retry-After được đặt next_at bằng thời gian hiện tại cộng số giây chờ. Truy vấn chỉ lấy URL có next_at nhỏ hơn hiện tại, nên URL bị hoãn tự quay lại khi tới giờ mà không cần thêm luồng hẹn giờ nào.
Chuẩn hóa URL và canonical khi xây dựng web crawler Python
Không chuẩn hóa URL là cách nhanh nhất để một website 500 trang biến thành 5.000 URL trong hàng đợi. Cùng một trang có thể xuất hiện với dấu # khác nhau, tham số utm khác nhau, chữ hoa chữ thường ở tên miền, hay cổng mặc định viết rõ ra. Crawler phải gộp chúng về một chuỗi duy nhất trước khi đưa vào bảng.
Hàm normalize trong code
Hàm normalize trong code dưới làm năm việc. Nó cắt phần fragment sau dấu # bằng urldefrag, đưa scheme và tên miền về chữ thường, bỏ cổng 80 với http và 443 với https, thêm dấu / khi đường dẫn rỗng. Cuối cùng nó lọc bỏ các tham số theo dõi như utm_source, fbclid, gclid.
Mình không sắp xếp lại thứ tự tham số và không xóa tham số lạ. Lý do là nhiều website dùng tham số để chọn nội dung thật, ví dụ ?page=2 hay ?id=15. Xóa nhầm một tham số như vậy là mất cả một nhóm trang. Danh sách tham số cần bỏ nên được mở rộng theo từng website sau khi xem dữ liệu thật.
Những biến thể URL code chưa gộp
Hàm normalize cố tình bảo thủ, nên vẫn còn vài loại biến thể nó để nguyên. Thứ nhất là dấu / ở cuối: /san-pham và /san-pham/ có thể là cùng một trang hoặc hai trang khác nhau, tùy cách website cấu hình. Thứ hai là www và không www, http và https. Thứ ba là chữ hoa chữ thường trong đường dẫn, vì máy chủ Linux phân biệt chữ hoa còn máy chủ Windows thường thì không.
Cách xử lý an toàn là chạy thử vài trăm trang, rồi đếm các cặp URL chỉ khác nhau ở những điểm trên. Nếu cặp nào cũng trả cùng tiêu đề và cùng canonical, thêm quy tắc gộp vào normalize. Đừng thêm quy tắc chỉ vì một bài hướng dẫn bảo vậy, vì mỗi website có cách đặt URL riêng.
Mã phiên trong URL, kiểu ;jsessionid= hay ?sid=, là loại nguy hiểm nhất. Mỗi lần tải lại trang, website sinh mã mới và crawler thấy một URL mới. Gặp loại này, thêm tên tham số vào DROP_PARAMS ngay, nếu không hàng đợi sẽ phình không có điểm dừng.
Đọc thẻ canonical
Thẻ link rel="canonical" là cách chủ website nói trang này là bản sao, bản gốc nằm ở URL khác. Theo hướng dẫn của Google về URL chuẩn, đây là tín hiệu để gộp các trang trùng nội dung. Crawler lưu canonical của từng trang vào cột riêng và thêm URL canonical vào frontier nếu nó cùng tên miền.
Khi xuất kết quả, chỉ những dòng có url trùng canonical mới được ghi ra. Trang /c trong ví dụ khai báo canonical là /b, nên /c vẫn được tải để lấy link nhưng không xuất hiện trong file kết quả. Nhờ vậy, bộ dữ liệu cuối không có hai bản ghi cho cùng một nội dung.
Chuẩn hóa URL quyết định kích thước hàng đợi. Bỏ qua bước này, crawler vẫn chạy nhưng tốn gấp nhiều lần thời gian để tải lại cùng một nội dung.
Nhiều biến thể, một URL
Chuẩn bị môi trường và dữ liệu thử để xây dựng web crawler Python
Code dưới dùng Python 3.12, thư viện requests 2.34 và lxml 6.1. SQLite và urllib có sẵn trong thư viện chuẩn. Ai đang dùng Python 3.10 trở lên thì chạy được, chỉ cần cài thêm hai thư viện.
Cài thư viện
Anh em nên tạo môi trường ảo riêng cho crawler để không đụng phiên bản thư viện của dự án khác. Hai lệnh dưới chạy trên PowerShell của Windows, trên Linux thì đổi đường dẫn kích hoạt thành bin/activate.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
pip install requests lxml
Website giả lập để thử
Thử crawler trên website thật ngay từ đầu vừa chậm vừa dễ làm phiền chủ website. Mình dựng một website nhỏ bằng http.server của Python, chạy ở 127.0.0.1 cổng 8765. Website này cố tình chứa các tình huống khó: link có utm, link có #, trang khai báo canonical sang trang khác, thư mục bị robots.txt chặn, một trang trả 429 lần đầu và một trang luôn trả lỗi 500.
# site.py: web thu nghiem cuc bo, chay: python site.py 8765
import sys
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

HITS = {}
PAGES = {
    "/": '<title>Trang chu</title><a href="/a">A</a> <a href="/b?utm_source=mail">B</a> '
         '<a href="/b#tren">B neo</a> <a href="/c">C</a> <a href="/private/x">P</a> '
         '<a href="/cham">Cham</a> <a href="/loi">Loi</a> <a href="https://ngoai.example.invalid/">Ngoai</a>',
    "/a": '<title>Trang A</title><a href="/">Ve</a> <a href="/a/1">A1</a>',
    "/a/1": '<title>Trang A1</title><a href="/a">A</a>',
    "/b": '<title>Trang B</title><a href="/">Ve</a>',
    "/c": '<title>Ban in cua B</title><link rel="canonical" href="/b"><a href="/">Ve</a>',
    "/cham": '<title>Trang cham</title>',
    "/private/x": '<title>Rieng tu</title>',
}


class H(BaseHTTPRequestHandler):
    def log_message(self, *a):
        pass

    def do_GET(self):
        path = self.path.split("?")[0]
        HITS[path] = HITS.get(path, 0) + 1
        print(path, HITS[path], flush=True)
        if path == "/robots.txt":
            body, ctype = b"User-agent: *\nDisallow: /private/\nCrawl-delay: 0.2\n", "text/plain"
        elif path == "/cham" and HITS[path] == 1:
            self.send_response(429); self.send_header("Retry-After", "1"); self.end_headers(); return
        elif path == "/loi":
            self.send_response(500); self.end_headers(); return
        elif path in PAGES:
            body, ctype = PAGES[path].encode(), "text/html; charset=utf-8"
        else:
            self.send_response(404); self.end_headers(); return
        self.send_response(200)
        self.send_header("Content-Type", ctype)
        self.end_headers()
        self.wfile.write(body)


ThreadingHTTPServer(("127.0.0.1", int(sys.argv[1])), H).serve_forever()
Mỗi lần có request, website in ra đường dẫn và số lần trang đó bị gọi. Nhờ dòng in này, mình kiểm được crawler có tải trùng trang nào không mà không phải đoán qua kết quả cuối.
Code mẫu khi xây dựng web crawler Python có checkpoint
Đây là phần chính của bài. File crawler.py dưới chứa toàn bộ logic: chuẩn hóa URL, bảng trạng thái, robots.txt, giãn cách request, thử lại và xuất kết quả. Mình để comment tiếng Việt không dấu ở những chỗ dễ hiểu sai.
Toàn bộ crawler.py
import json, os, sqlite3, sys, time
from urllib.parse import urljoin, urldefrag, urlsplit, urlunsplit, parse_qsl, urlencode
from urllib.robotparser import RobotFileParser

import requests
from lxml import html

UA = "ProxyVNDemoCrawler/1.0 (+lien-he@example.invalid)"
DROP_PARAMS = {"utm_source", "utm_medium", "utm_campaign", "utm_term", "utm_content", "fbclid", "gclid"}


def normalize(url):
    url, _ = urldefrag(url)
    p = urlsplit(url)
    host = (p.hostname or "").lower()
    port = p.port
    if port and not ((p.scheme == "http" and port == 80) or (p.scheme == "https" and port == 443)):
        host = f"{host}:{port}"
    query = urlencode([(k, v) for k, v in parse_qsl(p.query, keep_blank_values=True)
                       if k.lower() not in DROP_PARAMS])
    return urlunsplit((p.scheme.lower(), host, p.path or "/", query, ""))


class Crawler:
    def __init__(self, db, seed, max_depth=3, delay=1.0):
        self.db = sqlite3.connect(db)
        self.db.execute("""CREATE TABLE IF NOT EXISTS urls(
            url TEXT PRIMARY KEY, depth INT, status TEXT DEFAULT 'queued',
            tries INT DEFAULT 0, next_at REAL DEFAULT 0, http INT,
            canonical TEXT, title TEXT, fetched_at REAL)""")
        # URL dang tai do khi chuong trinh bi tat giua chung: tra ve hang doi
        self.db.execute("UPDATE urls SET status='queued' WHERE status='fetching'")
        self.db.commit()
        self.seed = normalize(seed)
        self.host = urlsplit(self.seed).netloc
        self.max_depth, self.delay = max_depth, delay
        self.s = requests.Session()
        self.s.headers["User-Agent"] = UA
        proxy = os.environ.get("CRAWLER_PROXY")  # vi du: http://user:pass@host:port
        if proxy:
            self.s.proxies = {"http": proxy, "https": proxy}
        self.robots = self.load_robots()
        cd = self.robots.crawl_delay(UA)
        if cd:
            self.delay = max(self.delay, float(cd))
        self.last = 0.0
        self.add(self.seed, 0)
        self.db.commit()

    def load_robots(self):
        # tai robots.txt bang chinh Session de di cung proxy voi cac request khac
        rp = RobotFileParser()
        url = f"{urlsplit(self.seed).scheme}://{self.host}/robots.txt"
        try:
            r = self.s.get(url, timeout=(5, 15))
        except requests.RequestException:
            print("robots.txt: khong tai duoc, dung lai", file=sys.stderr)
            raise SystemExit(1)
        if r.status_code >= 500:
            rp.parse(["User-agent: *", "Disallow: /"])
        elif r.status_code >= 400:
            rp.parse([])
        else:
            rp.parse(r.text.splitlines())
        return rp

    def add(self, url, depth):
        self.db.execute("INSERT OR IGNORE INTO urls(url, depth) VALUES(?, ?)", (url, depth))

    def mark(self, url, **kw):
        cols = ", ".join(f"{k}=?" for k in kw)
        self.db.execute(f"UPDATE urls SET {cols} WHERE url=?", (*kw.values(), url))
        self.db.commit()

    def next_url(self):
        return self.db.execute(
            "SELECT url, depth, tries FROM urls WHERE status='queued' AND next_at<=? "
            "ORDER BY depth, rowid LIMIT 1", (time.time(),)).fetchone()

    def wait_turn(self):
        gap = self.delay - (time.time() - self.last)
        if gap > 0:
            time.sleep(gap)
        self.last = time.time()

    def retry(self, url, tries, http=None, limit=3):
        if tries + 1 >= limit:
            self.mark(url, status="failed", tries=tries + 1, http=http)
        else:
            self.mark(url, status="queued", tries=tries + 1, http=http,
                      next_at=time.time() + 2 ** (tries + 1))

    def run(self, max_pages=100):
        done = 0
        while done < max_pages:
            row = self.next_url()
            if row is None:
                soonest = self.db.execute(
                    "SELECT MIN(next_at) FROM urls WHERE status='queued'").fetchone()[0]
                if soonest is None:
                    break
                time.sleep(max(0, soonest - time.time()))
                continue
            url, depth, tries = row
            if not self.robots.can_fetch(UA, url):
                self.mark(url, status="blocked_robots")
                continue
            self.mark(url, status="fetching")
            self.wait_turn()
            try:
                r = self.s.get(url, timeout=(5, 20))
            except requests.RequestException:
                self.retry(url, tries)
                continue
            if r.status_code in (429, 503):
                ra = r.headers.get("Retry-After", "")
                wait = int(ra) if ra.isdigit() else 2 ** (tries + 1)
                self.mark(url, status="queued", tries=tries + 1, http=r.status_code,
                          next_at=time.time() + wait)
                continue
            if r.status_code >= 500:
                self.retry(url, tries, r.status_code)
                continue
            final = normalize(r.url)
            if final != url:
                self.add(final, depth)
            if r.status_code != 200 or "text/html" not in r.headers.get("Content-Type", ""):
                self.mark(url, status="done", http=r.status_code, fetched_at=time.time())
                done += 1
                continue
            tree = html.fromstring(r.content, base_url=r.url)
            title = (tree.findtext(".//title") or "").strip()
            canon = tree.xpath("//link[@rel='canonical']/@href")
            canon = normalize(urljoin(r.url, canon[0])) if canon else final
            if canon != final and urlsplit(canon).netloc == self.host:
                self.add(canon, depth)
            if depth < self.max_depth:
                for href in tree.xpath("//a[@href]/@href"):
                    link = normalize(urljoin(r.url, href))
                    p = urlsplit(link)
                    if p.scheme in ("http", "https") and p.netloc == self.host:
                        self.add(link, depth + 1)
            self.mark(url, status="done", http=200, canonical=canon, title=title,
                      fetched_at=time.time())
            done += 1
        return done

    def export(self, path):
        rows = self.db.execute(
            "SELECT url, title FROM urls WHERE status='done' AND http=200 "
            "AND url=canonical ORDER BY rowid")
        with open(path, "w", encoding="utf-8") as f:
            for url, title in rows:
                f.write(json.dumps({"url": url, "title": title}, ensure_ascii=False) + "\n")


if __name__ == "__main__":
    seed, db = sys.argv[1], sys.argv[2]
    limit = int(sys.argv[3]) if len(sys.argv) > 3 else 100
    c = Crawler(db, seed, delay=float(os.environ.get("CRAWLER_DELAY", "1")))
    n = c.run(limit)
    c.export(db + ".jsonl")
    print("da tai", n, "trang")
    for status, count in c.db.execute("SELECT status, COUNT(*) FROM urls GROUP BY status ORDER BY status"):
        print(status, count)
Vài quyết định trong code cần giải thích
Hàm mark commit sau mỗi lần cập nhật. Commit liên tục chậm hơn gom nhiều thay đổi rồi commit một lần, nhưng với crawler có giãn cách 1 giây giữa các request thì chi phí này không đáng kể. Đổi lại, chương trình chết ở bất kỳ thời điểm nào cũng chỉ mất tối đa một trang đang tải dở.
Chỉ link cùng host mới được thêm vào hàng đợi. Link sang tên miền khác, như ngoai.example.invalid trong website thử, bị bỏ qua ngay ở vòng lặp đọc thẻ a. Muốn crawler đi cả tên miền phụ thì sửa điều kiện so sánh netloc, nhưng nên làm có chủ đích chứ đừng mở toang.
Giới hạn max_depth mặc định là 3. Trang ở độ sâu 3 vẫn được tải, nhưng link trong đó không được thêm nữa. Đây là chốt an toàn để crawler không đi lạc vào các trang lịch vô tận hay bộ lọc sinh URL không giới hạn.
Chạy thử và đầu ra mong đợi khi xây dựng web crawler Python
Để kiểm tra checkpoint, mình chạy crawler hai lần liên tiếp trên cùng file crawl.db. Lần đầu giới hạn 3 trang để giả lập chương trình bị dừng giữa chừng. Lần hai cho chạy tới khi hết hàng đợi.
Lệnh chạy và kết quả từng lần
# cua so 1
python site.py 8765

# cua so 2
$env:CRAWLER_DELAY = "0.2"
python crawler.py http://127.0.0.1:8765/ crawl.db 3
python crawler.py http://127.0.0.1:8765/ crawl.db 100
Kết quả in ra trên máy mình ngày 23/10/2026:
# lan 1
da tai 3 trang
done 3
queued 5

# lan 2
da tai 3 trang
blocked_robots 1
done 6
failed 1
Lần đầu dừng sau 3 trang, còn 5 URL nằm trong hàng đợi. Lần hai lấy tiếp đúng 5 URL đó chứ không đi lại từ trang chủ. Tổng thời gian hai lần chạy là 7,8 giây, phần lớn là thời gian chờ thử lại trang lỗi 500 và chờ Retry-After của trang 429.
Đối chiếu với nhật ký của website
Nhật ký phía website là bằng chứng rõ nhất. Mỗi trang chỉ bị gọi một lần, trừ /cham bị gọi hai lần vì lần đầu nhận 429 và /loi bị gọi ba lần trước khi bị đánh dấu failed. Trang /b chỉ bị gọi một lần dù trang chủ có tới hai link trỏ vào nó, một link có utm_source và một link có #tren.
/robots.txt 1
/ 1
/a 1
/b 1
/robots.txt 2
/c 1
/cham 1
/loi 1
/a/1 1
/cham 2
/loi 2
/loi 3
Dòng /robots.txt 2 xuất hiện vì lần chạy thứ hai khởi tạo crawler mới và đọc lại robots.txt. Đó là hành vi đúng: luật của website có thể đổi giữa hai lần chạy. Trang /private/x không có trong nhật ký, nghĩa là crawler không gửi request nào tới thư mục bị chặn.
File kết quả JSONL
File crawl.db.jsonl chứa 5 bản ghi: trang chủ, /a, /b, /cham và /a/1. Trang /c không có mặt vì canonical của nó trỏ về /b. Trang /loi không có vì bị đánh dấu failed. Mỗi dòng là một đối tượng JSON, dễ nạp vào pandas hay đẩy sang công cụ khác.
{"url": "http://127.0.0.1:8765/", "title": "Trang chu"}
{"url": "http://127.0.0.1:8765/a", "title": "Trang A"}
{"url": "http://127.0.0.1:8765/b", "title": "Trang B"}
{"url": "http://127.0.0.1:8765/cham", "title": "Trang cham"}
{"url": "http://127.0.0.1:8765/a/1", "title": "Trang A1"}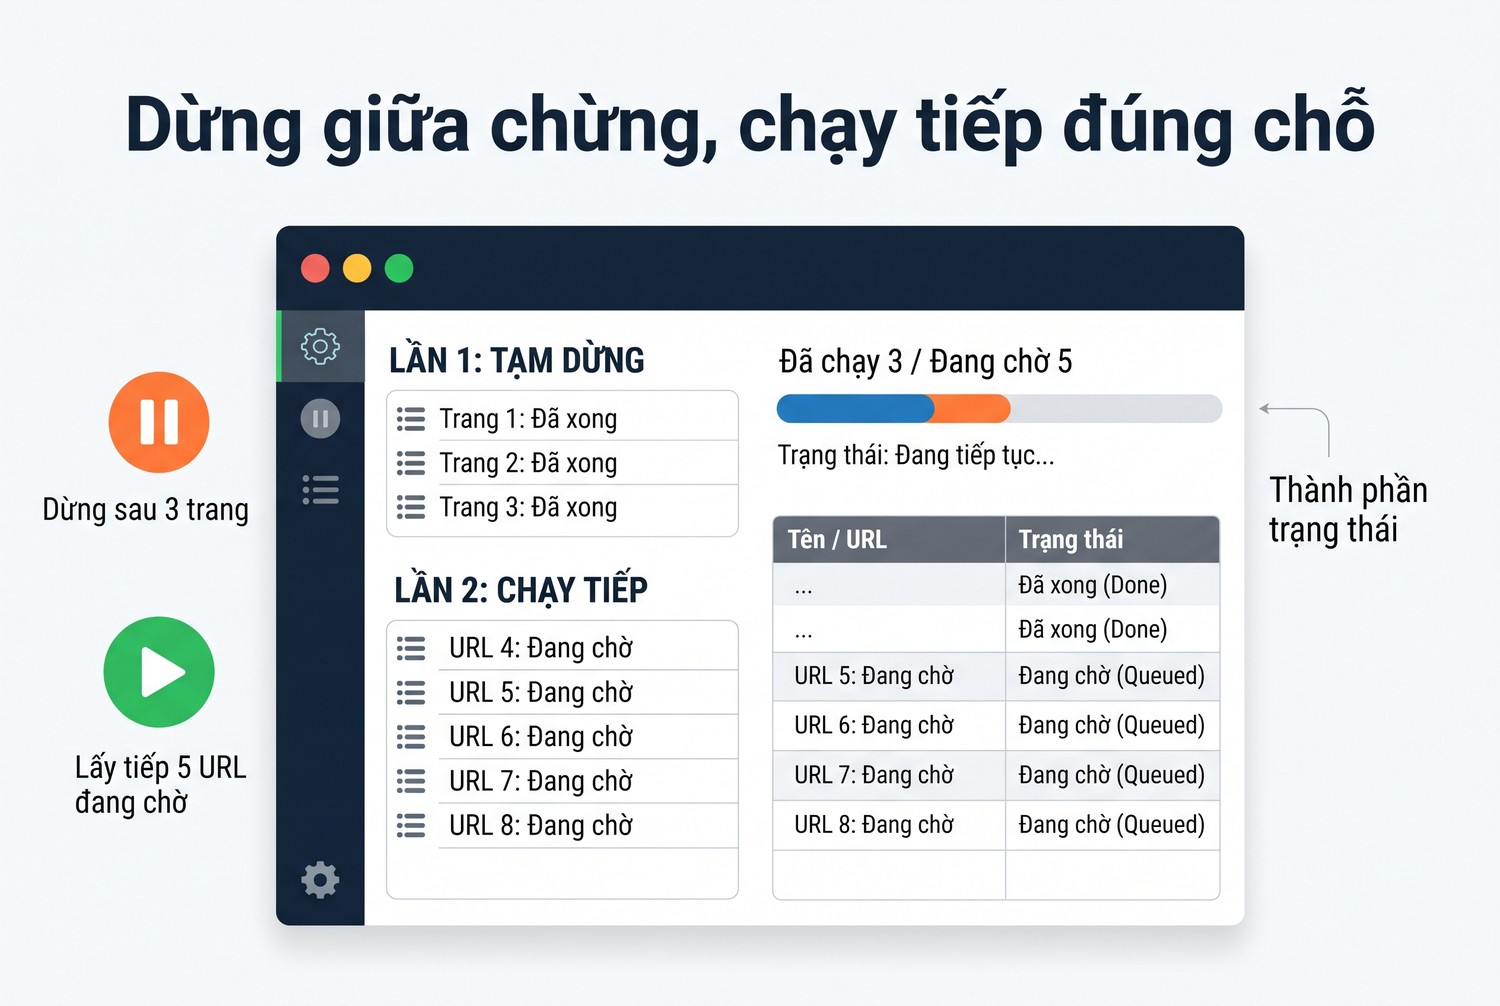
Dừng giữa chừng, chạy tiếp đúng chỗ
Robots.txt và lịch request khi xây dựng web crawler Python
Robots.txt là quy ước chủ website dùng để nói phần nào không muốn bị bot truy cập. RFC 9309 chuẩn hóa định dạng file này năm 2022. Crawler tử tế đọc file này trước khi tải bất kỳ trang nào.
Vì sao không dùng RobotFileParser.read()
Module urllib.robotparser có sẵn hàm read() để tự tải robots.txt. Mình không dùng hàm đó vì nó tải bằng urllib, không đi qua Session của requests. Nếu crawler chạy qua proxy, robots.txt sẽ được tải bằng một đường khác, có khi bị chặn hoặc nhận nội dung khác.
Thay vào đó, crawler tải robots.txt bằng chính Session, rồi đưa nội dung vào parse(). Cách xử lý mã lỗi bám theo tinh thần RFC 9309: robots.txt trả lỗi 4xx thì coi như không có luật, trả 5xx thì tạm coi toàn bộ website bị chặn. Không tải được do lỗi mạng thì crawler dừng hẳn để anh em kiểm tra, thay vì tự ý chạy tiếp.
Crawl-delay và giãn cách
Crawl-delay không nằm trong phần bắt buộc của RFC 9309, nhiều website vẫn dùng nó. Hàm crawl_delay() của RobotFileParser đọc được giá trị này. Crawler lấy số lớn hơn giữa giá trị trong robots.txt và giá trị anh em cấu hình qua biến CRAWLER_DELAY.
Mặc định mình đặt 1 giây giữa hai request. Với website nhỏ chạy trên hosting chia sẻ, 1 giây vẫn có thể là nhiều. Hỏi chủ website khung giờ ít người dùng và tốc độ chấp nhận được là cách nhanh nhất để khỏi bị chặn giữa chừng.
Xử lý lỗi và kiểm tra dữ liệu khi xây dựng web crawler Python
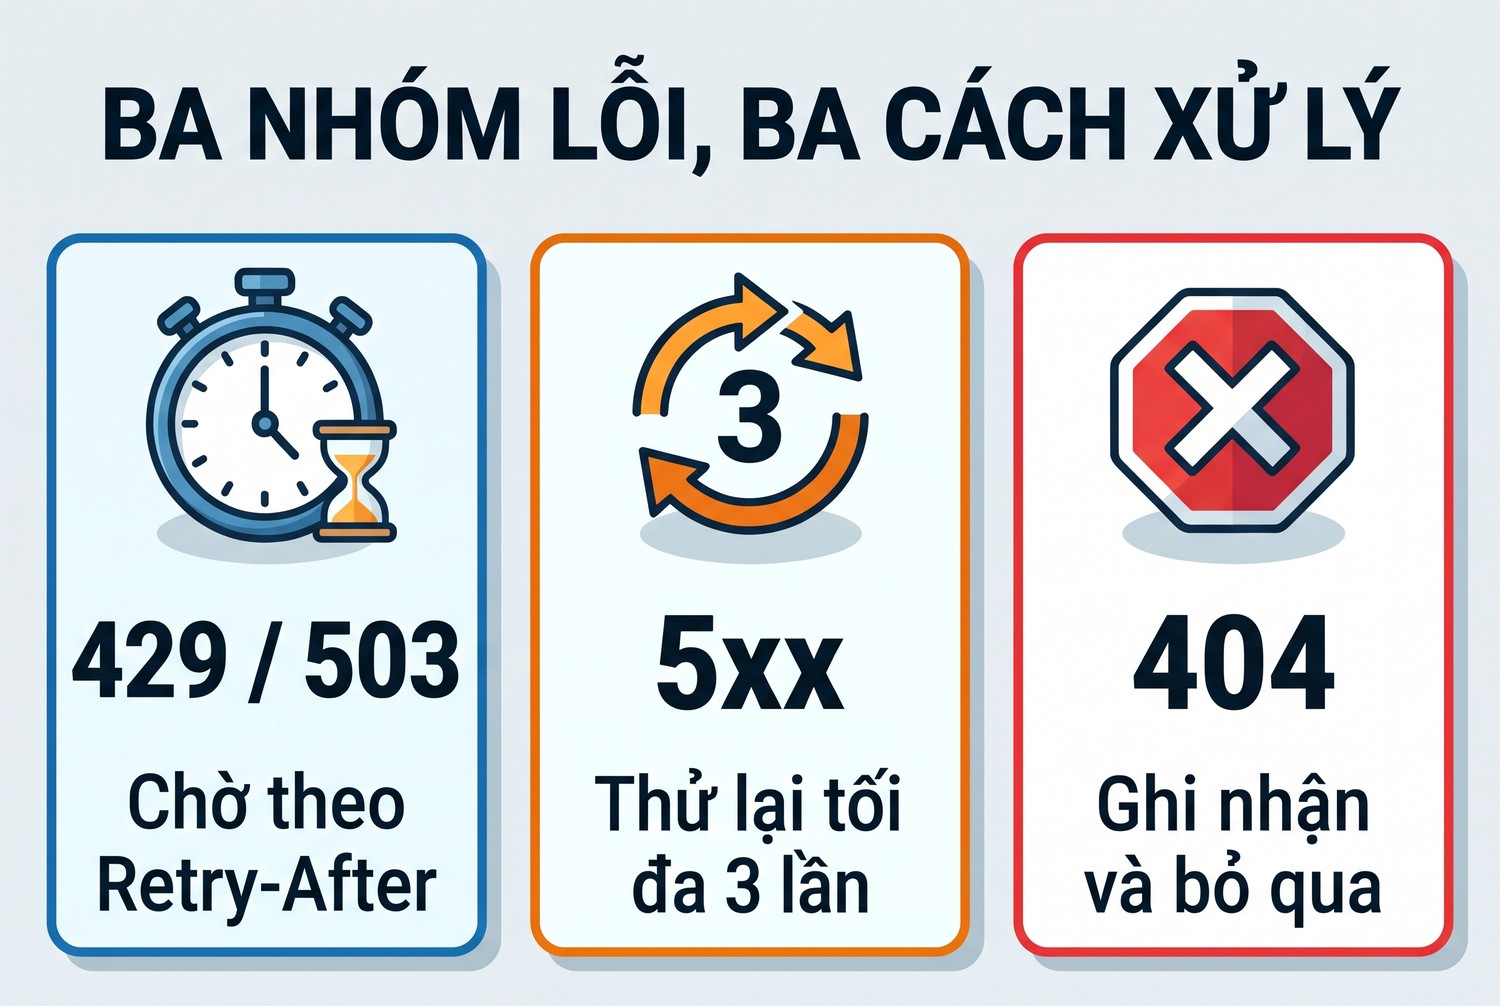
Không phải lỗi nào cũng nên thử lại. Crawler chia lỗi thành ba nhóm và xử lý khác nhau. Cách chia này quyết định crawler kết thúc gọn gàng hay vòng vèo mãi với một trang hỏng.
Ba nhóm lỗi
- 429 và 503: website bảo chậm lại. Crawler đọc Retry-After nếu là số giây, không có thì chờ theo lũy thừa 2. Mã 429 được định nghĩa trong tài liệu MDN về 429 Too Many Requests.
- Lỗi mạng và 5xx khác: có thể là sự cố tạm. Crawler thử lại tối đa 3 lần với thời gian chờ 2 giây rồi 4 giây, sau đó đánh dấu failed.
- 4xx khác như 404 hay 410: lỗi cố định. Crawler ghi mã lỗi và coi trang đã xử lý xong, không thử lại.
Retry-After cũng có thể là một mốc ngày giờ thay vì số giây. Code mẫu chỉ hiểu dạng số giây; gặp dạng ngày giờ thì quay về chờ theo lũy thừa 2. Nếu website anh em làm việc hay trả dạng ngày giờ, thêm phần đọc bằng email.utils.parsedate_to_datetime.
Redirect và trang lỗi giả dạng 200
requests tự đi theo redirect, nên r.url là địa chỉ cuối cùng sau mọi lần chuyển hướng. Crawler so URL cuối này với URL đã xin. Khác nhau thì URL cuối được thêm vào bảng, để lần sau gặp link trỏ thẳng tới nó thì không tải lại. URL ban đầu vẫn được đánh dấu done để không bị xin lại.
Khó hơn là trang lỗi trả mã 200, hay được gọi là soft 404. Website hiện chữ không tìm thấy sản phẩm nhưng vẫn trả 200, crawler coi đó là trang hợp lệ. Cách bắt khá thủ công: sau lần chạy đầu, nhóm các trang theo tiêu đề, tiêu đề nào lặp lại hàng trăm lần thì mở ra xem. Nếu đúng là trang lỗi, thêm điều kiện kiểm tra tiêu đề hoặc một đoạn chữ đặc trưng trước khi ghi done.
Kiểm tra dữ liệu sau mỗi lần chạy
Sau mỗi lần chạy, mình xem ba con số: số trang done, số trang failed và số URL còn queued. Done tăng đều là crawler đang chạy tốt. Failed tăng vọt thường báo website đang chặn hoặc đang bảo trì. Queued tăng nhanh hơn done nhiều lần là dấu hiệu chuẩn hóa URL chưa đủ, có tham số nào đó đang sinh URL vô hạn.
Một truy vấn SQL đơn giản liệt kê 20 URL queued gần nhất sẽ cho thấy ngay tham số gây phình hàng đợi. Thêm tham số đó vào DROP_PARAMS, xóa các dòng thừa, rồi chạy tiếp. Đây là chỗ checkpoint SQLite tiện hơn nhiều so với dữ liệu nằm trong RAM: anh em sửa được trạng thái giữa hai lần chạy.
Ba nhóm lỗi, ba cách xử lý
Khi nào cần proxy khi xây dựng web crawler Python
Phần lớn crawler kiểm kê website của chính mình không cần proxy. Proxy chỉ nên thêm vào khi có lý do cụ thể. Mình liệt kê những lý do hay gặp để anh em tự đối chiếu.
Những trường hợp có lý do dùng proxy
- Máy chạy crawler nằm trong mạng công ty, chỉ được ra Internet qua proxy.
- Website đích hiển thị nội dung theo quốc gia, cần IP ở đúng quốc gia để thấy đúng phiên bản trang.
- Chủ website cho phép thu thập nhưng chỉ mở tường lửa cho một IP cố định đã đăng ký.
- Nhóm cần tách IP của crawler khỏi IP văn phòng để lưu lượng thu thập không ảnh hưởng tới các dịch vụ khác của công ty.
Ở tất cả các trường hợp trên, một IP tĩnh là đủ. Proxy không phải công cụ để vượt giới hạn tốc độ mà website đã đặt. Gặp 429 thì giảm tốc, không phải đổi IP để gửi tiếp.
Cấu hình proxy cho crawler
Crawler đọc biến môi trường CRAWLER_PROXY và gán cho cả http lẫn https của Session. Theo tài liệu requests về proxy, với proxy SOCKS5 anh em cần cài thêm requests[socks] và dùng tiền tố socks5h để tên miền được phân giải phía proxy. Các cách khai báo proxy khác trong requests có trong bài cài đặt proxy cho thư viện requests.
$env:CRAWLER_PROXY = "http://TAI_KHOAN:MAT_KHAU@proxy.example.invalid:8080"
python crawler.py https://website-duoc-phep.example/ crawl.db 500
Trước khi chạy thật qua proxy, mình luôn gửi một request tới trang trả IP công khai bằng chính Session của crawler. IP trả về phải là IP của proxy, không phải IP văn phòng. Nếu ra IP văn phòng, biến môi trường chưa được nạp hoặc proxy chỉ được gán cho http mà quên https. Lỗi này không báo gì, crawler vẫn chạy bình thường, chỉ là đi sai đường.
Proxy cũng làm thay đổi cách đọc lỗi. Mã 407 đến từ proxy chứ không phải từ website, nghĩa là tài khoản proxy sai hoặc hết hạn. Timeout khi kết nối có thể nằm ở chặng tới proxy. Crawler mẫu gộp các lỗi mạng vào một nhóm thử lại, nên khi dùng proxy anh em nên ghi thêm tên lớp lỗi vào bảng để biết lỗi nằm ở chặng nào.
Khi có nhiều crawler chạy song song cho nhiều dự án, chia proxy theo dự án sẽ dễ quản lý hơn dùng chung một cụm. Cách chia được bàn kỹ trong bài proxy pool là gì và cách chia proxy cho crawling. Nếu dự án cần IP tĩnh để chủ website đưa vào danh sách cho phép, anh em có thể mua proxy dân cư tĩnh hoặc datacenter của ProxyVN, giao thức HTTP và SOCKS5, có tài khoản user và password.
Checklist trước khi chạy thật sau khi xây dựng web crawler Python
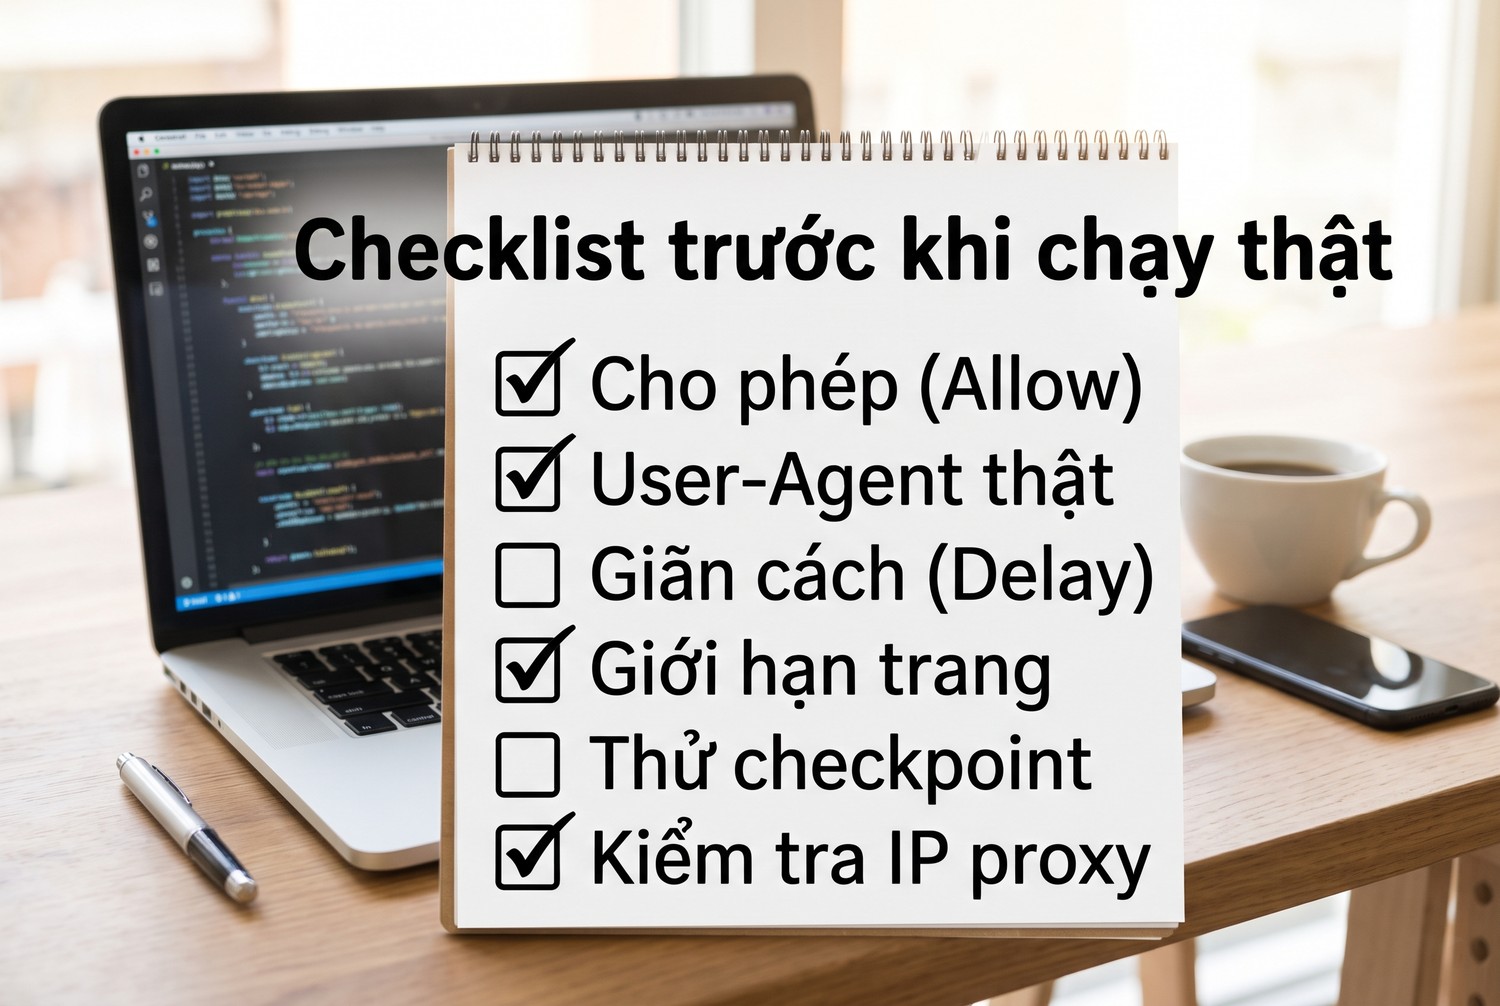
Chạy được trên website giả lập mới là bước đầu. Trước khi trỏ crawler vào website thật, mình rà lại danh sách dưới đây. Mất khoảng mười phút nhưng tránh được những đêm chạy uổng công.
Danh sách kiểm tra
- Đã có sự cho phép hoặc đã đọc điều khoản sử dụng của website đích.
- User-Agent có tên crawler và cách liên hệ thật, không để trống hay giả trình duyệt.
- Đã đặt CRAWLER_DELAY phù hợp, đã kiểm tra Crawl-delay trong robots.txt.
- Đã đặt giới hạn số trang cho lần chạy đầu, khoảng vài trăm trang để xem dữ liệu.
- Đã xem 20 URL queued đầu tiên để kiểm tra chuẩn hóa còn sót tham số nào.
- File crawl.db nằm trên ổ có đủ chỗ, có sao lưu nếu dự án chạy nhiều ngày.
- Đã thử tắt chương trình giữa chừng rồi chạy lại để chắc checkpoint hoạt động trên máy thật.
- Nếu dùng proxy, đã kiểm tra IP đầu ra trước khi chạy bằng một request tới trang trả IP.
Checklist trước khi chạy thật
Hướng mở rộng tiếp theo
Khi lõi đã ổn, có ba hướng mở rộng hay gặp. Đọc sitemap.xml để thêm URL vào frontier ngay từ đầu, thay vì chỉ dựa vào link. Lưu cả nội dung HTML ra đĩa để phân tích lại mà không phải tải lại. Chạy nhiều luồng với giới hạn số request đồng thời theo từng host.
Sitemap là hướng nên làm đầu tiên vì rẻ nhất. Phần lớn website khai báo sitemap trong robots.txt bằng dòng Sitemap:, và RobotFileParser có hàm site_maps() đọc được danh sách đó. Crawler chỉ cần tải từng sitemap, lấy các thẻ loc rồi gọi add với độ sâu 0. Những trang không có link nội bộ nào trỏ tới vẫn được tìm thấy nhờ cách này.
Chạy nhiều luồng thì cẩn thận hơn. SQLite cho nhiều kết nối đọc cùng lúc nhưng ghi thì lần lượt, nên mỗi luồng nên có kết nối riêng và lấy URL bằng một câu UPDATE đánh dấu fetching trước khi tải. Giới hạn số luồng theo từng host, đừng chỉ giới hạn tổng. Tăng từ một lên hai luồng là đã gấp đôi tải lên website đích, nên hỏi chủ website trước khi tăng.
Mỗi hướng đều giữ nguyên bảng urls làm trung tâm. Đó là lý do mình đầu tư vào thiết kế bảng trạng thái ngay từ phiên bản đầu tiên.
Xây dựng web crawler Python và điều cần nhớ
Xây dựng web crawler Python chạy được lâu cần hàng đợi lưu trên đĩa, URL được chuẩn hóa, canonical được tôn trọng và lỗi được phân loại trước khi thử lại. Anh em chạy thử trên website giả lập, đọc nhật ký phía website rồi mới chạy thật. Cần IP tĩnh, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khi xây dựng web crawler Python.


