
Web Scraping proxy là gì? Hoạt động thế nào?
Web scraping proxy là gì là câu hỏi nền tảng với anh em làm thu thập dữ liệu, theo dõi giá hay giám sát SEO. Đây là lớp proxy đứng giữa công cụ cào và trang đích, giúp phân tán request qua nhiều IP để không bị chặn. Bài viết này của ProxyVN giải thích vì sao cào dữ liệu cần proxy, cách xoay IP, chọn loại proxy theo độ khó của mục tiêu, và cách xử lý khi gặp 429 hay captcha.
Web scraping proxy là gì và vì sao cào dữ liệu cần proxy
Theo GroupBWT, mỗi request HTTP đều mang theo một địa chỉ IP, và website dùng địa chỉ đó để áp giới hạn tần suất, áp quy tắc theo vùng, phát hiện mẫu tự động và chặn client không mong muốn. Không có proxy, một công cụ cào gửi hàng nghìn request từ một IP sẽ bị phát hiện rất nhanh.
Các cơ chế phát hiện chính
Website chống cào chủ yếu bằng ba lớp. Giới hạn tần suất trả về mã 429 khi một IP vượt ngưỡng request cho phép trong một khoảng thời gian, dẫn tới bị bóp băng thông tạm thời hoặc chặn hẳn. Thử thách captcha xuất hiện khi lưu lượng trông đáng ngờ, buộc phải xác minh mới đi tiếp. Chặn IP là biện pháp mạnh nhất, đưa hẳn IP vào danh sách đen. Cả ba đều dựa vào việc nhiều request cùng đến từ một địa chỉ.
Một IP hoặc pool nhỏ sẽ hỏng ở quy mô
GroupBWT nhấn mạnh khi khối lượng tăng từ vài nghìn lên hàng trăm nghìn request mỗi ngày, một IP đơn hoặc một pool tĩnh nhỏ sẽ thất bại: tỉ lệ lỗi tăng, các đợt cào lại phình to, và các bên phụ thuộc dữ liệu mất niềm tin vào bảng số liệu. Web scraping proxy giải quyết đúng bài toán này bằng cách trải request qua nhiều IP.
Có một cách hiểu đơn giản. Website đặt ngưỡng cho mỗi IP, ví dụ vài chục request mỗi phút. Nếu anh em cần lấy một trăm nghìn trang trong một ngày mà chỉ có một IP, anh em buộc phải chạy rất chậm để không vượt ngưỡng, và như vậy không kịp tiến độ. Chia một trăm nghìn request đó cho một nghìn IP thì mỗi IP chỉ gánh một trăm request, nằm dưới ngưỡng, và toàn bộ công việc xong nhanh mà không IP nào bị gắn cờ. Đó là lý do proxy xoay gần như bắt buộc khi cào ở quy mô lớn.
Web scraping proxy là gì xét theo pool xoay IP
GroupBWT mô tả rotating proxy như một lớp kiểm soát điểm ra mạng, định tuyến request qua một pool IP để hệ thống duy trì được độ phủ qua các vùng, các ngưỡng tần suất và các mẫu phòng thủ của trang đích.
Có ba kiểu tần suất xoay. Xoay theo mỗi request cấp một IP mới cho từng lần gọi, phân tán tối đa. Xoay theo N request gom nhiều request trên một IP rồi mới đổi. Xoay theo thời gian đổi IP sau mỗi số giây hoặc phút định trước. Anh em thường không kết nối thẳng tới từng IP mà đi qua một cổng gateway cố định, chính gateway chọn IP thật từ pool cho từng request, nên cấu hình phía anh em không đổi trong khi IP mà website thấy luôn thay đổi.
Pool càng lớn thì mỗi IP gánh càng ít request, khả năng chạm ngưỡng chặn càng thấp. Cách chia pool cho nhiều luồng cào và tài khoản xem proxy pool là gì.
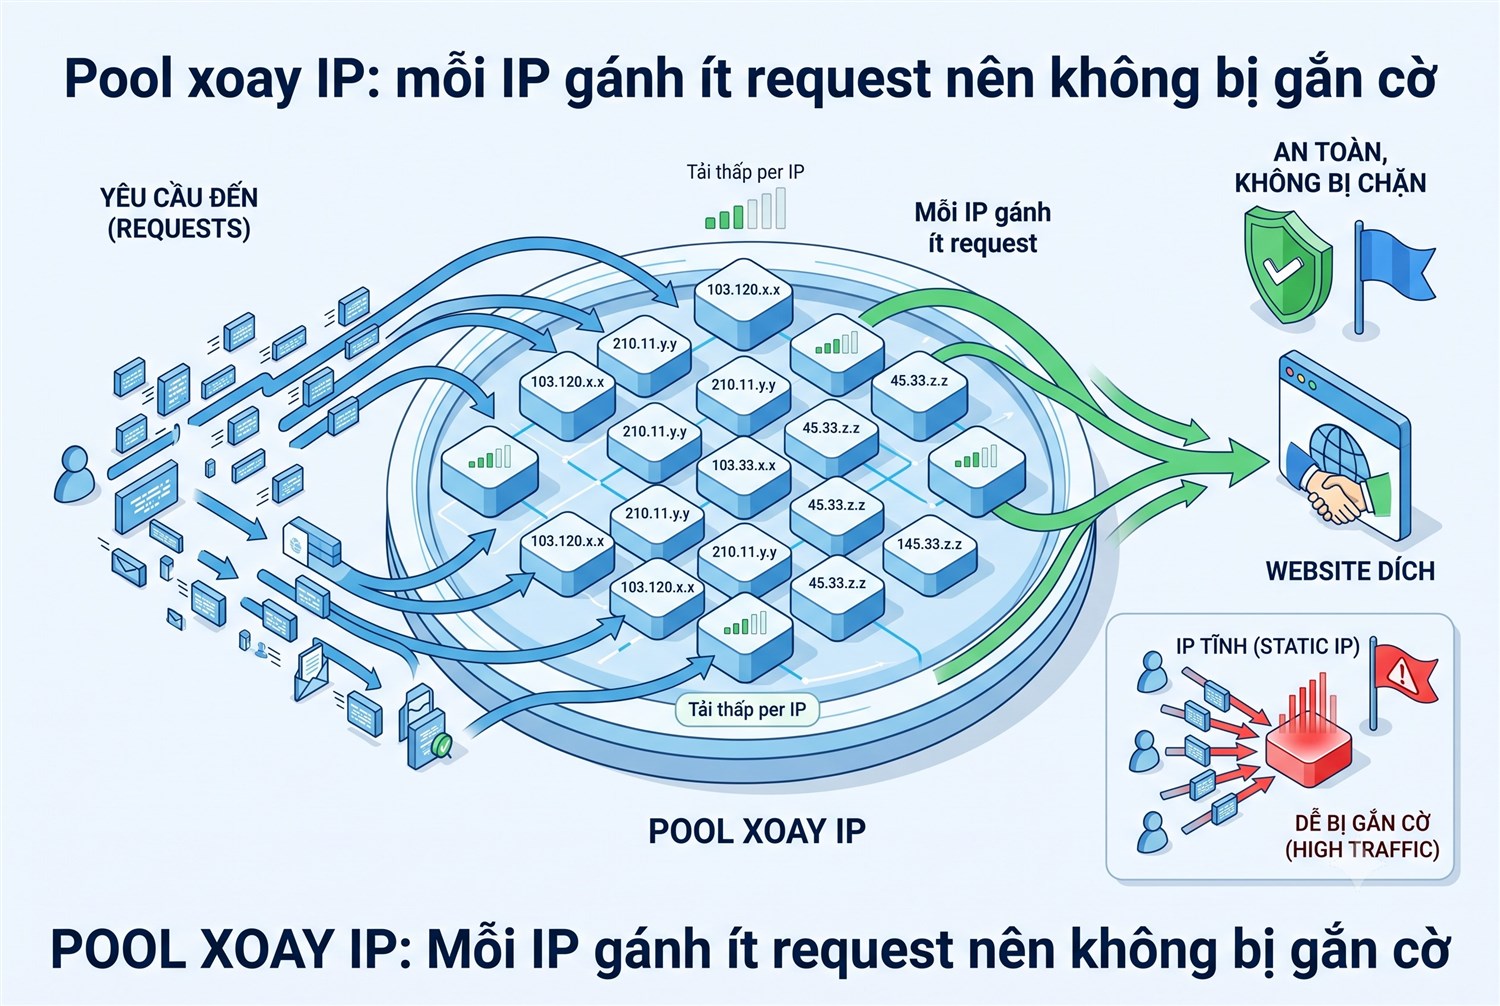
Pool xoay IP: mỗi IP gánh ít request nên không bị gắn cờ
Web scraping proxy là gì khi phân theo loại IP
GroupBWT phân bốn loại proxy cho scraping, mỗi loại có đánh đổi riêng.
|
Loại |
Đặc điểm |
Hợp mục tiêu nào |
|---|---|---|
|
Datacenter |
Rẻ, nhanh, mở rộng dễ, nhưng bị lập vân tay nhanh |
Nguồn khối lượng lớn, ít phòng thủ |
|
Residential |
IP nhà mạng dân cư, qua được nhiều lớp phòng thủ |
Luồng có bảo vệ, dữ liệu theo góc người dùng |
|
Mobile |
IP nhà mạng di động, mức trust cao nhất |
Luồng ưu tiên di động, mục tiêu khó nhất |
|
ISP / dedicated |
Xây uy tín theo thời gian |
Cần liên tục và tín hiệu tin cậy |
GroupBWT lưu ý pool residential thường chạy tốt trên các hành trình người dùng có phòng thủ, nhưng nếu chỉ cần residential cho một vùng hẹp thì nên coi đó như một pool riêng có giới hạn và log rõ ràng. Với IP datacenter, chúng mở rộng chi phí tốt nhưng một số mục tiêu lập vân tay và loại chúng ra rất nhanh.
Đặt vào thực tế, cách chọn thường là theo độ khó của trang đích. Với các nguồn dữ liệu mở như trang tin, kho tài liệu công khai, danh mục sản phẩm không đăng nhập, datacenter là đủ và rẻ nhất. Với các sàn thương mại điện tử lớn, mạng xã hội, công cụ tìm kiếm có chống bot, residential mới qua được ổn định. Với những mục tiêu khó nhất, chỉ chấp nhận lưu lượng di động, phải dùng mobile dù chậm và đắt. ISP nằm giữa, hợp khi anh em cần một nhóm IP ổn định lâu dài để xây danh tiếng tốt theo thời gian.
Bắt đầu với datacenter, nâng lên residential khi cần
Đây là nguyên tắc chọn loại proxy được các nguồn về scraping đồng thuận. Nên bắt đầu bằng proxy datacenter vì rẻ và nhanh. Chỉ chuyển sang residential khi thử nghiệm có kiểm soát cho thấy việc phân loại mạng, danh tiếng IP hoặc vị trí đang cản anh em lấy đúng các trang cần lấy một cách ổn định.
Cách làm đúng là chạy một đợt thử nhỏ trên chính trang đích với cả hai loại proxy, đo tỉ lệ bị chặn và tỉ lệ phân tích dữ liệu thành công, rồi mới quyết định. Nhiều đội giữ datacenter cho phần lớn khối lượng và chỉ dùng residential cho số ít request tới các trang khó, để tối ưu chi phí.
Một mô hình phối hợp phổ biến: cho mọi request đi qua datacenter trước, chỉ khi nhận mã 403 hoặc trang captcha thì tự động thử lại request đó qua residential. Cách này giữ chi phí thấp cho phần lớn lưu lượng mà vẫn lấy được dữ liệu ở các trang khó. Điều kiện là hệ thống của anh em phải phân biệt được lỗi mạng với lỗi bị chặn, để không lãng phí request residential đắt tiền cho các lỗi không liên quan tới IP.
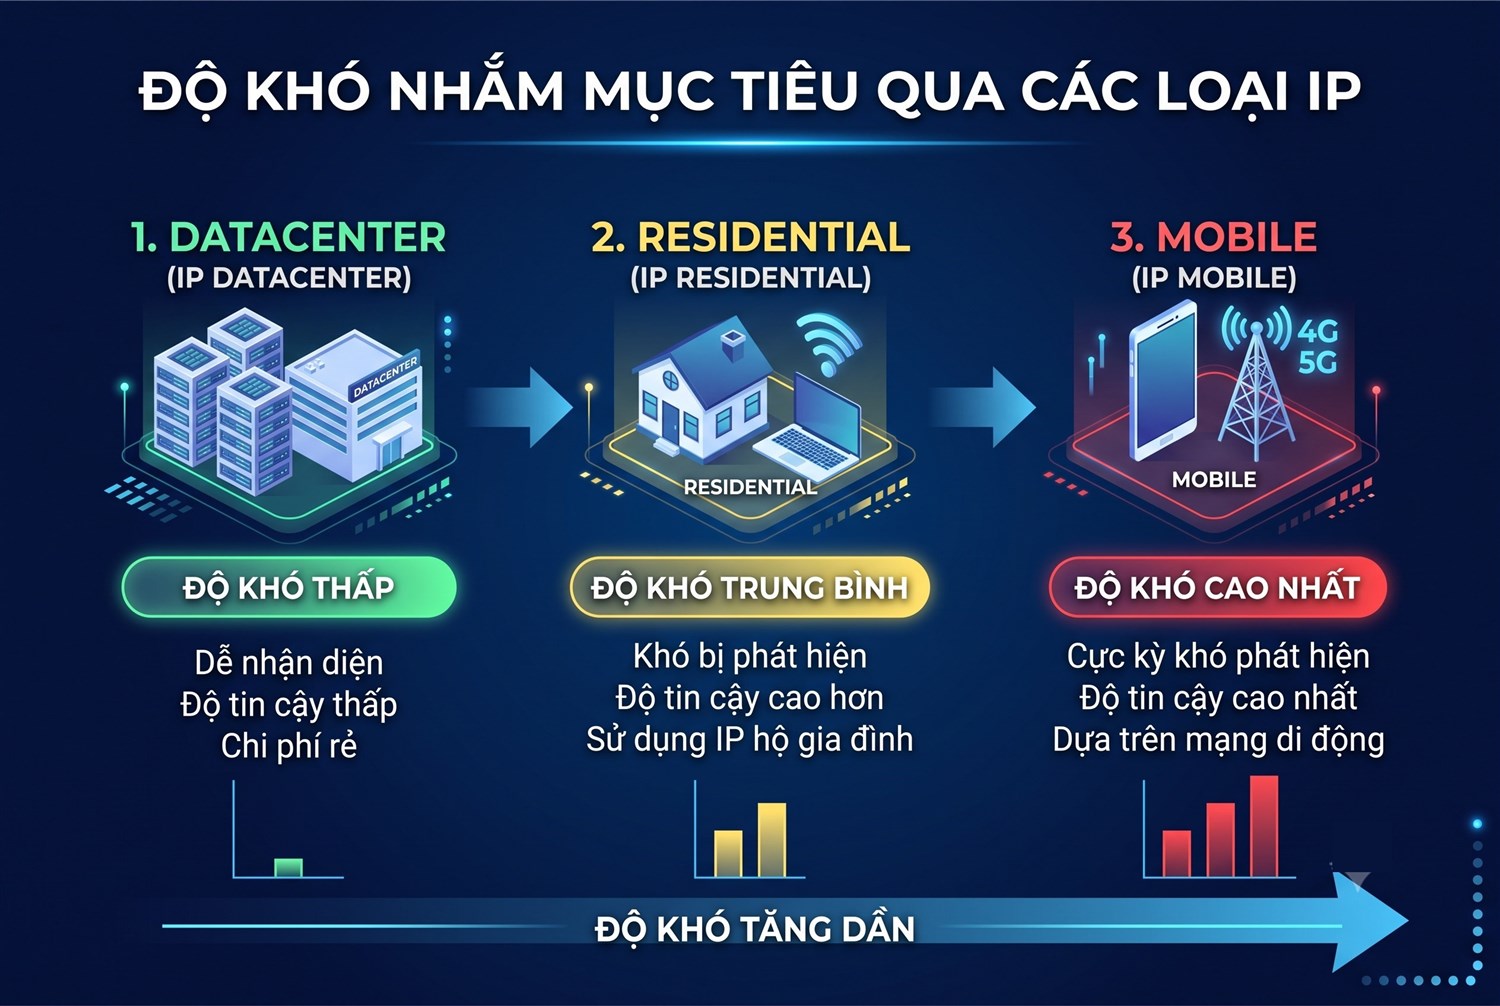
Datacenter → Residential → Mobile theo độ khó của mục tiêu
Web scraping proxy là gì khi cần sticky session
Không phải lúc nào cũng nên xoay IP mỗi request. GroupBWT chỉ ra khi một tác vụ gồm nhiều request tới cùng một site, ví dụ đăng nhập rồi lấy dữ liệu, hoặc thao tác giỏ hàng, thì việc mỗi request đến từ một IP khác bị hầu hết hệ thống chống bot coi là bất thường phiên và bắt đầu chặn.
Giải pháp là sticky session: giữ một IP cho trọn một phiên nhiều bước bằng cách gắn một mã phiên vào phần username của proxy. GroupBWT xếp việc đứt phiên vào sổ rủi ro cần theo dõi, với biện pháp kiểm soát là sticky session và chính sách phiên riêng cho từng mục tiêu. Nói cách khác, anh em cần một quy tắc rõ: request nào thuộc cùng một phiên thì đi cùng một IP, xong phiên mới xoay.
Web scraping proxy là gì khi gặp 429 và captcha
Cách phản ứng khi bị chặn quyết định phần lớn tỉ lệ thành công cuối cùng.
GroupBWT cảnh báo việc thử lại ngay từ một IP mới sau khi vừa bị chặn sẽ làm lỗi chồng lỗi. Cách đúng là giới hạn số lần thử lại trên mỗi IP và dùng backoff theo hàm mũ gắn với tín hiệu, tức khi gặp 429 thì tăng dần khoảng chờ trước khi thử lại thay vì bắn request liên tục. Sổ rủi ro của GroupBWT gọi hiện tượng bắn lại dồn dập sau khi bị chặn là khuếch đại thử lại, và biện pháp kiểm soát là giới hạn số lần thử cộng backoff theo tín hiệu.
Một điểm quan trọng khác là số luồng song song trên mỗi mục tiêu. GroupBWT nhấn mạnh quá nhiều request song song tới một host vẫn trông bất thường ngay cả khi proxy đang xoay qua nhiều IP. Vì vậy anh em phải giới hạn concurrency theo từng trang đích, không chỉ dựa vào việc xoay IP.
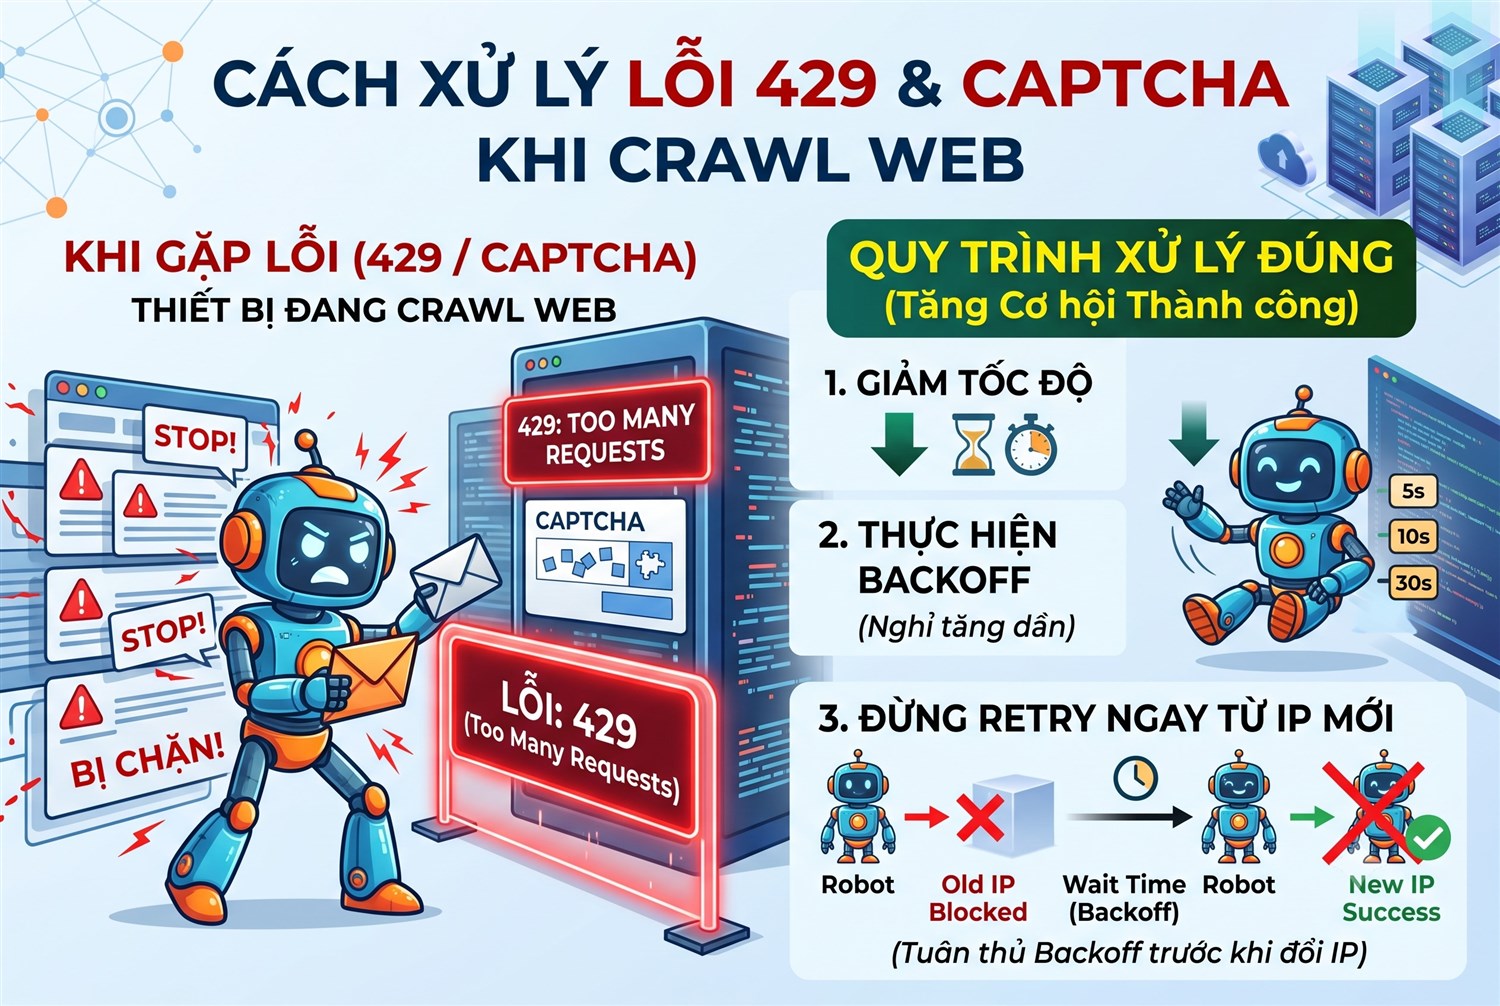
Gặp 429 hoặc captcha: giảm tốc, backoff, đừng retry ngay từ IP mới
Nhắm vị trí khi dùng web scraping proxy là gì cho dữ liệu theo vùng
Nhiều dữ liệu chỉ đúng khi lấy từ đúng vùng. Kết quả tìm kiếm, giá sản phẩm, tồn kho và ưu đãi thường thay đổi theo quốc gia hoặc thành phố. GroupBWT dẫn một tình huống doanh nghiệp du lịch cần dữ liệu giá theo thời gian thực trên nhiều vùng và nhiều nền tảng, và giải pháp là trộn pool theo từng mục tiêu với chính sách riêng cho từng nguồn.
Về mặt cấu hình, anh em thường thêm tham số quốc gia hoặc thành phố vào phần username của proxy để gateway chỉ chọn IP trong vùng đó. Với dữ liệu cần độ chính xác cao theo vùng, nên tách riêng luồng cào cho từng vùng và ghi log rõ IP nào phục vụ vùng nào để về sau truy vết được nguồn của mỗi bản ghi.
Một lỗi hay gặp là nhắm vị trí không khớp với các tín hiệu khác. Nếu IP ở Nhật nhưng ngôn ngữ trình duyệt để tiếng Anh Mỹ và múi giờ để Việt Nam, trang đích có thể trả về nội dung không nhất quán hoặc nghi ngờ. Khi nhắm vùng, nên đồng bộ cả header ngôn ngữ, múi giờ và các tham số vùng của request cho khớp với vị trí IP.
Web scraping proxy là gì thì cũng không phải là đủ
Xoay proxy là cần nhưng chưa đủ. Các nguồn về scraping đều thống nhất anh em vẫn phải xử lý các tín hiệu chống bot khác gồm vân tay trình duyệt và mẫu hành vi.
Cụ thể, request nên xoay cả user-agent và các header cho khớp một trình duyệt thật, tránh gửi cùng một bộ header cho mọi request. Khi dùng trình duyệt không đầu để cào các trang nặng JavaScript, cần che các dấu hiệu tự động hóa và giữ vân tay nhất quán trong một phiên. Hành vi cũng cần tự nhiên: có khoảng nghỉ giữa các thao tác, không tải trang với tốc độ máy. Cách gắn proxy vào trình duyệt không đầu xem cách sử dụng proxy trong Puppeteer.
Giám sát và vận hành web scraping proxy ở quy mô
GroupBWT khuyến nghị dựng bảng theo dõi với các chỉ số nền: tỉ lệ thành công theo từng mục tiêu, phân bố lỗi 4xx và 5xx theo endpoint, tần suất gặp thử thách, độ trễ theo vùng và theo loại pool, và chi phí trên mỗi bản ghi thu được thành công.
Dựa vào các chỉ số này, anh em loại bỏ các IP đã bị đốt và ưu tiên các IP đang chạy tốt. Một vòng phản hồi đơn giản: mỗi IP có một điểm số, tăng khi trả về 200 và giảm mạnh khi trả về 403 hoặc captcha; IP tụt dưới ngưỡng thì tạm nghỉ một thời gian rồi thử lại, nếu vẫn kém thì loại hẳn.
Khi vận hành nhiều luồng cào song song, chạy chúng trong container giúp cô lập cấu hình proxy, giới hạn tài nguyên và dễ mở rộng theo chiều ngang; cách cấu hình proxy ở mức container xem proxy cho Docker. GroupBWT cũng xếp việc quan sát yếu và tìm nguyên nhân chậm vào nhóm lỗi thường gặp khi tự làm, nên đầu tư cho hạ tầng giám sát là xứng đáng.
Đoạn dưới là ví dụ triển khai chuẩn cho vòng xoay proxy kèm thử lại có giới hạn, không phải trích từ nguồn tham khảo:
import random, time, requests

POOL = ["http://user:pass@gw:8000"]  # thêm nhiều endpoint

def fetch(url, tries=3):
    for i in range(tries):
        proxy = random.choice(POOL)
        try:
            r = requests.get(url, proxies={"http": proxy, "https": proxy}, timeout=20)
            if r.status_code == 429:
                time.sleep(2 ** i)          # backoff theo hàm mũ
                continue
            r.raise_for_status()
            return r
        except requests.RequestException:
            time.sleep(2 ** i)
    return None
Nguyên tắc và ranh giới khi cào dữ liệu
GroupBWT nhấn mạnh một câu đáng nhớ: khả năng kỹ thuật không đồng nghĩa với quyền được làm. Anh em nên phân loại mục tiêu thành ba nhóm: nội dung công khai không phòng thủ, nội dung cần đăng nhập hoặc trả phí, và dữ liệu có thông tin cá nhân.
- Ưu tiên thu thập dữ liệu công khai, tôn trọng robots.txt khi phù hợp bối cảnh dự án.
- Đặt delay hợp lý, giới hạn concurrency để không gây quá tải trang đích.
- Thận trọng với dữ liệu cá nhân, tuân thủ quy định về quyền riêng tư.
- Tách rõ khâu thu thập và khâu lưu trữ, ghi log để truy vết mỗi bản ghi về nguồn và cách lấy.
Proxy giúp anh em cào dữ liệu ổn định hơn, nhưng không thay đổi việc dữ liệu nào được phép lấy. Chuẩn bị phần ranh giới trước khi mở rộng quy mô luôn rẻ hơn xử lý hậu quả về sau.
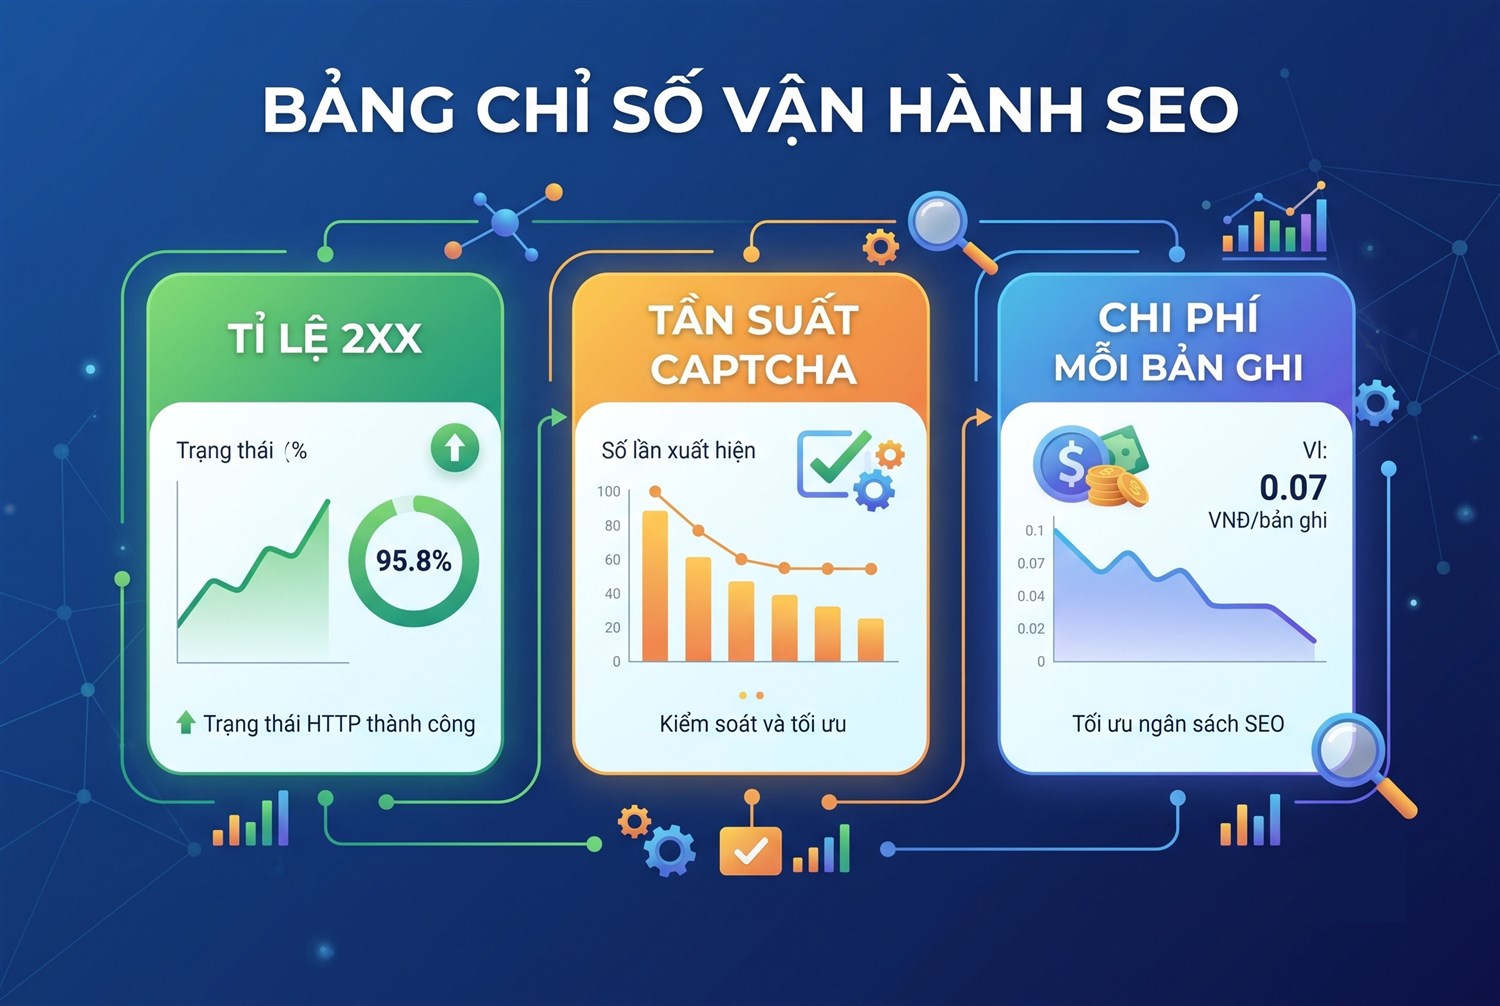
Bảng chỉ số vận hành: tỉ lệ 2xx, tần suất captcha, chi phí mỗi bản ghi
Với web scraping, ProxyVN có sẵn proxy dân cư tĩnh share và private, datacenter dùng riêng, Share1, Share3 và proxy US; anh em mua proxy giá rẻ theo ngày, thuê càng dài giá càng tốt.
Xem thêm:
- Proxy Pool là gì? Cách chia proxy cho crawling, SEO và tài khoản
- Proxy Scraping Google Là Gì? Giải đáp chi tiết
Giải đáp nhanh về web scraping proxy là gì
Vài câu hỏi thường gặp khi anh em mới tìm hiểu web scraping proxy là gì và bắt đầu triển khai.
Cào dữ liệu ít có cần proxy không?
Với vài trăm request tới site không phòng thủ thì có thể chưa cần. Khi lên vài nghìn request mỗi ngày hoặc gặp site có chống bot, proxy xoay gần như bắt buộc.
Nên dùng proxy datacenter hay residential để cào?
Bắt đầu bằng datacenter vì rẻ và nhanh. Chuyển sang residential khi đo được rằng danh tiếng IP hoặc phân loại mạng đang khiến anh em không lấy được trang cần lấy.
Vì sao xoay IP mà vẫn bị chặn?
Thường do quá nhiều luồng song song tới một host, hoặc do vân tay trình duyệt và hành vi vẫn giống nhau qua các request. Phải giới hạn concurrency và xử lý cả các tín hiệu ngoài IP.
Sticky session dùng khi nào trong scraping?
Khi một tác vụ cần nhiều request tới cùng site trong một phiên, ví dụ đăng nhập rồi lấy dữ liệu. Xoay IP giữa các request trong phiên sẽ bị coi là bất thường.
Tóm lại, web scraping proxy là gì có thể trả lời gọn: lớp proxy trải request qua một pool IP để né giới hạn tần suất, captcha và chặn IP khi cào dữ liệu ở quy mô. Chọn datacenter trước, nâng lên residential hoặc mobile theo độ khó của mục tiêu, dùng sticky session cho luồng nhiều bước, và luôn xử lý cả vân tay lẫn hành vi. Nếu anh em cần proxy cào dữ liệu ổn định, IP sạch, hãy liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


