
Scrapy DeltaFetch crawl tăng dần: khóa item và reset
Scrapy DeltaFetch crawl tăng dần là cách dùng middleware scrapy-deltafetch để lần chạy sau chỉ lấy item mới, bỏ qua những trang đã từng cho ra item ở các lần chạy trước. Ý tưởng đơn giản và tiết kiệm request, nhưng nó lọc theo request chứ không theo nội dung item, nên rất dễ bỏ sót dữ liệu đã đổi. ProxyVN chạy thử ngày 03/11/2026 với Scrapy 2.19.0 và scrapy-deltafetch 2.1.0 trên một catalog giả lập, qua ba lượt chạy và ba kiểu spider, để xem cụ thể item nào được lấy, item nào bị bỏ.
Scrapy DeltaFetch crawl tăng dần: mục tiêu và phạm vi không lặp
Phần đầu chốt bài toán, đầu ra và ranh giới với các cơ chế gần giống.
Bài toán
Một website catalog có vài nghìn sản phẩm, mỗi ngày thêm vài chục sản phẩm mới. Crawl lại toàn bộ mỗi ngày tốn request cho cả hai bên. Đội dữ liệu chỉ muốn lấy phần mới. DeltaFetch hứa làm đúng việc đó bằng cách nhớ những trang đã cho ra item.
Câu hỏi bài này trả lời: nhớ theo cái gì, quên lúc nào, và bỏ sót những gì.
Đầu ra nghiệm thu
Đầu ra là kết quả hai lần crawl trên cùng website: lần một với dữ liệu gốc, lần hai sau khi website thêm ba sản phẩm và đổi giá một sản phẩm. Kèm theo là khóa định danh đã dùng cho mỗi kiểu spider, số request tiết kiệm được, danh sách item bị bỏ sót và quy trình reset trạng thái có chủ đích.
Khác JOBDIR ở đâu
JOBDIR lưu hàng đợi để một job dở chạy tiếp. Khi job xong, trạng thái JOBDIR không còn ý nghĩa. DeltaFetch thì ngược lại: trạng thái của nó có giá trị chính là sau khi job xong, để job hôm sau biết bỏ qua gì.
Hai cơ chế có thể dùng cùng nhau nhưng giải hai bài toán khác nhau. Bài này chỉ nói DeltaFetch và không lặp lại cấu hình proxy hay retry trong bài Scrapy proxy.
Nguồn kiểm chứng
Mã nguồn và README của plugin nằm ở kho scrapy-plugins/scrapy-deltafetch. Bản trên PyPI ngày chạy lab là 2.1.0. Hành vi lọc được đọc trực tiếp từ tệp middleware.py trong bản này và xác nhận bằng lab.
Ai nên đọc
Người chạy crawler định kỳ và muốn giảm request. Người đã bật DeltaFetch và thấy số item mới mỗi ngày ít bất thường. Người cần giải thích cho đội dữ liệu vì sao giá trong kho không khớp với website.
Lọc item đã thấy bằng Scrapy DeltaFetch crawl tăng dần qua nhiều lần chạy
Phần này giải thích DeltaFetch nhớ gì và lọc ở đâu.
Middleware nằm ở tầng spider
DeltaFetch là spider middleware. Nó đứng giữa spider và engine, nhìn mọi thứ spider trả ra sau khi xử lý một response. Thứ trả ra có hai loại: item và request mới.
Khi thấy item, middleware ghi khóa của request đã tạo ra response đó vào cơ sở dữ liệu. Khi thấy request mới, middleware tính khóa của request đó. Nếu khóa đã có trong cơ sở dữ liệu, request bị bỏ, không bao giờ tới downloader.
Khóa mặc định là dấu vân tay request
Khóa request, không phải nội dung
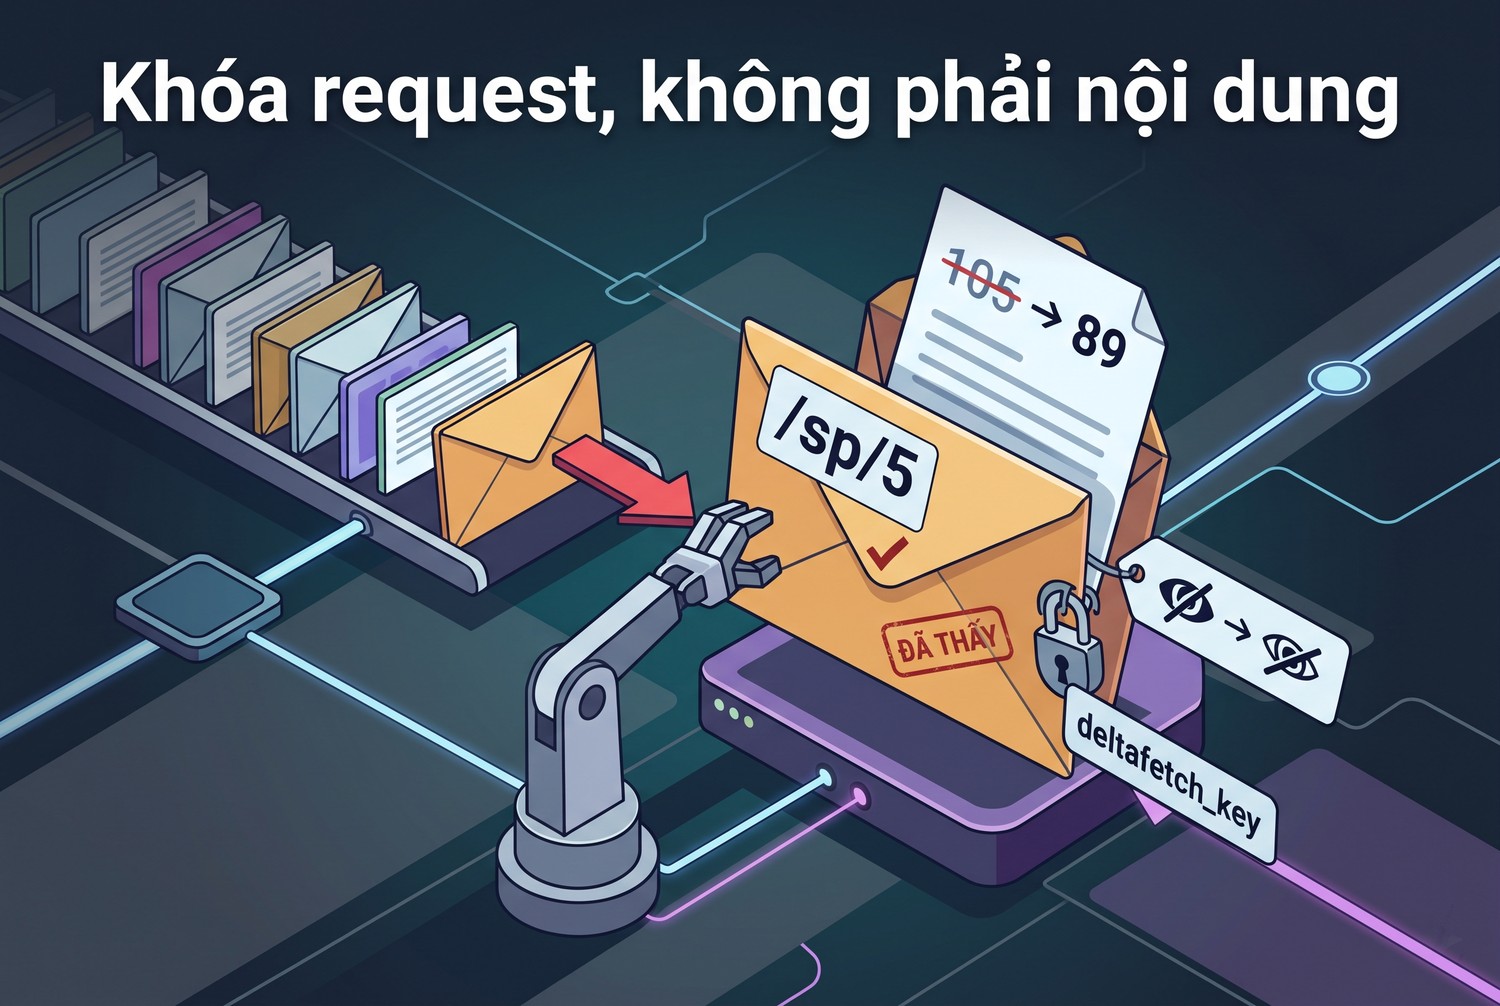
Khóa mặc định là dấu vân tay request do Scrapy tính, gồm phương thức, URL chuẩn hóa và thân. Không có gì về nội dung trang. Trang /sp/5 đã cho ra item một lần thì lần sau mọi request tới /sp/5 đều bị bỏ, dù giá trên trang đã đổi.
Có thể đặt khóa riêng qua request.meta với tên deltafetch_key. Đây là cửa duy nhất để đưa thông tin nội dung vào quyết định lọc.
Trang không cho item thì không bao giờ bị lọc
Trang danh sách chỉ trả request tới trang chi tiết, không trả item. Khóa của nó không bao giờ được ghi. Mỗi lần chạy, trang danh sách luôn được tải lại, và đó chính là điều cần: trang danh sách là nơi sản phẩm mới xuất hiện.
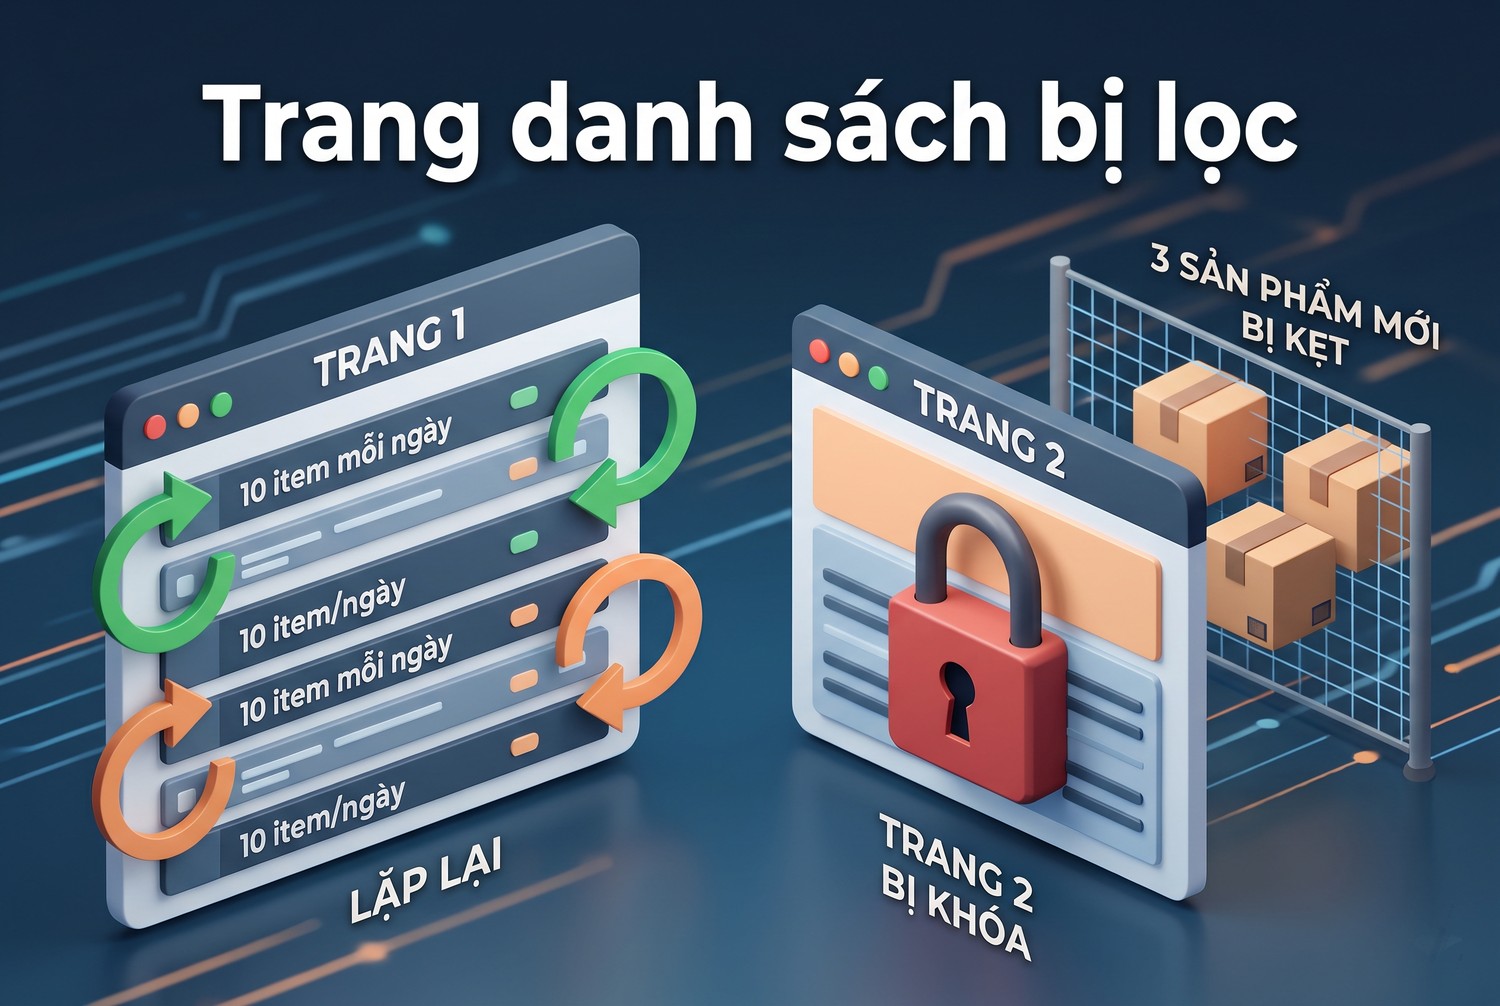
Ngược lại, nếu trang danh sách trả item, khóa của nó được ghi. Lần sau trang danh sách đó bị bỏ, kéo theo mọi sản phẩm mới trên trang. Lab có một kịch bản riêng cho lỗi này.
Request khởi đầu không đi qua bộ lọc
Request trong start_urls không phải là thứ spider trả ra từ một response, nên không đi qua hàm lọc. Trang đầu tiên luôn được tải, kể cả khi đã cho ra item ở lần trước. Chi tiết nhỏ này gây ra hành vi lạ trong kịch bản trang danh sách trả item.
Giá trị lưu là thời điểm ghi
Mỗi khóa trong cơ sở dữ liệu có giá trị là thời điểm ghi, dạng chuỗi số giây từ time.time(). Bản 2.1.0 không dùng giá trị này để làm gì, chỉ kiểm khóa có hay không. Nhưng nó mở ra một cách hết hạn khóa đơn giản.
TTL = 7 * 86400
def _seen_recent(self, key):
    v = self.db.get(key)
    return v is not None and time.time() - float(v) < TTL
Thay điều kiện key in self.db bằng hàm này trong lớp bọc, khóa cũ hơn bảy ngày sẽ được coi là chưa thấy. Mỗi trang chi tiết được tải lại ít nhất một lần mỗi tuần, không cần reset toàn bộ. Đây là đề xuất, lab chưa chạy lớp bọc có TTL.
Spider có nhiều trang chi tiết
Một sản phẩm có thể có trang chính và trang đánh giá phân trang. Nếu item được trả ở trang chính, khóa trang chính được ghi, còn trang đánh giá không có item nên không bao giờ bị lọc. Lần sau trang chính bị bỏ, nhưng request tới trang đánh giá chỉ sinh ra từ trang chính, nên cũng không còn.
Nếu đánh giá mới là dữ liệu quan trọng, phải tách thành job riêng hoặc tắt lọc cho trang chính bằng deltafetch_enabled.
Cơ sở dữ liệu là dbm
Plugin bản 2.1.0 dùng module dbm của Python, mỗi spider một tệp tên theo spider.name trong DELTAFETCH_DIR. Trên máy Windows của lab, dbm rơi về dbm.dumb, tạo ba tệp .bak, .dat và .dir. Trên Linux có thể là gdbm hay ndbm với định dạng khác.
Vì định dạng phụ thuộc hệ thống, không nên chép thư mục trạng thái từ máy Windows sang máy Linux rồi mong nó đọc được. Code middleware có nhánh: mở lỗi thì xóa và tạo mới, tức là trạng thái mất trong im lặng.
Chọn khóa item thay vì nhầm khóa URL hoặc session proxy trong Scrapy DeltaFetch crawl tăng dần
Khóa quyết định mọi thứ. Phần này nói cách chọn.
Khóa URL nhớ trang, không nhớ dữ liệu
Khóa mặc định trả lời câu hỏi đã từng tải trang này và có item chưa. Nó không trả lời dữ liệu trên trang có đổi không. Với website mà item không đổi sau khi đăng, như bài báo hay hồ sơ công ty đã đóng, khóa mặc định là đủ.
Với website mà item đổi theo thời gian, như giá, tồn kho, trạng thái tuyển dụng, khóa mặc định sẽ giữ bản đầu tiên mãi mãi.
Khóa có dấu thời gian cập nhật
Nhiều website ghi ngày cập nhật ngay trên trang danh sách, hay có trong sitemap với lastmod. Nếu đưa ngày đó vào khóa, ví dụ sp:5:2026-11-03, thì khi website cập nhật sản phẩm, khóa đổi và DeltaFetch cho request đi qua.
Khóa phải tạo được từ thông tin có trước khi tải trang chi tiết. Đó là lý do khóa này lấy từ thuộc tính data-upd trên trang danh sách, không phải từ trang chi tiết.
Đừng đưa thông tin phiên vào khóa
Một lỗi hay gặp là ghép tham số phiên hay tham số theo dõi vào URL, như sid hay utm. Mỗi lần chạy URL khác nhau, dấu vân tay khác nhau, DeltaFetch không lọc được gì. Kết quả giống như không bật plugin.
Khóa cũng không nên chứa thông tin của proxy hay IP thoát. Đổi proxy không làm sản phẩm thành sản phẩm mới. Nếu middleware proxy chèn tham số vào URL, cần bỏ tham số đó trước khi tính khóa.
Khóa và id trong kho dữ liệu nên khớp nhau
Kho dữ liệu đích thường có khóa chính là id sản phẩm. Khóa DeltaFetch nên bắt đầu bằng cùng id đó. Khi cần tra một sản phẩm vì sao không được cập nhật, có thể tìm ngay trong cơ sở dữ liệu của DeltaFetch.
Tắt lọc cho request cụ thể
Đặt deltafetch_enabled bằng False trong meta để một request luôn đi qua. Dùng cho các trang cần tải lại mọi lần dù có item, ví dụ trang khuyến mãi trong ngày. Dùng ít, vì mỗi trang như vậy là một request không được tiết kiệm.
Bật middleware và thư mục state theo bản plugin cho Scrapy DeltaFetch crawl tăng dần
Phần này ghi lại điều đầu tiên lab gặp phải: plugin không chạy.
Lỗi khi bật với Scrapy 2.19
Cài scrapy-deltafetch 2.1.0 cùng Scrapy 2.19.0, bật middleware theo README, spider dừng ngay khi khởi động. Không có request nào được gửi. Log có dòng TypeError: Middleware scrapy_deltafetch.middleware.DeltaFetch doesn't support asynchronous spider output.
Thông báo nói rõ cách sửa: phương thức process_spider_output phải là hàm sinh bất đồng bộ, hoặc middleware phải có thêm process_spider_output_async. Bản 2.1.0 chỉ có hàm đồng bộ.
Vì sao lỗi không hiện rõ
Khi chạy bằng scrapy runspider với -O, lệnh vẫn kết thúc và để lại tệp kết quả rỗng hoặc không có tệp. Nếu chỉ nhìn tệp kết quả, dễ tưởng website trống. Script lab ban đầu in ra 0 item cho mọi kịch bản, phải đọc log mới thấy TypeError.
Bài học: job định kỳ cần kiểm số item tối thiểu và báo động khi bằng 0, không chỉ kiểm mã thoát.
Nâng cấp Scrapy cũng là lúc dễ vấp lỗi này nhất. Một job đã chạy ổn nhiều tháng có thể ngừng lấy dữ liệu ngay sau lệnh pip install -U. Ghim phiên bản trong tệp requirements và chạy thử hai lượt trên máy thử trước khi nâng cấp máy chạy thật là cách tránh bị bất ngờ.
Lớp bọc tối thiểu
from scrapy.http import Request
from scrapy_deltafetch import DeltaFetch
import time

class DeltaFetchAsync(DeltaFetch):
    async def process_spider_output_async(self, response, result, spider=None):
        async for r in result:
            if isinstance(r, Request):
                key = self._get_key(r)
                if key in self.db and self._is_enabled_for_request(r):
                    self.stats.inc_value("deltafetch/skipped")
                    continue
            else:
                self.db[self._get_key(response.request)] = str(time.time())
                self.stats.inc_value("deltafetch/stored")
            yield r
Lớp bọc kế thừa DeltaFetch và thêm phương thức async giữ nguyên logic lọc. Với lớp này, Scrapy 2.19 chạy bình thường. Mọi số liệu lab bên dưới dùng lớp bọc.
Lựa chọn khác
Nếu không muốn tự bảo trì lớp bọc, có hai hướng. Một là ghim Scrapy ở phiên bản cũ hơn mà plugin còn chạy. Hướng này kéo theo việc không nhận bản vá bảo mật của Scrapy. Hai là theo dõi kho plugin để chờ bản chính thức hỗ trợ async.
Mình chưa thử phiên bản Scrapy cũ nào để xác định mốc chính xác plugin ngừng chạy, nên không ghi số phiên bản ở đây.
Nhiều tiến trình cùng một spider
Tệp cơ sở dữ liệu đặt theo spider.name. Nếu chạy hai tiến trình cùng spider song song, ví dụ chia theo danh mục, cả hai mở cùng tệp. dbm.dumb không có khóa ghi giữa các tiến trình, nên dữ liệu có thể hỏng. Mình chưa thử trường hợp này trong lab.
Cách an toàn là mỗi tiến trình một DELTAFETCH_DIR, hoặc đặt tên spider khác nhau theo danh mục. Khi đó mỗi phần có trạng thái riêng, đối soát cũng tách được.
Thử hai lượt trước khi lên lịch
Trước khi đưa job có DeltaFetch vào lịch hằng ngày, chạy hai lượt liền trên chính website: lượt một để ghi trạng thái, lượt hai ngay sau đó. Lượt hai phải cho 0 item mới và số request chỉ bằng số trang danh sách. Nếu lượt hai vẫn lấy nhiều item, khóa đang không ổn định, thường do tham số thay đổi trong URL.
Cấu hình trong lab
custom_settings = {
    "SPIDER_MIDDLEWARES": {"deltafix.DeltaFetchAsync": 100},
    "DELTAFETCH_ENABLED": True,
    "DELTAFETCH_DIR": os.path.abspath("state"),
}
DELTAFETCH_DIR nên là đường dẫn đầy đủ. Đường dẫn tương đối được giải theo thư mục dữ liệu của dự án Scrapy, chỗ này dễ đổi khi chạy từ thư mục khác.
Chạy hai lượt với item cũ, mới và đã đổi nội dung bằng Scrapy DeltaFetch crawl tăng dần
Phần này là kết quả chính.
Website giả lập
Máy chủ http.server ở 127.0.0.1 cổng 9841. Phiên bản một có 20 sản phẩm id 0 đến 19 trên hai trang danh sách. Phiên bản hai thêm id 20, 21, 22 vào trang danh sách thứ hai và đổi giá sản phẩm id 5 từ 105 xuống 89, ngày cập nhật đổi từ 2026-11-01 thành 2026-11-03.
Ba kiểu spider được thử. Kiểu detail vào trang chi tiết lấy item, khóa mặc định. Kiểu listyield lấy item ngay trên trang danh sách. Kiểu key_upd vào trang chi tiết nhưng đặt deltafetch_key gồm id và ngày cập nhật.
Bảng kết quả
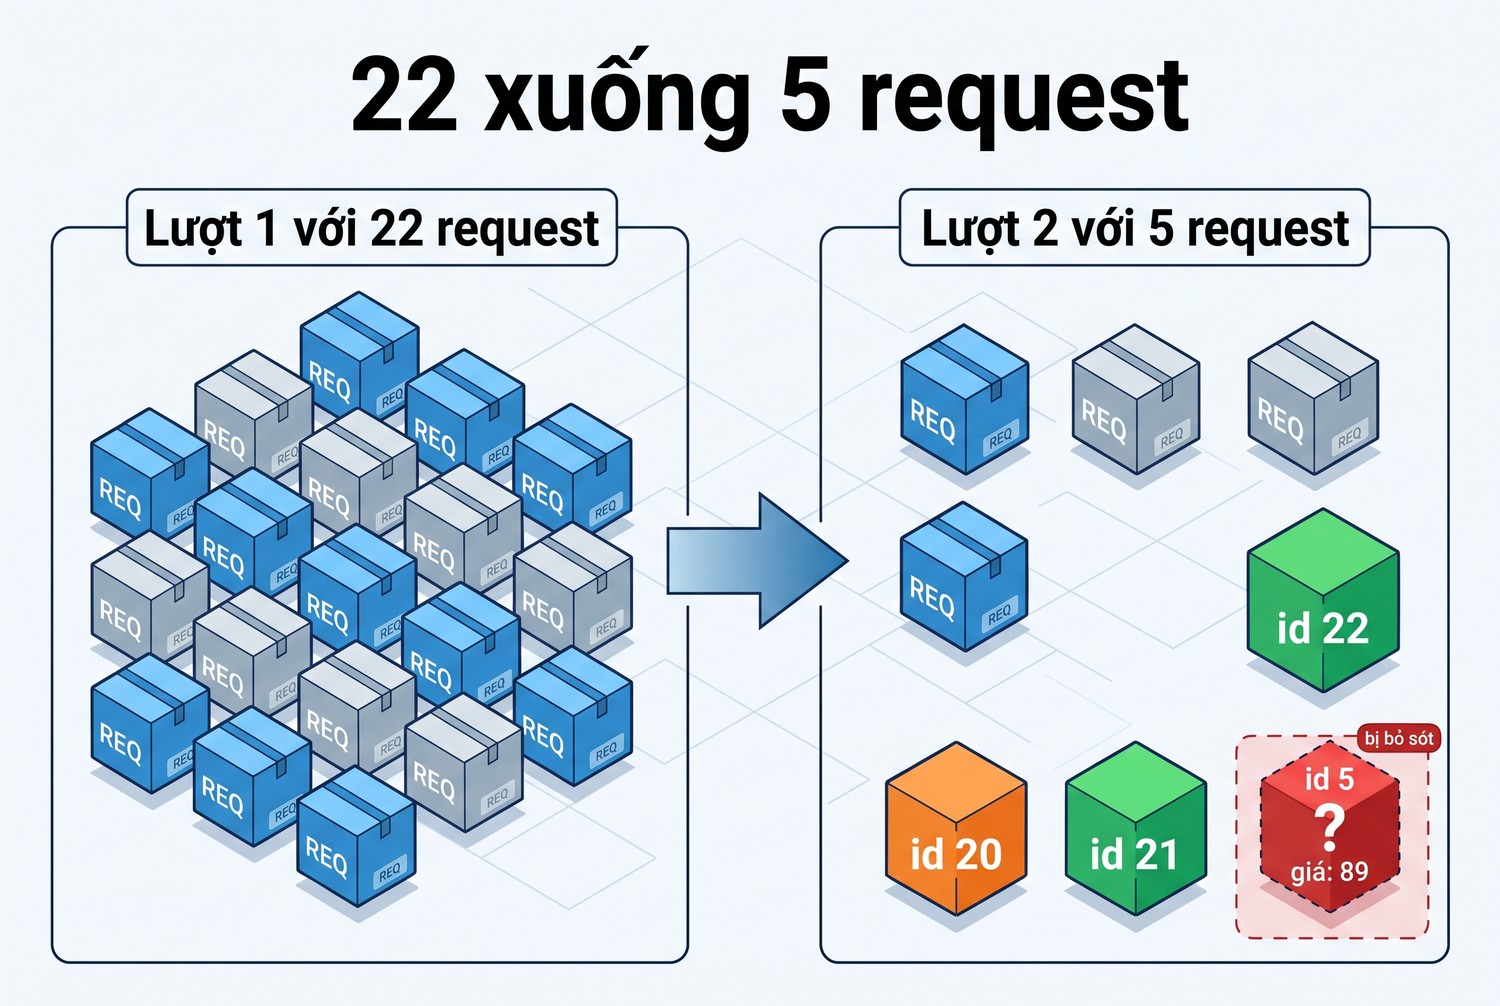
22 xuống 5 request
Kiểu spider |
Lượt 1 (bản 1) |
Lượt 2 (bản 2) |
Lượt 3 (bản 2) |
Giá id 5 lấy được |
|---|---|---|---|---|
detail, khóa mặc định |
20 item, 22 request |
3 item mới, 5 request |
0 item, 2 request |
Chỉ 105, bỏ sót 89 |
listyield |
20 item, 2 request |
10 item id 0 đến 9, 1 request |
10 item id 0 đến 9, 1 request |
89, nhưng mất id 10 đến 22 |
key_upd, khóa id cộng ngày |
20 item, 22 request |
4 item: id 5, 20, 21, 22 |
0 item, 2 request |
105 rồi 89 |
Kiểu detail: tiết kiệm nhưng bỏ sót thay đổi
Lượt hai chỉ tải 3 trang chi tiết mới và 2 trang danh sách, bỏ qua 20 trang chi tiết cũ. Số request giảm từ 22 xuống 5. Ba sản phẩm mới về đủ.
Nhưng giá mới của id 5 không bao giờ về. Trong kho, id 5 vẫn là 105. Lượt ba cũng vậy. Nếu không có cơ chế khác, giá sai này sẽ nằm đó tới khi reset.
Kiểu listyield: hỏng theo cách khó đoán
Trang danh sách bị lọc
Lượt một lấy 20 item từ hai trang danh sách, ghi khóa cả hai trang. Lượt hai, trang 1 là start_url nên vẫn được tải và cho lại 10 item id 0 đến 9. Trang 2 là request do spider trả ra, khóa đã có, nên bị bỏ.
Kết quả là ba sản phẩm mới nằm trên trang 2 bị mất. Đồng thời 10 item trang 1 bị ghi lại lần nữa mỗi ngày. Id 5 có giá mới 89 chỉ vì tình cờ nằm trên trang 1. Kiểu spider này không nên dùng với DeltaFetch.
Kiểu key_upd: đúng ý
Lượt hai lấy 3 sản phẩm mới và id 5 với giá 89, tổng 4 item, bỏ qua 19 trang chi tiết không đổi. Lượt ba không lấy gì vì không có thay đổi. Đây là hành vi đúng với bài toán crawl tăng dần.
Giới hạn: cách này dựa vào ngày cập nhật do website công bố. Nếu website đổi giá mà không đổi ngày, khóa vẫn giống cũ và thay đổi bị bỏ sót.
Khóa theo băm nội dung trang danh sách
Khi website không công bố ngày cập nhật, có thể băm phần dữ liệu ngắn hiển thị trên trang danh sách: tên, giá, nhãn tồn kho. Đưa mã băm này vào deltafetch_key. Đổi giá trên danh sách thì khóa đổi, trang chi tiết được tải lại.
Cách này chỉ bắt được thay đổi hiện ra ở trang danh sách. Mô tả hay thông số trên trang chi tiết đổi thì vẫn bỏ sót. Với nội dung dài có phần thay đổi nhỏ không đáng kể, bài SimHash chống trùng nội dung crawl có cách so gần đúng thay vì băm chính xác.
Đọc thống kê deltafetch
Scrapy in hai chỉ số deltafetch/stored và deltafetch/skipped. Lượt hai kiểu detail ghi skipped 20, stored 3. Kiểu key_upd ghi skipped 19, stored 4. So hai con số này với số sản phẩm mới kỳ vọng từ trang danh sách là bước kiểm nhanh nhất.
Reset state có chủ đích và đối soát item bị bỏ nhầm trong Scrapy DeltaFetch crawl tăng dần
Phần này nói cách xóa trạng thái và cách phát hiện item bị bỏ nhầm.
Hai cách reset
Đặt setting DELTAFETCH_RESET bằng 1, hoặc truyền tham số spider deltafetch_reset bằng 1. Cả hai đều mở cơ sở dữ liệu ở chế độ tạo mới. Lab chạy cả hai với bản 2: mỗi cách cho đủ 23 item, 25 request. Lượt kế tiếp không reset cho 0 item, nghĩa là trạng thái mới đã được ghi.
scrapy crawl catalog -s DELTAFETCH_RESET=1
scrapy crawl catalog -a deltafetch_reset=1
Khi nào reset
Reset theo lịch, ví dụ mỗi chủ nhật, để kéo lại toàn bộ dữ liệu và sửa các thay đổi bị bỏ sót trong tuần. Reset khi đổi cách tính khóa, vì khóa cũ không còn ý nghĩa. Reset khi phát hiện tỷ lệ item mới bằng 0 nhiều ngày liền mà website vẫn cập nhật.
Không reset khi chỉ đổi logic trích xuất. Khi đó tốt hơn là chạy một job riêng không bật DeltaFetch để lấy lại dữ liệu, giữ nguyên trạng thái cho job hằng ngày.
Reset là quyết định có ghi nhận
Mỗi lần reset làm số request tăng vọt và đổ vào kho một loạt item đã có. Ghi vào nhật ký vận hành: ai reset, lúc nào, lý do. Kho dữ liệu phải sẵn sàng upsert theo id để không tạo bản ghi trùng.
Nên sao lưu thư mục trạng thái trước khi reset. Nếu reset nhầm, chép lại là xong, không phải chờ một vòng crawl đầy đủ.
Đối soát item bị bỏ nhầm
Cách đối soát rẻ là chạy song song một mẫu nhỏ không bật DeltaFetch, ví dụ 50 sản phẩm ngẫu nhiên mỗi ngày. So giá trị trong mẫu với giá trị trong kho. Mỗi sản phẩm lệch là một trường hợp DeltaFetch đã bỏ sót thay đổi.
Tỷ lệ lệch cho biết khóa có đủ tốt không. Lệch gần 0 thì giữ. Lệch cao thì phải thêm thông tin vào khóa hay rút ngắn chu kỳ reset.
Đối soát sản phẩm mới
Trang danh sách luôn được tải, nên có thể đếm số id xuất hiện trên trang danh sách mà chưa có trong kho. Con số này phải bằng deltafetch/stored của trang chi tiết. Nếu stored nhỏ hơn, có sản phẩm mới bị lọc nhầm, thường do URL trùng với sản phẩm cũ đã bị gỡ.
Sản phẩm bị gỡ
DeltaFetch không biết sản phẩm nào đã biến mất. Trang danh sách không còn link thì không có request, không có gì để lọc. Muốn đánh dấu sản phẩm đã gỡ, so tập id trên trang danh sách với tập id trong kho sau mỗi lượt.
Đầu ra nghiệm thu: hai lần crawl item mới và cũ, khóa định danh và reset với Scrapy DeltaFetch crawl tăng dần
Phần cuối gom lại bộ bàn giao và vai trò của proxy.
Bộ bàn giao
Bộ bàn giao gồm bảng hai lượt như bảng trên cho chính website cần crawl, định nghĩa khóa bằng một câu dễ hiểu, lịch reset và lý do, cùng script đối soát mẫu. Ghi rõ phiên bản Scrapy và plugin, kèm lớp bọc nếu dùng.
Người nhận cần biết dữ liệu trong kho có thể cũ tới bao lâu. Với khóa mặc định và reset hằng tuần, giá có thể cũ tới bảy ngày. Con số này phải nằm trong tài liệu bàn giao.
Phương án thay thế
Nếu website có sitemap với lastmod đáng tin, có thể không cần DeltaFetch: đọc sitemap, so lastmod với lần tải trước, chỉ đưa URL đổi vào hàng đợi. Bài lấy tất cả URL của website có cách đọc sitemap.
Nếu website trả ETag hay Last-Modified, request có điều kiện cho câu trả lời chính xác hơn mọi khóa tự chế. Máy chủ trả 304 thì không đổi. Cách này tốn một request mỗi trang nhưng không bỏ sót.
Theo dõi kích thước trạng thái
Mỗi khóa là một dòng trong tệp dbm. Với dbm.dumb, tệp .dat chỉ tăng, không tự thu gọn khi ghi đè khóa. Sau nhiều tháng, tệp có thể lớn hơn nhiều so với số khóa thật. Reset định kỳ cũng là cách dọn tệp.
Theo dõi hai số: kích thước thư mục trạng thái và số khóa. Khi tỷ lệ giữa hai số tăng nhanh, đã tới lúc dọn.
Giám sát job hằng ngày
Mỗi lượt ghi lại ba con số: số item, deltafetch/stored, deltafetch/skipped. Vẽ theo ngày là thấy ngay bất thường: stored về 0 nhiều ngày, skipped tăng vọt, hay tổng request bằng lúc chưa bật plugin. Đặt ngưỡng báo động cho trường hợp stored bằng 0 liên tiếp ba ngày.
Khi DeltaFetch không phải lựa chọn tốt
Website nhỏ vài trăm trang thì tiết kiệm không đáng công bảo trì lớp bọc và lịch reset. Website mà phần lớn item đổi mỗi ngày, như bảng giá vé hay tỷ giá, cũng không hợp: gần như mọi trang đều phải tải lại, DeltaFetch chỉ thêm rủi ro bỏ sót.
DeltaFetch hợp nhất với website lớn, item ít đổi sau khi đăng, và sản phẩm mới luôn xuất hiện ở trang danh sách. Tin tức, tài liệu, hồ sơ doanh nghiệp, tin rao đã đóng là những ví dụ điển hình.
Giới hạn của lab
Lab dùng website giả lập 23 sản phẩm, máy Windows với dbm.dumb. Chưa thử dbm trên Linux, chưa thử hàng trăm nghìn khóa, chưa thử chạy song song nhiều tiến trình ghi cùng tệp dbm. Lớp bọc async là bản tối thiểu viết cho lab, chưa qua kiểm thử của nhà phát triển plugin.
Khi nào cần proxy với Scrapy DeltaFetch crawl tăng dần
DeltaFetch giảm request, nên giảm luôn nhu cầu về IP. Proxy không thay đổi gì trong logic lọc. Proxy cần khi máy chạy crawler phải ra ngoài qua proxy công ty, hoặc khi website yêu cầu IP cố định đã đăng ký.
Nếu dùng proxy, đảm bảo middleware proxy không chèn tham số vào URL, vì như đã nói ở trên, khóa sẽ đổi theo và DeltaFetch mất tác dụng. Chuỗi proxy có xác thực viết theo bài định dạng proxy. Job chạy hằng ngày với số request nhỏ hợp với proxy tĩnh. Anh em cần IP thoát ổn định có thể mua proxy Việt Nam tại trang chủ ProxyVN. Proxy không thay thế quyền truy cập, như bài Web Scraping proxy là gì đã phân tích.
Checklist Scrapy DeltaFetch crawl tăng dần
Checklist DeltaFetch
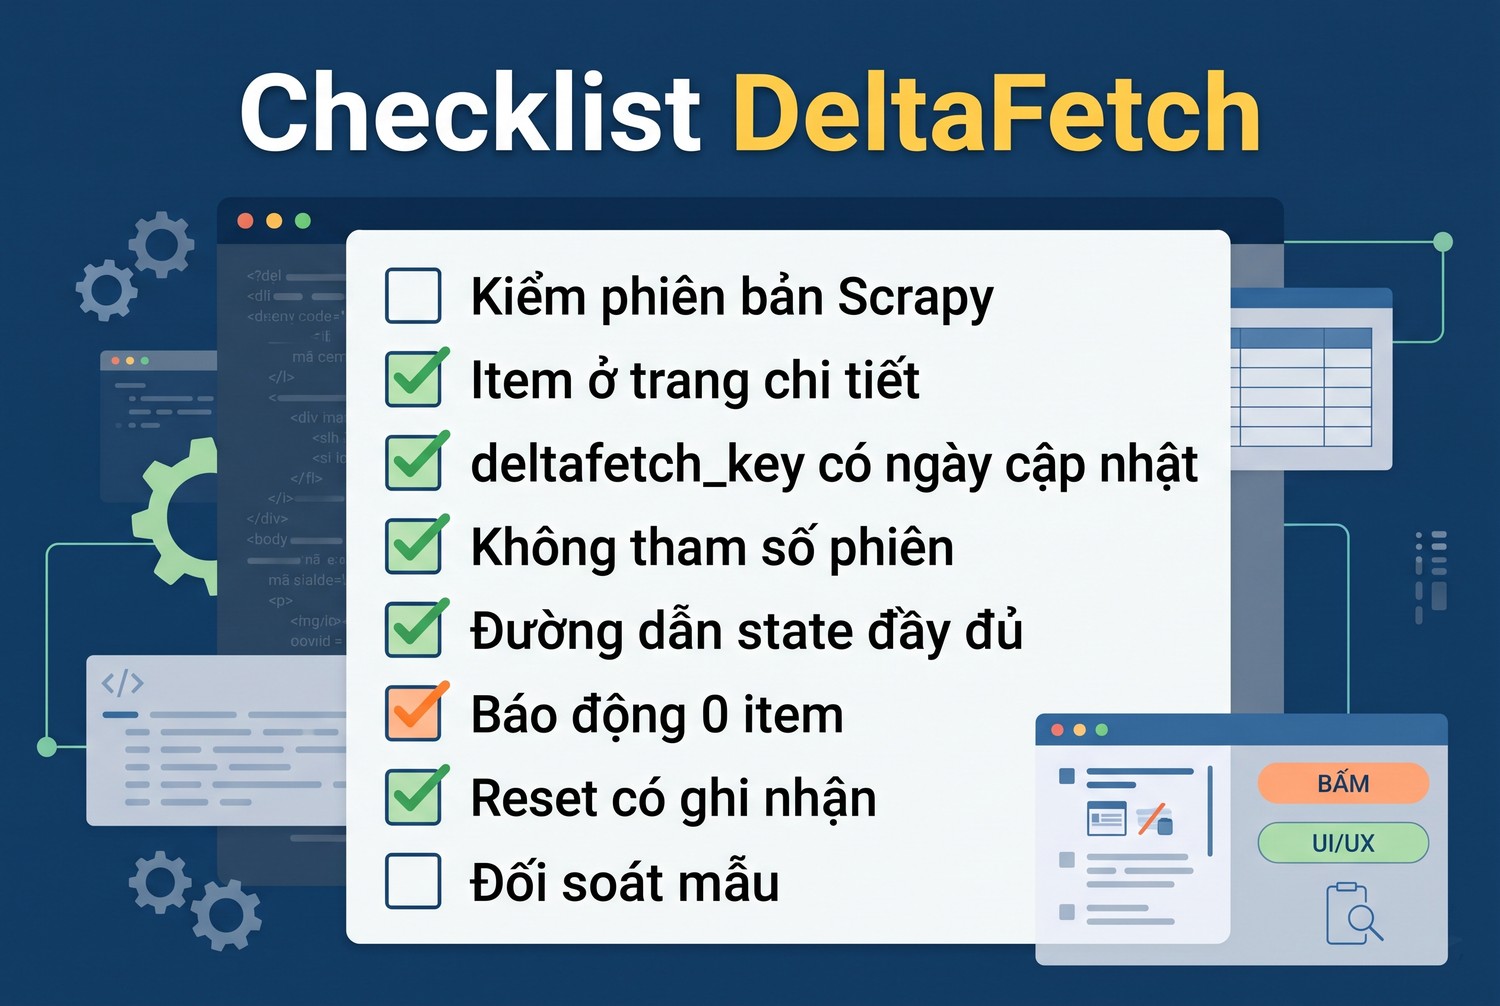
- Kiểm plugin chạy được với phiên bản Scrapy đang dùng, đọc log khi lần đầu bật.
- Lấy item ở trang chi tiết, không lấy ở trang danh sách.
- Đặt deltafetch_key có id và dấu hiệu cập nhật nếu item đổi theo thời gian.
- Không để tham số phiên hay proxy lọt vào khóa.
- DELTAFETCH_DIR là đường dẫn đầy đủ, không chép giữa hệ điều hành.
- Báo động khi số item bằng 0.
- Reset theo lịch, sao lưu trước, ghi nhật ký.
- Đối soát mẫu không lọc để đo tỷ lệ bỏ sót.
Câu hỏi thường gặp về Scrapy DeltaFetch crawl tăng dần
Vì sao bật DeltaFetch xong spider không chạy?
Với Scrapy 2.19 và plugin 2.1.0, middleware báo TypeError vì không hỗ trợ đầu ra async. Cần lớp bọc có process_spider_output_async.
DeltaFetch có biết item đã đổi giá không?
Không, nếu dùng khóa mặc định. Nó nhớ request, không nhớ nội dung. Thêm ngày cập nhật vào deltafetch_key.
Vì sao sản phẩm mới không về?
Thường do spider lấy item ngay trên trang danh sách, làm trang danh sách bị lọc ở lần sau.
Reset bằng cách nào?
DELTAFETCH_RESET=1 trong settings hoặc -a deltafetch_reset=1. Lab xác nhận cả hai.
DeltaFetch khác JOBDIR thế nào?
JOBDIR giúp một job dở chạy tiếp. DeltaFetch giúp job sau bỏ qua phần job trước đã lấy.
Đổi proxy có làm DeltaFetch tải lại không?
Không, trừ khi proxy chèn tham số vào URL làm khóa thay đổi.
Scrapy DeltaFetch crawl tăng dần và những điều cần nhớ
Scrapy DeltaFetch crawl tăng dần giảm request rõ rệt, lab ngày 03/11/2026 cho 22 xuống 5, nhưng với khóa mặc định thì giá đổi không bao giờ về và trang danh sách trả item làm mất sản phẩm mới. Cần lớp bọc async với Scrapy 2.19, khóa có ngày cập nhật, reset theo lịch. Cần IP thoát ổn định cho job Scrapy DeltaFetch crawl tăng dần, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


