
SimHash chống trùng nội dung crawl có bộ mẫu đánh giá
SimHash chống trùng nội dung crawl giúp tìm ứng viên gần giống, nhưng khoảng cách nhỏ không tự chứng minh hai bài có cùng ý nghĩa. Kết quả còn phụ thuộc phần chữ được chọn và cách tạo đặc trưng. Bài này dùng fingerprint có thể tái lập, phân biệt bản sao với sửa nội dung và hướng dẫn chọn ngưỡng bằng nhãn. ProxyVN hướng dẫn cách kiểm trên dữ liệu mẫu.
SimHash chống trùng nội dung crawl khác hash nguyên bản
Hash byte phù hợp để phát hiện hai tệp giống nhau theo dữ liệu đầu vào. Chỉ cần thay một phần nhỏ, hash mật mã thường thay nhiều. SimHash phục vụ một mục tiêu khác: tạo dấu vân tay để các văn bản có đặc trưng gần nhau có cơ hội nằm gần nhau theo khoảng cách bit.
Vì mục tiêu khác, hai loại hash có thể cùng xuất hiện trong pipeline. SHA-256 của HTML giữ dấu vết bản tải; fingerprint của main text giúp tìm ứng viên gần trùng. Không thay hash nguồn bằng SimHash rồi dùng nó làm bằng chứng tệp không bị sửa.
Bài nghiên cứu Detecting near-duplicates for web crawling là nguồn nền tảng cho chủ đề. Ví dụ Python trong bài là bản dạy cách tính đơn giản do người viết xây, không phải tái hiện đầy đủ hệ thống quy mô lớn trong nghiên cứu đó.
Khoảng cách bit cần một hợp đồng đầu vào
Hai số fingerprint chỉ so được khi cùng độ dài, cùng cách tạo đặc trưng và cùng phiên bản chuẩn hóa. Nếu một bản tính trên toàn HTML còn bản kia tính main text, khoảng cách không có cùng ý nghĩa. Metadata phương pháp cần đi kèm giá trị số.
Khoảng cách Hamming đếm số vị trí bit khác nhau. Với số nguyên Python, phép xor rồi bit_count là cách tính thuận tiện cho fingerprint cùng độ dài. Số bit khác nhỏ là tín hiệu ứng viên, chưa phải nhãn biên tập về việc nên xóa một bài.
Một ngưỡng được dùng trong một hệ thống không tự phù hợp với kho dữ liệu khác. Văn bản ngắn, trang sản phẩm và bài tin dài có phân phối đặc trưng khác nhau. Chọn ngưỡng cần dựa trên nhãn và chi phí sai của dự án.
SimHash chống trùng nội dung crawl sau loại boilerplate
Menu, footer và khối đề xuất có thể chiếm nhiều chữ lặp trên các trang. Nếu tính fingerprint trên toàn trang, hai nội dung khác nhau cùng template có thể trở nên gần nhau. Main text phải được chọn và kiểm trước khi đánh giá thuật toán gần trùng.
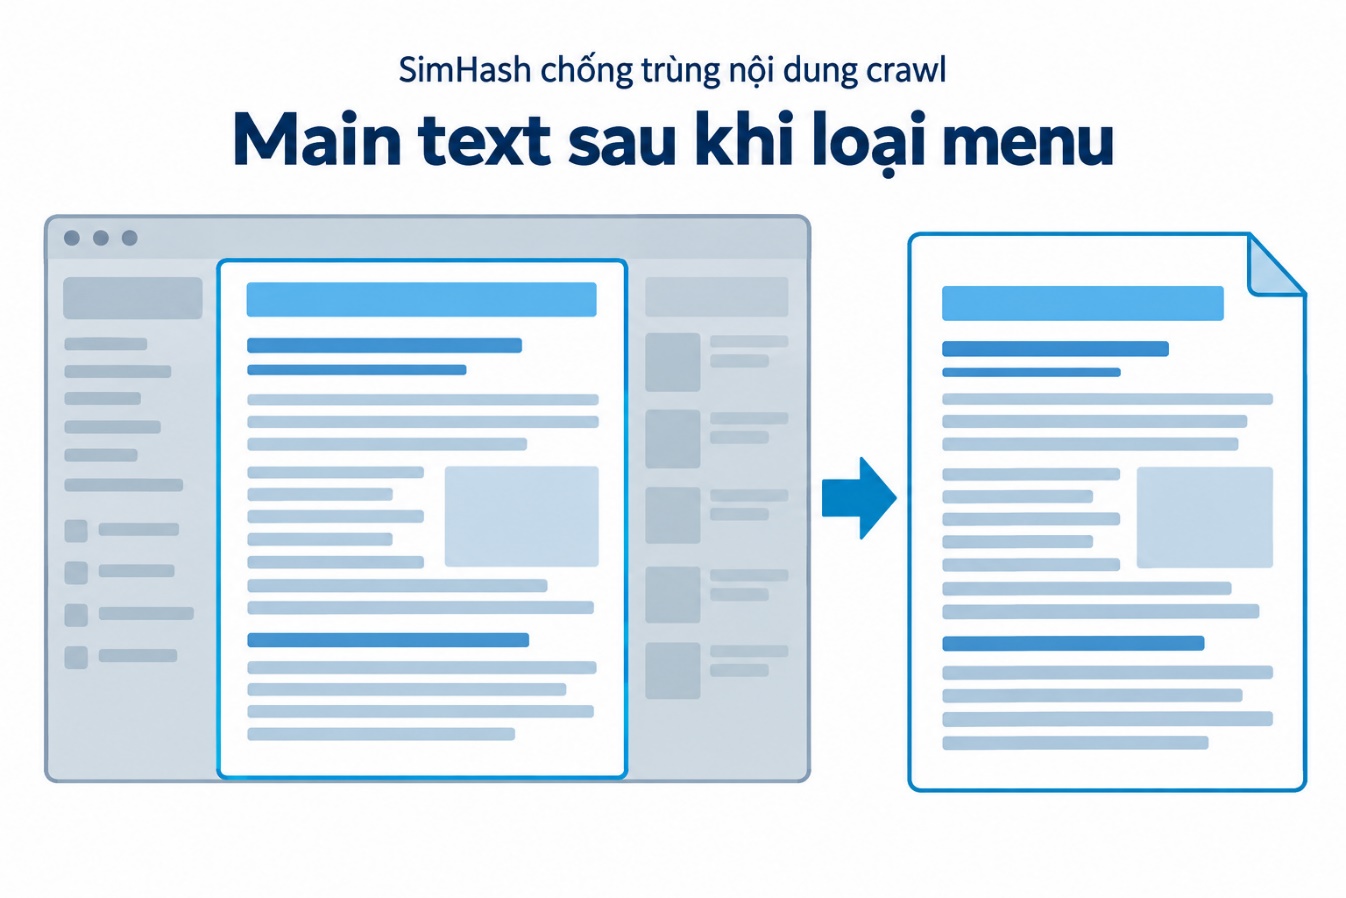
Main text sau khi loại menu
Giữ hai phiên bản để nhìn tác động của bộ trích
Lưu text toàn trang và text đã trích trong bộ mẫu. Tính fingerprint theo từng nhánh với tên phương pháp rõ ràng. Nếu khoảng cách thay đổi sau khi loại menu, anh em có bằng chứng về ảnh hưởng của boilerplate thay vì chỉ suy từ cảm giác hai trang giống.
Một bộ trích main text cũng có thể bỏ nhầm nội dung. Nếu cả hai trang bị trích rỗng hoặc chỉ còn tiêu đề, fingerprint gần nhau không nói gì về toàn bài. Kiểm độ dài và trạng thái trích xuất trước khi đưa vào chỉ mục gần trùng.
Header lặp không phải lúc nào cũng là rác. Trong một bảng giá, tên cột giúp hiểu số liệu; trong bài nghiên cứu, tiêu đề phần có thể quan trọng. Quy tắc loại cần theo tác vụ và có mẫu kiểm, không xóa mọi dòng xuất hiện nhiều lần.
Chuẩn hóa Unicode và khoảng trắng có chủ đích
Các dạng dấu Unicode tương đương có thể tạo token khác nếu chưa chuẩn hóa. NFC là một lựa chọn cần ghi rõ trong phương pháp khi áp dụng. Giữ text gốc để người kiểm biết fingerprint được tính từ bản nào và có thể tính lại khi quy tắc đổi.
Xử lý khoảng trắng thường giúp giảm khác biệt do trình bày. Nhưng bỏ hết dấu câu hoặc chữ số có thể làm mất thông tin quan trọng như giá, phiên bản và ngày. Một quy tắc khiến hai bản khác số tiền trông giống nhau cần được xem lại theo mục tiêu dữ liệu.
Không bỏ dấu tiếng Việt chỉ để tăng số cặp gần nhau. Hai từ khác dấu có thể khác ý nghĩa. Nếu dự án cần tìm kiếm không dấu, dùng một nhánh phụ có nhãn riêng thay vì thay nội dung đầu vào chính của chống trùng.
SimHash chống trùng nội dung crawl với fingerprint tái lập
Ví dụ dùng token theo biểu thức đơn giản, hash ổn định cho mỗi token và một vector 64 vị trí. Mỗi token cộng hoặc trừ trọng số theo bit của hash. Dấu của tổng ở từng vị trí quyết định bit fingerprint.
Mã minh họa không phụ thuộc hash ngẫu nhiên của tiến trình
Không dùng hash mặc định của Python cho mục tiêu cần lưu dấu vân tay ổn định qua các tiến trình theo cấu hình mặc định. Đoạn dưới lấy phần đầu SHA-256 để tạo số 64 bit. Lựa chọn này nhằm tái lập fixture, không phải tối ưu tốc độ cho kho lớn.
import hashlib, re
def fingerprint(text):
    weights = [0] * 64
    for token in re.findall(r'\w+', text.casefold()):
        value = int.from_bytes(
            hashlib.sha256(token.encode('utf-8')).digest()[:8], 'big')
        for bit in range(64):
            weights[bit] += 1 if (value >> bit) & 1 else -1
    return sum(1 << bit for bit, weight in enumerate(weights) if weight > 0)

a = fingerprint('alpha beta gamma delta')
b = fingerprint('alpha beta gamma delta epsilon')
print((a ^ b).bit_count())
Quy tắc weight lớn hơn không xác định cách xử lý điểm hòa: bit được đặt bằng không khi tổng bằng không. Đây là một phần phương pháp cần giữ ổn định. Đổi cách xử lý hòa có thể làm fingerprint khác dù token không đổi.
Token lặp góp nhiều lần trong ví dụ, tương đương trọng số theo tần suất ở mức đơn giản. Nếu chuyển sang tập token duy nhất hoặc trọng số khác, kết quả đổi. Không dùng cùng tên version cho hai cách tính chỉ vì cả hai đều được gọi SimHash.
Những đặc tính mà ví dụ cố ý chưa xử lý
Ví dụ là mô hình túi token nên không giữ thứ tự câu. Hai văn bản có cùng token và tần suất nhưng thứ tự khác có thể cho cùng fingerprint. Nếu thứ tự quan trọng, cần đặc trưng như shingle hoặc một phương pháp đánh giá bổ sung đã được kiểm.
Tokenizer theo \w không phải bộ tách từ ngữ nghĩa tiếng Việt. Một từ ghép có nhiều tiếng có thể bị chia thành nhiều đơn vị. Chọn tokenizer nên theo mục tiêu và dữ liệu, rồi đánh giá lại ngưỡng; không đổi tokenizer mà giữ nguyên kết luận cũ.
Text rỗng sẽ tạo một giá trị chung trong mô hình này. Vì vậy phải loại hoặc gắn trạng thái riêng trước khi so. Một cụm hàng nghìn trang rỗng không phải bằng chứng chúng là bản sao nội dung hợp lệ.
SimHash chống trùng nội dung crawl và bộ nhãn thủ công
Nhãn gần trùng cần định nghĩa trước khi đo. Một bản sửa giá có thể là bản gần giống về chữ nhưng phải được giữ như snapshot mới. Một bản sao chỉ đổi menu có thể được gộp trong tìm kiếm nhưng vẫn cần giữ URL nguồn cho provenance.
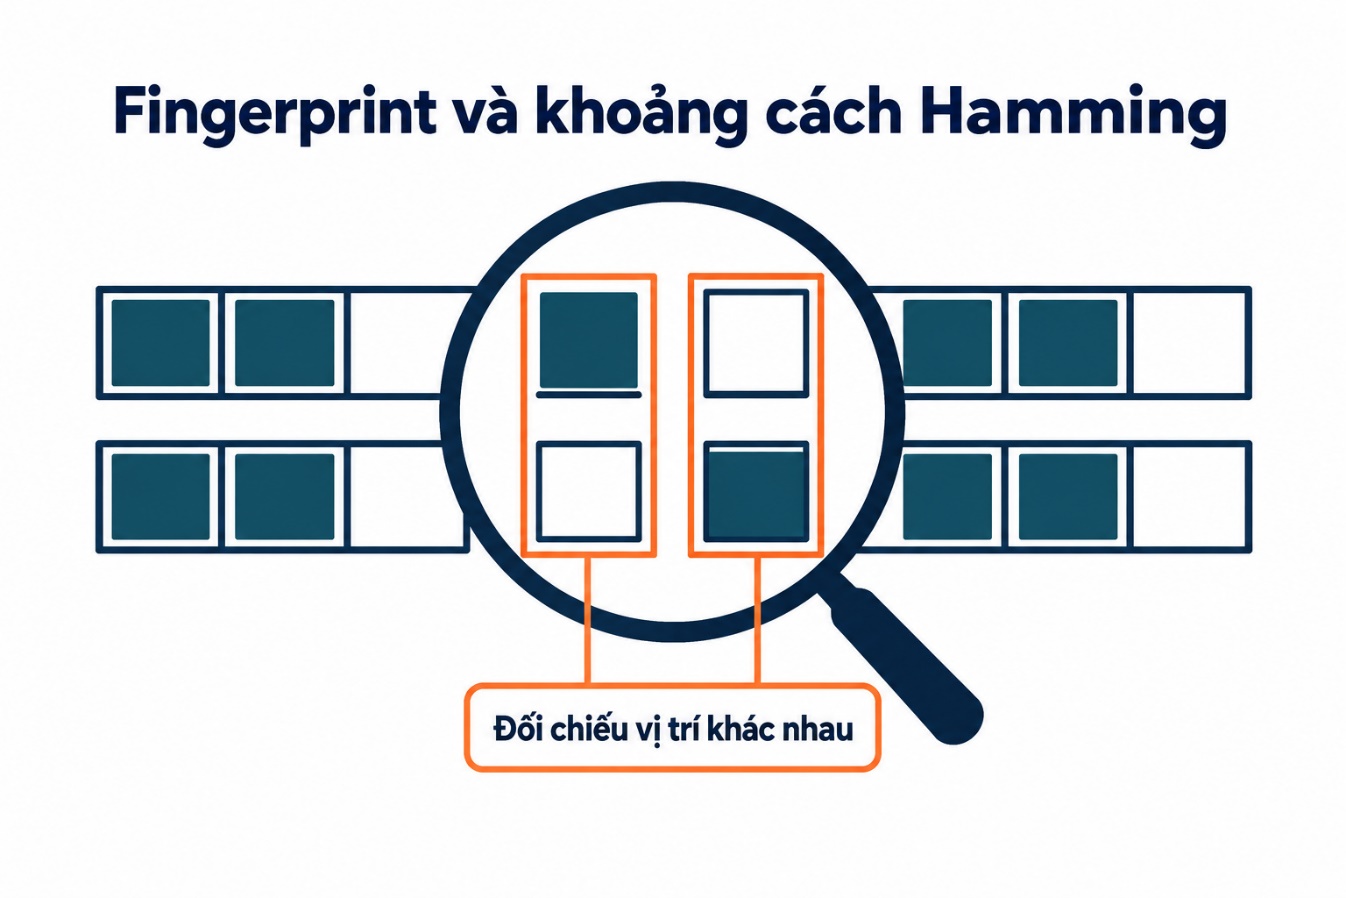
Fingerprint và khoảng cách Hamming
Cặp mẫu |
Câu hỏi nhãn |
Quyết định cần ghi |
|---|---|---|
Sao nguyên văn |
Có cùng nội dung đầu vào |
Cùng hash và fingerprint |
Đổi menu |
Main text có giữ nguyên |
Đánh giá sau loại boilerplate |
Đổi số tiền |
Có cần giữ thay đổi nghiệp vụ |
Không xóa chỉ theo khoảng cách |
Khác bài cùng template |
Có bị template chi phối |
Kiểm false positive |
Ghi nhãn theo mục tiêu sử dụng
Nếu mục tiêu giảm kết quả tìm kiếm lặp, người gán nhãn có thể xem hai bản chỉnh vài câu là gần trùng. Nếu mục tiêu lưu lịch sử thay đổi, chính vài câu đó có thể là thông tin cần giữ. Nhãn phải phản ánh tác vụ, không chỉ mức giống bằng mắt.
Mỗi cặp nên có lý do và vùng nội dung dùng để quyết định. Khi hai người gán nhãn bất đồng, giữ trường hợp để làm rõ định nghĩa. Không đổi nhãn theo kết quả thuật toán chỉ để tăng chỉ số đánh giá.
Tập kiểm nên tách với tập dùng chọn ngưỡng nếu muốn đánh giá khả năng tổng quát. Một tập rất nhỏ tự tạo chỉ chứng minh cơ chế, không cho tỷ lệ chính xác đáng tin cho toàn kho. Ghi rõ điều này trong báo cáo thay vì công bố phần trăm không có nền dữ liệu.
Đếm sai theo cặp và theo hành động
False positive là cặp bị đánh gần trùng trong khi nhãn yêu cầu phân biệt. False negative là cặp cần tìm nhưng bị bỏ sót. Chi phí hai loại lỗi khác nhau nếu hành động cuối là gợi ý biên tập hay tự xóa dữ liệu.
Với ứng viên để con người xem, có thể chấp nhận nhiều cặp dư hơn để giảm bỏ sót theo yêu cầu. Với hành động gộp tự động, cần điều kiện chặt và khả năng phục hồi. Không dùng cùng ngưỡng cùng chính sách cho hai mức tác động.
Ngoài chỉ số theo cặp, kiểm xem record quan trọng nào bị gộp sai. Một nhóm lớn có thể làm nhiều cặp sai từ một quyết định clustering. Đánh giá ở mức hành động giúp thấy tác động mà một tỷ lệ tổng có thể che mất.
SimHash chống trùng nội dung crawl khi chọn ngưỡng
Chọn ngưỡng là một bài toán đánh đổi có dữ liệu. Chạy một dải giá trị trên tập nhãn và ghi số cặp đúng, sai ở mỗi mức. Không lấy một khoảng cách quan sát ở ba chuỗi lab rồi dùng nó làm ngưỡng mặc định cho production.
Kết quả fixture cần gọi đúng phạm vi
Trong bộ thử tự tạo của bài, bản sao cho khoảng cách không, bản thêm một token cho khoảng cách ba và bản khác chủ đề cho khoảng cách lớn hơn. Các kết quả này kiểm cơ chế tính đã khóa. Chúng không tạo một quy tắc rằng mọi cặp cách ba bit đều là bản sao.
Chuỗi lab dùng token ASCII để làm rõ thuật toán, không đại diện phân phối bài tiếng Việt. Trước khi dùng cho kho thật, thêm bài có dấu, văn bản ngắn và các template thực. Giữ source text được phép cùng nhãn để người khác có thể tái đánh giá.
Nếu thay độ dài fingerprint, không so ngưỡng số bit như thể không có thay đổi. Khoảng cách tối đa và phân phối có thể khác. Version phương pháp nên bao gồm độ dài, hàm hash, tokenizer, trọng số và bước chuẩn hóa.
Đừng để ngưỡng thay cho kiểm dữ liệu
Hai trang có cùng tiêu đề và ít nội dung có thể nằm gần nhau dù thuộc hai sản phẩm. Một ngưỡng chặt hơn có thể giảm một phần nhưng không sửa được main text thiếu. Kiểm nguồn đặc trưng trước khi điều chỉnh tham số.
Với trang sản phẩm, giá và mã SKU có thể cần điều kiện bảo vệ riêng. Một cặp gần nhau theo văn bản vẫn không nên bị gộp nếu hai SKU khác nhau theo hợp đồng dữ liệu. Điều kiện nghiệp vụ cần được giải thích và kiểm, không nhét âm thầm vào một con số khoảng cách.
Khi theo dõi phiên bản tài liệu, giữ nhóm tương tự và quan hệ phiên bản có thể hữu ích hơn xóa bản mới. Đầu ra nên phục vụ mục tiêu cuối. SimHash tìm ứng viên; quyết định lưu, gộp hay hiển thị thuộc quy tắc ứng dụng.
SimHash chống trùng nội dung crawl và tìm ứng viên quy mô lớn
So mọi cặp có chi phí tăng nhanh khi số record lớn. Pipeline thường cần bước tạo ứng viên trước khi kiểm khoảng cách chính xác. Cách chia bucket hoặc chỉ mục phải được đánh giá về khả năng bỏ sót, không chỉ tốc độ truy vấn.
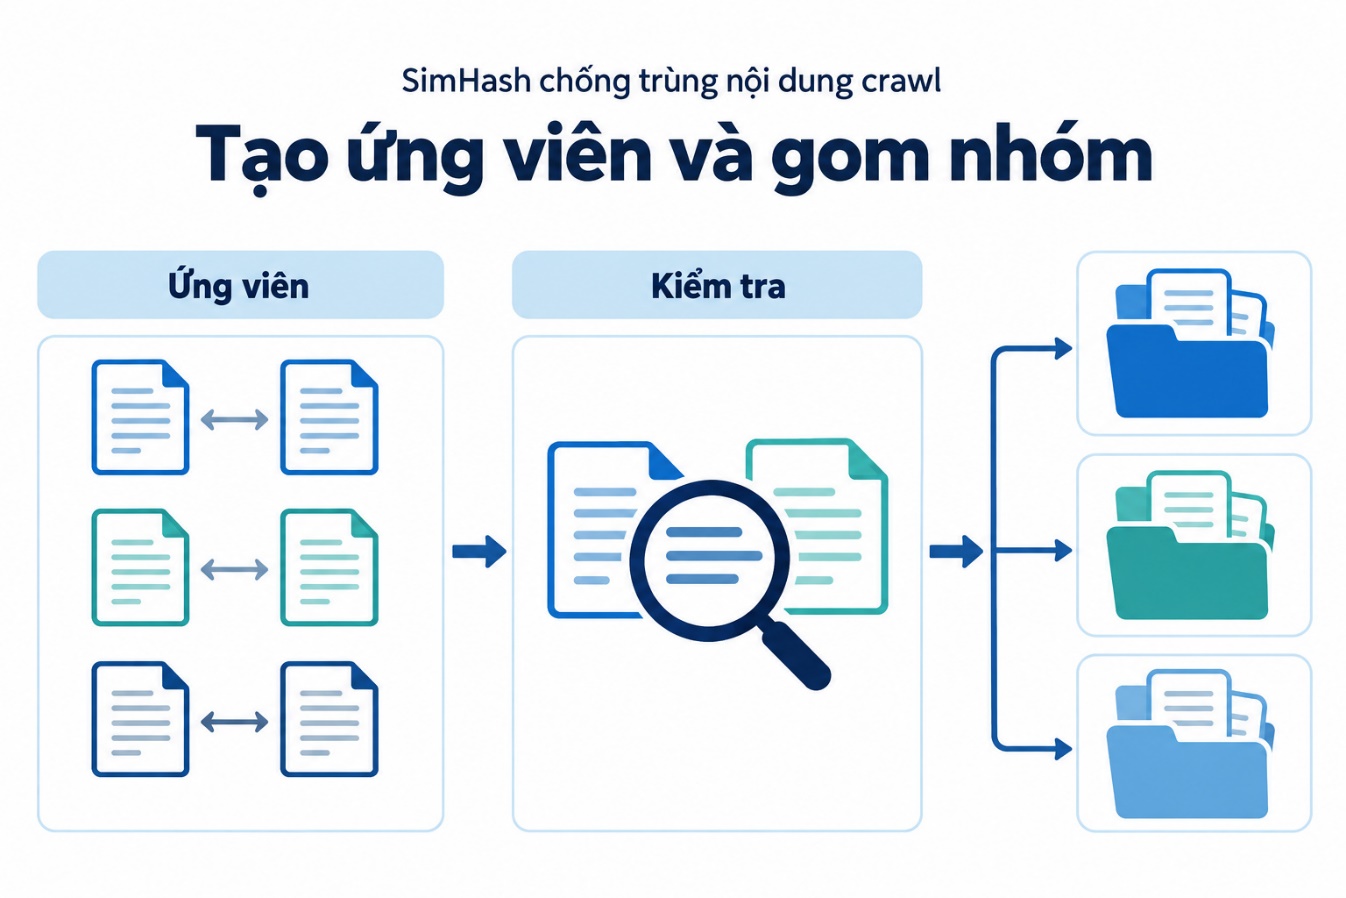
Tạo ứng viên và gom nhóm
Tách candidate generation với quyết định cuối
Candidate generator trả một tập cặp cần xem, không phải nhãn gần trùng cuối. Với mỗi ứng viên, tính khoảng cách đúng theo fingerprint đã lưu và áp điều kiện nghiệp vụ. Giữ các bước tách biệt giúp biết bỏ sót đến từ chỉ mục hay từ ngưỡng.
Một cách chia dải bit đơn giản có thể bỏ sót cặp nếu thiết kế không bao phủ ngưỡng mong muốn. Không chép một công thức bucket mà không kiểm bằng tập cặp đã biết. Bộ lab của bài chưa benchmark hoặc chứng nhận một chỉ mục phân tán.
Để kiểm candidate stage, chạy một tập nhỏ có thể so toàn cặp làm chuẩn đối chứng. So tập ứng viên mà chỉ mục tìm được với các cặp cần tìm trong chuẩn đó. Cách này đo riêng mức bỏ sót của bước tăng tốc trước khi chuyển sang kho lớn.
Clustering không luôn bắc cầu theo ngưỡng
A gần B và B gần C không bắt buộc A gần C theo ngưỡng đã chọn. Nếu dùng thành phần liên thông để gom nhóm, nhóm cuối có thể chứa hai bản khá khác nhau. Người vận hành cần biết quy tắc clustering, không chỉ quy tắc so cặp.
Chọn một đại diện nhóm cũng cần tiêu chí như nguồn ưu tiên, độ đầy đủ hoặc snapshot mới. Không tự giữ bản đầu tiên chỉ vì thứ tự crawl ngẫu nhiên. Giữ danh sách thành viên và lý do chọn để có thể thay đại diện mà không mất provenance.
Với hành động gộp, nên giữ quan hệ đến các record gốc thay vì xóa byte nguồn ngay. Khi phát hiện false positive, có thể tách nhóm và tính lại output. Một hệ thống không có đường phục hồi khiến chi phí sai cao hơn nhiều so với một danh sách gợi ý.
SimHash chống trùng nội dung crawl với các ca phản ví dụ
Phản ví dụ giúp người dùng thấy fingerprint đang giữ và bỏ thông tin nào. Mỗi ca cần có input, kỳ vọng nghiệp vụ và cách kiểm. Những trường hợp dưới đây là bộ thiết kế đề xuất để mở rộng ngoài ba chuỗi cơ chế đã chạy.
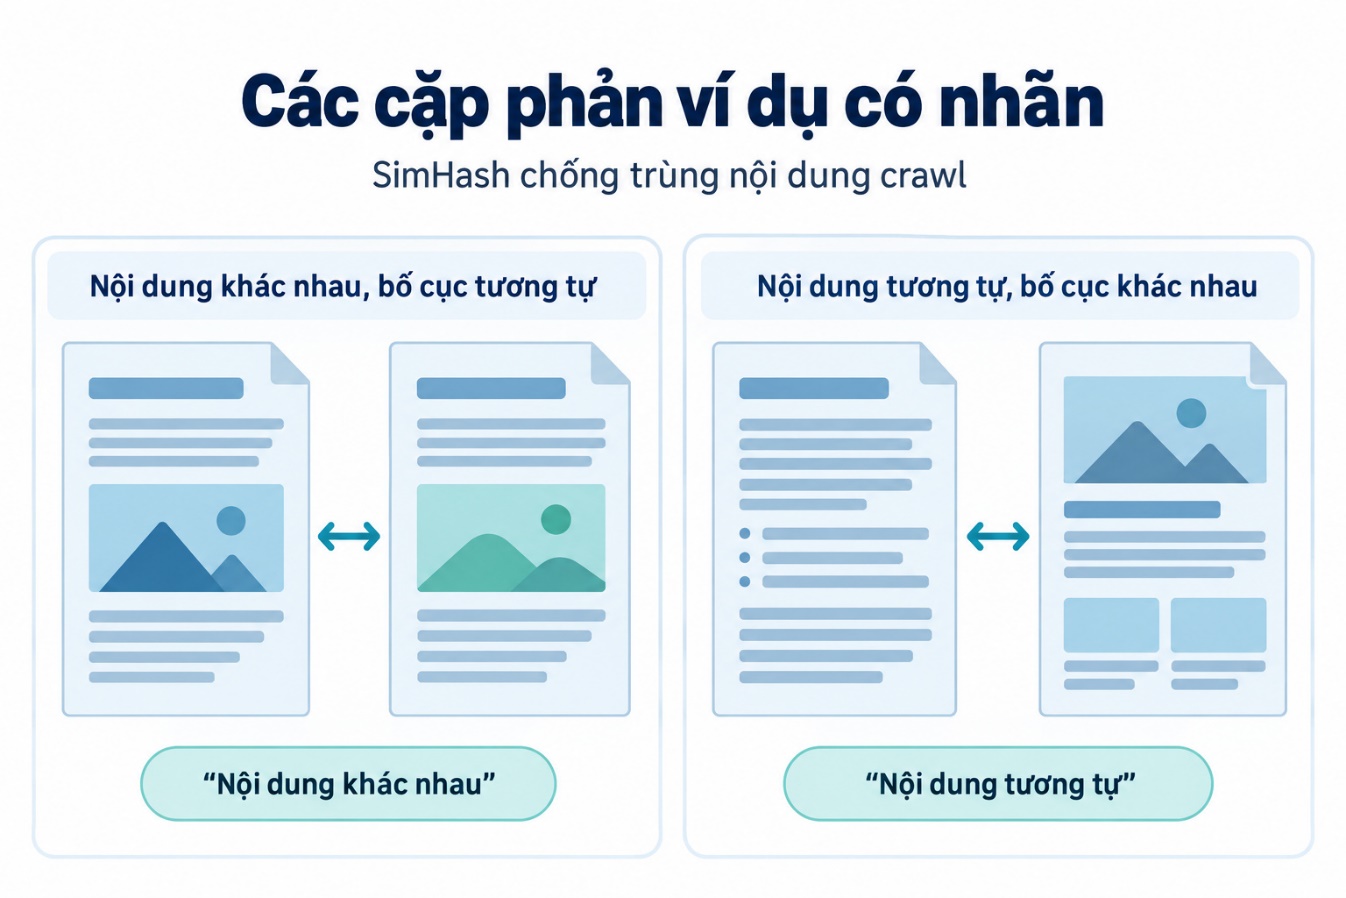
Các cặp phản ví dụ có nhãn
Sao nguyên văn và đổi trình bày
Ca sao nguyên văn dùng cùng main text ở hai URL khác. Hash text và fingerprint cần giống nếu phương pháp đầu vào giống. Tuy nhiên URL nguồn vẫn được giữ, vì cùng nội dung không có nghĩa cùng xuất xứ hoặc cùng quyền sử dụng.
Ca đổi xuống dòng và khoảng trắng kiểm đúng bước chuẩn hóa đã chọn. Nếu phương pháp gộp khoảng trắng, fingerprint đầu vào chuẩn hóa nên giữ ổn định. Nếu không có bước đó, ghi nhận khác biệt thay vì âm thầm sửa kỳ vọng sau khi chạy.
Ca đổi menu cần có hai HTML với cùng phần bài và menu khác. So fingerprint trước, sau trích main text để nhìn tác động. Nếu bộ trích bỏ mất cả bài, ca phải thất bại ở chất lượng trích xuất trước khi đánh giá gần trùng.
Thay nội dung có ý nghĩa và đổi thứ tự
Ca thay số tiền giữ phần lớn chữ nhưng đổi giá có nhãn. Tùy mục tiêu, cặp có thể vẫn là ứng viên tương tự nhưng không được gộp thành cùng snapshot. Kiểm hành động cuối chứ không chỉ khoảng cách.
Ca đảo thứ tự câu hoặc token cho thấy giới hạn của mô hình túi từ. Nếu fingerprint không đổi, đó là đặc tính của đặc trưng đã chọn, không phải hash bị hỏng. Muốn phân biệt, thử shingle hoặc phương pháp bổ sung trên cùng bộ nhãn.
Ca văn bản ngắn chỉ vài token cần chính sách riêng vì mỗi thay đổi chiếm tỷ trọng lớn. Không áp ngưỡng được chọn trên bài dài mà không đánh giá. Một tên sản phẩm có thể cần đối chiếu ID hơn là fingerprint nội dung.
Text rỗng và trang lỗi
Ca parser trả rỗng phải được gắn trạng thái không đủ đặc trưng. Không tạo một cụm nội dung hợp lệ từ mọi record rỗng. Giữ URL và lỗi trích để hệ thống có thể sửa parser hoặc tải lại theo chính sách.
Ca trang đăng nhập hoặc thông báo chặn có thể giống nhau trên nhiều URL nhưng không phải nội dung mục tiêu. Nếu chúng tạo một nhóm lớn, dùng đó làm tín hiệu chất lượng thu thập thay vì báo đã tìm được nhiều bài sao chép.
Ca bài khác nhau cùng template kiểm false positive do boilerplate. Nhãn cần được gán sau khi đọc phần nội dung có ý nghĩa. Không dùng cùng tên website làm bằng chứng hai trang gần trùng, cũng không dùng khác URL làm bằng chứng chúng khác nội dung.
SimHash chống trùng nội dung crawl khi đưa vào pipeline
Fingerprint được tính sau khi có text đầu vào hợp lệ, không phải ở lớp proxy. Thay tuyến HTTP có thể thay biểu diễn nguồn nhưng không tự sửa thuật toán gần trùng. Giữ bước tải và bước đánh giá nội dung độc lập để điều tra dễ hơn.
Provenance của một quyết định gộp
Mỗi quyết định nên giữ ID hai record, fingerprint version, khoảng cách và lý do nghiệp vụ. Nếu có người duyệt, lưu nhãn theo quy trình dự án. Không cần đưa toàn bộ nội dung nhạy cảm vào log chỉ để chứng minh hai bản nằm gần nhau.
Khi mua proxy cho tầng thu thập, nghiệm thu tuyến riêng bằng request được phép. Tầng chống trùng cần bộ nhãn riêng trên nội dung đã lấy. Không tuyên bố proxy làm tăng độ chính xác SimHash vì đó là hai phạm vi khác nhau.
Nâng tokenizer hoặc main-text extractor phải kích hoạt đánh giá lại fingerprint. Một kho trộn hai version có thể tạo khoảng cách không so được. Dùng namespace hoặc trường version để tránh đối chiếu nhầm giữa các thế hệ phương pháp.
Điều kiện bàn giao
Gói bàn giao nên có code tính, fixture, bảng nhãn và báo cáo kết quả theo phạm vi. Ba chuỗi lab của bài xác nhận tính tái lập cùng sự khác biệt khoảng cách đã quan sát. Chúng chưa xác nhận precision, recall hoặc ngưỡng production trên kho thực.
Tài liệu hashlib và int.bit_count giúp đối chiếu các phép tính trong ví dụ. Những API đó chỉ bảo đảm thao tác số theo định nghĩa, không quyết định nhãn gần trùng của dữ liệu.
Trước khi cho phép gộp tự động, kiểm phản ví dụ, khả năng tách nhóm và cách giữ nguồn. Bắt đầu bằng danh sách ứng viên để người biên tập đánh giá nếu chưa có nhãn đủ tốt. Chỉ mở rộng hành động khi chi phí sai và điều kiện phục hồi đã được xác định.
Diễn giải ba khoảng cách đã quan sát
Bộ fixture đã chạy gồm một chuỗi nền, bản sao, bản thêm một token và một chuỗi khác chủ đề. Với cách tính 64 bit đã khóa, bản sao cách không bit, bản thêm token cách ba bit và chuỗi khác cách ba mươi mốt bit. Đây là số đo của đúng các chuỗi tự tạo, không phải thống kê trên bài crawl thực.
Sự chênh lệch cho thấy bộ tính có phản ứng theo đặc trưng đầu vào trong ví dụ. Nó chưa cho biết xác suất hai bài ở khoảng cách ba là gần trùng. Muốn trả lời câu hỏi xác suất hoặc chọn ngưỡng, cần nhiều cặp có nhãn đại diện và một cách lấy mẫu không thiên lệch.
Nếu người nhận chạy lại mà số khác, kiểm thứ tự byte hash, cách cắt 64 bit và quy tắc hòa trước. Tiếp theo kiểm tokenizer, casefold và việc text đã được chuẩn hóa hay chưa. Một khác biệt nhỏ trong phương pháp có thể đổi fingerprint mà không phải do Python tính xor sai.
Giữ dữ liệu hiệu chỉnh ngưỡng theo phiên bản
Một bảng hiệu chỉnh nên có khoảng cách, nhãn thủ công, loại tài liệu và quyết định mà hệ thống dự kiến thực hiện. Tách bài dài, trang ngắn và trang lỗi để nhìn rõ nhóm nào tạo nhiều sai. Không chỉ chọn một ngưỡng tối ưu tỷ lệ tổng nếu nhóm dữ liệu quan trọng bị gộp nhầm.
Nếu nhãn được cập nhật sau khi phát hiện một trường hợp mới, giữ lịch sử thay đổi và lý do. Kết quả đánh giá cũ không còn cùng nền nhãn với kết quả mới. Việc so sánh cần chỉ ra thay đổi đến từ thuật toán hay từ cách định nghĩa gần trùng.
Một tập giữ lại để kiểm cuối nên chưa được dùng chỉnh tham số. Nếu tập quá nhỏ để tách, ghi rõ kết quả mới là đánh giá trên mẫu đã dùng hiệu chỉnh. Cách báo phạm vi này giúp tránh một con số có vẻ cao nhưng không phản ánh dữ liệu mới.
Theo dõi drift của nguồn đặc trưng
Website đổi template có thể làm bộ trích main text đổi độ dài hoặc giữ thêm menu. Theo dõi phân phối số token, tỷ lệ text rỗng và kích thước nhóm ứng viên giúp phát hiện thay đổi. Một nhóm lớn xuất hiện đột ngột cần kiểm dữ liệu trước khi kết luận nguồn sao chép nhiều hơn.
Khi một nhóm ứng viên bất thường được phát hiện, lấy mẫu có quyền đọc và so phần main text với HTML nguồn. Nếu lỗi thuộc extractor, sửa và tính lại fingerprint theo version mới. Không chỉ hạ ngưỡng để làm nhóm nhỏ đi vì có thể che nguyên nhân chất lượng đầu vào.
Proxy và HTTP client chỉ là một phần của chuỗi tạo text. Response đăng nhập hoặc nội dung vùng khác có thể tạo đặc trưng khác dự kiến. Giữ status, URL cuối và hash nguồn bên cạnh fingerprint giúp nối vấn đề chống trùng với dữ liệu thu được mà không đổ lỗi chung cho mạng.
Giới hạn hành động tự động khi chưa có đủ nhãn
Ở giai đoạn đầu, lưu ứng viên cùng lý do để biên tập xem thường ít rủi ro hơn xóa record. Khi có nhãn, có thể thiết kế mức tự động theo nhóm dữ liệu và chi phí sai. Những ngưỡng đó phải được nghiệm thu riêng, không tự sinh từ ba khoảng cách trong lab.
Nếu chưa có quy trình phục hồi nhóm đã gộp, giữ record gốc và xuất một lớp view thay vì phá dữ liệu nền. Cách tổ chức này cho phép đổi phương pháp về sau. Tính gần trùng là một suy luận có điều kiện, nên hệ thống cần giữ chỗ cho việc sửa suy luận.
Khoảng cách nhỏ tạo ứng viên để đánh giá; quyết định xóa hay gộp cần nhãn, ngữ cảnh và khả năng phục hồi.
Anh em hãy lưu dữ liệu mẫu cùng cấu hình và kết quả đối chiếu để lần cập nhật sau có cơ sở kiểm lại. Tham khảo thêm tại Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam. Bắt đầu từ phạm vi nhỏ và tiêu chí rõ ràng khi triển khai SimHash chống trùng nội dung crawl.


