
Lấy tất cả URL của website: sitemap, liên kết và canonical
Lấy tất cả URL của website là bước đầu của kiểm tra SEO, chuyển nhà website, tìm liên kết hỏng hay chuẩn bị crawl dữ liệu. ProxyVN ghép ba nguồn là sitemap, liên kết nội bộ và thẻ canonical vào một script Python đã chạy thử qua proxy. Bài cũng nói rõ vì sao URL tìm thấy chưa chắc là URL được lập chỉ mục.
Lấy tất cả URL của website cần những nguồn nào
Không có nguồn nào một mình cho đủ danh sách URL. Mỗi nguồn nhìn website từ một góc, có điểm mạnh và có chỗ mù riêng. Muốn danh sách gần đủ, phải ghép nhiều nguồn rồi đối chiếu.
Sitemap: danh sách chủ website muốn được tìm thấy
Sitemap là file XML liệt kê URL mà chủ website muốn công cụ tìm kiếm biết tới. Đây là nguồn nhanh nhất vì chỉ cần vài request là có hàng nghìn URL. Theo giao thức sitemaps.org, một file sitemap chứa tối đa 50.000 URL và không quá 50MB khi chưa nén, website lớn hơn thì dùng sitemap index trỏ tới nhiều file con.
Điểm yếu của sitemap là nó chỉ chứa những gì chủ website chọn đưa vào. Bài hướng dẫn của Decodo về tìm mọi URL trên tên miền nhận xét sitemap thường cũ, thiếu, hoặc bỏ sót trang lọc, trang động và trang cũ.
Liên kết nội bộ: những gì người dùng đi tới được
Crawl theo liên kết nội bộ bắt đầu từ trang chủ, đi theo mọi liên kết cùng tên miền cho tới khi hết. Cách này tìm được trang không có trong sitemap, như trang liên hệ, trang tìm kiếm hay bài viết mới chưa kịp đưa vào.
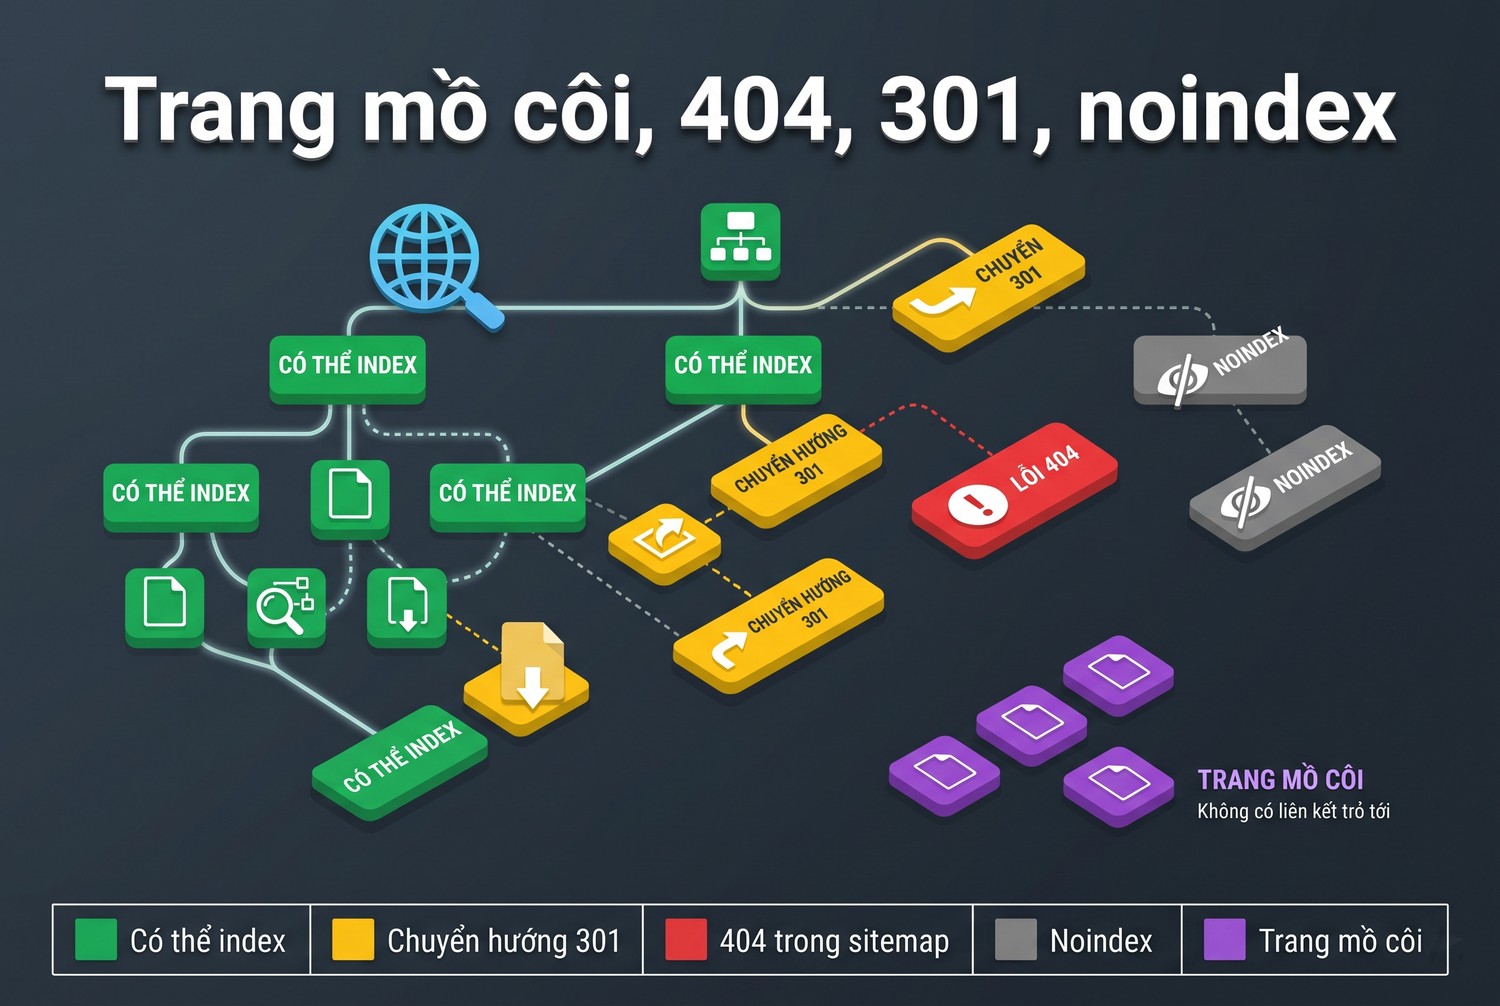
Điểm yếu ngược lại: crawler không tìm được trang mồ côi, tức trang tồn tại nhưng không trang nào liên kết tới. Những trang này chỉ hiện ra qua sitemap, qua dữ liệu Search Console hoặc qua nhật ký máy chủ.
Canonical, noindex và chuyển hướng: lọc lại danh sách
Sau khi gom URL từ hai nguồn trên, danh sách vẫn chứa URL trùng nội dung, URL chuyển hướng, URL lỗi và URL không muốn được lập chỉ mục. Thẻ canonical, thẻ meta robots và mã trạng thái HTTP giúp phân loại chúng.
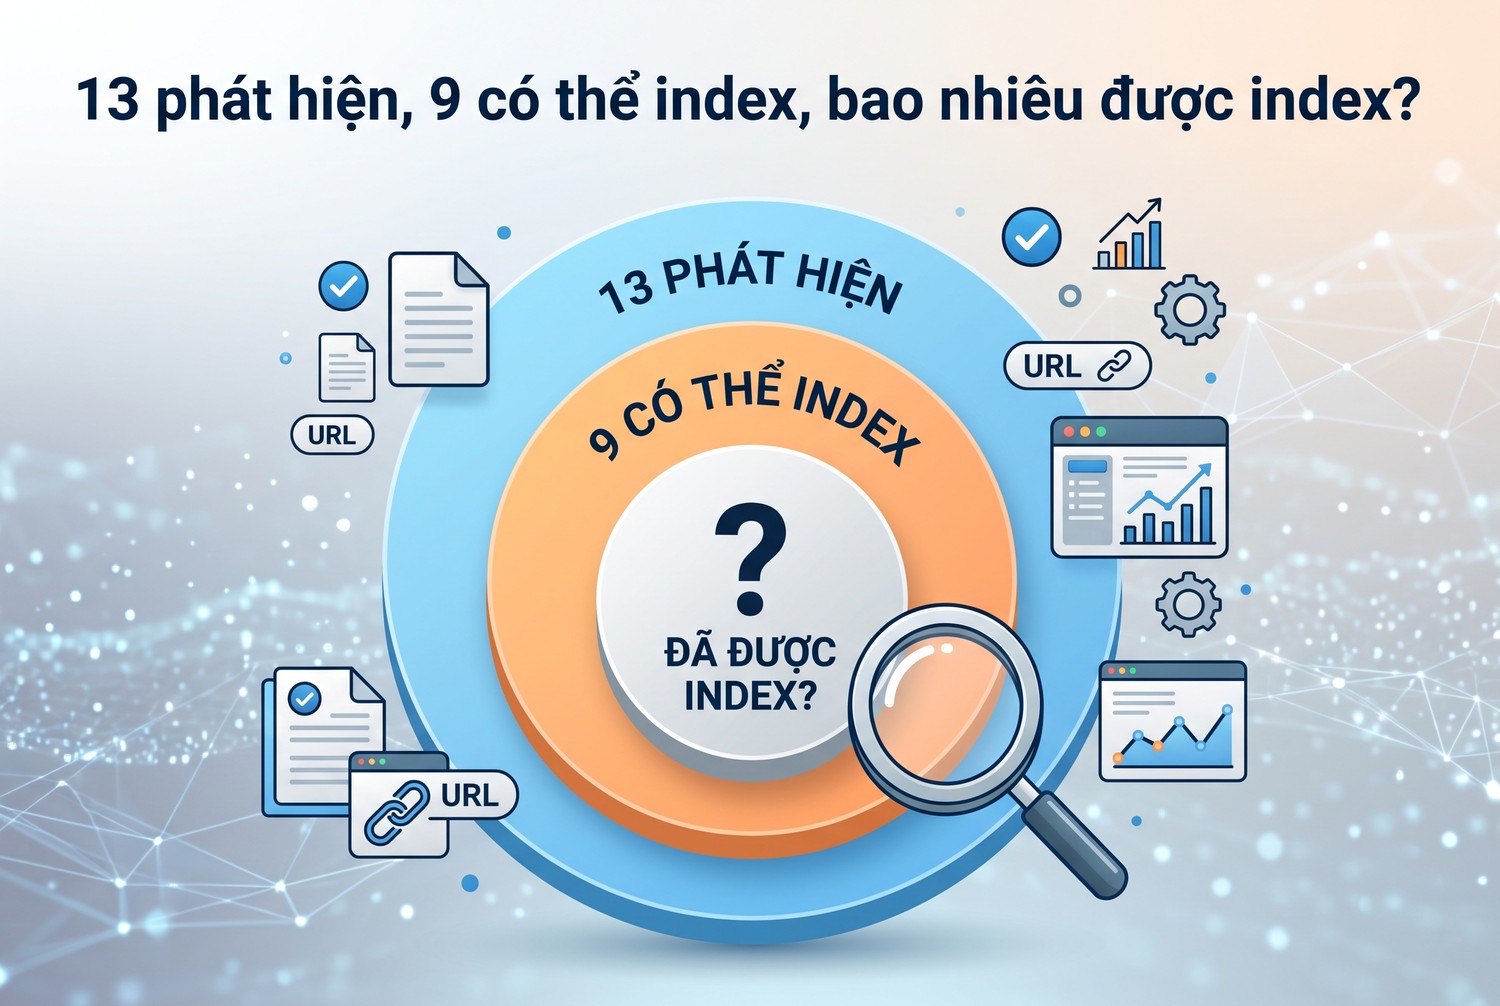
URL phát hiện được khác với URL có thể lập chỉ mục, và khác với URL đã được lập chỉ mục thật. Script trong bài báo cáo hai cột đầu; cột thứ ba chỉ Search Console của chủ website trả lời được.
Kết hợp sitemap index, liên kết nội bộ và canonical khi lấy tất cả URL của website
Phần này mô tả cách ghép ba nguồn theo thứ tự hợp lý, và những quy tắc chuẩn hóa URL để không đếm một trang thành nhiều URL.
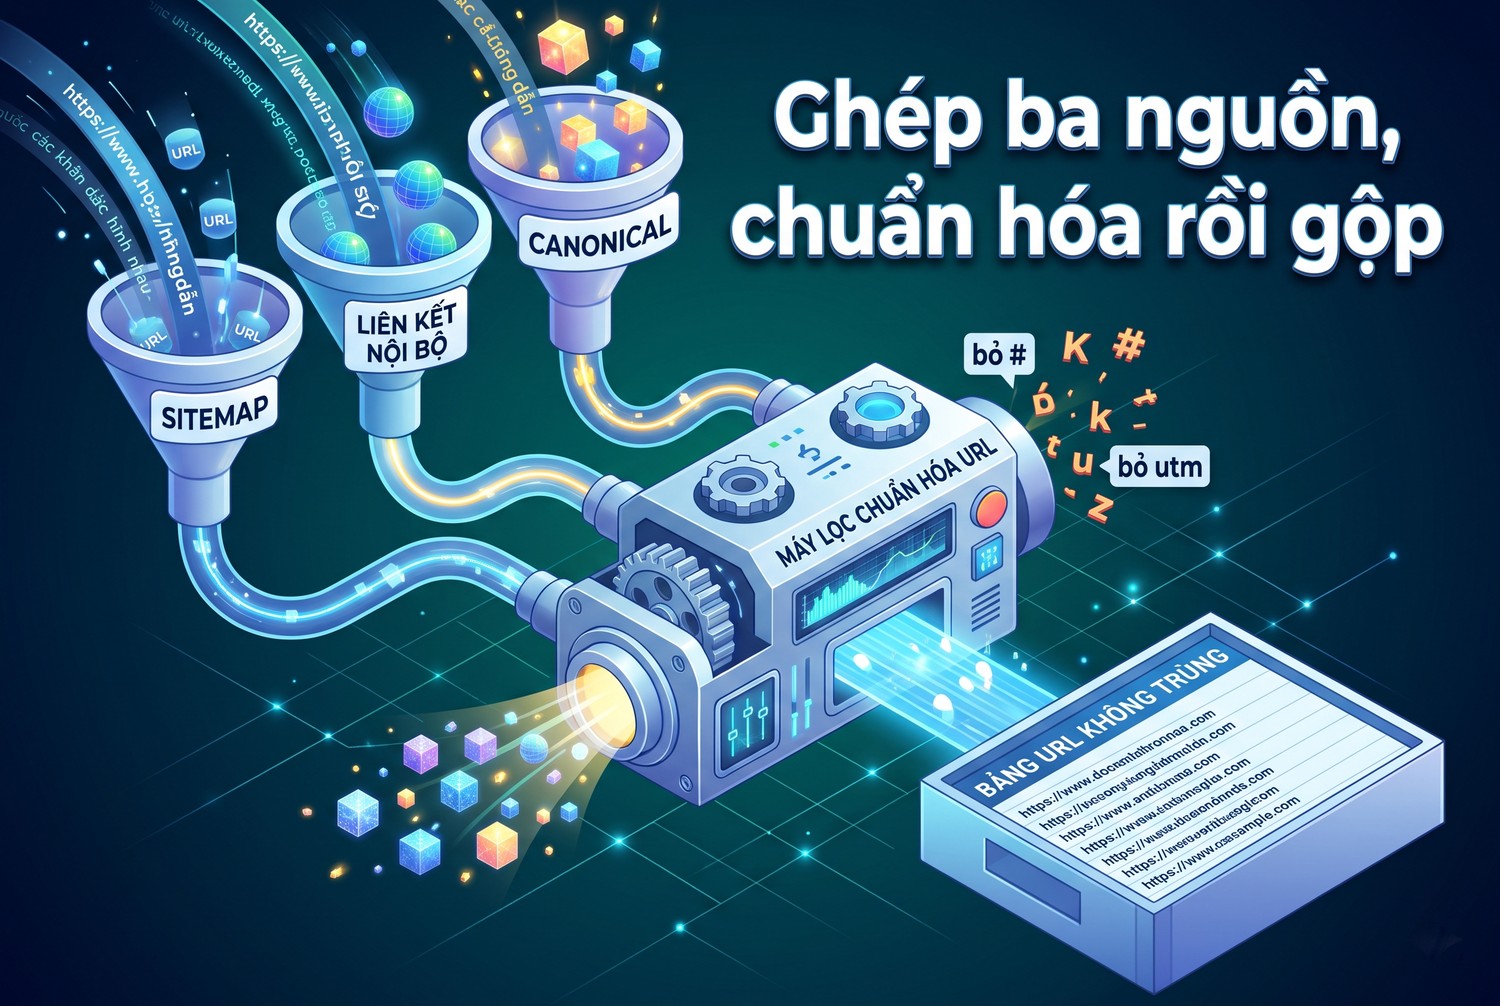
Ghép ba nguồn, chuẩn hóa rồi gộp
Bắt đầu từ robots.txt
Robots.txt là nơi đầu tiên cần đọc vì nó vừa cho biết vùng nào bị cấm crawl, vừa thường chứa dòng Sitemap trỏ tới sitemap hoặc sitemap index. Nếu robots.txt không có dòng Sitemap, thử các vị trí quen thuộc như /sitemap.xml, /sitemap_index.xml hay /wp-sitemap.xml với website WordPress.
Mọi URL tìm được sau đó đều phải lọc qua robots.txt trước khi tải. Bộ đọc robots.txt nên theo chuẩn RFC 9309; thư viện Protego mà Scrapy dùng là một lựa chọn đã kiểm qua.
Đọc sitemap index và sitemap nén
Sitemap index chứa danh sách sitemap con, mỗi sitemap con lại có thể là file XML thường hoặc file nén gzip với đuôi .xml.gz. Script phải đọc đệ quy: gặp sitemapindex thì đi vào từng sitemap con, gặp urlset thì lấy các thẻ loc.
Với file nén, kiểm hai byte đầu của nội dung tải về. Nếu là 1f 8b, đó là gzip và cần giải nén trước khi đọc XML. Không nên dựa vào đuôi tên file hay header Content-Type, vì máy chủ khác nhau trả về khác nhau.
Chuẩn hóa URL trước khi gộp
Cùng một trang có thể xuất hiện dưới nhiều dạng URL. Nếu không chuẩn hóa, danh sách sẽ phình to với các bản trùng. Mình áp dụng bốn quy tắc:
- Bỏ phần sau dấu thăng, vì fragment không gửi tới máy chủ.
- Bỏ các tham số theo dõi như utm_source, utm_medium, utm_campaign, fbclid, gclid.
- Viết thường giao thức và tên miền, giữ nguyên phân biệt hoa thường của đường dẫn.
- Đường dẫn rỗng thành dấu gạch chéo.
Không bỏ mọi tham số, vì nhiều website dùng tham số cho nội dung thật như trang sản phẩm hay phân trang. Chỉ bỏ những tham số rõ ràng không đổi nội dung.
Đọc canonical và noindex
Theo hướng dẫn gộp URL trùng của Google, chuyển hướng và thẻ rel canonical là tín hiệu mạnh cho biết URL nào nên là bản chính, còn việc có mặt trong sitemap chỉ là tín hiệu yếu. Mỗi trang tải về, script đọc thẻ link rel canonical và thẻ meta robots.
Trang có canonical trỏ tới URL khác là bản phụ. Trang có noindex là trang chủ website không muốn xuất hiện trên kết quả tìm kiếm. Cả hai vẫn là URL thật, vẫn nên có trong danh sách, nhưng được đánh dấu không thể lập chỉ mục.
Chuẩn bị môi trường lấy tất cả URL của website
Mình dựng một site thử có đủ các tình huống khó, đặt sau một proxy HTTP có mật khẩu, rồi chạy script. Không gửi request tới website thật nào.
Phiên bản đã dùng
Kiểm tra ngày 25/10/2026, môi trường thử gồm:
- Python 3.12.10 trong môi trường ảo riêng.
- requests 2.34.2 để tải trang, beautifulsoup4 4.15.0 với lxml để đọc HTML.
- Protego 0.7.0 để đọc robots.txt.
Cài bằng một lệnh pip là đủ. Script chỉ dùng thêm các mô-đun chuẩn của Python cho gzip, XML, CSV và xử lý URL.
python -m venv venv
venv\Scripts\python -m pip install requests beautifulsoup4 lxml protego
Site thử có những gì
Site thử mô phỏng một cửa hàng nhỏ với các tình huống anh em sẽ gặp ngoài đời:
- Robots.txt cấm thư mục /admin/ và trỏ tới một sitemap index.
- Sitemap index gồm một sitemap XML thường và một sitemap nén .xml.gz.
- Một trang chỉ có trong sitemap, không trang nào liên kết tới, tức trang mồ côi.
- Một URL trong sitemap đã bị xóa, trả về 404.
- Một trang cũ chuyển hướng 301 sang trang mới.
- Một trang sản phẩm có bản sao kèm tham số utm_source, cùng canonical về bản chính.
- Một trang tìm kiếm gắn noindex.
- Một liên kết có phần #form và một liên kết ra Facebook.
Proxy có mật khẩu
Mọi request đi qua một proxy HTTP yêu cầu tài khoản user1, mật khẩu p@ss#2026. Proxy ghi lại từng request, nhờ đó mình đếm được chính xác số request script gửi ra.
Có một chi tiết khi dựng proxy thử: bản đầu tiên tự đi theo chuyển hướng và bỏ mất header Location, làm trang 301 hiện thành 200. Proxy HTTP thông thường không làm vậy, nên mình sửa lại proxy thử. Nếu anh em thấy script báo 200 cho URL mà anh em biết rõ đang chuyển hướng, hãy kiểm proxy hoặc lớp trung gian đang dùng.
Ví dụ lấy tất cả URL của website: code, cách chạy và đầu ra
Script dưới gom URL từ sitemap và liên kết nội bộ, tải từng trang không tự đi theo chuyển hướng, đọc canonical và noindex, rồi ghi ra file CSV. Code đầy đủ, chạy được ngay.
Toàn bộ script
Các hằng số ở đầu file gồm tên crawler, proxy và thời gian nghỉ giữa các request. Mật khẩu proxy được mã hóa bằng quote để ký tự đặc biệt không làm hỏng URL proxy.
import csv, gzip, sys, time, xml.etree.ElementTree as ET
from collections import deque
from urllib.parse import quote, urldefrag, urljoin, urlsplit, urlunsplit, parse_qsl, urlencode
import requests
from bs4 import BeautifulSoup
from protego import Protego

UA, TOKEN = "UrlMapper/1.0 (+https://example.vn/bot)", "UrlMapper"
PROXY = f"http://user1:{quote('p@ss#2026', safe='')}@127.0.0.1:8822"
S = requests.Session()
S.headers["User-Agent"] = UA
S.proxies = {"http": PROXY, "https": PROXY}
NS = {"sm": "http://www.sitemaps.org/schemas/sitemap/0.9"}
DROP_PARAMS = {"utm_source", "utm_medium", "utm_campaign", "fbclid", "gclid"}
DELAY, MAX_PAGES = 0.2, 5000

def normalize(url):
    url, _ = urldefrag(url)
    p = urlsplit(url)
    q = urlencode([(k, v) for k, v in parse_qsl(p.query) if k not in DROP_PARAMS])
    return urlunsplit((p.scheme.lower(), p.netloc.lower(), p.path or "/", q, ""))

def read_sitemap(url):
    r = S.get(url, timeout=20)
    data = gzip.decompress(r.content) if r.content[:2] == b"\x1f\x8b" else r.content
    root = ET.fromstring(data)
    if root.tag.endswith("sitemapindex"):
        for loc in root.findall("sm:sitemap/sm:loc", NS):
            yield from read_sitemap(loc.text.strip())
    else:
        for loc in root.findall("sm:url/sm:loc", NS):
            yield loc.text.strip()

def main(start):
    host = urlsplit(start).netloc
    robots = Protego.parse(S.get(urljoin(start, "/robots.txt"), timeout=20).text)
    sitemaps = list(robots.sitemaps) or [urljoin(start, "/sitemap.xml")]
    info = {}
    for sm in sitemaps:
        for u in read_sitemap(sm):
            info.setdefault(normalize(u), {"sources": set()})["sources"].add("sitemap")
    queue, seen = deque([normalize(start)] + list(info)), set()
    info.setdefault(normalize(start), {"sources": set()})["sources"].add("start")
    while queue and len(seen) < MAX_PAGES:
        url = queue.popleft()
        if url in seen:
            continue
        seen.add(url)
        row = info.setdefault(url, {"sources": set()})
        if not robots.can_fetch(url, TOKEN):
            row.update(status="robots-cam")
            continue
        r = S.get(url, timeout=20, allow_redirects=False)
        time.sleep(DELAY)
        row["status"] = r.status_code
        if r.is_redirect:
            target = normalize(urljoin(url, r.headers["Location"]))
            row["redirect_to"] = target
            info.setdefault(target, {"sources": set()})["sources"].add("redirect")
            queue.append(target)
            continue
        if r.status_code != 200 or "html" not in r.headers.get("Content-Type", ""):
            continue
        soup = BeautifulSoup(r.text, "lxml")
        can = soup.find("link", rel="canonical")
        row["canonical"] = normalize(urljoin(url, can["href"])) if can else ""
        meta = soup.find("meta", attrs={"name": "robots"})
        row["noindex"] = bool(meta and "noindex" in meta.get("content", "").lower())
        for a in soup.select("a[href]"):
            link = normalize(urljoin(url, a["href"]))
            if urlsplit(link).netloc != host:
                continue
            info.setdefault(link, {"sources": set()})["sources"].add("link")
            if link not in seen:
                queue.append(link)
    with open("urls.csv", "w", newline="", encoding="utf-8-sig") as f:
        w = csv.writer(f)
        w.writerow(["url", "nguon", "status", "redirect_to", "canonical", "noindex", "co_the_index"])
        for u, d in sorted(info.items()):
            ok = d.get("status") == 200 and not d.get("noindex") and d.get("canonical", u) in ("", u)
            w.writerow([u, "+".join(sorted(d["sources"])), d.get("status", ""), d.get("redirect_to", ""),
                        d.get("canonical", ""), d.get("noindex", ""), ok])
    return info

if __name__ == "__main__":
    info = main(sys.argv[1] if len(sys.argv) > 1 else "https://example.com/")
    print("Tổng URL phát hiện:", len(info))
Chạy bằng lệnh python all_urls.py kèm địa chỉ trang chủ. File urls.csv được lưu với mã hóa utf-8-sig để mở thẳng bằng Excel không lỗi tiếng Việt.
Đầu ra trên site thử
Script phát hiện 13 URL. Sitemap index với hai sitemap con cho 7 URL, crawl theo liên kết tìm thêm 6 URL. Proxy ghi 16 request, tất cả đều có xác thực đúng. Bảng dưới tóm tắt các URL đáng chú ý trong file kết quả:
URL |
Nguồn |
Trạng thái |
Có thể index |
|---|---|---|---|
/khuyen-mai-cu |
Chỉ sitemap |
200 |
Có, nhưng là trang mồ côi |
/het-hang |
Chỉ sitemap |
404 |
Không |
/san-pham/cu |
Liên kết |
301 sang /san-pham/quan-jean |
Không |
/tim-kiem?q=jean |
Liên kết |
200, noindex |
Không |
/admin/ |
Liên kết |
Bị robots.txt cấm, không tải |
Không |
/lien-he |
Liên kết, không có trong sitemap |
200 |
Có |
/san-pham/ao-thun |
Sitemap và liên kết |
200, canonical trỏ về chính nó |
Có |
Bản có tham số utm_source của trang áo thun và liên kết /lien-he#form được gộp vào URL gốc nhờ bước chuẩn hóa. Liên kết ra Facebook bị bỏ qua vì khác tên miền. Tổng cộng 9 trên 13 URL có thể lập chỉ mục.
Đọc kết quả để ra quyết định
File CSV không chỉ là danh sách, nó chỉ ra việc cần làm. Trang mồ côi /khuyen-mai-cu cần được liên kết từ đâu đó hoặc gỡ khỏi sitemap. URL 404 trong sitemap cần gỡ. Trang chuyển hướng 301 không nên còn liên kết nội bộ trỏ tới, nên sửa liên kết sang thẳng trang đích.
Trang /lien-he và các trang khác chỉ có từ liên kết là gợi ý để bổ sung vào sitemap nếu muốn chúng được tìm thấy. Mỗi cột trong file trả lời một câu hỏi cụ thể, đó là lý do mình ghi riêng cột nguồn thay vì chỉ ghi danh sách URL.
Xử lý lỗi và giới hạn request khi lấy tất cả URL của website
Site thử chỉ có vài chục trang, website thật có thể có hàng trăm nghìn. Phần này nói về những điều cần thêm khi chạy với website thật.
Trang mồ côi, 404, 301, noindex
Giới hạn tốc độ
Script nghỉ 0,2 giây sau mỗi request, phù hợp với site thử chạy trên máy. Với website thật, đọc Crawl-delay trong robots.txt nếu có, và nếu không có thì bắt đầu với một request mỗi giây rồi theo dõi phản hồi.
Gặp mã 429 hoặc 503, tăng thời gian nghỉ thay vì thử lại ngay. Proxy giúp chia tải khi crawl nhiều website khác nhau, nhưng với cùng một website, tổng tốc độ qua mọi IP vẫn phải nằm trong giới hạn website chấp nhận.
Bẫy URL vô tận
Lịch có nút tháng sau, bộ lọc kết hợp nhiều tham số, trang tìm kiếm với từ khóa sinh ra từ chính trang: những thứ này tạo ra vô số URL khác nhau. Crawler đi theo mọi liên kết sẽ không bao giờ dừng.
Script có giới hạn MAX_PAGES là 5.000 trang làm chốt an toàn. Với website thật, mình thêm giới hạn độ sâu tính từ trang chủ và danh sách mẫu đường dẫn bỏ qua như /tim-kiem hay tham số sort, filter. Website có robots.txt tốt thường đã cấm sẵn những vùng này.
Tên miền con, http và https
Script chỉ đi theo liên kết có cùng tên máy chủ với trang bắt đầu. Website có blog ở blog.example.com hay cửa hàng ở shop.example.com sẽ bị coi là bên ngoài và không được crawl. Đây là lựa chọn có chủ ý, vì mỗi tên miền con có robots.txt và sitemap riêng.
Muốn lấy URL của cả hệ thống, chạy script riêng cho từng tên miền con rồi gộp file kết quả. Tương tự, nếu website còn trả nội dung ở cả http và https, hoặc cả có www và không www, đó là dấu hiệu thiếu chuyển hướng về một bản duy nhất, nên ghi vào danh sách việc cần sửa.
Trang dựng bằng JavaScript
Script dùng requests nên chỉ thấy liên kết có trong HTML ban đầu. Website dựng bằng React hay Vue có thể sinh liên kết sau khi chạy JavaScript, và script sẽ bỏ sót chúng.
Hai cách xử lý: dựa nhiều hơn vào sitemap, vì website kiểu này thường có sitemap tốt; hoặc thay phần tải trang bằng Playwright để lấy HTML sau khi dựng. Cách sau tốn RAM và thời gian hơn nhiều, chỉ nên dùng cho phần website thật sự cần.
Kiểm tra dữ liệu đầu ra
Sau mỗi lần chạy, mình kiểm vài điều trước khi tin vào danh sách. Tổng số URL có hợp lý so với quy mô website không. Có URL nào thuộc vùng robots.txt cấm mà vẫn có trạng thái tải không. Tỷ lệ 404 và chuyển hướng có tăng bất thường so với lần trước không.
Nếu tỷ lệ lỗi cao bất thường, thường là proxy bị chặn và website trả trang chặn hoặc mã lỗi cho mọi request. Xem vài trang lỗi bằng tay trước khi kết luận website có vấn đề.
URL phát hiện khi lấy tất cả URL của website chưa phải URL được index
Đây là phần hay bị hiểu nhầm nhất. Script trả lời được URL nào tồn tại và URL nào có thể lập chỉ mục theo tín hiệu trên trang. Nó không trả lời được Google đã lập chỉ mục URL nào.
Ba con số khác nhau
Với site thử, có ba con số. URL phát hiện là 13. URL có thể lập chỉ mục theo tín hiệu trên trang là 9. URL thật sự đã lập chỉ mục thì script không biết, vì đó là quyết định của công cụ tìm kiếm.
Google dùng canonical như một tín hiệu, không phải mệnh lệnh. Trang có canonical trỏ về chính nó vẫn có thể bị Google chọn một URL khác làm bản chính, nếu các tín hiệu khác mạnh hơn. Trang không có noindex vẫn có thể không được lập chỉ mục vì nội dung mỏng hay trùng.
Lấy con số thật từ Search Console
Với website của chính mình, báo cáo lập chỉ mục trang trong Google Search Console cho biết URL nào đã được lập chỉ mục và vì sao những URL khác không được. Ghép danh sách từ script với báo cáo này cho bức tranh đầy đủ: URL tồn tại, URL nên được lập chỉ mục, và URL thật sự được lập chỉ mục.
Toán tử site trên Google chỉ cho con số ước lượng và giới hạn số kết quả hiển thị, nên không dùng để đếm chính xác. Với website của người khác, anh em không có Search Console, nên chỉ nói được tới mức có thể lập chỉ mục.
Sitemap nên chứa gì
Hướng dẫn tạo sitemap của Google khuyên dùng URL đầy đủ, có giao thức và tên miền, và chỉ đưa URL bản chính vào sitemap. Google bỏ qua thẻ priority và changefreq, chỉ dùng lastmod khi giá trị đó chính xác và kiểm chứng được.
Nhìn lại kết quả site thử, sitemap có hai lỗi đúng theo hướng dẫn này: chứa một URL 404 và bỏ sót vài trang bản chính. Script giúp tìm ra cả hai, và đó là giá trị lớn nhất của việc ghép nhiều nguồn.
Theo dõi danh sách khi lấy tất cả URL của website định kỳ
Một lần chạy cho ảnh chụp tại một thời điểm. Chạy định kỳ và so sánh các lần chạy mới cho thấy website thay đổi thế nào, và đây thường là phần có giá trị nhất với người làm SEO hay theo dõi đối thủ.
So sánh hai lần chạy
Mình lưu mỗi file urls.csv kèm ngày chạy, rồi so file mới với file trước theo cột url. Ba nhóm cần xem: URL mới xuất hiện, URL biến mất, và URL đổi trạng thái như từ 200 sang 404 hay từ có thể lập chỉ mục sang noindex.
Với website của mình, URL biến mất ngoài kế hoạch thường là lỗi xóa nhầm hoặc lỗi chuyển hướng sau khi cập nhật giao diện. Với website đối thủ, URL mới trong thư mục sản phẩm hay bài viết cho biết họ đang mở rộng mảng nào.
Dùng lastmod cho đúng
Sitemap có thẻ lastmod ghi thời điểm trang thay đổi lần cuối. Theo hướng dẫn của Google, lastmod chỉ nên phản ánh thay đổi đáng kể của nội dung chính, dữ liệu có cấu trúc hay liên kết, không phải đổi năm bản quyền ở chân trang.
Khi chạy định kỳ, mình chỉ tải lại những trang có lastmod mới hơn lần chạy trước, các trang còn lại giữ kết quả cũ. Cách này giảm mạnh số request với website lớn. Nhưng nếu lastmod của website không đáng tin, ví dụ mọi trang đều có cùng một ngày, thì bỏ qua và tải lại toàn bộ theo lịch thưa hơn.
Sitemap dạng văn bản và nguồn cấp tin
Giao thức sitemaps.org còn cho phép sitemap dạng file văn bản, mỗi dòng một URL, và chấp nhận nguồn cấp RSS hoặc Atom làm sitemap. Một số nền tảng bán hàng dùng sitemap dạng văn bản, còn nhiều trang tin có sẵn RSS với các bài mới nhất.
Script trong bài chỉ đọc sitemap XML. Muốn đọc thêm hai dạng này, kiểm phần đầu nội dung tải về. Bắt đầu bằng thẻ urlset hay sitemapindex là XML sitemap, bắt đầu bằng thẻ rss hay feed là nguồn cấp tin, còn lại thì đọc từng dòng như danh sách URL. Với trang tin, RSS là cách rẻ nhất để phát hiện bài mới giữa các lần crawl đầy đủ.
Ghép nhật ký máy chủ
Với website của mình, nhật ký truy cập máy chủ là nguồn thứ tư rất đáng giá. Lọc các dòng có User-Agent của Googlebot, lấy đường dẫn và mã trạng thái, sẽ thấy những URL Google thật sự ghé thăm, kể cả trang mồ côi không có trong sitemap.
URL có trong nhật ký Googlebot mà không có trong danh sách của script thường là URL cũ còn liên kết từ website khác, hoặc URL sinh ra do lỗi. Đây là danh sách nên xử lý bằng chuyển hướng 301 về trang phù hợp hoặc trả 410 nếu đã gỡ hẳn.
Khi nào cần proxy để lấy tất cả URL của website và checklist
Lấy URL của website nhỏ thường không cần proxy. Proxy trở nên cần thiết với website lớn, website có chống bot, hoặc khi làm cho nhiều khách hàng cùng lúc.
13 phát hiện, 9 có thể index, bao nhiêu được index?
Khi nào cần proxy
Crawl vài trăm trang của website chính mình từ máy văn phòng là việc bình thường. Crawl hàng chục nghìn trang của website đối thủ hay website khách hàng chạy sau hệ thống chống bot thì khác. IP văn phòng dễ bị chặn, ảnh hưởng tới cả việc truy cập bình thường của mọi người trong văn phòng.
Proxy tách lưu lượng crawl khỏi IP văn phòng và cho phép chạy nhiều dự án song song, mỗi dự án một nhóm IP. Bài proxy pool hướng dẫn chia IP theo mục đích, còn bài web scraping proxy là gì giải thích cơ chế chung.
Công cụ không cần code
Không phải ai cũng muốn chạy script. Screaming Frog có chế độ crawl website và chế độ đọc sitemap, xuất được danh sách URL kèm trạng thái và canonical. Bài proxy Screaming Frog hướng dẫn gắn proxy cho công cụ này.
Với website dựng bằng JavaScript cần trình duyệt, bài Crawl4AI proxy có hướng dẫn crawl qua trình duyệt với proxy. Dù dùng công cụ nào, logic ghép nguồn và phân loại URL trong bài này vẫn áp dụng được.
Chọn proxy
Crawl website ít chống bot với tốc độ vừa phải thì proxy datacenter đủ dùng. Website có hệ thống chống bot cần proxy dân cư. Giữ một IP cố định cho một website trong suốt lần crawl giúp lưu lượng nhất quán, ít bị nghi ngờ hơn đổi IP liên tục.
Khi cần mua proxy cho việc crawl URL, ProxyVN có datacenter Việt Nam, proxy dân cư tĩnh Viettel, VNPT, FPT và proxy 4G, giao thức HTTP hoặc SOCKS5, cấp user và password. Mã hóa mật khẩu bằng quote như trong script nếu mật khẩu có ký tự đặc biệt.
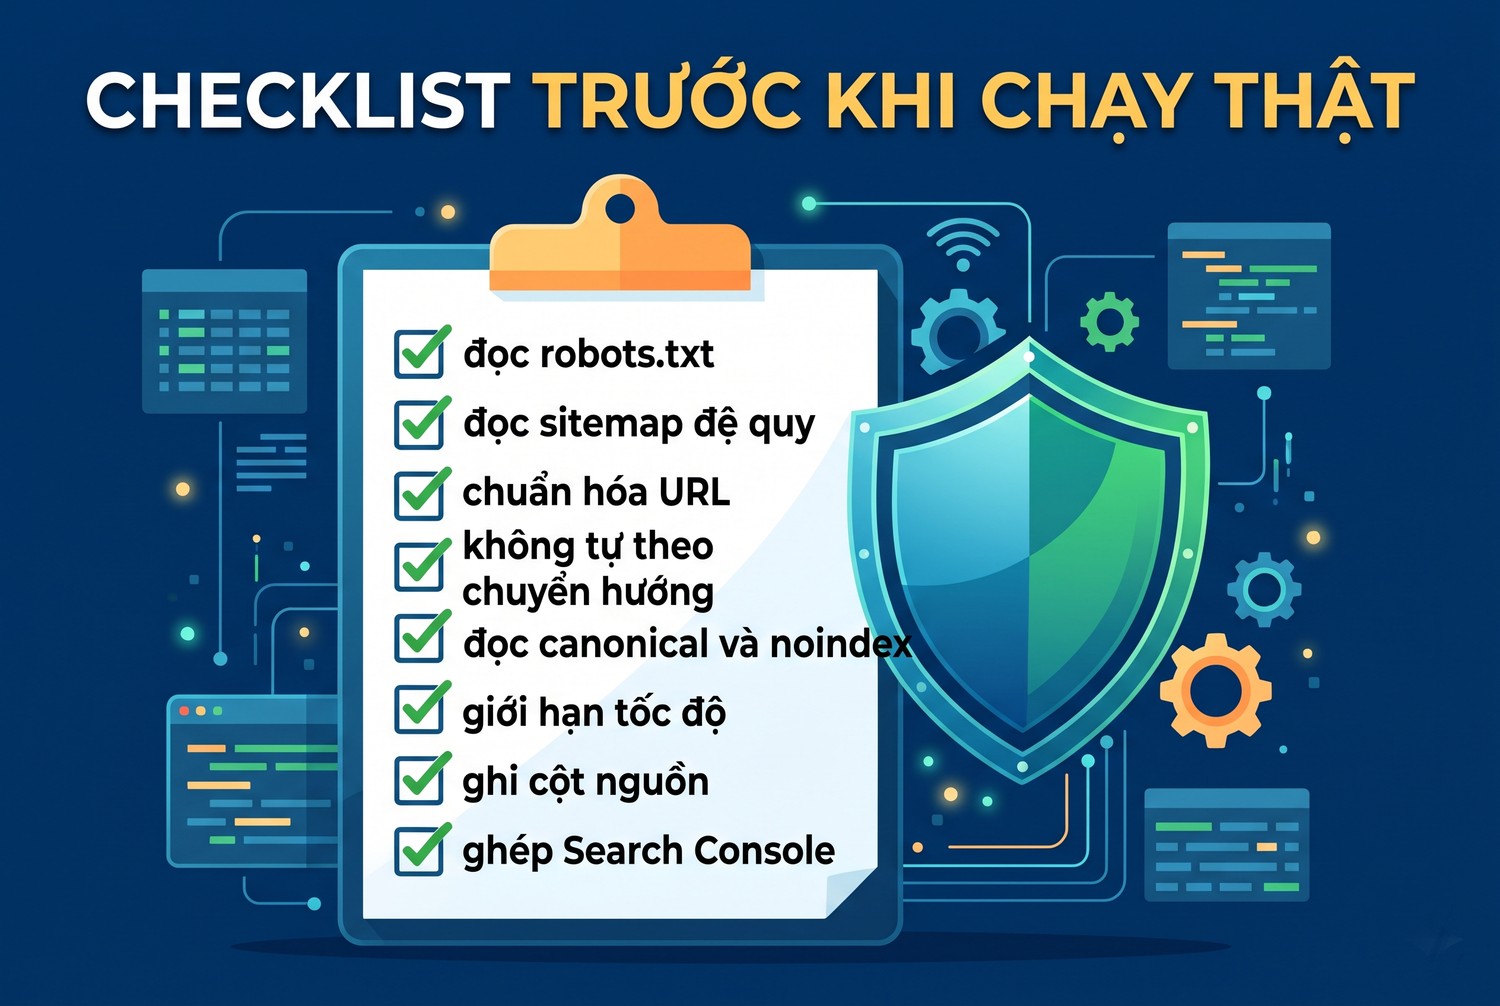
Checklist trước khi chạy thật
Danh sách dưới mình dùng mỗi khi lập bản đồ URL cho một website mới:
- Đọc robots.txt, lấy dòng Sitemap, lọc mọi URL qua bộ đọc theo RFC 9309.
- Đọc sitemap đệ quy, xử lý cả sitemap index lẫn file nén.
- Chuẩn hóa URL: bỏ fragment, bỏ tham số theo dõi, viết thường tên miền.
- Tải trang không tự đi theo chuyển hướng, ghi lại đích chuyển hướng.
- Đọc canonical và meta robots, tách URL phát hiện khỏi URL có thể lập chỉ mục.
- Giới hạn tốc độ, số trang và độ sâu để tránh bẫy URL vô tận.
- Ghi cột nguồn cho từng URL để biết trang mồ côi và trang thiếu trong sitemap.
- Với website của mình, ghép thêm báo cáo lập chỉ mục từ Search Console.
Sitemap cho biết chủ website muốn gì, liên kết cho biết người dùng đi tới đâu, canonical cho biết bản nào là bản chính. Thiếu một nguồn là danh sách thiếu một góc nhìn.
Checklist trước khi chạy thật
Câu hỏi thường gặp
Có cách nào lấy tất cả URL mà không crawl không. Đọc sitemap là cách nhanh nhất, nhưng chỉ ra những URL chủ website đưa vào. Với website của mình, Search Console và nhật ký máy chủ cho thêm URL. Muốn gần đủ thì vẫn phải crawl theo liên kết.
Trang mồ côi tìm bằng cách nào. So danh sách từ sitemap với danh sách từ crawl liên kết. URL chỉ có trong sitemap mà không có liên kết nào trỏ tới là trang mồ côi. Trang mồ côi không có trong sitemap thì chỉ tìm được qua nhật ký máy chủ hoặc dữ liệu phân tích truy cập.
Có nên giữ tham số trong URL không. Giữ tham số làm thay đổi nội dung như mã sản phẩm, số trang. Bỏ tham số theo dõi chiến dịch. Nếu không chắc, xem canonical của trang có tham số: nếu trỏ về URL không tham số thì tham số đó không quan trọng.
Website WordPress có gì khác. WordPress từ bản 5.5 có sẵn sitemap ở /wp-sitemap.xml, còn các plugin SEO phổ biến thường tạo /sitemap_index.xml. Script đọc dòng Sitemap trong robots.txt trước, nên thường tìm đúng file mà không cần đoán. Nếu robots.txt không có dòng này, thử lần lượt hai địa chỉ trên.
Có nên dùng toán tử site trên Google để đếm URL không. Chỉ để ước lượng nhanh. Con số hiển thị là ước lượng, số kết quả xem được bị giới hạn, và chỉ gồm trang Google đã lập chỉ mục. Muốn biết website có bao nhiêu URL thật thì phải crawl như trong bài, muốn biết bao nhiêu URL được lập chỉ mục thì xem Search Console.
Website có hàng triệu URL thì sao. Script trong bài lưu mọi thứ trong bộ nhớ, đủ cho vài chục nghìn URL. Với quy mô lớn hơn, chuyển sang Scrapy với hàng đợi lưu trên đĩa, hoặc chia website theo thư mục và chạy từng phần.
Lấy tất cả URL của website và những điều cần nhớ
Lấy tất cả URL của website cần ghép sitemap, liên kết nội bộ và canonical, chuẩn hóa URL, lọc qua robots.txt. URL phát hiện chưa phải URL được lập chỉ mục, con số thật nằm ở Search Console. Cần proxy ổn định, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khi lấy tất cả URL của website.


