
Chuyển HTML sang Markdown bằng MarkItDown: giữ link, bảng
Chuyển HTML sang Markdown bằng MarkItDown là cách biến trang HTML đã tải về thành văn bản Markdown có heading, danh sách, bảng và link. Kết quả dùng được cho kho tài liệu, cho pipeline RAG hay đơn giản là đọc cho dễ. Câu hỏi thực tế là chuyển xong thì mất những gì. ProxyVN chạy thử ngày 29/10/2026 với MarkItDown 0.1.9 trên một trang HTML mẫu có đủ thành phần khó: bảng, bảng gộp ô, khối code, danh sách lồng, link tương đối và thẻ base. Bài ghi lại cụ thể phần nào giữ nguyên, phần nào lệch, và cách sửa.
Chuyển HTML sang Markdown bằng MarkItDown: mục tiêu dữ liệu, quyền và phạm vi
Phần đầu chốt mình chuyển cái gì, đầu ra cần đạt chuẩn nào, và ranh giới với các cách xử lý HTML khác.
MarkItDown là gì
MarkItDown là thư viện Python mã nguồn mở của Microsoft, chuyển nhiều loại tài liệu sang Markdown: HTML, PDF, Word, Excel, PowerPoint, ảnh và vài loại khác. Thư viện nhắm tới việc tạo đầu vào cho mô hình ngôn ngữ, nên ưu tiên giữ cấu trúc hơn giữ trình bày.
Với HTML, MarkItDown dựa trên BeautifulSoup để đọc cây và markdownify để sinh Markdown. Hiểu điều này giúp anh em đoán được hành vi: những gì markdownify xử lý tốt thì MarkItDown xử lý tốt, và ngược lại.
Đầu ra mà bài này hướng tới
Đầu ra là một tệp Markdown cho mỗi trang HTML, kèm một bảng kiểm trước và sau. Bảng kiểm trả lời: heading còn đủ cấp không, link còn đúng đích không, bảng còn đúng hàng cột không, khối code còn nguyên không, và phần rác như menu, chân trang, script có bị kéo theo không.
Bảng kiểm là phần quan trọng nhất của bài. Chuyển đổi tự động luôn mất một thứ gì đó. Biết chính xác mất gì thì mới quyết định được có chấp nhận hay không.
HTML đã tải về, không phải crawl
Bài bắt đầu từ HTML đã có trên đĩa hoặc đã tải bằng một request được phép. Bài không bàn cách thu thập trang hàng loạt. Việc tải trang của người khác vẫn tuân theo robots.txt và điều khoản của trang, bài robots.txt khi crawl website giải thích chuyện đó.
Lab dùng một trang mẫu tự viết, phục vụ qua máy chủ HTTP cục bộ ở cổng 9770. Không trang nào của bên thứ ba bị tải trong lab này.
Quyền với nội dung sau khi chuyển
Chuyển sang Markdown không đổi quyền sở hữu nội dung. Tài liệu nội bộ của công ty vẫn là tài liệu nội bộ. Bài viết có bản quyền vẫn có bản quyền dù đổi định dạng.
Khi đưa Markdown vào kho dùng chung, giữ URL gốc và thời điểm tải ở đầu tệp. Người đọc sau cần biết nội dung đến từ đâu để kiểm và để tôn trọng nguồn.
Ranh giới với HTML sang JSON
Bài chuyển HTML sang JSON bàn việc trích các trường có schema rõ ràng như giá, tên, ngày. Đầu ra là dữ liệu có cấu trúc để lưu vào bảng. Markdown thì khác: đầu ra là văn bản có cấu trúc để người hoặc mô hình đọc.
Một trang sản phẩm cần JSON. Một trang tài liệu hướng dẫn cần Markdown. Chọn sai thì hoặc mất văn bản, hoặc mất trường dữ liệu.
Ranh giới với trích nội dung chính
Bài Trafilatura web scraping bàn việc tách phần nội dung chính khỏi menu, quảng cáo và chân trang. MarkItDown không làm việc đó. Lab sẽ cho thấy MarkItDown giữ nguyên menu và chân trang trong đầu ra.
Hai công cụ bổ sung cho nhau. Trafilatura hay một bộ chọn CSS cắt phần chính, MarkItDown chuyển phần đó sang Markdown giữ bảng và link tốt hơn.
Ai cần Markdown từ HTML
Nhóm xây kho tri thức nội bộ chuyển trang wiki cũ sang Markdown để quản lý bằng Git. Nhóm làm RAG cần văn bản sạch có heading để chia đoạn. Người viết tài liệu cần lấy nội dung từ trang cũ để biên tập lại.
Cả ba đều cần link còn đúng và bảng còn đọc được. Đó là hai thứ lab kiểm kỹ nhất.
Những gì bài không làm
Bài không thử MarkItDown với PDF, Word hay ảnh. Bài không dùng tính năng mô tả ảnh bằng mô hình ngôn ngữ của MarkItDown. Bài không so sánh với mọi công cụ chuyển đổi khác, chỉ đối chiếu với kỳ vọng từ HTML gốc.
Chuyển HTML sang Markdown bằng MarkItDown: giữ URL tương đối và kiểm tra mất bảng, link
Phần này đi qua trang mẫu, cách gọi MarkItDown và kết quả kiểm từng thành phần.
Trang HTML mẫu
Trang mẫu dài 1.708 ký tự, có thẻ title, thẻ base trỏ tới https://docs.example.com/guide/, một khối style, một khối script, thanh nav với hai link, phần main và chân trang có link quyền riêng tư.
Phần main có một H1, ba H2 và một H3. Đoạn văn có link tương đối, link neo, link đầy đủ, chữ đậm, chữ nghiêng và mã nội dòng. Trang còn có khối pre code mang class language-bash, danh sách lồng, danh sách đánh số, bảng thường, bảng gộp ô bằng rowspan và colspan, ảnh có alt, trích dẫn và khối details.
Gọi MarkItDown với tệp cục bộ
from markitdown import MarkItDown
md = MarkItDown()
res = md.convert("html/a_tai_lieu.html")
print(res.title)
open("a_tai_lieu.md", "w", encoding="utf-8").write(res.text_content)
Lab đo 0,012 giây cho trang mẫu. Đầu ra dài 930 ký tự, 47 dòng. res.title trả đúng nội dung thẻ title là Hướng dẫn cấu hình proxy cho máy chủ, nhưng tiêu đề này không xuất hiện trong text_content.
Bảng kiểm thành phần
Thành phần |
Kết quả |
Ghi chú |
|---|---|---|
H1, H2, H3 |
Giữ đủ |
Dạng dấu thăng |
Đoạn văn, đậm, nghiêng |
Giữ |
Gạch dưới trong chữ đậm bị thoát thành \_ |
Mã nội dòng |
Giữ |
Dấu backtick |
Khối code |
Giữ nội dung |
Mất tên ngôn ngữ bash |
Danh sách lồng |
Giữ |
Cấp hai dùng dấu cộng |
Danh sách đánh số |
Giữ |
1. và 2. |
Bảng thường |
Giữ đúng |
3 cột, 2 hàng |
Bảng gộp ô |
Lệch |
Hàng thứ hai thiếu một ô |
Ảnh |
Giữ |
alt và src tương đối |
Trích dẫn |
Giữ |
Dấu lớn hơn |
details, summary |
Thành văn bản thường |
Mất tính chất ẩn hiện |
script, style |
Bị loại |
Đúng mong đợi |
nav, footer |
Bị giữ |
Lẫn vào đầu và cuối |
Link tương đối giữ nguyên chuỗi
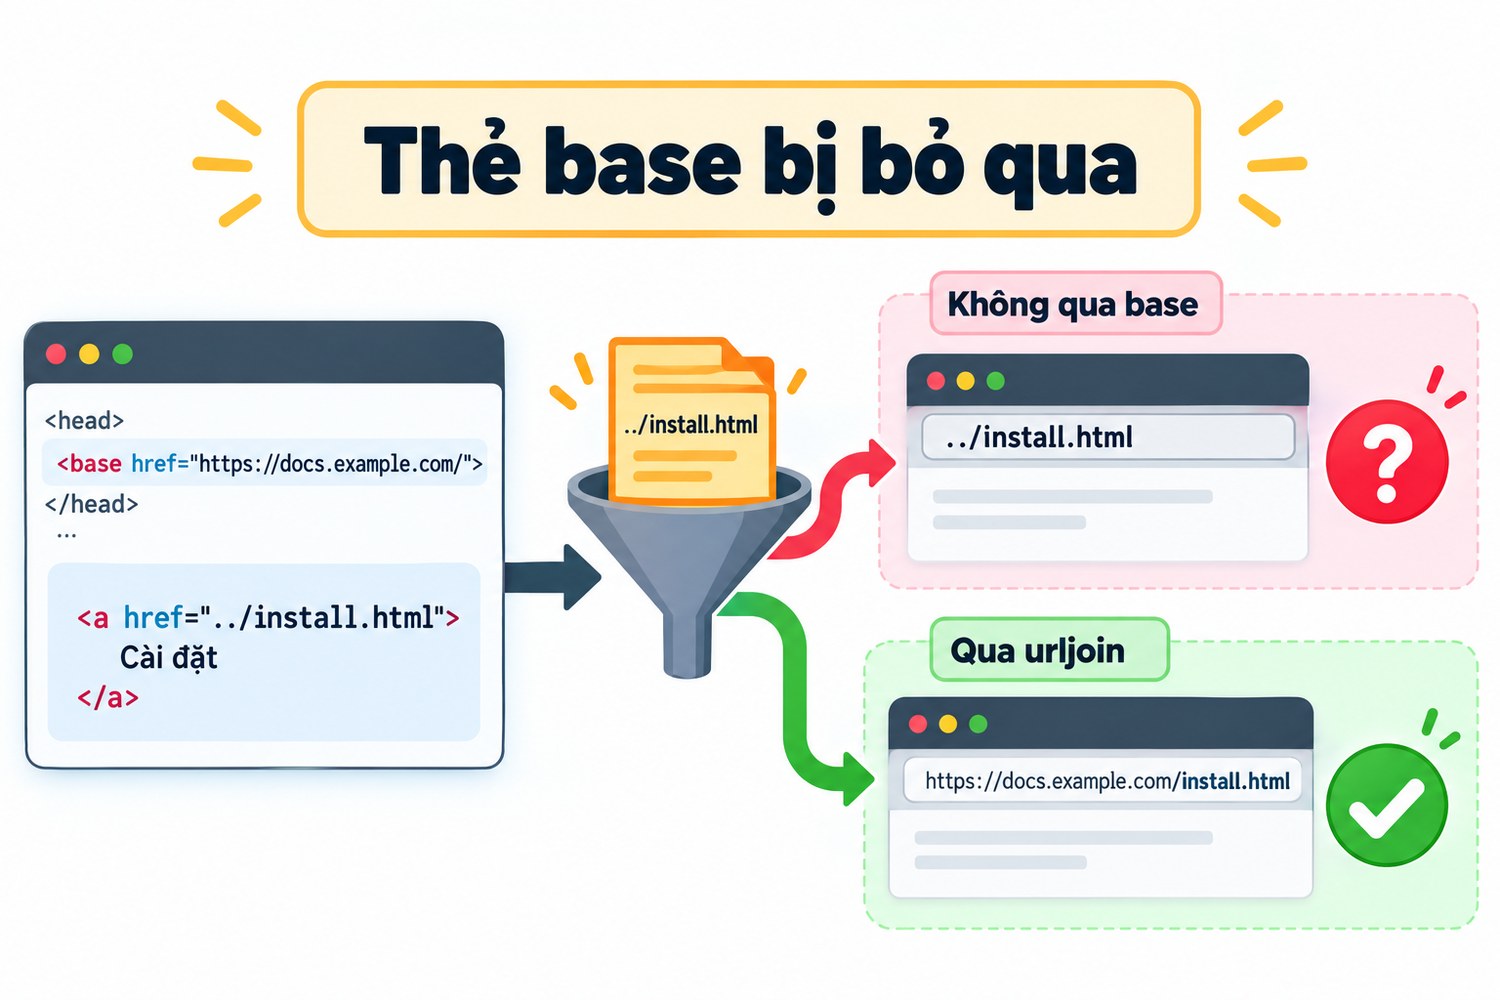
Trang gốc có bảy giá trị href, gồm cả href của thẻ base. Đầu ra có bảy link, nhưng là sáu link a cộng một src ảnh: /, /blog, ../install.html, #bang, https://example.org/spec, img/so-do.png và /privacy.
MarkItDown chép nguyên chuỗi href, không giải theo URL gốc. Link ../install.html vẫn là ../install.html. Khi tệp Markdown nằm ở chỗ khác, link này trỏ vào hư không.
Thẻ base bị bỏ qua
Thẻ base bị bỏ qua
Thẻ base trong trang mẫu nói mọi link tương đối phải giải theo https://docs.example.com/guide/. Trình duyệt làm đúng như vậy. MarkItDown thì không đọc thẻ base, nên link trong Markdown khác với link mà người đọc trang thật nhìn thấy.
Đây là chỗ mất thông tin quan trọng nhất trong lab. Nó không báo lỗi, không cảnh báo. Chỉ phép so link trước và sau mới thấy.
Bảng gộp ô bị lệch
Bảng gộp ô bị lệch
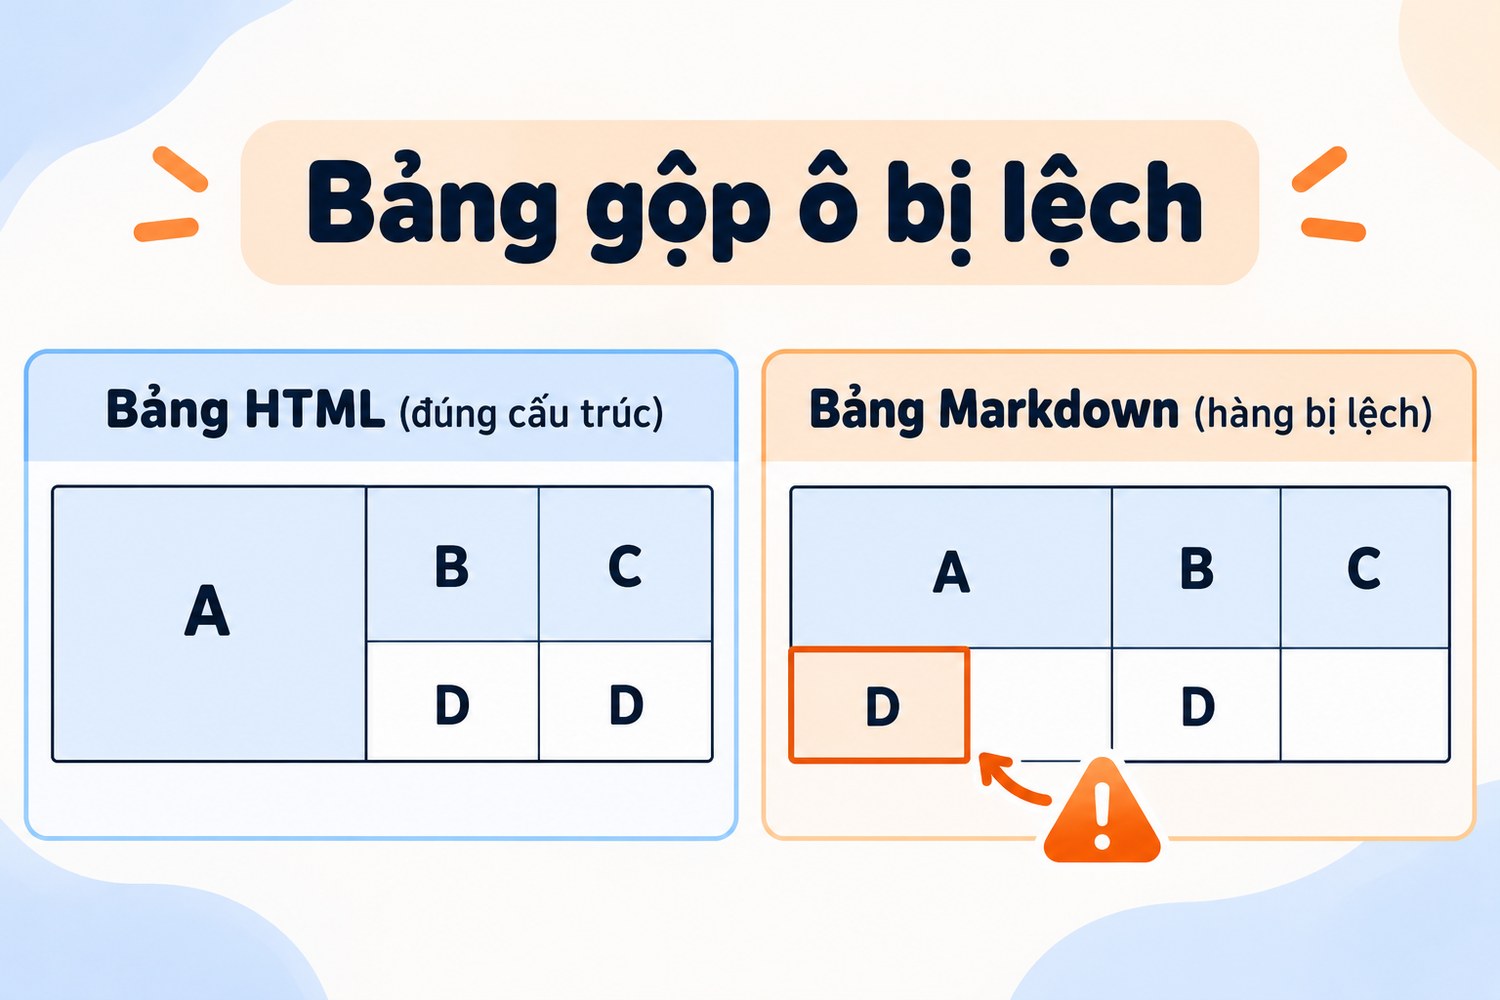
Bảng thứ hai có ô Gói gộp hai hàng và ô Giới hạn gộp hai cột. Markdown kiểu GitHub không có khái niệm gộp ô. Đầu ra có hàng tiêu đề với một ô trống ở cuối, hàng thứ hai chỉ có Luồng và Băng thông, lệch sang trái một cột so với tiêu đề.
Người đọc nhìn bảng sẽ hiểu sai: Luồng nằm dưới cột Gói. Bảng thường thì đúng từng ô. Với trang có nhiều bảng gộp ô, phải xử lý riêng.
Khối code mất tên ngôn ngữ
Khối pre code có class language-bash. Đầu ra là khối ba dấu backtick không có tên ngôn ngữ. Nội dung lệnh giữ nguyên từng ký tự, kể cả dấu at và dấu hai chấm trong URL proxy.
Mất tên ngôn ngữ làm mất tô màu khi hiển thị, và mô hình ngôn ngữ mất một gợi ý nhỏ về loại mã. Sửa được bằng một bước hậu xử lý đọc class từ HTML gốc.
Chuẩn bị đầu vào, URL gốc và phiên bản khi chuyển HTML sang Markdown bằng MarkItDown
Phần này gom các quyết định trước khi chạy hàng loạt: cắt phần chính, giải link, mã hóa ký tự và phiên bản.
Cắt phần chính trước khi chuyển
Cắt main trước khi chuyển
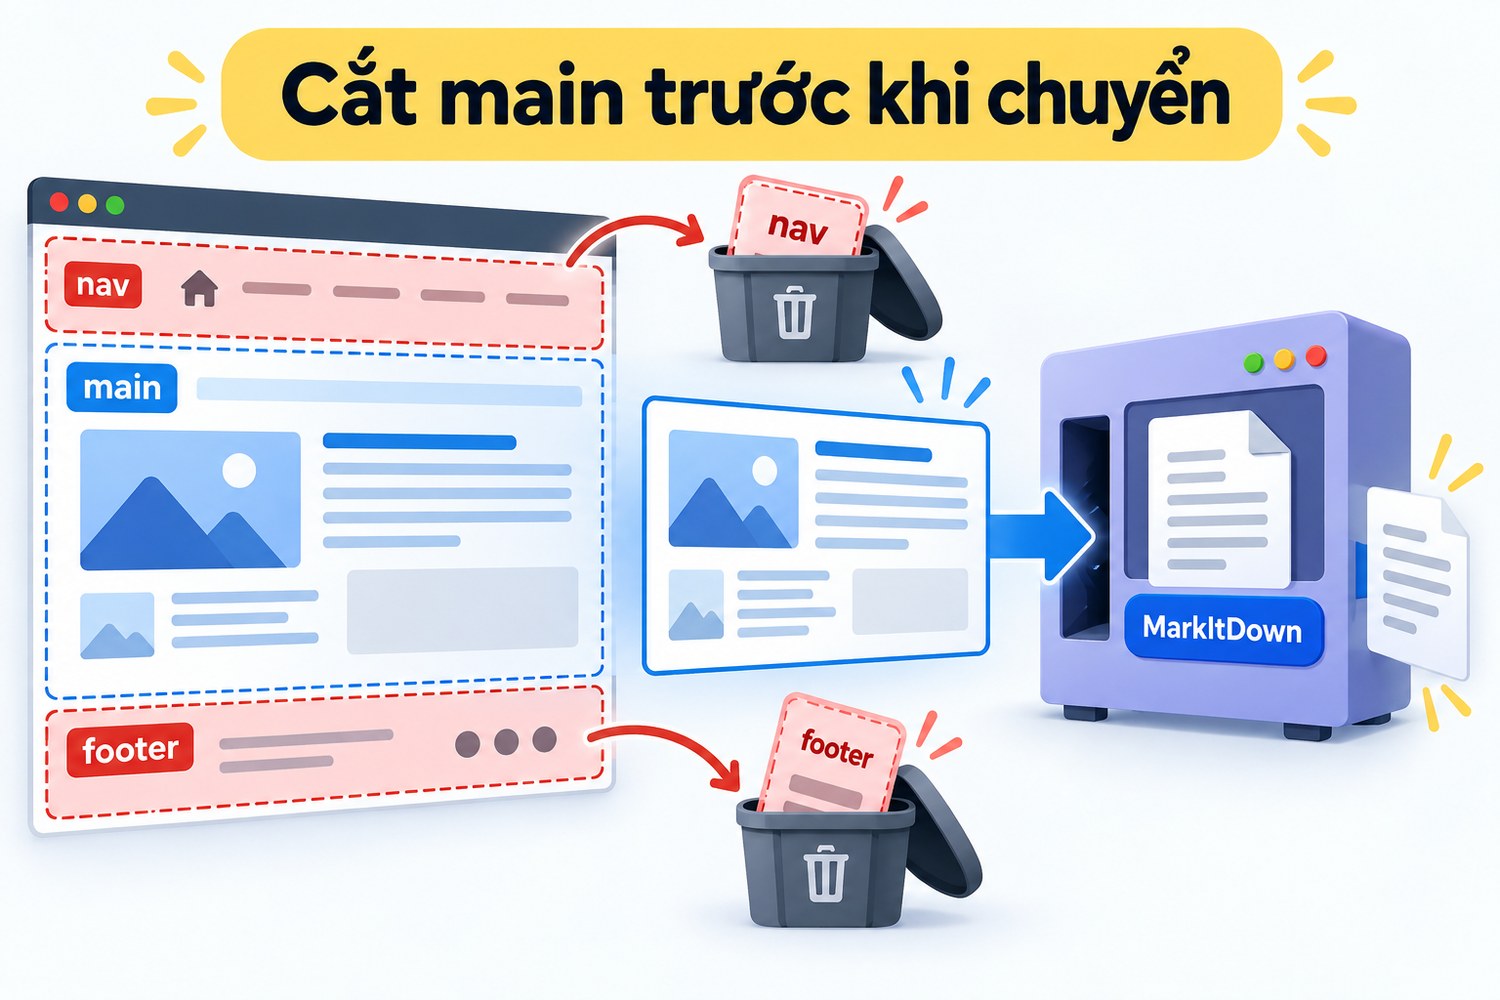
Vì MarkItDown giữ cả nav và footer, cắt phần main trước rồi mới chuyển. Trang mẫu có thẻ main rõ ràng nên chỉ cần BeautifulSoup chọn main. Trang thật có thể dùng article, một div có id content, hoặc cần Trafilatura để đoán.
Lab chuyển riêng phần main qua convert_stream. Đầu ra không còn Trang chủ ở đầu và Quyền riêng tư ở cuối, dài 909 ký tự thay vì 930.
Giải link theo URL gốc
import io
from urllib.parse import urljoin
from bs4 import BeautifulSoup
from markitdown import MarkItDown, StreamInfo
soup = BeautifulSoup(html, "html.parser")
base = soup.base["href"] if soup.base else page_url
main = soup.main or soup.body
for tag in main.find_all(["a", "img"]):
    k = "href" if tag.name == "a" else "src"
    if tag.get(k) and not tag[k].startswith("#"):
        tag[k] = urljoin(base, tag[k])
doc = f"<html><body>{main}</body></html>".encode("utf-8")
res = MarkItDown().convert_stream(io.BytesIO(doc),
        stream_info=StreamInfo(extension=".html", charset="utf-8"))
Đoạn code đọc thẻ base nếu có, nếu không thì dùng URL trang. Mọi href và src được giải thành URL đầy đủ, trừ link neo bắt đầu bằng dấu thăng.
Kết quả sau khi giải link
Link ../install.html thành https://docs.example.com/install.html. Ảnh img/so-do.png thành https://docs.example.com/guide/img/so-do.png. Link neo #bang giữ nguyên vì nó trỏ trong cùng tài liệu. Link đầy đủ https://example.org/spec không đổi.
Bốn link còn lại trong phần main đều trỏ đúng đích mà trình duyệt sẽ mở. Đây là kết quả mong muốn khi Markdown được lưu ở chỗ khác với trang gốc.
Khi nào nên giữ link tương đối
Khi chuyển cả một website tài liệu sang Markdown và giữ nguyên cấu trúc thư mục, link tương đối giữa các trang vẫn đúng. Khi đó giải link thành đầy đủ lại làm Markdown trỏ về website cũ thay vì trỏ nội bộ.
Quyết định một lần cho cả bộ tài liệu. Ghi quyết định vào README của kho để người sau không sửa lẫn lộn.
Mã hóa ký tự
Trang mẫu khai báo meta charset utf-8, tiếng Việt có dấu giữ nguyên trong đầu ra. Với convert_stream, truyền charset trong StreamInfo để MarkItDown không phải đoán. Trang cũ dùng windows-1258 hay không khai báo charset dễ bị lỗi font.
Bài sửa lỗi encoding tiếng Việt khi crawl có cách phát hiện và sửa trước khi chuyển.
Phiên bản và môi trường
Lab dùng Python 3.12.10, markitdown 0.1.9 cài kèm nhóm tùy chọn all, beautifulsoup4 4.15.0, markdownify 1.2.3, requests 2.34.2, trong venv riêng. MarkItDown đang ở nhánh 0.1, hành vi có thể đổi giữa các bản nhỏ. Khóa phiên bản trong requirements.txt.
Nhóm all kéo theo nhiều phụ thuộc cho PDF, Office và ảnh. Nếu chỉ chuyển HTML, cài bản gốc là đủ và nhẹ hơn.
Tên ngôn ngữ cho khối code
Trước khi chuyển, duyệt các thẻ pre code, đọc class bắt đầu bằng language-, ghi ra danh sách theo thứ tự. Sau khi chuyển, duyệt các khối ba dấu backtick trong Markdown theo cùng thứ tự và chèn tên ngôn ngữ vào sau dấu mở.
Cách này dựa trên giả định thứ tự khối code không đổi, đúng với MarkItDown trong lab. Kiểm số khối trước và sau bằng nhau trước khi chèn.
Chuyển hàng loạt và qua mạng khi chuyển HTML sang Markdown bằng MarkItDown
Phần này ghi kết quả gọi MarkItDown với URL, qua proxy, và khi gặp trang lỗi.
MarkItDown nhận cả URL
Ngoài đường dẫn tệp, convert nhận URL http hoặc https. MarkItDown tự tải trang bằng requests rồi chuyển. Constructor nhận tham số requests_session, cho phép truyền một phiên requests đã cấu hình sẵn header và proxy.
Lab truyền một phiên có User-Agent ProxyVN-lab/1.0 kèm email giả [email protected]. Khi chạy thật, thay bằng tên dự án và email thật.
Kết quả gọi qua URL và proxy
Cách gọi |
Kết quả |
Giây |
Giống bản cục bộ |
|---|---|---|---|
Tệp cục bộ |
Thành công |
0,012 |
Mốc so sánh |
URL gọi thẳng |
Thành công |
0,075 |
Có, 930 ký tự |
URL qua proxy HTTP cục bộ |
Thành công |
0,084 |
Có, 930 ký tự |
URL qua proxy SOCKS5h cục bộ |
Thành công |
0,083 |
Có, 930 ký tự |
URL trang không tồn tại |
HTTPError 404 |
không ghi |
Không có đầu ra |
Ba cách gọi qua mạng cho đầu ra giống hệt từng ký tự với bản đọc từ tệp. Proxy không làm thay đổi nội dung chuyển đổi.
Trang lỗi ném ngoại lệ
Với URL trả 404, MarkItDown ném HTTPError của requests. Không có đầu ra rỗng, không có Markdown của trang lỗi. Đây là hành vi tốt: job hàng loạt biết ngay trang nào hỏng thay vì lưu một tệp chứa chữ Not Found.
Bắt ngoại lệ theo từng URL, ghi vào danh sách lỗi, tiếp tục URL kế tiếp. Đừng để một trang hỏng dừng cả job.
Tách tải với chuyển đổi
Truyền URL cho MarkItDown tiện, nhưng gộp hai việc vào một bước. Khi chạy hàng loạt, nên tải HTML bằng code riêng, lưu thô xuống đĩa, rồi chuyển từ tệp. Lý do: khi đổi logic chuyển đổi, chạy lại từ tệp thô mà không tải lại trang.
Lưu HTML thô cũng cho phép đọc thẻ base và header gốc, những thứ mất đi khi chỉ giữ Markdown.
Nhịp tải
Lab chỉ tải một trang mẫu từ máy chủ cục bộ. Khi tải trang thật, nghỉ giữa các request, tôn trọng robots.txt và giới hạn của máy chủ. MarkItDown không có cơ chế giới hạn nhịp riêng, việc đó thuộc về code gọi nó.
Markdown cho người đọc và cho mô hình
Markdown phục vụ hai kiểu người đọc với nhu cầu khác nhau. Người đọc cần bảng thẳng hàng, ảnh hiển thị được và link bấm được. Mô hình ngôn ngữ cần heading rõ để biết đoạn nào thuộc mục nào, và cần ít ký tự thừa để tiết kiệm token.
Lab cho thấy MarkItDown làm tốt phần heading và phần lược bỏ script, style. Phần nav và footer thì thừa với cả hai kiểu người đọc. Mỗi dòng menu lặp lại trên mọi trang sẽ làm kho tài liệu RAG đầy những đoạn giống nhau, kéo kết quả truy xuất lệch đi.
Đo kích thước trước và sau
Trang mẫu 1.708 ký tự HTML ra 930 ký tự Markdown, giảm gần một nửa. Phần giảm chủ yếu là thẻ, thuộc tính, script và style. Với trang thật nhiều mã theo dõi và CSS nội dòng, tỷ lệ giảm còn lớn hơn nhiều.
Ghi hai con số này cho từng trang. Trang có Markdown dài bất thường so với HTML thường là trang bị giữ lại rác. Trang có Markdown quá ngắn có thể là trang mà nội dung thật sinh bằng JavaScript.
Tốc độ chuyển đổi
0,012 giây cho trang 1,7 KB. Trang thật vài trăm KB với nhiều bảng sẽ chậm hơn, phần lớn thời gian nằm ở BeautifulSoup parse cây. Với hàng nghìn trang, chạy song song nhiều tiến trình, mỗi tiến trình một MarkItDown riêng.
Đối soát nội dung, giá trị thiếu và xuất xứ sau khi chuyển HTML sang Markdown bằng MarkItDown
Phần này biến bảng kiểm thủ công thành phép kiểm tự động cho từng trang.
Đếm heading trước và sau
Đếm thẻ h1 tới h6 trong HTML phần main, đếm dòng bắt đầu bằng dấu thăng trong Markdown, ngoài khối code. Hai số phải bằng nhau. Trang mẫu có 5 heading trong phần main, đầu ra có 5.
Lệch số heading thường do heading nằm trong thẻ lạ hoặc do trang dùng div có class trông như heading. Phép đếm bắt được ngay.
Đối chiếu tập link
Lấy tập href của thẻ a trong HTML phần main sau khi giải URL, lấy tập link trong Markdown. So hai tập. Link có trong HTML mà thiếu trong Markdown là mất mát. Link trong Markdown mà không có trong HTML là bất thường cần xem.
Trong lab, tập link khớp sau khi giải URL. Trước khi giải, link vẫn khớp về chuỗi nhưng sai về đích, vì thẻ base bị bỏ qua. Vì vậy phép so phải làm trên URL đã giải.
Kiểm bảng có gộp ô
Duyệt mọi thẻ td và th trong HTML, tìm thuộc tính rowspan hoặc colspan lớn hơn 1. Nếu có, đánh dấu trang cần xem tay hoặc giữ bảng đó dạng HTML trong Markdown. Markdown kiểu GitHub cho phép chèn HTML thô.
Lab có một bảng gộp ô trong hai bảng. Phép kiểm này bắt được nó trước khi người đọc nhìn thấy bảng lệch.
Ký tự bị thoát
Chữ NO_PROXY trong thẻ strong thành NO\_PROXY trong đầu ra. markdownify thoát dấu gạch dưới để tránh bị hiểu là chữ nghiêng. Khi hiển thị, Markdown vẫn ra đúng NO_PROXY. Nhưng khi tìm kiếm chuỗi thô trong tệp, tìm NO_PROXY sẽ không thấy.
Mã nội dòng và khối code không bị thoát, vì nội dung trong backtick là nguyên văn. Đây là lý do nên giữ tên biến, lệnh, đường dẫn trong thẻ code ngay từ HTML gốc.
details và summary
Khối details có summary Câu hỏi và nội dung bên trong. Đầu ra là hai đoạn văn thường: Câu hỏi, rồi câu hỏi và trả lời. Tính chất ẩn hiện mất đi, nhưng nội dung còn đủ.
Với RAG, nội dung đủ là quan trọng hơn tính chất ẩn hiện. Với tài liệu cho người đọc, có thể giữ khối details dạng HTML thô.
Kiểm ảnh còn hiển thị được
Ảnh trong Markdown chỉ là đường dẫn. Sau khi giải URL, gửi HEAD tới từng src để biết ảnh còn tồn tại không. Ảnh trong lab trỏ tới tên miền ví dụ nên không kiểm được, nhưng với trang thật, đây là bước bắt ảnh vỡ trước khi đưa tài liệu lên kho.
Nếu cần Markdown dùng được khi mất mạng, tải ảnh về thư mục cạnh tệp Markdown và đổi src thành đường dẫn tương đối tới thư mục đó.
Giữ xuất xứ ở đầu tệp
Ghi một khối front matter ở đầu mỗi tệp Markdown với URL gốc, title lấy từ res.title, thời điểm tải, phiên bản MarkItDown và danh sách cảnh báo như bảng gộp ô. res.title có giá trị mà text_content không chứa, nên nếu không ghi ra, tiêu đề trang mất hẳn.
Bài RAG với ChromaDB và dữ liệu web bàn cách dùng metadata này khi chia đoạn và truy xuất.
Lưu kết quả, giới hạn request và khi nào chuyển HTML sang Markdown bằng MarkItDown cần proxy
Phần cuối bàn chuyện lưu trữ, nhịp tải và vị trí đúng của proxy.
Lưu Markdown cạnh HTML thô
Mỗi trang lưu ba tệp: HTML thô, Markdown và JSON nhỏ chứa kết quả kiểm. Ba tệp cùng tên gốc, khác đuôi. Khi nâng cấp MarkItDown, chạy lại chuyển đổi từ HTML thô và so Markdown mới với cũ để thấy hành vi thay đổi.
Chuyển lại khi trang nguồn đổi
Trang tài liệu được sửa theo thời gian. Lưu ETag hoặc Last-Modified của lần tải trước, lần sau gửi kèm để máy chủ trả 304 khi trang chưa đổi. Chỉ chuyển lại những trang thật sự đổi, phần còn lại giữ nguyên tệp Markdown cũ.
Cách này giảm tải cho máy chủ nguồn, giảm số commit vô nghĩa trong Git, và giúp diff chỉ hiện những thay đổi có thật. Với kho vài nghìn trang, khác biệt về thời gian chạy rất lớn.
Đặt tên tệp từ URL
Tên tệp Markdown nên suy ra được từ URL để tra ngược. Một cách đơn giản là lấy đường dẫn URL, bỏ đuôi html, thay dấu gạch chéo bằng thư mục. Tránh dùng tiêu đề trang làm tên tệp, vì tiêu đề có thể trùng hoặc đổi.
Quản lý bằng Git
Markdown là văn bản, quản lý bằng Git rất hợp. Mỗi lần chuyển lại tạo một commit. diff cho thấy chính xác câu nào, link nào, bảng nào đổi. Đây là lợi thế lớn so với lưu HTML hay PDF.
Tải trang tôn trọng nguồn
Khi tải hàng loạt, giới hạn nhịp, đặt User-Agent rõ ràng, cache trang đã tải. Bài rate limit API khi dùng proxy có mẫu bộ đếm request dùng được cho cả trang HTML.
Proxy trong lab kiểm ở đâu
Lab truyền phiên requests có proxy vào MarkItDown và tải trang mẫu qua proxy HTTP có xác thực và SOCKS5h cục bộ. Cả hai thành công, đầu ra giống hệt gọi thẳng. Log proxy HTTP ghi GET http://127.0.0.1:9770/a_tai_lieu.html với xác thực đúng. Log SOCKS5 ghi CONNECT tới 127.0.0.1 cổng 9770.
Máy chủ lab chạy HTTP thường nên proxy HTTP thấy cả URL. Với trang https, proxy chỉ thấy CONNECT tới tên máy và cổng 443.
Proxy nằm ở bước tải, không ở bước chuyển
MarkItDown chuyển đổi offline khi đầu vào là tệp. Proxy chỉ có vai trò khi MarkItDown tự tải URL, hoặc khi code riêng của anh em tải HTML. Nếu tách tải với chuyển đổi như khuyên ở trên, bước chuyển đổi không cần mạng.
Đừng cấu hình proxy cho bước chuyển đổi từ tệp. Nó không làm gì, chỉ làm cấu hình rối hơn.
Khi nào cần proxy thật
Proxy cần khi máy tải trang nằm trong mạng nội bộ chỉ được ra Internet qua proxy. Trường hợp thứ hai là tổ chức yêu cầu lưu lượng ra ngoài đi qua một IP cố định để giám sát, hay để trang nguồn đưa IP đó vào danh sách cho phép. Cấu hình và mã hóa mật khẩu có ký tự đặc biệt có trong bài định dạng proxy.
Bài Web Scraping proxy là gì phân biệt các vai trò của proxy. Bài proxy cho RAG pipeline bàn vị trí proxy khi dữ liệu web đi vào hệ thống hỏi đáp.
Khi máy chủ của nhóm đặt tại Việt Nam và cần IP thoát ổn định cho job tải tài liệu, proxy tĩnh dễ quản lý hơn proxy xoay. ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay qua HTTP hoặc SOCKS5. Anh em có thể mua proxy Việt Nam tại trang chủ ProxyVN rồi truyền vào requests_session của MarkItDown.
Giới hạn suy luận của bài
Số liệu đến từ một trang HTML mẫu tự viết, chuyển bằng MarkItDown 0.1.9 ngày 29/10/2026. Trang thật có cấu trúc phức tạp hơn nhiều: bảng lồng, iframe, nội dung sinh bằng JavaScript. MarkItDown không chạy JavaScript, nên nội dung chỉ có sau khi trình duyệt chạy script sẽ không có trong đầu ra.
Lab không thử trang thật trên Internet, không thử PDF hay Office, không thử proxy thương mại. Hành vi bỏ qua thẻ base và làm lệch bảng gộp ô được ghi nhận với phiên bản này, có thể đổi ở bản sau.
Checklist chuyển HTML sang Markdown bằng MarkItDown
Checklist MarkItDown
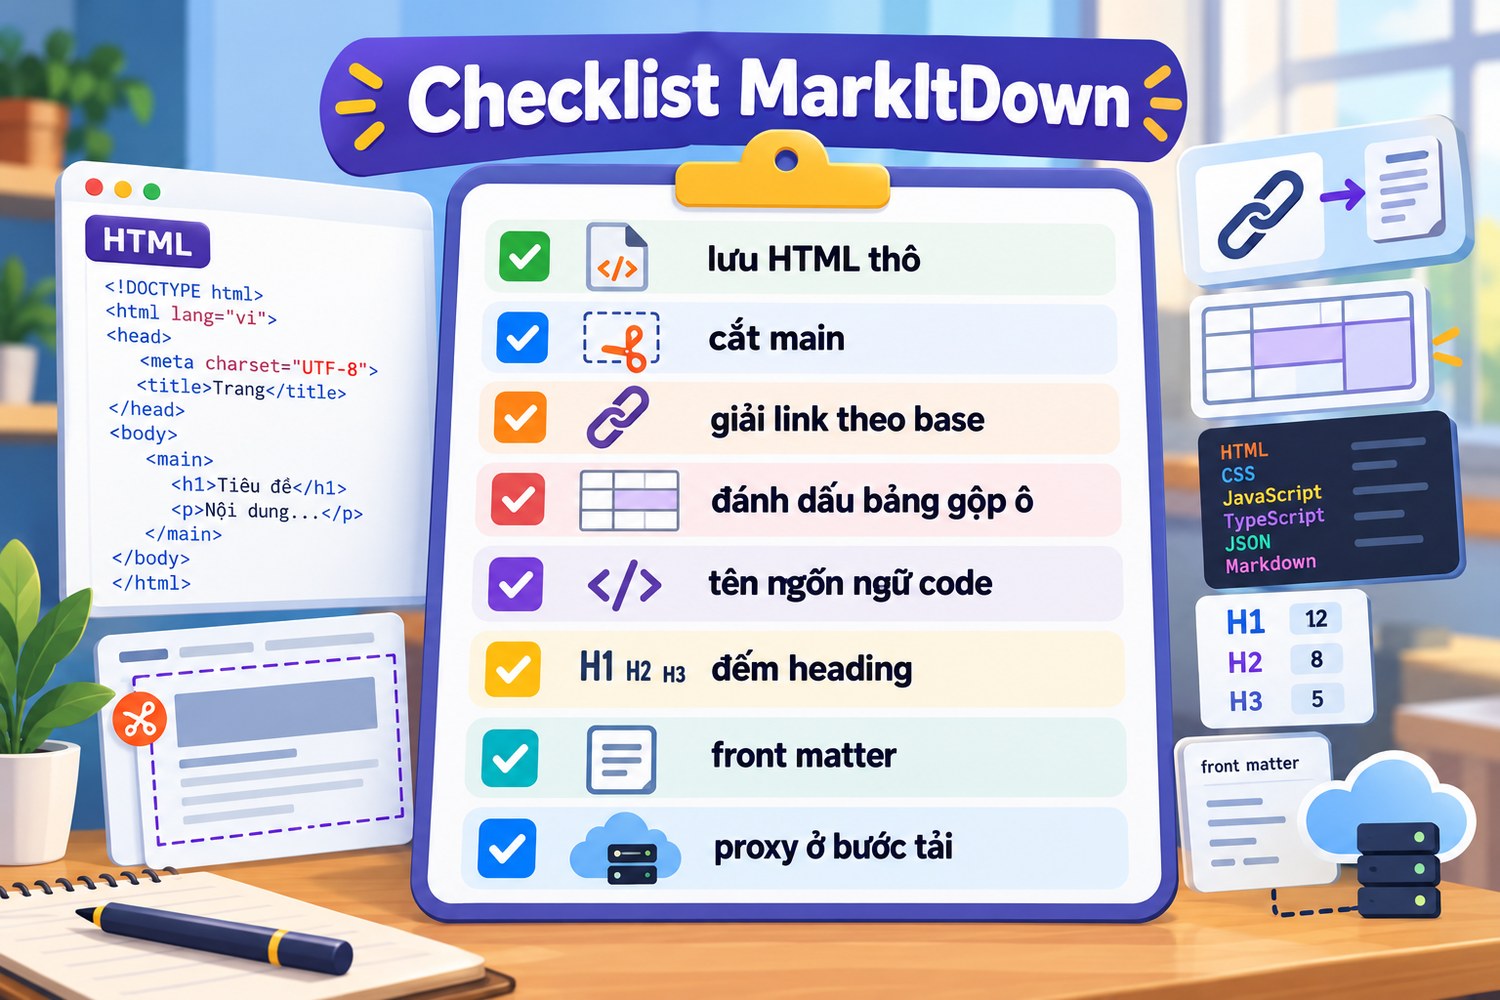
- Lưu HTML thô trước, chuyển từ tệp.
- Cắt phần main trước khi chuyển.
- Giải href và src theo thẻ base hoặc URL trang.
- Đánh dấu bảng có rowspan, colspan.
- Khôi phục tên ngôn ngữ cho khối code.
- Đếm heading và so tập link trước, sau.
- Ghi res.title và URL gốc vào front matter.
- Proxy chỉ ở bước tải, bắt HTTPError từng URL.
Câu hỏi thường gặp về chuyển HTML sang Markdown bằng MarkItDown
MarkItDown có tự bỏ menu và chân trang không?
Không. Lab thấy nav và footer có trong đầu ra. Cắt phần main trước khi chuyển.
Vì sao link trong Markdown trỏ sai?
MarkItDown chép nguyên href, không đọc thẻ base. Giải link theo URL gốc trước khi chuyển.
Bảng có gộp ô hiển thị thế nào?
Bị lệch, vì Markdown kiểu GitHub không có gộp ô. Giữ bảng đó dạng HTML hoặc sửa tay.
MarkItDown có chạy JavaScript không?
Không. Nội dung sinh bằng script không có trong đầu ra. Cần trình duyệt không giao diện để lấy HTML đã chạy script.
Có dùng proxy với MarkItDown được không?
Được, qua tham số requests_session. Lab thử proxy HTTP và SOCKS5h cục bộ đều cho đầu ra giống hệt.
Tiêu đề trang đi đâu?
Nằm ở res.title, không có trong text_content. Ghi ra front matter để không mất.
Chuyển HTML sang Markdown bằng MarkItDown và những điều cần nhớ
Chuyển HTML sang Markdown bằng MarkItDown giữ tốt heading, danh sách, bảng thường và khối code, nhưng bỏ qua thẻ base, giữ cả menu, làm lệch bảng gộp ô và mất tên ngôn ngữ của code. Lab ngày 29/10/2026 cho thấy cắt phần main và giải link trước khi chuyển là đủ sửa phần lớn. Luôn kiểm heading và link trước, sau. Cần IP thoát ổn định cho job tải trang trước khi chuyển HTML sang Markdown bằng MarkItDown, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


