
Rate limit API khi dùng proxy: token bucket và Retry-After
Rate limit API khi dùng proxy là chuyện của phía gọi API: anh em tự giới hạn tốc độ trước khi máy chủ phải chặn. ProxyVN chia sẻ một client Python khoảng 120 dòng, giới hạn riêng từng endpoint bằng token bucket, đọc Retry-After và lùi lại có jitter. Code đã chạy thử trên một API giả lập: gửi dồn bị 7/12 lần 429, có token bucket thì không lần nào.
Rate limit API khi dùng proxy là bài toán của phía client
Hầu hết API công khai đều có hạn mức, và hạn mức đó được tính ở phía máy chủ. Việc của phía client là biết hạn mức nằm ở đâu, gửi chậm hơn ngưỡng một chút, và khi lỡ chạm ngưỡng thì chờ đúng thời gian máy chủ yêu cầu. Proxy chỉ là một chặng nằm giữa, nó không thay đổi cách API đếm request của anh em.
API đếm request theo cái gì
Mỗi API đếm theo một khóa khác nhau. Có API đếm theo địa chỉ IP, có API đếm theo token, có API đếm theo từng endpoint hoặc từng loại thao tác. Tài liệu rate limit REST API của GitHub là ví dụ rõ nhất về chuyện này.
Request không đăng nhập tới GitHub bị tính theo IP gốc, hạn mức 60 request mỗi giờ. Request có token cá nhân thì tính theo người dùng, hạn mức 5.000 request mỗi giờ. Nhóm endpoint tìm kiếm có hạn mức riêng, chặt hơn phần còn lại. Ngoài hạn mức chính còn có hạn mức phụ: tối đa 100 request đồng thời, tối đa 900 điểm mỗi phút cho một endpoint REST.
Cách tính điểm cũng đáng để ý. Phần lớn request GET tốn 1 điểm, còn POST, PATCH, PUT, DELETE tốn 5 điểm. Nghĩa là cùng một nhịp gửi, script ghi dữ liệu chạm ngưỡng nhanh gấp năm lần script chỉ đọc.
Đổi IP không gỡ được hạn mức tính theo token
Khi API đếm theo token, mọi request mang cùng token đều cộng vào một quỹ, bất kể đi qua bao nhiêu proxy. Anh em đổi từ IP này sang IP khác, quỹ vẫn là quỹ cũ. Trường hợp duy nhất IP có ý nghĩa là request không đăng nhập, mà loại này thì hạn mức thấp tới mức không đáng dựa vào.
GitHub còn ghi rõ: tiếp tục gửi request khi đang bị giới hạn có thể khiến ứng dụng bị cấm. Vậy nên mục tiêu của bài là giữ tốc độ dưới ngưỡng và chờ đúng lúc, không bàn chuyện xoay IP để vượt hạn mức. Nếu điều khoản của API cấm vượt hạn mức bằng nhiều IP, làm vậy là vi phạm điều khoản chứ không còn là chuyện kỹ thuật.
Phạm vi của bài và bài liên quan
Bài proxy bị lỗi 429 và bao nhiêu request trên một IP là quá nhiều đã giải thích nguyên nhân 429 ở mức tổng quan: IP dùng chung, chạy quá nhiều luồng, hệ thống chống bot nhiều lớp. Bài này đi tiếp phần code. Anh em sẽ có một client giới hạn từng endpoint, đọc header của API, thử lại có kiểm soát, kèm số liệu đo được trên máy.
Bài nhắm tới người viết script gọi API: đồng bộ dữ liệu giữa hai hệ thống, lấy báo cáo định kỳ, gọi API đối tác qua IP được cấp quyền. Ví dụ dùng Python và thư viện requests, nhưng cách nghĩ áp dụng được cho Node, Go hay PHP.
Đọc tín hiệu từ API trước khi xử lý rate limit API khi dùng proxy
Trước khi viết dòng giới hạn nào, anh em cần biết API đang báo gì về hạn mức. Có ba nguồn tín hiệu: mã trạng thái, header Retry-After và nhóm header X-RateLimit. Client tốt đọc cả ba, client kém chỉ nhìn mã 200 hay không 200.
Mã 429 và 503
Mã 429 Too Many Requests được định nghĩa trong RFC 6585, nghĩa là client đã gửi quá nhiều request trong một khoảng thời gian. Theo trang 429 trên MDN, giới hạn có thể áp cho toàn máy chủ hoặc cho từng tài nguyên. Thường giới hạn dựa trên IP, nhưng nếu request có xác thực thì có thể tính riêng theo người dùng hay ứng dụng.
Mã 503 Service Unavailable thì khác: máy chủ đang quá tải hoặc bảo trì, không nhất thiết do anh em gửi nhiều. Hai mã này nên xử lý chung một nhánh vì cả hai đều nói cùng một điều: dừng lại, chờ, rồi thử lại. Một số API, trong đó có GitHub, còn trả 403 khi vượt hạn mức, nên anh em phải đọc tài liệu của từng API.
Header Retry-After có hai dạng
Header Retry-After cho biết client nên chờ bao lâu trước khi gửi request tiếp. Nó có hai dạng: một số nguyên chỉ số giây, ví dụ Retry-After: 120, hoặc một mốc thời gian theo định dạng HTTP, ví dụ Retry-After: Wed, 21 Oct 2015 07:28:00 GMT.
Nhiều script chỉ xử lý dạng số và bỏ qua dạng ngày giờ, hoặc tệ hơn là ép kiểu int rồi văng lỗi. Hàm dưới xử lý cả hai, trả về None khi giá trị không đọc được để client quay sang backoff. Hàm parsedate_to_datetime nằm trong module email.utils của Python, không phải cài thêm gì.
import email.utils
import time

def retry_after_seconds(value):
    if not value:
        return None
    value = value.strip()
    if value.isdigit():
        return int(value)
    try:
        when = email.utils.parsedate_to_datetime(value)
    except (TypeError, ValueError):
        return None
    return max(0.0, when.timestamp() - time.time())
Khi chạy thử, hàm trả 120 cho chuỗi "120", trả 29,5 giây cho một mốc thời gian đặt sau đó 30 giây, và trả None cho chuỗi rác. Phần lệch nửa giây là thời gian trôi qua giữa lúc tạo mốc và lúc đọc.
Nhóm header X-RateLimit
Nhiều API gửi kèm trạng thái hạn mức trong mọi phản hồi, kể cả phản hồi thành công. Tên header khác nhau giữa các API, nhưng nhóm X-RateLimit của GitHub là mẫu hay gặp. Bảng dưới tóm tắt ý nghĩa từng header theo tài liệu GitHub.
Header |
Ý nghĩa |
Client dùng để |
|---|---|---|
x-ratelimit-limit |
Tổng số request được phép trong cửa sổ |
Đặt tốc độ ban đầu |
x-ratelimit-remaining |
Số request còn lại |
Dừng sớm khi về 0 |
x-ratelimit-used |
Số request đã dùng |
Ghi log, đối chiếu |
x-ratelimit-reset |
Thời điểm cửa sổ mới, tính bằng giây epoch UTC |
Tính thời gian chờ |
x-ratelimit-resource |
Nhóm hạn mức mà request bị tính vào |
Biết endpoint nào đang hết quỹ |
GitHub cũng lưu ý giá trị remaining có thể nhảy lên xuống giữa các phản hồi vì request được xử lý ở nhiều vùng. Lời khuyên của họ là dùng các header này để giãn nhịp, đừng viết logic dựa vào con số remaining chính xác tới từng đơn vị. Client trong bài chỉ phản ứng khi remaining bằng 0.
Lỗi đến từ proxy hay từ API
Khi có proxy ở giữa, không phải lỗi nào cũng đến từ API. Đọc nhầm chặng là lý do nhiều người đổi proxy liên tục mà lỗi vẫn còn, hoặc ngược lại, giảm tốc độ mãi mà không hết lỗi. Bảng dưới là cách phân biệt nhanh.
Dấu hiệu |
Thường đến từ |
Xử lý |
|---|---|---|
429 kèm Retry-After hoặc X-RateLimit |
API |
Chờ theo header, giảm tốc |
407 Proxy Authentication Required |
Proxy |
Sửa user và password, không thử lại |
502, 504 với trang lỗi của proxy |
Proxy hoặc chặng proxy tới API |
Thử lại có giới hạn, kiểm tra proxy |
Timeout khi kết nối |
Mạng tới proxy hoặc proxy tới API |
Thử lại có giới hạn |
401, 403 kèm thông báo token |
API |
Kiểm tra token, không thử lại |
Mã 407 là trường hợp đáng tách riêng nhất. Thử lại 407 năm lần chỉ tốn thời gian và có thể khiến nhà cung cấp proxy khóa tài khoản vì đăng nhập sai liên tục. Bài sửa lỗi 407 Proxy Authentication Required có các bước kiểm tra chi tiết.
Thiết kế token bucket theo endpoint cho rate limit API khi dùng proxy
Token bucket là cách giới hạn tốc độ dễ hiểu và dễ chỉnh nhất cho client. Thay vì sleep cố định giữa hai request, client giữ một cái thùng chứa token, mỗi request lấy một token, và token được nạp lại theo tốc độ cố định.
Token bucket hoạt động thế nào
Thùng có hai thông số: rate là số token nạp mỗi giây, burst là số token tối đa thùng chứa được. Khi thùng đầy, client được gửi liền một loạt bằng burst. Sau đó nó chỉ gửi được theo nhịp rate. Nếu thùng rỗng, request phải chờ tới khi có token mới.
Ưu điểm so với sleep cố định là client không bị chậm vô ích. Lúc ít việc, token tích lại và lượt gửi kế tiếp đi ngay. Lúc nhiều việc, tốc độ bị chặn ở rate. Nhiều luồng dùng chung một thùng thì tổng tốc độ vẫn đúng, chuyện mà sleep trong từng luồng không làm được.
Bài viết của AWS về timeout, retry và backoff có jitter kể rằng họ dùng token bucket để giới hạn cả số lần thử lại phía client, và đã đưa cơ chế này vào AWS SDK từ năm 2016. Đây là mẫu thiết kế đã được kiểm chứng ở quy mô lớn, không phải mẹo riêng.
Vì sao tách thùng theo từng endpoint
API hiếm khi có một hạn mức chung cho mọi thứ. Endpoint tìm kiếm thường chặt hơn endpoint đọc chi tiết, endpoint ghi thường chặt hơn endpoint đọc. Dùng một thùng chung cho cả client thì anh em buộc phải chọn tốc độ của endpoint chậm nhất, lãng phí quỹ của các endpoint còn lại.
Client trong bài giữ một từ điển LIMITS, mỗi endpoint một cặp rate và burst. Khi một endpoint bị 429, chỉ thùng của endpoint đó bị tạm dừng. Các endpoint khác vẫn chạy bình thường, nên một nhánh bị giới hạn không kéo cả chương trình đứng lại.
Với API tính hạn mức theo token, anh em nên thêm token vào khóa của thùng nếu một chương trình dùng nhiều token. Hai token là hai quỹ riêng, dùng chung một thùng thì tự bóp mình chậm đi một nửa.
Chọn rate và burst thấp hơn hạn mức
Hạn mức của API thường viết dạng N request trong T giây. Cách đặt an toàn là rate bằng khoảng 80% của N chia T, burst nhỏ, từ 1 tới 2. Lý do là API hay đếm theo cửa sổ cố định, còn token bucket đếm liên tục, hai cách đếm lệch nhau ở mép cửa sổ.
Lấy API giả lập trong bài làm ví dụ: endpoint /search cho 5 request mỗi 10 giây. Nếu đặt rate 0,5 và burst 5, client gửi liền 5 request ở giây 0, rồi request thứ sáu ở giây thứ 2. Lúc đó cửa sổ đầu vẫn chưa hết, request thứ sáu nhận 429. Đặt rate 0,4 và burst 1 thì mỗi cửa sổ 10 giây chỉ có 4 request, không bao giờ chạm ngưỡng.
- Đọc hạn mức trong tài liệu API, ghi rõ đơn vị: theo giây, theo phút hay theo giờ.
- Quy về request mỗi giây rồi nhân 0,8 để ra rate.
- Đặt burst bằng 1 hoặc 2, chỉ tăng khi đã đo thấy an toàn.
- Nếu nhiều tiến trình cùng dùng một token, chia rate cho số tiến trình.
Mức 80% là điểm khởi đầu, không phải con số bắt buộc. Sau vài ngày chạy, nếu log không có 429 và header remaining luôn còn dư nhiều, anh em tăng dần lên. Ngược lại, nếu vẫn có 429 lác đác, giảm tiếp hoặc giảm số luồng.
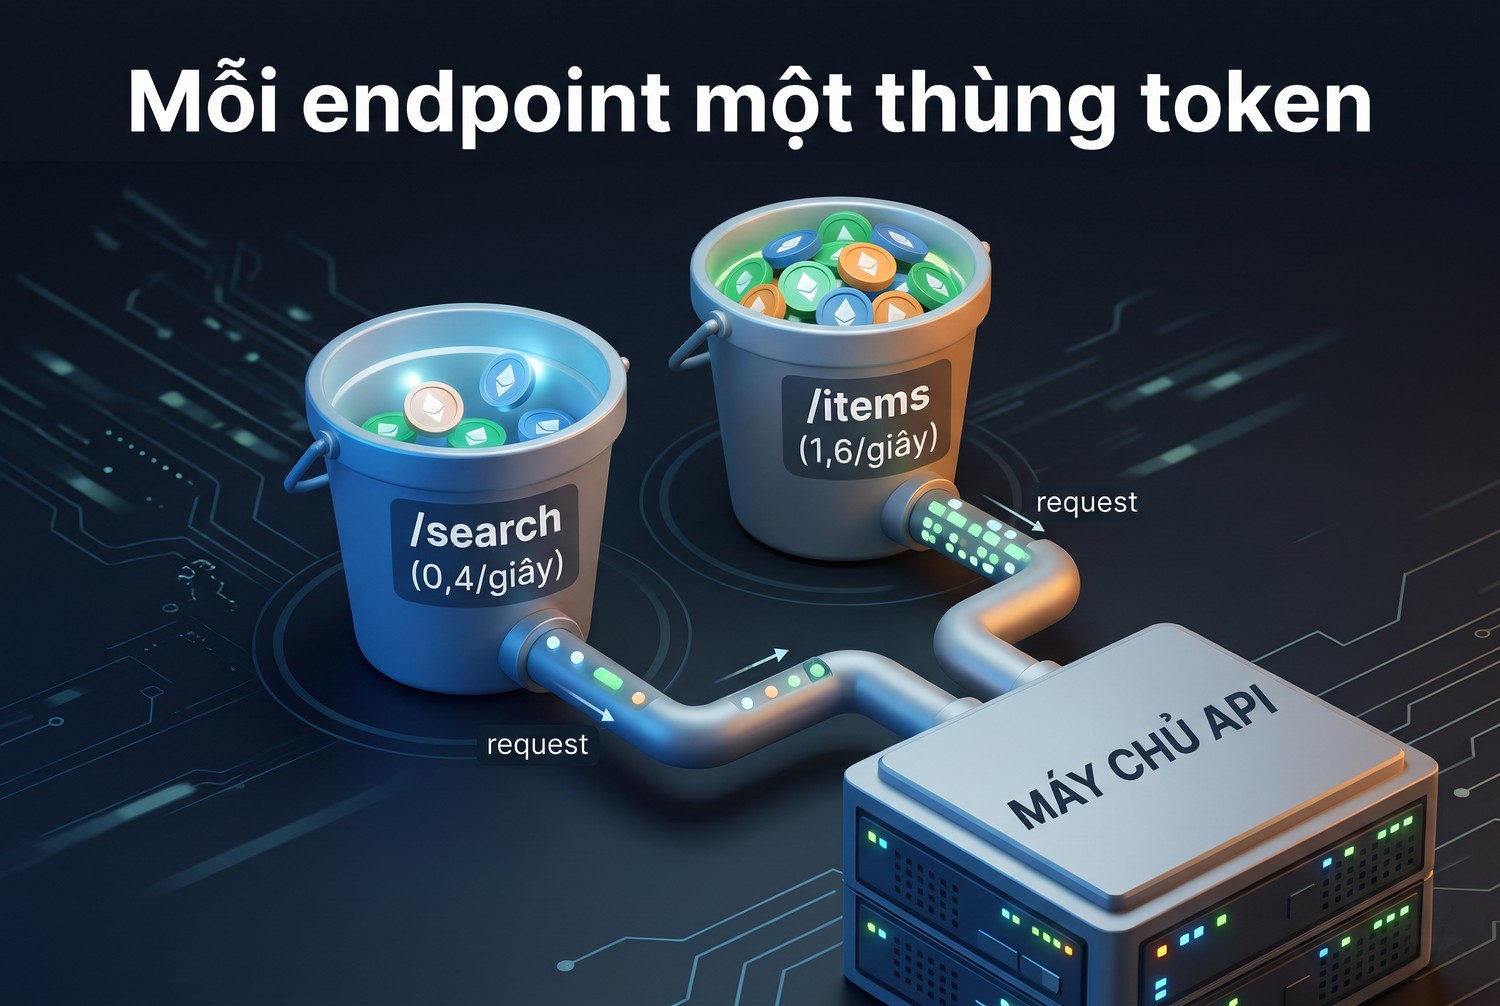
Mỗi endpoint một thùng token
Exponential backoff có jitter trong rate limit API khi dùng proxy
Token bucket giúp không chạm ngưỡng, còn backoff lo phần lỡ chạm ngưỡng hoặc gặp lỗi tạm thời. Hai thứ này bổ sung cho nhau. Thiếu token bucket, backoff phải làm việc liên tục. Thiếu backoff, một lỗi mạng nhỏ cũng làm script dừng.
Khi không có Retry-After
Nếu API trả 429 hay 503 mà có Retry-After, client chờ đúng số giây đó. Khi không có header, client tự tính thời gian chờ bằng exponential backoff: lần thử đầu chờ ngắn, mỗi lần sau gấp đôi, có trần trên để không chờ vô hạn.
GitHub hướng dẫn cụ thể cho hạn mức phụ: có retry-after thì chờ theo nó, remaining bằng 0 thì chờ tới x-ratelimit-reset, không có gì thì chờ ít nhất một phút. Nếu vẫn lỗi, tăng thời gian chờ theo cấp số nhân và dừng hẳn sau một số lần thử nhất định. Client trong bài làm theo đúng thứ tự ưu tiên này, chỉ thay mức tối thiểu một phút bằng thông số base_delay để dễ thử trên máy.
Vì sao phải có jitter
Khi nhiều luồng cùng nhận lỗi một lúc rồi cùng chờ đúng 2 giây, chúng sẽ cùng gửi lại một lúc và cùng nhận lỗi tiếp. Jitter là thêm yếu tố ngẫu nhiên vào thời gian chờ để các luồng tản ra. Công thức full jitter dùng trong bài: thời gian chờ là số ngẫu nhiên từ 0 tới min(trần, base_delay nhân 2 mũ số lần thử).
import random

def backoff(attempt, base_delay=0.5, max_delay=30):
    # full jitter: ngẫu nhiên từ 0 tới min(trần, cơ số * 2^lần thử)
    return random.uniform(0, min(max_delay, base_delay * 2 ** attempt))
Với base_delay 0,5 giây, lần thử thứ nhất chờ tối đa 0,5 giây, lần thứ ba tối đa 2 giây, lần thứ sáu tối đa 16 giây. Trong lần chạy thử, hai lỗi 503 được chờ 0,09 giây và 0,29 giây, đều nằm trong khoảng của lần thử đầu. Con số nhỏ vì đó là lần thử thứ nhất, và vì jitter cho phép chờ rất ngắn khi may mắn.
Chỉ thử lại request an toàn
Bài của AWS nhấn mạnh một điểm hay bị bỏ qua: API có tác dụng phụ không an toàn để thử lại, trừ khi API hỗ trợ idempotency. Gửi lại một request tạo đơn hàng có thể tạo hai đơn. Request đọc dữ liệu thì thử lại bao nhiêu lần cũng không sao.
Với endpoint ghi, anh em kiểm tra xem API có nhận khóa idempotency không. Nhiều API thanh toán và API đám mây cho gửi kèm một mã duy nhất trong header để máy chủ bỏ qua request trùng. Không có cơ chế đó thì chỉ nên thử lại khi chắc request chưa tới được máy chủ, ví dụ lỗi kết nối tới proxy, còn timeout khi đang chờ phản hồi thì phải kiểm tra trạng thái trước.
Lỗi 4xx nói chung không nên thử lại nguyên request cũ, vì gửi lại cũng sai y như vậy. 429 là ngoại lệ vì nó báo vấn đề về thời điểm, không phải về nội dung request.
Thử lại ở một tầng duy nhất
AWS đưa ra một ví dụ đáng nhớ. Một hệ thống có năm tầng gọi nhau, mỗi tầng thử lại 3 lần. Khi cơ sở dữ liệu ở đáy bắt đầu lỗi, tải lên nó tăng 243 lần vì số lần thử nhân lên qua từng tầng.
Script gọi API cũng mắc lỗi này theo kiểu nhỏ hơn. Thư viện HTTP có retry riêng, client tự viết có retry, rồi vòng lặp bên ngoài lại thử lại cả lô. Ba tầng mỗi tầng 3 lần là 27 request cho một việc. Anh em chọn một tầng để thử lại, thường là tầng client như trong bài, rồi tắt retry ở các tầng còn lại.
Token bucket giữ client dưới ngưỡng, Retry-After cho biết chờ bao lâu khi lỡ chạm ngưỡng, jitter giữ các luồng không đồng loạt quay lại. Thiếu một trong ba, 429 sẽ quay lại theo đợt.
Chuẩn bị môi trường để thử rate limit API khi dùng proxy
Thử logic giới hạn trên API thật vừa chậm vừa rủi ro, vì mỗi lần thử sai là một lần trừ vào quỹ thật, có khi bị khóa token. Mình dựng một API giả lập chạy ngay trên máy, có đủ hạn mức theo endpoint, header X-RateLimit, 429 kèm Retry-After và 503 ngẫu nhiên.
Phiên bản đã dùng
Lần chạy thử ngày 23/10/2026 dùng Python 3.12.10 và requests 2.34.2 trên Windows. API giả lập chỉ dùng thư viện chuẩn http.server. Anh em dùng Python 3.10 trở lên là chạy được, chỉ cần cài requests.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
pip install requests
API giả lập có hạn mức theo endpoint
API giả lập có hai endpoint. /search cho 5 request mỗi 10 giây, /items cho 20 request mỗi 10 giây. Hạn mức tính theo cặp token và endpoint, đếm bằng cửa sổ cố định. Cứ request thứ 8 tới /items thì trả 503 không kèm Retry-After, để thử nhánh backoff.
import json, time, threading
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler
from urllib.parse import urlparse

LIMITS = {"/search": (5, 10), "/items": (20, 10)}  # endpoint: (số request, giây)
state = {}
counter = {"/items": 0}
lock = threading.Lock()
log = []

class H(BaseHTTPRequestHandler):
    def do_GET(self):
        path = urlparse(self.path).path
        if path not in LIMITS:
            return self.reply(404, {"error": "not found"})
        token = self.headers.get("Authorization", "anon")
        limit, window = LIMITS[path]
        now = time.time()
        with lock:
            start, used = state.get((token, path), (now, 0))
            if now - start >= window:
                start, used = now, 0
            reset = start + window
            if used >= limit:
                log.append((round(now, 2), path, 429))
                return self.reply(429, {"error": "rate limited"}, limit, 0, reset,
                                  {"Retry-After": str(max(1, int(reset - now + 0.999)))})
            used += 1
            state[(token, path)] = (start, used)
            if path == "/items":
                counter["/items"] += 1
                if counter["/items"] % 8 == 0:
                    log.append((round(now, 2), path, 503))
                    return self.reply(503, {"error": "busy"}, limit, limit - used, reset)
        log.append((round(now, 2), path, 200))
        self.reply(200, {"path": path, "ok": True}, limit, limit - used, reset)

    def reply(self, code, body, limit=None, remaining=None, reset=None, extra=None):
        self.send_response(code)
        self.send_header("Content-Type", "application/json")
        if limit is not None:
            self.send_header("X-RateLimit-Limit", str(limit))
            self.send_header("X-RateLimit-Remaining", str(remaining))
            self.send_header("X-RateLimit-Reset", str(int(reset)))
        for k, v in (extra or {}).items():
            self.send_header(k, v)
        self.end_headers()
        self.wfile.write(json.dumps(body).encode())

    def log_message(self, *a):
        pass

def start(port=8766):
    srv = ThreadingHTTPServer(("127.0.0.1", port), H)
    threading.Thread(target=srv.serve_forever, daemon=True).start()
    return srv
Cửa sổ cố định là cách đếm đơn giản nhất và cũng là cách dễ lệch với token bucket nhất, nên dùng nó để thử là hợp lý. Nếu client chạy ổn với cửa sổ cố định, nó thường ổn với cửa sổ trượt hay token bucket phía máy chủ.
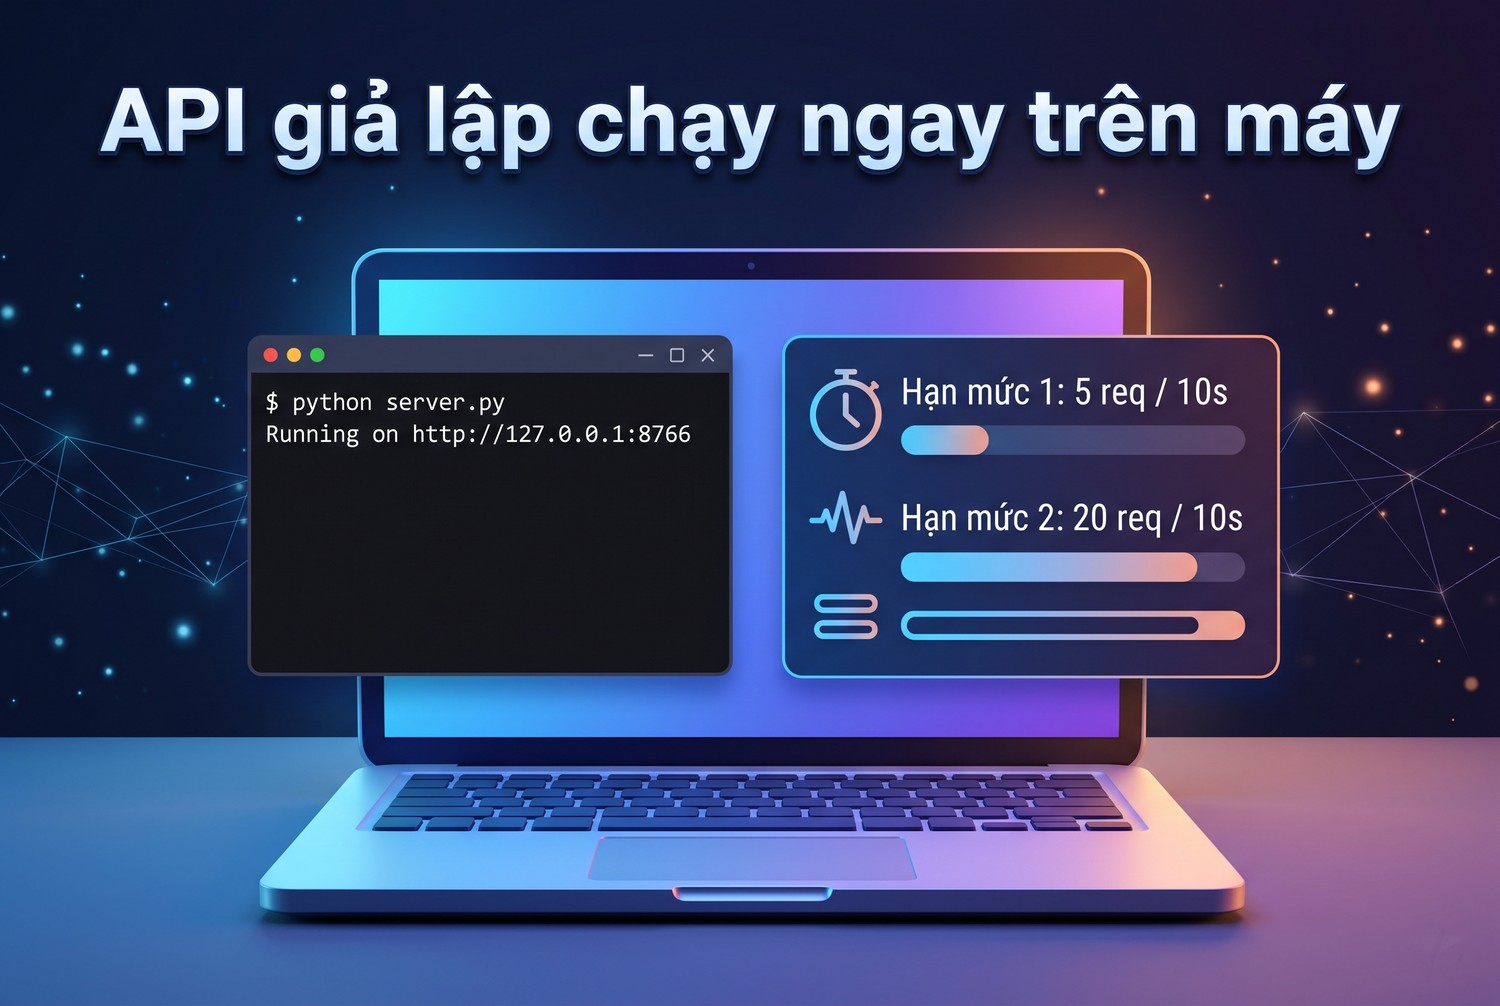
API giả lập chạy ngay trên máy
Code client xử lý rate limit API khi dùng proxy
Phần client gồm hai lớp: TokenBucket lo tốc độ, ApiClient lo gửi request, đọc header và quyết định thử lại hay dừng. Code dưới là đúng bản đã chạy thử, chỉ đổi phần chú thích sang tiếng Việt có dấu.
Lớp TokenBucket dùng chung cho nhiều luồng
Lớp này có khóa threading.Lock nên nhiều luồng gọi acquire cùng lúc vẫn an toàn. Hàm pause đặt mốc blocked_until và xả hết token, dùng khi API báo hết quỹ hoặc trả 429.
import threading
import time

class TokenBucket:
    def __init__(self, rate, burst):
        self.rate = rate
        self.burst = burst
        self.tokens = burst
        self.updated = time.monotonic()
        self.blocked_until = 0.0
        self.lock = threading.Lock()

    def acquire(self):
        while True:
            with self.lock:
                now = time.monotonic()
                self.tokens = min(self.burst, self.tokens + (now - self.updated) * self.rate)
                self.updated = now
                wait = self.blocked_until - now
                if wait <= 0 and self.tokens >= 1:
                    self.tokens -= 1
                    return
                if wait <= 0:
                    wait = (1 - self.tokens) / self.rate
            time.sleep(wait)

    def pause(self, seconds):
        with self.lock:
            self.blocked_until = max(self.blocked_until, time.monotonic() + seconds)
            self.tokens = 0
Hàm dùng time.monotonic thay cho time.time vì đồng hồ monotonic không nhảy khi máy đồng bộ giờ. Lệnh sleep nằm ngoài khối with, để luồng đang chờ không giữ khóa của các luồng khác.
Lớp ApiClient đọc header và quyết định thử lại
ApiClient giữ một Session của requests, gắn token vào header Authorization, và lấy proxy từ biến môi trường API_PROXY nếu có. Mỗi endpoint có một thùng riêng theo từ điển LIMITS.
import logging
import os
import random
import requests

log = logging.getLogger("api")

# Giới hạn phía client, đặt thấp hơn hạn mức của API khoảng 20%
LIMITS = {
    "/search": {"rate": 0.4, "burst": 1},   # API cho 5 request / 10 giây
    "/items": {"rate": 1.6, "burst": 2},    # API cho 20 request / 10 giây
}

class ApiClient:
    def __init__(self, base_url, token, max_retries=5, base_delay=0.5, max_delay=30):
        self.base_url = base_url.rstrip("/")
        self.session = requests.Session()
        self.session.headers["Authorization"] = f"Bearer {token}"
        proxy = os.environ.get("API_PROXY")
        if proxy:
            self.session.proxies = {"http": proxy, "https": proxy}
        self.buckets = {ep: TokenBucket(**cfg) for ep, cfg in LIMITS.items()}
        self.max_retries = max_retries
        self.base_delay = base_delay
        self.max_delay = max_delay
        self.stats = {"sent": 0, "429": 0, "503": 0, "network": 0}

    def backoff(self, attempt):
        return random.uniform(0, min(self.max_delay, self.base_delay * 2 ** attempt))

    def get(self, endpoint, **params):
        bucket = self.buckets[endpoint]
        for attempt in range(self.max_retries + 1):
            bucket.acquire()
            self.stats["sent"] += 1
            try:
                r = self.session.get(self.base_url + endpoint, params=params, timeout=(5, 20))
            except (requests.ConnectionError, requests.Timeout) as e:
                self.stats["network"] += 1
                delay = self.backoff(attempt)
                log.warning("%s lỗi mạng %s, thử lại sau %.2fs", endpoint, type(e).__name__, delay)
                time.sleep(delay)
                continue

            if r.headers.get("X-RateLimit-Remaining") == "0":
                reset = float(r.headers.get("X-RateLimit-Reset", 0))
                bucket.pause(max(0.0, reset - time.time()))

            if r.status_code in (429, 503):
                self.stats[str(r.status_code)] += 1
                wait = retry_after_seconds(r.headers.get("Retry-After"))
                if wait is None:
                    wait = self.backoff(attempt)
                log.warning("%s trả %s, chờ %.2fs", endpoint, r.status_code, wait)
                bucket.pause(wait)
                continue
            if r.status_code == 407:
                raise RuntimeError("Proxy từ chối xác thực (407): kiểm tra user/pass proxy, không thử lại")
            if r.status_code >= 500:
                delay = self.backoff(attempt)
                log.warning("%s trả %s, thử lại sau %.2fs", endpoint, r.status_code, delay)
                time.sleep(delay)
                continue
            r.raise_for_status()
            return r.json()
        raise RuntimeError(f"{endpoint}: hết {self.max_retries} lần thử lại")
Đọc luồng xử lý trong hàm get
Thứ tự kiểm tra trong hàm get có chủ ý. Đầu tiên là lỗi mạng, vì khi đó không có phản hồi nào để đọc. Tiếp theo là header remaining: dù request vừa rồi thành công, nếu quỹ đã về 0 thì thùng được tạm dừng tới mốc reset, request kế tiếp không phải ăn 429 mới biết.
Sau đó tới 429 và 503. Client ưu tiên Retry-After, không có thì mới dùng backoff. Thời gian chờ được đặt vào thùng bằng pause chứ không sleep trong luồng hiện tại. Nhờ vậy mọi luồng đang dùng endpoint đó cùng dừng, không chỉ luồng vừa nhận lỗi.
Mã 407 ném lỗi ngay. Các lỗi 5xx khác thử lại có backoff. Mọi mã 4xx còn lại đi qua raise_for_status và dừng, vì gửi lại cũng không khác gì. Cuối cùng, nếu hết max_retries mà vẫn không xong, client ném lỗi có tên endpoint để anh em biết nhánh nào đang tắc.
Timeout được đặt dạng cặp (5, 20): 5 giây để kết nối, 20 giây để chờ phản hồi. Khi đi qua proxy, chặng kết nối dài hơn bình thường một chút, nhưng 5 giây vẫn đủ rộng. Để timeout mặc định của requests là không có timeout, một proxy treo có thể giữ luồng mãi mãi.
Kết quả chạy thử rate limit API khi dùng proxy trên máy
Script run_test.py khởi động API giả lập ở cổng 8766, rồi chạy ba kịch bản. Mỗi kịch bản dùng một token riêng để không ăn chung quỹ. Toàn bộ kết quả được ghi ra file test-results.json.
Kịch bản 1: gửi dồn không giới hạn
Kịch bản đầu mô phỏng script hay gặp nhất: 4 luồng gửi liền 12 request tới /search, không giới hạn gì. Cả 12 request xong trong 0,02 giây, 5 cái đầu nhận 200, 7 cái sau nhận 429. Với một API thật, đây là 7 lần bị ghi nhận vượt hạn mức chỉ trong một lần chạy.
Nếu script này có thêm vòng thử lại ngay lập tức, kiểu while status != 200, nó sẽ bắn hàng trăm request 429 trong vài giây. Đó là kiểu hành vi mà GitHub cảnh báo có thể dẫn tới cấm ứng dụng.
Kịch bản 2: có token bucket theo endpoint
Kịch bản hai dùng ApiClient với cấu hình LIMITS ở trên, vẫn 4 luồng. Mười hai request /search xong trong 27,5 giây, không có 429 nào. Mười sáu request /items xong trong 10,02 giây. API giả lập trả 503 hai lần theo quy tắc request thứ 8, client chờ 0,09 giây và 0,29 giây rồi thử lại thành công.
Tổng cộng client gửi 30 request cho 28 việc. Hai request dư chính là hai lần thử lại sau 503. Không có request nào bị lãng phí vì 429.
Kịch bản 3: cấu hình sai, Retry-After cứu lại
Kịch bản ba cố ý đặt sai: thùng /search có rate 1 request mỗi giây và burst 3, nhanh gấp đôi hạn mức. Client vẫn hoàn thành 12/12 việc trong 22,37 giây, nhưng phải gửi 17 request và nhận 5 lần 429. Mỗi lần 429, Retry-After làm thùng dừng tới hết cửa sổ, rồi client chạy tiếp.
Kịch bản này cho thấy hai điều. Một, Retry-After đủ để client tự hồi phục khi cấu hình sai. Hai, cấu hình sai tuy xong sớm hơn 5 giây nhưng để lại 5 lần vượt hạn mức trong log của API. Với API có chính sách khóa khi vượt nhiều lần, 5 giây đó không đáng.
Có một chi tiết trong log của kịch bản ba: ba lần 429 đầu đến liền nhau. Lý do là 4 luồng đã lấy token và gửi đi trước khi phản hồi đầu tiên báo hết quỹ. Request đang bay thì không gọi lại được, nên giới hạn số luồng đồng thời cũng quan trọng như giới hạn tốc độ.
Kịch bản |
Request gửi |
Việc xong |
Lần 429 |
Thời gian |
|---|---|---|---|---|
Gửi dồn, không giới hạn |
12 |
5 |
7 |
0,02 giây |
Token bucket, rate 0,4 burst 1 |
12 |
12 |
0 |
27,5 giây |
Token bucket /items, có 503 |
18 |
16 |
0 |
10,02 giây |
Cấu hình sai, rate 1 burst 3 |
17 |
12 |
5 |
22,37 giây |
Client nhanh nhất trong bảng là client hỏng nhất. Đo hiệu quả bằng số việc xong và số lần vượt hạn mức, đừng đo bằng tốc độ gửi.
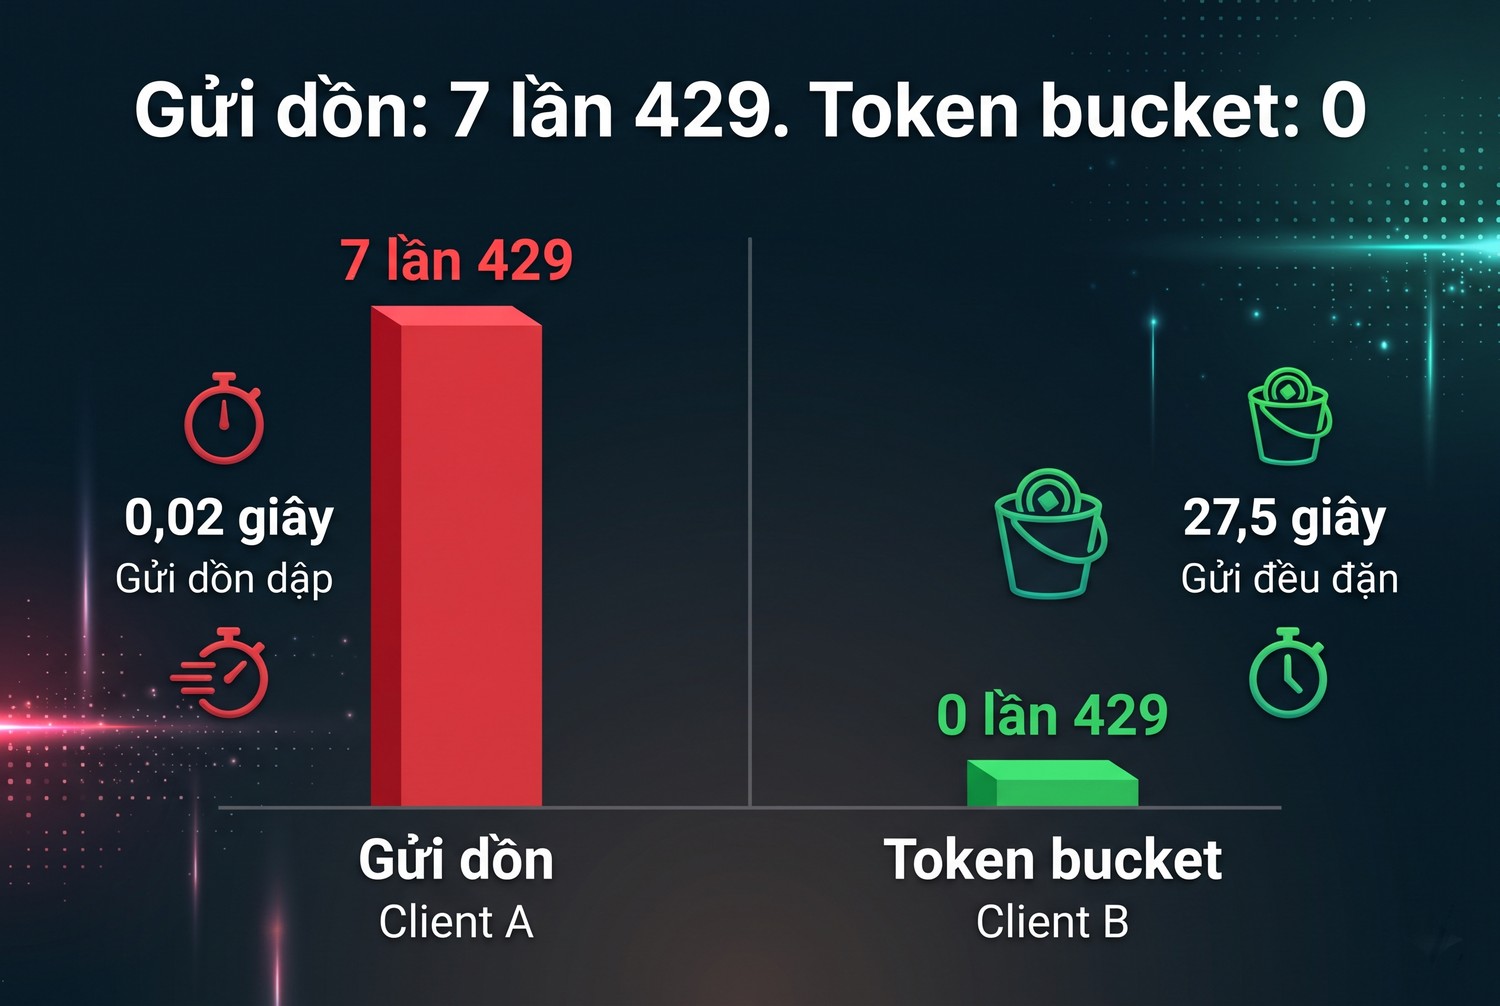
Gửi dồn: 7 lần 429. Token bucket: 0
Gắn proxy và đọc lỗi đúng chặng khi xử lý rate limit API khi dùng proxy
Tới đây client chưa dùng proxy nào. Phần này nói về lúc gắn proxy vào: khai báo thế nào, kiểm tra ra sao, và những gì proxy không làm thay anh em được.
Khai báo proxy bằng biến môi trường
Client đọc proxy từ biến API_PROXY để không phải ghi tài khoản proxy vào code. Định dạng là URL đầy đủ có user và password. Với SOCKS5, requests cần cài thêm gói requests[socks] và đổi tiền tố thành socks5h để DNS được phân giải ở phía proxy.
$env:API_PROXY = "http://TAI_KHOAN:MAT_KHAU@proxy.example.invalid:8080"
python run_test.py
Cách cấu hình proxy cho requests, gồm cả trường hợp HTTP và HTTPS dùng proxy khác nhau, được trình bày trong bài cài đặt proxy cho thư viện requests của Python. Nếu gặp ProxyError khi chạy, anh em xem thêm bài requests.exceptions.ProxyError để tìm nguyên nhân.
Kiểm tra IP đầu ra trước khi chạy
Trước khi chạy thật, gửi một request bằng chính Session của client tới một trang trả IP công khai. IP trả về phải là IP của proxy. Nếu ra IP văn phòng, biến môi trường chưa được nạp vào đúng cửa sổ PowerShell, hoặc proxy chỉ được gán cho http mà quên https.
Lỗi này không báo gì. Client vẫn chạy, vẫn nhận 200, chỉ là đi sai đường. Với API đối tác lọc theo IP, kết quả là 403 từ API, và người ta thường đi sửa token thay vì kiểm tra proxy.
Một token, nhiều IP: hạn mức vẫn tính chung
Như đã nói ở phần đầu, API tính theo token thì quỹ đi theo token. Chạy 4 tiến trình qua 4 proxy khác nhau với cùng một token, quỹ vẫn là một. Anh em phải chia rate trong LIMITS cho 4, hoặc đưa token bucket ra một chỗ chung như Redis để các tiến trình lấy token từ cùng một thùng.
Ngược lại, nếu dự án có nhiều token hợp lệ, ví dụ mỗi khách hàng một token, thì mỗi token là một quỹ riêng và có thể chạy song song. Lúc đó khóa của thùng nên là cặp token và endpoint, giống cách API giả lập đếm.
Khi nào proxy thật sự cần cho script gọi API
Proxy có chỗ đứng rõ ràng trong vài tình huống gọi API. API đối tác chỉ nhận request từ IP nằm trong danh sách cho phép, trong khi máy chạy script có IP động. API trả dữ liệu khác nhau theo quốc gia và anh em cần kiểm tra phiên bản dành cho Việt Nam. Hoặc công ty muốn tách IP đi ra của từng dự án để dễ truy vết.
Cả ba trường hợp đều cần IP ổn định, không cần IP xoay. Với API lọc theo IP, anh em có thể mua proxy dân cư tĩnh hoặc datacenter của ProxyVN, giao thức HTTP và SOCKS5, có tài khoản user và password. Sau đó gửi IP đầu ra cho bên đối tác thêm vào danh sách cho phép. Nếu chạy nhiều luồng trên một proxy, đọc thêm bài 1 proxy chạy được bao nhiêu luồng để tính tải cho đúng.
Checklist trước khi chạy thật rate limit API khi dùng proxy
Chạy được trên API giả lập mới là bước đầu. Trước khi trỏ client vào API thật, mình rà lại danh sách dưới. Mất chừng mười phút nhưng tránh được chuyện bị khóa token giữa đêm.
Danh sách kiểm tra
- Đã đọc tài liệu hạn mức của API, ghi lại hạn mức của từng endpoint mình gọi.
- Đã biết API tính hạn mức theo IP, theo token hay theo ứng dụng.
- LIMITS đặt khoảng 80% hạn mức, burst 1 hoặc 2.
- Số luồng đồng thời nhỏ hơn hạn mức request đồng thời của API, với GitHub là dưới 100.
- Client đọc Retry-After cả hai dạng, đọc X-RateLimit-Remaining và Reset nếu API có gửi.
- Chỉ thử lại ở một tầng, đã tắt retry tự động của thư viện khác nếu có.
- Endpoint ghi chỉ thử lại khi có khóa idempotency hoặc khi request chắc chưa tới máy chủ.
- Mã 407, 401 và 403 dừng ngay, không thử lại.
- Đã kiểm tra IP đầu ra qua proxy bằng chính Session của client.
- Log có đủ thời điểm, endpoint, mã trạng thái và thời gian chờ để đọc lại khi có sự cố.
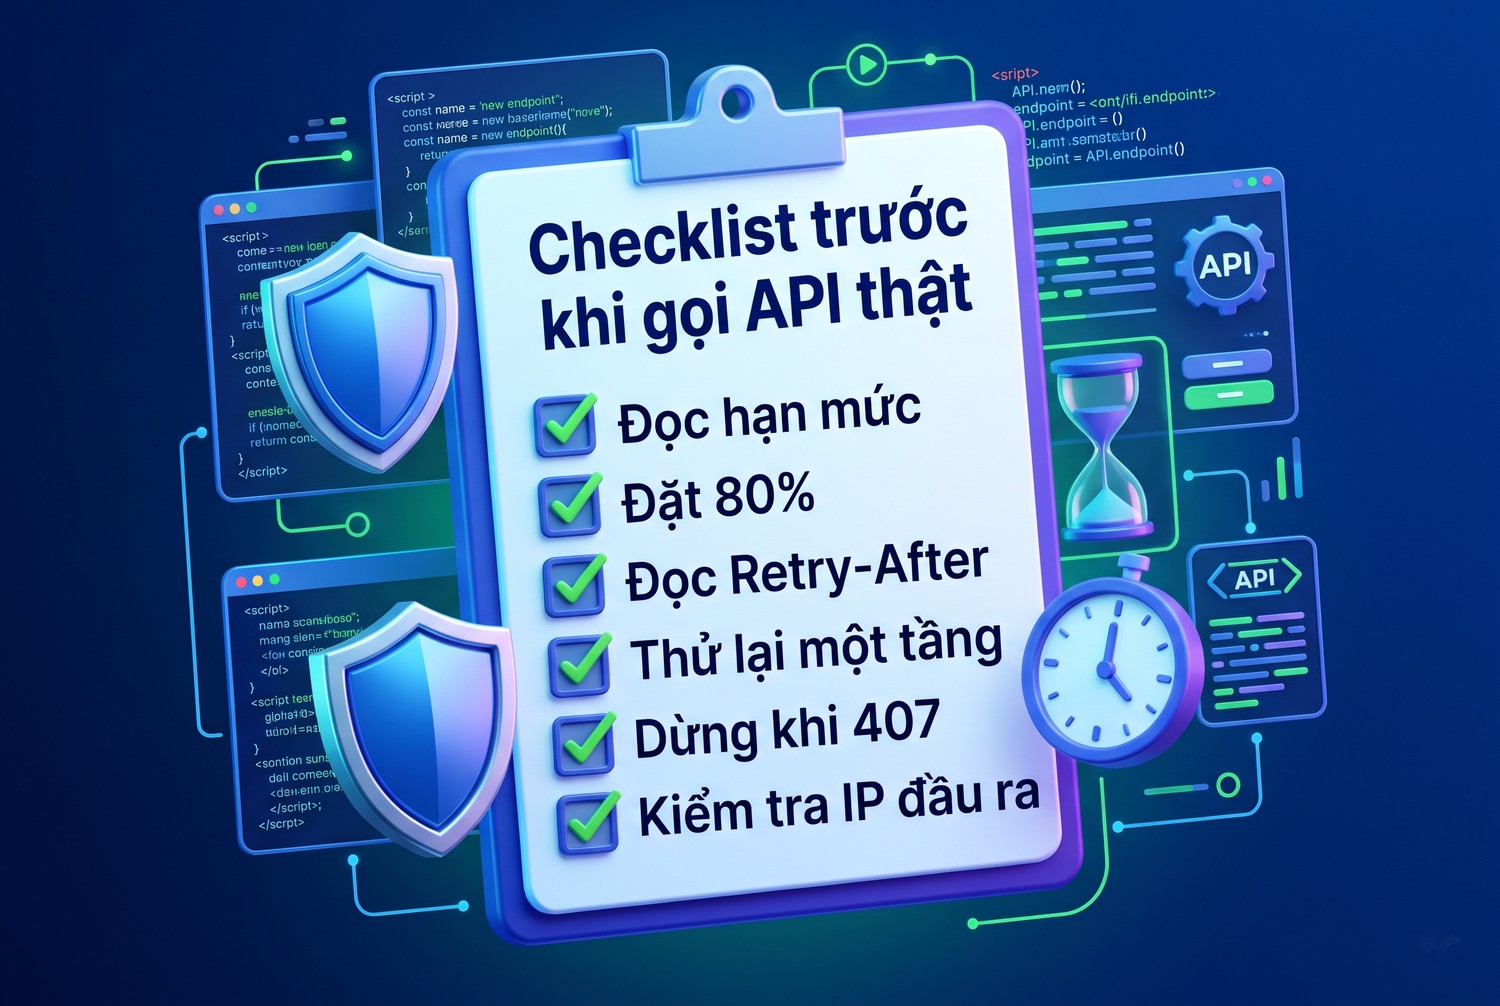
Checklist trước khi gọi API thật
Theo dõi sau khi chạy
Sau khi chạy thật vài ngày, anh em đếm số 429 theo từng endpoint trong log. Con số lý tưởng là 0. Có vài lần mỗi ngày thì chấp nhận được nếu Retry-After xử lý ổn. Có hàng chục lần thì rate đang đặt quá cao hoặc có tiến trình khác dùng chung token mà anh em chưa biết.
Một chỉ số nữa đáng theo dõi là X-RateLimit-Remaining thấp nhất trong ngày. Nếu nó luôn còn trên một nửa, anh em đang chạy quá thận trọng và có thể tăng rate. Nếu nó thường xuyên về 0, đó là dấu hiệu sắp gặp 429 khi lưu lượng tăng.
Khi có nhiều client cùng dùng chung một nhóm proxy, theo dõi thêm tỉ lệ lỗi 502, 504 và timeout theo từng proxy. Các lỗi này tăng ở một proxy mà không tăng ở proxy khác là dấu hiệu proxy đó có vấn đề, chuyện cần báo nhà cung cấp chứ không phải chuyện chỉnh rate. Bài dấu hiệu cần thay proxy liệt kê thêm các cảnh báo nên để ý.
Rate limit API khi dùng proxy và điều cần nhớ
Rate limit API khi dùng proxy xử lý tốt nhất ở phía client: token bucket cho từng endpoint, đọc Retry-After, backoff có jitter, chỉ thử lại request an toàn. Proxy lo đường đi và IP được phép, không gỡ được hạn mức tính theo token. Cần proxy tĩnh, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khi xử lý rate limit API khi dùng proxy.


