
Robots.txt khi crawl website: đọc luật và lọc URL đúng
Robots.txt khi crawl website là file đầu tiên một crawler nên đọc, trước cả trang chủ. ProxyVN viết bài này cho người tự viết crawler: đọc luật theo chuẩn RFC 9309, lấy danh sách sitemap, rồi lọc URL được phép trước khi gửi request. Code trong bài đã chạy thử qua proxy có mật khẩu, kèm một lỗi dễ gặp của thư viện chuẩn Python.
Robots.txt khi crawl website quy định những gì
Robots.txt là file văn bản đặt ở gốc tên miền, ví dụ example.com/robots.txt, nơi chủ website ghi phần nào crawler được và không được truy cập. Chuẩn này có từ năm 1994 và được IETF công bố thành RFC 9309 năm 2022.
Robots.txt không phải hàng rào kỹ thuật
RFC 9309 ghi rõ các luật trong robots.txt không phải cơ chế cấp quyền truy cập. Website không chặn được ai bằng robots.txt; crawler nào muốn làm ngơ thì vẫn tải được trang.
Vì vậy tôn trọng robots.txt là lựa chọn của người viết crawler. Robots.txt là lời yêu cầu của chủ website, crawler tử tế thì làm theo, và bỏ qua nó thường là bước đầu dẫn tới bị chặn IP hoặc rắc rối pháp lý. Đọc thêm điều khoản sử dụng của website, vì điều khoản có thể chặt hơn robots.txt.
Các dòng thường gặp
Một file robots.txt gồm các nhóm, mỗi nhóm bắt đầu bằng một hoặc nhiều dòng User-agent và theo sau là các luật. Danh sách dưới tóm tắt các dòng anh em sẽ gặp:
- User-agent: tên crawler mà nhóm áp dụng, dấu sao nghĩa là mọi crawler.
- Disallow: đường dẫn bị cấm, tính từ đầu đường dẫn.
- Allow: đường dẫn được phép, dùng để mở lại một phần trong vùng bị cấm.
- Sitemap: địa chỉ đầy đủ của sitemap hoặc sitemap index, không thuộc nhóm nào.
- Crawl-delay: số giây chờ giữa hai request, không nằm trong RFC 9309 và Google không hỗ trợ, nhưng nhiều crawler khác vẫn đọc.
Robots.txt và proxy
Dùng proxy không làm thay đổi luật trong robots.txt. Crawler đi qua mười IP khác nhau vẫn là một crawler, vẫn phải tuân theo luật cho user-agent của nó.
Proxy giúp chia tải và lấy nội dung theo vùng, không phải công cụ để vượt qua dòng Disallow. Phần sau của bài dùng proxy để tải robots.txt, sitemap và trang, đúng như một crawler thật chạy qua proxy.
Đọc User-agent, Disallow và Sitemap trong robots.txt khi crawl website
Phần lớn lỗi khi đọc robots.txt đến từ việc hiểu sai cách chọn nhóm và cách so khớp đường dẫn. RFC 9309 quy định rõ cả hai, và tài liệu robots.txt của Google giải thích thêm cách Google áp dụng.
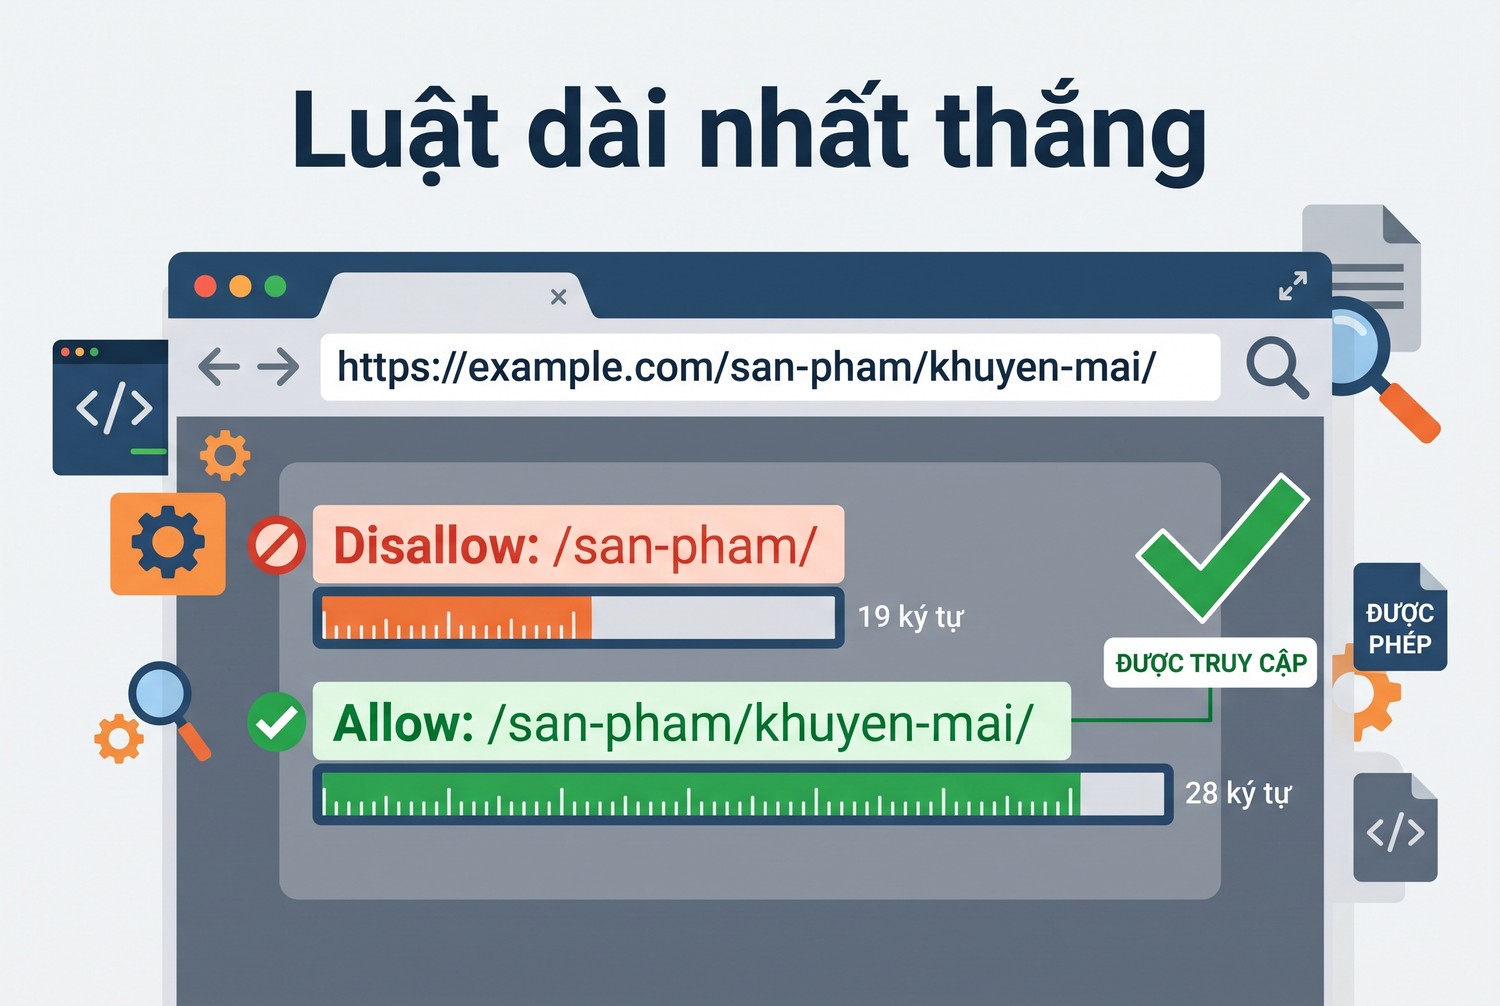
Luật dài nhất thắng
Chọn đúng nhóm User-agent
Crawler tìm nhóm có User-agent khớp với tên của mình, không phân biệt hoa thường. Nếu có nhiều nhóm cùng khớp, luật của chúng được gộp lại thành một. Chỉ khi không có nhóm nào khớp tên, crawler mới dùng nhóm có User-agent là dấu sao.
Điểm hay bị hiểu sai: nhóm riêng thay thế nhóm dấu sao, không cộng thêm vào. Nếu robots.txt có nhóm dấu sao cấm /san-pham/ và nhóm GiaBot chỉ cấm /tai-khoan/, thì GiaBot được vào /san-pham/. RFC 9309 còn yêu cầu tên trong dòng User-agent nên là một phần của chuỗi User-Agent mà crawler gửi trong request.
Đặt tên cho crawler của anh em
RFC 9309 quy định tên dùng trong dòng User-agent chỉ gồm chữ cái thường, chữ hoa, dấu gạch dưới và dấu gạch ngang. Tên đó nên xuất hiện trong chuỗi User-Agent mà crawler gửi đi, kèm đường dẫn tới trang mô tả mục đích crawler, ví dụ GiaCrawler/1.0 kèm địa chỉ trang giới thiệu.
Đặt tên rõ ràng có hai lợi ích. Chủ website biết ai đang truy cập và có thể viết luật riêng cho crawler của anh em thay vì chặn cả dải IP. Và anh em biết chắc nhóm luật nào áp dụng cho mình. Crawler giả danh trình duyệt rồi đọc nhóm dấu sao là cách làm thiếu minh bạch, dễ bị coi là bot xấu.
So khớp đường dẫn: luật dài nhất thắng
Theo RFC 9309, crawler so đường dẫn của URL với mọi dòng Allow và Disallow trong nhóm, rồi dùng luật khớp dài nhất tính theo số byte. Nếu Allow và Disallow dài bằng nhau, Allow được ưu tiên. Thứ tự dòng trong file không quan trọng.
Ví dụ Disallow: /san-pham/ và Allow: /san-pham/khuyen-mai/ thì URL /san-pham/khuyen-mai/ao-thun được phép, vì luật Allow dài hơn. Phần ví dụ sẽ cho thấy thư viện chuẩn của Python không làm đúng điều này.
Hai ký tự đặc biệt
RFC 9309 yêu cầu crawler hiểu hai ký tự. Dấu sao nghĩa là không hoặc nhiều ký tự bất kỳ, ví dụ Disallow: /*?sort= cấm mọi URL có tham số sort. Dấu đô la nghĩa là kết thúc đường dẫn, ví dụ Disallow: /*.pdf$ cấm file pdf nhưng không cấm /catalog.pdf?v=2.
Dấu thăng mở đầu chú thích, phần sau nó trên cùng dòng bị bỏ qua. Đường dẫn so khớp có phân biệt hoa thường, nên /San-Pham/ và /san-pham/ là hai đường dẫn khác nhau.
Dòng Sitemap
Dòng Sitemap chứa địa chỉ đầy đủ, có thể trỏ tới sitemap index chứa nhiều sitemap con, và có thể có nhiều dòng. Theo Google, dòng này không gắn với nhóm User-agent nào. Với crawler, đây là nguồn URL quan trọng nhất, vì chủ website tự liệt kê những trang họ muốn được tìm thấy.
Bảng dưới gom cách xử lý của RFC 9309 và Google cho các điểm hay gây tranh cãi:
Điểm |
RFC 9309 |
|
|---|---|---|
Allow và Disallow xung đột |
Luật dài nhất thắng, bằng nhau thì Allow |
Như RFC |
Crawl-delay |
Không có trong chuẩn |
Không hỗ trợ |
Giới hạn kích thước |
Phải đọc ít nhất 500 KiB |
Đọc tối đa 500 KiB |
Bộ nhớ đệm |
Không nên giữ quá 24 giờ |
Thường tối đa 24 giờ |
Chuyển hướng |
Theo ít nhất 5 lần |
Theo ít nhất 5 lần |
Chuẩn bị môi trường thử robots.txt khi crawl website
Mình dựng một site thử có robots.txt mẫu, sitemap index và sitemap con, đặt sau một proxy HTTP yêu cầu tài khoản. Mọi thứ chạy trên máy, không gửi request tới website thật.
Phiên bản đã dùng
Kiểm tra ngày 25/10/2026, các phiên bản như sau:
- Python 3.12.10, mô-đun chuẩn urllib.robotparser.
- Protego 0.7.0, bộ đọc robots.txt mà Scrapy dùng, cài kèm Scrapy 2.19.0.
- requests 2.34.2 để tải robots.txt và sitemap qua proxy.
Tài liệu urllib.robotparser bản mới nhắc tới RFC 9309. Kết quả trong bài là của Python 3.12.10, anh em dùng bản khác thì chạy lại phép thử bên dưới để kiểm.
Robots.txt mẫu
File mẫu có đủ các tình huống khó: một vùng cấm có phần mở lại, luật có dấu sao, luật có dấu đô la, một nhóm riêng cho GiaBot và một dòng Sitemap.
User-agent: *
Disallow: /san-pham/
Allow: /san-pham/khuyen-mai/
Disallow: /*?sort=
Disallow: /*.pdf$
Crawl-delay: 5

User-agent: GiaBot
Disallow: /tai-khoan/

Sitemap: https://shop.example/sitemap_index.xml
Sitemap index trỏ tới một sitemap con chứa 6 URL: hai trang sản phẩm, một trang danh mục có tham số sort, một file pdf, một trang tài khoản và một bài tin tức.
Ví dụ robots.txt khi crawl website: đầu vào, cách chạy và đầu ra
Phần này có hai ví dụ. Ví dụ đầu so hai bộ đọc trên cùng file. Ví dụ sau là một pipeline hoàn chỉnh: tải robots.txt qua proxy, lấy sitemap, lọc URL được phép.
So urllib.robotparser với Protego
Đoạn code dưới đọc cùng file mẫu bằng hai bộ đọc, rồi hỏi từng URL có được phép không với hai tên crawler. Chú ý thứ tự tham số của hai hàm can_fetch ngược nhau.
from urllib.robotparser import RobotFileParser
from protego import Protego

ROBOTS = open("robots_mau.txt", encoding="utf-8").read()
std = RobotFileParser()
std.parse(ROBOTS.splitlines())
pro = Protego.parse(ROBOTS)

for ua in ["MyCrawler", "GiaBot"]:
    for path in ["/san-pham/ao-thun", "/san-pham/khuyen-mai/ao-thun", "/danh-muc?sort=gia",
                 "/catalog.pdf", "/catalog.pdf?v=2", "/tai-khoan/don-hang", "/tin-tuc/"]:
        u = "https://shop.example" + path
        print(ua, path, "urllib=", std.can_fetch(ua, u), "protego=", pro.can_fetch(u, ua))
Với MyCrawler, hai bộ đọc trả lời khác nhau ở 3 trên 7 URL:
URL |
urllib.robotparser |
Protego |
Lý do |
|---|---|---|---|
/san-pham/khuyen-mai/ao-thun |
Cấm |
Được phép |
Luật Allow dài hơn phải thắng |
/danh-muc?sort=gia |
Được phép |
Cấm |
urllib không hiểu dấu sao |
/catalog.pdf |
Được phép |
Cấm |
urllib không hiểu dấu đô la |
Với GiaBot, hai bộ đọc trả lời giống nhau: được vào /san-pham/ và cấm /tai-khoan/, đúng quy tắc nhóm riêng thay thế nhóm dấu sao. Cả hai đọc được Crawl-delay bằng 5 và địa chỉ sitemap.
Đọc kết quả so sánh
Trên Python 3.12.10, urllib.robotparser so khớp theo thứ tự dòng thay vì theo luật dài nhất, và coi dấu sao, dấu đô la là ký tự thường. Kết quả là nó cấm nhầm trang được phép và cho phép nhầm trang bị cấm.
Cho phép nhầm nguy hiểm hơn cấm nhầm, vì crawler sẽ tải những trang chủ website đã yêu cầu tránh. Nếu tự viết crawler bằng Python, dùng Protego hoặc một bộ đọc theo RFC 9309 thay cho urllib.robotparser, hoặc ít nhất kiểm bộ đọc đang dùng bằng file mẫu có dấu sao và Allow lồng trong Disallow.
Pipeline hoàn chỉnh qua proxy
Đoạn dưới là pipeline mình dùng: tải robots.txt qua proxy với User-Agent có tên crawler và trang mô tả, xử lý mã lỗi theo RFC 9309, đọc mọi sitemap kể cả sitemap index, rồi chia URL thành hai danh sách.
import sys, xml.etree.ElementTree as ET
from urllib.parse import quote, urljoin
import requests
from protego import Protego

UA = "GiaCrawler/1.0 (+https://example.vn/bot)"
TOKEN = "GiaCrawler"
PROXY = f"http://user1:{quote('p@ss#2026', safe='')}@127.0.0.1:8792"
S = requests.Session()
S.headers["User-Agent"] = UA
S.proxies = {"http": PROXY, "https": PROXY}
NS = {"sm": "http://www.sitemaps.org/schemas/sitemap/0.9"}

def load_robots(base):
    r = S.get(urljoin(base, "/robots.txt"), timeout=15)
    if 400 <= r.status_code < 500 and r.status_code != 429:
        return Protego.parse(""), f"{r.status_code}: coi như không có luật"
    if r.status_code >= 500 or r.status_code == 429:
        return None, f"{r.status_code}: tạm dừng, coi như cấm toàn bộ"
    if "html" in r.headers.get("Content-Type", "").lower():
        return Protego.parse(""), "200 nhưng là trang HTML: coi như không có luật, ghi log để xem lại"
    text = r.content.decode("utf-8", "replace").lstrip("")  # bỏ BOM ở đầu file
    return Protego.parse(text), "200"

def sitemap_urls(url):
    root = ET.fromstring(S.get(url, timeout=15).content)
    if root.tag.endswith("sitemapindex"):
        for loc in root.findall("sm:sitemap/sm:loc", NS):
            yield from sitemap_urls(loc.text.strip())
    else:
        for loc in root.findall("sm:url/sm:loc", NS):
            yield loc.text.strip()

rp, note = load_robots("http://127.0.0.1:8811/")
if rp is None:
    sys.exit("Dừng lại, thử lại sau: " + note)
allowed, blocked = [], []
for sm in rp.sitemaps:
    for u in sitemap_urls(sm):
        (allowed if rp.can_fetch(u, TOKEN) else blocked).append(u)
print(rp.crawl_delay(TOKEN), allowed, blocked)
Với tên GiaCrawler, pipeline lấy được 6 URL từ sitemap. Ba URL được crawl là trang khuyến mãi, trang tài khoản và bài tin tức; ba URL bị cấm là trang sản phẩm thường, trang có tham số sort và file pdf. Crawl-delay đọc được là 5 giây. Đổi tên thành GiaBot, kết quả thành 5 được crawl và 1 bị cấm. Log proxy ghi 21 request, tất cả đều có xác thực đúng.
Xử lý lỗi và giới hạn request với robots.txt khi crawl website
Robots.txt không phải lúc nào cũng tải về được. Cách crawler xử lý khi tải lỗi quyết định nó tôn trọng website tới đâu, và đây là chỗ thư viện chuẩn Python cũng khác chuẩn.
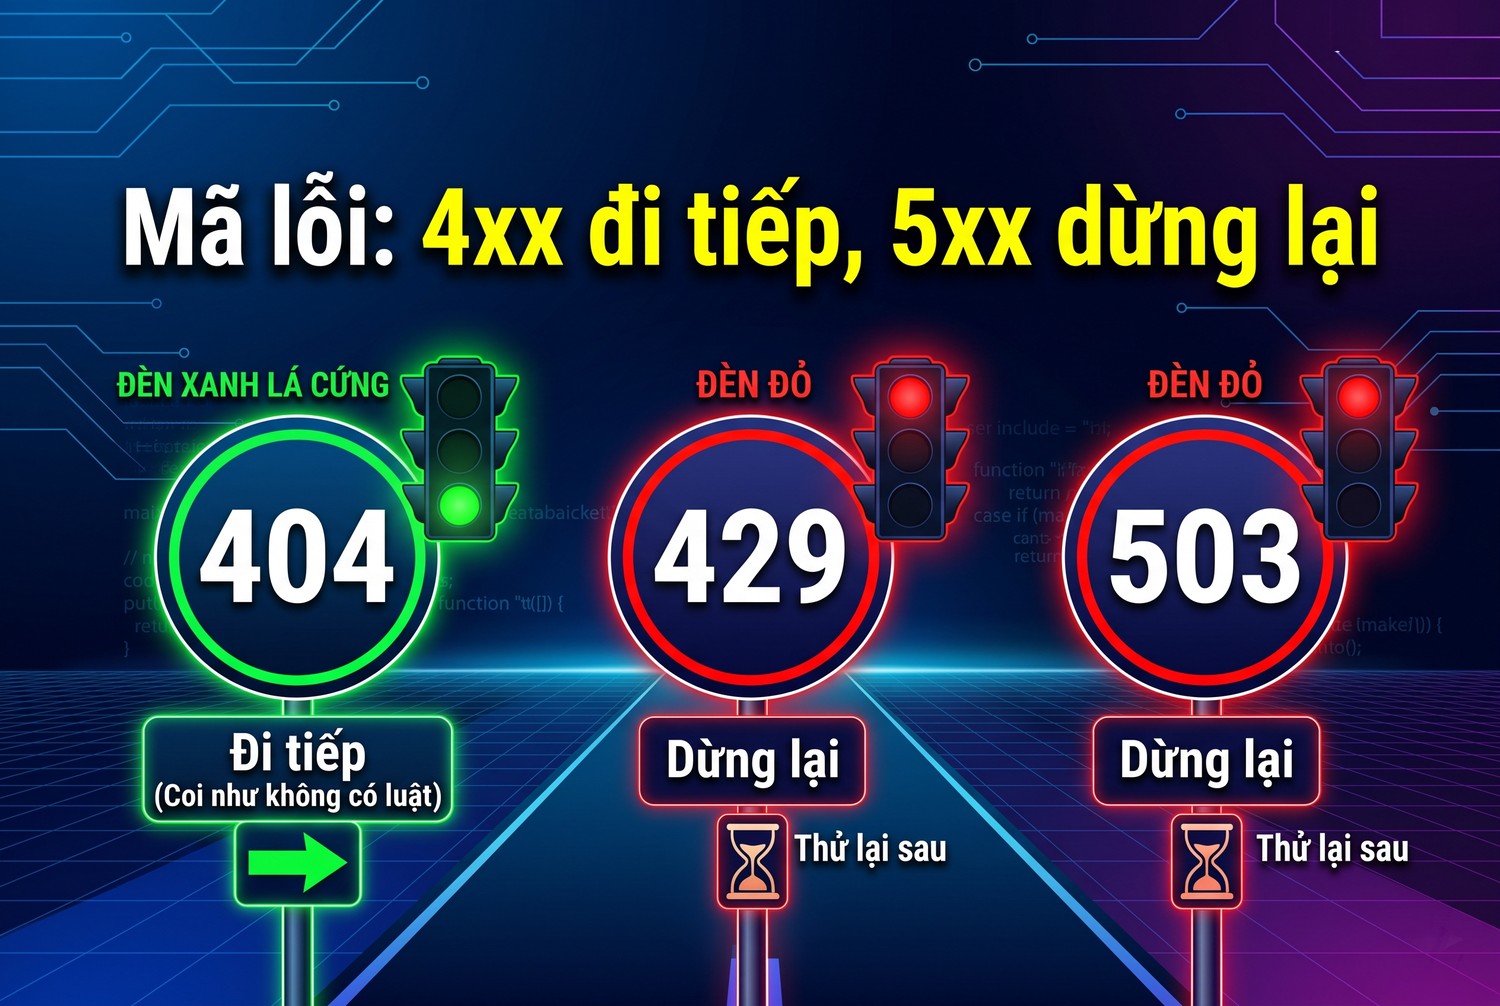
Mã lỗi: 4xx đi tiếp, 5xx dừng lại
Mã lỗi khi tải robots.txt
RFC 9309 chia làm hai trường hợp. Không có sẵn, tức mã 4xx, thì crawler được truy cập mọi thứ. Không truy cập được do lỗi máy chủ hay mạng, tức mã 5xx, thì crawler phải coi như bị cấm toàn bộ. Google bổ sung: 429 được xử lý như lỗi máy chủ, không như 4xx thường.
Mình thử urllib.robotparser với ba mã lỗi trên site thử. Với 404, nó cho phép tất cả, đúng chuẩn. Với 403, nó cấm tất cả, chặt hơn chuẩn. Với 503, can_fetch trả False cho mọi URL vì bộ đọc chưa ghi nhận lần tải thành công nào. Pipeline ở trên xử lý theo đúng RFC 9309 và Google.
Google xử lý lỗi kéo dài thế nào
Tài liệu của Google mô tả cụ thể khi robots.txt trả 5xx. Trong 12 giờ đầu, Google ngừng crawl nhưng vẫn thử tải lại robots.txt. Trong 30 ngày tiếp theo, Google dùng bản tốt gần nhất đã lưu. Sau 30 ngày, nếu website vẫn truy cập được, Google coi như không có robots.txt.
Crawler của anh em không cần làm phức tạp như vậy, nhưng nên có hai điều: dừng khi robots.txt lỗi 5xx, và lưu bản tốt gần nhất để dùng tạm khi lỗi ngắn hạn. Lỗi mạng như hết thời gian chờ hay kết nối bị ngắt cũng được Google coi là lỗi máy chủ.
Chuyển hướng khi tải robots.txt
Nhiều website chuyển hướng robots.txt từ http sang https, hoặc từ tên miền không có www sang có www. RFC 9309 yêu cầu crawler theo ít nhất năm lần chuyển hướng liên tiếp, kể cả sang tên miền khác, và dùng file tìm được ở cuối chuỗi.
Thư viện requests mặc định theo tới 30 lần chuyển hướng, nhiều hơn mức cần. Mình đặt thuộc tính max_redirects của Session bằng 5 cho phần tải robots.txt, để crawler không mắc kẹt trong vòng chuyển hướng lỗi. Quá năm lần thì coi như robots.txt không có sẵn, theo đúng RFC.
Giới hạn kích thước file
RFC 9309 yêu cầu crawler đọc được ít nhất 500 KiB, còn Google đọc tối đa 500 KiB và bỏ qua phần sau. Robots.txt thường chỉ vài KB, nhưng một số website lớn có file rất dài vì liệt kê hàng nghìn đường dẫn.
Với crawler tự viết, đặt giới hạn đọc khoảng 500 KiB là hợp lý, vừa đúng chuẩn vừa tránh việc một file bất thường làm tốn bộ nhớ. Nếu file bị cắt, ghi log để biết luật phía sau có thể bị bỏ sót.
Lưu đệm và tải lại
RFC 9309 khuyên không dùng bản lưu đệm quá 24 giờ, trừ khi không tải được bản mới. Với crawler chạy nhiều ngày, mình tải lại robots.txt mỗi ngày một lần cho mỗi tên miền, không tải lại trước mỗi request.
Tải robots.txt trước mỗi request vừa lãng phí vừa làm tăng số request lên gấp đôi. Với crawler qua proxy tính tiền theo dung lượng, đây là chi phí không cần thiết.
Crawl-delay và giới hạn tốc độ
Crawl-delay không có trong RFC 9309 và Google bỏ qua, nhưng khi một website ghi Crawl-delay: 5, đó là tín hiệu rõ về tốc độ họ chấp nhận. Mình luôn tuân theo, và giới hạn theo tên miền, không theo IP.
Đây là chỗ hay bị hiểu sai khi dùng proxy: có mười IP không có nghĩa được gửi nhanh gấp mười. Crawl-delay áp dụng cho crawler, nên tổng tốc độ qua mọi IP tới một tên miền vẫn phải theo đúng con số đó. Bài proxy Scrapy có phần cấu hình DOWNLOAD_DELAY và AUTOTHROTTLE theo tên miền.
Kiểm tra dữ liệu đầu ra
Sau mỗi lần chạy, mình kiểm hai điều. Không URL nào trong danh sách đã tải nằm trong danh sách bị cấm theo robots.txt. Và số URL bị cấm không tăng đột biến so với lần trước, vì tăng đột biến thường nghĩa là website vừa sửa robots.txt và cần xem lại phạm vi crawl.
Những file robots.txt khi crawl website dễ đọc sai
Robots.txt do con người viết tay, nên file thật ngoài đời có đủ loại lỗi. Mình tạo bốn file mẫu theo các lỗi hay gặp và cho hai bộ đọc chạy thử, kết quả có vài điểm bất ngờ.
Ký tự BOM ở đầu file
Nhiều trình soạn thảo trên Windows lưu file UTF-8 kèm ký tự BOM ở đầu. Tài liệu Google ghi họ bỏ qua BOM và chỉ dùng các dòng hợp lệ. Nhưng trong bài thử, cả urllib.robotparser lẫn Protego đều không nhận ra dòng User-agent đầu tiên khi có BOM dính phía trước.
Hệ quả là luật Disallow: /private/ mất tác dụng, cả hai bộ đọc đều cho phép /private/a. Pipeline ở trên đã thêm bước bỏ BOM trước khi đưa vào Protego; chạy lại với cùng file, URL đó bị cấm đúng như chủ website muốn.
Robots.txt trả về trang HTML
Một số website cấu hình sai, đường dẫn không tồn tại trả về trang chủ với mã 200 thay vì 404. Khi đó robots.txt mà crawler tải về là một trang HTML. Cả hai bộ đọc đều không tìm thấy luật nào trong HTML và cho phép mọi thứ.
Kết quả đó trùng với trường hợp 404, nên về mặt luật không sai. Nhưng mình vẫn ghi log riêng, vì đôi khi website trả HTML do bị lỗi tạm thời, còn robots.txt thật có luật cấm. Pipeline kiểm header Content-Type để phát hiện trường hợp này.
Sai chính tả từ khóa
File mẫu viết Dissalow thay vì Disallow, lỗi gõ khá phổ biến. urllib.robotparser bỏ qua dòng này và cho phép /private/a. Protego chấp nhận cách viết sai và vẫn cấm.
Với lỗi trong file của người khác, không có cách hiểu nào đúng cho mọi trường hợp. Với crawler tuân thủ, mình chọn cách hiểu chặt hơn, tức theo Protego, vì rõ ràng chủ website muốn cấm đường dẫn đó.
Một nhóm nhiều dòng User-agent
File mẫu có hai dòng User-agent cho GiaBot và TinBot liền nhau, theo sau là một dòng Disallow. Theo RFC 9309, luật áp dụng cho cả hai tên. Cả hai bộ đọc đều làm đúng, cấm TinBot vào /private/.
Đây là cách viết hợp lệ và gọn, nhưng người mới đọc file bằng mắt dễ nghĩ luật chỉ áp dụng cho dòng User-agent gần nhất. Khi đọc tay, nhớ rằng một nhóm kết thúc khi gặp dòng User-agent mới sau các luật, không phải khi gặp dòng User-agent mới ngay sau dòng User-agent khác.
Robots.txt theo tên miền con và giao thức
Tài liệu Google ghi luật trong robots.txt chỉ áp dụng cho đúng giao thức, tên máy chủ và cổng nơi file được đặt. File ở https://example.com/robots.txt không áp dụng cho http://example.com, cho shop.example.com hay cho cổng 8181.
Crawler đi qua nhiều tên miền con phải tải robots.txt riêng cho từng tên miền con. Lỗi hay gặp là tải robots.txt của tên miền chính rồi áp cho mọi tên miền con, có thể cho phép nhầm những đường dẫn mà tên miền con cấm.
Robots.txt khi crawl website trong pipeline thật
Phần này đặt bộ đọc robots.txt vào đúng chỗ trong một crawler đầy đủ, và nói về các công cụ có sẵn bộ đọc để anh em không phải tự viết.
Vị trí trong pipeline
Một pipeline crawl thường đi theo thứ tự: tải robots.txt, đọc sitemap, gom URL từ sitemap và từ liên kết trong trang, lọc qua robots.txt, xếp hàng theo Crawl-delay, rồi mới tải trang. Bước lọc phải đứng trước bước tải, không phải sau.
URL tìm được qua liên kết trong trang cũng phải lọc, không chỉ URL từ sitemap. Nhiều crawler chỉ lọc sitemap rồi đi theo liên kết tự do, vô tình tải những trang bị cấm.
Công cụ có sẵn bộ đọc
Scrapy có RobotsTxtMiddleware, bật bằng ROBOTSTXT_OBEY, dùng Protego làm bộ đọc mặc định. Dự án tạo bằng lệnh startproject đã bật sẵn setting này. Crawl4AI có tùy chọn check_robots_txt trong cấu hình chạy.
Với công cụ không code như Screaming Frog, phần cài đặt cho chọn tuân theo hay bỏ qua robots.txt. Bài proxy Screaming Frog có hướng dẫn cấu hình crawl SEO đi qua proxy.
Lưu lịch sử robots.txt
Mình lưu mỗi bản robots.txt tải về kèm ngày giờ, chỉ lưu khi nội dung khác bản trước. Sau vài tháng, thư mục này cho biết website đổi luật lúc nào và đổi gì, rất hữu ích khi có câu hỏi vì sao crawler từng tải một trang mà bây giờ bị cấm.
Lịch sử này cũng là bằng chứng crawler đã tuân thủ luật tại thời điểm tải. Với dự án thu thập dữ liệu cho khách hàng, đây là phần hồ sơ đáng giữ cùng log request.
Trang bị cấm nhưng vẫn có trong sitemap
Trong bài thử, sitemap liệt kê cả những URL mà robots.txt cấm. Website thật cũng hay gặp tình huống này, do hai file được quản lý bởi hai người hay hai hệ thống khác nhau. Khi xung đột, robots.txt là thứ crawler phải theo.
Nếu anh em làm SEO cho chính website đó, xung đột này là lỗi cần sửa: hoặc bỏ URL khỏi sitemap, hoặc mở lại trong robots.txt. Theo hướng dẫn đọc robots.txt của Geonode, kiểm robots.txt định kỳ là việc nên làm với cả người crawl lẫn chủ website.
Khi nào cần proxy với robots.txt khi crawl website và checklist
Proxy và robots.txt giải quyết hai vấn đề khác nhau. Robots.txt cho biết được crawl gì, proxy giúp crawl ổn định với số lượng lớn hoặc lấy nội dung theo vùng.
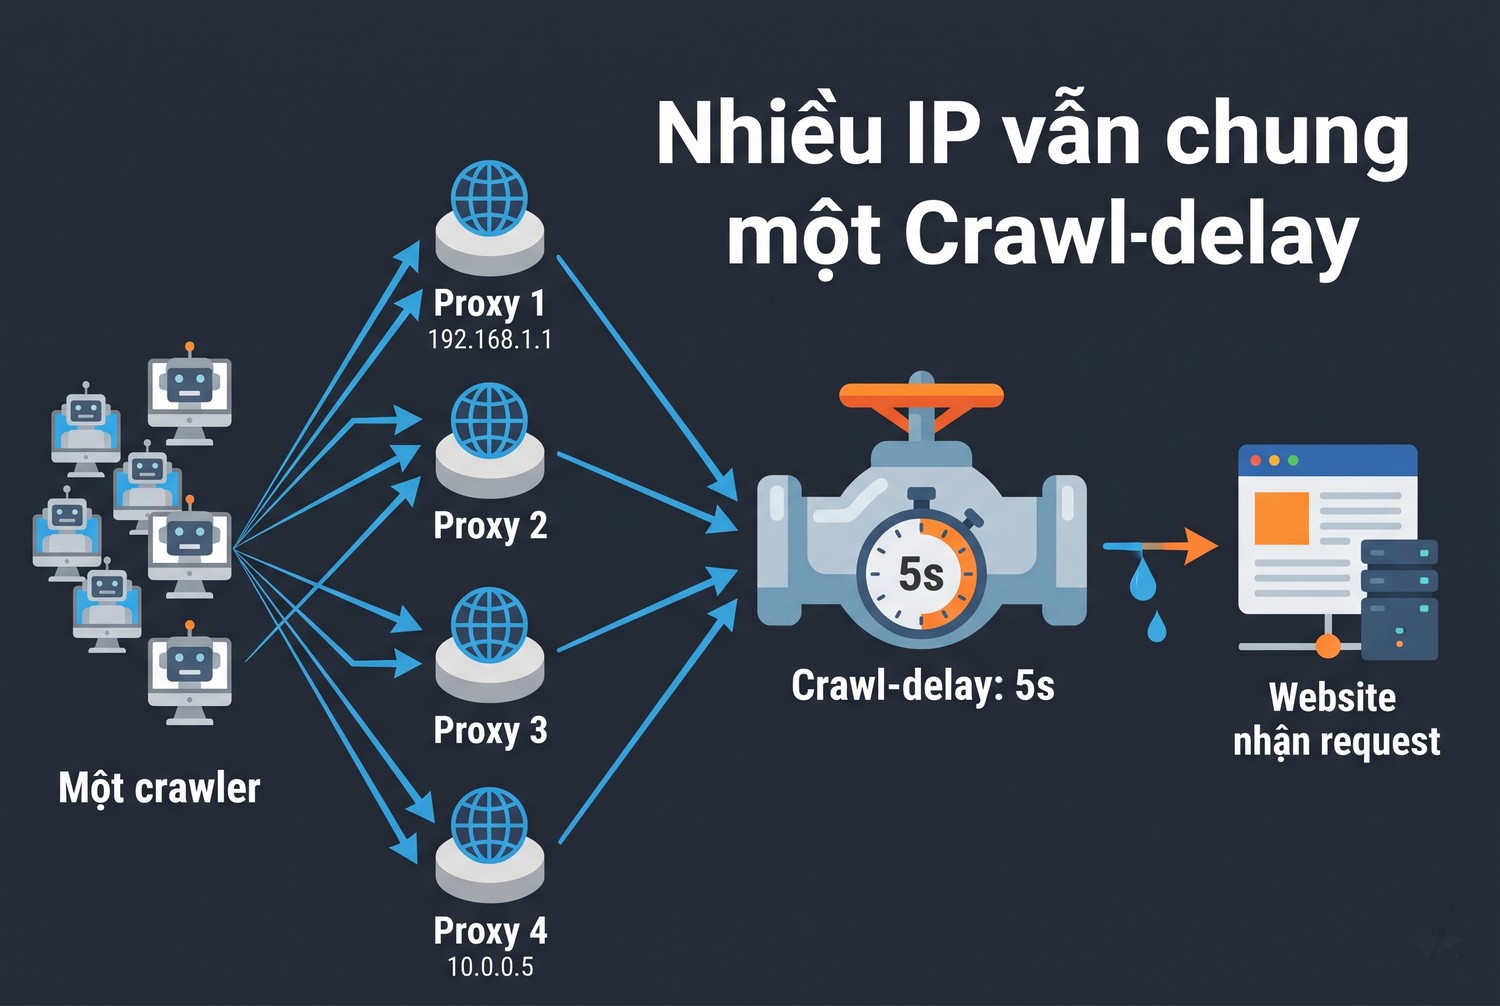
Nhiều IP vẫn chung một Crawl-delay
Khi nào cần proxy
Crawl vài trăm trang tuân theo Crawl-delay từ một máy thường không cần proxy. Proxy hữu ích khi crawl nhiều website cùng lúc, mỗi website một tốc độ, để tổng lưu lượng không dồn vào một IP. Proxy cũng cần khi website hiển thị nội dung khác theo vùng, như giá và tồn kho tại Việt Nam.
Bài web scraping proxy là gì giải thích cơ chế chung. Với nhiều dự án chạy song song, bài proxy pool hướng dẫn chia IP theo mục đích.
Chọn proxy cho crawler tuân thủ
Crawler tuân theo Crawl-delay gửi request chậm và đều, nên proxy datacenter thường đủ cho website ít chống bot. Website có hệ thống chống bot cần proxy dân cư. Giữ cùng một IP cho cùng một tên miền trong một phiên crawl giúp lưu lượng trông nhất quán.
Khi cần mua proxy tốc độ cao cho crawler, ProxyVN có datacenter Việt Nam, proxy dân cư tĩnh Viettel, VNPT, FPT và proxy 4G, giao thức HTTP hoặc SOCKS5, cấp user và password. Nhớ mã hóa mật khẩu khi ghép vào URL proxy như trong pipeline ở trên.
Checklist trước khi chạy thật
Danh sách dưới mình dùng cho mỗi crawler mới:
- Đặt User-Agent có tên crawler và trang mô tả, dùng cùng tên đó khi hỏi can_fetch.
- Dùng bộ đọc theo RFC 9309, kiểm bằng file mẫu có dấu sao, dấu đô la và Allow lồng trong Disallow.
- Xử lý mã lỗi: 4xx trừ 429 coi như không có luật, 5xx và 429 thì dừng.
- Lưu bản robots.txt tốt gần nhất, tải lại mỗi ngày.
- Lọc mọi URL trước khi tải, cả từ sitemap lẫn từ liên kết trong trang.
- Tuân theo Crawl-delay theo tên miền, không nhân lên theo số IP proxy.
- Đọc thêm điều khoản sử dụng của website.
- Ghi log URL bị cấm để phát hiện khi website đổi robots.txt.
Robots.txt cho biết crawler được đi đâu. Proxy chỉ giúp crawler đi ổn định hơn trên những con đường đã được phép.
Checklist trước khi chạy thật
Câu hỏi thường gặp
Website không có robots.txt thì sao. Mã 404 nghĩa là không có luật, crawler được phép truy cập mọi thứ theo RFC 9309. Vẫn nên crawl với tốc độ vừa phải và đọc điều khoản sử dụng.
Robots.txt cấm mọi thứ nhưng trang công khai, có crawl được không. Về kỹ thuật thì được, nhưng chủ website đã yêu cầu rõ là không. Nếu cần dữ liệu, liên hệ chủ website hoặc tìm API chính thức thay vì làm ngơ yêu cầu đó.
Có cần tôn trọng robots.txt khi chỉ theo dõi vài trang. Có. Số trang ít không thay đổi yêu cầu của chủ website. Với công cụ theo dõi thay đổi chạy dài ngày, số request cộng dồn còn lớn hơn một lần crawl.
Robots.txt cấm crawl có nghĩa là trang không được lập chỉ mục không. Không hẳn. Robots.txt điều khiển việc crawl, không điều khiển việc lập chỉ mục. Muốn trang không xuất hiện trên kết quả tìm kiếm, chủ website dùng thẻ meta robots noindex, và thẻ đó chỉ có tác dụng khi crawler được phép tải trang để đọc. Với người viết crawler thu thập dữ liệu, điều cần nhớ là cứ theo robots.txt cho việc tải trang.
Đổi IP bằng proxy có làm robots.txt hết hiệu lực không. Không. Robots.txt áp dụng cho crawler, không cho IP. Đổi IP để né luật cấm là làm ngơ yêu cầu của chủ website, dễ dẫn tới bị chặn cả dải IP.
Robots.txt khi crawl website và những điều cần nhớ
Robots.txt khi crawl website cần đọc đúng nhóm User-agent, luật dài nhất thắng, hiểu dấu sao và dấu đô la, xử lý mã lỗi theo RFC 9309. Lọc URL trước khi tải, tuân theo Crawl-delay dù có nhiều IP. Cần proxy ổn định, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam cho robots.txt khi crawl website.


