
RAG với ChromaDB và dữ liệu web: tải trang, lưu và trích nguồn
RAG với ChromaDB và dữ liệu web là cách cho mô hình ngôn ngữ trả lời dựa trên tài liệu anh em thu thập, thay vì chỉ dựa vào trí nhớ của mô hình. Phần khó thường nằm ở khâu tải và làm sạch trang. Bài này, ProxyVN hướng dẫn dựng một lab nhỏ: tải vài trang công khai qua proxy, chia đoạn, lưu vào ChromaDB rồi trả lời kèm đường dẫn nguồn.
RAG với ChromaDB và dữ liệu web hoạt động ra sao
Một hệ thống RAG gồm hai nửa tách biệt: nửa nạp dữ liệu và nửa truy vấn. Nửa nạp dữ liệu tải tài liệu, cắt nhỏ, chuyển thành vector rồi lưu lại. Nửa truy vấn nhận câu hỏi, tìm các đoạn gần nghĩa nhất và đưa chúng vào prompt cho mô hình. Hiểu rõ ranh giới này giúp anh em biết lỗi nằm ở đâu khi câu trả lời sai.
Khái niệm RAG được mô tả trong bài báo Retrieval-Augmented Generation của Lewis và cộng sự. Ý tưởng cốt lõi rất đơn giản: mô hình sinh văn bản được cấp thêm tài liệu liên quan tại thời điểm hỏi. Nhờ đó, câu trả lời có thể dẫn nguồn và cập nhật khi tài liệu thay đổi mà không cần huấn luyện lại mô hình.
Vai trò của ChromaDB trong lab
ChromaDB là cơ sở dữ liệu vector mã nguồn mở, chạy được ngay trong tiến trình Python hoặc dưới dạng máy chủ riêng. Với lab nhỏ, chế độ lưu trên đĩa là đủ dùng. Mỗi bản ghi gồm mã định danh, đoạn văn bản, vector và metadata. Phần metadata chính là nơi giữ URL nguồn để trích dẫn về sau.
Tài liệu chính thức của Chroma mô tả collection như một nhóm bản ghi dùng chung một hàm embedding. Nếu không chỉ định, Chroma dùng hàm embedding mặc định và tự tải model về máy ở lần chạy đầu. Chi tiết này liên quan trực tiếp tới cấu hình mạng, phần sau sẽ nói rõ.
Dữ liệu web khác tài liệu nội bộ ở điểm nào
Tài liệu nội bộ thường sạch và ổn định, còn trang web chứa menu, quảng cáo, chân trang và nội dung thay đổi theo thời gian. Nếu nạp nguyên HTML, kho vector sẽ đầy những đoạn vô nghĩa như "Đăng nhập", "Chính sách cookie". Các đoạn rác này dễ được truy xuất nhầm vì xuất hiện ở mọi trang.
Một điểm khác là quyền sử dụng. Trang công khai không có nghĩa được phép thu thập hàng loạt. Anh em cần đọc điều khoản của website và tệp robots.txt trước khi đưa URL vào danh sách. Chỉ nạp những trang anh em có quyền dùng cho mục đích của dự án.
Tóm lại, RAG với ChromaDB và dữ liệu web đòi hỏi chú ý cả hai khâu: tải đúng nội dung và lưu đủ thông tin nguồn. Thiếu một trong hai, câu trả lời sẽ khó kiểm chứng.
Chuẩn bị môi trường RAG với ChromaDB và dữ liệu web
Môi trường lab nên tách riêng để dễ ghi lại phiên bản và chạy lại trên máy khác. Anh em chỉ cần Python 3.10 trở lên, ba thư viện chính và một thư mục trống để Chroma lưu dữ liệu. Phần dưới đi qua từng bước cài đặt rồi mới tới code.
Cài thư viện cần thiết
Lab dùng Requests để tải trang, BeautifulSoup để lấy phần văn bản chính và ChromaDB để lưu vector. Lệnh dưới đây chạy trên PowerShell; trên Linux hoặc macOS chỉ khác lệnh kích hoạt môi trường ảo.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install chromadb requests beautifulsoup4
python -m pip freeze > requirements-lock.txt
Tệp requirements-lock.txt ghi lại đúng phiên bản đã cài. Khi kết quả truy vấn thay đổi sau một lần nâng cấp, anh em có thể so tệp này để biết thư viện nào đã đổi. Đây là thói quen nhỏ nhưng tiết kiệm nhiều thời gian dò lỗi.
Chuẩn bị danh sách URL thử
Danh sách đầu tiên chỉ nên có ba tới năm trang mà anh em biết rõ nội dung. Nên chọn trang tài liệu kỹ thuật, bài hướng dẫn hoặc trang do chính anh em quản lý. Khi đã biết trang nói gì, anh em mới đánh giá được câu trả lời của hệ thống đúng hay sai.
Lưu danh sách vào tệp urls.txt, mỗi dòng một địa chỉ. Đừng trộn trang cần đăng nhập vào lô thử đầu tiên. Trang đăng nhập trả về nội dung khác nhau theo phiên, khiến việc đối chiếu trở nên rối và dễ kết luận sai.
Tách thông tin proxy khỏi code
Thông tin proxy nên đặt trong biến môi trường thay vì ghi cứng trong tệp Python. Cách này giúp chia sẻ code mà không lộ tài khoản. Anh em đặt địa chỉ proxy theo dạng giao thức, máy chủ và cổng mà nhà cung cấp cấp cho.
$env:LAB_PROXY = 'http://USERNAME:PASSWORD@HOST:PORT'
$env:CHROMA_PATH = '.\chroma_lab'
USERNAME, PASSWORD, HOST và PORT là giá trị mẫu. Nếu mật khẩu có ký tự đặc biệt như @ hoặc :, cần mã hoá URL trước khi ghép vào chuỗi. Khi chụp màn hình hoặc gửi log cho người khác, hãy che phần thông tin đăng nhập.
Như vậy, môi trường đã có thư viện, danh sách URL và cấu hình mạng tách riêng. Đây là nền để code ở các phần sau chạy lại được mà không phải sửa tay.
Proxy trong RAG với ChromaDB và dữ liệu web nằm ở tầng nào
Câu hỏi hay bị bỏ qua là lưu lượng nào thật sự đi qua proxy. Trong lab này có ít nhất hai loại kết nối ra mạng: tải trang web cần thu thập và tải model embedding ở lần chạy đầu. Hai loại kết nối có mục đích khác nhau, nên cấu hình mạng cũng nên tách bạch.
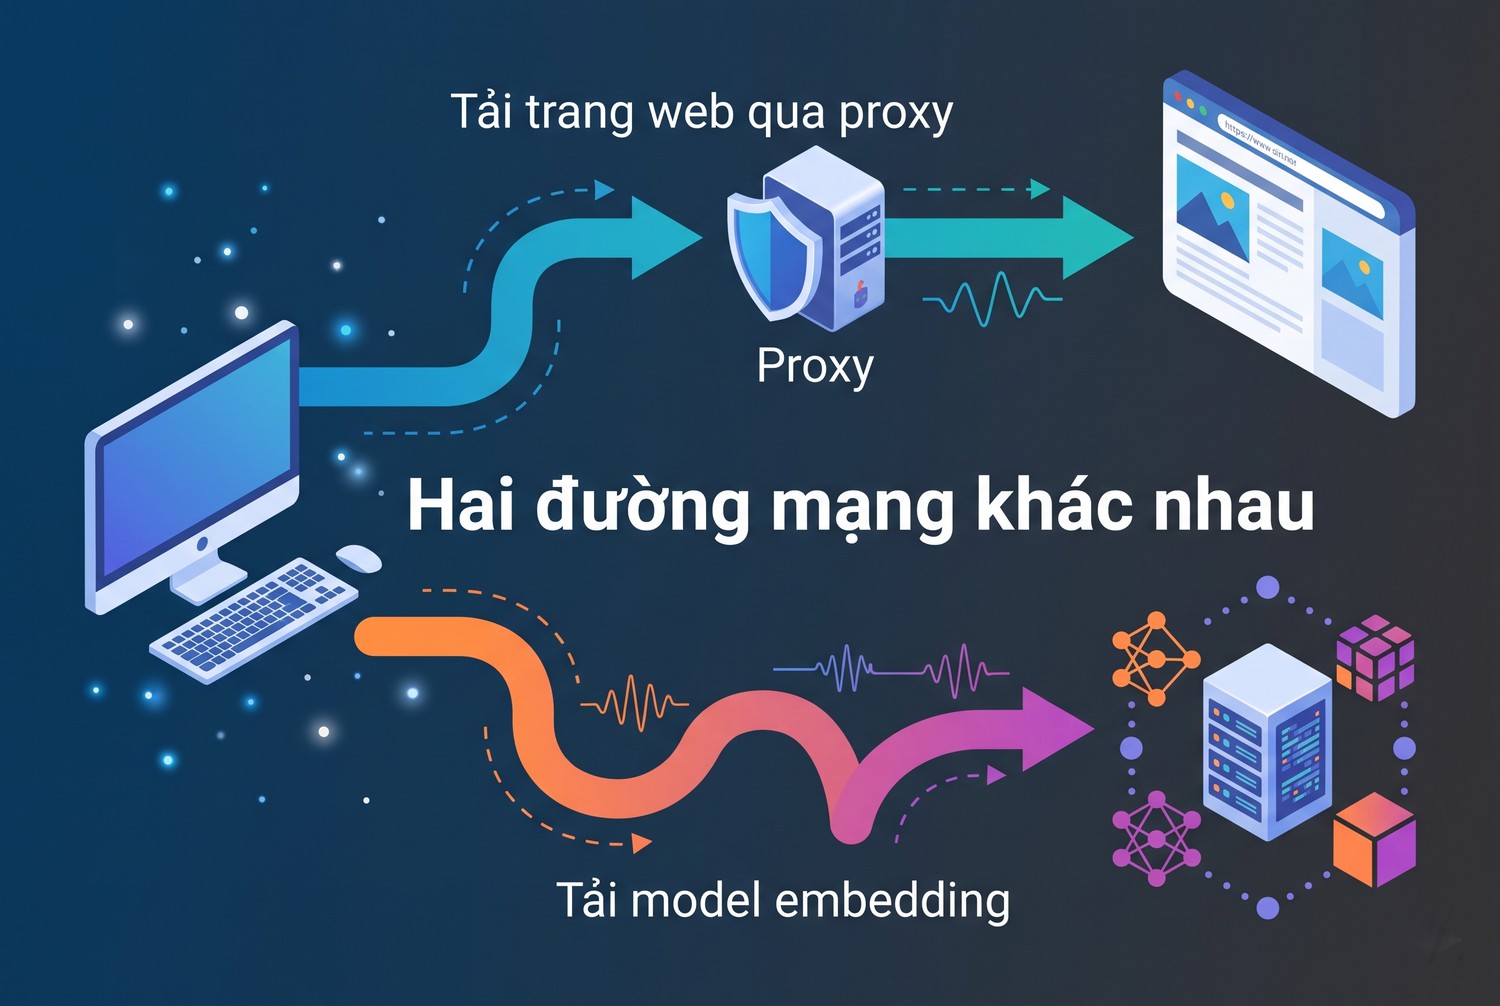
Hai đường mạng khác nhau
Đường tải trang web
Đây là đường anh em chủ động kiểm soát qua tham số proxies của Requests. Hướng dẫn proxy trong tài liệu Requests cho phép truyền proxy theo từng request hoặc theo Session. Truyền theo Session giúp mọi request trong một lượt nạp dùng chung cấu hình và chung kết nối.
Lý do dùng proxy ở đường này thường là phân tải, tách IP khỏi máy làm việc, hoặc kiểm tra nội dung theo khu vực khi website hiển thị khác nhau. Proxy không thay thế cho việc tôn trọng giới hạn tốc độ. Gửi quá nhanh vẫn có thể nhận mã 429 dù đổi IP liên tục.
Đường tải model embedding
Hàm embedding mặc định của Chroma tải model ONNX từ Internet ở lần dùng đầu tiên. Nếu máy nằm sau proxy doanh nghiệp, bước này có thể treo hoặc báo lỗi kết nối dù code tải trang vẫn chạy được. Nguyên nhân là đường tải model đọc biến môi trường HTTP_PROXY, HTTPS_PROXY chứ không đọc tham số proxies trong code của anh em.
Cách xử lý gọn là tải model một lần ở môi trường có mạng phù hợp, sau đó chạy offline từ bộ nhớ đệm. Nếu bắt buộc qua proxy doanh nghiệp, đặt HTTPS_PROXY trước khi khởi động Python. Đừng dùng chung proxy thu thập dữ liệu cho việc tải model nếu không cần, vì sẽ tốn băng thông vô ích.
Bảng phân biệt các đường mạng
Bảng dưới tóm tắt từng loại kết nối, nơi cấu hình và cách kiểm tra. Khi gặp lỗi mạng, anh em đối chiếu bảng này để biết cần sửa ở đâu.
Kết nối |
Mục đích |
Nơi cấu hình |
Cách kiểm tra |
|---|---|---|---|
Tải trang web |
Thu thập nội dung nguồn |
Tham số proxies của Session |
In status, URL cuối, độ dài nội dung |
Tải model embedding |
Lấy model lần đầu |
Biến HTTPS_PROXY hoặc chạy offline |
Xem thư mục cache model |
Gọi API LLM |
Sinh câu trả lời |
SDK của nhà cung cấp |
Log request đã che khoá |
Truy vấn Chroma |
Tìm đoạn gần nghĩa |
Chạy cục bộ, không ra mạng |
Đo thời gian truy vấn |
Truy vấn Chroma ở chế độ PersistentClient chạy ngay trên máy, không cần proxy. Phân biệt rõ điều này giúp anh em không cấu hình thừa và không đổ lỗi nhầm cho proxy khi truy vấn chậm.
Kết lại, proxy trong RAG với ChromaDB và dữ liệu web chỉ nên gắn vào đường tải trang. Các đường khác có cấu hình riêng và nên được kiểm tra riêng.
Tải và làm sạch trang cho RAG với ChromaDB và dữ liệu web
Khâu tải và làm sạch quyết định phần lớn chất lượng câu trả lời. Một đoạn văn sạch, đúng chủ đề có giá trị hơn mười đoạn lẫn menu và quảng cáo. Code dưới đây tải từng URL qua proxy, kiểm tra trạng thái rồi lấy phần văn bản chính.
Code tải trang có kiểm tra trạng thái
Hàm fetch dùng Session có proxy, đặt thời gian chờ và User-Agent rõ ràng. Mỗi lần tải trả về URL cuối cùng sau chuyển hướng, mã trạng thái và nội dung. Ví dụ dưới là mã triển khai chung, anh em điều chỉnh theo website mục tiêu.
import os
import time
import hashlib
import requests
from bs4 import BeautifulSoup

PROXY = os.environ.get("LAB_PROXY")

def make_session():
    s = requests.Session()
    if PROXY:
        s.proxies.update({"http": PROXY, "https": PROXY})
    s.headers.update({"User-Agent": "rag-lab/0.1 (contact: you@example.com)"})
    return s

def fetch(session, url, delay=2.0):
    time.sleep(delay)
    r = session.get(url, timeout=(10, 30))
    return {
        "url": r.url,
        "status": r.status_code,
        "type": r.headers.get("Content-Type", ""),
        "html": r.text if r.ok else "",
    }
Tham số timeout gồm hai giá trị: thời gian chờ kết nối và thời gian chờ đọc. Nếu proxy chậm phản hồi, request sẽ dừng ở mốc 10 giây thay vì treo vô hạn. Biến delay tạo khoảng nghỉ giữa các lượt tải để không dồn tải lên website.
Lấy phần văn bản chính
Hàm clean bỏ các thẻ không mang nội dung như script, style, nav, footer rồi lấy văn bản trong thẻ main hoặc article nếu có. Cách này chưa tối ưu cho mọi website nhưng đủ tốt cho lab. Với trang có cấu trúc riêng, anh em thêm selector phù hợp.
def clean(html):
    soup = BeautifulSoup(html, "html.parser")
    for tag in soup(["script", "style", "nav", "footer", "header", "aside", "form"]):
        tag.decompose()
    root = soup.find("main") or soup.find("article") or soup.body or soup
    title = soup.title.get_text(strip=True) if soup.title else ""
    lines = [ln.strip() for ln in root.get_text("\n").splitlines()]
    text = "\n".join(ln for ln in lines if len(ln) > 30)
    return title, text
Điều kiện độ dài dòng lớn hơn 30 ký tự loại bỏ phần lớn nhãn nút và liên kết ngắn. Ngưỡng này nên điều chỉnh theo ngôn ngữ của trang. Với tiếng Việt, dòng nội dung thường dài hơn nên ngưỡng 30 vẫn an toàn.
Kiểm tra nội dung trước khi nạp
Trước khi đưa vào Chroma, anh em in ra vài thông số: URL cuối, mã trạng thái, kiểu nội dung và số ký tự văn bản sạch. Trang trả 200 nhưng văn bản sạch chỉ vài trăm ký tự thường là trang chặn, trang thông báo cookie hoặc trang cần JavaScript để hiển thị.
- Mã trạng thái khác 200: ghi log, không nạp.
- Content-Type không phải text/html: bỏ qua hoặc xử lý riêng nếu là PDF.
- Văn bản sạch dưới 500 ký tự: đánh dấu cần xem tay.
- URL cuối khác URL ban đầu: lưu URL cuối làm nguồn trích dẫn.
Bốn kiểm tra này loại bỏ phần lớn rác trước khi vào kho vector. Rác đã vào Chroma rồi thì khó tìm và xoá hơn nhiều so với chặn từ đầu.
Chia đoạn và lưu RAG với ChromaDB và dữ liệu web
Sau khi có văn bản sạch, bước tiếp theo là cắt thành các đoạn vừa đủ ngắn để tìm kiếm chính xác. Đoạn quá dài làm vector bị loãng, đoạn quá ngắn làm mất ngữ cảnh. Với lab này, khoảng 800 tới 1.000 ký tự mỗi đoạn và chồng lấn 150 ký tự là điểm khởi đầu hợp lý.
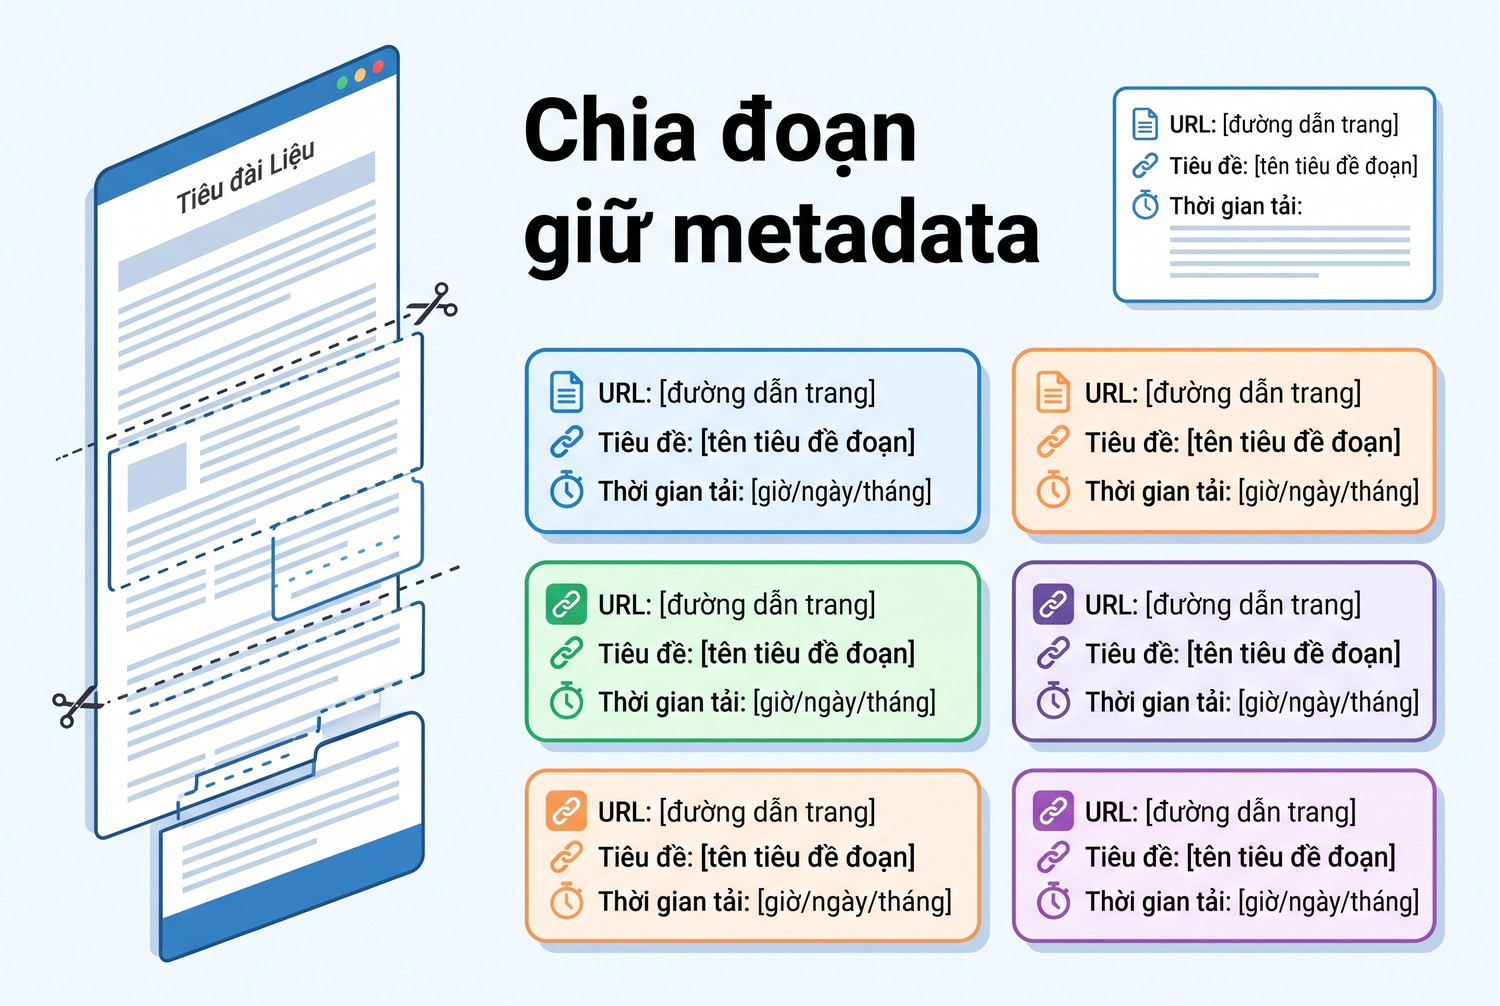
Chia đoạn giữ metadata
Code chia đoạn có chồng lấn
Hàm chunk cắt theo đoạn văn trước, rồi gộp các đoạn nhỏ tới khi gần ngưỡng. Cách này giữ ranh giới câu tự nhiên hơn so với cắt cứng theo số ký tự. Phần chồng lấn giúp câu hỏi rơi vào chỗ nối giữa hai đoạn vẫn tìm được ngữ cảnh.
def chunk(text, size=900, overlap=150):
    parts, buf = [], ""
    for para in text.split("\n"):
        if len(buf) + len(para) + 1 <= size:
            buf = (buf + "\n" + para).strip()
        else:
            if buf:
                parts.append(buf)
            tail = buf[-overlap:] if overlap and buf else ""
            buf = (tail + "\n" + para).strip()
    if buf:
        parts.append(buf)
    return parts
Hàm trả về danh sách chuỗi theo thứ tự xuất hiện. Thứ tự này quan trọng khi anh em muốn hiển thị đoạn trước và sau để người đọc kiểm tra ngữ cảnh. Vì vậy, chỉ số đoạn nên được lưu vào metadata.
Lưu vào ChromaDB kèm metadata nguồn
Mỗi đoạn được gán mã định danh tạo từ URL và chỉ số đoạn. Mã cố định giúp lần nạp sau dùng upsert để ghi đè thay vì tạo bản trùng. Metadata gồm URL, tiêu đề, chỉ số đoạn, thời điểm tải và mã băm nội dung trang.
import chromadb
from datetime import datetime, timezone

client = chromadb.PersistentClient(path=os.environ.get("CHROMA_PATH", "./chroma_lab"))
col = client.get_or_create_collection("web_docs")

def ingest(url_list):
    s = make_session()
    for url in url_list:
        page = fetch(s, url)
        if page["status"] != 200 or "html" not in page["type"]:
            print("skip", url, page["status"])
            continue
        title, text = clean(page["html"])
        if len(text) < 500:
            print("short", url, len(text))
            continue
        digest = hashlib.sha256(text.encode("utf-8")).hexdigest()[:16]
        pieces = chunk(text)
        col.upsert(
            ids=[f"{digest}-{i}" for i in range(len(pieces))],
            documents=pieces,
            metadatas=[{
                "url": page["url"],
                "title": title,
                "chunk": i,
                "sha": digest,
                "fetched": datetime.now(timezone.utc).isoformat(),
            } for i in range(len(pieces))],
        )
        print("ok", page["url"], len(pieces))
Lần chạy đầu, Chroma sẽ tải model embedding mặc định nên mất thêm thời gian. Các lần sau dùng bộ nhớ đệm và nhanh hơn. Nếu lần đầu treo lâu, quay lại phần phân biệt đường mạng để kiểm tra biến HTTPS_PROXY.
Chọn mã định danh để tránh trùng
Trong code trên, mã định danh dựa vào mã băm nội dung. Khi trang không đổi, mã giữ nguyên và upsert chỉ ghi đè. Khi trang thay đổi, mã băm mới tạo ra bản ghi mới, còn bản cũ vẫn nằm lại. Phần cập nhật dữ liệu ở cuối bài sẽ xử lý việc xoá bản cũ theo URL.
Một lựa chọn khác là dùng URL làm gốc cho mã định danh. Cách này đơn giản hơn nhưng không phát hiện được nội dung đã đổi. Lưu mã băm trong metadata là cách dung hoà: dễ truy vết và dễ quyết định khi nào cần nạp lại.
Như vậy, mỗi đoạn trong kho đều biết mình đến từ đâu, lúc nào và thuộc phiên bản nội dung nào. Đây là điều kiện để câu trả lời có trích nguồn đáng tin.
Truy vấn RAG với ChromaDB và dữ liệu web kèm trích nguồn
Nửa truy vấn nhận câu hỏi, tìm các đoạn gần nhất và ghép thành ngữ cảnh. Phần quan trọng là giữ URL nguồn đi theo từng đoạn tới tận câu trả lời cuối. Người đọc cần bấm được vào nguồn để kiểm tra, không chỉ tin vào lời mô hình.
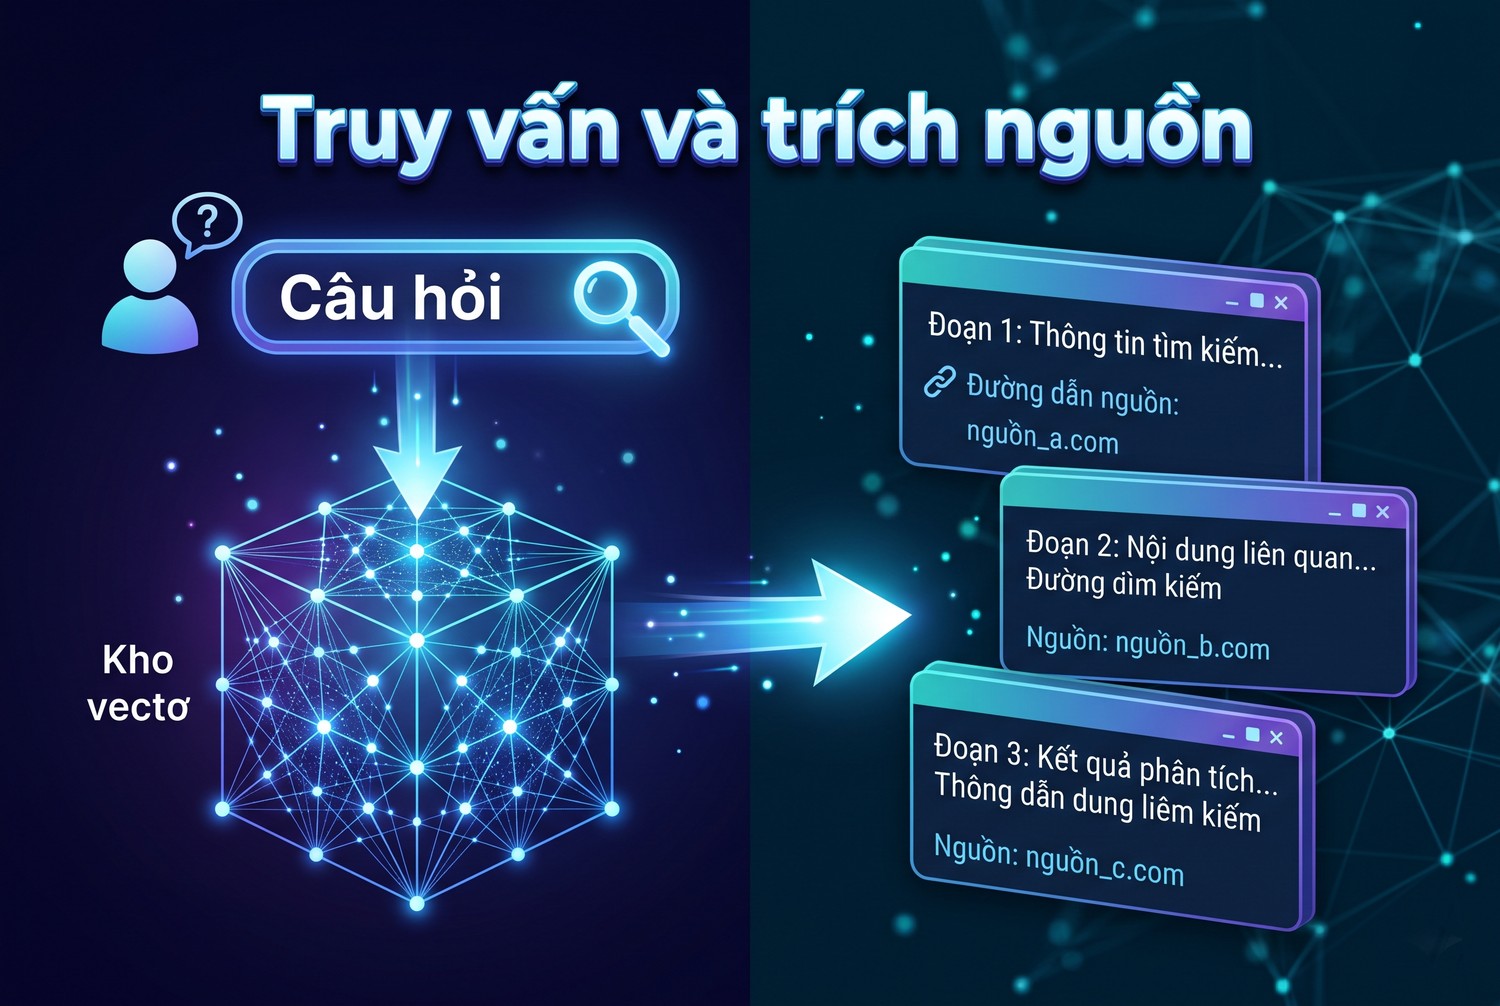
Truy vấn và trích nguồn
Code truy vấn và ghép ngữ cảnh
Hàm retrieve gọi collection.query với câu hỏi và số kết quả mong muốn. Kết quả trả về gồm đoạn văn, metadata và khoảng cách. Hàm build_prompt đánh số từng đoạn và ghi kèm URL để mô hình trích dẫn theo số.
def retrieve(question, k=4):
    res = col.query(query_texts=[question], n_results=k)
    hits = []
    for doc, meta, dist in zip(res["documents"][0], res["metadatas"][0], res["distances"][0]):
        hits.append({"text": doc, "url": meta["url"], "title": meta["title"], "dist": dist})
    return hits

def build_prompt(question, hits):
    blocks = []
    for i, h in enumerate(hits, 1):
        blocks.append(f"[{i}] {h['title']} - {h['url']}\n{h['text']}")
    context = "\n\n".join(blocks)
    return (
        "Chỉ trả lời dựa trên các đoạn dưới đây. "
        "Ghi số nguồn trong ngoặc vuông sau mỗi ý. "
        "Nếu không đủ thông tin, nói rõ là không tìm thấy.\n\n"
        f"{context}\n\nCâu hỏi: {question}"
    )
Prompt yêu cầu mô hình chỉ dựa vào các đoạn đã cấp và nói rõ khi thiếu thông tin. Câu dặn này giảm hiện tượng mô hình tự bịa. Anh em có thể đưa chuỗi prompt vào bất kỳ API mô hình nào đang dùng.
Đọc khoảng cách để lọc kết quả yếu
Giá trị distance cho biết đoạn văn gần câu hỏi tới mức nào. Giá trị càng nhỏ càng gần nghĩa. Anh em nên chạy vài câu hỏi đã biết đáp án, ghi lại khoảng cách của kết quả đúng và kết quả sai, rồi chọn một ngưỡng loại bỏ.
Ngưỡng phụ thuộc model embedding và ngôn ngữ, nên không có con số chung. Model mặc định của Chroma được huấn luyện chủ yếu trên tiếng Anh. Với nội dung tiếng Việt, anh em nên thử thêm model đa ngôn ngữ và so kết quả trên cùng bộ câu hỏi.
Hiển thị nguồn cho người đọc
Câu trả lời cuối nên kèm danh sách nguồn đã dùng, mỗi nguồn gồm tiêu đề và URL. Nếu mô hình trích [2] mà danh sách chỉ có ba nguồn, người đọc bấm được ngay vào nguồn số hai. Khi mô hình trích số không tồn tại, đó là dấu hiệu cần kiểm tra lại prompt.
Câu trả lời RAG chỉ đáng tin khi người đọc lần ngược được từ từng ý về đúng đoạn văn và đúng URL đã tải.
Phần trích nguồn biến hệ thống từ hộp đen thành công cụ có thể kiểm tra. Đó là giá trị lớn nhất của RAG với ChromaDB và dữ liệu web so với hỏi trực tiếp mô hình.
Xử lý lỗi khi chạy RAG với ChromaDB và dữ liệu web
Lỗi trong lab RAG thường rơi vào ba nhóm: lỗi mạng khi tải trang, lỗi dữ liệu khi làm sạch và lỗi chất lượng khi truy vấn. Mỗi nhóm có dấu hiệu riêng. Phân loại đúng giúp anh em sửa đúng chỗ, không thay proxy khi vấn đề nằm ở selector.
Lỗi mạng và mã trạng thái
Lỗi ProxyError hoặc ConnectTimeout cho thấy request chưa tới được website. Anh em kiểm tra lại địa chỉ, cổng, giao thức và thông tin đăng nhập proxy. Bài requests.exceptions.ProxyError trên blog ProxyVN đi sâu vào từng nguyên nhân của lỗi này.
Mã 403 hoặc 429 nghĩa là request đã tới website nhưng bị từ chối hoặc bị giới hạn. Tài liệu MDN về mã 429 mô tả header Retry-After mà máy chủ có thể gửi kèm. Khi thấy header này, hãy đợi đúng thời gian được yêu cầu rồi mới thử lại.
- ConnectTimeout: kiểm tra proxy còn hoạt động và cổng đúng.
- ProxyError 407: sai hoặc thiếu thông tin xác thực.
- 403: xem lại điều khoản website và header gửi đi.
- 429: giảm tốc độ, tăng delay, đọc Retry-After.
- SSLError: kiểm tra proxy có hỗ trợ CONNECT cho HTTPS.
Lỗi dữ liệu sau khi làm sạch
Dấu hiệu rõ nhất là nhiều đoạn trong kho giống hệt nhau, ví dụ cùng một câu thông báo cookie. Anh em có thể truy vấn Chroma bằng câu "cookie" hoặc "đăng nhập" để tìm các đoạn rác. Sau đó bổ sung selector loại bỏ vào hàm clean và nạp lại.
Trang dựa vào JavaScript để hiển thị nội dung sẽ cho văn bản sạch rất ngắn. Requests không chạy JavaScript nên chỉ nhận khung HTML trống. Với các trang này, anh em cần trình duyệt tự động như Playwright, xem thêm hướng dẫn proxy cho Playwright để gắn cùng cấu hình mạng.
Lỗi chất lượng khi truy vấn
Khi câu trả lời lạc đề dù tài liệu có chứa đáp án, nguyên nhân thường là đoạn quá dài hoặc model embedding không hợp ngôn ngữ. Anh em thử giảm kích thước đoạn, tăng số kết quả k, hoặc đổi model. Mỗi lần chỉ đổi một yếu tố và chạy lại cùng bộ câu hỏi để so sánh.
Một nguyên nhân khác là tài liệu cũ và mới cùng nằm trong kho. Mô hình nhận cả hai phiên bản và trả lời mâu thuẫn. Phần tiếp theo trình bày cách cập nhật để tránh tình trạng này.
Nhìn chung, ghi log rõ ràng ở từng khâu là cách nhanh nhất để xử lý lỗi. Không có log, mọi lỗi đều trông giống nhau.
Cập nhật kho RAG với ChromaDB và dữ liệu web theo lịch
Dữ liệu web thay đổi liên tục, nên kho vector cần được làm mới định kỳ. Mục tiêu là thay nội dung cũ bằng nội dung mới mà không để lại bản trùng. Cách làm dựa vào mã băm và URL đã lưu trong metadata.
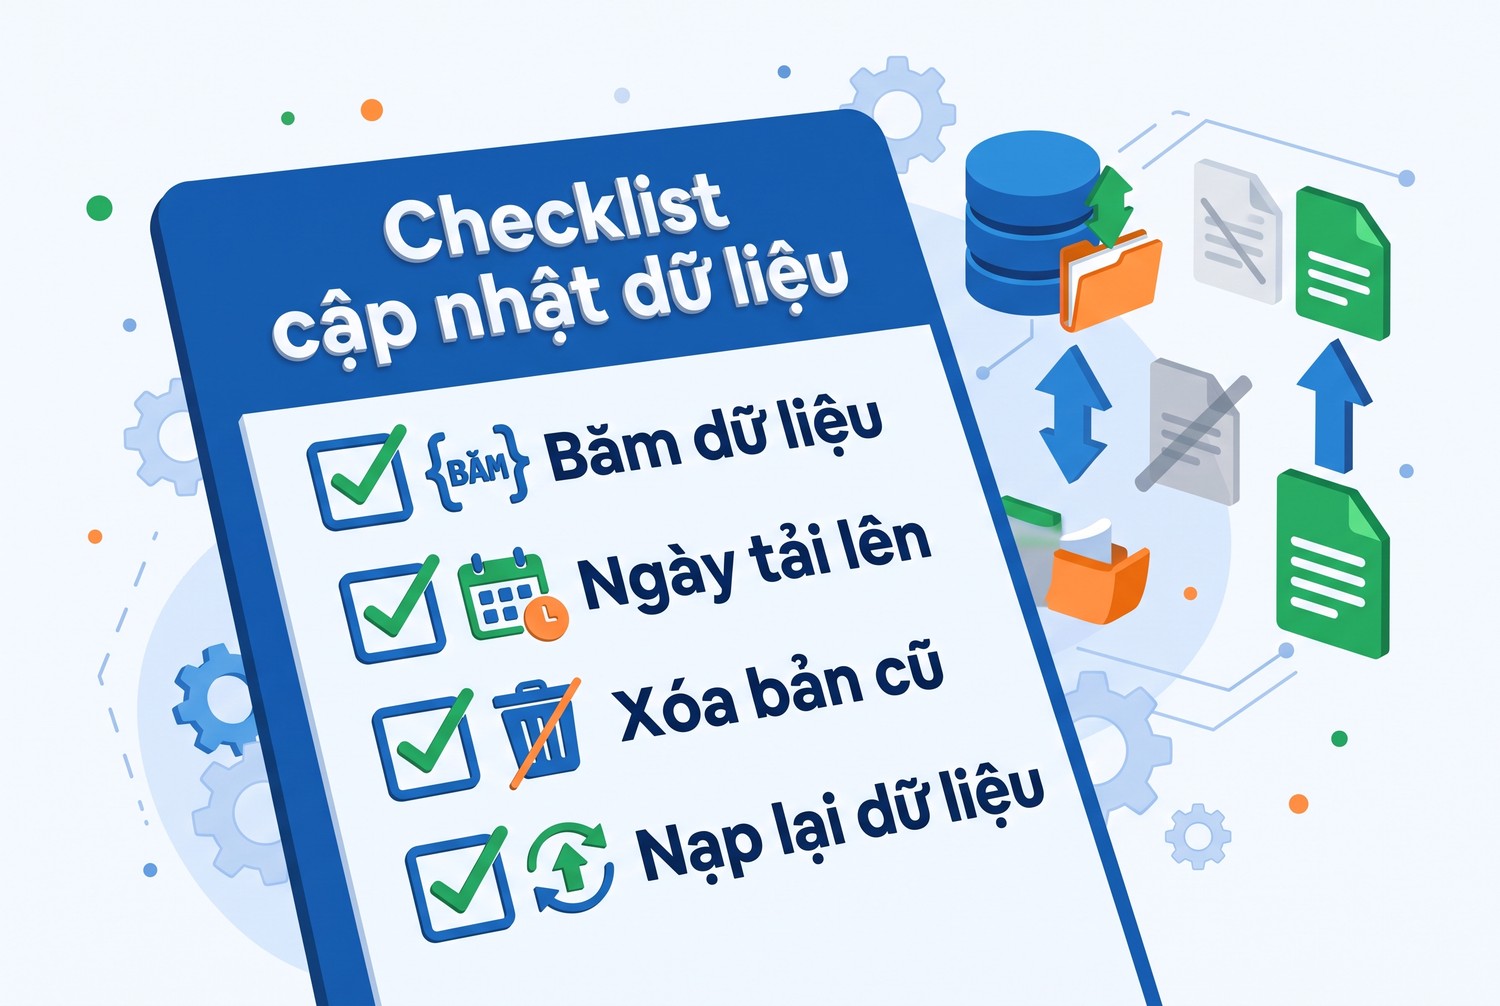
Checklist cập nhật dữ liệu
Phát hiện trang đã thay đổi
Khi chạy lại, anh em tải trang, làm sạch, tính mã băm rồi so với mã băm đang lưu cho URL đó. Nếu trùng, bỏ qua để tiết kiệm thời gian tạo vector. Nếu khác, xoá toàn bộ đoạn cũ của URL rồi nạp đoạn mới.
def refresh(url):
    s = make_session()
    page = fetch(s, url)
    if page["status"] != 200:
        return "skip"
    title, text = clean(page["html"])
    digest = hashlib.sha256(text.encode("utf-8")).hexdigest()[:16]
    old = col.get(where={"url": page["url"]}, include=["metadatas"])
    if old["metadatas"] and old["metadatas"][0].get("sha") == digest:
        return "same"
    if old["ids"]:
        col.delete(ids=old["ids"])
    ingest([url])
    return "updated"
Hàm refresh trả về một trong ba trạng thái để anh em ghi báo cáo sau mỗi lượt. Lưu ý lệnh ingest bên trong tải trang thêm một lần nữa; với lab nhỏ thì chấp nhận được. Khi lên quy mô lớn, nên tách hàm để dùng lại nội dung đã tải.
Lên lịch và giới hạn tải
Tần suất cập nhật nên dựa vào tốc độ thay đổi của nguồn. Trang tài liệu kỹ thuật thường đổi theo phiên bản, mỗi tuần kiểm tra một lần là đủ. Trang tin tức đổi hằng ngày nhưng nội dung cũ ít khi bị sửa, nên chỉ cần nạp bài mới.
Dù chạy theo lịch, vẫn giữ khoảng nghỉ giữa các request và giới hạn số trang mỗi lượt. Nếu cần nạp nhiều nguồn cùng lúc, bài proxy pool là gì trình bày cách chia proxy theo nhóm tác vụ để dễ theo dõi.
Checklist trước khi chạy thật
Trước khi chuyển lab thành dịch vụ chạy định kỳ, anh em rà lại danh sách dưới đây. Mỗi mục đều liên quan tới một lỗi đã gặp trong các phần trên.
- Đã đọc điều khoản và robots.txt của từng nguồn.
- Proxy chỉ gắn cho đường tải trang, model embedding đã có trong cache.
- Mỗi đoạn có URL, tiêu đề, chỉ số đoạn, thời điểm tải và mã băm.
- Có ngưỡng độ dài văn bản sạch để chặn trang lỗi.
- Có ngưỡng khoảng cách để lọc kết quả truy vấn yếu.
- Có hàm cập nhật xoá đoạn cũ theo URL trước khi nạp mới.
- Log ghi trạng thái từng URL, đã che thông tin đăng nhập proxy.
Khi cần mua proxy cho đường tải trang, anh em có thể xem các gói dân cư tĩnh hoặc datacenter đang hiển thị trên trang chủ ProxyVN, rồi thử với vài URL trong danh sách trước khi chạy cả lô. Lựa chọn gói nên dựa vào kết quả thử thật và tốc độ thay đổi của nguồn.
Mở rộng RAG với ChromaDB và dữ liệu web khi số nguồn tăng
Lab vài trang chạy tốt chưa có nghĩa hệ thống sẽ ổn khi có hàng nghìn trang. Khi số nguồn tăng, ba vấn đề xuất hiện: thời gian tạo vector, dung lượng lưu trữ và độ nhiễu của kết quả. Mỗi vấn đề có hướng xử lý riêng, không cần thay toàn bộ kiến trúc.
Tách collection theo nhóm nguồn
Thay vì dồn mọi trang vào một collection, anh em có thể tách theo chủ đề hoặc theo website. Khi người dùng hỏi về một sản phẩm, hệ thống chỉ tìm trong collection liên quan. Cách này giảm nhiễu và giúp xoá hoặc làm mới một nhóm nguồn mà không ảnh hưởng nhóm khác.
Nếu không muốn tách collection, có thể dùng bộ lọc where trên metadata. Ví dụ chỉ tìm trong các đoạn có trường site bằng một giá trị cụ thể. Bộ lọc metadata của Chroma hỗ trợ so sánh bằng và các toán tử cơ bản, đủ cho phần lớn nhu cầu lọc nguồn.
Chuyển sang chế độ máy chủ
Chế độ PersistentClient phù hợp một tiến trình. Khi nhiều dịch vụ cùng đọc ghi, anh em nên chạy Chroma dưới dạng máy chủ và kết nối qua HttpClient. Lúc này, truy vấn đi qua mạng nội bộ; nếu máy chủ Chroma nằm ở mạng khác, cần xét tới cấu hình mạng và xác thực riêng cho kết nối này.
Kết nối từ ứng dụng tới máy chủ Chroma không nên đi qua proxy thu thập dữ liệu. Đây là lưu lượng nội bộ, cần độ trễ thấp và ổn định. Trộn hai loại lưu lượng chỉ làm việc theo dõi khó hơn.
Đánh giá định kỳ bằng bộ câu hỏi cố định
Khi hệ thống lớn dần, anh em nên giữ một bộ khoảng hai mươi câu hỏi đã biết đáp án và nguồn đúng. Sau mỗi lần thay đổi lớn như đổi model, đổi kích thước đoạn hay thêm nhóm nguồn, chạy lại bộ câu hỏi và so tỷ lệ trả đúng nguồn. Con số này cho biết thay đổi có cải thiện thật hay không.
Ghi kết quả đánh giá vào một bảng đơn giản gồm ngày chạy, cấu hình và tỷ lệ đúng. Sau vài lần, anh em sẽ thấy cấu hình nào phù hợp với dữ liệu của mình. Đây là kinh nghiệm riêng mà không tài liệu chung nào cung cấp được.
Tóm lại, mở rộng RAG với ChromaDB và dữ liệu web là chuyện tổ chức dữ liệu và đo lường, không chỉ là tăng phần cứng. Giữ metadata đầy đủ từ đầu giúp mọi bước mở rộng sau dễ hơn.
Câu hỏi thường gặp về RAG với ChromaDB và dữ liệu web
Phần này gom một số thắc mắc hay gặp khi anh em bắt đầu dựng lab. Câu trả lời ngắn gọn, chi tiết đã nằm trong các phần trên.
Có bắt buộc dùng proxy khi tải trang không
Không bắt buộc. Với vài trang và tốc độ chậm, kết nối trực tiếp thường đủ. Proxy hữu ích khi cần tách IP khỏi máy làm việc, phân tải trên nhiều nguồn hoặc kiểm tra nội dung theo khu vực. Dùng proxy không thay cho việc tuân thủ điều khoản và giới hạn tốc độ của website.
Nội dung tiếng Việt có dùng được model mặc định không
Dùng được ở mức thử nghiệm, nhưng kết quả thường kém hơn model đa ngôn ngữ. Anh em nên chạy cùng bộ câu hỏi trên hai model và so tỷ lệ trả đúng nguồn. Khi đổi model, cần tạo collection mới vì vector của hai model không so sánh được với nhau.
Bao lâu nên làm mới dữ liệu
Tuỳ tốc độ thay đổi của nguồn. Tài liệu kỹ thuật có thể kiểm tra hằng tuần, trang giá hoặc tin tức cần thường xuyên hơn. Nhờ mã băm, lượt kiểm tra trang không đổi tốn rất ít thời gian, nên chạy dày hơn cũng không gây lãng phí lớn.
RAG với ChromaDB và dữ liệu web cho câu trả lời có nguồn rõ ràng khi khâu tải, làm sạch và lưu metadata được làm cẩn thận. Hãy thử vài trang đã biết nội dung trước khi mở rộng. Cần tư vấn kết nối, anh em nhắn Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam trước khi triển khai RAG với ChromaDB và dữ liệu web.


