
Trích bảng PDF bằng Camelot: lattice, stream và đối chiếu ô
Trích bảng PDF bằng Camelot là cách lấy bảng số liệu từ tệp PDF có lớp chữ thật thành DataFrame hay CSV, giữ đúng hàng và cột. Anh em không phải chép tay hay dán từ trình đọc PDF rồi sửa từng ô. Camelot chỉ làm việc với PDF có lớp chữ, không đọc được ảnh scan. ProxyVN chạy thử ngày 29/10/2026 với Camelot 2.0.0 trên năm tệp PDF có đáp án biết trước. Bảng kẻ ô trích đúng 30 trên 30 ô, bản scan trả về 0 bảng kèm cảnh báo, còn bảng không kẻ có ô xuống dòng bị tách thành hàng thừa.
Trích bảng PDF bằng Camelot: mục tiêu dữ liệu, quyền và phạm vi truy cập
Phần đầu chốt mình trích gì, đầu vào phải thỏa điều kiện nào, và ranh giới với các công cụ xử lý PDF khác.
Bài toán cụ thể
Báo cáo thống kê, bảng giá, phụ lục hợp đồng, kết quả thi thường được công bố dạng PDF. Người cần số liệu phải chuyển bảng trong PDF sang dạng máy đọc được. Chép tay thì chậm và dễ sai. Bôi đen rồi dán thì cột lệch, số dính vào nhau.
Camelot giải quyết đúng bài toán đó: tìm bảng trên trang, xác định ranh giới hàng cột, gán từng mẩu chữ vào ô. Đầu ra là đối tượng có DataFrame của pandas, xuất được CSV, Excel, JSON hay HTML.
Đầu ra mà bài này hướng tới
Đầu ra là tệp CSV cho mỗi bảng, kèm bảng đối chiếu với đáp án. Bảng đối chiếu ghi số hàng, số cột, số ô khớp trên tổng số ô, hàng tiêu đề nằm ở đâu và điểm chất lượng mà Camelot tự báo.
Đáp án là thứ quyết định bài có giá trị hay không. Nhiều hướng dẫn chỉ in DataFrame ra rồi bảo trông đúng. Bài này so từng ô với giá trị đã biết trước.
PDF có lớp chữ và PDF ảnh
PDF xuất từ Word, Excel hay phần mềm báo cáo có lớp chữ thật: mỗi ký tự có mã và tọa độ. PDF chụp từ máy scan chỉ là ảnh, không có ký tự nào. Mắt người nhìn hai loại giống nhau, nhưng máy đọc thì khác hẳn.
Camelot chỉ làm việc với loại thứ nhất. Với loại thứ hai, cần OCR trước để tạo lớp chữ, và chất lượng OCR quyết định chất lượng bảng. Lab có một tệp scan để kiểm điều này.
Dữ liệu lab là dữ liệu giả lập
Lab không tải PDF của bên thứ ba. Lab tự tạo PDF bằng reportlab 5.1.0 với font Arial có dấu tiếng Việt. Bảng có 6 hàng, 5 cột: gói, quốc gia, số luồng, giá tháng, băng thông. Số liệu là giả lập, không phải bảng giá thật của bất kỳ nhà cung cấp nào.
Vì tự tạo nên lab biết chính xác từng ô phải chứa gì. Đáp án được ghi vào tệp ground_truth.json trước khi chạy Camelot.
Quyền với PDF nguồn
Khi áp vào PDF thật, quyền với nội dung vẫn thuộc người công bố. Báo cáo công khai của cơ quan nhà nước thường cho phép dùng lại với ghi nguồn. Tài liệu nội bộ hay có bản quyền thì không. Trích bảng không đổi quyền sở hữu số liệu.
Một số PDF có cờ hạn chế sao chép. Bài không hướng dẫn gỡ các hạn chế đó. Nếu PDF bị khóa, xin bản dữ liệu gốc từ người công bố.
Ranh giới với trích văn bản PDF
Bài trích văn bản PDF sau web crawl bàn việc lấy chữ theo trang và theo tọa độ. Đầu ra là văn bản. Bài này lấy bảng: đầu ra là lưới ô có hàng cột.
Hai việc dùng chung một lớp chữ trong PDF, nhưng bài toán khác nhau. Trích văn bản không cần biết ô nào thuộc cột nào. Trích bảng thì đó là toàn bộ vấn đề.
Ai cần trích bảng PDF
Nhà phân tích cần số liệu từ báo cáo quý công bố dạng PDF. Nhóm dữ liệu cần gom bảng từ hàng trăm PDF thông báo. Người làm kế toán cần chuyển bảng kê từ đối tác sang Excel.
Cả ba đều cần đúng từng ô. Một số sai vị trí trong bảng giá hay bảng số liệu có thể dẫn tới kết luận sai, nên đối chiếu là bước không được bỏ.
Trích bảng PDF bằng Camelot với điều kiện đầu vào được xác minh: PDF text, ảnh scan và OCR
Phần này giải thích hai chế độ của Camelot và kết quả trên từng loại PDF.
Hai chế độ lattice và stream
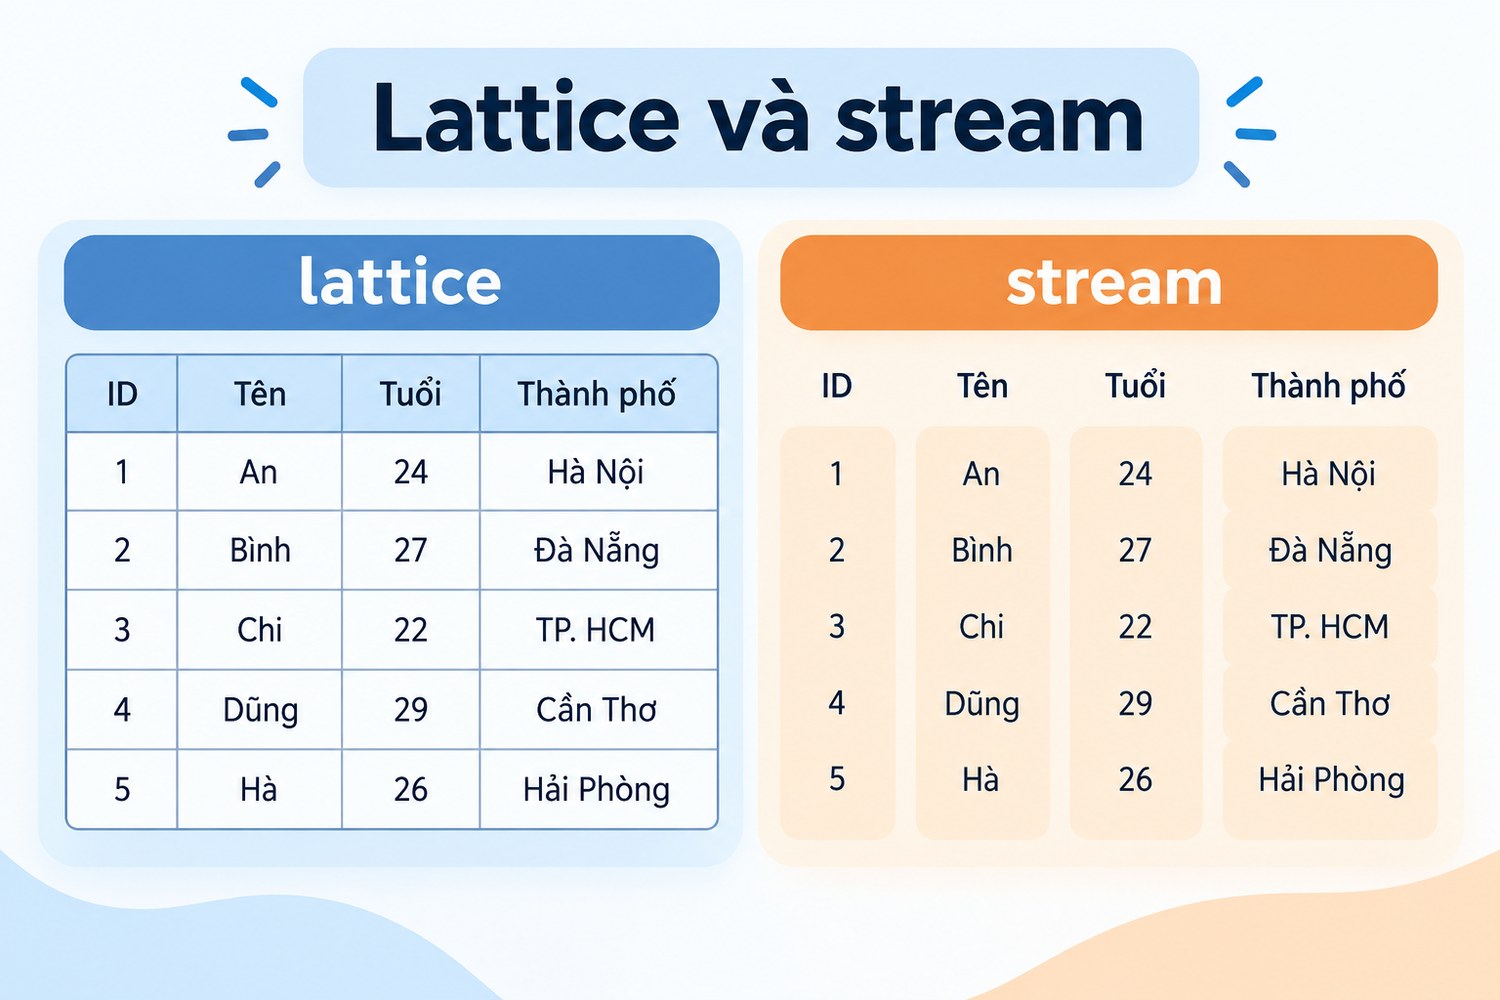
Lattice và stream
Camelot có hai chế độ chính. Lattice dành cho bảng có đường kẻ ô: Camelot chuyển trang thành ảnh, dùng OpenCV tìm đường kẻ ngang dọc, từ đó dựng lưới ô. Stream dành cho bảng không kẻ: Camelot nhìn khoảng trắng giữa các mẩu chữ để đoán ranh giới cột.
Chọn chế độ đúng là quyết định quan trọng nhất. Lattice trên bảng không kẻ sẽ không tìm thấy gì. Stream trên bảng có kẻ thường vẫn chạy nhưng dễ gom thêm chữ ngoài bảng.
Gọi Camelot
import camelot
ts = camelot.read_pdf("lattice.pdf", flavor="lattice", pages="1")
print(ts.n)
t = ts[0]
print(t.parsing_report)
df = t.df
ts.export("lattice_out.csv", f="csv")
read_pdf trả danh sách bảng tìm được. Mỗi bảng có df là DataFrame, parsing_report chứa độ chính xác, tỷ lệ khoảng trắng, thứ tự bảng và số trang. export ghi mỗi bảng thành một tệp, tên có số trang và số thứ tự bảng.
Ba tệp PDF chính trong lab
Tệp lattice.pdf có bảng kẻ lưới đầy đủ. Tệp stream.pdf có cùng bảng nhưng không có đường kẻ nào. Tệp scan.pdf là ảnh chụp của lattice.pdf ở độ phân giải gấp đôi, nhúng lại vào PDF, không có lớp chữ.
Cả ba tệp đều có tiêu đề, một đoạn văn mở đầu và một ghi chú cuối nằm ngoài bảng. Đoạn mở đầu cố ý chứa số 2026 và chữ Luồng, trùng tên một cột, để thử xem Camelot có gom nhầm không.
Kết quả trên ba tệp và hai chế độ
Tệp |
Chế độ |
Số bảng |
Hàng x cột |
Hàng tiêu đề |
Ô khớp |
Accuracy |
|---|---|---|---|---|---|---|
lattice.pdf |
lattice |
1 |
6 x 5 |
0 |
30/30 |
100,0 |
lattice.pdf |
stream |
1 |
8 x 5 |
2 |
30/30 |
95,5 |
stream.pdf |
lattice |
0 |
không có |
không có |
0/30 |
không có |
stream.pdf |
stream |
1 |
8 x 5 |
2 |
30/30 |
95,5 |
scan.pdf |
lattice |
0 |
không có |
không có |
0/30 |
không có |
scan.pdf |
stream |
0 |
không có |
không có |
0/30 |
không có |
Lattice trên bảng kẻ ra đúng 6 hàng 5 cột, không thừa không thiếu. Stream trên cả hai tệp ra 8 hàng, trong đó hai hàng đầu là tiêu đề trang và đoạn mở đầu bị gom vào.
Stream gom cả chữ ngoài bảng
Hai hàng thừa của stream là tiêu đề Bảng giá thử nghiệm nằm ở cột thứ hai, và đoạn văn mở đầu nằm trọn trong cột đầu. Ghi chú cuối trang thì không bị gom. Hàng tiêu đề thật của bảng nằm ở chỉ số 2.
Stream đoán vùng bảng bằng cách nhìn các dòng chữ có cấu trúc cột giống nhau. Tiêu đề và đoạn văn nằm sát phía trên bảng, nên bị coi là phần đầu bảng. Đây là lý do không được giả định hàng đầu tiên của DataFrame là tiêu đề.
PDF scan trả về 0 bảng
Với scan.pdf, cả hai chế độ trả 0 bảng trong vài phần trăm giây và phát cảnh báo nói trang 1 là trang ảnh, Camelot chỉ làm việc với trang có chữ. Không có ngoại lệ, chỉ có cảnh báo.
Job hàng loạt phải bắt cảnh báo này hoặc kiểm số bảng bằng 0. Nếu không, tệp scan sẽ âm thầm cho kết quả rỗng và bị coi là PDF không có bảng.
Khi nào cần OCR
Khi PDF là ảnh, cần chạy OCR để tạo lớp chữ trước, ví dụ bằng công cụ thêm lớp chữ vô hình vào PDF. Sau đó Camelot có thể đọc lớp chữ đó. Lab không chạy OCR, nên bài không khẳng định Camelot sẽ trích đúng bao nhiêu ô sau OCR.
Chất lượng phụ thuộc độ nét của bản scan, font và ngôn ngữ. Tiếng Việt có dấu là thách thức riêng cho OCR. Mọi bảng đi qua OCR nên được đối chiếu tay trên mẫu trước khi tin.
Chuẩn bị đầu vào, trang và phiên bản khi trích bảng PDF bằng Camelot
Phần này gom các quyết định trước khi chạy: kiểm loại PDF, chọn trang, chọn vùng và phiên bản thư viện.
Kiểm PDF có lớp chữ trước
Trước khi gọi Camelot, kiểm trang có chữ không. Một cách nhanh là dùng pdfminer hoặc pypdfium2 trích chữ của trang. Nếu kết quả rỗng hoặc chỉ vài ký tự, trang là ảnh. Phân loại trước giúp chuyển trang scan sang nhánh OCR thay vì nhận về 0 bảng.
Camelot cũng tự kiểm và phát cảnh báo, như lab ghi nhận. Nhưng kiểm riêng cho phép ghi lý do rõ ràng vào nhật ký.
Chọn trang
Tham số pages nhận chuỗi như 1, 1,3,5 hay 2-end. Mặc định chỉ đọc trang 1. Báo cáo dài có bảng ở trang 40 sẽ không được tìm thấy nếu quên tham số này.
Đọc tất cả trang bằng pages bằng all tốn thời gian với PDF dài, vì lattice phải chuyển từng trang thành ảnh. Biết trước trang có bảng thì chỉ đọc trang đó.
Giới hạn vùng bảng
Với stream, tham số table_areas nhận tọa độ một hình chữ nhật trên trang. Camelot chỉ tìm bảng trong vùng đó. Đây là cách loại tiêu đề và đoạn văn bị gom nhầm như lab gặp.
Tọa độ tính theo điểm PDF, gốc ở góc dưới trái. Lấy tọa độ bằng cách mở PDF trong công cụ hiển thị tọa độ, hoặc dùng chức năng vẽ của Camelot để xem các mẩu chữ nằm ở đâu.
Chỉ định cột
Khi stream đoán sai ranh giới cột, tham số columns nhận danh sách tọa độ x của các đường chia cột. Đây là cách sửa khi hai cột sát nhau bị gộp hoặc một cột bị tách đôi.
Chỉ định vùng và cột biến stream từ đoán tự động thành trích theo khuôn. Với một loại báo cáo lặp lại hàng tháng cùng bố cục, khuôn cố định cho kết quả ổn định hơn đoán.
Phiên bản và môi trường
Lab dùng Python 3.12.10, camelot-py 2.0.0, opencv-python-headless 5.0.0.93, pypdfium2 5.14.0, pdfminer.six 20260107, reportlab 5.1.0, trong venv riêng. Camelot 2.0 dùng pypdfium2 làm backend chuyển trang thành ảnh cho lattice theo mặc định, không cần Ghostscript.
Các bản Camelot cũ cần Ghostscript cài riêng cho lattice. Nếu gặp lỗi liên quan Ghostscript, kiểm phiên bản Camelot trước. Khóa phiên bản trong requirements.txt.
Font và tiếng Việt
PDF lab nhúng font Arial có đủ dấu tiếng Việt. Camelot trích đúng mọi chữ có dấu như Gói, Quốc gia, Dân cư tĩnh, Không giới hạn. PDF dùng font không nhúng hoặc bảng mã cũ có thể cho chữ lỗi dù bảng đúng cấu trúc.
Khi gặp chữ lỗi, vấn đề nằm ở lớp chữ của PDF, không ở Camelot. Thử trích chữ bằng công cụ khác để xác nhận.
Thu bảng và đánh giá chất lượng khi trích bảng PDF bằng Camelot
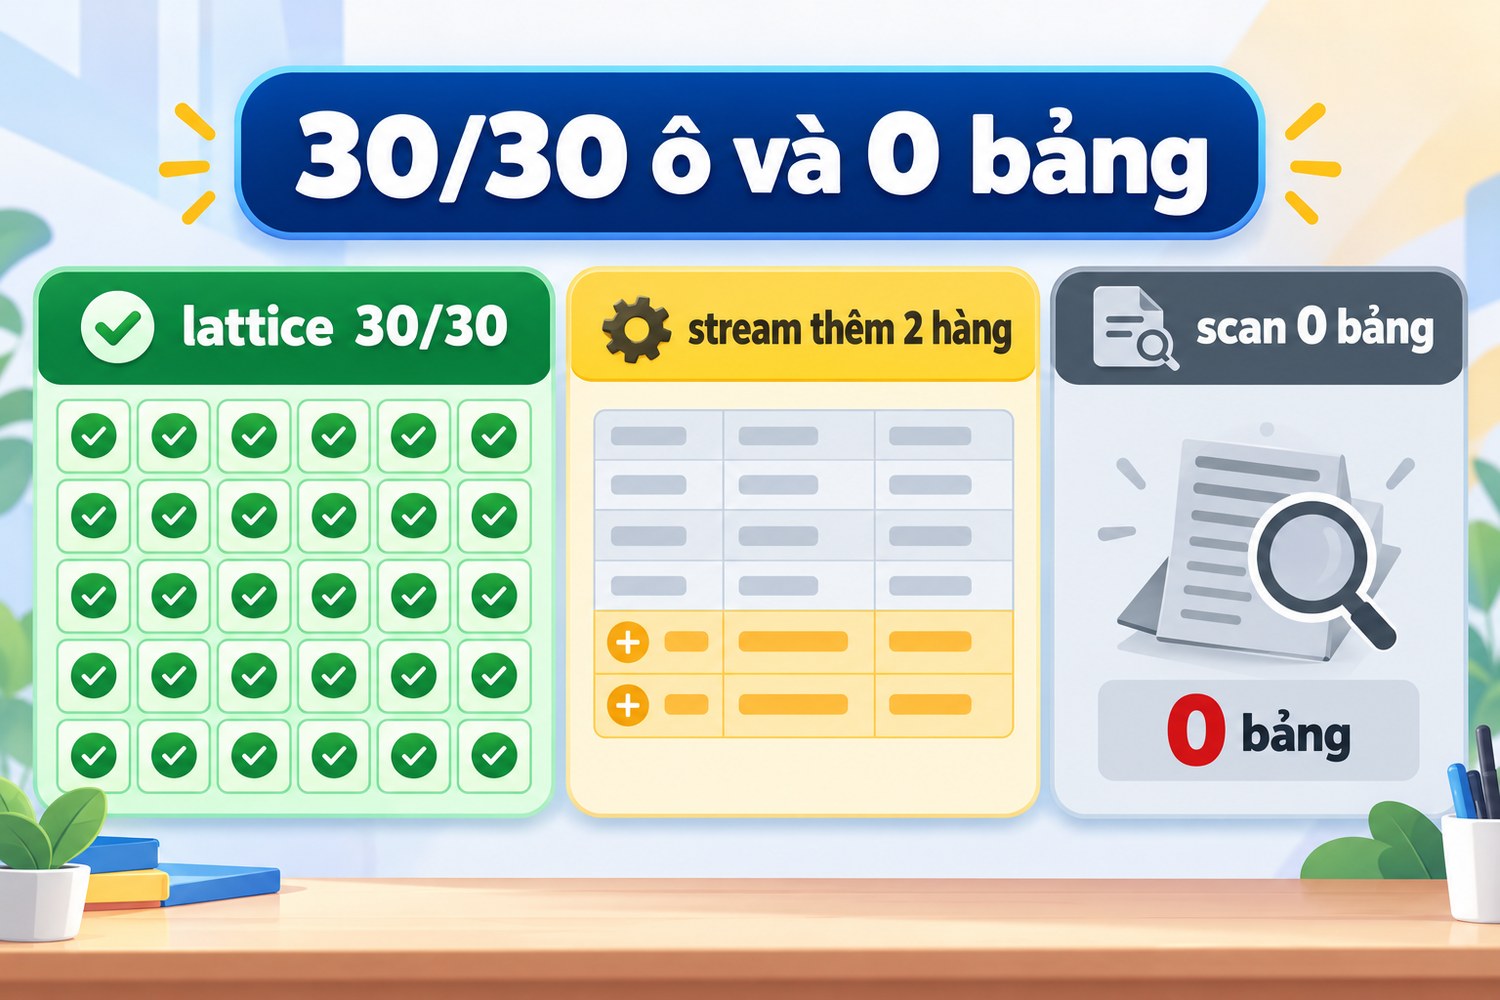
30/30 ô và 0 bảng
Phần này ghi lại các tình huống khó hơn trong lab và cách đọc báo cáo chất lượng.
Ô có chữ xuống dòng
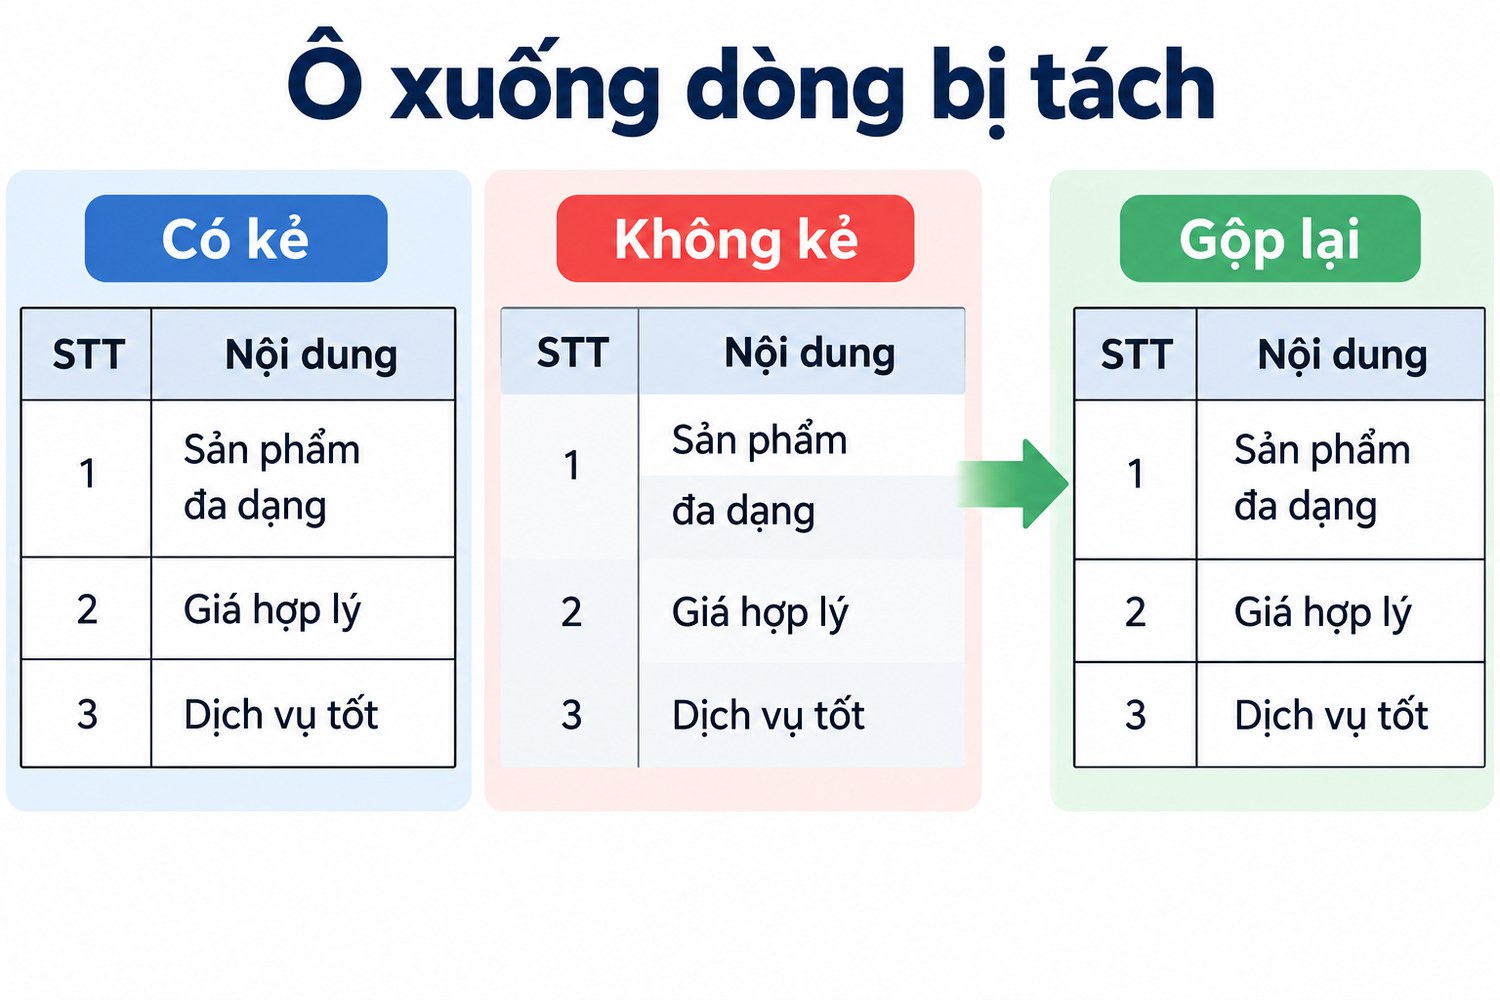
Ô xuống dòng bị tách
Lab tạo thêm hai tệp có cột Mô tả hẹp, chữ dài phải xuống dòng trong ô. Một tệp có đường kẻ, một tệp không. Bảng có 3 hàng, 3 cột.
Tệp |
Chế độ |
Hàng x cột |
Ô Mô tả hàng 2 |
|---|---|---|---|
wrap_lattice.pdf |
lattice |
3 x 3 |
IP cố định, phù hợp quản trị máy chủ và API |
wrap_stream.pdf |
stream |
5 x 3 |
IP cố định, phù hợp quản |
Lattice gộp hai dòng chữ trong cùng một ô vì đường kẻ cho biết ranh giới ô. Stream không có đường kẻ, nên mỗi dòng chữ thành một hàng. Phần trị máy chủ và API thành một hàng riêng với ô Gói và ô Giá trống.
Gộp hàng tiếp nối sau khi trích
Dấu hiệu của hàng tiếp nối là ô ở cột khóa trống trong khi cột mô tả có chữ. Duyệt DataFrame từ trên xuống, gặp hàng có cột đầu trống thì nối chữ của nó vào hàng phía trên rồi bỏ hàng đó.
Quy tắc này đúng với bảng lab, nơi cột Gói luôn có giá trị. Với bảng mà cột đầu có thể trống thật, cần quy tắc khác, ví dụ dựa vào cột số luôn có giá trị.
Đọc parsing_report
parsing_report có accuracy, whitespace, order và page. Accuracy là mức độ chữ khớp vào ô. Whitespace là tỷ lệ phần trăm ô trống. Bảng lattice sạch có accuracy 100 và whitespace 0. Bảng stream có accuracy 95,5 và whitespace 20 vì hai hàng thừa phần lớn là ô trống.
Báo cáo của Camelot 2.0 còn có trường confidence: 1,0 cho lattice và 0,76 cho stream trên cùng bảng. Lab dùng các con số này làm tín hiệu sơ bộ, không thay cho đối chiếu với đáp án.
Whitespace cao là cờ đỏ
Whitespace 20 phần trăm trong bảng mà mọi ô thật đều có giá trị nghĩa là có hàng thừa. Đặt ngưỡng: bảng có whitespace cao hơn mức bình thường của loại tài liệu đó thì chuyển sang xem tay.
Ngưỡng phụ thuộc tài liệu. Bảng thống kê có nhiều ô trống thật sẽ có whitespace cao mà vẫn đúng. Hiệu chỉnh ngưỡng trên vài tệp mẫu trước khi chạy hàng loạt.
Thời gian trích
Lattice mất khoảng 0,22 tới 0,25 giây mỗi trang vì phải chuyển trang thành ảnh. Stream mất khoảng 0,01 giây vì chỉ đọc tọa độ chữ. Với hàng nghìn trang, khác biệt này đáng kể.
Nếu biết bảng không có đường kẻ, chạy stream trực tiếp. Nếu không biết, chạy lattice trước, khi ra 0 bảng thì thử stream.
Bảng kéo dài qua nhiều trang
Báo cáo dài hay có bảng bắt đầu ở trang này và tiếp tục ở trang sau, lặp lại hàng tiêu đề hoặc không. Camelot trả mỗi trang một bảng riêng. Ghép chúng là việc của code phía sau.
Quy tắc ghép đơn giản: hai bảng ở hai trang liền nhau, cùng số cột, bảng sau không có hàng tiêu đề hoặc có hàng tiêu đề giống hệt bảng trước, thì nối lại và bỏ hàng tiêu đề lặp. Lab không có bảng nhiều trang nên quy tắc này chưa được kiểm thật.
Một trang nhiều bảng
Khi trang có nhiều bảng, ts.n lớn hơn 1, mỗi bảng có order riêng. Xuất từng bảng thành tệp riêng, tên ghi số trang và số thứ tự như Camelot làm mặc định với export. Lab chỉ có một bảng mỗi trang.
Đối soát giá trị ô, kiểu dữ liệu, giá trị thiếu và xuất xứ khi trích bảng PDF bằng Camelot
Có DataFrame rồi, việc tiếp theo là kiểm từng ô và chuyển kiểu.
Đối chiếu với đáp án
Hàm chấm điểm trong lab tìm hàng có ô đầu là Gói, coi đó là tiêu đề, rồi so từng ô của 6 hàng tiếp theo với đáp án sau khi chuẩn hóa khoảng trắng. Kết quả 30 trên 30 ô khớp cho cả lattice lẫn stream, sau khi bỏ hai hàng thừa của stream.
Với PDF thật không có đáp án sẵn, chọn ngẫu nhiên vài bảng, chép tay một số ô làm đáp án, rồi chấm. Một mẫu nhỏ có đáp án đáng tin hơn nhiều so với nhìn qua cả nghìn bảng.
Mọi ô là chuỗi
DataFrame của Camelot chứa toàn chuỗi. Số 150.000 là chuỗi 150.000. Chuyển kiểu là việc của bước sau, có quy tắc riêng cho từng cột.
Số kiểu Việt Nam
Bảng lab ghi giá theo kiểu Việt Nam với dấu chấm ngăn cách hàng nghìn: 1.200.000. Gọi float trực tiếp trên chuỗi này ném ValueError. Bỏ dấu chấm rồi chuyển sang số nguyên cho 1200000.
Cẩn thận với cột có số thập phân. Kiểu Việt Nam dùng dấu phẩy cho phần thập phân, kiểu Anh dùng dấu chấm. Xác định kiểu của từng tài liệu trước khi viết quy tắc chuyển đổi, đừng đoán theo từng ô.
Đơn vị nằm trong chữ
Cột Băng thông có giá trị Không giới hạn, 100 GB, 50 GB. Đây là cột lẫn chữ và số kèm đơn vị. Tách thành hai cột: một cột số tính theo GB, một cột cờ không giới hạn. Giữ cột gốc để tra lại.
Kiểm bằng tổng và ràng buộc
Ngoài đối chiếu ô, kiểm các ràng buộc mà bảng phải thỏa. Bảng có hàng tổng cộng thì cộng các hàng con phải ra đúng hàng tổng. Cột phần trăm thì mỗi hàng nằm trong khoảng 0 tới 100. Cột ngày thì không có ngày trong tương lai.
Ràng buộc bắt được loại lỗi mà đối chiếu mẫu bỏ sót: một số bị đọc nhầm 8 thành 3 ở bảng không nằm trong mẫu. Với bảng lab, cột Luồng phải là số nguyên dương và cột Giá phải chuyển được sang số, cả năm hàng đều thỏa.
Số hàng kỳ vọng
Nếu biết bảng có bao nhiêu hàng, ví dụ báo cáo luôn liệt kê 63 tỉnh thành, kiểm số hàng sau khi chuẩn hóa. Thiếu hàng thường do bảng bị chia sang trang sau. Thừa hàng thường do hàng tiếp nối chưa gộp hoặc chữ ngoài bảng bị gom.
Ô trống thật và ô trống do lỗi
Ô trống trong bảng tiếp nối của stream là ô trống do lỗi trích. Ô trống trong bảng thống kê có thể là trống thật, nghĩa là không có số liệu. Phân biệt hai loại bằng cách đối chiếu với PDF gốc trên mẫu.
Giữ xuất xứ cho từng bảng
Ghi tên tệp PDF, số trang, số thứ tự bảng, chế độ đã dùng, vùng và cột nếu có chỉ định, parsing_report và phiên bản Camelot vào một tệp JSON đi kèm CSV. Nếu PDF tải từ web, ghi thêm URL và thời điểm tải.
Bài JSON và CSV khi crawl dữ liệu bàn cách tổ chức tệp đi kèm như vậy.
Lưu kết quả, giới hạn request và khi nào trích bảng PDF bằng Camelot cần proxy
Phần cuối bàn chuyện lưu trữ, tải PDF và vị trí đúng của proxy.
Lưu CSV và bản chuẩn hóa
Lưu hai tầng: CSV thô đúng như Camelot xuất, và CSV đã chuẩn hóa với hàng thừa bị bỏ, hàng tiếp nối được gộp, số đã chuyển kiểu. Khi phát hiện lỗi trong quy tắc chuẩn hóa, chạy lại từ CSV thô mà không cần trích lại PDF.
Lab xuất tệp lattice_out-page-1-table-1.csv đúng 6 hàng 5 cột, mã UTF-8, chữ có dấu đúng.
Quy trình hàng loạt gợi ý
Một quy trình gọn cho hàng trăm PDF gồm năm bước. Tải và lưu PDF gốc. Phân loại trang có chữ hay trang ảnh. Chạy lattice, nếu ra 0 bảng thì chạy stream. Chuẩn hóa bảng và chấm điểm theo whitespace cùng ràng buộc. Đưa bảng điểm thấp vào hàng đợi xem tay.
Mỗi bước ghi kết quả ra đĩa trước khi sang bước sau. Khi một bước lỗi, chạy lại từ bước đó, không phải từ đầu.
Tải PDF tôn trọng nguồn
PDF thường nặng hơn trang HTML. Khi tải hàng loạt từ cổng thông tin, nghỉ giữa các request, đặt User-Agent rõ ràng, dùng If-Modified-Since để không tải lại tệp chưa đổi. Bài rate limit API khi dùng proxy có mẫu bộ đếm request.
Camelot làm việc offline
read_pdf nhận đường dẫn tệp cục bộ, cũng nhận URL http. Khi nhận URL, Camelot tự tải tệp về thư mục tạm. Lab chỉ dùng tệp cục bộ và khuyên tách bước tải ra code riêng.
Tách tải cho phép kiểm Content-Type là application/pdf, kiểm kích thước, lưu tệp gốc và cấu hình proxy rõ ràng. Bước trích bảng sau đó chạy offline trên tệp đã lưu.
Proxy nằm ở bước tải
Bước trích bảng không có lưu lượng mạng, không cần proxy. Proxy chỉ có vai trò khi tải PDF từ nguồn ngoài. Lab không tải PDF nào qua mạng, nên không có số đo proxy riêng cho bài này.
Ở các bài khác cùng cụm, lab đã ghi nhận requests qua proxy HTTP chỉ để lộ lệnh CONNECT tới tên máy và cổng 443 với nguồn https. Cách cấu hình proxy cho bước tải PDF giống hệt cách cấu hình cho request thường.
Khi nào cần proxy thật
Proxy cần khi máy tải PDF nằm trong mạng nội bộ chỉ được ra Internet qua proxy. Trường hợp thứ hai là tổ chức yêu cầu lưu lượng ra ngoài đi qua một IP cố định để giám sát, hay để cổng thông tin nguồn đưa IP đó vào danh sách cho phép. Cấu hình và mã hóa mật khẩu có ký tự đặc biệt có trong bài định dạng proxy.
Bài Web Scraping proxy là gì phân biệt các vai trò của proxy. Với Camelot, proxy không làm bảng trích đúng hơn hay sai hơn.
Khi máy chủ của nhóm đặt tại Việt Nam và cần IP thoát ổn định cho job tải tài liệu, proxy tĩnh dễ quản lý hơn proxy xoay. ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay qua HTTP hoặc SOCKS5. Anh em có thể mua proxy Việt Nam tại trang chủ ProxyVN rồi khai báo vào code tải PDF.
Giới hạn suy luận của bài
Số liệu đến từ năm tệp PDF tự tạo bằng reportlab ngày 29/10/2026, bảng đơn giản, font chuẩn. PDF thật có bảng lồng, ô gộp, nhiều trang, font lạ sẽ khó hơn nhiều. Kết quả 30 trên 30 ô không bảo đảm cho tài liệu khác.
Lab không chạy OCR, nên không có số liệu về bảng trong PDF scan sau OCR. Lab không thử table_areas và columns trên PDF thật, không tải PDF qua mạng và không thử proxy.
Checklist trích bảng PDF bằng Camelot
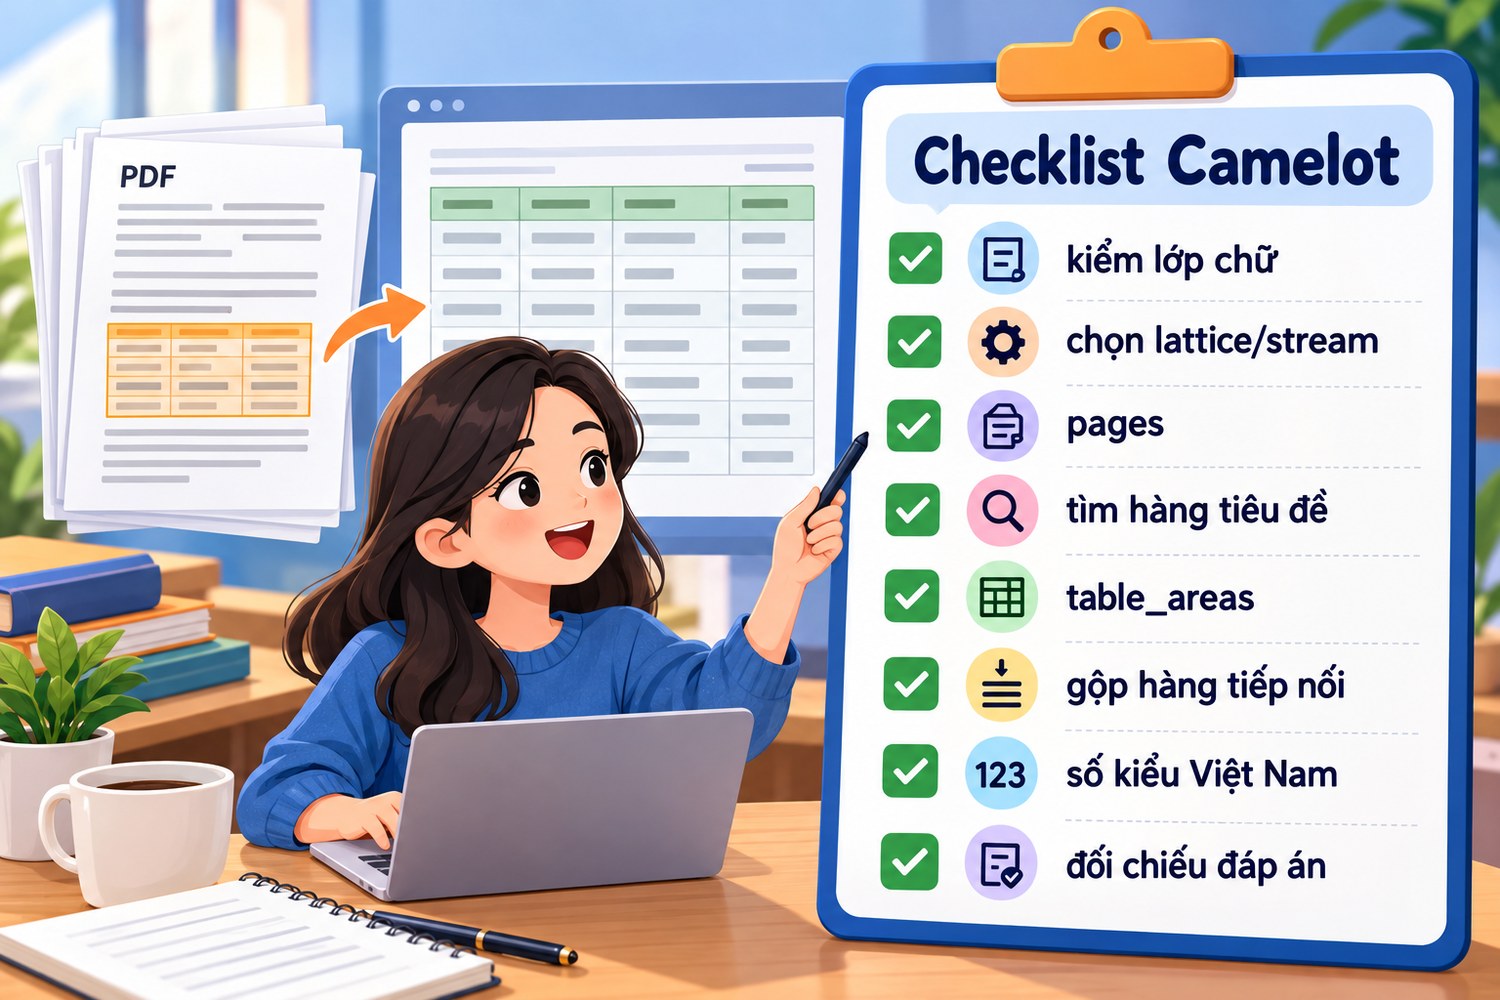
Checklist Camelot
- Kiểm trang có lớp chữ trước khi gọi Camelot.
- Bảng có kẻ dùng lattice, không kẻ dùng stream.
- Đặt pages đúng trang có bảng.
- Không giả định hàng đầu là tiêu đề, tìm hàng tiêu đề thật.
- Dùng table_areas để loại chữ ngoài bảng.
- Gộp hàng tiếp nối khi ô xuống dòng.
- Chuyển số kiểu Việt Nam có chủ ý.
- Đối chiếu với đáp án chép tay trên mẫu.
Câu hỏi thường gặp về trích bảng PDF bằng Camelot
Camelot có đọc được PDF scan không?
Không. Lab thấy Camelot trả 0 bảng kèm cảnh báo trang là ảnh. Cần OCR tạo lớp chữ trước.
Nên dùng lattice hay stream?
Bảng có đường kẻ dùng lattice. Bảng không kẻ dùng stream. Không biết thì thử lattice trước.
Vì sao DataFrame có hàng thừa ở đầu?
Stream gom cả tiêu đề và đoạn văn sát phía trên bảng. Dùng table_areas hoặc tìm hàng tiêu đề thật.
Vì sao một ô bị tách thành nhiều hàng?
Chữ trong ô xuống dòng, stream không có đường kẻ để biết ranh giới ô. Gộp hàng tiếp nối sau khi trích.
Camelot 2.0 có cần Ghostscript không?
Theo mã nguồn bản 2.0.0, lattice dùng pypdfium2 làm backend mặc định. Lab chạy lattice không cần Ghostscript.
Có cần proxy để trích bảng không?
Không. Trích bảng chạy offline. Proxy chỉ dùng ở bước tải PDF khi mạng yêu cầu.
Trích bảng PDF bằng Camelot và những điều cần nhớ
Trích bảng PDF bằng Camelot cho kết quả rất tốt khi PDF có lớp chữ và chọn đúng chế độ: lab ngày 29/10/2026 trích đúng 30 trên 30 ô với bảng kẻ. Bản scan trả 0 bảng, bảng không kẻ gom thêm chữ ngoài bảng và tách ô xuống dòng thành hàng thừa. Kiểm lớp chữ, tìm hàng tiêu đề thật, đối chiếu với đáp án. Cần IP thoát ổn định cho job tải tài liệu trước khi trích bảng PDF bằng Camelot, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


