
trích văn bản PDF sau web crawl có nguồn và tọa độ
trích văn bản PDF sau web crawl là bước xử lý tệp sau khi tải, tách biệt với cấu hình HTTP proxy. Một PDF mở được vẫn có thể không chứa lớp chữ để parser đọc. Bài này so tệp text với bản ảnh scan, lưu trang và tọa độ khối, rồi xác định khi nào cần đánh giá OCR. ProxyVN hướng dẫn cách kiểm trên dữ liệu mẫu.
trích văn bản PDF sau web crawl bắt đầu từ tệp hợp lệ
Đường tải và bộ trích xuất có nhiệm vụ khác nhau. HTTP client nhận byte từ URL theo quyền truy cập; PyMuPDF đọc cấu trúc tệp đã lưu. Truyền một địa chỉ proxy cho parser không làm nó tự thu được phần chữ còn thiếu trong một bản scan.
Trước khi mở PDF, giữ status, URL cuối, thời điểm tải và hash byte. Một response mang phần mở rộng .pdf có thể thực ra là trang đăng nhập hoặc thông báo lỗi HTML. Nếu bỏ qua bước nhận diện, lỗi parser sẽ bị hiểu nhầm thành lỗi tài liệu.
Bộ lab của bài tự tạo hai tệp có cùng nội dung nhìn thấy: một bản chứa chữ và một bản chỉ chứa ảnh trang. Cách làm này giúp phân biệt lớp dữ liệu mà parser đọc được. Nó không đánh giá chất lượng tài liệu scan thực, font phức tạp hoặc chữ viết tay.
Giữ nguyên bản tải trước khi chuẩn hóa
Tệp nguồn nên được lưu bất biến trong phạm vi công việc đã cho phép. Nếu sửa PDF trước khi ghi hash, người nhận không còn biết parser đã đọc đúng byte từ nguồn hay một bản đã biến đổi. Tách tệp gốc và tệp xử lý giúp đối soát sai lệch theo từng bước.
Không dùng tên tệp làm khóa duy nhất. Hai URL có thể cùng trả report.pdf nhưng nội dung khác; một URL cũng có thể được cập nhật theo ngày. Hash byte cùng URL và timestamp tạo một dấu vết phù hợp hơn cho việc truy tìm bản đã xử lý.
Nếu tài liệu có giới hạn quyền hoặc yêu cầu đăng nhập, giữ phạm vi sử dụng theo nguồn và dự án. Việc tải được không tự cấp quyền tái bản nội dung. Bài này dùng dữ liệu tự tạo nên không cần sao chép tài liệu của người khác để chứng minh parser hoạt động.
trích văn bản PDF sau web crawl bằng PyMuPDF
PyMuPDF có các kiểu đầu ra văn bản phục vụ nhu cầu khác nhau. Text liền dễ đọc nhưng có thể làm mất cấu trúc vị trí. Block hoặc word giữ thêm tọa độ để đối chiếu với trang và thiết kế bước xử lý sau.
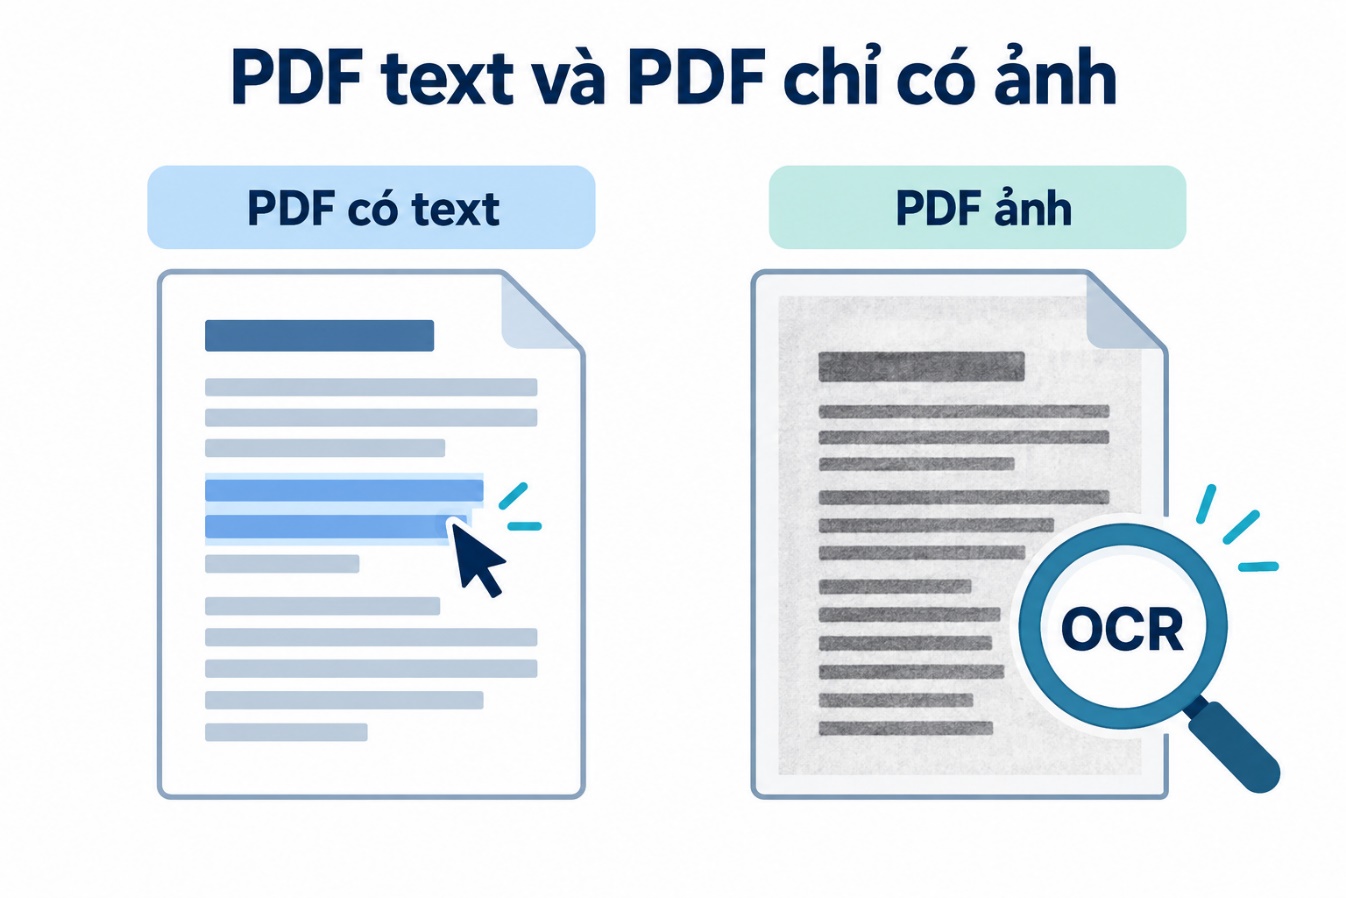
PDF text và PDF chỉ có ảnh
Ví dụ xuất khối chữ thành JSONL
Đoạn dưới đọc một tệp cục bộ đã tải và kiểm trước đó. URL nguồn là metadata được người gọi truyền vào, không phải yêu cầu mạng mà parser thực hiện. Số trang lưu từ một để người biên tập dễ nối với cách đánh số thường dùng.
import json, pymupdf
source_url = 'http://lab.invalid/text.pdf'
with pymupdf.open('text.pdf') as document, open(
        'blocks.jsonl', 'w', encoding='utf-8') as output:
    for page_number, page in enumerate(document, start=1):
        for block in page.get_text('blocks'):
            if len(block) > 6 and block[6] == 0:
                row = {'source_url': source_url, 'page': page_number,
                       'bbox': list(block[:4]), 'text': block[4]}
                output.write(json.dumps(row, ensure_ascii=False) + '\n')
Ví dụ lọc block có loại chữ theo cấu trúc trả về của API đang dùng. Khi nâng phiên bản, kiểm lại định dạng block thay vì mặc định tuple luôn giữ nguyên. Tài liệu trích text của PyMuPDF là điểm đối chiếu chính cho lựa chọn đầu ra.
JSONL giữ một record trên mỗi dòng nên có thể xử lý từng khối. Tuy nhiên các khối của cùng trang chưa chắc tương ứng thứ tự đọc mong muốn. Đừng ghép toàn bộ theo thứ tự trả về rồi gọi đó là văn bản đã được phục hồi bố cục.
Chọn độ hạt phù hợp với tác vụ
Nếu cần tìm đoạn có từ khóa, block thường đủ để xác định vùng đối chiếu. Nếu cần bôi sáng từ hoặc căn chỉnh với ảnh, có thể cần word và tọa độ chi tiết hơn. Lưu quá nhiều cấu trúc không dùng đến làm dữ liệu nặng mà không cải thiện kết quả.
Tọa độ cần được giữ cùng hệ quy chiếu và kích thước trang của API. Không coi số trong bbox là pixel của ảnh render ở mọi độ phân giải. Nếu hiển thị lên ảnh, cần phép chuyển dựa trên tỷ lệ và các biến đổi trang liên quan.
Một trang quay hoặc có vùng crop có thể làm cách đối chiếu trực quan khác dự kiến. Thử ít nhất một trang có tình huống tương ứng nếu tài liệu nguồn thường gặp. Bản lab một trang thẳng không chứng minh xử lý mọi phép quay đã đúng.
trích văn bản PDF sau web crawl với text layer và bản scan
PDF là một định dạng chứa nhiều thành phần, không chỉ văn bản. Trang nhìn rõ chữ có thể là một ảnh duy nhất. Parser text không có dữ liệu ký tự để lấy trong trường hợp đó, dù người đọc bằng mắt thấy nội dung.
Kiểm trước khi quyết định chạy OCR
Với bản text lab, đầu ra phải chứa câu mẫu và có khối chữ. Với bản scan chỉ chứa ảnh, đầu ra text rỗng là kết quả phù hợp. Không gán nhãn parser hỏng chỉ vì nó không tự nhận dạng ảnh khi chưa gọi chức năng OCR.
Text rỗng chưa chứng minh tài liệu là scan trong mọi trường hợp. Nó cũng có thể là trang không có chữ, chữ bị mã hóa theo cách khó trích hoặc lỗi xử lý. Cần đối chiếu hình trang và cấu trúc tài liệu để phân loại thay vì tự đẩy mọi ca rỗng vào một hàng đợi OCR vô hạn.
Với tài liệu hỗn hợp, đánh giá theo trang. Một trang bìa ảnh không yêu cầu cả tài liệu phải OCR lại. Lưu trạng thái từng trang giúp chọn bước xử lý phù hợp và tránh thay lớp chữ tốt bằng kết quả nhận dạng kém hơn.
OCR tạo một nguồn suy luận mới
Kết quả OCR là nhận dạng từ ảnh, có thể sai dấu, số hoặc thứ tự dòng. Cần lưu công cụ, ngôn ngữ, cấu hình và trạng thái kiểm chất lượng riêng. Không ghi OCR text như thể đó là byte văn bản gốc đã được lấy nguyên vẹn từ PDF.
Hướng dẫn OCR của PyMuPDF mô tả nhánh chức năng liên quan. Bộ lab của bài chỉ phân biệt bản có lớp chữ với bản ảnh; không chạy OCR và không công bố tỷ lệ nhận dạng. Nếu dự án cần OCR, bổ sung tập mẫu có nhãn trước khi nghiệm thu.
Các trường như mã sản phẩm, số tiền và ngày cần kiểm riêng vì một ký tự sai có thể thay ý nghĩa. Chỉ số tổng số ký tự nhận dạng không đủ cho tác vụ dữ liệu có cấu trúc. Chọn tiêu chí theo trường mà người dùng cuối thực sự sử dụng.
trích văn bản PDF sau web crawl với thứ tự đọc
Thứ tự hiển thị trên trang không luôn trùng thứ tự đối tượng trong tệp. Tài liệu hai cột, chú thích và bảng dễ làm text liền bị xen dòng. Cần một mẫu kiểm có nhãn theo bố cục thường gặp của nguồn.
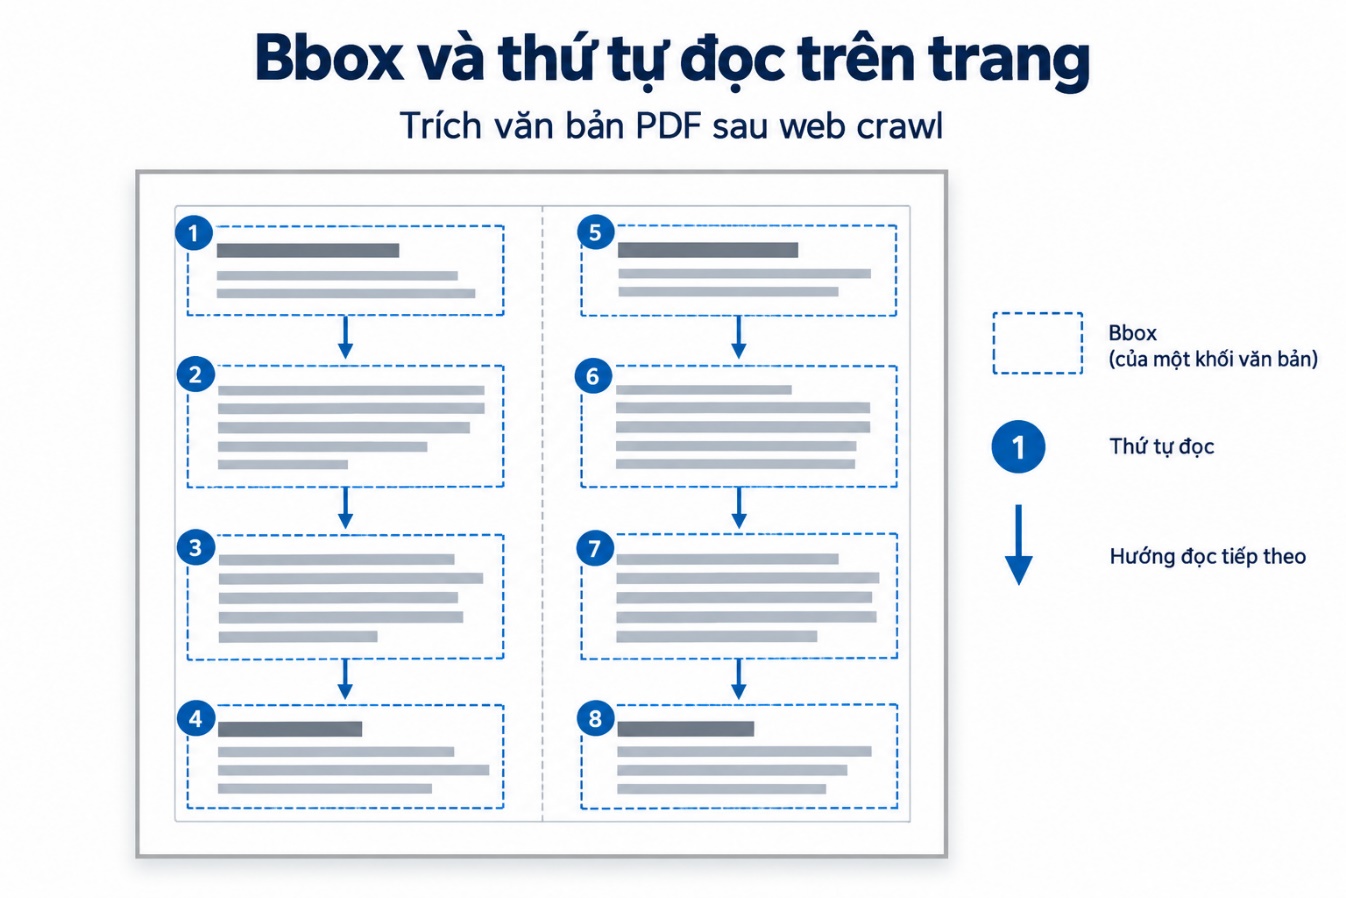
Bbox và thứ tự đọc trên trang
Loại trang |
Rủi ro khi ghép text |
Dữ liệu nên giữ |
|---|---|---|
Một cột đơn |
Header và footer lẫn vào bài |
Trang và block |
Hai cột |
Dòng hai cột bị trộn |
Bbox và thứ tự đọc kiểm tay |
Bảng |
Ô mất quan hệ hàng cột |
Vùng bảng và cấu trúc riêng |
Ảnh scan |
Không có text layer |
Ảnh trang và trạng thái OCR |
Không sửa thứ tự bằng một quy tắc toàn cục mù
Sắp mọi block theo y rồi x có thể cải thiện một số trang nhưng làm sai trang có hai cột hoặc chú thích bên lề. Quy tắc cần được thử trên tập bố cục mục tiêu. Nếu nguồn có nhiều dạng, phân loại trang trước khi chọn cách ghép có thể hữu ích hơn.
Một bộ nhãn nhỏ nên xác định đoạn mở đầu, đoạn tiếp và vị trí chú thích. So text theo các vùng đã chọn giúp phát hiện lỗi đọc chéo cột. Đừng chỉ kiểm có đủ từ trong đầu ra vì một tập từ đúng vẫn có thể tạo câu sai thứ tự.
Giữ đầu ra block gốc trước khi áp dụng thuật toán ghép. Khi quy tắc đổi, có thể tái xử lý mà không phải tải lại tài liệu. Đồng thời lưu version của bước ghép để giải thích hai bản text khác nhau được tạo từ cùng một PDF.
Tách bảng khỏi đoạn văn nếu tác vụ cần số liệu
Một bảng giá có thể được trích thành các dòng chữ rời nhưng mất quan hệ giữa tên hàng và giá. Nếu downstream cần dữ liệu bảng, phải thiết kế bộ trích phù hợp với cấu trúc đó. Không lấy một chuỗi text đọc tương đối được làm bằng chứng bảng đã chuẩn hóa.
Đầu ra bảng cần số hàng, số cột và nguồn vùng trang để đối chiếu. Với ô gộp hoặc hàng nhiều dòng, quy tắc diễn giải phải được ghi rõ. Một phép split theo khoảng trắng thường không đủ ổn định cho tài liệu có độ rộng cột thay đổi.
Bài tập trung vào block chữ và provenance, không chứng nhận trích bảng. Nếu dự án cần bảng, thêm tệp lab tự tạo với giá trị biết trước và kiểm từng ô. Cách này giữ phạm vi kỹ thuật cụ thể thay vì hứa một parser giải được mọi định dạng PDF.
trích văn bản PDF sau web crawl và schema đầu ra
Đầu ra nên đủ để truy lại phần nguồn khi một đoạn bị nghi sai. URL và trang là mức cơ bản, còn bbox giúp xác định vùng. Hash tệp và version parser nối bản ghi với lần xử lý cụ thể.
Phân biệt trường nguồn với trường đã chuẩn hóa
Text gốc từ parser nên được giữ riêng với text đã bỏ xuống dòng hoặc chuẩn hóa Unicode. Nếu chỉ lưu bản đã làm sạch, một lỗi mất ký tự có thể không truy được bước gây ra. Hai trường có tên rõ giúp người nhận biết dữ liệu nào là bằng chứng và dữ liệu nào là sản phẩm xử lý.
Thời điểm thu tệp khác thời điểm trích text và khác ngày xuất bản trong tài liệu. Lưu riêng các mốc theo ý nghĩa. Không lấy thời gian chạy script rồi gán thành ngày của nội dung chỉ để điền một cột còn thiếu.
Một record cần định danh ổn định trong phạm vi snapshot. Có thể ghép hash tệp, số trang và chỉ số block theo version trích xuất. Không dùng chỉ số block như khóa vĩnh viễn qua mọi lần đổi parser vì thứ tự phân đoạn có thể thay.
Biểu diễn lỗi theo trạng thái có thể xử lý
Tệp không mở được, trang không có lớp chữ và text có chất lượng thấp là ba trạng thái khác nhau. Ghi mã lý do giúp pipeline quyết định tải lại, đánh giá OCR hoặc chuyển kiểm tay. Một cột text rỗng cho cả ba trường hợp sẽ làm bước sau đoán nguyên nhân.
Nếu một trang lỗi trong tài liệu nhiều trang, giữ danh sách trang đã xử lý và trang thất bại. Chính sách cho phép xuất một phần hay dừng cả tệp cần theo yêu cầu dự án. Đừng âm thầm bỏ trang lỗi rồi báo tài liệu đã trích đủ.
Khi cân nhắc mua proxy cho tầng tải, kiểm riêng quyền truy cập, độ ổn định truyền và kích thước tệp. Một proxy khác không tự sửa thứ tự đọc hoặc tạo text layer. Kết quả parser cần được nghiệm thu trên byte tài liệu đã giữ.
trích văn bản PDF sau web crawl trong pipeline nhiều tệp
Xử lý nhiều tài liệu cần giới hạn tài nguyên và khả năng chạy lại. Số trang lớn, ảnh độ phân giải cao hoặc cấu trúc phức tạp có thể tăng chi phí. Không lấy thời gian của một PDF một trang lab để dự báo mọi nguồn.
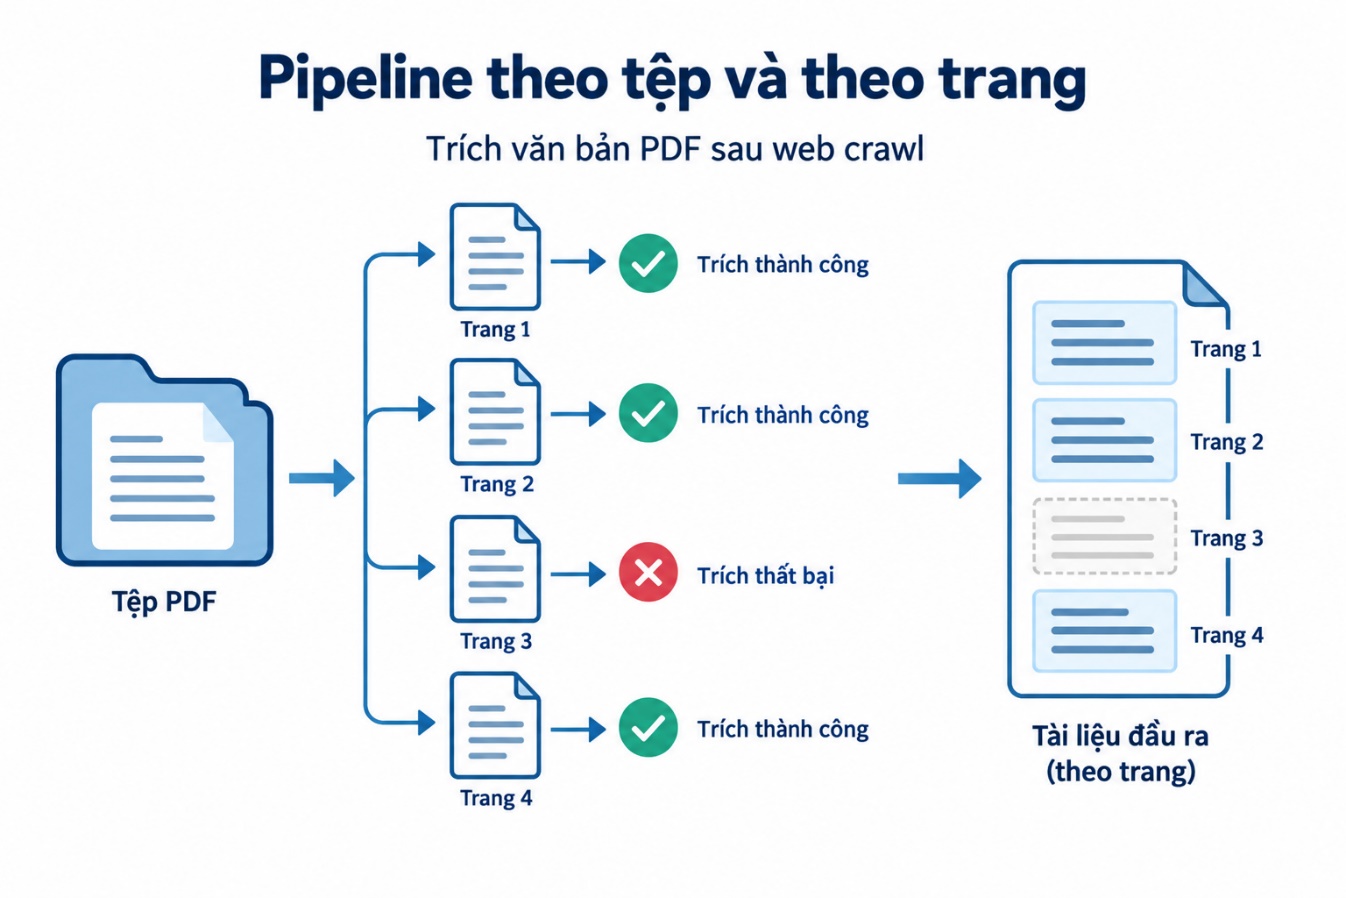
Pipeline theo tệp và theo trang
Giới hạn theo tệp và theo công việc
Chọn ngưỡng byte, số trang và thời gian dựa trên loại tài liệu dự kiến. Khi vượt ngưỡng, đưa vào trạng thái cần xem xét thay vì tự cắt không báo. Các ngưỡng tự chọn phải được ghi là chính sách pipeline, không phải giới hạn mặc định của PyMuPDF.
Worker nên đóng document sau khi xử lý bằng cơ chế API phù hợp. Giữ đối tượng tệp lâu ngoài vòng đời cần thiết có thể làm tăng tài nguyên. Một ca chạy lặp có giới hạn giúp kiểm cleanup trước khi tăng số worker.
Nếu dùng nhiều tiến trình, mỗi tiến trình nên mở tài liệu theo cách thư viện hỗ trợ. Không chia sẻ đối tượng đang mở giữa các worker bằng giả định nó là một chuỗi dữ liệu đơn giản. Đọc tài liệu concurrency của đúng phiên bản trước khi chọn kiến trúc.
Checkpoint ở ranh giới có thể tái tạo
Checkpoint theo tệp hoặc theo trang cần gắn với hash nguồn và version parser. Nếu tệp đổi, không tiếp tục dùng kết quả cũ của một số trang rồi ghép với trang mới. Một snapshot nhất quán giúp đầu ra có ý nghĩa khi đối soát.
Ghi JSONL vào tệp tạm và chỉ công bố sau khi trạng thái hoàn tất phù hợp. Nếu xuất theo trang, manifest cần chỉ rõ trang nào có mặt. Không để một tệp đầu ra bị cắt giữa dòng được downstream coi là đầy đủ chỉ vì tên kết thúc bằng jsonl.
Khi chạy lại, chống trùng bằng khóa snapshot thay vì xóa mọi record có cùng URL. Hai phiên bản tài liệu tại cùng URL có thể đều cần giữ để nghiên cứu thay đổi. Quy tắc lưu lịch sử phải phục vụ mục tiêu dữ liệu, không chỉ tiết kiệm dung lượng.
trích văn bản PDF sau web crawl và kiểm chất lượng
Chất lượng trích xuất cần có nhãn độc lập. Một script không ném exception chưa chứng minh văn bản đúng. Bộ mẫu nên có ít nhất bản chữ đơn giản, bản ảnh và những bố cục mà nguồn thực thường dùng.
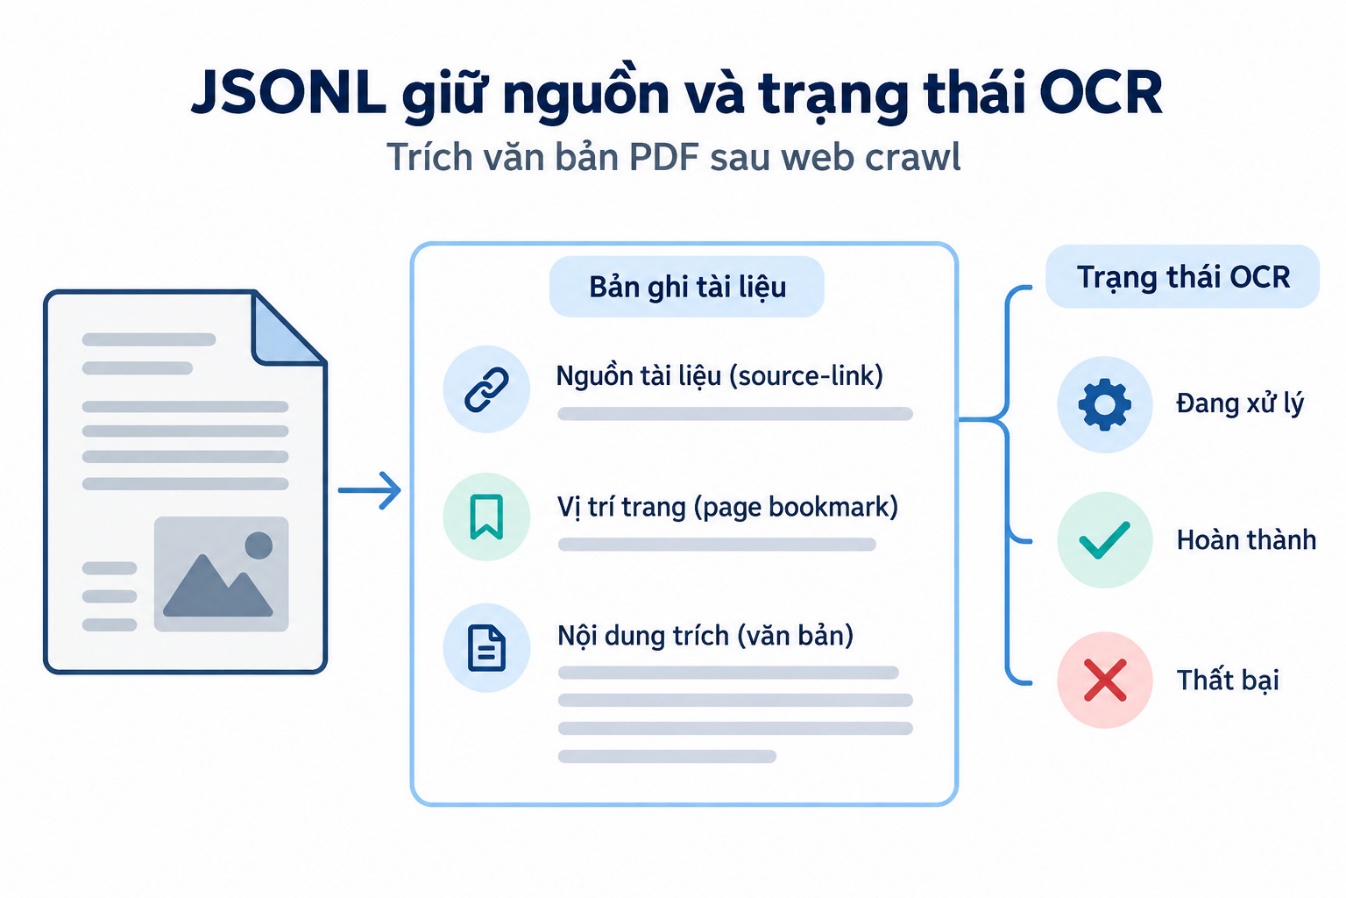
JSONL giữ nguồn và trạng thái OCR
Đối soát bản text và bản scan trong lab
Với bản text tự tạo, kiểm câu mẫu xuất hiện và record có trang cùng bbox hợp lệ. Với bản scan, kiểm không có text layer theo cách tạo fixture. Kết quả rỗng ở bản scan được ghi là cần đánh giá OCR, không phải lỗi HTTP hay bằng chứng proxy làm mất chữ.
JSONL cần đọc lại được từng dòng và giữ đúng URL nguồn. Kiểm số trang không vượt tổng trang của document, bbox có đủ bốn giá trị và text không bị thay bằng biểu diễn byte. Đây là các điều kiện cấu trúc nhỏ nhưng giúp phát hiện lỗi tích hợp sớm.
Nếu lưu Unicode tiếng Việt, xuất UTF-8 và đọc lại theo cùng hợp đồng. Không dùng thao tác thay ký tự để làm terminal hiển thị đẹp mà bỏ qua dữ liệu trong tệp. Ca kiểm chữ có dấu cần được so trên chuỗi và byte lưu thực.
Chọn thước đo theo mục tiêu cuối
Với tìm kiếm văn bản, có thể kiểm việc giữ đủ các đoạn có nhãn. Với trích số liệu, kiểm chính xác trường và mối quan hệ bảng. Với trích dẫn, cần trang và vùng nguồn đúng. Một chỉ số chung về số ký tự không thể thay ba nhóm tiêu chí này.
Lỗi phát hiện nhầm cũng cần ghi nhận. Ví dụ một header lặp bị đưa vào mỗi đoạn có thể làm tìm kiếm nghiêng về một từ không thuộc nội dung chính. Đếm ký tự nhiều hơn không có nghĩa giữ thông tin tốt hơn.
Đánh giá thủ công một tập nhỏ có đại diện giúp xác định nơi cần quy tắc mới. Ghi rõ tập mẫu, loại trang và tiêu chí để người nhận biết phạm vi. Không công bố tỷ lệ chính xác trên dữ liệu chưa có nhãn hoặc chưa chạy kiểm.
Bảo vệ provenance khi sửa văn bản
Một bước nối từ bị ngắt dòng cần biết khi nào dấu gạch nối là ngắt dòng và khi nào là một phần từ. Nếu quy tắc xóa mọi dấu nối, mã sản phẩm hoặc thuật ngữ có thể bị đổi. Giữ text gốc và ghi version quy tắc để có thể phục hồi.
Việc bỏ header footer cũng cần thử trên nhiều trang. Một dòng lặp có thể là tiêu đề bảng cần thiết, không chỉ thành phần trang trí. Nếu xóa theo tần suất mà không đối chiếu vùng, có thể mất thông tin làm các record còn lại khó hiểu.
Khi thêm OCR hoặc bước sửa lỗi, tạo nhãn phương pháp cho từng đoạn. Người dùng cuối có thể cần biết câu đến từ lớp chữ gốc hay nhận dạng ảnh. Trộn hai nguồn mà không lưu phương pháp làm giảm khả năng đánh giá độ tin cậy của trích dẫn.
Điều kiện bàn giao bản xử lý
Gói bàn giao dữ liệu nên có schema, mẫu JSONL và manifest liên kết nguồn. Không cần gửi ảnh render mọi trang nếu người dùng chỉ yêu cầu dữ liệu, nhưng phải giữ cách truy lại vùng khi kiểm. Các tài liệu Page và TextPage giúp đối chiếu API chi tiết.
Trước xuất bản hướng dẫn, ghi rõ phiên bản PyMuPDF đã chạy và các nhánh chưa kiểm như OCR, bảng hoặc tài liệu mã hóa. Những giới hạn này không làm mất giá trị của lab block chữ. Chúng giúp người đọc không áp dụng kết quả sang một nhiệm vụ khác mà thiếu bộ kiểm cần thiết.
Sau khi kiểm, đóng tệp nguồn và dọn dữ liệu tạm của chính công việc. Giữ hash và báo cáo để lần nâng phiên bản có thể so với mốc cũ. Không sửa tài liệu gốc của người dùng khi nhiệm vụ chỉ là trích text và tạo đầu ra mới.
Đối chiếu tọa độ với hình trang
Một bbox có giá trị số hợp lệ vẫn có thể bị hiển thị sai nếu ứng dụng dùng nhầm hệ tọa độ. Khi kiểm, render trang ở độ phân giải đã biết rồi đánh dấu vùng bằng phép chuyển tương ứng. Giữ kích thước trang và thông số render để phép so không phụ thuộc cửa sổ xem đang phóng to bao nhiêu.
Với bản text một dòng, vùng chữ phải bao quanh đúng câu mẫu ở gần vị trí đã đặt. Không yêu cầu bbox trùng từng pixel với nét chữ vì hộp ký tự và ảnh raster có khái niệm khác nhau. Mục tiêu là xác định đúng vùng đọc và tránh lệch sang trang hoặc cột khác.
Nếu đưa bbox vào công cụ trích dẫn, kiểm cả số trang hiển thị. Chỉ số nội bộ bắt đầu từ không có thể gây lệch một trang khi giao diện dùng số từ một. Ghi rõ quy ước trong schema để người tích hợp không phải đoán từ một ví dụ.
Một tài liệu có trang bìa không đánh số nhưng phần nội dung bắt đầu từ một còn thêm sự khác biệt giữa số trang vật lý và số in trên tài liệu. Lưu số trang vật lý của PDF để truy lại ổn định; nếu trích số in, dùng một trường riêng và ghi cách nhận diện.
Kiểm font và ký tự khi text layer tồn tại
Có lớp chữ không đồng nghĩa mọi ký tự được ánh xạ đúng sang Unicode. Một font hoặc cấu trúc mã hóa đặc biệt có thể tạo chuỗi khó đọc. Bộ kiểm nên so một số cụm có dấu, chữ số và ký hiệu từ nguồn có nhãn, thay vì chỉ kiểm text không rỗng.
Nếu chữ trên trang nhìn đúng nhưng text lấy ra sai, giữ tệp và đoạn output nhỏ để điều tra ánh xạ. Không tự thay hàng loạt ký tự theo một bảng đoán rồi nhận dữ liệu đã được sửa. Một quy tắc thay phù hợp tệp này có thể làm hỏng tệp khác.
Với dữ liệu số, giữ nguyên biểu diễn gốc trước khi đổi kiểu. Dấu phẩy và dấu chấm có thể mang ý nghĩa khác theo tài liệu. Tách bước trích chuỗi khỏi bước diễn giải số giúp biết lỗi xuất hiện ở parser PDF hay ở quy tắc chuẩn hóa sau đó.
Giới hạn truy xuất của một record block
Một block có thể chứa nhiều dòng hoặc một phần đoạn văn. Chỉ số block không nhất thiết là số đoạn theo nghĩa biên tập. Nếu downstream cần đoạn hoàn chỉnh, thêm bước ghép có kiểm và giữ danh sách block nguồn để vẫn truy vết được phần đã gộp.
Khi chia văn bản thành chunk cho tìm kiếm, không bỏ quan hệ với trang và bbox. Một chunk vượt qua hai trang nên giữ danh sách vùng nguồn thay vì gán một trang tùy ý. Nhờ đó người đọc có thể kiểm lại câu được trích từ đâu mà không phải tìm thủ công toàn tài liệu.
Đừng lấy hash của text đã làm sạch làm bằng chứng tệp PDF không đổi. Hai PDF khác byte có thể tạo cùng text, còn một PDF không đổi có thể tạo text khác khi nâng parser. Lưu riêng hash tài liệu và hash output theo đúng mục đích đối soát.
Bổ sung tập mẫu trước khi dùng cho nguồn mới
Nguồn báo cáo, hóa đơn và bài nghiên cứu thường có bố cục khác nhau. Chạy một tập mẫu nhỏ của nguồn mới để xác định lỗi đặc trưng trước khi đưa vào pipeline định kỳ. Một parser hoạt động tốt trên tin một cột chưa được nghiệm thu cho bảng tài chính nhiều cột.
Tập mẫu cần có ca không đạt và lý do, không chỉ những tệp trích đẹp. Các bản bị từ chối giúp đo giới hạn của quy tắc và giảm áp lực sửa âm thầm. Khi thay cấu hình, giữ lại các ca cũ để kiểm không làm mất khả năng xử lý đã có.
Tệp tải đúng, chữ trích đúng và thứ tự đọc đúng là ba điều kiện cần đối chiếu riêng.
Anh em hãy lưu dữ liệu mẫu cùng cấu hình và kết quả đối chiếu để lần cập nhật sau có cơ sở kiểm lại. Tham khảo thêm tại Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam. Bắt đầu từ phạm vi nhỏ và tiêu chí rõ ràng khi triển khai trích văn bản PDF sau web crawl.


