
ScrapingBee API: gọi thử, tính credit và dùng own_proxy
ScrapingBee API là dịch vụ nhận một URL rồi tự tải trang, chạy JavaScript nếu cần và trả HTML hoặc dữ liệu đã trích. Anh em không phải tự quản trình duyệt hay bể proxy, nhưng mỗi request bị trừ credit theo tham số. ProxyVN đọc tài liệu chính thức ngày 29/10/2026, gọi thử điểm cuối thật khi chưa có khóa và viết script tính ngân sách để anh em thử mà không đốt credit.
ScrapingBee API là gì và khác gì proxy tự mua
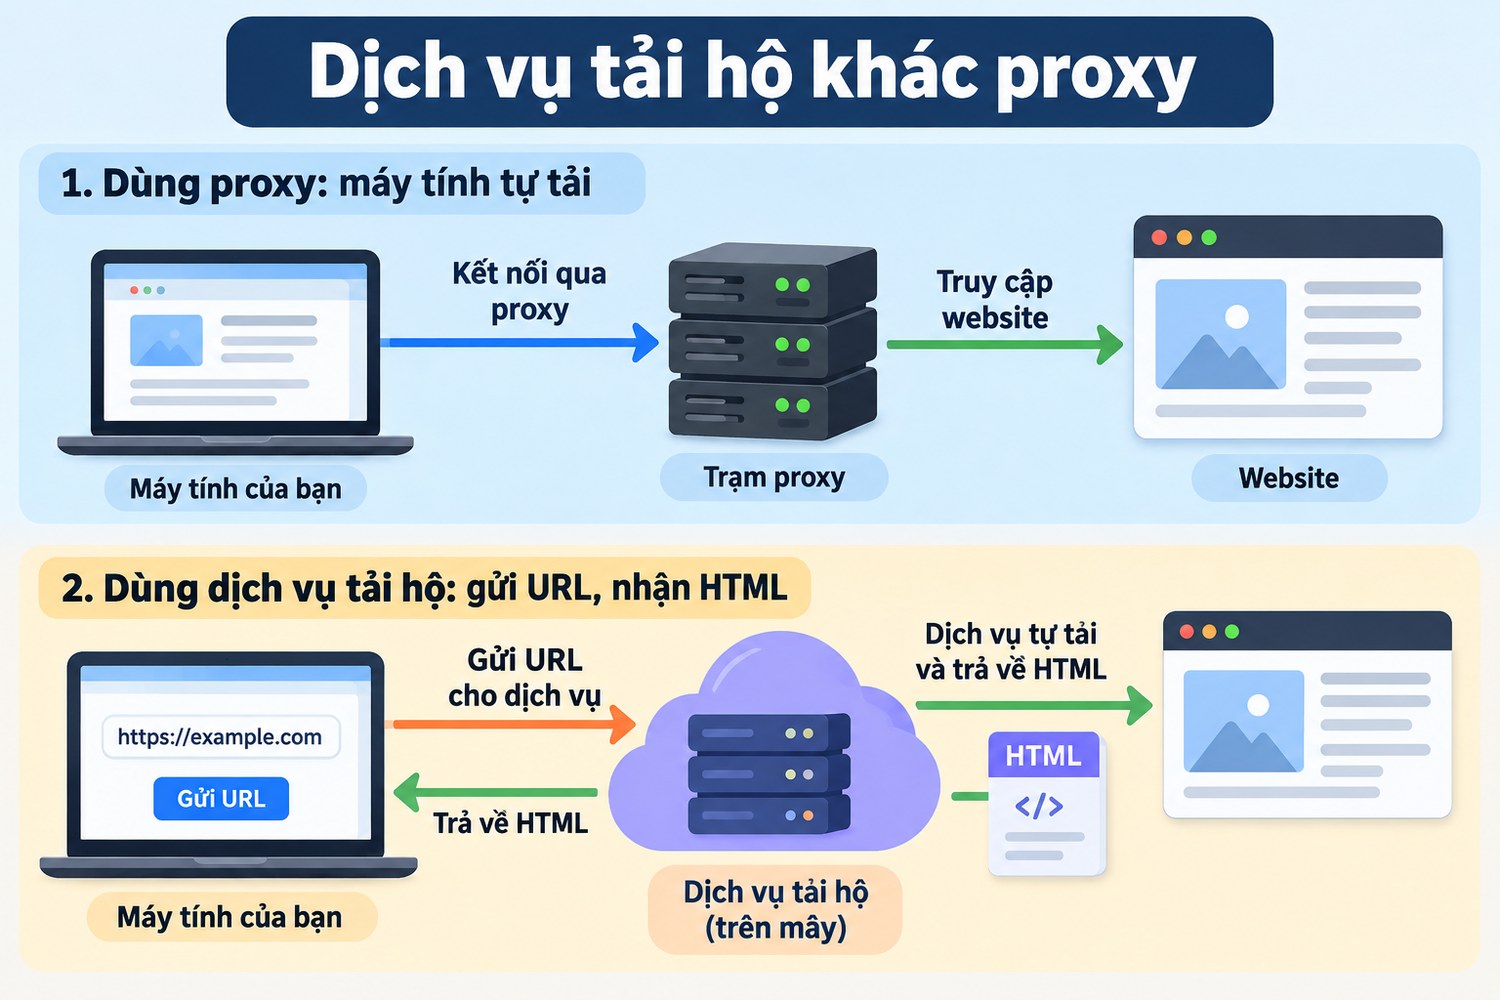
Dịch vụ tải hộ khác proxy
Câu hỏi đầu tiên khi đọc tài liệu HTML API của ScrapingBee là dịch vụ này nằm ở lớp nào trong luồng crawl. Nếu xếp nhầm lớp, anh em sẽ so giá sai và cấu hình sai. Phần này đặt ScrapingBee cạnh proxy HTTP thường để thấy mỗi bên làm gì.
Một request đi qua những bên nào
Khi dùng proxy tự mua, chương trình của anh em vẫn tự mở kết nối tới trang đích. Proxy chỉ đứng giữa để thay địa chỉ IP thoát. Phần tải trang, giải nén, chạy JavaScript, thử lại khi lỗi và đổi IP là việc của mã anh em viết.
Với ScrapingBee, chương trình gửi request tới máy chủ app.scrapingbee.com kèm URL đích trong tham số. Máy chủ của họ chọn proxy, mở trình duyệt không giao diện nếu bật render, tải trang, rồi trả kết quả về. Trang đích nhìn thấy IP của ScrapingBee hoặc IP của proxy họ chọn, không thấy IP máy anh em.
ScrapingBee là dịch vụ tải trang hộ, còn proxy là đường đi; hai thứ giải hai bài toán khác nhau. Khi trang đích chỉ cần đổi IP, proxy thường rẻ hơn. Khi trang cần trình duyệt thật, chạy kịch bản và thử lại nhiều tầng, dịch vụ quản lý sẵn đỡ được phần vận hành.
Proxy mode chỉ là cửa vào khác
Tài liệu có mục Proxy Mode với địa chỉ proxy.scrapingbee.com cổng 8886 cho HTTP, 8887 cho HTTPS và socks.scrapingbee.com cổng 8888 cho SOCKS5. Tên đăng nhập là API key, mật khẩu là chuỗi tham số như render_js=False. Nhìn qua thì giống một proxy thường, nhưng bản chất vẫn là API.
Tài liệu nói rõ chế độ này chỉ đổi cách truy cập. Chi phí, mã trả về và tham số mặc định giống request API thường. JavaScript vẫn bật mặc định, nên mỗi request qua proxy mode vẫn tốn 5 credit nếu anh em quên tắt render.
Ranh giới với bài đã có
Bài datacenter proxy là gì chỉ trích ScrapingBee làm nguồn số liệu về loại proxy. Bài web scraping proxy là gì nói về proxy trong crawl nói chung. Bài này đi vào một tác vụ: gọi HTML API với tham số cụ thể, tính trước số credit, đọc phản hồi và quyết định khi nào cần proxy riêng.
Bài cũng không coi ScrapingBee là công cụ để nhập proxy ProxyVN. Tham số own_proxy có tồn tại, nhưng ProxyVN chưa thử nó với proxy của mình. Phần nói về own_proxy chỉ mô tả theo tài liệu và cách mã hóa chuỗi cho đúng.
Chuẩn bị khóa, trang đích và phạm vi thử ScrapingBee API
Trước khi gọi request đầu tiên, anh em cần ba thứ: một API key, một trang đích được phép thu thập và một ngân sách thử có giới hạn. Thiếu thứ thứ ba là cách nhanh nhất để hết credit trong buổi đầu. Ba mục dưới đây đi lần lượt từng thứ.
API key và header Authorization
Khóa lấy ở bảng điều khiển sau khi tạo tài khoản và xác nhận email. Trang giá ScrapingBee ngày 29/10/2026 ghi gói dùng thử có 1.000 credit, không cần thẻ. ProxyVN không đăng ký tài khoản trong bài này, nên mọi lệnh có khóa ghi YOUR-API-KEY làm chỗ trống.
Tài liệu khuyên gửi khóa qua header Authorization dạng Bearer. Cách truyền khóa bằng tham số api_key trên URL đã bị đánh dấu deprecated. Cách cũ vẫn chạy để tương thích, nhưng tài liệu cảnh báo có thể bị bỏ ở phiên bản sau.
Đưa khóa vào header còn giúp tránh lộ khóa trong log. URL thường bị ghi nguyên vào log máy chủ, log proxy công ty và lịch sử terminal. Header Authorization ít bị ghi hơn, dù vẫn cần che khi in log ra màn hình.
Trang đích được phép
Bài dùng books.toscrape.com làm trang đích. Đây là trang tập crawl công khai, dữ liệu sách là giả và được dựng để người học thu thập. Chọn trang như vậy giúp phép thử không làm phiền website thật và không vướng điều khoản sử dụng.
Lưu ý là máy chủ ScrapingBee phải truy cập được trang đích qua Internet. Trang chạy trên máy anh em ở 127.0.0.1 hoặc trong mạng nội bộ sẽ không tới được. Muốn thử với trang lab riêng, anh em phải đưa nó lên một địa chỉ công khai có kiểm soát.
Trước khi crawl website khác, anh em đọc robots.txt và điều khoản như bài robots.txt khi crawl website đã hướng dẫn. Dịch vụ tải hộ không thay đổi trách nhiệm của người đặt lệnh. Nếu trang cấm thu thập, gửi qua ScrapingBee cũng vậy.
Ghi lại phiên bản và ngày đọc tài liệu
ScrapingBee đổi giá và tham số khá thường xuyên. Ngày 29/10/2026, tài liệu đã có mode=auto và max_cost, hai tham số chưa thấy trong nhiều bài hướng dẫn cũ. Anh em nên ghi ngày đọc tài liệu vào đầu script để người sau biết bảng giá đang dựa trên bản nào.
Bảng credit trong script lab bên dưới chép từ mục Credit cost của tài liệu ngày hôm đó. Khi ScrapingBee đổi giá, anh em chỉ cần sửa một từ điển trong script. Không nên rải các con số 5, 10, 25 khắp mã.
Bảng tham số ScrapingBee API hay dùng cho tác vụ fetch
Tài liệu liệt kê hơn ba mươi tham số, nhưng một tác vụ tải trang thường chỉ cần dưới mười cái. Bảng sau gom những tham số ảnh hưởng tới kết quả và chi phí nhiều nhất, kèm giá trị mặc định ghi trong tài liệu. Đọc bảng này trước giúp anh em biết tham số nào làm tăng credit.
Tham số |
Mặc định |
Tác dụng |
Ảnh hưởng chi phí |
|---|---|---|---|
url |
bắt buộc |
URL đích, phải mã hóa |
Không |
render_js |
true |
Mở trình duyệt chạy JavaScript |
Từ 1 lên 5 credit |
premium_proxy |
false |
Dùng bể proxy dân cư |
10 hoặc 25 credit |
stealth_proxy |
false |
Bể proxy cho trang khó |
75 credit, cần render_js |
country_code |
trống |
Chọn quốc gia proxy |
Đi cùng premium hoặc stealth |
mode |
trống |
auto: tự chọn cấu hình rẻ nhất |
Chỉ trả cho cấu hình thành công |
max_cost |
trống |
Trần credit cho mode=auto |
Giới hạn trần |
extract_rules |
trống |
Trích dữ liệu bằng CSS hoặc XPath |
Không tăng |
ai_query |
trống |
Trích bằng AI |
Cộng thêm 5 credit |
session_id |
trống |
Giữ cùng IP trong 5 phút |
Không |
timeout |
140000 |
Thời gian chờ tối đa, ms |
Không |
transparent_status_code |
false |
Trả nguyên mã của trang đích |
Mã dưới 500 bị tính phí |
own_proxy |
trống |
Dùng proxy riêng |
Theo tài liệu không nêu mức riêng |
Tham số render và chờ
render_js mặc định bật, nên request trần không tham số đã tốn 5 credit. Với trang trả HTML tĩnh như books.toscrape.com, anh em đặt render_js=false để chỉ tốn 1 credit. Khi tắt render, các tham số chờ như wait, wait_for và block_resources không còn tác dụng.
Khi bật render, wait_for nhận bộ chọn CSS hoặc XPath, bộ chọn bắt đầu bằng dấu / được coi là XPath. Tài liệu ghi thứ tự chạy là wait_for, rồi wait, rồi js_scenario. Muốn đổi thứ tự thì viết hết vào js_scenario, vì các lệnh trong đó chạy đúng thứ tự khai báo.
Tham số trích dữ liệu
extract_rules nhận một JSON dạng tên trường và bộ chọn, ví dụ title lấy h1 và price lấy .price_color. Với request GET, JSON này phải được stringify rồi mã hóa URL. Phản hồi khi đó là JSON chứa các trường đã trích, không phải HTML.
Các tham số return_page_text, return_page_markdown và return_page_source đổi dạng nội dung trả về. return_page_source trả HTML gốc trước khi JavaScript chạy, và tài liệu nói tham số này không cần khi đã tắt render. Chọn đúng dạng trả về giúp giảm phần xử lý phía anh em.
Trích bằng bộ chọn không tốn thêm credit, còn trích bằng AI cộng 5 credit mỗi request. Với trang có cấu trúc ổn định, extract_rules là lựa chọn rẻ hơn nhiều. ai_query hợp với trang mỗi nơi một kiểu mà anh em không muốn viết bộ chọn riêng.
Credit của ScrapingBee API: tính trước khi chạy lô
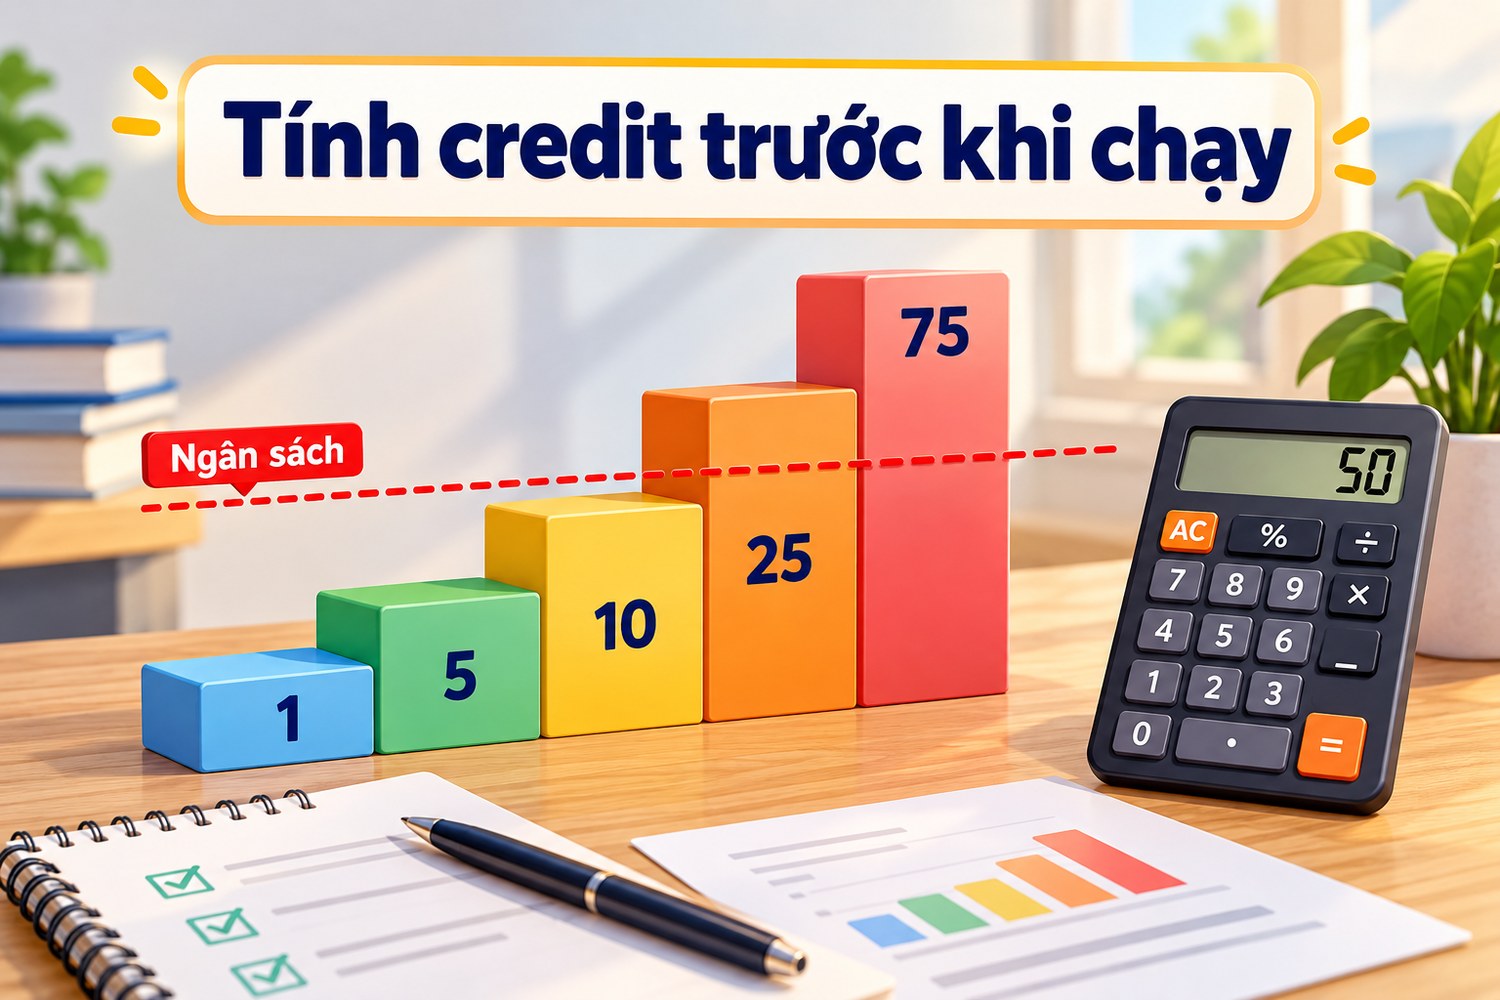
Tính credit trước khi chạy
Mỗi gói ScrapingBee có một số credit mỗi tháng, credit không cộng dồn sang tháng sau. Chi phí mỗi request đi từ 1 tới 75 credit tùy tham số. Tính trước tổng credit cho một lô URL là bước nên làm trước khi bấm chạy.
Bảng credit theo cấu hình
Bảng sau chép từ mục Credit cost for your requests trong tài liệu ngày 29/10/2026. Cột cuối là phép nhân ProxyVN tự tính cho lô 50 URL, chưa tính các lần thử lại phía anh em.
Cấu hình |
Credit mỗi request |
Lô 50 URL |
|---|---|---|
Proxy thường, tắt JavaScript |
1 |
50 |
Proxy thường, bật JavaScript (mặc định) |
5 |
250 |
Premium, tắt JavaScript |
10 |
500 |
Premium, bật JavaScript |
25 |
1.250 |
Stealth, bật JavaScript |
75 |
3.750 |
Bật JavaScript cộng ai_query |
10 |
500 |
Con số 1.000 credit dùng thử nghe nhiều, nhưng chỉ đủ 40 request premium có render. Nếu thử stealth, 13 request đã gần hết. Vì vậy phép thử đầu nên chạy cấu hình rẻ nhất rồi mới leo dần.
Script tính ngân sách trước khi gửi
Script dưới đây ProxyVN chạy thật trên Python 3.12.10 ngày 29/10/2026. Nó không gọi API mà chỉ tính credit dự kiến và dựng URL request. Bảng giá nằm trong một từ điển để dễ sửa khi ScrapingBee đổi.
import json, urllib.parse

API = "https://app.scrapingbee.com/api/v1"
COST = {("classic", False): 1, ("classic", True): 5,
        ("premium", False): 10, ("premium", True): 25,
        ("stealth", True): 75}

def cost(p):
    js = str(p.get("render_js", "true")).lower() != "false"
    tier = ("stealth" if p.get("stealth_proxy")
            else "premium" if p.get("premium_proxy") else "classic")
    if tier == "stealth" and not js:
        raise ValueError("stealth_proxy chi chay khi render_js bat")
    c = COST[(tier, js)]
    if p.get("ai_query") or p.get("ai_extract_rules"):
        c += 5
    return c

def plan(urls, params, budget):
    total = cost(params) * len(urls)
    return {"moi_request": cost(params), "so_url": len(urls),
            "toi_da": total, "trong_ngan_sach": total <= budget}
Chạy với 50 trang danh mục của books.toscrape.com và ngân sách 1.000 credit cho kết quả như sau. Hai cấu hình premium có render và stealth bị đánh dấu vượt ngân sách. Ca stealth tắt JavaScript bị chặn ngay vì tài liệu ghi stealth chỉ chạy khi bật render.
html_tinh {'moi_request': 1, 'so_url': 50, 'toi_da': 50, 'trong_ngan_sach': True}
mac_dinh_js {'moi_request': 5, 'so_url': 50, 'toi_da': 250, 'trong_ngan_sach': True}
premium_khong_js {'moi_request': 10, 'so_url': 50, 'toi_da': 500, 'trong_ngan_sach': True}
premium_js {'moi_request': 25, 'so_url': 50, 'toi_da': 1250, 'trong_ngan_sach': False}
stealth {'moi_request': 75, 'so_url': 50, 'toi_da': 3750, 'trong_ngan_sach': False}
js_ai {'moi_request': 10, 'so_url': 50, 'toi_da': 500, 'trong_ngan_sach': True}
chan: stealth_proxy chi chay khi render_js bat
Con số trong script là trần lý thuyết theo bảng giá. Thực tế có request lỗi 500 không bị tính, nên tổng có thể thấp hơn. Ngược lại, nếu anh em tự thử lại các request lỗi 404 thì mỗi lần thử đều bị tính, vì 404 thuộc nhóm có tính phí.
mode=auto và max_cost
Tài liệu ngày 29/10/2026 có Auto-Mode: thêm mode=auto để ScrapingBee thử từ cấu hình rẻ nhất lên đắt nhất và dừng ở cấu hình đầu tiên thành công. Anh em chỉ trả credit cho cấu hình đó, một trong các mức 1, 5, 10, 25 hoặc 75. Nếu mọi cấu hình đều thất bại, request tốn 0 credit.
Không đặt trần thì Auto-Mode có thể leo tới mức 75 credit. max_cost giới hạn chuyện đó, ví dụ max_cost=10 không cho chạm mức 25 và 75. Tài liệu còn ghi mode=auto chỉ áp cho GET, và không được truyền kèm render_js, premium_proxy, stealth_proxy hay transparent_status_code.
Đặt max_cost ngay từ lần chạy đầu. Một lô 1.000 URL leo lên stealth sẽ tốn 75.000 credit, ngang cả gói Hobby một tháng.
Số credit Auto-Mode đã trừ nằm ở header Spb-auto-cost, bằng 0 khi thất bại. Ghi header này cho từng URL giúp anh em biết trang nào cần cấu hình đắt. Lần chạy sau có thể đặt cấu hình cố định cho nhóm trang đó thay vì để Auto-Mode thử lại từ đầu.
Giá các gói tháng
Trang giá ngày 29/10/2026 ghi gói Hobby 19 USD mỗi tháng có 75.000 credit và 25 request đồng thời. Gói Freelance 49 USD có 250.000 credit, 50 đồng thời. Gói Startup 99 USD có 1.000.000 credit, 100 đồng thời, giá chưa gồm VAT.
Đổi sang chi phí mỗi trang, gói Hobby với cấu hình tắt JavaScript rơi vào khoảng 0,25 USD cho 1.000 trang. Cùng gói đó với premium có render, 1.000 trang tốn 25.000 credit, tức khoảng một phần ba gói. Phép tính này cho thấy tham số quyết định giá nhiều hơn là chọn gói.
Gọi ScrapingBee API lần đầu bằng curl và Python
Khi đã biết cấu hình rẻ nhất, anh em gửi request đầu tiên. Có hai cách hay dùng: curl để thử nhanh và Python để chạy lô. Cả hai đều dùng header Authorization theo khuyến nghị của tài liệu.
Lệnh curl tối thiểu
curl có tùy chọn -G kèm --data-urlencode để tự mã hóa URL đích. Cách này tránh lỗi quên mã hóa dấu & hay dấu ? trong URL đích, lỗi làm tham số của trang đích bị hiểu thành tham số của ScrapingBee.
curl -s -G "https://app.scrapingbee.com/api/v1" ^
  -H "Authorization: Bearer YOUR-API-KEY" ^
  --data-urlencode "url=https://books.toscrape.com/" ^
  --data-urlencode "render_js=false" ^
  -D headers.txt -o page.html
Dấu ^ là ký tự xuống dòng của cmd trên Windows, trên PowerShell dùng dấu ` và trên Linux dùng dấu \. Tùy chọn -D ghi header ra tệp riêng để đọc Spb-cost sau đó. Tệp page.html chứa HTML trang đích nếu request thành công.
Phản hồi thật khi chưa có khóa
ProxyVN gửi đúng lệnh trên nhưng bỏ header Authorization, để xem điểm cuối phản hồi thế nào mà không tốn credit. Kết quả nhận ngày 29/10/2026 là mã 400 chứ không phải 401. Thân phản hồi là JSON báo thiếu trường api_key.
HTTP/1.1 400 BAD REQUEST
server: gunicorn
content-type: application/json
access-control-allow-origin: *
spb-cost: 0
access-control-expose-headers: Spb-cost, Spb-auto-cost, Spb-initial-status-code, Spb-resolved-url, Spb-request-id
spb-request-id: a1f304b1-9a09-4cff-9bd7-00054f98d7a4

{"errors":{"api_key":{"api_key":["Missing data for required field."]}}}
Phản hồi này cho ba thông tin hữu ích. Header spb-cost bằng 0 xác nhận lỗi tham số không bị tính. Header spb-request-id có mặt kể cả khi lỗi, đúng như tài liệu ghi, và là mã cần gửi khi hỏi hỗ trợ.
Điểm cuối /usage gọi thiếu khóa cũng trả cùng mã 400 và cùng thông báo. Bảng mã lỗi của tài liệu dành 401 cho trường hợp hết credit hoặc khóa sai. Thiếu hẳn khóa thì rơi vào nhóm 400, tức lỗi tham số.
Vì thế đoạn mã xử lý lỗi nên đọc thân JSON, không chỉ dựa vào mã trạng thái. Một vòng lặp coi mọi 400 là "URL sai" sẽ bỏ qua lỗi cấu hình khóa. Cả lô sẽ chạy hết mà không có trang nào được tải.
Python với requests và extract_rules
Đoạn Python dưới đây gửi request tới trang chi tiết một cuốn sách, tắt render và trích tiêu đề cùng giá bằng extract_rules. Đoạn mã đọc khóa từ biến môi trường, dừng nếu không có khóa. ProxyVN chỉ chạy phần dựng URL, chưa chạy phần gửi vì không có khóa.
import json, os, requests

key = os.environ.get("SCRAPINGBEE_API_KEY")
if not key:
    raise SystemExit("Chua co SCRAPINGBEE_API_KEY")

params = {
    "url": "https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html",
    "render_js": "false",
    "extract_rules": json.dumps({"title": "h1", "price": ".price_color"}),
    "tag": "lab271",
}
r = requests.get("https://app.scrapingbee.com/api/v1", params=params,
                 headers={"Authorization": f"Bearer {key}"}, timeout=150)
print(r.status_code, r.headers.get("Spb-cost"), r.headers.get("Spb-request-id"))
print(r.text[:500])
Thư viện requests tự mã hóa từng giá trị trong params, nên URL đích và chuỗi JSON đều được mã hóa đúng. URL mà script lab dựng ra có dạng sau, anh em có thể so với URL của mình khi gỡ lỗi.
https://app.scrapingbee.com/api/v1?url=https%3A%2F%2Fbooks.toscrape.com%2Fcatalogue%2Fa-light-in-the-attic_1000%2Findex.html&render_js=false&extract_rules=%7B%22title%22%3A+%22h1%22%2C+%22price%22%3A+%22.price_color%22%7D&tag=lab271timeout của requests đặt 150 giây vì thời gian chờ mặc định phía ScrapingBee là 140 giây. Nếu để timeout phía client ngắn hơn, client sẽ cắt kết nối trong khi máy chủ vẫn đang tải trang. Request đó vẫn có thể bị tính credit mà anh em không nhận được kết quả.
Thư viện Python chính thức
Tài liệu cũng có thư viện scrapingbee cài bằng pip, với lớp ScrapingBeeClient. Thư viện tự thêm tiền tố Spb- cho header cần chuyển tiếp và tự stringify extract_rules. Dùng thư viện gọn hơn, còn dùng requests thì thấy rõ từng tham số đi lên URL.
Bài này chọn requests để anh em thấy chuỗi thật. Khi đã hiểu, chuyển sang thư viện chính thức là việc đổi vài dòng. Dù chọn cách nào, khóa vẫn đọc từ biến môi trường, không viết vào mã.
Đọc response ScrapingBee API: mã trạng thái, header Spb và lỗi
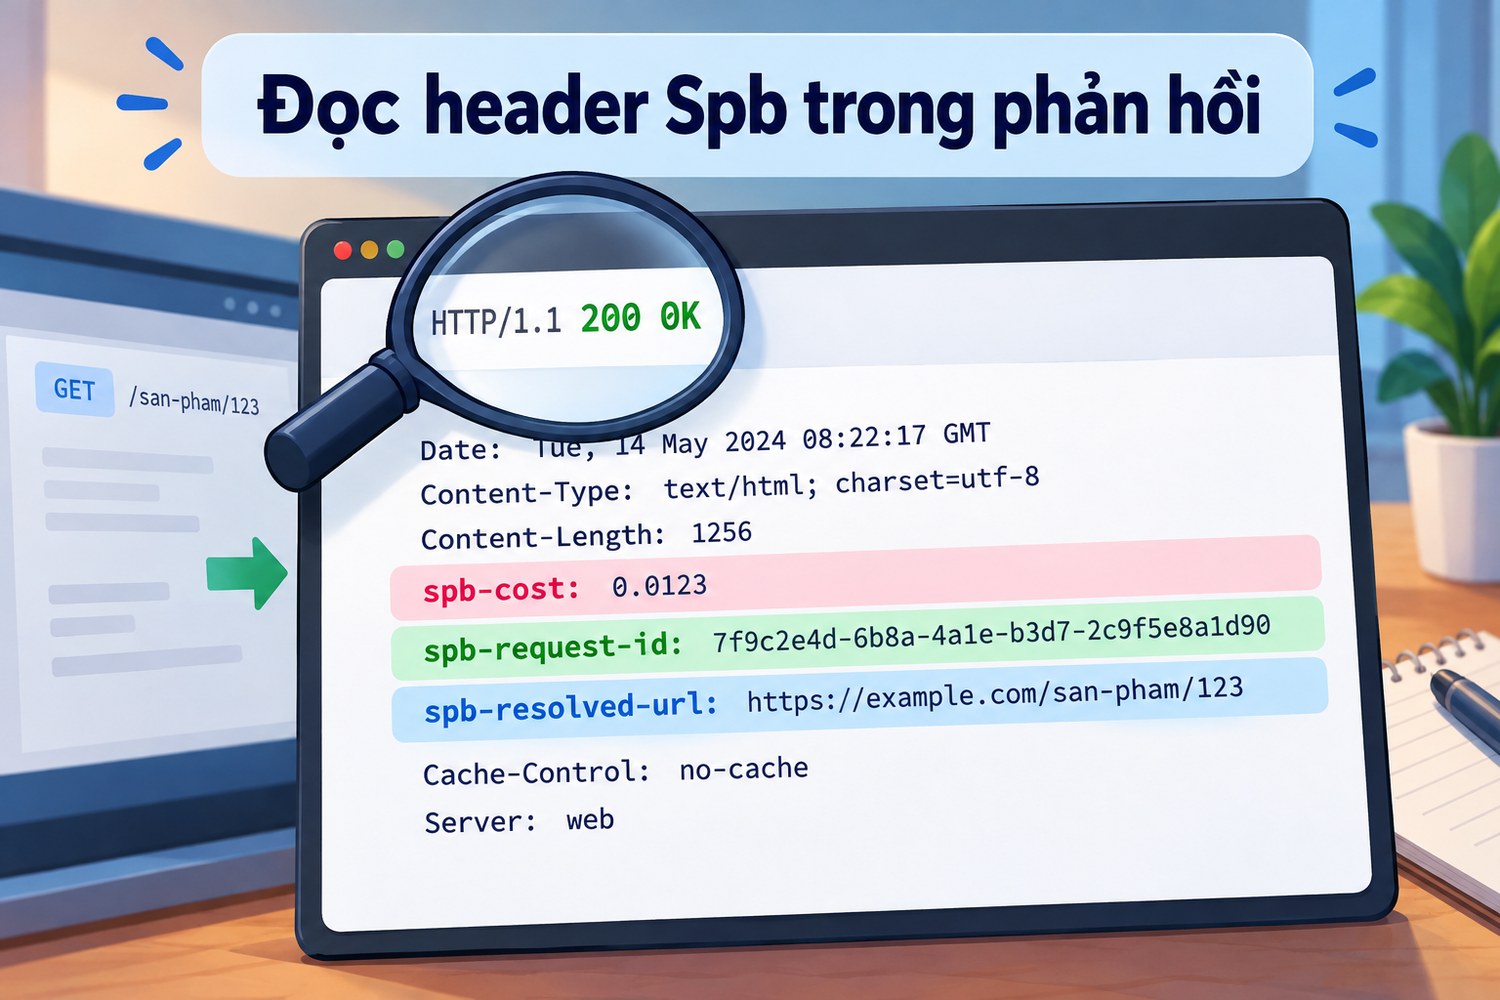
Đọc header Spb trong phản hồi
Mã trạng thái của ScrapingBee là mã của chính họ, không phải mã của trang đích. Hiểu nhầm điểm này là nguồn của nhiều báo cáo sai kiểu "trang chặn 500". Phần này giải thích ba thứ cần đọc ở mỗi phản hồi.
Bảng mã trạng thái
Bảng sau tóm từ mục Response Status Code của tài liệu. Cột tính phí cho biết request đó có trừ credit không.
Mã |
Tính phí |
Ý nghĩa theo tài liệu |
Việc nên làm |
|---|---|---|---|
200 |
Có |
Thành công |
Lưu kết quả |
400 |
Không |
Tham số sai hoặc thiếu |
Đọc thân JSON, sửa tham số |
401 |
Không |
Hết credit hoặc khóa sai |
Kiểm khóa, kiểm gói |
403 |
Không |
Tài khoản bị khóa hoặc đích bị chặn |
Đọc thân phản hồi |
404 |
Có |
URL đích không tồn tại |
Sửa danh sách URL |
410 |
Có |
URL đích đã gỡ |
Bỏ khỏi danh sách |
413 |
Có |
Trang đích từ chối vì payload lớn |
Kiểm URL |
429 |
Không |
Quá số request đồng thời |
Giảm đồng thời |
500 |
Không |
Không tải được trang |
Thử lại có giãn cách |
Tài liệu nhấn mạnh 403 ở bảng này không bao giờ là 403 của trang đích. Nếu trang đích trả 403 vì chống bot, mặc định anh em nhận 500. Hai mã 403 có nguyên nhân rất khác nhau nên không được gộp chung một nhánh xử lý.
transparent_status_code
Mặc định ScrapingBee đổi mọi mã 2xx thành 200, giữ nguyên 404, 410 và 413, còn lại thành 500. Redirect được đi theo trước, nên mã là mã cuối chuỗi. Một trang chặn bot trả 403 hay trang quá tải trả 503 đều tới tay anh em dưới dạng 500, và 500 không bị tính.
Bật transparent_status_code=true thì anh em nhận đúng thân và mã của trang đích. Đổi lại, mọi mã dưới 500 đều bị tính, và ScrapingBee không còn tự thử lại sang proxy khác. Tham số này hợp cho việc kiểm tra trang, không hợp cho lô lớn đang cần tỷ lệ thành công.
Header Spb cần ghi lại
Mỗi phản hồi có thêm vài header riêng. Spb-cost là số credit request đó tốn. Spb-initial-status-code là mã đầu tiên của trang đích, hữu ích khi trang redirect. Spb-resolved-url là URL cuối sau redirect.
Spb-request-id là mã định danh request, có ở mọi phản hồi kể cả lỗi. Tài liệu nhắc HTTP/2 viết thường tên header, nên mã đọc header phải không phân biệt hoa thường. Lần thử thật ở trên nhận đúng dạng chữ thường spb-request-id.
Tham số tag gắn một chuỗi tùy ý vào request và trả lại trong header phản hồi. Anh em có thể đặt tag theo tên lô hoặc mã đợt chạy. Khi đối soát hóa đơn credit cuối tháng, tag giúp tách chi phí theo từng dự án.
ScrapingBee API với proxy riêng: own_proxy và proxy mode
Phần này trả lời câu anh em hay hỏi: đã mua proxy rồi thì có dùng chung với ScrapingBee được không. Tài liệu có tham số own_proxy cho việc đó. Cũng có trường hợp ngược lại, anh em muốn dùng ScrapingBee như một proxy trong công cụ sẵn có.
own_proxy theo tài liệu
own_proxy cho phép dùng hạ tầng ScrapingBee với proxy của nhà cung cấp khác. Cú pháp tài liệu ghi là giao thức, tên đăng nhập, mật khẩu, máy chủ và cổng, giao thức là tùy chọn. Nếu không ghi cổng, tài liệu nói dùng 1080, cổng mặc định của cURL.
Điểm hay sai là mã hóa hai lần, theo quy tắc percent-encoding của RFC 3986. Chuỗi proxy nằm trong một tham số URL, nên cả chuỗi phải mã hóa. Nếu mật khẩu có ký tự @ hay #, mật khẩu phải được mã hóa trước khi ghép vào chuỗi proxy, như bài định dạng proxy đã giải thích.
Script lab dùng hàm quote của urllib.parse để dựng URL cho proxy có mật khẩu p@ss#2026 và cho chuỗi dưới đây. Ký tự @ trong mật khẩu thành %40 ở lớp đầu, rồi thành %2540 ở lớp tham số. Ký tự @ ngăn cách tài khoản với máy chủ chỉ mã hóa một lần thành %40.
own = "http://user1:" + urllib.parse.quote("p@ss#2026", safe="") + "@203.0.113.10:8080"
# -> tham so own_proxy tren URL:
# own_proxy=http%3A%2F%2Fuser1%3Ap%2540ss%25232026%40203.0.113.10%3A8080
203.0.113.10 là địa chỉ dành cho tài liệu, không phải proxy thật. ProxyVN chưa gửi request nào có own_proxy, vì cần khóa và proxy công khai. Bài không khẳng định own_proxy chạy với loại proxy hay giao thức nào ngoài những gì tài liệu ghi.
Khi nào own_proxy có lý
own_proxy hợp khi anh em cần IP cố định của mình, ví dụ trang đích đã cho phép IP đó, nhưng vẫn muốn ScrapingBee lo phần trình duyệt. Một ví dụ là trang nội bộ của đối tác chỉ mở cho dải IP đã đăng ký. Proxy riêng cho IP đúng, còn ScrapingBee cho trình duyệt và js_scenario.
Trường hợp chỉ cần đổi IP mà không cần render, own_proxy ít ý nghĩa. Anh em vẫn trả credit cho ScrapingBee trong khi tự mình gọi trang qua proxy cũng đạt cùng kết quả. Tài liệu không ghi mức credit riêng cho own_proxy, nên cần kiểm Spb-cost thật trước khi tính kinh tế.
Proxy mode cho công cụ sẵn có
Ngược lại, proxy mode biến ScrapingBee thành một địa chỉ proxy để nhập vào công cụ chỉ biết proxy, như trình crawl có ô cấu hình proxy. Tên đăng nhập là API key, mật khẩu là chuỗi tham số. Tài liệu khuyên tắt JavaScript trong chế độ này.
Vì khóa nằm ở vị trí tên đăng nhập, mọi log in URL proxy của công cụ đều lộ khóa. Anh em cần kiểm công cụ có che mật khẩu proxy không, và chỗ khóa ở đây nằm ở phần tên đăng nhập. Nếu công cụ ghi nguyên URL proxy ra log, nên dùng HTML API thay vì proxy mode.
Dùng proxy tự mua thay cho dịch vụ tải hộ
Với trang HTML tĩnh, không có chống bot nặng, anh em có thể bỏ ScrapingBee và gọi thẳng bằng requests qua proxy. Phần thử lại, giãn cách và đổi IP tự viết không quá khó, các bài về rate limit API khi dùng proxy đã có mẫu. Chi phí khi đó là tiền proxy theo băng thông hoặc theo IP, không theo số request.
ProxyVN có proxy dân cư tĩnh, datacenter Việt Nam, datacenter US, 4G và proxy xoay, giao thức HTTP và SOCKS5, cấp tài khoản user và mật khẩu. Khi lô cần IP Việt Nam ổn định mà không cần trình duyệt, anh em có thể mua proxy tại trang chủ ProxyVN rồi so chi phí với bảng credit ở trên.
Quyết định nên dựa vào số liệu của chính lô. Chạy thử 50 URL với cả hai cách, ghi tỷ lệ thành công, thời gian và chi phí. Khi một cách thắng rõ trên cả ba chỉ số, chọn cách đó cho lô lớn.
Phân trang, lưu kết quả và đối soát dữ liệu ScrapingBee API
Một request thành công mới là phần đầu. Tác vụ thật thường có phân trang, nhiều URL chạy song song và cần đối soát kết quả. Ba mục dưới đây đi qua từng việc.
Phân trang và số request đồng thời
books.toscrape.com có 50 trang danh mục theo dạng page-1.html tới page-50.html. Anh em có thể sinh danh sách URL trước, hoặc tải trang 1 rồi đọc liên kết next. Cách đọc liên kết next an toàn hơn khi số trang thay đổi.
Mỗi gói giới hạn số request đồng thời, Hobby là 25. Vượt giới hạn thì nhận 429, mã này không tính credit. Nhóm luồng của anh em nên nhỏ hơn giới hạn gói vài đơn vị để chừa chỗ cho các tiến trình khác dùng chung khóa.
Điểm cuối /usage trả mức credit và mức đồng thời theo thời gian thực. Tài liệu ghi gọi /usage không làm tăng đồng thời nhưng chỉ được gọi 6 lần mỗi phút. Kiểm /usage trước và sau lô cho anh em con số tiêu hao thật để so với dự toán.
session_id và giữ cùng IP
Các request cùng session_id đi qua cùng một IP trong 5 phút. Tài liệu khuyên dùng số nguyên ngẫu nhiên từ 0 tới 10.000.000 cho mỗi phiên mới. Tham số này hữu ích khi trang đích gắn phiên với IP, như giỏ hàng hay luồng đăng nhập.
Với lô thu thập danh mục, giữ cùng IP thường không cần. Đổi IP mỗi request giảm khả năng bị giới hạn theo IP. Chỉ dùng session_id khi biết trang có kiểm tra IP giữa các bước.
Lưu kết quả kèm xuất xứ
Mỗi bản ghi lưu xuống nên có URL yêu cầu, Spb-resolved-url, mã trạng thái, Spb-cost, Spb-request-id và thời điểm tải. Thiếu những trường này, khi dữ liệu sai anh em không biết lỗi nằm ở trang đích, ở redirect hay ở bộ chọn. Lưu thêm tag nếu có nhiều dự án dùng chung khóa.
Với extract_rules, kiểm kiểu dữ liệu sau khi nhận. Giá sách trên trang lab có ký hiệu bảng Anh, nên chuỗi cần làm sạch trước khi đổi sang số. Trường trống là tín hiệu bộ chọn đã lệch do trang đổi cấu trúc, không nên điền giá trị mặc định cho qua.
Đối soát theo ID là cách duy nhất biết lô có thiếu bản ghi hay không. Trang chi tiết sách có mã UPC riêng, anh em dùng nó làm khóa. So số UPC duy nhất với số sách trên trang danh mục cho biết có trang nào bị bỏ sót.
Checklist và lỗi hay gặp khi dùng ScrapingBee API
Phần này gom các bước kiểm và các lỗi đã gặp trong quá trình đọc tài liệu và chạy thử. Anh em in ra và dò từng dòng trước khi chạy lô lớn. Phần lớn lỗi đều nằm ở tham số, không ở mạng.
Checklist trước khi chạy lô
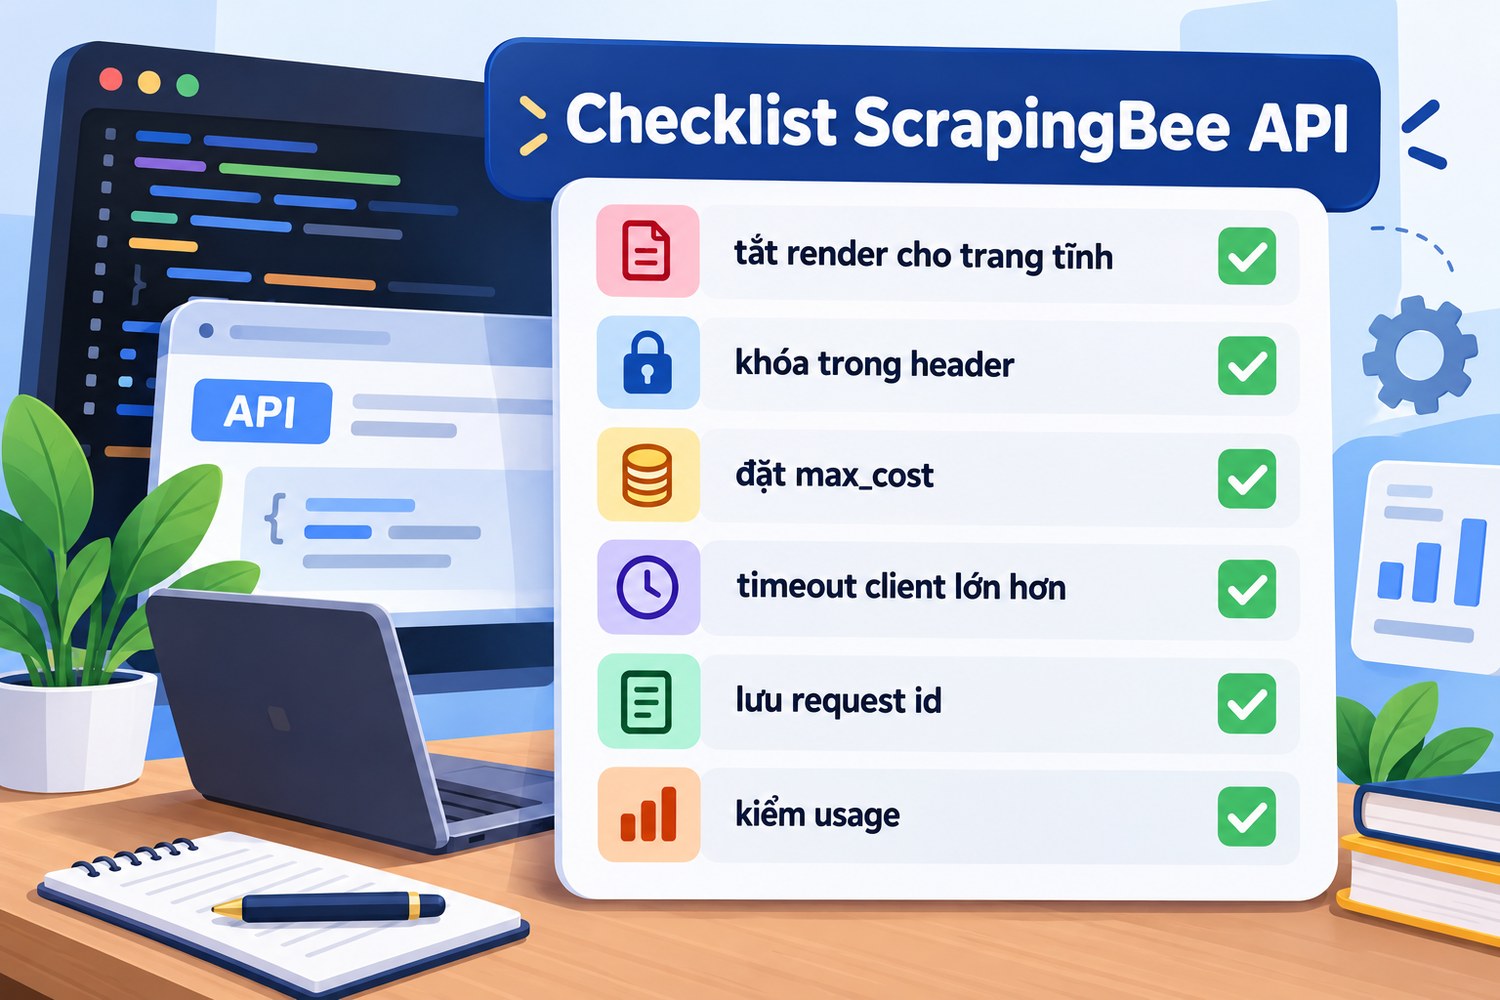
Checklist ScrapingBee API
- Ghi ngày đọc tài liệu và bảng credit vào đầu script.
- Đọc khóa từ biến môi trường, gửi qua header Authorization.
- Chạy một URL với render_js=false trước, đọc Spb-cost.
- Tính tổng credit dự kiến cho cả lô, đặt ngân sách trần.
- Nếu dùng mode=auto, đặt max_cost.
- Đặt timeout phía client lớn hơn timeout phía ScrapingBee.
- Giữ số luồng nhỏ hơn giới hạn đồng thời của gói.
- Lưu Spb-request-id, Spb-cost và tag cho mỗi bản ghi.
- Kiểm /usage trước và sau lô, so với dự toán.
Lỗi hay gặp
Lỗi thứ nhất là quên tắt render cho trang tĩnh, mỗi request tốn gấp năm lần cần thiết. Lỗi thứ hai là không mã hóa URL đích có tham số, dấu & trong URL đích làm phần sau bị hiểu thành tham số ScrapingBee. Khi đó trang trả về sai mà mã vẫn là 200.
Lỗi thứ ba là coi mọi 500 là trang đích chặn. Theo tài liệu, 500 gồm cả trường hợp không tải được và trường hợp trang trả mã không được chuyển qua. Bật transparent_status_code trên vài URL mẫu giúp biết mã thật của trang đích.
Lỗi thứ tư là tự thử lại không giới hạn khi gặp 404. Mỗi lần thử bị tính credit mà kết quả không đổi. Vòng thử lại nên chỉ áp cho 429 và 500, có giãn cách tăng dần.
Proxy không thay quyền truy cập
Dù dùng ScrapingBee hay proxy riêng, quyền thu thập dữ liệu vẫn do trang đích và pháp luật quyết định. Đổi IP không biến một trang cấm thu thập thành trang được phép. Anh em giữ phạm vi thu thập ở dữ liệu công khai, đúng điều khoản và đúng tần suất hợp lý.
Câu hỏi thường gặp về ScrapingBee API
ScrapingBee có cần proxy riêng không?
Không cần. ScrapingBee tự chọn proxy trong các bể của họ. Proxy riêng qua own_proxy chỉ cần khi anh em muốn trang đích thấy IP của mình.
Vì sao request đầu tiên tốn 5 credit?
render_js mặc định bật, nên request không tham số tốn 5 credit. Với trang tĩnh, thêm render_js=false để về 1 credit.
Request lỗi có bị trừ credit không?
Tùy mã. Theo tài liệu, 400, 401, 403, 429 và 500 không tính. 200, 404, 410 và 413 có tính. Bật transparent_status_code thì mọi mã dưới 500 đều tính.
ScrapingBee có tải được trang trên máy local không?
Không. Máy chủ ScrapingBee phải truy cập trang đích qua Internet. Trang ở 127.0.0.1 hoặc mạng nội bộ không tới được.
Có nên để API key trong JavaScript phía trình duyệt?
Không nên. Phản hồi thật có header access-control-allow-origin dấu sao, tức trình duyệt cho phép gọi từ mọi trang. Đặt khóa ở frontend thì ai mở trang cũng đọc được khóa. Hãy gọi từ máy chủ của anh em.
Giới hạn của bài
Bài chưa dùng tài khoản ScrapingBee thật. Phần chạy thật gồm script tính credit, dựng URL và hai lệnh curl không có khóa tới điểm cuối API và /usage ngày 29/10/2026. Bảng giá, mã trạng thái và hành vi tham số lấy từ tài liệu chính thức cùng ngày, cần đối chiếu lại khi ScrapingBee cập nhật.
ScrapingBee API và những điều cần nhớ
ScrapingBee API là dịch vụ tải trang hộ tính phí theo credit, không phải proxy đổi IP. Tắt render cho trang tĩnh, đặt max_cost khi dùng mode=auto, đọc header Spb-cost và Spb-request-id ở mọi phản hồi, và chỉ dùng own_proxy khi cần IP của riêng mình. Cần proxy ổn định đi kèm ScrapingBee API, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


