
Python và JavaScript cho web scraping: chọn theo đúng tác vụ
Python và JavaScript cho web scraping là câu hỏi gần như ai mới làm thu thập dữ liệu cũng gặp. ProxyVN không trả lời bằng cảm tính mà cho hai ngôn ngữ làm cùng một việc trên cùng một site thử, qua cùng một proxy có mật khẩu. Bài ghi lại code, số dòng lấy được, RAM đo thật và những lỗi chỉ lộ ra khi chạy.
Python và JavaScript cho web scraping giải quyết bài toán gì
Một scraper dù viết bằng ngôn ngữ nào cũng làm bốn việc: gửi request, nhận HTML hoặc JSON, rút dữ liệu cần lấy, rồi lưu ra file hay cơ sở dữ liệu. Ngôn ngữ chỉ quyết định anh em dùng thư viện nào cho từng việc và viết code theo kiểu nào.
Hai lớp của một scraper
Lớp thứ nhất là lớp mạng: tải trang, giữ cookie, đi qua proxy, thử lại khi lỗi. Lớp thứ hai là lớp dữ liệu: chọn phần tử bằng CSS selector hay XPath, làm sạch giá tiền, ghép nhiều trang thành một bảng.
Hai ngôn ngữ đều có công cụ tốt cho cả hai lớp. Khác biệt nằm ở chỗ hệ sinh thái nào mạnh hơn ở lớp nào, và đội của anh em đang quen hệ sinh thái nào. Ngôn ngữ ít khi là lý do một scraper chết; site đổi giao diện, IP bị chặn và dữ liệu sai định dạng mới là lý do thường gặp.
Vì sao không trả lời bằng một câu
Bài so sánh của Decodo về JavaScript và Python cũng kết luận rằng kiến trúc, proxy, cơ chế thử lại quan trọng hơn ngôn ngữ. Bài của Proxyway thì nhấn vào độ dễ học: Python dễ bắt đầu hơn với người chưa biết lập trình.
Các nhận định đó hợp lý nhưng phần lớn không kèm số đo. Mình làm thêm một bước: dựng một site thử có trang tĩnh và trang dựng bằng JavaScript, đặt một proxy có xác thực ở giữa, rồi cho mỗi ngôn ngữ chạy ba lần. Kết quả bên dưới chỉ đúng cho môi trường thử này, nhưng đủ để thấy những điểm khác biệt thật khi bắt tay vào code.
Phạm vi bài này
Bài tập trung vào ba câu hỏi. Cùng một tác vụ, code hai bên dài ngắn ra sao và lỗi dễ gặp là gì. Với trang dựng bằng JavaScript, mỗi bên xử lý thế nào. RAM và cách vận hành khác nhau tới đâu khi có thêm trình duyệt.
Bài không so tốc độ tải trang qua Internet. Trên site chạy ngay trong máy, thời gian đo được chủ yếu phản ánh độ trễ cục bộ, không phản ánh ngôn ngữ nào nhanh hơn khi đi qua mạng thật. Mình ghi số đo thời gian cho đủ, nhưng anh em không nên dùng nó để kết luận về tốc độ.
So sánh Python và JavaScript cho web scraping theo thư viện
Mỗi bước của scraper đều có thư viện tương ứng ở hai bên. Bảng dưới xếp chúng theo vai trò để anh em dễ đối chiếu, sau đó là phần giải thích những chỗ khác nhau đáng để ý.
Vai trò |
Python |
JavaScript (Node.js) |
|---|---|---|
Gửi request HTTP |
requests, httpx |
fetch tích hợp, undici, axios |
Phân tích HTML |
BeautifulSoup, lxml, parsel |
Cheerio |
Điều khiển trình duyệt |
Playwright, Selenium |
Playwright, Puppeteer |
Khung crawl đầy đủ |
Scrapy |
Crawlee |
Chạy song song |
asyncio với httpx hoặc aiohttp |
Vòng lặp sự kiện có sẵn, Promise.all |
Xử lý dữ liệu sau khi lấy |
pandas, NumPy |
Chủ yếu xuất JSON để xử lý tiếp |
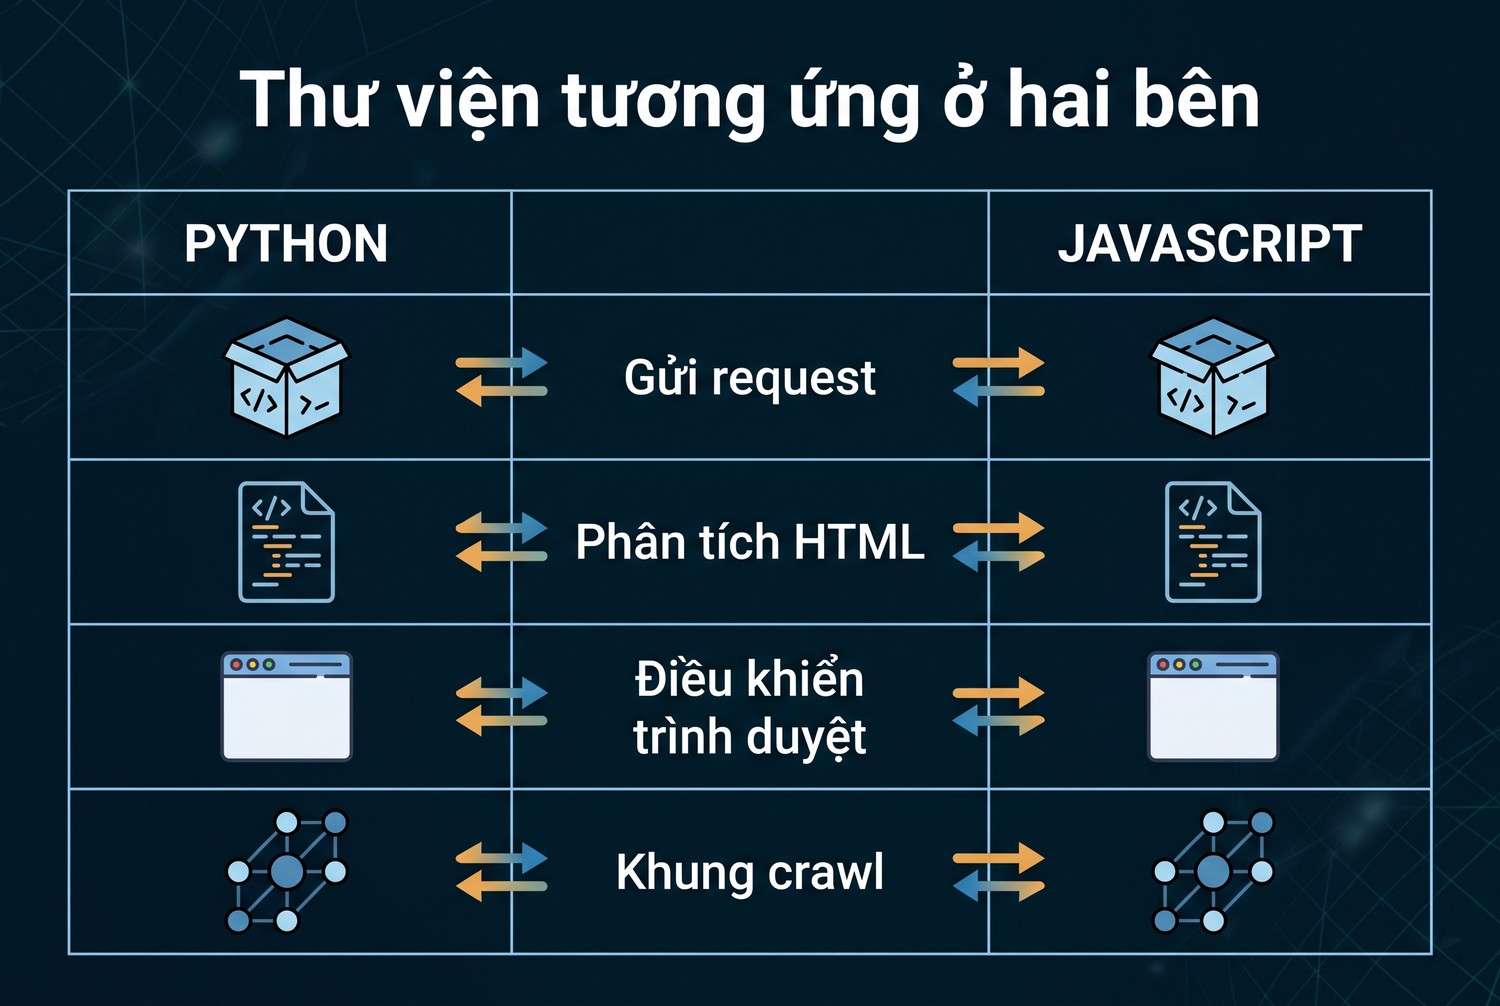
Thư viện tương ứng ở hai bên
Lớp gửi request
Bên Python, requests là lựa chọn quen thuộc nhất, khai báo proxy qua một dict có khóa http và https. Bên Node.js, từ bản 18 đã có fetch tích hợp, nhưng muốn đi qua proxy thì cần ProxyAgent của undici, truyền vào tham số dispatcher.
Khác biệt nhỏ này gây ra lỗi thật trong bài thử, phần ví dụ sẽ nói chi tiết. Với người mới, cách khai báo proxy của requests dễ hiểu hơn, vì chỉ là một chuỗi URL có tài khoản. Bài cài đặt proxy trong thư viện requests có thêm các cách khai báo khác.
Lớp phân tích HTML
BeautifulSoup và Cheerio có cách dùng rất giống nhau: nạp HTML, chọn phần tử bằng CSS selector, lấy chữ hoặc thuộc tính. Cheerio dùng cú pháp kiểu jQuery với dấu đô la, BeautifulSoup dùng select và select_one.
Trong bài thử, hai đoạn phân tích có số dòng gần bằng nhau. Nếu cần XPath, Python có lxml hỗ trợ trực tiếp, còn Cheerio chỉ làm việc với CSS selector. Đây là điểm cộng cho Python khi trang có cấu trúc khó chọn bằng CSS.
Lớp trình duyệt
Playwright có bản cho cả hai ngôn ngữ, cùng điều khiển một nhân trình duyệt. Bản Python thực chất gọi xuống một driver viết bằng Node.js, nên với trình duyệt, hai bên gần như dùng chung một bộ máy.
Lợi thế của JavaScript ở lớp này là anh em viết luôn code chạy trong trang bằng page.evaluate, cùng ngôn ngữ với trang. Bên Python cũng gọi được evaluate, nhưng phần code chạy trong trang vẫn phải viết bằng JavaScript dưới dạng chuỗi.
Khung crawl và xử lý dữ liệu
Scrapy gom lập lịch, thử lại, giới hạn tốc độ và pipeline lưu dữ liệu vào một khung, có tài liệu dày và cộng đồng lâu năm. Crawlee là khung tương tự bên Node.js, mạnh ở phần quản lý trình duyệt và hàng đợi.
Sau khi lấy được dữ liệu, Python có pandas để làm sạch, gộp, thống kê ngay trong cùng một script. Bên JavaScript thường xuất JSON rồi chuyển sang công cụ khác. Nếu dữ liệu đi tiếp vào phân tích hay mô hình, Python giữ được cả quy trình trong một ngôn ngữ.
Chuẩn bị môi trường thử Python và JavaScript cho web scraping
Để so sánh công bằng, hai bên phải làm cùng một tác vụ, trên cùng một site, qua cùng một proxy. Mình dựng mọi thứ trên một máy Windows 10, không gọi ra Internet, để kết quả không bị ảnh hưởng bởi mạng.
Phiên bản đã dùng
Ghi rõ phiên bản là bước hay bị bỏ qua, nhưng nó quyết định code có chạy lại được hay không. Bài thử dùng các phiên bản sau, kiểm tra ngày 25/10/2026:
- Python 3.12.10, requests 2.34.2, beautifulsoup4 4.15.0, lxml 6.1.3.
- Node.js 24.20.0, undici 7.30.1, cheerio 1.2.0.
- Playwright 1.64.1 cho cả Python và Node.js, điều khiển Microsoft Edge 156 ở chế độ headless.
Edge có sẵn trên Windows nên mình dùng tham số channel là msedge, không phải tải thêm trình duyệt. Trên máy chủ Linux, anh em thường cài Chromium qua lệnh cài trình duyệt của Playwright.
Site thử và dữ liệu mẫu
Site thử có 100 sản phẩm, chia thành 5 trang danh sách, mỗi trang 20 sản phẩm và một liên kết sang trang sau. Mỗi sản phẩm có tên và giá dạng 101,500đ, phải làm sạch thành số nguyên.
Site còn một trang dựng bằng JavaScript: HTML ban đầu chỉ có một thẻ ul rỗng, script trong trang gọi API trả JSON rồi mới chèn danh sách vào. Đây là mô hình phổ biến của các trang bán hàng và trang tin hiện nay.
Proxy có mật khẩu chứa ký tự đặc biệt
Giữa scraper và site là một proxy HTTP tự dựng, yêu cầu tài khoản user1 và mật khẩu p@ss#2026. Mình cố ý chọn mật khẩu có dấu @ và dấu thăng, vì đây là hai ký tự làm hỏng URL proxy nếu ghép tay.
Proxy ghi lại mọi request: URL, có xác thực đúng hay không, User-Agent. Nhờ vậy mình biết request nào thật sự đi qua proxy, thay vì chỉ tin rằng code đã khai báo đúng. Muốn biết scraper có đi qua proxy không, hãy xem log phía proxy hoặc IP mà site nhìn thấy, đừng chỉ nhìn code.
Ví dụ trang tĩnh với Python và JavaScript cho web scraping
Tác vụ đầu tiên là lấy hết 100 sản phẩm qua 5 trang danh sách, làm sạch giá thành số, đi theo liên kết trang sau cho tới khi hết. Hai đoạn code dưới làm đúng việc này, mỗi bên dùng bộ thư viện phổ biến nhất của mình.
Bản Python với requests và BeautifulSoup
Đoạn Python dùng một Session để giữ kết nối và header, mã hóa mật khẩu bằng quote trước khi ghép vào URL proxy. Hàm crawl lặp qua từng trang, lấy tên và giá, rồi tìm liên kết có class next.
from urllib.parse import quote, urljoin
import requests
from bs4 import BeautifulSoup

PROXY_USER, PROXY_PASS = "user1", "p@ss#2026"  # mật khẩu có @ và #
PROXY = f"http://{quote(PROXY_USER)}:{quote(PROXY_PASS, safe='')}@127.0.0.1:8782"
proxies = {"http": PROXY, "https": PROXY}

def crawl(start):
    s = requests.Session()
    s.headers["User-Agent"] = "t21-python"
    url, rows = start, []
    while url:
        r = s.get(url, proxies=proxies, timeout=15)
        r.raise_for_status()
        soup = BeautifulSoup(r.text, "lxml")
        for li in soup.select("li.item"):
            price = li.select_one(".price").get_text(strip=True)
            rows.append({"name": li.select_one(".name").get_text(strip=True),
                         "price": int(price.replace(",", "").replace("đ", ""))})
        nxt = soup.select_one("a.next")
        url = urljoin(url, nxt["href"]) if nxt else None
    return rows

rows = crawl("http://127.0.0.1:8781/products?page=1")
Chạy ba lần, lần nào cũng ra 100 dòng, dòng đầu là San pham 1 giá 101500, dòng cuối là San pham 100 giá 250000. Log proxy cho thấy mọi request đều có xác thực đúng. Tham số safe rỗng trong quote là chi tiết quan trọng: thiếu nó, dấu gạch chéo trong mật khẩu sẽ không được mã hóa.
Bản JavaScript với undici và Cheerio
Đoạn Node.js dùng fetch và ProxyAgent của undici, truyền tài khoản qua tham số token dạng Basic. Cách này tránh hẳn việc ghép mật khẩu vào URL, nên ký tự đặc biệt không còn là vấn đề.
import { ProxyAgent, fetch } from "undici";
import * as cheerio from "cheerio";

const user = "user1", pass = "p@ss#2026"; // mật khẩu có @ và #
const dispatcher = new ProxyAgent({
  uri: "http://127.0.0.1:8782",
  token: "Basic " + Buffer.from(`${user}:${pass}`).toString("base64"),
});
const headers = { "User-Agent": "t21-node" };

async function crawl(start) {
  let url = start;
  const rows = [];
  while (url) {
    const r = await fetch(url, { dispatcher, headers });
    if (!r.ok) throw new Error(`HTTP ${r.status}`);
    const $ = cheerio.load(await r.text());
    $("li.item").each((_, el) => {
      const price = $(el).find(".price").text().trim();
      rows.push({ name: $(el).find(".name").text().trim(), price: Number(price.replace(/[,đ]/g, "")) });
    });
    const next = $("a.next").attr("href");
    url = next ? new URL(next, url).href : null;
  }
  return rows;
}

const rows = await crawl("http://127.0.0.1:8781/products?page=1");
Kết quả cũng là 100 dòng, dòng đầu và dòng cuối khớp với bản Python. Về độ dài, hai đoạn chênh nhau vài dòng, không đáng kể. Phần khác biệt đáng nói nằm ở lần chạy đầu tiên, khi đoạn này báo lỗi.
Lỗi 501 khi ProxyAgent mở đường hầm
Lần chạy đầu, bản Node.js dừng ngay với thông báo Proxy response (501) !== 200 when HTTP Tunneling. Nguyên nhân là ProxyAgent của undici dùng phương thức CONNECT để mở đường hầm qua proxy, kể cả khi URL đích là http chứ không phải https.
Proxy tự dựng ban đầu chỉ hỗ trợ kiểu chuyển tiếp thường, không hỗ trợ CONNECT, nên trả 501. Bản Python với requests không gặp lỗi này vì requests gửi thẳng URL đầy đủ tới proxy khi đích là http. Sau khi thêm CONNECT cho proxy, bản Node.js chạy đúng ở cả ba lần.
Bài học thực tế là cùng một proxy có thể chạy được với ngôn ngữ này mà lỗi với ngôn ngữ kia, vì mỗi thư viện đi qua proxy theo một kiểu. Proxy thương mại thường hỗ trợ cả hai kiểu, nhưng proxy nội bộ hoặc proxy công ty đôi khi chặn CONNECT. Khi đổi ngôn ngữ hoặc đổi thư viện, hãy kiểm lại kết nối proxy từ đầu, đừng mặc định cấu hình cũ vẫn đúng.
Mật khẩu chứa ký tự đặc biệt
Nếu bỏ hàm quote và ghép thẳng p@ss#2026 vào URL proxy, dấu @ đầu tiên bị hiểu là chỗ kết thúc phần tài khoản, còn dấu thăng bị hiểu là bắt đầu phần fragment. Kết quả là scraper gửi sai tài khoản hoặc gửi tới sai máy chủ, và lỗi trả về thường chỉ là 407 hay lỗi phân giải tên miền, rất khó đoán ra nguyên nhân.
Hai cách an toàn là mã hóa từng phần bằng quote như bản Python, hoặc truyền tài khoản qua tham số riêng như token của undici. Bài định dạng proxy hướng dẫn tách đúng các phần ip, port, user, pass từ chuỗi nhà cung cấp gửi.
Trang động: Python và JavaScript cho web scraping khi nội dung do JS dựng
Tác vụ thứ hai là lấy danh sách sản phẩm trên trang dựng bằng JavaScript. Đây là chỗ nhiều người nghĩ phải dùng JavaScript mới làm được, nhưng bài thử cho thấy câu chuyện khác.
Tải HTML thô sẽ không thấy dữ liệu
Cả hai bản requests và fetch khi tải trang /app đều nhận về HTML có thẻ ul rỗng. Đếm phần tử li.item, cả hai đều ra 0. Lý do đơn giản: requests và fetch chỉ tải HTML, không chạy script trong trang, nên không có bước chèn dữ liệu.
Đây là lỗi kinh điển của người mới, và nó không phụ thuộc ngôn ngữ. Cheerio là thư viện JavaScript nhưng cũng không chạy JavaScript của trang, cách làm việc giống hệt BeautifulSoup.
Gọi thẳng API mà trang đang dùng
Mở công cụ nhà phát triển của trình duyệt, thẻ Network, lọc Fetch/XHR, anh em sẽ thấy trang gọi /api/products và nhận JSON. Gọi thẳng địa chỉ này qua proxy, cả hai bản đều nhận đủ 20 sản phẩm, không cần trình duyệt.
Cách này nhẹ nhất và ít hỏng nhất khi giao diện đổi, vì API thường ổn định hơn HTML. Hạn chế là nhiều API cần token, cookie hoặc chữ ký sinh ra trong trang, khi đó mới cần tới trình duyệt. Trước khi gọi API, anh em đọc điều khoản của site để chắc việc truy cập được phép.
Dùng Playwright khi buộc phải chạy trang
Khi không gọi được API trực tiếp, Playwright mở trang trong trình duyệt thật, chờ script chạy xong rồi mới đọc dữ liệu. Đoạn Python dưới khai báo proxy có tài khoản ngay khi khởi động trình duyệt.
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    b = p.chromium.launch(channel="msedge", headless=True,
                          proxy={"server": "http://127.0.0.1:8782",
                                 "username": "user1", "password": "p@ss#2026",
                                 "bypass": "<-loopback>"})
    page = b.new_page()
    page.goto("http://127.0.0.1:8781/app")
    page.wait_for_selector("li.item")
    names = page.locator("li.item .name").all_inner_texts()
    b.close()
Bản Node.js gần như dịch từng dòng, chỉ khác cú pháp await. Điểm cộng là gọi page.evaluate với một hàm JavaScript bình thường, có gợi ý code trong trình soạn thảo, thay vì viết chuỗi như bên Python.
import { chromium } from "playwright-core";

const b = await chromium.launch({ channel: "msedge", headless: true,
  proxy: { server: "http://127.0.0.1:8782", username: "user1", password: "p@ss#2026", bypass: "<-loopback>" } });
const page = await b.newPage();
await page.goto("http://127.0.0.1:8781/app");
await page.waitForSelector("li.item");
const names = await page.locator("li.item .name").allInnerTexts();
const n = await page.evaluate(() => document.querySelectorAll("li.item").length);
await b.close();
Cả hai đều lấy được 20 sản phẩm. Mình có đặt thêm tham số bypass với giá trị đặc biệt <-loopback> để chắc địa chỉ 127.0.0.1 của site thử đi qua proxy. Chạy lại không có tham số này, Playwright 1.64.1 vẫn cho request đi qua proxy, nên với site thật anh em không cần đặt nó.
Trình duyệt gửi tài khoản sau lần 407 đầu
Log proxy cho thấy một chi tiết đáng biết: request đầu tiên của trình duyệt tới trang /app không có tài khoản, proxy trả 407, trình duyệt gửi lại kèm tài khoản và lần này thành công. Với requests và undici, tài khoản đi kèm ngay từ request đầu.
Trong log của nhà cung cấp proxy, anh em có thể thấy một lượng request 407 đều đặn khi chạy Playwright. Đó là hành vi bình thường của trình duyệt, không phải sai mật khẩu. Chỉ khi 407 lặp lại liên tục cho cùng một request mới là dấu hiệu cấu hình sai, theo hướng dẫn proxy trong tài liệu mạng của Playwright.
RAM, tốc độ và vận hành của Python và JavaScript cho web scraping
Mình đo RAM bằng cách cộng bộ nhớ thường trú của tiến trình chính và mọi tiến trình con, lấy mẫu mỗi 20 mili giây, giữ giá trị lớn nhất. Cách đo này tính cả các tiến trình trình duyệt mà Playwright mở ra, nên phản ánh đúng chi phí trên máy chủ.
Cách chạy |
Kết quả |
RAM đỉnh cả cây tiến trình |
Thời gian ghi nhận |
|---|---|---|---|
Python requests và BeautifulSoup, trang tĩnh |
100/100 dòng |
32–33 MB |
0,03–0,08 giây |
Node.js undici và Cheerio, trang tĩnh |
100/100 dòng |
65–73 MB |
0,07 giây |
Python Playwright với Edge headless, trang động |
20/20 dòng |
506–533 MB |
0,61–0,62 giây |
Node.js Playwright với Edge headless, trang động |
20/20 dòng |
463–485 MB |
0,54–0,67 giây |
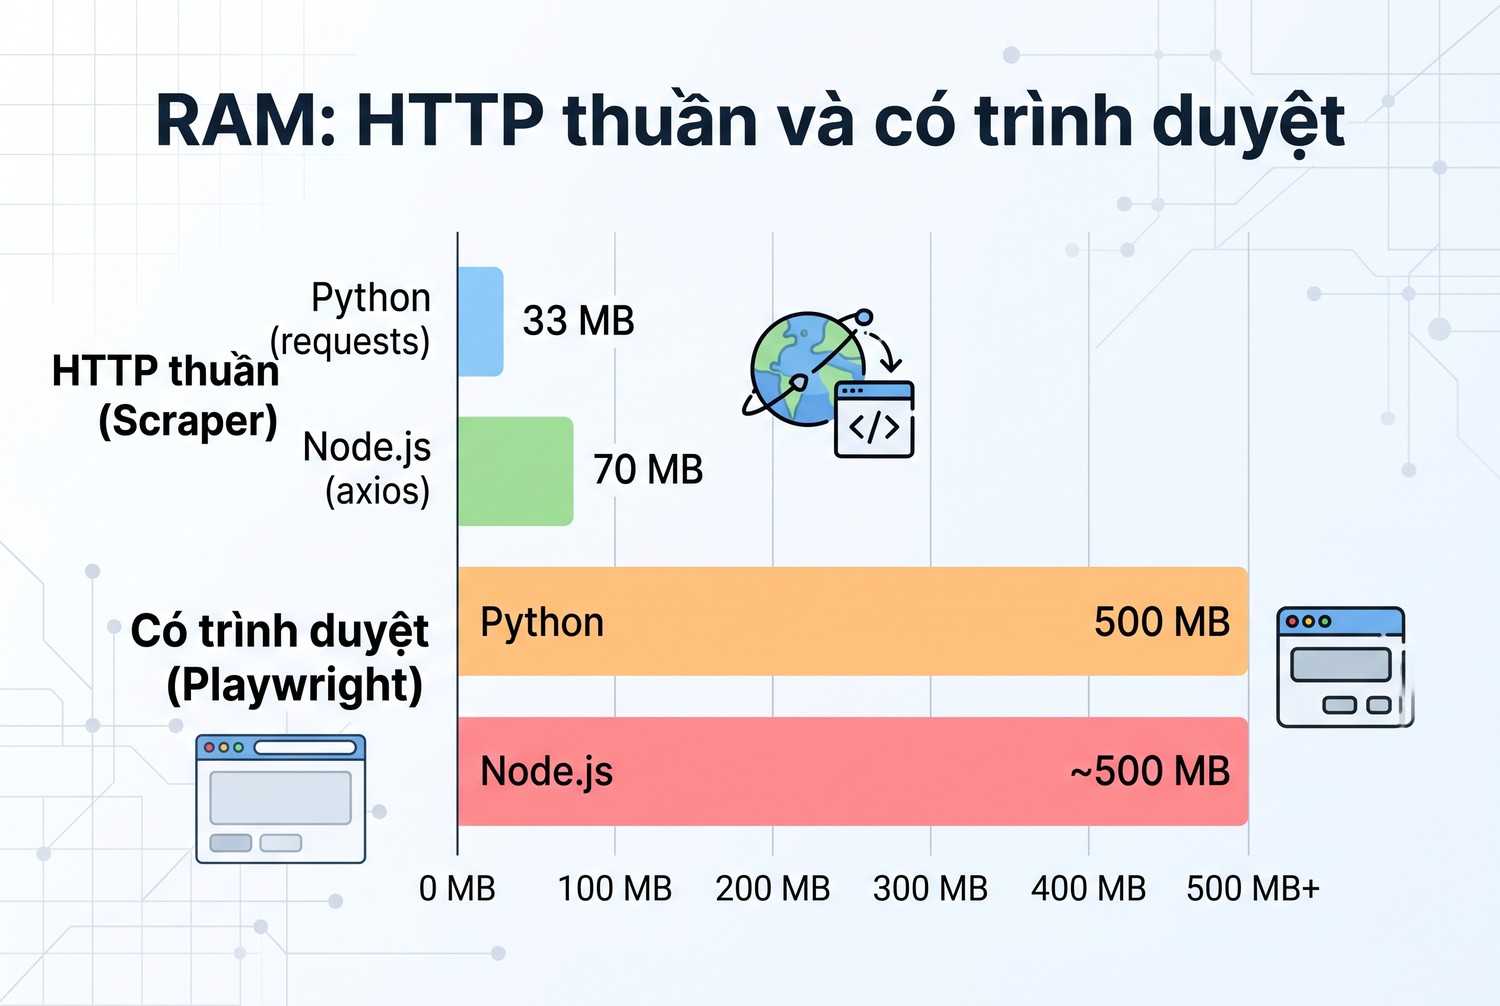
RAM: HTTP thuần và có trình duyệt
Đọc số đo RAM cho đúng
Với scraper HTTP thuần, trong bài thử này tiến trình Python dùng khoảng một nửa RAM so với Node.js. Con số này ngược với nhận định phổ biến rằng Node.js nhẹ hơn cho request thuần. Lý do có thể là bản thân môi trường chạy Node.js khởi động với bộ nhớ nền lớn hơn, còn scraper ở đây quá nhỏ để thấy lợi thế xử lý nhiều kết nối.
Mình không kết luận Python nhẹ hơn trong mọi trường hợp. Với hàng nghìn kết nối đồng thời, kết quả có thể khác. Điều chắc hơn là khi có trình duyệt, RAM tăng lên khoảng 15 lần so với scraper HTTP và chênh lệch giữa hai ngôn ngữ chỉ còn vài chục MB, vì trình duyệt chiếm gần hết.
Đừng dùng số thời gian ở đây để so tốc độ
Thời gian trong bảng là trên site chạy cùng máy, mỗi request chỉ mất vài mili giây. Khi đi qua Internet và proxy thật, mỗi request mất hàng trăm mili giây, và thời gian chờ mạng lấn át mọi khác biệt về tốc độ chạy code.
Scraping chủ yếu là chờ mạng. Muốn nhanh hơn, anh em tăng số request chạy song song trong giới hạn site cho phép và chọn proxy có độ trễ thấp, chứ không phải đổi ngôn ngữ. Thứ tự ưu tiên khi cần nhanh là giảm request thừa, chạy song song có kiểm soát, rồi mới tới chuyện ngôn ngữ.
Chạy song song ở mỗi bên
Node.js chạy bất đồng bộ ngay từ đầu, gom nhiều request bằng Promise.all là xong. Python cần chuyển sang asyncio và một thư viện hỗ trợ bất đồng bộ như httpx, nhưng một khi đã chuyển thì cách viết rất giống nhau.
import asyncio
import httpx

async def fetch_all(urls, proxy):
    sem = asyncio.Semaphore(5)  # tối đa 5 request cùng lúc
    async with httpx.AsyncClient(proxy=proxy, timeout=15) as client:
        async def one(u):
            async with sem:
                r = await client.get(u)
                r.raise_for_status()
                return r.text
        return await asyncio.gather(*(one(u) for u in urls))
Semaphore giới hạn số request cùng lúc là chi tiết không được bỏ. Gửi dồn hàng trăm request vào một site là cách nhanh nhất để bị chặn IP, dù dùng ngôn ngữ nào. Bên Node.js, anh em có thể dùng thư viện p-limit hoặc tự chia mảng URL thành từng lô.
Vận hành và bảo trì lâu dài
Cả hai ngôn ngữ đều đóng gói Docker dễ, chạy được với cron, GitHub Actions hay Kubernetes. Phần tốn công nhất về lâu dài là sửa selector khi site đổi giao diện, cập nhật thư viện và trình duyệt, theo dõi tỷ lệ lỗi.
Một scraper do người quen ngôn ngữ đó bảo trì sẽ được sửa nhanh hơn nhiều so với scraper viết bằng ngôn ngữ cả đội không ai rành. Đây thường là yếu tố quyết định quan trọng nhất, quan trọng hơn mọi số đo phía trên.
Xử lý lỗi và kiểm tra dữ liệu với Python và JavaScript cho web scraping
Scraper chạy được một lần chưa phải scraper dùng được. Phần này gom các lỗi hay gặp và cách kiểm dữ liệu đầu ra, áp dụng như nhau cho cả hai ngôn ngữ.
Những mã lỗi cần xử lý riêng
Mỗi mã lỗi nói một điều khác nhau, nên xử lý chung một kiểu là sai. Danh sách dưới là cách mình phân loại khi viết phần thử lại:
- 407: proxy từ chối tài khoản. Kiểm lại user, pass và cách mã hóa ký tự đặc biệt, không thử lại liên tục.
- 403: site chặn. Thường do IP, User-Agent hoặc tốc độ, cần đổi IP hoặc giảm tốc chứ thử lại ngay vô ích.
- 429: gửi quá nhanh. Đọc header Retry-After nếu có, chờ đúng thời gian đó rồi mới gửi tiếp.
- 500, 502, 503: lỗi phía máy chủ hoặc proxy. Thử lại vài lần với thời gian chờ tăng dần.
- Lỗi kết nối, hết thời gian chờ: thường do proxy chậm hoặc chết, ghi lại proxy nào lỗi để loại khỏi danh sách.
Thử lại có giới hạn
Đoạn Python dưới là ví dụ triển khai phần thử lại cho các lỗi tạm thời, chờ tăng dần và cộng thêm một khoảng ngẫu nhiên để các request không dồn vào cùng một lúc. Bên Node.js viết tương tự với vòng lặp và setTimeout.
import random, time
import requests

RETRY = {429, 500, 502, 503, 504}

def get_with_retry(s, url, proxies, tries=4):
    for i in range(tries):
        try:
            r = s.get(url, proxies=proxies, timeout=15)
        except requests.RequestException:
            r = None
        if r is not None and r.status_code not in RETRY:
            return r
        wait = float(r.headers.get("Retry-After", 0)) if r is not None else 0
        time.sleep(max(wait, 2 ** i) + random.uniform(0, 1))
    raise RuntimeError(f"Hết lượt thử: {url}")
Hàm trả về ngay với 403 và 407 vì đó không phải lỗi tạm thời, phần gọi hàm sẽ quyết định đổi proxy hay dừng. Header Retry-After ở đây được đọc theo dạng số giây, dạng phổ biến nhất; nếu site trả dạng ngày giờ thì anh em cần đổi sang số giây trước khi chờ.
Kiểm dữ liệu đầu ra
Scraper không báo lỗi vẫn có thể trả dữ liệu sai: trang đổi class, giá đổi định dạng, một trang bị chặn trả về trang xác minh thay vì danh sách. Mình luôn đặt vài điều kiện kiểm ở cuối mỗi lần chạy.
- Số dòng: trang thử có 100 sản phẩm, ra ít hơn là có trang bị bỏ sót.
- Trường bắt buộc: tên không rỗng, giá là số dương.
- Trùng lặp: cùng một sản phẩm xuất hiện hai lần thường do phân trang lỗi.
- Biên độ: giá thấp bất thường so với lần chạy trước có thể là lỗi tách số, không phải giảm giá thật.
Trong bài thử, cả hai bản đều qua các điều kiện này. Khi chạy với site thật, mình lưu cả HTML của trang lỗi để xem lại, vì nhìn HTML nhanh hơn đoán nguyên nhân từ log.
Gắn proxy cho Python và JavaScript cho web scraping và checklist chạy thật
Proxy không phụ thuộc ngôn ngữ, nhưng cách khai báo và hành vi thì phụ thuộc thư viện như phần ví dụ đã cho thấy. Phần này nói khi nào cần proxy, chọn loại nào, và những bước kiểm trước khi chạy với site thật.
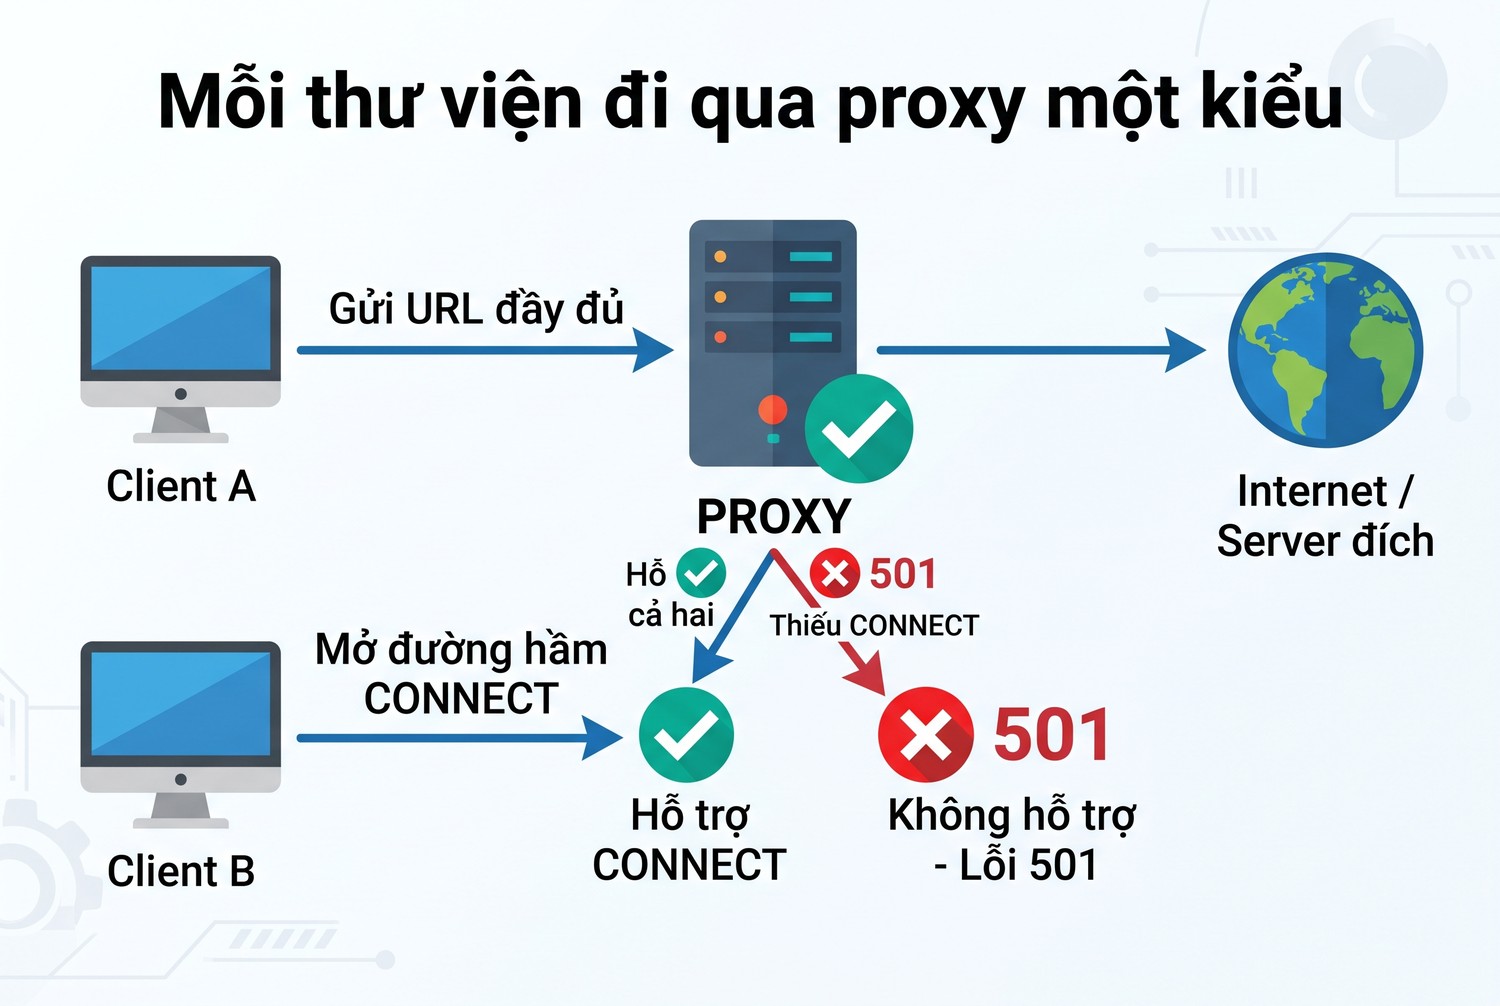
Mỗi thư viện đi qua proxy một kiểu
Khi nào scraper cần proxy
Scraper chạy vài chục request mỗi ngày tới một site không chặn thì chưa cần proxy. Proxy trở nên cần thiết khi số request lớn tới mức site giới hạn theo IP, khi nội dung khác nhau theo vùng, hoặc khi anh em cần tách lưu lượng scraper khỏi IP văn phòng.
Bài web scraping proxy là gì giải thích cơ chế chung. Với crawl nhiều site, bài proxy pool hướng dẫn chia proxy theo mục đích để IP dùng cho crawl không làm ảnh hưởng IP dùng cho tài khoản.
Chọn loại proxy theo site
Site tĩnh, ít chống bot thường chạy ổn với proxy datacenter, rẻ và nhanh. Site có hệ thống chống bot, hoặc cần IP giống người dùng thật ở Việt Nam, phù hợp hơn với proxy dân cư hoặc 4G. Với tác vụ cần giữ phiên đăng nhập qua nhiều bước, chọn IP tĩnh để phiên không bị đứt giữa chừng.
Khi cần mua proxy cho scraper Python hay Node.js, ProxyVN có proxy dân cư tĩnh Viettel, VNPT, FPT, datacenter Việt Nam, proxy 4G và proxy xoay, giao thức HTTP hoặc SOCKS5, cấp user và password. Anh em nên thử kết nối bằng đúng thư viện sẽ dùng trước khi chạy số lượng lớn, vì như bài thử cho thấy, mỗi thư viện đi qua proxy theo một kiểu.
Checklist trước khi chạy với site thật
Danh sách dưới là các bước mình làm trước mỗi dự án mới, dùng được cho cả hai ngôn ngữ:
- Ghi rõ phiên bản ngôn ngữ, thư viện và trình duyệt vào file cấu hình dự án.
- Đọc robots.txt và điều khoản sử dụng của site, chỉ lấy dữ liệu công khai được phép.
- Thử proxy bằng đúng thư viện sẽ dùng, xem IP mà site nhìn thấy, không chỉ xem code.
- Mã hóa mật khẩu proxy có ký tự đặc biệt, hoặc truyền tài khoản qua tham số riêng.
- Kiểm trang có cần chạy JavaScript không; nếu có API thì ưu tiên gọi API.
- Giới hạn số request cùng lúc và thêm thời gian chờ giữa các request.
- Xử lý riêng 403, 407, 429 và lỗi máy chủ; ghi log proxy nào lỗi.
- Đặt điều kiện kiểm dữ liệu đầu ra: số dòng, trường bắt buộc, trùng lặp.
Chọn ngôn ngữ mà người bảo trì scraper rành nhất. Proxy, giới hạn tốc độ và kiểm dữ liệu mới quyết định scraper sống được bao lâu.
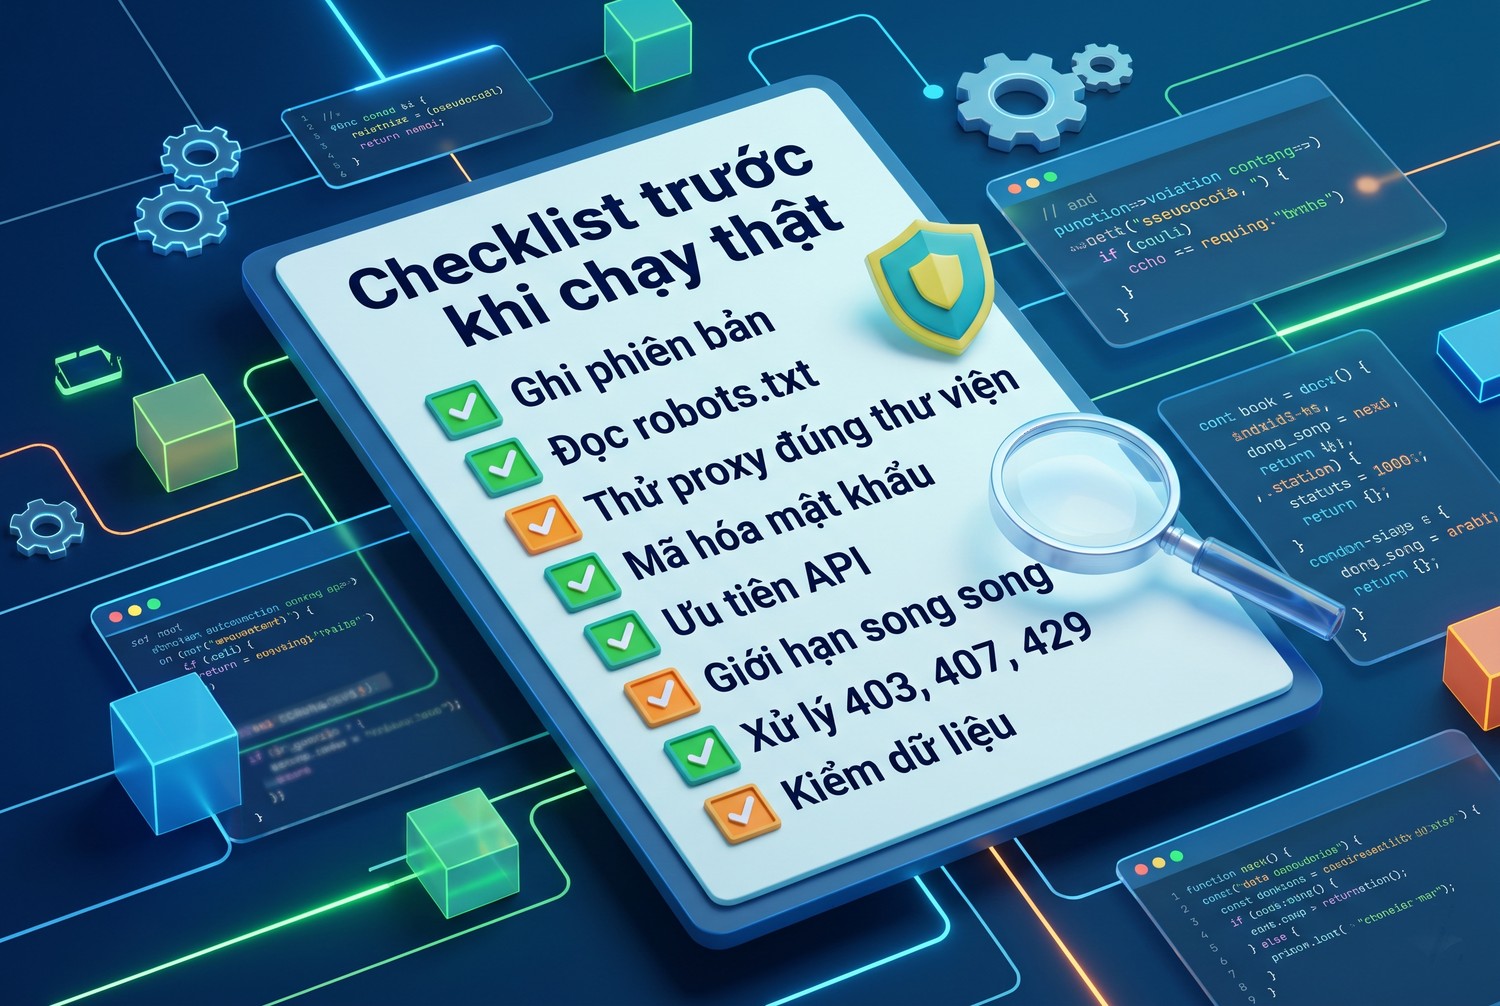
Checklist trước khi chạy thật
Câu hỏi thường gặp
Người mới nên học Python hay JavaScript để làm scraping. Nếu chưa biết ngôn ngữ nào, Python dễ bắt đầu hơn và có pandas để xử lý dữ liệu sau khi lấy. Nếu đã làm web bằng JavaScript, cứ dùng Node.js, không cần học thêm một ngôn ngữ chỉ để scraping.
Trang dựng bằng React hay Vue có bắt buộc dùng JavaScript không. Không. Python với Playwright điều khiển cùng một trình duyệt như Node.js. Trước khi mở trình duyệt, hãy xem trang có gọi API trả JSON không, vì gọi thẳng API nhẹ hơn nhiều.
Có nên dùng cả hai ngôn ngữ trong một dự án không. Nhiều đội dùng Node.js với Playwright cho phần lấy trang khó, rồi chuyển JSON sang Python để làm sạch và phân tích. Cách này hợp khi đội có người rành cả hai, còn nếu không, một ngôn ngữ sẽ dễ bảo trì hơn.
Scrapy hay Crawlee tốt hơn. Hai khung có mục tiêu giống nhau. Scrapy mạnh ở crawl HTTP quy mô lớn và pipeline dữ liệu, Crawlee mạnh ở phần quản lý trình duyệt. Bài proxy Scrapy và bài proxy cho Crawlee hướng dẫn gắn proxy cho từng khung.
Python và JavaScript cho web scraping, chọn sao cho hợp
Python và JavaScript cho web scraping đều lấy đủ dữ liệu trong bài thử. Python gọn cho trang tĩnh và xử lý dữ liệu, JavaScript tiện khi làm việc sâu với trình duyệt. Chọn theo người bảo trì, thử proxy bằng đúng thư viện. Cần proxy ổn định, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam cho Python và JavaScript cho web scraping.


