
Proxy Cho Crawlee: Gắn IP Và Quản Lý Session Khi Crawl
Proxy cho Crawlee là mảnh ghép còn thiếu khi thư viện này đã lo xong hàng đợi, thử lại và điều khiển trình duyệt. Mọi yêu cầu đi ra từ cùng một địa chỉ IP vẫn là lý do khiến công cụ thu thập bị chặn nhanh nhất. Bài viết của ProxyVN hướng dẫn khai báo proxy, giữ phiên, dùng proxy phân tầng và kiểm tra, kèm mã cho cả Node.js lẫn Python.
Proxy cho Crawlee đảm nhận vai trò gì
Crawlee là thư viện mã nguồn mở để thu thập dữ liệu web và tự động hóa trình duyệt. Theo bài hướng dẫn của IPRoyal, thư viện này kết hợp cả yêu cầu HTTP lẫn trình duyệt không giao diện, nên xử lý được trang tĩnh và trang dựng bằng JavaScript.
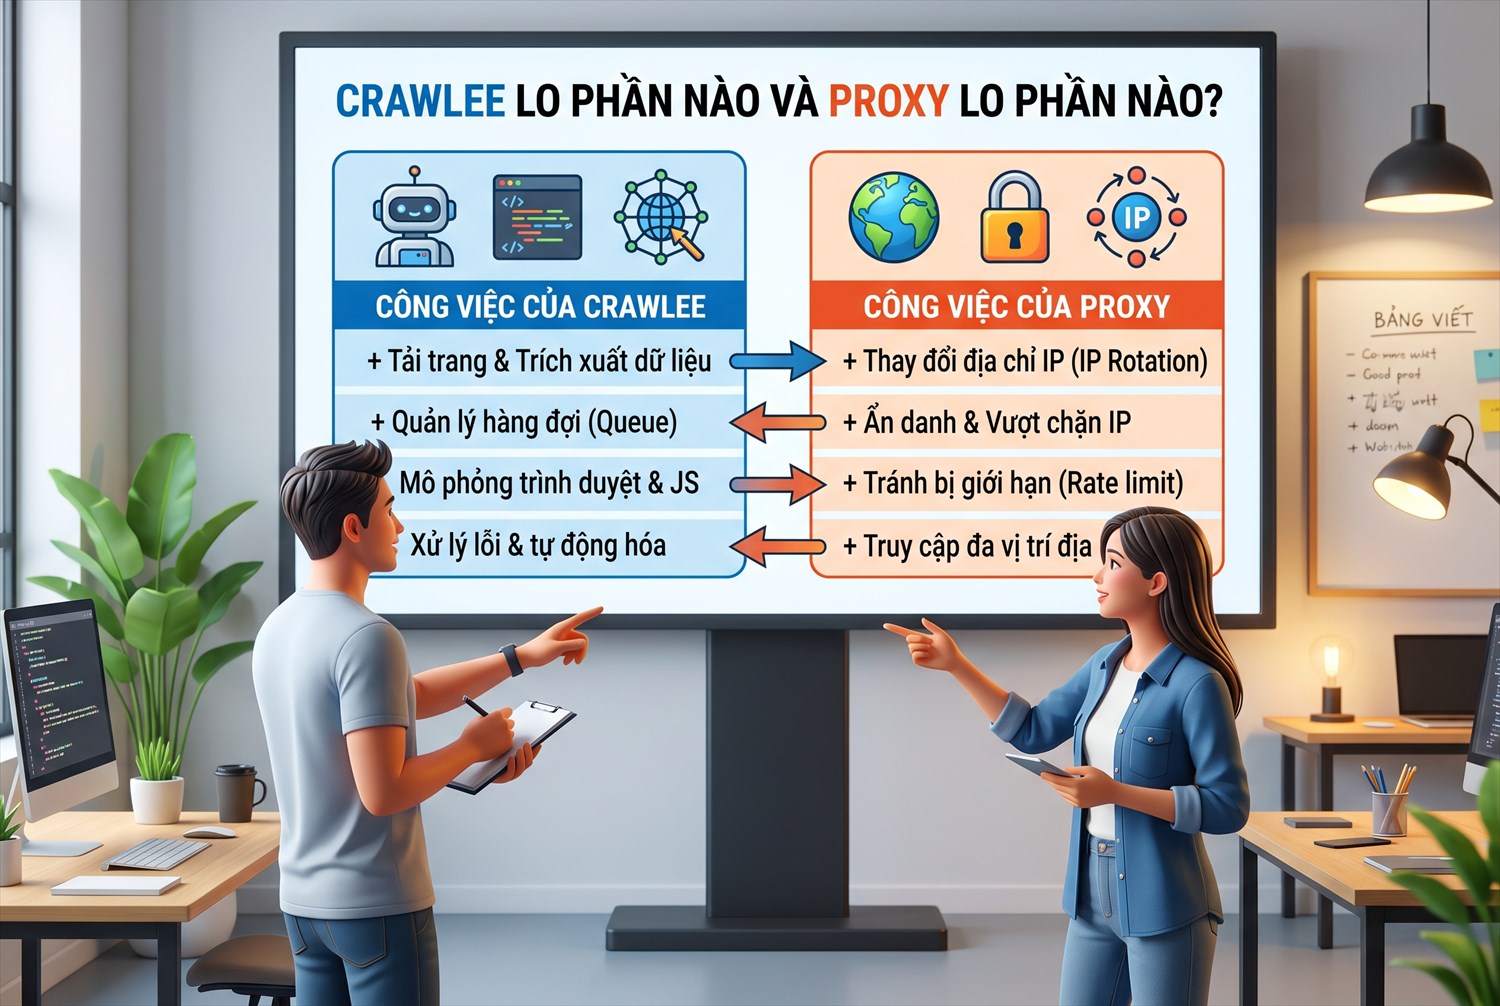
Crawlee lo phần nào và proxy lo phần nào
Crawlee lo phần nào
IPRoyal liệt kê các tính năng chính:
- Thiết lập trình thu thập dễ dàng với trình duyệt không giao diện và máy khách HTTP.
- Xoay proxy và chạy đồng thời có sẵn.
- Tự thử lại và xử lý lỗi.
- Xuất dữ liệu ra JSON hoặc CSV.
- Tích hợp với các nền tảng tự động hóa trình duyệt.
Phần còn thiếu
Hướng dẫn tích hợp của Webshare nói rõ Crawlee xử lý logic thu thập gồm hàng đợi, thử lại, nhóm phiên và tự động hóa trình duyệt. Nhưng nó không tự giải quyết việc mọi yêu cầu xuất phát từ một IP.
Lớp proxy bổ sung ba khả năng:
- Xoay IP để vượt giới hạn tần suất và chặn theo địa chỉ.
- Giữ phiên cho quy trình nhiều bước như đăng nhập, duyệt rồi thanh toán.
- Định vị theo khu vực để xem nội dung và kết quả theo từng nước.
Ba loại trình thu thập
Loại |
Cách hoạt động |
Phù hợp với |
|---|---|---|
CheerioCrawler |
Gửi yêu cầu HTTP, phân tích HTML |
Trang tĩnh, cần tốc độ |
PuppeteerCrawler |
Điều khiển trình duyệt Chromium |
Trang dựng bằng JavaScript |
PlaywrightCrawler |
Điều khiển nhiều loại trình duyệt |
Trang động, cần thao tác phức tạp |
IPRoyal tóm gọn rằng với trang đơn giản thì HTTP nhanh hơn, còn khi trang phụ thuộc vào JavaScript thì dùng trình duyệt.
Cả ba loại nhận cùng một đối tượng cấu hình proxy. Hiểu ranh giới giữa hai bên giúp anh em biết phải cấu hình gì ở đâu.
Chọn loại IP trước khi cấu hình proxy cho Crawlee
Loại proxy quyết định chi phí và tỷ lệ thành công. Webshare đưa ra bảng ghép theo tình huống.
Tình huống |
Loại proxy |
Lý do |
|---|---|---|
Thu thập khối lượng lớn, ưu tiên tốc độ |
Datacenter |
Nhanh và kinh tế nhất |
Luồng nhiều bước cần danh tính nhất quán |
Dân cư tĩnh hoặc ISP |
IP giữ nguyên trong suốt phiên |
Trang có chống bot mạnh |
Dân cư xoay |
IP do nhà mạng cấp, tự xoay |
Bắt đầu từ datacenter
Webshare khuyên khởi đầu với proxy datacenter để kiểm chứng cấu hình, sau đó nâng lên các tầng dân cư khi cần. Theo nguồn này, không phải dự án nào cũng cần dân cư, vì rất nhiều trang đích không kiểm tra IP gắt gao.
Anh em chỉ nên chuyển sang dân cư khi vẫn gặp CAPTCHA hoặc bị chặn dù đã xoay IP datacenter. Bài residential proxy so với datacenter proxy giúp so sánh.
Giao thức
Webshare cho biết ProxyConfiguration nhận mọi định dạng địa chỉ proxy mà máy khách bên dưới hỗ trợ. HTTP hoạt động tốt nhất với trình thu thập dùng trình duyệt, còn SOCKS5 hợp với trình thu thập thuần HTTP.
Thông tin cần chuẩn bị
- Địa chỉ máy chủ và cổng.
- Tên đăng nhập và mật khẩu.
- Quy ước chọn quốc gia và phiên của nhà cung cấp, nếu có.
Một số nhà cung cấp cho phép thêm mã nước và mã phiên vào tên đăng nhập. Quy ước này khác nhau giữa các đơn vị, anh em đọc tài liệu của bên mình dùng.
Kiểm tra proxy trước khi viết mã
Lệnh sau, theo Webshare, xác nhận thông tin đăng nhập còn hiệu lực:
curl -x http://username:[email protected]:80 https://ipinfo.ioNếu IP trả về khác với IP của anh em thì proxy hoạt động. Bước này tránh việc gỡ lỗi nhầm chỗ về sau.
Chọn đúng loại và kiểm tra trước giúp phần viết mã diễn ra suôn sẻ.
Khai báo proxy cho Crawlee trên Node.js
Phần này dùng mã của Webshare và IPRoyal. Anh em thay địa chỉ và tài khoản bằng thông tin proxy của mình.
Khai báo ProxyConfiguration
Cài đặt
Các lệnh khởi tạo dự án theo IPRoyal:
mkdir my-crawlee-project
cd my-crawlee-project
npm init -y
npm install crawlee
Tệp package.json cần khai báo kiểu mô-đun để dùng cú pháp import:
{
  "type": "module",
  "dependencies": {
    "crawlee": "^3.13.9"
  }
}
Cấu hình cơ bản với CheerioCrawler
import { CheerioCrawler, ProxyConfiguration } from 'crawlee';

const proxyConfiguration = new ProxyConfiguration({
    proxyUrls: [
        'http://username:[email protected]:80',
    ],
});

const crawler = new CheerioCrawler({
    proxyConfiguration,
    async requestHandler({ request, $, log, proxyInfo }) {
        const title = $('title').text();
        log.info(`${request.url} -> "${title}" (via ${proxyInfo?.url})`);
    },
});

await crawler.run(['https://example.com']);
Tham số proxyInfo trong hàm xử lý cho biết proxy nào đã phục vụ yêu cầu. Webshare lưu ý đây là công cụ gỡ lỗi hữu ích trước khi mở rộng quy mô.
Danh sách nhiều proxy
Khi có nhiều địa chỉ, anh em liệt kê tất cả trong mảng. Mẫu của IPRoyal:
import { CheerioCrawler, ProxyConfiguration } from 'crawlee';

const proxyConfig = new ProxyConfiguration({
  proxyUrls: [
    'http://user:[email protected]:8000',
    'http://proxy2.example.com:8000',
  ],
});

const crawler = new CheerioCrawler({
  proxyConfiguration: proxyConfig,
  async requestHandler({ request, response }) {
    console.log(`URL: ${request.url} - Status: ${response.statusCode}`);
  },
});

await crawler.run(['https://iproyal.com']);
Với danh sách tĩnh, Crawlee xoay lần lượt theo vòng. Cách này không nhận biết phiên, tức là hai yêu cầu liên tiếp của cùng một phiên có thể đi qua hai IP khác nhau.
Trích xuất dữ liệu
Ví dụ của IPRoyal lấy tiêu đề bài viết từ một trang blog:
import { CheerioCrawler } from 'crawlee';

const crawler = new CheerioCrawler({
  async requestHandler({ request, $ }) {
    console.log(`Visiting: ${request.url}`);

    const titles = [];

    // Adjust the selector if needed
    $('h2.post-title, h2.entry-title, h2.tp-headline-s').each((_, el) => {
      const title = $(el).text().trim();
      if (title) titles.push(title);
    });

    console.log('Captured titles:', titles);
  },
});

await crawler.run(['https://iproyal.com/blog/']);
Anh em thêm thuộc tính proxyConfiguration như ở mẫu trước để các yêu cầu này đi qua proxy.
Bốn đoạn mã trên đủ cho phần lớn nhu cầu thu thập trang tĩnh.
Giữ phiên cố định khi dùng proxy cho Crawlee
Quy trình có đăng nhập hoặc nhiều bước cần một IP ổn định trong suốt phiên. Danh sách tĩnh không làm được điều này.
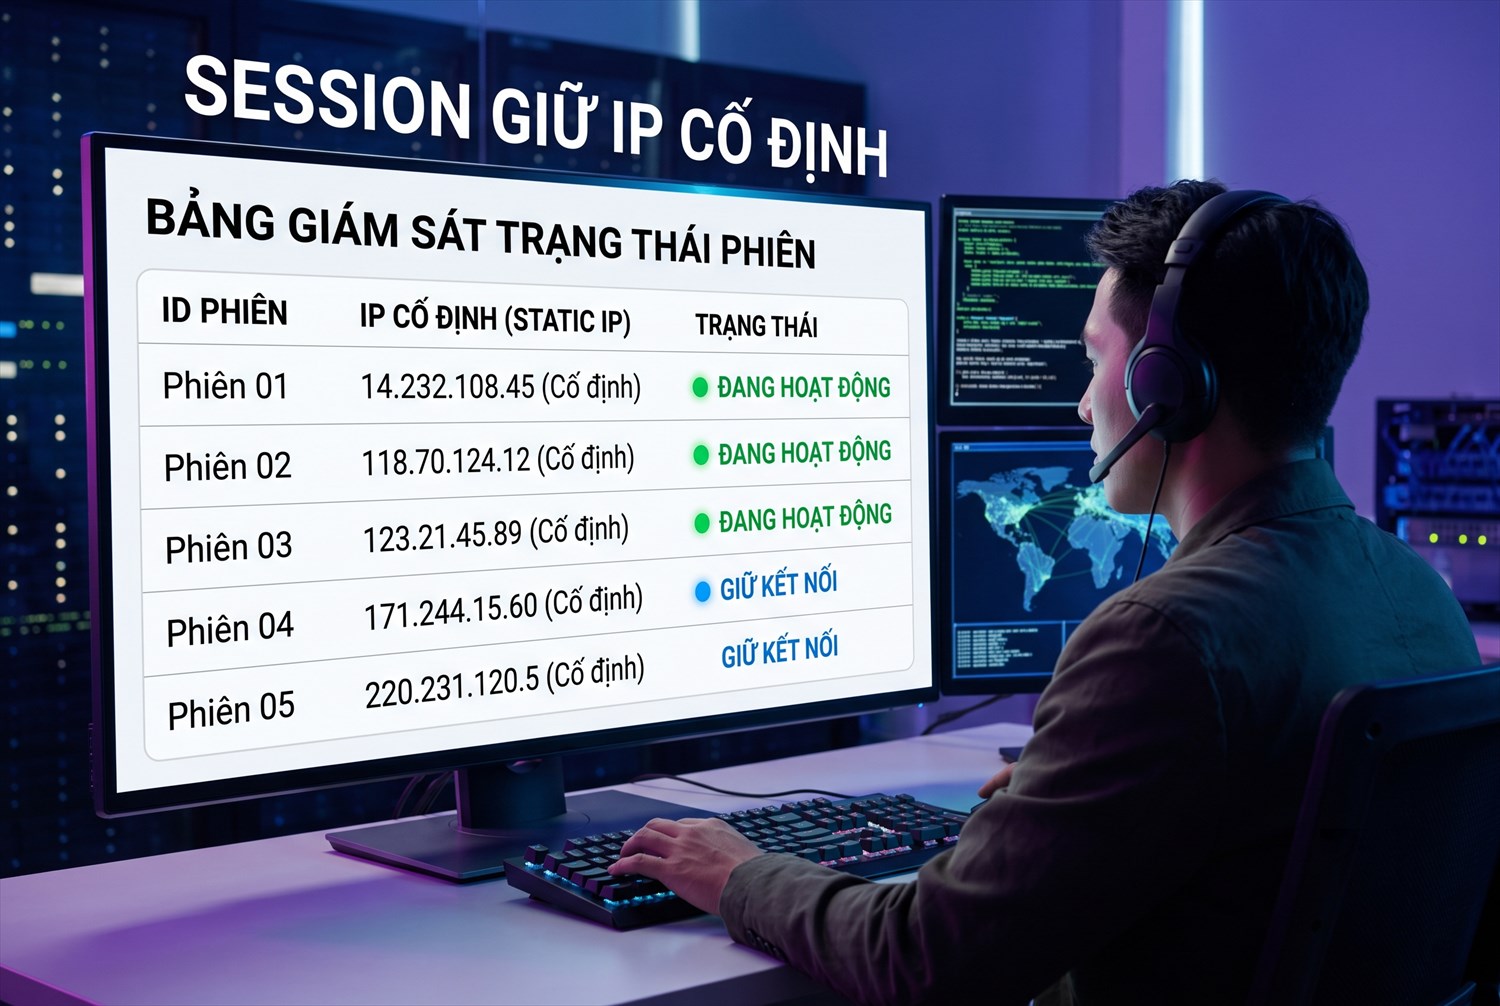
Session giữ IP cố định
Hàm tạo địa chỉ theo phiên
Thay vì proxyUrls, anh em dùng newUrlFunction. Hàm nhận mã phiên và trả về địa chỉ proxy tương ứng. Mẫu của Webshare:
import { PlaywrightCrawler, ProxyConfiguration } from 'crawlee';

const proxyConfiguration = new ProxyConfiguration({
    newUrlFunction: (sessionId) => {
        const sid = sessionId ?? Math.floor(Math.random() * 1_000_000);
        return `http://username-us-${sid}:[email protected]:80`;
    },
});

const crawler = new PlaywrightCrawler({
    proxyConfiguration,
    useSessionPool: true,
    sessionPoolOptions: { maxPoolSize: 50 },
    async requestHandler({ page, request, proxyInfo, log }) {
        await page.waitForSelector('body');
        log.info(`${request.url} via ${proxyInfo?.url}`);
    },
});

await crawler.run(['https://example.com']);
Trong ví dụ này, mã nước us và mã phiên được ghép vào tên đăng nhập theo quy ước của Webshare. Nhà cung cấp khác sẽ có cú pháp khác.
Cách phiên và IP gắn với nhau
Mỗi phiên trong nhóm phiên của Crawlee có một mã riêng. Hàm tạo địa chỉ chuyển mã đó thành một tham số gửi tới nhà cung cấp, và nhà cung cấp giữ nguyên IP cho mọi yêu cầu mang cùng mã.
Kết quả là cookie, dấu vân tay và IP của một phiên đi cùng nhau. Trang đích thấy một người dùng nhất quán.
Tự đổi phiên khi bị chặn
Webshare giải thích khi Crawlee phát hiện bị chặn, nó tự chuyển sang một mã phiên mới. Hàm tạo địa chỉ biến mã mới thành một IP mới mà anh em không phải viết thêm dòng nào.
Sức mạnh của Crawlee nằm ở chỗ phiên, cookie và proxy được quản lý như một khối. Bỏ một phiên bị chặn là bỏ luôn IP và cookie của nó.
Các tham số nên biết
Tham số |
Ý nghĩa |
|---|---|
useSessionPool |
Bật nhóm phiên |
sessionPoolOptions.maxPoolSize |
Số phiên tối đa giữ trong nhóm |
persistCookiesPerSession |
Lưu cookie riêng cho từng phiên |
proxyInfo |
Thông tin proxy của yêu cầu hiện tại |
Lỗi thường gặp
Webshare chỉ ra nguyên nhân phổ biến khiến phiên không giữ được IP là dùng danh sách tĩnh thay vì hàm tạo địa chỉ. Danh sách tĩnh chỉ xoay vòng, không biết gì về phiên.
Bài sticky session proxy là gì trình bày khái niệm giữ phiên ở phía nhà cung cấp.
Dùng hàm tạo địa chỉ là điều kiện để các quy trình nhiều bước chạy ổn định.
Proxy phân tầng trong cấu hình proxy cho Crawlee
Proxy dân cư đắt hơn datacenter nhiều lần. Crawlee có cơ chế chỉ dùng loại đắt khi cần.
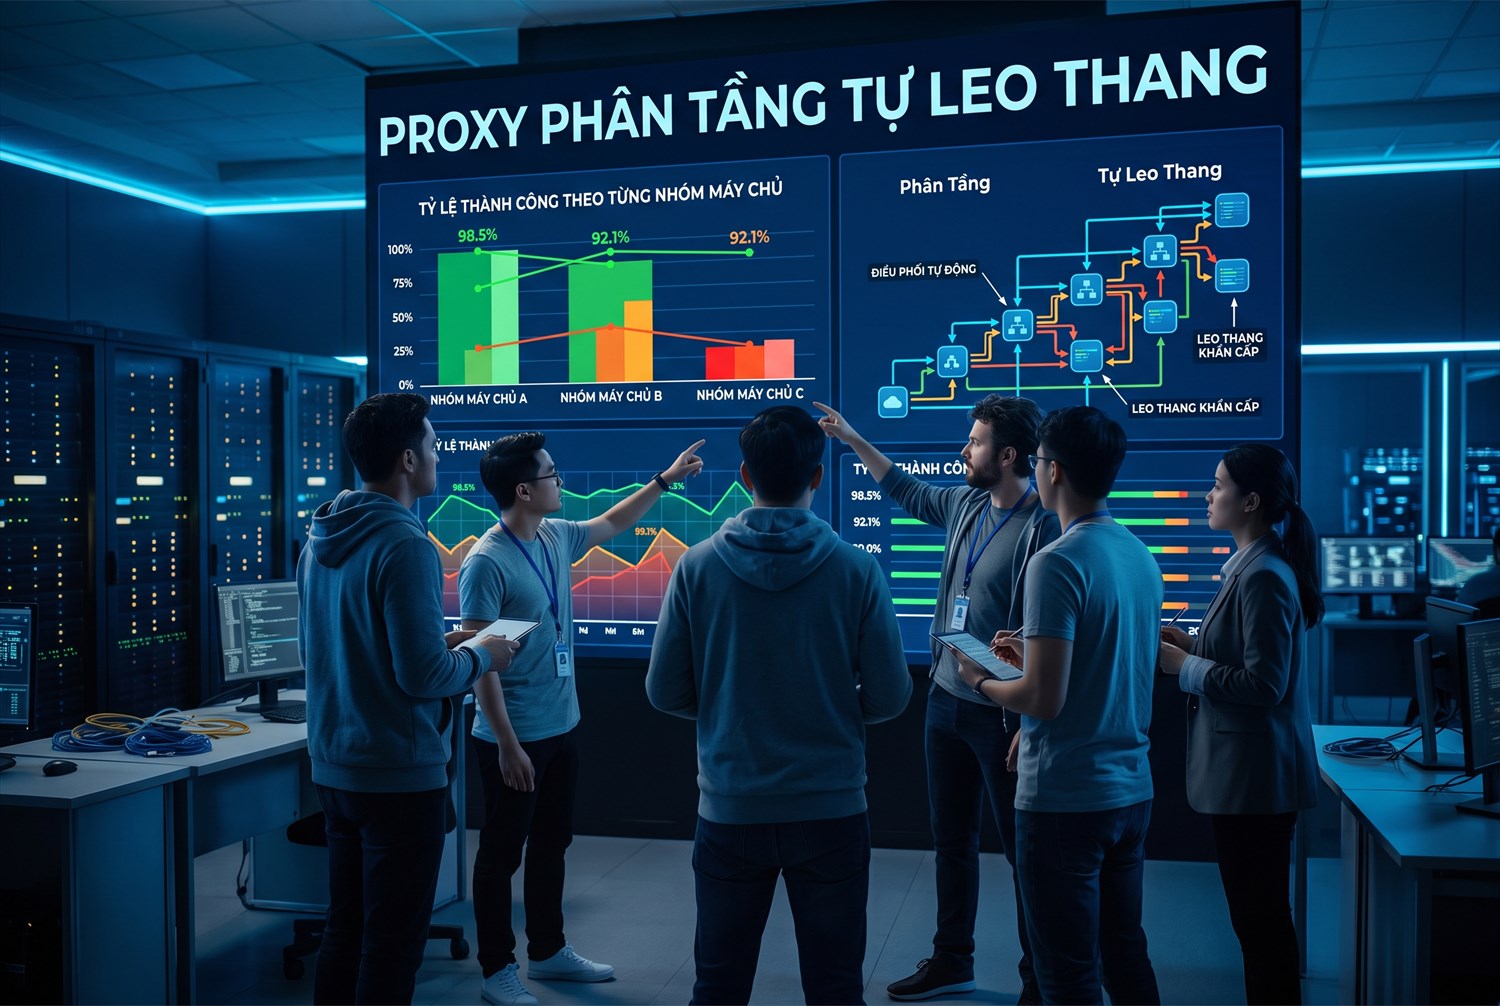
Proxy phân tầng tự leo thang
Khai báo các tầng
const proxyConfiguration = new ProxyConfiguration({
    tieredProxyUrls: [
        ['http://dc-username:[email protected]:80'],        // Tier 0: datacenter
        ['http://isp-username:[email protected]:80'],       // Tier 1: static residential
        ['http://rotating-username:[email protected]:80'],  // Tier 2: rotating residential
    ],
});
Mỗi mảng con là một tầng, xếp từ rẻ tới đắt. Mẫu trên của Webshare dùng ba tầng là datacenter, dân cư tĩnh và dân cư xoay.
Cơ chế leo thang và hạ tầng
Crawlee bắt đầu ở tầng thấp nhất. Khi phát hiện bị chặn trên một tên miền, nó chuyển các yêu cầu tới tên miền đó lên tầng cao hơn.
Theo Webshare, thư viện định kỳ thử lại tầng thấp. Nếu tình trạng chặn giảm, nó tự hạ xuống proxy rẻ hơn.
Lợi ích về chi phí
Trang dễ được phục vụ bằng datacenter, chỉ trang khó mới tiêu tốn băng thông dân cư. Anh em không phải tự phân loại trang đích trước.
Bài cách tính chi phí mua proxy giúp ước tính mức tiết kiệm.
Khi nào nên dùng
- Thu thập nhiều tên miền có mức độ bảo vệ khác nhau.
- Ngân sách giới hạn nhưng vẫn cần tỷ lệ thành công cao.
- Chưa rõ trang đích khó tới đâu.
Nếu chỉ làm việc với một trang đã biết rõ, khai báo thẳng loại proxy phù hợp sẽ đơn giản hơn.
Kết hợp với định tuyến riêng
Mỗi trình thu thập có cấu hình proxy độc lập. Webshare xác nhận trong một dự án, anh em có thể tạo nhiều trình thu thập với nhiều cấu hình khác nhau.
Proxy phân tầng là tính năng ít thư viện có, và là lý do đáng kể để chọn Crawlee cho dự án lớn.
Dùng proxy cho Crawlee trên Python
Crawlee có bản Python với cách dùng tương tự. Mã dưới đây lấy từ hướng dẫn của Webshare.
Cài đặt
pip install crawlee
pip install 'crawlee[beautifulsoup]'
pip install 'crawlee[playwright]'
Cấu hình cơ bản
import asyncio
from crawlee.beautifulsoup_crawler import BeautifulSoupCrawler, BeautifulSoupCrawlingContext
from crawlee.proxy_configuration import ProxyConfiguration

async def main() -> None:
    proxy_configuration = ProxyConfiguration(
        proxy_urls=[
            'http://username:[email protected]:80',
        ]
    )

    crawler = BeautifulSoupCrawler(proxy_configuration=proxy_configuration)

    @crawler.router.default_handler
    async def request_handler(context: BeautifulSoupCrawlingContext) -> None:
        title = context.soup.title.string if context.soup.title else None
        context.log.info(f'{context.request.url} -> "{title}"')

    await crawler.run(['https://example.com'])

if __name__ == '__main__':
    asyncio.run(main())
Giữ phiên
import asyncio
from crawlee.playwright_crawler import PlaywrightCrawler, PlaywrightCrawlingContext
from crawlee.proxy_configuration import ProxyConfiguration

def get_webshare_url(session_id: str | None = None, request=None, proxy_tier=None) -> str:
    sid = session_id or 'default'
    return f'http://username-us-{sid}:[email protected]:80'

async def main() -> None:
    proxy_configuration = ProxyConfiguration(new_url_function=get_webshare_url)

    crawler = PlaywrightCrawler(proxy_configuration=proxy_configuration)

    @crawler.router.default_handler
    async def request_handler(context: PlaywrightCrawlingContext) -> None:
        title = await context.page.title()
        context.log.info(f'{context.request.url} -> "{title}"')

    await crawler.run(['https://example.com'])

if __name__ == '__main__':
    asyncio.run(main())
Proxy phân tầng
proxy_configuration = ProxyConfiguration(
    tiered_proxy_urls=[
        ['http://dc-username:[email protected]:80'],
        ['http://isp-username:[email protected]:80'],
        ['http://rotating-username:[email protected]:80'],
    ]
)
Tên tham số trong bản Python dùng dấu gạch dưới thay cho kiểu viết liền của bản Node.js.
Lỗi cổng 80 và 443
Webshare ghi nhận một lỗi có thật ở các phiên bản cũ của bản Python. Proxy dùng cổng 80 hoặc 443 bị xử lý sai thành giá trị rỗng, vì máy khách HTTP bên dưới coi các cổng mặc định là không có giá trị.
Cách khắc phục là nâng cấp lên phiên bản mới nhất của thư viện. Nếu chưa nâng cấp được, anh em dùng cổng khác do nhà cung cấp hỗ trợ.
Đường dẫn nhập mô-đun
Cấu trúc gói của bản Python thay đổi qua các phiên bản. Nếu câu lệnh nhập báo lỗi, anh em đối chiếu với tài liệu chính thức của Crawlee cho đúng phiên bản đang cài.
Hai bản Node.js và Python chia sẻ cùng khái niệm, nên anh em chuyển đổi giữa hai bên khá dễ.
Kiểm tra và vận hành proxy cho Crawlee
Mã chạy được chưa có nghĩa là hệ thống ổn định. Phần này nói về việc theo dõi và tinh chỉnh.
Xác nhận proxy được dùng
Anh em in proxyInfo trong hàm xử lý như ở các mẫu trên. Mỗi dòng nhật ký cho biết yêu cầu đi qua địa chỉ nào.
Với proxy xoay, chạy thử trên một trang trả về IP và quan sát địa chỉ thay đổi qua từng yêu cầu.
Điều chỉnh đồng thời
Webshare xác nhận cấu hình proxy hoạt động độc lập với hàng đợi và cơ chế tự điều chỉnh số luồng. Dù vậy, anh em vẫn nên giới hạn số luồng theo số IP đang có.
Bài 1 proxy chạy được bao nhiêu luồng có cách ước tính.
Theo dõi tỷ lệ lỗi
- Tỷ lệ yêu cầu phải thử lại tăng nghĩa là proxy hoặc trang đích có vấn đề.
- Số phiên bị loại bỏ cao cho thấy nhóm IP bị nhận diện.
- Mã 403 và 429 cần được thống kê theo từng tầng proxy.
- Thời gian phản hồi tăng báo hiệu proxy quá tải.
Bài proxy success rate hướng dẫn cách đo.
Thu thập có trách nhiệm
Anh em đặt giới hạn số yêu cầu mỗi phút cho từng tên miền, tôn trọng tệp robots.txt và chỉ lấy dữ liệu công khai. Tự thử lại quá nhiều lần cũng là một dạng gây tải.
Bảo mật thông tin proxy
Không ghi tên đăng nhập và mật khẩu trực tiếp trong mã nguồn. Anh em đưa vào biến môi trường và đọc ra khi khởi chạy, đặc biệt khi mã được lưu trên kho dùng chung.
Bài web scraping proxy là gì trình bày quy trình tổng thể của một hệ thống thu thập.
Theo dõi đều đặn giúp anh em phát hiện sớm khi nhóm IP xuống chất lượng.
Sai lầm thường gặp khi tích hợp proxy cho Crawlee
Phần lớn lỗi khi mới dùng thư viện này lặp lại ở vài điểm. Biết trước giúp anh em tiết kiệm nhiều giờ gỡ lỗi.
Dùng trình duyệt cho trang tĩnh
Trình duyệt không giao diện tải cả hình ảnh, tệp định dạng và mã kịch bản, nên tốn băng thông proxy gấp nhiều lần yêu cầu HTTP. Nếu dữ liệu có sẵn trong mã HTML, anh em dùng CheerioCrawler hoặc bản tương đương trên Python.
Khi buộc phải dùng trình duyệt, hãy chặn tải hình ảnh và phông chữ để giảm dung lượng trên mỗi trang.
Đặt số luồng quá cao
Cơ chế tự điều chỉnh của thư viện tăng số luồng theo tài nguyên máy, không theo sức chịu đựng của trang đích. Số luồng lớn trên ít IP khiến từng địa chỉ gửi yêu cầu dồn dập và bị chặn.
Anh em đặt mức trần cho số luồng đồng thời và số yêu cầu mỗi phút ngay từ đầu.
Trộn proxy xoay với phiên có đăng nhập
Cổng xoay theo từng yêu cầu sẽ đổi IP ngay giữa quy trình đăng nhập. Trang đích thấy cookie của một phiên xuất hiện từ nhiều địa chỉ và hủy phiên đó.
Quy trình có trạng thái luôn cần hàm tạo địa chỉ theo phiên như đã trình bày.
Không phân biệt lỗi của proxy và lỗi của trang đích
Mã 407 là lỗi xác thực với proxy, còn 403 và 429 đến từ trang đích. Hai nhóm cần cách xử lý khác nhau: nhóm đầu phải kiểm tra tài khoản, nhóm sau phải đổi IP và giảm nhịp.
Bài sửa lỗi 407 Proxy Authentication Required và mua proxy bị lỗi 429 hướng dẫn chi tiết từng trường hợp.
Bỏ qua bước kiểm tra nội dung
Trang chặn đôi khi trả về mã 200 kèm nội dung rỗng hoặc trang xác minh. Hàm xử lý nên kiểm tra sự có mặt của phần tử mong đợi và chủ động báo lỗi để thư viện đổi phiên.
Tránh năm lỗi này giúp hệ thống của anh em ổn định ngay từ những lần chạy đầu.
Khi đưa Crawlee vào chạy thật, anh em có thể mua proxy Việt Nam tại ProxyVN, proxy được cấp kèm user và password để nạp thẳng vào cấu hình proxy của crawler.
Tiêu chí chọn nhà cung cấp proxy cho Crawlee
Thư viện này khai thác tốt một số tính năng mà không phải nhà cung cấp nào cũng có.
- Giữ phiên qua tham số: cần cho hàm tạo địa chỉ theo phiên.
- Có đủ ba loại datacenter, dân cư tĩnh, dân cư xoay: cần cho proxy phân tầng.
- Chọn quốc gia qua tham số.
- Xác thực bằng tên đăng nhập và mật khẩu, hỗ trợ HTTP và SOCKS5.
- Cho phép nhiều kết nối đồng thời.
- Thời gian hoạt động cao, hỗ trợ kỹ thuật liên tục.
Nếu cần so sánh với các công cụ khác, anh em tham khảo bài so sánh Puppeteer, Playwright và Selenium của IPRoyal cùng các bài proxy Playwright và cách sử dụng proxy trong Puppeteer của ProxyVN.
ProxyVN cung cấp proxy với đường truyền ổn định, hạn chế mất kết nối giữa chừng. Đội kỹ thuật hỗ trợ 24/24 khi công cụ thu thập của anh em gặp lỗi kết nối.
Tóm lại, anh em dùng danh sách tĩnh cho yêu cầu độc lập, hàm tạo địa chỉ khi cần giữ phiên và proxy phân tầng để tối ưu chi phí. Hãy in thông tin proxy ra nhật ký để kiểm chứng. Cần tư vấn, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam để chọn proxy cho Crawlee.


