
LangGraph checkpoint cho agent web: resume sau lỗi tool
LangGraph checkpoint cho agent web là cơ chế lưu trạng thái của đồ thị LangGraph sau mỗi bước vào một kho bền, theo từng thread. Khi một tool đọc web lỗi giữa chừng, agent nối lại đúng chỗ thay vì chạy lại từ đầu. Nối lại được không có nghĩa là không gọi lại mạng: thiết kế node quyết định có bao nhiêu request bị lặp. ProxyVN chạy LangGraph 1.2.19 với SqliteSaver ngày 03/11/2026, cho một trang tin cục bộ trả 503 giữa chừng, rồi đếm số request thật mà máy chủ nhận được trước và sau khi resume.
LangGraph checkpoint cho agent web: mục tiêu và phạm vi không lặp
Phần đầu chốt bài toán, đầu ra và ranh giới với các bài đã có.
Bài toán
Một agent nghiên cứu web điển hình làm vài bước: lập danh sách nguồn, tải từng nguồn, tóm tắt, viết kết quả. Bước tải là bước hay lỗi nhất: website chậm, trả 503, giới hạn tốc độ, proxy rớt. Khi lỗi, agent dừng, và câu hỏi là phải làm lại bao nhiêu.
Làm lại từ đầu tốn thời gian, tốn token nếu có LLM, và tạo thêm request tới các website đã tải xong. Với nguồn có giới hạn tốc độ, request lặp còn làm tăng khả năng bị chặn.
Đầu ra nghiệm thu
Đầu ra là một workflow bị ngắt bởi lỗi tool rồi được nối lại, kèm ba con số. Đó là trạng thái trước khi resume, trạng thái sau khi resume, và số lần mỗi URL thực sự được gọi qua mạng, đếm phía máy chủ. Hai thiết kế node khác nhau được so trên cùng tình huống.
Phạm vi không lặp
Bài LangChain web search đã nói cách cho LangChain tìm kiếm web. Bài RAG với ChromaDB và dữ liệu web đã nói cách lưu và truy xuất nội dung web cho LLM. Bài này không dựng lại search hay RAG.
Trọng tâm duy nhất là checkpoint, thread và resume sau lỗi tool. Lab không dùng LLM: các node là hàm Python xác định, để mọi con số chỉ phản ánh cơ chế checkpoint, không lẫn yếu tố ngẫu nhiên của mô hình.
Nguồn kiểm chứng
Khái niệm được đối chiếu với trang Persistence trong tài liệu LangGraph. Lab dùng langgraph 1.2.19, langgraph-checkpoint 4.3.1, langgraph-checkpoint-sqlite 3.1.3 và httpx 0.28.1 cài từ PyPI.
Ai nên đọc
Người viết agent bằng LangGraph có tool gọi web và từng thấy agent làm lại từ đầu sau một lỗi nhỏ. Người cần chạy agent dài hàng chục bước trên máy chủ và muốn khởi động lại tiến trình mà không mất tiến độ. Người lo agent gọi lặp tới cùng một website.
Khôi phục agent nghiên cứu web bằng LangGraph checkpoint cho agent web sau lỗi tool
Phần này giải thích checkpoint lưu gì và resume hoạt động thế nào.
Checkpoint là ảnh chụp sau mỗi bước
Khi đồ thị được compile với một checkpointer, LangGraph lưu một checkpoint sau mỗi super-step. Checkpoint chứa giá trị của state, node sẽ chạy tiếp, và metadata. Các checkpoint của cùng một thread nối thành lịch sử, đọc được bằng get_state_history.
Trong lab, một lần chạy đầy đủ của đồ thị bốn bước tạo 5 checkpoint trong thread. Lần chạy bị lỗi ở bước tải tạo 3 checkpoint, dừng trước node tải.
Thread là đơn vị resume
thread_id
Mỗi lần gọi invoke cần config có thread_id. Cùng thread_id thì đọc tiếp lịch sử cũ. Thread_id khác là một cuộc hội thoại mới, không biết gì về thread cũ.
Lab thử resume với một thread_id gõ sai. LangGraph không tìm thấy checkpoint nào, và vì đầu vào là None nên báo EmptyInputError: Received no input for __start__. Không có request mạng nào được gửi. Lỗi này rõ ràng, tốt hơn nhiều so với việc lặng lẽ chạy lại từ đầu.
Resume bằng invoke với None
Cách nối lại là gọi invoke với đầu vào None và cùng config. LangGraph đọc checkpoint mới nhất, thấy node nào còn dang dở, chạy tiếp từ đó. Không cần tự lưu biến trung gian hay tự đánh dấu bước nào đã xong.
Agent có LLM thì lưu thêm gì
Với agent dùng LLM chọn tool, state thường có danh sách tin nhắn: câu hỏi, lời gọi tool do mô hình sinh ra, kết quả tool. Checkpoint lưu cả danh sách này. Khi tool lỗi và resume, câu hỏi then chốt là lời gọi tool đã nằm trong state chưa. Nếu đã nằm, node chạy tool sẽ thực hiện lại đúng lời gọi đó mà không cần hỏi lại mô hình.
Đây là suy luận từ cách checkpoint hoạt động, lab chưa chạy với LLM thật. Khi áp dụng, nên thử đúng kịch bản lỗi như lab và đếm cả số lần gọi mô hình, không chỉ số request web.
Quay lại checkpoint cũ
Mỗi checkpoint có id riêng. Tài liệu LangGraph mô tả việc chạy tiếp từ một checkpoint cũ bằng cách đưa checkpoint_id vào config, tạo ra một nhánh mới từ điểm đó. Tính năng này hữu ích khi muốn thử lại một bước với tham số khác mà không chạy lại các bước trước. Lab chưa thử tính năng này, chỉ dùng checkpoint mới nhất.
Pending writes giữ kết quả của task đã xong
Khi một super-step có nhiều task chạy song song mà một task lỗi, LangGraph lưu kết quả của các task thành công dưới dạng pending writes. Lúc resume, chỉ task lỗi chạy lại. Đây là cơ chế quyết định kết quả của thiết kế B trong lab.
Bảng writes trong tệp SQLite của lab là nơi chứa các pending writes này, bên cạnh bảng checkpoints.
Dừng trước tool để người duyệt
Dừng trước tool
Checkpoint còn cho phép dừng có chủ đích. Compile đồ thị với interrupt_before chứa tên node tải, đồ thị chạy tới trước node đó rồi dừng, lưu checkpoint. Lab chạy thử: lần invoke đầu dừng với next là fetch_all, state có 3 URL, máy chủ chưa nhận request nào.
Người duyệt xem danh sách URL, gọi update_state để bỏ URL thứ ba, rồi gọi invoke với None. Đồ thị chạy tiếp với 2 URL, máy chủ nhận đúng /tin/1 và /tin/2 mỗi URL một lần, thread có 6 checkpoint. Đây là cách cho người kiểm danh sách nguồn trước khi agent đi tải hàng loạt.
app = gr.compile(checkpointer=cp, interrupt_before=["fetch_all"])
app.invoke({"topic": "tin"}, cfg)          # dừng trước fetch_all
app.update_state(cfg, {"urls": urls[:2]})   # người duyệt bỏ bớt URL
app.invoke(None, cfg)                       # chạy tiếp
Sửa state trước khi resume
update_state không chỉ dùng cho người duyệt. Khi một URL chết hẳn, resume chỉ làm lỗi lại. Sửa state để bỏ URL đó, hay thay bằng nguồn dự phòng, rồi mới resume. Checkpoint mới được ghi với state đã sửa, lịch sử vẫn giữ bản cũ để đối chiếu.
Mọi lần sửa nên được ghi lại: ai sửa, lúc nào, lý do. Với agent chạy cho khách hàng, đây là dấu vết kiểm toán quan trọng.
Node là đơn vị chạy lại
Ngược lại, nếu một node làm nhiều việc rồi lỗi ở việc cuối, cả node chạy lại khi resume. LangGraph không biết bên trong node đã gọi mạng bao nhiêu lần. Đây là cơ chế quyết định kết quả của thiết kế A.
Chọn checkpointer, thread_id và nơi lưu bền vững cho LangGraph checkpoint cho agent web
Chọn kho lưu sai thì checkpoint chỉ sống bằng tuổi tiến trình.
InMemorySaver chỉ hợp để thử
InMemorySaver giữ checkpoint trong bộ nhớ. Tiến trình kết thúc là mất. Với agent web, lỗi thường đi kèm việc tiến trình dừng hẳn, nên kho trong bộ nhớ không giúp được gì ngoài lúc viết test.
SqliteSaver cho một máy
Lab dùng SqliteSaver từ gói langgraph-checkpoint-sqlite, mở bằng SqliteSaver.from_conn_string với tệp cp.sqlite. Mỗi lệnh chạy trong lab là một tiến trình Python riêng: lần chạy lỗi là một tiến trình, lần resume là tiến trình khác. Resume vẫn đọc được checkpoint, xác nhận kho bền qua lần khởi động lại.
from langgraph.checkpoint.sqlite import SqliteSaver

with SqliteSaver.from_conn_string("cp.sqlite") as cp:
    app = build(cp)
    cfg = {"configurable": {"thread_id": "nghien-cuu-2026-11-03-a"}}
    app.invoke({"topic": "tin"}, cfg)
Khởi động lại tiến trình là kịch bản chính
Trong lab, mỗi lệnh là một tiến trình Python mới. Lần lỗi kết thúc tiến trình, lần resume mở lại tệp SQLite từ đầu. Đây chính là kịch bản hay gặp nhất ngoài thực tế: worker bị khởi động lại, container bị thay, máy chủ cập nhật hệ điều hành. Checkpoint chỉ có giá trị nếu vượt qua được ranh giới tiến trình, và lab xác nhận SqliteSaver làm được điều đó.
Postgres cho nhiều máy
Khi nhiều worker cùng chạy agent, hay khi agent chạy trên nền tảng tự khởi động lại container, cần kho dùng chung như Postgres. LangGraph có gói checkpointer riêng cho Postgres. Lab không thử, nhưng giao diện giống SqliteSaver: đổi checkpointer, giữ nguyên đồ thị.
Đặt thread_id có ý nghĩa
thread_id nên đọc được và gắn với công việc: mã yêu cầu nghiên cứu, ngày, người yêu cầu. Khi có sự cố, nhìn thread_id là biết thread nào của việc nào. thread_id ngẫu nhiên kiểu uuid vẫn chạy được, nhưng phải lưu ánh xạ sang công việc ở chỗ khác.
Quan trọng nhất là thread_id phải được lưu lại ngoài tiến trình, ví dụ trong hàng đợi công việc. Mất thread_id là mất đường quay lại checkpoint, dù checkpoint vẫn nằm trong kho.
Một thread cho một nhiệm vụ
Không nên dùng chung một thread cho nhiều nhiệm vụ nghiên cứu khác nhau chỉ để tiết kiệm thiết lập. State của nhiệm vụ trước sẽ lẫn vào nhiệm vụ sau, nhất là với trường có reducer cộng dồn như pages. Mỗi nhiệm vụ một thread, kết thúc thì đóng.
Nếu cần nhớ thông tin giữa các nhiệm vụ, như danh sách nguồn đáng tin, dùng một kho riêng cho trí nhớ dài hạn. Checkpoint là trí nhớ ngắn hạn của một thread.
Tách checkpoint khỏi dữ liệu kết quả
Kết quả cuối của agent nên được ghi ra nơi lưu chính thức của ứng dụng, không chỉ nằm trong checkpoint. Checkpoint có thể bị dọn theo lịch, kết quả thì cần giữ lâu. Node cuối của đồ thị là nơi hợp lý để ghi kết quả ra ngoài, và việc ghi này cũng nên idempotent theo thread_id.
Dọn checkpoint cũ
Mỗi bước tạo một checkpoint, mỗi thread vài chục bước, vài trăm thread mỗi ngày. Kho phình nhanh. Cần lịch dọn: giữ thread đang chạy và thread gần đây, xóa hoặc lưu trữ thread đã xong quá một thời hạn. Lab có 5 dòng checkpoint cho thread t-R, đếm bằng truy vấn SQL trực tiếp trên bảng checkpoints.
Xác định checkpoint trước/sau web tool trong LangGraph checkpoint cho agent web
Phần này mô tả đồ thị và máy chủ của lab.
Máy chủ tin cục bộ
Máy chủ http.server ở 127.0.0.1 cổng 9881 trả ba trang /tin/1, /tin/2, /tin/3. Mỗi request được ghi vào tệp nhật ký, để đếm số lần gọi phía máy chủ chứ không tin vào log của agent. Khi có tệp cờ fail.flag, /tin/3 trả 503 Service Unavailable.
Đồ thị bốn bước
Node plan trả danh sách ba URL. Bước tải có hai thiết kế. Node summ gom các trang đã tải thành một chuỗi tóm tắt. State có trường pages với reducer operator.add, để kết quả từ nhiều task được cộng dồn thay vì ghi đè.
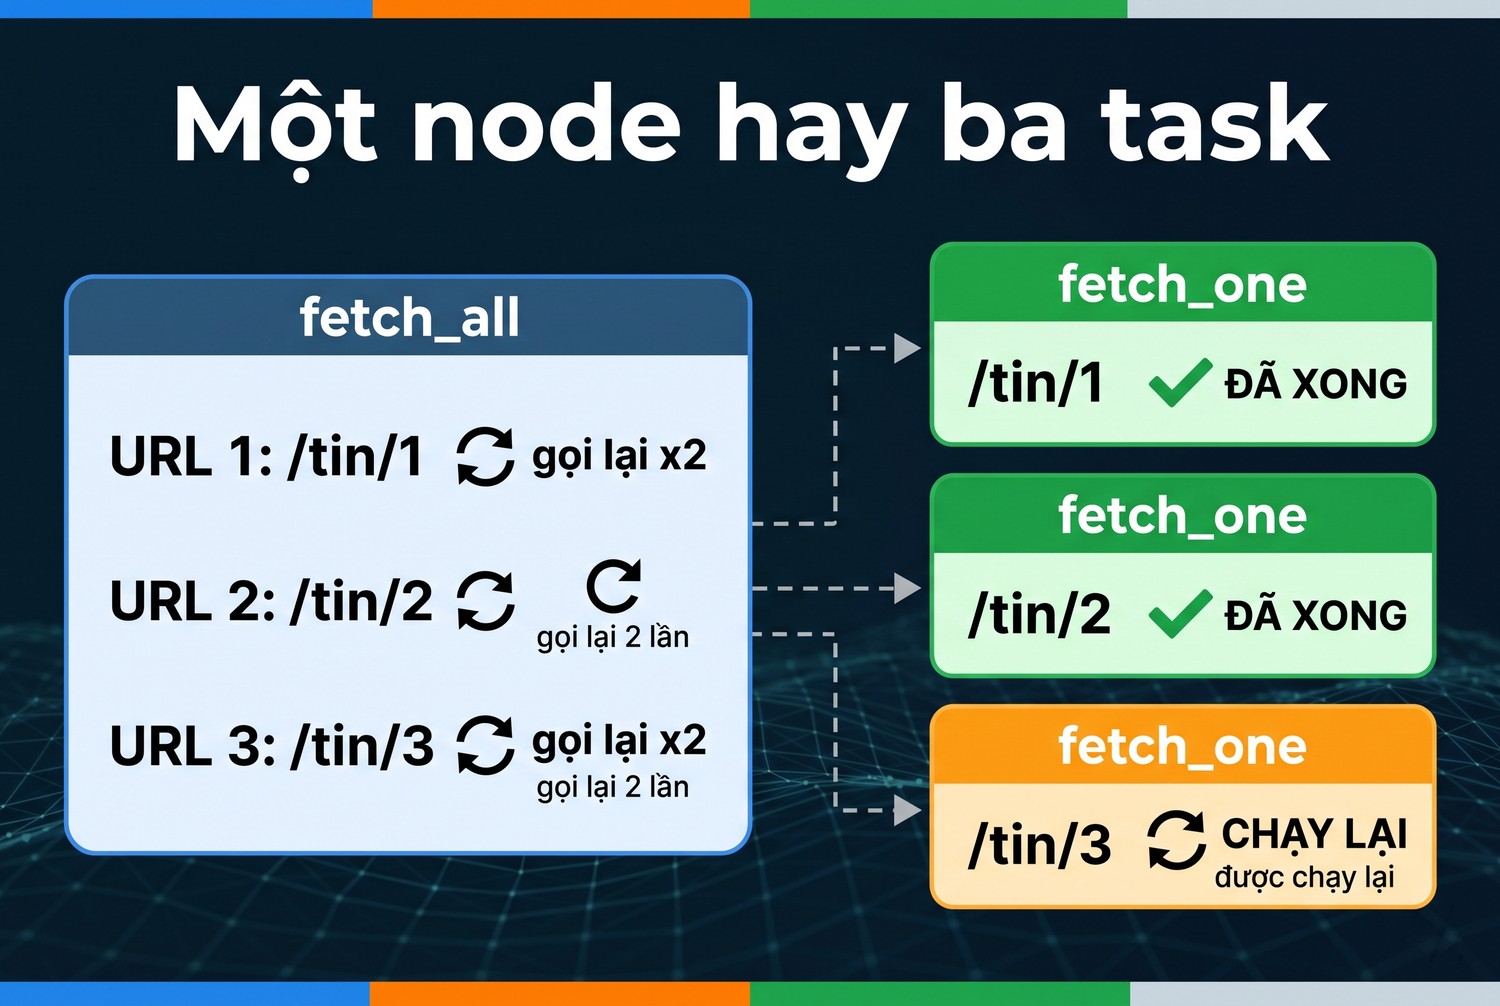
Thiết kế A: một node tải tất cả
Một node hay ba task
def fetch_all(s):
    out = []
    for u in s["urls"]:
        r = httpx.get(u, timeout=5)
        r.raise_for_status()
        out.append({"url": u, "len": len(r.text)})
    return {"pages": out}
Một node, một vòng lặp, ba request tuần tự. Đây là cách viết tự nhiên nhất khi chuyển một script cũ sang LangGraph.
Thiết kế B: mỗi URL một task
def fan(s):
    return [Send("fetch_one", {"url": u}) for u in s["urls"]]

def fetch_one(x):
    r = httpx.get(x["url"], timeout=5)
    r.raise_for_status()
    return {"pages": [{"url": x["url"], "len": len(r.text)}]}
Hàm fan dùng Send để tạo ba task fetch_one, mỗi task một URL. Ba task chạy trong cùng super-step. Mỗi task trả một phần tử, reducer cộng lại thành danh sách.
Vị trí checkpoint so với tool
Với thiết kế A, checkpoint gần nhất trước lỗi là sau node plan. Mọi request bên trong fetch_all nằm giữa hai checkpoint, không có ranh giới nào ở giữa. Với thiết kế B, checkpoint cũng ở sau plan, nhưng mỗi task thành công để lại pending write riêng.
Nói cách khác, ranh giới an toàn để resume là ranh giới giữa các task, không phải giữa các dòng mã. Muốn một lời gọi web không bị lặp, nó phải là một task riêng.
Ngắt workflow sau một tool call rồi nối lại đúng thread với LangGraph checkpoint cho agent web
Đây là kết quả chính của lab.
Kịch bản
Bật cờ lỗi, chạy đồ thị với thread mới. /tin/3 trả 503, httpx raise_for_status ném HTTPStatusError, đồ thị dừng. Tắt cờ lỗi, chạy resume trong một tiến trình mới với cùng thread_id. Cuối cùng thử resume với thread_id sai.
Bảng kết quả
Thiết kế |
Sau lần chạy lỗi |
Sau resume |
Gọi mạng sau lần lỗi |
Gọi mạng sau resume |
|---|---|---|---|---|
A: một node tải tất cả |
next fetch_all, 0 trang trong state, 3 checkpoint |
3 trang, 5 checkpoint |
/tin/1, /tin/2, /tin/3 mỗi URL 1 lần |
Mỗi URL 2 lần |
B: mỗi URL một task |
next fetch_one, 2 trang trong state, 3 checkpoint |
3 trang, 5 checkpoint |
Mỗi URL 1 lần |
/tin/1 và /tin/2 vẫn 1 lần, /tin/3 2 lần |
Đọc thiết kế A
Sau lần lỗi, state không có trang nào, dù /tin/1 và /tin/2 đã tải thành công. Kết quả của chúng nằm trong biến cục bộ out của node, mất khi node ném lỗi. Resume chạy lại cả node, tải lại cả ba URL. Máy chủ ghi nhận mỗi URL hai lần.
Kết quả cuối vẫn đúng: 3 trang. Agent nối lại được. Nhưng hai request lặp là chi phí ẩn, nhân lên theo số nguồn và số lần lỗi.
Đọc thiết kế B
Sau lần lỗi, get_state cho thấy 2 trang đã có trong state và danh sách task gồm hai fetch_one không lỗi và một fetch_one có lỗi. Resume chỉ chạy lại task lỗi. Máy chủ ghi nhận /tin/1 và /tin/2 mỗi URL đúng một lần trong cả hai lần chạy, chỉ /tin/3 được gọi lại.
Đây là hành vi mong muốn cho agent web: không gọi lại nguồn đã đọc xong. Với mười nguồn và một nguồn lỗi, khác biệt giữa hai thiết kế là chín request thừa mỗi lần resume. Với nguồn có quota theo ngày, chín request đó có thể là phần quota cuối cùng.
Thread sai không chạy lại gì
Với thread_id sai, cả hai thiết kế đều báo EmptyInputError và không gửi request nào. Nhật ký máy chủ không thay đổi. Đây là hàng rào tốt: sai thread_id không âm thầm biến thành chạy lại toàn bộ.
Thử lại ngay trong lần chạy
Lab chạy thêm thiết kế B với RetryPolicy gồm max_attempts 3, initial_interval 0,5 giây, chỉ thử lại khi gặp HTTPStatusError. Máy chủ cho /tin/3 lỗi một lần rồi trả 200. Kết quả: đồ thị chạy xong trong một lần, /tin/3 được gọi 2 lần, hai URL kia 1 lần, không cần resume.
rp = RetryPolicy(max_attempts=3, initial_interval=0.5, retry_on=httpx.HTTPStatusError)
g.add_node("fetch_one", fetch_one, retry_policy=rp)
RetryPolicy và checkpoint bổ sung cho nhau. RetryPolicy xử lý lỗi thoáng qua trong vài giây. Checkpoint xử lý lỗi kéo dài hay tiến trình chết, khi việc thử lại phải đợi tới lần chạy sau.
Đối soát state và số lần tool thực sự gọi mạng với LangGraph checkpoint cho agent web
Phần này biến kết quả lab thành quy tắc thiết kế.
Lỗi nào nên để đồ thị dừng
Không phải lỗi nào cũng nên ném ra ngoài. 404 của một nguồn trong mười nguồn là dữ liệu: nguồn đó không còn. Task có thể bắt lỗi và trả về một phần tử đánh dấu nguồn hỏng, để đồ thị chạy tiếp với chín nguồn. Lỗi nên làm đồ thị dừng là lỗi khiến kết quả vô nghĩa, như mất kết nối toàn bộ hay hết quota.
Quy tắc này giúp agent ít phải resume hơn. Resume dành cho sự cố, không phải cho mọi trang lỗi.
Thứ tự kết quả không cố định
Ở thiết kế B, nhật ký máy chủ của lần chạy đầu ghi /tin/2 trước /tin/1. Các task trong cùng super-step chạy song song, thứ tự hoàn thành không cố định. Node summ của lab sắp xếp theo URL trước khi ghép chuỗi để kết quả ổn định. Mọi bước sau Send cần làm điều tương tự nếu thứ tự có ý nghĩa.
Đếm phía máy chủ, không tin log agent
Lab đếm request từ nhật ký của máy chủ, không từ log trong node. Log trong node có thể ghi trước khi request đi, hoặc không ghi khi lỗi xảy ra giữa chừng. Với nguồn bên ngoài không có nhật ký, đặt một proxy ghi log ở giữa hoặc bọc client HTTP bằng một lớp đếm.
Quy tắc một lời gọi web một task
Mỗi lời gọi tới một nguồn bên ngoài nên là một task riêng, qua Send hay một node riêng. Như vậy kết quả của nó thành pending write ngay khi xong, và resume không gọi lại. Node gộp nhiều lời gọi chỉ hợp khi các lời gọi rẻ và an toàn để lặp.
Tool phải idempotent khi không tách được
Có lúc không tách được, ví dụ tool của một thư viện ngoài tự gọi nhiều request. Khi đó tool cần idempotent: gọi lại không gây tác dụng phụ. Đọc trang là idempotent về mặt dữ liệu, nhưng vẫn tốn quota và tăng tải cho nguồn. Gửi form, đăng bài, thanh toán thì không được nằm trong node có thể bị chạy lại mà không kiểm tra.
Cache ở tầng HTTP
Một lớp cache theo URL trong client HTTP giảm thiệt hại của thiết kế A: lần resume đọc từ cache thay vì gọi mạng. Cache cần lưu bền như checkpoint, nếu không tiến trình mới lại bắt đầu với cache trống. Bài HTTP Range tải tiếp qua proxy có cách tải tiếp tệp lớn khi đứt giữa chừng, một bài toán gần.
Đối soát state sau resume
Sau resume, kiểm ba điều: số trang trong state bằng số URL kế hoạch, không có URL nào xuất hiện hai lần trong pages, và summary chứa đủ URL. Với reducer operator.add, nếu một task bị chạy lại mà task cũ đã ghi, có thể xuất hiện bản trùng. Lab không gặp trùng vì task lỗi không ghi gì.
Xem lịch sử để gỡ lỗi
get_state_history trả mọi checkpoint của thread theo thứ tự mới tới cũ. Mỗi checkpoint có next và values. Khi agent cho kết quả lạ, đi ngược lịch sử để xem state thay đổi ở bước nào. Đây là lợi ích phụ của checkpoint mà nhiều người chỉ nhận ra khi cần gỡ lỗi.
Đầu ra nghiệm thu: workflow bị ngắt rồi resume với state trước/sau và số tool call thực tế của LangGraph checkpoint cho agent web
Phần cuối gom lại bộ bàn giao và vai trò của proxy.
Bộ bàn giao
Bộ bàn giao gồm đồ thị với checkpointer bền, quy ước đặt thread_id và kịch bản thử lỗi giống lab chạy trên chính tool của agent. Kèm bảng gồm state trước resume, state sau resume, số request mỗi nguồn phía máy chủ. Kèm phiên bản các gói LangGraph đã dùng.
Kiểm thử bằng máy chủ giả
Kịch bản lỗi của lab dễ đưa vào test tự động: một máy chủ cục bộ có cờ lỗi, một bộ đếm request, hai lần gọi invoke. Test khẳng định số request mỗi URL không vượt mức cho phép. Khi ai đó gộp các task lại thành một node, test sẽ đỏ.
Giới hạn của lab
Lab không có LLM, các node là hàm xác định. Với agent dùng LLM chọn tool, việc LLM có gọi lại tool hay không sau resume còn phụ thuộc vào cách đồ thị lưu tin nhắn và lời gọi tool. Lab chỉ thử SqliteSaver, chưa thử Postgres hay chế độ lưu bất đồng bộ. Chưa thử giết tiến trình giữa lúc một task đang chạy dở.
Giới hạn song song khi fan-out
Send với hàng trăm URL tạo hàng trăm task trong một super-step. Nếu chúng cùng nhắm một website, đó là một đợt request dồn dập. Cần giới hạn số task chạy cùng lúc ở cấu hình chạy, hoặc chia danh sách thành từng lô qua nhiều super-step, kèm độ trễ giữa các request cùng tên miền. Bài rate limit API khi dùng proxy có cách tính nhịp gọi.
Theo dõi thread bị treo
Thread lỗi mà không ai resume sẽ nằm mãi trong kho với next khác rỗng. Một tác vụ định kỳ quét các thread có next khác rỗng và checkpoint cuối cũ hơn một ngưỡng, ví dụ một giờ, rồi báo lên kênh vận hành. Người trực quyết định resume, sửa state, hay đóng thread.
Không tự động resume mọi thread lỗi theo vòng lặp vô hạn. Nguồn chết hẳn sẽ làm thread lỗi lặp lại mãi, mỗi lần tạo thêm request và checkpoint.
Kích thước kho
Tệp cp.sqlite của lab nặng 28.672 byte sau vài thread nhỏ, mỗi state chỉ vài trăm byte. Với agent thật lưu cả nội dung trang trong state, mỗi checkpoint có thể vài trăm KB. Mười bước, trăm thread mỗi ngày là vài trăm MB mỗi ngày. Nên lưu nội dung trang ở kho riêng và chỉ giữ đường dẫn hay mã băm trong state.
Bảo vệ kho checkpoint
Checkpoint chứa state đầy đủ: nội dung trang đã tải, tham số tool, có khi cả token hay cookie nếu chúng nằm trong state. Kho checkpoint cần được bảo vệ như cơ sở dữ liệu ứng dụng. Không đưa khóa API vào state, truyền qua cấu hình hay biến môi trường của tool.
Khi nào cần proxy với LangGraph checkpoint cho agent web
Checkpoint không lưu kết nối mạng, chỉ lưu dữ liệu. Proxy là chuyện của client HTTP trong tool: httpx nhận tham số proxy hay đọc biến môi trường. Proxy cần khi agent chạy trên máy chủ chỉ ra Internet qua proxy, hoặc khi nguồn yêu cầu IP cố định.
Một chi tiết liên quan tới resume: nếu agent xoay proxy giữa hai lần chạy, task resume sẽ đi qua IP khác với task cũ. Với nguồn có phiên gắn IP, điều này có thể làm lỗi lại. Bài proxy cho AI agent tự động bàn cách chọn loại proxy cho agent. Với agent cần IP thoát ổn định tại Việt Nam, anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Chuỗi proxy viết theo bài định dạng proxy.
Checklist LangGraph checkpoint cho agent web
Checklist checkpoint
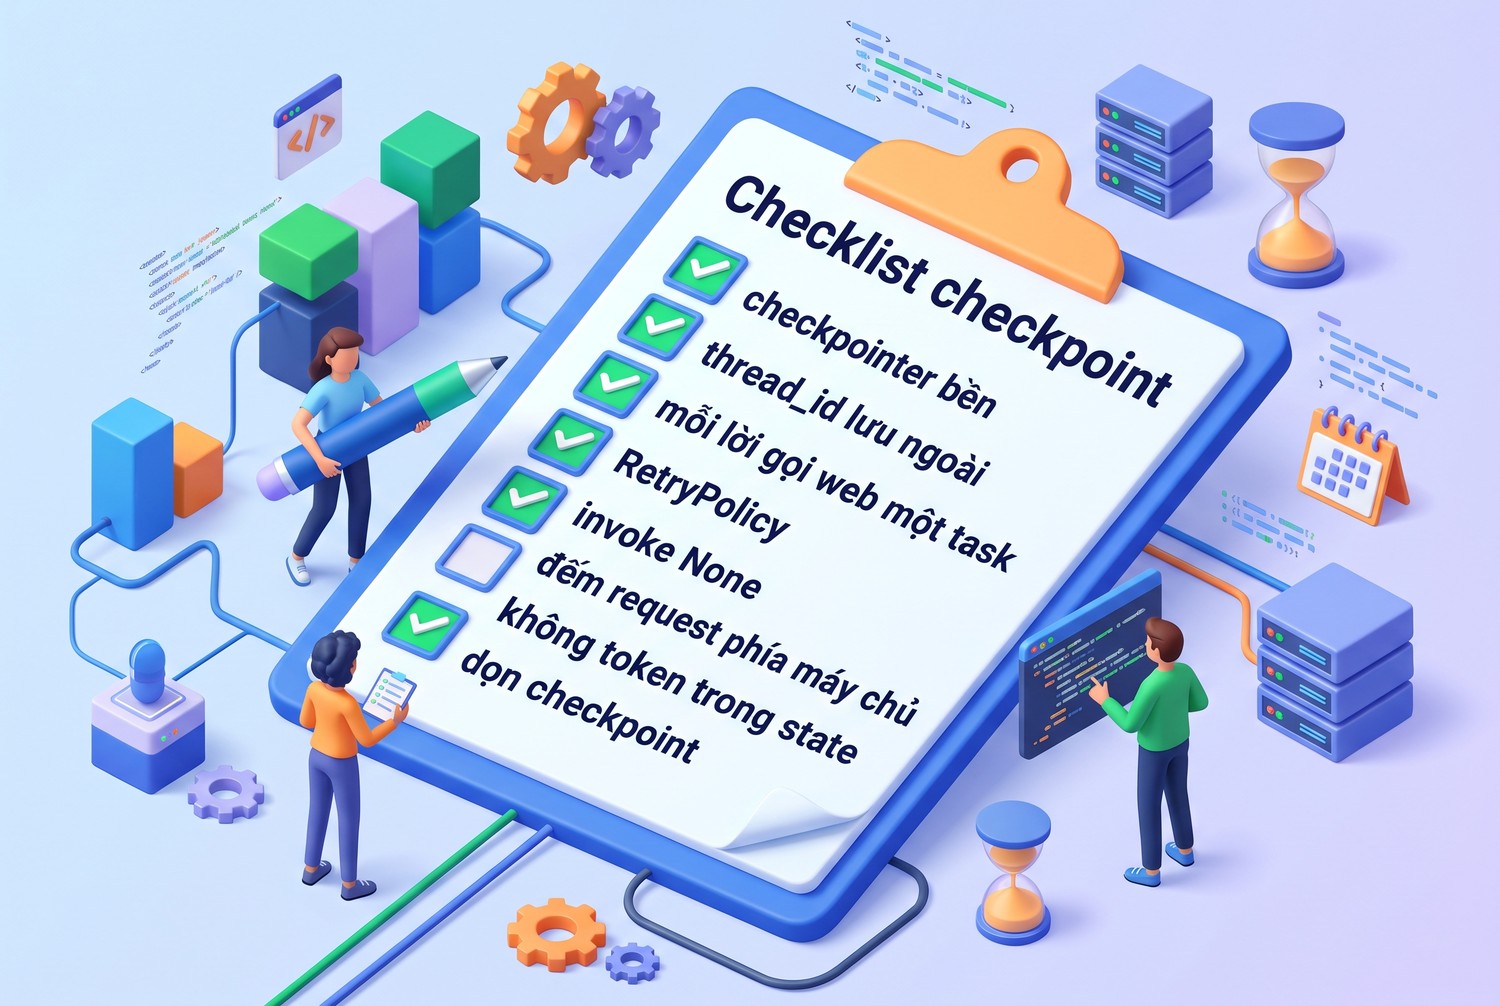
- Dùng checkpointer bền, không dùng InMemorySaver ngoài test.
- thread_id có ý nghĩa và được lưu ngoài tiến trình.
- Mỗi lời gọi web là một task riêng qua Send hay node riêng.
- Gắn RetryPolicy cho lỗi thoáng qua, để checkpoint lo lỗi kéo dài.
- Resume bằng invoke với None và cùng thread_id.
- Đếm request phía máy chủ hay proxy khi thử nghiệm.
- Không đưa token vào state.
- Có lịch dọn checkpoint cũ.
Câu hỏi thường gặp về LangGraph checkpoint cho agent web
Resume có gọi lại web tool đã xong không?
Tùy thiết kế. Một node tải nhiều URL thì gọi lại cả node. Mỗi URL một task thì chỉ task lỗi chạy lại.
Làm sao nối lại một thread?
Gọi invoke với đầu vào None và cùng config có thread_id.
Gõ sai thread_id thì sao?
Lab nhận EmptyInputError và không có request nào được gửi.
InMemorySaver có dùng được cho agent thật không?
Không nên. Tiến trình dừng là mất checkpoint, mà lỗi web thường đi kèm tiến trình dừng.
RetryPolicy khác checkpoint thế nào?
RetryPolicy thử lại ngay trong lần chạy. Checkpoint cho phép chạy tiếp ở lần sau, kể cả sau khi khởi động lại.
Checkpoint có lưu proxy không?
Không. Proxy thuộc client HTTP trong tool, checkpoint chỉ lưu state.
LangGraph checkpoint cho agent web và những điều cần nhớ
LangGraph checkpoint cho agent web giúp agent nối lại sau lỗi tool mà không làm lại từ đầu. Lab ngày 03/11/2026 cho thấy node gộp ba URL vẫn gọi lại cả ba khi resume, còn mỗi URL một task qua Send thì chỉ gọi lại URL lỗi. Dùng kho bền, giữ thread_id, tách lời gọi web thành task. Cần IP ổn định cho LangGraph checkpoint cho agent web, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


