HTTP Content-Digest kiểm toàn vẹn: digest đúng lớp mã hóa
HTTP Content-Digest kiểm toàn vẹn là việc dùng trường Content-Digest theo RFC 9530 để xác nhận byte nhận được đúng là byte server đã gửi, sau khi đi qua proxy, cache hay bất kỳ lớp trung gian nào. Cái khó không nằm ở phép băm, mà ở chỗ băm đúng lớp: byte trên dây, byte đã giải nén, hay toàn bộ đại diện. ProxyVN dựng một origin trả JSON thường, gzip và range, cùng bốn kiểu proxy giữ nguyên, sửa một byte, giải nén và tính lại digest, rồi kiểm bằng requests, httpx và http_sfv thật.
HTTP Content-Digest kiểm toàn vẹn: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và ranh giới.
Bài toán cần giải
Một crawler tải dữ liệu giá qua proxy và lưu vào kho. Thỉnh thoảng có bản ghi lạ: một ký tự trong URL bị đổi, giá vẫn là số hợp lệ. JSON parse được, không có lỗi nào. Server có gửi Content-Digest, nhưng crawler băm r.content và luôn thấy lệch, nên đã tắt kiểm tra từ lâu. Lỗi thật lọt qua vì phép kiểm sai lớp.
Đầu ra nghiệm thu
Đầu ra là một bảng: mỗi ca có mã, Content-Encoding, kích thước byte nhận, kết quả so Content-Digest trên byte trên dây và trên byte đã giải nén, kết quả so Repr-Digest, và JSON có parse được không. Bảng phải có ca sửa một byte, ca gzip, ca range và ca proxy tính lại digest. Kèm theo là kết luận lớp nào kiểm được gì.
Ranh giới với bài SimHash và WARC
Bài SimHash chống trùng nội dung crawl băm nội dung trang để phát hiện trang gần giống nhau, đó là băm phía crawler cho mục đích khử trùng. Bài lưu website dạng WARC có payload digest của bản lưu trữ. Bài này nói về trường digest do server gửi trong thông điệp HTTP, để kiểm byte không bị đổi trên đường.
Không phải chữ ký nguồn
Digest chỉ nói byte có khớp với giá trị băm đi kèm hay không. Ai cũng tính được SHA-256. Một lớp trung gian sửa nội dung và tính lại digest sẽ qua mọi phép kiểm. Lab có đúng ca này. Xác thực nguồn cần TLS hoặc chữ ký, ngoài phạm vi bài.
Giới hạn của lab
Origin và proxy đều là http.server tự viết, nghe ở 127.0.0.1:9781 và 9782. Origin tự tính digest theo RFC 9530. Các kiểu proxy sửa nội dung do ProxyVN viết để mô phỏng lỗi. Thứ thật trong lab là requests 2.34.2, httpx 0.28.1, http_sfv 0.9.9, gzip và hashlib của Python 3.12.10.
Ai nên đọc
Người viết crawler hoặc client tải dữ liệu qua nhiều lớp trung gian. Người muốn thêm bước kiểm toàn vẹn mà không gặp báo động giả. Người đang thấy dữ liệu sai lặt vặt mà không rõ do nguồn hay do đường đi.
Xác minh HTTP Content-Digest kiểm toàn vẹn sau tải qua intermediary và phân biệt representation digest
Phần này tóm tắt RFC 9530, chỉ giữ ý cần cho client.
Hai trường digest
RFC 9530 định nghĩa Content-Digest và Repr-Digest. Content-Digest tính trên nội dung thông điệp thực tế. Repr-Digest tính trên toàn bộ dữ liệu đại diện được chọn. RFC này thay cho trường Digest cũ của RFC 3230.
Vì sao có hai trường
Một trường duy nhất không đủ vì HTTP có nhiều cách gửi cùng một tài nguyên: đủ, một đoạn, không body với HEAD. Content-Digest giúp kiểm đúng thứ vừa nhận. Repr-Digest giúp kiểm tài nguyên dù nhận theo kiểu nào. Client chọn trường theo mục đích, không dùng lẫn.
Định dạng Structured Field
Cả hai trường là Dictionary theo chuẩn Structured Field Values. Khóa là tên thuật toán, giá trị là Byte Sequence chứa kết quả băm dạng base64 giữa hai dấu hai chấm. Một trường có thể mang nhiều thuật toán cùng lúc, để hỗ trợ các bên khác nhau.
Content-Digest: sha-256=:RK/0qy18MlBSVnWgjwz6lZEWjP/lF5HF9bvEF8FabDg=:Giá trị trên là ví dụ trong RFC 9530 cho chuỗi {"hello": "world"} kèm LF.
Lab kiểm lại ví dụ của RFC
Trước khi dựng gì, lab tính SHA-256 cho chuỗi trong ví dụ B.1 của RFC và cho chuỗi rỗng trong ví dụ B.2. Cả hai trùng nguyên văn với RFC.
RFC 9530 B.1 '{"hello": "world"}\n' -> sha-256=:RK/0qy18MlBSVnWgjwz6lZEWjP/lF5HF9bvEF8FabDg=:
RFC 9530 B.2 rong -> sha-256=:47DEQpj8HBSa+/TImW+5JCeuQeRkm5NMpJWZG3hSuFU=:
Bước này bảo đảm hàm tạo digest của lab đúng định dạng trước khi dùng nó để kết luận về client.
Content-Digest và Repr-Digest khác nhau khi nào
Content-Digest và Repr-Digest
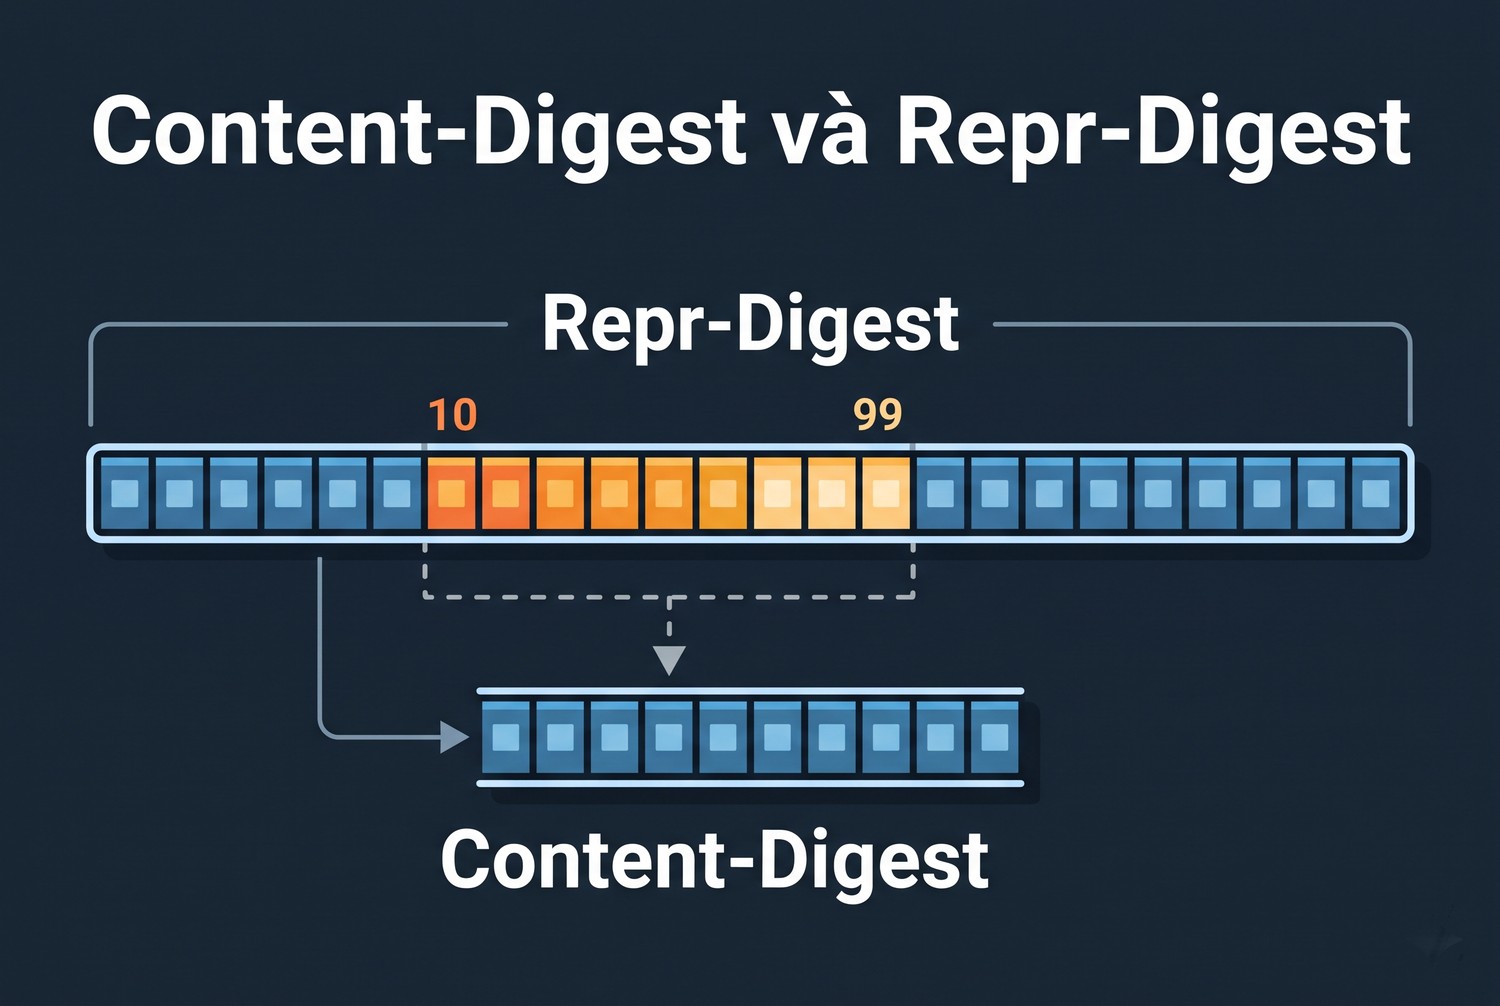
Với phản hồi 200 trả đủ đại diện, hai trường có cùng giá trị, như ví dụ B.1. Với HEAD, Content-Digest tính trên nội dung rỗng, Repr-Digest vẫn tính trên đại diện. Với 206 Partial Content, Content-Digest chỉ tính trên đoạn được gửi, Repr-Digest tính trên toàn bộ.
Content-Encoding thuộc về đại diện
Đây là chỗ hay hiểu sai. Theo HTTP, Content-Encoding như gzip là một phần của đại diện. Dữ liệu đại diện của phản hồi gzip là byte đã nén. Vì vậy cả Content-Digest lẫn Repr-Digest của phản hồi gzip đều tính trên byte nén. Băm byte đã giải nén sẽ luôn lệch.
Transfer-Encoding thì không
Transfer-Encoding chunked của HTTP/1.1 là cách truyền, không thuộc đại diện, không thuộc nội dung theo nghĩa của RFC 9530. Byte của các chunk sau khi ghép lại mới là nội dung. Thư viện client đã ghép chunk trước khi trả byte cho anh em, nên chunked không ảnh hưởng phép kiểm.
Bảng ba lớp
Bảng dưới gom ba lớp byte mà client có thể băm và trường nào tương ứng.
Lớp byte |
Ví dụ với gzip |
Trường tương ứng |
|---|---|---|
Byte nội dung nhận được |
365 byte nén |
Content-Digest |
Toàn bộ đại diện |
365 byte nén, kể cả khi chỉ nhận một đoạn |
Repr-Digest |
Byte sau khi giải nén |
2412 byte JSON |
Không trường nào |
Người nhận có thể bỏ qua
RFC nói người nhận có thể bỏ qua một số hoặc mọi digest, và chính sách cục bộ có thể đặt thêm ràng buộc. Người gửi có thể gửi digest mà không biết bên nhận có hỗ trợ thuật toán đó không. Client tự quyết định thuật toán nào chấp nhận và làm gì khi lệch.
Thuật toán được phép
Registry của RFC 9530 ghi sha-256 và sha-512 là Active. md5, sha, unixsum, unixcksum, adler, crc32c là Deprecated, trong đó md5 và sha-1 có ghi chú dễ bị tấn công va chạm. Client nên chỉ chấp nhận sha-256 và sha-512, coi thuật toán khác là không có digest.
Digest trong trailer
RFC cho phép gửi Content-Digest trong phần trailer, sau body, và người nhận có thể gộp vào phần header. Cách này giúp server đang phát dữ liệu dần vẫn gửi được digest khi đã tính xong. requests và httpx không phơi trailer ra một cách thuận tiện. Lab không thử trailer, chỉ dùng digest ở header.
Xin digest bằng Want-Content-Digest
RFC định nghĩa Want-Content-Digest và Want-Repr-Digest để bên gửi request nói mình muốn nhận digest với thuật toán nào, giá trị ưu tiên từ 0 tới 10. Đây chỉ là gợi ý, server có thể bỏ qua. Lab không gửi các trường này vì origin lab luôn trả digest.
Phân biệt digest của content với representation trong HTTP Content-Digest kiểm toàn vẹn
Phần này dựng origin lab và chạy ba ca cơ bản.
Dữ liệu và ba đường dẫn
Dữ liệu là JSON 39 sản phẩm kèm LF, 2412 byte. Bản gzip nén với mtime 0 để byte ổn định qua các lần chạy, 365 byte. Origin có đường dẫn /plain trả JSON thường, /gz trả gzip, và hỗ trợ header Range trên cả hai.
DATA = json.dumps({"items": [{"id": i, "url": f"https://shop.test/p/{i}", "price": 100000 + i}
                             for i in range(1, 40)]}).encode() + b"\n"
GZ = gzip.compress(DATA, mtime=0)
mtime=0 quan trọng: gzip mặc định ghi thời gian vào header, làm byte nén đổi mỗi lần nén.
Origin tính digest
Origin xác định đại diện là byte nén nếu là /gz, byte thường nếu không. Nội dung là đại diện, hoặc một đoạn của đại diện nếu có Range. Content-Digest tính trên nội dung, Repr-Digest tính trên đại diện.
rep = GZ if gz else DATA
content = rep
if rg:
    a, b = [int(x) for x in rg.split("=")[1].split("-")]
    content = rep[a:b + 1]; code = 206
hdr += [("Content-Digest", sf_digest(content)), ("Repr-Digest", sf_digest(rep))]
sf_digest trả chuỗi dạng sha-256=:base64:, cùng hàm đã kiểm với ví dụ của RFC.
Đọc byte trên dây
Client lấy byte trên dây bằng r.raw.read(decode_content=False) của requests với stream=True. Byte này là nội dung theo RFC 9530. Byte đã giải nén lấy bằng gzip.decompress nếu có Content-Encoding gzip.
r = requests.get(url, headers=headers or {}, stream=True)
wire = r.raw.read(decode_content=False)
decoded = gzip.decompress(wire) if r.headers.get("Content-Encoding") == "gzip" else wire
Với requests không có stream=True, byte trên dây đã bị giải nén và không lấy lại được.
Parse trường bằng http_sfv
Lab dùng thư viện http_sfv 0.9.9 để parse Dictionary, thay vì tách chuỗi bằng tay. Giá trị đúng là Byte Sequence trả về kiểu bytes. Giá trị sai kiểu bị đánh dấu riêng.
def parse(field):
    d = http_sfv.Dictionary(); d.parse(field.encode())
    return {k: (v.value if isinstance(v.value, bytes) else None) for k, v in d.items()}
Parse bằng tay dễ hỏng khi có nhiều thuật toán, khoảng trắng hoặc tham số.
Vì sao kiểm cả hai lớp trong lab
Bảng lab băm cả byte nhận và byte đã giải nén ở mọi ca, để thấy lớp nào cho kết quả đúng. Client thật chỉ cần băm byte nhận. Cột byte giải nén trong bảng là bằng chứng cho việc không nên làm cách đó, không phải một phép kiểm nên giữ.
Ca JSON thường
Origin trả 200, không nén, 2412 byte. Content-Digest khớp trên byte nhận, khớp cả trên byte đã giải nén vì hai lớp trùng nhau, Repr-Digest khớp. JSON parse được.
Phiên bản thư viện
Lab chạy requests 2.34.2, httpx 0.28.1 và http_sfv 0.9.9. Cách lấy byte thô của hai thư viện HTTP ổn định qua nhiều phiên bản. http_sfv còn ở số phiên bản dưới 1, nên giao diện có thể đổi. Ghi phiên bản vào tệp yêu cầu và chạy lại ca ví dụ của RFC sau mỗi lần nâng cấp.
Ca gzip
Origin trả 200, gzip, 365 byte. Content-Digest khớp trên byte nhận 365 byte, lệch trên byte đã giải nén 2412 byte. Repr-Digest khớp trên byte nhận. Đây là ca cho thấy rõ nhất phải băm byte nén.
Ca range
Client gửi Range bytes=10-99, origin trả 206 với 90 byte. Content-Digest khớp trên 90 byte nhận. Repr-Digest lệch với 90 byte, nhưng khớp khi client tải đủ tài nguyên rồi băm. Hai trường khác giá trị, đúng như ví dụ B.3 của RFC.
206 Content-Digest == Repr-Digest ? False
ghep phan + doi RD voi ca tai nguyen: KHOP
Với tải tiếp tục theo range, Repr-Digest là cách kiểm toàn bộ tệp sau khi ghép các đoạn. Bài HTTP Range tải tiếp qua proxy nói kỹ hơn về tải theo đoạn.
Lưu body và trường digest ở đúng lớp mã hóa cho HTTP Content-Digest kiểm toàn vẹn
Phần này nói về cái bẫy phổ biến nhất: thư viện tự giải nén.
requests r.content đã giải nén
Bẫy r.content đã giải nén
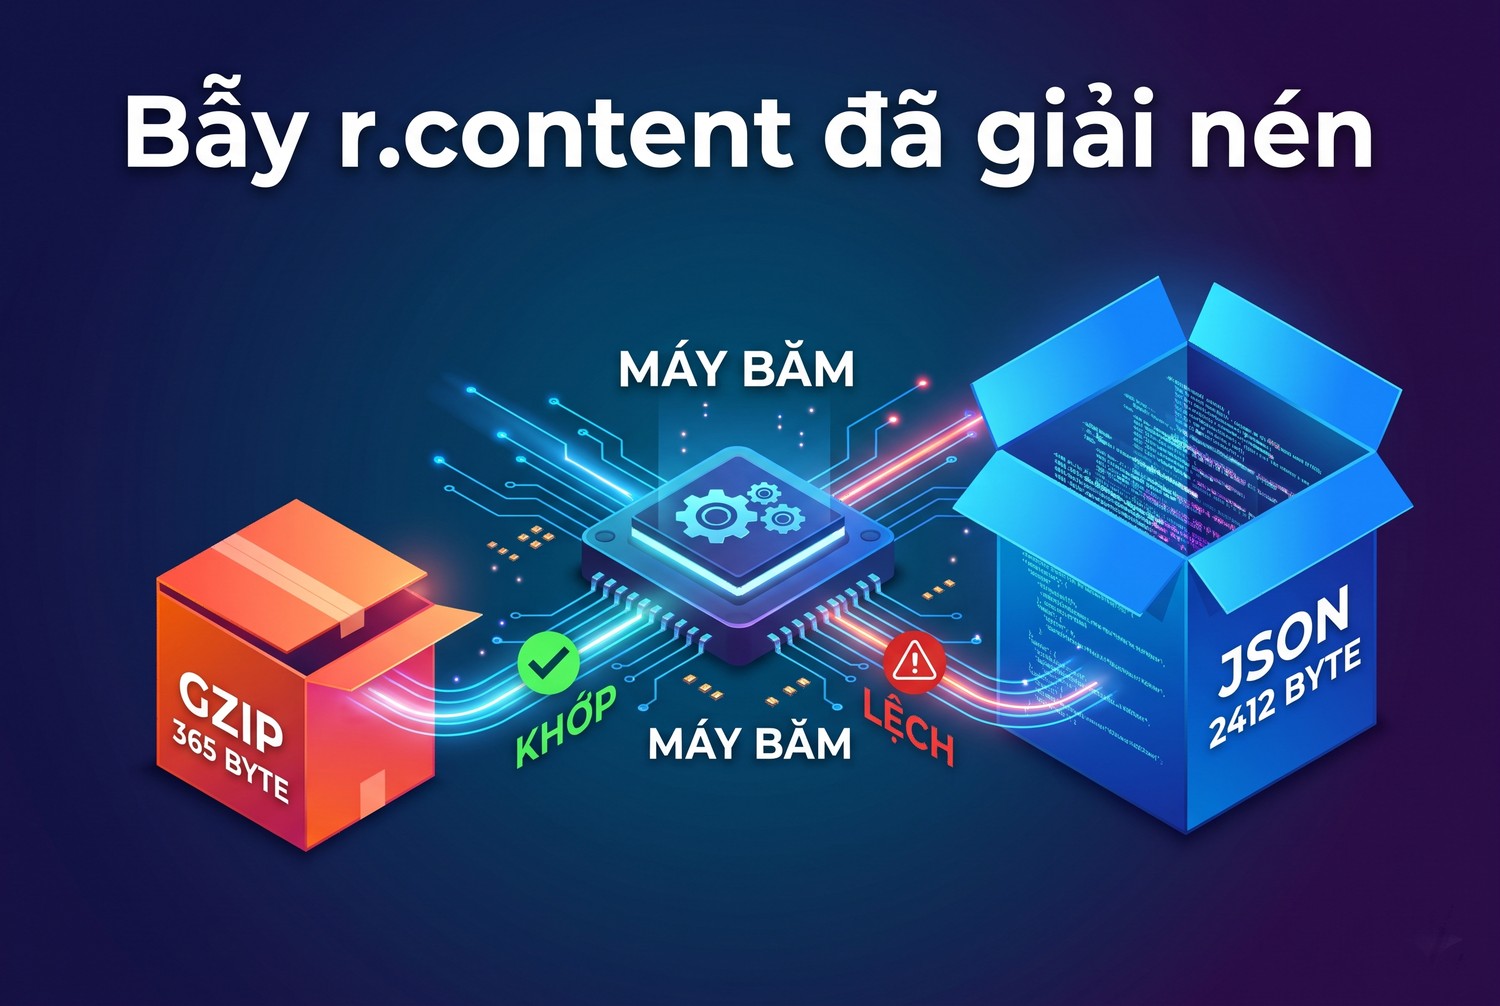
Gọi requests.get bình thường trên /gz, r.content dài 2412 byte, là JSON đã giải nén. Băm r.content so với Content-Digest cho kết quả lệch. Byte gốc 365 byte đã mất khỏi đối tượng phản hồi.
requests r.content 2412 B -> LECH | byte goc 365 BĐây là nguyên nhân của câu chuyện ở đầu bài: phép kiểm luôn báo lệch nên bị tắt.
httpx cũng giải nén
httpx 0.28.1 cho kết quả tương tự với r.content: 2412 byte, lệch. httpx có iter_raw trên phản hồi stream, trả byte chưa giải nén. Băm 365 byte từ iter_raw cho kết quả khớp.
httpx 0.28.1 r.content 2412 B -> LECH
httpx iter_raw 365 B -> KHOP
Với cả hai thư viện, muốn kiểm digest thì phải yêu cầu byte thô một cách tường minh.
Lưu cả hai lớp
Crawler nên lưu byte trên dây khi cần kiểm hoặc lưu trữ lâu dài, và lưu bản giải nén cho xử lý. Digest đi kèm byte trên dây, không đi kèm bản giải nén. Nếu chỉ lưu bản giải nén, sau này không thể kiểm lại digest.
Ghi trường digest cùng dữ liệu
Lưu nguyên giá trị Content-Digest, Repr-Digest, Content-Encoding và Content-Range nếu có. Bốn trường này đủ để kiểm lại bất cứ lúc nào mà không cần tải lại. Thiếu Content-Encoding, người kiểm sau không biết digest tính trên byte nén hay không.
Đọc raw khi có cả chunked và gzip
Phản hồi có thể vừa chunked vừa gzip. Thư viện ghép chunk trước, rồi mới đến bước giải nén. r.raw.read với decode_content=False trả byte sau khi ghép chunk nhưng trước khi giải nén. Đây đúng là nội dung theo RFC 9530, nên phép kiểm không cần làm gì thêm với chunked.
Không tự nén lại để so
Một cách sửa sai là giải nén, rồi nén lại để băm. Byte nén phụ thuộc mức nén, thời gian trong header gzip, phiên bản thư viện. Lab phải đặt mtime=0 mới có byte ổn định ngay trên cùng máy. Nén lại gần như không bao giờ ra đúng byte của server.
Accept-Encoding quyết định lớp
Client gửi Accept-Encoding gzip thì có thể nhận đại diện nén, không gửi thì nhận đại diện thường. Hai đại diện có digest khác nhau. requests và httpx gửi Accept-Encoding mặc định. Khi so digest giữa hai lần tải, kiểm cả Content-Encoding của hai lần. Bài gzip và brotli khi web scraping có thêm chi tiết về nén.
Bộ nhớ khi đọc raw
Đọc raw cả body vào bộ nhớ như lab chỉ hợp với tệp vừa. Với tệp lớn, đọc raw theo khối, vừa ghi ra đĩa vừa cập nhật đối tượng băm. hashlib hỗ trợ cập nhật từng phần. Cách này kiểm được tệp vài GB mà không tốn bộ nhớ.
h = hashlib.sha256()
with requests.get(url, stream=True) as r, open(path, "wb") as f:
    for chunk in r.raw.stream(65536, decode_content=False):
        f.write(chunk); h.update(chunk)
Đoạn này là ví dụ triển khai, lab chưa chạy với tệp lớn.
Thứ tự kiểm khi lệch
Khi digest lệch, kiểm theo thứ tự: đang băm byte nào, Content-Encoding là gì, có Content-Range không, thuật toán có đúng sha-256 không. Bốn câu này loại hết các lệch do phía client trước khi nghi ngờ đường đi.
Sửa một byte fixture rồi xác minh HTTP Content-Digest kiểm toàn vẹn
Phần này cho proxy sửa nội dung theo nhiều kiểu.
Bốn kiểu proxy
Proxy lab nhận đường dẫn dạng /chế-độ@URL-origin. Chế độ pass chuyển nguyên. Chế độ flip đảo một bit của byte giữa body, giữ nguyên digest. Chế độ decode giải nén gzip, bỏ Content-Encoding, giữ digest. Chế độ resign đảo một bit rồi tính lại cả hai digest.
if mode in ("flip", "resign"):
    i = len(body) // 2; body = body[:i] + bytes([body[i] ^ 0x01]) + body[i + 1:]
if mode == "decode" and h.get("Content-Encoding") == "gzip":
    body = gzip.decompress(body); h.pop("Content-Encoding")
if mode == "resign":
    h["Content-Digest"] = sf_digest(body); h["Repr-Digest"] = sf_digest(body)
Mọi chế độ đều thêm Via để biết phản hồi đã qua proxy nào.
Sửa một byte trên JSON thường
Sửa một byte
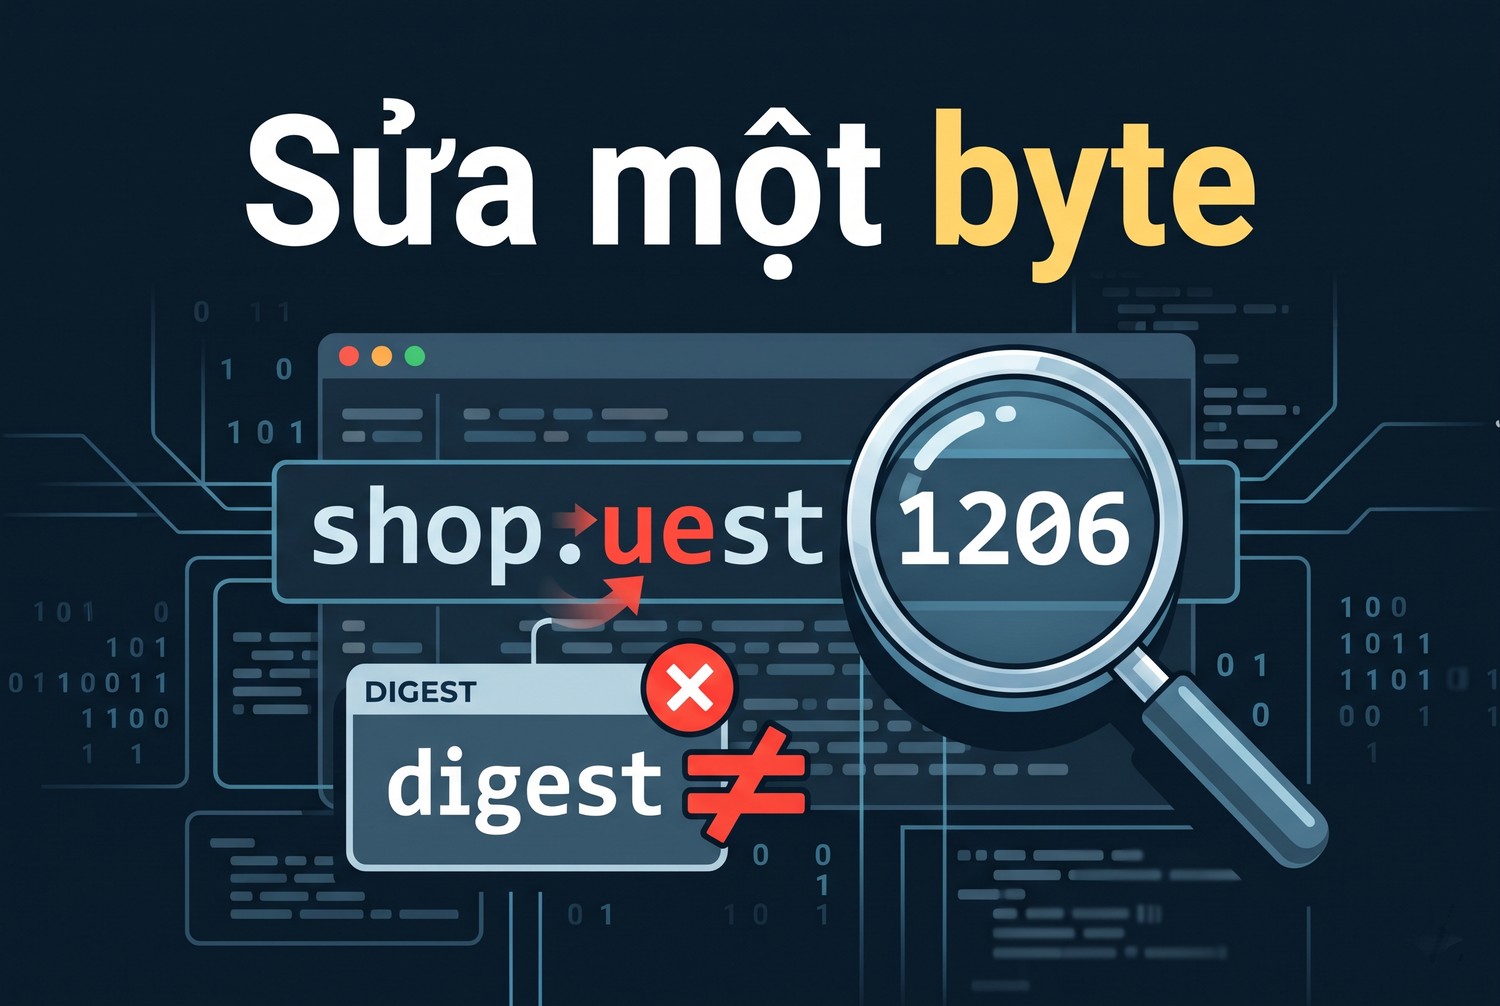
Proxy flip trên /plain đổi byte ở vị trí 1206. Content-Digest lệch, Repr-Digest lệch. JSON vẫn parse được.
byte bi sua o vi tri 1206 : b's://shop.test/p/20", "pr' -> b's://shop.tesu/p/20", "pr'Chữ t trong shop.test thành u. URL sai nhưng JSON hợp lệ. Không có digest, lỗi này lọt thẳng vào kho.
Sửa một byte trên gzip
Proxy flip trên /gz đổi một byte trong dữ liệu nén. Content-Digest lệch. Giải nén thất bại vì gzip có kiểm CRC riêng: BadGzipFile, CRC check failed. Ở ca này, lớp gzip tự bắt được lỗi, digest là lớp kiểm thứ hai.
Vì sao proxy giải nén
Một số proxy giải nén để quét nội dung, nén lại theo cách khác, hoặc bỏ nén vì client cũ không hỗ trợ. Header Cache-Control no-transform cho phép server yêu cầu lớp trung gian không biến đổi nội dung. Proxy không tôn trọng chỉ thị này là nguyên nhân hay gặp của digest lệch ở ca thật.
Proxy giải nén
Proxy decode giải nén và bỏ Content-Encoding, nhưng giữ digest của byte nén. Client nhận 2412 byte JSON thường, digest lệch ở mọi lớp. Nội dung không sai về nghĩa, nhưng đại diện đã bị biến đổi. RFC 9530 mục 6.2 nhắc đúng loại proxy biến đổi này như một thứ digest giúp phát hiện.
Proxy tính lại digest
Proxy resign sửa một byte rồi tính lại digest. Mọi phép kiểm đều khớp, JSON parse được. Dữ liệu sai mà không có dấu hiệu nào. Đây là minh họa trực tiếp cho câu trong RFC 9530 mục 6.1: một tác nhân trên đường có thể thay digest bằng giá trị tính trên nội dung đã sửa.
Digest lệch là tín hiệu. Digest khớp chỉ là không có tín hiệu. Hai thứ này không đối xứng.
Bảng kết quả
Bảng dưới là output thật của lab, gom gọn.
Ca |
Mã |
Mã hóa |
Byte |
CD byte nhận |
CD byte giải nén |
RD |
JSON |
|---|---|---|---|---|---|---|---|
origin thường |
200 |
không |
2412 |
KHỚP |
KHỚP |
KHỚP |
được |
origin gzip |
200 |
gzip |
365 |
KHỚP |
LỆCH |
KHỚP |
được |
origin range 10-99 |
206 |
không |
90 |
KHỚP |
KHỚP |
LỆCH |
không áp dụng |
proxy pass gzip |
200 |
gzip |
365 |
KHỚP |
LỆCH |
KHỚP |
được |
proxy flip thường |
200 |
không |
2412 |
LỆCH |
LỆCH |
LỆCH |
được |
proxy flip gzip |
200 |
gzip |
365 |
LỆCH |
LỆCH |
LỆCH |
CRC lỗi |
proxy decode |
200 |
không |
2412 |
LỆCH |
LỆCH |
LỆCH |
được |
proxy resign |
200 |
không |
2412 |
KHỚP |
KHỚP |
KHỚP |
được |
Đọc bảng theo cột
Cột byte nhận là phép kiểm đúng: khớp ở mọi ca không bị sửa, lệch ở mọi ca bị sửa trừ resign. Cột byte giải nén báo lệch giả ở hai ca gzip hợp lệ. Cột RD lệch ở ca range hợp lệ. Cột JSON chỉ bắt được một ca, nhờ CRC của gzip.
Một bit là đủ
Proxy flip chỉ đảo một bit của một byte. SHA-256 cho kết quả khác hẳn với thay đổi nhỏ nhất. Đây là tính chất cần thiết của hàm băm cho kiểm toàn vẹn. Phép so kích thước tệp không bắt được ca này, vì kích thước giữ nguyên 2412 byte.
Thuật toán lạ và giá trị sai kiểu
Lab thử thêm ba giá trị trường. Trường có cả sha-512 và sha-256 đúng: khớp. Trường chỉ có unixsum: không có thuật toán hỗ trợ. Trường sha-256=AAAA không có dấu hai chấm: giá trị là Token chứ không phải Byte Sequence, hàm kiểm báo sai kiểu. Bản đầu của hàm parse ném TypeError ở ca này, lab sửa rồi mới chạy lại.
Ghi kết quả HTTP Content-Digest kiểm toàn vẹn và không suy ra xác thực danh tính nguồn
Phần này biến bảng thành quy tắc ghi kết quả.
Bốn kết quả có thể có
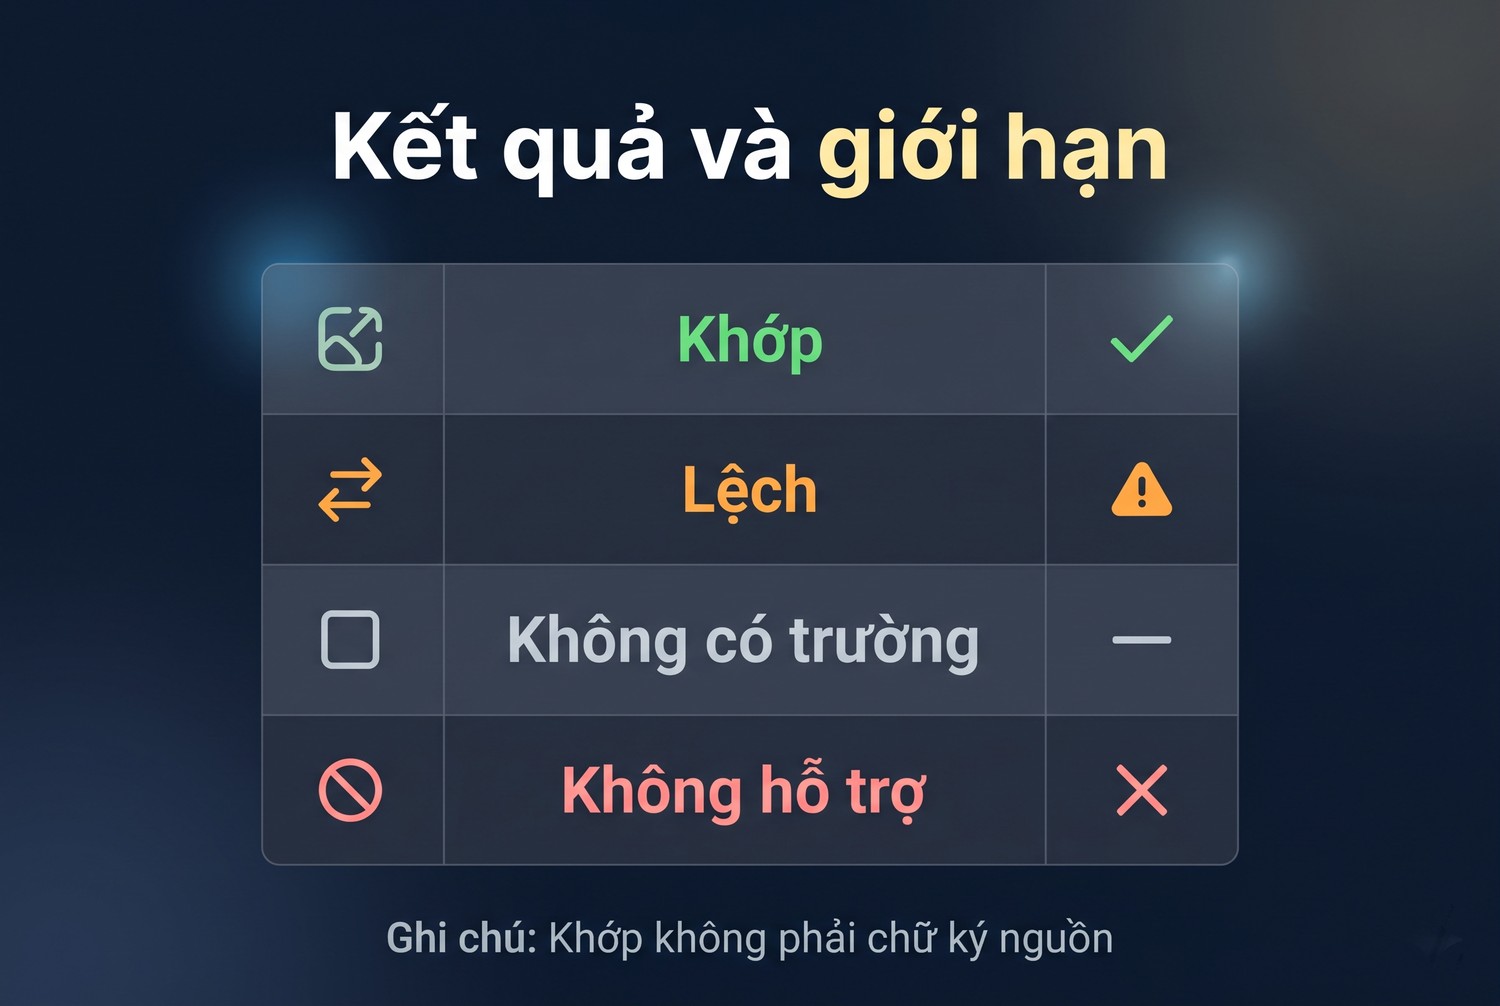
Mỗi lần kiểm cho một trong bốn kết quả: khớp, lệch, không có trường, không có thuật toán hỗ trợ. Ghi đúng một trong bốn, kèm lớp đã băm và thuật toán. Không gộp "không có trường" vào "khớp", vì đó là hai mức tin cậy khác nhau.
{"url": "http://127.0.0.1:9781/gz", "status": 200, "encoding": "gzip",
 "bytes_on_wire": 365, "checked": "content-digest", "alg": "sha-256", "result": "khop"}
Bản ghi mẫu dựng từ ca origin gzip.
Lưu kết quả cạnh bản ghi
Kết quả kiểm nên đi cùng bản ghi dữ liệu tới tận kho, ví dụ một cột integrity. Khi có người hỏi một giá trị lạ có đáng tin không, cột này trả lời ngay: đã kiểm và khớp, đã kiểm và lệch rồi tải lại, hay nguồn không gửi digest.
Khớp nghĩa là gì
Khớp nghĩa là byte nhận được trùng với byte mà ai đó đã băm và đặt vào trường digest. Ai đó có thể là origin, cũng có thể là proxy resign. Khớp không nói ai đã gửi. Viết đúng nghĩa này vào tài liệu nội bộ để không ai đọc kết quả như một bằng chứng xác thực.
Lệch nghĩa là gì
Lệch nghĩa là byte bị đổi sau khi digest được tính, hoặc client băm sai lớp, hoặc digest sai từ đầu. Sau khi đã loại lỗi phía client theo thứ tự kiểm ở phần trước, lệch là tín hiệu mạnh rằng có lớp trung gian biến đổi nội dung. Đây là lúc xem lại proxy, cache và các công cụ kiểm tra lưu lượng.
Cần gì để xác thực nguồn
RFC 9530 mục 6.1 và 6.3 nói muốn chống sửa đổi có chủ đích thì kết hợp digest với TLS hoặc chữ ký số, ví dụ HTTP Message Signatures ký cả trường Content-Digest. Khi đó tính lại digest không đủ, vì chữ ký không khớp. Bài không lab phần chữ ký.
HTTPS và proxy
Với HTTPS đi qua proxy kiểu CONNECT, proxy chỉ chuyển luồng mã hóa, không đọc hay sửa được byte. Digest khi đó chủ yếu bắt lỗi ở origin hoặc ở các lớp sau TLS như CDN. Proxy có giải mã TLS, như công cụ trong bài mitmproxy, thì sửa được cả byte lẫn digest.
Dữ liệu sai do proxy
Bài proxy trả dữ liệu sai nói về các trường hợp nội dung nhận qua proxy khác nội dung thật. Digest là một trong vài cách đo được chuyện này, với điều kiện origin gửi digest. Không có digest, chỉ còn cách tải lại từ đường khác rồi so.
Kiểm khi đổi proxy
Khi đưa một đường proxy mới vào dùng, tải vài tài nguyên có digest qua đường đó và qua đường thẳng, so kết quả kiểm. Nếu đường mới cho lệch còn đường thẳng khớp, đường mới đang biến đổi nội dung. Phép thử này nhanh và nên chạy trước khi đưa đường mới vào pipeline.
Đếm kết quả theo đường đi
Thống kê bốn loại kết quả theo từng đường proxy. Một đường có tỷ lệ lệch cao hơn hẳn các đường khác là đáng nghi. Thống kê theo nguồn giúp tách lỗi của nguồn với lỗi của đường đi, vì lỗi nguồn sẽ lệch ở mọi đường.
Không phải mọi server gửi digest
Content-Digest còn mới, nhiều website không gửi. Crawler nên đếm tỷ lệ phản hồi có digest theo nguồn. Với nguồn không có, ghi "không có trường" và dùng biện pháp khác như so với lần tải trước hay so kích thước. Đừng coi thiếu digest là lỗi.
Đầu ra nghiệm thu của HTTP Content-Digest kiểm toàn vẹn: byte sửa, digest trước và sau decode
Phần này gom tiêu chí và giới hạn.
Danh sách kiểm tra
Kết quả và giới hạn
Client đạt khi mọi dòng dưới đây đúng.
- Băm byte trên dây, lấy bằng raw hoặc iter_raw, không băm r.content.
- Parse trường bằng parser Structured Field, chấp nhận sha-256 và sha-512.
- Với 206, kiểm Content-Digest trên đoạn, Repr-Digest trên tệp đã ghép.
- Lưu byte trên dây cùng Content-Encoding và trường digest.
- Ghi một trong bốn kết quả, kèm lớp và thuật toán.
- Không diễn giải khớp thành xác thực nguồn.
- Ca sửa một byte trong fixture cho kết quả lệch.
Những gì lab chưa chạy
Chưa thử website thật gửi Content-Digest. Chưa thử brotli, zstd, HTTP/2, digest trong trailer, HEAD, request có digest gửi lên server. Chưa thử Want-Content-Digest. Chưa thử HTTP Message Signatures. Các kiểu proxy sửa nội dung là mô phỏng của lab.
Đưa vào pipeline
Bước kiểm digest nên nằm ngay sau bước tải, trước bước parse. Kết quả lệch đưa bản ghi vào hàng chờ tải lại qua đường khác. Kết quả không có trường vẫn đi tiếp, có cờ để biết mức tin cậy. Bước này rẻ, chỉ thêm một phép băm cho mỗi phản hồi.
Chạy lại với nguồn thật
Tìm một nguồn có gửi Content-Digest, tải với và không với Accept-Encoding gzip. Băm byte trên dây ở cả hai lần, so với trường digest của từng lần. Nếu cả hai khớp, client đã băm đúng lớp. Nếu một lần lệch, đọc lại phần bẫy giải nén.
Proxy ở đâu trong luồng
Proxy chuyển tiếp không nên đổi byte. Digest là cách đo việc đó. Khi cần IP tại Việt Nam để tải dữ liệu trong nước, anh em có thể mua proxy tại trang chủ ProxyVN, rồi dùng chính phép kiểm trong bài để xác nhận đường đi không biến đổi nội dung. Vai trò của proxy có ở bài Web Scraping proxy là gì, cách ghi chuỗi cấu hình có ở bài định dạng proxy.
HTTP Content-Digest kiểm toàn vẹn: câu hỏi thường gặp
Các câu dưới đây gom những điểm hay bị hỏi.
Vì sao băm r.content luôn lệch với phản hồi gzip?
Vì r.content đã giải nén. Digest tính trên byte nén. Dùng raw của requests hoặc iter_raw của httpx.
Content-Digest và Repr-Digest khác nhau thế nào?
Content-Digest tính trên nội dung nhận được. Repr-Digest tính trên toàn bộ đại diện. Khác nhau rõ nhất với 206.
Digest khớp có chứng minh dữ liệu từ đúng server không?
Không. Lab có proxy sửa byte rồi tính lại digest, mọi phép kiểm vẫn khớp.
Có nên chấp nhận md5 không?
Không nên. RFC 9530 xếp md5 và sha-1 vào nhóm Deprecated vì dễ va chạm.
Sửa một byte có làm JSON hỏng không?
Thường là không. Lab đổi một chữ trong URL, JSON vẫn hợp lệ. Chỉ digest bắt được.
Server không gửi digest thì sao?
Ghi không có trường, dùng cách khác như so với lần tải trước. Thiếu digest không phải lỗi.
Chunked có ảnh hưởng digest không?
Không. Thư viện ghép chunk trước khi trả byte. Digest tính trên byte đã ghép, trước khi giải nén.
HTTP Content-Digest kiểm toàn vẹn và những điều cần nhớ
HTTP Content-Digest kiểm toàn vẹn chỉ có ý nghĩa khi băm đúng byte trên dây, đúng lớp mã hóa, và hiểu rằng khớp không phải là xác thực nguồn. Lưu byte thô cùng trường digest, dùng Repr-Digest cho tệp ghép từ nhiều đoạn. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em giữ ca sửa một byte trong bộ test HTTP Content-Digest kiểm toàn vẹn.


