
Exa API bằng Python: semantic search, lọc nguồn và quyền URL
Exa API bằng Python là cách gọi endpoint /search của Exa để tìm trang web theo ý nghĩa của câu truy vấn thay vì chỉ khớp từ khóa. Kết quả là danh sách URL kèm tiêu đề, ngày đăng và đoạn nổi bật. Khác với tìm kiếm thông thường, Exa khuyến khích viết truy vấn như mô tả trang mình muốn tìm. ProxyVN chạy thử ngày 29/10/2026: gọi thật Exa không khóa và với khóa giả để ghi lỗi, dựng máy chủ giả lập theo schema tài liệu, và kiểm robots.txt thật của sáu tên miền trong kết quả. Kết quả tìm kiếm không đồng nghĩa với quyền tải trang, và lab cho thấy cả công cụ kiểm quyền cũng có thể sai.
Exa API bằng Python: mục tiêu dữ liệu, quyền và phạm vi truy cập
Phần đầu chốt Exa làm gì, đầu ra cần gì, và ranh giới giữa tìm kiếm với thu thập toàn site.
Exa là gì
Exa là dịch vụ tìm kiếm web có API, thiết kế cho ứng dụng AI. Theo tài liệu endpoint Search của Exa, request là POST tới https://api.exa.ai/search với khóa trong header x-api-key, hoặc Authorization dạng Bearer, và thân JSON có query cùng các tùy chọn.
Exa có nhiều chế độ tìm qua tham số type: auto là mặc định cân bằng, lite cho độ trễ thấp và chi phí thấp, fast, instant, và các chế độ deep cho tìm sâu nhiều bước. Response có thể kèm nội dung trang qua tùy chọn contents.
Đầu ra mà bài này hướng tới
Đầu ra là bảng nguồn cho mỗi truy vấn: truy vấn, kiểu truy vấn, URL, tiêu đề, ngày đăng nếu có, đoạn nổi bật, thứ hạng, requestId, chi phí. Kèm theo là cột quyền: robots.txt của tên miền có cho phép tải đường dẫn đó không, nếu ứng dụng định tự tải trang.
Kèm thêm bảng nhãn liên quan và không liên quan do người gán tay. Như mọi dịch vụ tìm kiếm, thứ hạng là ý kiến của dịch vụ. Chỉ nhãn tay cho biết kết quả có phục vụ câu hỏi của mình không.
Tìm kiếm khác với thu thập toàn site
Exa trả lời câu hỏi trang nào liên quan tới truy vấn. Nó không duyệt mọi trang của một website. Muốn có mọi trang tài liệu của một dự án, cần crawler đi theo sitemap hay link nội bộ, với quyền và nhịp riêng.
Nhầm hai việc này dẫn tới hai lỗi. Dùng Exa để cố lấy toàn bộ website thì tốn rất nhiều request mà vẫn thiếu trang. Dùng crawler để trả lời câu hỏi thì phải tự xếp hạng, việc mà dịch vụ tìm kiếm làm tốt hơn.
Kết quả tìm kiếm không phải giấy phép
Một URL xuất hiện trong kết quả Exa nghĩa là Exa biết trang đó tồn tại và liên quan. Nó không có nghĩa anh em được phép tự tải trang đó bằng crawler của mình. Quyền tải do chủ website quyết định qua robots.txt và điều khoản sử dụng.
Khi ứng dụng chỉ dùng đoạn nổi bật Exa trả về, việc tải là của Exa. Khi ứng dụng tự tải URL để lấy toàn văn, việc tải là của anh em, và robots.txt của trang đó áp cho anh em.
Quyền với nội dung
Đoạn nổi bật và nội dung trang vẫn thuộc website nguồn. Hiển thị cho người dùng cuối thì giữ URL nguồn. Không trình bày nội dung của người khác như nội dung của mình. Bài không tư vấn pháp lý về mức trích dẫn được phép.
Ranh giới với Tavily
Tavily là dịch vụ tìm kiếm khác cho ứng dụng AI, trả đoạn trích chọn sẵn theo câu hỏi và tính phí bằng credit. Bài cùng cụm về Tavily tập trung vào ngân sách credit và khử trùng. Bài này tập trung vào cách viết truy vấn dạng mô tả, lọc nguồn theo đường dẫn và kiểm quyền URL.
Không có dịch vụ nào tốt hơn cho mọi trường hợp. Chạy cùng một bộ truy vấn có nhãn tay trên hai dịch vụ là cách duy nhất để biết cái nào hợp với dữ liệu của mình.
Ai cần Exa
Nhóm xây ứng dụng nghiên cứu cần tìm bài báo, tài liệu kỹ thuật, trang công ty theo mô tả. Nhóm làm danh sách nguồn cho mô hình cần URL chất lượng cho một chủ đề hẹp. Nhóm vận hành cần biết chi phí mỗi truy vấn.
Cả ba đều phải trả lời câu hỏi quyền nếu ứng dụng tự tải trang. Phần sau của bài giải quyết câu hỏi đó.
Thiết kế truy vấn semantic search của Exa và đối soát URL, nội dung theo quyền trong Exa API bằng Python
Phần này đi qua tham số chính, khuôn response và cách viết truy vấn.
Tham số chính
query là chuỗi truy vấn, không được rỗng. type chọn chế độ tìm, mặc định auto. numResults đặt số kết quả, mặc định 10, tối đa công khai 100. category gợi ý loại nội dung như company, publication, news, personal site, financial report, people.
includeDomains và excludeDomains nhận tên máy, tên máy kèm tiền tố đường dẫn như example.com/docs, hoặc tên miền con dạng ký tự đại diện như *.example.com. startPublishedDate và endPublishedDate giới hạn theo ngày đăng. contents chọn trả thêm highlights, text hay summary.
Giới hạn của chế độ lite
Tài liệu ghi chế độ lite chỉ nhận một danh sách tham số nhất định, request đặt tham số khác bị từ chối. lite phục vụ từ chỉ mục đã làm mới định kỳ, không tải trang tại thời điểm truy vấn, nên không hỗ trợ tùy chọn cần tải trực tiếp.
Một số category cũng có giới hạn: company và people không hỗ trợ lọc theo ngày đăng, people không hỗ trợ excludeDomains. Đặt bộ lọc không được hỗ trợ trả 400. Đọc giới hạn trước khi kết hợp tham số.
Khuôn response
Response có results, requestId, costDollars, searchTime, resolvedSearchType, và có thể có warnings, notices. Mỗi kết quả có title, url, publishedDate, author, id, image, favicon, và nội dung theo contents đã yêu cầu như text, highlights, highlightScores, summary.
costDollars là chi phí ước tính bằng đô la, chia theo phần tìm kiếm và phần nội dung. Tài liệu ghi warnings là cảnh báo về request, ví dụ một trường không có tác dụng, và khuyên ghi log chứ không đưa cho mô hình.
Khung code gọi trực tiếp
import os, requests
H = {"x-api-key": os.environ["EXA_API_KEY"], "Content-Type": "application/json"}
def exa(query, **kw):
    body = {"query": query, "type": "auto", "numResults": 10,
            "contents": {"highlights": True}, **kw}
    r = requests.post("https://api.exa.ai/search", headers=H,
                      json=body, timeout=60)
    j = r.json()
    for w in j.get("warnings", []):
        print("WARN", w.get("code"), w.get("path"))
    return r.status_code, j
code, j = exa("page explaining how the CONNECT method tunnels TLS through a proxy")
for i, x in enumerate(j.get("results", []), 1):
    print(i, x["url"], x.get("publishedDate"))
print(j.get("costDollars"), j.get("requestId"))
Hàm in warnings ra log ngay khi nhận, tách biệt với kết quả. Khóa đọc từ biến môi trường.
Truy vấn dạng mô tả
Từ khóa và mô tả
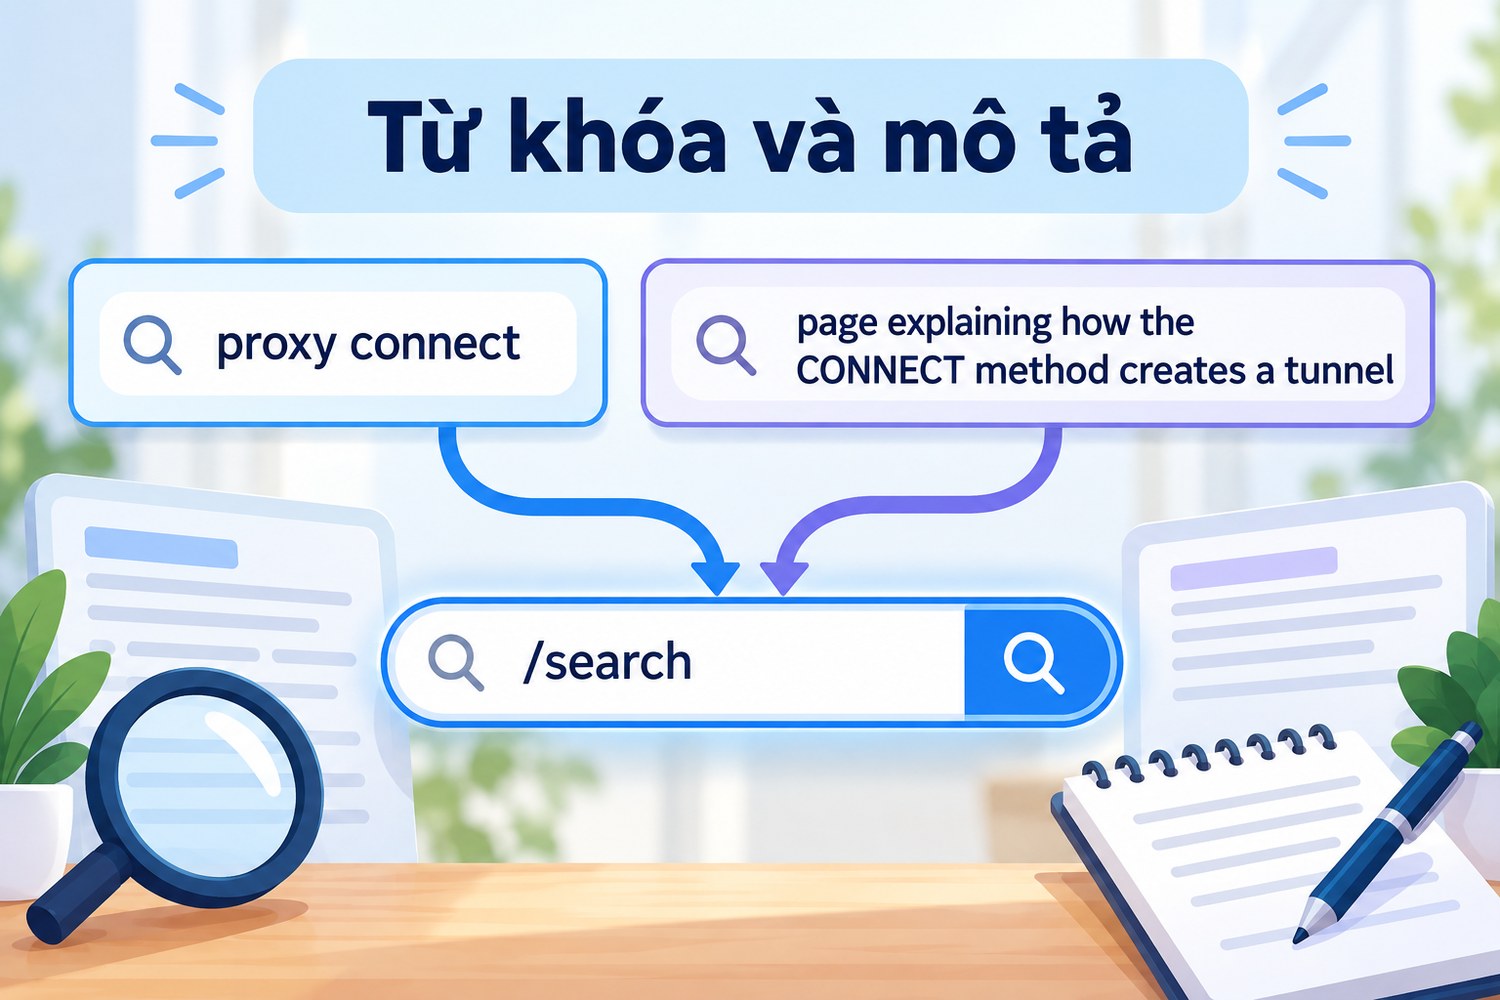
Exa khuyến khích viết truy vấn như mô tả trang cần tìm. Thay vì proxy connect, viết page explaining how the CONNECT method creates a tunnel through a proxy for TLS. Truy vấn dài hơn nhưng nói rõ loại trang và nội dung mong muốn.
Lab chạy cả hai kiểu trên máy chủ giả lập. Máy chủ giả lập xếp hạng bằng số từ khớp, nên kết quả chỉ minh họa cách tổ chức thí nghiệm. Với Exa thật, khác biệt giữa hai kiểu truy vấn là thứ cần đo bằng nhãn tay trên bộ truy vấn của mình.
Kết quả gọi thật không có khóa hợp lệ
Request |
Mã |
Giây |
Tag |
|---|---|---|---|
Không có khóa |
402 |
0,66 |
X402_PAYMENT_REQUIRED |
Khóa giả qua x-api-key |
401 |
0,62 |
INVALID_API_KEY |
Khóa giả qua Bearer |
401 |
0,55 |
INVALID_API_KEY |
Khóa giả, query rỗng |
401 |
0,60 |
INVALID_API_KEY |
Không có khóa, Exa trả 402 Payment Required với tag X402_PAYMENT_REQUIRED và trường x402Version, kèm mô tả tài nguyên. Đây là mã khác hẳn 401 của khóa sai. Lỗi có requestId, error và tag, đúng khuôn lỗi trong tài liệu.
Xác thực trước, kiểm dữ liệu sau
Với khóa giả và query rỗng, Exa trả 401, không trả 400. Máy chủ kiểm khóa trước rồi mới kiểm thân request. Thứ tự này ngược với Tavily trong bài cùng cụm, nơi thân sai trả 422 trước khi kiểm khóa.
Hệ quả thực tế: không dùng mã lỗi để đoán request sai ở đâu khi khóa còn sai. Sửa khóa trước, rồi mới thử lại để thấy lỗi dữ liệu. Với job tự động, viết một bài kiểm khóa riêng chạy đầu tiên, để lỗi khóa không bị lẫn với lỗi của từng truy vấn.
Chuẩn bị truy vấn, khóa và phiên bản API khi dùng Exa API bằng Python
Phần này gom các quyết định trước khi chạy: khóa, bộ truy vấn, chế độ, bộ lọc và máy chủ giả lập.
Giữ khóa ngoài code
Khóa đọc từ biến môi trường hoặc kho bí mật. Gửi qua x-api-key hoặc Authorization, chọn một cách dùng thống nhất. Che khóa khi in log. Exa có endpoint quản lý khóa theo nhóm, cho phép tạo khóa riêng cho từng ứng dụng để theo dõi chi phí và thu hồi khi cần.
Bộ truy vấn có hai dạng
Viết mỗi câu hỏi thành hai truy vấn: dạng từ khóa và dạng mô tả. Gán mã chung cho cặp. Khi chấm nhãn tay, so hai dạng trên cùng câu hỏi để biết dạng nào hợp với dữ liệu thật. Lab dùng câu hỏi tìm tài liệu giải thích phương thức CONNECT qua proxy.
Chọn chế độ
auto cho phần lớn trường hợp. lite khi cần độ trễ thấp và chấp nhận chỉ mục không tải trực tiếp. Chế độ deep khi cần tìm nhiều bước, chi phí và độ trễ cao hơn. Ghi chế độ vào mỗi dòng kết quả, và ghi resolvedSearchType mà Exa trả về, vì auto có thể chọn chế độ cụ thể khác nhau tùy truy vấn.
Lọc theo đường dẫn thay vì toán tử site
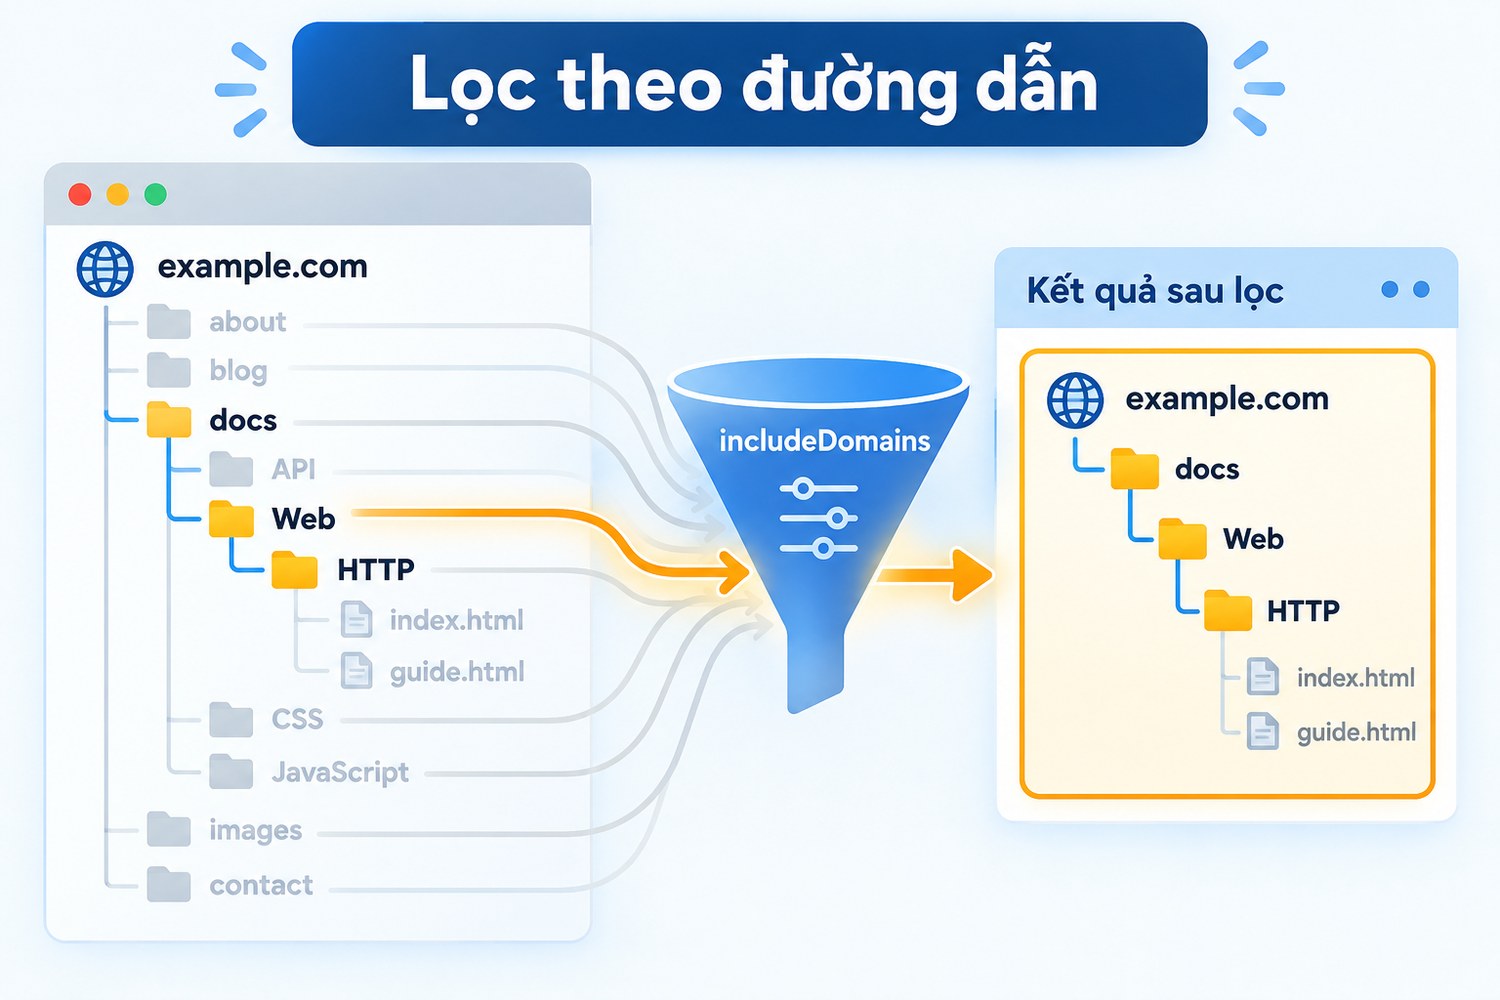
Tài liệu khuyên dùng includeDomains thay cho thêm toán tử site vào truy vấn. includeDomains nhận cả tiền tố đường dẫn, ví dụ developer.mozilla.org/en-US/docs/Web/HTTP chỉ lấy trang trong mục HTTP của tài liệu MDN, không lấy trang khác trên cùng tên miền.
Lọc theo đường dẫn là công cụ mạnh để giới hạn vào tài liệu chính thức. Nó cũng giúp loại trang tìm kiếm nội bộ, trang đăng nhập, trang danh sách.
Máy chủ giả lập theo schema
Lab dựng máy chủ HTTP cục bộ ở cổng 9791, nhận POST /search theo khuôn tài liệu. Máy chủ kiểm khóa qua x-api-key hoặc Bearer, trả 400 khi query rỗng và 429 khi quá năm request mỗi giây. Bộ lọc includeDomains và excludeDomains được áp theo cả tiền tố đường dẫn lẫn ký tự đại diện tên miền con. Response có warnings IGNORED_FIELD cho trường không tác dụng và có costDollars.
Kho của máy chủ có 8 URL thật trên sáu tên miền: MDN, RFC Editor, curl, Python docs, Wikipedia, GitHub. Tiêu đề và mô tả do lab viết. Điểm xếp hạng và chi phí của máy chủ giả lập không phải của Exa.
Phiên bản và môi trường
Python 3.12.10, requests 2.34.2, urllib.robotparser của thư viện chuẩn. Exa có SDK exa-py. Lab gọi bằng requests để thấy rõ header và trường. Ghi ngày đọc tài liệu vào cấu hình, vì danh sách chế độ và tham số của Exa thay đổi theo thời gian.
Thu dữ liệu có phân trang hoặc trạng thái theo đúng nguồn với Exa API bằng Python
Phần này ghi kết quả trên máy chủ giả lập.
Hai dạng truy vấn
Truy vấn |
Số kết quả |
Kết quả đầu |
|---|---|---|
proxy connect |
7 |
RFC 9110 |
page explaining how the CONNECT method creates a tunnel through a proxy for TLS |
7 |
MDN CONNECT request method |
Cùng 7 URL, khác thứ tự. Truy vấn mô tả đưa trang MDN về phương thức CONNECT lên đầu vì có nhiều từ khớp với mô tả trang đó. Đây là hệ quả của cách máy chủ giả lập đếm từ, không phải bằng chứng về Exa.
Lọc theo tiền tố đường dẫn
Lọc theo đường dẫn
includeDomains bằng developer.mozilla.org/en-US/docs/Web/HTTP trả đúng 2 kết quả, cả hai thuộc mục HTTP của MDN. excludeDomains bằng *.wikipedia.org và github.com trả 4 kết quả, loại hai trang Wikipedia và trang tìm kiếm GitHub.
Máy chủ giả lập áp quy tắc theo mô tả tài liệu. Với Exa thật, kiểm lại bằng vài truy vấn trước khi tin vào bộ lọc cho job lớn.
Warnings cho trường không tác dụng
Lab gửi kèm hai trường useAutoprompt và startCrawlDate. Máy chủ giả lập trả hai cảnh báo IGNORED_FIELD với đường dẫn /useAutoprompt và /startCrawlDate. Tài liệu Exa có ví dụ cảnh báo đúng khuôn này cho startCrawlDate.
Code cũ hay mẫu trên mạng có thể dùng tham số đã bỏ. Không có warnings, anh em tưởng tham số có tác dụng. Ghi warnings vào log là cách phát hiện.
Chi phí cộng dồn
Mỗi truy vấn có highlights trên máy chủ giả lập trả costDollars.total bằng 0,012. Hai truy vấn cộng lại 0,024. Con số này là của máy chủ giả lập. Với Exa thật, cộng costDollars.total từ mọi response để biết chi phí thật của job, thay vì nhân số request với bảng giá.
Không có phân trang
/search không có tham số trang. numResults tối đa 100 là tất cả một request trả về. Cần nhiều hơn thì đổi truy vấn, đổi bộ lọc hay dùng chế độ khác, mỗi cách là một request riêng.
Hạn mức và 429
Máy chủ giả lập giới hạn năm request mỗi giây và trả 429 với tag RATE_LIMIT. Hàm gọi của lab chờ và thử lại. Exa thật có giới hạn theo gói. Đọc tài liệu về giới hạn của gói và đặt nhịp gửi thấp hơn.
Đối soát ID, kiểu dữ liệu, giá trị thiếu và xuất xứ từng kết quả trong Exa API bằng Python
Phần này bàn quyền URL, nhãn tay và các trường hay thiếu.
Kiểm robots.txt thật cho URL kết quả
Lab tải robots.txt thật của sáu tên miền trong kho, mỗi tên miền một lần, nghỉ một giây giữa các lần, với User-Agent ProxyVN-lab/1.0 kèm email giả. Cả sáu trả 200, thời gian từ 0,36 tới 0,80 giây. Rồi dùng urllib.robotparser kiểm từng URL.
URL |
robotparser nói |
|---|---|
MDN CONNECT, MDN Proxy servers |
Được phép |
RFC 9110, curl man page, Python urllib.request |
Được phép |
Wikipedia HTTP tunnel |
Được phép |
Wikipedia Special:Search |
Không được phép |
GitHub search |
Được phép |
Wikipedia cấm đường dẫn /wiki/Special: trong robots.txt, robotparser bắt đúng. Trang tìm kiếm nội bộ là loại trang mà website thường không muốn bị crawl.
robotparser báo sai với GitHub
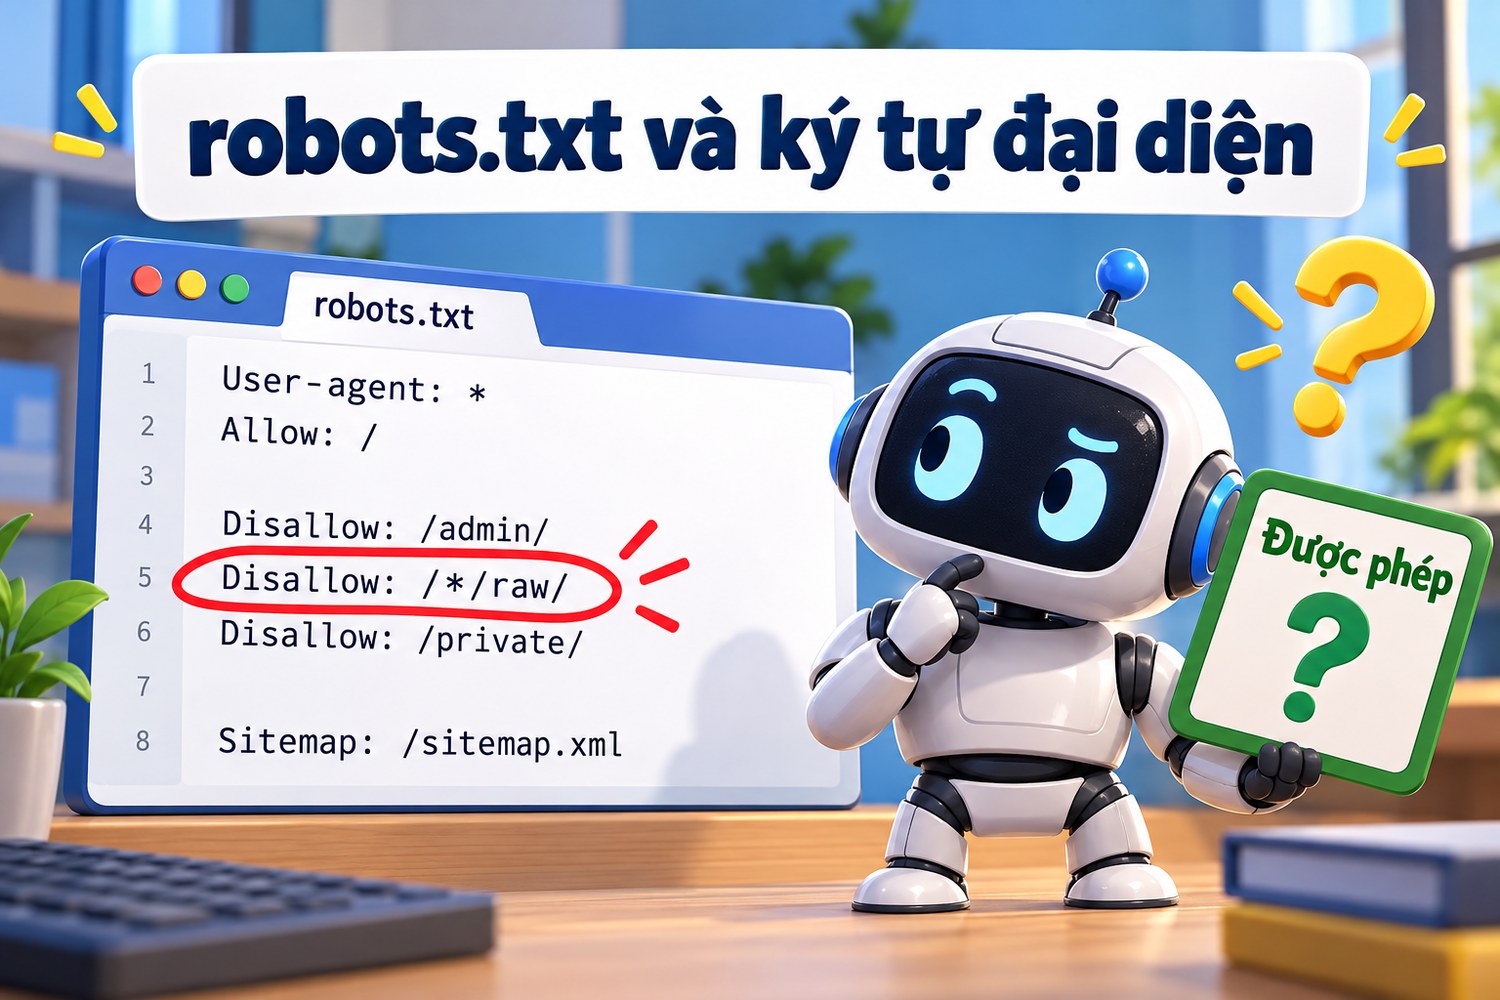
GitHub có quy tắc Disallow: /search$ và Disallow: /*/raw/ trong nhóm User-agent dấu sao. Lab kiểm thêm: robotparser của Python trả được phép cho https://github.com/search và cho một đường dẫn dạng /a/b/raw/main/x. Cả hai đều bị cấm theo quy tắc.
Lý do là urllib.robotparser không hiểu ký tự đại diện dấu sao và dấu đô la, vốn được chuẩn RFC 9309 mô tả và các công cụ tìm kiếm lớn hỗ trợ. Nó so chuỗi tiền tố theo nghĩa đen, nên quy tắc có ký tự đại diện không bao giờ khớp.
Hệ quả cho ứng dụng
Một ứng dụng nhận URL từ Exa, kiểm bằng robotparser, thấy được phép rồi tự tải, có thể đang tải trang mà website đã cấm. Lỗi không đến từ Exa mà từ công cụ kiểm quyền. Dùng thư viện phân tích robots.txt hỗ trợ ký tự đại diện cho job thật, và thử nó trên vài quy tắc có ký tự đại diện trước khi tin.
Bài robots.txt khi crawl website bàn cú pháp và cách đọc tệp này.
Thư viện kiểm robots phải được kiểm trước
Bài học rộng hơn từ phép thử GitHub: mọi công cụ trong pipeline đều cần một bộ ca kiểm nhỏ có đáp án. Với bộ kiểm robots, bộ ca nên có quy tắc tiền tố thường, quy tắc có dấu sao giữa đường dẫn, quy tắc kết thúc bằng dấu đô la, quy tắc Allow đè Disallow, và nhóm User-agent riêng.
Chạy bộ ca này mỗi khi đổi thư viện hay nâng phiên bản. Mười dòng kiểm tốn vài giây, còn một lần tải nhầm trang bị cấm trên quy mô lớn có thể khiến cả dải IP của tổ chức bị chặn.
Robots.txt thay đổi theo thời gian
robots.txt và ký tự đại diện
Robots.txt lab tải ngày 29/10/2026 có thể khác ở thời điểm anh em đọc. Cache robots.txt theo tên miền với thời hạn vừa phải, ví dụ một ngày, và tải lại khi hết hạn. Ghi thời điểm tải robots.txt cạnh quyết định cho phép hay cấm của từng URL.
GitHub trong lab có các nhóm User-agent riêng cho một số bot AI, với Crawl-delay riêng. Tên User-agent của ứng dụng anh em quyết định nhóm quy tắc nào áp dụng. Đặt tên rõ ràng và kiểm theo đúng tên đó.
Nhãn tay trên kết quả
Câu hỏi của lab là tìm tài liệu giải thích phương thức CONNECT qua proxy. Gán nhãn liên quan cho MDN CONNECT, MDN Proxy servers and tunneling, RFC 9110, Wikipedia HTTP tunnel. Gán không liên quan cho trang tìm kiếm Wikipedia và trang tìm kiếm GitHub. Trang man của curl liên quan một phần vì chỉ nói tùy chọn dòng lệnh.
Trang tìm kiếm nội bộ vừa không liên quan vừa bị robots.txt cấm. Lọc chúng bằng excludeDomains theo đường dẫn ngay trong truy vấn là cách rẻ nhất.
Trường hay thiếu
publishedDate thiếu ở trang tài liệu không có ngày đăng, như trang man của curl hay tài liệu Python. author thường thiếu. highlights chỉ có khi yêu cầu contents. Ghi null cho trường thiếu và đếm tỷ lệ có giá trị.
Lọc theo startPublishedDate sẽ loại mọi trang không có ngày đăng. Với tài liệu kỹ thuật, đó thường là những trang tốt nhất. Cân nhắc kỹ trước khi bật bộ lọc ngày cho loại câu hỏi này.
Giữ xuất xứ cho từng kết quả
Mỗi dòng giữ truy vấn, dạng truy vấn, type, resolvedSearchType, requestId, thứ hạng, URL, cờ robots và thư viện kiểm robots đã dùng, chi phí và thời điểm. Bài JSON và CSV khi crawl dữ liệu bàn cách tổ chức tệp như vậy.
Lưu kết quả, giới hạn request và khi nào Exa API bằng Python cần proxy
Phần cuối bàn chuyện cache, chi phí và vị trí của proxy.
Cache theo truy vấn và tham số
Khóa cache là truy vấn cùng toàn bộ tham số. Cùng khóa trong một khoảng thời gian thì dùng lại kết quả. Với truy vấn về tài liệu kỹ thuật, kết quả ít đổi, thời hạn cache dài được.
Ngân sách đô la
Exa trả chi phí bằng đô la trong costDollars. Đặt hạn mức theo đô la cho mỗi job, cộng dồn sau mỗi response, dừng khi chạm hạn mức. Phần nội dung như text và summary làm tăng chi phí, chỉ bật khi thật cần. Bài rate limit API khi dùng proxy có mẫu bộ đếm dùng chung được.
Xử lý mã lỗi
402 là thiếu khóa hoặc cần thanh toán. 401 là khóa sai. 400 là thân request sai hoặc kết hợp tham số không được hỗ trợ. 429 là quá nhanh. 500 và 503 là lỗi phía Exa, thử lại sau. Đọc tag trong thân lỗi, nó cụ thể hơn mã HTTP.
Proxy trong lab kiểm ở đâu
Lab gửi một truy vấn tới máy chủ giả lập qua proxy HTTP có xác thực cục bộ, kết quả 200 với 7 nguồn, giống gọi thẳng. Với Exa thật qua HTTPS, proxy chỉ thấy CONNECT tới api.exa.ai cổng 443. Khóa và truy vấn nằm trong kênh mã hóa.
Proxy không đổi kết quả Exa
Exa tìm trong chỉ mục của họ và tải trang bằng hạ tầng của họ. IP proxy của anh em không ảnh hưởng kết quả. Muốn kết quả theo vị trí người dùng, dùng tham số userLocation theo tài liệu, không phải đổi IP. Hạn mức gắn với khóa, đổi IP không giúp vượt 429.
Proxy khi tự tải trang từ kết quả
Khi ứng dụng tự tải URL từ kết quả Exa, request đó đi từ máy anh em tới website nguồn. Đó là chỗ proxy có thể cần, ví dụ khi máy chủ nằm trong mạng chỉ ra Internet qua proxy. Robots.txt và nhịp tải của website nguồn áp cho request này, không phải cho Exa.
Khi nào cần proxy thật
Proxy cần khi máy chạy ứng dụng nằm trong mạng nội bộ chỉ được ra Internet qua proxy. Trường hợp thứ hai là tổ chức yêu cầu lưu lượng tới dịch vụ AI bên ngoài và tới website nguồn đi qua một IP cố định để giám sát. Cấu hình và mã hóa mật khẩu có ký tự đặc biệt có trong bài định dạng proxy.
Bài Web Scraping proxy là gì phân biệt các vai trò của proxy. Bài proxy cho AI agent tự động bàn trường hợp agent vừa gọi dịch vụ tìm kiếm vừa tự tải trang.
Khi máy chủ của nhóm đặt tại Việt Nam và cần IP thoát ổn định, proxy tĩnh dễ quản lý hơn proxy xoay. ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay qua HTTP hoặc SOCKS5. Anh em có thể mua proxy Việt Nam tại trang chủ ProxyVN rồi khai báo vào requests theo tham số proxies.
Giới hạn suy luận của bài
Lab chỉ gọi Exa thật bốn lần ngày 29/10/2026, không có khóa hợp lệ, để ghi mã 402 và 401. Mọi số liệu về kết quả, thứ hạng, bộ lọc, warnings và chi phí đến từ máy chủ giả lập tự viết theo schema tài liệu. Thứ hạng của máy chủ giả lập dựa trên đếm từ, không phản ánh tìm kiếm ngữ nghĩa của Exa.
Phần robots.txt là thật: sáu tệp tải ngày 29/10/2026 và kết quả của urllib.robotparser trong Python 3.12.10. Lab không thử thư viện robots khác, không có tài khoản Exa, không thử contents text hay summary với dữ liệu thật.
Checklist Exa API bằng Python
Checklist Exa API
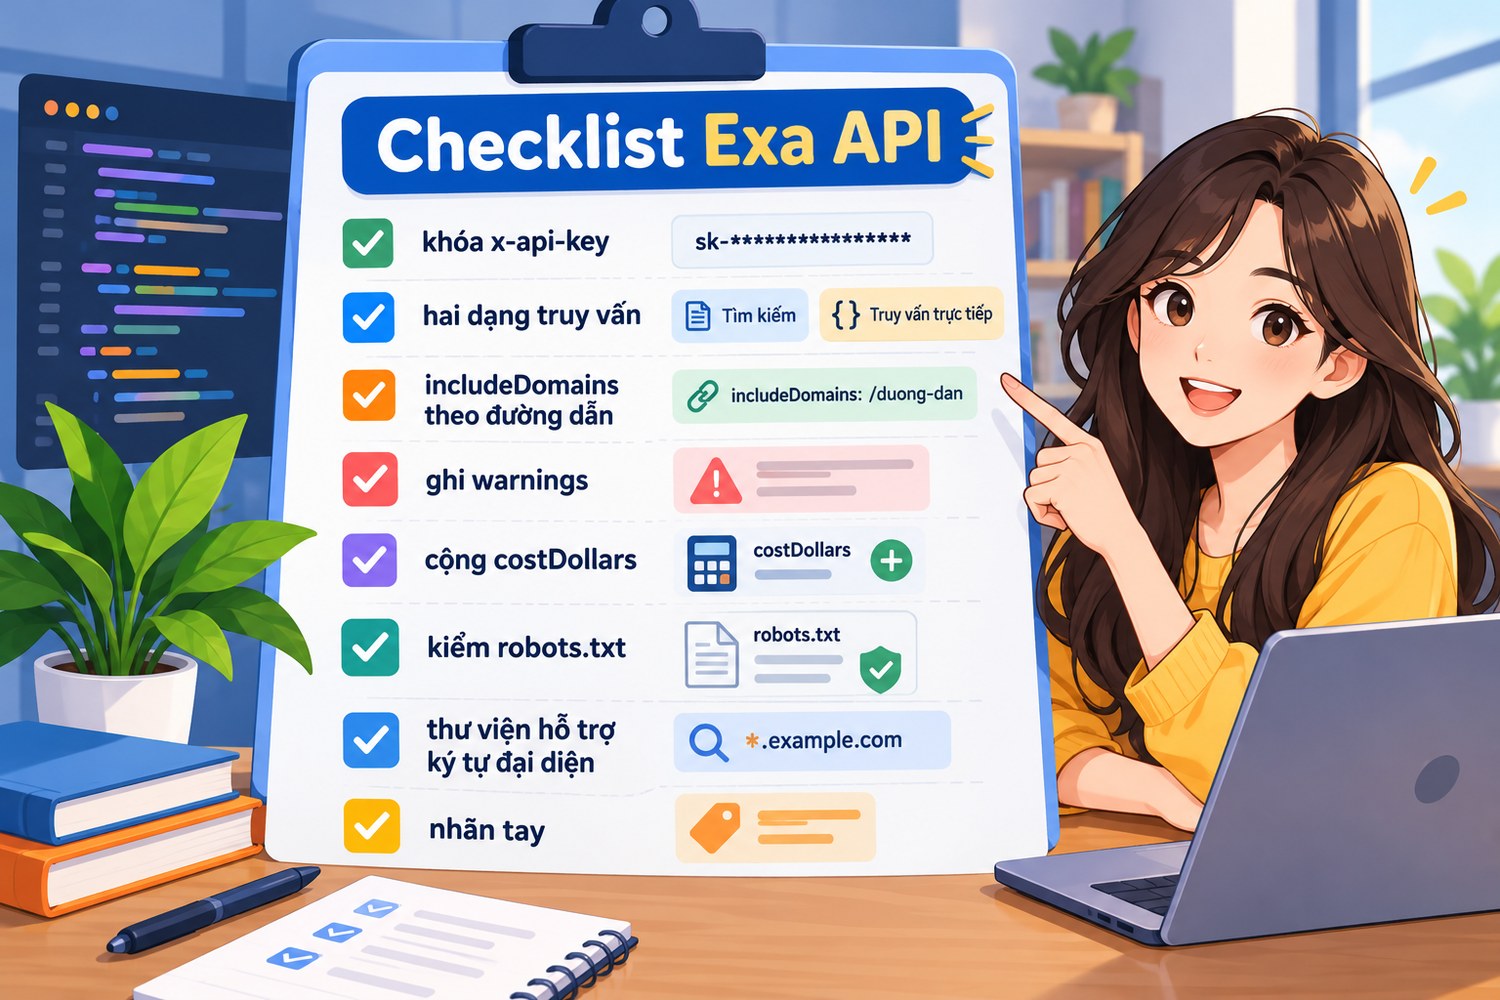
- Giữ khóa trong biến môi trường, gửi qua x-api-key.
- Viết mỗi câu hỏi thành dạng từ khóa và dạng mô tả.
- Dùng includeDomains theo đường dẫn thay cho toán tử site.
- Ghi warnings vào log, không đưa cho mô hình.
- Cộng costDollars.total sau mỗi response.
- Kiểm robots.txt trước khi tự tải URL kết quả.
- Dùng thư viện robots hỗ trợ ký tự đại diện.
- Chấm nhãn tay, loại trang tìm kiếm nội bộ.
Câu hỏi thường gặp về Exa API bằng Python
Gọi Exa không có khóa thì bị gì?
Lab nhận 402 với tag X402_PAYMENT_REQUIRED. Khóa sai thì 401 với tag INVALID_API_KEY.
numResults tối đa bao nhiêu?
Tài liệu ghi tối đa công khai là 100 kết quả mỗi request.
Kết quả có trong Exa thì có được tự tải trang không?
Không mặc nhiên. Kiểm robots.txt và điều khoản của website nguồn trước khi tự tải.
Vì sao robotparser báo được phép mà robots.txt lại cấm?
urllib.robotparser không hiểu ký tự đại diện dấu sao và dấu đô la. Lab thấy nó báo sai với quy tắc /search$ và /*/raw/ của GitHub.
warnings trong response dùng để làm gì?
Báo trường không có tác dụng hay vấn đề khác của request. Ghi log, không đưa cho mô hình.
Dùng proxy có đổi kết quả Exa không?
Không. Dùng userLocation nếu cần kết quả theo vị trí.
Exa API bằng Python và những điều cần nhớ
Exa API bằng Python cho anh em tìm trang theo mô tả, lọc nguồn tới từng đường dẫn và biết chi phí từng request. Lab ngày 29/10/2026 ghi mã 402 và 401 từ Exa thật, chạy logic trên máy chủ giả lập, và phát hiện robotparser của Python báo sai quyền với quy tắc có ký tự đại diện. Kết quả tìm kiếm không phải giấy phép tải trang. Cần IP thoát cố định cho máy chủ gọi Exa API bằng Python, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


