
Apache Tika nhận dạng tài liệu crawl: MIME, magic và metadata
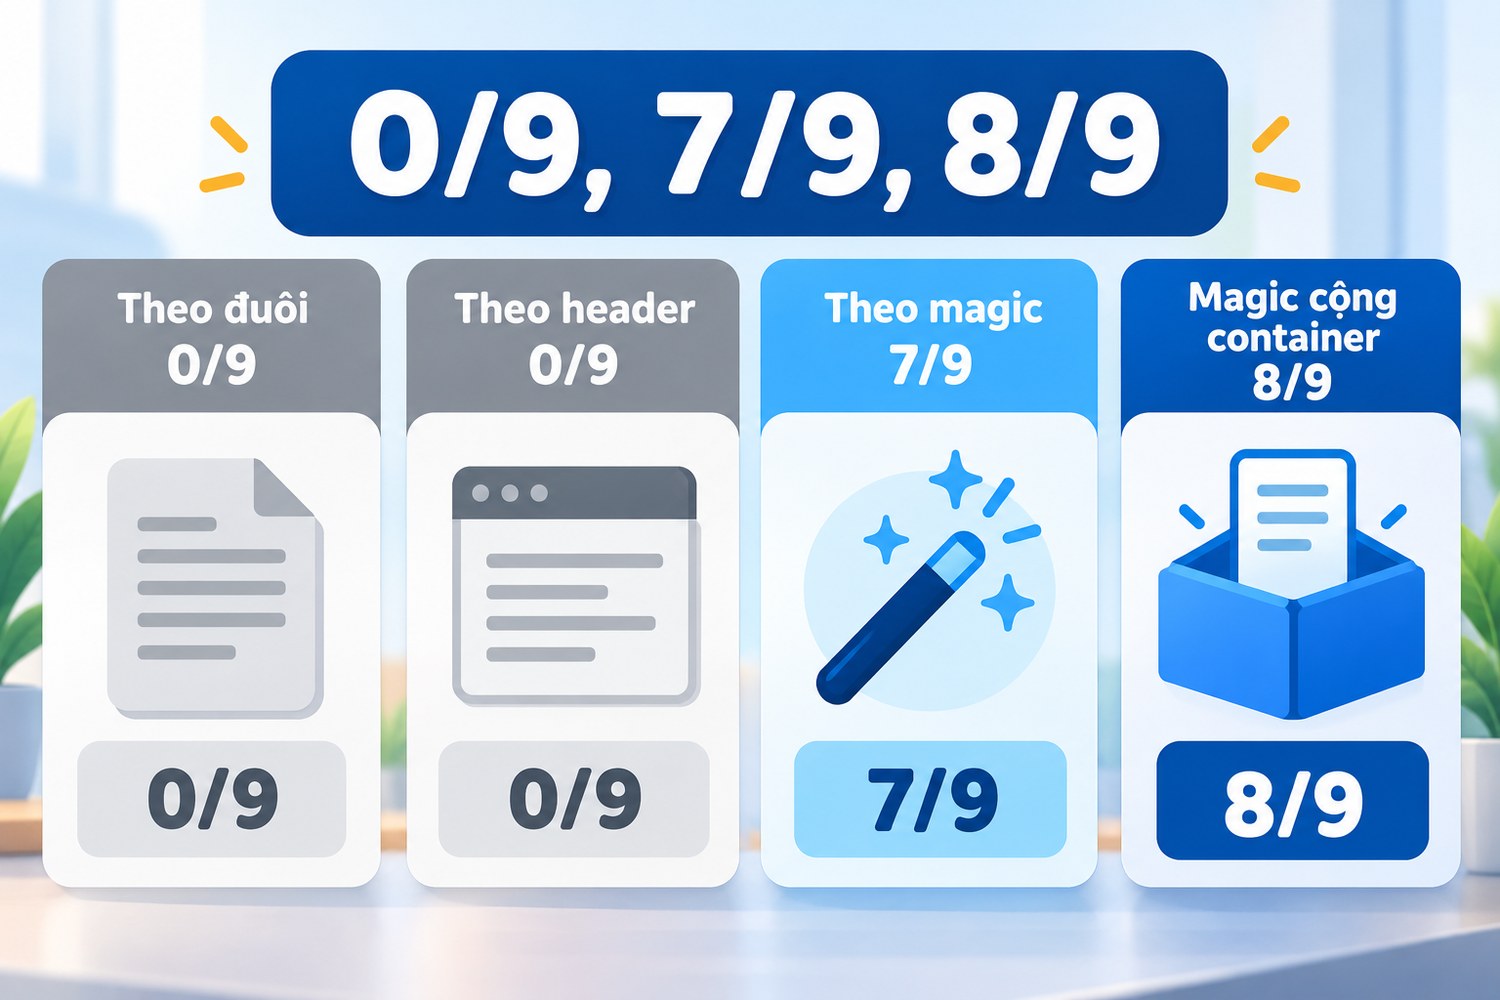
Apache Tika nhận dạng tài liệu crawl là bước đứng trước mọi parser: xác định một tệp tải về thật sự là PDF, ảnh, Word, ZIP hay trang lỗi HTML, rồi mới chuyển nó tới đúng công cụ xử lý. Tin vào đuôi tệp hay header Content-Type của máy chủ là cách nhanh nhất để pipeline đổ vỡ âm thầm. ProxyVN chạy lab ngày 29/10/2026 với 9 tệp cố ý đặt sai đuôi. Đoán theo đuôi tệp và theo header đều đúng 0 trên 9. Quy tắc magic đọc từ chính tệp tika-mimetypes.xml của Tika 2.9.4 đúng 7 trên 9, thêm bước soi bên trong ZIP thì đúng 8 trên 9. Lab không chạy được Tika server, bài ghi rõ phần đó.
Apache Tika nhận dạng tài liệu crawl: mục tiêu dữ liệu, quyền và phạm vi truy cập
Phần đầu chốt vì sao cần nhận dạng trước, Tika làm gì, và ranh giới với các công cụ trích nội dung.
Vấn đề của pipeline tài liệu
Crawler tải về hàng nghìn tệp từ nhiều website. Mỗi tệp có tên, có đuôi, có header Content-Type do máy chủ gửi. Ba thông tin này thường đúng, nhưng không phải lúc nào cũng đúng. Một đường dẫn kết thúc bằng .pdf có thể trả về trang đăng nhập. Một máy chủ cấu hình sai có thể gửi mọi tệp với application/octet-stream.
Khi tệp sai loại đi vào parser PDF, parser ném lỗi hoặc tệ hơn là trả về rỗng mà không báo gì. Lỗi xuất hiện ở bước sau, xa chỗ gây ra, và khó lần ngược.
Tika làm gì
Apache Tika là bộ công cụ Java mã nguồn mở của Apache Software Foundation. Tika có hai phần chính: nhận dạng loại tệp và trích nội dung cùng metadata từ hơn một nghìn định dạng. Bài này chỉ bàn phần thứ nhất.
Tika có thể dùng như thư viện Java, như ứng dụng dòng lệnh, hoặc như Tika server, một dịch vụ REST nhận tệp qua HTTP. Với pipeline Python, Tika server là cách nối phổ biến nhất.
Đầu ra mà bài này hướng tới
Đầu ra là một bảng cho mỗi tệp: tên, kích thước, loại theo đuôi, loại theo header, loại theo magic, loại sau khi soi container, và quyết định chuyển tệp tới parser nào. Bảng này là bộ định tuyến của pipeline.
Kèm theo là bảng so với đáp án. Vì lab tự dựng tệp, lab biết chính xác mỗi tệp thật sự là gì.
Tập tệp lab
Lab dựng 9 tệp. Một PDF đặt tên .jpg. Một PNG đặt tên .pdf. Một DOCX tối giản đặt tên .zip. Một ZIP thường chứa CSV đặt tên .docx. Một trang lỗi HTML 403 đặt tên .pdf. Một tệp gzip đặt tên .csv. Một JSON đặt tên .txt. Một tệp rỗng đặt tên .pdf. Một PDF có ba byte BOM ở đầu đặt tên .bin.
Mỗi tệp mô phỏng một tình huống có thật khi crawl. Trang lỗi HTML mang đuôi PDF là tình huống hay gặp nhất: máy chủ chặn hoặc yêu cầu đăng nhập, nhưng URL vẫn kết thúc bằng .pdf.
Quyền với tệp tải về
Nhận dạng loại tệp không đổi quyền với nội dung. Tài liệu tải về vẫn thuộc người công bố. Khi Tika phát hiện một tệp .pdf thật ra là trang 403, đó là tín hiệu máy chủ đã từ chối. Pipeline nên ghi nhận và dừng thử lại URL đó, không tìm cách vượt qua.
Ranh giới với trích bố cục
Các công cụ phân tích bố cục như Docling trích heading, bảng và tọa độ từ tài liệu. Đó là bước sau. Tika đứng trước, trả lời câu hỏi đơn giản hơn: tệp này là gì, có nên đưa vào parser PDF không.
Không dùng cùng một công cụ cho cả hai việc chỉ vì nó làm được. Nhận dạng cần nhanh và chạy trên mọi tệp. Trích bố cục chậm và chỉ chạy trên tệp đã được xác nhận đúng loại.
Ranh giới với trích văn bản
Bài trích văn bản PDF sau web crawl bàn việc lấy chữ từ PDF. Bài này bàn việc biết chắc tệp là PDF trước khi lấy chữ. Hai bài nối tiếp nhau trong cùng một pipeline.
Ai cần bước nhận dạng
Nhóm vận hành crawler tài liệu với nhiều nguồn. Nhóm lưu trữ số cần phân loại kho tệp cũ không rõ nguồn gốc. Nhóm bảo mật cần chặn tệp thực thi đội lốt tài liệu.
Cả ba đều cần một câu trả lời không dựa vào tên tệp. Magic byte là câu trả lời đó.
Apache Tika nhận dạng tài liệu crawl: MIME và metadata trước pipeline, không phải trích layout
Magic trước, tên sau
Phần này giải thích cơ chế nhận dạng của Tika theo tài liệu chính thức và theo chính tệp quy tắc trong bản 2.9.4.
Ba nguồn tín hiệu
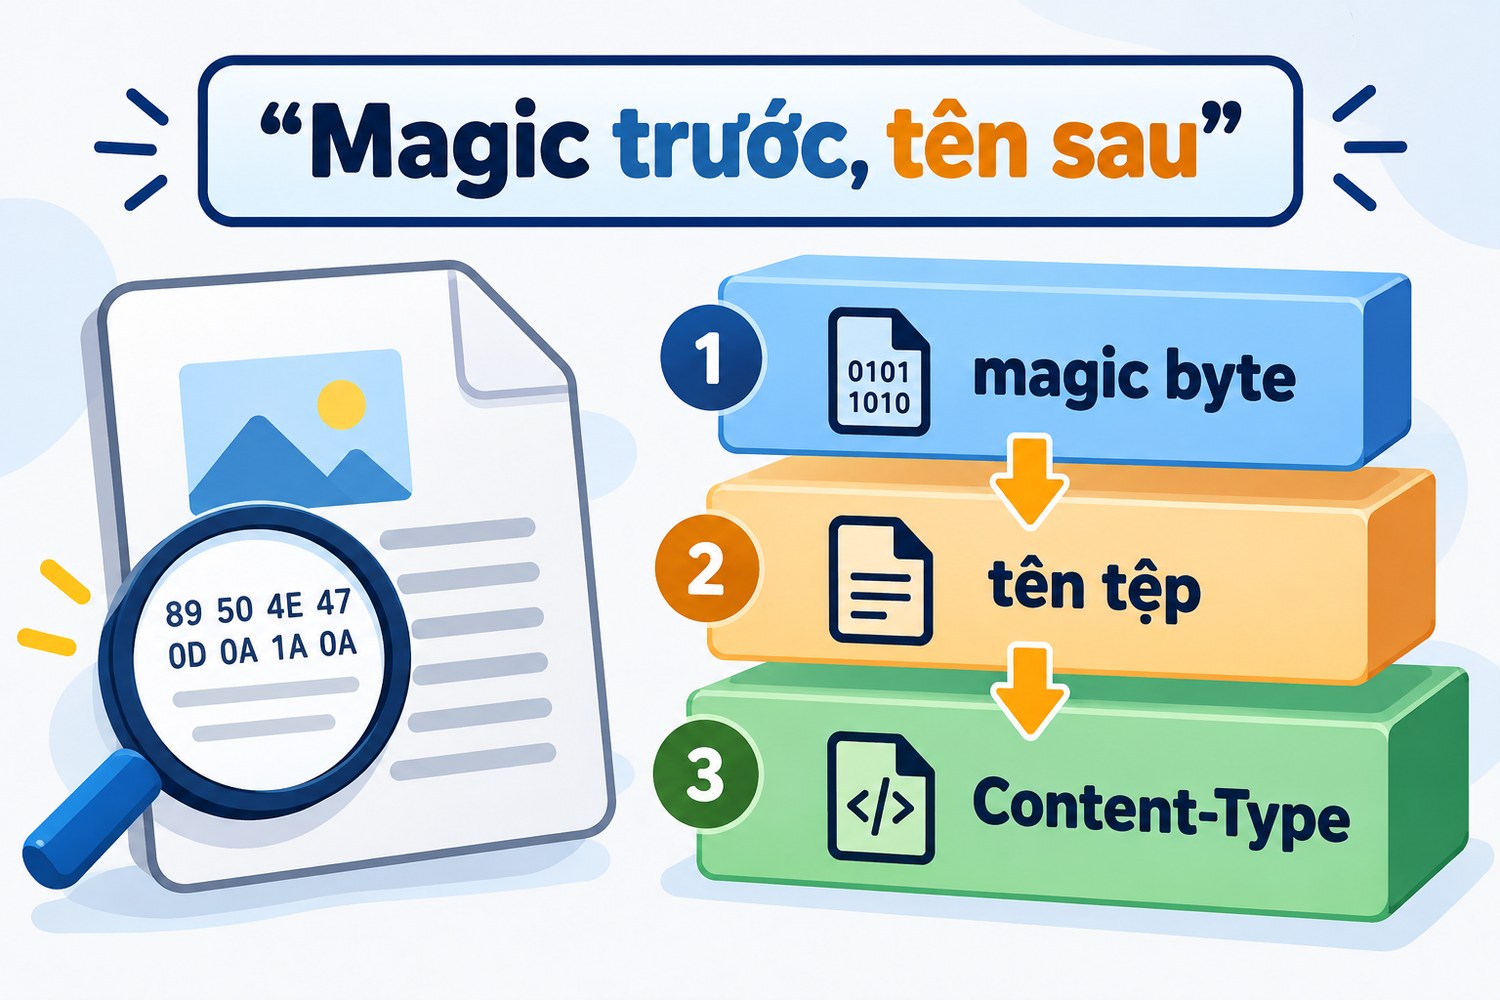
Theo tài liệu Detection của Tika, bộ nhận dạng mặc định MimeTypes dùng tệp tika-mimetypes.xml cho cả nhận dạng theo magic lẫn theo tên tệp. Trước tiên Tika đọc phần đầu tệp và so với magic. Tiếp theo, nếu có tên tệp, Tika dùng tên để làm chi tiết hơn, ví dụ magic thấy văn bản, tên gợi ý CSV. Cuối cùng, nếu có Content-Type được cung cấp, Tika dùng nó để tinh chỉnh thêm.
Thứ tự này là điểm mấu chốt. Nội dung đứng trước, tên và header chỉ để làm rõ thêm. Đuôi .jpg không thể biến một tệp bắt đầu bằng %PDF- thành ảnh.
Tệp quy tắc tika-mimetypes.xml
Lab tải tika-server-standard 2.9.4 từ Maven Central, kiểm SHA1 khớp bff8dc55, rồi mở tệp jar như một tệp ZIP để đọc org/apache/tika/mime/tika-mimetypes.xml mà không chạy gì. Tệp dài 311.288 ký tự, khai báo 1.670 loại MIME, 415 khối magic và 1.361 mẫu tên tệp.
Đọc thẳng tệp quy tắc cho anh em biết chính xác Tika nhận dạng một loại thế nào, thay vì đoán.
Quy tắc của vài loại phổ biến
Loại |
Mẫu tên |
Magic chính |
Độ ưu tiên |
|---|---|---|---|
application/pdf |
%PDF- tại offset 0, hoặc BOM rồi %PDF- |
50 |
|
image/png |
*.png |
89 50 4E 47 0D 0A 1A 0A tại offset 0 |
50 |
application/zip |
*.zip |
PK 03 04 tại offset 0 |
50 |
application/gzip |
*.gz, *.tgz |
1F 8B tại offset 0 |
45 |
text/html |
*.html, *.htm |
DOCTYPE HTML trong 64 byte đầu, thẻ h1 tới h3 |
60, 40, 20 |
DOCX |
*.docx |
Không có magic riêng |
Kiểu con của x-tika-ooxml |
application/json |
*.json |
Không có magic |
Kiểu con của application/javascript |
Hai dòng cuối giải thích hai giới hạn quan trọng. DOCX không có magic riêng vì bên ngoài nó chỉ là ZIP. JSON không có magic vì nó chỉ là văn bản.
Container cần soi bên trong
DOCX, XLSX, PPTX, EPUB, JAR, APK đều là ZIP bên ngoài. Magic chỉ thấy PK 03 04 và kết luận application/zip. Muốn biết bên trong là gì, phải mở ZIP và xem danh sách tệp, ví dụ có [Content_Types].xml và thư mục word thì là DOCX.
Tài liệu Tika gọi đây là nhận dạng có hiểu container. Việc này chậm hơn vì phải đọc cấu trúc ZIP, thường ở cuối tệp. Tài liệu ghi rằng các bộ nhận dạng container nằm trong gói parser, không có trong tika-core.
Thêm loại mới vào tệp quy tắc
Tika cho phép bổ sung loại MIME riêng bằng tệp custom-mimetypes.xml đặt trong classpath. Nếu pipeline gặp một định dạng nội bộ có chữ ký byte riêng, khai báo magic và mẫu tên trong tệp đó thay vì viết bộ nhận dạng riêng bên ngoài.
Cách khai báo giống hệt các khối trong tika-mimetypes.xml mà lab đã đọc: thẻ mime-type, thẻ glob cho tên, thẻ magic với priority và match. Đọc vài khối có sẵn là cách học nhanh nhất.
Độ ưu tiên khi nhiều magic cùng khớp
Một tệp có thể khớp magic của nhiều loại. Ví dụ một tệp HTML bắt đầu bằng thẻ h1 khớp cả mẫu HTML ưu tiên 60 lẫn mẫu văn bản chung. Tika chọn loại có priority cao hơn. Đó là lý do bảng quy tắc ghi kèm độ ưu tiên.
Phép kiểm của lab làm theo cùng nguyên tắc: khi nhiều loại khớp, chọn loại có priority lớn nhất. Với 9 tệp lab, không có trường hợp hai loại cùng priority khớp một tệp.
Tika server và endpoint detect
Tika server có endpoint /detect/stream nhận thân tệp qua PUT và trả về một dòng chứa loại MIME. Header Content-Disposition hay tên tệp gửi kèm được dùng làm gợi ý tên. Endpoint /meta trả metadata, /tika trả nội dung. Trang TikaServer trên wiki của Apache liệt kê đầy đủ.
Lab định chạy Tika server ở cổng 9780 và gửi 9 tệp tới /detect/stream. Lệnh khởi động java -jar bị chặn bởi cơ chế an toàn của môi trường lab. Lab không lách, và thay bằng phép kiểm dưới đây.
Phép kiểm thay thế của lab
Lab viết lại bằng Python một tập con quy tắc magic, đọc trực tiếp từ tika-mimetypes.xml cho năm loại PDF, PNG, ZIP, gzip, HTML, kèm bước soi ZIP để nhận DOCX. Phép kiểm này chỉ tái hiện logic Tika trên vài loại, đủ để thấy vì sao magic thắng tên tệp.
Kết quả trong bài là kết quả của phép kiểm thay thế này. Bài không khẳng định Tika server cho đúng từng dòng như vậy, dù quy tắc được lấy từ chính Tika.
Chuẩn bị máy chủ, phiên bản Java và tệp mẫu cho Apache Tika nhận dạng tài liệu crawl
Phần này gom các quyết định trước khi đưa Tika vào pipeline: phiên bản, Java, cách chạy và cách gửi tệp.
Phiên bản Tika và Java
Tika 2.x chạy trên Java 8 trở lên. Tika 3.x cần Java 11 trở lên. Máy lab chỉ có Java 8u401, nên lab chọn tika-server-standard 2.9.4. Trang chủ Tika ghi đây là bản 2.x cuối cùng, và nhánh 2.x cùng hỗ trợ Java 8 đã hết vòng đời. Với hệ thống chạy thật, cài Java 11 trở lên và dùng Tika 3 để còn nhận bản vá.
Kiểm phiên bản Java trước khi tải Tika. Lỗi phiên bản lớp khi khởi động là dấu hiệu Java quá cũ cho bản Tika đang dùng.
Tải từ nguồn chính thức và kiểm hash
Tải jar từ Maven Central hoặc trang tải của Apache, không tải từ nguồn lạ. Lab tải 66.689.555 byte và kiểm SHA1 công bố cạnh tệp trên Maven Central, khớp. Bước kiểm hash rẻ và chặn được tệp hỏng hay bị thay.
Chạy server cục bộ
Lệnh thường dùng là java -jar với tệp tika-server-standard, kèm host và port. Đặt host là 127.0.0.1 để server chỉ nghe trên máy, không mở ra mạng ngoài. Tika server không có xác thực mặc định, mở ra mạng là để ai cũng gửi tệp được.
Trên máy chủ chạy job, nên chạy Tika server như một dịch vụ riêng, có giới hạn bộ nhớ Java, tự khởi động lại khi lỗi.
Gửi tệp từ Python
import requests
def tika_detect(path, name):
    with open(path, "rb") as f:
        r = requests.put("http://127.0.0.1:9780/detect/stream", data=f,
                         headers={"Content-Disposition": f"attachment; filename={name}"},
                         timeout=30)
    r.raise_for_status()
    return r.text.strip()
Hàm gửi thân tệp bằng PUT và tên tệp làm gợi ý. Trang TikaServer ghi rằng /detect/stream dùng Default Detector của Tika, và gợi ý tên tệp giúp tăng chất lượng nhận dạng. Code này chưa chạy được trong lab vì server không khởi động được.
Thư viện tika cho Python
Gói tika trên PyPI bọc Tika server, tự tải jar và tự khởi động server khi gọi lần đầu. Tiện, nhưng ẩn mất bước tải và bước chạy Java. Trong môi trường có kiểm soát, nên tự quản lý server và gọi HTTP như hàm trên.
Chỉ gửi phần đầu tệp khi chỉ cần magic
Magic chỉ cần vài trăm byte đầu. Với tệp lớn, gửi toàn bộ chỉ để nhận dạng là lãng phí. Nhưng nhận dạng container cần đọc cấu trúc ZIP ở cuối tệp. Quyết định theo loại: đọc phần đầu trước, nếu ra ZIP thì gửi cả tệp để soi container.
Môi trường lab
Python 3.12.10, requests 2.34.2, mimetypes, zipfile, gzip của thư viện chuẩn. Máy chủ HTTP tĩnh cục bộ ở cổng 9781 để đo header Content-Type mà một máy chủ đoán theo đuôi sẽ gửi. Java 8u401 có sẵn trên máy, Tika server 2.9.4 tải về nhưng không chạy được.
Thu kết quả nhận dạng trên tập tệp crawl với Apache Tika nhận dạng tài liệu crawl
Phần này ghi kết quả phép kiểm thay thế trên 9 tệp.
Bảng kết quả
0/9, 7/9, 8/9
Tệp |
Thật là |
Theo đuôi |
Theo header |
Theo magic |
Magic và container |
|---|---|---|---|---|---|
bao-cao.jpg |
image/jpeg |
image/jpeg |
|||
anh-chup.pdf |
PNG |
PNG |
PNG |
||
hop-dong.zip |
DOCX |
x-zip-compressed |
x-zip-compressed |
ZIP |
DOCX |
du-lieu.docx |
ZIP |
DOCX |
DOCX |
ZIP |
ZIP |
trang-loi.pdf |
HTML |
HTML |
HTML |
||
gia.csv |
gzip |
vnd.ms-excel |
vnd.ms-excel |
gzip |
gzip |
ket-qua.txt |
JSON |
text/plain |
text/plain |
text/plain |
text/plain |
rong.pdf |
rỗng |
octet-stream |
octet-stream |
||
bom-pdf.bin |
octet-stream |
octet-stream |
Tổng: theo đuôi 0 trên 9, theo header 0 trên 9, theo magic 7 trên 9, magic cộng container 8 trên 9.
Header của máy chủ chỉ chép lại đuôi tệp
Cột theo header giống hệt cột theo đuôi ở cả 9 dòng. Máy chủ HTTP tĩnh của Python đoán Content-Type từ đuôi tệp, giống phần lớn máy chủ tĩnh. Header không cho thêm thông tin nào, nó chỉ là đuôi tệp được nói lại.
Bài học: khi crawl, Content-Type của máy chủ là gợi ý, không phải bằng chứng. Tika đặt nó ở bước cuối cùng, sau magic và tên tệp, là có lý do.
Đuôi .csv ra Excel trên Windows
Python mimetypes trên máy lab Windows trả application/vnd.ms-excel cho đuôi .csv, vì đọc bảng ánh xạ từ registry. Trên Linux, cùng code thường trả text/csv. Cùng một tệp, hai máy cho hai kết quả.
Đây là thêm một lý do không dựa vào đuôi tệp. Kết quả phụ thuộc cả máy chạy chứ không chỉ tệp.
Trang lỗi đội lốt PDF
Trang lỗi đội lốt PDF
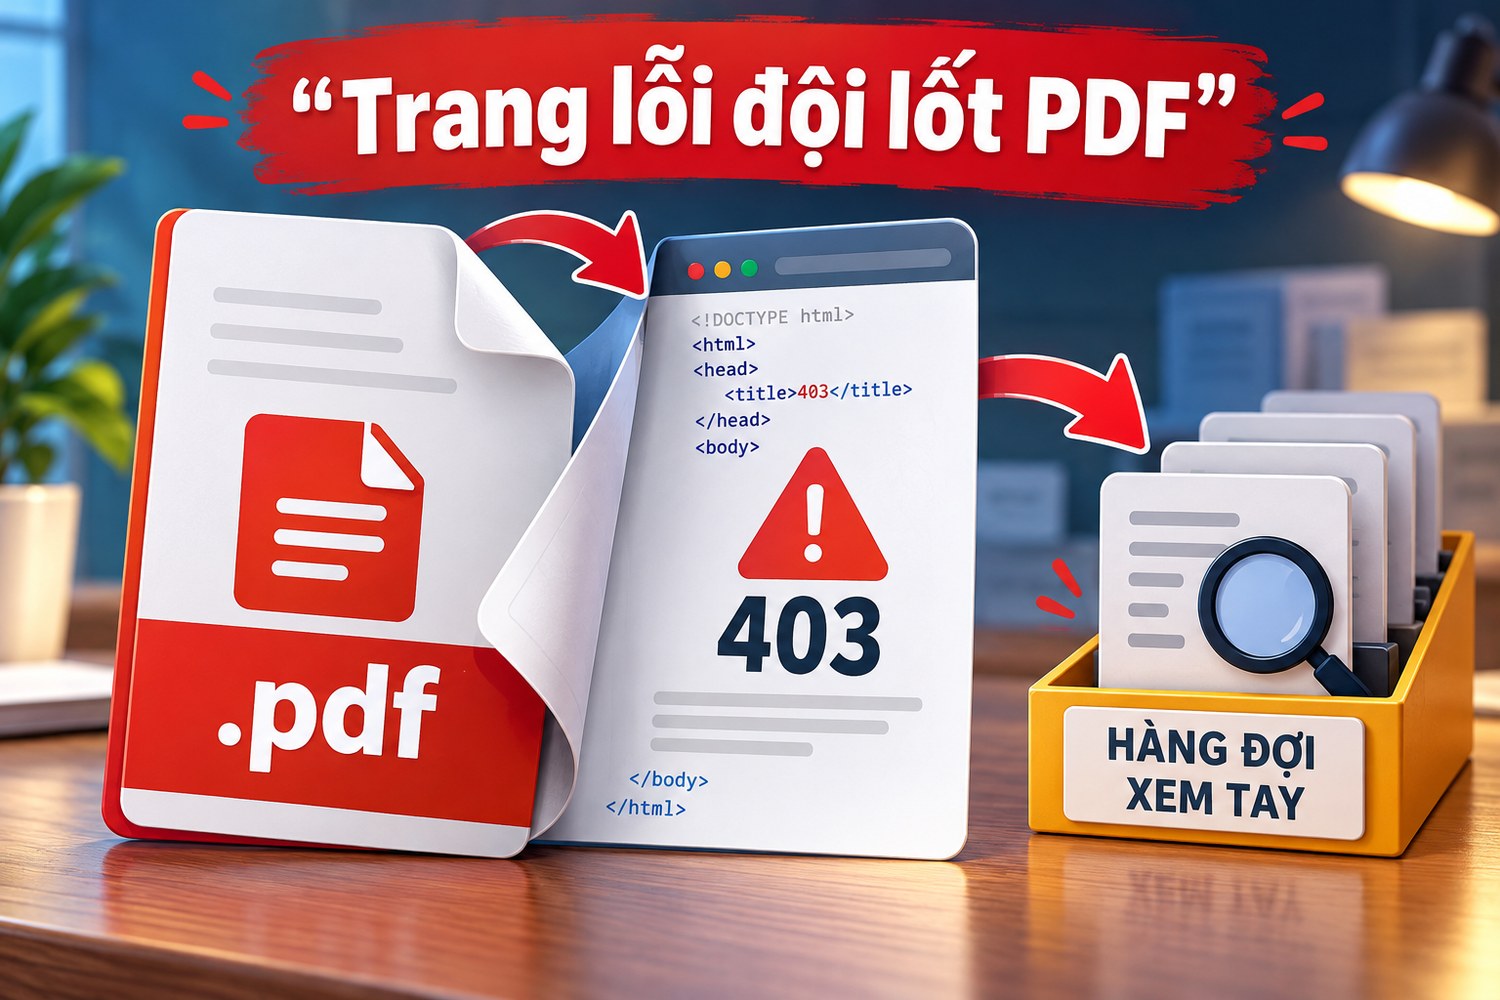
trang-loi.pdf là trang HTML 403 dài 94 byte. Theo đuôi và header là PDF. Magic tìm thấy DOCTYPE html trong 64 byte đầu và kết luận text/html. Nếu tệp này đi vào parser PDF, parser báo lỗi định dạng và người vận hành sẽ nghĩ PDF bị hỏng.
Với magic, pipeline biết ngay đây là trang lỗi và ghi nhận máy chủ đã từ chối. Đó là thông tin đúng để quyết định bước tiếp theo.
PDF có BOM
bom-pdf.bin bắt đầu bằng ba byte EF BB BF rồi mới tới %PDF-. Một số công cụ tạo PDF lỗi hoặc bước chuyển mã sai thêm BOM vào đầu. Quy tắc của Tika có hẳn một mẫu cho trường hợp này: BOM rồi %PDF- tại offset 0.
Phép kiểm của lab nhận đúng PDF nhờ đọc mẫu đó từ tệp quy tắc. Một phép kiểm tự viết chỉ so %PDF- tại byte đầu sẽ bỏ sót.
Đo tốc độ phép kiểm magic
Phép kiểm magic chỉ đọc vài trăm byte đầu tệp, nên gần như tức thời. Soi container phải mở cấu trúc ZIP, chậm hơn với tệp lớn nhưng vẫn nhanh hơn nhiều so với parse nội dung. Với pipeline hàng chục nghìn tệp mỗi ngày, bước nhận dạng không phải nút cổ chai.
Tika server thêm chi phí một request HTTP cục bộ cho mỗi tệp và chi phí khởi động máy ảo Java lúc đầu. Giữ server chạy liên tục thay vì khởi động lại cho từng lô.
Tệp rỗng
rong.pdf có 0 byte. Magic không có gì để so, kết quả là application/octet-stream. Tệp rỗng thường do tải lỗi giữa chừng hoặc máy chủ trả 200 với thân rỗng. Kiểm kích thước bằng 0 trước cả khi nhận dạng là cách rẻ nhất.
ZIP thường và DOCX
hop-dong.zip là DOCX thật. Magic chỉ thấy ZIP, bước soi container thấy [Content_Types].xml và thư mục word, kết luận DOCX. du-lieu.docx là ZIP thường chứa một tệp CSV. Đuôi nói DOCX, magic nói ZIP, soi container không thấy cấu trúc Word nên giữ ZIP.
Không có bước container, DOCX bị coi là ZIP và không tới được parser Word. Có bước container, cả hai tệp được định tuyến đúng.
Đối soát media type, metadata, giá trị thiếu và xuất xứ với Apache Tika nhận dạng tài liệu crawl
Phần này bàn trường hợp lab chưa giải được và cách tổ chức kết quả.
JSON không nhận dạng được bằng magic
ket-qua.txt là JSON hợp lệ. Cả bốn cách đều trả text/plain. Tệp quy tắc của Tika không có magic cho application/json, chỉ có mẫu tên *.json. Với đuôi .txt, không có gì để gợi ý JSON.
Trên Tika thật, kết quả cho tệp này nhiều khả năng cũng là text/plain, vì quy tắc không có magic, nhưng lab chưa xác nhận bằng server. Cách xử lý thực tế: với tệp text/plain, thử json.loads trên phần đầu. Thành công thì định tuyến như JSON.
Kiểu con và kiểu cha
Tika tổ chức loại MIME thành cây. DOCX là kiểu con của x-tika-ooxml, rồi của ZIP. JSON là kiểu con của application/javascript. Bộ định tuyến nên chấp nhận kiểu con: parser cho ZIP có thể xử lý DOCX như ZIP nếu cần, nhưng parser Word thì không xử lý được ZIP thường.
Ghi cả kiểu cụ thể nhất và kiểu cha vào bảng kết quả. Khi thêm parser mới, quy tắc định tuyến theo kiểu cha giúp không phải sửa từng dòng.
Metadata đi kèm loại
Ngoài loại MIME, endpoint /meta của Tika server trả metadata như tác giả, ngày tạo, số trang, ứng dụng tạo tệp. Metadata giúp phát hiện thêm vấn đề, ví dụ PDF có số trang bằng 0 hay tệp Office tạo bởi công cụ lạ. Lab không lấy được metadata vì server không chạy.
Giữ xuất xứ cho từng tệp
Ghi URL nguồn, header Content-Type gốc, tên tệp gốc, kích thước, SHA-256 của nội dung, loại theo magic, loại sau container, công cụ và phiên bản dùng để nhận dạng. Hash giúp phát hiện cùng một tệp được tải từ nhiều URL.
Bài JSON và CSV khi crawl dữ liệu bàn cách tổ chức bảng như vậy.
Tệp nén cần nhận dạng hai lần
gia.csv thật là gzip. Sau khi giải nén, bên trong là CSV. Bộ định tuyến phải nhận ra lớp ngoài là gzip, giải nén, rồi nhận dạng lại lớp trong. Bài gzip và brotli khi web scraping phân biệt nén ở tầng HTTP với tệp nén thật sự.
Nén ở tầng HTTP thì requests tự giải, tệp lưu xuống đĩa đã là nội dung thật. Tệp gzip thật thì vẫn là gzip sau khi tải, cần bước giải riêng.
Lưu kết quả, giới hạn request và khi nào Apache Tika nhận dạng tài liệu crawl cần proxy
Phần cuối bàn chuyện tích hợp, nhịp xử lý và vị trí của proxy.
Đặt bước nhận dạng ngay sau bước tải
Thứ tự gọn: tải tệp, kiểm kích thước khác 0, nhận dạng bằng magic, soi container nếu là ZIP hay OLE2, định tuyến tới parser. Mỗi tệp có một dòng trong bảng kết quả trước khi bất kỳ parser nào chạm vào nó.
Tệp có loại không nằm trong danh sách parser được hỗ trợ đi vào hàng đợi riêng để xem tay, không bị bỏ.
Tệp đã nhận dạng xong thì đi đâu
Sau bước nhận dạng, mỗi loại có một đích rõ ràng. PDF đi tới bước trích chữ hoặc trích bố cục. DOCX đi tới parser Word. HTML đội lốt PDF đi vào danh sách URL bị từ chối. gzip đi qua bước giải nén rồi quay lại bước nhận dạng. Tệp rỗng đi vào danh sách tải lại.
Ghi đích này vào cùng dòng với kết quả nhận dạng. Khi đếm cuối ngày, anh em biết bao nhiêu tệp đã được xử lý, bao nhiêu đang chờ, bao nhiêu bị loại và vì sao.
Tika server là dịch vụ cục bộ
Tika server chạy trên máy hoặc trong mạng nội bộ, nhận dạng không gửi tệp đi đâu. Không có hạn mức request bên ngoài. Giới hạn là CPU và bộ nhớ của máy chạy Java. Với tệp lớn và nhiều luồng, đặt giới hạn bộ nhớ Java và số luồng gửi đồng thời.
Tải tài liệu tôn trọng nguồn
Khi bước nhận dạng phát hiện nhiều trang lỗi HTML từ cùng một máy chủ, đó là dấu hiệu máy chủ đang từ chối. Giảm nhịp hoặc dừng với nguồn đó. Bài rate limit API khi dùng proxy có mẫu bộ đếm request.
Proxy nằm ở bước tải
Tika server nhận tệp từ pipeline qua địa chỉ cục bộ 127.0.0.1. Không cần và không nên đặt proxy cho request tới Tika server. Nếu biến môi trường HTTP_PROXY được đặt cho cả máy, nhớ thêm 127.0.0.1 và localhost vào NO_PROXY, nếu không requests sẽ gửi tệp tới proxy thay vì tới Tika.
Proxy chỉ có chỗ ở bước tải tài liệu từ website nguồn. Lab không tải tài liệu qua mạng trong bài này.
Khi nào cần proxy thật
Proxy cần khi máy chạy crawler nằm trong mạng nội bộ chỉ được ra Internet qua proxy. Trường hợp thứ hai là tổ chức yêu cầu lưu lượng ra ngoài đi qua một IP cố định để giám sát, hay để website nguồn đưa IP đó vào danh sách cho phép. Cấu hình và mã hóa mật khẩu có ký tự đặc biệt có trong bài định dạng proxy.
Bài Web Scraping proxy là gì phân biệt các vai trò của proxy. Với Tika, proxy không làm nhận dạng đúng hơn. Nhưng bước nhận dạng giúp phát hiện khi proxy hoặc máy chủ trả trang lỗi thay cho tài liệu.
Khi máy chủ của nhóm đặt tại Việt Nam và cần IP thoát ổn định cho job tải tài liệu, proxy tĩnh dễ quản lý hơn proxy xoay. ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay qua HTTP hoặc SOCKS5. Anh em có thể mua proxy Việt Nam tại trang chủ ProxyVN rồi khai báo cho bước tải, nhớ đặt NO_PROXY cho Tika server.
Giới hạn suy luận của bài
Lab không chạy được Tika server ngày 29/10/2026 vì lệnh java -jar bị chặn trong môi trường lab. Mọi kết quả nhận dạng trong bảng đến từ phép kiểm thay thế bằng Python, dùng tập con quy tắc đọc từ tika-mimetypes.xml của Tika 2.9.4. Tika thật có thêm nhiều quy tắc và bộ nhận dạng container đầy đủ hơn.
Lab không lấy metadata, không thử Tika 3, không thử tệp OLE2 như DOC hay XLS cũ, không tải tài liệu qua mạng. Đoạn code gọi /detect/stream viết theo tài liệu, chưa chạy thật.
Checklist Apache Tika nhận dạng tài liệu crawl
Checklist Apache Tika
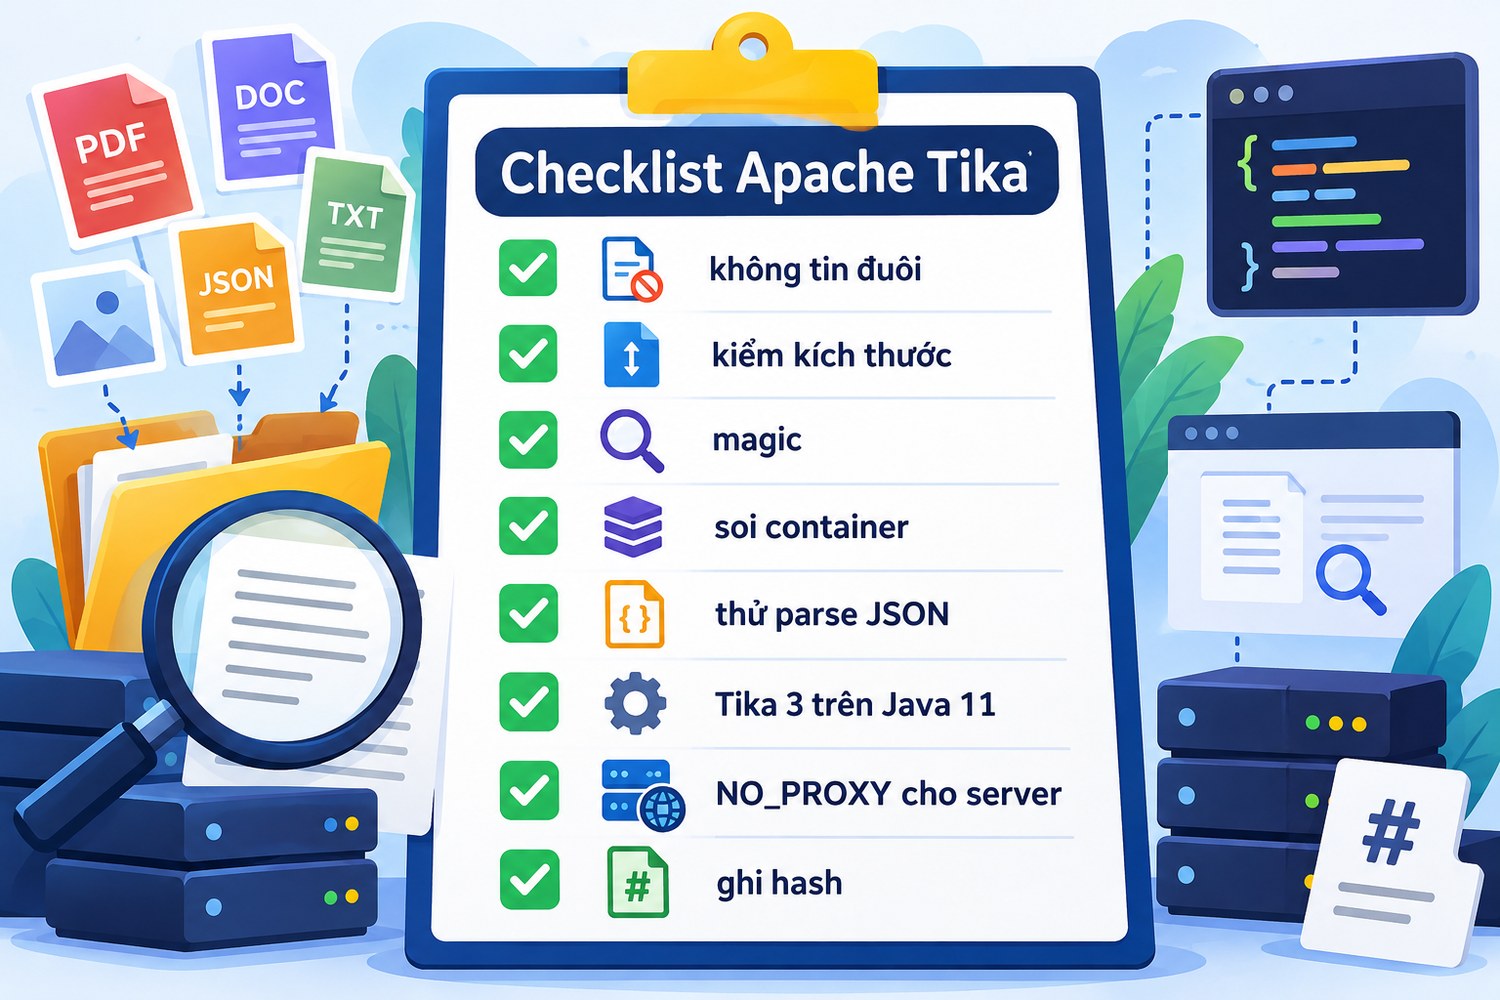
- Không tin đuôi tệp và header Content-Type.
- Kiểm kích thước khác 0 trước tiên.
- Nhận dạng bằng magic trên nội dung.
- Soi container khi magic ra ZIP hoặc OLE2.
- Thử parse JSON với tệp text/plain.
- Dùng Tika 3 trên Java 11 trở lên, nhánh 2.x đã hết vòng đời.
- Server chỉ nghe 127.0.0.1, thêm vào NO_PROXY.
- Ghi hash, loại, phiên bản cho từng tệp.
Câu hỏi thường gặp về Apache Tika nhận dạng tài liệu crawl
Vì sao không tin đuôi tệp?
Vì đuôi do người đặt tên quyết định. Lab có 9 tệp đổi đuôi, đoán theo đuôi đúng 0 trên 9.
Header Content-Type có đáng tin hơn không?
Với máy chủ tĩnh, header thường chỉ là đuôi tệp nói lại. Lab đo header giống hệt đuôi ở cả 9 tệp.
Tika nhận DOCX thế nào khi DOCX chỉ là ZIP?
Bằng nhận dạng container: mở ZIP và xem cấu trúc bên trong. Magic thuần chỉ thấy ZIP.
Tika có nhận JSON không?
Tệp quy tắc 2.9.4 không có magic cho JSON, chỉ có mẫu tên .json. JSON đặt sai đuôi sẽ ra văn bản thường.
Tika server cần Java bản nào?
Tika 3.x cần Java 11 trở lên. Tika 2.x chạy trên Java 8 nhưng đã hết vòng đời, bản cuối là 2.9.4.
Có cần proxy cho Tika không?
Không cho Tika server. Proxy chỉ dùng ở bước tải tài liệu, nhớ đặt NO_PROXY cho địa chỉ cục bộ.
Apache Tika nhận dạng tài liệu crawl và những điều cần nhớ
Apache Tika nhận dạng tài liệu crawl dựa vào nội dung trước, tên tệp và header sau, đúng thứ tự mà pipeline tài liệu cần. Lab ngày 29/10/2026 với 9 tệp đổi đuôi: theo đuôi và header đều 0 trên 9, magic theo quy tắc Tika 7 trên 9, thêm soi ZIP 8 trên 9, còn JSON cần phép thử riêng. Lab chưa chạy được Tika server và ghi rõ điều đó. Cần IP thoát ổn định cho bước tải trước khi Apache Tika nhận dạng tài liệu crawl, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


