Typesense import JSONL crawl: đối soát từng dòng kết quả
Typesense import JSONL crawl là cách đẩy hàng loạt tài liệu từ một tệp JSONL vào collection, rồi đọc phản hồi từng dòng để biết bản ghi nào vào được, bản ghi nào bị loại. Endpoint import luôn trả HTTP 200, kể cả khi phần lớn tài liệu hỏng. ProxyVN chạy client typesense-python thật trên máy chủ mô phỏng, dựng tệp có sáu kiểu dòng lỗi, map kết quả về source ID và ghi rõ phần chưa chạy trên Typesense thật.
Typesense import JSONL crawl: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra cần giao và những thứ bài không bàn tới.
Bài toán cần giải
Một crawler ghi mỗi trang sản phẩm thành một dòng JSON, cuối ngày gom thành tệp JSONL và đẩy vào Typesense. Log ghi import xong, mã trạng thái 200. Sáng hôm sau, người dùng tìm không ra một nửa sản phẩm mới. Lý do nằm trong thân phản hồi, nơi từng dòng có thể là success false mà không ai đọc.
Đầu ra nghiệm thu
Đầu ra là một tệp import có chủ ý chứa dòng lỗi, kèm bảng nối mỗi dòng phản hồi về source ID của trang gốc. Bảng phải cho biết dòng nào thành công, dòng nào thất bại, mã lỗi là gì và cách xử lý. Sau đó là lượt import lại riêng các dòng đã sửa và bước truy vấn xác nhận.
Source ID là gì trong bài này
Source ID là mã do crawler gắn cho mỗi lần lấy trang, ví dụ S01 hay S02. Nó khác document ID của Typesense. Document ID dùng để ghi đè hoặc cập nhật, còn source ID dùng để truy ngược về lần tải, tệp HTML gốc và parser đã chạy. Hai mã này cần tồn tại song song.
Ranh giới với bài Meilisearch
Bài Meilisearch index dữ liệu crawl xử lý mô hình task bất đồng bộ, phải hỏi lại bằng taskUid. Typesense import là đồng bộ: phản hồi trả về ngay, nhưng kết quả nằm rải rác trong từng dòng. Vấn đề ở đây là đối soát dòng, không phải chờ task.
Ranh giới với bài OpenSearch
Bài OpenSearch bulk index cũng có phản hồi theo item, nhưng là một mảng JSON với cờ errors ở đầu. Typesense trả về văn bản JSONL, không có cờ tổng. Muốn biết có lỗi hay không, anh em phải đọc hết từng dòng. Bài này không so sánh hai công cụ tìm kiếm.
Giới hạn của lab
Nói rõ ngay. Lab không chạy máy chủ Typesense thật. Máy lab không được tải và chạy tệp nhị phân bên ngoài, nên ProxyVN viết một máy chủ Python nhỏ mô phỏng các endpoint collection, import, lấy tài liệu và tìm kiếm. Tìm kiếm chỉ là so chuỗi con, không có xếp hạng hay sửa lỗi chính tả.
Thứ gì thật, thứ gì giả
Client typesense-python 2.1.1 là thật, gồm cả cách nó chia lô phía client và cách nó parse phản hồi. Quy tắc action, return_id, dirty_values và HTTP 200 lấy từ tài liệu chính thức. Câu chữ thông báo lỗi do ProxyVN đặt theo định dạng quen thuộc, máy thật có thể ghi khác.
Ai nên đọc bài này
Người nạp dữ liệu crawl vào Typesense để làm tìm kiếm nội bộ hoặc trang so sánh giá. Người từng thấy import báo thành công mà số tài liệu không khớp. Người đang viết lại pipeline và muốn có bước đối soát trước khi coi một lượt là xong.
Typesense import JSONL crawl: đồng bộ collection và kiểm kết quả từng dòng
Phần này tóm tắt tài liệu chính thức về import và những điều cần nhớ trước khi viết mã.
Endpoint import
Trang Documents API mô tả endpoint POST tới đường dẫn documents/import của một collection. Thân request là JSONL, mỗi dòng một tài liệu. Tài liệu khuyên dùng endpoint này thay vì gọi tạo từng tài liệu khi cần ghi nhiều, vì nó được tối ưu cho nạp hàng loạt.
Phản hồi theo đúng thứ tự
Tài liệu nêu mỗi dòng phản hồi ứng với một tài liệu trong thân request, theo cùng thứ tự. Một tài liệu hỏng không ảnh hưởng tài liệu khác. Dòng lỗi có thông báo lỗi và nội dung tài liệu gốc. Thứ tự này là chìa khóa của cả bài, vì nó là cách duy nhất để nối kết quả về nguồn khi dòng lỗi không có ID.
Luôn là 200
Tài liệu ghi rõ endpoint import luôn trả HTTP 200, bất kể kết quả từng tài liệu. Lý do: một lần import có thể vừa có dòng thành công vừa có dòng thất bại, và Typesense không muốn trả mã lỗi trong trường hợp nửa vời đó. Mã 200 ở đây không nói gì về dữ liệu.
Bốn chế độ action
Tham số action có bốn giá trị. Create là mặc định, tạo mới và báo lỗi nếu ID đã tồn tại. Upsert tạo mới hoặc thay thế, cần gửi đủ tài liệu. Update chỉ sửa tài liệu đã có, cho phép gửi một phần. Emplace tạo mới hoặc cập nhật, chấp nhận cả tài liệu đủ lẫn một phần.
Action |
ID chưa có |
ID đã có |
Cần gửi đủ trường |
|---|---|---|---|
create |
Tạo mới |
Lỗi |
Có |
upsert |
Tạo mới |
Thay toàn bộ |
Có |
update |
Lỗi |
Sửa trường gửi lên |
Không |
emplace |
Tạo mới |
Sửa trường gửi lên |
Không |
Chọn action cho dữ liệu crawl
Lượt crawl đầu dùng create là hợp lý, vì nó lộ ra trang lặp qua lỗi trùng ID. Các lượt sau lấy lại toàn bộ trang thì upsert đơn giản hơn. Nếu một lượt chỉ cập nhật giá, update giúp không phải gửi lại mô tả dài. Bài này dùng create cho lượt đầu để bắt lỗi rõ nhất.
return_id và return_doc
Tài liệu nêu tham số return_id làm phản hồi kèm trường id của tài liệu đã nạp. Tham số return_doc trả lại toàn bộ tài liệu. Trong lab, dòng thất bại không có id, chỉ có trường document chứa chuỗi gốc. Vậy return_id giúp với dòng thành công, nhưng không cứu được việc map dòng lỗi.
Lô phía máy chủ và lô phía client
Tài liệu nêu Typesense mặc định nạp 40 tài liệu mỗi lần, sau mỗi lô thì phục vụ hàng đợi tìm kiếm rồi mới nạp tiếp. Tham số batch_size đổi con số này, và đây là lô phía máy chủ trong một request. Anh em cũng có thể chia lô phía client bằng nhiều request import riêng.
Giới hạn kích thước request
Tài liệu cảnh báo mỗi request import tối đa 10GB, tệp lớn hơn phải chia nhỏ. Với dữ liệu crawl, tệp chạm tới mức này rất hiếm, nhưng giới hạn thực tế thường đến sớm hơn từ proxy ngược hay bộ cân bằng tải đứng trước Typesense. Lab không thử ca này.
Dữ liệu bẩn
Tham số dirty_values quyết định cách xử lý khi kiểu dữ liệu không khớp schema. Coerce_or_reject thử ép kiểu, không được thì từ chối. Coerce_or_drop thử ép kiểu, không được thì bỏ trường đó. Drop bỏ trường. Reject từ chối cả tài liệu. Đây là nơi giá ghi dạng chuỗi bị bắt.
Giá trị mặc định của dirty_values
Tài liệu nêu mặc định là coerce_or_reject nếu schema có trường wildcard hoặc tên trường dạng biểu thức chính quy. Ngược lại, mặc định là reject để giữ tương thích với bản cũ. Schema của lab khai báo tường minh, không có wildcard, nên máy chủ mô phỏng dùng reject làm mặc định.
Typesense import JSONL crawl: định nghĩa collection schema và khóa document ID
Phần này dựng collection và quyết định cách sinh ID, hai việc ảnh hưởng mọi lượt import sau.
Khởi tạo client
Client trỏ tới máy chủ mô phỏng ở cổng 9481. Typesense thật mặc định dùng cổng 8108. Khóa API là chuỗi giả của lab.
import typesense

c = typesense.Client({
    "nodes": [{"host": "127.0.0.1", "port": 9481, "protocol": "http"}],
    "api_key": "khoa-lab",
    "connection_timeout_seconds": 5,
})
Khóa dùng để nạp dữ liệu nên là khóa có quyền ghi riêng cho pipeline. Đừng dùng khóa admin trong tác vụ crawl chạy định kỳ.
Schema của lab
Collection pages có năm trường. Url, title, shop và source_id là chuỗi bắt buộc. Price là số thực, cho phép thiếu vì có trang không ghi giá.
schema = {"name": "pages", "fields": [
    {"name": "url", "type": "string"},
    {"name": "title", "type": "string"},
    {"name": "price", "type": "float", "optional": True},
    {"name": "shop", "type": "string", "facet": True},
    {"name": "source_id", "type": "string"},
]}
c.collections.create(schema)
Trường shop đặt facet để lọc theo cửa hàng. Trường source_id được lưu vào tài liệu để truy ngược từ kết quả tìm kiếm về lần crawl.
Vì sao khai báo tường minh
Typesense cho phép tự suy kiểu bằng trường wildcard. Với dữ liệu crawl, tự suy kiểu là con dao hai lưỡi. Dòng đầu có giá là số thì trường thành số, dòng đầu có giá là chuỗi thì trường thành chuỗi, và cả lượt sau bị lệch. Khai báo tường minh giúp lỗi lộ ra ở đúng dòng hỏng.
Trường bắt buộc và trường tùy chọn
Trường không đánh optional là bắt buộc. Trang thiếu tiêu đề sẽ bị từ chối. Đó là điều anh em muốn, vì tiêu đề rỗng thường là dấu hiệu parser hỏng hoặc trang trả về nội dung khác. Giá thì khác: trang hết hàng không ghi giá là chuyện bình thường, nên để optional.
Quy tắc của trường id
Tài liệu nêu trường id đặc biệt, không cần khai báo trong schema. Nếu tài liệu không có id, Typesense tự sinh. Tài liệu cũng ghi id không nên chứa dấu cách hay ký tự cần mã hóa trong URL. Như vậy URL trang không dùng thẳng làm id được.
Sinh document ID từ URL
Băm URL đã chuẩn hóa thành chuỗi hex là cách ổn định. Cùng URL luôn ra cùng ID, nên lượt crawl sau ghi đè đúng chỗ, không tạo bản lặp.
import hashlib

def pid(url):
    return hashlib.sha1(url.encode()).hexdigest()[:16]
Hàm này là ví dụ triển khai. Nếu website có nhiều URL cho cùng một sản phẩm, chuẩn hóa URL trước khi băm, nếu không mỗi biến thể sẽ thành một tài liệu.
Đừng để Typesense tự sinh ID
ID tự sinh khiến lượt sau không biết tài liệu nào cần thay. Mỗi lần import lại sẽ cộng thêm bản sao. Lab có một ca cho thấy tài liệu thiếu id được gán số thứ tự, và nếu chạy lại sẽ thành hai tài liệu cùng nội dung.
Source ID đi kèm tài liệu
Source ID được ghi vào trường source_id trước khi xuất JSONL. Khi người dùng báo một kết quả sai, anh em đọc trường này, mở đúng tệp HTML gốc và log parser. Không có nó, việc dò ngược phải đi qua URL và thời gian, chậm hơn nhiều.
Typesense import JSONL crawl: import tệp có một dòng sai kiểu
Phần này dựng tệp import với các kiểu dòng hỏng thường gặp trong dữ liệu crawl và gửi đi.
Tệp fixture
Tệp import.jsonl có bảy dòng. Mỗi dòng mang một lỗi điển hình, trừ dòng đầu.
Source ID |
Nội dung đáng chú ý |
Lỗi dự kiến |
|---|---|---|
S01 |
Đủ trường, giá là số |
Không |
S02 |
Giá là chuỗi 390.000d |
Sai kiểu |
S03 |
Thiếu title |
Thiếu trường bắt buộc |
S04 |
Giá là chuỗi 250000 |
Sai kiểu khi reject |
S09 |
Dòng JSON bị cắt ngang |
JSON hỏng |
S05 |
id là URL |
ID không hợp lệ |
S06 |
Trùng URL với S01 |
Trùng ID khi create |
Nguồn gốc từng lỗi
Giá dạng chuỗi có đơn vị đến từ parser lấy nguyên văn bản hiển thị. Thiếu tiêu đề đến từ trang lỗi trả mã 200 với giao diện khác. Dòng JSON hỏng đến từ worker chết giữa lúc ghi tệp. ID là URL đến từ một nhánh mã cũ. Trang lặp đến từ hai đường dẫn cùng dẫn tới một sản phẩm.
Gửi tệp thô
Gửi bytes thay vì danh sách, client chuyển thẳng tệp lên và trả về chuỗi văn bản. Đây là cách gần nhất với việc dùng curl đẩy tệp JSONL.
data = open("import.jsonl", "rb").read()
raw = c.collections["pages"].documents.import_(
    data, {"action": "create", "return_id": True})
resp = raw.split("\n")
print(type(raw).__name__, len(resp))   # str 7
Client 2.1.1 không parse khi nhận bytes. Anh em tự tách dòng và tự parse từng dòng.
Kết quả lần đầu
Bảy dòng gửi, bảy dòng nhận. Chỉ một dòng thành công. Dưới đây là output thật của client trên máy chủ mô phỏng.
('S01', True, '1c2d5450a0e513aa', '', '')
('S02', False, '', 400, 'Field `price` must be a float.')
('S03', False, '', 400, 'Field `title` has been declared in the schema, but is not found in the document.')
('S04', False, '', 400, 'Field `price` must be a float.')
('S09', False, '', 400, 'Bad JSON.')
('S05', False, '', 400, "Document's `id` field should be a string without spaces or URL-reserved characters.")
('S06', False, '', 409, 'A document with id 1c2d5450a0e513aa already exists.')
Không có ngoại lệ nào bị ném. Nếu mã chỉ kiểm mã trạng thái, lượt này được ghi là thành công.
Dòng giá 250000 cũng hỏng
Dòng S04 ghi giá là chuỗi chỉ gồm chữ số. Với dirty_values mặc định là reject, máy chủ mô phỏng từ chối cả dòng. Trên Typesense thật, mặc định phụ thuộc schema như đã nêu ở trên. Anh em cần biết collection của mình đang ở chế độ nào trước khi đoán lý do.
Dòng JSON hỏng không mất
Dòng S09 bị cắt ngang vẫn có một dòng phản hồi riêng, đứng đúng vị trí của nó. Nếu máy chủ bỏ qua dòng hỏng mà không trả gì, toàn bộ phần sau sẽ lệch một vị trí. Đây là hành vi của máy chủ mô phỏng, theo quy tắc mỗi dòng một kết quả trong tài liệu.
Đếm num_documents là chưa đủ
Sau lượt đầu, collection báo một tài liệu. Con số này cho biết có vấn đề, nhưng không nói dòng nào hỏng. Với lô hàng nghìn dòng, chênh lệch giữa số dòng gửi và num_documents cũng bị nhiễu bởi trang lặp có chủ ý. Chỉ phản hồi từng dòng mới cho đủ thông tin.
Chỗ thường gặp khi dùng curl
Đẩy tệp bằng curl thì phải dùng data-binary. Tùy chọn data thường của curl bỏ ký tự xuống dòng, cả tệp dính thành một dòng. Lab không chạy curl, nhưng ví dụ trong tài liệu chính thức dùng đúng tùy chọn data-binary.
Typesense import JSONL crawl: map từng dòng response về source ID
Phần này là tài sản chính của bài: bảng nối mỗi kết quả về trang gốc.
Nguyên tắc nối theo vị trí
Dòng phản hồi thứ i ứng với dòng thứ i của thân request đã gửi. Mã đối soát chỉ cần ghép hai danh sách theo vị trí. Nhưng phải là danh sách thực sự đã gửi, không phải tệp gốc trước khi lọc.
import json

table = []
for (sid, _), line, r in zip(src, lines, resp):
    r = json.loads(r)
    table.append((sid, r["success"], r.get("id", ""),
                  r.get("code", ""), r.get("error", "")))
Hàm zip dừng ở danh sách ngắn nhất. Nên kiểm số dòng gửi bằng số dòng nhận trước khi ghép, nếu lệch thì dừng.
Bảng đối soát lần đầu
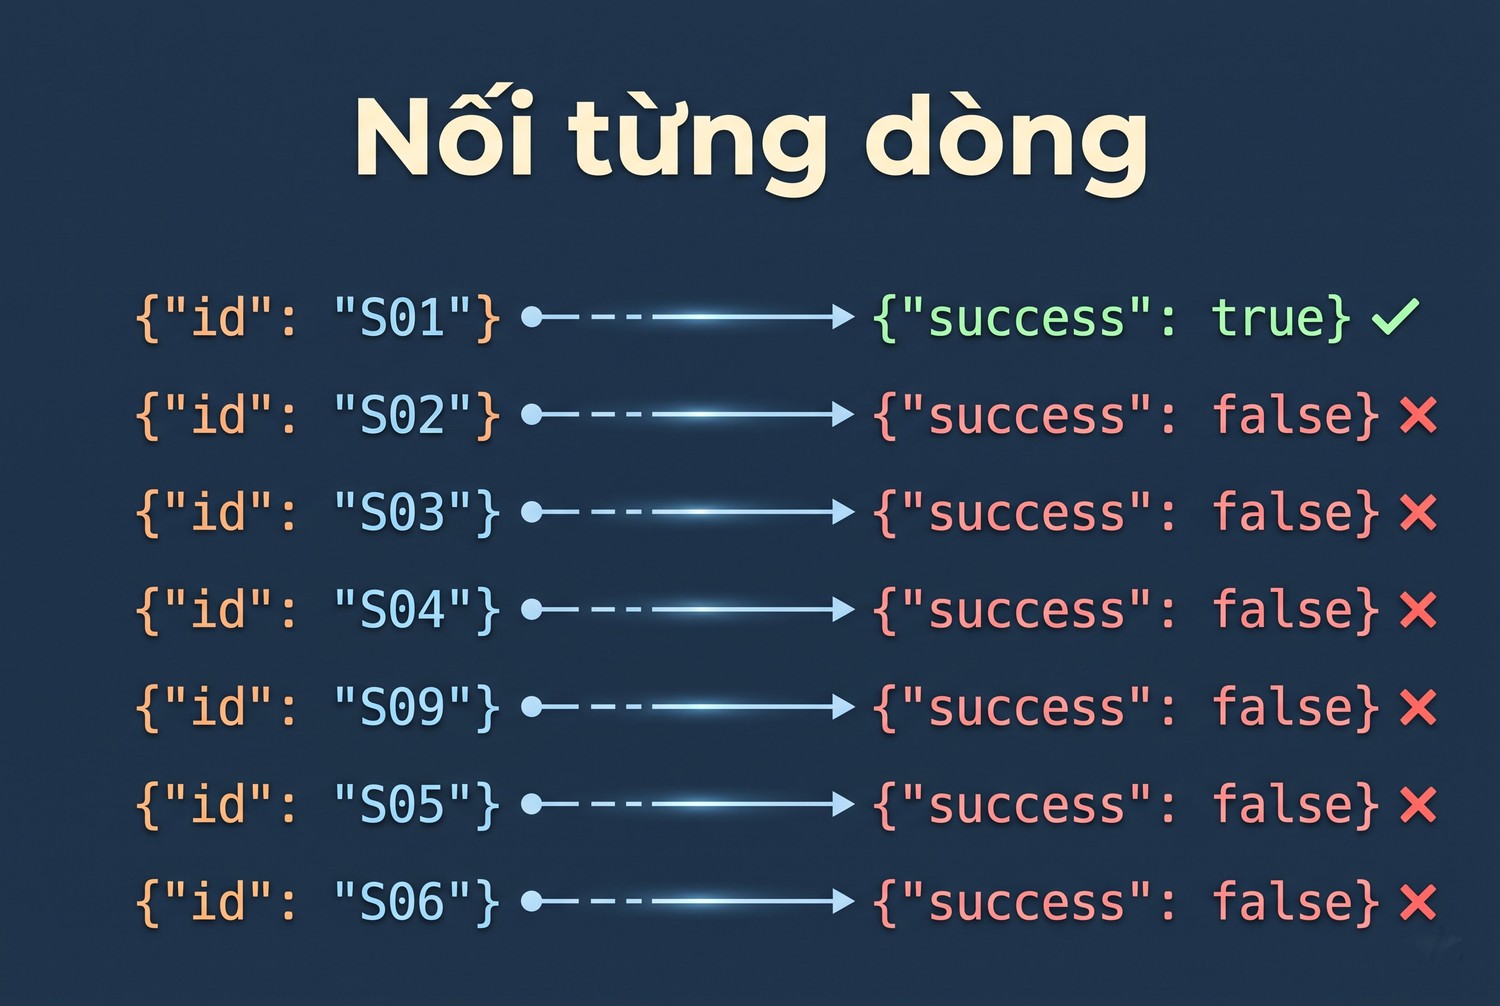
Nối từng dòng
Bảng dưới là đầu ra nghiệm thu, gom từ output thật của client.
Source ID |
Thành công |
Mã |
Lỗi |
Xử lý |
|---|---|---|---|---|
S01 |
Có |
Giữ |
||
S02 |
Không |
400 |
price phải là float |
Làm sạch giá, import lại |
S03 |
Không |
400 |
Thiếu title |
Đánh dấu cần xem, import lại |
S04 |
Không |
400 |
price phải là float |
Ép kiểu, import lại |
S09 |
Không |
400 |
JSON hỏng |
Crawl lại trang |
S05 |
Không |
400 |
id không hợp lệ |
Băm URL làm id |
S06 |
Không |
409 |
Trùng id với S01 |
Bỏ có chủ ý |
Vì sao không dựa vào return_id
Return_id chỉ có ở dòng thành công. Dòng lỗi mang trường document chứa nguyên chuỗi đã gửi, nên về lý thuyết có thể parse lại để lấy source_id. Nhưng dòng JSON hỏng không parse được, và đó là dòng cần dò nhất. Vị trí là cách duy nhất làm việc với mọi loại lỗi.
Bẫy lọc dòng trước khi gửi
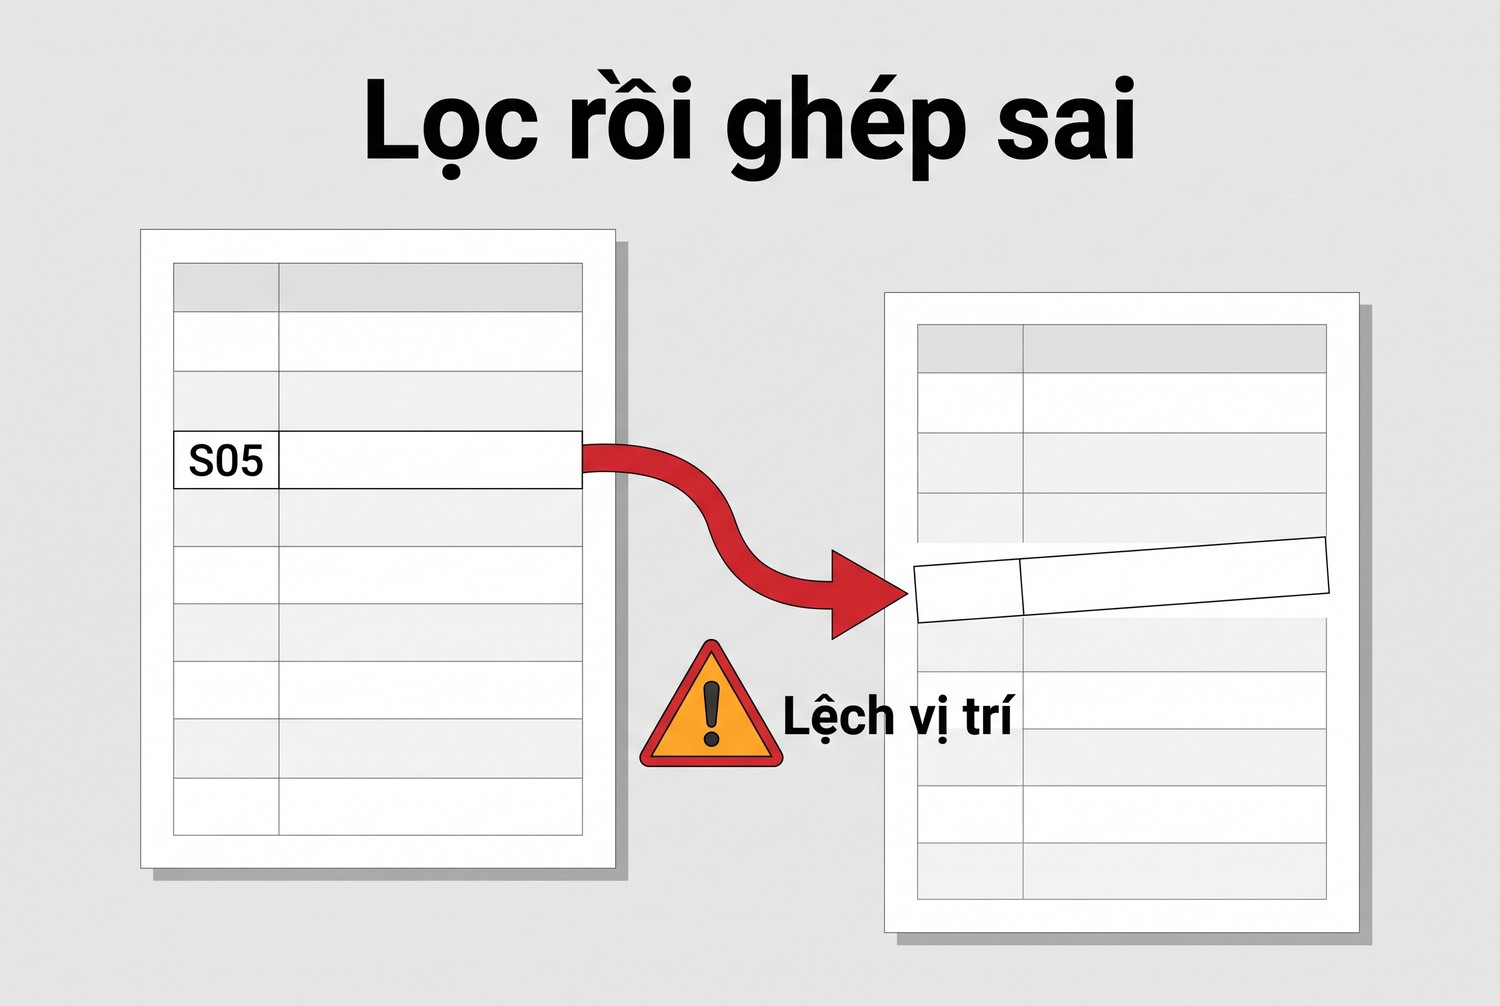
Lọc rồi ghép sai
Lab có một ca cố ý sai. Mã lọc bỏ dòng hỏng trước khi gửi, còn sáu dòng. Phản hồi có sáu dòng, nhưng lại được ghép với bảy source ID của tệp gốc.
map theo file goc (sai): [('S01', True), ('S02', False), ('S03', False), ('S04', False), ('S09', False), ('S05', True)]
map theo danh sach da gui (dung): [('S01', True), ('S02', False), ('S03', False), ('S04', False), ('S05', False), ('S06', True)]
Bản ghép sai báo S05 thành công và làm mất S06. Không có lỗi nào được ném, bảng trông vẫn hợp lý.
Lỗi lệch vị trí khó thấy
Khi lệch một vị trí, mọi kết luận sau đó đều sai nhưng không ai phát hiện. Anh em sửa nhầm bản ghi, bỏ qua bản ghi hỏng thật. Cách phòng: giữ danh sách source ID song song với từng dòng thực gửi, ghép theo danh sách đó, và kiểm số dòng hai bên.
Upsert ghi đè bản tốt bằng bản lặp
Ca lọc dòng chạy với action upsert. Dòng S06 trùng ID với S01, và lần này thành công. Tài liệu của S01 bị thay bằng tiêu đề của trang lặp. Ở create, trùng ID là lỗi 409 dễ thấy. Ở upsert, trùng ID là ghi đè im lặng. Hãy khử trang lặp trước khi xuất tệp.
Lô phía client vẫn giữ thứ tự
Truyền danh sách mười tài liệu với batch_size bằng 4, client gửi ba request và gộp lại mười kết quả đã parse. Hai tài liệu có giá không hợp lệ nằm đúng vị trí 2 và 7, khớp C03 và C08.
batch_size=4 -> so request: 3 | so ket qua: 10
  that bai o vi tri: [2, 7] -> ['C03', 'C08']
Trong client 2.1.1, batch_size truyền vào hàm là chia lô phía client, khác tham số batch_size trên URL mà tài liệu mô tả cho phía máy chủ.
Ghi bảng đối soát ra đâu
Lab ghi bảng ra tệp JSON cạnh tệp import. Pipeline thật nên lưu vào cơ sở dữ liệu của crawler, cùng run ID. Mỗi dòng gồm source ID, document ID, trạng thái, mã, thông báo lỗi, tên tệp import. Lượt sau đọc bảng này để biết cần làm lại những gì.
Nhóm lỗi theo thông báo
Thông báo lỗi là văn bản, không phải mã cố định. Nhóm theo mã HTTP trong dòng phản hồi trước, rồi theo mẫu thông báo. Với 400, thường là dữ liệu. Với 409, thường là trùng ID. Với 404 khi dùng update, là tài liệu chưa có. Đừng so khớp nguyên câu, vì câu chữ có thể đổi theo phiên bản.
Typesense import JSONL crawl: import lại đúng bản ghi lỗi và kiểm truy vấn
Phần này sửa từng nhóm lỗi, import lại riêng phần đã sửa và xác nhận bằng truy vấn.
Phân loại trước khi sửa
Không phải dòng lỗi nào cũng nên sửa tự động. Dòng sai kiểu có thể làm sạch. Dòng thiếu trường bắt buộc nên đánh dấu để người xem. Dòng JSON hỏng phải lấy lại trang. Dòng trùng ID thì bỏ qua nếu đó là trang lặp có chủ ý.
Quy tắc sửa trong lab
Mã lab đọc thông báo lỗi và áp quy tắc tương ứng. Đây là ví dụ triển khai, không phải bộ quy tắc đầy đủ.
if "must be a float" in err:
    d["price"] = float("".join(ch for ch in str(d["price"]) if ch.isdigit()))
if "not found in the document" in err:
    d["title"] = "(chua co tieu de)"; d["needs_review"] = True
if "`id` field" in err:
    d["id"] = pid(d["url"])
Quy tắc làm sạch giá ở đây bỏ mọi ký tự không phải chữ số. Với giá có phần thập phân, quy tắc này sai và cần viết lại theo định dạng của từng website.
Import lại bằng upsert
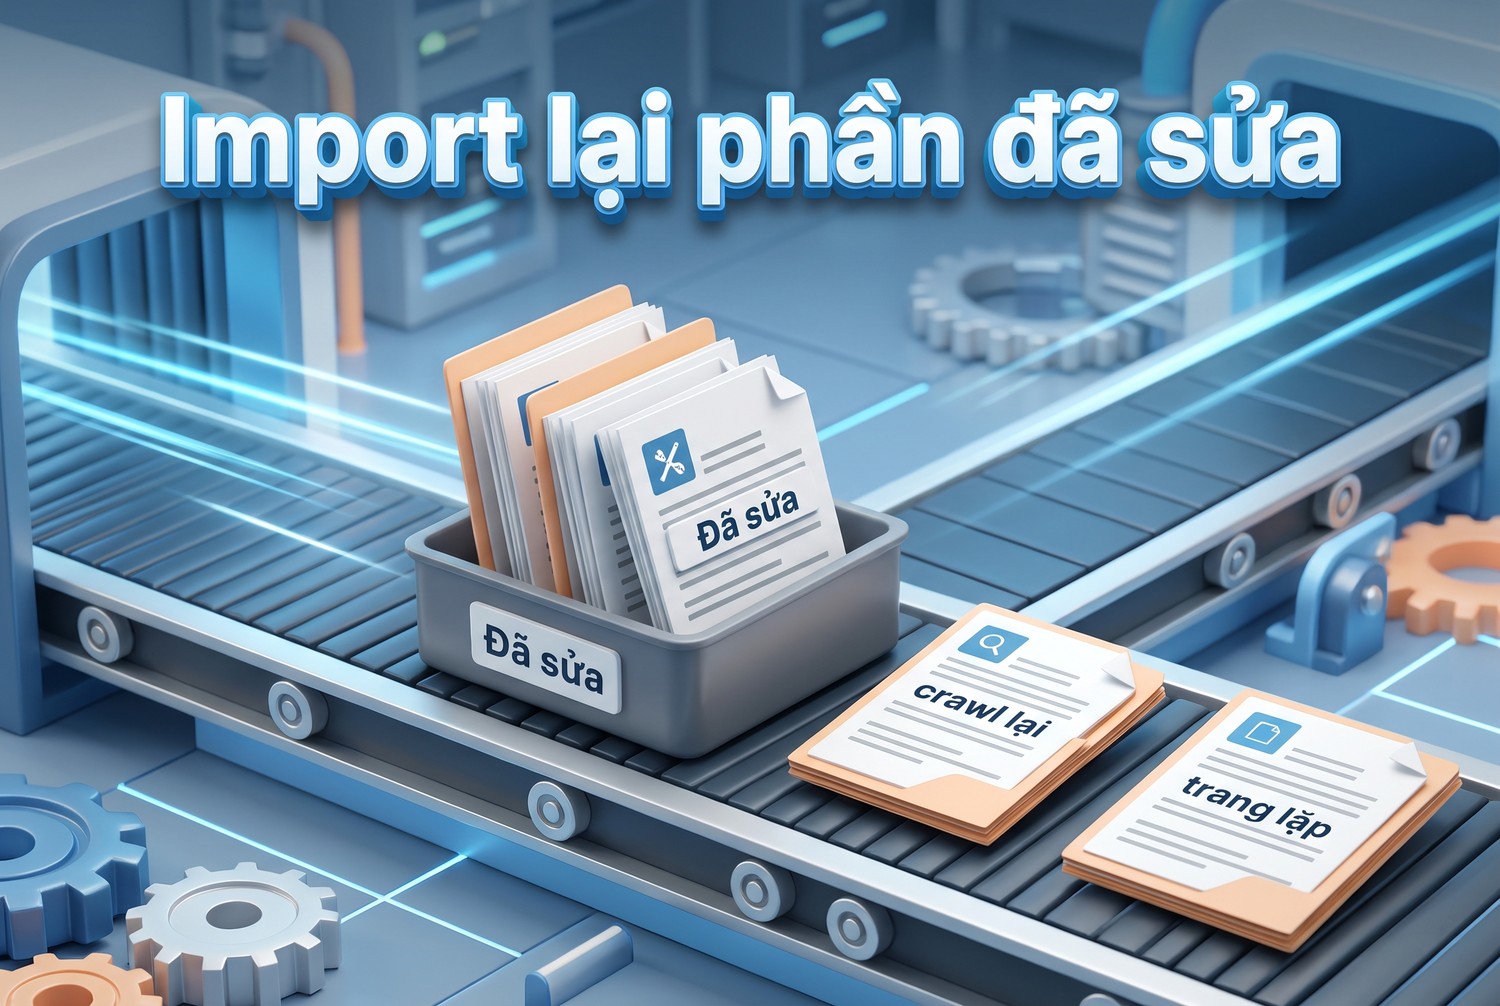
Import lại phần đã sửa
Bốn dòng đã sửa được import lại với action upsert và return_id. Cả bốn thành công.
import lai S02 {'success': True, 'id': 'c762e559e73d81ed'}
import lai S03 {'success': True, 'id': '28eff00e0eb7a270'}
import lai S04 {'success': True, 'id': '1974899ba9d7f60f'}
import lai S05 {'success': True, 'id': 'c2ca658976b73306'}
Dùng upsert ở bước này để lượt sửa chạy lại nhiều lần vẫn an toàn. Nếu lượt sửa bị gián đoạn, chạy lại không sinh lỗi trùng ID.
Hai dòng không import lại
Dòng S09 có JSON hỏng, mã lab ghi cần crawl lại trang và không tự sửa. Dòng S06 trùng ID với S01, mã ghi bỏ qua có chủ ý. Cả hai vẫn nằm trong bảng đối soát với lý do rõ ràng, để lượt sau không bị coi là thiếu.
Thử ép kiểu bằng dirty_values
Lab import hai tài liệu mới với dirty_values bằng coerce_or_reject. Giá 250000 dạng chuỗi được ép thành số 250000.0. Giá 390.000d vẫn bị từ chối vì không ép được.
coerce_or_reject: [{'success': True}, {'code': 400, ..., 'error': 'Field `price` must be a float.', 'success': False}]
x1 price luu = 250000.0
Ép kiểu phía máy chủ tiện, nhưng không thay được bước làm sạch ở parser. Giá có dấu chấm ngăn cách hàng nghìn cần quy tắc riêng.
Cẩn thận với coerce_or_drop
Chế độ coerce_or_drop sẽ nhận tài liệu và bỏ trường giá nếu không ép được. Phản hồi báo thành công. Người dùng thấy sản phẩm không có giá. Với dữ liệu crawl dùng để so sánh giá, im lặng bỏ trường còn tệ hơn từ chối cả dòng, vì lỗi bị giấu đi.
Kiểm tra bằng truy vấn
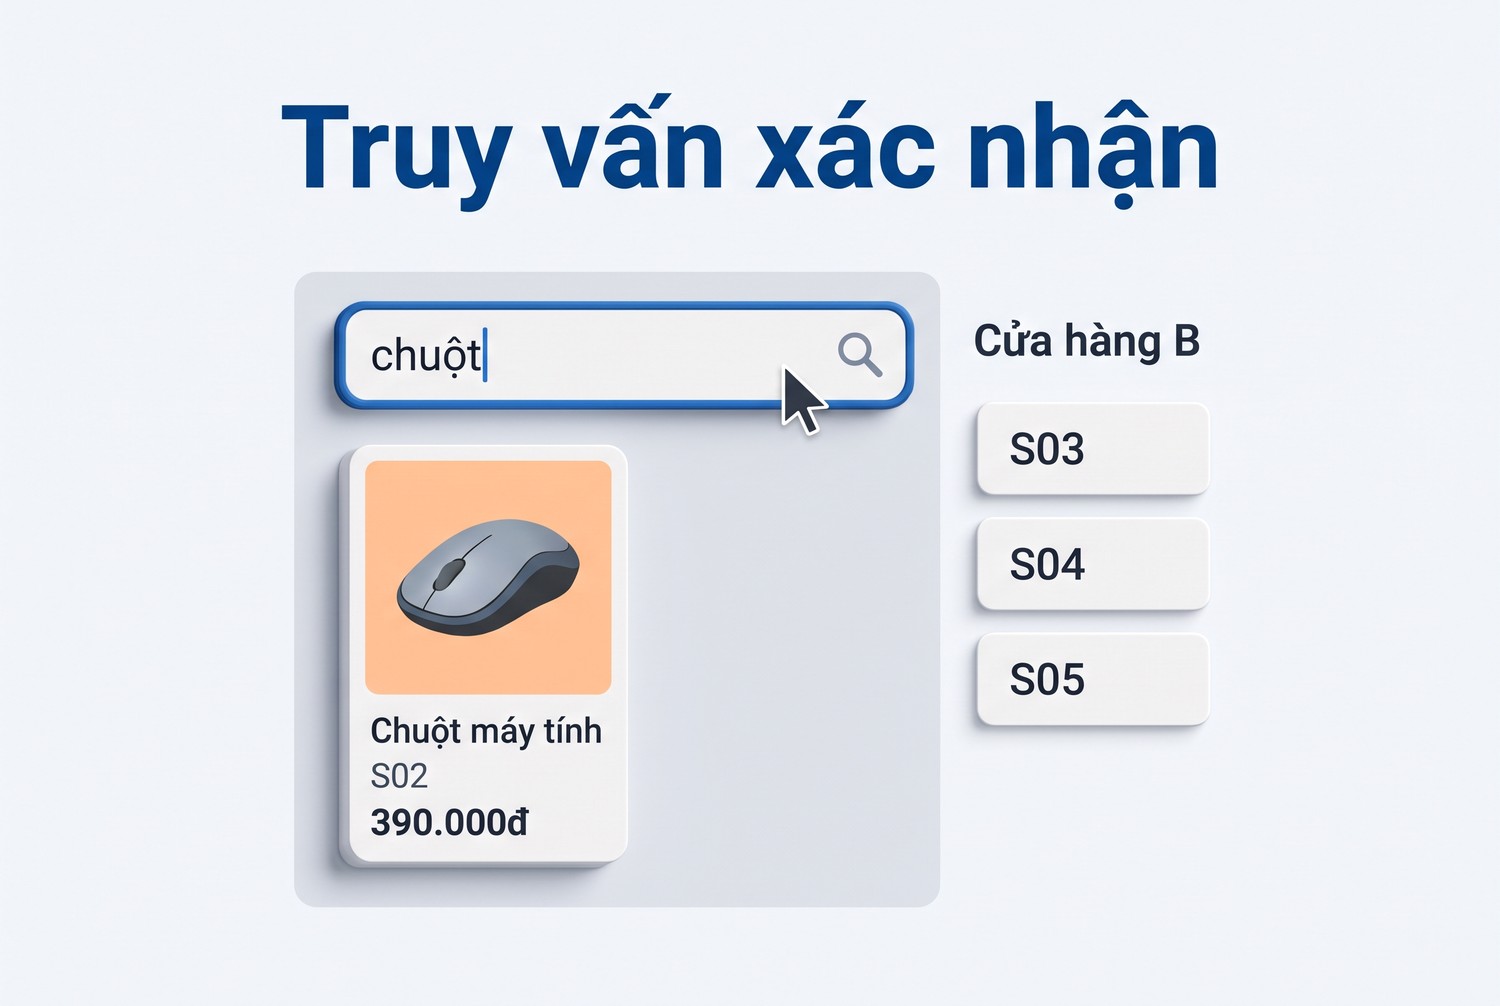
Truy vấn xác nhận
Sau lượt sửa, lọc theo cửa hàng b phải ra đúng ba sản phẩm S03, S04, S05. Tìm từ chuột phải ra S02 với giá đã làm sạch.
search shop b found: 3 ['S03', 'S04', 'S05']
search 'chuot': 1 [('S02', 390000.0)]
Hai truy vấn này kiểm cả việc tài liệu có mặt lẫn việc trường đã đúng kiểu. Máy chủ mô phỏng không xếp hạng, nên lab không kiểm thứ tự kết quả.
Kiểm tra theo ID
Lấy tài liệu theo document ID cho từng dòng thành công trong bảng đối soát xác nhận nó có thật. Với lô lớn, kiểm một mẫu ngẫu nhiên là đủ. Trường source_id trong tài liệu phải khớp với bảng, nếu không thì có thứ gì đó đã ghi đè.
Bộ truy vấn mẫu
Giữ một danh sách từ khóa với kết quả mong đợi, chạy sau mỗi lượt. Bộ này bắt được lỗi mà kiểm theo ID không thấy, như tiêu đề bị ghi đè bởi trang lặp. Truy vấn tiêu đề của S01 sau ca upsert lỗi sẽ không ra tên gốc, dấu hiệu rõ.
Typesense import JSONL crawl: vận hành pipeline hằng ngày
Phần này gom các quyết định vận hành mà lab gợi ra nhưng không thể hiện hết trong mã.
Kích thước tệp mỗi lần
Chia tệp theo số dòng hoặc dung lượng giúp khoanh vùng lỗi và giảm ảnh hưởng tới tìm kiếm. Tài liệu nhắc lô lớn tốn nhiều bộ nhớ tạm khi import. Bài không đưa con số tối ưu, vì lab không đo hiệu năng máy chủ thật.
Lô song song
Tài liệu nêu có thể chia lô phía client và gửi nhiều request, kể cả song song. Khi song song, hai lô có thể chứa cùng một ID với nội dung khác nhau, và thứ tự ghi không được đảm bảo. Khử trùng theo ID trước khi chia lô để tránh chuyện này.
Ghi tệp an toàn
Dòng JSON hỏng đến từ worker chết giữa lúc ghi. Ghi vào tệp tạm, đóng tệp, rồi đổi tên sang tên chính thức. Bước import chỉ đọc tệp đã đổi tên. Cách này loại phần lớn dòng bị cắt ngang trước khi tới Typesense.
Lưu tệp đã gửi
Giữ lại đúng tệp đã gửi cùng bảng đối soát, ít nhất cho tới lượt sau. Khi cần điều tra, anh em có cả đầu vào và kết quả. Nếu chỉ giữ tệp gốc trước khi lọc, việc tái lập ca lệch vị trí sẽ rất khó.
Ngưỡng cảnh báo
Đặt ngưỡng tỷ lệ dòng lỗi cho mỗi lượt. Vượt ngưỡng thì dừng các bước sau và báo người phụ trách. Lượt crawl bình thường có vài dòng lỗi lẻ. Một lượt có nửa số dòng lỗi thường là parser hỏng vì website đổi giao diện, không nên tự sửa hàng loạt.
Đổi schema
Thêm trường mới vào collection đang chạy cần lên kế hoạch riêng. Tài liệu crawl cũ không có trường đó, nên trường mới phải là optional, hoặc phải nạp lại toàn bộ. Lab không thử đổi schema, phần này nêu ra để anh em không quên khi parser sinh thêm trường.
Bảo mật khóa API
Khóa ghi chỉ nằm ở máy chạy pipeline. Phía tìm kiếm dùng khóa chỉ cho phép tìm, giới hạn theo collection. Khóa trong lab là chuỗi giả. Log của pipeline không được in header chứa khóa, kể cả khi đang gỡ lỗi.
Typesense import JSONL crawl: đầu ra nghiệm thu và phần chưa chạy
Phần này gom tiêu chí đạt và những gì lab chưa kiểm được.
Danh sách kiểm tra
Một lượt import đạt khi mọi dòng dưới đây đúng.
- Schema khai báo tường minh, trường bắt buộc và tùy chọn rõ ràng.
- Document ID băm từ URL chuẩn hóa, không dùng ID tự sinh.
- Source ID nằm trong tài liệu và trong bảng đối soát.
- Mã đọc từng dòng phản hồi, không dựa vào mã trạng thái 200.
- Số dòng gửi bằng số dòng nhận, ghép theo danh sách thực gửi.
- Trang lặp được khử trước khi xuất tệp, nhất là khi dùng upsert.
- Dòng lỗi được phân loại, chỉ dòng sửa được mới import lại.
- Có bước truy vấn mẫu sau lượt import.
Tệp đầu ra của lab
Lab tạo ba thứ. Tệp import.jsonl bảy dòng có lỗi cố ý. Tệp bang_ket_qua_lan1.json chứa bảng đối soát lần đầu. Output của lượt import lại và truy vấn kiểm tra, in ra cuối lab. Ba thứ này đủ để người khác tái lập bài.
Những gì lab chưa chạy
Chưa chạy Typesense thật. Chưa có xếp hạng, typo tolerance, facet thật, lô phía máy chủ, giới hạn 10GB, nhiều node, chưa đo tốc độ. Câu chữ thông báo lỗi và thứ tự kiểm tra trường là của máy chủ mô phỏng. Hàm pid và quy tắc làm sạch giá là ví dụ.
Kiểm lại trên máy thật
Trên Typesense thật, đổi cổng và khóa trong client là script lab chạy lại được. So bảng đối soát với bảng trong bài, nhất là ca dirty_values mặc định và ca dòng JSON hỏng. Chỗ nào khác, tin máy thật và sửa quy tắc phân loại theo thông báo thật.
Proxy ở đâu trong luồng này
Proxy thuộc bước tải trang, trước khi có tệp JSONL. Typesense nằm trong hạ tầng của anh em và không cần đi qua proxy. Với website được phép thu thập, đôi khi cần IP Việt Nam để thấy đúng giá trong nước. Khi đó anh em có thể mua proxy tại trang chủ ProxyVN. Vai trò của proxy trong crawl có ở bài Web Scraping proxy là gì, cách ghi cấu hình ở bài định dạng proxy.
Proxy không sửa được dữ liệu
Proxy không làm dòng sai kiểu thành đúng, cũng không giảm lỗi trùng ID. Nếu tỷ lệ trang lỗi tăng vì website chặn và trả trang khác, dấu hiệu sẽ là hàng loạt dòng thiếu title. Lúc đó sửa ở tầng tải, đừng hạ schema xuống cho dễ qua.
Typesense import JSONL crawl: câu hỏi thường gặp
Các câu dưới đây gom những điểm anh em hay hỏi khi bắt đầu.
Vì sao import trả 200 mà tài liệu không có?
Vì endpoint luôn trả 200, kết quả thật nằm trong từng dòng phản hồi. Lab có lượt sáu trên bảy dòng thất bại mà không có ngoại lệ nào. Hãy đọc từng dòng và tìm success false.
Có cách nào biết dòng lỗi thuộc trang nào?
Có, ghép theo vị trí. Dòng phản hồi thứ i ứng với dòng thứ i đã gửi. Giữ danh sách source ID song song với từng dòng thực gửi, đừng ghép với tệp gốc trước khi lọc.
Dùng URL làm id được không?
Không nên. Tài liệu nêu id không nên chứa ký tự cần mã hóa trong URL. Lab từ chối id là URL. Hãy băm URL chuẩn hóa.
Nên dùng create hay upsert?
Create cho lượt đầu để lộ trang lặp. Upsert cho lượt sau và lượt sửa, vì chạy lại an toàn. Nhớ khử trang lặp trước khi dùng upsert, nếu không bản lặp sẽ ghi đè bản tốt.
dirty_values nên đặt thế nào?
Với dữ liệu crawl dùng so sánh giá, reject hoặc coerce_or_reject. Tránh coerce_or_drop và drop vì chúng nhận tài liệu và bỏ trường im lặng.
Bài có chạy trên Typesense thật không?
Không. Client là thật, máy chủ là mô phỏng theo tài liệu. Kết quả chứng minh mã đối soát xử lý đúng các dạng phản hồi, không chứng minh hành vi chi tiết hay hiệu năng của Typesense.
Typesense import JSONL crawl và những điều cần nhớ
Typesense import JSONL crawl chỉ xong khi từng dòng phản hồi đã được đọc và nối về source ID, vì mã 200 không nói gì về dữ liệu. Hãy khai báo schema rõ, băm URL làm ID, ghép theo danh sách thực gửi và import lại riêng dòng đã sửa. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em chạy lại Typesense import JSONL crawl trên máy thật.


