
Meilisearch index dữ liệu crawl: theo dõi task, xác minh truy vấn
Meilisearch index dữ liệu crawl là việc đưa tài liệu vào một hàng đợi task rồi chờ xử lý xong, chứ không phải ghi xong ngay khi gọi API. Mã 202 chỉ nói yêu cầu đã được nhận. ProxyVN chạy client meilisearch thật trên máy chủ mô phỏng hàng đợi task, ghi sổ taskUid, thử các ca lỗi primary key và settings, rồi ghi rõ phần chưa chạy trên Meilisearch thật.
Meilisearch index dữ liệu crawl: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và giới hạn.
Bài toán cần giải
Một pipeline đẩy trang crawl vào Meilisearch, log báo thành công, nhưng người dùng tìm không ra. Lý do: request đã nhận không có nghĩa là tài liệu đã vào. Task nằm trong hàng đợi, thậm chí đã thất bại, trong khi pipeline không hề hỏi lại.
Đầu ra nghiệm thu
Đầu ra là một sổ task: mỗi thao tác có taskUid, trạng thái cuối, mã lỗi nếu có, số tài liệu nhận và số tài liệu đã index. Kèm theo là ca settings sai và bước truy vấn xác minh cuối cùng.
Ranh giới với bài OpenSearch
Bài OpenSearch bulk index nói về phản hồi đồng bộ theo từng item. Meilisearch khác hẳn: phản hồi đầu tiên không chứa kết quả, phải hỏi lại bằng taskUid. Bài này không phải hướng dẫn import JSONL và không so sánh công cụ tìm kiếm.
Giới hạn của lab
Nói rõ ngay. Lab không chạy Meilisearch thật. Máy lab không tải được máy chủ, nên ProxyVN viết một máy chủ Python có hàng đợi task xử lý tuần tự, cố ý chậm 0,25 giây mỗi task để thấy khoảng trễ. Tìm kiếm chỉ là so chuỗi, không có xếp hạng, không có typo tolerance.
Thứ gì thật, thứ gì giả
Client meilisearch-python 0.43.0 là thật, gồm wait_for_task và các lớp ngoại lệ. Mã lỗi trong lab lấy từ danh sách chính thức của Meilisearch. Quy tắc xử lý do ProxyVN viết theo tài liệu. Tên trường và thứ tự kiểm tra cụ thể của máy chủ thật có thể khác.
Đọc kết quả thế nào
Thời gian trễ trong lab do chính ProxyVN đặt, nên không nói gì về tốc độ của Meilisearch. Câu lab chứng minh là mã xử lý đúng khi tài liệu chưa kịp xuất hiện, khi task thất bại, khi chờ quá hạn. Hành vi cụ thể của máy chủ thật anh em cần chạy lại.
Ai nên đọc bài này
Người nạp dữ liệu crawl vào Meilisearch cho công cụ tìm kiếm nội bộ. Người thấy add_documents không báo lỗi mà tài liệu không xuất hiện. Người chuyển từ một hệ đồng bộ sang và chưa quen mô hình task.
Theo dõi task indexing và xác minh tài liệu trong Meilisearch index dữ liệu crawl
Phần này tóm tắt tài liệu chính thức.
Thao tác bất đồng bộ
Trang Tasks and asynchronous operations mô tả nhiều thao tác được xử lý bất đồng bộ qua hàng đợi: yêu cầu không được xử lý ngay, Meilisearch đưa vào hàng đợi và xử lý theo thứ tự nhận. Mọi thao tác có thể tốn thời gian đều đi đường này, để không ảnh hưởng hiệu năng tìm kiếm.
Phản hồi tóm tắt
Các endpoint POST và PUT khởi tạo thao tác bất đồng bộ trả về đối tượng task tóm tắt, chỉ có các trường để theo dõi. Tài liệu đưa ví dụ dưới đây.
{
  "taskUid": 0,
  "indexUid": "movies",
  "status": "enqueued",
  "type": "documentAdditionOrUpdate",
  "enqueuedAt": "2021-08-11T09:25:53.000000Z"
}
Trường status lúc này luôn là enqueued. Không có gì trong phản hồi này nói tài liệu có hợp lệ hay không.
Năm trạng thái
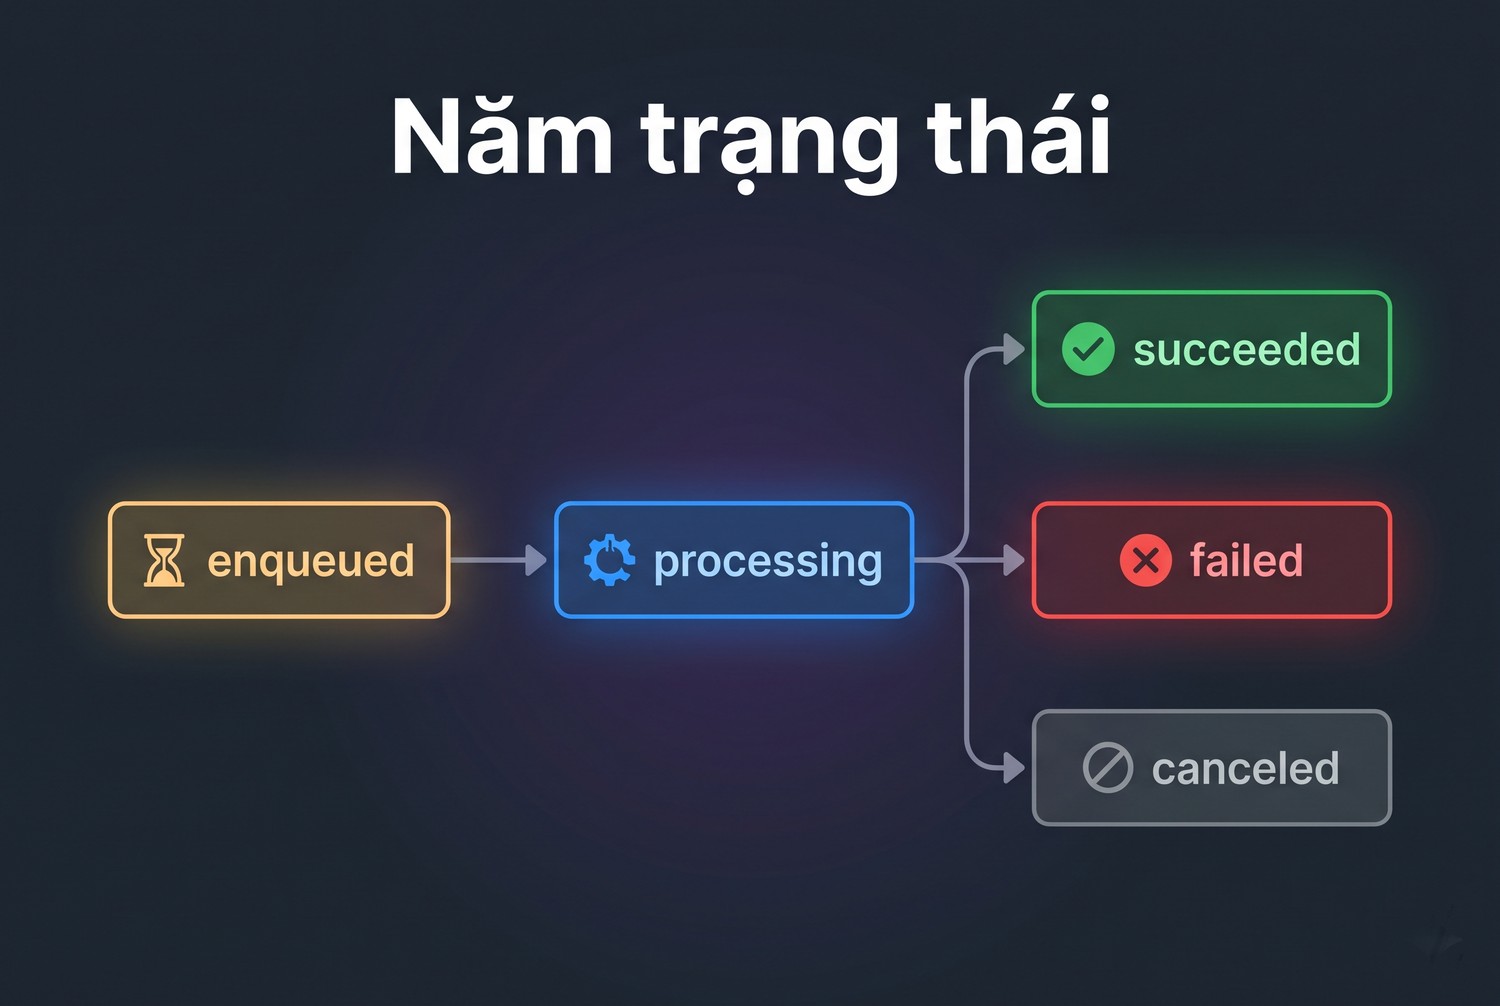
Năm trạng thái
Tài liệu nêu năm trạng thái. Hai trạng thái chưa xong, ba trạng thái đã xong.
Trạng thái |
Nhóm |
Ý nghĩa |
|---|---|---|
enqueued |
Chưa xong |
Đã nhận, chờ xử lý |
processing |
Chưa xong |
Đang xử lý |
succeeded |
Đã xong |
Xử lý thành công |
failed |
Đã xong |
Có lỗi, không có thay đổi nào trong cơ sở dữ liệu |
canceled |
Đã xong |
Task đã bị hủy |
Ý nghĩa của failed
Tài liệu ghi failed nghĩa là không có thay đổi nào được thực hiện. Với crawl, câu này rất quan trọng: một tài liệu sai trong lô có thể làm cả task hỏng. Đây là khác biệt lớn với Bulk API của OpenSearch, nơi các item độc lập.
Task đầy đủ
Đối tượng task đầy đủ có thêm uid, status, type, details, error, duration, enqueuedAt, startedAt, finishedAt. Trường error có message, code, type và link. Pipeline cần lưu ít nhất uid, status, code và số tài liệu trong details.
Thứ tự xử lý
Tài liệu nêu task trong hàng đợi được xử lý lần lượt theo thứ tự yêu cầu, có cơ chế gom batch. Tức là task lớn phía trước làm task nhỏ phía sau phải chờ. Khi nạp hàng loạt, độ trễ từ gửi tới tìm thấy tăng theo độ dài hàng đợi.
Gom batch
Tài liệu nêu Meilisearch xử lý task theo batch, gom các task để đạt hiệu năng tốt nhất, và trong đa số trường hợp người dùng không cần để ý. Với pipeline, điều này có nghĩa là không nên suy thời gian xử lý của một task từ thời gian của batch. Trường duration của task cho số đo cụ thể hơn.
Hàng đợi có giới hạn
Tài liệu nêu khi hàng đợi đạt giới hạn khoảng 10GiB, Meilisearch ném lỗi no_space_left_on_device, người dùng phải xóa task bằng endpoint delete tasks để ghi tiếp. Crawl chạy lâu mà không dọn task cũ có thể đụng giới hạn này, nên việc dọn phải nằm trong lịch vận hành.
Khởi động lại giữa chừng
Tài liệu nêu tắt instance giữa thao tác bất đồng bộ là an toàn: task đang xử lý được đặt về enqueued khi khởi động lại. Vậy nên pipeline không cần gửi lại, chỉ cần tiếp tục hỏi theo taskUid. Mô phỏng không chạy ca này, anh em nên thử trên máy thật.
Tạo index và gửi tài liệu fixture cho Meilisearch index dữ liệu crawl
Phần này là mã, chạy thật với client Python.
Tạo index có primary key
Chỉ định primary key rõ ràng ngay từ đầu. Client trả về thông tin task, không trả đối tượng index.
import meilisearch

c = meilisearch.Client("http://127.0.0.1:9473", "khoa-gia")
ti = c.create_index("crawl", {"primaryKey": "id"})
print(ti.task_uid, ti.status)   # 0 enqueued
c.wait_for_task(ti.task_uid, timeout_in_ms=5000, interval_in_ms=50)
Cổng 9473 là của máy chủ mô phỏng, Meilisearch mặc định dùng 7700. Ngay cả tạo index cũng là task, nên phải chờ.
Fixture
Lab dùng năm tài liệu đơn giản, mã p1 tới p5, có url, title và shop. Trường id là chuỗi chỉ gồm chữ và số, đúng yêu cầu định dạng.
docs = [
    {"id": f"p{i}", "url": f"http://s/p{i}", "title": f"San pham {i}",
     "shop": "a" if i % 2 else "b"}
    for i in range(1, 6)
]
ti = idx.add_documents(docs)
add_documents trả về ngay. Ở lab, in ra task_uid 1 và status enqueued, không có ngoại lệ.
Khoảng trễ giữa gửi và tìm thấy
Lab gọi search ngay sau add_documents, nhận 0 kết quả. Sau khi task xong, cùng truy vấn nhận 5. Khoảng trễ trong lab do máy chủ mô phỏng đặt, nhưng cơ chế đúng với tài liệu: chưa xong thì chưa tìm được.
A vua gui 1 enqueued
A search ngay 0
ledger ('nap 5 tai lieu', 1, 'succeeded', 'documentAdditionOrUpdate', None, {'receivedDocuments': 5, 'indexedDocuments': 5})
A search sau khi xong 5
Tìm ra 0 ngay sau khi gửi không phải là lỗi, cũng chưa phải bằng chứng gì.
Test tích hợp hay bị chập chờn vì chuyện này
Test nạp xong tìm ngay sẽ lúc xanh lúc đỏ, tùy máy nhanh chậm. Thêm sleep không chữa được, phải chờ task. Một lệnh wait_for_task thay cho mọi sleep, và lỗi thật cũng lộ ra thay vì bị che đi.
Primary key
Trang add or replace documents mô tả primaryKey là trường định danh duy nhất từng tài liệu, và đã đặt rồi thì các lần chỉ định sau sẽ bị bỏ qua. Vì vậy đặt sai ngay từ đầu rất phiền. Khóa này cũng quyết định việc gửi lại sẽ ghi đè hay thêm mới.
Định dạng ID
Trang mã lỗi nêu định danh tài liệu phải là số nguyên hoặc chuỗi chỉ gồm chữ, số, gạch ngang và gạch dưới. Nghĩa là URL không dùng làm ID trực tiếp được, vì có dấu hai chấm và gạch chéo. Đây là khác biệt lớn với thói quen dùng URL làm khóa.
Sinh ID cho trang crawl
Băm URL chuẩn hóa thành chuỗi hex là cách an toàn. URL gốc giữ ở trường url để hiển thị.
import hashlib

def page_id(url_norm):
    return hashlib.sha256(url_norm.encode()).hexdigest()[:32]
Hàm này là ví dụ triển khai. Cùng URL luôn ra cùng ID, nên chạy lại lượt crawl sẽ ghi đè tại chỗ.
Hai hàm thêm tài liệu
Meilisearch có thêm hoặc thay thế, và thêm hoặc cập nhật. Thay thế đổi cả tài liệu, cập nhật chỉ sửa trường gửi lên. Với crawl gửi đủ trường mỗi lần, thay thế là đơn giản nhất và cũng là hàm lab đã dùng. Nếu hai nguồn cùng làm giàu một tài liệu, xem lại lựa chọn này.
Chỉ gửi thứ cần tìm
Trang crawl có nhiều phần không dùng để tìm kiếm: HTML gốc, header, thông tin phiên tải. Đưa hết vào tài liệu làm việc index chậm và tốn đĩa. Parser nên tạo tài liệu chỉ gồm tiêu đề, văn bản đã làm sạch, các trường lọc và đường dẫn tới bản gốc. Đường dẫn đủ để quay lại khi cần.
Trang dài nên tách đoạn
Một trang rất dài là một tài liệu thì kết quả tìm kiếm trỏ về đầu trang, người dùng phải tự dò. Tách theo tiêu đề thành nhiều tài liệu nhỏ, mỗi đoạn có ID riêng gồm ID trang ghép số thứ tự đoạn. Trường page_id giữ quan hệ về trang. Khi trang đổi, xóa các đoạn cũ theo page_id rồi nạp lại, nếu không đoạn thừa sẽ nằm lại mãi.
Khai báo trường tìm kiếm
Thứ tự searchableAttributes ảnh hưởng độ liên quan, và mặc định mọi trường đều được tìm. Dữ liệu crawl có url, mã băm, thời gian không nên nằm trong danh sách này. Khai báo sớm giúp kết quả sạch hơn và bớt tốn công index. Lab không có xếp hạng, nên phần này là khuyến nghị theo cách Meilisearch vận hành.
Lưu task UID của thao tác indexing trong Meilisearch index dữ liệu crawl
Phần này dựng sổ task, tài sản chính của bài.
Chia lô theo dung lượng
Lab chỉ gửi vài tài liệu. Với dữ liệu thật, gom lô theo dung lượng hợp lý hơn số tài liệu, vì một trang tin dài gấp nhiều lần một trang sản phẩm. Lô vừa phải giúp lỗi dễ khoanh vùng và hàng đợi không bị một task nặng chặn lại. Bài không đưa con số, vì lab không đo tốc độ của máy thật.
Cùng một dữ liệu gửi hai lần
Mất kết nối sau khi gửi thì không biết task đã tạo chưa, vì chưa nhận được taskUid. Gửi lại là cách duy nhất. ID ổn định làm việc này an toàn: hai task cùng ghi một tài liệu, kết quả vẫn một bản. Sổ sẽ có thêm một dòng, không ảnh hưởng gì.
Vì sao cần sổ
Client có thể chờ từng task, nhưng worker có thể chết giữa lúc chờ, và lần chạy sau không còn biết taskUid. Lưu taskUid xuống chỗ bền ngay sau khi gửi là cách duy nhất để hỏi lại được. Đây là phần thường bị bỏ qua trong các ví dụ ngắn.
Lược đồ sổ
Sổ không cần phức tạp. Một bảng với vài cột là đủ.
CREATE TABLE ledger(
  task_uid INTEGER PRIMARY KEY,
  run_id TEXT,
  case_name TEXT,
  batch_file TEXT,
  status TEXT DEFAULT 'enqueued',
  error_code TEXT,
  received INTEGER,
  indexed INTEGER
);
Lược đồ này là ví dụ triển khai. Lab giữ sổ trong danh sách Python rồi xuất ra tệp JSON. Cột batch_file cho biết phải gửi lại tệp nào nếu task thất bại.
Ghi trước, chờ sau
Thứ tự đúng: gửi, ghi taskUid, rồi mới chờ. Nếu chờ xong mới ghi, tiến trình chết lúc đang chờ sẽ để lại một task không ai biết. Lô sau có thể lại gửi cùng dữ liệu, nhưng ID ổn định giúp chuyện đó vô hại.
Hàm ghi sổ của lab
Hàm dưới là mã lab: chờ task, lấy các trường cần, in ra sổ.
def led(case, ti):
    t = c.wait_for_task(ti.task_uid, timeout_in_ms=5000, interval_in_ms=50)
    code = t.error.get("code") if t.error else None
    LED.append((case, ti.task_uid, t.status, t.type, code, t.details))
    return t
Giá trị interval_in_ms là khoảng cách giữa hai lần hỏi. Đặt quá nhỏ sẽ tạo tải vô ích khi nạp dài.
Sổ task của lab
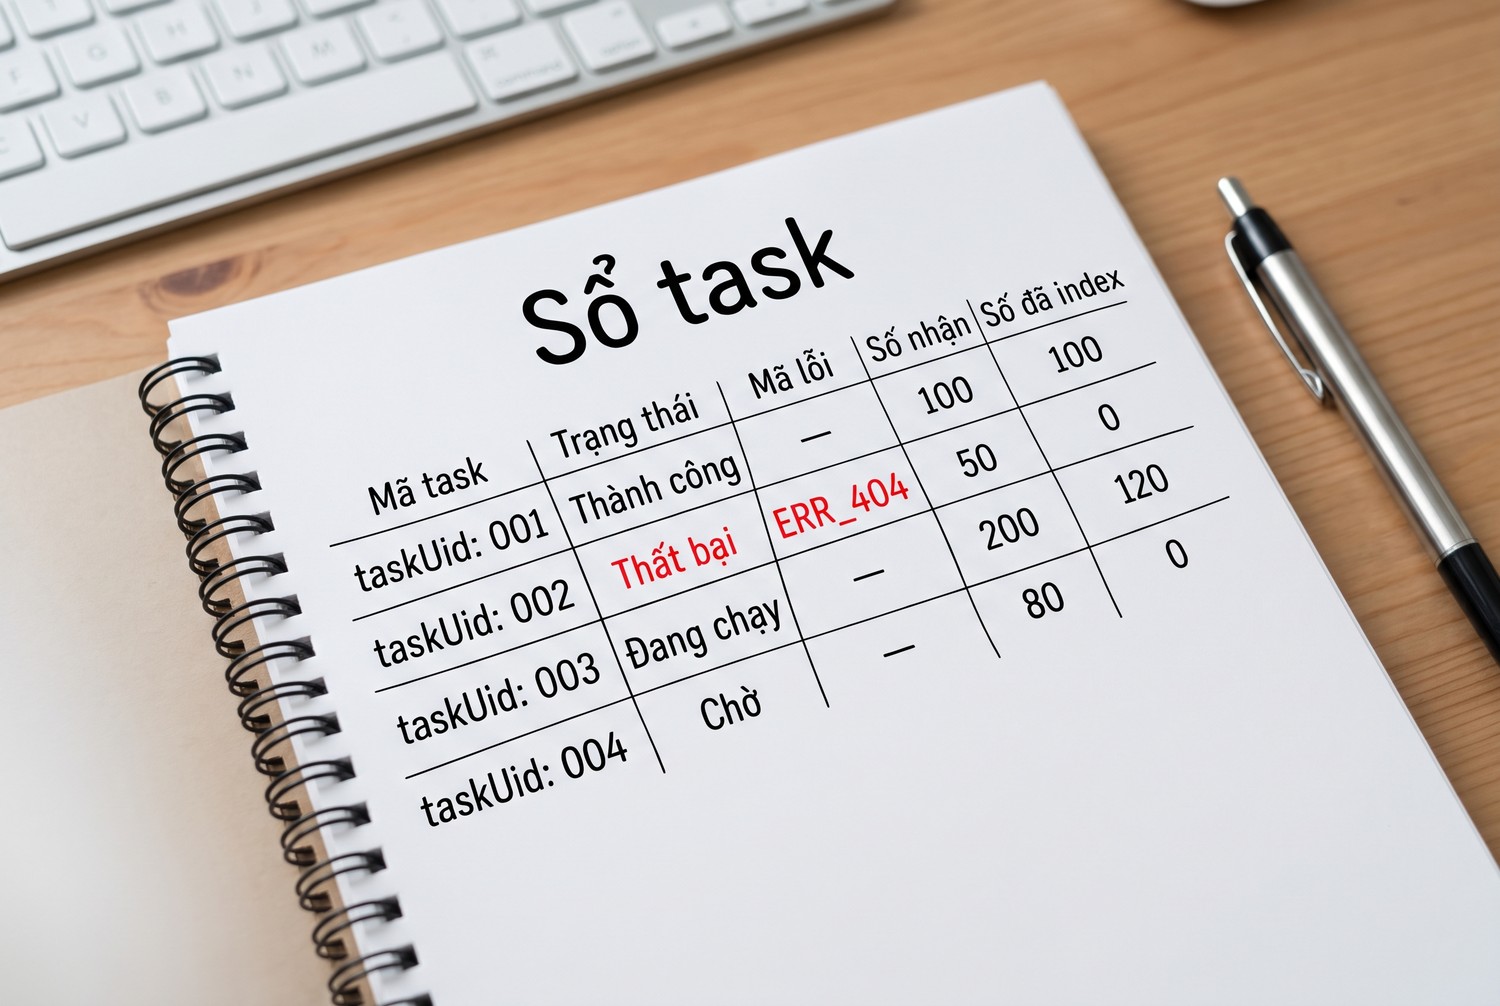
Sổ task
Bảng dưới là đầu ra nghiệm thu chính, gom từ output thật của client trên máy chủ mô phỏng.
Task |
Ca |
Trạng thái |
Mã lỗi |
Nhận |
Đã index |
|---|---|---|---|---|---|
0 |
Tạo index |
succeeded |
|||
1 |
Nạp 5 tài liệu |
succeeded |
5 |
5 |
|
2 |
ID là URL |
failed |
invalid_document_id |
1 |
0 |
3 |
Lô trộn có 1 ID sai |
failed |
invalid_document_id |
3 |
0 |
4 |
Filterable shop |
succeeded |
|||
5 |
Không có trường id |
failed |
index_primary_key_no_candidate_found |
1 |
0 |
6 |
Hai trường id |
failed |
index_primary_key_multiple_candidates_found |
1 |
0 |
So received với indexed
Hai cột cuối là phép kiểm tra đơn giản nhất. Task succeeded mà received khác indexed là dấu hiệu cần xem. Với task failed, indexed bằng 0, phù hợp với câu không có thay đổi nào trong tài liệu.
Dùng webhook hay hỏi định kỳ
Tài liệu nêu có thể cấu hình webhook để báo task đã xong. Pipeline nhỏ thì hỏi định kỳ là đủ. Pipeline lớn nên hỏi theo lô bằng endpoint liệt kê task có lọc theo trạng thái, thay vì hỏi từng uid. Lab chỉ thử hỏi từng task.
Khôi phục sau khi worker chết
Khi worker khởi động lại, nó đọc các dòng trong sổ chưa có trạng thái cuối, hỏi lại từng taskUid, cập nhật sổ. Đây là lợi ích trực tiếp của việc ghi trước, chờ sau. Task không còn tồn tại vì đã bị dọn thì đánh dấu riêng để người xem, đừng tự coi là thành công.
for uid, in db.execute("select task_uid from ledger where status in ('enqueued','processing')"):
    t = c.get_task(uid)
    db.execute("update ledger set status=? where task_uid=?", (t.status, uid))
Đoạn trên là ví dụ triển khai, hàm get_task thì lab đã gọi thật trong ca chờ quá hạn.
Cảnh báo task treo
Task ở enqueued quá lâu có nghĩa là hàng đợi đang dài hoặc instance có vấn đề. Theo dõi tuổi của task cũ nhất chưa xong trong sổ, vượt ngưỡng thì báo. Con số này nói được nhiều hơn tổng số task, vì một lô lớn hợp lệ cũng làm tổng tăng vọt mà không có gì sai.
Theo dõi trạng thái kết thúc và đọc lỗi task của Meilisearch index dữ liệu crawl
Phần này đi qua các ca lỗi.
Ca ID là URL
Lab gửi tài liệu có id là http://s/p6. Client nhận phản hồi bình thường, status enqueued, không có ngoại lệ. Chỉ khi chờ task mới thấy failed với mã invalid_document_id. Lỗi dữ liệu không xuất hiện ở lúc gọi hàm, nó nằm trong task.
Ca lô trộn
Lab gửi ba tài liệu, tài liệu giữa có ID chứa dấu cách. Task thất bại, received 3, indexed 0. Tìm từ tot không ra gì, kể cả hai tài liệu hợp lệ.
ledger ('lo tron', 3, 'failed', 'documentAdditionOrUpdate', 'invalid_document_id', {'receivedDocuments': 3, 'indexedDocuments': 0})
p7 co khong 0
Quy tắc cả lô cùng hỏng trong mô phỏng lấy từ câu failed không có thay đổi nào. Anh em nên thử ca này trên máy thật vì nó quyết định cách chia lô.
Hệ quả khi chia lô
Nếu một tài liệu sai làm hỏng cả lô, lô càng lớn thì thiệt hại càng lớn. Có hai cách. Kiểm tra ID ở phía client trước khi gửi. Khi task thất bại, chia đôi lô rồi gửi lại, thu hẹp dần tới tài liệu có lỗi.
import re

ID_OK = re.compile(r"^[A-Za-z0-9_-]{1,511}$")

def valid(batch, pk="id"):
    return [d for d in batch if ID_OK.match(str(d.get(pk, "")))]
Mẫu trên lấy theo quy tắc trong danh sách mã lỗi. Giới hạn 511 byte ProxyVN lấy từ thông báo quen thuộc của Meilisearch, cần đối chiếu lại với phiên bản đang dùng.
Ca không có primary key
Lab gửi tài liệu vào index chưa có primary key, tài liệu có url và title. Task thất bại với index_primary_key_no_candidate_found. Tài liệu mã lỗi nêu việc suy luận thất bại khi không có trường nào kết thúc bằng id, và khuyên chỉ định thủ công.
Ca có hai ứng viên
Tài liệu có item_id và shop_id. Task thất bại với index_primary_key_multiple_candidates_found. Với dữ liệu crawl, rất nhiều trường kết thúc bằng id: product_id, category_id, seller_id. Đừng dựa vào suy luận, luôn chỉ định primary key.
Mã lỗi |
Khi nào |
Xử lý |
|---|---|---|
invalid_document_id |
ID có ký tự không hợp lệ |
Băm URL, kiểm tra trước khi gửi |
index_primary_key_no_candidate_found |
Không có trường kết thúc bằng id |
Chỉ định primaryKey |
index_primary_key_multiple_candidates_found |
Nhiều trường kết thúc bằng id |
Chỉ định primaryKey |
invalid_search_filter |
Lọc trên trường chưa khai báo |
Thêm filterableAttributes, chờ task |
invalid_settings_filterable_attributes |
Sai kiểu giá trị settings |
Sửa mã gửi |
Ca settings sai kiểu
Lab gọi update_filterable_attributes với chuỗi shop thay vì danh sách. Client ném MeilisearchApiError với mã invalid_settings_filterable_attributes ngay lúc gọi. Trong mô phỏng, kiểm tra kiểu chạy đồng bộ. Lỗi loại này rõ ràng hơn lỗi trong task, và mã tự có ngoại lệ.
Ca lọc trên trường chưa khai báo
Lab tìm với filter shop = a khi chưa khai báo, nhận invalid_search_filter. Đây là lỗi của truy vấn, không phải task. Nó xuất hiện ở phía người dùng tìm kiếm, nên phải khai báo settings trước khi mở tính năng.
Settings cũng là task
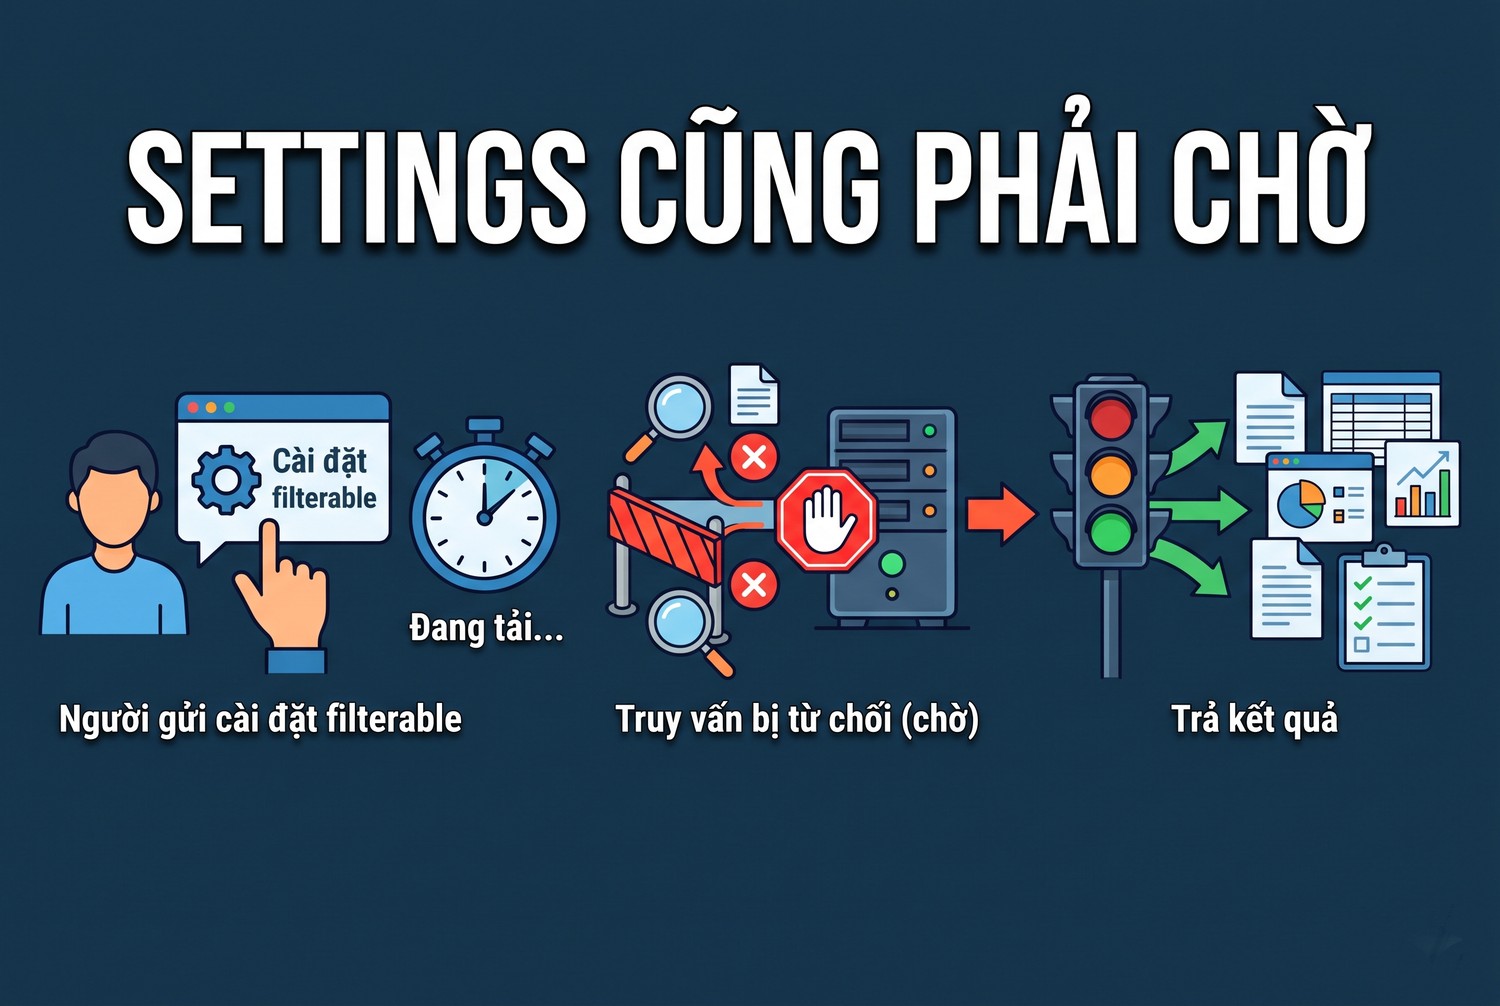
Settings cũng phải chờ
Lab gửi settings hợp lệ rồi tìm ngay, vẫn nhận invalid_search_filter. Chờ task xong mới nhận 3 kết quả. Đây là bẫy dễ dính khi triển khai: script đặt settings rồi kiểm tra ngay và báo lỗi, dù mọi thứ đang đúng.
ti = idx.update_filterable_attributes(["shop"])
c.wait_for_task(ti.task_uid, timeout_in_ms=5000, interval_in_ms=100)
print(idx.search("", {"filter": "shop = a"})["estimatedTotalHits"])   # 3
Với dữ liệu lớn, đổi settings kéo theo index lại, có thể mất nhiều thời gian. Anh em đặt settings trước khi nạp dữ liệu sẽ tốt hơn.
Chờ quá hạn không có nghĩa là thất bại
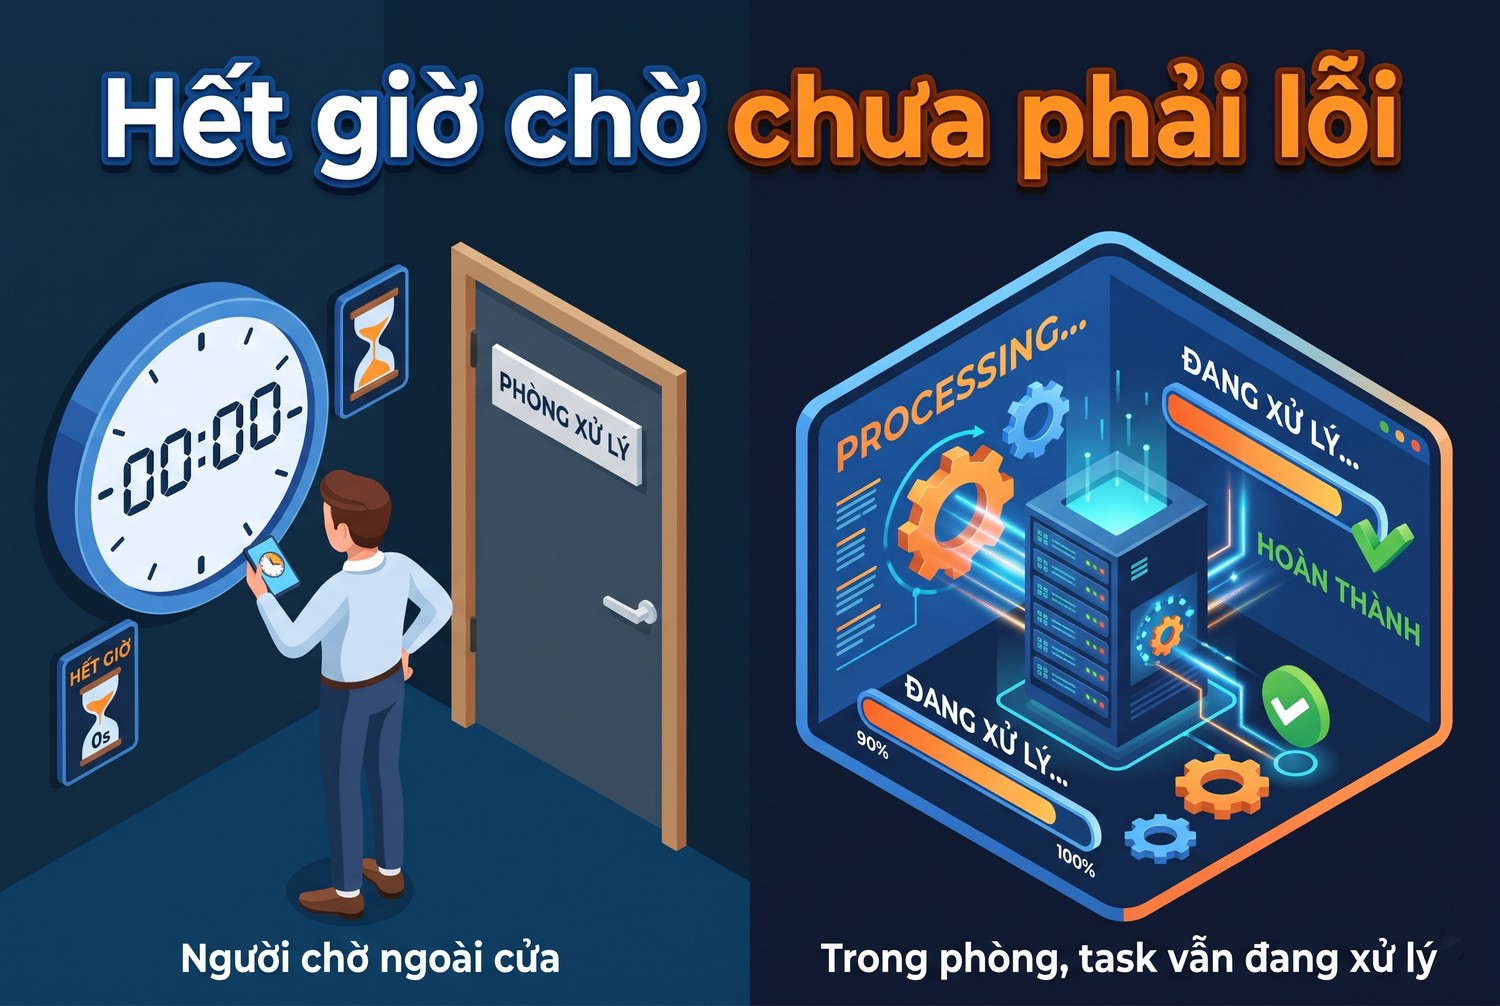
Hết giờ chờ chưa phải lỗi
Lab cho task mất 1,5 giây và chờ tối đa 300 mili giây. Client ném MeilisearchTimeoutError, nhưng hỏi lại thì task vẫn processing, rồi thành succeeded. Timeout của client chỉ là hết kiên nhẫn. Đừng gửi lại lô chỉ vì wait_for_task hết giờ.
Thứ tự các task
Lab gửi ba task liên tiếp cùng ID pz với ba nội dung khác nhau. Sau khi cả ba xong, tài liệu mang nội dung của task cuối. Hàng đợi xử lý theo thứ tự nhận, nên lần ghi sau thắng. Với nhiều worker, thứ tự nhận không phải thứ tự crawl, nên cần trường thời gian nếu muốn chắc bản mới nhất.
Nhiều worker cùng gửi
Nhiều worker gửi lô cùng lúc không làm việc index nhanh hơn, vì hàng đợi xử lý tuần tự. Gửi dồn chỉ làm hàng đợi dài ra. Mô hình gọn hơn là worker ghi tài liệu ra tệp, một tiến trình nạp duy nhất gom lô và gửi. Sổ task khi đó chỉ có một người ghi, tránh được rất nhiều rắc rối.
Lỗi hệ thống và lỗi dữ liệu
Task thất bại vì dữ liệu thì gửi lại y nguyên vô ích. Task thất bại vì hết đĩa hay lỗi nội bộ thì có thể gửi lại sau khi sửa. Trường type trong error giúp phân loại, ví dụ invalid_request là lỗi của người gửi. Pipeline nên có bảng quy tắc theo code.
Chỉ xác nhận thành công sau truy vấn tài liệu đã index với Meilisearch index dữ liệu crawl
Phần này là bước cuối, thứ phân biệt nạp xong với tìm được.
Vì sao succeeded chưa đủ
Task succeeded nói tài liệu đã vào. Nó không nói người dùng tìm thấy theo cách họ cần. Trường bị loại khỏi searchableAttributes sẽ không tìm được. Tiêu đề rỗng do parser hỏng vẫn succeeded. Cần một bước kiểm tra từ phía sử dụng.
Kiểm tra theo ID
Lấy tài liệu theo ID xác nhận nó tồn tại. Lab duyệt năm ID trong fixture, không thiếu cái nào.
from meilisearch.errors import MeilisearchApiError

miss = []
for i in want:
    try:
        idx.get_document(i)
    except MeilisearchApiError:
        miss.append(i)
print(len(want), "thieu", miss)   # 5 thieu []
Với lô lớn, kiểm tra mẫu ngẫu nhiên là đủ, không cần lấy từng ID.
Kiểm tra theo truy vấn
Giữ một bộ truy vấn mẫu với kết quả mong đợi. Sau mỗi lượt, chạy lại và so. Ví dụ từ khóa của một sản phẩm cố định phải ra ID đó trong top đầu. Bước này bắt được lỗi settings mà kiểm tra theo ID không thấy. Máy chủ mô phỏng không xếp hạng, nên phần top đầu lab không kiểm tra được.
Đối soát cả lượt
Một lượt đạt khi đủ ba điều kiện: mọi task trong sổ có trạng thái cuối, không có failed chưa xử lý, và số tài liệu theo ID khớp số đã gửi trừ số đã loại có chủ ý. Lấy số tài liệu của index từ stats cũng được, nhưng nhớ tổng đếm không chỉ ra tài liệu nào thiếu.
Thời điểm mở cho người dùng
Khi cần thay toàn bộ dữ liệu, nạp vào index mới rồi đổi sang bằng swap index, người dùng không thấy trạng thái dang dở. Chỉ đổi khi đối soát đạt. Lab không thử swap. Ý chính là bước xác minh phải đứng trước bước mở.
Dọn task cũ
Mỗi lượt crawl tạo nhiều task. Sau khi đã ghi kết quả vào sổ riêng, dọn task đã xong bằng endpoint delete tasks để tránh chạm giới hạn hàng đợi. Sổ của anh em giữ lịch sử lâu dài, hàng đợi của Meilisearch không phải chỗ làm việc đó.
Đầu ra nghiệm thu của Meilisearch index dữ liệu crawl
Phần này gom tiêu chí và phần chưa thử.
Danh sách kiểm tra
Pipeline đạt khi mọi dòng dưới đây đúng.
- primaryKey chỉ định rõ, không dựa vào suy luận.
- ID được băm từ URL chuẩn hóa, kiểm tra định dạng trước khi gửi.
- Settings đặt trước khi nạp, và đã chờ task xong.
- taskUid ghi xuống sổ ngay sau khi gửi.
- Không gửi lại lô chỉ vì client hết giờ chờ.
- Task failed có người xử lý, chia lô để tìm tài liệu lỗi.
- Có bước xác minh bằng ID và truy vấn mẫu.
- Có lịch dọn task cũ.
Những gì lab chưa chạy
Chưa chạy Meilisearch thật. Chưa có xếp hạng, typo tolerance, batch thật, webhook, swap index, delete tasks, khởi động lại giữa task, chưa đo tốc độ. Thời gian xử lý, thứ tự kiểm tra, cách cả lô hỏng là quy tắc mô phỏng. Hàm page_id, lược đồ sổ là ví dụ.
Kiểm lại trên máy thật
Trên Meilisearch thật, chỉ cần đổi địa chỉ và khóa trong client, script lab chạy lại được. So sổ task với bảng trong bài, đặc biệt ca lô trộn và ca settings sai kiểu. Chỗ nào khác, tin máy thật.
Bảo vệ khóa API
Lab dùng một chuỗi giả. Meilisearch thật có master key và các khóa theo quyền. Pipeline nạp dữ liệu dùng khóa có quyền ghi, phía tìm kiếm dùng khóa chỉ đọc. Đừng đưa khóa ghi vào mã chạy phía trình duyệt, kể cả cho công cụ nội bộ.
Proxy ở đâu trong luồng này
Proxy thuộc bước tải trang, xảy ra trước khi có tài liệu. Meilisearch nằm trong mạng của anh em, không cần đi qua proxy. Với website được phép thu thập, có lúc cần IP tại Việt Nam để nhận đúng nội dung trong nước. Khi đó anh em có thể mua proxy tại trang chủ ProxyVN. Proxy không làm task chạy nhanh hơn. Vai trò của nó có ở bài Web Scraping proxy là gì, cách ghi chuỗi cấu hình ở bài định dạng proxy.
Meilisearch index dữ liệu crawl: câu hỏi thường gặp
Các câu dưới đây gom những điểm anh em hay hỏi.
Vì sao add_documents không lỗi mà không tìm thấy?
Vì thao tác là bất đồng bộ. Phản hồi chỉ nói đã nhận. Phải chờ task và đọc trạng thái. Lab có task failed dù lúc gửi không có ngoại lệ nào.
Dùng URL làm ID được không?
Không dùng trực tiếp được. ID chỉ gồm chữ, số, gạch ngang, gạch dưới. Hãy băm URL chuẩn hóa.
Một tài liệu sai có làm hỏng cả lô không?
Theo tài liệu, task failed thì không có thay đổi nào. Lab mô phỏng đúng như vậy với lô ba tài liệu. Anh em nên thử lại trên máy thật.
wait_for_task hết giờ thì có nên gửi lại không?
Không. Lab thấy task vẫn chạy và xong sau đó. Hãy hỏi lại bằng taskUid, ID ổn định chỉ là lưới an toàn.
Có cần chờ task sau khi đặt settings không?
Có. Lab tìm ngay sau khi gửi settings vẫn nhận lỗi filter. Chờ xong mới dùng được.
Bài có chạy trên Meilisearch thật không?
Không. Client là thật, máy chủ là mô phỏng theo tài liệu. Kết quả chứng minh mã xử lý đúng các tín hiệu, không chứng minh hiệu năng.
Meilisearch index dữ liệu crawl và những điều cần nhớ
Meilisearch index dữ liệu crawl chỉ xong khi task báo succeeded và truy vấn tìm thấy tài liệu, mã 202 chưa nói lên gì. Hãy ghi taskUid, chỉ định primaryKey, băm URL làm ID, đặt settings trước khi nạp. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em kiểm lại Meilisearch index dữ liệu crawl trên máy thật.


