
SiteOne Crawler audit website: khóa phạm vi và báo cáo URL
SiteOne Crawler audit website là cách dùng công cụ dòng lệnh mã nguồn mở SiteOne Crawler để duyệt một website được phép. Kết quả là báo cáo kỹ thuật gồm mã trạng thái, loại nội dung, chuyển hướng, trang 404 và URL bị bỏ qua. Công cụ có rất nhiều tham số, và vài mặc định có thể làm báo cáo sai lệch nếu không để ý, như cache 24 giờ hay giới hạn số trang. ProxyVN đọc README và tài liệu JSON của SiteOne ngày 03/11/2026, dựng một website mẫu 20 URL có lỗi cài sẵn, và lập bảng đối chứng để biết một báo cáo đúng phải trông như thế nào.
SiteOne Crawler audit website: mục tiêu và phạm vi không lặp
Phần đầu chốt mục tiêu, đầu ra và giới hạn của phép thử.
Bài toán
Trước khi chuyển hosting, đổi giao diện hay ra mắt website mới, đội kỹ thuật cần một danh sách đầy đủ. URL nào trả 200, URL nào 404, URL nào chuyển hướng, tệp nào có Content-Type sai, link nào trỏ ra ngoài. Danh sách đó là cơ sở để so trước và sau thay đổi.
SiteOne Crawler làm đúng việc này trong một lệnh, cho ra báo cáo HTML đọc được và JSON xử lý được bằng máy. Câu hỏi của bài là làm sao để báo cáo phản ánh đúng website, không thiếu và không thừa.
Đầu ra nghiệm thu
Đầu ra gồm lệnh chạy có khóa phạm vi rõ ràng và một báo cáo URL, status, loại nội dung. Kèm theo là một mẫu đối chứng: website nhỏ biết trước đáp án, để kiểm báo cáo có bắt đúng mọi lỗi cài sẵn không.
Audit khác thu thập nội dung
Báo cáo audit trả lời câu hỏi website có khỏe không: lỗi, tốc độ, header, chuyển hướng. Nó không lấy giá, mô tả hay bài viết để dùng lại. Trích dữ liệu theo trường là việc của công cụ khác, như Custom Extraction của SEO Spider. Phần cấu hình proxy cho công cụ đó có trong bài proxy Screaming Frog.
SiteOne có tính năng xuất bản offline và xuất Markdown. Bài này không bàn hai tính năng đó, chỉ dùng phần audit.
Giới hạn của phép thử
Lab tải bản Windows của SiteOne Crawler 2.5.1 từ trang phát hành GitHub, nhưng chính sách an toàn của môi trường lab chặn chạy tệp thực thi tải từ bên ngoài. Mình không tìm cách lách. Vì vậy bài không có kết quả chạy SiteOne thật.
Những gì có thật là: README và tài liệu JSON Output chính thức, website mẫu chạy cục bộ, và một trình duyệt đối chứng viết bằng Python ghi lại đáp án đúng cho website mẫu. Mọi câu về hành vi của SiteOne trong bài đều dẫn từ tài liệu.
Ai nên đọc
Người phụ trách kỹ thuật website cần một báo cáo nhanh trước khi thay đổi lớn. Người làm SEO kỹ thuật muốn công cụ dòng lệnh chạy được trong CI. Người đã chạy SiteOne và thấy số URL trong báo cáo ít hơn dự kiến.
Chạy SiteOne Crawler audit website với website được phép để phân loại URL và xuất báo cáo kỹ thuật
Phần này giới thiệu công cụ và các tính năng audit chính theo tài liệu.
Công cụ là gì
SiteOne Crawler là công cụ mã nguồn mở, có bản dựng sẵn cho Linux, macOS và Windows. README hiện hướng dẫn dựng từ mã nguồn bằng cargo, nên bản hiện hành viết bằng Rust. Công cụ có chế độ hỏi đáp tương tác cho người mới, và chế độ tham số đầy đủ cho người dùng quen.
Ngoài audit, công cụ còn làm kiểm thử tải, xuất bản offline, xuất Markdown, tạo sitemap và tùy chọn dùng trình duyệt để render. Phạm vi rộng nên càng phải giới hạn rõ khi chỉ cần audit.
Ba định dạng báo cáo
README liệt kê ba định dạng. Báo cáo HTML là một tệp tự chứa, có bảng sắp xếp được và điểm chất lượng. JSON chứa mọi URL đã thăm, chi tiết phản hồi và kết quả phân tích. Text là bảng màu trên terminal kèm tóm tắt.
Với audit cần đối chứng, JSON là định dạng quan trọng nhất. HTML để người đọc xem nhanh, JSON để máy so sánh giữa hai lần chạy.
Các bảng phân tích
results và tables
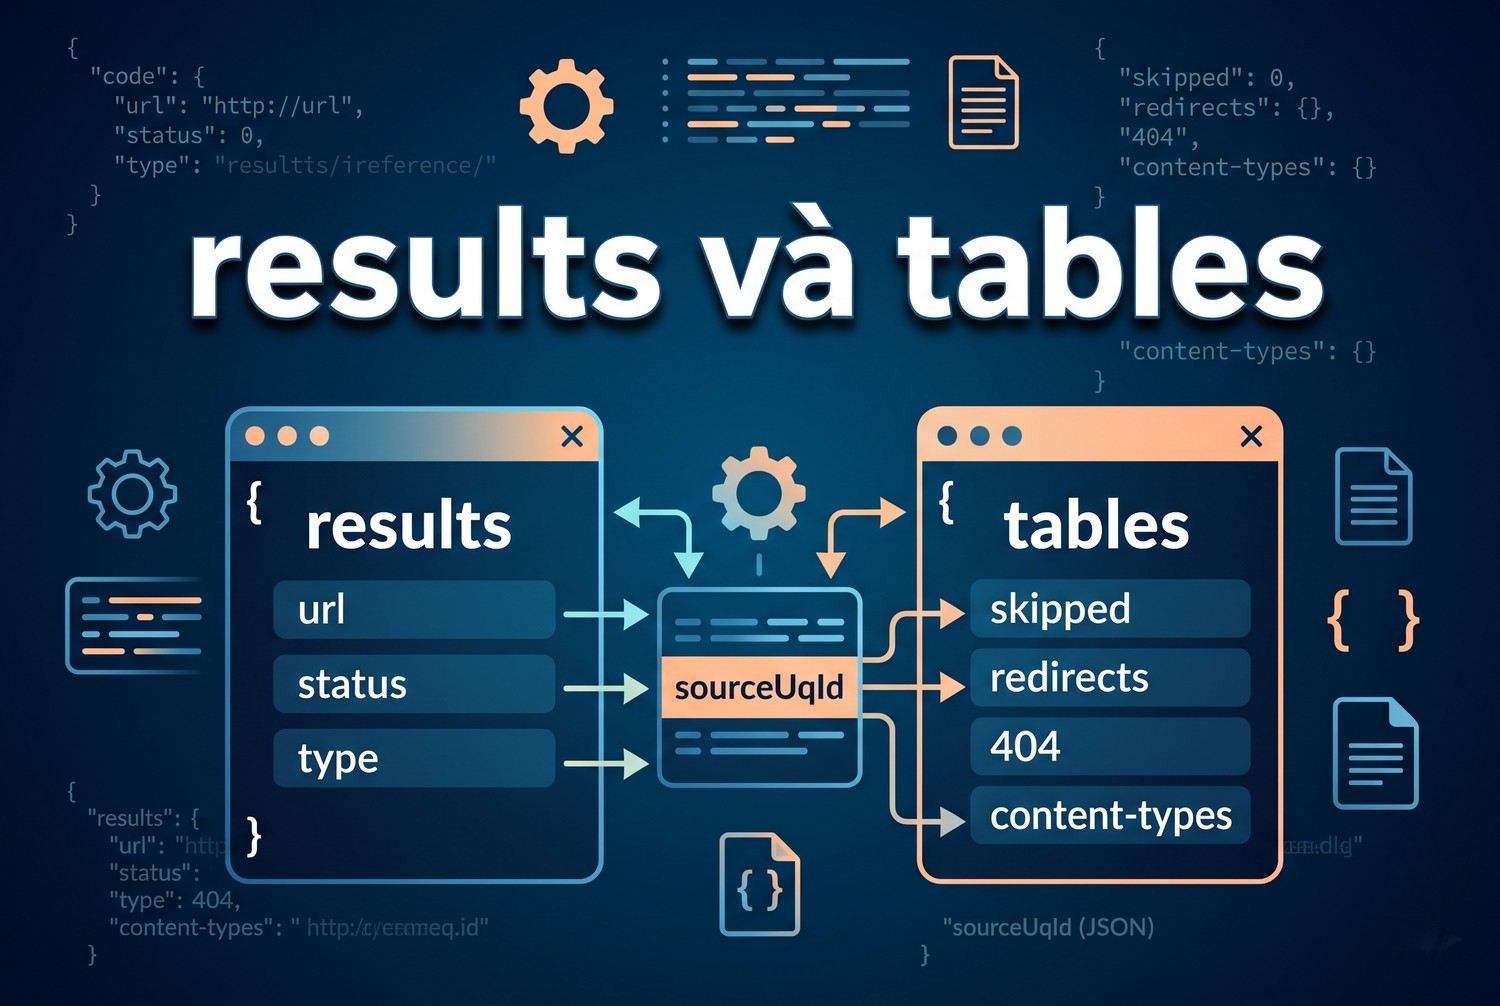
Theo tài liệu JSON, khóa tables chứa nhiều bảng. skipped-summary và skipped dành cho URL bị bỏ qua, redirects cho chuyển hướng, 404 cho trang không tìm thấy. content-types thống kê theo nhóm nội dung, content-types-raw theo MIME type, kèm các bảng SEO, header, cache, bảo mật.
Bảng skipped có cột reason, url, sourceAttr và sourceUqId. Cột cuối là đường dẫn trang nơi URL bị bỏ qua được tìm thấy. Đây là thông tin cần để sửa link, không chỉ để biết có lỗi.
Mảng results
Mỗi phần tử trong results là một URL đã thăm, có url, status dạng chuỗi, elapsedTime, size và type. type là số nguyên: 1 là HTML, 2 là JavaScript, 3 là CSS, 4 là ảnh, 7 là tài liệu như robots.txt, 8 là JSON. Tài liệu ghi còn các loại khác như Audio, Font, Video, XML, Redirect, Other.
Trường stats có countByStatus: mỗi mã trạng thái gặp được kèm số lượng. Đây là con số đầu tiên cần so với mẫu đối chứng.
Đọc bảng content-types
Bảng content-types gom URL theo nhóm và có cột theo từng loại mã trạng thái. Tài liệu ghi các cột trạng thái là động: cột như status42x chỉ xuất hiện khi gặp mã tương ứng. Script đọc bảng này phải đọc tên cột từ dữ liệu, không viết cứng danh sách cột.
Bảng content-types-raw cùng cấu trúc nhưng nhóm theo chuỗi MIME đầy đủ, kể cả phần charset. Từ bảng này dễ phát hiện trang HTML thiếu khai báo charset hay tệp JSON trả về với MIME text/plain.
Phân tích header bảo mật và cache
Ngoài status, báo cáo còn có bảng header, cache theo nhóm nội dung và các phát hiện bảo mật. Với audit trước khi chuyển hosting, hai bảng đáng so nhất là cache và header bảo mật, vì cấu hình máy chủ mới hay quên chép những thứ này. CSS và JS mất max-age, hay trang mất Strict-Transport-Security, là lỗi hay gặp sau khi chuyển.
Điểm chất lượng và CI
SiteOne tính điểm chất lượng theo nhóm hiệu năng, SEO, bảo mật, khả năng truy cập, thực hành tốt. Có chế độ CI với ngưỡng, ví dụ điểm tối thiểu 7,0 và số lỗi 5xx tối đa 0. Lệnh trả mã thoát khác 0 khi không đạt, để pipeline triển khai dừng lại.
Khóa start URL, phạm vi host và giới hạn số trang cho SiteOne Crawler audit website
Phạm vi là phần quyết định báo cáo có đúng không.
Lệnh audit khóa phạm vi
siteone-crawler --url=https://staging.example.vn/ \
  --max-visited-urls=5000 --max-depth=0 \
  --workers=2 --max-reqs-per-sec=5 --timeout=10 \
  --no-cache \
  --output=json --output-json-file=tmp/audit.json \
  --output-html-report=tmp/audit.html
Lệnh trên dùng tham số theo README. Start URL là website được phép audit. max-visited-urls đặt trần, max-depth bằng 0 là không giới hạn độ sâu. workers và max-reqs-per-sec giữ tải nhẹ. no-cache tắt cache HTTP. Hai tham số cuối đặt chỗ lưu báo cáo.
Mặc định phạm vi là host khởi đầu
Theo README, crawler chỉ duyệt trang trong tên miền khởi đầu. Muốn thêm tên miền khác, như bản ngôn ngữ trên tên miền riêng, dùng allowed-domain-for-crawling. Muốn tải tệp từ CDN, dùng allowed-domain-for-external-files. Mặc định này an toàn: không lỡ tay audit website của người khác qua link ngoài.
Trần số trang mặc định
Trần 8 URL giấu lỗi
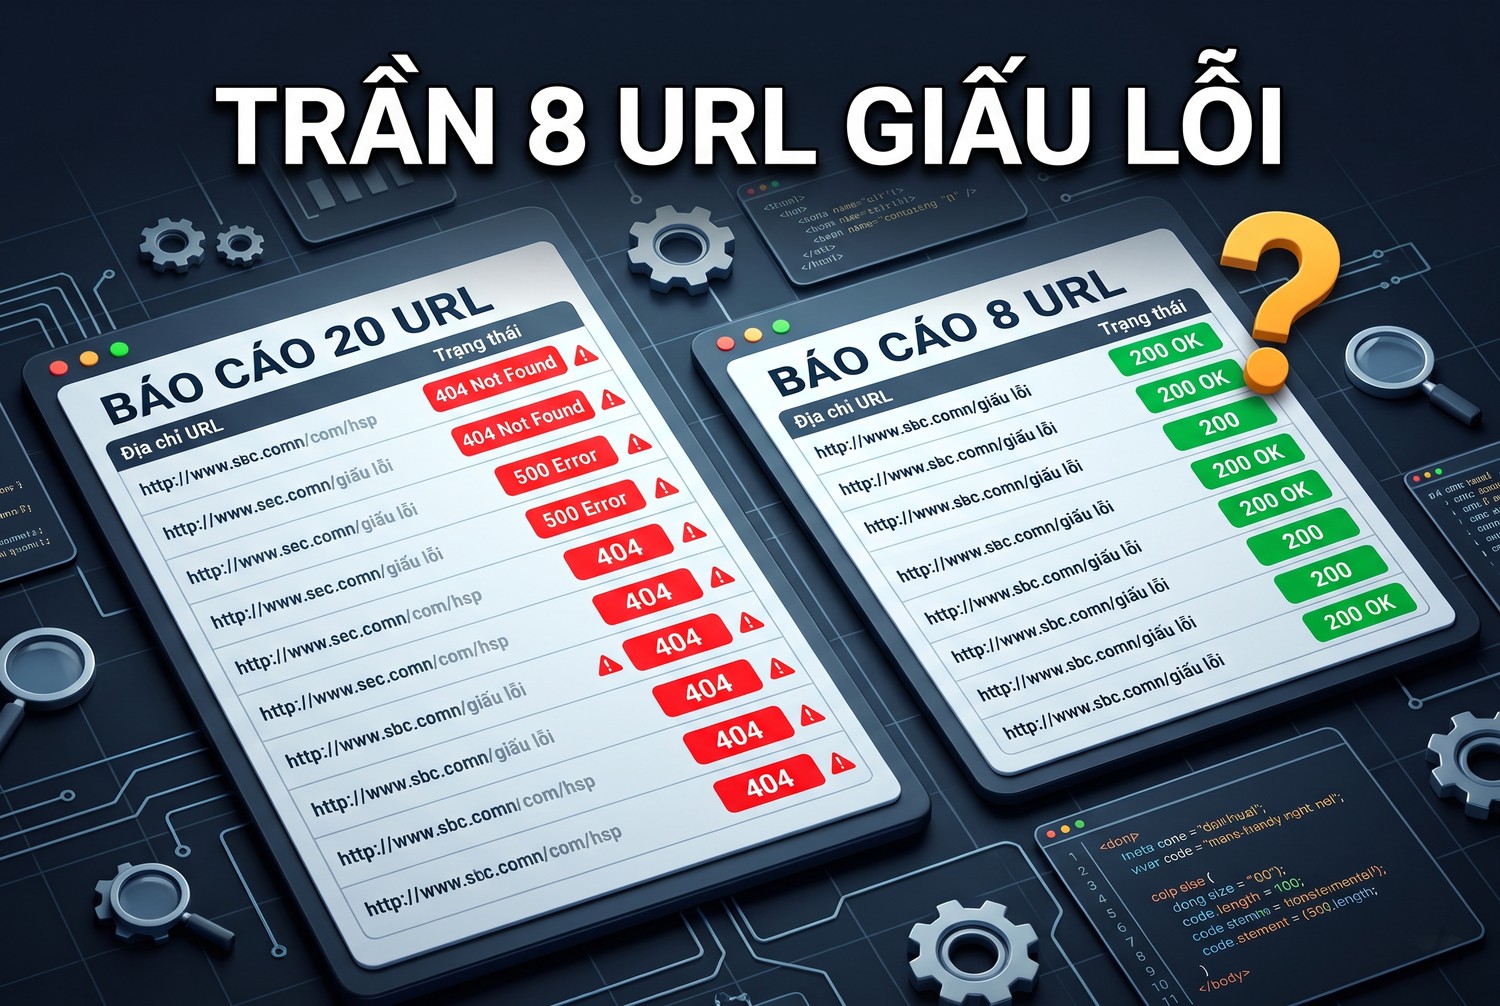
max-visited-urls mặc định là 10.000. max-queue-length mặc định 9.000. Website lớn hơn sẽ bị cắt mà báo cáo vẫn trông đầy đủ. Lab đối chứng cho thấy tác động của trần: với trần 20 URL, đáp án có 20 dòng và đủ các lỗi cài sẵn. Với trần 8 URL, cả 8 dòng đều 200, không còn dòng 404 hay 500 nào.
Báo cáo với trần thấp không sai, nhưng nó nói website sạch lỗi trong khi thực tế không phải. Luôn ghi trần đã dùng vào bàn giao, và so stats.totalUrls với trần để biết lần chạy có bị cắt không.
Bẫy URL động trả lỗi
max-non200-responses-per-basename mặc định là 5, là cơ chế chống vòng lặp với URL động trả lỗi. Website mẫu có trang tìm kiếm /tim?q=N luôn trả 404 và trỏ sang q=N+1. Đáp án đối chứng dừng sau 5 lần 404 trên cùng đường dẫn /tim và ghi URL thứ sáu vào danh sách bỏ qua.
Trình đối chứng áp dụng quy tắc này theo cách mình hiểu từ mô tả một dòng trong README. Cách SiteOne tính basename có thể khác. Khi chạy thật, xem bảng skipped để biết URL nào bị cắt bởi quy tắc này.
Chạy từ tệp danh sách URL
README mô tả tham số url-list nhận tệp văn bản, mỗi dòng một URL. Kết hợp với single-page, crawler chỉ tải đúng các URL trong danh sách mà không đi theo link. Tài liệu ghi rõ URL trong danh sách được tải trực tiếp: robots.txt và các regex không áp cho chúng, và chúng có thể thuộc tên miền khác.
Chế độ này hợp để kiểm lại một danh sách URL quan trọng sau khi chuyển hosting, ví dụ 500 URL có traffic cao nhất. Vì robots.txt không áp, người lập danh sách phải tự chịu trách nhiệm danh sách chỉ chứa URL được phép.
Tham số truy vấn và URL trùng
Website có tham số theo dõi hay tham số sắp xếp dễ sinh hàng nghìn URL gần giống nhau. README có remove-query-params để bỏ mọi tham số, và keep-query-param để chỉ giữ tham số cần thiết như page. Với audit, giữ tham số phân trang và bỏ phần còn lại thường cho báo cáo gọn mà đủ.
Lọc theo regex
include-regex và ignore-regex nhận biểu thức PCRE, dùng nhiều lần được. Mặc định chúng áp cho cả trang và tệp tĩnh. Thêm regex-filtering-only-for-pages để chỉ lọc trang, vẫn tải CSS, JS, ảnh của trang được giữ.
Với website có trang đăng xuất, README gợi ý ignore-regex cho logout hay signout khi crawl có cookie đăng nhập. Chi tiết này tránh việc crawler tự đăng xuất giữa chừng.
Chọn chế độ report và vị trí artifact kết quả của SiteOne Crawler audit website
Phần này nói về cache, tệp báo cáo và những mặc định cần biết.
Cache HTTP mặc định bật 24 giờ
README ghi cache HTTP mặc định nằm ở thư mục cache của người dùng, thời hạn mặc định 24 giờ. Nghĩa là chạy lại trong ngày có thể nhận phản hồi từ cache thay vì từ máy chủ. Với audit trước và sau thay đổi, đây là cái bẫy lớn nhất: báo cáo sau có thể chỉ là bản sao của báo cáo trước.
Dùng no-cache, hoặc đặt http-cache-dir thành off. README cũng khuyên tắt cache khi crawl có thông tin đăng nhập, vì phản hồi có xác thực cũng được lưu như mọi phản hồi khác.
Vị trí tệp báo cáo
Mặc định báo cáo lưu vào thư mục tmp trong thư mục hiện hành, tên có tên miền và thời điểm chạy. Nếu không tạo được tmp, công cụ dùng thư mục dữ liệu của hệ điều hành, trên Windows là thư mục siteone-crawler trong APPDATA. Đặt đường dẫn rõ ràng bằng output-json-file và output-html-report để không phải đi tìm.
Upload báo cáo là tùy chọn
README có tham số upload để gửi báo cáo HTML lên máy chủ của SiteOne, mặc định giữ 30 ngày. Đây là tùy chọn bật thủ công. Với website khách hàng hay website nội bộ, không bật upload: báo cáo chứa toàn bộ cấu trúc URL và header, có thể lộ đường dẫn quản trị.
Tương tự, tính năng gửi email báo cáo cần SMTP. Chỉ bật khi đã rõ ai nhận và báo cáo đi qua máy chủ nào.
Chọn mục trong báo cáo HTML
html-report-options cho chọn mục: summary, visited-urls, redirects, 404-pages, content-types, skipped-urls, headers, security và nhiều mục khác. Báo cáo cho quản lý có thể chỉ cần summary và 404. Báo cáo cho kỹ thuật nên giữ đủ.
Chế độ trình duyệt
SiteOne có chế độ browser dùng Chrome hay Chromium để render. README ghi rõ giới hạn: mỗi trang HTML bị tải hai lần, cache không lưu bản render, header tùy chỉnh và cookie không chuyển sang trình duyệt. Audit kỹ thuật thường không cần render, nên để mặc định.
Nhóm URL theo status và loại nội dung trong SiteOne Crawler audit website
Phần này là đáp án đối chứng của website mẫu.
Website mẫu
Máy chủ http.server ở 127.0.0.1 cổng 9861 có trang chủ trỏ tới mọi tình huống. Có hai trang sản phẩm, trang giới thiệu có và không có gạch chéo cuối, CSS, JS, ảnh PNG, PDF và JSON. Có một chuyển hướng 301, một trang 404, một trang 500 và một ảnh không tồn tại. Có một trang trả PDF nhưng khai Content-Type là text/html. Cuối cùng là thư mục quản trị bị robots.txt chặn, một link ngoài và chuỗi trang tìm kiếm luôn 404.
Trình đối chứng
Trình đối chứng viết bằng Python, chỉ dùng thư viện chuẩn. Nó đọc robots.txt, chỉ đi trong host khởi đầu, không tự theo chuyển hướng mà ghi lại 301. Nó phân nhóm theo Content-Type, đánh dấu khi nội dung bắt đầu bằng %PDF- mà Content-Type không phải PDF, và áp quy tắc 5 lỗi trên cùng đường dẫn.
Mục đích không phải thay SiteOne, mà để có một danh sách đúng biết trước, làm thước đo cho báo cáo của bất kỳ công cụ audit nào.
Đáp án theo status
Mã |
Số URL |
URL |
|---|---|---|
200 |
11 |
trang chủ, 2 sản phẩm, giới thiệu, giới thiệu có gạch chéo, bảng giá, CSS, JS, PNG, PDF, JSON |
301 |
1 |
/cu chuyển về /gioi-thieu |
404 |
7 |
/mat, /anh-mat.jpg, /tim?q=1 đến /tim?q=5 |
500 |
1 |
/loi |
Đáp án theo nhóm nội dung
Nhóm |
Số URL |
Ghi chú |
|---|---|---|
HTML |
14 |
Gồm cả trang lỗi 404, 500 và /bang-gia |
CSS, JS, Image, Document, JSON |
mỗi nhóm 1 |
Theo Content-Type |
Redirect |
1 |
/cu |
URL bị bỏ qua
Ba URL bị bỏ qua có lý do: /admin/ bị robots.txt chặn, example.org không thuộc host cho phép, /tim?q=6 vượt ngưỡng 5 lỗi trên cùng đường dẫn. Mỗi dòng ghi trang nguồn, đều là trang chủ hoặc trang tìm kiếm.
Đọc bảng 404 và redirects
Bảng 404 trong JSON liệt kê URL trả 404 cùng trang nguồn chứa link. Bảng redirects ghi mã chuyển hướng và đích. Hai bảng này là danh sách việc của đội nội dung: sửa link trên trang nguồn thay vì chỉ đặt thêm chuyển hướng.
Với website mẫu, /cu chuyển về /gioi-thieu, một trang đã có trong danh sách. Một báo cáo tốt nên cho thấy cả hai: URL cũ trả 301 và đích trả 200. Nếu đích lại chuyển tiếp, đó là chuỗi chuyển hướng cần rút ngắn.
Ngưỡng chấp nhận cho từng nhóm
Không phải lỗi nào cũng nghiêm trọng như nhau. 5xx trên trang HTML là việc phải sửa ngay. 404 trên ảnh cũ trong bài viết năm năm trước có thể để sau. Đặt ngưỡng riêng cho từng nhóm giúp báo cáo có thứ tự ưu tiên thay vì một danh sách dài ngang hàng.
Ảnh không tồn tại bị xếp vào HTML
/anh-mat.jpg trả 404 kèm trang lỗi Content-Type text/html. Trình đối chứng phân nhóm theo Content-Type nên xếp nó vào HTML. Công cụ phân nhóm theo đuôi tệp sẽ xếp nó vào ảnh. Hai cách đều có lý, nhưng khi so hai báo cáo, khác biệt kiểu này làm lệch số liệu từng nhóm.
Khi đối chiếu báo cáo SiteOne, so theo URL và status trước, rồi mới so nhóm nội dung. Lệch nhóm ở URL lỗi là bình thường, lệch status mới là vấn đề.
Nội dung không khớp Content-Type
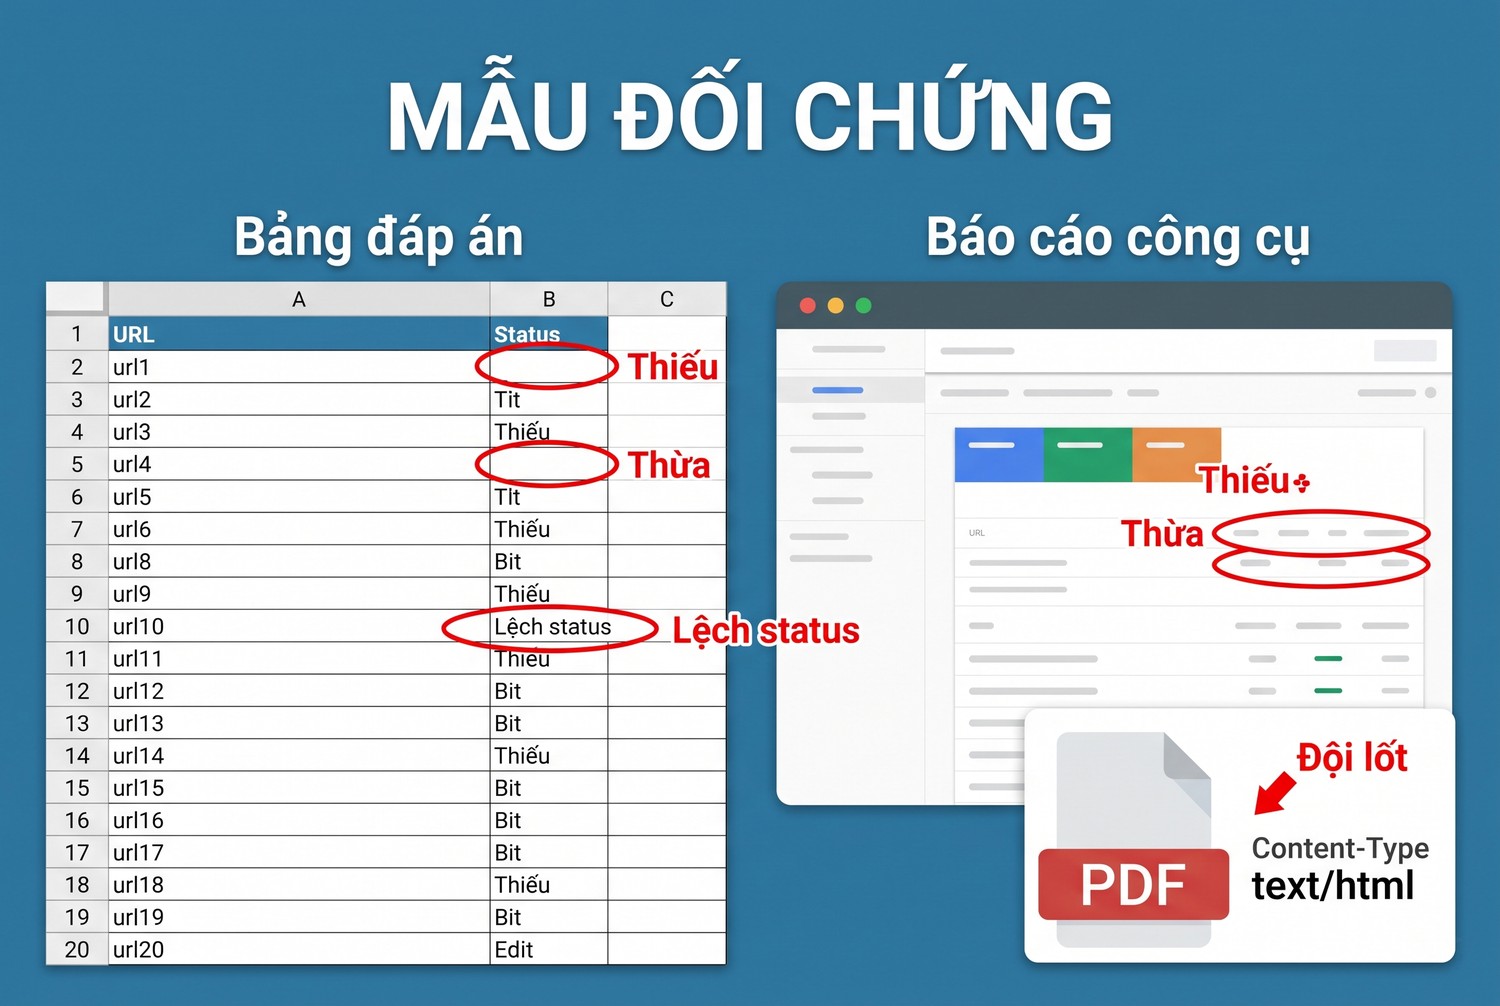
/bang-gia trả 200, Content-Type text/html, nhưng nội dung là PDF. Trình duyệt sẽ hiển thị rác. Công cụ audit dựa vào header sẽ không thấy lỗi. Đây là loại lỗi cần kiểm riêng bằng cách đọc vài byte đầu của phản hồi, trình đối chứng của lab có làm, còn SiteOne có làm hay không thì tài liệu không nói.
Đối chiếu báo cáo SiteOne Crawler audit website với fixture có link lỗi và content type khác nhau
Phần này mô tả cách so báo cáo với đáp án.
Ba phép so
Mẫu đối chứng
Phép một: stats.countByStatus phải khớp bảng đáp án theo status. Phép hai: tập url trong results phải bằng tập URL đáp án, không thiếu, không thừa. Phép ba: bảng skipped phải có ba lý do tương ứng. Ba phép này đủ để biết phạm vi crawl có đúng không.
Script so sánh
import json, csv
rep = json.load(open("tmp/audit.json", encoding="utf-8"))
got = {r["url"]: r["status"] for r in rep["results"]}
want = {row["url"]: str(row["status"]) for row in csv.DictReader(open("baseline.csv", encoding="utf-8"))}
print("thiếu:", sorted(set(want) - set(got)))
print("thừa:", sorted(set(got) - set(want)))
print("lệch status:", [(u, want[u], got[u]) for u in want if u in got and want[u] != got[u]])
print("countByStatus:", rep["stats"]["countByStatus"])
Script đọc JSON theo cấu trúc trong tài liệu chính thức: results có url và status dạng chuỗi, stats có countByStatus. Vì SiteOne không chạy được trong lab, script này chưa được chạy với báo cáo thật. Trước khi dùng, cần chuẩn hóa URL về cùng dạng, vì đáp án ghi đường dẫn tương đối còn SiteOne ghi URL đầy đủ.
Đọc kết quả so
Thiếu URL thường do trần số trang, regex lọc quá tay hoặc robots.txt. Thừa URL thường do biến thể gạch chéo cuối, tham số truy vấn hay tên miền phụ được cho phép. Lệch status ở cùng URL là dấu hiệu cache cũ hoặc máy chủ trả khác nhau theo User-Agent.
Biến thể gạch chéo cuối
Website mẫu có /gioi-thieu và /gioi-thieu/, cả hai đều 200. Đáp án coi là hai URL. Nếu website thật trả cùng nội dung cho cả hai mà không có canonical, đó là lỗi nội dung trùng cần báo cáo, không phải lỗi của công cụ.
User-Agent và bot protection
README ghi User-Agent mặc định theo thiết bị desktop, mobile hay tablet, và thêm chữ ký siteone-crawler ở cuối trừ khi kết thúc giá trị bằng dấu chấm than. Website có lớp chống bot có thể trả 403 cho chữ ký này. Với website của mình, nên đưa User-Agent của crawler vào danh sách cho phép thay vì giả làm trình duyệt. Cách này cũng giúp đội vận hành nhận ra request của audit trong log máy chủ, tránh nhầm với tấn công. Nên báo trước cho đội vận hành thời điểm chạy, nhất là khi website có hệ thống cảnh báo tự động theo số request.
So hai lần chạy trước và sau
Lưu JSON của lần trước, chạy lại sau thay đổi, so tập URL và status. README nhắc tham số ci-baseline nhận một tệp JSON cũ để kiểm hồi quy trong chế độ CI. Đây là cách tự động hóa phép so mà không cần script riêng, mình chưa thử nên không mô tả chi tiết.
Đầu ra nghiệm thu: lệnh chạy khóa phạm vi và báo cáo URL, status, loại nội dung có mẫu đối chứng cho SiteOne Crawler audit website
Phần cuối gom lại bộ bàn giao và vai trò của proxy.
Bộ bàn giao
Bộ bàn giao gồm lệnh chạy đầy đủ tham số, tệp JSON và HTML, bảng tóm tắt theo status và nhóm nội dung, danh sách URL bị bỏ qua kèm lý do và trang nguồn. Thêm một dòng ghi trần số trang, trạng thái cache và User-Agent đã dùng.
Nếu có mẫu đối chứng, đính kèm kết quả ba phép so. Người nhận thấy ngay báo cáo có bị cắt hay không.
Audit trong pipeline triển khai
Chế độ CI biến audit thành cổng kiểm tra. Sau khi triển khai lên staging, pipeline chạy SiteOne với ngưỡng 5xx bằng 0 và điểm tối thiểu. Không đạt thì không đưa lên production. README đặt khoảng in tiến độ mặc định 10 giây trong chế độ CI để log không quá dài.
Cổng này chỉ có ích khi staging giống production về nội dung. Staging với dữ liệu mẫu ít ỏi sẽ luôn đạt, nhưng không nói gì về website thật.
Tốc độ và quyền
README cảnh báo số workers cao có thể gây tấn công từ chối dịch vụ, mặc định 3 workers và 10 request mỗi giây. Với website đang chạy thật, giảm xuống 1 hay 2 workers và vài request mỗi giây, chạy ngoài giờ cao điểm. Chỉ audit website mình quản lý hoặc được chủ website cho phép bằng văn bản.
SiteOne tôn trọng robots.txt theo mặc định. Tham số ignore-robots-txt chỉ nên dùng với website của chính mình, khi muốn audit cả khu vực bị chặn với bot tìm kiếm. Bài robots.txt khi crawl website giải thích các quy tắc.
Giới hạn của bài
Không có kết quả chạy SiteOne thật do môi trường lab chặn tệp thực thi tải về. Hành vi của công cụ lấy từ README và JSON-OUTPUT.md ngày 03/11/2026. Trình đối chứng là cách hiểu của mình về các quy tắc phạm vi, có thể khác SiteOne ở chi tiết như cách tính basename hay phân nhóm URL lỗi.
Khi nào cần proxy với SiteOne Crawler audit website
README có tham số proxy nhận dạng host và cổng, là proxy HTTP. Tài liệu không nêu tham số tên người dùng và mật khẩu riêng cho proxy, nên proxy có xác thực cần kiểm thêm trước khi dùng. Ở chế độ browser, tham số proxy được chuyển sang trình duyệt.
Proxy cần khi website staging chỉ cho phép một IP cố định, hoặc khi cần audit phiên bản website hiển thị cho người dùng một quốc gia. Proxy không vượt qua robots.txt hay xác thực của website. Cách viết host và cổng có trong bài định dạng proxy. Khi cần IP tĩnh tại Việt Nam cho staging có danh sách cho phép, anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Vai trò hợp lệ của proxy được phân tích trong bài Web Scraping proxy là gì.
Checklist SiteOne Crawler audit website
Checklist audit
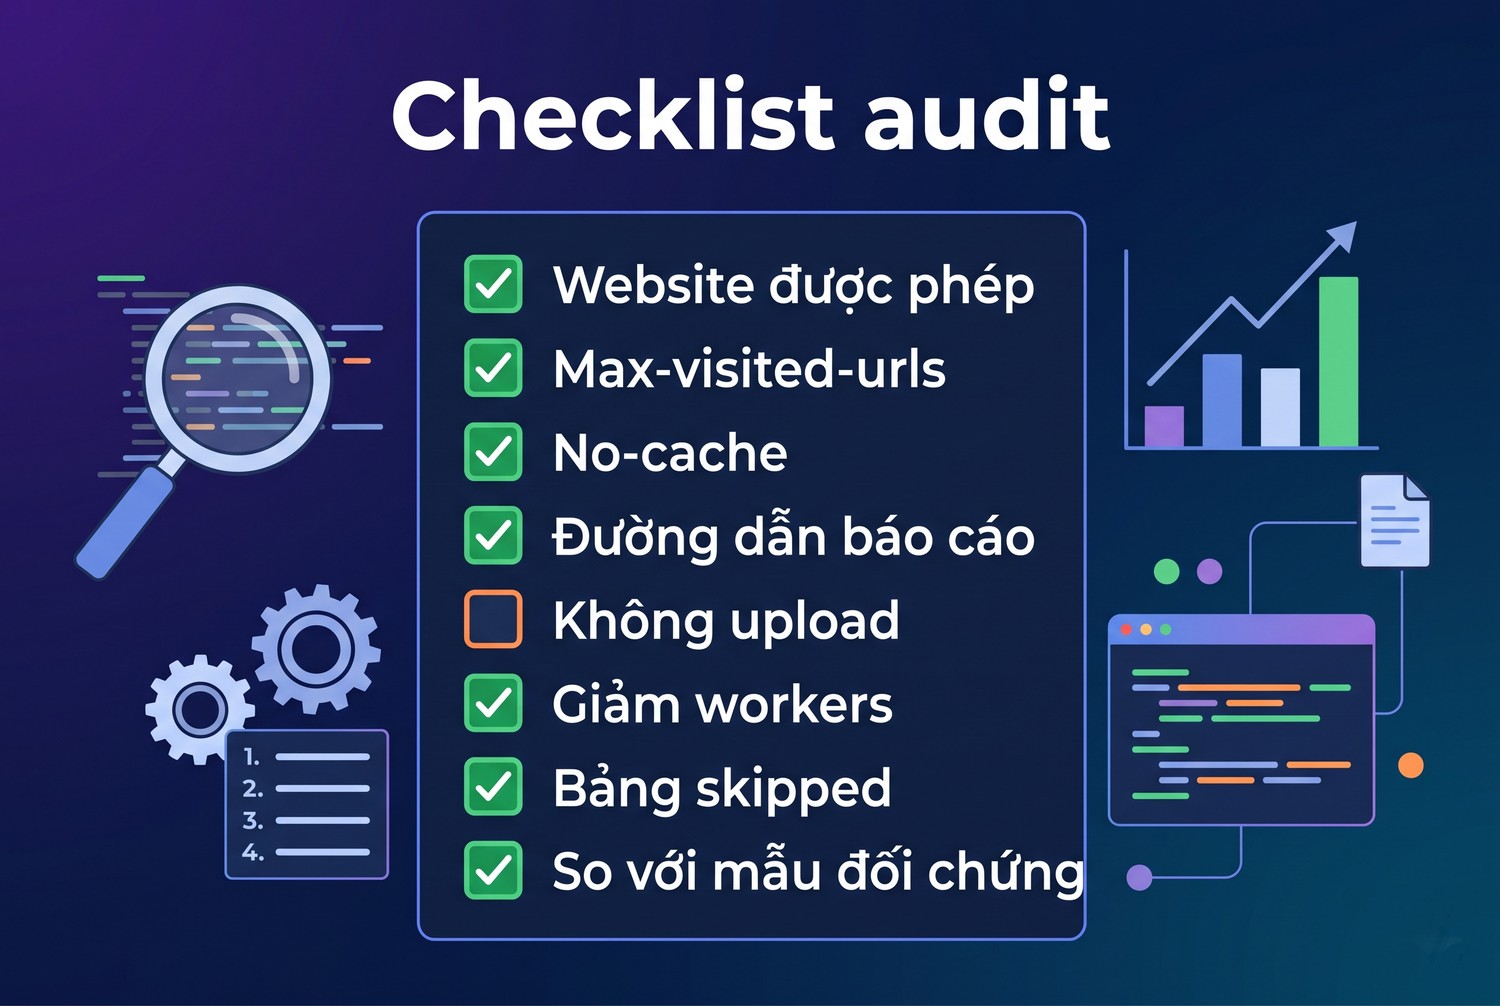
- Chỉ audit website mình quản lý hoặc được cho phép.
- Đặt max-visited-urls và ghi lại, so với stats.totalUrls.
- Dùng no-cache khi so trước và sau.
- Đặt output-json-file và output-html-report rõ ràng.
- Không bật upload với website khách hàng hay nội bộ.
- Giảm workers và max-reqs-per-sec với website đang chạy.
- Đọc bảng skipped với cột trang nguồn.
- So báo cáo với một mẫu đối chứng biết trước đáp án.
Câu hỏi thường gặp về SiteOne Crawler audit website
Vì sao báo cáo ít URL hơn website thật?
Trần max-visited-urls mặc định 10.000, robots.txt, regex lọc, hoặc quy tắc 5 lỗi trên cùng basename.
Chạy lại trong ngày sao kết quả không đổi?
Cache HTTP mặc định 24 giờ. Thêm no-cache khi cần dữ liệu mới.
SiteOne có tự gửi báo cáo lên mạng không?
Chỉ khi bật tham số upload. Mặc định báo cáo lưu ở thư mục tmp cục bộ.
Type trong JSON là gì?
Số nguyên chỉ nhóm nội dung: 1 HTML, 2 JS, 3 CSS, 4 ảnh, 7 tài liệu, 8 JSON, theo tài liệu.
Có cần bật chế độ trình duyệt để audit không?
Thường không. Chế độ này tải trang HTML hai lần và không chuyển cookie hay header tùy chỉnh.
SiteOne hỗ trợ proxy thế nào?
Tham số proxy nhận host và cổng của proxy HTTP, áp cả cho chế độ trình duyệt.
SiteOne Crawler audit website và những điều cần nhớ
SiteOne Crawler audit website cho báo cáo đầy đủ trong một lệnh, nhưng trần số trang, cache 24 giờ và quy tắc lỗi theo basename có thể làm báo cáo trông sạch hơn thực tế. Mẫu đối chứng 20 URL trong bài cho thấy trần 8 URL là đủ giấu mọi lỗi 404 và 500. Khóa phạm vi, tắt cache, so với đáp án. Cần IP tĩnh cho SiteOne Crawler audit website trên staging, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


