
Scrapy và BeautifulSoup: chọn khung crawl hay thư viện phân tích
Scrapy và BeautifulSoup hay được đặt lên bàn cân như hai đối thủ, dù thật ra chúng làm hai việc khác nhau. ProxyVN cho hai bên lấy cùng 100 sản phẩm từ một site thử có lỗi 503 giả lập, đi qua cùng một proxy có mật khẩu. Bài ghi lại code, số request, thời gian, RAM và những chi tiết cấu hình dễ làm anh em chạy sai.
Scrapy và BeautifulSoup làm hai việc khác nhau
Câu hỏi nên chọn cái nào chỉ trả lời được khi tách rõ một scraper gồm những phần nào. Mỗi phần có thể do một công cụ khác đảm nhận, và chỗ khác biệt giữa hai cái tên này nằm ở phạm vi chúng ôm vào.
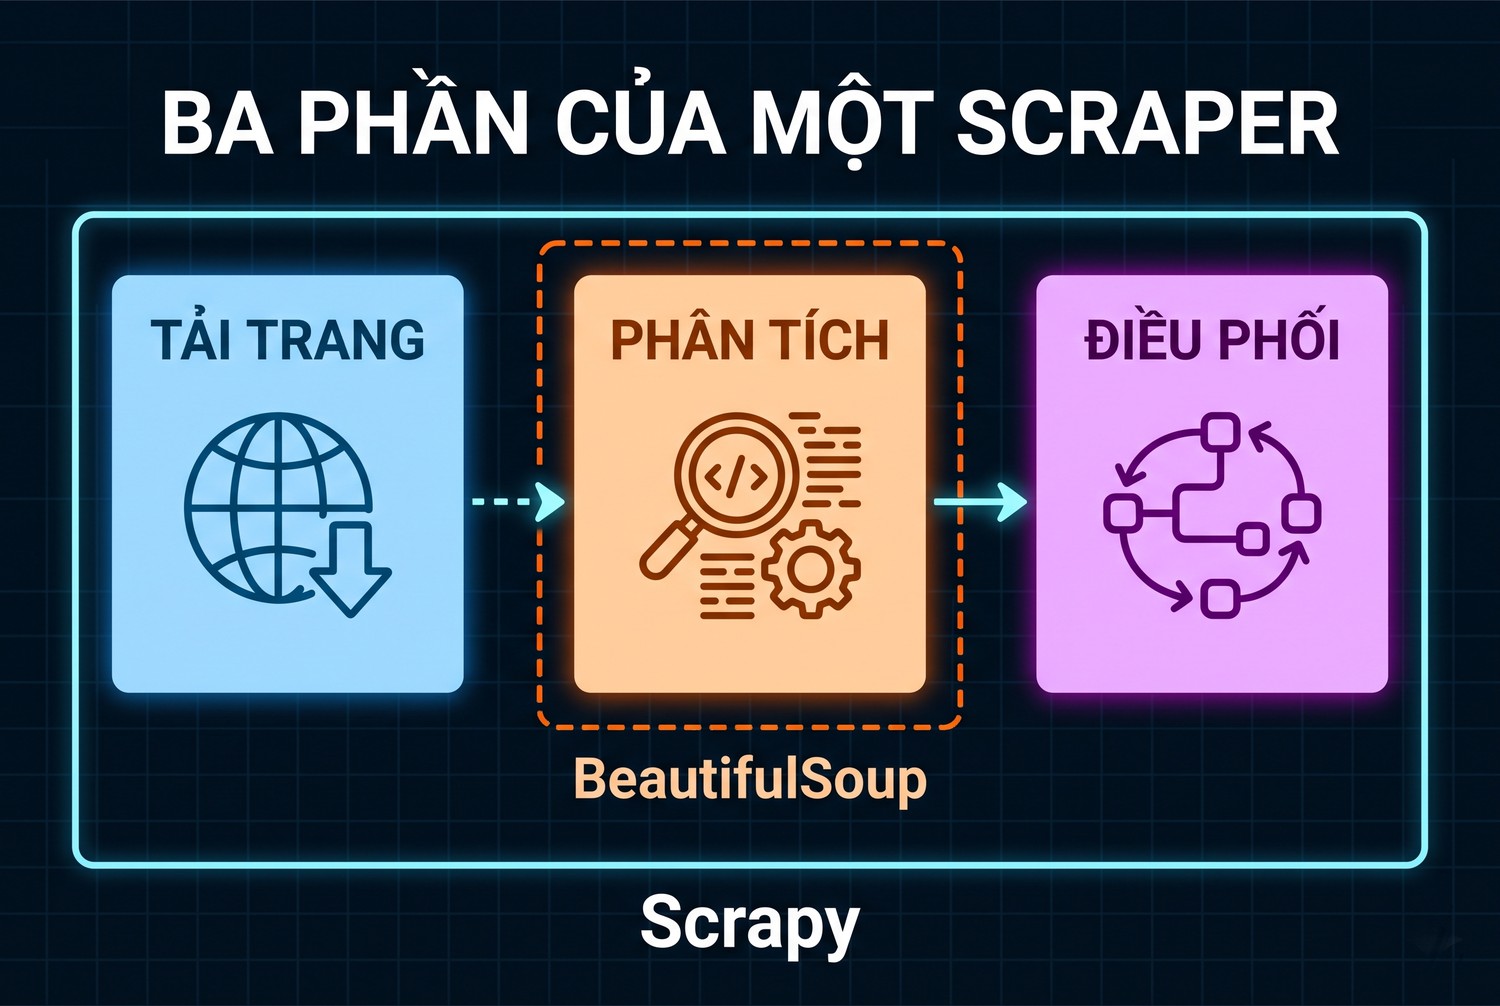
Ba phần của một scraper
Phần thứ nhất là tải trang: gửi request, nhận phản hồi, giữ cookie, đi qua proxy. Phần thứ hai là phân tích: biến HTML thành các trường dữ liệu như tên, giá, tồn kho. Phần thứ ba là điều phối: quyết định tải trang nào tiếp theo, chạy bao nhiêu request cùng lúc, thử lại khi lỗi, lưu kết quả ra đâu.
BeautifulSoup chỉ làm phần thứ hai. Nó nhận một chuỗi HTML và cho anh em chọn phần tử. Việc tải trang phải nhờ thư viện khác như requests, còn việc điều phối do chính code của anh em viết.
Scrapy ôm trọn cả ba phần
Theo trang tổng quan của Scrapy, Scrapy là một khung ứng dụng để crawl website và trích xuất dữ liệu có cấu trúc. Nó có bộ tải trang riêng, bộ lập lịch, hàng đợi request, cơ chế thử lại, giới hạn tốc độ và hệ thống xuất dữ liệu ra JSON hay CSV.
Phần phân tích của Scrapy dùng CSS selector và XPath qua đối tượng response, không cần BeautifulSoup. Nhưng nếu anh em quen BeautifulSoup, vẫn có thể dùng nó ngay trong Scrapy. So sánh đúng là requests cộng BeautifulSoup cộng code điều phối tự viết, đặt cạnh Scrapy.
Bài so sánh này đo những gì
Bài của DataImpulse về Scrapy và BeautifulSoup chạy hai bộ code trên năm trang công khai và kết luận cả hai ra cùng dữ liệu. Mình làm một tác vụ nặng hơn để thấy rõ phần điều phối: 5 trang danh sách dẫn tới 100 trang chi tiết. Mỗi request trễ 50 mili giây như đi qua mạng, và 5 trang chi tiết cố ý trả lỗi 503 ở lần đầu.
Mục tiêu là xem mỗi bên cần bao nhiêu code để xử lý chuyện này, chạy mất bao lâu, tốn bao nhiêu RAM, và dữ liệu cuối có khớp nhau không. Số đo chỉ đúng cho môi trường thử, nhưng các chi tiết cấu hình thì áp dụng được cho site thật.
So sánh Scrapy và BeautifulSoup trên cùng yêu cầu
Trước khi vào code, bảng dưới tóm tắt khác biệt về phạm vi và cách làm việc. Phần sau giải thích từng điểm và đặt số đo thật vào.
Tiêu chí |
requests + BeautifulSoup |
Scrapy |
|---|---|---|
Phạm vi |
Tải trang và phân tích, điều phối tự viết |
Tải, phân tích, điều phối, xuất dữ liệu |
Chạy song song |
Tự dùng luồng hoặc asyncio |
Có sẵn, chỉnh bằng setting |
Thử lại khi lỗi |
Tự viết |
RetryMiddleware có sẵn |
Giới hạn tốc độ |
Tự viết |
DOWNLOAD_DELAY, AutoThrottle |
Xuất JSON, CSV |
Tự viết |
FEEDS có sẵn |
Proxy |
Tham số proxies của requests |
meta proxy hoặc biến môi trường |
Học để bắt đầu |
Vài phút |
Cần hiểu spider, callback, setting |
Ba phần của một scraper
Khi nào requests cộng BeautifulSoup là đủ
Một danh sách URL cố định, vài chục tới vài trăm trang, chạy một lần hoặc thỉnh thoảng: requests cộng BeautifulSoup là lựa chọn gọn nhất. Code đọc từ trên xuống dưới, gỡ lỗi bằng print là đủ, không phải học cấu trúc dự án.
Nhà phân tích dữ liệu cần lấy một bảng giá để đưa vào pandas là trường hợp điển hình. Họ không cần hàng đợi hay pipeline, họ cần dữ liệu trong vài phút.
Khi nào nên chuyển sang Scrapy
Khi code điều phối bắt đầu dài hơn code phân tích, đó là dấu hiệu nên chuyển. Các dấu hiệu cụ thể: crawl nhiều tầng, đi theo liên kết, cần thử lại có quy tắc, cần giới hạn tốc độ theo tên miền, cần chạy định kỳ và theo dõi số liệu từng lần chạy.
Một dự án theo dõi giá hằng ngày trên vài sàn, mỗi sàn hàng nghìn trang, là trường hợp Scrapy phát huy. Các phần lặp lại như thử lại, ghi số liệu, xuất file đã có sẵn và đã được nhiều người dùng kiểm qua.
Dùng chung cả hai
Hai công cụ không loại trừ nhau. Trong callback của Scrapy, anh em có thể đưa response.text vào BeautifulSoup nếu đội đã có sẵn code phân tích viết bằng BeautifulSoup. Cách này giữ được phần điều phối của Scrapy mà không phải viết lại phần phân tích.
Đánh đổi là tốn thêm thời gian phân tích, vì HTML bị đọc hai lần: một lần bởi Scrapy để tạo response, một lần bởi BeautifulSoup. Với vài nghìn trang thì không đáng kể, với hàng triệu trang thì nên chuyển sang selector của Scrapy.
Bốn câu hỏi trước khi chọn
DataImpulse đề xuất chọn theo bốn yếu tố: trang có cần chạy JavaScript không, crawl phức tạp tới đâu, yêu cầu vận hành ra sao, và đội quen công cụ nào. Mình thấy cách này dùng được, và hay biến nó thành bốn câu hỏi cụ thể trước mỗi dự án:
- HTML tải về bằng requests có chứa đủ trường cần lấy không? Nếu không, cả hai công cụ đều cần thêm trình duyệt hoặc gọi API.
- Có bao nhiêu kiểu trang và bao nhiêu đường đi giữa chúng? Một danh sách URL cố định khác hẳn một cây danh mục nhiều tầng.
- Dự án chạy một lần hay chạy định kỳ, ai theo dõi khi lỗi, cần số liệu từng lần chạy không?
- Người sẽ sửa scraper sau ba tháng quen công cụ nào?
Nếu ba câu đầu đều ra đáp án đơn giản, requests cộng BeautifulSoup là đủ. Chỉ cần một câu ra đáp án phức tạp, nhất là câu thứ hai và thứ ba, Scrapy sẽ tiết kiệm công sức về sau. Câu thứ tư quyết định khi hai lựa chọn ngang nhau.
Chuẩn bị môi trường thử Scrapy và BeautifulSoup
Hai bộ code chạy trong cùng một môi trường ảo Python để phiên bản thư viện không lẫn với máy. Site thử và proxy chạy ngay trên máy, không gọi ra Internet.
Phiên bản đã dùng
Mình ghi phiên bản cụ thể vì Scrapy thay đổi khá nhiều giữa các bản, nhất là phần setting mặc định. Kiểm tra ngày 25/10/2026:
- Python 3.12.10 trên Windows 10, chạy trong môi trường ảo riêng.
- Scrapy 2.19.0.
- beautifulsoup4 4.15.0, lxml làm bộ phân tích, requests.
Cài bằng một lệnh pip trong môi trường ảo là đủ. Trên Windows, Scrapy cài được trực tiếp bằng pip với Python 3.12, không cần bước biên dịch riêng.
python -m venv venv
venv\Scripts\python -m pip install scrapy beautifulsoup4 lxml requests
Site thử và các lỗi cố ý
Site thử có 5 trang danh sách, mỗi trang 20 sản phẩm, mỗi sản phẩm dẫn tới một trang chi tiết có tên, giá và số lượng tồn. Tổng cộng 105 trang cần tải nếu không có lỗi.
Mỗi request chờ 50 mili giây trước khi trả lời để giống độ trễ mạng. Các sản phẩm số 17, 34, 51, 68 và 85 trả lỗi 503 ở lần đầu, lần sau mới trả trang bình thường. Vì vậy một scraper đúng phải gửi 110 request và vẫn ra đủ 100 dòng.
Proxy có mật khẩu
Giữa scraper và site là một proxy HTTP yêu cầu tài khoản user1, mật khẩu p@ss#2026. Proxy ghi lại mọi request, nhờ đó mình đếm được bao nhiêu request thật sự đi qua và có xác thực đúng hay không.
Cả hai bộ code đều mã hóa mật khẩu bằng hàm quote trước khi ghép vào URL proxy. Phần sau sẽ cho thấy chuyện gì xảy ra nếu bỏ bước này, và hai bên phản ứng khác nhau thế nào.
Ví dụ tối thiểu với Scrapy và BeautifulSoup trên 100 trang
Tác vụ giống nhau cho cả hai: đi qua 5 trang danh sách, gom 100 liên kết chi tiết, tải từng trang chi tiết, lấy tên, giá, tồn kho, thử lại khi gặp 503, rồi ghi ra file JSON.
Bản requests cộng BeautifulSoup
Đoạn code dưới tự viết phần thử lại trong hàm fetch, tự đi theo liên kết trang sau, và dùng ThreadPoolExecutor để tải trang chi tiết song song. Số luồng truyền qua tham số dòng lệnh.
import json, time
from concurrent.futures import ThreadPoolExecutor
from urllib.parse import quote, urljoin

import requests
from bs4 import BeautifulSoup

PROXY = f"http://user1:{quote('p@ss#2026', safe='')}@127.0.0.1:8792"
PROXIES = {"http": PROXY, "https": PROXY}
session = requests.Session()
session.headers["User-Agent"] = "t22-bs4"

def fetch(url, tries=3):
    for i in range(tries):
        r = session.get(url, proxies=PROXIES, timeout=15)
        if r.status_code in (429, 500, 502, 503, 504):
            time.sleep(0.5 * (i + 1))
            continue
        r.raise_for_status()
        return r.text
    raise RuntimeError(f"Hết lượt thử: {url}")

def detail(url):
    soup = BeautifulSoup(fetch(url), "lxml")
    return {"url": url,
            "name": soup.select_one("h1.name").get_text(strip=True),
            "price": int(soup.select_one(".price").get_text(strip=True).replace(",", "").replace("đ", "")),
            "stock": soup.select_one(".stock").get_text(strip=True)}

def main(workers):
    url, links = "http://127.0.0.1:8791/products?page=1", []
    while url:
        soup = BeautifulSoup(fetch(url), "lxml")
        links += [urljoin(url, a["href"]) for a in soup.select("li.item h2 a")]
        nxt = soup.select_one("a.next")
        url = urljoin(url, nxt["href"]) if nxt else None
    with ThreadPoolExecutor(workers) as ex:
        return list(ex.map(detail, links))

rows = main(8)
json.dump(rows, open("bs4_out.json", "w", encoding="utf-8"), ensure_ascii=False)
File đầy đủ dài 53 dòng, tính cả phần đo thời gian. Có một điểm cần lưu ý khi dùng chung một Session cho nhiều luồng: requests không cam kết Session an toàn khi dùng song song. Bài thử chạy ổn với 8 luồng, nhưng dự án lớn nên tạo Session riêng cho mỗi luồng.
Bản Scrapy
Spider dưới làm cùng tác vụ trong 36 dòng. Phần thử lại, chạy song song và ghi file JSON không phải viết, chỉ khai báo trong custom_settings. Proxy truyền qua khóa proxy trong meta của từng request, đúng như mô tả của HttpProxyMiddleware.
from urllib.parse import quote
import scrapy

PROXY = f"http://user1:{quote('p@ss#2026', safe='')}@127.0.0.1:8792"

class ShopSpider(scrapy.Spider):
    name = "shop"
    start_urls = ["http://127.0.0.1:8791/products?page=1"]
    custom_settings = {
        "USER_AGENT": "t22-scrapy",
        "CONCURRENT_REQUESTS": 8,
        "RETRY_TIMES": 2,
        "FEEDS": {"scrapy_out.json": {"format": "json", "encoding": "utf8", "overwrite": True}},
    }

    async def start(self):
        for url in self.start_urls:
            yield scrapy.Request(url, meta={"proxy": PROXY})

    def parse(self, response):
        for href in response.css("li.item h2 a::attr(href)").getall():
            yield response.follow(href, self.parse_item, meta={"proxy": PROXY})
        nxt = response.css("a.next::attr(href)").get()
        if nxt:
            yield response.follow(nxt, self.parse, meta={"proxy": PROXY})

    def parse_item(self, response):
        yield {
            "url": response.url,
            "name": response.css("h1.name::text").get(),
            "price": int(response.css(".price::text").get().replace(",", "").replace("đ", "")),
            "stock": response.css(".stock::text").get(),
        }
Chạy bằng lệnh scrapy runspider shop_spider.py, không cần tạo dự án. Hàm start viết dạng async là cách mới của các bản Scrapy gần đây; với bản cũ hơn, anh em dùng hàm start_requests như các hướng dẫn trước.
Kết quả hai bên
Hai file JSON sau khi sắp xếp theo URL trùng khớp từng dòng: 100 sản phẩm, đủ tên, giá, tồn kho. Log proxy ghi 110 request, cả 110 đều có xác thực đúng, tức 105 trang cộng 5 lần thử lại. Thống kê cuối của Scrapy ghi 105 phản hồi 200, 5 phản hồi 503 và retry/count bằng 5.
Cách chạy |
Dòng |
Request |
Thời gian |
RAM đỉnh |
|---|---|---|---|---|
requests + BeautifulSoup, 1 luồng |
100/100 |
110 |
9,4–9,5 giây |
36 MB |
requests + BeautifulSoup, 8 luồng |
100/100 |
110 |
1,9–2,0 giây |
36 MB |
Scrapy, CONCURRENT_REQUESTS 8 |
100/100 |
110 |
1,0–1,5 giây |
77 MB |
Bản một luồng chậm vì mỗi request chờ đủ 50 mili giây cộng thời gian chờ thử lại. Khi cùng chạy song song 8 request, Scrapy nhanh hơn bản tự viết một chút, phần lớn nhờ không chặn luồng lúc chờ thử lại. Scrapy tốn RAM gấp đôi vì nạp cả khung, nhưng 77 MB vẫn nhỏ với máy chủ thông thường.
Setting mặc định của Scrapy và BeautifulSoup khi chạy thật
Phần này là chỗ nhiều người chạy Scrapy lần đầu thấy nó chậm bất thường hoặc không lấy được trang nào, trong khi code BeautifulSoup vẫn chạy. Nguyên nhân thường nằm ở file settings.py, không nằm ở code spider.
Cùng spider: 1 giây và 128 giây
File settings.py do startproject tạo ra
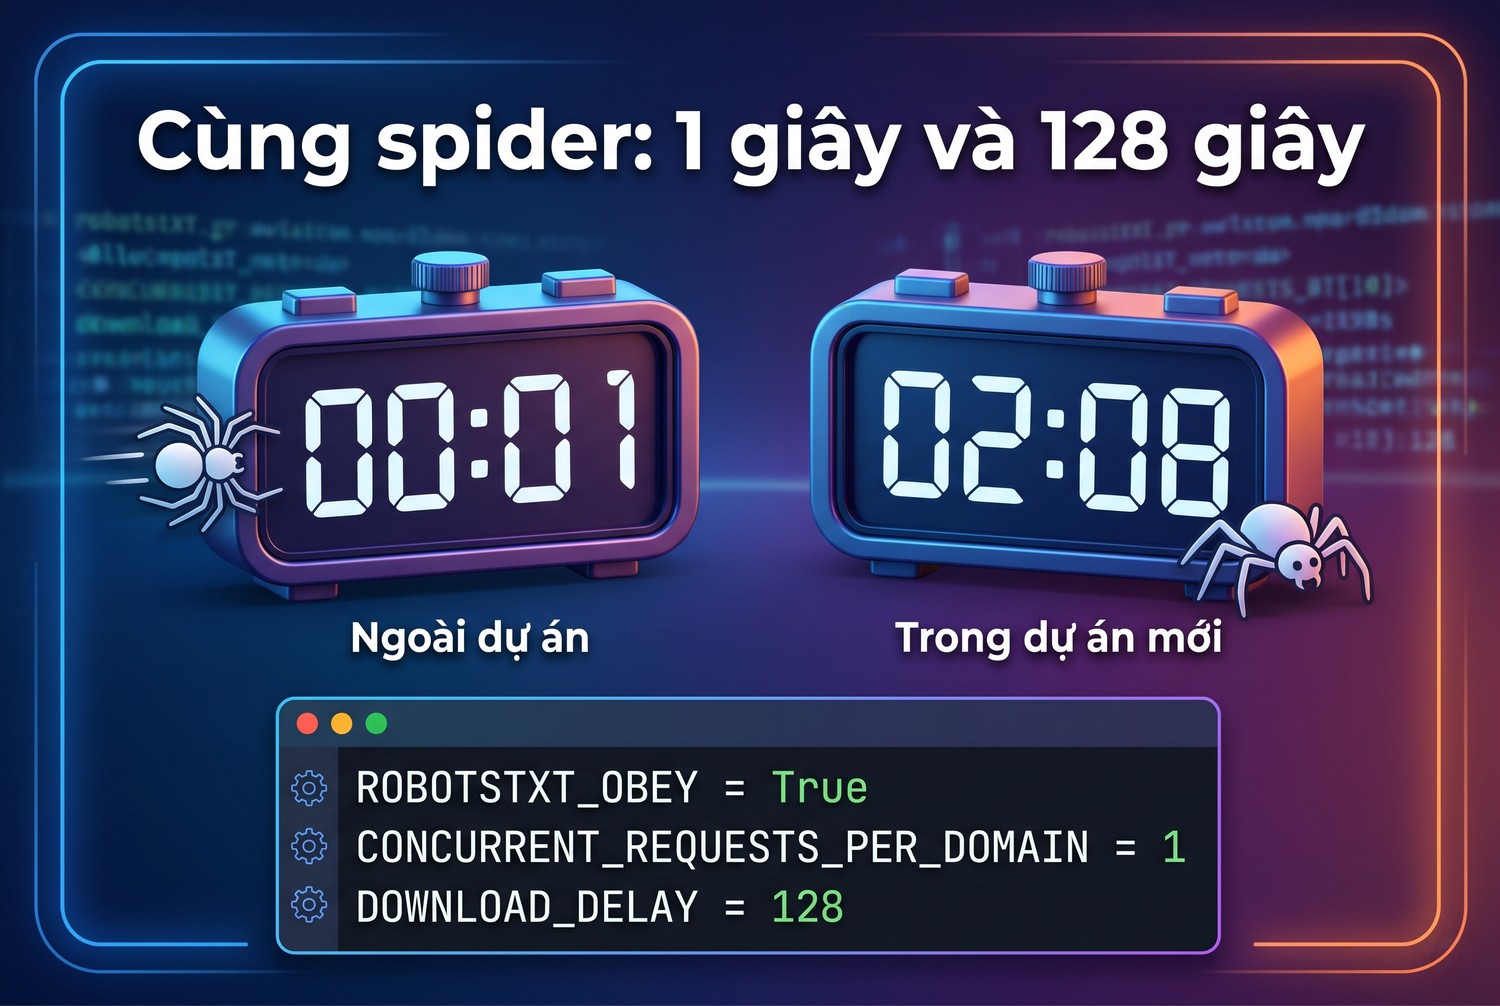
Khi tạo dự án bằng lệnh scrapy startproject, Scrapy 2.19.0 sinh file settings.py có sẵn ba dòng đáng chú ý. Mình tạo thử dự án và lọc bỏ chú thích, kết quả như sau:
ROBOTSTXT_OBEY = True
CONCURRENT_REQUESTS_PER_DOMAIN = 1
DOWNLOAD_DELAY = 1
Theo tài liệu setting của Scrapy, giá trị dự phòng khi không đặt là ROBOTSTXT_OBEY bằng False, CONCURRENT_REQUESTS_PER_DOMAIN bằng 8 và DOWNLOAD_DELAY bằng 0. Nghĩa là cùng một spider, chạy bằng runspider ngoài dự án thì nhanh, đặt vào dự án mới tạo thì chậm hẳn và tôn trọng robots.txt.
Ảnh hưởng tới thời gian chạy
Mình chép nguyên spider ở trên vào dự án mới tạo và chạy bằng scrapy crawl shop. Kết quả vẫn đủ 100 sản phẩm, nhưng mất 128,7 giây thay vì khoảng 1 giây. Số request là 106, trong đó có một request tới robots.txt mà Scrapy tự gửi trước tiên, site thử trả 404 nên mọi URL đều được phép.
Thời gian tăng hơn trăm lần vì DOWNLOAD_DELAY bằng 1 và chỉ một request mỗi lần tới cùng tên miền. CONCURRENT_REQUESTS bằng 8 trong spider không giúp gì, vì giới hạn theo tên miền đang là 1. Tài liệu Scrapy còn ghi rằng từ bản 2.19.0, độ trễ này được làm ngẫu nhiên trong khoảng cộng trừ 50 phần trăm qua setting DOWNLOAD_DELAY_JITTER.
Đây là mặc định hợp lý để tránh gửi quá tải tới site người khác, không phải lỗi. Anh em chỉ nên tăng tốc sau khi đã đọc robots.txt, điều khoản của site và theo dõi phản hồi. Bài proxy Scrapy có phần hướng dẫn chỉnh DOWNLOAD_DELAY và AUTOTHROTTLE chi tiết.
robots.txt ở mỗi bên
Với ROBOTSTXT_OBEY bằng True, Scrapy tự tải robots.txt của mỗi tên miền trước và bỏ các URL bị cấm. requests cộng BeautifulSoup không làm việc này, anh em phải tự đọc robots.txt bằng mô-đun urllib.robotparser của Python hoặc thư viện tương đương.
Đây là khác biệt dễ bị bỏ qua nhất: chuyển từ BeautifulSoup sang Scrapy có thể khiến một số trang biến mất khỏi kết quả, vì Scrapy đang tôn trọng robots.txt thay cho anh em. Khi thấy thiếu dữ liệu, xem log có dòng Forbidden by robots.txt không trước khi sửa selector.
Xử lý lỗi và kiểm dữ liệu với Scrapy và BeautifulSoup
Cả hai bộ code đều ra đủ dữ liệu trong bài thử, nhưng cách chúng xử lý lỗi khác nhau. Hiểu cách mỗi bên phản ứng giúp anh em đọc log đúng khi chạy với site thật.
Thử lại có sẵn và thử lại tự viết
RetryMiddleware của Scrapy mặc định thử lại các mã 500, 502, 503, 504, 522, 524, 408, 429 và lỗi kết nối, với số lần thử lại đặt qua RETRY_TIMES, mặc định là 2. Bản tự viết chỉ thử lại những mã anh em liệt kê, và phải tự quyết định chờ bao lâu giữa các lần.
Ưu điểm của bản tự viết là kiểm soát được từng chi tiết, ví dụ đọc header Retry-After để chờ đúng thời gian site yêu cầu. Với Scrapy, muốn làm điều tương tự thì viết một downloader middleware riêng. Cả hai đều làm được, khác nhau ở chỗ việc nào có sẵn và việc nào phải viết.
Mật khẩu proxy chưa mã hóa
Mình thử bỏ hàm quote, ghép thẳng p@ss#2026 vào URL proxy. requests báo ProxyError, trong thông báo lỗi tên máy chủ proxy bị hiểu thành ss, vì phần sau dấu @ đầu tiên bị coi là địa chỉ. Scrapy thì vẫn chạy và proxy nhận đúng tài khoản, vì cách Scrapy tách URL proxy lấy dấu @ cuối cùng làm điểm chia.
Chi tiết này có thể làm anh em bối rối khi chuyển code giữa hai công cụ: chuỗi proxy chạy được trong Scrapy lại lỗi trong requests. Cách an toàn cho mọi thư viện là luôn mã hóa user và mật khẩu bằng quote với safe rỗng. Bài định dạng proxy hướng dẫn tách đúng từng phần của chuỗi proxy nhà cung cấp gửi.
Kiểm dữ liệu sau khi chạy
Không báo lỗi chưa có nghĩa là dữ liệu đúng. Sau mỗi lần chạy, mình kiểm vài điều kiện đơn giản, áp dụng cho cả hai bên:
- Số dòng bằng số liên kết chi tiết đã gom được; trong bài thử là 100.
- Không có URL trùng; trùng thường do phân trang lặp.
- Tên không rỗng, giá là số dương, tồn kho đúng định dạng.
- Với Scrapy, so item_scraped_count với số request thành công trong thống kê cuối.
- Với bản tự viết, ghi lại số request và số lần thử lại để so với lần chạy trước.
Scrapy in thống kê cuối mỗi lần chạy, gồm số request, số phản hồi theo từng mã, số item, thời gian chạy. Bản tự viết phải tự đếm, như biến stats trong file thử của mình. Với dự án chạy định kỳ, bộ thống kê có sẵn là lợi thế đáng kể của Scrapy.
Trang dựng bằng JavaScript
Cả Scrapy lẫn requests đều chỉ tải HTML, không chạy JavaScript của trang. Nếu dữ liệu do script dựng sau khi tải, cả hai đều thấy trang trống. Cách đầu tiên nên thử là tìm API mà trang gọi trong thẻ Network của trình duyệt rồi gọi thẳng.
Khi buộc phải chạy trang, bên Scrapy có scrapy-playwright, bên BeautifulSoup thì dùng Playwright tải trang rồi đưa HTML đã dựng vào BeautifulSoup. Hai cách đều làm RAM tăng mạnh vì phải mở trình duyệt.
Chuyển dự án giữa Scrapy và BeautifulSoup từng bước
Nhiều dự án bắt đầu bằng một script BeautifulSoup nhỏ, rồi lớn dần tới mức phần điều phối khó quản lý. Viết lại từ đầu bằng Scrapy tốn công và dễ làm sai dữ liệu. Cách mình hay dùng là chuyển từng phần, giữ nguyên hàm phân tích cũ cho tới khi phần mới chạy ổn.
Bước 1: tách hàm phân tích khỏi phần tải trang
Trong script cũ, hàm phân tích thường lẫn với lệnh gọi requests. Bước đầu là tách nó thành một hàm chỉ nhận chuỗi HTML và trả về dict. Hàm này không biết gì về proxy hay thử lại, nên dùng lại được ở bất kỳ đâu.
Khi đã tách, anh em lưu vài file HTML mẫu của trang thật vào thư mục kiểm thử. Mỗi lần sửa hàm, chạy nó với các file mẫu và so kết quả. Việc này giúp phát hiện lỗi phân tích mà không phải gửi request nào tới site.
Bước 2: gọi hàm cũ bên trong spider
Spider dưới giữ nguyên hàm parse_detail_html viết bằng BeautifulSoup, chỉ đưa response.text vào. Phần đi theo liên kết, chạy song song và xuất file do Scrapy lo. Mình cố ý thêm một liên kết trùng tới sản phẩm số 1 ở mỗi trang danh sách để xem Scrapy xử lý thế nào.
from bs4 import BeautifulSoup
from scrapy.exceptions import DropItem

def parse_detail_html(html):
    soup = BeautifulSoup(html, "lxml")
    return {"name": soup.select_one("h1.name").get_text(strip=True),
            "price": int(soup.select_one(".price").get_text(strip=True).replace(",", "").replace("đ", "")),
            "stock": soup.select_one(".stock").get_text(strip=True)}

class CheckPipeline:
    def open_spider(self, spider=None):
        self.seen = set()

    def process_item(self, item, spider=None):
        if not item["name"] or item["price"] <= 0:
            raise DropItem(f"Thiếu trường: {item['url']}")
        if item["url"] in self.seen:
            raise DropItem(f"Trùng URL: {item['url']}")
        self.seen.add(item["url"])
        return item

# trong spider:
#     custom_settings = {"ITEM_PIPELINES": {"mix_spider.CheckPipeline": 300}, ...}
#     def parse_item(self, response):
#         yield {"url": response.url, **parse_detail_html(response.text)}
Kết quả chạy là 100 sản phẩm với 105 request, thống kê ghi dupefilter/filtered bằng 5. Nghĩa là bộ lọc trùng của Scrapy đã tự bỏ 5 lần xếp hàng lại sản phẩm số 1, không cần code gì thêm. Với bản BeautifulSoup tự viết, anh em phải tự giữ một tập URL đã tải để làm việc này.
Bước 3: chuyển phần kiểm dữ liệu sang pipeline
Lớp CheckPipeline ở trên là nơi đặt các điều kiện kiểm đã nói ở phần trước: thiếu trường thì bỏ, trùng URL thì bỏ. Item bị bỏ được đếm trong thống kê cuối dưới khóa item_dropped_count, nên chỉ cần nhìn thống kê là biết lần chạy đó có bao nhiêu dòng lỗi.
Tách kiểm dữ liệu ra pipeline giúp spider chỉ còn lo đi đường và phân tích. Khi site đổi giao diện làm giá bị rỗng, pipeline sẽ bỏ dòng lỗi và số đếm tăng lên, anh em thấy ngay thay vì phát hiện khi dữ liệu đã vào báo cáo.
Bước 4: thay dần BeautifulSoup bằng selector của Scrapy
Khi mọi thứ đã chạy ổn, có thể giữ BeautifulSoup mãi nếu số trang không lớn. Nếu muốn giảm thời gian phân tích, thay từng trường sang response.css hoặc response.xpath, chạy lại với file HTML mẫu và so kết quả với hàm cũ. Khi mọi trường khớp, bỏ hàm cũ đi.
Chiều ngược lại cũng làm được. Một dự án Scrapy nhỏ dần, chỉ còn vài trang cố định, có thể quay về script requests cộng BeautifulSoup cho dễ bảo trì. Chọn công cụ theo nhu cầu hiện tại của dự án, không theo thói quen.
Khi nào cần proxy cho Scrapy và BeautifulSoup và checklist trước khi chạy
Proxy không thay đổi lựa chọn giữa hai công cụ, nhưng cách gắn và cách kiểm thì khác. Phần này nói khi nào cần proxy, gắn ở đâu, và các bước kiểm trước khi chạy với site thật.
Gắn proxy ở mỗi bên
Khi nào cần proxy
Vài trăm request mỗi ngày tới một site không giới hạn thì chưa cần proxy. Proxy cần khi site giới hạn số request theo IP, khi nội dung khác nhau theo vùng, hoặc khi anh em muốn tách lưu lượng crawl khỏi IP văn phòng để không ảnh hưởng tới việc khác.
Bài web scraping proxy là gì giải thích cơ chế chung. Với nhiều dự án chạy song song, bài proxy pool hướng dẫn chia IP theo mục đích để một dự án bị chặn không kéo theo dự án khác.
Gắn proxy ở mỗi bên
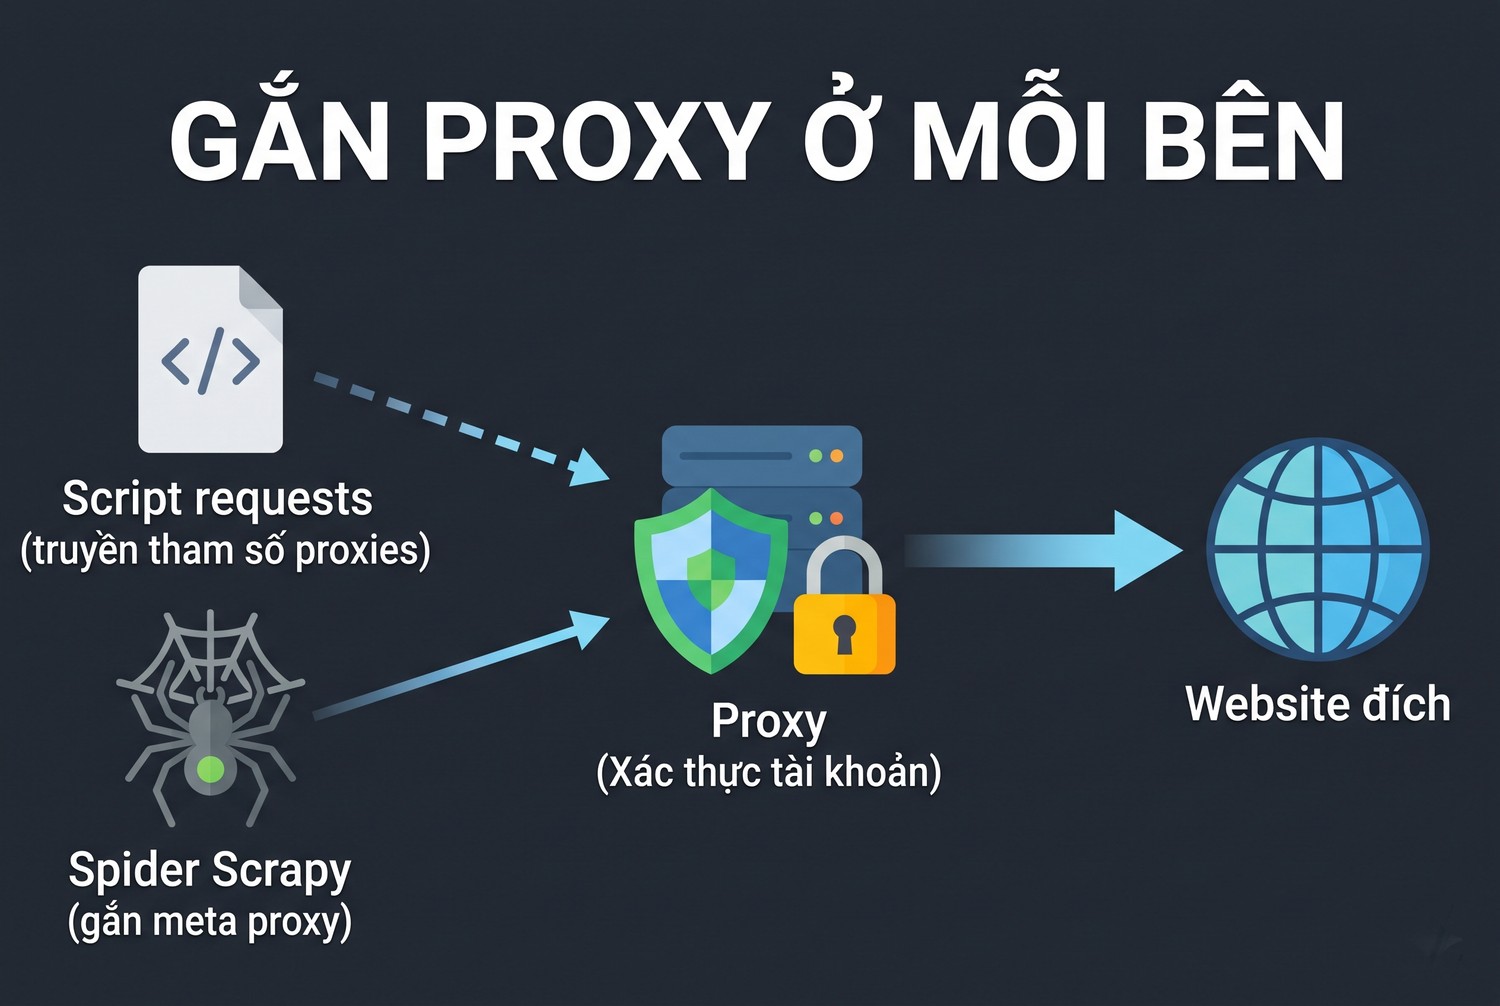
Với requests, proxy truyền qua tham số proxies ở từng lần gọi hoặc đặt cho cả Session. Bài cài đặt proxy trong thư viện requests có đủ các cách. Với Scrapy, theo tài liệu downloader middleware, HttpProxyMiddleware đọc khóa proxy trong meta của từng request, hoặc đọc biến môi trường http_proxy và https_proxy, giá trị trong meta được ưu tiên.
Muốn xoay proxy theo request trong Scrapy, anh em viết một downloader middleware gán meta proxy khác nhau cho mỗi request. Với requests, xoay proxy nghĩa là chọn proxy khác trước mỗi lần gọi trong hàm fetch.
Khi cần mua proxy giá rẻ cho dự án Scrapy hay script BeautifulSoup, ProxyVN có datacenter Việt Nam cho site ít chống bot, proxy dân cư tĩnh Viettel, VNPT, FPT và 4G cho site khó hơn. Proxy dùng giao thức HTTP hoặc SOCKS5, cấp user và password. Anh em nên thử một vài request với đúng công cụ sẽ dùng và xem log trước khi chạy số lượng lớn.
Checklist trước khi chạy với site thật
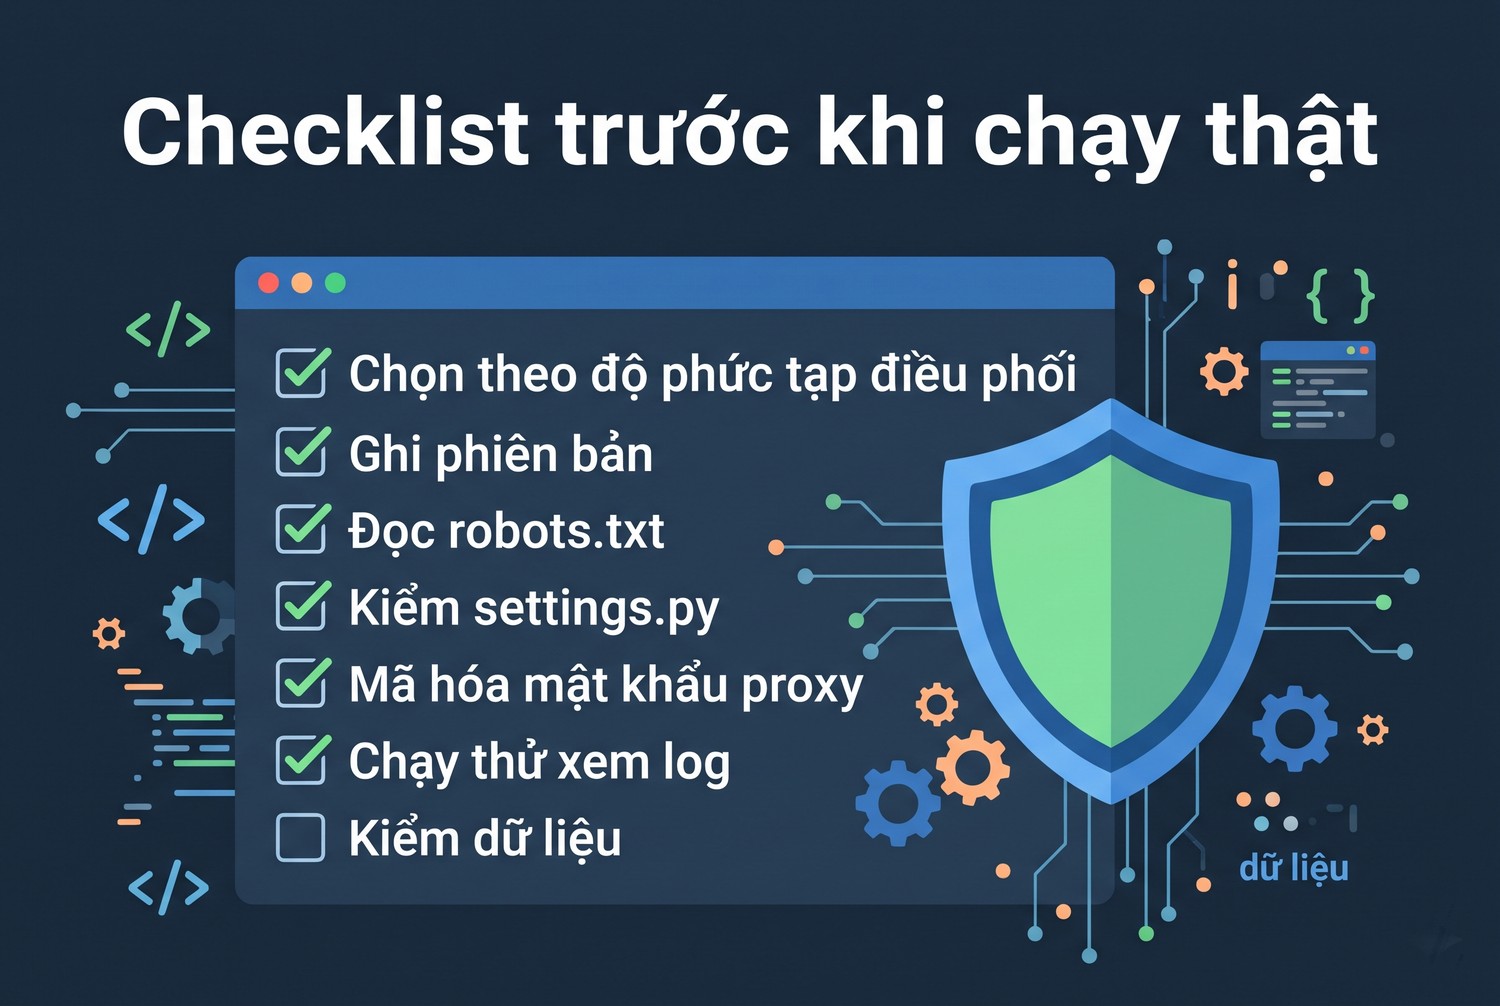
Danh sách dưới mình dùng trước mỗi dự án mới, cho cả hai công cụ:
- Chọn công cụ theo độ phức tạp của phần điều phối, không theo số trang.
- Ghi phiên bản Scrapy hoặc requests và BeautifulSoup vào file yêu cầu của dự án.
- Đọc robots.txt và điều khoản sử dụng; với Scrapy, kiểm ROBOTSTXT_OBEY đang bật.
- Kiểm settings.py: DOWNLOAD_DELAY và CONCURRENT_REQUESTS_PER_DOMAIN có hợp với site không.
- Mã hóa user và mật khẩu proxy bằng quote, dù công cụ đang dùng có chấp nhận chuỗi chưa mã hóa.
- Chạy thử vài trang, xem log proxy hoặc IP mà site nhìn thấy.
- Đặt điều kiện kiểm dữ liệu: số dòng, URL trùng, trường bắt buộc.
BeautifulSoup trả lời câu hỏi lấy dữ liệu gì từ một trang. Scrapy trả lời câu hỏi tải trang nào, lúc nào và làm gì khi lỗi.
Checklist trước khi chạy thật
Câu hỏi thường gặp
Người mới nên học BeautifulSoup hay Scrapy trước. BeautifulSoup trước, vì nó dạy cách đọc HTML và chọn phần tử, kiến thức dùng lại được trong Scrapy. Khi đã viết phần điều phối tới mức thấy rối, chuyển sang Scrapy sẽ hiểu ngay vì sao khung đó tồn tại.
Scrapy có nhanh hơn BeautifulSoup không. Trong bài thử, khi cùng chạy 8 request song song, Scrapy nhanh hơn một chút. Với một luồng, bản BeautifulSoup chậm gấp nhiều lần chỉ vì chờ mạng tuần tự, không phải vì phân tích chậm. Tốc độ phụ thuộc cách chạy song song nhiều hơn công cụ.
Có nên dùng BeautifulSoup bên trong Scrapy không. Được, khi đội đã có code phân tích viết sẵn bằng BeautifulSoup. Với dự án mới, selector của Scrapy đủ dùng và tránh phải đọc HTML hai lần.
Scrapy có chạy được trang cần đăng nhập không. Có, Scrapy giữ cookie giữa các request và có FormRequest để gửi biểu mẫu. Khi đăng nhập, anh em nên dùng proxy IP tĩnh để phiên không bị đứt do đổi IP giữa chừng.
Scrapy và BeautifulSoup, chọn sao cho hợp
Scrapy và BeautifulSoup đều lấy đủ 100/100 dòng trong bài thử. BeautifulSoup hợp với việc nhỏ, đọc từ trên xuống. Scrapy hợp khi điều phối, thử lại, giới hạn tốc độ thành phần chính. Nhớ kiểm settings.py và mã hóa mật khẩu proxy. Cần proxy ổn định, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam cho Scrapy và BeautifulSoup.


