Proxy Cào Review Sản Phẩm: Thu Thập Đánh Giá Quy Mô Lớn
Proxy cào review sản phẩm là hạ tầng giúp trình cào lấy đánh giá trên sàn thương mại điện tử với số lượng lớn mà không bị chặn sau vài chục trang. Sàn chặn IP đọc nhiều trang review liên tục, và một sản phẩm phổ biến có hàng nghìn đánh giá cần nhiều IP để lấy hết. Bài viết này ProxyVN trình bày cách chọn proxy, cấu hình trình cào, xử lý phân trang và làm sạch dữ liệu.
Vì sao cần proxy cào review sản phẩm
Đánh giá của khách là dữ liệu công khai nhưng khối lượng lớn và trải trên nhiều trang, nên việc lấy có hệ thống chạm ngay vào cơ chế chống tự động của sàn.
Sàn chặn IP đọc nhiều trang review liên tục
Một người thật hiếm khi lật hai mươi trang đánh giá trong một phút. Khi một IP làm đúng việc đó, sàn trả về CAPTCHA, mã 429, hoặc trang rỗng. Theo bài của IPRoyal về cào đánh giá, proxy che địa chỉ gốc và cho xoay qua nhiều IP để lưu lượng trông như đến từ nhiều người, kèm giả lập User-Agent của trình duyệt thật và đặt giới hạn tần suất hợp lý. Bao nhiêu request mỗi IP thì bắt đầu dính 429 được bàn cụ thể trong bài lỗi 429 khi mua proxy.
Review khác nhau theo miền sàn và theo vùng
Cùng một sản phẩm trên các tên miền sàn khác nhau, ví dụ bản quốc tế và bản nội địa, có tập đánh giá khác nhau. Một số sàn còn hiển thị đánh giá địa phương trước tùy vùng của người xem. Muốn lấy đủ, cào từ IP của từng vùng mục tiêu chứ không chỉ từ một nơi.
Dùng dữ liệu review để làm gì
Đánh giá đã thu thập phục vụ phân tích cảm xúc khách hàng, tìm lỗi sản phẩm hay bị nhắc, so điểm mạnh yếu với đối thủ, phát hiện đánh giá giả, và theo dõi phản ứng thị trường sau khi ra mắt hoặc đổi giá. Quy mô càng lớn thì kết luận càng vững.
Proxy đảm nhận việc gì cụ thể
Trong đường ống dữ liệu review, proxy làm ba việc. Một, phân tán request qua nhiều địa chỉ để không IP nào lật đủ nhiều trang tới mức bị đếm. Hai, đặt điểm xuất phát vào đúng vùng để lấy tập đánh giá mà khách vùng đó thấy, gồm cả đánh giá địa phương được ưu tiên hiển thị. Ba, khi phải cào theo nhiều lát cắt bộ lọc để vượt trần phân trang, giữ mỗi lát cắt trên một nhóm IP riêng để chúng không cộng dồn tần suất lên cùng một địa chỉ. Ba việc này không liên quan tới khâu phân tích HTML nhưng quyết định có đủ dữ liệu để phân tích hay không. Cách chia và xoay tập proxy cho một job cào lớn được hướng dẫn trong bài web scraping proxy là gì.
Chọn loại proxy cào review sản phẩm
Chọn theo độ khó của sàn và cách trang review được tải. Trang tĩnh và trang dựng bằng JavaScript cần cách tiếp cận khác nhau.
Dân cư xoay cho sàn lớn, datacenter cho site nhẹ
Các sàn lớn có tường chống bot dày, chặn IP datacenter nhanh, nên cần proxy dân cư xoay phân tán qua nhiều nhà mạng. Với diễn đàn hoặc site nhỏ ít bảo vệ, proxy datacenter chạy nhanh và rẻ hơn. Thử datacenter trước, chỉ nâng lên dân cư khi gặp chặn. Khác biệt giữa datacenter và dân cư quyết định sàn nào cào được bằng loại nào được phân tích trong bài so sánh proxy dân cư và datacenter.
Selenium hay request thuần
Nếu trang trả về đầy đủ review trong HTML ban đầu thì dùng request thuần kèm phân tích HTML là đủ và nhanh. Nếu review chỉ hiện sau khi trang chạy JavaScript hoặc sau khi bấm xem thêm, cần trình duyệt tự động như Selenium hoặc Playwright. Trình duyệt tự động nặng hơn nhưng qua được nội dung động và một số thử thách.
Xoay User-Agent đi kèm xoay IP
Đổi IP mà giữ nguyên một User-Agent cho mọi request vẫn để lộ mẫu bot. Xoay User-Agent theo một danh sách trình duyệt thật, đi kèm Accept-Language khớp vùng, để mỗi request trông như một phiên khác nhau.
Đặt giới hạn tần suất có đạo đức
Bài của IPRoyal khuyên đặt giới hạn request hợp lý để không làm quá tải máy chủ đích. Ngoài lý do lịch sự, tần suất thấp cũng giúp trình cào sống lâu hơn: một IP đọc review với nhịp giống người thật ít bị gắn cờ hơn nhiều so với IP quét dồn. Ước lượng số trang một người thật xem trong một giờ rồi giữ mỗi IP dưới mức đó. Các quy tắc giữ nhịp để trình cào sống lâu và không bị cấm IP được liệt kê trong bài cách tránh bị cấm proxy.
Review sau tường đăng nhập cần IP tĩnh
Phần lớn đánh giá là công khai, không cần đăng nhập. Nhưng nếu nguồn yêu cầu tài khoản để xem đầy đủ, ví dụ một số diễn đàn hoặc trang thành viên, thì luồng đó cần IP tĩnh hoặc phiên giữ IP để không bị đăng xuất giữa chừng. Tách luồng này khỏi pool xoay dùng cho phần công khai.
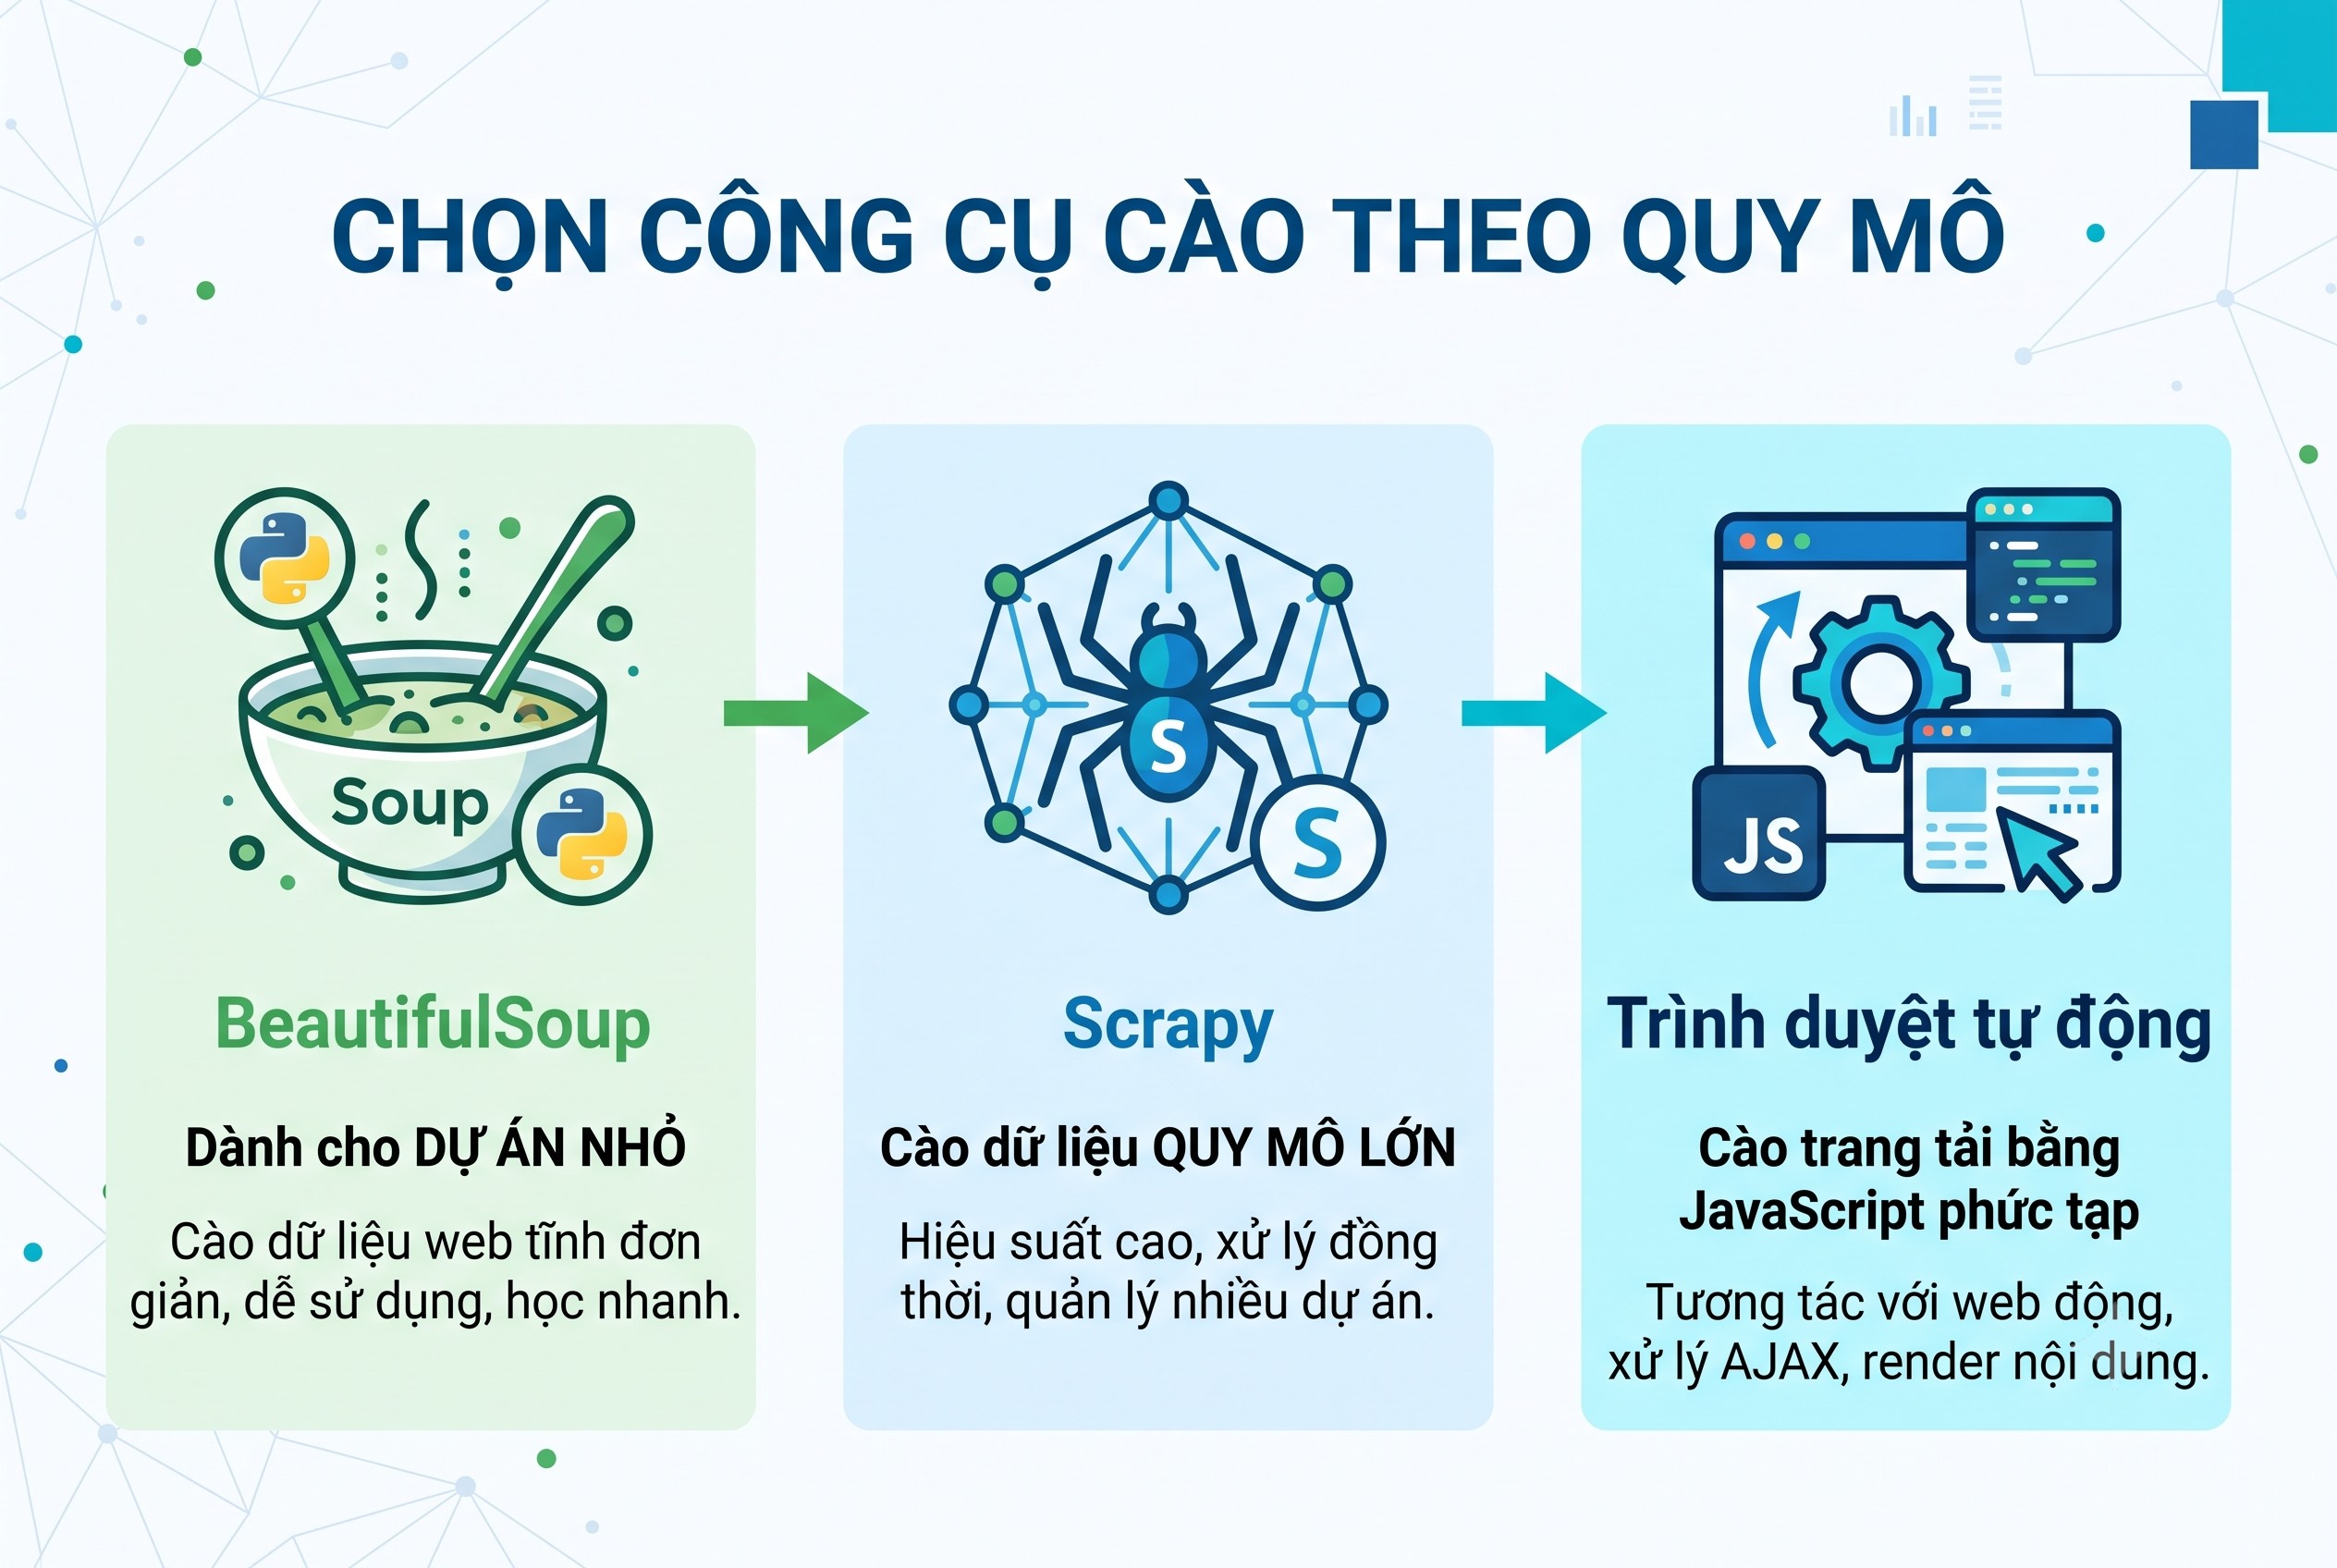
|
Công cụ |
Hợp với |
Ghi chú |
|---|---|---|
|
BeautifulSoup |
Dự án nhỏ, HTML tĩnh |
Nhẹ, dễ bắt đầu, tự lo phần điều phối |
|
Scrapy |
Quy mô lớn, nhiều sản phẩm |
Có sẵn xử lý lỗi và hàng đợi, nhưng cần học |
|
Selenium hoặc Playwright |
Trang tải review bằng JavaScript |
Chạy trình duyệt thật, nặng hơn, qua được nội dung động |
Chọn công cụ cào theo quy mô
Cấu hình proxy cào review sản phẩm cho một trình cào
Ba việc: dựng đúng URL trang review theo mã sản phẩm, lặp qua các trang, và xoay proxy cùng User-Agent ở mỗi request.
Cấu trúc URL trang review và mã sản phẩm
Bài của IPRoyal về trình cào đánh giá Amazon chỉ ra rằng nhiều sàn có một đường dẫn riêng cho trang đánh giá, tách khỏi trang sản phẩm để bớt phần thừa. Mã định danh sản phẩm, như ASIN trên Amazon, thường nằm ngay trong URL sau đoạn dp. Lấy mã này làm khóa để dựng URL trang review và để gom dữ liệu.
Vòng lặp phân trang qua proxy
Trang đánh giá dùng tham số số trang. Lặp tăng dần số trang, mỗi vòng chọn một proxy và một User-Agent, chèn khoảng nghỉ ngẫu nhiên vài giây. Dừng khi trang không còn đánh giá mới hoặc khi chạm trần phân trang của sàn.
Ví dụ trình cào review bằng Python
Đoạn dưới là ví dụ triển khai chung: cào review một sản phẩm, phân trang, xoay proxy và User-Agent, khử trùng lặp theo cặp tiêu đề và ngày, xuất tệp JSON.
# Vi du trien khai chung: cao review mot san pham, phan trang, xoay proxyimport requests, time, random, jsonfrom bs4 import BeautifulSoupPROXIES = [ "http://user:[email protected]:8000", "http://user:[email protected]:8000",]UA = [ "Mozilla/5.0 (Windows NT 10.0; Win64; x64) Chrome/120.0", "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) Chrome/120.0",]def tai_trang(ma_sp, trang): proxy = random.choice(PROXIES) url = ("https://san.example/product-reviews/" + ma_sp + "?pageNumber=" + str(trang) + "&sortBy=recent") r = requests.get(url, timeout=30, headers={"User-Agent": random.choice(UA), "Accept-Language": "vi-VN,vi;q=0.9"}, proxies={"http": proxy, "https": proxy}) return r.textdef doc_review(html): soup = BeautifulSoup(html, "html.parser") out = [] for r in soup.select("[data-hook='review']"): out.append({ "sao": r.select_one("[data-hook='review-star-rating']").get_text(strip=True)[:3], "tieu_de": r.select_one("[data-hook='review-title']").get_text(strip=True), "noi_dung": r.select_one("[data-hook='review-body']").get_text(" ", strip=True), "ngay": r.select_one("[data-hook='review-date']").get_text(strip=True), }) return outdef cao_het(ma_sp, so_trang=10): tat_ca, da_thay = [], set() for t in range(1, so_trang + 1): for rv in doc_review(tai_trang(ma_sp, t)): khoa = (rv["tieu_de"], rv["ngay"]) if khoa not in da_thay: da_thay.add(khoa) tat_ca.append(rv) time.sleep(random.uniform(3, 7)) return tat_cajson.dump(cao_het("ABC123"), open("review.json", "w", encoding="utf-8"), ensure_ascii=False, indent=2)
Lấy được nghìn review đầu tiên là phần dễ. Phần khó là biết sàn đã chặn anh em ở đâu và những review nào anh em chưa hề thấy.
Phân trang và giới hạn khi dùng proxy cào review sản phẩm
Đây là chỗ nhiều người tưởng đã lấy hết trong khi thực ra mới lấy một phần. Sàn giới hạn số trang đánh giá xem được cho mỗi sản phẩm.
Trần khoảng 1000 review mỗi sản phẩm
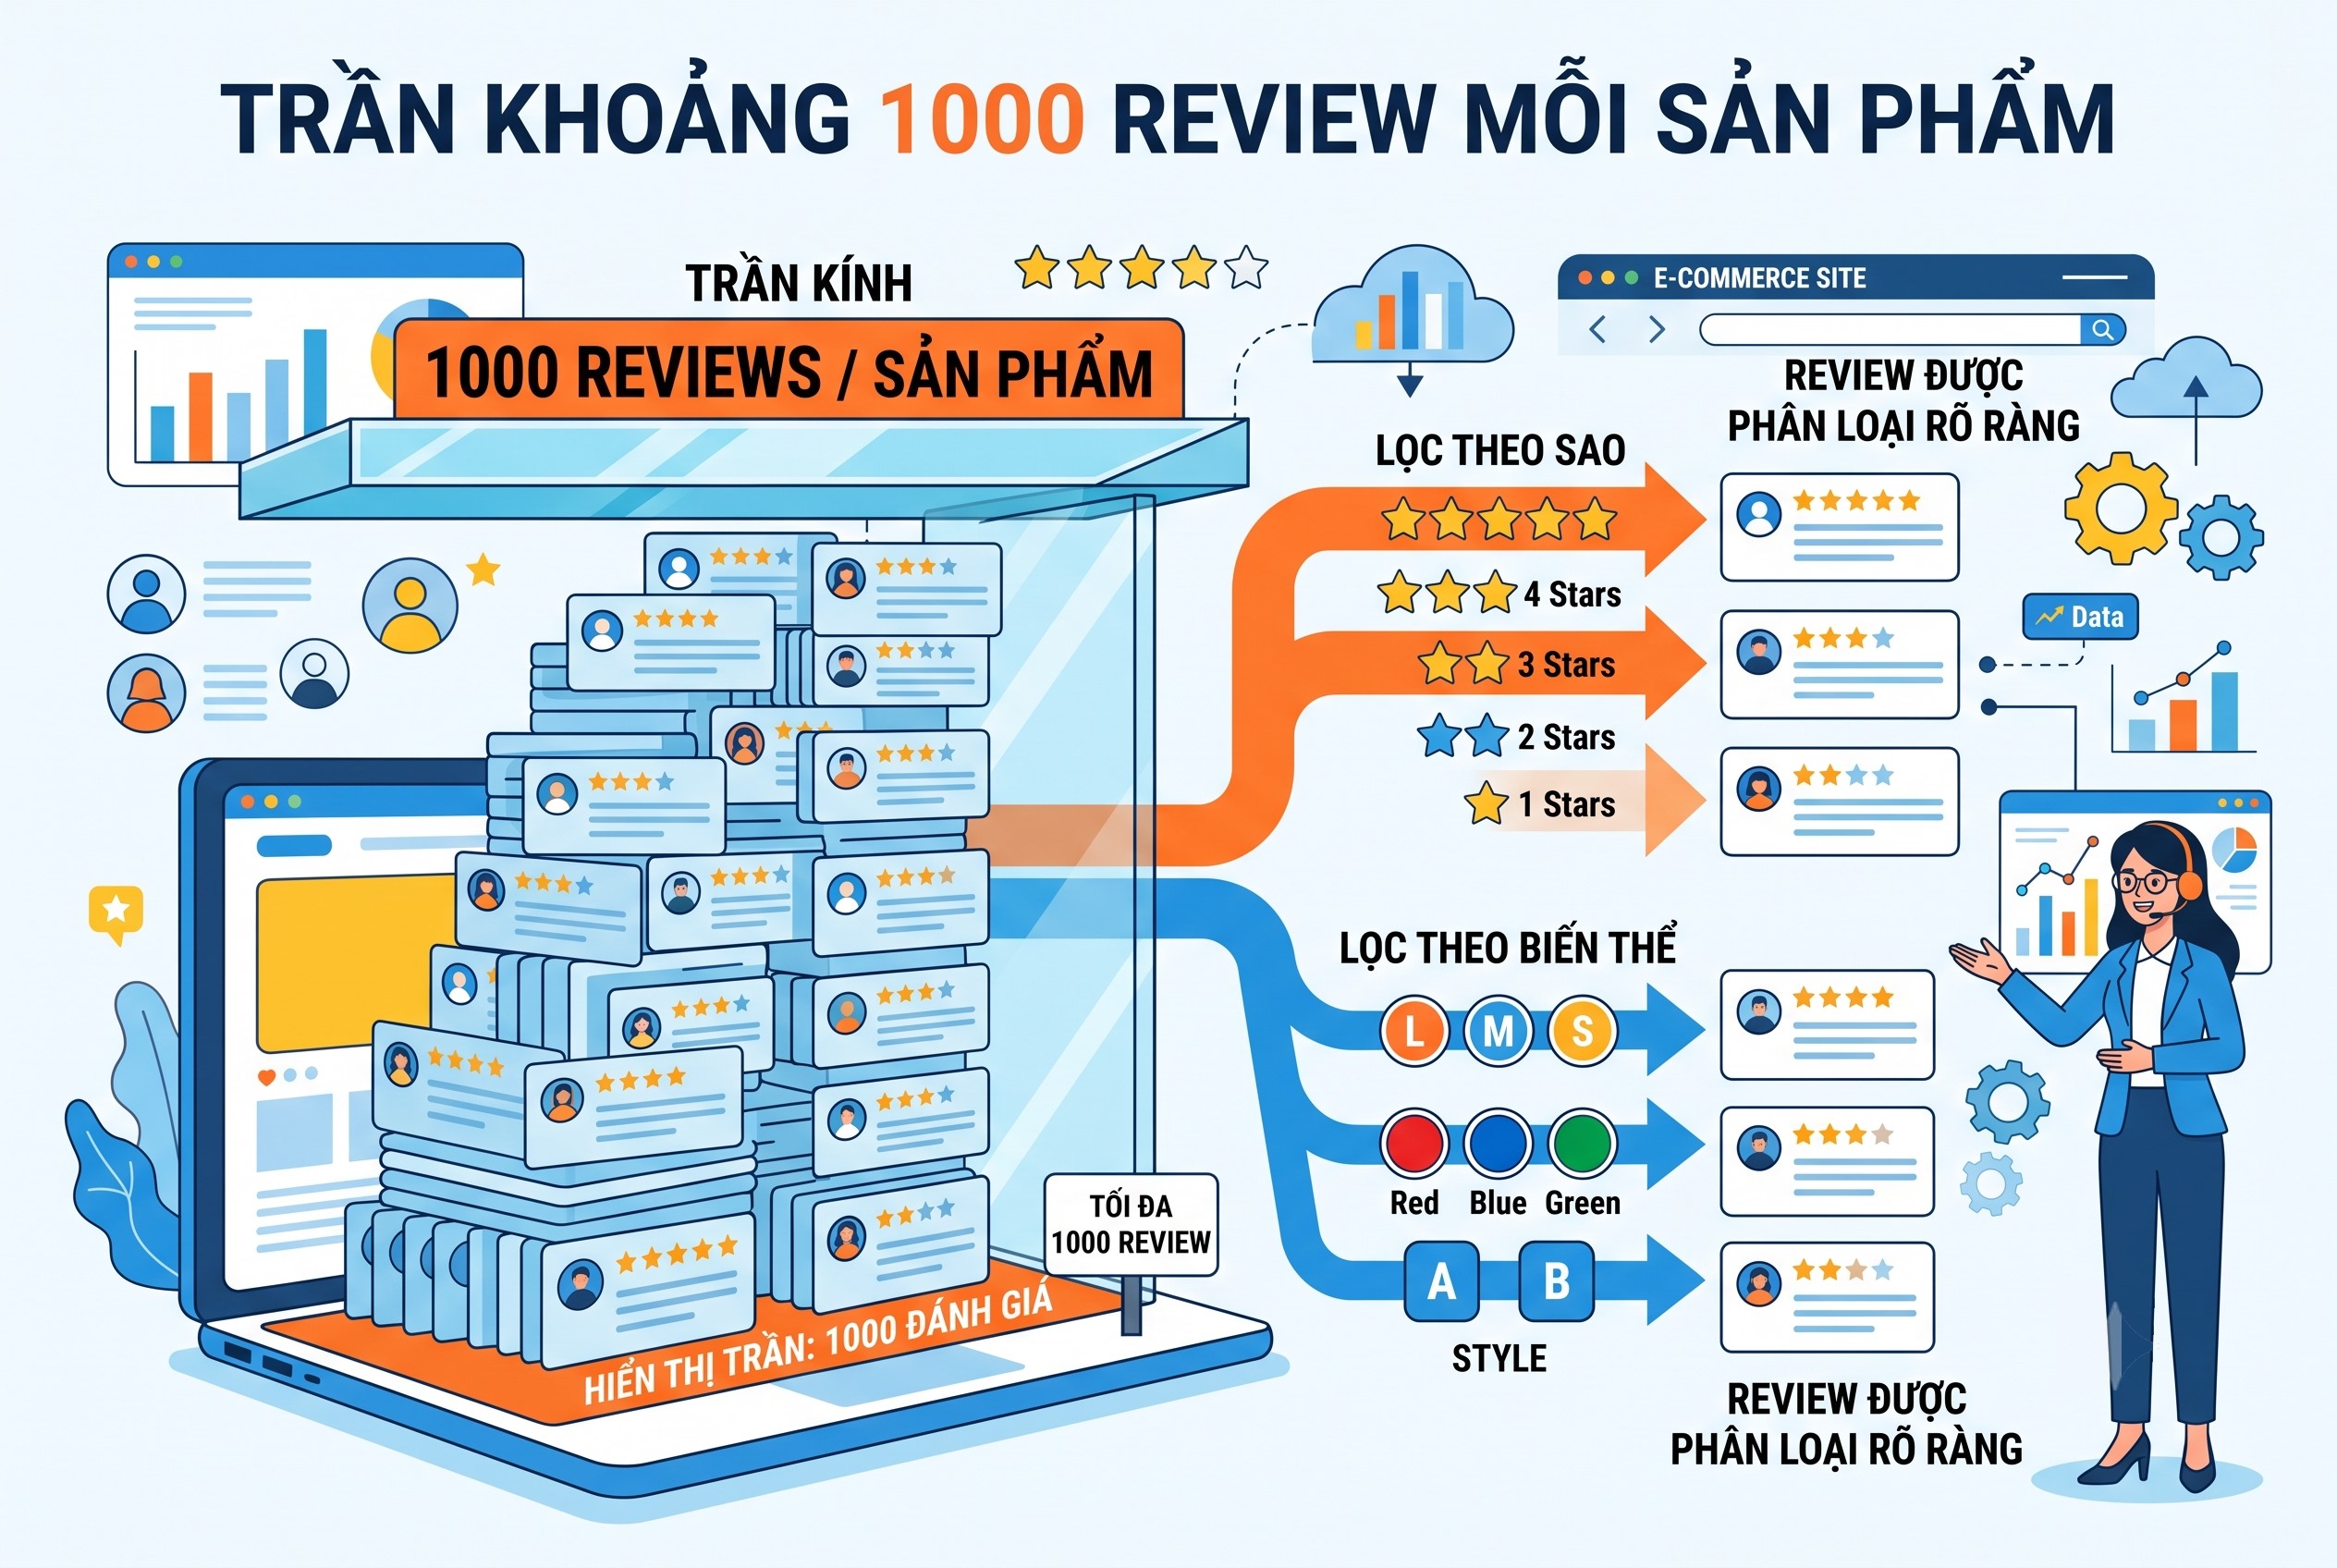
Bài của IPRoyal cho biết Amazon thường chặn phân trang ở mức khoảng 1000 đánh giá cho một sản phẩm. Sản phẩm có 8000 đánh giá thì lối phân trang thường chỉ cho tới trang chứa đánh giá thứ 1000, phần còn lại không truy cập theo cách thông thường.
Lách trần bằng tổ hợp bộ lọc rồi khử trùng lặp
Cách vượt trần là cào theo từng bộ lọc rồi ghép lại. Chạy riêng cho từng mức sao, riêng cho từng biến thể sản phẩm, riêng cho từng khoảng ngày. Mỗi lát cắt có dưới 1000 đánh giá nên lấy được trọn. Sau đó khử trùng lặp bằng một khóa ổn định như mã đánh giá, hoặc cặp tác giả và thời điểm.
Sắp xếp Mới nhất để lọc theo khoảng ngày
Trang đánh giá thường cho sắp xếp theo Nổi bật hoặc Mới nhất. Chọn Mới nhất khi cần lọc theo khoảng thời gian, vì thứ tự theo ngày giúp biết khi nào đã đi qua hết khoảng cần lấy và dừng đúng lúc.
Ước lượng độ phủ đã lấy được
Trần phân trang tồn tại vì sàn không muốn ai rút toàn bộ kho đánh giá một cách máy móc. Chấp nhận điều đó và chuyển sang đo độ phủ: lấy tổng số đánh giá sàn công bố làm mẫu số, số bản ghi duy nhất lấy được làm tử số. Nếu tỉ lệ thấp, thêm lát cắt bộ lọc. Với nhiều phân tích, một mẫu vài nghìn đánh giá trải đều các mức sao và các mốc thời gian đã đủ đại diện, không nhất thiết phải lấy trọn.
Trần khoảng 1000 review mỗi sản phẩm
Trích xuất và làm sạch dữ liệu review
Dữ liệu thô lấy về còn lẫn thẻ HTML, định dạng ngày mỗi vùng một kiểu, và bản ghi trùng. Làm sạch trước khi phân tích để kết quả đáng tin.
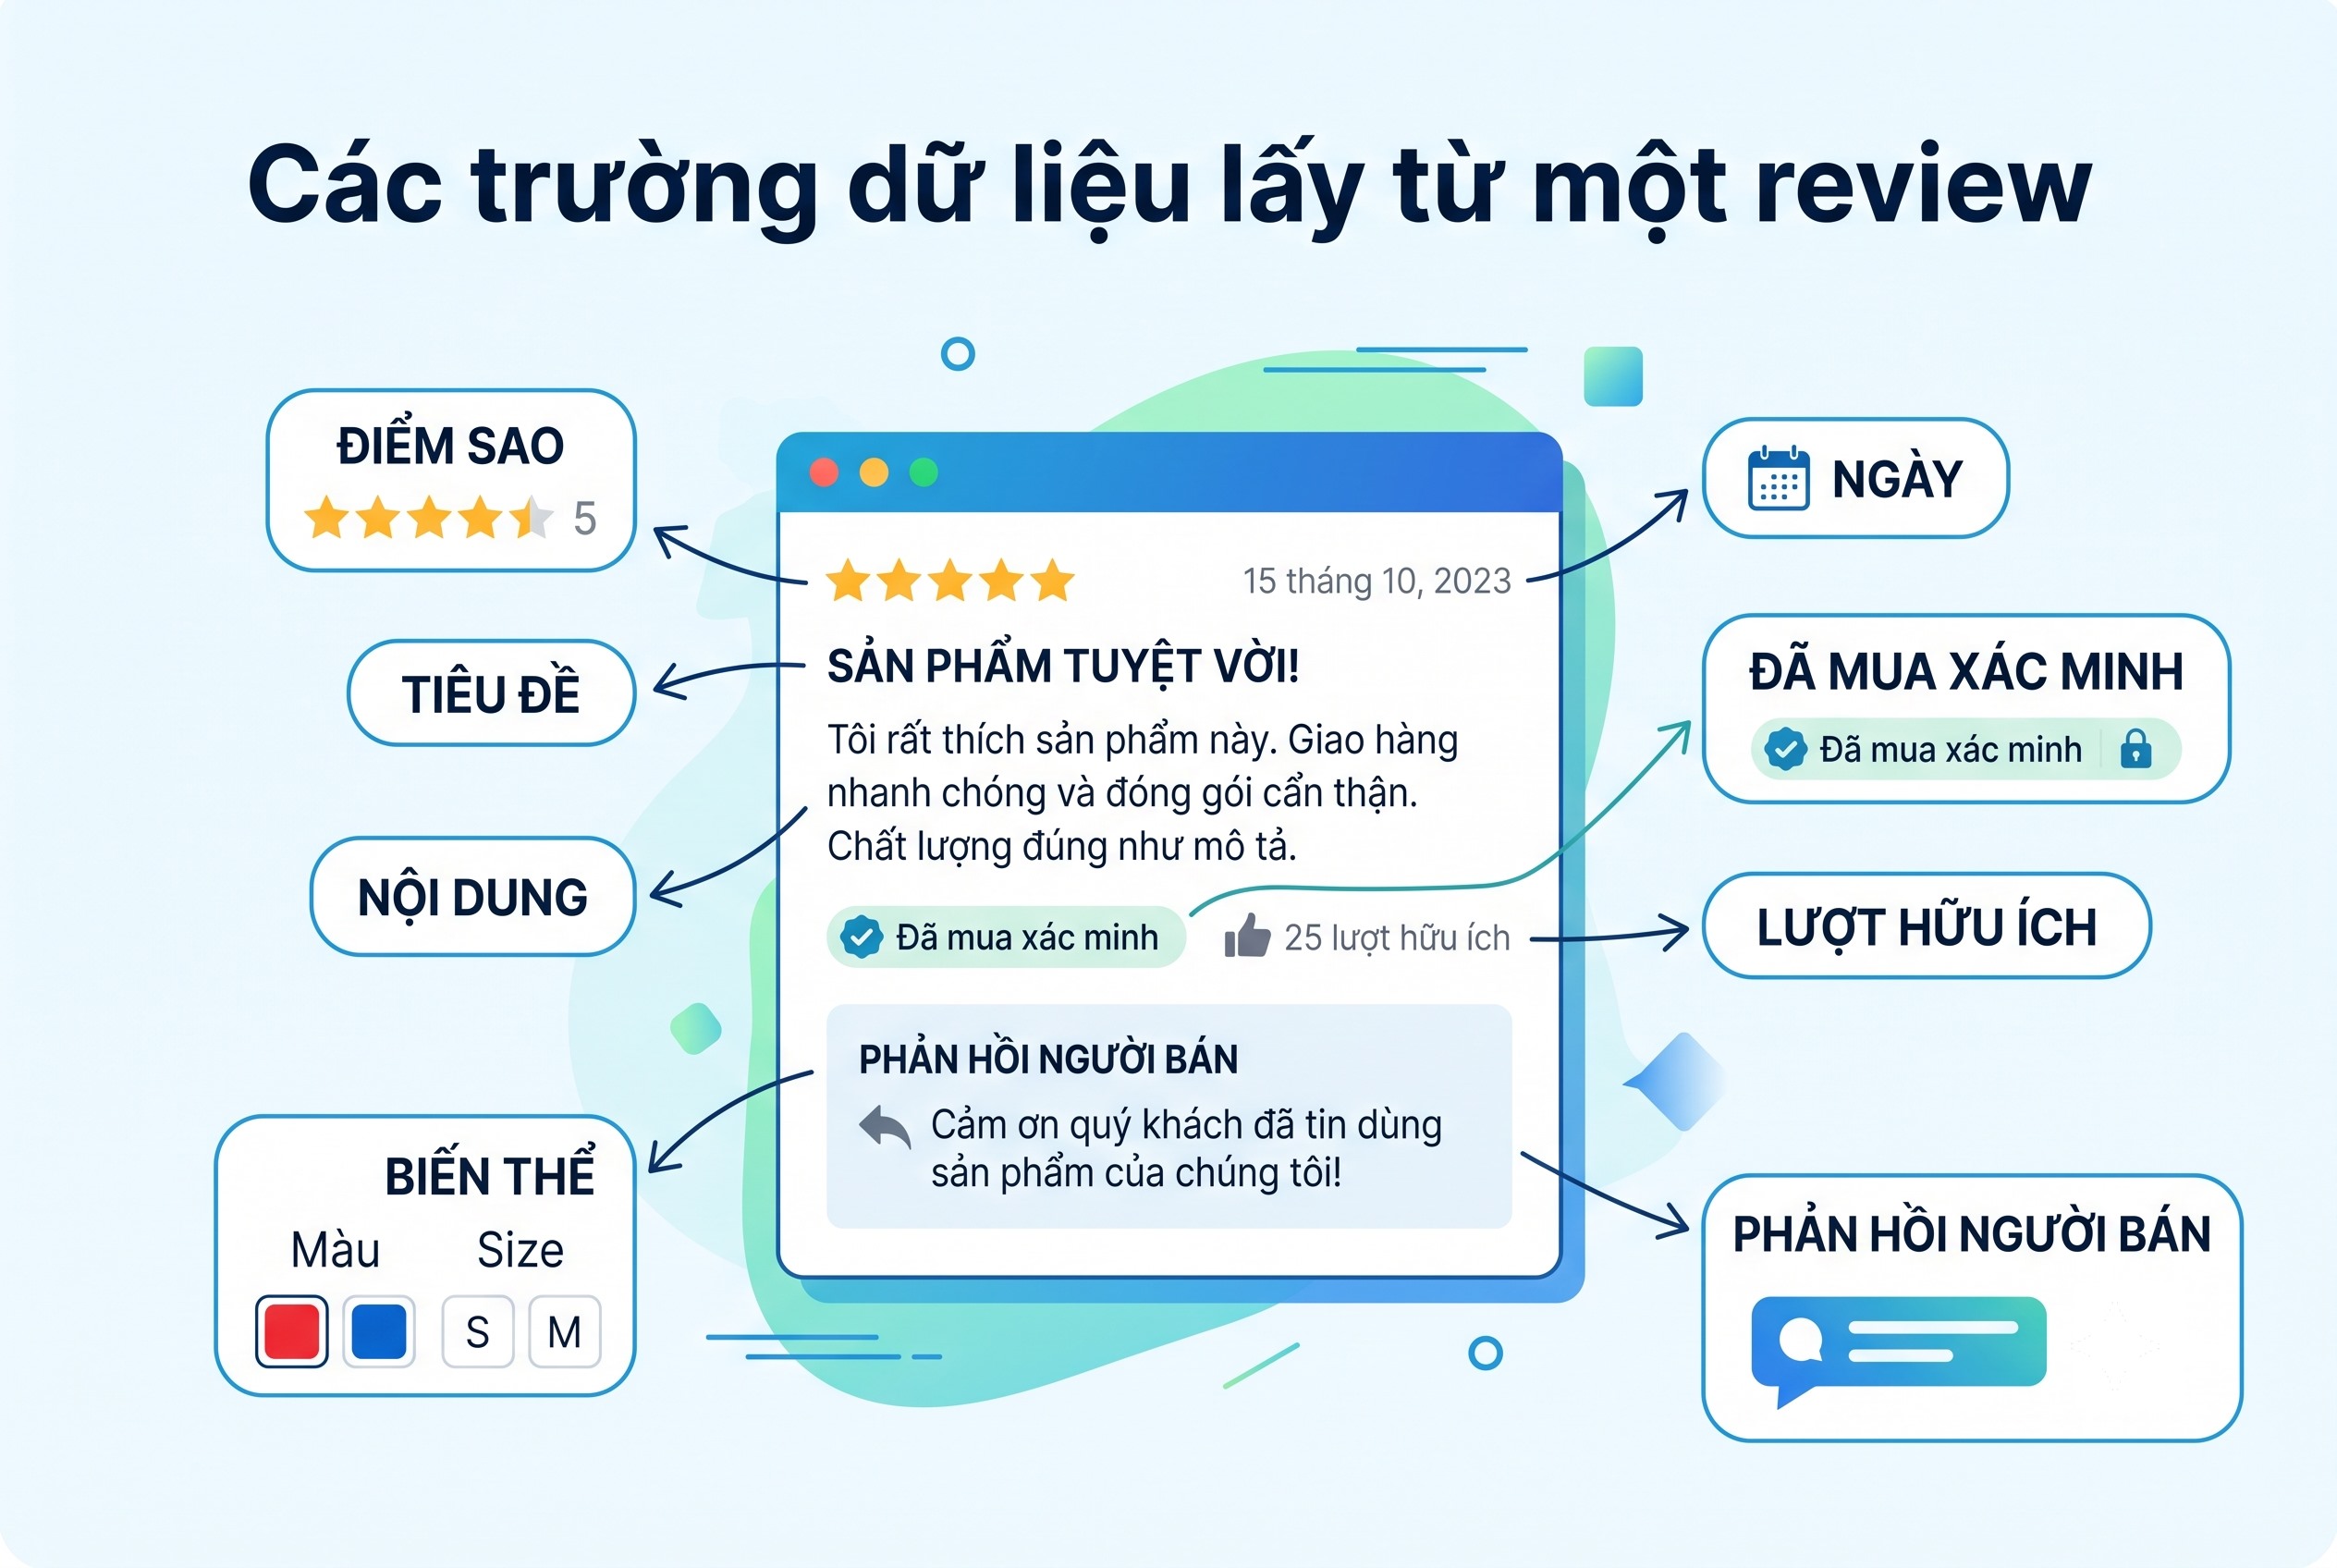
Các trường cần lấy từ mỗi review
Ngoài điểm sao và nội dung, nên lấy đủ các trường để phân tích sâu hơn về sau.
|
Trường |
Mô tả |
|---|---|
|
Điểm sao |
Số sao trên thang 1 đến 5 |
|
Tiêu đề và nội dung |
Tiêu đề ngắn và phần thân đánh giá |
|
Ngày |
Thời điểm đăng, chuẩn hóa về dạng năm-tháng-ngày |
|
Đã mua hàng xác minh |
Cờ cho biết người viết đã mua qua sàn |
|
Lượt thấy hữu ích |
Số người bình chọn đánh giá này có ích |
|
Biến thể |
Màu, kích cỡ hoặc cấu hình sản phẩm được đánh giá |
|
Phản hồi của người bán |
Trả lời của người bán nếu có |
Chuẩn hóa ngày, điểm sao, bỏ thẻ HTML
Bỏ các thẻ HTML còn sót và khoảng trắng thừa trong nội dung. Đưa ngày về một định dạng thống nhất năm-tháng-ngày. Đưa điểm sao về số nguyên hoặc số thực trên thang 1 đến 5, vì nhiều trang ghi dạng chuỗi như 4,0 trên 5 sao.
Khử trùng lặp giữa các lần chạy
Chạy cào nhiều lần trong tuần sẽ lấy lại các đánh giá cũ. Giữ một khóa duy nhất cho mỗi đánh giá và bỏ qua bản đã có. Khi ghép dữ liệu từ nhiều bộ lọc như ở phần phân trang, bước khử trùng lặp này là bắt buộc, nếu không số liệu bị đếm nhiều lần.
Giữ lại HTML thô và bối cảnh mỗi lần cào
Lưu kèm mỗi bản ghi vài trường bối cảnh: vùng IP đã dùng, ngày giờ cào, URL nguồn, và nếu có thể thì cả đoạn HTML thô của khối đánh giá. Khi bộ chọn CSS hỏng vì sàn đổi giao diện, HTML thô cho phép phân tích lại mà không phải cào lại từ đầu. Bối cảnh vùng và thời gian giúp về sau lọc đúng nhóm dữ liệu cần dùng.
Phân tích cảm xúc và ngôn ngữ là bước sau
Việc gán nhãn tích cực hay tiêu cực, nhận diện ngôn ngữ, gom chủ đề hay bị nhắc là các bước xử lý sau, tách khỏi khâu cào. Tách bạch như vậy giúp anh em chạy lại phần phân tích với mô hình tốt hơn mà không cần đụng tới dữ liệu thô đã lưu.
Các trường dữ liệu lấy từ một review
Build hay mua công cụ proxy cào review sản phẩm
Hai hướng, chọn theo mức tùy biến và độ ổn định cần có.
API cào review cho nhu cầu ổn định
Theo tài liệu cào đánh giá của Decodo, một API cào review nhận tham số như target chỉ nguồn, query là mã sản phẩm, page_from để phân trang, parse để bật phân tích, rồi trả về các trường gồm điểm sao, phân bố sao, tiêu đề, nội dung, tác giả, thời điểm, cờ đã mua xác minh, lượt hữu ích và phản hồi người bán. API lo phần proxy và vượt CAPTCHA, tự thử lại khi lỗi, tính tiền theo request thành công. Giới hạn tốc độ theo gói dao động từ khoảng mười request mỗi giây ở gói thấp tới năm mươi request mỗi giây ở gói cao, đủ cho phần lớn nhu cầu cào định kỳ.
Tự dựng trình cào cho tùy biến sâu
Tự dựng cho toàn quyền chọn nguồn, chọn bộ lọc lách trần, chọn cách làm sạch. Đổi lại phải tự lo proxy, tự bảo trì bộ chọn khi sàn đổi giao diện. Hợp khi cần cào nhiều sàn lạ hoặc cần logic ghép dữ liệu riêng.
Khi API cho nguồn đó tạm ngừng
Có lúc API cào review cho một sàn cụ thể tạm ngừng phục vụ. Tại thời điểm viết bài, trang cào đánh giá Amazon của Decodo ghi rõ phần lấy dữ liệu đánh giá đang không khả dụng dù phần dữ liệu sản phẩm vẫn chạy. Nếu quy trình chỉ dựa vào một API, nên có sẵn một trình cào tự dựng làm phương án dự phòng cho các nguồn quan trọng.
Lỗi thường gặp khi dùng proxy cào review sản phẩm
Vài lỗi khiến dữ liệu thiếu hoặc trình cào bị chặn sớm.
Cào quá nhanh trên một IP
Lật hàng chục trang đánh giá mỗi phút từ một địa chỉ là chạm ngưỡng ngay. Giới hạn số luồng trên một IP, thêm độ trễ thật giữa các trang, và chia tải ra nhiều IP thay vì ép một địa chỉ chạy nhanh. Cách dựng pool proxy và chia đều tải cho việc cào được nói trong bài proxy pool là gì.
Bỏ qua trần phân trang, tưởng đã lấy hết
Cào tới trang cuối mà lối phân trang cho phép rồi kết luận đã lấy hết là sai khi sản phẩm có nhiều nghìn đánh giá. So tổng số đánh giá sàn công bố với số bản ghi lấy được; chênh lệch lớn nghĩa là còn phần sau trần chưa chạm tới.
Không xử lý review đa ngôn ngữ và biến thể
Một sản phẩm bán nhiều nước có đánh giá bằng nhiều thứ tiếng, và mỗi biến thể màu hoặc dung lượng có luồng đánh giá riêng. Ghi lại ngôn ngữ và biến thể cho mỗi bản ghi, để phân tích sau này không trộn nhầm các nhóm khác nhau.
Không đối chiếu định kỳ với trình duyệt thật
Trình cào có thể vẫn chạy trơn nhưng dữ liệu đã sai từ lâu vì sàn đổi bố cục hoặc trả bản rút gọn cho IP nghi ngờ. Mỗi tuần mở thủ công vài sản phẩm bằng trình duyệt thật qua đúng proxy vùng, so vài đánh giá đầu với dữ liệu trình cào lấy được. Lệch một cách hệ thống là dấu hiệu cần rà lại bộ chọn hoặc đổi nhóm IP.
Checklist rút gọn
-
Thử datacenter trước, nâng lên proxy dân cư xoay khi gặp chặn. Nguồn proxy datacenter và dân cư xoay cho job cào review có tại trang mua proxy.
-
Xoay IP và User-Agent cùng lúc, thêm độ trễ giữa các trang.
-
Cào theo tổ hợp bộ lọc để vượt trần khoảng 1000 review mỗi sản phẩm.
-
Khử trùng lặp bằng một khóa ổn định trước khi phân tích.
-
So số bản ghi lấy được với tổng đánh giá sàn công bố.
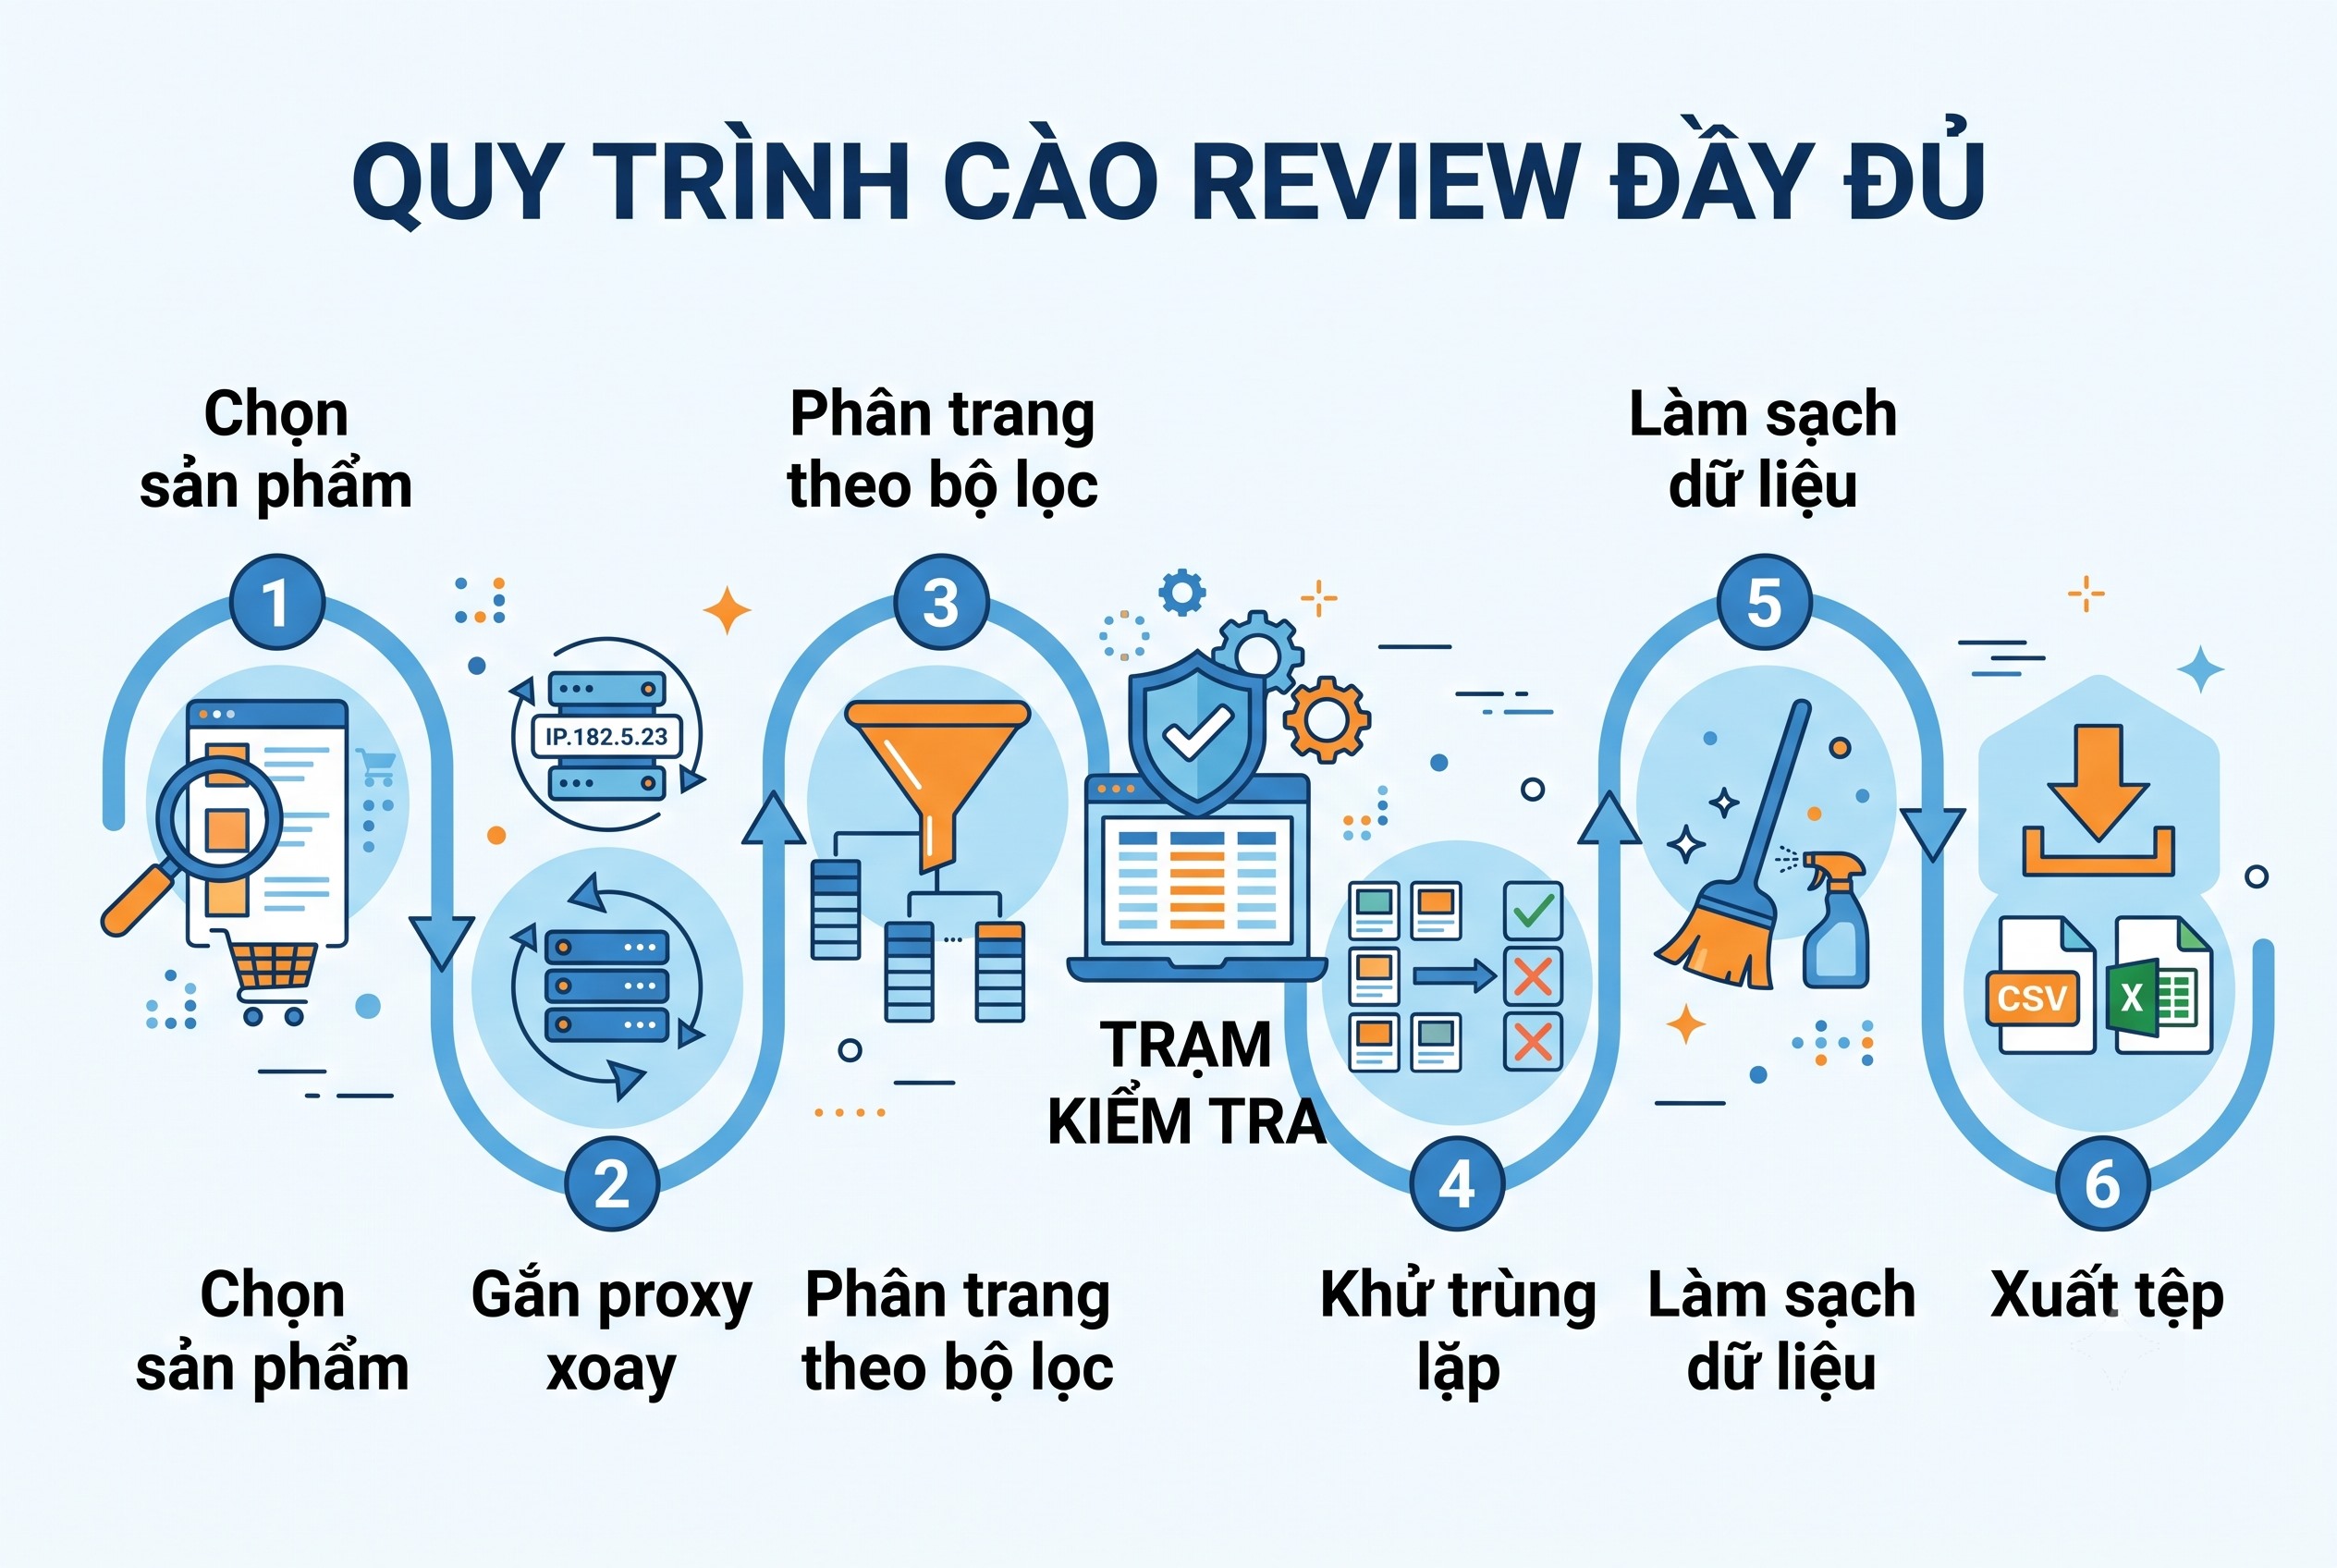
Quy trình cào review đầy đủ
Tóm lại, proxy cào review sản phẩm là chọn loại IP theo độ khó của sàn, xoay IP cùng User-Agent, lặp phân trang có độ trễ, và biết cách vượt trần khoảng 1000 đánh giá bằng tổ hợp bộ lọc rồi khử trùng lặp. Làm sạch dữ liệu trước khi phân tích để kết luận đáng tin. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam tư vấn anh em chọn proxy theo sàn và quy mô đánh giá cần thu thập.


