JSON Text Sequences streaming: đọc json-seq và phục hồi lỗi
JSON Text Sequences streaming là cách đọc dòng dữ liệu application/json-seq, nơi mỗi bản ghi JSON được mở đầu bằng ký tự RS 0x1E và kết thúc bằng LF. Định dạng này do RFC 7464 định nghĩa, với mục tiêu rõ ràng: một bản ghi hỏng không được kéo theo cả dòng dữ liệu. ProxyVN dựng một byte fixture có bản ghi hỏng, số bị cắt, byte không phải UTF-8 và bản ghi dở ở cuối. Fixture được phát qua máy chủ chunked tự viết, rồi đọc bằng httpx và requests thật với một parser theo RFC.
JSON Text Sequences streaming: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và ranh giới với các bài đã có.
Bài toán cần giải
Một API xuất dữ liệu sản phẩm theo luồng, mỗi sản phẩm một bản ghi. Giữa luồng có một bản ghi bị cắt do lỗi phía nguồn. Client đọc cả luồng bằng một lần json.loads thì hỏng toàn bộ. Client đọc từng dòng như JSONL thì dừng ở dòng hỏng, hoặc mất luôn những bản ghi xuống dòng bên trong. Dữ liệu tốt phía sau bị bỏ phí.
Đầu ra nghiệm thu
Đầu ra là một byte fixture 677 byte với tám bản ghi hợp lệ mã 1 tới 8, xen các lỗi có chủ đích. Parser phải đọc được đủ tám bản ghi theo đúng thứ tự, báo lỗi riêng cho từng phần tử hỏng, và cho cùng kết quả bất kể dòng dữ liệu được cắt thành chunk 7 byte hay 64 byte.
Ranh giới với bài JSONL
Bài DuckDB xử lý dữ liệu crawl JSONL dùng JSON Lines, mỗi dòng một bản ghi, phân tách bằng LF. Bài này không lặp JSONL. Json-seq dùng RS làm dấu mở đầu, nên một bản ghi được phép xuống dòng bên trong. Lab sẽ cho thấy đúng điểm khác này làm parser JSONL đọc sai.
Ranh giới với bài ijson
Bài ijson đọc JSON lớn từ web đọc một tài liệu JSON rất lớn dạng mảng mà không nạp hết vào bộ nhớ. Đó vẫn là một tài liệu duy nhất, hỏng một chỗ là hỏng cả. Json-seq là nhiều tài liệu nối nhau, hỏng chỗ nào bỏ chỗ đó. Hai bài giải hai bài toán khác nhau.
Giới hạn của lab
Máy chủ là http.server tự viết ở 127.0.0.1:9771, phát fixture bằng Transfer-Encoding chunked với kích thước chunk do lab chọn. Fixture do ProxyVN dựng tay. Parser SeqParser do ProxyVN viết theo RFC 7464, không phải thư viện có sẵn. Thứ thật trong lab là httpx 0.28.1, requests 2.34.2 và module json của Python 3.12.10.
Ai nên đọc
Người tiêu thụ API trả luồng sự kiện hoặc luồng bản ghi. Người viết log có cấu trúc dạng nối thêm, nơi tiến trình có thể chết giữa lúc ghi. Người cần chọn giữa JSONL và json-seq cho định dạng xuất dữ liệu crawl.
Đọc application/json-seq với record separator và phục hồi sau record lỗi trong JSON Text Sequences streaming
Phần này tóm tắt RFC 7464, chỉ giữ ý cần cho parser.
Định dạng này dùng ở đâu
Json-seq hợp với các dòng dữ liệu nối thêm: log có cấu trúc, luồng sự kiện, kết quả truy vấn trả dần. Nó cũng hợp với tệp mà tiến trình ghi có thể bị dừng bất ngờ, vì phần đã ghi xong vẫn đọc được. RFC nhắc đúng tình huống tệp log bị hệ tệp cắt khi tiến trình chết.
Hai bộ quy tắc
RFC 7464 đưa ra hai bộ ABNF: một cho parser, một cho encoder. Lý do: parser phải chịu được phần tử bị cắt, còn encoder thì phải tạo phần tử hoàn chỉnh. Tách hai bộ quy tắc cho phép parser phục hồi mà không nới lỏng yêu cầu với phía ghi.
Quy tắc cho encoder
RS mở đầu, LF kết thúc
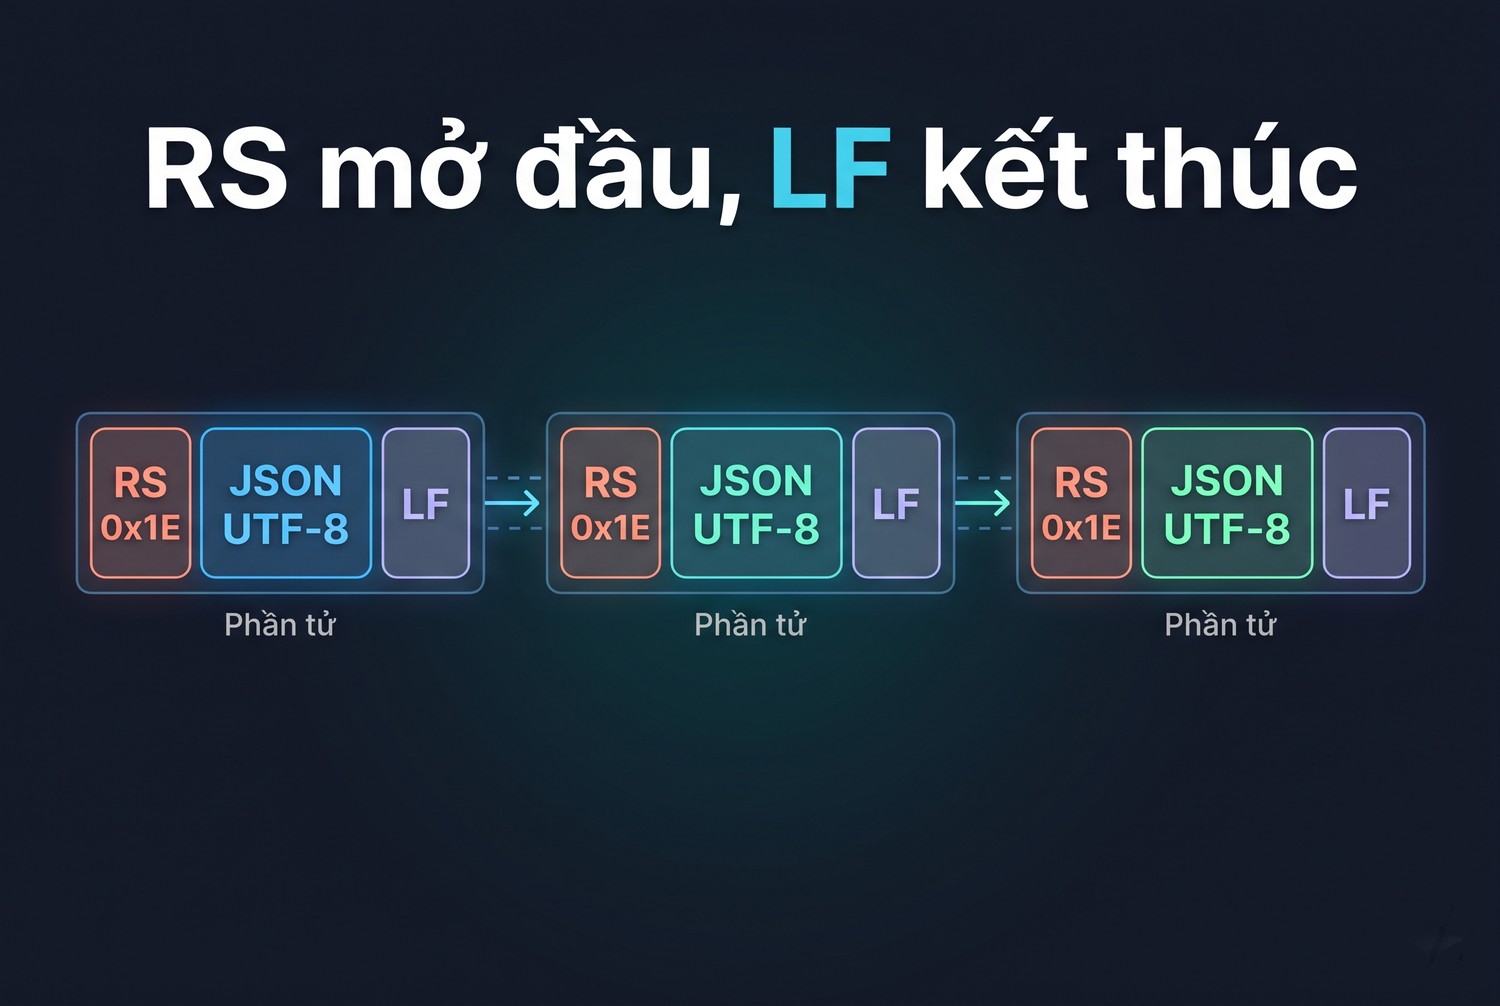
Encoder ghi mỗi văn bản JSON theo dạng RS, văn bản JSON, LF. RS là byte 0x1E. Văn bản JSON phải mã hóa UTF-8. Vì RS là ký tự điều khiển, nó chỉ có thể xuất hiện trong chuỗi JSON ở dạng escape, nên RS luôn là dấu mở đầu không nhập nhằng của một phần tử.
Quy tắc cho parser
Parser coi dòng dữ liệu là chuỗi các đoạn byte, mỗi đoạn đứng sau một hoặc nhiều RS. Mỗi đoạn được thử parse như một văn bản JSON UTF-8. Nếu parse thất bại, RFC nói parser nên tiếp tục với phần còn lại của dòng. Nhiều RS liên tiếp không tạo phần tử rỗng và có thể bỏ qua.
Không có dấu kết thúc
RFC ghi rõ json-seq không có chỉ báo kết thúc dòng dữ liệu. Parser không thể biết dòng đã hết hay bị cắt chỉ dựa vào định dạng. Việc này phải dựa vào tầng dưới, như kết thúc chunked đúng chuẩn hoặc Content-Length khớp.
Không định vị theo số thứ tự
RFC nói định dạng không có cơ chế định danh phần tử theo vị trí. Phần tử có thể bị cắt, thậm chí mất hẳn, nên tham chiếu "phần tử thứ n" không đáng tin. Mỗi bản ghi cần mang mã riêng của nó, như trường id trong fixture của lab.
Số và true false null là ca đặc biệt
Object, array và string tự đóng ngoặc nên biết được khi nào hết. Số và ba từ khóa true, false, null thì không. RFC dùng LF làm byte canh: parser phải kiểm văn bản JSON là số hoặc từ khóa có ít nhất một ký tự khoảng trắng sau nó, nếu không phải bỏ phần tử đó vì có thể đã bị cắt.
Parser tăng dần
RFC cho phép dùng parser JSON tăng dần, đọc từng phần của văn bản JSON trước khi nhận hết. Khi đó parser có thể đã trả vài kết quả rồi mới thất bại. Lab không dùng cách này, mỗi phần tử được parse một lần khi đã nhận đủ tới RS kế tiếp. Cách đơn giản này đủ cho bản ghi kích thước vừa.
Cảnh báo về phần tử bị cắt
RFC nói parser nên có tùy chọn cảnh báo về văn bản JSON bị cắt. Danh sách errors của lab là dạng cảnh báo đó, có loại lỗi và byte đầu. Ứng dụng tự quyết định bỏ qua, ghi log hay dừng hẳn khi số cảnh báo vượt ngưỡng.
Ví dụ của RFC
RFC đưa ví dụ RS 123 RS: có thể ý định là 1234 nhưng bị cắt. RS true RS có thể là chuỗi không hợp lệ trueish bị cắt. RS truefalse RS không phải hai giá trị, chỉ là văn bản không hợp lệ. Fixture của lab có một ca giống ví dụ đầu.
So với JSONL và một tài liệu JSON
Bảng dưới đặt ba cách đóng gói cạnh nhau.
Đặc điểm |
Một tài liệu JSON |
JSONL |
json-seq |
|---|---|---|---|
Dấu tách |
Không có, một khối |
LF cuối mỗi dòng |
RS đầu mỗi phần tử, LF cuối |
Xuống dòng trong bản ghi |
Có |
Không |
Có |
Hỏng một chỗ |
Hỏng cả |
Hỏng dòng đó, nếu parser bỏ qua |
Hỏng phần tử đó |
Phát hiện số bị cắt |
Không áp dụng |
Không |
Có, nhờ LF |
Media type |
application/json |
Không có đăng ký chuẩn |
application/json-seq |
Dựng byte stream có record separator và JSON record cho JSON Text Sequences streaming
Phần này dựng fixture, chạy thật trên Python 3.12.10.
Tám bản ghi hợp lệ
Bản ghi hợp lệ có id, url và price, id từ 1 tới 8. Fixture còn có một bản ghi hợp lệ thêm với id 55 và một chuỗi top-level, đều đúng chuẩn, để kiểm parser không loại nhầm.
GOOD = [{"id": i, "url": f"https://shop.test/p/{i}", "price": 100000 + i} for i in range(1, 9)]
RS, LF = b"\x1e", b"\n"
Giá trị là giả lập, không lấy từ website nào.
Các phần của fixture
Fixture gồm 14 phần nối nhau, 17 byte RS, tổng 677 byte. Đoạn dưới là danh sách phần, giữ nguyên thứ tự trong lab.
PARTS = [
    RS + json.dumps(GOOD[0]).encode() + LF,
    RS + json.dumps(GOOD[1], indent=2).encode() + LF,
    RS + b'{"id": 99, "url": "https://shop.test/p/99", "price": 1' + LF,
    RS + json.dumps(GOOD[2]).encode() + LF,
    RS + RS + RS + json.dumps(GOOD[3]).encode() + LF,
    RS + b"12" + RS,
    RS + json.dumps(GOOD[4]).encode() + LF,
    RS + b'{"id": 55, "note": "chua \\u001e da escape"}' + LF,
    RS + json.dumps(GOOD[5]).encode() + LF,
    RS + b'"chuoi top-level"' + LF,
    RS + json.dumps(GOOD[6]).encode() + LF,
    RS + b"\xff\xfe khong phai utf-8" + LF,
    RS + json.dumps(GOOD[7]).encode() + LF,
    RS + b'{"id": 100, "url": "https://shop.test/p/1',
]
Fixture được ghi ra tệp fixture.json-seq để có thể đọc lại bằng công cụ khác.
Ý nghĩa từng lỗi
Phần thứ hai là bản ghi id 2 in đẹp nhiều dòng, hợp lệ với json-seq nhưng phá JSONL. Phần thứ ba là object bị cắt giữa chừng. Phần thứ năm có ba RS liên tiếp. Phần thứ sáu là số 12 không có LF, giống ví dụ của RFC. Phần thứ mười hai là byte không phải UTF-8. Phần cuối là object dở khi dòng dữ liệu kết thúc.
RS trong chuỗi phải escape
Bản ghi id 55 chứa chuỗi có ký tự RS ở dạng escape \u001e. Đây là cách duy nhất RS được phép xuất hiện bên trong văn bản JSON. Parser tách theo byte 0x1E sẽ không bị đánh lừa, vì sáu ký tự escape không chứa byte đó.
Vì sao có cả chuỗi top-level
Chuỗi "chuoi top-level" là văn bản JSON hợp lệ, tự đóng ngoặc nên không cần quy tắc LF. Nó có mặt để kiểm parser không loại nhầm giá trị không phải object. Ứng dụng thật thường chỉ chấp nhận object, nhưng việc lọc kiểu thuộc về tầng ứng dụng, không thuộc về parser json-seq.
Máy chủ phát chunked
Máy chủ trả Content-Type application/json-seq, Transfer-Encoding chunked, cắt fixture thành chunk 7 byte ở đường dẫn /small và 64 byte ở đường dẫn gốc. Ranh giới chunk cố ý không trùng ranh giới bản ghi, để kiểm parser ghép đúng.
step = 7 if self.path == "/small" else 64
for i in range(0, len(data), step):
    c = data[i:i + step]
    self.wfile.write(f"{len(c):x}\r\n".encode() + c + b"\r\n"); self.wfile.flush()
    time.sleep(0.002)
self.wfile.write(b"0\r\n\r\n")
Khoảng nghỉ 2 mili giây giữa các chunk mô phỏng dữ liệu đến dần.
Kiểm fixture bằng mắt
Mở tệp fixture.json-seq trong trình soạn thảo, RS thường hiện thành một ký tự điều khiển hoặc ô vuông. RFC có nhắc trên vài hệ thống có thể gõ RS bằng tổ hợp ctrl và dấu mũ. Biết cách nhìn và gõ RS giúp tạo ca kiểm thử bằng tay khi cần.
Encoder đúng chuẩn
Phía ghi, encoder chỉ cần ba bước: RS, json.dumps, LF. json.dumps của Python luôn escape ký tự điều khiển, kể cả với ensure_ascii=False, nên RS trong dữ liệu tự thành \u001e. Lab kiểm bằng ba giá trị: một object chứa RS, số 42 và true.
bytes: b'\x1e{"t": "chu co \\u001e ben trong"}\n\x1e42\n\x1etrue\n'
doc lai: [{'t': 'chu co \x1e ben trong'}, 42, True] | loi: []
Số 42 và true có LF phía sau nên parser chấp nhận.
Parse từng record thay vì đọc như một JSON document trong JSON Text Sequences streaming
Phần này cho thấy hai cách đọc sai trước khi tới cách đúng.
Đọc cả dòng bằng json.loads
Gọi json.loads trên toàn bộ 677 byte ném UnicodeDecodeError vì byte 0xff ở vị trí 555. Thay byte lỗi bằng ký tự thay thế rồi parse lại vẫn ném JSONDecodeError Expecting value ở vị trí 0, vì byte đầu là RS. Không lấy được bản ghi nào.
json.loads ca stream: UnicodeDecodeError 'utf-8' codec can't decode byte 0xff in position 555
json.loads sau khi thay byte loi: JSONDecodeError Expecting value tai 0
Đây là kết quả của client coi json-seq như application/json.
Đọc như JSONL có bỏ qua dòng lỗi
JSONL làm mất bản ghi
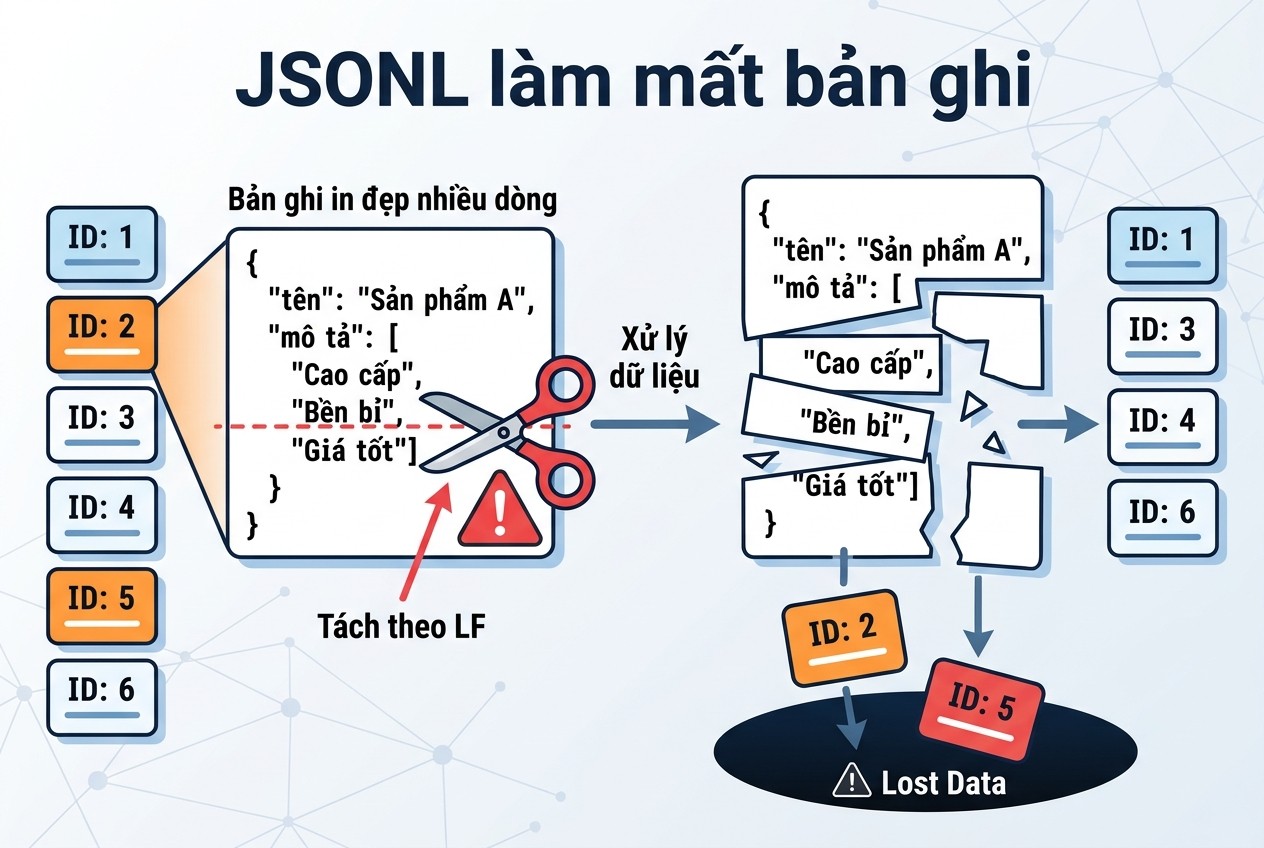
Cách thứ hai tách theo LF, bỏ RS ở đầu dòng, parse từng dòng, bỏ qua dòng lỗi. Kết quả đọc được id 1, 3, 4, 55, 6, chuỗi top-level, 7, 8. Có 9 dòng lỗi. Mất id 2 vì bản ghi in nhiều dòng bị cắt làm mảnh. Mất id 5 vì dòng của nó dính sau RS 12 RS không có LF.
JSONL: doc duoc [1, 3, 4, 55, 6, 'chuoi top-level', 7, 8] | dong loi 9Hai bản ghi hợp lệ biến mất mà parser không báo lỗi riêng cho chúng.
JSONL ngây thơ dừng sớm
Cách thứ ba là JSONL không bỏ qua lỗi: dừng ở dòng lỗi đầu tiên. Lab chỉ đọc được id 1, rồi dừng với lỗi Expecting property name enclosed in double quotes, chính là dòng thứ hai của bản ghi in đẹp. Bảy bản ghi tốt phía sau bị bỏ.
Vì sao không tách theo LF
LF có thể xuất hiện bên trong một bản ghi in đẹp, nên không thể dùng làm dấu tách. RS thì không thể xuất hiện ở dạng thô trong văn bản JSON. Đây là lý do duy nhất json-seq chọn RS. Parser tách theo LF là parser JSONL, dù có bỏ RS ở đầu dòng.
Parser tách theo RS
SeqParser giữ một bộ đệm byte. Mỗi lần nhận chunk, nó tìm RS, cắt đoạn byte giữa hai RS, xử lý đoạn đó như một phần tử. Phần sau RS cuối cùng nằm lại trong bộ đệm chờ chunk tiếp theo.
def feed(self, chunk):
    self.buf += chunk
    while True:
        i = self.buf.find(RS)
        if i < 0:
            return
        if not self.started:
            if self.buf[:i].strip():
                self.errors.append((0, "byte truoc RS dau tien", self.buf[:i][:24]))
            self.started = True; self.buf = self.buf[i + 1:]; continue
        raw, self.buf = self.buf[:i], self.buf[i + 1:]
        v = self._emit(raw)
        if v is not None:
            yield v
Parser là mã lab, viết theo mục 2.1 của RFC.
Xử lý một phần tử
Hàm _emit bỏ qua đoạn rỗng do RS liên tiếp, giải mã UTF-8, kiểm quy tắc số và từ khóa, rồi parse JSON. Mỗi bước lỗi ghi vào danh sách errors với số thứ tự phần tử, loại lỗi và vài byte đầu.
def needs_ws(txt):
    t = txt.strip()
    return bool(t) and (t[0] in "-0123456789" or t in ("true", "false", "null"))

if needs_ws(txt) and not txt[-1:].isspace():
    self.errors.append((self.n, "co-the-bi-cat (so/true/false/null khong co LF)", raw[:24]))
    return None
Kiểm ký tự cuối là khoảng trắng chính là cách áp quy tắc byte canh LF của RFC.
Phần tử cuối dòng dữ liệu
Khi dòng dữ liệu kết thúc, bộ đệm còn đoạn sau RS cuối. Hàm close xử lý đoạn này với cờ final. Nếu đoạn không kết thúc bằng LF, parser ghi lỗi cuối stream không có LF và bỏ phần tử, kể cả khi nó trông giống JSON hợp lệ. Lý do: không có cách nào biết encoder đã ghi xong.
Ghép chunk đúng
Chunk 7 byte có thể cắt ngang ký tự UTF-8 nhiều byte. Parser của lab chỉ giải mã UTF-8 khi đã có đủ một phần tử giữa hai RS, nên không bao giờ giải mã nửa ký tự. Nếu giải mã từng chunk trước rồi mới tách, ký tự tiếng Việt bị cắt sẽ thành lỗi giả.
Bộ đệm không được lớn vô hạn
Parser của lab không giới hạn bộ đệm. Với dòng dữ liệu thật, một nguồn hỏng có thể gửi hàng trăm MB không có RS. Đặt trần kích thước phần tử, vượt trần thì bỏ bộ đệm tới RS kế tiếp và ghi lỗi. Lab chưa chạy ca này.
Chèn record lỗi hoặc stream bị cắt ở cuối JSON Text Sequences streaming
Phần này chạy parser trên dòng dữ liệu thật qua HTTP.
Đọc bằng httpx
httpx 0.28.1 mở stream tới /small, đọc bằng iter_bytes. Header trả về có content-type application/json-seq và transfer-encoding chunked. Client nhận 97 chunk.
p = SeqParser(); vals = []
with httpx.stream("GET", f"http://127.0.0.1:{PORT}/small") as r:
    for ch in r.iter_bytes():
        vals.extend(p.feed(ch))
vals.extend(p.close())
iter_bytes trả byte đã giải mã nén nếu có, nhưng không cắt theo dòng. Đó là điều parser cần.
Kết quả của httpx
Parser bỏ đúng phần tử lỗi
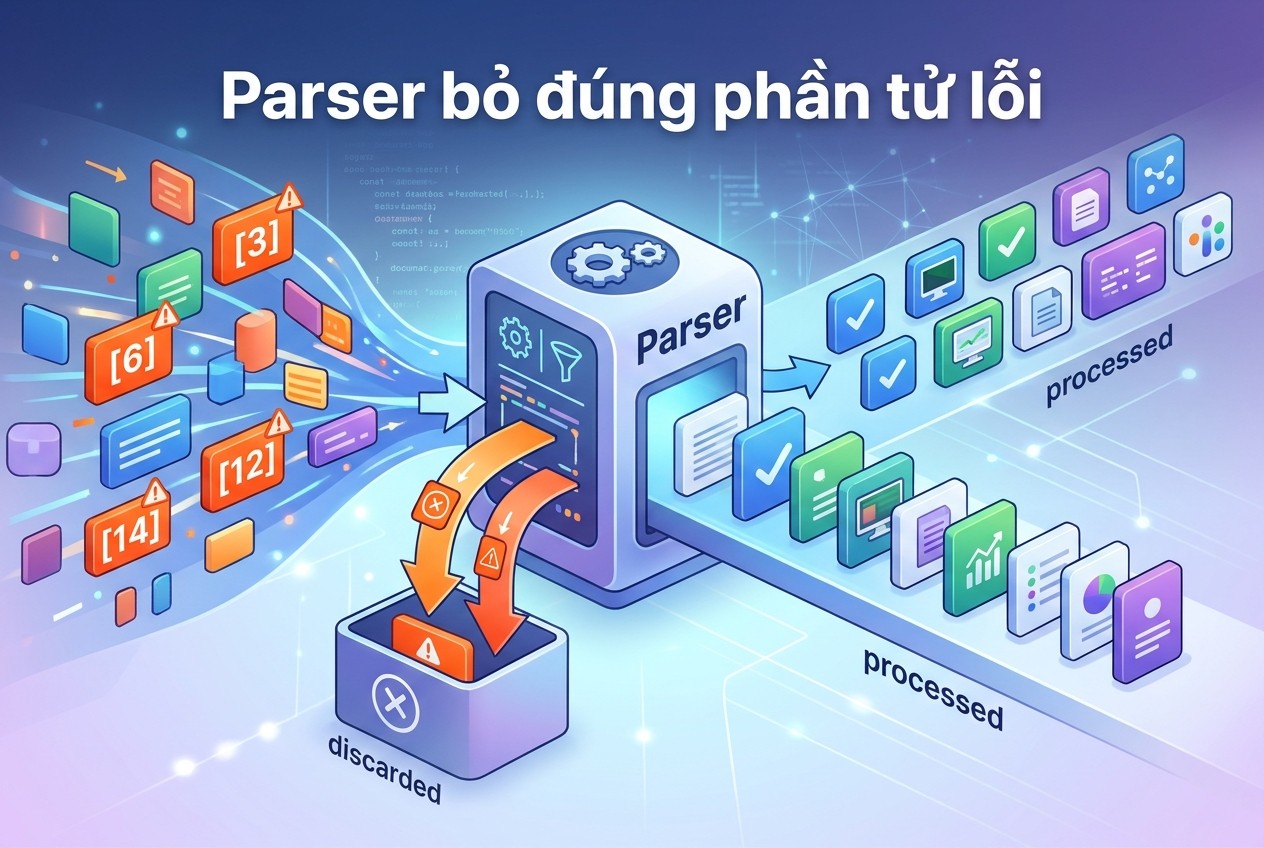
Parser trả mười giá trị theo thứ tự: 1, 2, 3, 4, 5, 55, 6, chuỗi top-level, 7, 8. Có bốn lỗi được ghi.
record: [1, 2, 3, 4, 5, 55, 6, 'chuoi top-level', 7, 8]
loi: (3, "json: Expecting ',' delimiter", b'{"id": 99, "url": "https')
loi: (6, 'co-the-bi-cat (so/true/false/null khong co LF)', b'12')
loi: (12, 'utf8', b'\xff\xfe khong phai utf-8\n')
loi: (14, 'cuoi stream khong co LF', b'{"id": 100, "url": "http')
Bản ghi id 2 in nhiều dòng được đọc đúng. Bản ghi id 5 ngay sau số bị cắt cũng đọc đúng.
Một bản ghi hỏng chỉ được phép làm mất chính nó. Bản ghi tốt phía sau phải đến nơi.
Đọc bằng requests
requests 2.34.2 đọc đường dẫn gốc với stream=True và iter_content(64). Parser trả đúng mười giá trị như httpx, bốn lỗi giống hệt. Kết quả không phụ thuộc thư viện hay kích thước chunk.
record: [1, 2, 3, 4, 5, 55, 6, 'chuoi top-level', 7, 8] | so loi: 4 | giong httpx: TruePhần tử đếm thế nào
Số thứ tự trong lỗi là số phần tử không rỗng mà parser đã gặp, không phải số dòng hay số byte. Phần tử 3 là đoạn thứ ba có nội dung. Với log thật, ghi thêm vị trí byte của RS mở đầu giúp tìm lại đoạn lỗi trong tệp gốc nhanh hơn.
Ba RS liên tiếp
Phần thứ năm có ba RS trước bản ghi id 4. Parser gặp hai đoạn rỗng, bỏ qua, rồi đọc id 4 bình thường. Không có lỗi nào được ghi cho hai đoạn rỗng, đúng như RFC nói RS liên tiếp không tạo phần tử rỗng.
Số 12 bị bỏ đúng cách
Phần thứ sáu là RS 12 RS. Parser nhận đoạn 12, thấy là số, thấy ký tự cuối không phải khoảng trắng, bỏ và ghi lỗi có thể bị cắt. Nếu parser chỉ gọi json.loads, nó sẽ trả số 12 và coi là hợp lệ, trong khi giá trị thật có thể là 1250.
Byte không phải UTF-8
Phần thứ mười hai có byte 0xff 0xfe. Parser ghi lỗi utf8 và đi tiếp. RFC yêu cầu json-seq dùng UTF-8, các mã hóa UTF-16 và UTF-32 không được dùng. Byte 0xff 0xfe trông giống dấu thứ tự byte của UTF-16, ca hay gặp khi dữ liệu đi qua công cụ trên Windows.
Tiếp tục từ chỗ dừng
Khi dòng dữ liệu bị cắt, lần đọc sau nên bắt đầu từ bản ghi cuối cùng đã nhận đủ. Vì json-seq không định vị theo thứ tự, việc này phải dựa vào trường trong bản ghi như id hay thời gian, và vào API có hỗ trợ đọc từ một mốc. Lab không có API như vậy, chỉ ghi được id cuối là 8.
Phần tử dở ở cuối
Phần cuối là object id 100 bị cắt. Parser ghi lỗi cuối stream không có LF. Trong thực tế, ca này xảy ra khi kết nối đứt hoặc nguồn bị dừng giữa lúc ghi. Ghi lỗi riêng giúp biết lần đọc sau có thể cần lấy lại từ id cuối cùng đã nhận.
Bảng lỗi
Bảng dưới gom các phần tử lỗi trong fixture và cách parser xử lý.
Phần tử |
Nội dung |
Lỗi |
Parser làm gì |
|---|---|---|---|
3 |
object id 99 bị cắt |
JSON không hợp lệ |
Bỏ, ghi lỗi, đọc tiếp |
6 |
số 12 không có LF |
Có thể bị cắt |
Bỏ, ghi lỗi, đọc tiếp |
12 |
byte 0xff 0xfe |
Không phải UTF-8 |
Bỏ, ghi lỗi, đọc tiếp |
14 |
object id 100 dở |
Cuối dòng không có LF |
Bỏ, ghi lỗi |
giữa 4 |
hai đoạn rỗng |
Không phải lỗi |
Bỏ qua, không ghi |
Xác nhận parser phục hồi và không bỏ mất record hợp lệ sau lỗi của JSON Text Sequences streaming
Phần này là phép kiểm nghiệm thu.
Đủ tám bản ghi theo thứ tự
Lab kiểm hai điều. Mọi id từ 1 tới 8 đều có mặt trong kết quả. Thứ tự các id này giữ nguyên như trong fixture. Cả hai đều True.
nghiem thu: moi record hop le 1-8 deu co mat: True | thu tu giu nguyen: TrueĐây là tiêu chí chính của brief: parser không mất bản ghi hợp lệ nào phía sau bản ghi lỗi.
Lỗi im lặng nguy hiểm nhất
Cách JSONL bỏ qua dòng lỗi báo 9 dòng lỗi nhưng không nói bản ghi nào bị mất. Người xem log nghĩ mất 9 bản ghi, thực tế mất 2 bản ghi tốt và vài mảnh rác. SeqParser báo 4 lỗi, mỗi lỗi đúng một phần tử, nên con số trên log khớp với dữ liệu thật.
So ba cách đọc
Bảng dưới gom số bản ghi tốt từ 1 tới 8 mà mỗi cách đọc được.
Cách đọc |
Bản ghi 1 tới 8 đọc được |
Thiếu |
Báo lỗi riêng |
|---|---|---|---|
json.loads cả dòng |
0 |
Tất cả |
Một lỗi chung |
JSONL ngây thơ |
1 |
2 tới 8 |
Một lỗi, dừng |
JSONL bỏ qua dòng lỗi |
6 |
2 và 5 |
9 dòng lỗi, không chỉ ra bản ghi |
SeqParser theo RFC |
8 |
Không |
4 lỗi, đúng vị trí |
Kiểm cả giá trị, không chỉ id
Phép kiểm của lab so id. Với dữ liệu thật, nên so thêm giá trị các trường của vài bản ghi mẫu với nguồn, để chắc parser không ghép nhầm hai mảnh. Lab có thể làm vì biết trước GOOD, bản ghi id 2 đọc về đúng url và price như khi tạo.
Kết quả không phụ thuộc chunk
Chunk 7 byte cắt ngang mọi thứ: giữa RS và JSON, giữa hai byte UTF-8, giữa ngoặc. Chunk 64 byte cắt ít hơn. Hai cách cho kết quả trùng nhau. Đây là kiểm tra quan trọng, vì mạng thật không cắt theo ranh giới bản ghi.
Ghi lỗi để lấy lại
Danh sách errors có số thứ tự phần tử và vài byte đầu. Với bản ghi có id, lỗi ở phần tử 3 đi kèm byte đầu chứa id 99. Pipeline có thể ghi id này vào hàng chờ lấy lại. Với lỗi không đọc được id, như số 12 hay byte lạ, chỉ ghi lại vị trí và byte thô.
Ngưỡng dừng
Bỏ qua lỗi không có nghĩa là bỏ qua vô hạn. Nếu phần lớn phần tử trong một lần đọc đều lỗi, nguồn có thể đã đổi định dạng hoặc mã hóa. Đặt ngưỡng, ví dụ tỷ lệ lỗi trên một phần trăm, vượt ngưỡng thì dừng và báo người vận hành thay vì nạp tiếp một ít dữ liệu tốt lẫn nhiều lỗi.
Byte trước RS đầu tiên
Parser của lab ghi lỗi nếu có byte không phải khoảng trắng trước RS đầu tiên. Fixture không có ca này. Nó xảy ra khi client mở nhầm đường dẫn trả JSON thường, hoặc khi proxy chèn trang lỗi HTML. Lỗi này cho biết ngay dòng dữ liệu không phải json-seq.
Kiểm content type trước khi parse
Client nên kiểm Content-Type là application/json-seq trước khi dùng SeqParser. Nếu nguồn trả application/json hay text/html, dùng parser khác hoặc dừng. Lab in header nhận được để kiểm.
Tách lớp đọc và lớp xử lý
SeqParser chỉ trả giá trị JSON. Kiểm schema, chuẩn hóa giá trị và ghi vào kho là việc của lớp sau. Tách như vậy giúp thay đổi quy tắc nghiệp vụ mà không đụng tới parser, và giúp test parser bằng byte fixture độc lập với dữ liệu thật.
Đo bản ghi trên giây
Lab không đo tốc độ, fixture quá nhỏ. Với dữ liệu thật, parser tách theo RS rất nhẹ, phần tốn thời gian là json.loads cho từng bản ghi. Nếu cần nhanh hơn, có thể thay json bằng thư viện parse JSON khác, giữ nguyên lớp tách RS.
Đầu ra nghiệm thu của JSON Text Sequences streaming: byte fixture và parser không mất record
Phần này gom tiêu chí và giới hạn.
Danh sách kiểm tra
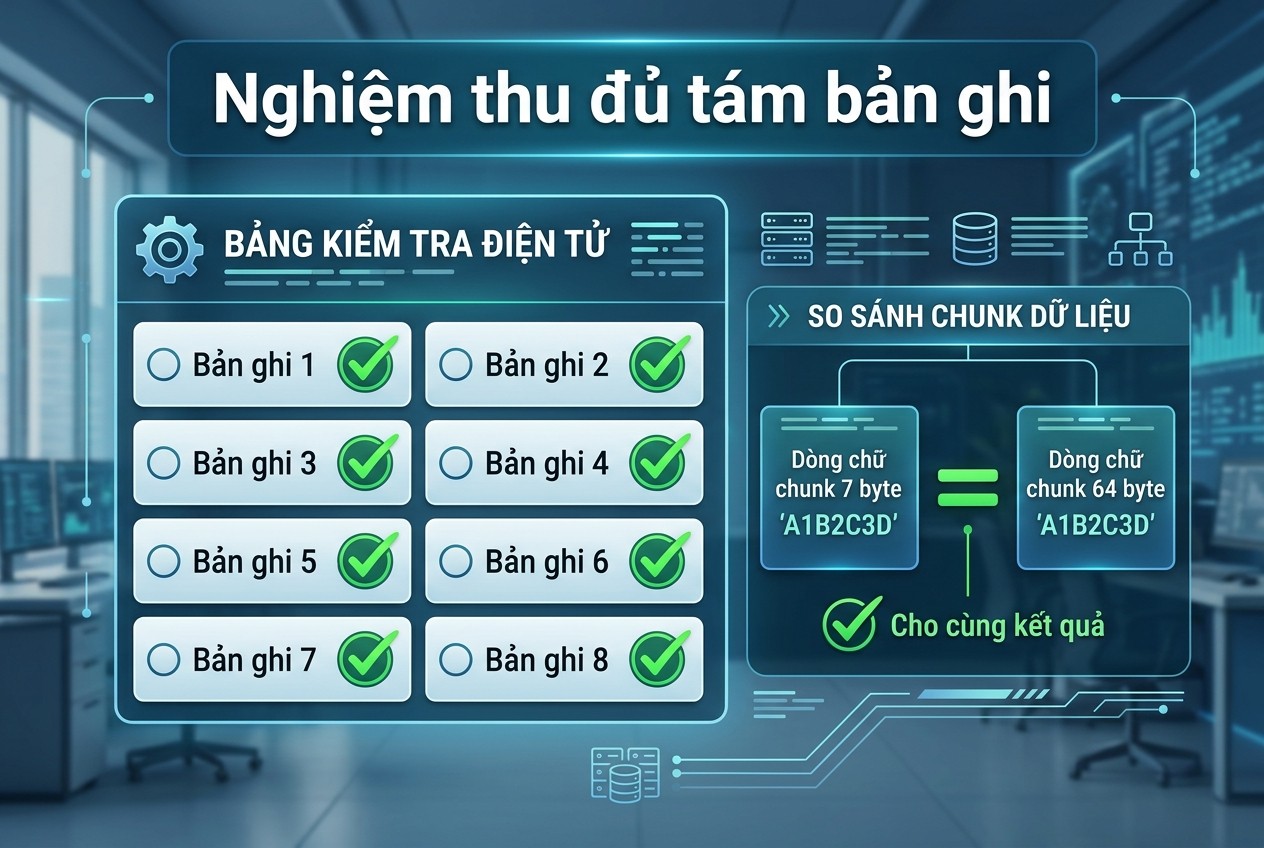
Nghiệm thu đủ tám bản ghi
Parser đạt khi mọi dòng dưới đây đúng với fixture của anh em.
- Tách theo byte RS, không theo LF.
- RS liên tiếp không tạo phần tử, không ghi lỗi.
- Phần tử hỏng bị bỏ, có lỗi riêng, không dừng dòng dữ liệu.
- Số và true false null không có khoảng trắng phía sau bị bỏ.
- Byte không phải UTF-8 bị bỏ, có lỗi riêng.
- Phần tử cuối không có LF bị bỏ và báo.
- Kết quả không đổi khi đổi kích thước chunk.
- Mọi bản ghi hợp lệ có mặt, đúng thứ tự.
Những gì lab chưa chạy
Chưa thử nguồn json-seq thật. Chưa thử dòng dữ liệu nén gzip, HTTP/2, dòng dữ liệu rất dài, bộ đệm có trần. Chưa đo tốc độ. Chưa thử đọc tệp json-seq bằng công cụ dòng lệnh như jq với tùy chọn seq. Parser là mã lab viết theo RFC, chưa so với thư viện bên thứ ba.
Chuyển json-seq sang JSONL
Nếu công cụ phía sau chỉ đọc JSONL, chuyển bằng cách parse từng phần tử bằng SeqParser rồi ghi lại bằng json.dumps không indent, mỗi bản ghi một dòng. Không chuyển bằng cách thay RS thành LF, vì bản ghi in đẹp sẽ vỡ ra nhiều dòng.
Khi nào nên chọn json-seq
Khi bản ghi có thể chứa xuống dòng, khi nguồn có thể bị cắt giữa lúc ghi, khi muốn bắt được số bị cắt. JSONL vẫn đơn giản và được nhiều công cụ hỗ trợ hơn. Bài JSON và CSV khi crawl dữ liệu có thêm góc nhìn về chọn định dạng lưu.
Proxy ở đâu trong luồng
Proxy chuyển tiếp truyền byte của dòng dữ liệu, không đổi RS hay LF. Proxy có bộ đệm có thể làm dữ liệu đến thành từng cục lớn thay vì từng chút, nhưng không đổi nội dung. Khi nguồn chỉ cho IP tại Việt Nam, anh em có thể mua proxy tại trang chủ ProxyVN. Vai trò của proxy có ở bài Web Scraping proxy là gì, cách ghi chuỗi cấu hình có ở bài định dạng proxy.
JSON Text Sequences streaming: câu hỏi thường gặp
Các câu dưới đây gom những điểm hay bị hỏi.
json-seq khác JSONL ở đâu?
Json-seq mở đầu mỗi bản ghi bằng RS và cho phép xuống dòng bên trong. JSONL tách theo LF, không cho xuống dòng.
Một bản ghi hỏng có làm hỏng cả dòng dữ liệu không?
Không, nếu parser theo RFC 7464. Lab bỏ bốn phần tử lỗi, vẫn đọc đủ tám bản ghi.
Vì sao phải bỏ số không có LF?
Vì có thể đã bị cắt. RS 12 có thể là 1250 bị mất đuôi. RFC yêu cầu bỏ phần tử này.
RS có xuất hiện trong dữ liệu được không?
Chỉ ở dạng escape \u001e trong chuỗi. json.dumps của Python tự làm việc này.
Có thư viện Python sẵn cho json-seq không?
Bài không kiểm. Parser của lab chỉ khoảng ba mươi dòng, dùng json của thư viện chuẩn.
Kích thước chunk có ảnh hưởng kết quả không?
Không trong lab. Chunk 7 byte và 64 byte cho cùng mười giá trị và bốn lỗi.
Dòng dữ liệu có dấu kết thúc không?
Không. RFC nói json-seq không có chỉ báo kết thúc. Dựa vào tầng HTTP để biết dòng đã hết đúng cách.
JSON Text Sequences streaming và những điều cần nhớ
JSON Text Sequences streaming đọc đúng khi tách theo RS, parse từng phần tử, bỏ phần tử hỏng mà không dừng, và áp quy tắc LF cho số. Đừng đọc json-seq bằng json.loads hay bằng parser JSONL. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em giữ byte fixture để kiểm parser JSON Text Sequences streaming.


