
DuckDB xử lý dữ liệu crawl JSONL và xuất Parquet
DuckDB xử lý dữ liệu crawl JSONL giúp tổng hợp nhiều file theo ngày bằng SQL ngay trong Python. Bài này dùng dữ liệu tự tạo có giá lỗi và cột xuất hiện muộn, tách dòng cần kiểm rồi xuất Parquet. Cần giữ nguồn file, ý nghĩa giá trị thiếu và đối chiếu số dòng trước khi sử dụng kết quả. ProxyVN hướng dẫn cách kiểm trên dữ liệu mẫu.
DuckDB xử lý dữ liệu crawl JSONL với hợp đồng đầu vào
Một thư mục crawl theo ngày thường chứa các record cùng loại nhưng khác schema. Ngày sau có thể thêm cột, một trường số bị trả thành chuỗi lỗi hoặc cùng SKU xuất hiện nhiều lần. Nếu gom file mà không ghi quy tắc, bảng cuối dễ đẹp về hình thức nhưng sai về ý nghĩa.
Bài dùng hai file JSONL tự tạo để kiểm đường xử lý nhỏ. Tổng cộng có bốn dòng với giá dạng chuỗi, gồm hai giá không âm hợp lệ theo hợp đồng và hai dòng cần cách ly. Cột stock chỉ có ở ngày sau nhằm kiểm trường hợp schema giữa các file không giống nhau.
Tài liệu đọc JSON của DuckDB là nguồn kiểm hàm đọc và tùy chọn theo phiên bản. Ca thực nghiệm dùng DuckDB 2.0.0 trong Python, chạy trên file cục bộ. Nó chưa đo hiệu năng với kho dữ liệu lớn hoặc chứng minh mọi schema crawl thực tế đều được suy luận đúng.
Xác định một dòng đại diện điều gì
Ở fixture này, mỗi dòng là một lần quan sát SKU tại một thời điểm, không phải hồ sơ sản phẩm duy nhất suốt đời. Do đó hai dòng cùng SKU ở hai ngày cần được giữ để phân tích lịch sử. Xóa trùng theo SKU sẽ làm mất một quan sát hợp lệ trước khi nhóm bắt đầu tính biến động giá.
Nếu mục tiêu là bảng trạng thái mới nhất, hãy tạo bảng dẫn xuất từ lịch sử với quy tắc chọn thời điểm rõ ràng. Cần thêm cách xử lý khi hai quan sát cùng thời gian nhưng khác nguồn hoặc khác giá. Chọn dòng đầu mà không có thứ tự ổn định sẽ khiến kết quả phụ thuộc cách đọc file.
Giá hợp lệ trong bài được định nghĩa là chuyển được sang DECIMAL đã chọn và không âm. Định nghĩa này chưa kiểm tiền tệ, đơn vị bán, giá khuyến mãi hay độ hợp lý so với thị trường. Bảng được chấp nhận chỉ có nghĩa vượt qua tiêu chí minh họa, không phải chứng nhận dữ liệu sản phẩm hoàn chỉnh.
DuckDB xử lý dữ liệu crawl JSONL từ nhiều file theo ngày
JSONL đặt mỗi JSON record trên một dòng theo hợp đồng đầu vào của bài. Điều đó khác một file chứa một mảng JSON lớn. Khi dữ liệu crawler xuất không đúng dạng đã chọn, nên sửa hoặc nhận diện định dạng trước khi chạy truy vấn, thay vì bật mọi tùy chọn bỏ lỗi để cố nhận một bảng có dòng.
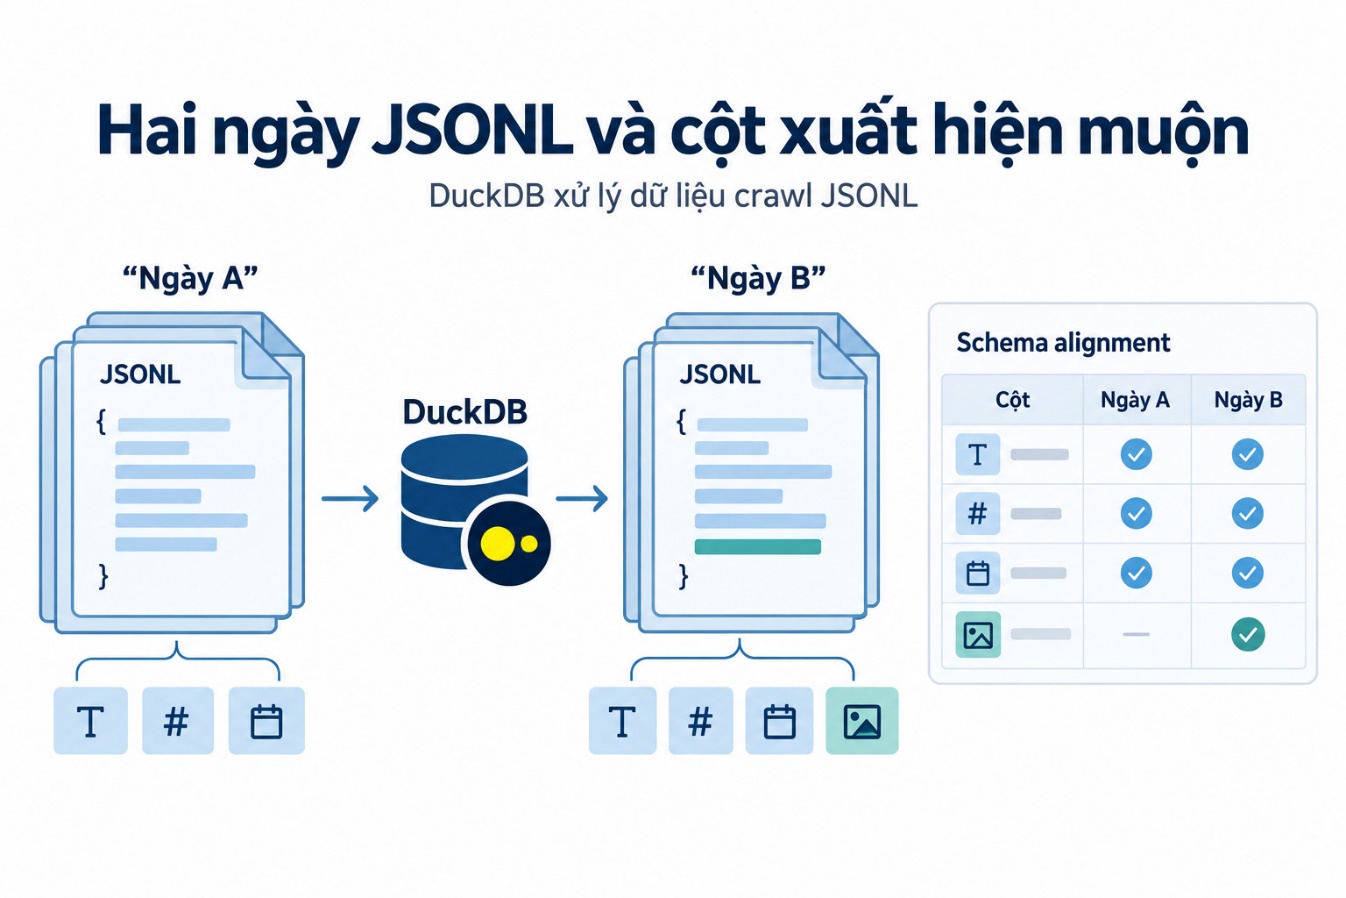
Hai ngày JSONL và cột xuất hiện muộn
Tạo fixture có lỗi để kiểm cách phân luồng
Hai file dưới đây có tên ngày nhằm giúp người đọc theo dõi nguồn. Thời điểm quan sát nằm trong record và không nên được thay tự động bằng tên file nếu chưa có quy tắc. Tên file có thể là ngày xuất hoặc ngày gom, khác với thời điểm crawler thực sự quan sát sản phẩm.
from pathlib import Path
import json

folder = Path('jsonl-lab')
folder.mkdir(exist_ok=True)
days = {
    'day1.jsonl': [
        {'sku': 'A', 'price': '12.50', 'observed_at': '2026-10-25T00:00:00Z'},
        {'sku': 'B', 'price': 'bad', 'observed_at': '2026-10-25T00:00:00Z'}],
    'day2.jsonl': [
        {'sku': 'A', 'price': '13.00', 'observed_at': '2026-10-26T00:00:00Z', 'stock': 4},
        {'sku': 'C', 'price': '-2', 'observed_at': '2026-10-26T00:00:00Z', 'stock': 0}]
}
for name, items in days.items():
    (folder / name).write_text(
        ''.join(json.dumps(x) + '\n' for x in items), encoding='utf-8')
Mã tạo fixture được dùng để kiểm parser và SQL, không mô phỏng một cửa hàng thật. SKU A xuất hiện ở cả hai ngày để giữ lịch sử, B có giá không chuyển được và C có giá âm. Cột stock bằng không ở dòng C là một giá trị có nghĩa trong fixture, khác với thiếu cột ở ngày đầu.
Đọc và giữ tên file nguồn
Tùy chọn hợp schema theo tên giúp nhận cột chỉ xuất hiện ở một phần tập file. Nó không bảo đảm mọi kiểu dữ liệu xung đột đều được xử lý theo ý muốn. Sau bước đọc, hãy xem schema được suy luận và so với hợp đồng, đặc biệt các trường thời gian và số có ảnh hưởng tới tính toán.
import duckdb

con = duckdb.connect()
con.execute("""
CREATE TABLE raw AS
SELECT * FROM read_json_auto(?, format='newline_delimited',
                             union_by_name=true, filename=true)
""", [str(folder / '*.jsonl')])
print(con.execute('DESCRIBE raw').fetchall())
assert con.execute('SELECT count(*) FROM raw').fetchone()[0] == 4
Trong ca kiểm, raw có sku và price dạng VARCHAR, observed_at dạng TIMESTAMP WITH TIME ZONE, stock dạng BIGINT cùng filename. Suy luận này là kết quả của fixture trong phiên bản đã dùng. Với nguồn mới, cần kiểm lại; không nên sao chép kỳ vọng kiểu của mẫu sang mọi bộ JSONL rồi cho rằng quá trình đọc sẽ luôn giống nhau.
Tài liệu kết hợp schema giúp kiểm lựa chọn khi đọc nhiều file. Bài giữ filename để truy lại dòng lỗi theo nguồn, nhưng chưa thêm định danh dòng gốc. Với hệ thống vận hành, một record ID hoặc offset có kiểm có thể cần thiết để truy vết chính xác hơn trong file lớn.
DuckDB xử lý dữ liệu crawl JSONL bằng TRY_CAST có lý do lỗi
TRY_CAST phù hợp khi muốn tạo một cột đã chuyển kiểu và phân luồng những giá trị không chuyển được. Tuy nhiên NULL của kết quả có thể đến từ nhiều nguyên nhân, bao gồm đầu vào thiếu hoặc giá trị không hợp lệ. Giữ cột raw giúp người kiểm phân biệt, thay vì chỉ nhìn một cột số rồi đoán lỗi.
Tạo cột chuẩn hóa bên cạnh dữ liệu gốc
Mẫu dùng DECIMAL cho giá với độ chính xác và số chữ số thập phân xác định. Lựa chọn này cần theo hợp đồng của tập dữ liệu, không theo thói quen dùng float cho mọi con số. Nếu nguồn có nhiều mức thập phân hoặc giá vượt miền, cần kiểm quy tắc chuyển đổi trước khi chấp nhận cho báo cáo tài chính.
CREATE TABLE normalized AS
SELECT *, TRY_CAST(price AS DECIMAL(10,2)) AS price_value
FROM raw;

SELECT COUNT(*) AS input_rows,
       COUNT(*) FILTER (WHERE price_value IS NOT NULL
                        AND price_value >= 0) AS accepted_rows,
       COUNT(*) FILTER (WHERE price_value IS NULL
                        OR price_value < 0) AS quarantine_rows
FROM normalized;
Tài liệu casting giải thích hành vi chuyển kiểu. Trong bài, TRY_CAST biến giá bad thành NULL còn giá âm vẫn chuyển được thành số âm. Vì thế chỉ kiểm kết quả chuyển không NULL sẽ bỏ lọt dòng C; cần kiểm cả miền giá trị theo hợp đồng đã định.
Tách lỗi cú pháp JSON khỏi lỗi giá
Một dòng không phải JSON hợp lệ có thể làm quá trình đọc thất bại trước khi bảng normalized tồn tại. TRY_CAST trên price không xử lý được lỗi cú pháp của toàn record. Nếu cần nhận các file hỏng một phần, phải thiết kế đường cách ly ở bước đọc và lưu được nguồn dòng lỗi theo khả năng của công cụ.
Ngược lại, một record JSON hợp lệ có price là chuỗi bad vẫn có thể vào raw và được cách ly ở bước chuẩn hóa. Hai nhóm lỗi này nằm ở hai giai đoạn khác nhau. Báo cáo số lượng cần phân biệt để người vận hành biết nên sửa cấu trúc file, bộ trích dữ liệu hay quy tắc kiểm giá.
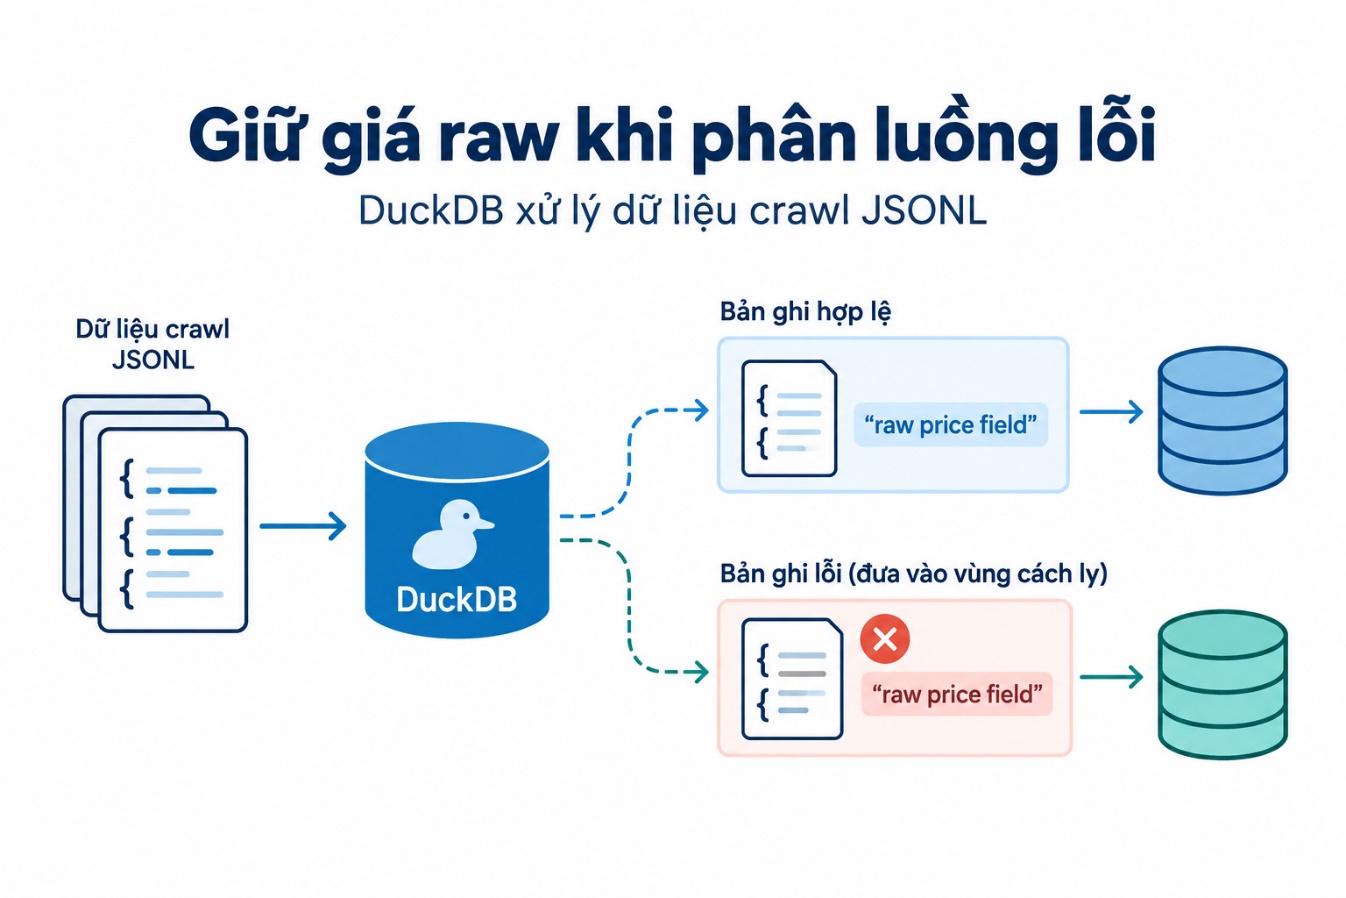
Giữ giá raw khi phân luồng lỗi
Giữ lý do để người sửa biết bắt đầu từ đâu
Có thể tạo cột trạng thái riêng theo thứ tự ưu tiên đã công bố. Ví dụ thiếu price, không chuyển được, âm hoặc được chấp nhận. Nếu chỉ gán mọi trường hợp thành invalid, nhóm sửa nguồn sẽ phải đọc lại từng record để biết có phải selector mất giá, một chuỗi tiền tệ mới hay giá âm do lỗi parse.
Trong fixture hiện tại không có price thiếu, nên số đếm hai dòng cách ly đến từ bad và giá âm. Nhánh thiếu được nêu như phần thiết kế mở rộng, chưa được báo thành ca chạy thực tế của bốn dòng. Khi bổ sung fixture, nên lưu riêng kết quả để tránh làm thay đổi mô tả kiểm của bộ mẫu ban đầu.
DuckDB xử lý dữ liệu crawl JSONL với cột xuất hiện muộn
Stock chỉ có trong ngày hai, vì vậy các quan sát ngày một có giá trị thiếu ở cột này sau khi hợp schema. Thiếu ở đây không có nghĩa hết hàng. Nếu đổi mọi NULL thành không, báo cáo có thể tạo ra một câu chuyện biến động tồn kho mà crawler chưa hề quan sát.
Giữ unknown tách khỏi số không
Giá trị không ở ngày hai được fixture ghi trực tiếp và có ý nghĩa riêng theo hợp đồng. Giá trị thiếu ở ngày một có thể do schema chưa thu stock. Hai trạng thái cần được giữ khác nhau để người dùng biết đâu là quan sát và đâu là phần dữ liệu chưa có.
Khi nguồn thêm một trường mới, nên ghi phiên bản schema hoặc giai đoạn bắt đầu thu trường đó. Điều này giúp phân tích tỷ lệ thiếu theo đúng thời kỳ, tránh coi toàn bộ file cũ là lỗi crawler chỉ vì chúng chưa từng có cột mới. Quy tắc chất lượng có thể cần áp dụng theo phiên bản dữ liệu.
Kiểm schema trước khi tính tổng
Một cột được suy luận thành chuỗi do có giá trị đặc biệt có thể làm truy vấn cộng hoặc so sánh hoạt động khác kỳ vọng. Bước DESCRIBE và kiểm miền dữ liệu giúp phát hiện sớm. Đừng chỉ nhìn truy vấn chạy không lỗi rồi kết luận các phép tính đang dùng đúng kiểu số.
Với dữ liệu thời gian, cần kiểm múi giờ và cách hiển thị của môi trường chạy. Fixture dùng mốc có Z và đã được suy luận thành kiểu có múi giờ. Nếu file thật trộn thời gian không có offset với thời gian có offset, cần hợp đồng chuẩn hóa rõ ràng trước khi chọn quan sát mới nhất.
DuckDB xử lý dữ liệu crawl JSONL và xuất Parquet có đối chiếu
Sau khi tách dòng, bảng được chấp nhận có hai quan sát của SKU A theo hai ngày. Bài xuất phần này sang Parquet rồi đọc lại để kiểm số dòng. Giữ cột raw cùng cột chuẩn hóa trong mẫu giúp đối chiếu, nhưng khi bàn giao thật có thể chọn cột tối thiểu theo nhu cầu và ghi schema rõ ràng.
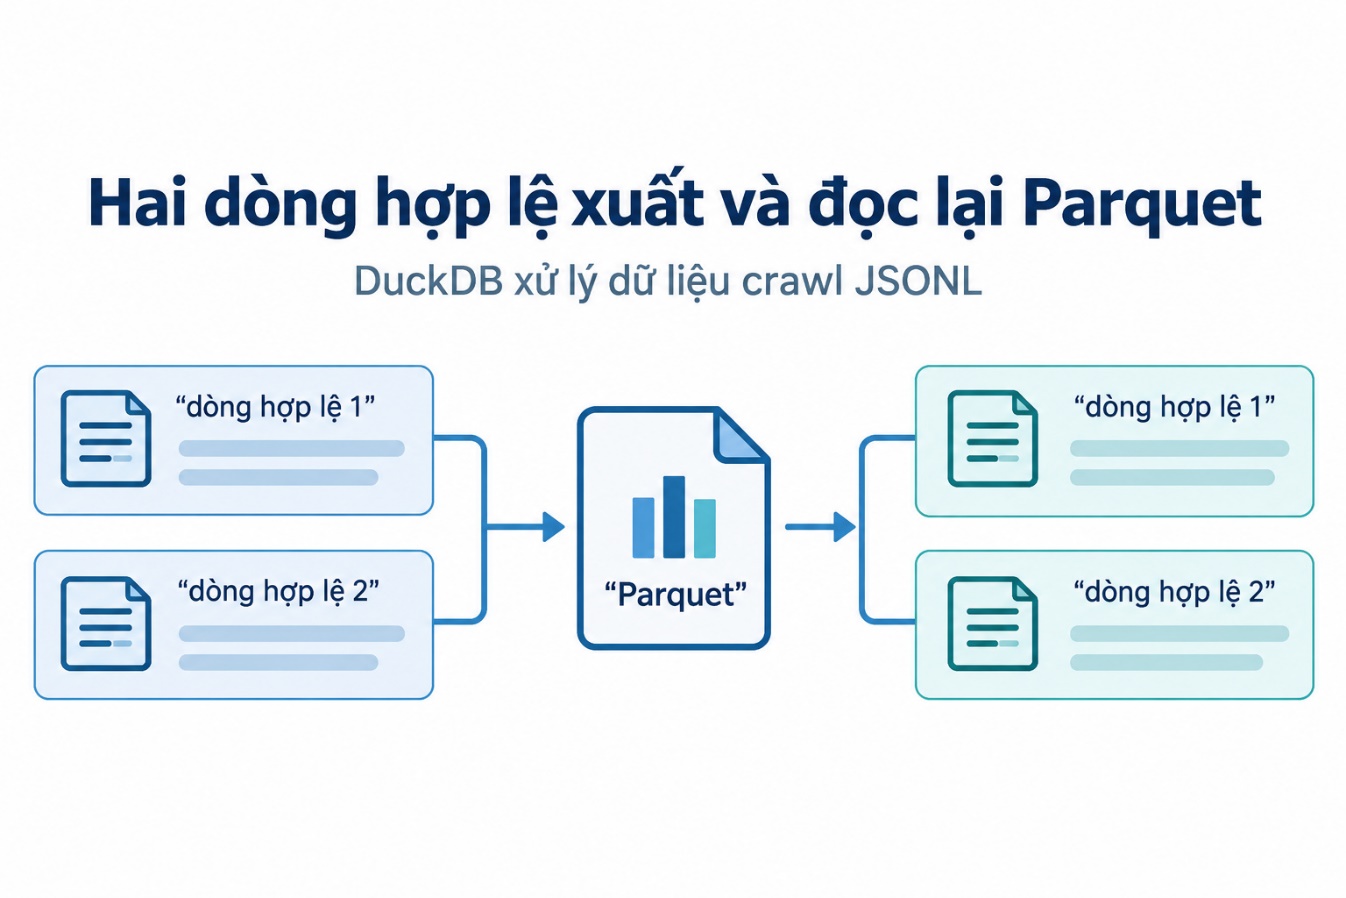
Hai dòng hợp lệ xuất và đọc lại Parquet
Xuất theo đường dẫn do tác vụ quản lý
Đoạn lệnh dưới dùng tên file cố định trong thư mục lab. Không nhận một chuỗi SQL hoặc đường dẫn tùy ý từ dữ liệu crawl để nối vào câu lệnh. Nếu ứng dụng cho người dùng chọn output, hãy xử lý bằng giao diện tham số hoặc quy tắc kiểm đường dẫn phù hợp khả năng của thư viện và môi trường.
con.execute("""
COPY (
  SELECT * FROM normalized
  WHERE price_value IS NOT NULL AND price_value >= 0
) TO 'accepted.parquet' (FORMAT PARQUET)
""")
count = con.execute(
    'SELECT count(*) FROM read_parquet(?)', ['accepted.parquet']).fetchone()[0]
assert count == 2
Tài liệu Parquet của DuckDB là nguồn kiểm cách đọc và ghi định dạng này. Ca chạy đọc lại được hai dòng sau xuất. Phép kiểm đó chứng minh số lượng ở đường đi nhỏ đã khớp, chưa kiểm mọi kiểu dữ liệu, metadata hay khả năng tương thích của mọi công cụ nhận file.
Kiểm cân bằng số dòng theo hợp đồng
Với fixture, bốn dòng đầu vào bằng hai được chấp nhận cộng hai cách ly. Kiểm cân bằng giúp phát hiện dòng bị rơi giữa các bước phân luồng. Tuy nhiên một pipeline vẫn có thể vừa làm mất một dòng vừa nhân đôi dòng khác mà tổng không đổi, nên cần đối chiếu thêm định danh quan sát hoặc dữ liệu chọn mẫu.
Nếu ghi riêng bảng cách ly, giữ filename, giá raw và lý do để nhóm sửa có thể tìm lại. Không chỉ xuất một file accepted rồi bỏ toàn bộ phần còn lại mà không thống kê. Khi tỷ lệ lỗi tăng, bảng cách ly cùng số đếm theo file sẽ giúp khoanh vùng ngày hoặc nguồn xuất hiện thay đổi.
DuckDB xử lý dữ liệu crawl JSONL mà không mất lịch sử SKU
Hai quan sát của A có giá khác nhau theo ngày trong fixture, vì vậy bảng lịch sử có hai dòng hợp lệ. Nếu cần tính thay đổi, hãy dùng thứ tự thời gian và kiểm điều kiện so sánh cùng đơn vị. Chênh lệch số học giữa hai giá không tự thể hiện một đợt giảm hay tăng giá thương mại đã được xác minh.
Bảng lịch sử và bảng mới nhất có vai trò riêng
Bảng lịch sử lưu quan sát để tái lập, còn bảng mới nhất tiện phục vụ tra cứu. Có thể tạo cả hai từ cùng raw, nhưng cần đặt tên để người nhận không dùng bảng mới nhất cho thống kê số lần thay đổi. Một lần xuất mất lịch sử rồi ghi đè nguồn sẽ làm các phân tích về sau khó kiểm lại.
Khi dùng hàm cửa sổ chọn dòng mới nhất theo SKU, cần thứ tự đủ xác định cho trường hợp hòa thời gian. Nếu hai nguồn có cùng timestamp nhưng giá khác, một tie breaker theo ưu tiên nguồn phải được giải thích. Không nên coi kết quả tùy thứ tự file là sự thật nghiệp vụ mặc định.
Tách dữ liệu thu được khỏi chất lượng mạng
DuckDB xử lý các file đã có, nên một truy vấn SQL thành công không chứng minh crawler đã lấy đầy đủ mọi trang. Cần báo cáo riêng số URL dự kiến, lỗi tải và số record xuất từ giai đoạn thu thập. Nếu đầu vào thiếu một ngày, công cụ phân tích có thể vẫn chạy bình thường trên tập còn lại.
Nhu cầu mua proxy thuộc giai đoạn cấu hình tuyến crawl phù hợp môi trường. Nó không sửa được schema JSON sai hoặc tự điền những quan sát chưa từng được lấy. Ca lab trong bài chạy trên file tự tạo, chưa kiểm một hệ thống tải trang qua proxy hay đo hiệu quả thu thập thực tế.
DuckDB xử lý dữ liệu crawl JSONL với hồ sơ kiểm minh bạch
Ca thực nghiệm đã đọc hai file bốn dòng, hợp cột stock, chuyển giá, đếm hai dòng được chấp nhận và hai dòng cách ly. File Parquet đọc lại có hai dòng. Các số liệu này thuộc fixture nêu trong bài, không phải benchmark tốc độ hoặc độ chính xác trên dữ liệu khách hàng.
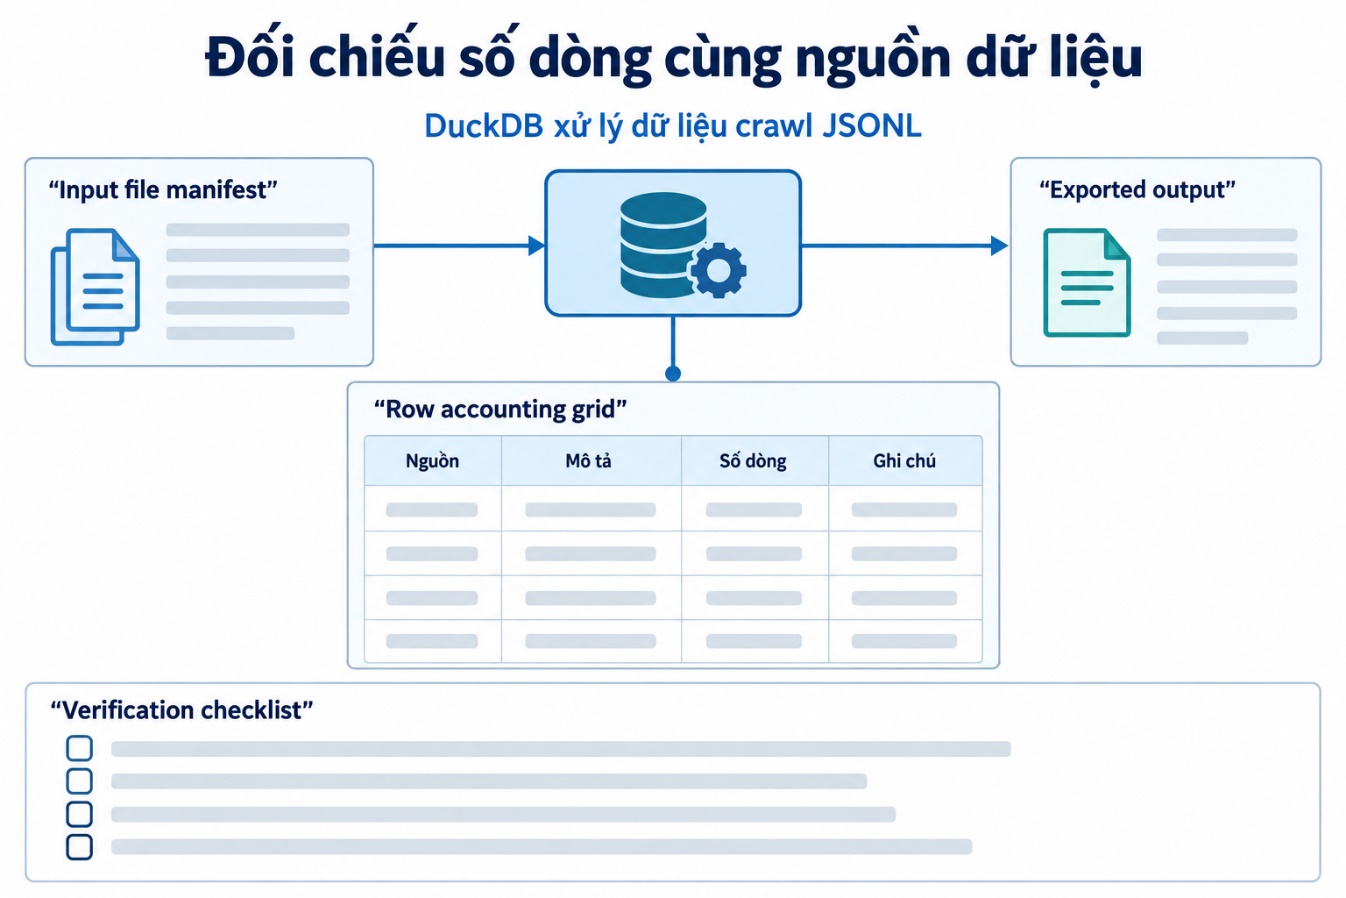
Đối chiếu số dòng cùng nguồn dữ liệu
Giai đoạn |
Quan sát trong fixture |
Phạm vi kết luận |
|---|---|---|
Đọc JSONL |
Hai file, bốn dòng |
Mẫu cục bộ |
Hợp schema |
Stock thiếu ở ngày đầu |
Chưa kiểm mọi xung đột kiểu |
Chuẩn hóa |
Hai đạt, hai cách ly |
Theo quy tắc giá mẫu |
Parquet |
Đọc lại hai dòng |
Kiểm số lượng, chưa kiểm toàn schema |
Đi theo một dòng lỗi từ đầu đến cuối
Chọn dòng B trong ngày một để kiểm price raw vẫn là bad sau khi đọc. Ở normalized, price_value cần là NULL và filename cần chỉ đúng file nguồn. Dòng đó phải đi vào nhóm cách ly chứ không được thay bằng giá không để tiếp tục tính toán như một quan sát hợp lệ.
Sau đó kiểm C ở ngày hai: price_value chuyển được nhưng âm, stock bằng không vẫn được giữ nguyên. Tình huống này giúp phân biệt lỗi miền giá với dữ liệu tồn kho. Nếu công cụ loại toàn record, bảng cách ly vẫn phải giữ các trường đủ để giải thích quyết định, không chỉ để lại mã SKU.
Cuối cùng kiểm hai dòng A còn trong accepted và Parquet. So thời điểm cùng giá để nhận ra lịch sử được giữ, không chỉ đếm hai dòng. Nếu cùng một quan sát bị nhân đôi và quan sát kia mất, số đếm vẫn bằng hai nhưng ý nghĩa bảng đã sai; đối chiếu theo trường là bước bổ sung cần thiết.
Tổ chức lần chạy để có thể kiểm lại
Nên ghi danh sách file đầu vào cho từng lần xử lý thay vì chỉ lưu một glob có thể khớp thêm file về sau. Khi muốn tái lập, tập file và phiên bản công cụ phải rõ. Một truy vấn giống nhau chạy trên thư mục đã có thêm ngày mới có thể cho kết quả khác mà SQL không hề thay đổi.
Giữ query hoặc script, schema đã quan sát, số đếm các nhánh và vị trí output. Nếu thay ngưỡng kiểm giá, tạo phiên bản quy tắc để giải thích khác biệt accepted giữa hai lần. Các bằng chứng này giúp người kiểm phân biệt nguồn đổi, công cụ đổi và hợp đồng chất lượng do chính nhóm sửa.
Việc ghi file nên có trạng thái hoàn tất để công cụ khác không đọc một output đang viết dở. Trong một pipeline nhiều bước, có thể viết vào thư mục lần chạy rồi công bố chỉ mục sau khi đối chiếu xong. Đây là thiết kế vận hành cần kiểm thêm; lab hiện tại chưa thử tắt tiến trình giữa lúc COPY.
Mở rộng kiểm tra theo rủi ro của dữ liệu
Nếu mục tiêu chỉ là thống kê danh mục, một bộ kiểm gọn có thể đủ cho giai đoạn thử. Nếu bảng được dùng cho quyết định nhạy cảm hơn, cần kiểm thêm nguồn giá, tiền tệ, độ trễ quan sát và trường bắt buộc. Không nên dùng số dòng đã qua một điều kiện giá để đại diện toàn bộ chất lượng dữ liệu.
Các fixture tiếp theo có thể thêm giá thiếu, chuỗi tiền tệ, số vượt miền và ngày sai định dạng để kiểm phản ứng của phiên bản đang dùng. Những ca này cần kết quả riêng và tiêu chí rõ. Bài không báo chúng đã chạy trong bộ bốn dòng hiện tại, tránh biến danh sách đề xuất thành bằng chứng thử nghiệm.
Với schema thay đổi thường xuyên, cân nhắc khai báo kiểu đầu vào theo hợp đồng thay vì chỉ phụ thuộc vào suy luận tự động. Suy luận tiện khi khám phá, nhưng một cột mới hoặc giá trị hiếm có thể ảnh hưởng kiểu. Trước khi cố định pipeline, hãy kiểm tập đại diện và cách xử lý khác biệt theo từng nguồn.
Bàn giao Parquet kèm định nghĩa trường
Người nhận cần biết price là chuỗi nguồn còn price_value là giá đã chuyển theo quy tắc mẫu. Stock thiếu khác stock bằng không, observed_at là thời điểm trong record và filename là nguồn đọc. Nếu chỉ gửi file không có định nghĩa, những khác biệt này dễ bị công cụ hoặc người dùng diễn giải theo suy đoán riêng.
Một bản bàn giao tốt có số dòng đầu vào, số được chấp nhận, số cách ly và lý do chính. Kèm danh sách file giúp kiểm tính đầy đủ của phạm vi đã xử lý. Kèm giới hạn giúp người nhận biết phần nào cần xác minh thêm trước khi dùng vào một báo cáo có yêu cầu cao hơn ca minh họa này.
Khi thêm dữ liệu ngày mới, hãy giữ bản xuất cũ đủ lâu để so những thay đổi có ý nghĩa theo quy trình của nhóm. Không nên chỉnh tay Parquet để chữa một record rồi bỏ qua script, vì lần chạy tiếp theo có thể tái tạo lỗi cũ. Sửa ở nguồn hoặc quy tắc có phiên bản giúp kết quả nhất quán và có thể kiểm lại.
Phân biệt lỗi dòng và lỗi toàn lần chạy
Một giá không hợp lệ có thể được cách ly theo dòng vì raw vẫn đọc được, còn một file chưa hoàn tất có thể yêu cầu dừng cả lần xử lý theo hợp đồng. Cần xác định mức lỗi trước khi công bố output. Nếu bỏ qua một file mà không báo, người nhận có thể tưởng bảng đã bao phủ đủ hai ngày dự kiến.
Khi một trường mới chỉ có ở một nguồn, kiểm tỷ lệ thiếu theo nguồn và thời gian sẽ hữu ích hơn một tỷ lệ chung. Tỷ lệ chung có thể tăng vì thêm nhiều file cũ chưa thu trường đó, chưa chắc do crawler hôm nay hỏng. Giữ filename và thông tin phiên bản giúp đặt các số đếm vào đúng ngữ cảnh.
Với bảng mới nhất, hãy kiểm trường hợp cùng SKU có một quan sát mới bị cách ly. Nhóm cần quyết định giữ quan sát hợp lệ gần nhất hay thể hiện trạng thái mới chưa dùng được. Không tự điền giá cũ vào ngày mới mà thiếu nhãn, vì như vậy sẽ biến dữ liệu suy diễn thành một quan sát mà crawler chưa thu được.
Mục tiêu của quy trình là giải thích được từng dòng đã dùng và từng dòng bị loại. DuckDB hỗ trợ các phép đọc, chuyển kiểu và truy vấn, còn hợp đồng chất lượng vẫn do nhóm thiết kế. Duy trì raw, lý do lỗi và kiểm đối chiếu sẽ giúp bảng Parquet hữu ích hơn một lần chuyển đổi định dạng đơn thuần.
So sánh hai bản xuất theo cùng tập đầu vào
Khi thử một quy tắc mới, giữ nguyên bộ file để so tác động của quy tắc trước. Nếu vừa thêm ngày mới vừa đổi cách chuyển giá, chênh lệch sẽ khó phân tích vì có hai nguyên nhân cùng lúc. Một lần thử nhỏ có tập đầu vào cố định giúp người kiểm giải thích từng dòng chuyển từ nhánh này sang nhánh khác.
Chẳng hạn thay DECIMAL có thể ảnh hưởng giá có nhiều chữ số thập phân hoặc nằm gần biên miền. Cần thêm fixture đại diện trước khi triển khai thay đổi đó cho lịch sử. Không lấy việc hai dòng A trong bài vẫn đọc được làm bằng chứng rằng mọi giá ở nguồn đều giữ nguyên sau một thay đổi kiểu số.
Nếu file đầu vào được sửa sau lần chạy, nên lưu định danh nội dung hoặc bản sao theo chính sách lưu của nhóm. Chỉ có tên file và ngày chưa đủ phân biệt hai phiên bản khác nhau cùng đường dẫn. Dấu vết này giúp tái lập và giải thích báo cáo, nhưng không tự chứng minh nguồn web ban đầu đã được thu đầy đủ.
Cuối đợt kiểm, đối chiếu tiêu chí đã đặt với bằng chứng thực tế thay vì thêm tuyên bố chất lượng chung. Bộ mẫu hiện tại kiểm được phân luồng giá, schema khác nhau và số dòng Parquet đọc lại. Những câu hỏi về quy mô, đồng thời nhiều tiến trình và phục hồi sau sự cố cần phép kiểm riêng khi có yêu cầu vận hành tương ứng.
Ghi nhớ: giữ dữ liệu gốc và nguồn file, rồi mới chuẩn hóa, cách ly và xuất bảng đã kiểm.
Anh em hãy lưu dữ liệu mẫu cùng cấu hình và kết quả đối chiếu để lần cập nhật sau có cơ sở kiểm lại. Tham khảo thêm tại Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam. Bắt đầu từ phạm vi nhỏ và tiêu chí rõ ràng khi triển khai DuckDB xử lý dữ liệu crawl JSONL.


