
Confluence API bằng Python: đọc trang REST v2, version và body
Confluence API bằng Python là cách đọc các trang tài liệu nội bộ trên Confluence Cloud qua REST API phiên bản 2, lấy tiêu đề, phiên bản và nội dung để đưa vào kho tìm kiếm hay bản sao lưu. Cách làm đúng là gọi API bằng tài khoản được cấp quyền, không đăng nhập trình duyệt rồi cào HTML. ProxyVN đã gọi thật điểm cuối Confluence Cloud không kèm khóa ngày 29/10/2026 để ghi mã lỗi, rồi dựng server giả lập theo đặc tả OpenAPI chính thức để chạy phân trang, đọc body và retry.
Confluence API bằng Python: mục tiêu dữ liệu, quyền và phạm vi truy cập
Trước khi viết code, anh em cần chốt đọc không gian nào, trang nào và để làm gì. Confluence của một công ty có thể chứa hàng chục nghìn trang, trong đó có trang hạn chế quyền mà người viết script không được thấy.
Đọc trang để làm gì
Nhu cầu hay gặp nhất là đưa tài liệu nội bộ vào công cụ tìm kiếm riêng hoặc hệ thống hỏi đáp. Nhu cầu thứ hai là sao lưu nội dung một không gian ra file text có kèm phiên bản. Nhu cầu thứ ba là kiểm tra trang nào lâu không cập nhật để nhắc chủ trang.
Cả ba nhu cầu chỉ cần đọc. Bài này không tạo, sửa hay xóa trang. Script đọc sai cùng lắm là thiếu dữ liệu, còn script ghi sai có thể làm hỏng tài liệu của cả nhóm.
Quyền đi theo tài khoản
Confluence trả về những gì tài khoản gọi API được phép xem. Trang có hạn chế quyền sẽ không xuất hiện trong danh sách nếu tài khoản không có quyền. Không có cách nào dùng API để xem trang mình không được phép xem, và cũng không nên tìm cách đó.
Khi dùng token API của một người, script thấy đúng những gì người đó thấy. Với tác vụ chạy định kỳ, nên dùng tài khoản dịch vụ chỉ được cấp quyền đọc vào đúng những không gian cần thiết.
Token API mang quyền của người tạo ra nó, nên token của quản trị viên trong một script đọc là quá nhiều quyền.
Phạm vi OAuth cho đọc trang
Đặc tả OpenAPI phiên bản 2 ghi điểm cuối danh sách trang chấp nhận Basic auth hoặc OAuth 2.0 với phạm vi read:page:confluence. Ứng dụng OAuth chỉ xin phạm vi này sẽ không ghi được trang nào.
Với script nội bộ, Basic auth bằng email và token API là cách đơn giản nhất. Trang Basic auth cho REST API của Confluence hướng dẫn tạo token. Bài này không tạo token thật.
Không scrape sau đăng nhập
Có người dùng Selenium đăng nhập Confluence rồi cào HTML từng trang. Cách này chậm, dễ gãy khi giao diện đổi, và lưu cookie phiên đăng nhập vào máy chạy script là rủi ro bảo mật. API trả nội dung có cấu trúc, có phiên bản, nên không có lý do để cào giao diện.
Bài web scraping proxy là gì nói về thu thập từ trang công khai không có API. Confluence nội bộ có API và có quyền, đó là đường đi đúng.
Phần chạy thật và phần giả lập
Lab không có tài khoản Confluence và không đăng ký tài khoản mới. Phần chạy thật là gọi điểm cuối Confluence Cloud không kèm khóa hoặc kèm khóa giả để ghi mã trạng thái và thân lỗi.
Phần phân trang, đọc body, đọc phiên bản và retry chạy trên server giả lập cục bộ ở cổng 9720. Server giả lập trả dữ liệu theo đúng cấu trúc trong file đặc tả OpenAPI phiên bản 2.0.0 mà Atlassian công bố, nhưng nó không phải Confluence thật.
Đầu ra của bài này
Bài hướng tới ba đầu ra: một danh mục trang gồm page ID, tiêu đề, space ID, trang cha, trạng thái và số phiên bản; một hàm chuyển body sang text; và file xuất text kèm đường dẫn nguồn. File xuất không chứa thông tin người dùng như account ID hay tên người được nhắc tới.
Confluence API bằng Python: đọc các trang được cấp quyền qua REST v2, giữ version và định dạng body
Phần này giải thích cấu trúc một trang trong REST v2, hai định dạng body và cách giữ phiên bản.
Cấu trúc danh sách trang
Theo đặc tả, điểm cuối GET /wiki/api/v2/pages trả một đối tượng gồm results và _links. Mỗi phần tử trong results có id, status, title, spaceId, parentId, parentType, position, authorId, ownerId, lastOwnerId, subtype, createdAt, version, body và _links.
Trường id là chuỗi số. Khi lưu vào cơ sở dữ liệu, nên lưu dạng chuỗi để không mất số 0 đầu hay tràn kiểu số nguyên. Trường spaceId cũng là id số của không gian, không phải khóa ngắn như LAB hay HR.
Phiên bản là một đối tượng
Trường version gồm number, createdAt, message, minorEdit và authorId. Số phiên bản tăng mỗi lần trang được lưu. Lưu number và createdAt cho phép biết lần sau có cần tải lại trang không.
Server giả lập trả lịch sử phiên bản của trang 98302 gồm ba phiên bản: 3, 2 và 1, trong đó phiên bản 2 có minorEdit là true. Chỉnh sửa nhỏ thường là sửa lỗi chính tả, không gửi thông báo. Báo cáo theo dõi thay đổi có thể bỏ qua các bản này.
Hai định dạng body chính
Storage và ADF
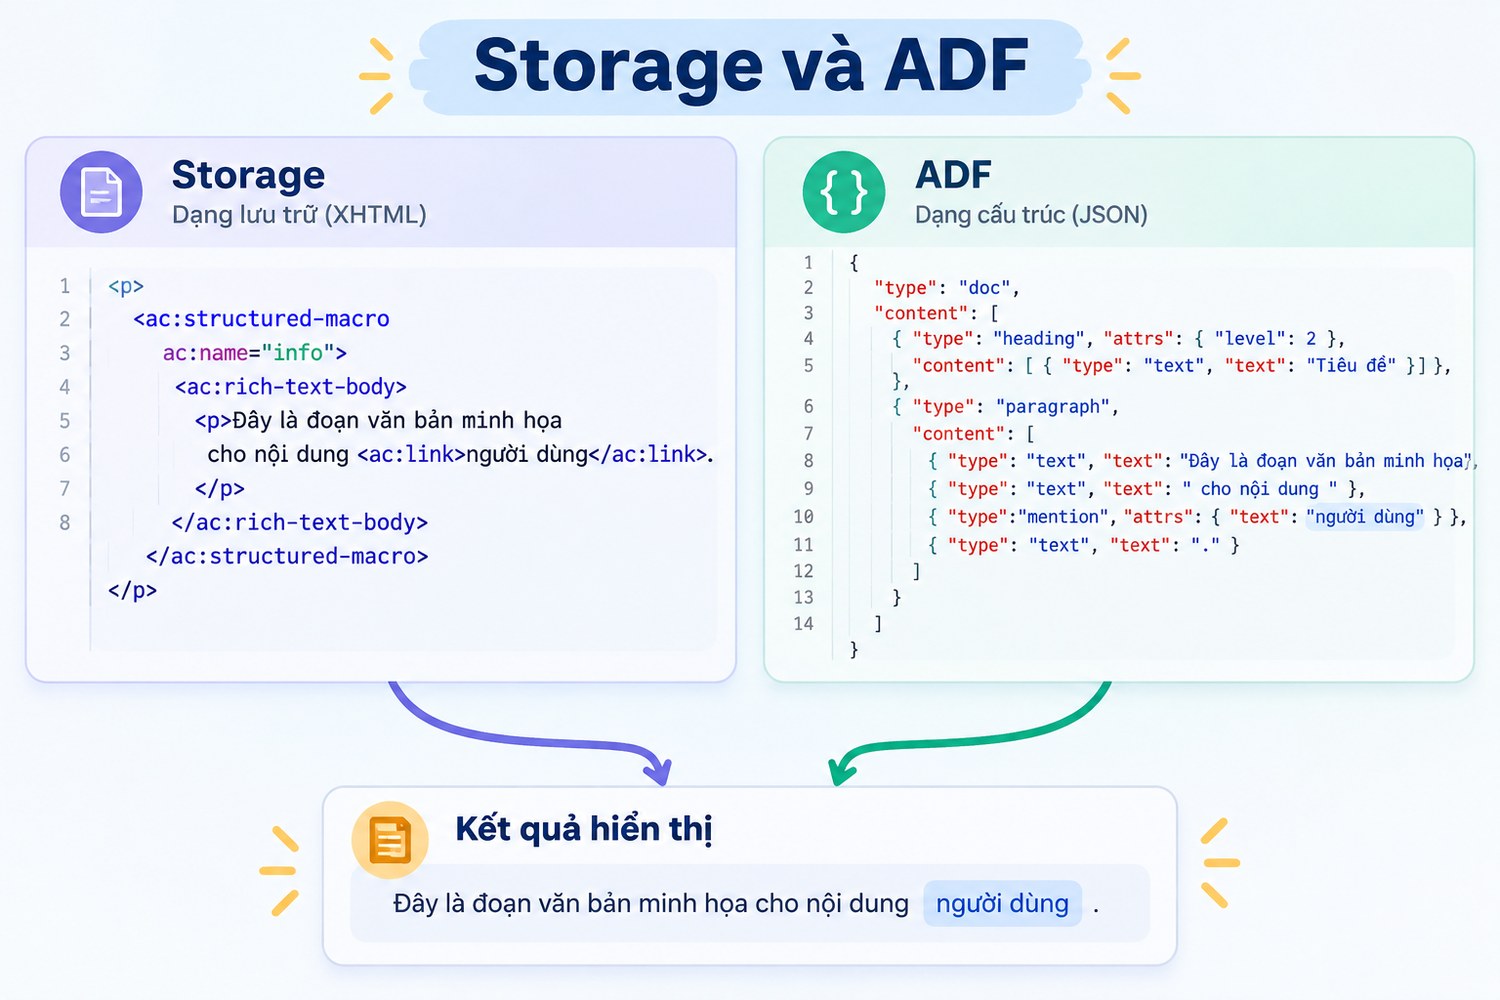
Tham số body-format nhận storage hoặc atlas_doc_format theo đặc tả. Storage là định dạng XHTML riêng của Confluence, có thẻ như ac:structured-macro và ri:user. Atlas doc format, gọi tắt là ADF, là cây JSON mô tả tài liệu.
Mặc định danh sách trang không trả body. Phải thêm body-format thì mới có nội dung. Đây là chỗ hay sai: script lấy được danh sách trang nhưng mọi body đều rỗng vì quên tham số.
Body storage trông như thế nào
Server giả lập trả body storage có tiêu đề h2, một đoạn có thẻ code và strong, một macro info và một đoạn nhắc tới người dùng bằng thẻ ri:user kèm account ID. Đây là những thành phần thường gặp trong trang Confluence thật.
Hàm chuyển sang text của lab thay thẻ ri:user bằng chữ [nguoi dung], bỏ thẻ, giữ xuống dòng sau đoạn và tiêu đề. Kết quả gồm bốn dòng: tiêu đề "Cai dat", đoạn hướng dẫn cài requests, dòng "Luu y quyen" và dòng "Lien he [nguoi dung]".
import re, html
def storage_text(s):
    s = re.sub(r"<ri:user[^>]*/>", "[nguoi dung]", s)
    s = re.sub(r"</(p|h\d|li)>", "\n", s)
    s = re.sub(r"<[^>]+>", "", s)
    return html.unescape(s).strip()
Body ADF là chuỗi JSON lồng trong JSON
Khi chọn atlas_doc_format, trường value của body là một chuỗi, không phải đối tượng. Lab kiểm tra kiểu của value trong phản hồi giả lập: str. Phải gọi json.loads trên value rồi mới duyệt cây được.
Hàm duyệt ADF của lab đi qua từng nút, lấy text ở nút loại text, thay nút mention bằng [nguoi dung], thêm xuống dòng sau paragraph và heading. Kết quả trùng với hàm storage. Hai định dạng cho cùng một nội dung text khi xử lý đúng.
Chọn định dạng nào
Storage dễ xử lý bằng biểu thức chính quy hoặc thư viện HTML, nhưng macro có cấu trúc riêng. ADF có cấu trúc rõ ràng hơn, dễ duyệt chính xác, nhưng cần viết hàm duyệt cây. Với mục tiêu xuất text cho tìm kiếm, cả hai đều được.
Nên chọn một định dạng cho cả kho và ghi định dạng đó vào metadata của file xuất. Trộn hai định dạng trong cùng một kho làm hàm xử lý phức tạp không cần thiết. Bài chuyển HTML sang JSON có thêm cách tách cấu trúc từ HTML.
Chuẩn bị truy vấn, page ID, token và phiên bản cho Confluence API bằng Python
Phần này đi qua địa chỉ site, cách lấy cloud ID, cách gửi token và các tham số lọc trong đặc tả.
Địa chỉ site và tiền tố đường dẫn
Confluence Cloud có địa chỉ dạng tencongty.atlassian.net. API phiên bản 2 nằm dưới /wiki/api/v2. API phiên bản 1 cũ nằm dưới /wiki/rest/api. Trang giới thiệu REST API v2 mô tả các nhóm điểm cuối của phiên bản 2.
Ứng dụng OAuth không gọi thẳng địa chỉ site mà gọi qua cổng api.atlassian.com/ex/confluence/{cloudId}. Cloud ID là mã định danh của site, khác với tên miền.
Lấy cloud ID
Lab gọi đường dẫn /_edge/tenant_info của một site Atlassian công khai. Site trả 200 với JSON chứa cloudId dạng UUID. Đường dẫn này không cần xác thực và chỉ trả mã site, không trả nội dung.
Sau đó lab gọi cổng api.atlassian.com với cloud ID đó, không token và với token Bearer giả. Cả hai đều trả 404 với mã NOT_FOUND. Cổng không trả 401 mà trả 404 khi không xác thực được.
Mã lỗi thật khi không có quyền
404 khi thiếu quyền
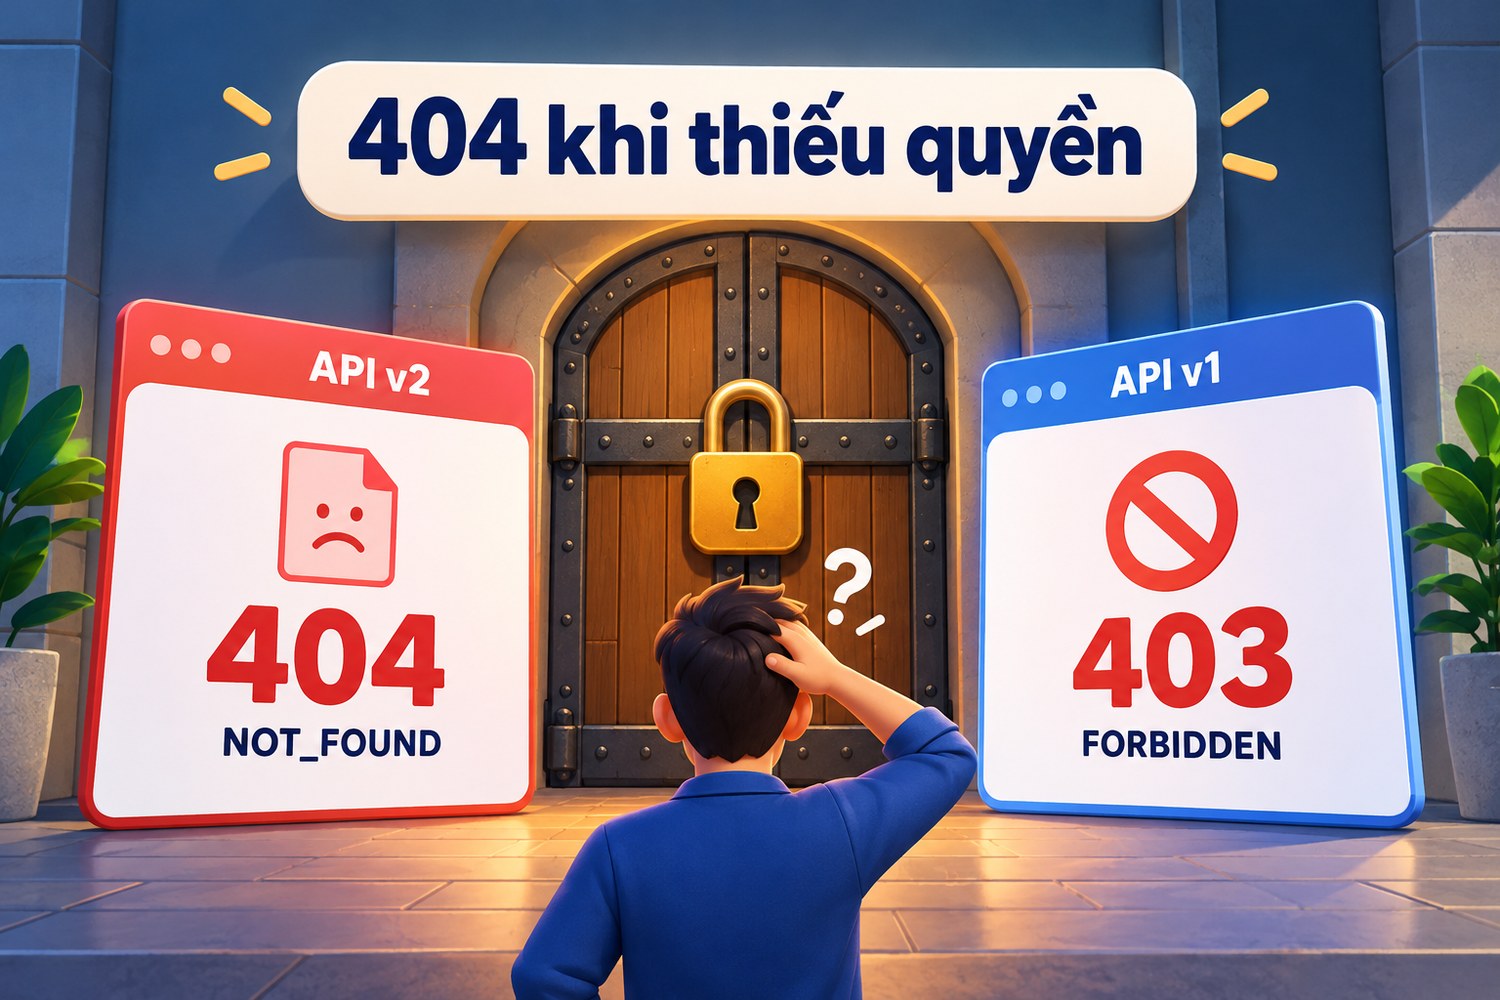
Lab gọi /wiki/api/v2/pages và /wiki/api/v2/spaces của site đó không kèm xác thực. Cả hai trả 404, thân JSON có errors với status 404 và code NOT_FOUND. Gửi Basic auth bằng email giả và token giả cũng trả 404.
Gọi API phiên bản 1 /wiki/rest/api/content không xác thực lại trả 403, thân báo request bị từ chối vì người gọi không truy cập được Confluence. Hai phiên bản API trả hai mã khác nhau cho cùng tình huống.
Với Confluence Cloud, 404 ở API v2 có thể là thiếu quyền chứ không chỉ là sai đường dẫn.
Gửi token đúng cách
Basic auth gửi chuỗi email:token mã hóa base64 trong header Authorization. Đọc email và token từ biến môi trường, không ghi vào file mã hay commit lên kho mã nguồn.
import os, requests
S = requests.Session()
S.auth = (os.environ["CONF_EMAIL"], os.environ["CONF_TOKEN"])
r = S.get("https://tencongty.atlassian.net/wiki/api/v2/pages",
          params={"space-id": "65537", "limit": 100, "body-format": "storage"}, timeout=30)
Đoạn mã trên chưa chạy với site và token thật. Tên site và space-id là ví dụ.
Tham số lọc trong đặc tả
Đặc tả liệt kê các tham số id, space-id, sort, status, title, body-format, subtype, cursor và limit cho danh sách trang. Tham số limit có mặc định 25, tối thiểu 1, tối đa 250. Tham số status nhận current, archived, trashed, deleted, historical hoặc draft tùy điểm cuối.
Điểm cuối /spaces/{id}/pages có thêm tham số depth với giá trị all hoặc root. Lấy root chỉ trả trang cấp cao nhất của không gian, hữu ích khi dựng cây trang từ trên xuống.
Trang lưu trữ không có trong mặc định
Server giả lập có 7 trang, trong đó 1 trang ở trạng thái archived. Gọi danh sách không chỉ định status trả 6 trang. Gọi với status=current và status=archived trả đủ 7 trang. Hành vi này là thiết kế của server giả lập theo mô tả trong đặc tả, chưa đối chiếu với site thật.
Nếu mục tiêu là sao lưu, nên lấy cả trang lưu trữ và ghi trạng thái vào danh mục. Nếu mục tiêu là tìm kiếm, có thể chỉ lấy trang hiện hành.
Thu dữ liệu Confluence API bằng Python có phân trang cursor theo đúng nguồn
Confluence REST v2 phân trang bằng cursor chứ không bằng số trang. Phần này đưa vòng lặp đã chạy trên server giả lập và cách retry.
Cursor trong _links.next và header Link
Phân trang cursor
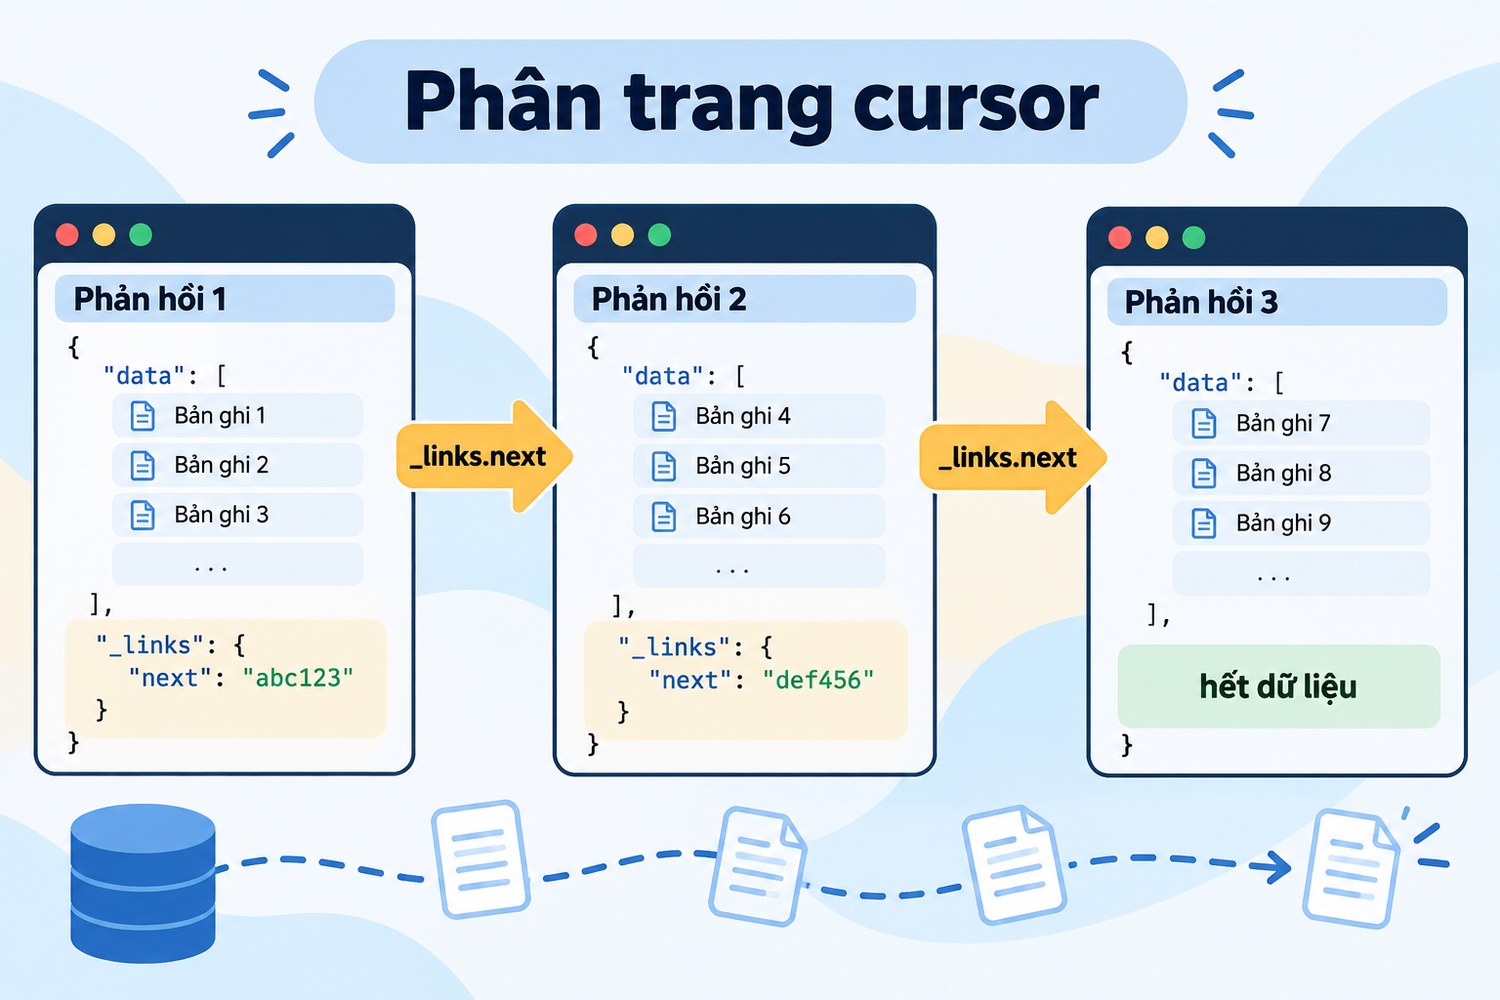
Theo đặc tả, khi còn dữ liệu, phản hồi có _links.next chứa đường dẫn tương đối với tham số cursor. Header Link cũng chứa đường dẫn đó với rel="next". Khi hết dữ liệu, _links.next không còn.
Đường dẫn trong _links.next là tương đối, bắt đầu bằng /wiki/api/v2. Phải ghép với địa chỉ site, lấy từ _links.base, rồi mới gọi được.
Vòng lặp đã chạy
Lab gọi danh sách trang với limit 2 và body-format storage trên server giả lập. Vòng lặp đi theo _links.next tới khi không còn.
url = BASE + "/api/v2/pages"; params = {"limit": 2, "body-format": "storage"}; got = []
while url:
    d = S.get(url, params=params, timeout=10).json(); got += d["results"]
    nxt = d["_links"].get("next")
    url = d["_links"]["base"].rsplit("/wiki", 1)[0] + nxt if nxt else None
    params = None
Kết quả: 3 lần gọi, 6 trang hiện hành, id từ 98301 tới 98307, bỏ qua 98304 vì trang đó đã lưu trữ. Phản hồi cuối không có header Link, đúng điều kiện dừng.
Không tự sửa cursor
Cursor là chuỗi mờ do máy chủ tạo. Trong server giả lập, cursor là số thứ tự mã hóa base64, nhưng Confluence thật có thể dùng cách khác. Không giải mã, không tự tăng, không lưu cursor để dùng lại sau nhiều giờ.
Đường dẫn trong _links.next đã giữ body-format và limit. Lab đặt params bằng None sau lần gọi đầu để không gửi trùng tham số.
limit vượt 250
Đặc tả ghi limit tối đa 250. Server giả lập được viết để trả 400 với mã INVALID_REQUEST_PARAMETER khi limit bằng 300. Đây là hành vi lab tự đặt để kiểm tra code xử lý lỗi 400, chưa đối chiếu Confluence thật trả 400 hay tự hạ về 250.
Script an toàn nên đặt limit không quá 250 từ đầu. Với body lớn, limit thấp hơn giúp mỗi phản hồi nhẹ hơn và lỗi giữa chừng mất ít dữ liệu hơn.
Retry khi bị giới hạn
Trang giới hạn request của Confluence Cloud mô tả việc trả 429 kèm header cho biết khi nào thử lại. Lab không chạm giới hạn thật, nên dựng điểm cuối giả lập trả 429 kèm Retry-After 1 cho hai lần đầu.
Hàm retry đọc Retry-After rồi chờ. Kết quả: thử lại 2 lần, tổng 2,03 giây, lần cuối trả 200. Đây là kiểm tra logic, không phải số đo hành vi của Confluence thật.
Trang không tồn tại hoặc đã xóa
Server giả lập trả 404 với mã NOT_FOUND khi gọi trang 98399. Với site thật, lab đã thấy 404 cũng xuất hiện khi thiếu quyền. Script nên ghi page ID trả 404 vào danh sách riêng để người có quyền kiểm tra, không coi là lỗi mạng và không retry.
Tách danh mục và body thành hai lượt
Một cách làm gọn hơn là chạy hai lượt. Lượt một gọi danh sách trang không kèm body-format, chỉ lấy id, tiêu đề và version. Lượt hai chỉ gọi body cho những trang có version mới hơn bản đã lưu.
Lượt một nhẹ vì không có nội dung, nên có thể dùng limit cao. Lượt hai nặng hơn nhưng chỉ chạm tới phần nhỏ trang thật sự đổi. Với kho ít thay đổi, cách này giảm đáng kể lượng dữ liệu tải mỗi lần chạy.
Lab chạy lượt một và lượt hai gộp trong một vòng lặp trên server giả lập vì kho chỉ có 7 trang. Cách tách hai lượt là đề xuất cho kho thật, chưa đo thời gian trên Confluence thật.
Dựng cây trang từ parentId
Danh sách trang trả phẳng, mỗi trang có parentId và parentType. Muốn dựng cây, gom trang theo parentId rồi bắt đầu từ trang không có cha. Trong server giả lập, trang 98301 là gốc, sáu trang còn lại có cha là 98300.
Id 98300 không có trong danh sách, đúng loại tình huống trang cha nằm ngoài phạm vi hoặc bị hạn chế quyền. Code dựng cây phải xử lý nút cha thiếu bằng cách gắn các trang con vào một nút tạm, thay vì báo lỗi và dừng.
Đối soát ID, kiểu dữ liệu, giá trị thiếu và xuất xứ trong Confluence API bằng Python
Thu dữ liệu xong, phần này kiểm tra danh mục, phiên bản và loại bỏ thông tin người dùng trước khi xuất.
Danh mục page ID và version
Lab xuất danh mục 6 trang gồm page_id, title, space_id, parent_id, status, version, version_at và webui. Đây là bảng chủ của cả kho. Mọi file text xuất ra đều trỏ về một dòng trong bảng này.
Trường |
Ví dụ từ lab |
Ghi chú |
|---|---|---|
page_id |
98302 |
Chuỗi, khóa chính |
space_id |
65537 |
Id số của không gian |
parent_id |
98300 |
Rỗng với trang gốc |
status |
current |
Có thể là archived |
version |
3 |
Tăng mỗi lần lưu |
version_at |
2026-10-22T08:00:00.000Z |
Giờ UTC |
webui |
/spaces/LAB/pages/98302 |
Đường dẫn tương đối |
Dữ liệu trong bảng là dữ liệu giả lập. Cấu trúc trường lấy theo đặc tả, giá trị do lab đặt.
Kiểm tra trùng và thiếu
Mỗi page_id chỉ xuất hiện một lần trong danh mục. Khi phân trang cursor, trùng ít xảy ra hơn phân trang offset, nhưng vẫn nên kiểm tra. Lab kiểm tra 6 id, không trùng.
Trang có parent_id trỏ tới id không có trong danh mục là dấu hiệu trang cha bị hạn chế quyền hoặc nằm ngoài phạm vi lọc. Ghi lại các trường hợp này để dựng cây trang không bị đứt.
Phiên bản dùng để tải tăng dần
Lần chạy sau so số version mới với version đã lưu. Trang nào có version lớn hơn mới cần tải lại body. Trang có version bằng nhau bỏ qua. Cách này giảm request đáng kể với kho lớn ít thay đổi.
Nếu cần nội dung của một phiên bản cũ, đặc tả có tham số version cho điểm cuối lấy một trang. Server giả lập trả đúng số phiên bản được hỏi. Lab chưa thử với Confluence thật.
Loại bỏ thông tin người dùng
Body storage chứa account ID trong thẻ ri:user, lab xác nhận chuỗi account-id có trong body giả lập. Trường authorId, ownerId và authorId của version cũng là account ID. Đây là định danh người dùng.
File xuất text của lab thay nhắc tên bằng [nguoi dung] và không ghi các trường authorId, ownerId. Nếu cần biết ai là chủ trang để nhắc cập nhật, xử lý trong hệ thống nội bộ có kiểm soát, không đưa vào file xuất chung.
Xuất nội dung trang không đồng nghĩa với xuất danh sách người viết.
Xuất xứ từng file text
Mỗi file text xuất ra nên có phần đầu ghi page_id, title, version, version_at, đường dẫn webui đầy đủ và ngày xuất. Khi ai đó đọc đoạn text trong công cụ tìm kiếm, họ bấm được về trang gốc để xem bản mới nhất.
Lưu JSON gốc bên cạnh file text. Bài JSON và CSV khi crawl dữ liệu bàn khi nào nên giữ JSON gốc.
Lưu kết quả, giới hạn request và khi nào Confluence API bằng Python thực sự cần proxy
Phần cuối nói về lưu trữ, nhịp gọi và vai trò thật của proxy với Confluence.
Cấu trúc thư mục xuất
Một cấu trúc gọn là thư mục theo space_id, trong đó có index.json là danh mục trang, thư mục raw chứa JSON gốc từng trang, và thư mục text chứa file text theo page_id. Đổi tên trang không làm đổi tên file vì file đặt theo id.
Mỗi lần chạy ghi một file nhật ký: số trang đọc, số trang tải lại body, số trang 404, thời gian chạy. Nhật ký giúp phát hiện khi quyền của tài khoản dịch vụ bị thu hẹp.
Nhịp gọi hợp lý
Gọi tuần tự bằng một Session, limit vừa phải, có retry theo Retry-After. Kho vài nghìn trang với limit 100 cần vài chục request danh sách. Chạy song song hàng chục luồng tới Confluence của công ty dễ chạm giới hạn và ảnh hưởng người dùng khác trên cùng site.
Bài rate limit API khi dùng proxy giải thích vì sao đổi IP không phải cách xử lý giới hạn API có xác thực.
Thử qua proxy lab
Lab gọi lại /wiki/api/v2/pages của site Atlassian qua proxy HTTP cục bộ có xác thực ở cổng 9702. Kết quả vẫn là 404 với mã NOT_FOUND, mất 0,886 giây. Proxy chuyển request đi nguyên vẹn, không thay đổi quyền.
px = {"https": "http://user1:p%40ss%232026@127.0.0.1:9702"}
r = requests.get(SITE + "/wiki/api/v2/pages?limit=1", proxies=px, timeout=30)
Kết quả này cho thấy proxy không thay được token. Không có token hợp lệ, qua proxy hay không qua proxy đều không đọc được trang.
Khi nào proxy thực sự cần
Confluence Cloud có tính năng giới hạn truy cập theo dải IP cho gói doanh nghiệp. Khi site của công ty chỉ chấp nhận kết nối từ IP văn phòng, máy chạy script ở nơi khác cần đi qua một IP cố định đã được khai báo. Đó là lúc proxy có vai trò thật.
Trường hợp khác là máy chạy script nằm trong mạng chỉ cho ra Internet qua proxy. Khi đó requests cần biến proxies hoặc biến môi trường HTTPS_PROXY. Bài định dạng proxy có cách viết URL proxy đúng.
Chọn loại proxy khi cần
Với danh sách cho phép theo IP, cần IP cố định, không dùng proxy xoay. ProxyVN có proxy dân cư tĩnh, proxy datacenter, proxy 4G và proxy xoay, hỗ trợ HTTP và SOCKS5. Anh em có thể mua proxy tại ProxyVN, chọn loại IP tĩnh, rồi nhờ quản trị viên Atlassian thêm IP đó vào danh sách cho phép.
Lịch chạy và cảnh báo
Với kho tài liệu thay đổi vài lần mỗi ngày, chạy mỗi đêm là đủ. Nếu số trang đọc được giảm đột ngột so với lần trước, đó thường là dấu hiệu tài khoản dịch vụ bị thu hồi quyền ở một không gian. Script nên gửi cảnh báo thay vì lặng lẽ xóa các trang không còn thấy khỏi kho tìm kiếm.
Cũng nên cảnh báo khi số trang trả 404 tăng mạnh. Một vài trang bị xóa là bình thường, hàng trăm trang cùng lúc thường là vấn đề quyền hoặc token hết hạn.
Giới hạn suy luận của bài
Phần gọi thật chỉ gồm các request không xác thực hoặc kèm khóa giả tới một site Atlassian công khai và cổng api.atlassian.com ngày 29/10/2026. Lab không có tài khoản Confluence, không đọc được trang thật nào.
Phân trang, body, phiên bản, giới hạn limit, trang lưu trữ và retry đều chạy trên server giả lập dựng theo đặc tả OpenAPI phiên bản 2.0.0. Hành vi của Confluence thật có thể khác ở chi tiết. Proxy trong lab là proxy cục bộ.
Checklist Confluence API bằng Python
Checklist Confluence API
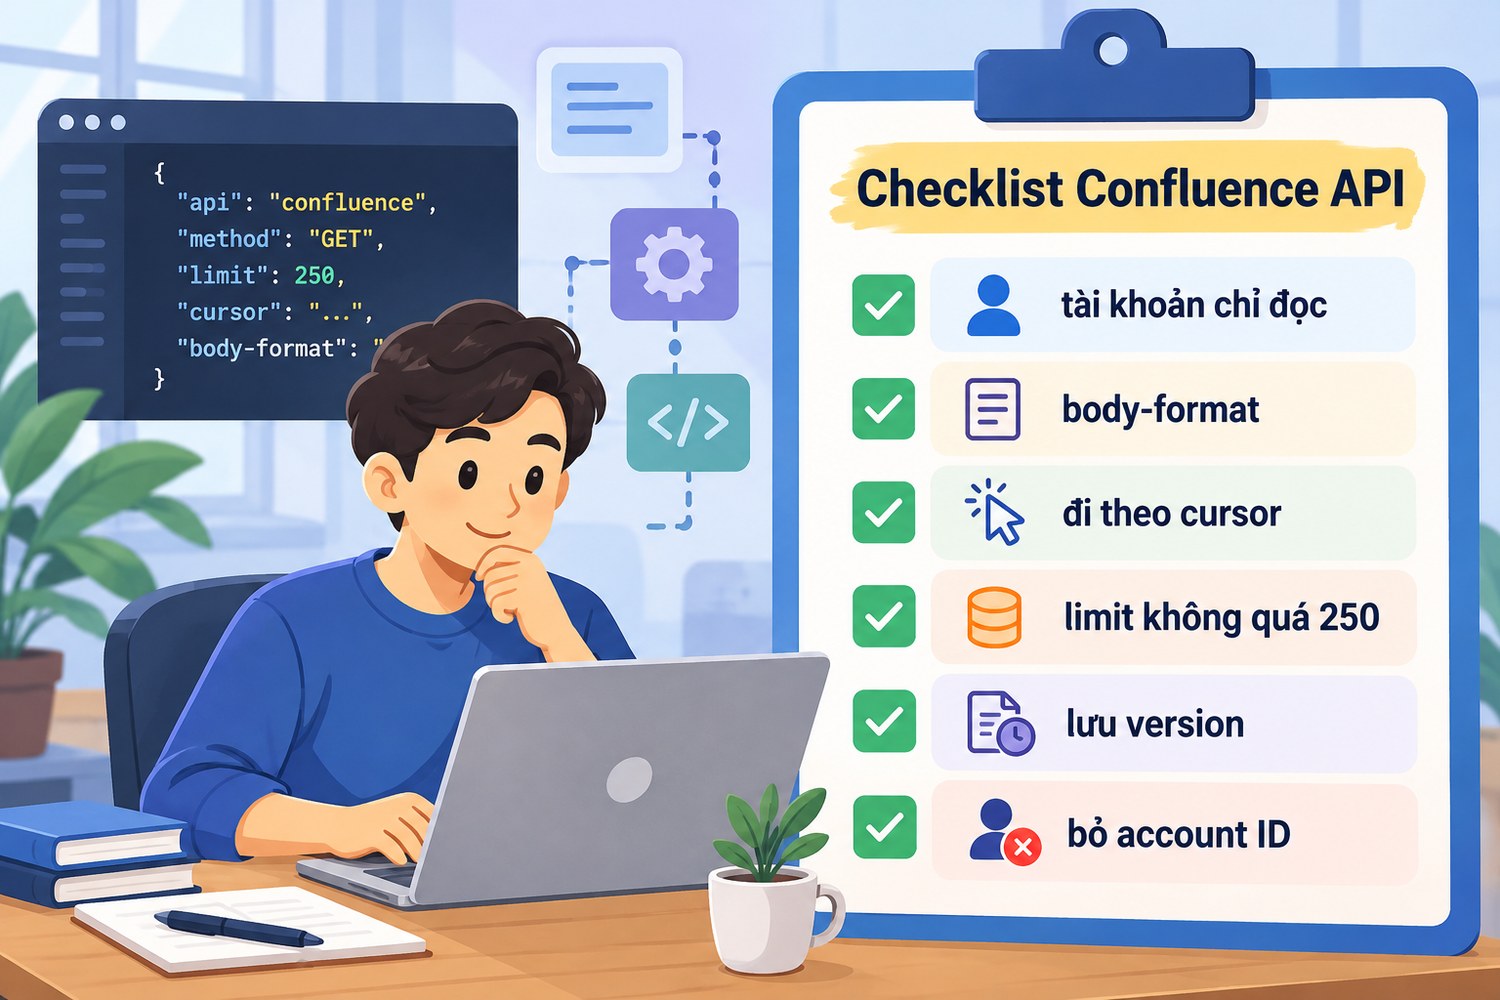
- Dùng tài khoản dịch vụ chỉ có quyền đọc đúng không gian.
- Gọi /wiki/api/v2, thêm body-format để có nội dung.
- Đi theo _links.next, ghép với _links.base, không sửa cursor.
- Giữ limit không quá 250, retry theo Retry-After.
- Coi 404 có thể là thiếu quyền, ghi lại để kiểm tra.
- Lưu page_id dạng chuỗi và số version để tải tăng dần.
- Thay account ID bằng nhãn trung tính trước khi xuất text.
- Ghi đường dẫn nguồn và phiên bản vào đầu mỗi file xuất.
Câu hỏi thường gặp về Confluence API bằng Python
Nên dùng API v1 hay v2?
Bài dùng v2 vì Atlassian đang phát triển các điểm cuối mới ở đó. Lab thấy v1 và v2 trả mã lỗi khác nhau khi không xác thực, 403 và 404, nên code xử lý lỗi cần viết riêng cho từng phiên bản.
Vì sao danh sách trang không có nội dung?
Mặc định không trả body. Thêm tham số body-format là storage hoặc atlas_doc_format.
Vì sao gọi API trả 404 dù trang có tồn tại?
Với Confluence Cloud v2, lab thấy request không có quyền nhận 404. Kiểm tra token, email và quyền của tài khoản trên không gian đó trước khi nghi ngờ đường dẫn.
Body ADF đọc thế nào?
Trường value là chuỗi JSON. Gọi json.loads rồi duyệt cây, lấy text ở nút text và xử lý riêng nút mention.
Có lấy được trang hạn chế quyền không?
Không, trừ khi tài khoản gọi API có quyền xem trang đó. API không có cách vượt hạn chế quyền.
Proxy có giúp đọc Confluence nhanh hơn không?
Lab không thấy lý do. Proxy chỉ cần khi site giới hạn IP hoặc mạng nội bộ bắt buộc đi qua proxy. Bài cài đặt Python proxy từ thư viện requests hướng dẫn khai báo proxy cho requests.
Confluence API bằng Python và những điều cần nhớ
Confluence API bằng Python là cách đọc tài liệu nội bộ đúng quyền, có phiên bản và có cấu trúc, thay cho cào HTML sau đăng nhập. Lab ngày 29/10/2026 ghi lại Confluence Cloud v2 trả 404 khi thiếu quyền còn v1 trả 403, rồi chạy phân trang cursor, hai định dạng body và retry trên server giả lập theo đặc tả. Giữ page_id, version và đường dẫn nguồn, bỏ account ID khỏi file xuất. Cần IP tĩnh cho danh sách cho phép khi làm Confluence API bằng Python, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


