
XPath và CSS selector chọn theo dữ liệu và engine
XPath và CSS selector đều giúp chọn phần tử khi thu thập dữ liệu, nhưng cách diễn đạt quan hệ và lấy giá trị có khác biệt. Anh em nên chọn theo đầu ra, engine và khả năng bảo trì. ProxyVN hướng dẫn so sánh trên cùng fixture, chạy mười bốn kiểm tra cục bộ và lập tiêu chí chuyển đổi mà không dựa vào lời khẳng định tốc độ chung chung.
XPath và CSS selector theo mục tiêu thu thập
Một quyết định chọn công cụ cần bắt đầu từ dữ liệu cần lấy, không từ việc biểu thức nào trông ngắn hơn. Nếu mục tiêu là các card mang class product, cả hai cách đều có thể đáp ứng. Khi cần đọc chuỗi, thuộc tính hoặc một quan hệ với nhãn ở gần, cách viết và bước xử lý kết quả sẽ khác nhau.
Phân biệt ngôn ngữ chọn với thư viện thực thi
CSS selector là cú pháp chọn phần tử, còn BeautifulSoup hoặc API của browser là nơi thực thi lựa chọn trong một ngữ cảnh cụ thể. XPath cũng cần một engine như lxml để đánh giá biểu thức. Không nên nói đã chọn CSS hay XPath mà bỏ qua thông tin chương trình thực sự chạy trên thư viện nào và đọc cây tài liệu nào.
Tài liệu CSS selectors của MDN giúp đối chiếu các kiểu lựa chọn. Trong bài, CSS được chạy qua BeautifulSoup và SoupSieve, còn XPath chạy trên lxml. Đây là phép đối chiếu kết quả của một fixture nhỏ, không phải benchmark mọi browser hoặc mọi phiên bản thư viện.
Định nghĩa kết quả trước biểu thức
Kết quả chính cần là hai card P01 và P02 trong catalog, kèm hai liên kết tiêu đề a1 và a2. Một card quảng cáo có class product-card phải bị loại. Fixture còn có heading đứng trước các article để làm rõ sự khác nhau giữa vị trí trong danh sách mọi phần tử con và vị trí giữa các phần tử cùng loại.
Việc ghi mã mong đợi giúp kiểm tra truy vấn đang chọn đúng phần tử, thay vì chỉ kiểm tra danh sách không rỗng. Hai biểu thức đều trả hai phần tử vẫn có thể chọn hai phần tử khác nhau. Khi chuyển công cụ trong hệ thống thật, hãy đối chiếu định danh hoặc trường dữ liệu có ý nghĩa theo từng dòng, không chỉ so tổng số.
Chọn một ngôn ngữ phù hợp là bước đầu; tính đúng của bộ thu thập được xác nhận bằng những bản ghi mà biểu thức thực sự trả về.
XPath và CSS selector với fixture đối chiếu
Một fixture tốt phải chứa cả phần tử cần lấy lẫn phần tử dễ bị lấy nhầm. Nhờ vậy, sự khác biệt giữa token class, chuỗi con và phạm vi truy vấn được thể hiện bằng kết quả. Anh em không cần gọi website thật để học hoặc kiểm tra những đặc điểm này.
Chuẩn bị môi trường có ghi phiên bản
Bộ thử của bài đã chạy Python 3.12.14, BeautifulSoup 4.14.3, SoupSieve 3.0.4 và lxml 6.1.1. Các số này mô tả môi trường đã được dùng, không phải cam kết một biểu thức nâng cao được hỗ trợ ở mọi engine. Khi triển khai sang môi trường khác, hãy chạy lại các ca quan trọng trước khi thay cấu hình nguồn.
python -m pip install beautifulsoup4==4.14.3 soupsieve==3.0.4 lxml==6.1.1Lưu HTML dưới đây thành selector-fixture.html bằng UTF-8. Hai sản phẩm là dữ liệu giả lập, không phản ánh cửa hàng hoặc khách hàng nào. Thẻ b trong tiêu đề Alpha One được thêm để kiểm tra việc lấy văn bản có cấu trúc lồng, còn class product-card giúp phát hiện lựa chọn bằng chuỗi con quá rộng.
<!doctype html><html><head><meta charset="utf-8"></head><body><main>
<section id="catalog"><h1 id="heading">Danh mục</h1>
<article id="p1" class="product featured" data-id="P01">
<h2><a id="a1" class="title" href="/one">Alpha <b>One</b></a></h2></article>
<article id="p2" class="product" data-id="P02">
<h2><a id="a2" class="title" href="/two">Beta Two</a></h2></article>
<article id="ad" class="product-card" data-id="AD"><h2>Quảng cáo</h2></article>
</section></main></body></html>
Tạo hai cây từ cùng đầu vào
Đọc cùng bytes để tránh vô tình so hai bản tài liệu khác nhau. Đoạn dưới tạo cây cho BeautifulSoup và lxml rồi giữ chúng cho các truy vấn tiếp theo. Trong bài, HTML được viết rõ cấu trúc để giảm nhiễu do khác biệt sửa lỗi tài liệu giữa parser.
from pathlib import Path
from bs4 import BeautifulSoup
from lxml import html

raw = Path('selector-fixture.html').read_bytes()
soup = BeautifulSoup(raw, 'html.parser')
tree = html.fromstring(raw)
Với HTML bị hỏng trên nguồn thật, hai parser có thể tạo cây khác nhau trước cả khi selector được áp dụng. Khi kết quả lệch, kiểm tra cấu trúc cây đã phân tích thay vì kết luận ngôn ngữ truy vấn nào sai. Hãy lưu mẫu được phép sử dụng cùng tên parser để người khác tái hiện đúng đầu vào.
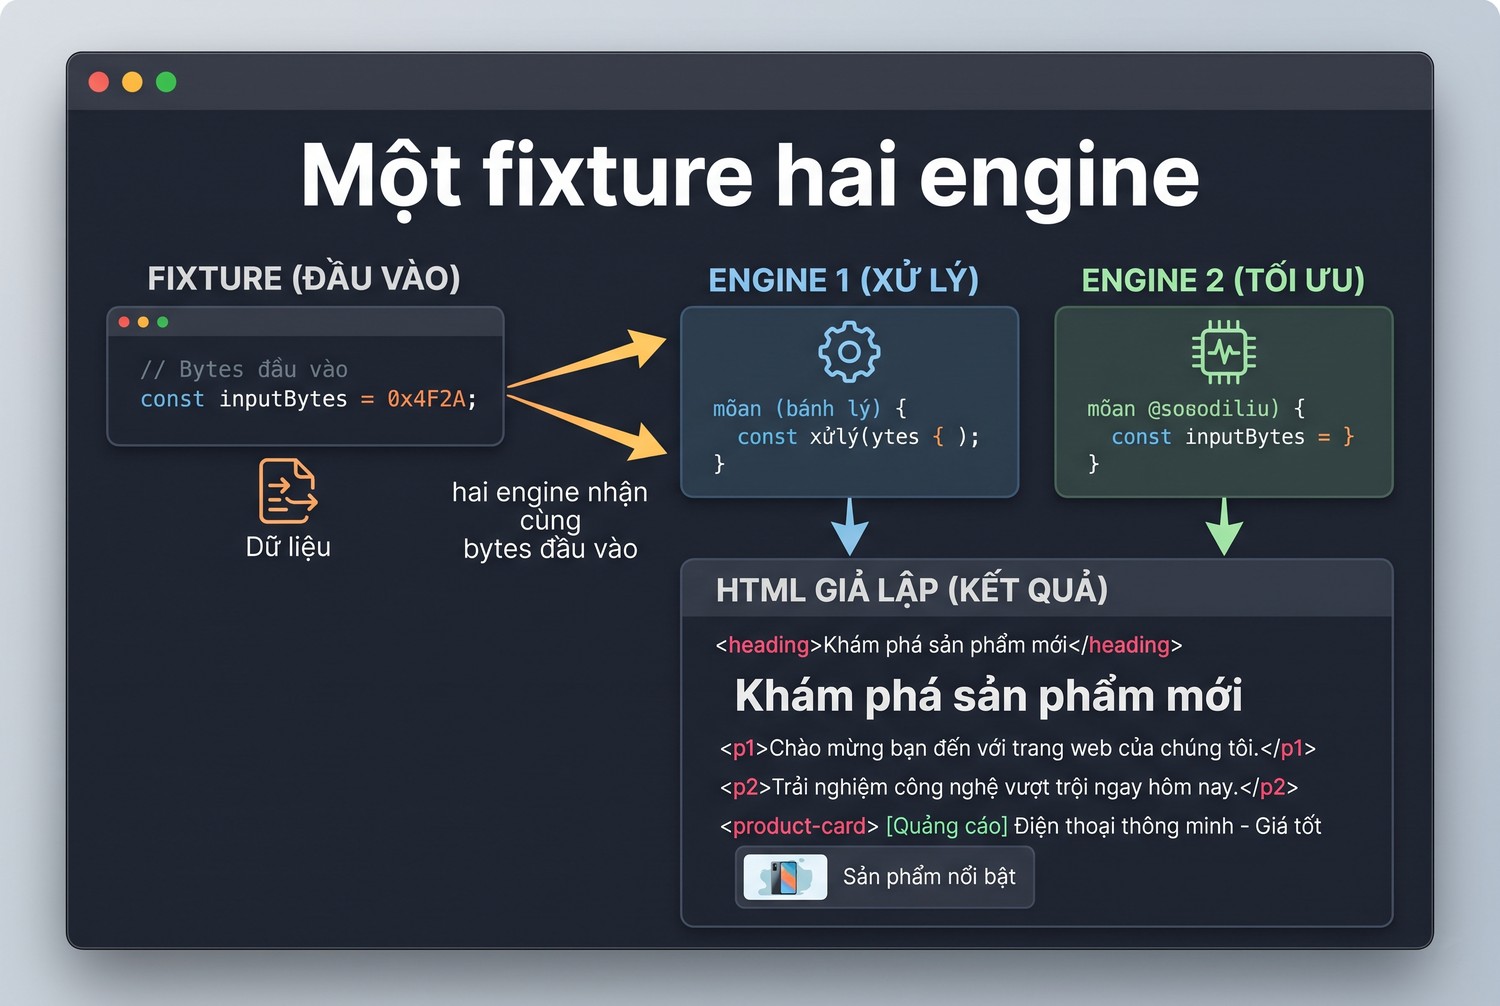
Một fixture hai engine
XPath và CSS selector khi chọn class cùng thuộc tính
CSS có cú pháp class ngắn gọn, còn XPath cần diễn đạt rõ token nếu không muốn khớp chuỗi con. Cả hai đều cần thêm phạm vi catalog để thể hiện ý định thu thập. Không bỏ điều kiện vùng chỉ vì fixture hiện tại chưa có nhiều nhóm sản phẩm ngoài danh mục chính.
Chọn card chính và kiểm tra định danh
Trong CSS, article.product khớp token product trong class. Trong XPath mẫu, điều kiện thêm khoảng trắng hai phía và chuẩn hóa khoảng trắng nhằm diễn đạt token tương ứng. Truy vấn không dùng contains(@class,'product') đơn lẻ vì điều kiện ấy còn khớp product-card trong fixture.
css_cards = soup.select('#catalog > article.product')
token = "contains(concat(' ', normalize-space(@class), ' '), ' product ')"
xp_cards = tree.xpath("//section[@id='catalog']/article[" + token + "]")
assert [node['id'] for node in css_cards] == ['p1', 'p2']
assert [node.get('id') for node in xp_cards] == ['p1', 'p2']
Không rút gọn XPath thành @class='product' rồi xem nó tương đương CSS class selector. Điều kiện bằng cả chuỗi không nhận card p1 đang có thêm featured. Khi chuyển nhiều cấu hình, hãy tìm những phép so class như vậy và thêm fixture có nhiều token cùng thứ tự khác nhau để phát hiện bỏ sót.
Thuộc tính định danh dễ đối chiếu
Với một trường dữ liệu ổn định như data-id, cả hai cách có thể chọn bản ghi P02 trực tiếp. Lựa chọn theo định danh thường dễ kiểm tra hơn đường dẫn dài dựa vào vị trí các khối giao diện. Dù vậy, tính ổn định phải được xác nhận từ nguồn, không được suy ra chỉ vì thuộc tính có chữ id trong tên.
Khi thuộc tính có ký tự đặc biệt, cách trích dẫn và truyền giá trị cần theo engine đang dùng. Không ghép dữ liệu tùy ý vào một biểu thức rồi kỳ vọng mọi dấu nháy đều được xử lý đúng. Với XPath của lxml có thể dùng biến cho giá trị; với CSS cần cơ chế thoát phù hợp tại nơi tạo biểu thức hoặc ánh xạ lựa chọn đã kiểm soát.
Không gộp việc chọn và ghi dữ liệu
Nên có một bước xác nhận số phần tử hoặc định danh trước khi tạo bản ghi đầu ra. Nếu selector chọn hai card nhưng một card thiếu tiêu đề, đừng dùng danh sách tiêu đề toàn trang để bù vào. Mỗi trường phải được đọc dưới đúng card, giữ quan hệ nguồn của dữ liệu.
Một danh sách nhìn đủ dòng vẫn có thể ghép sai tiêu đề và URL nếu các trường được lấy bằng truy vấn độc lập toàn trang. Điều này không phụ thuộc việc dùng CSS hay XPath. Hãy tổ chức parser theo từng bản ghi và thêm một fixture thiếu trường để kiểm tra chương trình không âm thầm làm lệch thứ tự.
XPath và CSS selector với văn bản và giá trị trả về
CSS selector chọn phần tử, còn việc lấy văn bản hoặc thuộc tính thường do API thư viện thực hiện sau đó. XPath có thể trả ngay một giá trị chuỗi hoặc danh sách thuộc tính qua biểu thức. Sự khác nhau này ảnh hưởng kiểu đầu ra và cách viết kiểm tra, không phải bằng chứng rằng một cách luôn phù hợp hơn.
Đọc tiêu đề có thẻ lồng
Fixture chứa Alpha ở trong thẻ a và One ở trong thẻ b. Cách đọc cần giữ được cả hai phần cùng khoảng cách phù hợp. Trong phép thử, BeautifulSoup dùng get_text với dấu cách và strip, còn XPath dùng normalize-space trên phần tử liên kết đã xác định.
css_title = soup.select_one('#a1').get_text(' ', strip=True)
xp_title = tree.xpath('normalize-space(//a[@id="a1"])')
assert css_title == xp_title == 'Alpha One'
Quy tắc chuẩn hóa trong hai lệnh không nên được coi là tương đương cho mọi cấu trúc văn bản. Với nội dung cần giữ xuống dòng hoặc khoảng trắng có ý nghĩa, hãy định nghĩa chính sách khác và lưu thêm bản thô nếu cần. Kiểm tra trên fixture đại diện có giá trị hơn suy luận từ một tiêu đề chỉ có hai từ.
Lấy href theo đúng API
Với BeautifulSoup, chọn thẻ rồi đọc thuộc tính href. Với XPath, có thể dùng @href trong biểu thức và nhận danh sách chuỗi. Cả hai đường đều cần quyết định khi không có phần tử, thiếu thuộc tính hoặc có nhiều liên kết, thay vì chỉ thêm [0] ở mọi nơi để làm mã ngắn.
Không mặc định chuỗi rỗng có cùng ý nghĩa với thiếu phần tử. Một thẻ tồn tại nhưng không có href khác với một card không có thẻ liên kết tiêu đề. Ghi chính sách trường bắt buộc trong schema rồi kiểm tra số lượng trước khi đọc giá trị; cách làm này giữ lỗi dữ liệu rõ ràng trong cả hai phiên bản parser.
Tìm theo nội dung cần phân biệt phần mở rộng
Không chép các pseudo-class tìm chữ của một công cụ vào CSS chuẩn rồi giả định browser nào cũng chạy. Có engine cung cấp phần mở rộng, trong khi XPath có điều kiện văn bản ngay trong ngôn ngữ. Nếu dùng phần mở rộng, hãy ghi tên engine và thêm phép thử khi nâng phiên bản hoặc chuyển sang thư viện khác.
Một hướng khác là dùng CSS chọn vùng ứng viên rồi lọc nội dung bằng Python. Cách này có thể dễ đọc với điều kiện nghiệp vụ phức tạp, nhưng cần kiểm tra chi phí và số ứng viên trong công việc thật. Không cần ép mọi bước chuẩn hóa dữ liệu thành một selector dài nếu mã xử lý riêng thể hiện mục tiêu rõ hơn.
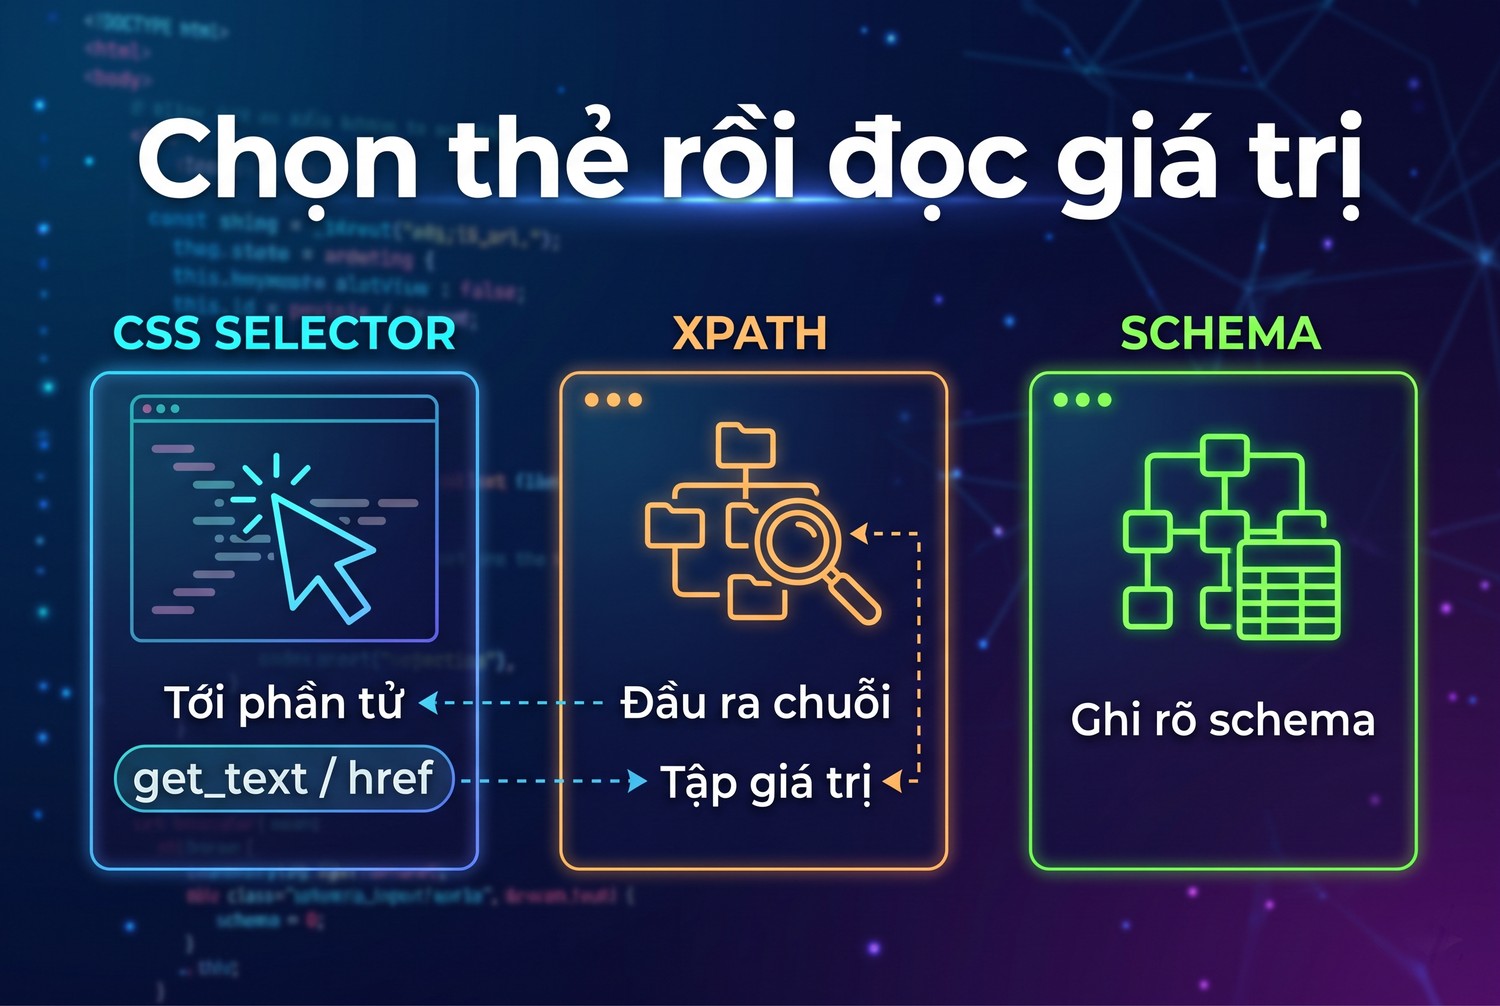
Chọn thẻ rồi đọc giá trị
XPath và CSS selector với quan hệ cha con và sibling
Cả hai ngôn ngữ có thể diễn đạt nhiều quan hệ trong cây, nhưng cách tạo truy vấn và đối tượng trả về khác nhau. Một đánh giá chỉ dựa trên câu CSS không chọn được cha là thiếu cập nhật khi có :has. Thay vào đó, hãy xem quan hệ cần kiểm tra và khả năng engine cụ thể đang hỗ trợ.
Con trực tiếp khác với hậu duệ
Dấu lớn hơn trong CSS thể hiện con trực tiếp, còn khoảng trắng thể hiện hậu duệ. Trong XPath, một bước con và một bước hậu duệ cũng có phạm vi khác nhau. Selectors Level 4 của W3C là nguồn đối chiếu các quan hệ CSS, nhưng ứng dụng vẫn cần kiểm thử trên engine thực sự sử dụng.
Nếu nguồn thêm một div bọc quanh article, truy vấn con trực tiếp có thể không còn khớp, trong khi truy vấn hậu duệ vẫn chọn được. Không vì thế mà dùng hậu duệ ở mọi vị trí. Một điều kiện rộng hơn có thể kéo cả card gợi ý ở bên trong vùng khác; hãy chọn mức ràng buộc phản ánh cấu trúc và mục tiêu dữ liệu.
:has cần được kiểm tra ở nơi chạy
Trong môi trường đã thử, article.product:has(a.title) chọn hai card có liên kết tiêu đề. XPath kiểm tra quan hệ hậu duệ tương ứng trên cùng fixture cũng cho p1 và p2. Tài liệu :has của MDN giải thích lựa chọn theo quan hệ, giúp tránh kết luận cũ rằng CSS không thể dựa vào phần tử bên trong.
Một biểu thức phức tạp hơn trong :has không nên được coi là đã được kiểm chứng chỉ vì biểu thức đơn giản chạy được. Trong khi làm bài, engine SoupSieve đang cài không chấp nhận một biến thể phức tạp đã thử; bộ kiểm tra cuối giữ biểu thức được xác nhận. Giới hạn này thuộc cấu hình thử cụ thể, không phải lời phủ nhận cú pháp của chuẩn CSS.
Quan hệ cùng cấp cần giữ đúng mức gần
CSS dùng dấu cộng cho phần tử cùng cấp ngay sau và dấu ngã cho phần tử cùng cấp phía sau. Khi chuyển sang XPath, điều kiện vị trí phải được giữ đúng để không biến ngay sau thành bất kỳ phần tử nào phía sau. Bộ thử của bài có hai cặp đối chiếu cho quan hệ kế tiếp và quan hệ phía sau trên fixture.
Đừng tự chuyển một trục ngược của XPath sang CSS bằng cách đổi ký hiệu một cách cơ học. Có thể cần chọn một phần tử theo :has với quan hệ tương đối hoặc giữ bước đi cây trong API. Hãy kiểm tra định danh kết quả trên nhiều nút ứng viên, vì một fixture chỉ có hai nút gần nhau dễ che khác biệt ngữ nghĩa.
XPath và CSS selector khi dùng vị trí
Các biểu thức vị trí thường ngắn nhưng dễ phụ thuộc giao diện. Fixture đặt h1 trước article để minh họa rằng phần tử con thứ hai và article thứ hai là hai điều kiện khác nhau. Một phép chuyển đổi đúng cần xác định đang đếm tập nào trước khi áp vị trí.
nth-child không phải nth-of-type
Trong fixture, article:nth-child(2) chọn p1 vì h1 là phần tử con đầu tiên của catalog. article:nth-of-type(2) chọn p2 vì nó đếm các article cùng cấp theo loại. Nếu chỉ nhìn hai sản phẩm mà bỏ qua heading, người viết có thể hiểu nhầm cả hai điều kiện đang chỉ cùng một bản ghi.
assert [n['id'] for n in soup.select('#catalog > article:nth-child(2)')] == ['p1']
assert [n['id'] for n in soup.select('#catalog > article:nth-of-type(2)')] == ['p2']
Khi viết XPath đối chiếu nth-of-type, cần xét thứ tự các article trước khi lọc những điều kiện khác nếu đó là ý nghĩa của biểu thức CSS. Lấy article thỏa class product rồi chọn bản thứ hai không luôn tương đương article thứ hai rồi kiểm tra class. Chèn thêm một article quảng cáo vào đầu fixture sẽ giúp phát hiện sự khác nhau này.
Ưu tiên ý nghĩa trước vị trí
Vị trí là lựa chọn hợp lệ nếu nghiệp vụ cần sản phẩm đầu danh sách theo thứ tự nguồn. Khi ấy, hãy ghi thứ tự là một phần hợp đồng và thử khi đảo card. Nếu nghiệp vụ cần một SKU hoặc nhãn cụ thể, nên chọn theo dấu hiệu ấy rồi xác nhận tính duy nhất thay vì dựa vào số thứ tự giao diện.
Không dùng phần tử đầu tiên như cách chữa chung cho selector đang trả quá nhiều kết quả. Điều này giảm số dòng nhưng không biết đã giữ đúng dữ liệu hay chưa. Hãy kiểm tra vì sao truy vấn có nhiều ứng viên, sau đó bổ sung điều kiện có ý nghĩa hoặc báo trường hợp mơ hồ cho người xử lý.
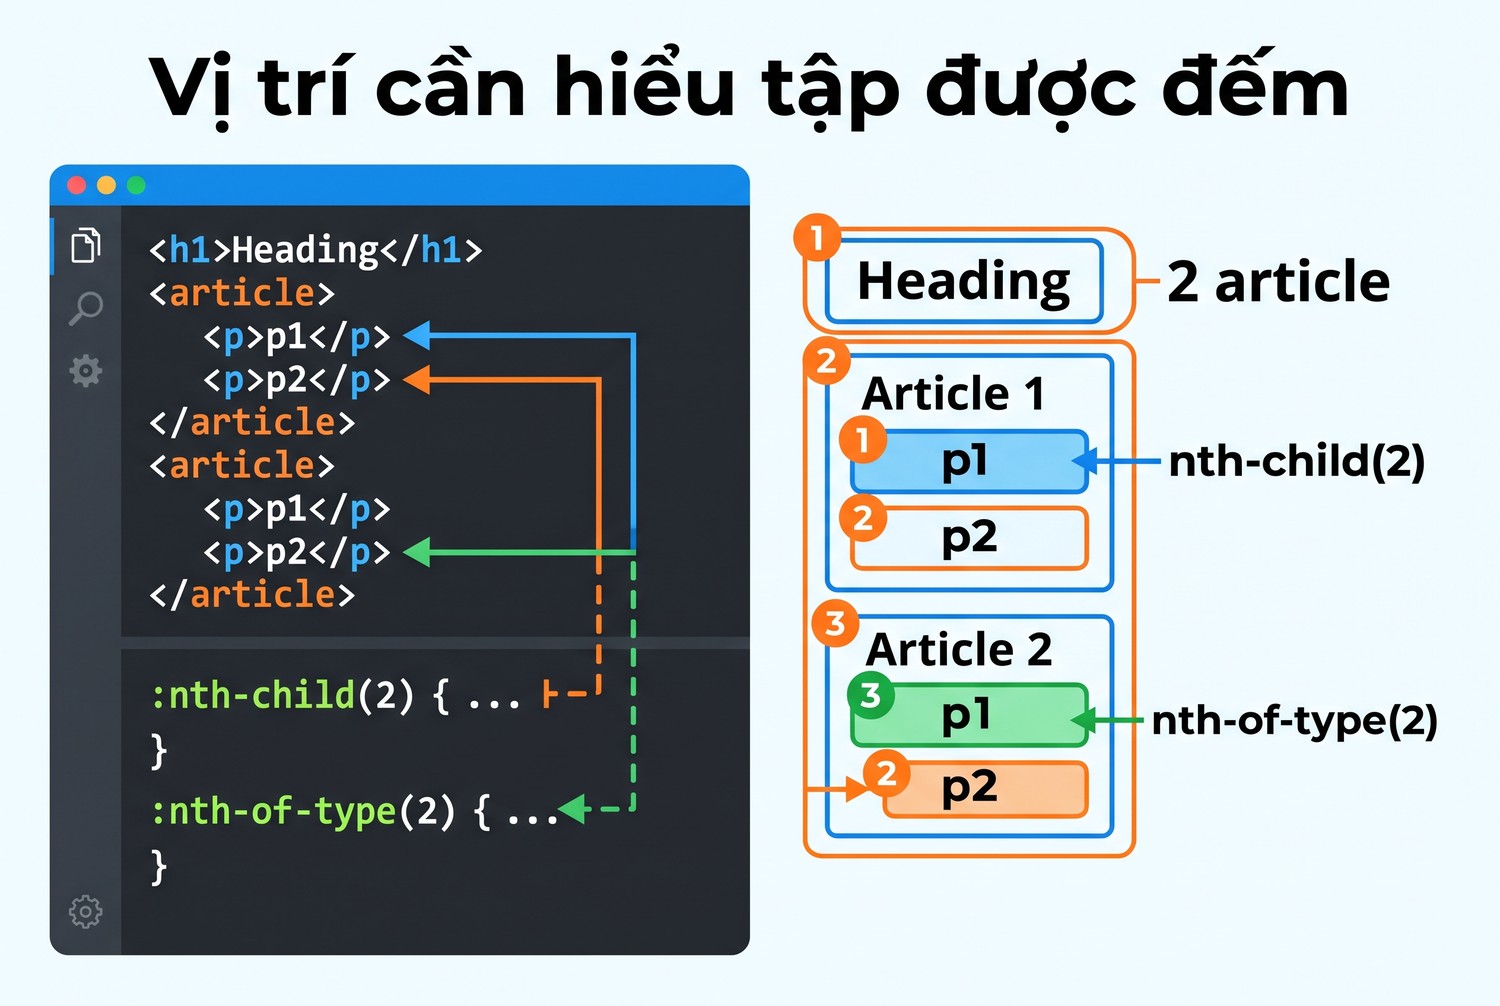
Vị trí cần hiểu tập được đếm
XPath và CSS selector trong các engine khác nhau
Một biểu thức cần được kiểm tra cùng parser và nơi thực thi, bởi hỗ trợ cú pháp và cây đầu vào có thể khác. Tài liệu Beautiful Soup chỉ rõ phần chọn CSS được thực hiện qua SoupSieve. Kết quả thử ở đây không được dùng để tuyên bố các browser hay framework khác có cùng tập phần mở rộng.
Browser nhận DOM tại một thời điểm
Tài liệu querySelectorAll của MDN mô tả kết quả NodeList tĩnh của API. Điều này có ý nghĩa khi giao diện tiếp tục thay đổi sau lần truy vấn. Một danh sách đã lấy trước khi card xuất hiện không tự trở thành bằng chứng rằng lần truy vấn sau cũng sẽ rỗng.
Trong bộ thu thập, hãy chờ điều kiện dữ liệu phù hợp rồi truy vấn ở thời điểm đã xác định. Đổi từ CSS sang XPath không tự giải quyết việc card chỉ xuất hiện sau JavaScript. Nếu cây đầu vào còn thiếu dữ liệu, cần sửa tầng lấy tài liệu hoặc render trước khi đánh giá biểu thức chọn phần tử.
HTML sửa lỗi và XML có namespace
Với HTML không đúng cấu trúc, parser có thể thêm hoặc sắp xếp lại các nút theo quy tắc riêng. Hai biểu thức dự kiến tương ứng có thể nhìn trên hai cây khác nhau và trả kết quả khác. Hãy so vùng cây thực tế liên quan, không chỉ so chuỗi HTML gốc hoặc ảnh chụp giao diện.
Khi đọc XML, namespace cũng cần được khai báo theo engine. Không áp nguyên một ví dụ HTML không namespace cho feed XML rồi kết luận XPath hoặc CSS không hoạt động. Tài liệu, parser và ánh xạ namespace là một phần của cấu hình nguồn cần được lưu bên cạnh biểu thức.
XPath và CSS selector với bộ đối chiếu mười bốn kiểm tra
Bộ kiểm thử chạy mười cặp truy vấn trên fixture, so cả hai danh sách định danh với kết quả mong đợi. Các nhóm gồm class và con trực tiếp, liên kết hậu duệ, thuộc tính, vị trí theo loại, sibling kế tiếp, sibling phía sau, :has, loại class và quan hệ vùng tổ tiên. Các cặp chỉ khẳng định kết quả trên fixture đã công bố.
Kiểm tra giá trị thay vì thông báo thành công
Bốn kiểm tra bổ sung xác nhận nth-child có tính heading, contains class lấy nhầm quảng cáo, văn bản qua API CSS và chuỗi văn bản qua XPath. Cả mười bốn kiểm tra đã đạt trong môi trường ghi phía trên. Không có đo thời gian chạy browser, truy cập website thật hoặc thử endpoint proxy thương mại trong báo cáo này.
Một phép so sánh chỉ kiểm tra hai danh sách bằng nhau vẫn có thể bỏ qua lỗi nếu cả hai đều chọn sai. Vì vậy, mỗi cặp còn có danh sách định danh mong đợi do fixture quy định. Khi chuyển sang dữ liệu thật, cần có mẫu kiểm tra được biên tập để kết quả của cả hai bên được đối chiếu với mục tiêu độc lập.
Không biến cặp ví dụ thành quy tắc dịch chung
Một XPath so @class bằng chuỗi title có thể khớp CSS .title trên fixture một token, nhưng không khớp mọi tài liệu có nhiều class. Bài thử kiểm tra kết quả của các mẫu cụ thể, không đưa ra công cụ dịch tự động mọi selector. Khi áp dụng ngoài fixture, hãy xem lại từng điều kiện có phụ thuộc giá trị toàn chuỗi hay token.
Quy tắc vị trí cũng cần được đánh giá lại khi thêm quảng cáo hoặc khối xen kẽ. Hãy bổ sung fixture biến đổi trước khi công bố phép chuyển đổi cho nhiều nguồn. Việc có một bảng cặp biểu thức giúp bắt đầu nhanh, nhưng bằng chứng hồi quy mới giúp duy trì đúng ngữ nghĩa khi HTML thay đổi.
XPath và CSS selector khi bảo trì hệ thống thu thập
Hai lựa chọn đều có thể tạo ra mã khó đọc nếu truy vấn chứa quá nhiều giả định không được ghi rõ. Hãy giữ biểu thức gần cấu hình nguồn, kèm mô tả mục tiêu và fixture. Khi thay giao diện, người sửa cần hiểu vì sao card được chọn, không chỉ thấy một chuỗi dài phải chỉnh đến khi hết lỗi.
Chẩn đoán theo từng tầng
Nếu truy vấn trả rỗng, kiểm tra tài liệu đúng URL, đúng loại nội dung và đã có dữ liệu trước. Sau đó kiểm tra vùng cha, số card và từng trường. Một lần thay endpoint trong khi selector chọn sai phạm vi chỉ làm điều kiện thử thay đổi, không cung cấp bằng chứng rằng lỗi ngôn ngữ truy vấn đã được sửa.
Anh em có thể đọc thêm về cơ chế web scraping proxy để tách tuyến tải khỏi parser. Trước khi mua proxy, hãy xác định client sẽ lấy HTML hoặc DOM và cách kiểm tra tuyến của client ấy. Lựa chọn endpoint không thay thế việc kiểm tra dữ liệu mà CSS hoặc XPath thực sự trả về.
Đánh giá chi phí chuyển đổi bằng công việc thật
Không có benchmark tốc độ chung trong bài để xếp một ngôn ngữ luôn nhanh hơn ngôn ngữ còn lại. Nếu tốc độ là vấn đề, đo toàn tác vụ trên mẫu đại diện, ghi engine, phiên bản và số lần lặp. Thời gian tải, render và ghi tệp có thể lớn hơn phần truy vấn, nên tối ưu nhầm nơi sẽ không giải quyết mục tiêu.
Chi phí bảo trì cũng cần được tính: người trong nhóm quen cú pháp nào, có fixture hay không và cần bao nhiêu phần mở rộng riêng. Một biểu thức ngắn hơn nhưng khó kiểm tra có thể tốn công khi nguồn đổi cấu trúc. Chọn cách người nhận bàn giao có thể tái hiện và sửa đúng bằng bằng chứng.
XPath và CSS selector trong checklist quyết định
Một tiêu chí gọn giúp nhóm thống nhất lựa chọn theo nhiệm vụ thay vì theo sở thích. Bảng dưới là định hướng cho cách tổ chức mã, không phải kết luận thay thế kiểm thử. Khi điều kiện của nguồn thay đổi, có thể giữ cả hai công cụ ở những bước khác nhau nếu mỗi bước có trách nhiệm rõ ràng.
Nhu cầu |
Cách cân nhắc |
Điều phải xác nhận |
|---|---|---|
Class, ID và thuộc tính quen thuộc |
CSS thường dễ đọc trong cấu hình HTML |
Engine và token class |
Chuỗi hoặc thuộc tính trả ngay từ biểu thức |
XPath có thể gom bước lấy giá trị |
Kiểu và số lượng kết quả |
Quan hệ nhãn, cha hoặc sibling phức tạp |
So XPath với CSS hiện hành và API đi cây |
Ngữ nghĩa trên fixture đối chứng |
Browser tự động |
Chọn theo API và điều kiện chờ dữ liệu |
DOM đúng thời điểm |
Di chuyển thư viện |
Đối chiếu bản ghi trước và sau |
Không chỉ so số dòng |
Tối ưu thời gian |
Đo trên tác vụ đại diện |
Giữ môi trường và dữ liệu thử |
Khi chuyển một nguồn đang chạy, có thể chạy hai phiên bản parser trên cùng một bản tài liệu đã lưu rồi so các trường sau chuẩn hóa theo schema. Những dòng khác nhau cần được phân loại trước khi thay cấu hình chính. Không gửi thêm request tới nguồn chỉ để so ngôn ngữ selector nếu một đầu vào đã có thể phục vụ cả hai bên.
Gắn phiên bản biểu thức với mã nguồn và thời điểm áp dụng để có thể quay lại cấu hình trước khi phát hiện lỗi dữ liệu. Nếu đầu ra được dùng trong báo cáo định kỳ, lưu dấu vết phiên bản cùng mã lô. Khi ấy, một thay đổi số dòng có thể được đối chiếu với thay đổi parser thay vì bị diễn giải ngay thành biến động của website.
Bàn giao đủ để lựa chọn được kiểm tra lại
Gói bàn giao nên có fixture, biểu thức, kết quả mong đợi và phiên bản của các engine. Nếu cấu hình dùng :has hoặc phần mở rộng riêng, ghi rõ phạm vi đã thử. Điều này giúp người nhận biết thay môi trường nào cần chạy hồi quy, thay vì hiểu mọi chuỗi selector đều có thể di chuyển nguyên trạng.
Hãy ghi cả những điều chưa đo như browser thật, mạng thương mại hay tác động của nguồn nhiều trang. Một báo cáo có giới hạn rõ ràng giúp lập kế hoạch kiểm tra tiếp theo. Không dùng kết quả fixture vài card để hứa mức tốc độ hoặc độ ổn định mà hệ thống chưa được nghiệm thu.
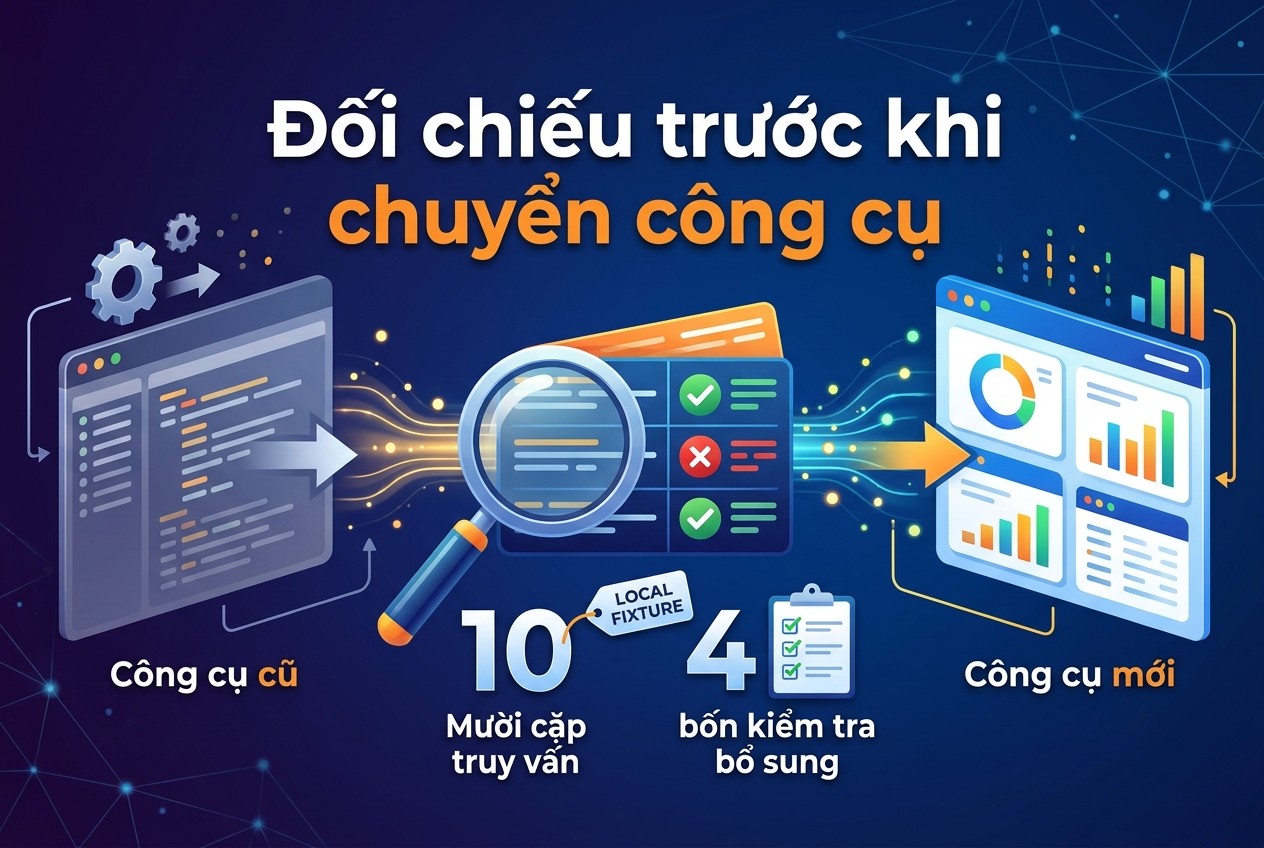
Đối chiếu trước khi chuyển công cụ
XPath và CSS selector nên được chọn theo đầu ra, engine và khả năng kiểm tra lại. Anh em hãy giữ fixture đối chứng, xác nhận quan hệ từng trường và chạy hồi quy khi chuyển công cụ. Theo dõi Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam để trao đổi cách dùng XPath và CSS selector.


