
Too many open files khi chạy crawler: tìm rò rỉ trước ulimit
Too many open files khi chạy crawler là lỗi báo tiến trình đã dùng hết số file descriptor được phép, gồm cả tệp và socket mạng. Cách sửa phổ biến nhất trên mạng là tăng ulimit, nhưng nếu mã đang rò rỉ thì tăng giới hạn chỉ làm lỗi đến muộn hơn. ProxyVN chạy lab Python thật, mở tệp đến khi gặp errno 24, đo số handle theo từng 50 request khi rò socket và khi dùng lại Session để anh em biết lỗi nằm ở mã hay ở giới hạn.
Too many open files khi chạy crawler: lớp nào quyết định hành vi
Thông báo "Too many open files" đến từ hệ điều hành chứ không từ thư viện HTTP. Thư viện chỉ chuyển lời. Muốn sửa đúng, anh em cần biết lớp nào đặt giới hạn và lớp nào tiêu tài nguyên.
File descriptor là gì
Trên Linux và macOS, mỗi tệp đang mở, mỗi socket mạng, mỗi pipe đều được tiến trình giữ bằng một số nguyên gọi là file descriptor. Hệ điều hành cấp số nhỏ nhất còn trống mỗi khi tiến trình mở thêm một thứ. Ba số đầu 0, 1, 2 dành cho đầu vào, đầu ra và lỗi chuẩn.
Một crawler gửi request qua proxy dùng file descriptor ở nhiều chỗ: socket tới proxy, tệp kết quả đang ghi, tệp log, tệp cookie và kết nối cơ sở dữ liệu. Nếu dùng Playwright hay Selenium, còn có pipe tới tiến trình trình duyệt. Socket thường chiếm phần lớn.
Ba lớp đặt giới hạn
Lớp thứ nhất là giới hạn theo tiến trình, RLIMIT_NOFILE trên Linux. Đây là thứ lệnh ulimit -n đọc và đổi. Vượt giới hạn này cho lỗi EMFILE, errno 24.
Lớp thứ hai là giới hạn toàn hệ thống, tệp /proc/sys/fs/file-max trên Linux. Vượt giới hạn này cho lỗi ENFILE, errno 23, thông báo "Too many open files in system". Lỗi này hiếm gặp hơn vì giá trị mặc định thường rất lớn.
Lớp thứ ba là trình quản lý tiến trình. Khi crawler chạy bằng systemd, Docker hay supervisor, giới hạn mà tiến trình nhận được do lớp đó đặt, không phải do ulimit trong terminal của anh em.
Windows khác ở chỗ nào
Windows không có ulimit. Python trên Windows mở tệp qua thư viện C runtime của Microsoft, và theo tài liệu _setmaxstdio, tầng I/O mức thấp hỗ trợ tối đa 8.192 tệp mở đồng thời. Socket trên Windows lại đi đường riêng qua Winsock, không tính vào con số này.
Cùng một crawler có thể gặp lỗi tệp trên Windows mà không gặp lỗi socket, còn trên Linux thì tệp và socket chung một giới hạn. Vì vậy kết quả thử trên máy Windows của dev không nói được nhiều về máy chủ Linux chạy thật.
Crawler tiêu file descriptor ở đâu nhiều nhất
Với crawler thuần HTTP, mỗi kết nối đang mở tới proxy là một socket. Nếu crawler chạy 50 luồng và mỗi luồng giữ một kết nối, con số là 50. Nếu mỗi luồng giữ bể riêng mười kết nối, con số thành 500. Nếu mã tạo bể mới cho mỗi request, con số tăng theo số URL đã xử lý.
Crawler dùng trình duyệt tiêu nhiều hơn hẳn. Mỗi tiến trình Chromium mở hàng trăm file descriptor cho thư viện, bộ nhớ đệm, socket nội bộ và pipe điều khiển. Crawler mở nhiều context hay nhiều trình duyệt song song có thể chạm 1.024 rất nhanh dù không rò gì.
Phần còn lại là tệp: log xoay vòng, tệp kết quả, tệp tạm khi giải nén, cơ sở dữ liệu SQLite. Mỗi thứ chỉ vài file descriptor, nhưng nếu mã mở lại mỗi lần ghi mà quên đóng, chúng cộng dồn theo số trang.
Phạm vi bài này
Bài xây dựng web crawler Python hướng dẫn dựng crawler từ đầu. Bài này chỉ xử lý một lỗi: crawler chạy một lúc thì báo hết file descriptor. Trọng tâm là đo, tìm chỗ rò và chọn giữa sửa mã với tăng giới hạn.
Too many open files khi chạy crawler: EMFILE, ENFILE, rò rỉ và soft limit
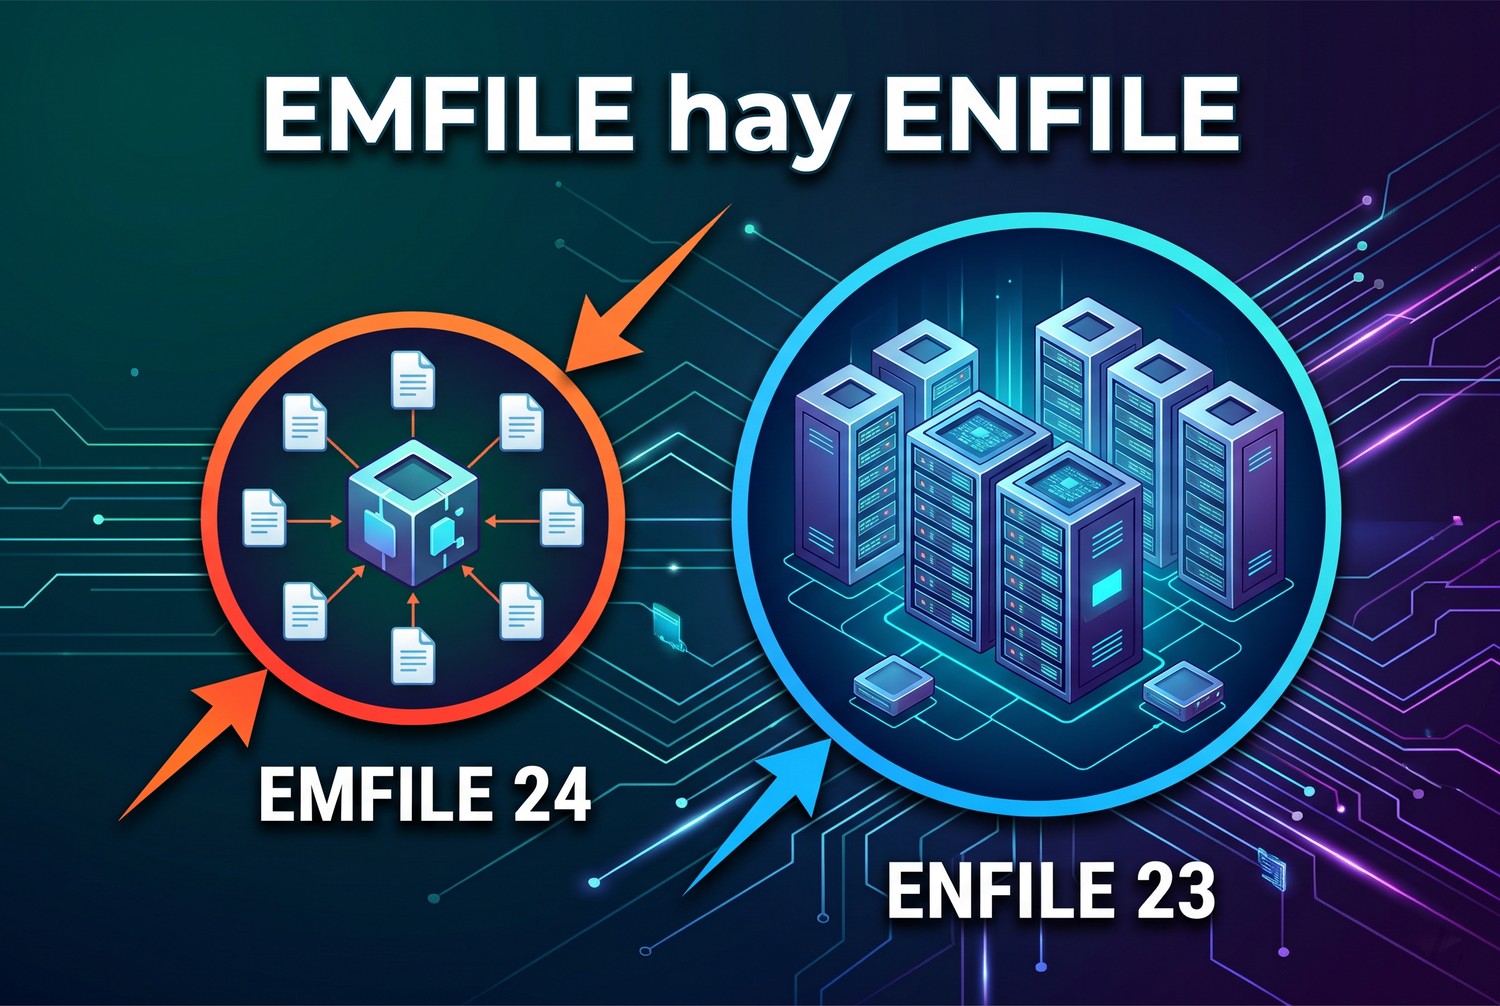
EMFILE hay ENFILE
Ba cặp khái niệm này quyết định cách sửa. Nhầm một cặp là sửa sai chỗ. Định nghĩa dưới đây lấy theo trang man errno và trang man getrlimit, đọc ngày 29/10/2026.
EMFILE và ENFILE
Mã |
Số |
Thông báo |
Giới hạn bị vượt |
Phạm vi ảnh hưởng |
|---|---|---|---|---|
EMFILE |
24 |
Too many open files |
RLIMIT_NOFILE của tiến trình |
Chỉ tiến trình đó |
ENFILE |
23 |
Too many open files in system |
/proc/sys/fs/file-max |
Mọi tiến trình trên máy |
EMFILE là lỗi của riêng crawler. Các chương trình khác trên máy vẫn mở tệp bình thường. ENFILE thì cả máy bị ảnh hưởng, SSH có thể không vào được, lệnh đơn giản cũng báo lỗi.
Nếu thấy errno 24 thì nhìn vào tiến trình. Nếu thấy errno 23 thì nhìn vào tổng số handle của máy, có thể không phải do crawler mà do một dịch vụ khác đang rò.
Soft limit và hard limit
RLIMIT_NOFILE có hai giá trị. Soft limit là giá trị đang áp dụng, tiến trình tự nâng được tới hard limit. Hard limit là trần, chỉ tiến trình có quyền mới nâng được, và không vượt quá /proc/sys/fs/nr_open.
Trang man getrlimit ghi rõ giá trị này lớn hơn một so với số file descriptor lớn nhất được mở. Soft limit 1.024 nghĩa là số lớn nhất là 1.023. Đây chính là giá trị mặc định trên nhiều bản phân phối Linux.
Tài liệu systemd.exec ghi hard limit mặc định hiện nay là 524.288 và khuyên ứng dụng tự nâng soft limit lên hard limit nếu không dùng hàm select. Lý do là select không xử lý được file descriptor lớn hơn 1.023 trên Linux.
Rò rỉ file và rò rỉ socket
Rò rỉ file là mở tệp mà không đóng, thường do thiếu khối with hoặc đóng trong nhánh thành công mà quên nhánh lỗi. Số tệp mở tăng đều theo số trang xử lý.
Rò rỉ socket khó thấy hơn. Thư viện HTTP giữ socket trong bể kết nối để dùng lại, nên số socket mở cao chưa chắc là rò. Rò thật là khi mỗi vòng tạo bể mới, hoặc giữ đối tượng response chưa đọc hết làm socket không trả về bể được.
Dấu hiệu phân biệt là đường cong số handle theo vòng chạy. Bể kết nối đúng cách cho đường phẳng sau vài vòng đầu. Rò rỉ cho đường dốc lên đều, không bao giờ đi ngang.
Thiết kế lab Too many open files khi chạy crawler: phiên bản và phép đo
Lab chạy ngày 29/10/2026 trên Windows 10 với Python 3.12.10, requests 2.34.2 và psutil 7.2.2. Một máy chủ HTTP nhỏ chạy cùng tiến trình ở 127.0.0.1 cổng 9480, trả trang 2 KB cho mọi request.
Năm ca thử
Ca A mở cùng một tệp nhiều lần, không đóng, cho tới khi hệ điều hành từ chối. Mục tiêu là xem lỗi xuất hiện ở số nào và thông báo ra sao.
Ca B mở và đóng tệp bằng khối with 10.000 lần, đo số handle mỗi 2.000 lần. Đây là đối chứng cho ca A.
Ca C mô phỏng lỗi rò socket hay gặp: mỗi request tạo một Session mới, gửi với stream=True, giữ đối tượng response trong danh sách để xử lý sau mà không đọc body. Chạy 400 vòng, đo mỗi 50 vòng.
Ca D là bản đã sửa: một Session cho cả 400 request, đọc hết body, đóng response bằng khối with. Đo cùng nhịp với ca C.
Ca E tạo 9.000 socket thô bằng module socket để kiểm socket trên Windows có tính vào giới hạn của C runtime hay không.
Cách đo
Số handle lấy bằng psutil.Process().num_handles(), con số Windows đếm cho tiến trình, gồm tệp, socket, luồng và các đối tượng kernel khác. Số kết nối TCP đếm bằng net_connections, chỉ lấy kết nối ESTABLISHED có cổng đích 9480, tức phía client.
Vì máy chủ chạy cùng tiến trình, mỗi kết nối mở thêm socket phía máy chủ và luồng xử lý. Số handle tăng theo kết nối vì vậy cao hơn một handle mỗi kết nối.
Vì sao ca rò dùng stream=True
Khi gửi không có stream, requests đọc hết body ngay và trả socket về bể. Lúc đó dù tạo Session mới mỗi request, socket vẫn có thể được đóng khi Session bị thu gom. Lỗi khó tái lập và phụ thuộc thời điểm bộ thu gom rác chạy.
Với stream=True, body chưa được đọc nên socket bị giữ bởi response. Mã thật hay gặp mẫu này khi tải tệp lớn, khi đọc từng dòng JSON hoặc khi muốn kiểm header trước rồi mới quyết định có tải body không. Chỉ cần quên đóng ở một nhánh, socket nằm lại.
Giữ tham chiếu trong danh sách mô phỏng các hàng đợi "xử lý sau" thường thấy trong crawler: lưu response vào hàng đợi cho worker khác phân tích. Nếu worker chậm hơn tốc độ tải, hàng đợi phình ra và kéo theo socket.
Kết quả kỳ vọng
Ca A dừng ở gần 8.192 trừ đi ba tệp chuẩn. Ca B có số handle phẳng. Ca C có số handle tăng tuyến tính theo vòng và số kết nối bằng số vòng. Ca D có một kết nối duy nhất. Ca E không lỗi.
Tái lập Too many open files khi chạy crawler: luồng đúng và ca rò rỉ
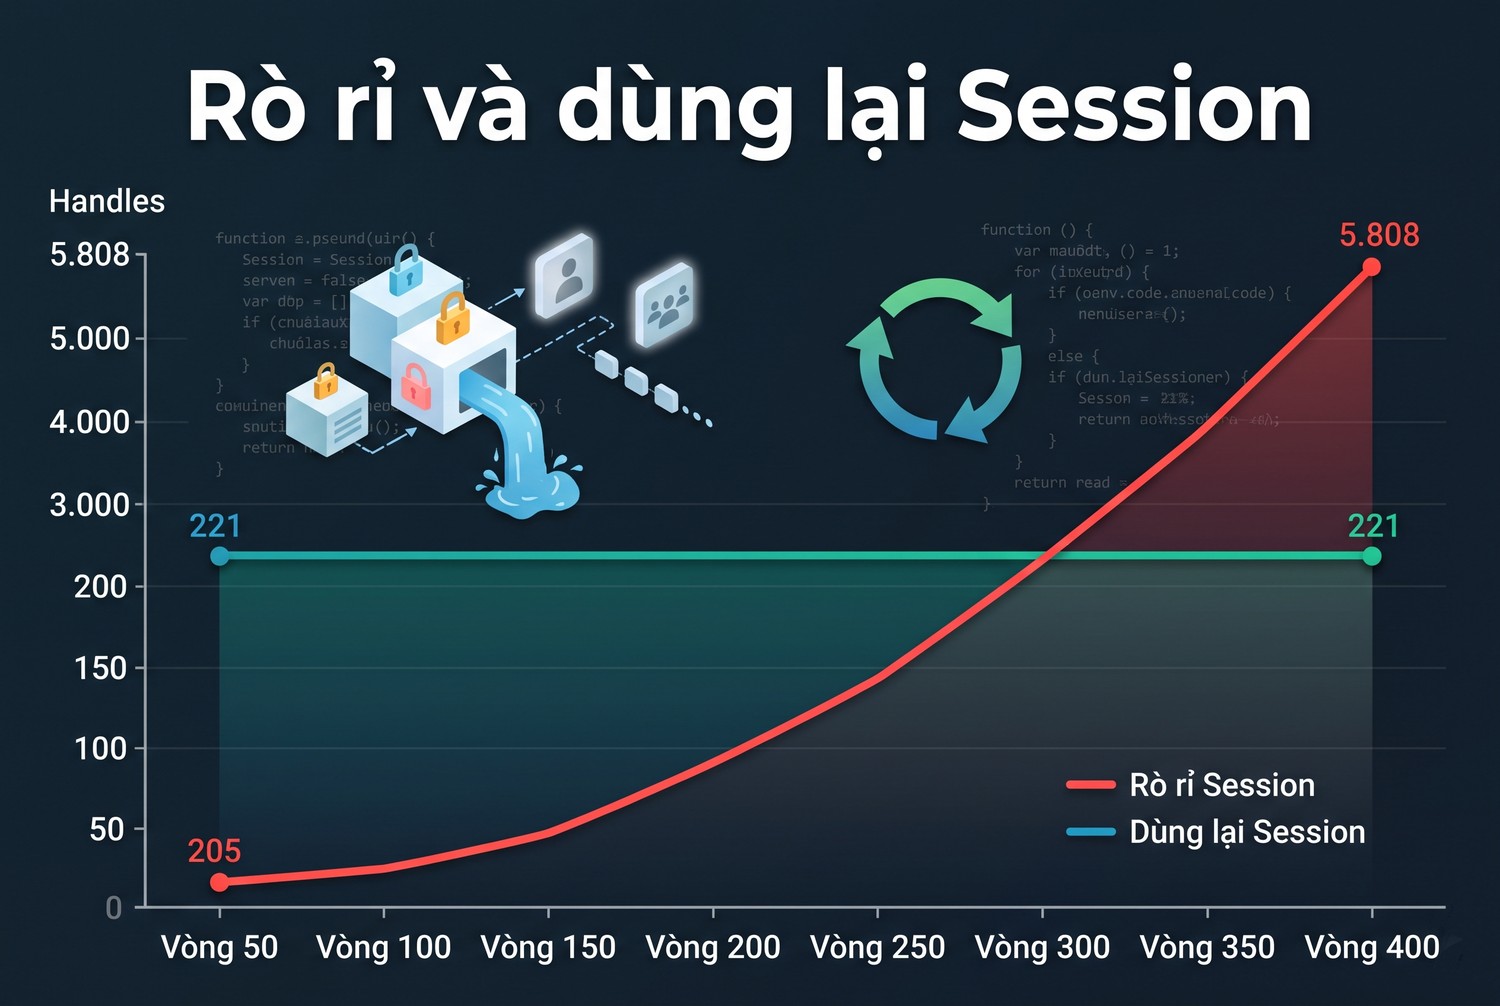
Rò rỉ và dùng lại Session
Phần này trình bày mã của từng ca và số liệu thật. Script đầy đủ nằm trong lab của ProxyVN, đoạn dưới đây giữ phần cốt lõi.
Ca A: mở tệp tới khi gặp errno 24
import errno
kept = []
try:
    while True:
        kept.append(open("t264_tmp.txt", "rb"))
except OSError as e:
    print(len(kept), e.errno, errno.errorcode[e.errno], e.strerror)
for f in kept:
    f.close()
Kết quả: tiến trình mở được 8.189 tệp rồi nhận lỗi errno 24, mã EMFILE, thông báo "Too many open files". Số handle của tiến trình tăng từ 204 lên 16.582 lúc lỗi.
Con số 8.189 khớp tài liệu Microsoft: 8.192 trừ ba file descriptor chuẩn. Số handle tăng gấp đôi số tệp vì mỗi tệp mở trên Windows có thể giữ hơn một đối tượng kernel. Sau khi đóng hết, số handle về 205.
Ca B: đóng bằng with
Mở và đóng 10.000 lần với khối with, năm lần đo đều ra 205 handle. Đường phẳng đúng như kỳ vọng. Khối with bảo đảm tệp được đóng cả khi xử lý bên trong ném lỗi.
Ca C: rò socket theo vòng
import requests
leak = []
for i in range(1, 401):
    s = requests.Session()
    r = s.get("http://127.0.0.1:9480/page", stream=True, timeout=5)
leak.append((s, r)) # giữ lại để "xử lý sau", body chưa đọcVòng |
Số handle |
Kết nối TCP phía client |
|---|---|---|
Bắt đầu |
205 |
0 |
50 |
908 |
50 |
100 |
1.608 |
100 |
200 |
3.008 |
200 |
300 |
4.408 |
300 |
400 |
5.808 |
400 |
Mỗi 50 vòng, số handle tăng đúng 700 và số kết nối tăng đúng 50. Đường thẳng không có dấu hiệu chững lại. Trên Linux với soft limit 1.024, ca này sẽ báo Too many open files trước vòng thứ 1.000, sớm hơn nếu crawler còn mở tệp log và tệp kết quả.
Sau khi đóng hết response và Session rồi chạy gc, số handle về 214 và kết nối về 0. Tài nguyên không mất vĩnh viễn, nó chỉ bị giữ chừng nào mã còn tham chiếu.
Ca D: một Session, đọc hết body
with requests.Session() as s:
    for i in range(1, 401):
        with s.get("http://127.0.0.1:9480/page", timeout=5) as r:
            r.content
Ở cả tám lần đo, số handle đứng ở 221 và chỉ có một kết nối TCP. Bể kết nối của Session dùng lại đúng một socket cho 400 request vì máy chủ trả HTTP/1.1 có Content-Length.
Cùng 400 request, bản rò giữ 400 kết nối, bản sửa giữ 1 kết nối. Không có thay đổi nào về giới hạn hệ điều hành. Chỉ đổi cách dùng Session và cách đóng response.
Ca C trên Linux sẽ gãy ở đâu
Ca C giữ một kết nối mỗi vòng. Trên Linux, mỗi kết nối client tốn một file descriptor, cộng khoảng vài chục file descriptor nền của trình thông dịch Python và thư viện. Với soft limit 1.024, crawler sẽ gãy quanh vòng thứ 990 tới 1.000.
Nếu crawler chạy 8 luồng cùng mã này, mỗi luồng tạo Session riêng mỗi request, giới hạn bị chạm sau khoảng 125 request mỗi luồng. Với tốc độ vài request mỗi giây, lỗi xuất hiện sau vài phút chạy. Đây là kiểu lỗi chạy thử năm phút thì ổn, chạy lô thật thì gãy.
Tăng soft limit lên 65.536 thì crawler chạy được khoảng 65 nghìn request trước khi gãy. Nghe có vẻ đủ, nhưng lô crawl hàng trăm nghìn URL vẫn sẽ chạm. Lúc đó máy còn giữ hàng chục nghìn kết nối treo tới proxy, và phía proxy cũng phải giữ chừng ấy kết nối.
Ca E: socket thô trên Windows
Tạo 9.000 socket bằng socket.socket() không gặp lỗi. Socket Winsock không tính vào giới hạn 8.192 của C runtime. Đây là lý do crawler chạy trên Windows có thể rò hàng nghìn socket mà không báo Too many open files, trong khi trên Linux cùng mã đó gãy sớm.
Đọc log và số liệu để tách nguyên nhân Too many open files khi chạy crawler
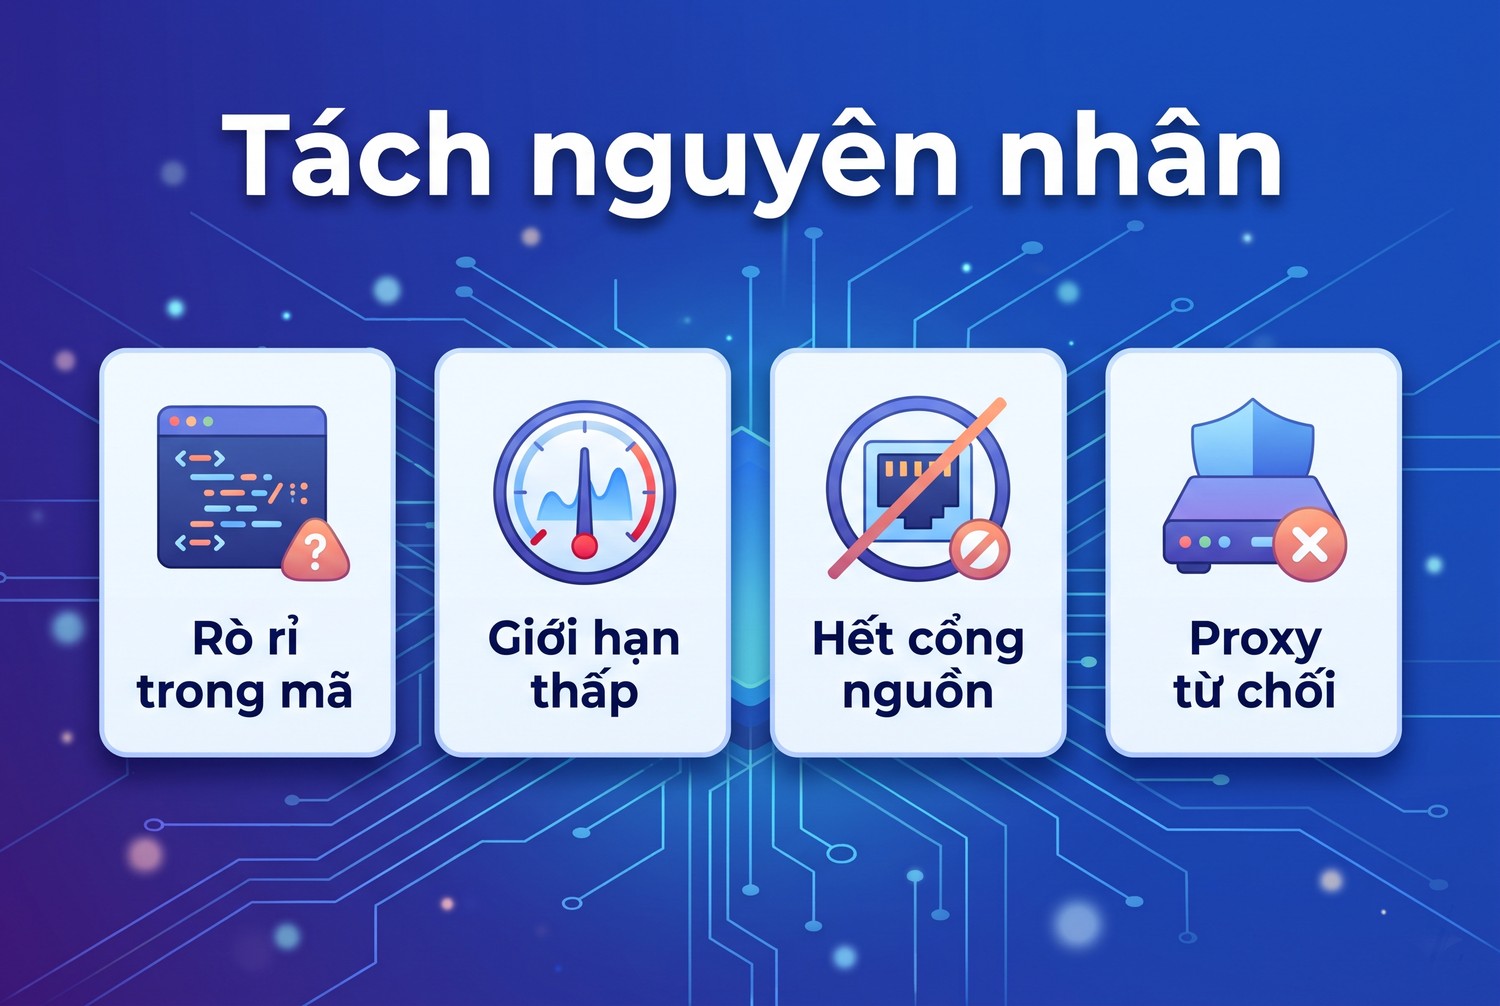
Tách nguyên nhân
Lỗi hết file descriptor thường đi kèm hoặc bị nhầm với vài lỗi khác. Phần này đưa ra lệnh đo trên Linux và bảng phân biệt.
Lệnh đo trên Linux
cat /proc/$PID/limits | grep "open files"
ls /proc/$PID/fd | wc -l
ls -l /proc/$PID/fd | awk '{print $NF}' | sed 's/[0-9]*//g' | sort | uniq -c | sort -rn | head
cat /proc/sys/fs/file-nr
ss -tanp | grep "pid=$PID" | awk '{print $1}' | sort | uniq -c
Dòng đầu cho soft limit và hard limit mà tiến trình đang nhận thật. Dòng hai đếm số file descriptor đang mở. Dòng ba nhóm theo loại: socket, pipe, tệp thường. Dòng bốn cho tổng của cả máy theo trang man proc_sys_fs. Dòng cuối đếm socket theo trạng thái.
Các lệnh Linux này chưa được ProxyVN chạy trong bài, vì máy lab là Windows. Cú pháp theo trang man. Trên Windows, psutil num_handles và net_connections cho số liệu tương đương như trong lab.
Đọc theo thời gian, không đọc một lần
Một lần đo chỉ cho biết đang mở bao nhiêu. Muốn biết có rò hay không, ghi số file descriptor mỗi phút trong vài chục phút. Đường phẳng là bình thường dù con số cao. Đường dốc lên đều là rò.
Trong Python, có thể in số file descriptor ngay trong vòng lặp crawler bằng len(os.listdir("/proc/self/fd")) trên Linux hoặc psutil trên mọi hệ điều hành. Ghi kèm số trang đã xử lý để vẽ đường theo vòng như bảng ca C.
Bảng phân biệt
Triệu chứng |
Rò rỉ trong mã |
Giới hạn quá thấp |
Hết cổng nguồn |
Proxy từ chối |
|---|---|---|---|---|
Thông báo |
Too many open files |
Too many open files |
Address not available |
Connection refused hoặc 407 |
Số fd theo thời gian |
Tăng đều |
Phẳng nhưng sát trần |
Không liên quan |
Không liên quan |
Xảy ra khi |
Sau N vòng, N tỉ lệ với trần |
Ngay khi tăng số luồng |
Khi mở kết nối mới rất nhanh |
Từ request đầu |
Tăng ulimit |
Lỗi đến muộn hơn |
Hết lỗi |
Không đổi |
Không đổi |
Cách sửa |
Đóng tài nguyên, dùng lại Session |
Nâng soft limit |
Dùng lại kết nối |
Sửa thông tin proxy |
Cột cuối có bài riêng: requests.exceptions.ProxyError cho lỗi kết nối tới proxy. Lỗi hết cổng nguồn cũng sinh ra từ việc không dùng lại kết nối, nhưng thông báo khác hẳn.
Đối chiếu phía proxy
Nếu có quyền xem proxy, số kết nối từ IP máy crawler tới proxy là bằng chứng thứ hai. Kết nối tăng đều theo thời gian dù số luồng không đổi là dấu hiệu crawler không dùng lại socket. Proxy thương mại thường giới hạn số kết nối đồng thời mỗi tài khoản, nên crawler rò có thể bị proxy từ chối trước khi chạm giới hạn file descriptor.
Lỗi trong log ứng dụng trông thế nào
Với requests, lỗi thường hiện thành ConnectionError hoặc ProxyError bao bên ngoài một OSError có errno 24. Phải đọc xuống tận dòng cuối của traceback mới thấy chữ Too many open files.
Với aiohttp, lỗi có thể nằm trong ClientConnectorError. Với Scrapy, lỗi hiện ở log Twisted. Cách nhanh nhất là tìm chuỗi "Errno 24" trong toàn bộ log thay vì tìm tên ngoại lệ.
Có một bẫy: khi đã hết file descriptor, chính tệp log cũng có thể không mở được nếu crawler xoay vòng log theo giờ. Khi đó log dừng đột ngột mà không có dòng lỗi nào. Thấy log dừng đúng lúc đổi giờ là một gợi ý đáng kiểm.
Xử lý Too many open files khi chạy crawler theo bằng chứng và checklist
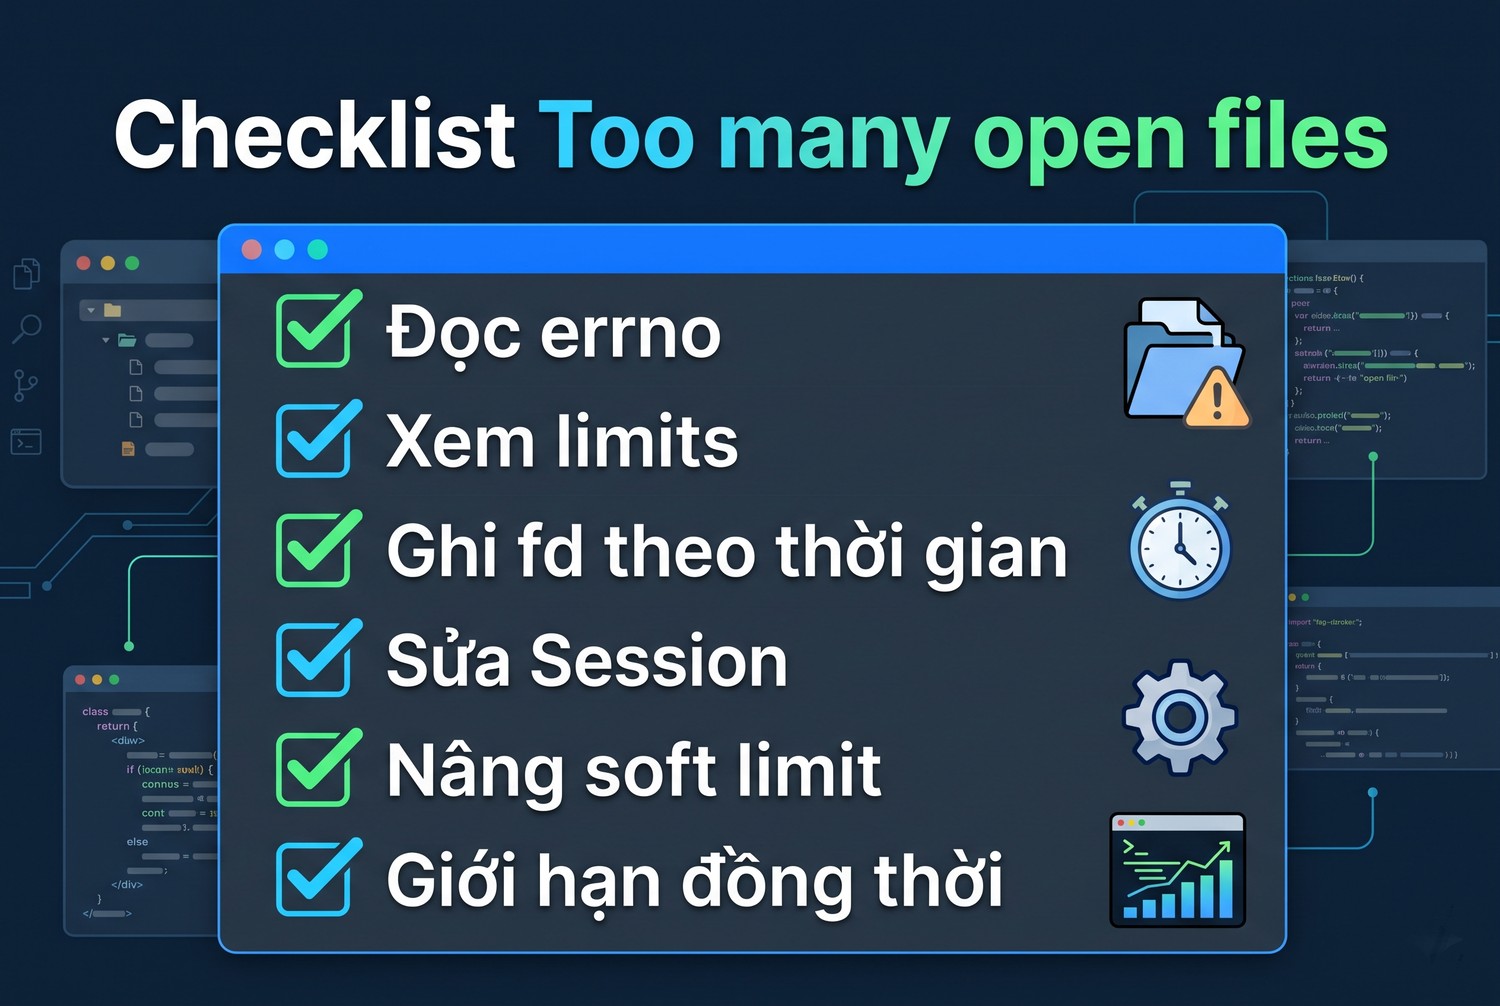
Checklist Too many open files
Thứ tự xử lý: tìm và sửa rò rỉ trước, đặt giới hạn hợp lý sau, cuối cùng giới hạn đồng thời để số file descriptor không phụ thuộc vào tải.
Sửa vòng đời tài nguyên
- Tạo một Session cho mỗi worker, dùng cho mọi request, đóng khi worker kết thúc.
- Đóng response bằng khối with, nhất là khi dùng stream=True.
- Đọc hết body hoặc gọi close nếu bỏ qua body, để socket trả về bể.
- Mở tệp kết quả bằng with, hoặc mở một lần và ghi nhiều lần thay vì mở mỗi trang.
- Với aiohttp, dùng một ClientSession và đặt giới hạn connector.
- Với Playwright hay Selenium, đóng trang và context sau khi xong, không chỉ đóng tab.
Bài aiohttp proxy và cài đặt proxy cho thư viện requests có cách truyền proxy cho Session. Khi proxy gắn vào Session thay vì từng request, việc dùng lại kết nối tới proxy cũng tự nhiên hơn.
Đặt giới hạn hợp lý
Khi đã hết rò mà vẫn chạm trần vì cần nhiều kết nối đồng thời, lúc đó mới nâng giới hạn. Trong Python, tiến trình có thể tự nâng soft limit lên hard limit bằng module resource:
import resource
soft, hard = resource.getrlimit(resource.RLIMIT_NOFILE)
resource.setrlimit(resource.RLIMIT_NOFILE, (min(hard, 65536), hard))
Với systemd, đặt LimitNOFILE trong tệp unit. Với Docker, dùng tùy chọn --ulimit nofile. Đặt trong .bashrc hay ulimit ở terminal không ảnh hưởng tới dịch vụ chạy bằng systemd.
Đừng đặt giới hạn vô hạn. Giới hạn hợp lý vẫn là lưới an toàn: nếu có rò rỉ mới, crawler gãy ở mức kiểm soát được thay vì kéo cả máy tới ENFILE.
Giới hạn đồng thời
Số file descriptor cần dùng nên tỉ lệ với số luồng hoặc số tác vụ song song, không tỉ lệ với số URL. Dùng semaphore trong asyncio, giới hạn connector của aiohttp, hoặc CONCURRENT_REQUESTS trong Scrapy để chặn trên.
Bài 1 proxy chạy được bao nhiêu luồng bàn về số luồng hợp lý theo proxy. Chọn số luồng theo bài đó, rồi đặt soft limit cao hơn số luồng nhân số kết nối mỗi luồng cộng thêm phần dư cho tệp và log.
Theo dõi file descriptor trong crawler chạy lâu
Crawler chạy nhiều giờ nên tự ghi số file descriptor của mình vào log định kỳ, ví dụ mỗi 1.000 trang. Một dòng log gồm thời điểm, số trang đã xử lý, số file descriptor và số kết nối đang mở là đủ để vẽ lại đường như bảng ca C.
Có thể đặt thêm một ngưỡng tự vệ. Khi số file descriptor vượt 80% soft limit, crawler ngừng nhận URL mới, ghi cảnh báo và chờ các tác vụ đang chạy kết thúc. Cách này biến lỗi gãy giữa chừng thành lần dừng có kiểm soát, dữ liệu đã lấy không bị mất.
Khi crawler chạy trong container, nên theo dõi cả từ bên ngoài. Tệp /proc/PID/fd của tiến trình trong container vẫn đọc được từ máy chủ nếu có quyền. Prometheus process exporter hay node exporter có chỉ số số file descriptor mở theo tiến trình.
Trường hợp crawler dùng trình duyệt
Với Playwright, mỗi lệnh launch tạo một tiến trình trình duyệt riêng kèm nhiều file descriptor. Nên launch một lần, tạo context mới cho mỗi phiên, và đóng context sau khi xong. Đóng page mà không đóng context vẫn để lại tài nguyên.
Với Selenium, quên gọi quit khi có ngoại lệ là nguyên nhân phổ biến. Tiến trình chromedriver và trình duyệt còn chạy ngầm, giữ file descriptor và bộ nhớ. Bọc phần dùng driver trong try và finally để quit luôn được gọi.
Trình duyệt chạy qua proxy cũng mở kết nối tới proxy như crawler HTTP thường. Nếu proxy cần xác thực, mỗi context có thể mở kết nối riêng. Số kết nối tới proxy vì vậy tăng theo số context song song, không theo số trang.
Giới hạn suy luận của bài
Lab chạy trên Windows, nên giới hạn đo được là của C runtime Microsoft, không phải RLIMIT_NOFILE của Linux. Phần Linux, systemd và lệnh /proc lấy theo tài liệu chính thức ngày 29/10/2026, chưa chạy trên máy Linux.
Số handle Windows gồm cả handle của máy chủ chạy cùng tiến trình, nên tỉ lệ 14 handle mỗi kết nối chỉ đúng với lab này. Điều chắc là xu hướng: bản rò tăng tuyến tính, bản sửa phẳng.
Checklist Too many open files khi chạy crawler
- Đọc dòng cuối traceback, xác nhận là errno 24 hay 23.
- Xem /proc/PID/limits để biết giới hạn thật của tiến trình.
- Ghi số file descriptor theo thời gian, xem đường phẳng hay dốc.
- Nhóm file descriptor theo loại để biết socket hay tệp đang rò.
- Sửa vòng đời Session, response và tệp trước khi nâng giới hạn.
- Nâng soft limit trong unit systemd hoặc Docker, không chỉ trong terminal.
- Đặt giới hạn đồng thời để số file descriptor không chạy theo số URL.
Proxy ổn định giúp crawler giữ kết nối lâu và dùng lại socket, ít mở kết nối mới hơn. ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay, giao thức HTTP và SOCKS5; anh em có thể mua proxy uy tín tại trang chủ ProxyVN rồi gắn vào một Session duy nhất cho mỗi worker.
Câu hỏi thường gặp về Too many open files khi chạy crawler
Tăng ulimit lên 1 triệu có được không?
Được về mặt kỹ thuật nếu hard limit và nr_open cho phép. Nhưng nếu mã đang rò, lỗi vẫn sẽ đến, chỉ muộn hơn và có thể kéo theo thiếu bộ nhớ. Hãy đo đường số file descriptor trước.
Vì sao chạy trên máy Windows không lỗi mà lên máy chủ Linux thì lỗi?
Trên Windows, socket không tính vào giới hạn tệp của C runtime, như ca E trong lab. Trên Linux, socket và tệp dùng chung một giới hạn, mặc định thường chỉ 1.024.
Dùng proxy có làm tăng số file descriptor không?
Mỗi kết nối tới proxy là một socket, giống kết nối thẳng. Proxy không làm tăng thêm. Nhưng nếu mỗi request tạo kết nối mới tới proxy thay vì dùng lại, số socket tăng nhanh như ca C.
Đã tăng LimitNOFILE mà vẫn lỗi?
Kiểm /proc/PID/limits của đúng tiến trình đang chạy. Cần chạy lệnh nạp lại cấu hình systemd và khởi động lại dịch vụ. Nếu crawler chạy trong container, giới hạn của container có thể thấp hơn của máy chủ.
Lỗi ENFILE có phải do crawler không?
Có thể, nếu crawler rò nặng tới mức kéo tổng số handle của máy lên trần. Nhưng thường là do dịch vụ khác. Đọc /proc/sys/fs/file-nr rồi so số file descriptor của từng tiến trình để tìm thủ phạm.
Làm sao biết đang rò tệp hay rò socket?
Trên Linux, ls -l /proc/PID/fd cho biết từng file descriptor trỏ tới đâu. Socket hiện dạng socket kèm số inode, tệp hiện đường dẫn. Nhóm theo loại sẽ thấy loại nào tăng.
Scrapy có bị lỗi này không?
Có, nhất là khi tăng CONCURRENT_REQUESTS rất cao hoặc dùng pipeline mở tệp theo từng item. Giảm đồng thời và mở tệp một lần cho cả spider thường là đủ.
Too many open files khi chạy crawler và những điều cần nhớ
Too many open files khi chạy crawler thường là triệu chứng của rò rỉ, không phải giới hạn quá thấp. Trong lab, bản rò giữ 400 kết nối sau 400 request, bản dùng một Session chỉ giữ 1. Đo đường số file descriptor, sửa vòng đời tài nguyên, rồi mới nâng giới hạn. Cần proxy ổn định để giữ kết nối lâu khi xử lý Too many open files khi chạy crawler, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


