Semantic Scholar API graph: thu đồ thị citation giữ đúng ID
Semantic Scholar API graph là cách dùng Academic Graph API của Semantic Scholar để lấy một bài báo, danh sách bài nó trích dẫn và danh sách bài trích dẫn nó, rồi dựng thành đồ thị có hướng. Việc khó không nằm ở lệnh gọi mà ở chỗ giữ đúng định danh, đúng chiều cạnh và biết mình mới lấy được bao nhiêu phần của đồ thị. ProxyVN gọi API thật không dùng khóa, thu một đồ thị nhỏ quanh một bài báo, ghi từng lượt 429 và lập danh sách những gì còn thiếu.
Semantic Scholar API graph: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và ranh giới với bài OpenAlex.
Bài toán cần giải
Một nhóm làm tổng quan tài liệu muốn biết bài báo nền tảng của họ được những công trình nào trích dẫn gần đây, và chính nó dựa trên những bài nào. Họ cần một đồ thị nhỏ để vẽ và lọc, không cần cả kho dữ liệu. Đồ thị phải giữ được định danh để ghép với danh sách DOI có sẵn.
Đầu ra nghiệm thu
Đầu ra là đồ thị citation nhỏ: mỗi nút có paperId, corpusId, DOI nếu có, tiêu đề, năm; mỗi cạnh có chiều trích dẫn và loại endpoint đã sinh ra nó. Kèm theo là danh sách thiếu trường, số liệu phân trang và nhật ký mọi lượt gọi, kể cả lượt bị 429.
Ranh giới với bài OpenAlex
Blog đã có bài OpenAlex API bằng Python về thống kê works. Bài này không thống kê. Nó tập trung vào cạnh trích dẫn: chiều của cạnh, hai loại ID của Semantic Scholar và cách chọn trường. Hai nguồn có ID và cách đếm khác nhau, không nên trộn mà không đối soát.
Không dùng khóa API
Lab gọi API không xác thực, dùng chung giới hạn với mọi người dùng không có khóa. Mục tiêu là cho thấy pipeline nhỏ chạy được ra sao trong điều kiện đó, và cần gì để chịu được lỗi 429. Phần nào cần khóa mới chạy được thì bài ghi rõ là chưa chạy.
Giới hạn của lab
Lab chạy ngày 05/11/2026 trên Windows với Python 3.12.10 và requests 2.34.2. Bài báo gốc là Construction of the Literature Graph in Semantic Scholar, DOI 10.18653/v1/N18-3011, cũng là ví dụ trong tài liệu API. Lab lấy đủ references và 100 trên 496 citations. Số liệu trên API thay đổi theo thời gian.
Ai nên đọc
Người làm tổng quan tài liệu hoặc phân tích trích dẫn bằng Python. Người viết pipeline cần ghép dữ liệu Semantic Scholar với DOI hoặc với nguồn khác. Người đang gặp 429 liên tục khi gọi API mà không rõ nên chờ bao lâu.
Thu citation graph có paper ID và field selection theo Semantic Scholar API graph hiện hành
Phần này tóm tắt tài liệu chính thức, chỉ giữ ý cần cho phép thử.
Ba nhóm dịch vụ
Trang Semantic Scholar API mô tả ba nhóm: Academic Graph cho bài báo, tác giả, trích dẫn và nơi xuất bản; Recommendations cho bài báo tương tự; Datasets cho bản tải toàn bộ dữ liệu. Lab chỉ dùng Academic Graph qua địa chỉ api.semanticscholar.org/graph/v1.
Giới hạn không có khóa
Trang sản phẩm ghi hầu hết endpoint dùng được không cần xác thực, nhưng chịu giới hạn 1000 request mỗi giây chia chung cho mọi người dùng không xác thực, và có thể bị siết thêm khi tải cao. Khóa API ban đầu có giới hạn 1 request mỗi giây cho mọi endpoint. Như vậy không khóa không có nghĩa nhanh hơn, chỉ có nghĩa dùng chung.
Most Semantic Scholar endpoints are available to the public without authentication, but they are rate-limited. (Semantic Scholar API)
Tài liệu tham chiếu
Tài liệu API là trang hiển thị bằng JavaScript, đặc tả máy đọc được nằm ở tệp swagger.json của Graph API, phiên bản 1.0. Lab đọc đặc tả này để lấy danh sách loại ID, cách chọn trường và ví dụ phân trang, thay vì dựa vào trí nhớ.
Loại ID được nhận
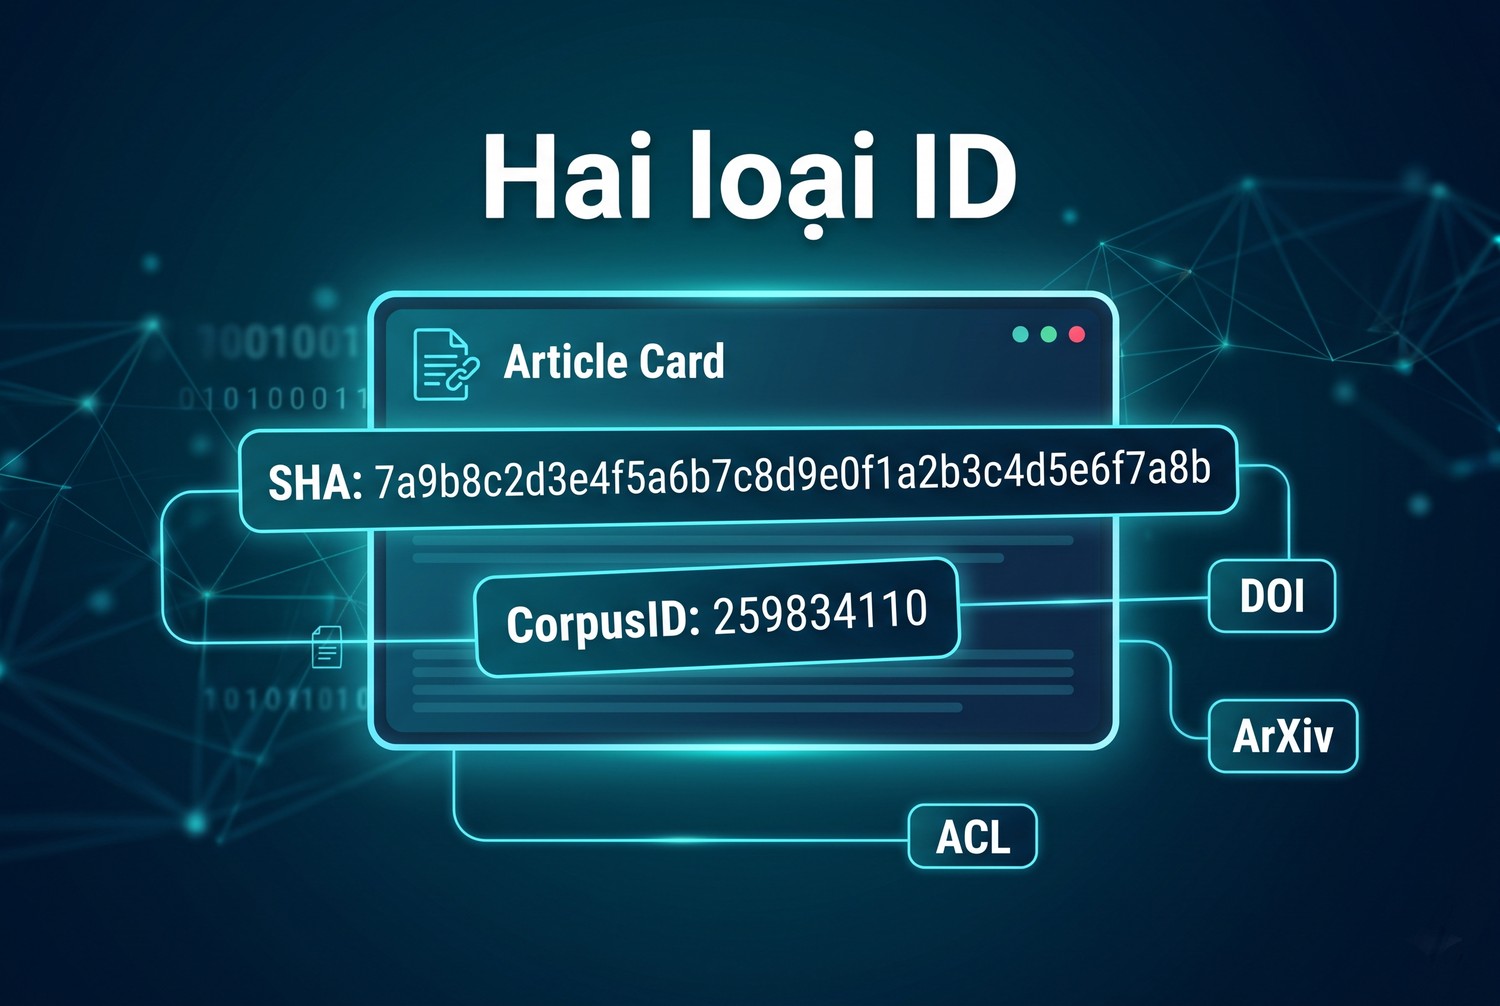
Đặc tả liệt kê các dạng ID cho đường dẫn bài báo: mã sha 40 ký tự của Semantic Scholar, CorpusId:, DOI:, ARXIV:, MAG:, ACL:, PMID:, PMCID: và URL: từ một số trang được hỗ trợ. Lab dùng DOI: cho bài gốc, rồi chuyển sang paperId cho mọi lượt gọi sau.
Chọn trường bằng fields
Tham số fields là danh sách trường cách nhau bằng dấu phẩy. Nếu bỏ qua, API chỉ trả paperId và title. paperId luôn có. Với citations và references, đặc tả nói mặc định trả paperId và title của bài liên quan, trường khác phải xin thêm.
Giới hạn kích thước
Đặc tả của endpoint bài báo ghi chỉ trả tối đa 10 MB dữ liệu mỗi lần. Xin trường citations.authors trên một bài có hàng nghìn trích dẫn dễ chạm giới hạn này. Lab dùng endpoint citations và references riêng có phân trang thay vì nhúng vào bài gốc.
Quy mô kho dữ liệu
Trang sản phẩm ghi kho có khoảng 214 triệu bài báo, 2,49 tỷ trích dẫn và 79 triệu tác giả tại thời điểm đọc. Với quy mô này, mọi đồ thị lấy qua API đều chỉ là một mảnh rất nhỏ. Câu hỏi của pipeline không phải lấy hết mà là lấy đúng mảnh cần cho câu hỏi nghiên cứu.
Session và User-Agent
Lab dùng một requests.Session với User-Agent ProxyVN-lab/1.0 kèm mô tả tần suất thấp. Session giữ kết nối mở giữa các lượt gọi, giảm thời gian bắt tay TLS. User-Agent có tên giúp phía API phân biệt pipeline của nhóm với lưu lượng khác khi cần liên hệ.
Vì sao cần đồ thị nhỏ
Với một câu hỏi tổng quan tài liệu, đồ thị hai tầng quanh vài bài là đủ. Kéo cả kho qua API là sai công cụ, vì đã có Datasets cho việc đó. Pipeline đồ thị nhỏ phải biết dừng ở đâu và ghi lại ranh giới đã dừng.
Chọn paper ID và fields cần cho citation graph trong Semantic Scholar API graph
Phần này giải thích hai loại ID và cách chọn trường cho từng nút.
Gọi bài gốc bằng DOI
Lượt gọi đầu là /paper/DOI:10.18653/v1/N18-3011 với fields gồm paperId, corpusId, externalIds, title, year, citationCount, referenceCount. Lượt này trả 200 ngay. Bài có paperId 649def34f8be52c8b66281af98ae884c09aef38b, corpusId 19170988, năm 2018, referenceCount 26, citationCount 496.
SEED = "DOI:10.18653/v1/N18-3011"
PF = "paperId,corpusId,externalIds,title,year,citationCount,referenceCount"
r = get(f"/paper/{SEED}", {"fields": PF})
seed = r.json()
paperId và corpusId
Hai loại ID
paperId là mã sha 40 ký tự dạng chuỗi. corpusId là số nguyên. Cả hai chỉ cùng một bài, nhưng dùng ở những chỗ khác nhau: API nhận cả hai, bộ dữ liệu tải về thường dùng corpusId. Lab lưu cả hai cho mọi nút, và dùng paperId làm khóa chính của đồ thị.
externalIds
Trường externalIds của bài gốc có MAG, DBLP, ArXiv, ACL, DOI và CorpusId. Đây là cầu nối sang nguồn khác. Một nút không có DOI trong externalIds không ghép được với danh sách DOI bằng định danh, phải dùng ArXiv hay tiêu đề.
DOI không đủ cho mọi nút
Trong 127 nút của đồ thị, 9 nút có paperId nhưng không có DOI trong externalIds. Nếu nhóm nghiên cứu chỉ giữ nút có DOI, họ mất 9 nút. Lưu paperId làm khóa và DOI làm thuộc tính là cách không mất nút.
Chọn trường cho cạnh
Cho references và citations, lab xin paperId, corpusId, externalIds, title, year của bài liên quan. Với citations, lab xin thêm isInfluential và intents, hai trường gắn với cạnh chứ không gắn với bài. Không xin abstract hay authors để giữ response nhỏ.
Bảng trường đã dùng
Lượt gọi |
fields |
Gắn với |
|---|---|---|
/paper/{id} |
paperId, corpusId, externalIds, title, year, citationCount, referenceCount |
bài gốc |
/paper/{id}/references |
paperId, corpusId, externalIds, title, year |
bài được trích |
/paper/{id}/citations |
các trường trên cùng isInfluential, intents |
bài trích và cạnh |
/paper/batch |
paperId, corpusId, title |
kiểm lại nút |
Chuyển sang paperId sau lượt đầu
Sau khi có paperId của bài gốc, mọi lượt gọi dùng paperId thay vì DOI. paperId không có ký tự gạch chéo cần mã hóa trong đường dẫn. Nó cũng là thứ API trả về trong mọi response, nên không cần chuyển đổi qua lại.
Gọi bằng ArXiv hay PMID
Nếu danh sách đầu vào là mã ArXiv hay PMID, dùng tiền tố tương ứng như ARXIV: hay PMID: thay cho DOI:. API trả cùng paperId cho cùng bài, bất kể gọi bằng loại ID nào. Ghi loại ID đầu vào vào kết quả để biết nút được tìm ra bằng cách nào.
Mã hóa DOI trong đường dẫn
DOI có dấu gạch chéo, ví dụ 10.18653/v1/N18-3011. Lab đặt DOI thẳng vào đường dẫn sau tiền tố DOI: và API vẫn nhận đúng. Với DOI có ký tự đặc biệt như dấu ngoặc hay dấu thăng, nên mã hóa phần trăm trước khi ghép vào URL, nếu không thư viện HTTP có thể cắt chuỗi sai.
Không ghép bằng tiêu đề
Tiêu đề giống nhau không có nghĩa là cùng bài. Bản preprint và bản hội nghị có thể cùng tiêu đề nhưng khác ID. Lab không gộp nút theo tiêu đề. Nếu cần gộp, ghi lý do và giữ cả hai ID trong một bảng ánh xạ riêng.
Đọc citations/references với pagination đúng Semantic Scholar API graph
Phần này mô tả cách phân trang và cách chịu lỗi 429.
offset, limit và next
Response của citations và references có offset, next và data. Đặc tả có ví dụ một bài 1600 citations: gọi mặc định trả offset 0, next 100 và 100 phần tử. Khi đã tới trang cuối, next không còn. Vòng lặp phân trang dừng khi next vắng mặt hoặc khi đạt số trang định trước.
References trong một trang
Lab gọi references với limit 100, offset 0. API trả 26 phần tử và next là None. Con số 26 khớp với referenceCount của bài gốc. Danh sách references của bài này đã đủ trong một trang.
Citations hai trang
Lab gọi citations với limit 50 ở offset 0 và offset 50. Trang đầu trả next là 50, trang sau trả next là 100. Lab dừng sau hai trang, lấy 100 trên 496 citations. Ranh giới này được ghi vào kết quả, để người đọc đồ thị biết nó chỉ là một phần.
Thứ tự của citations
Trong 100 citations lấy được, 41 bài có năm 2026, 31 bài năm 2025 và 28 bài năm 2024. Hai trang đầu nghiêng hẳn về bài mới. Lab không thấy tài liệu nào cam kết thứ tự này, nên không coi đó là quy tắc. Muốn có bài cũ, phải đi hết các trang.
Một lượt 429
Phân trang và 429
Trong sáu lượt gọi của lab, một lượt bị 429: trang citations ở offset 50. Thân lỗi ghi Too Many Requests và gợi ý xin khóa API. Response không có header Retry-After. Hàm get chờ 5 giây rồi thử lại, lần thứ hai trả 200.
Hàm get có backoff
Hàm get nghỉ 1,5 giây trước mỗi lượt. Nếu nhận 429, nó đọc Retry-After nếu có, nếu không thì chờ 5 giây, gấp đôi mỗi lần, tối đa 60 giây, tối đa 8 lần thử. Mỗi lượt được ghi: đường dẫn, tham số, mã trạng thái, lần thử, thời gian phản hồi và Retry-After.
def get(path, params):
    wait = 5
    for attempt in range(1, 9):
        time.sleep(1.5)
        r = S.get(B + path, params=params, timeout=30)
        LOG.append({"path": path, "status": r.status_code, "attempt": attempt,
                    "retry_after": r.headers.get("Retry-After")})
        if r.status_code == 429:
            ra = r.headers.get("Retry-After")
            time.sleep(int(ra) if ra and ra.isdigit() else wait)
            wait = min(wait * 2, 60)
            continue
        return r
    return r
429 trước cả lượt đầu
Trước khi chạy lab, một lượt thử bằng curl tới endpoint bài báo nhận 429 ngay lần đầu. Pool chung có thể đang đầy vì người khác. Một pipeline không có backoff sẽ thất bại ngẫu nhiên, không liên quan tới mã của mình.
Thời gian chạy
Sáu lượt gọi của lab, cộng thời gian nghỉ và một lần chờ sau 429, mất chưa tới nửa phút. Phần lớn thời gian là thời gian nghỉ chủ động. Với pipeline nhỏ, chậm một chút để không bị chặn tốt hơn nhanh rồi phải chạy lại.
Ghi lỗi khác 429
Hàm get trả về mọi mã khác 429 cho bên gọi xử lý. API có thể trả mã lỗi khác, ví dụ khi ID không tồn tại hoặc tên trường viết sai. Lab không gặp mã lỗi nào ngoài 429, nhưng bên gọi vẫn kiểm status_code trước khi đọc JSON, để không ghi một response lỗi vào đồ thị.
Không chạy song song
Lab gọi tuần tự, không mở nhiều luồng. Với pool chung, chạy song song chỉ làm tăng 429 cho mình và cho người khác. Nếu cần tốc độ cao hơn, con đường đúng là xin khóa API hoặc dùng bộ dữ liệu tải về.
Giữ phân biệt citingPaper và citedPaper trong cạnh Semantic Scholar API graph
Phần này nói về chiều của cạnh, chỗ hay bị đảo nhất.
Hai endpoint, hai tên trường
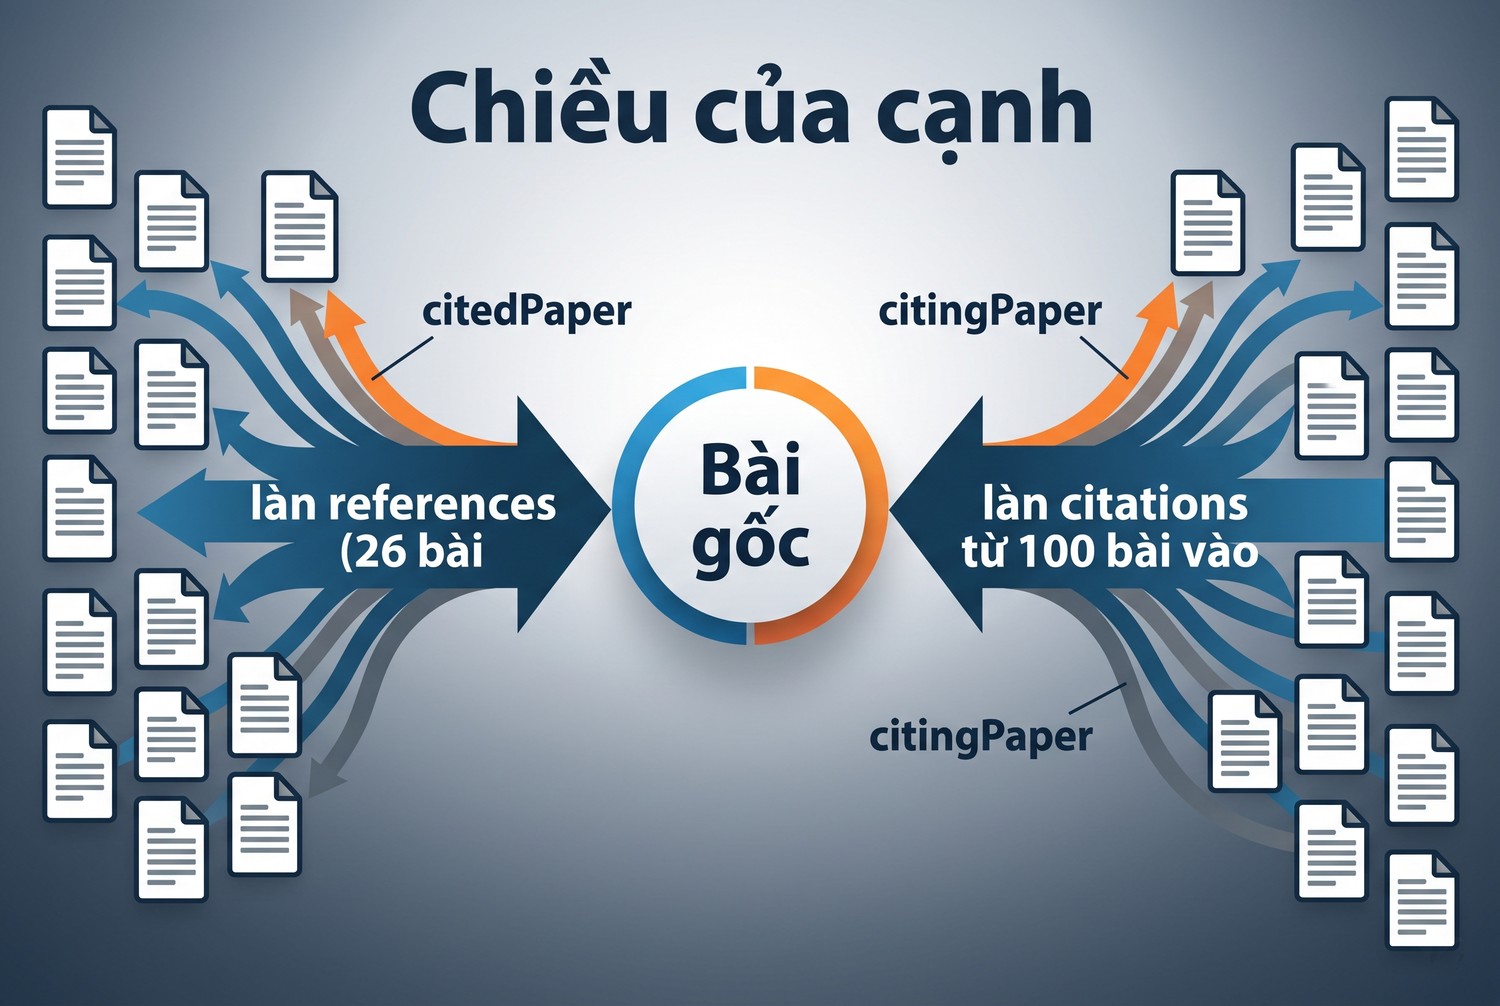
Endpoint references trả mỗi phần tử có citedPaper, là bài mà bài gốc trích dẫn. Endpoint citations trả mỗi phần tử có citingPaper, là bài trích dẫn bài gốc. Bài gốc không xuất hiện trong phần tử, nó nằm ở đường dẫn của lượt gọi.
Chiều cạnh thống nhất
Chiều của cạnh
Lab ghi mọi cạnh theo một quy ước: citing là bài trích dẫn, cited là bài được trích dẫn. Với references, citing là bài gốc, cited là citedPaper. Với citations, citing là citingPaper, cited là bài gốc. Mỗi cạnh còn có cột type ghi endpoint đã sinh ra nó.
for x in refs:
    k = node(x.get("citedPaper") or {}, "reference")
    edges.append({"citing": s, "cited": k, "type": "references"})
for x in cits:
    k = node(x.get("citingPaper") or {}, "citation")
    edges.append({"citing": k, "cited": s, "type": "citations",
                  "isInfluential": x.get("isInfluential"), "intents": x.get("intents")})
Lỗi đảo chiều hay gặp
Mã viết vội thường đọc trường paper chung cho cả hai endpoint, hoặc ghi cạnh từ bài gốc tới mọi bài liên quan. Kết quả là đồ thị nói bài gốc trích dẫn 496 bài, trong khi nó chỉ có 26 tham chiếu. Kiểm nhanh là so số cạnh ra khỏi bài gốc với referenceCount.
Thuộc tính của cạnh
isInfluential và intents là thuộc tính của cạnh trích dẫn, không phải của bài. Trong 100 cạnh citations, 12 cạnh có isInfluential là true. intents có 4 cạnh background, 9 cạnh methodology, 0 cạnh result. Phần lớn cạnh không có intents nào.
Không có bài vừa là tham chiếu vừa trích dẫn
Lab kiểm nút nào vừa là reference vừa là citation của bài gốc. Kết quả là 0. Với bài khác, chuyện này có thể xảy ra ở các bài cùng nhóm tác giả ra cùng lúc. Nếu có, đó là hai cạnh ngược chiều, không phải một cạnh trùng.
Không có cạnh trùng
Lab đếm cặp citing, cited lặp lại trong danh sách cạnh. Kết quả là 0 cạnh trùng trên 126 cạnh. Với đồ thị lấy qua nhiều trang hoặc nhiều lần chạy, phép đếm này phát hiện trang bị gọi lặp hoặc dữ liệu đổi giữa hai lần gọi.
Kiểu đồ thị nên dùng
Đồ thị citation là đồ thị có hướng. Khi nạp vào thư viện như NetworkX, dùng DiGraph với cạnh từ citing sang cited. Thuộc tính isInfluential và intents gắn vào cạnh, thuộc tính tiêu đề và năm gắn vào nút. Dùng đồ thị vô hướng sẽ mất ý nghĩa của chiều trích dẫn.
Bảng tóm tắt đồ thị
Chỉ số |
Giá trị |
|---|---|
referenceCount của bài gốc |
26 |
references lấy được |
26, paperId null: 0 |
citationCount của bài gốc |
496 |
citations lấy được |
100 (2 trang) |
Số nút |
127 |
Số cạnh |
126, trùng: 0 |
Cạnh isInfluential |
12 |
Nút không có DOI |
9 |
Lượt gọi / lượt 429 |
6 / 1 |
Đối soát paperId/corpusId cùng cạnh trùng hoặc thiếu trường trong Semantic Scholar API graph
Phần này kiểm lại nút bằng endpoint batch và lập danh sách thiếu.
Endpoint batch
Lab gửi POST /paper/batch với năm paperId lấy từ đồ thị và một ID không tồn tại, xin paperId, corpusId, title. API trả 200 với danh sách sáu phần tử. Năm phần tử đầu khớp paperId và corpusId đã lưu. Phần tử cuối là null.
null thay vì lỗi
Với ID không tồn tại, batch không trả lỗi mà trả null đúng vị trí. Mã đọc batch phải giữ thứ tự và kiểm null, nếu không sẽ lệch dữ liệu giữa ID đầu vào và kết quả. Đây là hành vi khác với endpoint một bài, nơi ID sai trả lỗi HTTP.
Danh sách thiếu trường
Lab ghi một dòng thiếu khi nút có paperId mà thiếu corpusId hoặc year, và khi phần tử có paperId null. Với bài gốc này, danh sách thiếu trống: mọi tham chiếu đã khớp với một bài trong kho, mọi nút có corpusId và năm. Thiếu duy nhất là DOI ở 9 nút.
Tham chiếu chưa khớp
Một phần tử references có thể mang citedPaper với paperId null nếu tham chiếu chưa khớp với bài nào trong kho. Mã của lab chuẩn bị sẵn cho ca này: tạo nút tạm với khóa KHONG_ID kèm tiêu đề và ghi vào danh sách thiếu. Bài gốc trong lab không có ca này, nên nhánh mã đó chưa được kiểm bằng dữ liệu thật.
So số đếm với số lấy được
referenceCount 26 khớp với 26 references lấy được. citationCount 496 lớn hơn nhiều so với 100 citations lấy được, đúng như dự kiến khi chỉ lấy hai trang. Bảng đầu ra ghi cả hai số, để không ai đọc đồ thị và nghĩ bài gốc chỉ có 100 trích dẫn.
Đối soát với nguồn khác
Nếu ghép với OpenAlex hay Crossref, dùng DOI hoặc ArXiv trong externalIds làm cầu nối, không dùng paperId. Số citation của hai nguồn khác nhau vì phạm vi kho khác nhau. Bảng ghép nên giữ số của từng nguồn trong cột riêng.
Bản ghi bị gộp hay tách
Kho dữ liệu lớn có lúc gộp hai bản ghi trùng thành một hoặc tách một bản ghi sai thành hai. Khi đó paperId cũ có thể không còn trả về đúng bài. Gọi lại các nút quan trọng bằng batch theo chu kỳ, so paperId trả về với paperId đã lưu, giúp phát hiện thay đổi này. Lab chưa gặp ca nào.
Thời điểm lấy
Mỗi lượt gọi có thời điểm UTC trong nhật ký. citationCount của bài gốc sẽ tăng theo thời gian. Bảng đầu ra ghi thời điểm lấy bài gốc, để người dùng hiểu 496 là con số ngày 05/11/2026.
Đầu ra nghiệm thu Semantic Scholar API graph: đồ thị citation nhỏ giữ ID, loại cạnh và danh sách thiếu trường
Phần này gom đầu ra thành bản ghi có thể lưu.
Tệp đầu ra
Lab sinh result.json gồm phiên bản Python và requests, bài gốc và ba trang đã gọi kèm offset và next. Tệp có 127 nút với paperId, corpusId, DOI, tiêu đề, năm và vai trò. Tệp còn có 126 cạnh có chiều và loại, kết quả batch, danh sách thiếu và nhật ký sáu lượt gọi.
Danh sách kiểm tra
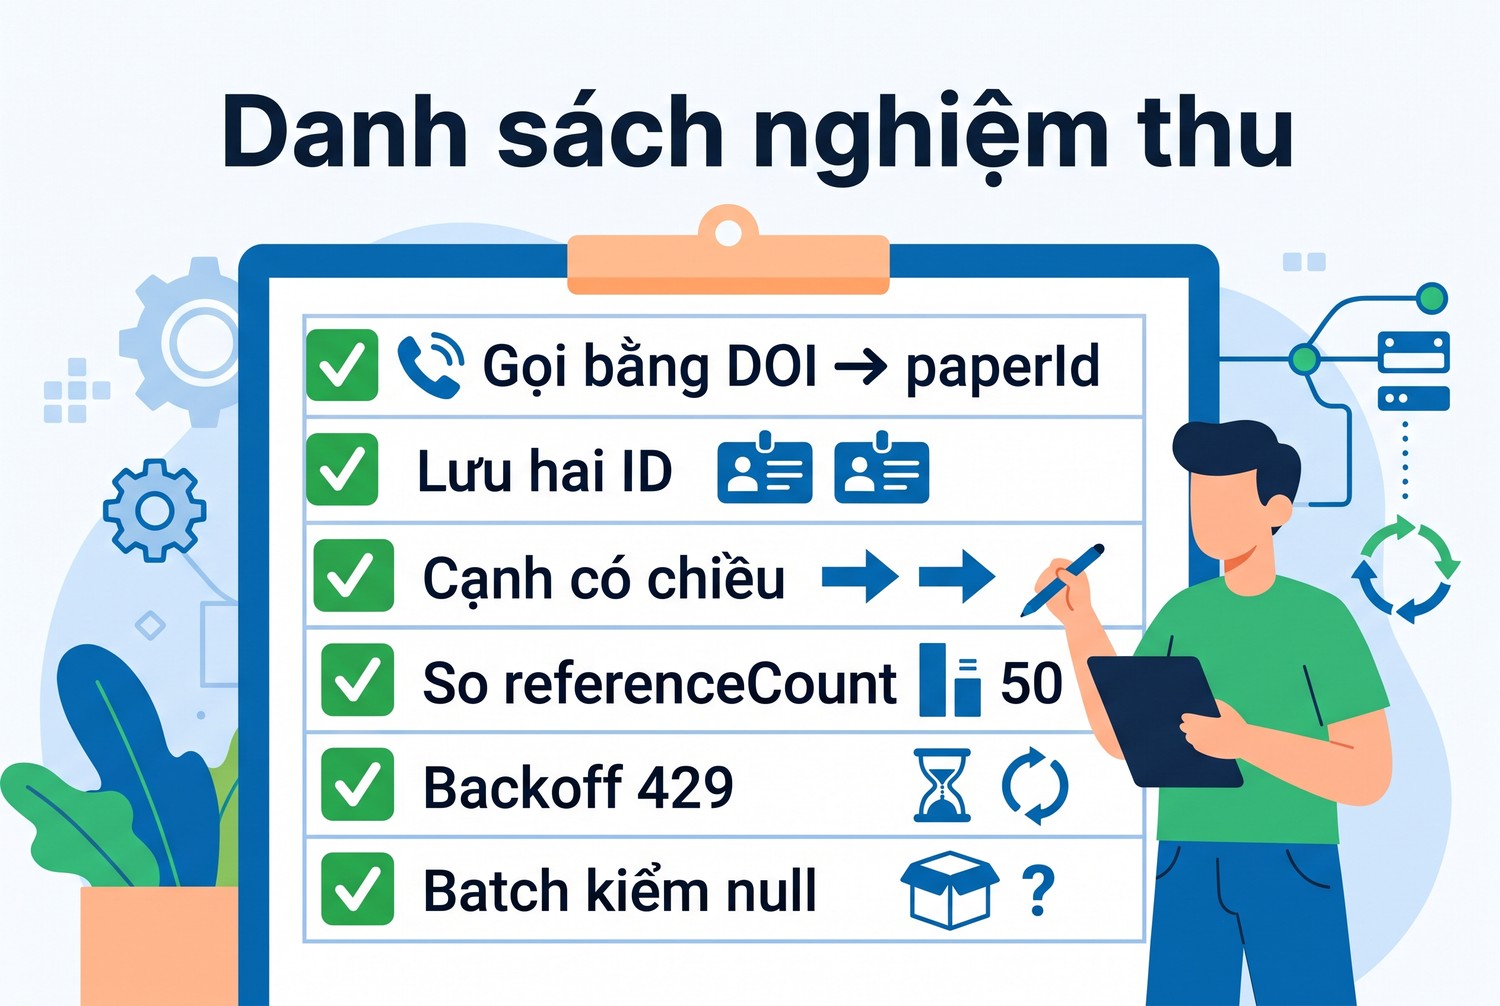
Danh sách nghiệm thu
- Bài gốc gọi bằng DOI, các lượt sau dùng paperId.
- Mỗi nút lưu cả paperId và corpusId, DOI là thuộc tính.
- Mỗi cạnh có citing, cited và endpoint sinh ra nó.
- Số cạnh ra khỏi bài gốc khớp referenceCount.
- Số citations lấy được ghi cạnh citationCount.
- Có backoff cho 429 và nhật ký mọi lượt.
- Batch được đọc theo vị trí, có kiểm null.
Những gì lab chưa chạy
Chưa dùng khóa API. Chưa đi hết 496 citations. Chưa thử bài có references paperId null. Chưa thử endpoint tác giả, tìm kiếm, Recommendations và Datasets. Chưa đối soát với OpenAlex hay Crossref. Chưa thử trường contexts của cạnh.
Câu kết luận được phép viết
Câu được phép viết là: không dùng khóa, lab lấy được 26 references và 100 citations của một bài qua sáu lượt gọi, gặp một lượt 429 không có Retry-After. Câu không được phép viết là: API không khóa đủ cho pipeline lớn. Lab chỉ chạy sáu lượt.
Vận hành pipeline đồ thị với Semantic Scholar API graph
Phần này chuyển kết quả lab thành quy tắc cho pipeline chạy thật.
Xin khóa khi chạy định kỳ
Pipeline chạy hằng ngày hay hằng tuần nên dùng khóa API. Khóa cho giới hạn riêng thay vì pool chung, và giúp đội API hỗ trợ khi có sự cố. Lưu khóa trong biến môi trường, không ghi vào mã hay log.
Lưu response theo trang
Lưu từng trang response kèm offset vào tệp. Khi một lượt thất bại giữa chừng, chạy tiếp từ offset cuối thay vì gọi lại từ đầu. Việc này giảm số lượt gọi và giảm 429.
Giới hạn độ sâu
Đồ thị hai tầng quanh một bài có thể đã có hàng nghìn nút. Đặt giới hạn số trang mỗi bài và số tầng ngay từ đầu, ghi giới hạn vào kết quả. Câu hỏi cần cả kho thì chuyển sang bộ dữ liệu tải về.
Không đổi IP để né giới hạn
Giới hạn của pool chung là chính sách của nhà cung cấp. Đổi IP liên tục để né 429 là đi ngược chính sách và làm hại người dùng khác. Con đường đúng là khóa API, nhịp gọi chậm và bộ dữ liệu tải về.
Proxy ở đâu trong luồng
Proxy có vai trò khi hạ tầng của nhóm phải đi ra Internet qua một điểm cố định, ví dụ máy chủ trong mạng công ty, chứ không phải để vượt giới hạn. Khi cần IP tại Việt Nam cho phần tải này, anh em có thể mua proxy tại trang chủ ProxyVN. Vai trò của proxy có ở bài Web Scraping proxy là gì, cách ghi chuỗi cấu hình có ở bài định dạng proxy.
Ghi giấy phép và trích dẫn
Dữ liệu Semantic Scholar có điều khoản sử dụng riêng, và trang sản phẩm có mục Cite the Paper cho bài báo mô tả nền tảng. Báo cáo dùng đồ thị nên ghi nguồn, thời điểm lấy và điều khoản đã đọc.
Định dạng lưu đồ thị
Lưu nút và cạnh thành hai tệp riêng, JSON Lines hoặc CSV, mỗi dòng một nút hoặc một cạnh. Định dạng phẳng dễ nạp vào công cụ vẽ đồ thị, bảng tính hay cơ sở dữ liệu. Đính kèm tệp nhật ký gọi API và một dòng mô tả ranh giới đã dừng.
Ghi phiên bản đặc tả
Ghi phiên bản của swagger.json đã đọc, lab thấy là 1.0, cùng ngày đọc. Nếu đặc tả đổi tên trường hay cách phân trang, pipeline sẽ hỏng theo cách khó hiểu. So phiên bản đặc tả khi pipeline bắt đầu lỗi là bước chẩn đoán rẻ nhất.
Bảo vệ khóa trong log
Khi đã có khóa, header x-api-key đi kèm mỗi lượt gọi. Nhật ký của lab chỉ ghi đường dẫn, tham số và mã trạng thái, không ghi header. Giữ nguyên quy tắc này khi thêm khóa, để tệp log có thể chia sẻ mà không lộ khóa.
Kiểm lại số đếm định kỳ
Gọi lại bài gốc với citationCount và referenceCount theo chu kỳ. Khi citationCount tăng, chỉ cần lấy thêm các trang mới. Khi referenceCount đổi, bản ghi bài gốc đã được xử lý lại và nên lấy lại references.
Semantic Scholar API graph: câu hỏi thường gặp
Các câu dưới đây gom những điểm hay bị hỏi.
Có cần khóa API không?
Không bắt buộc với hầu hết endpoint, nhưng không khóa thì dùng chung giới hạn và dễ gặp 429.
paperId khác corpusId thế nào?
paperId là mã sha 40 ký tự, corpusId là số nguyên. Cả hai chỉ cùng một bài.
citingPaper và citedPaper khác nhau ra sao?
citingPaper có trong endpoint citations, là bài trích dẫn. citedPaper có trong endpoint references, là bài được trích dẫn.
Gặp 429 thì chờ bao lâu?
Đọc Retry-After nếu có. Trong lab, response 429 không có header này, chờ 5 giây là đủ cho lượt sau.
Batch trả gì cho ID sai?
null ở đúng vị trí trong danh sách, không trả lỗi HTTP.
Vì sao không phải nút nào cũng có DOI?
Một số bài chỉ có ArXiv, DBLP hay ACL. Trong lab, 9 trên 127 nút không có DOI.
Lấy toàn bộ citations bằng cách nào?
Đi theo next cho tới khi hết. Với bài có rất nhiều citations, dùng khóa API hoặc bộ dữ liệu tải về.
Semantic Scholar API graph và những điều cần nhớ
Semantic Scholar API graph cho dựng đồ thị citation nhỏ bằng hai endpoint có phân trang, miễn là giữ đúng paperId, corpusId và chiều của từng cạnh. Lab không dùng khóa lấy đủ 26 references, 100 trên 496 citations, gặp một lượt 429 và thấy batch trả null cho ID sai. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em ghi rõ ranh giới đã dừng khi dùng Semantic Scholar API graph.


