
Scrapingdog API structured results: endpoint, trường và credit
Scrapingdog API structured results là phần dữ liệu đã được bóc sẵn thành JSON mà Google Search API của Scrapingdog trả về, gồm kết quả tự nhiên, thông tin tìm kiếm và các khối đặc biệt. Thay vì tự phân tích HTML trang kết quả, ta đọc thẳng các trường như title, link, rank. Việc còn lại là ánh xạ đúng sang bảng dữ liệu của mình, tính đúng credit và không nhầm phản hồi rỗng với phản hồi thành công. ProxyVN đọc tài liệu chính thức ngày 03/11/2026, gọi endpoint thật bằng khóa giả để xem lỗi thật, rồi chạy mã ánh xạ trên một máy chủ mô phỏng theo đúng mẫu phản hồi trong tài liệu. Bài ghi rõ phần nào đã chạy và phần nào chưa thử với tài khoản thật.
Scrapingdog API structured results: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và những gì bài không bàn.
Bài toán
Một nhóm SEO cần theo dõi thứ hạng vài trăm từ khóa trên Google mỗi tuần. Họ dùng Google Search API của Scrapingdog để lấy kết quả dạng JSON. Câu hỏi thực tế là: gọi endpoint nào, tham số nào ảnh hưởng tới credit, trường nào luôn có và trường nào có thể thiếu, và làm sao biết một phản hồi 200 thật sự có dữ liệu.
Đầu ra nghiệm thu
Đầu ra gồm bảng endpoint, mức credit, trường đầu ra và một phản hồi mẫu đã che bí mật. Kèm theo là mã ánh xạ organic_results sang schema nội bộ, đã chạy trên phản hồi mẫu và trên các ca thiếu dữ liệu.
Không phải bài cấu hình proxy
Scrapingdog tự lo việc gửi request tới Google. Người dùng API không cấu hình proxy cho từng request tìm kiếm. Bài không bàn cách xoay IP hay vượt chặn. Trọng tâm là hợp đồng dữ liệu giữa API và hệ thống của bạn.
Giới hạn của lab
Lab không có tài khoản Scrapingdog trả phí. Một lần gọi endpoint thật với khóa giả trả HTTP 401 kèm JSON báo khóa không hợp lệ. Mọi phép thử ánh xạ chạy trên máy chủ mô phỏng ở cổng 9451, trả về đúng cấu trúc mẫu trong tài liệu. Mức credit trong bài lấy từ tài liệu, chưa đối chiếu với bảng điều khiển tài khoản.
Ai nên đọc
Người đang dùng hoặc định dùng Scrapingdog để lấy kết quả tìm kiếm. Người viết pipeline theo dõi thứ hạng và cần schema nội bộ ổn định dù nhà cung cấp thêm bớt trường. Người phụ trách ngân sách cần ước tính credit trước khi chạy hàng nghìn truy vấn.
Vì sao chọn API thay vì tự phân tích
Trang kết quả của Google thay đổi cấu trúc thường xuyên và có cơ chế chống truy cập tự động. Tự phân tích nghĩa là tự duy trì parser và tự lo việc bị chặn. API chuyển hai việc đó sang nhà cung cấp, đổi lại bằng chi phí credit và sự phụ thuộc vào hợp đồng dữ liệu của họ. Bài này là về việc quản lý sự phụ thuộc đó.
Quyền sử dụng dữ liệu
Kết quả tìm kiếm lấy qua API vẫn chịu điều khoản của nhà cung cấp API và của chính công cụ tìm kiếm. Bài chỉ bàn kỹ thuật. Trước khi dùng dữ liệu cho sản phẩm thương mại, nên đọc điều khoản của Scrapingdog về mục đích sử dụng và lưu trữ.
Kiểm tra Google Search API của Scrapingdog và hợp đồng structured response hiện hành với Scrapingdog API structured results
Phần này tóm tắt những gì tài liệu chính thức nói.
Endpoint
Theo trang Google Search API Documentation của Scrapingdog, endpoint là https://api.scrapingdog.com/google, gọi bằng GET. Khóa API truyền qua tham số api_key trên URL. Truy vấn truyền qua tham số query.
Mức credit
Tài liệu ghi mỗi request thành công tốn 5 credit cho tìm kiếm thường. Bật advance_search hoặc mob_search thì tốn 10 credit. Bật deep_scrape, vốn tải thêm nội dung các trang trong organic_results, thì cộng 5 credit, và chỉ được phép khi advance_search tắt.
Tham số results đã ngừng tác dụng
Tài liệu ghi rõ tham số results đã lỗi thời: Google không còn hỗ trợ đổi số kết quả mỗi trang, mỗi trang trả tối đa 10 kết quả, và đổi tham số này không có tác dụng. Nhiều ví dụ cũ vẫn truyền results bằng 100. Mã như vậy vẫn chạy, nhưng không nhận được 100 kết quả.
Phân trang
Tham số page bắt đầu từ 0 cho trang đầu, 1 cho trang thứ hai. Muốn lấy 30 kết quả đầu, phải gọi ba lần với page 0, 1, 2. Mỗi lần là một request tính credit riêng.
Vị trí và ngôn ngữ
Tài liệu có các tham số domain, country, language, cùng một số tham số nâng cao như cr và lr để giới hạn quốc gia và ngôn ngữ của kết quả. Với từ khóa tiếng Việt, lab dùng country bằng vn và language bằng vi. Lab chưa kiểm kết quả thật khác nhau thế nào giữa các tổ hợp tham số.
Tham số html
Bật tham số html, API trả về HTML gốc của trang kết quả thay vì chỉ JSON đã bóc. Tùy chọn này hữu ích khi cần kiểm chéo dữ liệu đã bóc với trang gốc, hoặc khi cần một khối mà API chưa bóc. Lab không thử tham số này, vì không có khóa thật để nhận HTML.
Cấu trúc phản hồi mẫu
Phản hồi mẫu trong tài liệu có search_information với thời gian, tổng số kết quả, truy vấn hiển thị. Có organic_results là danh sách, mỗi phần tử có title, link, displayed_link, source, snippet, rank. Tùy truy vấn, phản hồi còn có các khối như sports_results.
Chọn đúng Google Search endpoint và gói đang có quyền trong Scrapingdog API structured results
Phần này giúp chọn endpoint và kiểm quyền trước khi viết pipeline.
Một nhà cung cấp, nhiều endpoint
Scrapingdog có nhiều API riêng cho các nguồn khác nhau, như tìm kiếm Google, Google Maps, mạng xã hội, trang thương mại điện tử. Mỗi API có endpoint, tham số và mức credit riêng. Bài chỉ dùng Google Search API. Đừng chép tham số từ API khác sang, vì chúng không dùng chung.
Kiểm khóa trước khi chạy hàng loạt
Lab gọi endpoint thật với khóa giả FAKEKEY123. Phản hồi là HTTP 401 với thông điệp Unauthorized request, please make sure your API key is valid, kèm success bằng false. Gọi thiếu cả khóa cũng ra 401 cùng thông điệp. Pipeline nên gọi một truy vấn thử trước khi chạy hàng loạt, dừng ngay nếu nhận 401.
Endpoint tài khoản
Lab thử đường dẫn account trên cùng máy chủ với khóa giả, nhận HTTP 400 và thông điệp api_key is not valid. Mã trạng thái khác với endpoint tìm kiếm. Lab không có khóa thật nên không biết endpoint này trả về gì khi khóa đúng. Nếu dùng nó để đọc số credit còn lại, cần kiểm với tài khoản thật.
Mã trạng thái khác nhau giữa các endpoint
Endpoint tìm kiếm trả 401 cho khóa sai, endpoint tài khoản trả 400. Mã xử lý lỗi không nên chỉ dựa vào 401 để nhận ra khóa sai. Nên đọc cả trường success và message trong thân phản hồi, vì cả hai endpoint đều trả success bằng false kèm thông điệp.
Gói và tính năng
Một số tính năng như advance_search hay mob_search tốn nhiều credit hơn. Tài liệu không nói gói nào chặn tính năng nào. Trước khi đưa tham số vào pipeline, nên thử một request với tài khoản thật và xem số credit bị trừ.
Thử một request trước khi chạy cả lô
Trước mỗi đợt chạy hàng trăm từ khóa, pipeline nên gọi một truy vấn đơn giản và kiểm ba điều: mã 200, có organic_results, phần tử đầu có link. Đạt thì chạy cả lô. Không đạt thì dừng và báo. Một request thử tốn 5 credit, rẻ hơn nhiều so với một lô hỏng.
Đọc lại tài liệu theo định kỳ
Tham số results từng có tác dụng rồi bị ghi là lỗi thời. Điều này cho thấy hợp đồng có thể đổi theo thay đổi phía Google. Nên đặt lịch đọc lại trang tài liệu, và ghi ngày đọc vào cấu hình pipeline.
Khóa API nằm trên URL
Vì khóa truyền qua tham số URL, nó xuất hiện ở mọi nơi ghi URL: log của ứng dụng, log của proxy công ty, thông báo lỗi của thư viện HTTP. Lab kiểm thư viện requests: khi kết nối lỗi, thông báo ConnectionError chứa nguyên URL kèm api_key. Mã gọi API phải che khóa trước khi ghi lỗi.
Đọc tham số truy vấn, khu vực và phân trang trong docs của Scrapingdog API structured results
Phần này trình bày hàm gọi API và hàm tính credit.
Hàm gọi
def fetch(query, key, page=0, country="vn", language="vi", **extra):
    p = {"api_key": key, "query": query, "page": str(page),
         "country": country, "language": language, **extra}
    r = requests.get(BASE, params=p, timeout=30)
    try:
        body = r.json()
    except ValueError:
        body = {"raw": r.text[:200]}
    return r.status_code, body, credits(p)
Hàm trả về mã trạng thái, thân phản hồi và credit ước tính. Nếu thân không phải JSON, hàm giữ 200 ký tự đầu để chẩn đoán thay vì ném lỗi.
Hàm tính credit theo tài liệu
def credits(p):
    c = 10 if p.get("advance_search") == "true" or p.get("mob_search") == "true" else 5
    if p.get("deep_scrape") == "true" and p.get("advance_search") != "true":
        c += 5
    return c
Hàm dịch đúng các câu trong tài liệu sang mã. Có một ca tài liệu không nói rõ: bật cùng lúc mob_search và deep_scrape. Hàm cho ra 15, nhưng đây là suy luận, chưa kiểm với tài khoản thật.
Ghi request mà không ghi khóa
Máy chủ mô phỏng ghi mọi tham số nhận được vào req.log, thay giá trị api_key bằng ba dấu sao. Cuối lab, kiểm tệp log không chứa khóa thử. Pipeline thật nên làm tương tự ở phía mình: ghi tham số truy vấn để đối soát, che khóa.
Truy vấn và từ khóa có dấu
requests tự mã hóa tham số khi dựng URL, nên từ khóa tiếng Việt có dấu được gửi đúng. Nếu tự ghép URL bằng chuỗi, phải tự mã hóa, nếu không ký tự có dấu và dấu cách sẽ làm truy vấn sai.
Một hàm, một trách nhiệm
Hàm fetch chỉ gọi API và trả dữ liệu thô. Hàm map_rows chỉ ánh xạ. Hàm credits chỉ tính chi phí. Tách ba việc giúp kiểm từng phần riêng, và khi nhà cung cấp đổi cấu trúc thì chỉ sửa hàm ánh xạ.
Timeout
Lab đặt timeout 30 giây. Tìm kiếm qua API mất vài giây vì nhà cung cấp phải gửi request tới Google rồi phân tích. Timeout quá ngắn làm request bị hủy trong khi nhà cung cấp vẫn có thể đã tính credit. Lab chưa kiểm chuyện này với tài khoản thật.
Gom tham số vào cấu hình
Đặt country, language, page tối đa và các cờ tính năng vào một tệp cấu hình, không rải trong mã. Khi cần đổi vùng tìm kiếm hay tắt advance_search để tiết kiệm, chỉ sửa một chỗ. Tệp cấu hình cũng là nơi ghi ngày đọc tài liệu và công thức credit đang dùng.
Bảng endpoint, tham số và credit
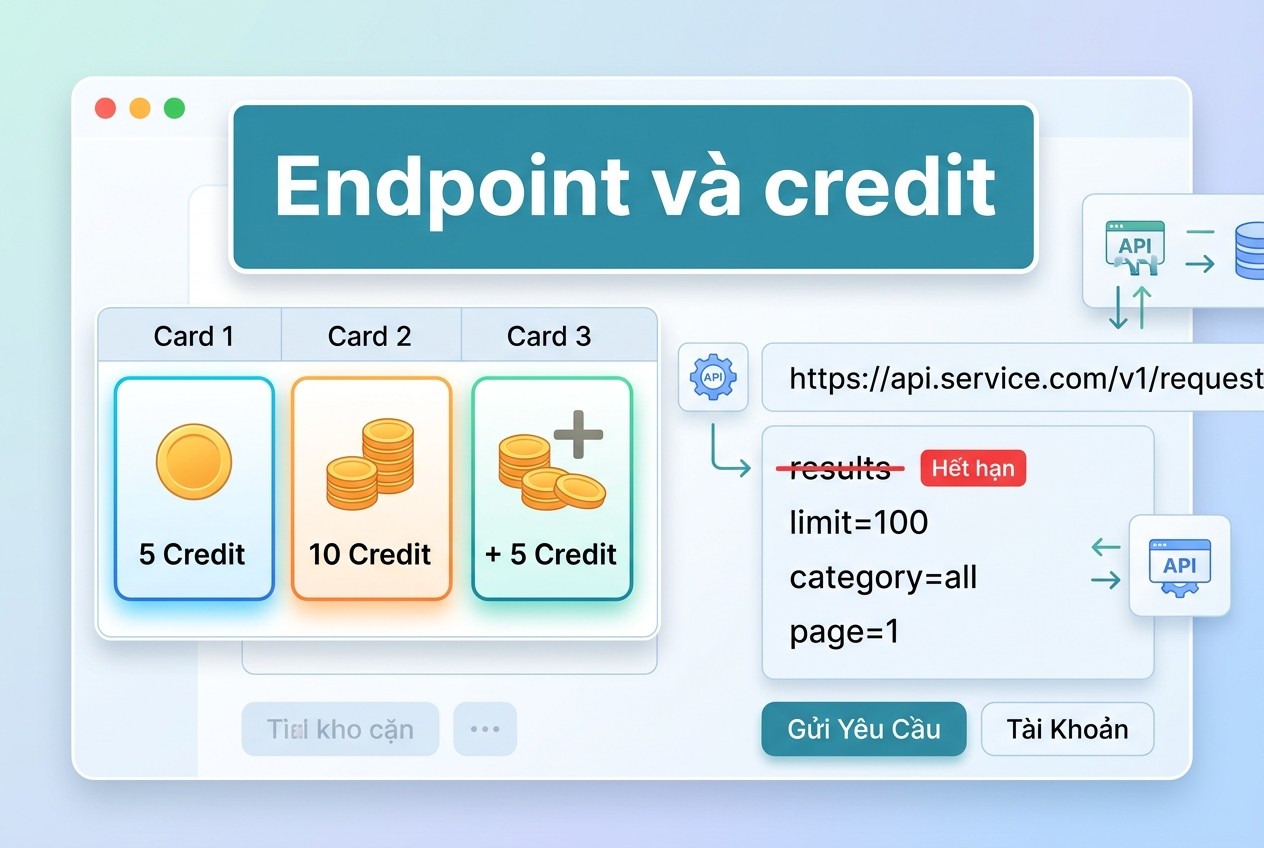
Endpoint và credit
Mục |
Giá trị theo tài liệu |
Ghi chú lab |
|---|---|---|
Endpoint |
GET https://api.scrapingdog.com/google |
401 với khóa giả |
Bắt buộc |
api_key, query |
thiếu khóa cũng 401 |
Phân trang |
page từ 0 |
mỗi trang tính credit riêng |
results |
lỗi thời, tối đa 10 mỗi trang |
không còn tác dụng |
Tìm thường |
5 credit |
chưa đối chiếu tài khoản |
advance_search hoặc mob_search |
10 credit |
chưa đối chiếu tài khoản |
deep_scrape |
cộng 5 credit, chỉ khi advance_search tắt |
chưa đối chiếu tài khoản |
Map organic results cùng trường tùy chọn sang schema nội bộ với Scrapingdog API structured results
Phần này ánh xạ dữ liệu và thử các ca thiếu trường.
Schema nội bộ
Bảng nội bộ có các cột query, page, rank, title, url, source, snippet, displayed_link. query và page lấy từ request, các cột còn lại lấy từ từng phần tử organic_results. url là bắt buộc, các cột khác có thể rỗng.
Hàm ánh xạ
Ánh xạ sang schema
def map_rows(query, page, body):
    rows, issues = [], []
    if "organic_results" not in body:
        issues.append("thieu khoa organic_results"); return rows, issues
    if not body["organic_results"]:
        issues.append("organic_results rong")
    for o in body["organic_results"]:
        if not o.get("link"):
            issues.append(f"rank {o.get('rank')} khong co link"); continue
        rows.append({"query": query, "page": page, "rank": o.get("rank"),
                     "title": o.get("title"), "url": o["link"],
                     "source": o.get("source"), "snippet": o.get("snippet"),
                     "displayed_link": o.get("displayed_link")})
    return rows, issues
Hàm trả về cả dòng dữ liệu lẫn danh sách vấn đề. Không có ngoại lệ nào bị nuốt im lặng: mọi chỗ thiếu đều được ghi lại.
Phản hồi mẫu đã che
Máy chủ mô phỏng trả ba phần tử. Phần tử 1 đủ trường. Phần tử 2 thiếu displayed_link và snippet. Phần tử 3 thiếu link. Kết quả ánh xạ có 2 dòng, kèm vấn đề rank 3 không có link.
{"search_information": {"total_results": 3690000, "query_displayed": "proxy"},
 "organic_results": [
  {"title": "Proxy là gì", "link": "https://vi.wikipedia.org/wiki/Proxy", "source": "Wikipedia", "snippet": "Máy chủ proxy là...", "rank": 1},
  {"title": "Proxy - MDN", "link": "https://developer.mozilla.org/...", "source": "MDN", "rank": 2},
  {"title": "Không có link", "displayed_link": "example.vn", "rank": 3}]}
Dùng get thay vì truy cập trực tiếp
Truy cập o["snippet"] khi trường không có sẽ ném KeyError và dừng cả lô. Dùng o.get trả None, dòng vẫn được ghi với snippet rỗng. Chỉ link là trường bắt buộc, nên chỉ link bị kiểm gắt.
Rank lấy từ API, không tự đếm
Hàm lấy rank từ trường rank của API, không tự đánh số theo thứ tự trong danh sách. Nếu API bỏ một phần tử vì lý do nào đó, tự đếm sẽ làm lệch thứ hạng của mọi phần tử sau. Khi rank bị thiếu, nên ghi rỗng thay vì đoán.
Title và source dùng để làm gì
title giúp người đọc báo cáo nhận ra trang mà không cần mở link. source cho tên nguồn ngắn gọn như Wikipedia hay MDN, tiện để gom thứ hạng theo đối thủ. Cả hai đều có thể thiếu, nên báo cáo không được dựa vào chúng để nối dữ liệu. Nối bằng url đã chuẩn hóa.
Rank qua nhiều trang
Lab chưa kiểm rank ở trang thứ hai bắt đầu từ 11 hay từ 1. Đây là điều cần kiểm ngay với tài khoản thật trước khi tính thứ hạng. Nếu rank bắt đầu lại từ 1 mỗi trang, thứ hạng tổng phải tính bằng page nhân 10 cộng rank.
Chuẩn hóa URL trước khi so thứ hạng
Cùng một trang có thể xuất hiện với URL khác nhau giữa các lần: có hay không có dấu gạch chéo cuối, có tham số theo dõi. Khi so thứ hạng theo thời gian, nên chuẩn hóa URL trước: bỏ phần fragment, bỏ tham số utm, thống nhất dấu gạch chéo. Lab giữ nguyên link từ API, phần chuẩn hóa để ở bước sau.
Khối khác ngoài organic_results
Phản hồi có thể chứa nhiều khối khác như kết quả thể thao, mua sắm, địa điểm. Bài chỉ ánh xạ organic_results. Các khối khác nên được lưu nguyên dạng JSON vào một cột riêng, để sau này cần thì đọc lại mà không phải gọi lại API.
Lưu phản hồi gốc
Ngoài bảng đã ánh xạ, nên lưu phản hồi gốc kèm thời điểm và tham số request, đã che khóa. Khi ánh xạ có lỗi hoặc nhà cung cấp đổi tên trường, phản hồi gốc cho phép ánh xạ lại mà không tốn thêm credit.
Kiểm response lỗi và credit usage mà không suy từ HTTP200 với Scrapingdog API structured results
Phần này chạy các ca lỗi và lập sổ credit.
Các ca đã chạy
Ca |
HTTP |
Dòng |
Credit ước tính |
Vấn đề |
|---|---|---|---|---|
Tìm thường |
200 |
2 |
5 |
rank 3 không có link |
advance_search |
200 |
2 |
10 |
rank 3 không có link |
deep_scrape |
200 |
2 |
10 |
rank 3 không có link |
mob_search và deep_scrape |
200 |
2 |
15 |
suy luận, tài liệu không nói |
200 nhưng rỗng |
200 |
0 |
5 |
organic_results rỗng |
200 thiếu organic_results |
200 |
0 |
5 |
thiếu khóa organic_results |
Sai khóa |
401 |
0 |
0 |
Unauthorized |
Tổng credit ước tính của bảy ca là 50.
200 không có nghĩa là có dữ liệu
200 nhưng rỗng
Hai ca trả 200 nhưng không có dòng nào: một ca organic_results rỗng, một ca thiếu hẳn khóa này. Nếu pipeline chỉ kiểm mã trạng thái, cả hai sẽ được ghi là thành công. Bảng thứ hạng sẽ hiện từ khóa đó như thể không có kết quả nào trên Google, trong khi có thể là lỗi phía nhà cung cấp.
Lab mô phỏng hai ca này. Lab chưa biết API thật có bao giờ trả như vậy không. Nhưng mã ánh xạ nên xử lý chúng, vì chi phí xử lý thấp và hậu quả bỏ qua thì lớn.
Thứ tự kiểm một phản hồi
Kiểm mã HTTP trước. Nếu 200, kiểm thân có phải JSON không. Nếu là JSON, kiểm có khóa organic_results không. Nếu có, kiểm danh sách rỗng không. Nếu không rỗng, kiểm từng phần tử có link không. Mỗi bước thất bại ghi một loại vấn đề riêng, để thống kê sau này biết lỗi hay xảy ra ở bước nào.
Phân biệt rỗng thật với lỗi
Truy vấn rất hiếm có thể thật sự không có kết quả. search_information có total_results. Nếu total_results lớn hơn 0 mà organic_results rỗng, gần như chắc là lỗi. Nếu total_results bằng 0, có thể là rỗng thật. Ghi cả hai con số vào sổ để phân biệt khi đối soát.
Credit cho request lỗi
Tài liệu ghi chi phí cho request thành công. Lab coi request 401 là 0 credit. Với request trả 200 nhưng rỗng, tài liệu không nói có tính credit không. Lab tính 5 credit để ước tính an toàn. Cách duy nhất để biết chắc là so số dư credit trước và sau một loạt request có kiểm soát.
Ước tính ngân sách trước khi chạy
Với 300 từ khóa, mỗi từ khóa 3 trang, tìm thường: 300 nhân 3 nhân 5 bằng 4.500 credit mỗi lần chạy. Bật advance_search thì gấp đôi. Chạy hằng tuần trong một tháng là bốn lần con số đó. Tính trước giúp chọn gói phù hợp và quyết định có cần advance_search cho mọi từ khóa hay chỉ cho từ khóa quan trọng.
Sổ credit
Lab ghi mỗi request thành một dòng trong ledger.json: tên ca, mã HTTP, số dòng, credit ước tính, danh sách vấn đề. Cuối mỗi đợt chạy, cộng credit ước tính và so với số dư trong bảng điều khiển. Chênh lệch lớn là dấu hiệu công thức sai hoặc có request bị tính mà không ghi.
Khóa không nằm trong log
Cuối lab, kiểm req.log không chứa khóa thử. Nhưng phép thử riêng với requests cho thấy thông báo lỗi kết nối chứa nguyên URL kèm khóa. Nếu mã ghi str của ngoại lệ vào log, khóa sẽ lộ. Cách sửa là bắt ngoại lệ, che giá trị api_key bằng biểu thức chính quy, rồi mới ghi.
Lỗi 429 và giới hạn tốc độ
Tài liệu trang Google Search không nêu giới hạn số request đồng thời. Nhiều nhà cung cấp trả 429 khi gọi quá nhanh. Lab không kiểm được. Pipeline nên bắt đầu với số luồng thấp, tăng dần, và coi 429 là tín hiệu giảm tốc chứ không phải lỗi để thử lại ngay.
Thử lại có tốn credit
Request lỗi tạm thời như timeout hay 5xx thường được thử lại. Nếu nhà cung cấp đã xử lý xong và tính credit trước khi kết nối bị cắt, thử lại sẽ tính thêm. Lab không kiểm được. Nên giới hạn số lần thử lại và ghi mỗi lần thử vào sổ credit riêng.
Đầu ra nghiệm thu: bảng endpoint gói trường output và một response mẫu được ẩn bí mật khi lab của Scrapingdog API structured results
Phần cuối gom kết quả thành bộ bàn giao.
Bộ bàn giao
Bộ bàn giao gồm bảng endpoint, tham số và credit ở trên, phản hồi mẫu đã che, tệp lab.py với máy chủ mô phỏng, hàm gọi, hàm tính credit và hàm ánh xạ, tệp ledger.json và req.log. Người nhận chạy lại lab.py, phải thấy bảy ca với đúng số dòng và vấn đề như bảng.
Tiêu chí đạt
Mỗi phần tử organic_results có link được ánh xạ thành một dòng. Phần tử thiếu link được ghi vào vấn đề, không bị bỏ im lặng. Phản hồi 200 rỗng hoặc thiếu khóa được đánh dấu. Credit ước tính có công thức dẫn từ tài liệu. Khóa không xuất hiện trong log.
Đối soát theo tuần
Mỗi tuần, cộng credit ước tính trong sổ và so với mức tiêu thụ trên bảng điều khiển. Đồng thời đếm số request có vấn đề theo từng loại. Tỷ lệ 200 rỗng tăng đột ngột là dấu hiệu nhà cung cấp đang gặp sự cố hoặc đổi cấu trúc. Phát hiện sớm giúp không tốn credit cho dữ liệu hỏng.
Việc cần làm khi có tài khoản thật
Gọi một truy vấn, so cấu trúc với phản hồi mẫu. Gọi page 1 để xem rank bắt đầu từ đâu. So số dư credit trước và sau mười request thường và mười request advance_search. Thử bật cùng mob_search và deep_scrape để xem credit thật. Ghi kết quả vào bảng.
Khi nào cần proxy với Scrapingdog API structured results
Scrapingdog tự lo phần gửi request tới Google, nên người dùng API không cần proxy cho từng truy vấn. Proxy chỉ liên quan khi mạng công ty bắt mọi kết nối ra ngoài đi qua proxy, khi đó requests đọc biến môi trường proxy như mọi ứng dụng khác. Nhớ rằng khóa API nằm trên URL, nên proxy công ty có thể ghi lại nó nếu nó chặn TLS để soi.
Ngoài tìm kiếm qua API, nhóm thường còn tự tải trang của chính các kết quả để phân tích nội dung. Với website được phép thu thập, có lúc cần IP tại Việt Nam để thấy đúng trang hiển thị cho người dùng trong nước. Khi đó anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Proxy không thay credit của API và không làm kết quả tìm kiếm đúng hơn. Vai trò hợp lệ của proxy được giải thích ở bài Web Scraping proxy là gì.
Cấu hình proxy cho phần tự tải
Phần tự tải trang dùng proxy riêng, không dùng chung biến môi trường với lời gọi API nếu không cần. Gọi API qua proxy không mang lại gì, chỉ thêm một chỗ có thể ghi lại khóa. Cách viết chuỗi proxy cho thư viện HTTP được giải thích trong bài định dạng proxy.
Lưu trữ kết quả bao lâu
Kết quả tìm kiếm có giá trị theo thời gian: so thứ hạng tuần này với tuần trước. Nên giữ bảng đã ánh xạ lâu dài, còn phản hồi gốc có thể giữ ngắn hơn. Kiểm điều khoản của nhà cung cấp về việc lưu trữ dữ liệu trước khi đặt thời hạn.
Những gì lab chưa thử
Lab chưa gọi API với khóa thật, chưa thấy phản hồi thật cho truy vấn tiếng Việt, chưa biết rank trang thứ hai, chưa đối chiếu credit với bảng điều khiển. Lab chưa thử tham số html trả HTML gốc, chưa thử các khối đặc biệt ngoài organic_results. Mọi kết luận về cấu trúc dựa trên mẫu trong tài liệu ngày 03/11/2026.
Checklist Scrapingdog API structured results
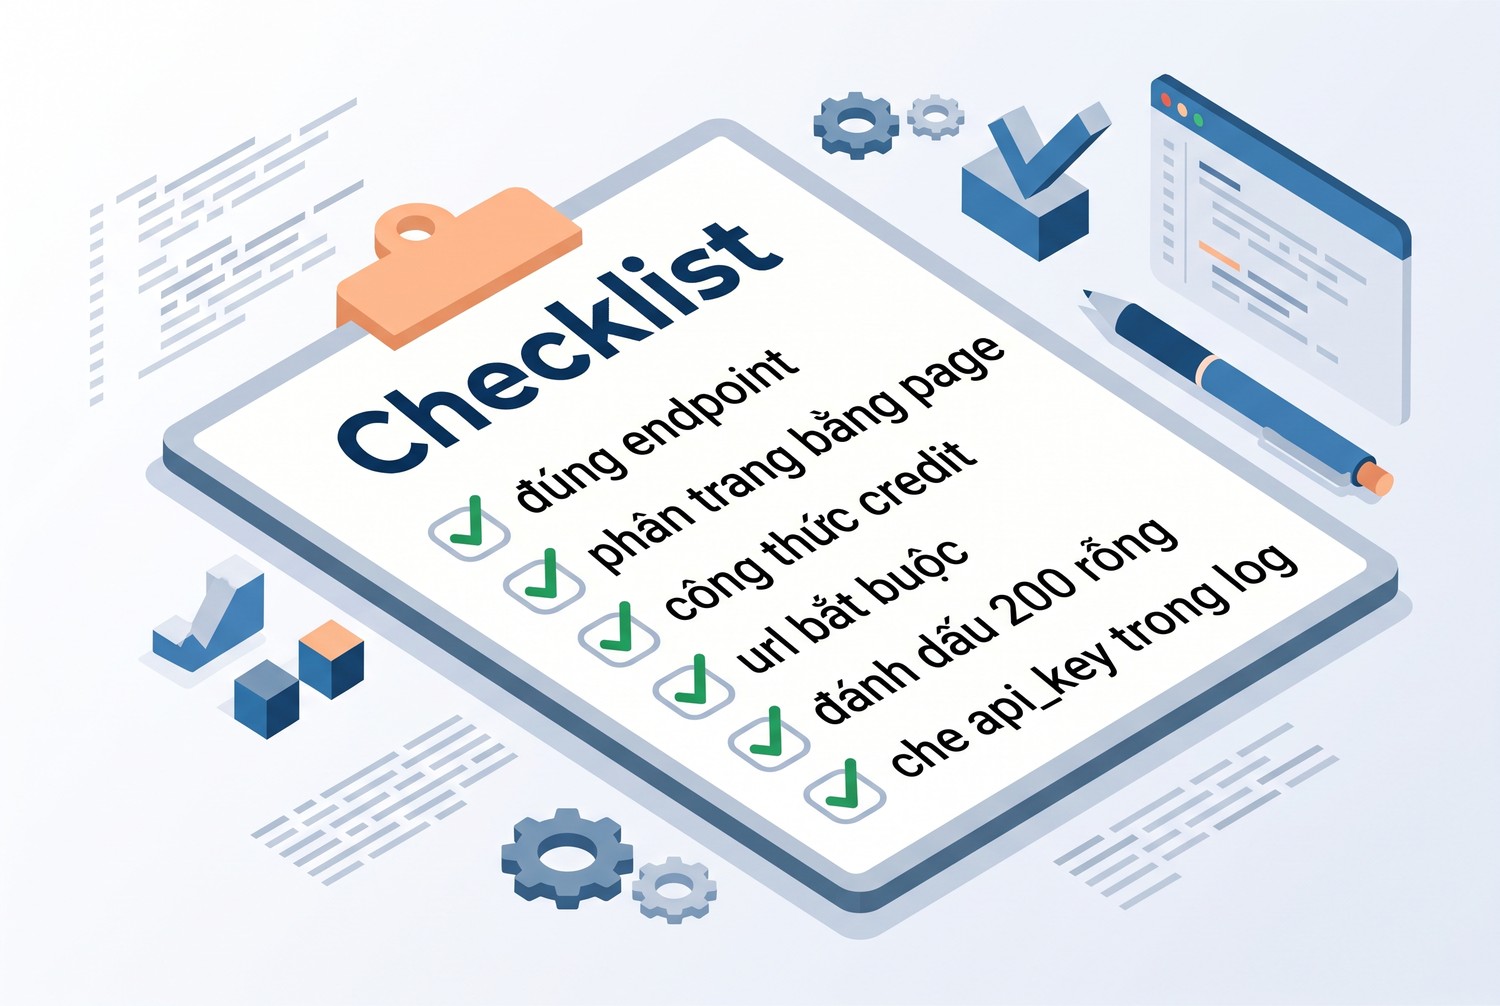
Checklist
- Endpoint Google Search, không chép tham số từ API khác.
- Không dùng results, phân trang bằng page từ 0.
- Ghi công thức credit theo tài liệu, đối chiếu với tài khoản.
- url là trường bắt buộc, các trường khác dùng get.
- Lấy rank từ API, kiểm rank ở trang thứ hai.
- Đánh dấu 200 rỗng và 200 thiếu organic_results.
- Lưu phản hồi gốc đã che khóa.
- Che api_key trong mọi log và thông báo lỗi.
Câu hỏi thường gặp về Scrapingdog API structured results
Mỗi request Google Search tốn bao nhiêu credit?
Theo tài liệu, 5 credit cho tìm thường, 10 credit khi bật advance_search hoặc mob_search, cộng 5 khi bật deep_scrape.
Có lấy được 100 kết quả một lần không?
Không. Tài liệu ghi results đã lỗi thời, mỗi trang tối đa 10 kết quả, phải phân trang bằng page.
Khóa sai thì API trả gì?
Lab nhận HTTP 401 với thông điệp Unauthorized request kèm success bằng false.
Phản hồi 200 có luôn chứa kết quả không?
Không nên giả định vậy. Mã ánh xạ của lab đánh dấu riêng ca organic_results rỗng và ca thiếu khóa này.
Trường nào có thể thiếu?
Trong phản hồi mẫu, displayed_link và snippet có thể thiếu. Lab coi chỉ link là bắt buộc.
Dùng API có cần proxy không?
Không cho truy vấn tìm kiếm. Chỉ cần khi mạng công ty bắt buộc, hoặc cho phần tự tải trang kết quả.
Scrapingdog API structured results và những điều cần nhớ
Scrapingdog API structured results giúp bỏ qua bước phân tích HTML trang kết quả, nhưng không bỏ được việc kiểm dữ liệu. Tài liệu cho biết endpoint, công thức credit và việc results đã lỗi thời. Lab cho thấy khóa sai trả 401, phần tử thiếu link cần được ghi lại, phản hồi 200 rỗng phải được đánh dấu, và thông báo lỗi của requests làm lộ khóa trên URL. Cần IP tĩnh cho phần tự tải trang kết quả bên cạnh Scrapingdog API structured results, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


