
ScrapingBot raw HTML response: body text, status và parser
ScrapingBot raw HTML response là phản hồi của endpoint raw-html: thân phản hồi là nguyên trang HTML dạng chuỗi, không phải một đối tượng JSON có các trường như statusCode hay captchaFound. Nhiều hướng dẫn cũ cấu hình bước gọi API ở n8n theo kiểu JSON, và quy trình gãy ngay ở bước đọc phản hồi. ProxyVN đọc hướng dẫn chính thức của ScrapingBot ngày 03/11/2026 và gọi endpoint thật với thông tin đăng nhập giả để xem lỗi thật. Sau đó lab mô phỏng bước HTTP Request và bước trích HTML bằng Python trên một máy chủ giả lập. Lab không chạy n8n, và bài ghi rõ điều đó ở từng chỗ.
ScrapingBot raw HTML response: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và giới hạn.
Bài toán
Một người làm marketing dựng quy trình n8n lấy giá sản phẩm từ vài trang thương mại điện tử qua ScrapingBot. Bước gọi API trả về, nhưng bước sau không đọc được gì, hoặc đọc được nhưng toàn giá trị rỗng. Nguyên nhân thường nằm ở chỗ cấu hình định dạng phản hồi và chỗ đọc sai trường.
Đầu ra nghiệm thu
Đầu ra gồm một phản hồi raw-html mẫu, bảng ánh xạ body và status từ bước HTTP Request sang bước trích dữ liệu, và một ca parser nhận sai kiểu JSON cùng kết quả sau khi sửa. Mỗi ca phải có kết quả chạy, dù là chạy trên mô phỏng.
Không phải bài cấu hình proxy cho n8n
n8n có thể chạy sau proxy công ty, và việc đó có hướng dẫn riêng. Bài không bàn chuyện đó. Trọng tâm là hình dạng phản hồi của một endpoint cụ thể và cách đọc nó cho đúng.
Không mặc định có job bất đồng bộ
ScrapingBot có một số API dùng cơ chế xếp hàng rồi hỏi kết quả, như API mạng xã hội. Endpoint raw-html thì trả HTML ngay trong phản hồi. Bài không giả định raw-html có job bất đồng bộ, vì hướng dẫn chính thức không nói vậy.
Giới hạn của lab
Lab không có tài khoản ScrapingBot. Gọi endpoint thật với tên và khóa giả nhận HTTP 401 cùng thân JSON. Lab không chạy n8n, vì chạy phần mềm Node tải về bị chặn trong môi trường lab. Hành vi của nút HTTP Request được mô phỏng bằng Python theo mô tả trong hướng dẫn, nên chỉ chứng minh logic ánh xạ, không chứng minh giao diện n8n.
Vì sao lỗi này phổ biến
Hầu hết API hiện nay trả JSON, nên người dùng công cụ tự động hóa quen đặt Response Format là JSON cho mọi nút gọi API. raw-html là ngoại lệ: nó trả đúng thứ người dùng muốn, nguyên trang HTML, nhưng ở dạng mà thói quen không lường trước. Trong khi đó, các API có cấu trúc của cùng nhà cung cấp lại trả JSON, nên tài liệu cũ dễ trộn lẫn hai kiểu.
Ai nên đọc
Người dùng n8n hoặc công cụ tự động hóa tương tự gọi ScrapingBot raw-html. Người viết mã gọi API này bằng Python hay JavaScript và đang xử lý phản hồi như JSON. Người cần chẩn đoán vì sao quy trình chạy xanh mà dữ liệu trích ra rỗng.
Phân biệt raw-html body dạng text với JSON envelope khi gọi ScrapingBot từ n8n với ScrapingBot raw HTML response
Phần này tóm tắt những gì hướng dẫn chính thức nói.
Endpoint và xác thực
Theo bài ScrapingBot n8n HTTP Request guide, endpoint là https://api.scraping-bot.io/scrape/raw-html, gọi bằng POST. Xác thực bằng HTTP Basic Auth: tên người dùng là username ScrapingBot, mật khẩu là khóa API. Thân request là JSON có url và tùy chọn options.
Raw HTML là văn bản
Hướng dẫn ghi rõ: endpoint raw-html trả trang đã render dưới dạng chuỗi HTML thuần, không trả đối tượng JSON với statusCode, captchaFound hay host. Những trường đó thuộc về các API có cấu trúc như Retail, Real Estate, Booking. Hướng dẫn cũng thừa nhận phiên bản trước của chính bài viết đã sai ở điểm này.
Cấu hình nút HTTP Request
Hướng dẫn đề nghị đặt Response Format là Text và bật Include Response Headers and Status. Khi đó đầu ra của nút có dạng statusCode, headers và body, với HTML nằm trong body. Kiểm lỗi bằng mã trạng thái thật và độ dài body, không bằng một cờ JSON không tồn tại.
Bộ trích HTML của n8n
Sau nút HTTP Request, hướng dẫn dùng nút HTML với thao tác trích nội dung và trỏ nguồn vào thuộc tính body. Người dùng khai báo từng trường đầu ra bằng bộ chọn CSS và kiểu giá trị là văn bản hay thuộc tính. Lab thay nút này bằng lxml với XPath tương đương. Logic giống nhau: một chuỗi HTML vào, một đối tượng có tên trường ra.
Mức credit theo tùy chọn
Hướng dẫn liệt kê: không tùy chọn 1 credit, useChrome 10 credit, premiumProxy 10 credit, cả hai 20 credit, proxyCountry đi cùng premiumProxy 25 credit. Lab không kiểm được con số này vì không có tài khoản.
Các tùy chọn khác
Hướng dẫn còn nhắc tới waitForNetworkRequests để chờ các request mạng của trang xong rồi mới lấy HTML, phù hợp với trang tải dữ liệu bằng JavaScript sau khi hiển thị. Lab không mô phỏng tùy chọn này. Với trang phức tạp, useChrome có thể chưa đủ nếu nội dung chỉ xuất hiện sau một request phụ.
Lỗi thì trả gì
Hướng dẫn liệt kê các lỗi hay gặp: 401 khi sai thông tin đăng nhập, 429 khi gọi quá nhanh, HTML rỗng hoặc thiếu khi trang cần JavaScript mà không bật useChrome. Hướng dẫn không nói rõ thân phản hồi lỗi có dạng gì. Lab trả lời phần này bằng một lần gọi thật.
Thiết lập HTTP Request node với auth của ScrapingBot trong ScrapingBot raw HTML response
Phần này ghi lại lần gọi endpoint thật và cách lưu thông tin đăng nhập.
Gọi thật với thông tin giả
Lab gửi POST tới endpoint raw-html với Basic Auth tên fakeuser, khóa fakekey123, thân JSON chứa url https://example.com. Phản hồi là HTTP 401, Content-Type application/json, thân là error với code 401 và message Unauthorized. Gọi không có Basic Auth cũng nhận 401 cùng thân đó.
Thành công là HTML, lỗi là JSON
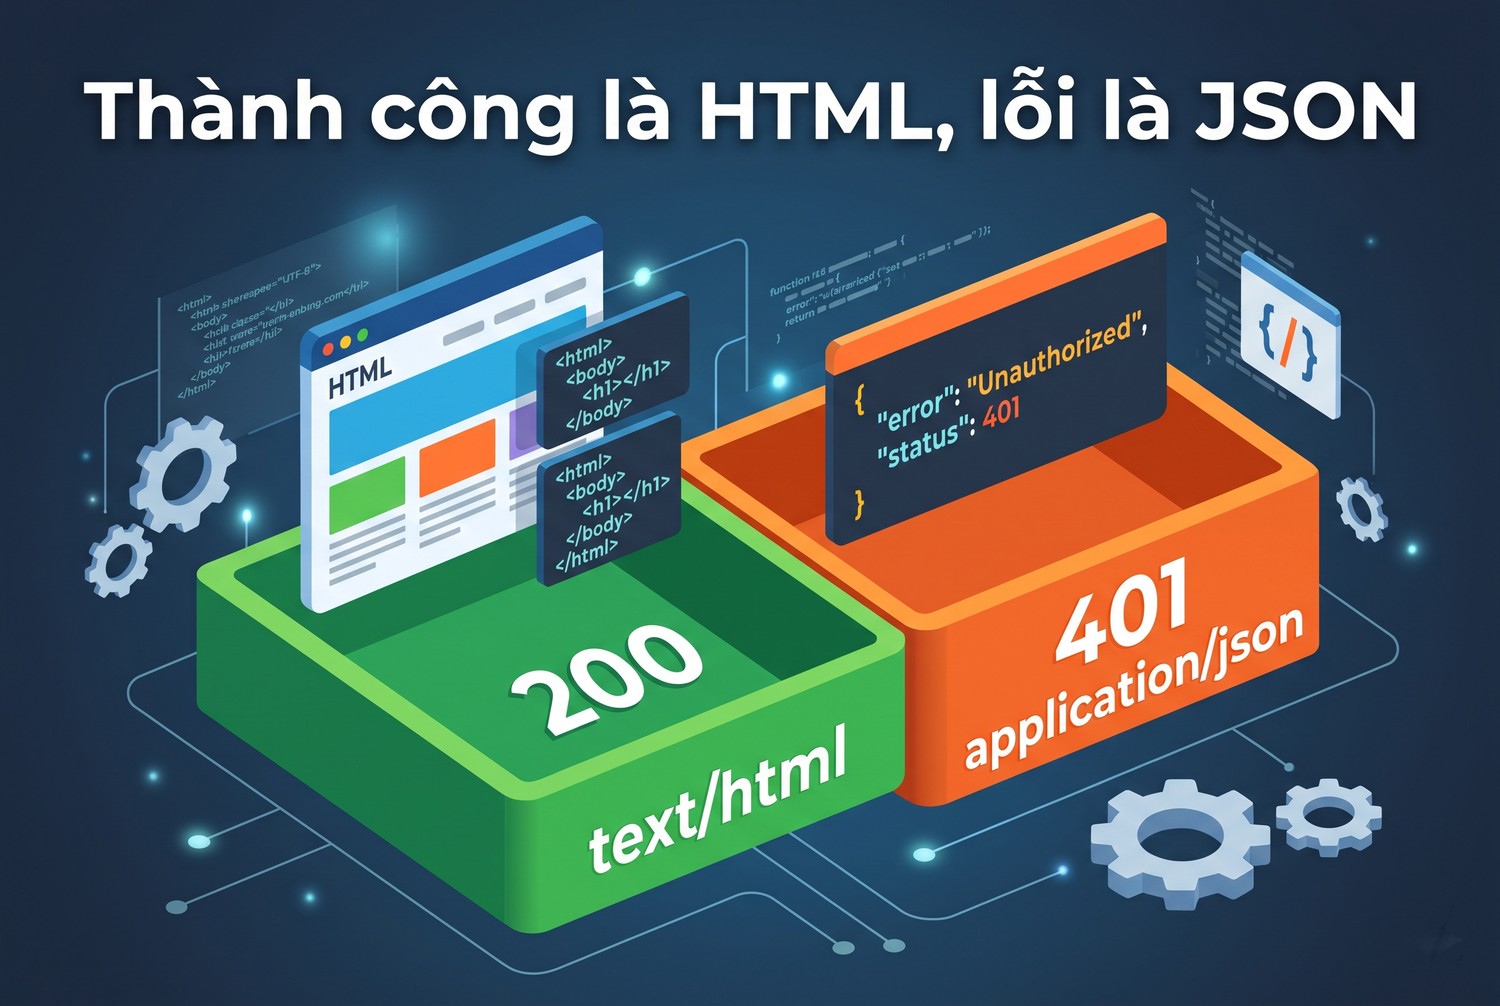
Thành công là HTML, lỗi là JSON
Phát hiện quan trọng nhất của lần gọi thật: khi lỗi, endpoint trả JSON. Khi thành công, theo hướng dẫn, endpoint trả HTML. Cùng một endpoint, hai kiểu nội dung. Mã đọc phản hồi phải xem Content-Type hoặc mã trạng thái trước khi quyết định đọc thân thế nào.
Lưu khóa trong credential
Hướng dẫn đề nghị tạo credential Basic Auth riêng trong n8n thay vì dán khóa vào từng nút. Lý do: khóa không xuất hiện trong tệp quy trình khi xuất ra để chia sẻ. Lab không kiểm được điều này vì không chạy n8n, nhưng đây là thực hành tốt cho mọi công cụ tự động hóa.
Thông tin đăng nhập giả vẫn tạo request thật
Lần gọi với thông tin giả là một request thật tới máy chủ ScrapingBot. Nó không tốn credit của ai vì không có tài khoản nào khớp. Lab chỉ gọi hai lần, đủ để biết hình dạng lỗi. Không nên dùng cách này để dò quy tắc của dịch vụ với số lượng lớn.
Khóa không nằm trên URL
Khác với các API truyền khóa qua tham số URL, ScrapingBot dùng header Authorization. Khóa không xuất hiện trong log truy cập ghi URL. Nhưng header Authorization dạng Basic chỉ là mã hóa base64, không phải mã hóa bảo mật. Ai đọc được header thì đọc được khóa.
Đọc lỗi theo Content-Type
Một cách xử lý gọn: nếu Content-Type bắt đầu bằng application/json, đọc thân như JSON và lấy error message; nếu là text/html, coi là trang. Cách này không phụ thuộc vào danh sách mã trạng thái, nên vẫn đúng khi nhà cung cấp thêm mã lỗi mới. Lab ghi Content-Type ở mọi ca để xác nhận quy tắc này đúng với phản hồi thật và giả lập.
Máy chủ giả lập
Lab dựng máy chủ ở cổng 9441 nhận POST tại đường dẫn raw-html. Máy chủ kiểm Basic Auth, trả 401 dạng JSON giống hệt lần gọi thật nếu sai. Đúng thông tin thì trả HTML với Content-Type text/html. Một số URL đặc biệt tạo ra các ca lỗi: body rỗng, trang cần JavaScript, 429.
Hàm mô phỏng nút HTTP Request
def node(url, fmt="text", full=True, options=None):
    r = requests.post(EP, json={"url": url, **({"options": options} if options else {})},
                      auth=(USER, KEY), timeout=30)
    if fmt == "json":
        try: data = r.json()
        except ValueError as e: return {"error": f"parse JSON loi: {e}"}
    else:
        data = r.text
    if full:
        return {"statusCode": r.status_code,
                "headers": {"content-type": r.headers.get("Content-Type")},
                "body": data}
    return {"data": data}
fmt tương ứng Response Format, full tương ứng Include Response Headers and Status. Đây là mô phỏng theo mô tả, không phải mã của n8n.
Chọn response dạng text và giữ status/header trong ScrapingBot raw HTML response
Phần này chạy ba cấu hình khác nhau của bước gọi.
Cấu hình đúng
Text kèm headers và status. Đầu ra có statusCode 200, content-type text/html, body là chuỗi HTML bắt đầu bằng thẻ html. Bước trích nhận body và lấy đủ ba trường: tên sản phẩm, giá 150.000đ, đường dẫn /p/1.
Vì sao mô phỏng vẫn có giá trị
Mô phỏng không chứng minh n8n hoạt động thế nào. Nó chứng minh logic dữ liệu: chuỗi HTML không đọc được bằng bộ đọc JSON, trường không tồn tại trả về rỗng, điều kiện kiểm sai thì ra kết quả sai. Những điều này đúng với mọi công cụ, kể cả n8n. Phần riêng của n8n như tên trường đầu ra được ghi theo hướng dẫn chính thức.
Response Format JSON
Cùng request, nhưng đọc thân như JSON. Python báo JSONDecodeError: Expecting value ở dòng 1 cột 1. Ký tự đầu tiên của thân là dấu nhỏ hơn của thẻ html, không phải dấu ngoặc nhọn. Không có dữ liệu nào đi tiếp.
Trong n8n thật, cấu hình này có thể báo lỗi hoặc xử lý khác, lab không kiểm được. Điều chắc là thân HTML không phải JSON hợp lệ, nên mọi bộ đọc JSON đều không đọc được nó.
Text nhưng không lấy headers và status
Đầu ra chỉ còn một trường data chứa HTML. Không có statusCode. Bước kiểm lỗi phía sau không có gì để kiểm: một phản hồi 401 dạng JSON và một trang HTML hợp lệ đều chỉ là chuỗi trong data. Đây là lý do hướng dẫn nhấn mạnh phải bật Include Response Headers and Status.
Bảng ánh xạ
Đầu ra bước gọi |
Dùng ở bước sau |
Ghi chú |
|---|---|---|
statusCode |
điều kiện IF |
200 mới đi tiếp |
headers content-type |
điều kiện IF phụ |
text/html là trang, application/json là lỗi |
body |
nguồn của bước trích HTML |
chuỗi, không phải đối tượng |
body length |
điều kiện IF |
0 là trang rỗng |
Đầu ra một nút, nhiều cách đọc
Cùng một đầu ra statusCode, headers, body có thể được đọc bởi nhiều nút sau: nút IF kiểm lỗi, nút HTML trích dữ liệu, nút ghi log. Mỗi nút đọc đúng phần của nó. Giữ cấu trúc đầu ra ổn định giúp thêm nút mới mà không phải sửa nút cũ.
Giữ header content-type
Ngoài mã trạng thái, Content-Type là dấu hiệu nhanh nhất để biết phản hồi là trang hay lỗi. Lab ghi lại header này ở mọi ca. Ca thành công luôn là text/html, ca lỗi luôn là application/json.
Kích thước body
Trang HTML thật có thể vài trăm kilobyte. Đầu ra mỗi nút n8n được giữ trong bộ nhớ và trong lịch sử thực thi. Với lô hàng trăm URL, lưu nguyên HTML trong lịch sử làm cơ sở dữ liệu của n8n phình nhanh. Nên trích ngay sau bước gọi và chỉ giữ các trường cần, không chuyển nguyên body qua nhiều nút.
Không parse HTML bằng biểu thức chính quy
Body là HTML đầy đủ. Bước trích nên dùng bộ phân tích HTML với bộ chọn CSS hoặc XPath, như nút HTML của n8n theo hướng dẫn. Lab dùng lxml với XPath. Biểu thức chính quy dễ gãy khi thứ tự thuộc tính hay khoảng trắng thay đổi.
Map raw-html body tới bước parser riêng với ScrapingBot raw HTML response
Phần này trình bày bước trích và bước kiểm.
Bước trích
def extract(item):
    doc = lxml.html.fromstring(item["body"])
    g = lambda xp: (doc.xpath(xp) or [None])[0]
    return {"productTitle": g("//h2[@class='product-title']/text()"),
            "productPrice": g("//span[@class='price']/text()"),
            "productUrl":   g("//a[@class='product-link']/@href")}
Ba bộ chọn khớp với ví dụ trong hướng dẫn: tiêu đề trong h2 class product-title, giá trong span class price, đường dẫn từ thuộc tính href của thẻ a class product-link. Trường không tìm thấy trả None.
Bước kiểm trước khi trích
def gate(item):
    return (item.get("statusCode") == 200 and isinstance(item.get("body"), str)
            and len(item["body"]) > 0)
Điều kiện giống biểu thức trong hướng dẫn: mã 200 và body không rỗng. Lab thêm kiểm body là chuỗi để chặn ca body bị đọc thành đối tượng.
Ca đọc nhầm trường JSON
Đọc nhầm trường JSON
Nhiều quy trình cũ đọc body.statusCode hoặc body.captchaFound, vì tưởng raw-html trả JSON như các API có cấu trúc. Lab thử đọc như vậy trên phản hồi đúng: body là chuỗi, không phải đối tượng, nên không có statusCode hay captchaFound trong body. Trong JavaScript, truy cập thuộc tính không tồn tại trên chuỗi trả về undefined, và điều kiện so với 200 luôn sai.
Kết quả là mọi request đều bị coi là lỗi, kể cả request thành công. Hoặc ngược lại, nếu điều kiện viết là khác false, mọi request đều được coi là thành công.
Lỗi ngược chiều cũng có
Có quy trình viết điều kiện kiểu body.statusCode khác 401 để bắt lỗi xác thực. Với raw-html, body là chuỗi nên điều kiện này luôn đúng, kể cả khi thật sự lỗi 401. Quy trình đi tiếp với body là chuỗi JSON lỗi, bước trích HTML chạy trên chuỗi đó và trả toàn None. Kết quả giống ca trang JavaScript, nhưng nguyên nhân khác hẳn.
Sửa
Đọc statusCode ở cấp ngoài cùng của đầu ra, nơi nút HTTP Request đặt nó khi bật headers và status. Đọc body như chuỗi và đưa cho bước trích HTML. Bỏ mọi tham chiếu tới captchaFound khi dùng raw-html. Sau khi sửa, ca đúng đi qua bước kiểm và trích đủ ba trường.
Muốn JSON thì dùng API có cấu trúc
Hướng dẫn chỉ ra một lối khác. Nếu trang đích thuộc loại được hỗ trợ như thương mại điện tử, bất động sản, khách sạn, có thể gọi các endpoint Retail, Real Estate, Booking để nhận JSON đã bóc sẵn giá, đơn vị tiền, tình trạng hàng. Đó mới là chỗ statusCode và captchaFound thật sự xuất hiện trong thân phản hồi.
Bộ chọn phụ thuộc trang đích
Ba bộ chọn trong lab khớp với HTML giả lập và với ví dụ trong hướng dẫn. Trang thật có cấu trúc riêng, và có thể đổi bất cứ lúc nào. Khi bước trích bắt đầu trả None cho một trường vốn luôn có, đó thường là dấu hiệu trang đổi giao diện, không phải lỗi của API.
Đường dẫn tương đối
productUrl trong lab là /p/1, một đường dẫn tương đối. Muốn dùng được, phải ghép với tên miền của trang gốc. Bước trích nên trả cả URL gốc của request để bước sau ghép đúng. Đây là lỗi nhỏ nhưng hay gặp khi trích link từ HTML.
Tái lập nhầm body HTML thành JSON và kiểm mapping sau sửa với ScrapingBot raw HTML response
Phần này chạy các ca lỗi và tổng hợp.
Sai thông tin đăng nhập
Máy chủ giả trả 401, Content-Type application/json, body là chuỗi JSON báo Unauthorized, giống lần gọi thật. Bước kiểm trả sai vì mã khác 200. Bước trích không chạy.
Body rỗng
Máy chủ giả trả 200 với body rỗng. Bước kiểm trả sai vì độ dài bằng 0. Đây là ca hướng dẫn gọi là HTML rỗng hoặc thiếu.
Trang cần JavaScript, không bật useChrome
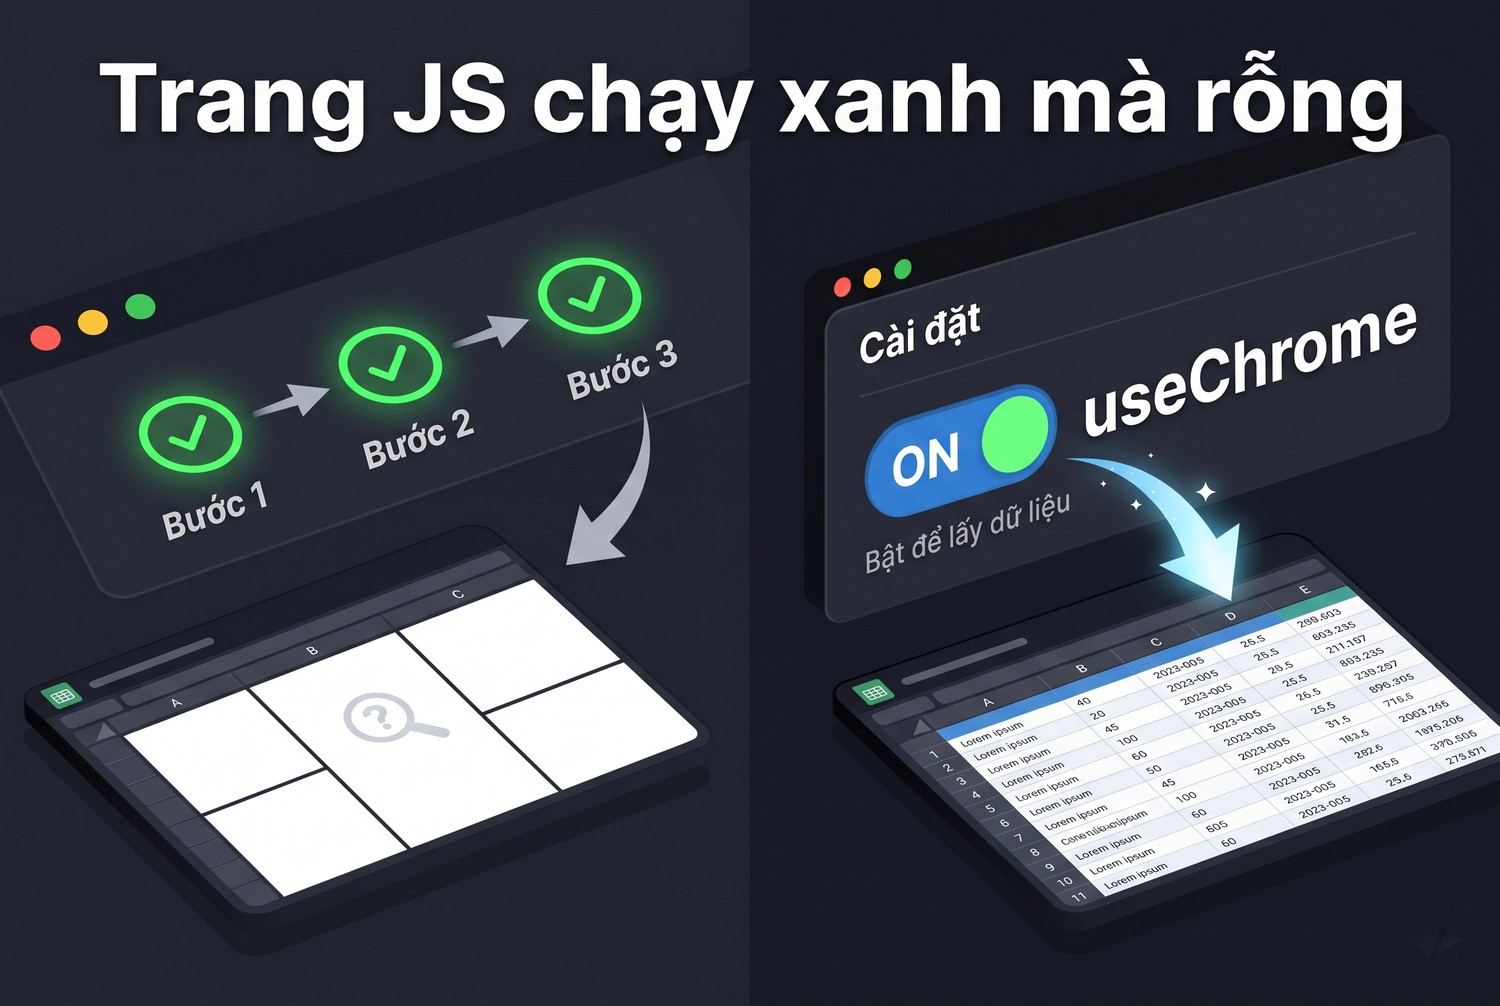
Trang JS chạy xanh mà rỗng
Máy chủ giả trả 200 với HTML chỉ có một thẻ div rỗng, mô phỏng trang dựng bằng JavaScript. Bước kiểm trả đúng vì mã 200 và body không rỗng. Bước trích chạy và trả ba trường None.
Đây là ca nguy hiểm nhất. Quy trình đi qua mọi điều kiện, ghi một dòng toàn giá trị rỗng vào bảng tính, không có cảnh báo nào.
Kiểm bằng độ dài là chưa đủ
Trang JavaScript trong lab có body dài khoảng 50 ký tự, không rỗng. Trang thật dựng bằng JavaScript thường có body dài hơn nhiều vì chứa thẻ script và khung trang. Ngưỡng độ dài nào cũng có thể sai. Kiểm trường bắt buộc sau khi trích là cách đáng tin hơn.
Bật useChrome
Cùng URL, bật useChrome trong options. Máy chủ giả trả trang đầy đủ, bước trích lấy đủ ba trường. Trong dịch vụ thật, useChrome tốn 10 credit thay vì 1 theo hướng dẫn. Chỉ bật cho trang thật sự cần.
429 giả lập
Máy chủ giả trả 429 dạng JSON. Bước kiểm trả sai. Hướng dẫn đề nghị tăng độ trễ hoặc giảm kích thước lô khi gặp 429. Lab không thử nhánh thử lại.
Nhánh thử lại có điều kiện
Không phải lỗi nào cũng đáng thử lại. 401 cần sửa thông tin đăng nhập, thử lại không giúp gì. 429 cần chờ rồi thử lại. Body rỗng hoặc trường trích rỗng có thể thử lại với useChrome. Mỗi loại một nhánh, để quy trình không gọi lại vô ích và không đốt credit.
Kiểm sau khi trích
Ca trang JavaScript cho thấy bước kiểm trước khi trích là chưa đủ. Cần thêm một bước kiểm sau khi trích: trường bắt buộc như tên sản phẩm và giá không được rỗng. Dòng không đạt đi vào nhánh xử lý riêng, có thể thử lại với useChrome.
Bảng kết quả các ca
Ca |
Status |
Content-Type |
Qua bước kiểm |
Kết quả trích |
|---|---|---|---|---|
Text kèm headers, đúng |
200 |
text/html |
có |
đủ 3 trường |
Response Format JSON |
không có |
không có |
không |
lỗi parse JSON |
Text, không headers |
không có |
không có |
không kiểm được |
không áp dụng |
Sai thông tin đăng nhập |
401 |
application/json |
không |
không chạy |
Body rỗng |
200 |
text/html |
không |
không chạy |
Trang JS, không useChrome |
200 |
text/html |
có |
3 trường None |
Trang JS, có useChrome |
200 |
text/html |
có |
đủ 3 trường |
429 giả lập |
429 |
application/json |
không |
không chạy |
Đầu ra nghiệm thu: response fixture raw HTML và mapping body/status của HTTP Request node cùng ca parser nhận sai JSON của ScrapingBot raw HTML response
Phần cuối gom kết quả thành bộ bàn giao.
Bộ bàn giao
Bộ bàn giao gồm tệp lab.py với máy chủ giả lập, hàm mô phỏng nút HTTP Request, bước kiểm và bước trích; tệp out.txt với kết quả tám ca; phản hồi lỗi thật từ endpoint lưu trong body.txt và hdr.txt. Người nhận chạy lại lab.py, phải thấy đúng bảng kết quả.
Kiểm lại sau mỗi lần nâng cấp
Khi n8n hoặc ScrapingBot nâng cấp, chạy lại một URL mẫu và so đầu ra với ca đúng trong bảng. Nếu tên trường hay cấu trúc đầu ra thay đổi, sửa ngay trước khi chạy lô. Một URL mẫu cố định với kết quả biết trước là công cụ kiểm hồi quy rẻ nhất.
Tiêu chí đạt
Phản hồi thành công được đọc như văn bản và trích đủ trường. Phản hồi lỗi được nhận ra qua mã trạng thái và Content-Type. Ca đọc nhầm JSON được tái lập và sửa. Ca trang rỗng nội dung được bắt bằng kiểm sau khi trích.
Lô và độ trễ
Hướng dẫn đề nghị gom 5 tới 10 URL mỗi lô, chờ một khoảng ngắn giữa các lô, và dùng độ trễ ngẫu nhiên. Lab không mô phỏng phần này. Với quy trình nhỏ vài chục URL mỗi ngày, độ trễ cố định là đủ. Với hàng trăm URL, nên làm theo hướng dẫn để tránh 429.
Việc cần làm khi có tài khoản và n8n thật
Dựng nút HTTP Request đúng cấu hình trong hướng dẫn, gọi một URL, xem đầu ra có đúng dạng statusCode, headers, body không. Thử Response Format JSON để xem n8n báo gì. Xuất quy trình ra tệp, kiểm tệp không chứa khóa. Ghi số credit bị trừ cho một request thường và một request useChrome.
Khi nào cần proxy với ScrapingBot raw HTML response
ScrapingBot tự lo phần tải trang đích. Tùy chọn premiumProxy và proxyCountry là của chính dịch vụ, tính thêm credit. Người dùng không cần proxy riêng để gọi API, trừ khi máy chạy n8n nằm sau proxy công ty.
Với website được phép thu thập mà bạn tự tải không qua API, có lúc cần IP tại Việt Nam để thấy đúng trang hiển thị cho người dùng trong nước. Khi đó anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Proxy không sửa lỗi đọc nhầm JSON và không render JavaScript thay cho useChrome. Vai trò hợp lệ của proxy được phân tích ở bài Web Scraping proxy là gì.
premiumProxy không phải proxy của bạn
Tùy chọn premiumProxy và proxyCountry trong thân request là tài nguyên của ScrapingBot, không phải chỗ để điền proxy riêng. Đừng nhầm hai thứ. Nếu muốn dùng IP của mình để tải trang, bạn không cần ScrapingBot cho bước đó, và ngược lại.
Proxy công ty và Basic Auth
Nếu n8n gọi API qua proxy công ty có chặn TLS để soi, proxy đọc được header Authorization, tức đọc được khóa ScrapingBot. Hỏi đội mạng xem proxy có soi TLS không trước khi đưa khóa vào quy trình chạy qua đó. Cách viết chuỗi proxy cho công cụ tự động hóa có trong bài định dạng proxy.
Một URL mẫu cho mỗi trang đích
Mỗi trang đích nên có một URL mẫu với kết quả trích biết trước. Khi thêm trang đích mới, chạy URL mẫu trước để chọn bộ chọn và quyết định có cần useChrome. Khi trang đích đổi giao diện, URL mẫu là chỗ đầu tiên báo lỗi.
Ghi lại request lỗi
Mỗi request không qua bước kiểm nên được ghi vào một bảng riêng: URL, mã trạng thái, Content-Type, độ dài body, thông điệp lỗi nếu có. Bảng này giúp thấy xu hướng: trang nào hay cần useChrome, giờ nào hay gặp 429. Không có bảng này, lỗi chỉ được biết khi ai đó phát hiện dữ liệu thiếu.
Chi phí của một lần cấu hình sai
Với Response Format JSON, mọi request đều lỗi ở bước đọc, nhưng request đã được gửi tới API và có thể đã tính credit. Một lô 500 URL cấu hình sai có thể tốn 500 credit mà không thu được gì. Lab không kiểm được việc tính credit, nhưng nên chạy thử một URL trước khi chạy cả lô.
Những gì lab chưa thử
Lab chưa chạy n8n, chưa có phản hồi thành công thật từ ScrapingBot, chưa đối chiếu credit, chưa thử waitForNetworkRequests hay các tùy chọn khác trong hướng dẫn. Lab chưa thử các endpoint Retail, Real Estate, Booking. Mọi kết luận về đầu ra nút n8n dựa trên mô tả trong hướng dẫn ngày 03/11/2026.
Checklist ScrapingBot raw HTML response
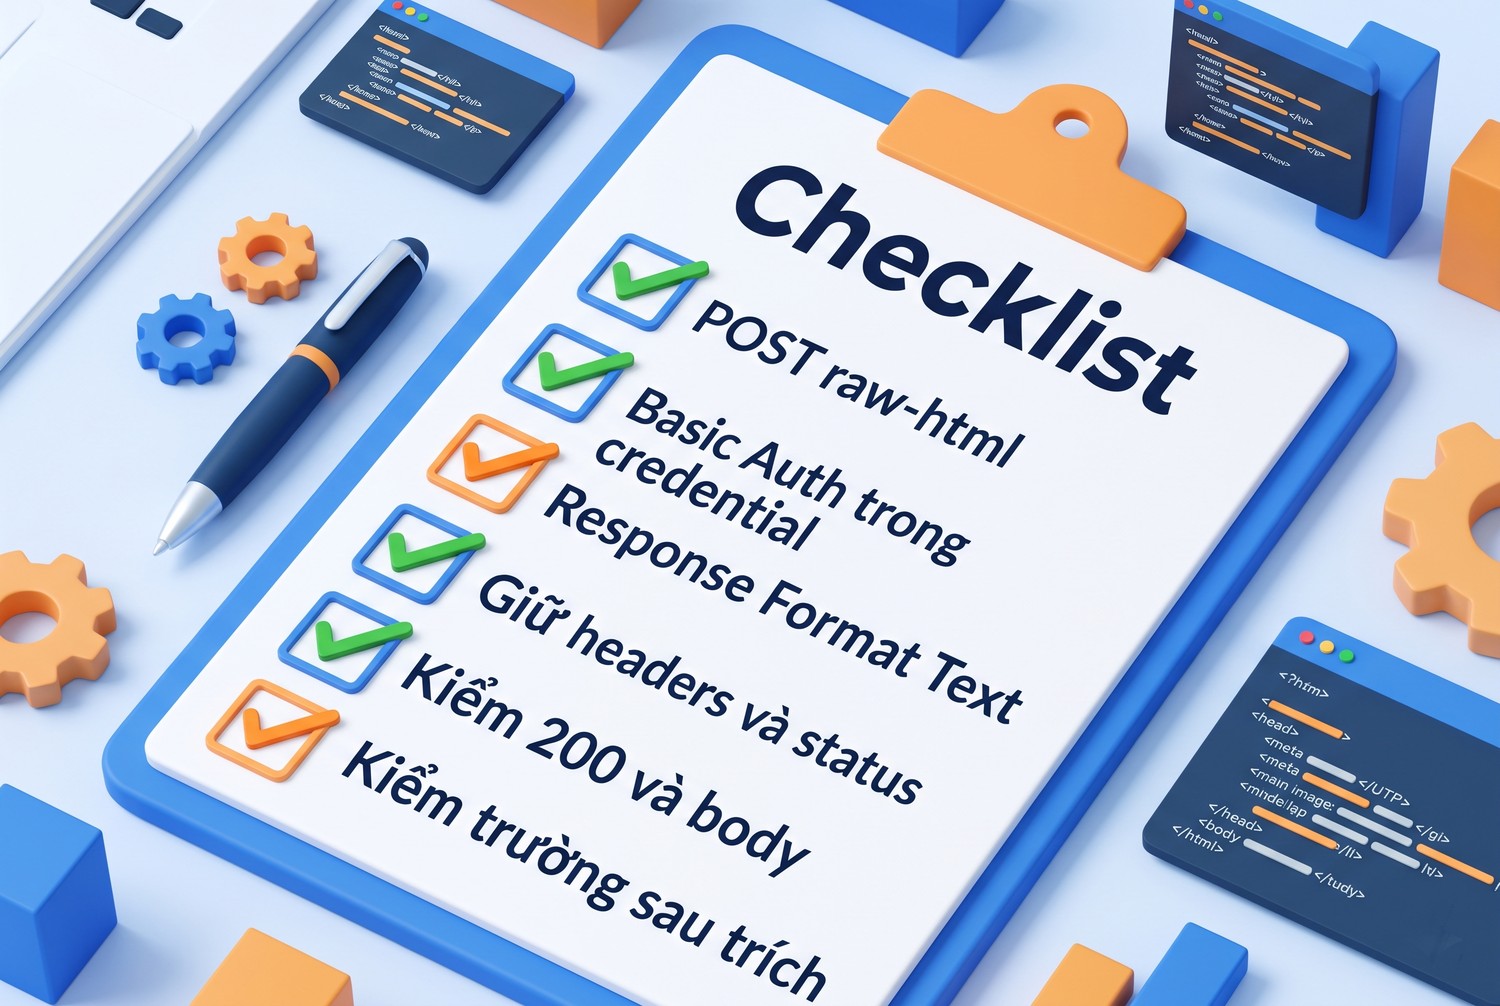
Checklist
- Endpoint raw-html gọi POST, xác thực Basic Auth.
- Lưu khóa trong credential, không dán vào nút.
- Response Format là Text.
- Bật Include Response Headers and Status.
- Kiểm statusCode 200 và body không rỗng.
- Không đọc statusCode hay captchaFound trong body.
- Trích bằng bộ chọn CSS hoặc XPath, kiểm trường bắt buộc sau khi trích.
- Chỉ bật useChrome cho trang cần JavaScript.
Câu hỏi thường gặp về ScrapingBot raw HTML response
raw-html có trả JSON không?
Không khi thành công. Hướng dẫn chính thức ghi body là chuỗi HTML. Khi lỗi, lần gọi thật trả JSON với error code và message.
Vì sao n8n không đọc được phản hồi?
Thường do Response Format đặt là JSON. Thân HTML không phải JSON hợp lệ, lab nhận JSONDecodeError ở ký tự đầu.
captchaFound nằm ở đâu?
Không có trong raw-html. Theo hướng dẫn, trường này thuộc các API có cấu trúc như Retail, Real Estate, Booking.
Sai thông tin đăng nhập thì sao?
Lab gọi thật nhận HTTP 401 với thân JSON báo Unauthorized.
Vì sao quy trình chạy xanh mà dữ liệu rỗng?
Thường do trang cần JavaScript mà không bật useChrome. Lab thấy bước kiểm vẫn qua, bước trích trả ba trường None.
Gọi ScrapingBot có cần proxy không?
Không. Dịch vụ tự lo tải trang. Chỉ cần khi mạng công ty bắt buộc.
ScrapingBot raw HTML response và những điều cần nhớ
ScrapingBot raw HTML response là chuỗi HTML trong body, không phải đối tượng JSON, trong khi lỗi lại trả JSON. Lab cho thấy đọc như JSON làm hỏng ngay bước đầu, không lấy headers và status thì không kiểm lỗi được, còn trang cần JavaScript đi qua mọi điều kiện với dữ liệu rỗng. Đặt Text, giữ status, trích bằng bộ chọn và kiểm trường bắt buộc sau khi trích. Cần IP tĩnh cho phần tự tải trang bên cạnh ScrapingBot raw HTML response, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


