
ScrapeStorm proxy: cài Custom IP và kiểm IP thật khi chạy
ScrapeStorm proxy là cách cho công cụ cào dữ liệu không cần code ScrapeStorm đi qua IP khác thay vì IP mạng nhà hay văn phòng. ProxyVN đối chiếu tài liệu chính thức của ScrapeStorm ngày 25/10/2026 để viết lại các bước cài IP Rotation. Bài kèm hai script nhỏ đã chạy thử: một để lọc proxy chết trước khi dán, một để soát file kết quả.
ScrapeStorm proxy dùng để làm gì và giới hạn của nó
ScrapeStorm là phần mềm cào dữ liệu trực quan, chạy trên Windows, Mac và Linux, quảng cáo là do đội ngũ từng làm crawler ở Google xây dựng. Người dùng chỉ cần dán URL, phần mềm tự nhận diện danh sách, phân trang và các trường dữ liệu.
Hai chế độ làm việc
Phần mềm có hai chế độ. Smart Mode tự nhận diện dữ liệu trên trang, hợp với trang danh sách có cấu trúc rõ. Flowchart Mode cho anh em vẽ quy trình từng bước như mở trang, bấm nút, nhập chữ, cuộn trang, hợp với trang phức tạp hơn.
Cả hai chế độ đều dùng chung phần cài đặt chạy, trong đó có mục IP Rotation & Delay. Vì vậy cách gắn proxy trong bài áp dụng cho cả hai chế độ.
Vì sao cần proxy cho ScrapeStorm
Khi ScrapeStorm mở hàng trăm trang của cùng một website từ một IP, website có thể chặn, hiện CAPTCHA hoặc trả trang trống. Tài liệu chính thức mô tả IP Rotation là tính năng để tránh các kiểu chặn này bằng cách đổi IP trong lúc chạy.
Proxy còn hữu ích khi website hiển thị nội dung khác nhau theo vùng, ví dụ giá và tồn kho theo tỉnh thành. Bài web scraping proxy là gì giải thích cơ chế chung, phần dưới đi thẳng vào ScrapeStorm.
Ba giới hạn cần biết trước khi mua proxy
Đọc kỹ tài liệu, mình thấy ba giới hạn ảnh hưởng trực tiếp tới việc dùng proxy riêng. Nắm trước ba điểm này giúp anh em không mua proxy rồi mới phát hiện gói phần mềm chưa hỗ trợ:
- IP Rotation là tính năng nâng cao, chỉ có ở gói Professional trở lên. Gói miễn phí không dùng được.
- Trang hỏi đáp của hãng ghi IP Rotation làm việc với Bright Data, nhưng trang hướng dẫn cài đặt có thêm lựa chọn Custom IP để dùng IP của chính anh em.
- Tính năng đổi proxy trong lúc chỉnh sửa tác vụ, theo tài liệu, chỉ hướng dẫn với Bright Data Zone. Proxy riêng chỉ được mô tả trong phần cài đặt chạy.
Muốn dùng proxy tự mua với ScrapeStorm, anh em cần gói Professional trở lên và dùng mục Custom IP trong cài đặt chạy.
Cài ScrapeStorm proxy cho tác vụ không code từng bước
Phần này viết lại các bước theo hai trang hướng dẫn chính thức về IP Rotation, giữ nguyên tên nút trong giao diện tiếng Anh để anh em dễ tìm. Mình chưa cài phần mềm nên không có ảnh chụp riêng; khi giao diện bản của anh em khác đi, hãy tìm theo tên nút.
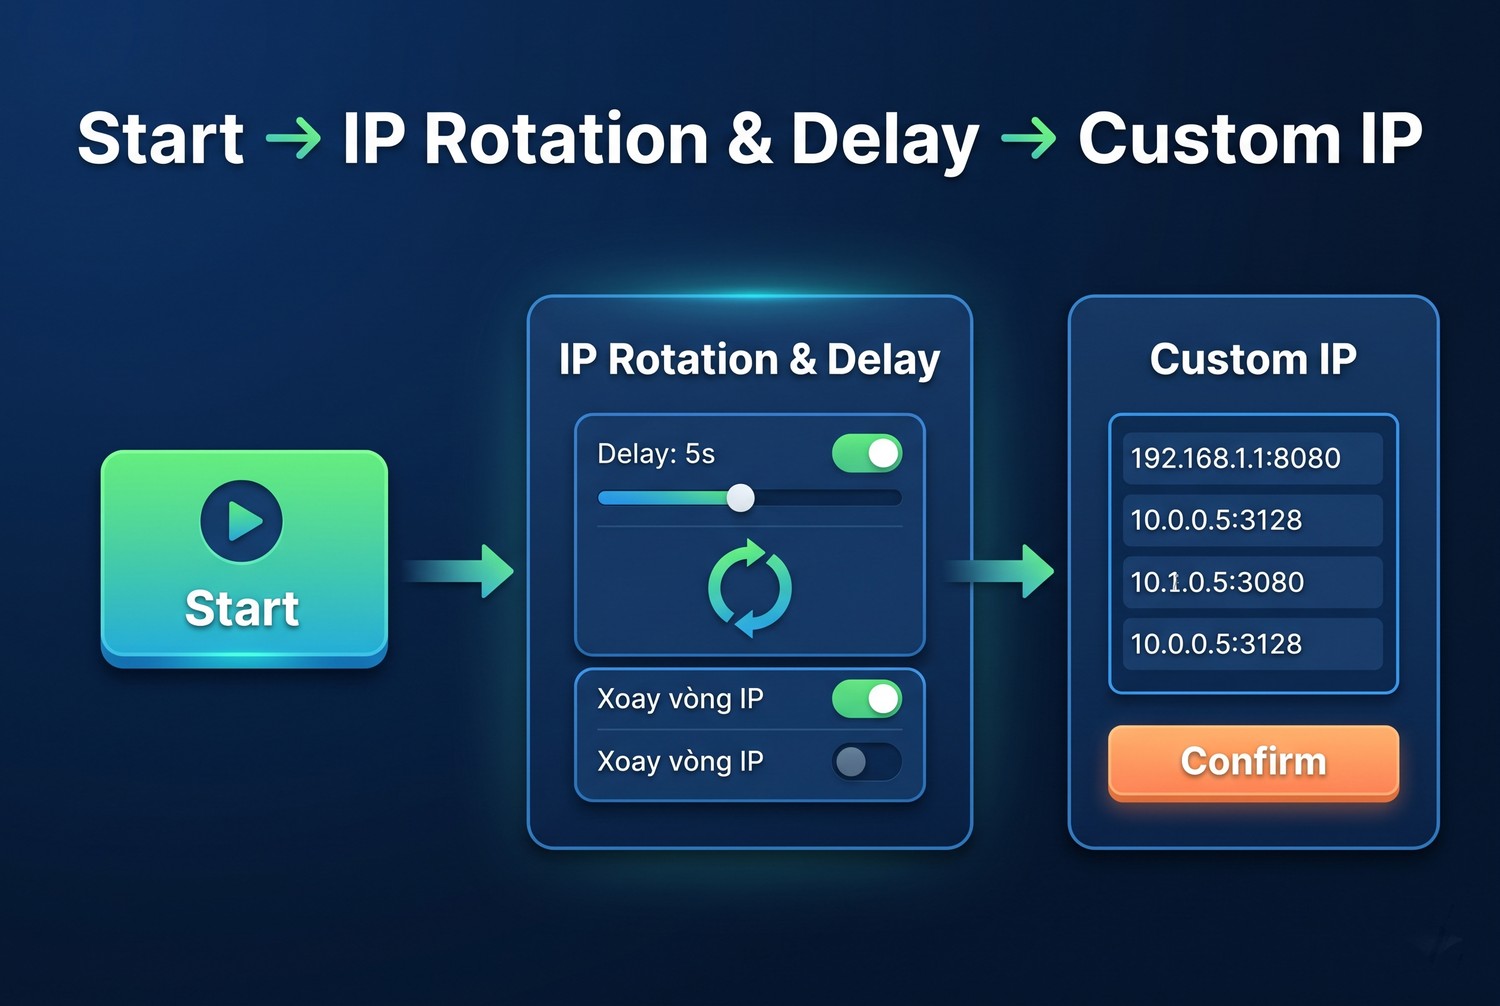
Start → IP Rotation & Delay → Custom IP
Mở cài đặt chạy
IP Rotation không nằm trong phần cài đặt chung của phần mềm mà nằm trong cài đặt chạy của từng tác vụ. Các bước mở như sau:
- Bước 1: mở tác vụ cần chạy trong giao diện chỉnh sửa.
- Bước 2: bấm nút Start ở góc trên để mở cửa sổ cài đặt chạy.
- Bước 3: chọn mục IP Rotation & Delay.
- Bước 4: bật ô IP Rotation.
Cách khác theo hướng dẫn của Geonode cho ScrapeStorm là bấm chuột phải vào tác vụ trong danh sách rồi chọn Start, cửa sổ hiện ra giống hệt.
Chọn loại IP
Phần IP Type có hai lựa chọn. Bright Data Zone là proxy của Bright Data, phải mua trên trang của họ rồi điền tài khoản. Custom IP là IP của chính anh em, bấm nút Set Up để khai báo.
Với Custom IP, anh em liệt kê proxy theo dạng địa chỉ IP và cổng, rồi điền thông tin đăng nhập nếu proxy yêu cầu, sau đó bấm Confirm. Theo hướng dẫn IP Rotation & Delay, các IP trong Custom IP được đổi lần lượt theo thứ tự liệt kê.
Định dạng tài khoản khi dùng Bright Data Zone
Hướng dẫn Bright Data Zone của ScrapeStorm ghi định dạng tài khoản là username, dấu hai chấm, rồi password, ví dụ lum-customer-data_center:123456. Chi tiết này đáng nhớ vì nhiều nhà cung cấp khác gửi proxy dạng ip:port:user:pass, phải tách đúng phần trước khi dán.
Nếu mật khẩu proxy có chứa dấu hai chấm, cách ghép username:password sẽ bị hiểu sai. Khi tạo proxy, mình chọn mật khẩu chỉ gồm chữ và số để tránh lỗi này. Bài định dạng proxy hướng dẫn tách đúng từng phần của chuỗi proxy.
Chọn điều kiện đổi IP
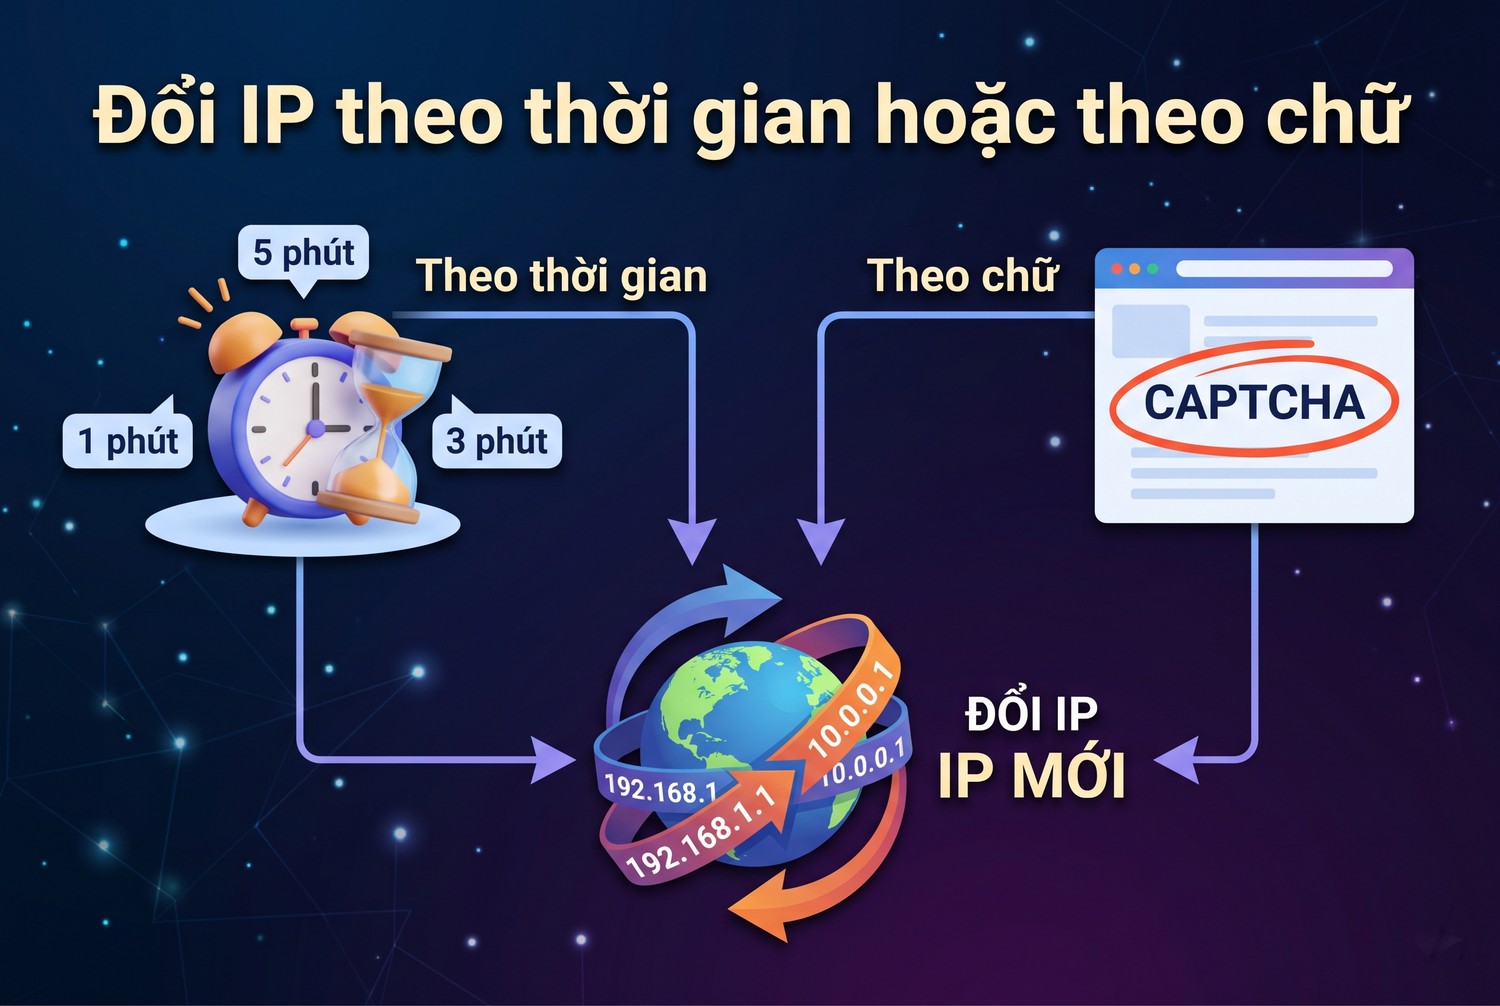
Mục Switch IP when the following condition is met có hai điều kiện. Interval đổi IP theo thời gian, trang hướng dẫn cho chọn 1 phút, 3 phút hoặc 5 phút. Text appears on the page đổi IP khi trên trang xuất hiện một đoạn chữ anh em nhập vào.
Với điều kiện theo chữ, có thể nhập nhiều đoạn, ngăn cách bằng hai dấu gạch đứng, ví dụ A||B||C nghĩa là đổi khi gặp A hoặc B hoặc C. Chữ phải khớp đúng; nếu trang chặn hiện bằng hình ảnh thay vì chữ, điều kiện này không hoạt động, phải dùng điều kiện theo thời gian.
Lưu và chạy thử
Bấm Start để lưu cài đặt và bắt đầu chạy. Tài liệu ghi mỗi tác vụ có cài đặt proxy riêng, proxy của tác vụ này không áp dụng cho tác vụ khác. Muốn mọi tác vụ đi qua proxy thì phải cài cho từng tác vụ.
Lần chạy đầu, mình luôn để tác vụ dừng sau vài chục dòng để xem kết quả trước. Phần kiểm IP thật bên dưới giải thích vì sao bước này quan trọng.
Chuẩn bị proxy và phiên bản cho ScrapeStorm proxy
Trước khi dán proxy vào phần mềm, có hai việc nên làm: kiểm phiên bản phần mềm và lọc proxy chết. Cả hai đều mất vài phút nhưng tránh được cả buổi gỡ lỗi.
Phiên bản và gói phần mềm
Trang tải về của ScrapeStorm ghi bản mới nhất là 4.1.2, cập nhật ngày 6/7/2026. Các bản trước đó là 4.1.1 ngày 11/5/2026 và 4.1.0 ngày 29/4/2026. Giao diện có thể thay đổi giữa các bản, nên khi làm theo hướng dẫn mà không thấy nút, kiểm lại phiên bản trước.
Trang giá ghi ScrapeStorm cho dùng thử 14 ngày, không cần thẻ thanh toán, và hoàn tiền trong 5 ngày nếu không hài lòng. Gói Premium có 3 Speed Boost Engine, dùng các kỹ thuật như tắt JavaScript và chạy nhiều luồng, theo hãng thường nhanh gấp 3 tới 10 lần. Chạy nhanh hơn đồng nghĩa với gửi nhiều request hơn trong cùng thời gian, nên càng cần proxy.
Lọc proxy chết trước khi dán
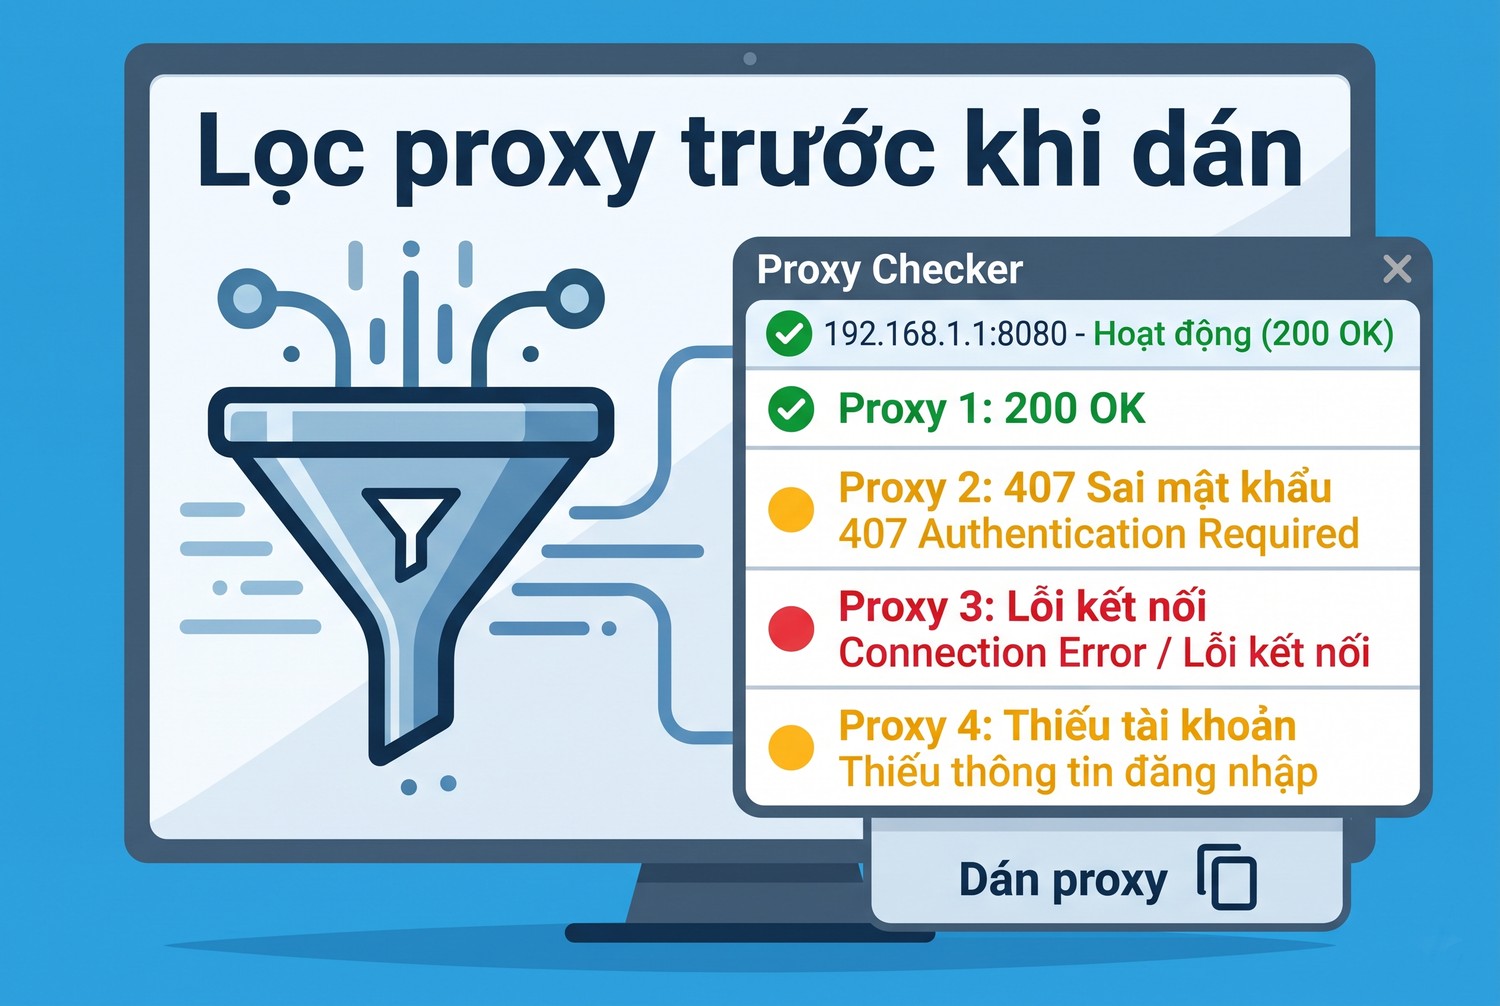
Custom IP đổi lần lượt từng IP trong danh sách. Nếu trong danh sách có proxy chết hay sai mật khẩu, tác vụ sẽ lỗi đúng lúc tới lượt proxy đó, và rất khó đoán nguyên nhân từ giao diện. Mình viết một script nhỏ kiểm từng dòng trước khi dán.
import sys, time
from concurrent.futures import ThreadPoolExecutor
from urllib.parse import quote
import requests

def parse(line):
    parts = line.strip().split(":")
    if len(parts) == 2:
        return parts[0], parts[1], None, None
    if len(parts) >= 4:
        return parts[0], parts[1], parts[2], ":".join(parts[3:])
    raise ValueError(f"Sai định dạng: {line.strip()}")

def check(line, target):
    host, port, user, pw = parse(line)
    auth = f"{quote(user, safe='')}:{quote(pw, safe='')}@" if user else ""
    proxy = f"http://{auth}{host}:{port}"
    t = time.perf_counter()
    try:
        r = requests.get(target, proxies={"http": proxy, "https": proxy}, timeout=15)
        return f"{host}:{port}", r.status_code, round((time.perf_counter() - t) * 1000), r.text.strip()[:40]
    except requests.RequestException as e:
        return f"{host}:{port}", "LỖI", None, type(e).__name__

lines = [l for l in open(sys.argv[1], encoding="utf-8") if l.strip() and not l.startswith("#")]
target = sys.argv[2] if len(sys.argv) > 2 else "https://api.ipify.org"
with ThreadPoolExecutor(5) as ex:
    for row in ex.map(lambda l: check(l, target), lines):
        print(" | ".join(str(x) for x in row))
Chạy bằng lệnh python check_proxies.py proxies.txt, mỗi dòng của file là ip:port hoặc ip:port:user:pass. Mặc định script gọi api.ipify.org, trang trả về IP đi ra, nên cột cuối chính là IP mà website sẽ thấy.
Kết quả chạy thử script
Mình chạy script với bốn dòng proxy trên một proxy thử có mật khẩu chứa @ và dấu thăng. Kết quả cho thấy mỗi loại lỗi hiện ra khác nhau, giúp anh em biết sửa chỗ nào:
- Dòng đúng tài khoản: mã 200, độ trễ 8 mili giây.
- Dòng sai mật khẩu: mã 407, nghĩa là proxy sống nhưng từ chối tài khoản.
- Dòng sai cổng: ProxyError, nghĩa là không kết nối được tới proxy.
- Dòng thiếu tài khoản với proxy cần xác thực: mã 407.
Chỉ dán vào Custom IP những dòng ra mã 200 và IP ở cột cuối đúng là IP proxy. Với danh sách lớn, bài công cụ kiểm tra proxy giới thiệu thêm cách kiểm khác.
Ví dụ tối thiểu ScrapeStorm proxy: đầu vào, cách chạy và đầu ra
Cách chắc nhất để biết ScrapeStorm có thật sự đi qua proxy không là cho chính nó cào một trang hiển thị IP. Tác vụ thử này mất vài phút dựng và nên làm mỗi khi đổi nhà cung cấp hay đổi gói proxy.
Dựng tác vụ kiểm IP
Tác vụ thử dùng Smart Mode với một trang trả về IP dạng chữ thuần, ví dụ api.ipify.org. Các bước:
- Bước 1: tạo tác vụ Smart Mode mới, dán URL trang hiển thị IP.
- Bước 2: để phần mềm nhận diện; trang chỉ có một dòng chữ nên sẽ ra một trường duy nhất.
- Bước 3: dùng URLs Generator hoặc dán cùng một URL nhiều lần để tác vụ mở trang đó nhiều lượt.
- Bước 4: bật IP Rotation với Custom IP chứa hai tới ba proxy, điều kiện Interval 1 phút.
- Bước 5: chạy vài phút rồi xuất kết quả ra CSV.
Đầu ra mong đợi
File CSV nên có nhiều dòng IP, đổi giá trị sau mỗi khoảng một phút, và mọi giá trị đều thuộc danh sách proxy đã dán. Nếu có dòng là IP mạng nhà của anh em, nghĩa là có lúc phần mềm chạy không qua proxy, cần xem lại cài đặt trước khi chạy tác vụ thật.
Tài liệu ScrapeStorm có lưu ý về điều kiện thời gian: IP không đổi đúng lúc hết giờ, mà đợi thao tác trang hiện tại xong mới đổi. Vì vậy khoảng cách giữa hai lần đổi trong file kết quả có thể dài hơn một phút một chút, đó là bình thường.
Đo mức tiêu thụ IP
Trang hướng dẫn ghi mỗi lần đổi IP sẽ tiêu thụ một IP. Với Interval 3 phút, một tác vụ chạy 3 giờ sẽ đổi khoảng 60 lần. Nếu nhà cung cấp tính tiền theo số IP hay theo lần đổi, con số này quyết định chi phí.
Với proxy tĩnh mua theo tháng, đổi lần lượt trong danh sách không tốn thêm tiền, nhưng IP sẽ quay vòng. Danh sách ngắn mà đổi liên tục thì mỗi IP vẫn gửi nhiều request tới cùng website, hiệu quả tránh chặn giảm đi. Số IP trong danh sách và khoảng đổi phải tính cùng nhau theo số trang cần cào.
Tính số IP và khoảng đổi cho ScrapeStorm proxy
Phần lớn người mới chọn số proxy theo cảm tính, mua ít thì bị chặn, mua nhiều thì lãng phí. Mình dùng một cách tính đơn giản dựa trên ba con số anh em biết trước khi chạy: số trang cần cào, tốc độ mở trang, và mức website chịu được từ một IP.
Ba con số cần ước tính
Con số thứ nhất là tổng số trang, gồm cả trang danh sách và trang chi tiết. Con số thứ hai là thời gian trung bình ScrapeStorm mở xong một trang, tính cả Delay; với Delay 1 giây và trang tải 2 giây, khoảng 3 giây mỗi trang.
Con số thứ ba khó nhất: một IP mở được bao nhiêu trang của website đó trước khi bị chặn. Không tài liệu nào cho sẵn con số này, anh em phải thử bằng cách chạy không đổi IP và ghi lại số trang trước khi gặp CAPTCHA đầu tiên. Lấy khoảng một nửa con số đó làm ngưỡng an toàn.
Ví dụ tính cụ thể
Giả sử cần cào 6.000 trang, mỗi trang mất 3 giây, và thử thấy một IP mở được khoảng 200 trang thì bị CAPTCHA. Ngưỡng an toàn là 100 trang mỗi IP mỗi lượt. Với 3 giây một trang, 100 trang mất khoảng 5 phút, nên chọn Interval 5 phút là hợp lý.
Tổng thời gian chạy là 6.000 nhân 3 giây, khoảng 5 giờ, tức khoảng 60 lần đổi IP. Nếu danh sách Custom IP có 10 proxy tĩnh, mỗi proxy được dùng khoảng 6 lượt, cách nhau gần 50 phút. Khoảng nghỉ đó thường đủ để website không coi một IP là đang cào liên tục.
Đây là ví dụ minh họa cách tính, không phải số liệu đo trên website thật. Mỗi site có ngưỡng khác nhau, thậm chí thay đổi theo giờ trong ngày, nên con số thử nghiệm của chính anh em luôn đáng tin hơn.
Bảng chọn nhanh theo kiểu website
Khi chưa có thời gian thử ngưỡng, bảng dưới là điểm xuất phát mình hay dùng. Sau lần chạy đầu, chỉnh lại theo số CAPTCHA thực tế gặp phải.
Kiểu website |
Loại proxy |
Điều kiện đổi IP |
Delay |
|---|---|---|---|
Trang tin, danh bạ ít chống bot |
Datacenter |
Interval 5 phút |
1 giây |
Sàn thương mại điện tử |
Dân cư |
Interval 3 phút kèm chữ CAPTCHA |
2–3 giây |
Trang cần đăng nhập |
Dân cư IP tĩnh |
Không đổi trong phiên |
2–3 giây |
Trang hiện CAPTCHA bằng hình |
Dân cư |
Interval 1 phút |
3 giây trở lên |
Lưu lượng proxy theo dung lượng
Với proxy tính tiền theo dung lượng, tổng số GB quan trọng hơn số IP. ScrapeStorm mở trang bằng trình duyệt tích hợp nên tải cả hình ảnh, phông chữ, script, mỗi trang có thể tốn từ vài trăm KB tới vài MB.
Speed Boost Engine của gói Premium có kỹ thuật tắt JavaScript, theo trang giá, giúp nhanh hơn và có thể giảm dung lượng. Trước khi chạy lớn, anh em chạy thử 50 trang, xem dung lượng tiêu thụ trên bảng điều khiển của nhà cung cấp, rồi nhân lên theo tổng số trang để ước tính chi phí.
Xử lý lỗi và kiểm tra dữ liệu với ScrapeStorm proxy
Gắn proxy rồi vẫn có thể gặp CAPTCHA, trang trống hay dữ liệu lẫn trang chặn. Phần này gom các tình huống tài liệu chính thức có nhắc tới và cách mình soát file kết quả.
Lọc proxy trước khi dán
CAPTCHA trong lúc chạy
Theo trang hỏi đáp, ScrapeStorm không tự giải CAPTCHA mà chỉ hỗ trợ giải tay. Khi phát hiện CAPTCHA, phần mềm tạm dừng tác vụ và hiện cửa sổ để người dùng xác minh, xong thì chạy tiếp.
Kết hợp với IP Rotation, tài liệu khuyên dùng chữ trên trang CAPTCHA làm điều kiện đổi IP. Khi CAPTCHA xuất hiện, phần mềm đổi IP và thử lại cho tới khi trang CAPTCHA không còn. Nếu trang CAPTCHA là hình ảnh, không có chữ để bắt, thì dùng điều kiện thời gian. Bài CAPTCHA là gì giải thích vì sao IP sạch giảm số lần gặp CAPTCHA.
Các tùy chọn trong phần Manual
Phần Manual của IP Rotation & Delay có thêm vài tùy chọn hữu ích khi gặp trang khó. Mình tóm tắt theo tài liệu:
Tùy chọn |
Dùng khi nào |
Lưu ý |
|---|---|---|
Delay(s) |
Trang mở chậm, dữ liệu chưa kịp hiện |
Mặc định 1 giây |
Detect CAPTCHA During the Scraping |
Phần mềm không tự nhận ra CAPTCHA |
Nhập chữ đặc trưng của trang |
Detect Login Prompt During the Scraping |
Site đăng xuất giữa chừng |
Phần mềm nhắc đăng nhập lại |
Only Extract Visible Elements |
Trang trộn ký tự ẩn vào dữ liệu |
Có thể làm thiếu dữ liệu |
Load Page Info one by one |
Phải cuộn mới hiện nội dung |
Làm chậm tốc độ |
Switch Browser Regularly |
Site chặn theo phiên bản trình duyệt |
Khoảng 30 giây tới 10 phút |
Tăng Delay là cách đơn giản nhất để giảm bị chặn mà không tốn thêm tiền proxy. Mình thường thử tăng Delay lên 2 tới 3 giây trước, chỉ khi vẫn bị chặn mới tăng số IP.
Soát file kết quả sau khi chạy
Tác vụ chạy xong không báo lỗi chưa có nghĩa dữ liệu sạch. Trang chặn đôi khi vẫn được cào thành một dòng dữ liệu, chứa chữ kiểu xác minh bạn là người. Script dưới đọc file CSV xuất ra, đếm dòng trùng, ô trống theo cột, và đánh dấu dòng nghi là trang chặn.
import csv, sys
from collections import Counter

BLOCK_WORDS = ["captcha", "verify you are human", "access denied", "too many requests", "xác minh"]

rows = list(csv.DictReader(open(sys.argv[1], encoding="utf-8-sig")))
cols = list(rows[0].keys()) if rows else []
empty, blocked = Counter(), []
for i, r in enumerate(rows, start=2):
    for c in cols:
        if not (r[c] or "").strip():
            empty[c] += 1
    if any(w in " ".join(r.values()).lower() for w in BLOCK_WORDS):
        blocked.append(i)
dup = sum(n - 1 for n in Counter(tuple(r.values()) for r in rows).values() if n > 1)
print(f"Tổng dòng: {len(rows)} | trùng lặp: {dup} | dòng nghi trang chặn: {blocked}")
for c in cols:
    print(f"  Cột {c}: {empty[c]} ô trống")
Mình chạy script với một file CSV mẫu tự tạo gồm 5 dòng có cài sẵn lỗi. Kết quả đúng như mong đợi: 1 dòng trùng, dòng số 6 bị đánh dấu là trang CAPTCHA, cột tên có 1 ô trống, cột giá có 2 ô trống. Với file thật, anh em thêm chữ đặc trưng của trang chặn trên site mình cào vào danh sách BLOCK_WORDS.
Cào lại từ điểm dừng
Khi tác vụ dừng giữa chừng vì lỗi proxy, nhiều người nghĩ ScrapeStorm tự chạy tiếp từ chỗ dừng. Trang hướng dẫn cào từ điểm dừng ghi rõ tính năng tự động này chưa có, và đưa ra hai cách làm tay.
Cách thứ nhất là bật Data Deduplication với lựa chọn bỏ qua dữ liệu trùng. Tác vụ vẫn chạy lại từ trang đầu, chỉ bỏ qua các dòng đã có, nên dễ cài nhưng tốn lưu lượng proxy vì vẫn mở lại các trang cũ. Cách thứ hai là lấy End URL và Pager Count ghi ở màn hình dừng, rồi đặt trang bắt đầu trong Scraping Range hoặc sửa URL của tác vụ cho khớp.
Với proxy tính theo dung lượng, cách thứ hai tiết kiệm hơn hẳn. Tài liệu lưu ý Pager Count có thể lớn hơn thực tế khi có trang bị treo, nên đối chiếu với End URL trước khi đặt. Và đừng bấm xóa dữ liệu cũ nếu còn cần giữ phần đã cào.
Lên lịch và chạy nhiều tác vụ với ScrapeStorm proxy
Khi ScrapeStorm chạy định kỳ, proxy phải sống lâu hơn một lần chạy. Phần này nói về những điểm cần để ý khi kết hợp Schedule với IP Rotation và khi nhiều tác vụ chạy cùng lúc trên một máy.
Schedule và proxy hết hạn
Theo trang hướng dẫn Schedule, đây là tính năng nâng cao với hai kiểu. Interval Loop chạy lại tác vụ sau một khoảng thời gian kể từ lần chạy trước kết thúc, tối thiểu 1 phút. Schedule chạy theo tần suất một lần, hằng ngày hoặc hằng tuần, có giờ bắt đầu và giờ dừng.
Rủi ro lớn nhất của tác vụ định kỳ là proxy hết hạn hoặc đổi mật khẩu trong khi lịch vẫn chạy. Tác vụ sẽ lỗi mỗi ngày mà không ai biết, cho tới khi cần dữ liệu thì mới phát hiện. Mình đặt nhắc gia hạn proxy trước ngày hết hạn vài ngày, và chạy lại script kiểm proxy mỗi tuần.
Mỗi tác vụ một cài đặt proxy
Tài liệu ghi proxy của tác vụ nào chỉ áp dụng cho tác vụ đó. Điều này vừa là ưu điểm vừa là rủi ro. Ưu điểm là anh em chia được proxy theo website, tác vụ cào sàn thương mại dùng proxy dân cư, tác vụ cào trang tin dùng datacenter.
Rủi ro là khi đổi nhà cung cấp, phải cập nhật từng tác vụ, sót một tác vụ là nó vẫn dùng proxy cũ đã hết hạn. Mình giữ một bảng ghi tác vụ nào dùng danh sách proxy nào, cập nhật bảng mỗi khi đổi.
Chạy nhiều tác vụ cùng lúc
Trang giá có giải thích tính năng chạy nhiều tác vụ đồng thời trên máy cục bộ. Khi hai tác vụ cùng cào một website, đừng cho chúng dùng chung danh sách proxy, vì cùng một IP sẽ gửi request gấp đôi tới website đó.
Nếu bắt buộc dùng chung, chia danh sách thành hai nửa không trùng nhau cho hai tác vụ. Cách này giữ được tính toán số IP và khoảng đổi ở phần trước cho từng tác vụ.
Khi nào cần ScrapeStorm proxy và checklist trước khi chạy thật
Không phải tác vụ nào cũng cần proxy. Phần này giúp anh em quyết định có cần không, chọn loại nào, và kiểm những gì trước khi chạy tác vụ lớn.
Đổi IP theo thời gian hoặc theo chữ
Khi nào chưa cần proxy
Cào vài trăm trang một lần, từ website không có chống bot, với Delay mặc định 1 giây: thường chưa cần proxy. Tăng Delay lên vẫn là cách rẻ nhất để giảm áp lực lên website.
Proxy trở nên cần thiết khi số trang lên hàng nghìn, khi bật Speed Boost Engine, khi website hiện CAPTCHA liên tục, hoặc khi cần dữ liệu theo vùng. Với nhiều tác vụ chạy cùng lúc trên cùng máy, bài proxy pool hướng dẫn chia IP để tác vụ này bị chặn không ảnh hưởng tác vụ khác.
Chọn loại proxy
Website tĩnh, ít chống bot thì proxy datacenter là đủ và rẻ. Sàn thương mại điện tử, trang tin lớn, mạng xã hội cần proxy dân cư để IP giống người dùng thật. Tác vụ có đăng nhập nên dùng IP tĩnh và tắt đổi IP theo thời gian, vì đổi IP giữa phiên đăng nhập dễ bị đăng xuất.
Khi cần mua proxy uy tín cho ScrapeStorm, ProxyVN có proxy dân cư tĩnh Viettel, VNPT, FPT, datacenter Việt Nam và proxy 4G, giao thức HTTP hoặc SOCKS5, cấp user và password. ProxyVN chưa thử trực tiếp với ScrapeStorm, nên anh em chạy script kiểm và tác vụ kiểm IP ở trên trước khi chạy tác vụ thật.
Checklist trước khi chạy tác vụ lớn
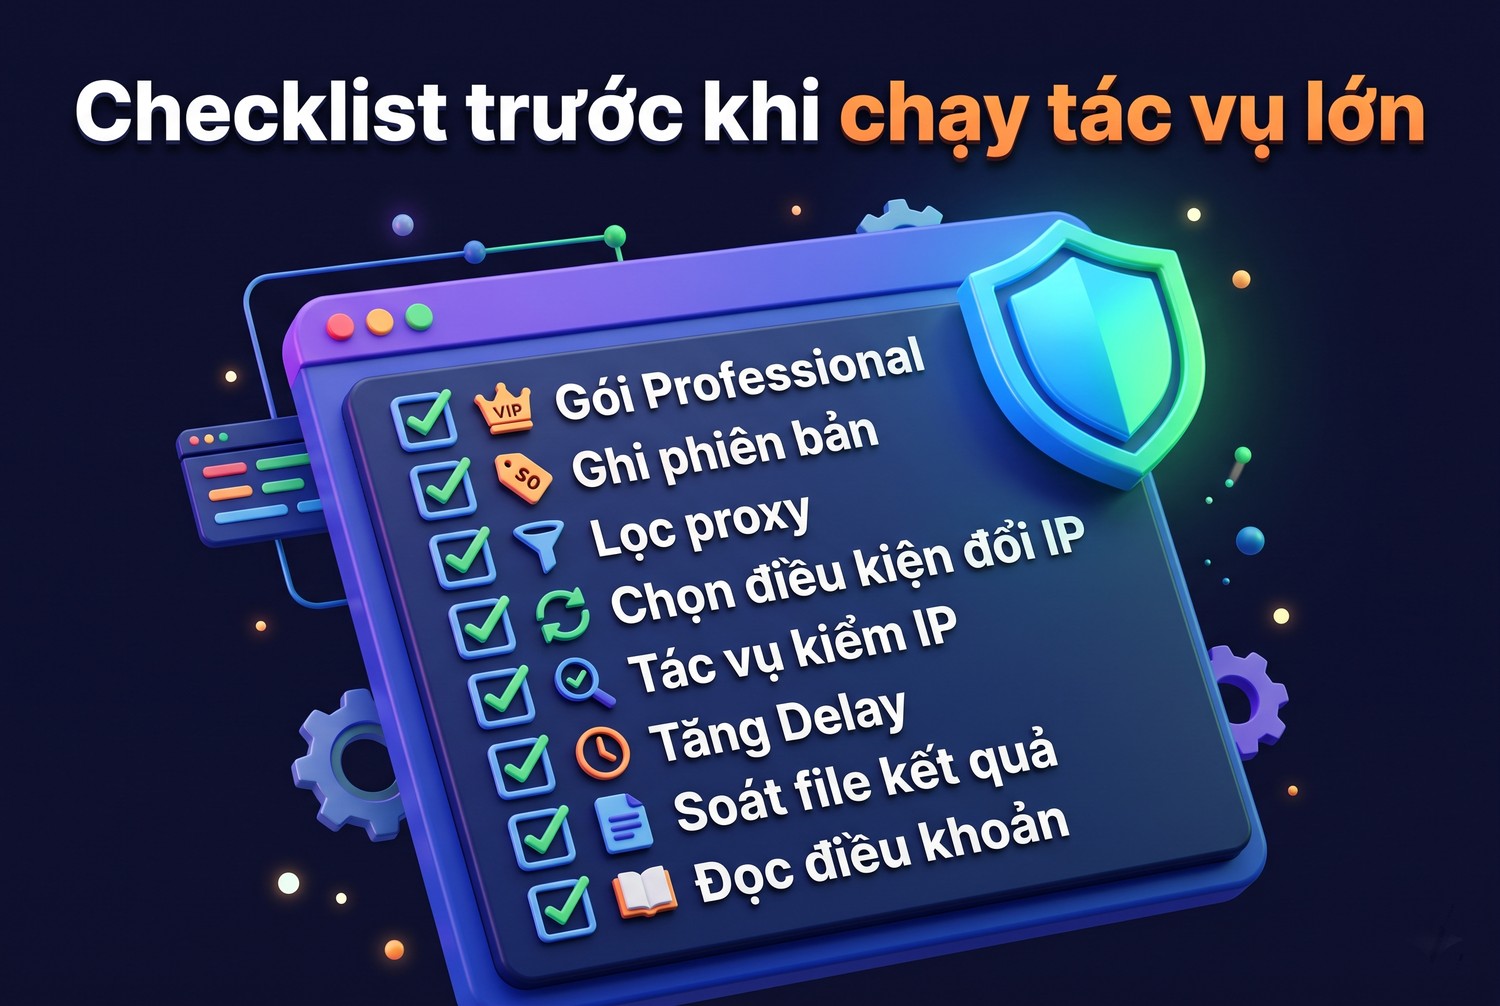
Danh sách dưới là các bước mình làm trước khi để ScrapeStorm chạy hàng nghìn trang:
- Kiểm gói phần mềm có IP Rotation, tức Professional trở lên.
- Ghi lại phiên bản phần mềm đang dùng.
- Chạy script lọc proxy, chỉ giữ dòng ra mã 200 và đúng IP.
- Dán proxy vào Custom IP, chọn điều kiện đổi IP phù hợp với site.
- Chạy tác vụ kiểm IP, xác nhận không có dòng nào là IP mạng nhà.
- Tăng Delay trước khi tăng số IP.
- Chạy thử vài chục dòng, soát file kết quả bằng script.
- Đọc điều khoản và robots.txt của website, chỉ cào dữ liệu công khai được phép.
Proxy giúp ScrapeStorm đổi IP, nhưng chỉ file kết quả mới cho biết proxy có thật sự làm việc hay không.
Checklist trước khi chạy tác vụ lớn
Câu hỏi thường gặp
Gói miễn phí của ScrapeStorm có dùng proxy được không. Theo tài liệu, IP Rotation chỉ có ở gói Professional trở lên. Với gói miễn phí, cách chung là đặt proxy ở cấp hệ điều hành, nhưng mình chưa thử ScrapeStorm có đi theo proxy hệ thống hay không, nên cần kiểm IP như hướng dẫn ở trên.
Có dùng proxy SOCKS5 được không. Tài liệu ScrapeStorm không ghi rõ loại giao thức Custom IP hỗ trợ. Mình khuyên dùng proxy HTTP có tài khoản cho lần đầu, vì đây là loại phổ biến nhất, rồi thử SOCKS5 sau nếu cần.
Vì sao đã bật IP Rotation mà vẫn gặp CAPTCHA. Có thể IP đã bị site đánh dấu, điều kiện chữ không khớp với trang CAPTCHA, hoặc tốc độ quá nhanh. Kiểm IP có bị đưa vào danh sách đen theo bài kiểm tra proxy có bị blacklist không, sửa đúng chữ điều kiện và tăng Delay.
ScrapeStorm khác Octoparse ở chỗ gắn proxy thế nào. Hai công cụ cùng loại không cần code, cách gắn proxy khác nhau ở tên mục và gói hỗ trợ. Bài proxy Octoparse hướng dẫn phía Octoparse để anh em so sánh.
ScrapeStorm proxy và những điều cần nhớ
ScrapeStorm proxy cần gói Professional trở lên, gắn qua IP Rotation với Custom IP hoặc Bright Data Zone, đổi IP theo thời gian hoặc theo chữ trên trang. Lọc proxy trước khi dán, kiểm IP bằng tác vụ thử, soát file kết quả. Cần proxy ổn định, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam cho ScrapeStorm proxy.


