Proxy Scraping Google Maps: Lấy Data Doanh Nghiệp Ổn Định
Proxy scraping Google Maps là hạ tầng giúp trình cào lấy dữ liệu doanh nghiệp trên bản đồ một cách ổn định, không bị chặn sau vài chục truy vấn. Google Maps chặn IP tải nhiều listing liên tục, và kết quả lại thay đổi theo vị trí người xem. Bài viết này ProxyVN trình bày cách chọn proxy, cấu hình trình cào, trích xuất dữ liệu và khi nào nên dùng API chính thức.
Vì sao cần proxy scraping Google Maps
Dữ liệu doanh nghiệp trên Maps là công khai, nhưng lấy có hệ thống thì chạm ngay vào cơ chế chống tự động, và kết quả phụ thuộc vị trí nên một điểm truy cập là chưa đủ.
Google Maps chặn IP tải nhiều listing liên tục
Một người thật hiếm khi mở hàng trăm địa điểm trong vài phút. Khi một IP làm đúng việc đó, Maps trả về trang xác minh, kết quả rỗng, hoặc chặn hẳn. Proxy giải quyết bằng cách xoay địa chỉ để lưu lượng trông như đến từ nhiều người, kèm nhịp truy cập chậm lại cho giống hành vi người dùng.
Kết quả thay đổi theo vị trí người xem
Tìm cùng một từ khóa từ hai thành phố khác nhau cho ra hai danh sách địa điểm khác nhau, sắp xếp theo khoảng cách tới người tìm. Muốn lập danh sách doanh nghiệp đầy đủ cho một khu vực, phải tìm từ IP đặt trong chính khu vực đó, và chia nhỏ theo từng vùng. Cách dùng proxy để đo đúng thứ hạng Google Maps của một địa điểm được hướng dẫn trong bài proxy đo thứ hạng Google Maps.
Dữ liệu doanh nghiệp dùng để làm gì
Danh sách tên, địa chỉ, số điện thoại, website, điểm đánh giá và số lượt đánh giá phục vụ tìm khách hàng tiềm năng, nghiên cứu mật độ đối thủ theo khu vực, làm sạch cơ sở dữ liệu địa chỉ, và theo dõi thay đổi điểm đánh giá của một nhóm cửa hàng theo thời gian.
Proxy đảm nhận việc gì cụ thể
Trong đường ống dữ liệu Maps, proxy làm ba việc. Một, phân tán truy vấn qua nhiều địa chỉ để không IP nào mở đủ nhiều địa điểm tới mức bị đếm. Hai, đặt điểm xuất phát vào đúng vùng để danh sách trả về là danh sách khách vùng đó thấy, sắp theo khoảng cách tới đúng khu vực. Ba, khi chia thành phố thành lưới ô, giao mỗi nhóm ô cho một nhóm IP riêng để chúng không cộng dồn tần suất lên cùng một địa chỉ. Ba việc này tách khỏi khâu phân tích HTML nhưng quyết định có đủ dữ liệu để phân tích hay không.
Chọn loại proxy scraping Google Maps
Maps là sản phẩm của Google nên tường chống bot dày. Lựa chọn proxy và nhịp truy cập quyết định trình cào sống được bao lâu. Cách proxy giúp vượt lớp chống bot của các sản phẩm Google được nói kỹ hơn trong bài proxy scraping Google là gì.
Proxy dân cư xoay là mặc định
Theo hướng dẫn cào Google Maps của IPRoyal, nên dùng proxy dân cư xoay đổi IP theo từng request để tránh bị chặn IP và dính CAPTCHA khi gửi nhiều truy vấn. IP datacenter bị nhận diện và chặn nhanh trên các dịch vụ của Google. Khác biệt giữa dân cư và datacenter và khi nào datacenter đủ dùng được phân tích trong bài so sánh proxy dân cư và datacenter.
Nhắm vùng để lấy kết quả địa phương
Chọn proxy ở đúng quốc gia, và nếu được thì đúng thành phố của khu vực cần lập danh sách. Trình cào của Webshare truyền tham số quốc gia vào tên đăng nhập proxy dạng có hậu tố quốc gia và từ khóa xoay, để mỗi truy vấn đi ra từ đúng vùng. Cách chọn proxy theo quốc gia, thành phố hay ASN để lấy đúng kết quả bản địa được nói trong bài geo targeting proxy là gì.
Xoay IP theo request, thêm độ trễ giống người
Chèn khoảng nghỉ ngẫu nhiên vài giây giữa các thao tác, dài hơn khi mở trang chi tiết. Cuộn bảng kết quả từ từ thay vì nhảy thẳng xuống cuối. Nhịp chậm và không đều là thứ giữ cho IP không bị gắn cờ.
Ước lượng số IP cần theo quy mô
Lập danh sách một thành phố lớn với lưới ô dày có thể là vài nghìn truy vấn, mỗi truy vấn kèm vài chục lần cuộn. Ước lượng tổng số lần tải trang trong một giờ, chia cho mức an toàn một IP dân cư chịu được, rồi nhân thêm hệ số dự phòng. Chạy chậm với nhiều IP luôn an toàn hơn chạy nhanh với ít IP. Nếu deadline gấp, tăng số IP song song thay vì ép mỗi IP tải nhanh hơn người thật.
Cấu hình proxy scraping Google Maps trong trình cào
Maps dựng giao diện bằng JavaScript nên cần trình duyệt tự động. Hai lựa chọn phổ biến là Selenium kèm Selenium-Wire, hoặc Playwright.
Hai cách gắn proxy: Selenium-Wire hoặc Playwright
Selenium-Wire nhận cấu hình proxy qua một từ điển có khóa http và https trỏ tới cổng proxy kèm thông tin xác thực. Playwright nhận proxy qua tham số khi khởi chạy trình duyệt, gồm server, username, password. Cả hai đều chuyển toàn bộ lưu lượng của phiên qua proxy.
Chấp nhận cookie và tìm ô tìm kiếm
Lần mở đầu, Maps thường hiện hộp đồng ý cookie. Bấm nút Accept all bằng bộ chọn theo nội dung nút. Sau đó nhập từ khóa vào ô có mã searchboxinput và gửi phím Enter. Đoạn dưới là ví dụ triển khai chung bằng Selenium-Wire.
# Vi du trien khai chung: mo Google Maps qua proxy dan cu xoayfrom seleniumwire import webdriverfrom selenium.webdriver.common.by import Byfrom selenium.webdriver.common.keys import Keysfrom selenium.webdriver.support.ui import WebDriverWaitfrom selenium.webdriver.support import expected_conditions as ECimport timeproxy_options = { "proxy": { "http": "http://user:[email protected]:12321", "https": "http://user:[email protected]:12321", }}driver = webdriver.Chrome(seleniumwire_options=proxy_options)driver.get("https://www.google.com/maps")try: nut = WebDriverWait(driver, 20).until( EC.element_to_be_clickable( (By.XPATH, '//button[contains(., "Accept all")]'))) nut.click()except Exception: passo_tim = driver.find_element(By.XPATH, '//input[@id="searchboxinput"]')o_tim.send_keys("quan an ngon quan 1")o_tim.send_keys(Keys.RETURN)time.sleep(5)
Cuộn bảng kết quả để tải thêm listing
Maps chỉ tải một số kết quả đầu, phần còn lại hiện dần khi cuộn bảng bên trái. Lặp thao tác cuộn xuống vài lần, mỗi lần nghỉ một chút, cho tới khi không còn kết quả mới hoặc chạm dòng báo đã hết. Một truy vấn thường trả về tối đa khoảng vài chục tới trăm địa điểm.
Đọc HTML sau khi trang đã dựng xong
Sau khi cuộn xong, lấy mã HTML hiện tại của trang và đưa cho một thư viện phân tích như BeautifulSoup, hoặc dùng ngay bộ chọn của trình duyệt tự động. Hướng của IPRoyal lấy tên doanh nghiệp từ thuộc tính nhãn của liên kết kết quả, còn hướng của Webshare đọc từng trường từ các lớp con bên trong thẻ kết quả. Cách nào cũng cần kiểm tra lại bộ chọn sau mỗi lần Google cập nhật.
Trình cào Google Maps sống được bao lâu phụ thuộc hai thứ: proxy đủ sạch để không bị chặn, và bộ chọn được cập nhật mỗi khi Google đổi giao diện.
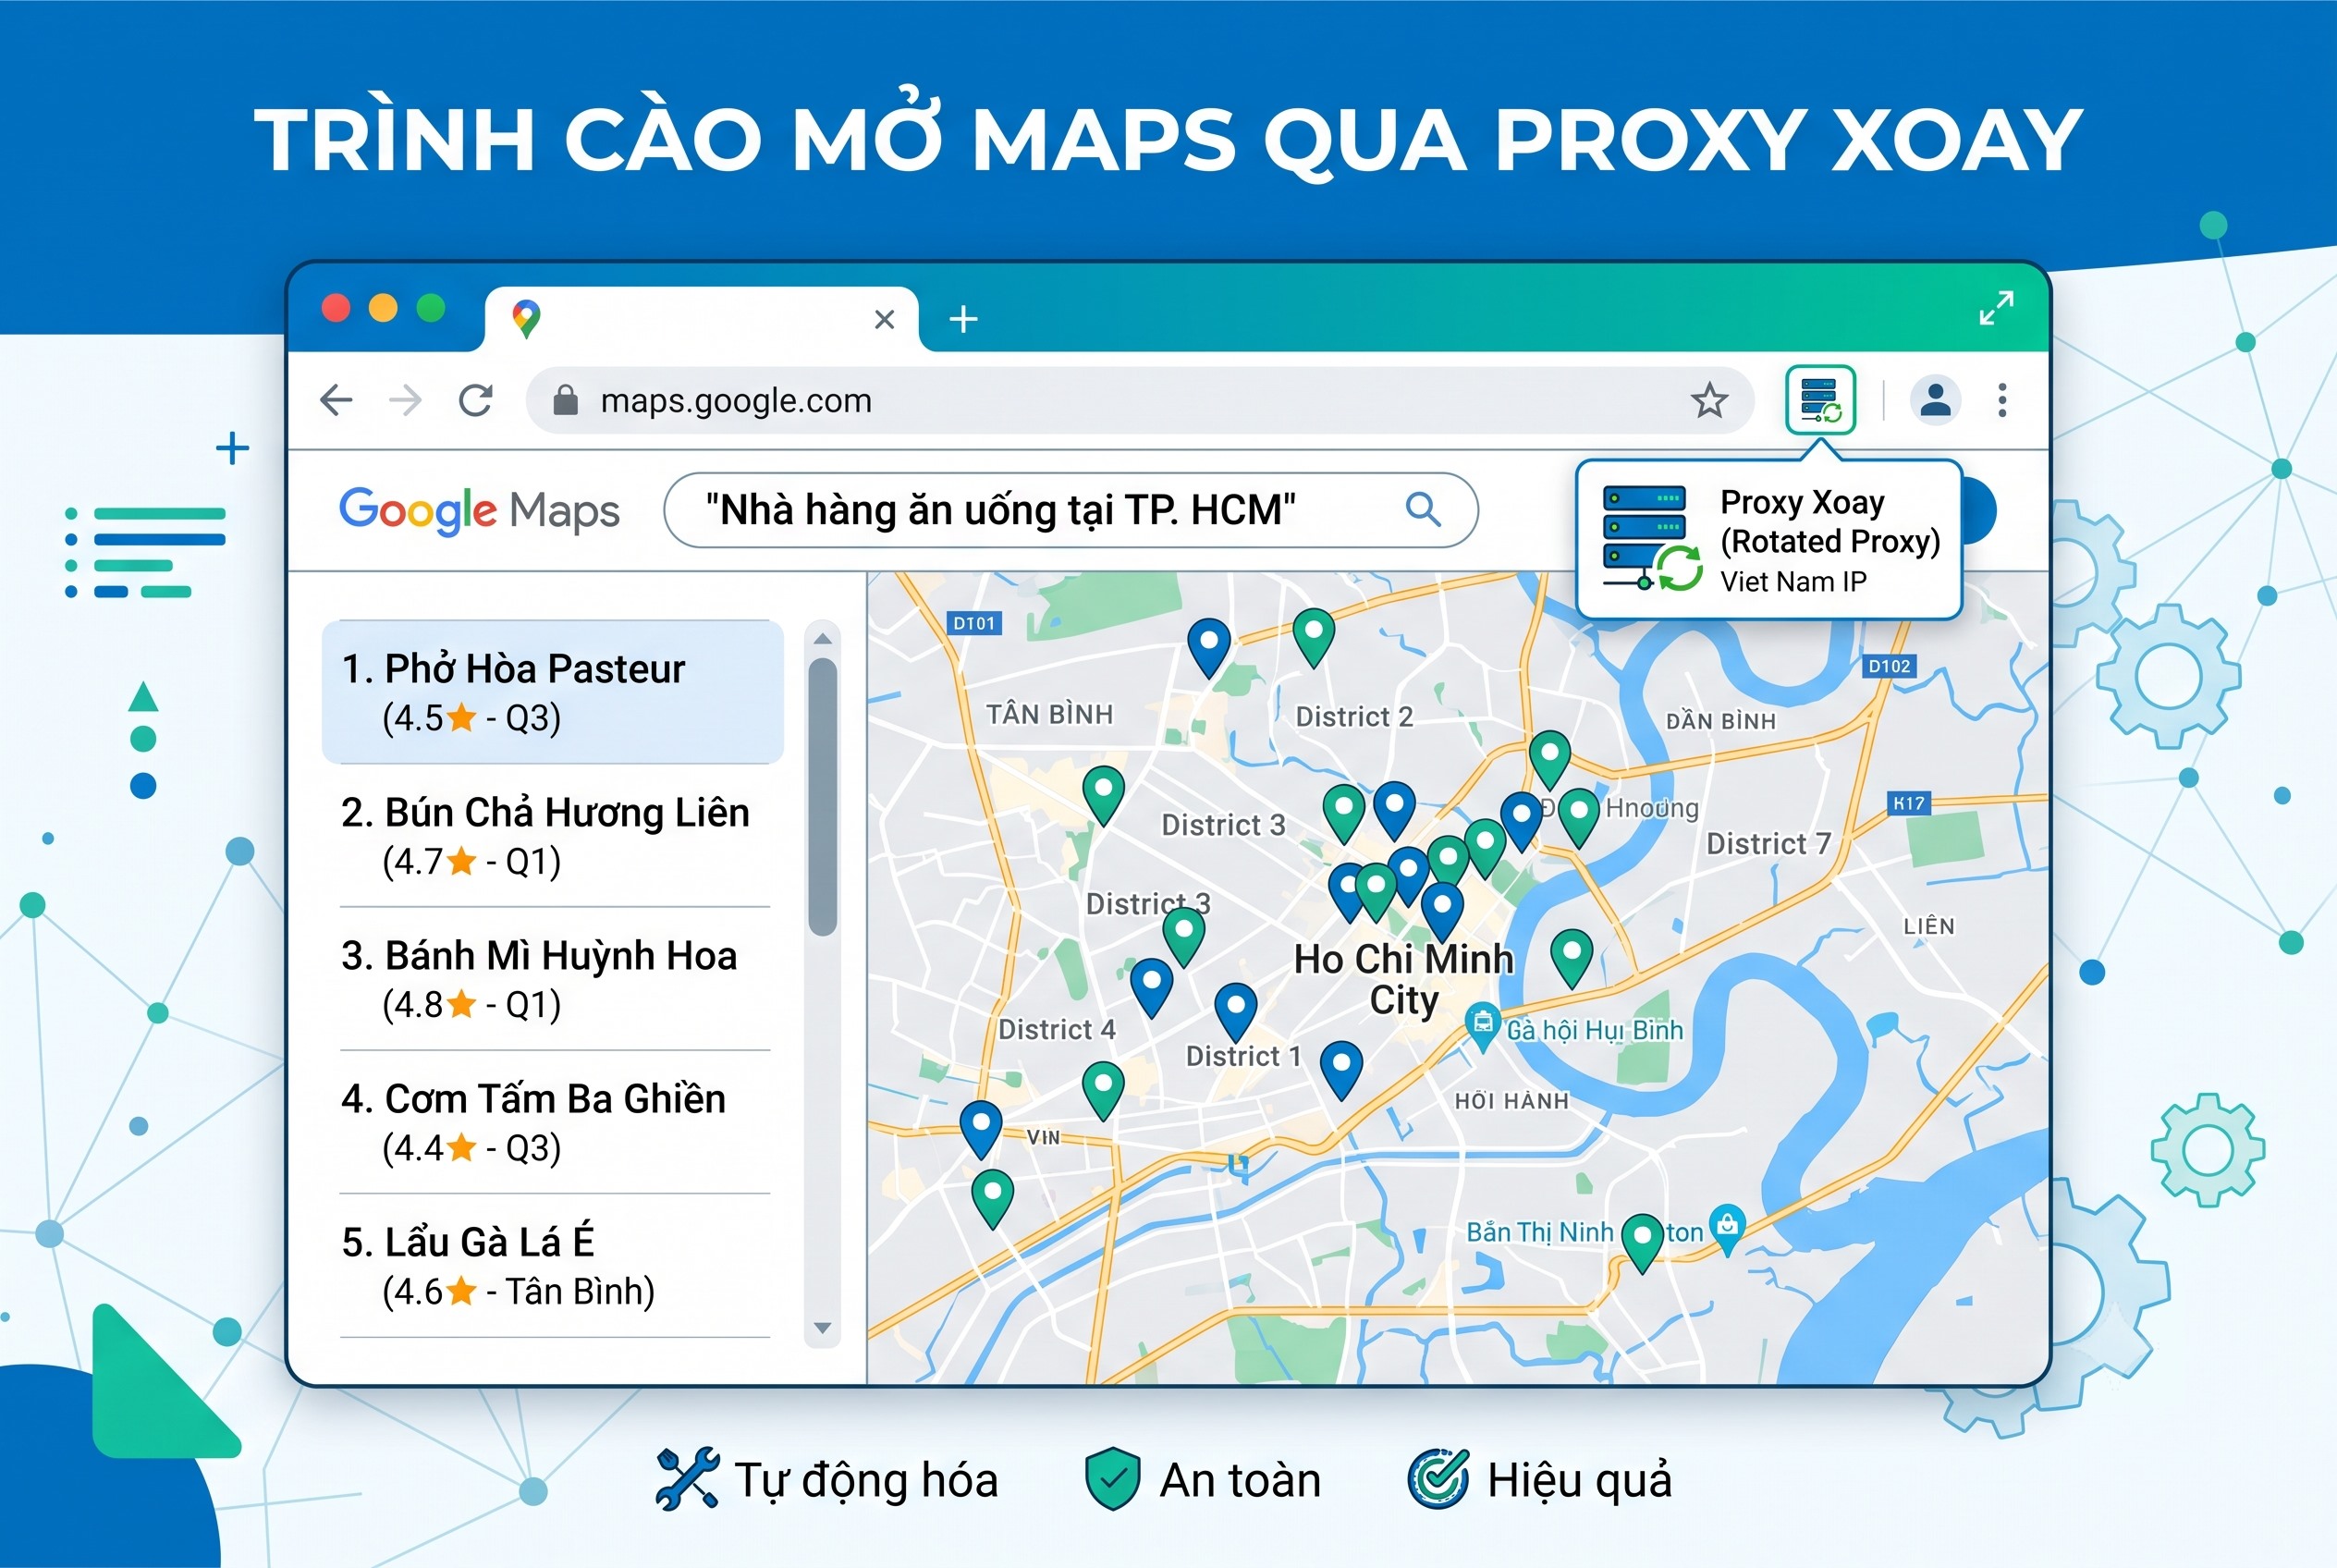
Trình cào mở Maps qua proxy xoay
Trích xuất dữ liệu doanh nghiệp khi proxy scraping Google Maps
Sau khi kết quả đã tải, đọc từng thẻ và lấy các trường cần dùng. Bộ chọn CSS thay đổi theo cập nhật giao diện của Google nên cần kiểm tra định kỳ.
Các trường và bộ chọn CSS
Hướng dẫn cào Google Maps của Webshare dùng bộ chọn cho thẻ kết quả và từng trường bên trong. Bảng dưới liệt kê các trường thường lấy và bộ chọn tham khảo.
|
Trường |
Bộ chọn tham khảo |
Ghi chú |
|---|---|---|
|
Tên doanh nghiệp |
div[role='article'] .qBF1Pd |
Tiêu đề trên thẻ kết quả |
|
Điểm đánh giá |
.MW4etd |
Số thực, ví dụ 4,5 |
|
Số lượt đánh giá |
.UY7F9 |
Tách số trong ngoặc bằng regex |
|
Địa chỉ |
.W4Efsd span |
Lọc theo mẫu tên đường |
|
Số điện thoại |
button[data-item-id*='phone'] |
Lấy từ thuộc tính data |
|
Website |
a[data-item-id='authority'] |
Lấy thuộc tính href |
|
Tọa độ |
URL chứa !3d và !4d |
Tách bằng regex, đổi sang số thực |
Lấy tọa độ từ URL của Maps
URL của một địa điểm chứa vĩ độ và kinh độ ngay trong chuỗi, sau các đoạn đánh dấu 3d và 4d. Dùng biểu thức chính quy để tách hai số này. Tọa độ hữu ích khi cần vẽ bản đồ mật độ hoặc ghép với dữ liệu vùng khác.
Chuẩn hóa và khử trùng lặp
Điểm đánh giá lấy về có thể là 4,5 hoặc 4.5 tùy ngôn ngữ giao diện; đưa về một định dạng số. Số lượt đánh giá thường nằm trong ngoặc kèm chữ, tách lấy phần số. Khi chia lưới ô, một doanh nghiệp gần ranh giới xuất hiện ở nhiều ô; khử trùng lặp bằng một khóa ổn định như tên cộng địa chỉ, hoặc theo tọa độ làm tròn. Lưu kèm vùng IP và thời điểm cào cho mỗi bản ghi.
Xuất JSON và CSV
Giữ bản JSON có cấu trúc lồng cho tọa độ, và một bản CSV đã trải phẳng thành các cột riêng gồm từ khóa tìm, tên, địa chỉ, số điện thoại, website, điểm, số lượt đánh giá, vĩ độ, kinh độ, thời điểm cào. Đoạn dưới là ví dụ triển khai chung bằng Playwright.
# Vi du trien khai chung: trich xuat cac truong tu the ket quaimport re, json, random, asynciofrom playwright.async_api import async_playwrightPROXY = {"server": "http://p.webshare.io:80", "username": "user-vn-rotate", "password": "matkhau"}def toa_do(url): m = re.search(r"!3d(-?[0-9.]+)!4d(-?[0-9.]+)", url or "") return (float(m.group(1)), float(m.group(2))) if m else (None, None)async def cao(tu_khoa): async with async_playwright() as p: br = await p.chromium.launch(proxy=PROXY) pg = await br.new_page() await pg.goto("https://www.google.com/maps/search/" + tu_khoa) await asyncio.sleep(random.uniform(3, 6)) for _ in range(8): await pg.mouse.wheel(0, 3000) await asyncio.sleep(random.uniform(1, 3)) ds = [] for the in await pg.locator('div[role="article"]').all(): ten = await the.locator(".qBF1Pd").first.text_content() diem = await the.locator(".MW4etd").first.text_content() dia_chi = await the.locator(".W4Efsd span").last.text_content() link = await the.locator("a").first.get_attribute("href") lat, lng = toa_do(link) ds.append({"ten": ten, "diem": diem, "dia_chi": dia_chi, "lat": lat, "lng": lng}) await br.close() return dsjson.dump(asyncio.run(cao("plumber in London")), open("maps.json", "w", encoding="utf-8"), ensure_ascii=False, indent=2)
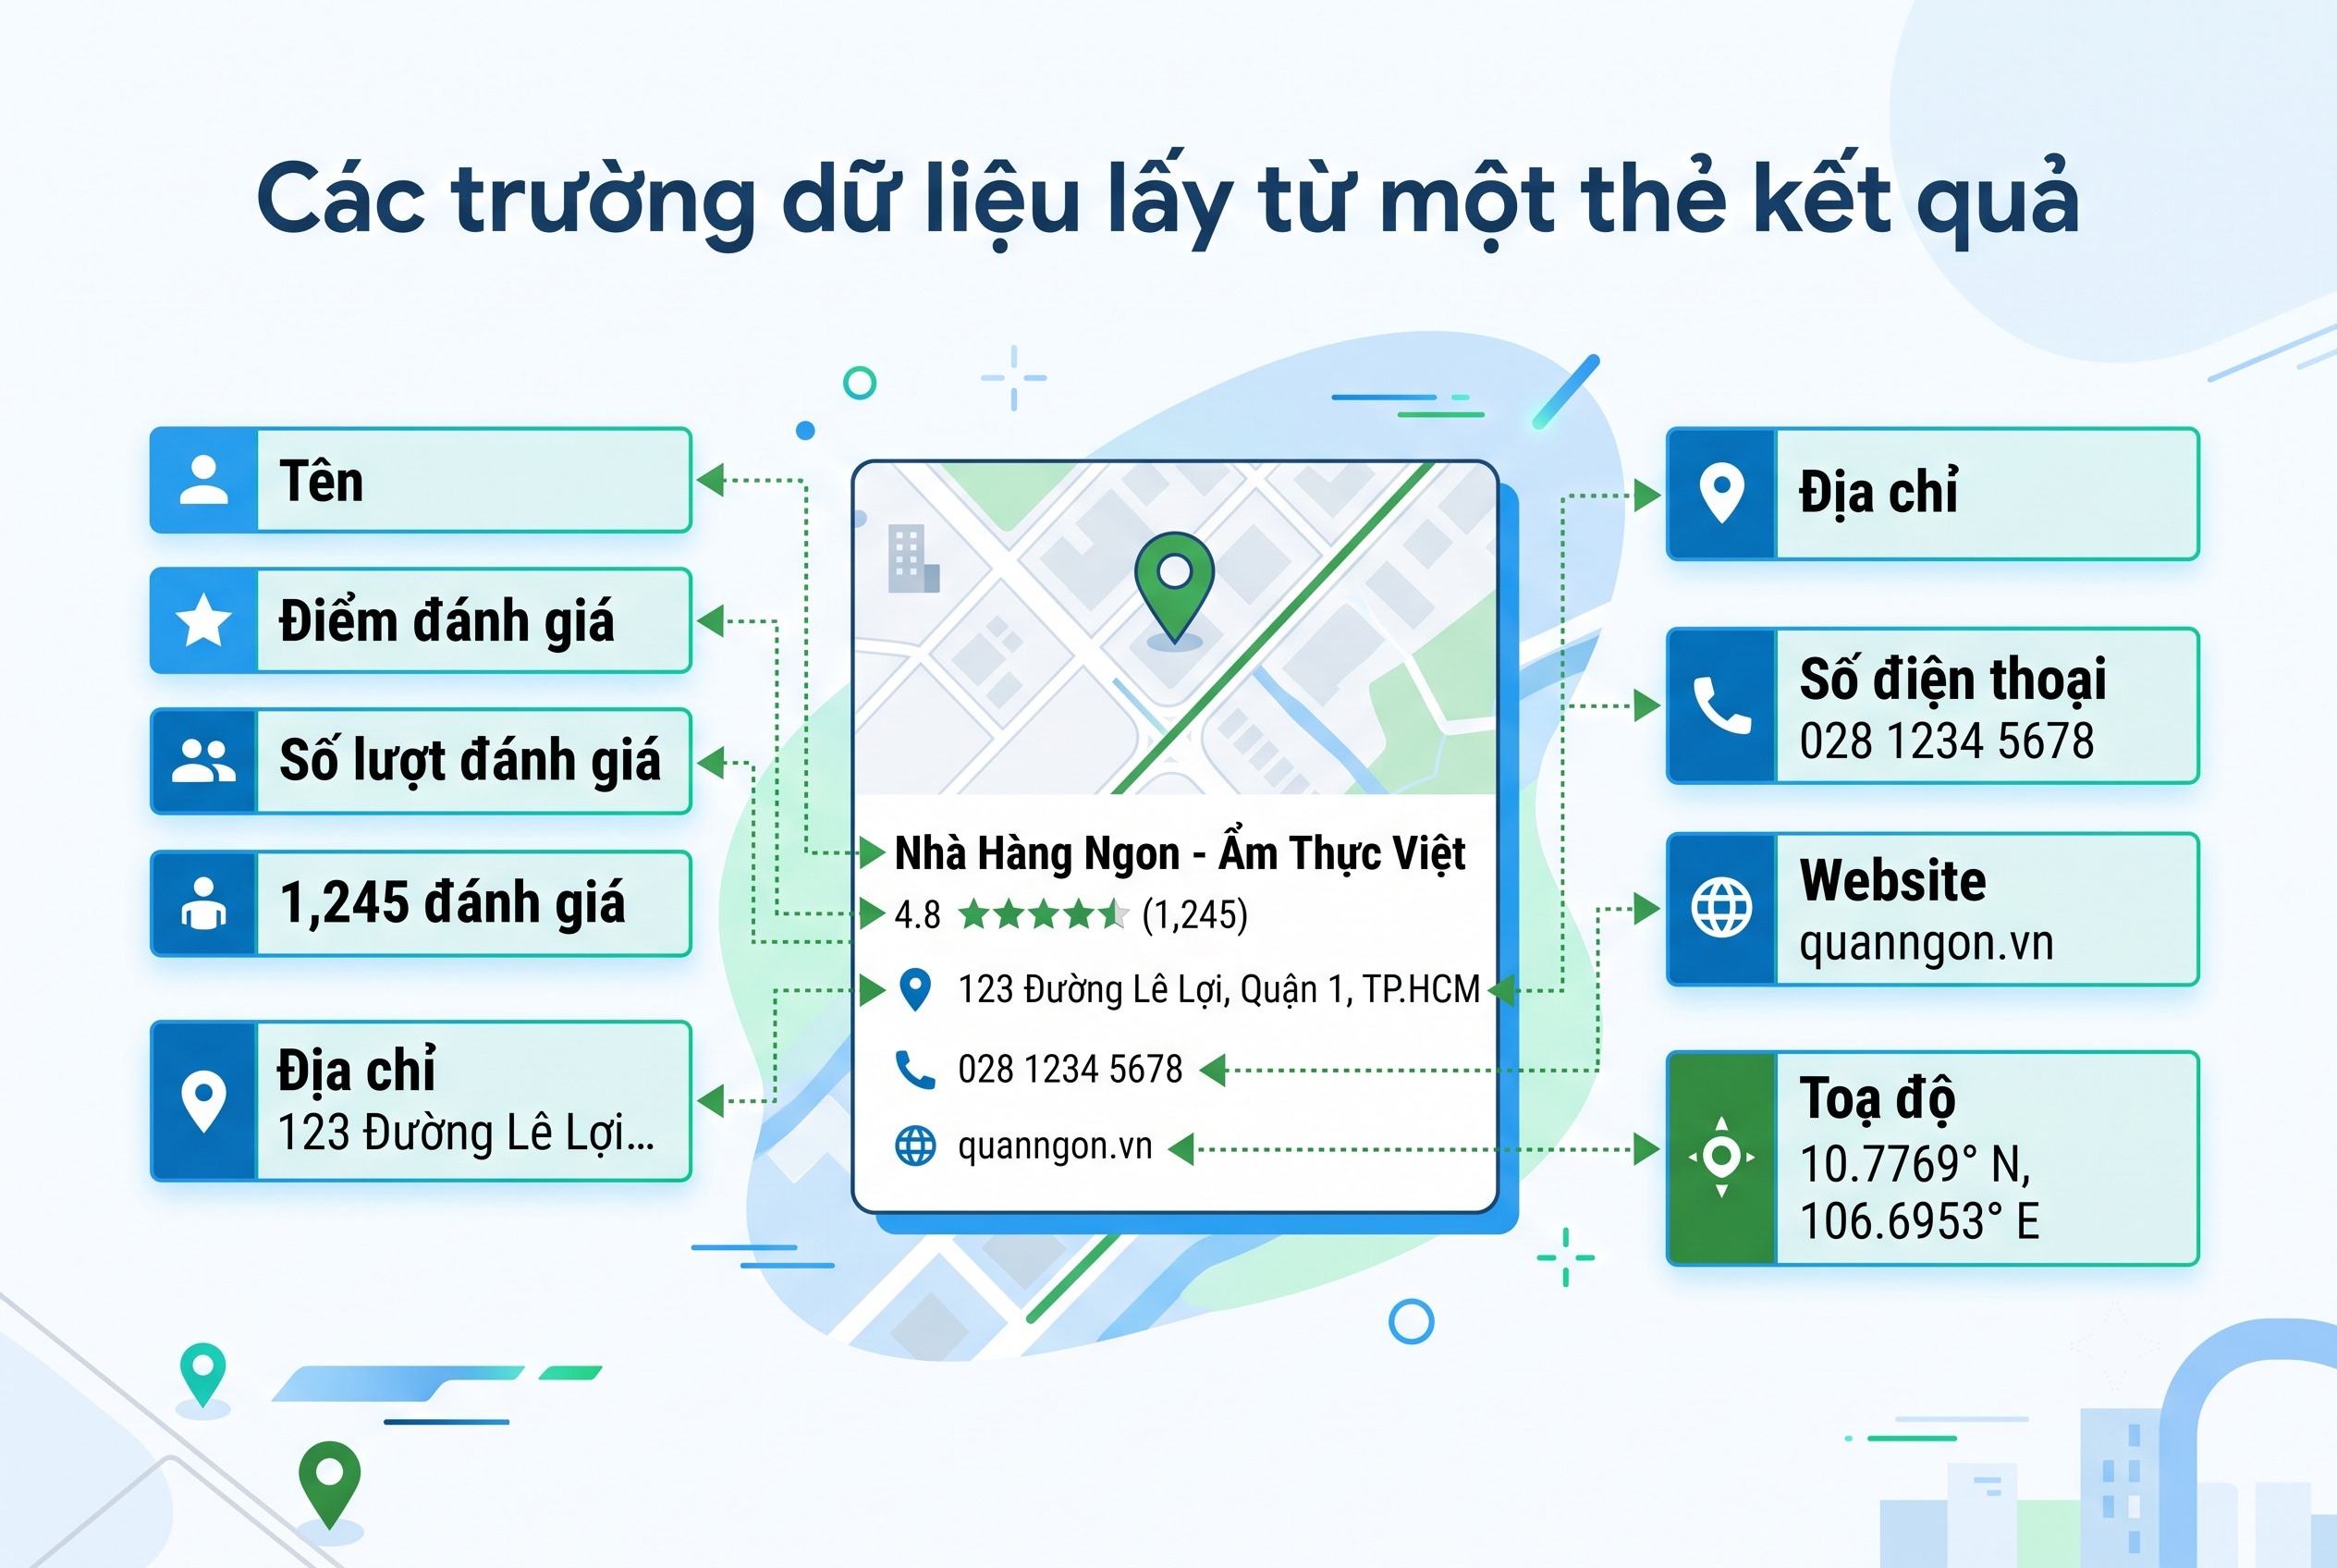
Các trường dữ liệu lấy từ một thẻ kết quả
Lịch chạy và quy mô khi proxy scraping Google Maps
Lập danh sách cho một thành phố lớn là hàng nghìn truy vấn. Cần chia nhỏ và rải đều để không dồn tải lên ít IP.
Chia khu vực theo ô lưới địa lý
Phủ khu vực cần lấy bằng một lưới ô vuông, mỗi ô là một truy vấn riêng với từ khóa kèm tên phường hoặc tọa độ trung tâm ô. Cách này vừa lách được giới hạn số kết quả mỗi truy vấn, vừa cho phép giao mỗi ô cho một nhóm IP khác nhau.
Giới hạn số listing mỗi truy vấn
Một truy vấn Maps chỉ trả về một số hữu hạn địa điểm dù khu vực có nhiều hơn. Đừng cố cuộn mãi để ép ra thêm; thay vào đó thu nhỏ phạm vi mỗi truy vấn bằng lưới dày hơn. Ghi lại số kết quả mỗi ô để biết ô nào còn sót.
Chạy định kỳ để theo dõi thay đổi
Nếu mục tiêu là theo dõi điểm đánh giá hoặc doanh nghiệp mới mở, lên lịch chạy lại mỗi tuần hoặc mỗi tháng, so với lần trước bằng một khóa ổn định như tên cộng địa chỉ. Không cần cào lại toàn bộ mỗi ngày.
Giữa các lần chạy, lưu lại số ô đã cào, số bản ghi mỗi ô và ngày cào vào một bảng theo dõi. Khi một ô bỗng trả về ít hơn hẳn lần trước, đó là dấu hiệu ô đó bị chặn hoặc bộ chọn hỏng, cần chạy lại riêng ô đó thay vì chạy lại cả thành phố.
Proxy scraping Google Maps hay dùng Places API
Google có bộ API chính thức cho dữ liệu bản đồ. Hai hướng có ưu nhược khác nhau, và nhiều dự án dùng cả hai.
Khi nào API chính thức phù hợp hơn
Bài của IPRoyal về dùng Google Maps API với Python nêu các API như Places, Geocoding, Distance Matrix, Directions, Autocomplete. API cho dữ liệu ổn định, có phiên bản hóa, không lo bộ chọn hỏng, phù hợp khi tích hợp vào ứng dụng và khi khối lượng nằm trong hạn mức.
Chi phí và hạn mức của API
API tính tiền theo số lệnh gọi, có một lượng miễn phí mỗi tháng theo gói, ví dụ hàng nghìn lệnh Geocoding hoặc Places rồi tính phí cho phần vượt. Cài đặt gồm tạo dự án trên Google Cloud Console, bật API cần dùng, tạo khóa, đặt giới hạn khóa và liên kết tài khoản thanh toán.
API cào SERP như một lớp trung gian
Ngoài hai thái cực tự cào và API chính thức, còn một lớp giữa là các API cào bên thứ ba. Tài liệu cào Google Search của Decodo cho gửi một yêu cầu POST kèm tham số như target, query, locale, page_from, num_pages, rồi nhận về kết quả gồm cả gói địa điểm địa phương. Lớp này lo phần proxy và vượt CAPTCHA, tính tiền theo request thành công, giới hạn tốc độ từ khoảng mười tới năm mươi request mỗi giây tùy gói. Hợp khi không muốn tự bảo trì trình cào nhưng vẫn cần linh hoạt hơn API chính thức.
Kết hợp cả hai
Cách thường dùng: cào để lấy danh sách rộng và các trường mà API không trả, rồi dùng Geocoding API để chuẩn hóa địa chỉ thành tọa độ chính xác. Phần nào cần đúng điều khoản và ổn định lâu dài thì để API, phần nào cần khối lượng và linh hoạt thì tự cào.
|
Tiêu chí |
Tự cào qua proxy |
Places API chính thức |
|---|---|---|
|
Chi phí |
Trả cho proxy theo băng thông |
Trả theo lệnh gọi, có hạn mức miễn phí |
|
Trường dữ liệu |
Bất cứ gì hiển thị trên giao diện |
Theo tài liệu API, một số trường không có |
|
Ổn định |
Hỏng khi Google đổi giao diện |
Ổn định, có phiên bản hóa |
|
Giới hạn |
Ngưỡng chống bot, cần xoay IP |
Hạn mức và quota theo gói |
|
Hợp với |
Khối lượng lớn, trường lạ |
Tích hợp ứng dụng, cần đúng điều khoản |
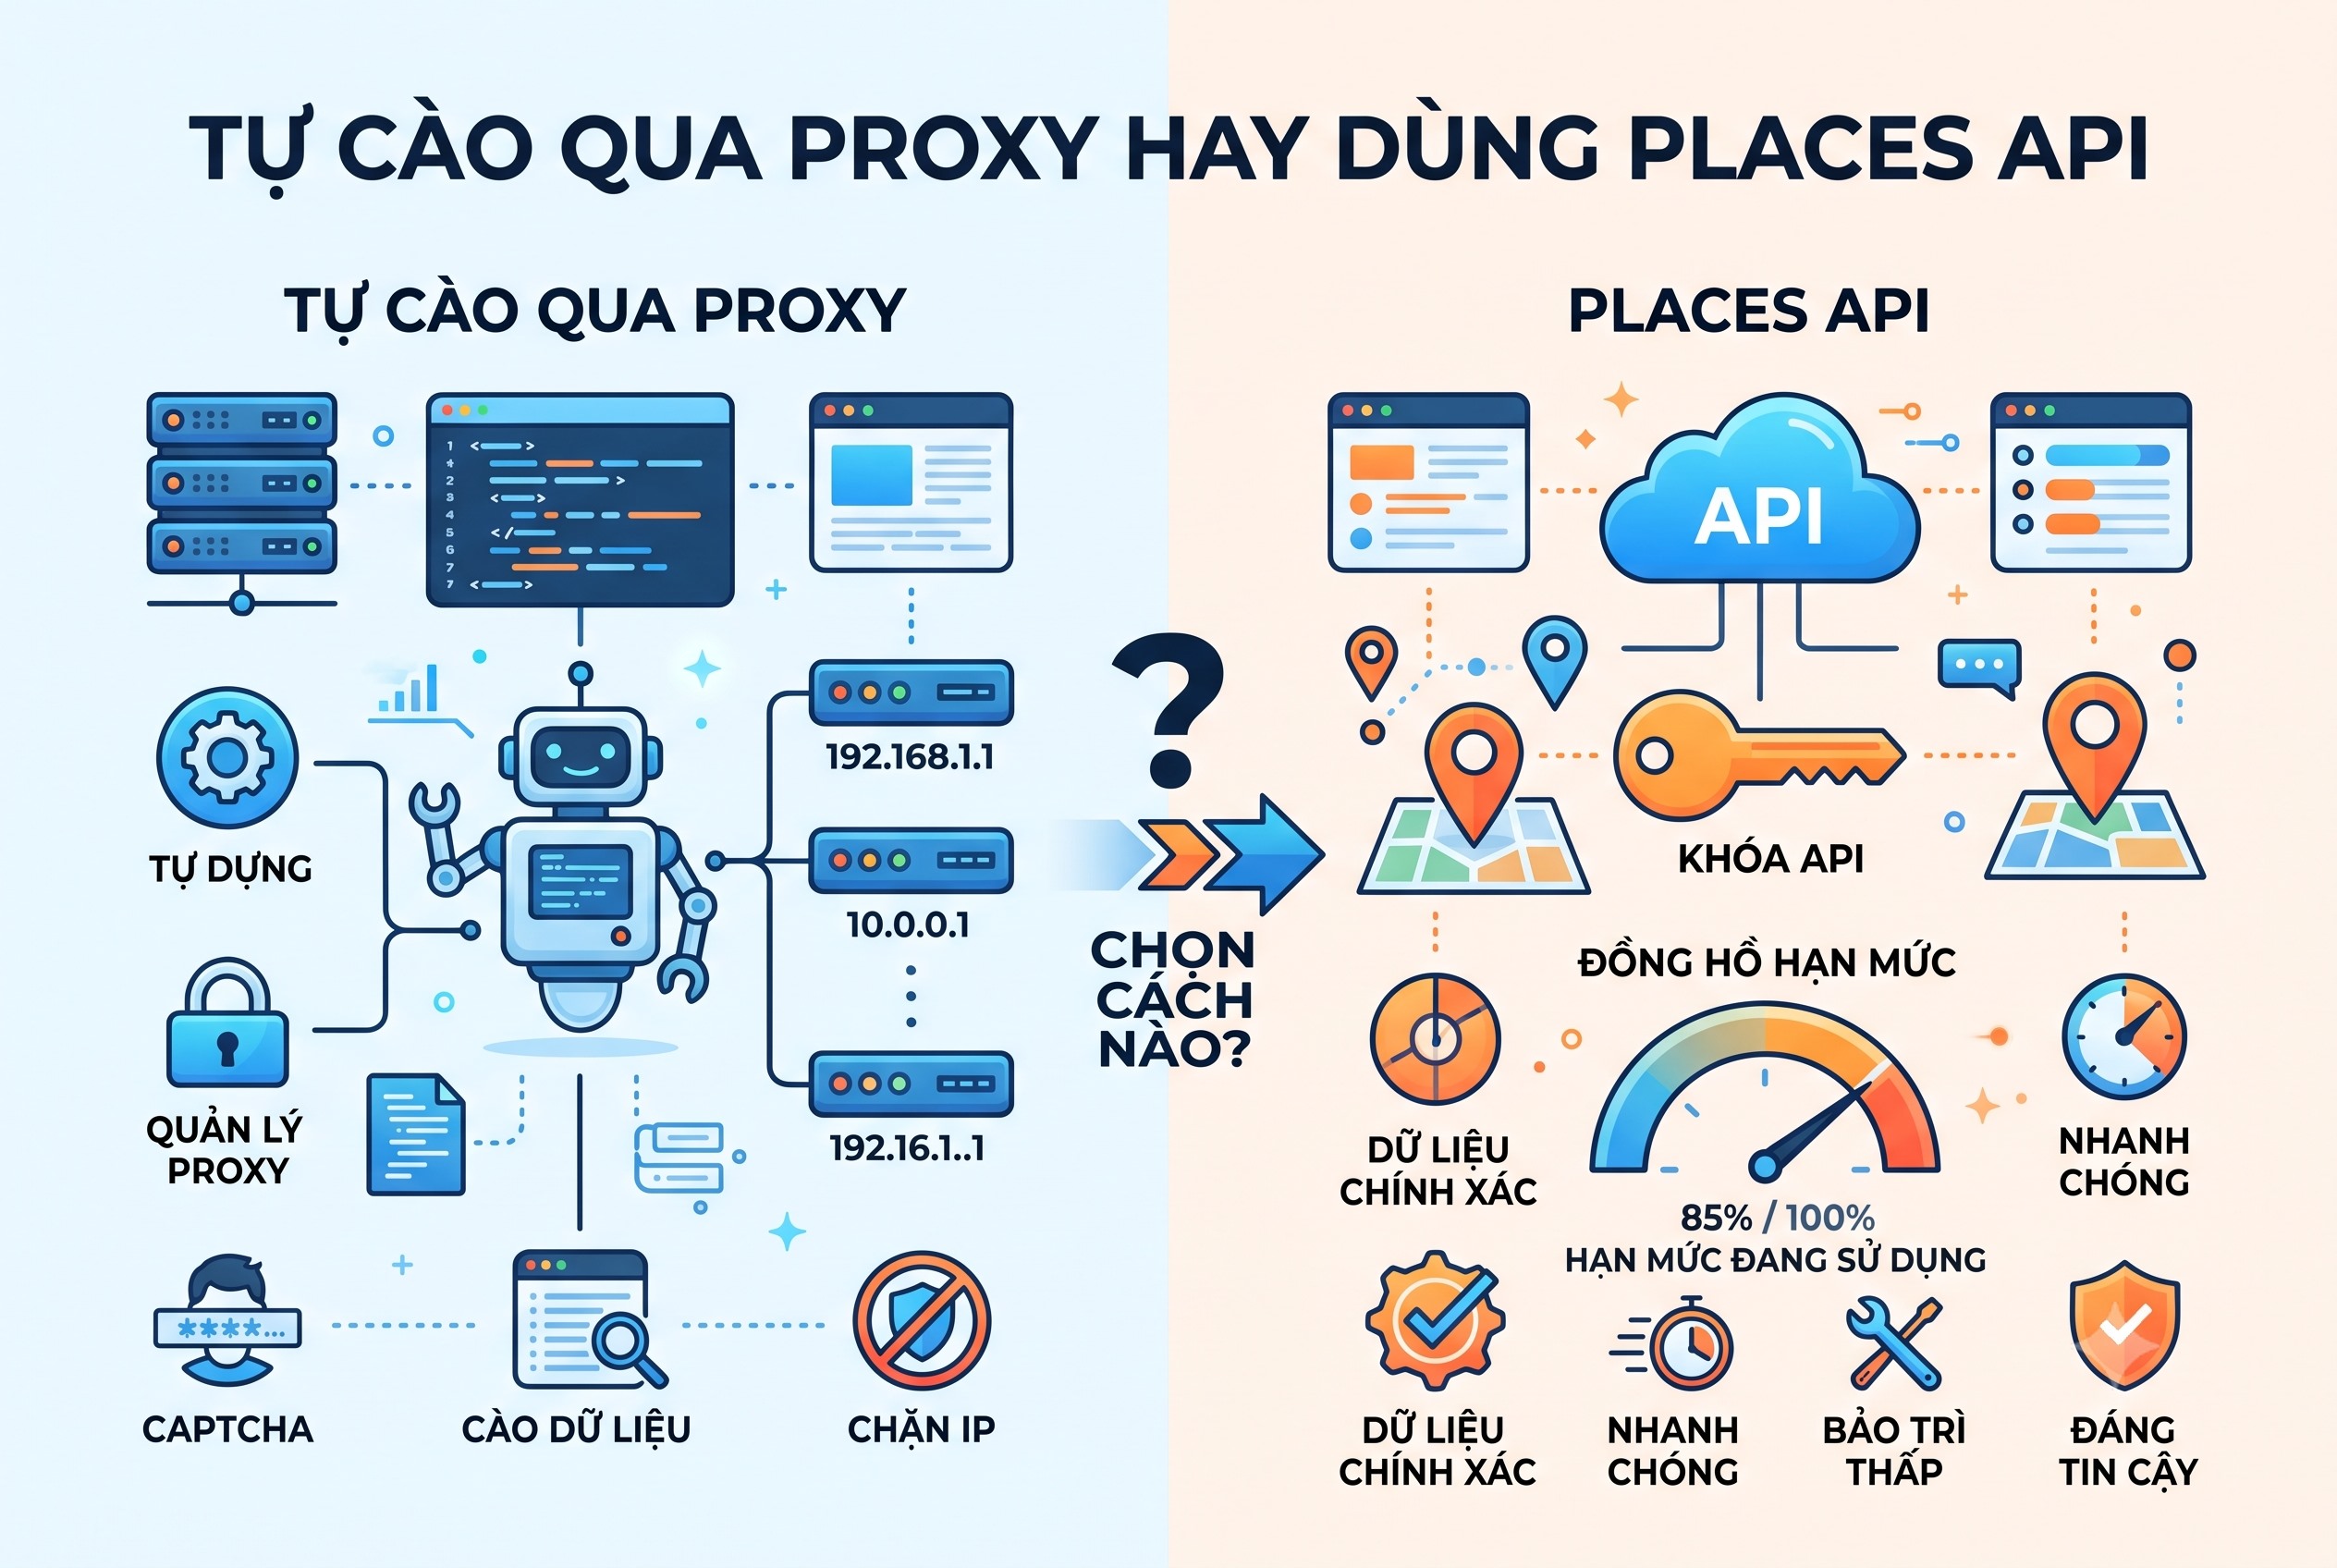
Tự cào qua proxy hay dùng Places API
Lỗi thường gặp khi proxy scraping Google Maps
Vài lỗi khiến dữ liệu thiếu hoặc trình cào bị chặn sớm.
Cào quá nhanh trên một IP
Mở hàng chục địa điểm mỗi phút từ một địa chỉ là chạm ngưỡng ngay. Giảm số luồng trên một IP, thêm độ trễ thật giữa các thao tác, và chia truy vấn ra nhiều IP thay vì ép một địa chỉ chạy nhanh. Khi bắt đầu thấy trang xác minh xuất hiện dày, dừng nhóm IP đó lại vài giờ chứ đừng đổi IP rồi chạy tiếp cùng nhịp, vì nhịp mới là thứ bị đếm. Bao nhiêu request mỗi IP thì bắt đầu dính 429 được bàn cụ thể trong bài lỗi 429 khi mua proxy.
Bộ chọn CSS hỏng khi Google đổi giao diện
Các lớp CSS như tên thẻ kết quả hay điểm đánh giá là chuỗi Google sinh tự động và đổi theo bản cập nhật. Khi trình cào bỗng trả về rỗng ở một trường, khả năng cao bộ chọn đã lỗi thời. Ghi log khi một trường trả về rỗng để phát hiện sớm.
Không cuộn hết bảng, tưởng đã lấy đủ
Dừng cuộn sau vài lần rồi kết luận đã lấy hết là sai khi khu vực còn nhiều địa điểm. Cuộn tới khi có dòng báo đã hết kết quả, hoặc dùng lưới ô nhỏ hơn để mỗi truy vấn nằm trong giới hạn.
Không khớp vùng IP với khu vực cần lấy
Tìm doanh nghiệp ở Hà Nội nhưng dùng IP nước ngoài cho ra danh sách sắp xếp theo khoảng cách tới nước đó, thiếu nhiều điểm địa phương. Luôn dùng proxy đặt trong hoặc gần khu vực đang lập danh sách.
Checklist rút gọn
-
Dùng proxy dân cư xoay, đặt ở đúng vùng cần lấy. Nguồn proxy dân cư xoay nhắm được tới quốc gia và thành phố có tại trang mua proxy.
-
Chấp nhận cookie, cuộn bảng kết quả từ từ, nghỉ ngẫu nhiên giữa thao tác.
-
Chia khu vực theo lưới ô để lách giới hạn số kết quả mỗi truy vấn.
-
Kiểm tra bộ chọn CSS định kỳ, ghi log khi trường trả về rỗng.
-
Cân nhắc Places API cho phần cần ổn định và đúng điều khoản.
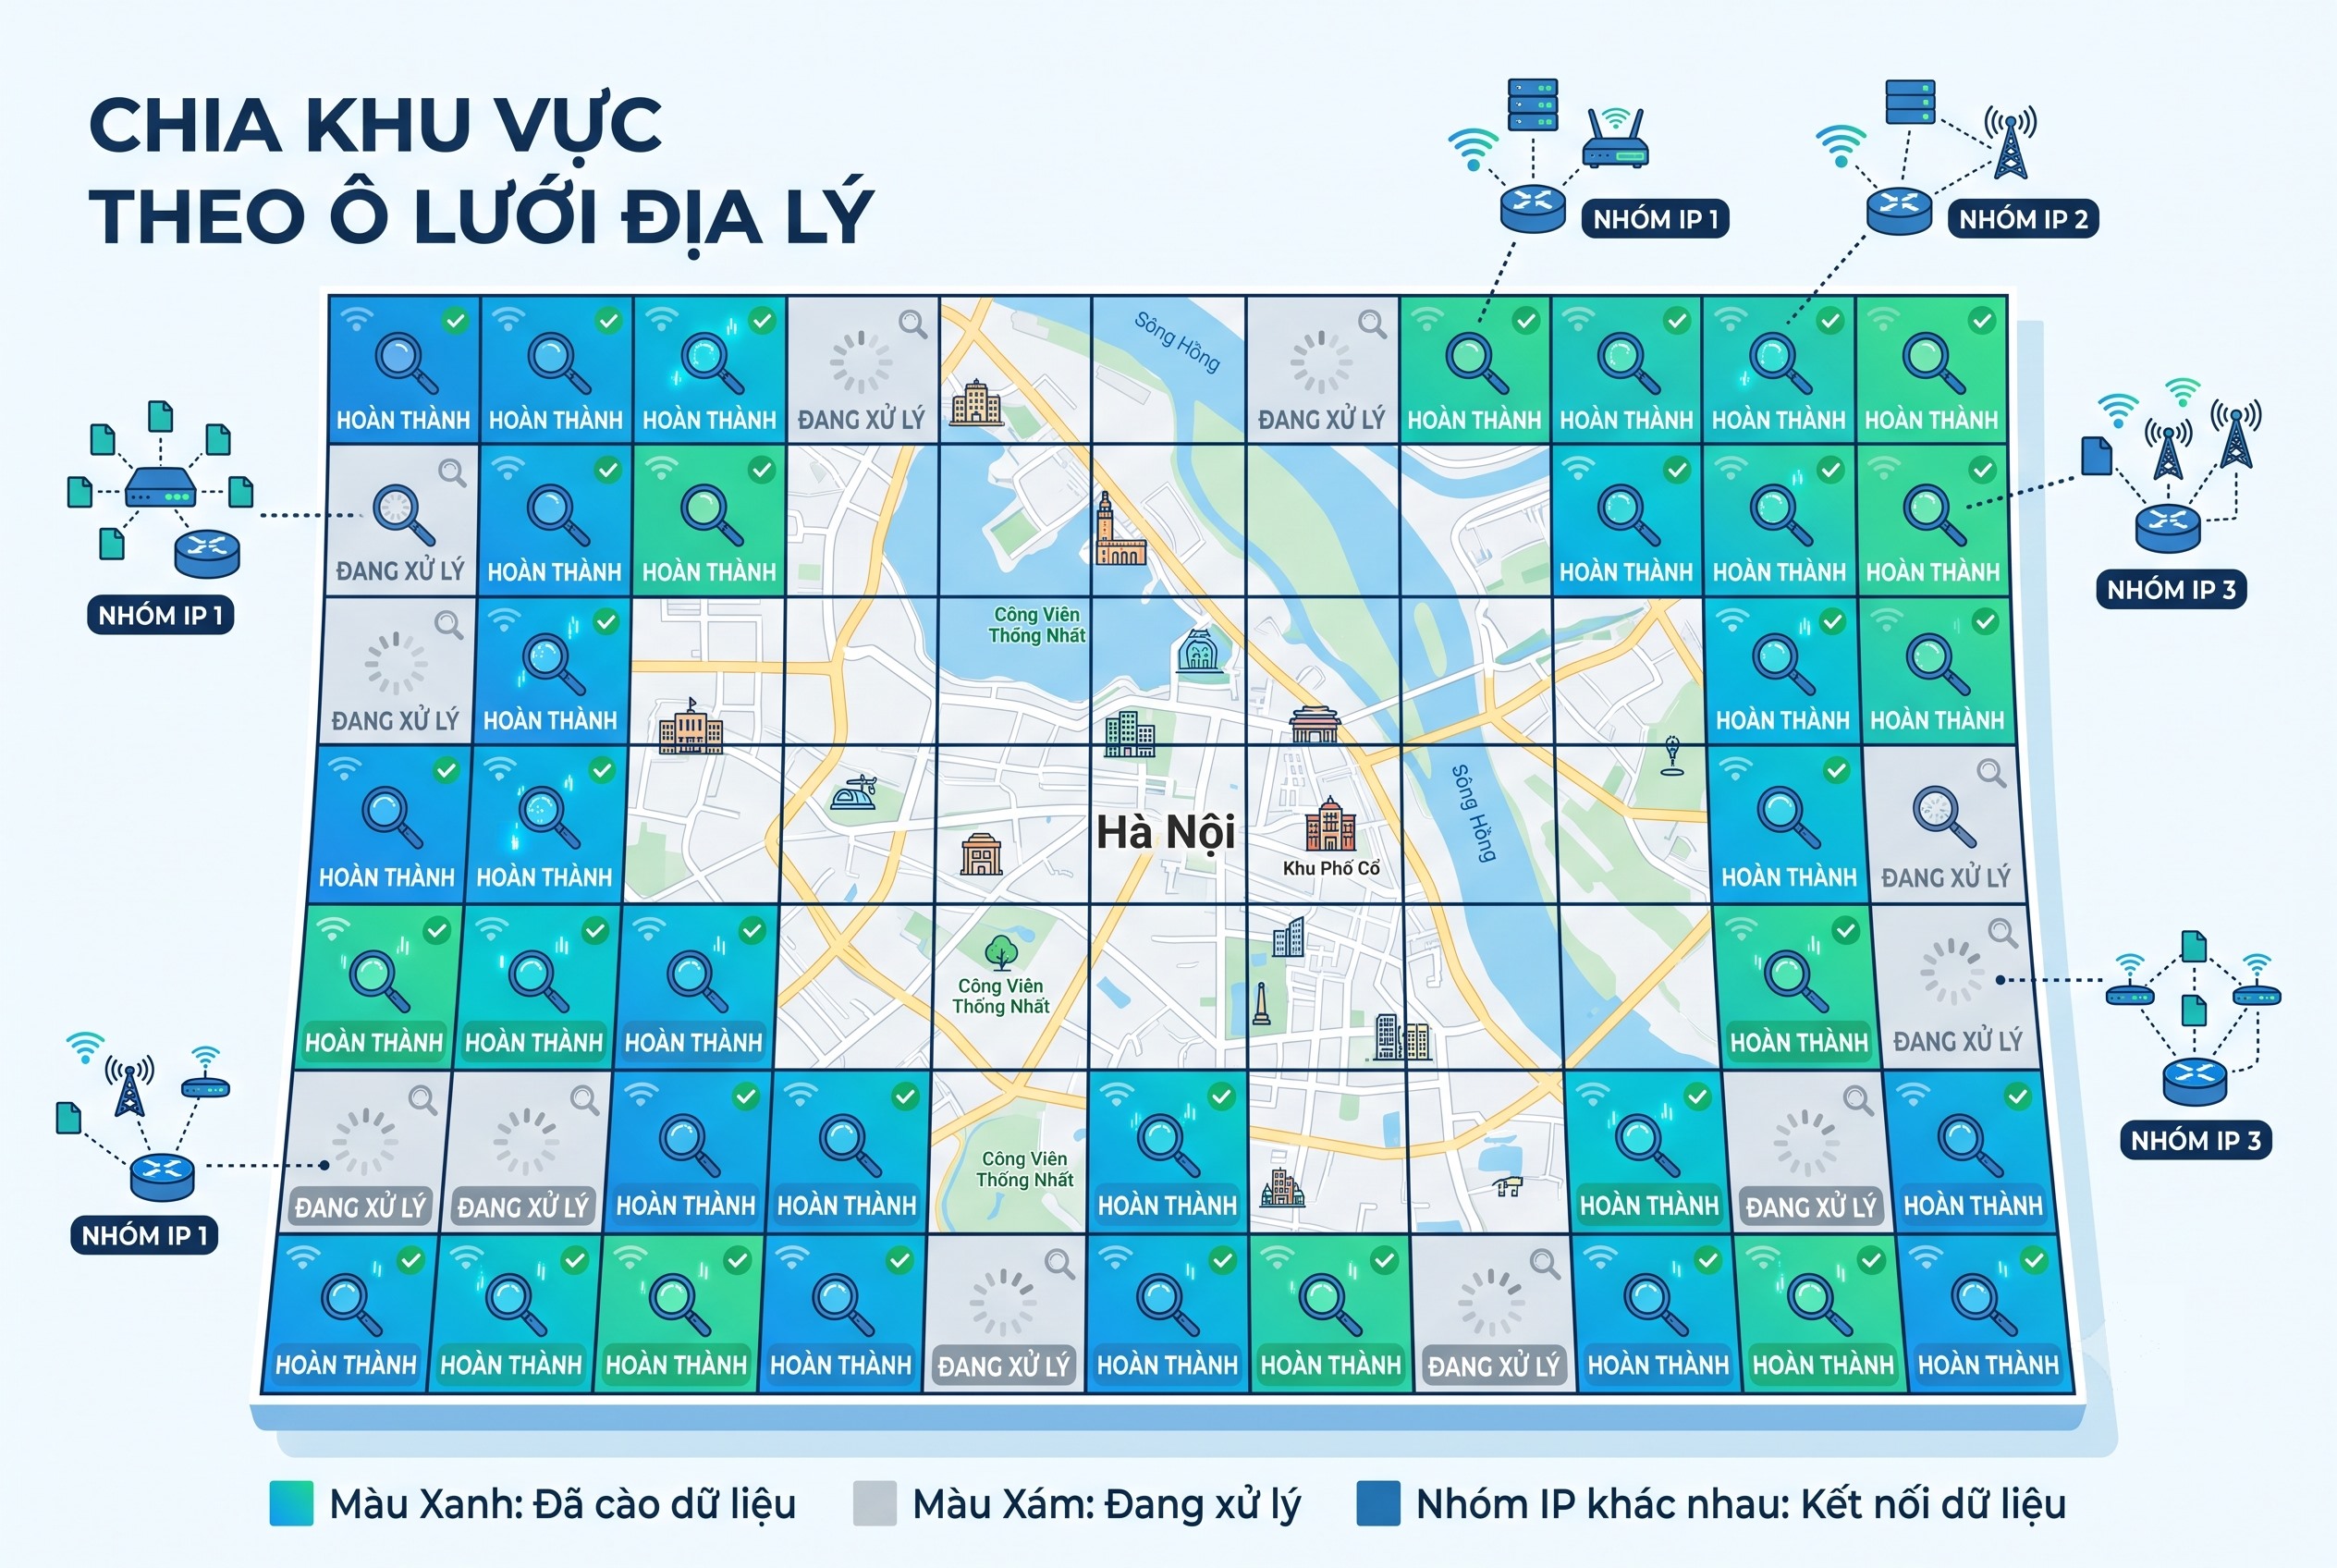
Chia khu vực theo ô lưới địa lý
Tóm lại, proxy scraping Google Maps là dùng proxy dân cư xoay đặt đúng vùng, điều khiển trình duyệt tự động với nhịp giống người, chia khu vực theo lưới ô, và cập nhật bộ chọn mỗi khi Google đổi giao diện. Với phần cần ổn định lâu dài, cân nhắc kết hợp Places API. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam tư vấn anh em chọn proxy theo khu vực và quy mô dữ liệu cần thu thập.


