
pandas read_html proxy tải HTML và kiểm tra bảng dữ liệu
pandas read_html proxy nên được triển khai bằng cách tải HTML qua HTTP client rồi chuyển nội dung cho pandas. ProxyVN hướng dẫn anh em chọn đúng bảng, giữ mã có số không đầu và kiểm tra giá trước khi xuất CSV. Ví dụ dùng dữ liệu tự tạo, có kiểm tra cục bộ, đồng thời phân biệt rõ phần đã chạy với phần cần nghiệm thu trên endpoint thật.
pandas read_html proxy và ranh giới giữa tải với đọc bảng
read_html có nhiệm vụ nhận tài liệu HTML và tìm các bảng có thể chuyển thành DataFrame. Nó không phải giao diện quản lý pool proxy hay trình duyệt thực thi JavaScript. Khi công việc cần xác thực gateway, giới hạn kích thước hoặc ghi lỗi mạng riêng, tách bước tải là cách dễ kiểm tra.
Đầu ra luôn cần được chọn có chủ đích
Theo API pandas.read_html, giá trị trả về là danh sách các DataFrame. Một trang có thể chứa bảng bố cục, bảng chú giải và bảng dữ liệu cùng lúc. Lấy phần tử đầu tiên chỉ đúng khi đã xác nhận bảng đầu chính là dữ liệu cần đọc, không phải quy tắc chung.
Anh em nên xác định bảng bằng thuộc tính hoặc văn bản có ý nghĩa rồi kiểm tra số bảng khớp. Một điều kiện chặt làm chương trình dừng khi trang đổi cấu trúc, thay vì tiếp tục tạo tệp sai. Với dữ liệu vận hành, lỗi được báo rõ thường dễ sửa hơn một tệp nhìn giống kết quả hợp lệ nhưng chứa bảng phụ.
Một DataFrame có nhiều dòng cũng chưa chứng minh thu thập thành công. Cần kiểm tra tên cột, kiểu dữ liệu, khóa nghiệp vụ và giá trị bắt buộc. Nếu website trả trang đăng nhập có bảng hướng dẫn, read_html vẫn có thể đọc ra bảng, nhưng kết quả không đáp ứng công việc ban đầu.
Tách HTTP giúp giữ bằng chứng của từng lớp
Lớp tải nên trả nội dung HTML đã được kiểm tra sơ bộ, còn lớp đọc bảng trả dữ liệu có cấu trúc. Giữa hai lớp có thể lưu mẫu phản hồi phù hợp để chẩn đoán. Nhờ vậy, lỗi proxy, sai encoding và bảng đổi tiêu đề không bị gom vào cùng một thông báo không đọc được dữ liệu.
Thiết kế này còn giúp chạy kiểm tra bằng fixture mà không truy cập website. Anh em có thể thử bảng thiếu cột hay giá không hợp lệ trên máy phát triển. Các kiểm tra như vậy chứng minh quy tắc xử lý dữ liệu; chúng không thay thế phép đo đường ra hoặc xác thực của một dịch vụ proxy thương mại.
Chọn đúng bảng trước, xác nhận schema sau, rồi mới chuyển đổi số và xuất tệp cho người dùng.
pandas read_html proxy với môi trường và dữ liệu mẫu
Để tái tạo ví dụ, cần ghi phiên bản Python, pandas và parser HTML đang dùng. Phần kiểm tra cục bộ của bài được chạy với pandas 3.0.1 và lxml 6.1.1. Tài liệu trực tuyến được đối chiếu riêng tại ngày biên tập; phiên bản tài liệu mới hơn không được trình bày thành phiên bản đã chạy.
Cài parser phù hợp với lựa chọn flavor
Ví dụ chọn flavor lxml để hành vi parser có phạm vi rõ. Nếu dự án dùng BeautifulSoup và html5lib, cần cài đúng phụ thuộc rồi kiểm tra lại fixture. Đừng thay parser chỉ để làm exception biến mất mà không đối chiếu kết quả, nhất là với bảng có cấu trúc lồng hoặc HTML không chuẩn.
Hướng dẫn HTML trong pandas IO tools giải thích cách chọn bảng, xử lý header và những điểm cần lưu ý của parser. Anh em nên giữ phiên bản phụ thuộc trong hồ sơ dự án. Khi nâng thư viện, chạy lại tập mẫu trước khi dùng kết quả của lần mới thay bản dữ liệu đang vận hành.
python -m pip install pandas lxml
python -c "import pandas,lxml; print(pandas.__version__,lxml.__version__)"
Fixture có hai bảng để tránh chọn nhầm
Mẫu HTML sau được tự tạo cho bài hướng dẫn. Bảng layout xuất hiện trước, còn bảng prices mới là dữ liệu cần lấy. Mã sản phẩm có số không đầu để kiểm tra việc chuyển kiểu, trong khi giá dùng dấu chấm phân cách hàng nghìn theo quy tắc của riêng fixture này.
<!doctype html><html><head><meta charset="utf-8"></head>
<body><table id="layout"><tr><td>Menu</td></tr></table>
<table id="prices"><thead><tr><th>SKU</th><th>Tên</th>
<th>Giá VND</th></tr></thead><tbody>
<tr><td>0012</td><td>Bộ A</td><td>125.000</td></tr>
<tr><td>0013</td><td>Cáp B</td><td>89.000</td></tr>
</tbody></table></body></html>
Kỳ vọng kiểm tra là hai dòng với mã giữ nguyên 0012 và 0013, giá số tương ứng 125000 và 89000. Đây là hệ quả của dữ liệu mẫu, không phải giá của sản phẩm trên thị trường. Việc có bảng layout đứng trước giúp phát hiện ngay cách làm lấy tables[0] mà chưa lọc đúng vùng dữ liệu.
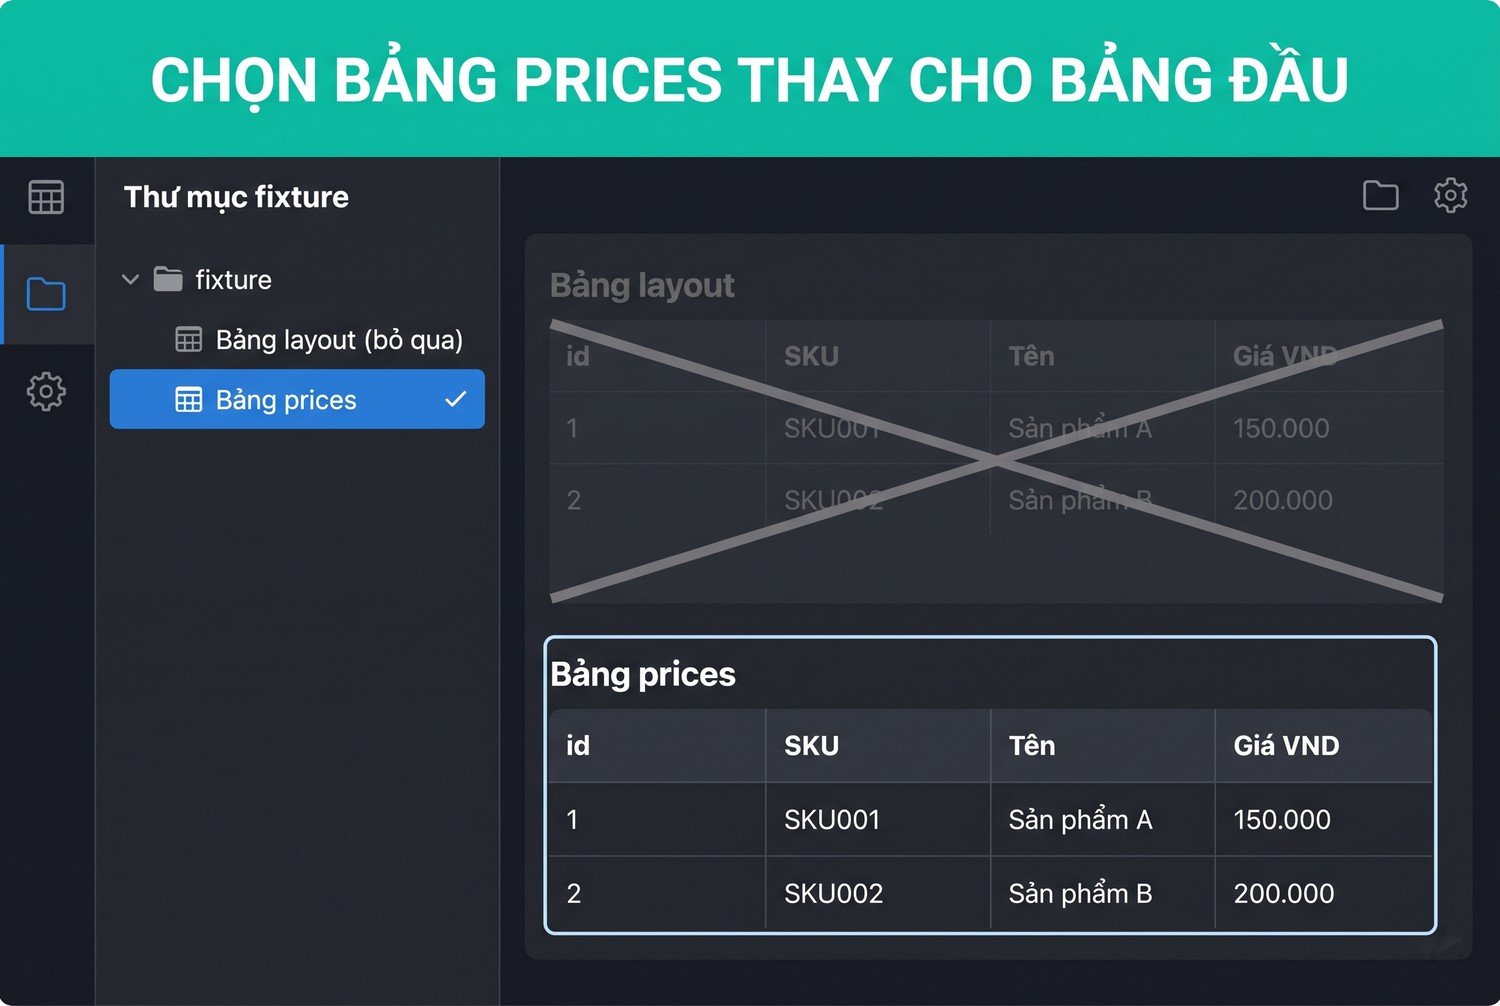
Chọn bảng prices thay cho bảng đầu
pandas read_html proxy với StringIO và schema bảng
Khi đã có chuỗi HTML, nên bọc bằng StringIO để cung cấp đối tượng giống tệp cho read_html. Cách này thể hiện rõ đầu vào là nội dung, tránh sự nhập nhằng với đường dẫn hoặc URL trong các phiên bản khác nhau. Không dựa vào ví dụ cũ truyền chuỗi HTML trần mà chưa kiểm tra phiên bản.
Một hàm parse có điều kiện đầu ra
StringIO trong thư viện chuẩn Python cung cấp luồng văn bản trong bộ nhớ. Ví dụ dưới dùng nó để đọc fixture, lọc bảng có id prices và yêu cầu đúng ba cột. Bộ chuyển đổi giữ SKU cùng giá ở dạng chuỗi trước khi áp quy tắc kiểm tra riêng.
from io import StringIO
import pandas as pd

def parse_prices(html):
    tables = pd.read_html(StringIO(html), attrs={'id': 'prices'},
        flavor='lxml', converters={'SKU': str, 'Giá VND': str},
        keep_default_na=False)
    if len(tables) != 1:
        raise ValueError('Expected exactly one prices table')
    frame = tables[0]
    if list(frame.columns) != ['SKU', 'Tên', 'Giá VND']:
        raise ValueError('Unexpected table columns')
    if frame.empty:
        raise ValueError('Prices table is empty')
    frame['SKU'] = frame['SKU'].str.strip()
    frame['Tên'] = frame['Tên'].astype(str).str.strip()
    if frame['SKU'].eq('').any() or frame['Tên'].eq('').any():
        raise ValueError('Missing SKU or name')
    if frame['SKU'].duplicated().any():
        raise ValueError('Duplicate SKU')
    raw = frame['Giá VND'].astype(str)
    if not raw.str.fullmatch(r'[0-9]+(?:\.[0-9]{3})*').all():
        raise ValueError('Unexpected VND price format')
    frame['Giá VND'] = pd.to_numeric(
        raw.str.replace('.', '', regex=False), errors='raise'
    ).astype('Int64')
    return frame
Hàm này cố ý dừng khi dữ liệu lệch hợp đồng. Với ứng dụng cần giữ các dòng lỗi để biên tập, anh em có thể tách nhóm đạt và nhóm cần xem thay vì ném exception cho cả bảng. Dù chọn cách nào, báo cáo phải thể hiện số dòng bị loại và lý do, không âm thầm biến lỗi thành ô trống.
Giữ giá nguyên bản trước khi suy luận kiểu
Trong lần kiểm tra cục bộ đầu tiên, giá chưa có converter bị pandas suy luận thành số trước bước kiểm tra định dạng, khiến quy tắc chuỗi không còn nhận dữ liệu gốc. Bổ sung converter cho cột giá giữ đúng thứ tự: đọc chuỗi, xác nhận mẫu rồi chuyển số. Đây là lỗi của cách dựng ví dụ đã được sửa, không phải kết luận pandas không đọc được giá.
Khi đưa vào công việc thật, nên lưu thêm giá nguyên bản nếu cần truy nguyên. Không xóa dấu phân cách trong mọi chuỗi chỉ vì fixture dùng dấu chấm. Một nguồn khác có dấu chấm thập phân sẽ cho ý nghĩa khác, nên quy tắc số phải gắn với từng nguồn và tiền tệ.
pandas read_html proxy với HTTP client riêng
Một lời gọi read_html không có tham số proxies tương tự Requests. Để kiểm soát gateway rõ, anh em có thể dùng urllib.request hoặc Requests tải nội dung trước rồi đưa chuỗi vào hàm parse. Bài này minh họa urllib trong thư viện chuẩn, giúp phép thử cục bộ không cần thêm gói HTTP bên ngoài.
Tạo opener có cấu hình proxy tường minh
Tài liệu ProxyHandler của urllib.request mô tả ánh xạ giao thức đích sang URL proxy. Trong mẫu, cả HTTP và HTTPS dùng cùng một HTTP gateway. Khóa https chỉ nhóm URL đích, không yêu cầu chuỗi gateway cũng phải có scheme https.
from urllib.parse import urlsplit
from urllib.request import ProxyHandler, Request, build_opener

def fetch_html(url, proxy_url):
    if urlsplit(url).scheme not in {'http', 'https'}:
        raise ValueError('Unsupported target scheme')
    if urlsplit(proxy_url).scheme != 'http':
        raise ValueError('This example expects an HTTP proxy')
    opener = build_opener(ProxyHandler({
        'http': proxy_url, 'https': proxy_url,
    }))
    request = Request(url, headers={'Accept': 'text/html'})
    with opener.open(request, timeout=20) as response:
        if response.headers.get_content_type() != 'text/html':
            raise ValueError('Expected HTML response')
        raw = response.read(2_000_001)
        if len(raw) > 2_000_000:
            raise ValueError('HTML exceeds example size limit')
        encoding = response.headers.get_content_charset() or 'utf-8'
    return raw.decode(encoding)
Hàm này kiểm tra scheme, kiểu nội dung và số byte trước khi giải mã. Giới hạn hai triệu byte là lựa chọn của ví dụ, không phải giới hạn pandas hay dịch vụ proxy. Timeout của urllib dành cho các thao tác blocking theo API, không phải cam kết toàn bộ lô sẽ hoàn tất trong hai mươi giây.
Opener mặc định có thể xử lý chuyển hướng, nên công việc giới hạn hostname cần bổ sung chính sách redirect phù hợp. Ngoài ra, biến no_proxy có thể ảnh hưởng các đích loại trừ. Anh em phải đo tuyến với URL đại diện thay vì suy ra mọi request đều đi gateway chỉ vì mã đã tạo ProxyHandler.
Cấp thông tin xác thực mà không đưa vào bài
Nếu HTTP proxy yêu cầu tài khoản, urllib hỗ trợ các cách cấp thông tin tương ứng, bao gồm URL có userinfo được xử lý đúng. Mật khẩu chứa ký tự đặc biệt cần mã hóa từng thành phần trước khi ghép, không đưa chuỗi host:port:user:pass thô vào URL. Đối với ứng dụng cần cơ chế xác thực khác, kiểm tra đúng hỗ trợ của client cùng dịch vụ.
Đọc PROXY_URL từ nơi quản lý bí mật và che thông tin xác thực trong log trước khi dùng đoạn tích hợp sau.
import os

# fetch_html and parse_prices are the functions above.
html = fetch_html(os.environ['TARGET_URL'], os.environ['PROXY_URL'])
data = parse_prices(html)
print(data.shape)
Với HTTPS, hãy giữ kiểm tra chứng chỉ mặc định và nghiệm thu CONNECT cùng xác thực trên môi trường được cấp. Phép thử cục bộ trong bài dùng HTTP để kiểm tra cách chuyển request tới proxy giả lập; nó không đo TLS, SOCKS hay tính tương thích với một endpoint bán trên thị trường.
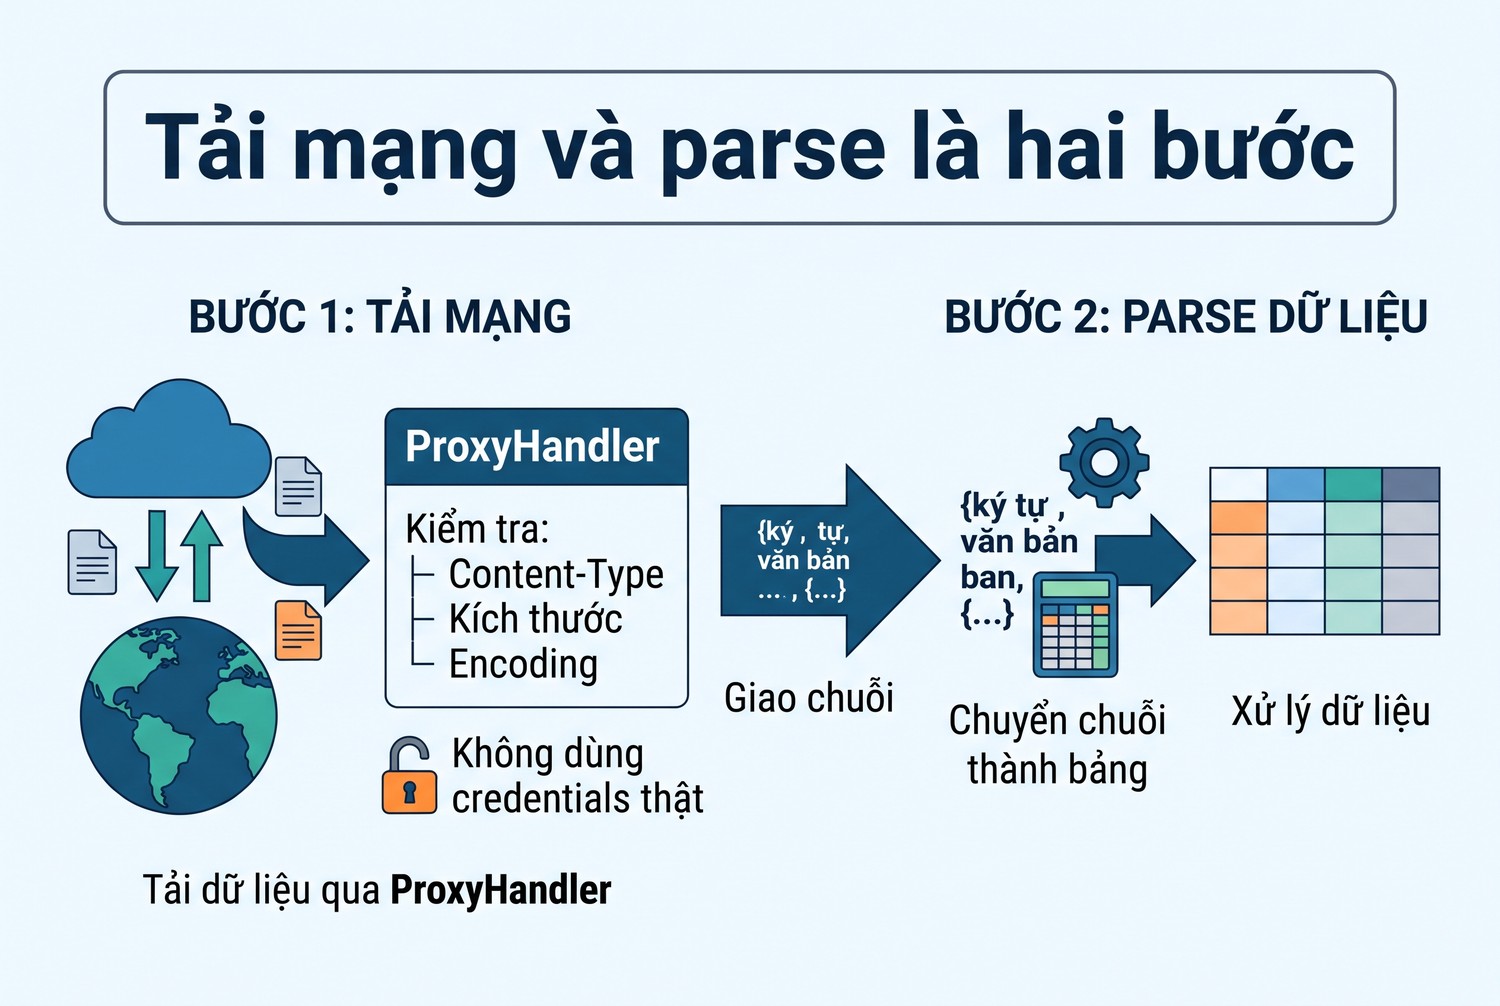
Tải mạng và parse là hai bước
pandas read_html proxy với match attrs và header
Một trang nhiều bảng cần quy tắc chọn có khả năng giải thích. attrs chọn theo thuộc tính thẻ table, còn match lọc theo văn bản bằng chuỗi hoặc biểu thức phù hợp. Sau khi chọn, vẫn phải kiểm tra schema; bộ lọc là cách tìm ứng viên, không phải lời bảo đảm nội dung luôn đúng.
Không phụ thuộc vị trí bảng trong trang
Khi website thêm bảng thông báo ở đầu, số thứ tự của bảng dữ liệu có thể thay đổi. Chọn theo id giúp fixture của bài không bị ảnh hưởng bởi bảng layout đứng trước. Nếu website không có id ổn định, anh em có thể lọc ứng viên theo cột hoặc văn bản rồi yêu cầu chỉ có một kết quả phù hợp.
Nếu hai bảng cùng khớp, hãy báo tình trạng mơ hồ thay vì tự chọn bảng có nhiều dòng hơn. Bảng nhiều dòng có thể là lịch sử hoặc bản tổng hợp, không phải dữ liệu hiện tại. Điều kiện phân biệt cần đến từ nghiệp vụ, chẳng hạn kỳ báo cáo hoặc tên khu vực được thể hiện trong tài liệu.
Đừng tạo biểu thức match quá rộng chỉ để mọi trang đều có kết quả. Một lần không tìm thấy bảng là tín hiệu cần xem nguồn. Giữ mẫu HTML phù hợp sẽ giúp nhận ra bảng đã đổi tiêu đề, bị chuyển sang JavaScript hoặc bị thay bằng trang từ chối truy cập.
Header nhiều tầng cần giữ ý nghĩa
Các bảng có nhiều hàng tiêu đề có thể tạo MultiIndex cho cột. Khi đó, việc so với danh sách tên đơn như fixture sẽ báo sai schema có chủ đích. Anh em cần định nghĩa cách giữ tầng hoặc làm phẳng tên cột mà không làm mất năm, đơn vị và nhóm chỉ tiêu.
Ví dụ, cột doanh thu cùng tên ở hai năm không thể được gộp chỉ thành doanh thu. Nếu làm phẳng, tên mới cần chứa đầy đủ ngữ cảnh và kiểm tra không trùng. Một bảng nhìn gọn hơn nhưng mất kỳ báo cáo sẽ khiến phép so sánh sau đó sai dù dữ liệu số không thay đổi.
skiprows, header và index_col cũng ảnh hưởng cách hàng được hiểu. Chỉ thêm chúng sau khi đã quan sát bảng cụ thể, rồi ghi kỳ vọng về số dòng và tên cột. Việc thử nhiều tổ hợp đến khi DataFrame trông đẹp có thể vô tình bỏ một dòng dữ liệu đầu hoặc lấy tổng cộng làm tiêu đề.
pandas read_html proxy với ô gộp và dữ liệu ẩn
HTML cho phép rowspan, colspan và các cấu trúc không giống bảng phẳng mà người dùng muốn nhận. read_html cố gắng diễn giải bảng, nhưng ý nghĩa nghiệp vụ của ô gộp vẫn cần kiểm tra. Đừng lấy việc không có exception làm bằng chứng mọi mối quan hệ giữa hàng và cột đã được giữ.
Kiểm tra giá trị được lặp từ ô gộp
Một ô khu vực kéo dài nhiều hàng có thể được điền lại trong DataFrame để tạo bảng chữ nhật. Cách diễn giải đó có ích cho phân tích nhưng cần đối chiếu tài liệu nguồn, đặc biệt khi dữ liệu có tổng nhóm. Nếu không nhận diện dòng tổng, cộng lại cả bảng có thể tính hai lần cùng một giá trị.
Đối với bảng lồng, nên xem rõ bảng cha và bảng con đang được parser nhận như thế nào. Chọn đúng table rồi chỉ đưa phần HTML đó vào StringIO có thể giúp giới hạn đầu vào. Tuy nhiên, việc tách cần giữ những hàng tiêu đề có ý nghĩa, tránh làm mất thông tin đơn vị nằm ở vùng xung quanh.
Bảng ẩn và JavaScript có ranh giới khác nhau
displayed_only ảnh hưởng việc xem các phần tử ẩn theo khả năng xử lý của parser. Nó không phải một engine CSS đầy đủ như browser. Một bảng được giấu bằng cơ chế phức tạp cần được quan sát riêng, thay vì suy ra giá trị mặc định luôn tương ứng với thứ người dùng nhìn thấy.
Nếu dữ liệu được JavaScript dựng thành div hoặc gọi từ API sau khi tải, read_html không tự chạy đoạn mã đó. Anh em cần lấy endpoint dữ liệu được phép dùng hoặc nội dung bảng sau khi browser dựng xong. Proxy chỉ đổi đường tải; nó không tạo thẻ table chưa có trong tài liệu được chuyển vào parser.
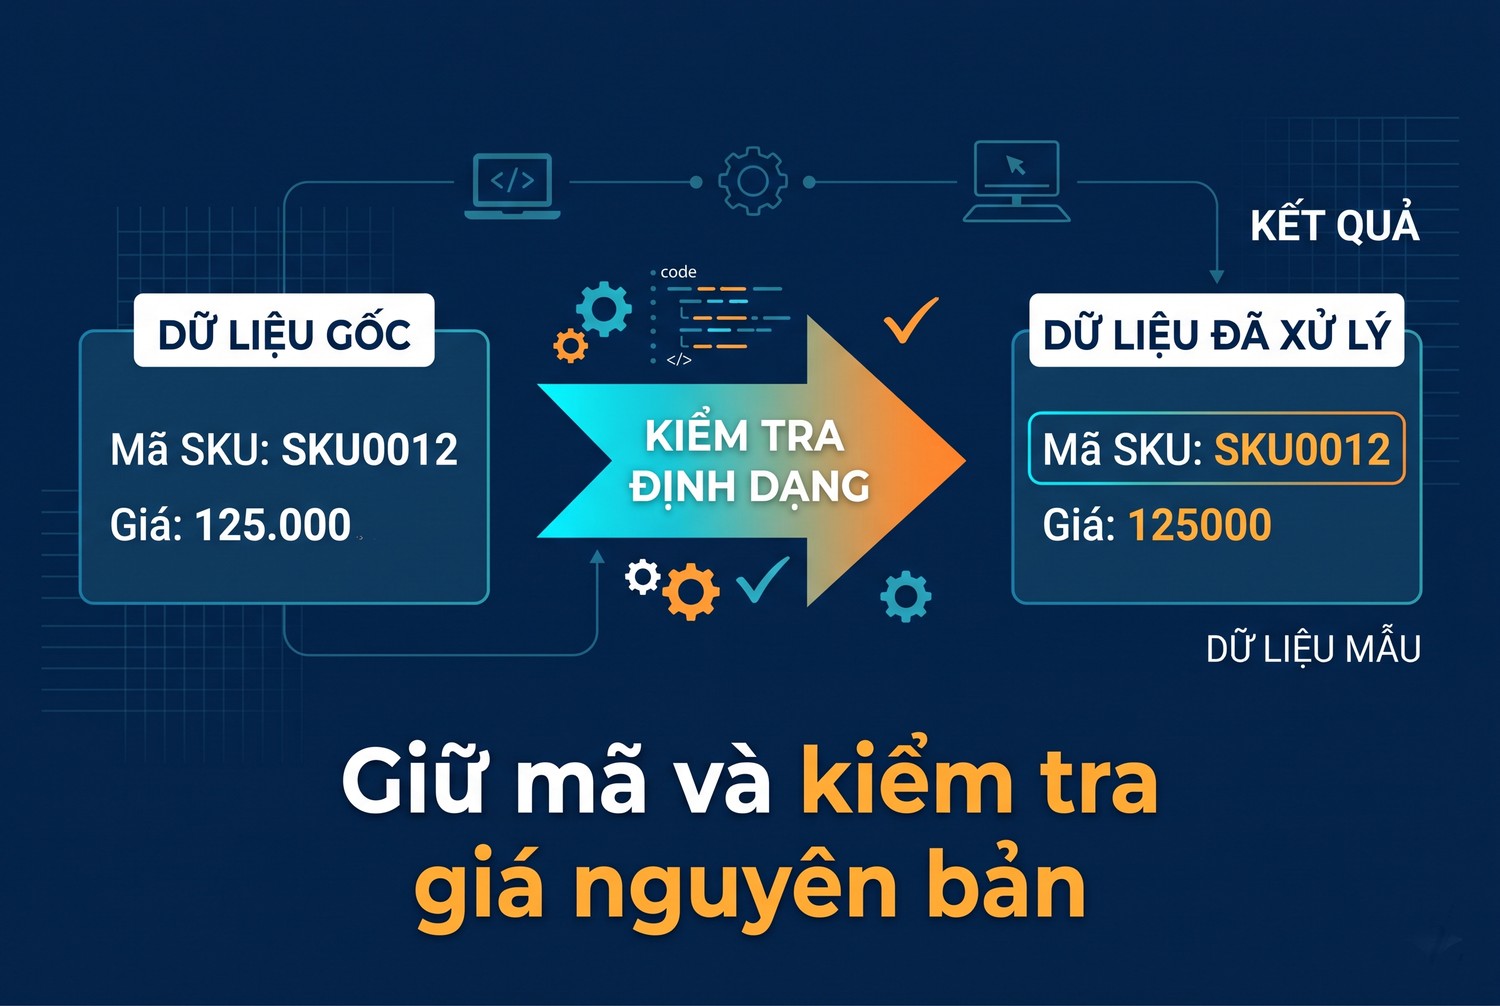
Giữ mã và kiểm tra giá nguyên bản
pandas read_html proxy với kiểu dữ liệu và giá trị thiếu
Việc suy luận kiểu tự động giúp thao tác nhanh nhưng có thể làm mất ý nghĩa của mã định danh. SKU, mã bưu chính hoặc mã chi nhánh có số không đầu nên được giữ dưới dạng văn bản. Một khi đã biến 0012 thành số 12, chương trình không còn biết độ dài ban đầu nếu không giữ bản gốc.
Chuyển số sau khi xác nhận định dạng
pandas.to_numeric cung cấp thao tác chuyển dữ liệu sang số với chính sách lỗi rõ. Trong ví dụ, errors bằng raise giúp dữ liệu không hợp lệ dừng lại thay vì âm thầm tạo giá trị thiếu. Quyết định này phù hợp fixture có giá bắt buộc; ứng dụng khác có thể cần nhóm lỗi riêng.
Regex trong hàm parse chỉ chấp nhận số nguyên cùng nhóm nghìn dùng dấu chấm đúng mẫu đã định. Nó không xử lý phần thập phân, tiền tệ khác hay khoảng giá. Nếu nguồn có các trường hợp đó, hãy bổ sung quy tắc có kiểm tra trước khi mở rộng, đừng xóa mọi ký tự không phải số vì kết quả có thể sai nghĩa.
Với dữ liệu tài chính hoặc định lượng quan trọng, cần chọn kiểu có độ chính xác phù hợp và phạm vi giá trị được chấp nhận. Không nên mặc định float là lựa chọn duy nhất chỉ vì pandas suy luận như vậy. Đối chiếu đơn vị, dấu và giới hạn hợp lệ giúp phát hiện lỗi nguồn trước khi đưa vào báo cáo.
Giá trị thiếu không đồng nghĩa số không
Một ô rỗng có thể là thiếu dữ liệu, chưa công bố hoặc không áp dụng. Điền số không cho tất cả các trường hợp sẽ làm sai phép tính tổng và trung bình. Hãy giữ trạng thái thiếu hoặc thêm trường giải thích theo hợp đồng dữ liệu, đặc biệt với cột bắt buộc cho quyết định sau đó.
keep_default_na=False trong mẫu tránh việc các mã văn bản nhất định bị tự diễn giải là thiếu theo tập mặc định. Nhưng ứng dụng vẫn phải kiểm tra ô rỗng và các dấu hiệu thiếu của riêng nguồn. Tắt suy luận mặc định không tự làm toàn bộ bảng hợp lệ; nó chỉ giữ quyền quyết định ở bước chuẩn hóa của anh em.
Nếu cột mã có giá trị như NA mang ý nghĩa thật, cần kiểm tra bằng fixture riêng. Tương tự, một dấu gạch ngang trong cột số có thể là ký hiệu thiếu, không phải số âm. Đưa các ví dụ ranh giới vào kiểm tra sẽ có ích hơn việc chỉ thử bảng chứa toàn dữ liệu đẹp.
pandas read_html proxy với CSV và lưu phiên bản kết quả
Tệp CSV là sản phẩm đầu ra cần được nghiệm thu riêng với DataFrame trong bộ nhớ. Một cột mã đã đúng trong Python vẫn có thể bị ứng dụng mở tệp suy luận lại thành số. Vì vậy, hãy ghi rõ schema nhập cho người dùng hoặc chọn định dạng khác nếu cần giữ kiểu mạnh hơn.
Xuất tệp có thứ tự cột rõ
Theo DataFrame.to_csv, anh em có thể chọn index, encoding và các tùy chọn định dạng phù hợp. Ví dụ đặt index=False để không thêm cột chỉ số không thuộc nghiệp vụ. Sau khi xuất, đọc lại với dtype dành cho SKU để kiểm tra mã còn nguyên.
from io import StringIO
import pandas as pd

data.to_csv('prices.csv', index=False, encoding='utf-8')
check = pd.read_csv('prices.csv', dtype={'SKU': str})
assert check['SKU'].tolist() == data['SKU'].tolist()
assert list(check.columns) == ['SKU', 'Tên', 'Giá VND']
Đoạn đọc lại không ngăn mọi ứng dụng bảng tính tự đổi kiểu khi người dùng nhấp mở tệp. Nếu cách mở đó là yêu cầu, cần hướng dẫn nhập cột văn bản hoặc tạo định dạng phù hợp hơn. Không tuyên bố CSV tự giữ đầy đủ kiểu dữ liệu giống DataFrame, vì hai mô hình có khả năng khác nhau.
Với nội dung văn bản từ nguồn ngoài, cần xem cách ứng dụng người nhận xử lý chuỗi giống công thức. Tạo bản dùng cho bảng tính theo chính sách phù hợp và giữ bản dữ liệu gốc riêng nếu cần truy nguyên. Việc trích xuất HTML đúng không tự giải quyết cách công cụ khác sẽ diễn giải nội dung ô.
Không thay tệp tốt bằng kết quả lỗi
Job định kỳ nên ghi tệp tạm, kiểm tra chất lượng rồi mới thay bản đang được sử dụng. Nếu tải trang lỗi hoặc bảng thiếu cột, giữ bản trước và báo lần cập nhật thất bại. Cách này giúp người dùng biết dữ liệu cũ thay vì nhận một tệp rỗng mà tưởng đã được cập nhật.
Khi cần mua proxy tốc độ cao, anh em nên mô tả dung lượng HTML, số URL và nhu cầu phiên của bước tải. Sau khi nhận endpoint, đo cả thời gian đến dữ liệu hợp lệ và số lần thử, rồi mới chọn cấu hình chạy định kỳ; tốc độ tải đơn lẻ chưa phản ánh chất lượng tệp cuối.
pandas read_html proxy với kiểm tra cục bộ và giới hạn bằng chứng
Phần kiểm tra của bài dùng fixture trên và một máy chủ HTTP cục bộ giả lập điểm nhận request proxy. Mục tiêu là xác nhận request được gửi đến đúng điểm trung gian cùng cách parse bảng. Nó không đo độ ổn định, vị trí IP hay băng thông của bất kỳ gói dịch vụ nào.
Những nhánh đã được chạy
- Đã kiểm tra fixture trả đúng hai dòng và ba cột yêu cầu, dù bảng layout đứng trước bảng giá.
- Đã kiểm tra SKU giữ nguyên số không đầu, và giá phân nhóm nghìn chuyển thành các số nguyên dự kiến.
- Đã kiểm tra đổi tên cột, SKU trùng, tên rỗng và chuỗi giá không hỗ trợ đều bị từ chối.
- Đã kiểm tra không có bảng prices trả lỗi thay vì xuất một DataFrame được coi là thành công.
- Đã kiểm tra xuất rồi đọc lại CSV với dtype của SKU giữ đúng mã, cùng một lần tải qua HTTP proxy giả lập và parse tiếp.
Tổng cộng mười kiểm tra cục bộ đã qua sau khi sửa thứ tự giữ giá nguyên bản. Kết quả này gắn với pandas 3.0.1 cùng lxml 6.1.1 trong môi trường biên tập. Nó không được mở rộng thành khẳng định đã kiểm tra tài khoản proxy thật, CONNECT HTTPS, SOCKS hoặc các kiểu bảng chưa có trong fixture.
Những phép nghiệm thu còn cần endpoint thật
Với gateway được cấp, anh em cần thử xác thực, URL HTTPS đại diện và quan sát IP đường ra bằng công cụ phù hợp. Đồng thời kiểm tra timeout, no_proxy và chính sách redirect trong môi trường triển khai. Nếu website có đăng nhập, cần xác nhận cookie cùng quyền truy cập trước khi chạy tự động.
Anh em có thể đọc thêm vai trò Web Scraping proxy để đặt bước tải trong toàn bộ quy trình. Hồ sơ nghiệm thu cuối vẫn nên tách phần mạng, phần bảng và phần xuất tệp. Ba lớp có điều kiện thành công khác nhau, nên kết quả một lớp không đại diện cho các lớp còn lại.
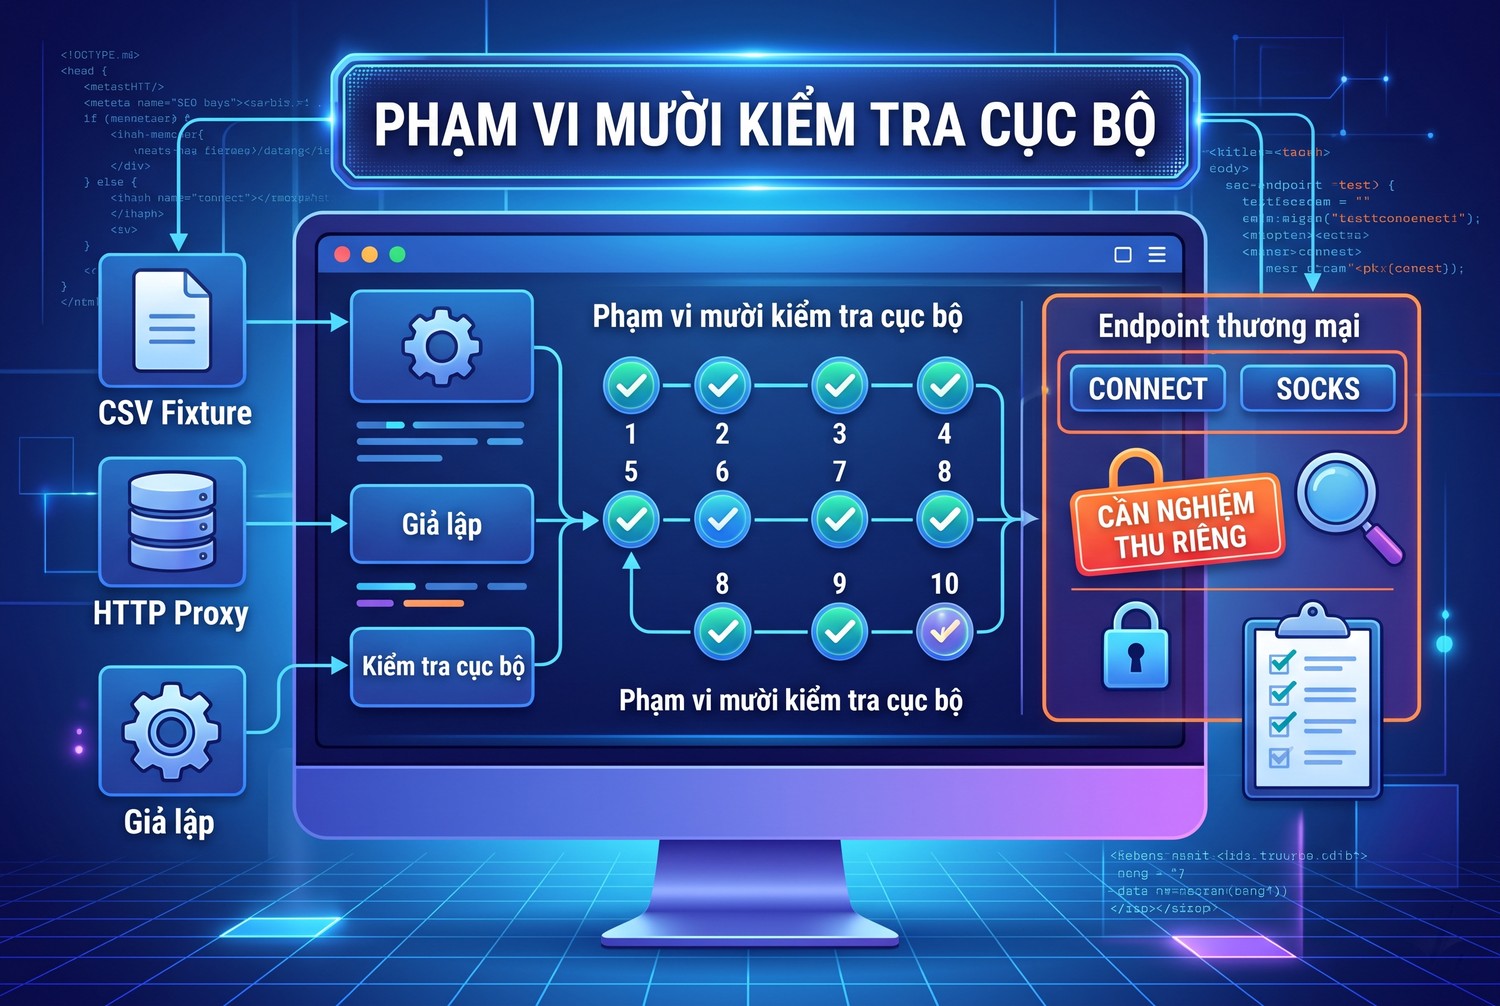
Phạm vi mười kiểm tra cục bộ
pandas read_html proxy với vận hành khi website thay đổi
Website có thể thay tiêu đề, thêm bảng hoặc chuyển dữ liệu sang JavaScript mà không báo cho công cụ đọc. Ứng dụng cần phát hiện thay đổi bằng điều kiện dữ liệu, thay vì gửi lại cùng request nhiều lần. Một cảnh báo có mẫu HTML phù hợp sẽ giúp sửa nhanh hơn báo chung không lấy được bảng.
Giữ checkpoint và nguyên nhân thất bại
Với nhiều URL, lưu trạng thái từng trang sau khi dữ liệu đã được kiểm tra. Nếu một trang lỗi schema, chưa nên bỏ toàn bộ lô hoặc coi nó là lỗi mạng để xoay proxy. Hãy giữ nhóm lỗi cấu trúc riêng và tiếp tục các trang độc lập theo chính sách của công việc.
Đặt giới hạn số lần thử cho timeout và tôn trọng hạn tốc độ của website hoặc API. Khi nhiều trang cùng trả một dạng HTML lỗi, dừng có kiểm soát để xem nguyên nhân. Số endpoint nhiều hơn không làm hợp đồng dữ liệu bớt cần thiết và không tự mở rộng quyền thu thập của ứng dụng.
Nâng phiên bản bằng tập mẫu có ý nghĩa
Mỗi khi đổi pandas hoặc parser, chạy lại fixture chuẩn cùng các trường hợp ranh giới đã ghi nhận. Nếu đầu ra thay đổi, đối chiếu HTML nguồn và ngữ nghĩa mong muốn trước khi chấp nhận. Không sửa hàng loạt kỳ vọng chỉ để kiểm tra xanh khi chưa hiểu vì sao số dòng hoặc kiểu cột khác đi.
pandas read_html proxy tổng kết cách làm
pandas read_html proxy nên tách tải HTML, chọn bảng và kiểm tra schema trước khi chuẩn hóa số. Anh em hãy giữ mã văn bản, dùng fixture có lỗi và nghiệm thu endpoint thật riêng. Theo dõi Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam để trao đổi cấu hình phù hợp cho pandas read_html proxy.


