
Nokogiri web scraping tải HTML chọn dữ liệu và dùng proxy
Nokogiri web scraping phù hợp để biến HTML thành dữ liệu có cấu trúc trong Ruby. ProxyVN hướng dẫn anh em tách bước tải trang, chọn phần tử và kiểm tra bản ghi trước khi xuất tệp. Proxy được đặt ở HTTP client, còn Nokogiri xử lý tài liệu đã nhận; hiểu đúng ranh giới này giúp sửa lỗi selector, mã hóa và dữ liệu thiếu theo từng nguyên nhân.
Nokogiri web scraping và luồng xử lý dữ liệu
Một bộ thu thập HTML nên có ba chặng riêng: lấy tài liệu, đọc cấu trúc và chuẩn hóa đầu ra. Nokogiri giữ vai trò ở chặng đọc cấu trúc. Việc gộp mọi thứ vào một biểu thức ngắn có thể tiện lúc thử, nhưng làm mất thông tin cần thiết khi website trả lỗi hoặc dữ liệu đổi dạng.
Parser nhận tài liệu đã có
Anh em có thể đưa chuỗi HTML, dữ liệu đọc từ tệp hoặc đối tượng IO phù hợp vào parser. Nó dựng cây phần tử để chương trình chọn bằng CSS hay XPath. Các thao tác đó không tự điều khiển trình duyệt, bấm nút hoặc chờ JavaScript tạo thêm nội dung trên trang.
Hướng dẫn phân tích tài liệu của Nokogiri là điểm bắt đầu để hiểu đầu vào và cách dựng document. Trong ví dụ bài này, phần tải mạng được giữ bên ngoài để anh em kiểm tra status và body trước. Nhờ vậy, parser không vô tình xử lý một trang báo lỗi như tài liệu nghiệp vụ.
Đầu ra hữu ích cần có hợp đồng rõ. Chẳng hạn, một bản ghi danh mục cần mã sản phẩm, tên, giá nguyên bản và liên kết nguồn. Nếu thiếu mã hoặc tên, chương trình nên trả lỗi kiểm tra hoặc đưa bản ghi vào nhóm cần xem lại, thay vì âm thầm bỏ trường rồi xuất tệp trông có vẻ đủ.
Fixture giúp kiểm tra mà không gọi mạng
Fixture là tài liệu mẫu do anh em kiểm soát, lưu cùng mã kiểm tra. Nó cho phép sửa selector và thử điều kiện dữ liệu thiếu mà không phụ thuộc proxy hay trạng thái website bên ngoài. Mẫu bên dưới là dữ liệu tự tạo để minh họa, không phải kết quả thu thập từ khách hàng hoặc cửa hàng nào.
Tách kiểm tra parser bằng fixture còn giúp chẩn đoán nhanh hơn. Nếu cùng một tệp nhưng kết quả thay đổi sau khi nâng gem, cần xem lại parser hoặc selector. Nếu fixture vẫn cho kết quả đúng còn trang trực tiếp sai, hãy kiểm tra HTML nhận được và việc website đổi cấu trúc trước khi sửa hàm chuẩn hóa.
Hãy kiểm tra tài liệu đã tải có đúng nội dung cần đọc trước khi sửa một selector đang trả về danh sách rỗng.
Nokogiri web scraping với môi trường và lựa chọn parser
Một lệnh cài gem thành công chưa mô tả đủ môi trường để tái tạo kết quả. Anh em cần ghi Ruby, Nokogiri, nền tảng và loại parser đang dùng. Các bản dựng native, JRuby và lựa chọn HTML4 hay HTML5 có thể dẫn tới điều kiện cài đặt và hành vi cây tài liệu khác nhau.
Cài phụ thuộc theo nền tảng
Tài liệu cài đặt Nokogiri cung cấp các hướng phù hợp hệ điều hành cùng nền tảng Ruby. Hãy dùng hướng dẫn khớp môi trường thực tế và đọc thông báo cài đặt nếu gem phải biên dịch. Không mặc định mọi máy đều cần cài thêm cùng một bộ thư viện hệ thống.
Trong dự án, khai báo Nokogiri bằng Bundler và giữ Gemfile.lock. Nếu ví dụ xuất CSV, khai báo cả gem csv khi môi trường yêu cầu thay vì dựa vào việc máy phát triển đang có sẵn. Việc ghi phiên bản phụ thuộc giúp so sánh kết quả parser giữa terminal, job nền và máy triển khai.
Anh em cũng nên ghi nhận kiểu runtime trước khi chọn HTML5. Theo tài liệu hiện tại, chức năng HTML5 không sẵn trên JRuby. Nếu dự án dùng JRuby, cần lựa chọn đường xử lý được hỗ trợ và kiểm tra fixture theo lựa chọn đó, không tự đổi parser rồi coi đầu ra sẽ giống browser.
Chọn HTML5 có chủ đích
API HTML5 của Nokogiri mô tả cách dựng document và fragment. Bài này dùng HTML5 cho tệp HTML minh họa trên môi trường Ruby hỗ trợ tính năng đó. Không dùng HTML parser cho XML chỉ vì cả hai cùng có dấu ngoặc nhọn và đều chọn được phần tử.
HTML bị thiếu thẻ hoặc lồng sai có thể được parser sửa khi dựng cây. Điều đó giúp tài liệu vẫn đọc được, nhưng cũng có thể làm vị trí phần tử khác chuỗi HTML ban đầu. Khi selector không khớp, hãy quan sát cây sau parse và so với fixture thay vì chỉ tìm chuỗi bằng mắt trong tệp gốc.
Document và fragment phục vụ hai đầu vào khác nhau. Một đoạn HTML chỉ chứa thẻ li có thể cần cách parse fragment để không thêm các lớp bao như tài liệu đầy đủ. Nếu dữ liệu từ API trả một mảnh HTML, ghi rõ loại đầu vào đó để người bảo trì không vô tình thay sang cách parse khác.
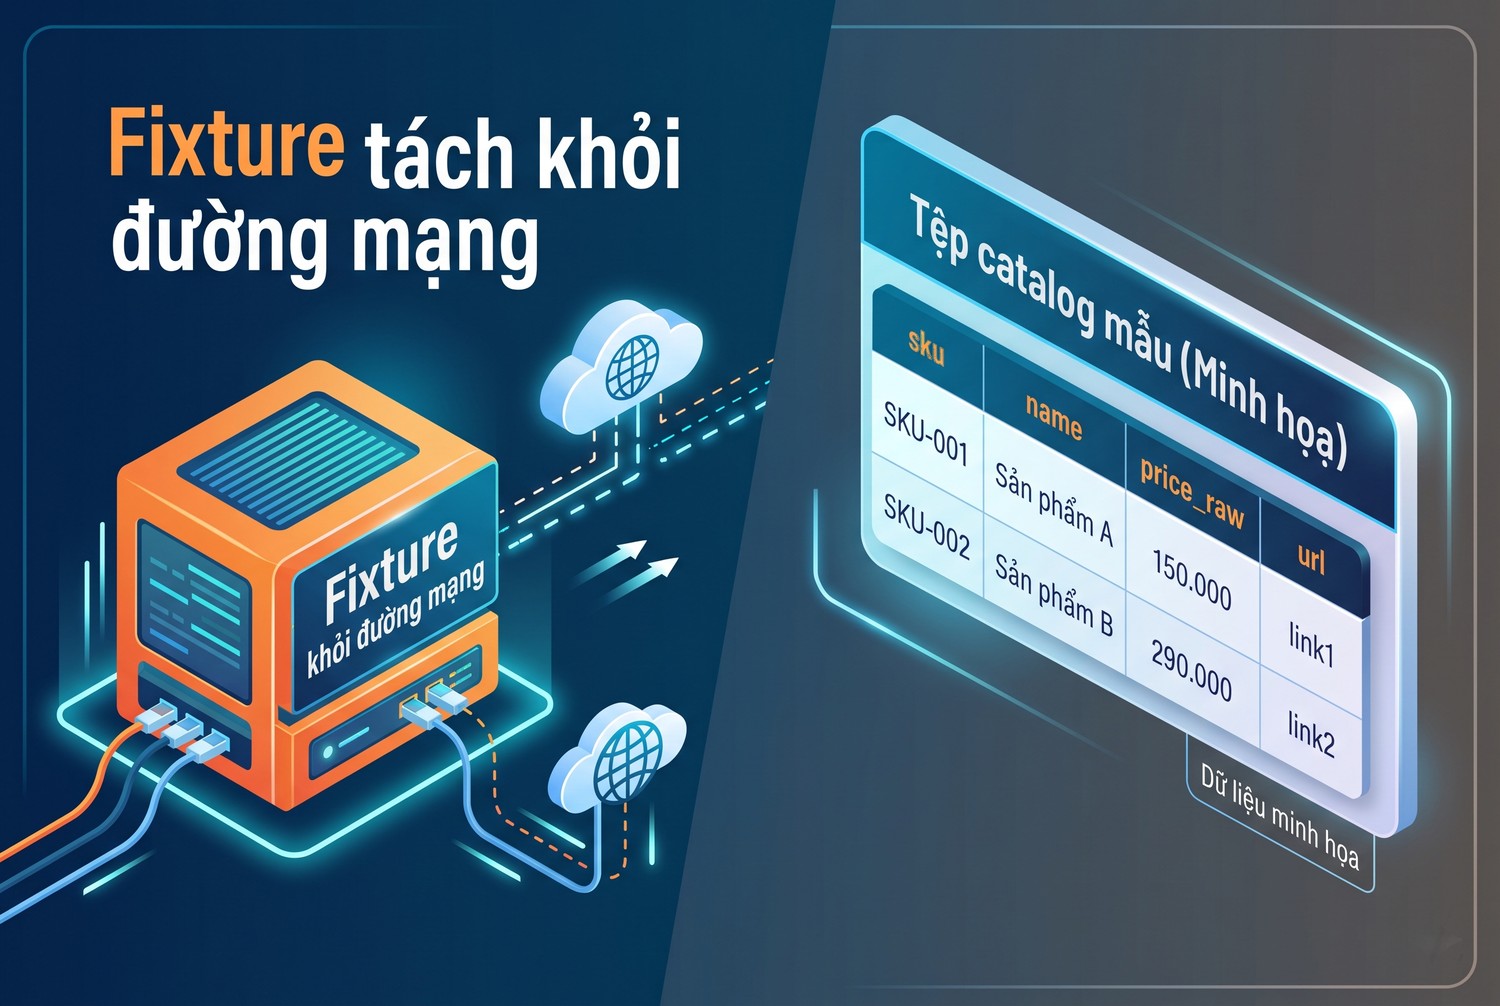
Fixture tách khỏi đường mạng
Nokogiri web scraping với fixture danh mục sản phẩm
Ví dụ này dùng các thẻ article có class product để mỗi phần tử đại diện một bản ghi. Việc lấy theo từng khối giúp giữ tên, giá và liên kết cùng sản phẩm. Cách lấy riêng toàn bộ tên rồi ghép với toàn bộ giá theo vị trí dễ sai khi một sản phẩm thiếu trường.
Tạo tài liệu mẫu có đầu ra dự kiến
Lưu HTML sau thành catalog.html với mã hóa UTF-8. Hai sản phẩm có dữ liệu khác nhau để anh em nhận ra lỗi ghép trường. Các địa chỉ .example và số liệu giá chỉ là dữ liệu mẫu, không mô tả một cửa hàng hay mức giá thị trường.
<!doctype html>
<html lang="vi">
<head><meta charset="utf-8"><title>Danh mục mẫu</title></head>
<body><main id="catalog">
  <article class="product" data-sku="SP001">
    <h2 class="name">Bộ chuyển đổi A</h2>
    <span class="price">125.000 đ</span>
    <a class="detail" href="/san-pham/a">Chi tiết</a>
  </article>
  <article class="product" data-sku="SP002">
    <h2 class="name">Cáp kết nối B</h2>
    <span class="price">89.000 đ</span>
    <a class="detail" href="/san-pham/b">Chi tiết</a>
  </article>
</main></body></html>
Với fixture này, kỳ vọng là hai bản ghi giữ mã SP001 và SP002, tên không lẫn nhau, giá giữ dạng nguyên bản. Liên kết tương đối cần được ghép với URL nguồn đã xác định. Đây là kỳ vọng kiểm tra do cấu trúc mẫu quy định, chưa phải kết quả chạy được ghi nhận trên môi trường người đọc.
Đừng xóa trường giá nguyên bản ngay khi chuyển sang số. Nếu quy tắc chuẩn hóa gặp ký hiệu tiền tệ mới hoặc cách phân cách thay đổi, chuỗi gốc giúp lần lại nguyên nhân. Một đầu ra có cả giá gốc và giá đã chuẩn hóa sẽ dễ kiểm toán hơn khi cần giải thích khác biệt giữa hai lần thu thập.
Chọn bản ghi rồi chọn trường bên trong
Đoạn parser sau trả lỗi nếu khối sản phẩm không có các phần tử bắt buộc. Nó không tải website, nên anh em có thể kiểm tra riêng với fixture. Giá trong ví dụ được giữ dạng chuỗi để chưa áp quy tắc số học cho dữ liệu chưa được xác nhận.
require 'nokogiri'
require 'uri'
require 'json'

html = File.read('catalog.html', encoding: 'UTF-8')
document = Nokogiri::HTML5.parse(html)
base = URI('https://shop.example/catalog')
rows = document.css('#catalog article.product').map do |item|
  name_node = item.at_css('.name')
  price_node = item.at_css('.price')
  link_node = item.at_css('a.detail[href]')
  sku = item['data-sku'].to_s.strip
  raise 'Invalid product block' if sku.empty? ||
    name_node.nil? || price_node.nil? || link_node.nil?
  name = name_node.text.gsub(/[[:space:]]+/, ' ').strip
  raise 'Empty product name' if name.empty?
  link = URI.join(base.to_s, link_node['href'])
  raise 'Unexpected link scheme' unless %w[http https].include?(link.scheme)
  {
    sku: sku,
    name: name,
    price_raw: price_node.text.strip,
    url: link.to_s
  }
end
raise 'No product blocks found' if rows.empty?
puts JSON.pretty_generate(rows)
Hàm at_css có thể trả nil khi không có phần tử phù hợp, nên kiểm tra trước khi gọi text. Ngược lại, css trả tập kết quả để anh em xử lý nhiều phần tử. Sự khác nhau này cần được thể hiện trong quy tắc dữ liệu thiếu, tránh dùng toán tử an toàn ở mọi nơi rồi xuất hàng loạt giá trị rỗng.
Nếu trang hợp lệ có thể không có sản phẩm, điều kiện rows.empty không nên luôn làm job thất bại. Hãy phân biệt trạng thái danh mục rỗng được website báo rõ với việc không tìm được khối do selector hỏng. Mẫu chọn báo lỗi vì fixture đã định nghĩa phải có dữ liệu, còn ứng dụng thật cần hợp đồng phù hợp.
Nokogiri web scraping với CSS XPath và phạm vi truy vấn
Selector là cách diễn đạt quan hệ trong tài liệu, không phải chuỗi nên lấy dài nhất từ công cụ trình duyệt. Một selector quá phụ thuộc vị trí có thể hỏng khi thêm banner. Selector quá rộng lại có thể lấy giá ở khu vực khuyến mãi rồi gán cho sản phẩm không liên quan.
Dùng quan hệ gần dữ liệu cần đọc
Anh em nên bắt đầu từ khối bản ghi có ý nghĩa rồi truy vấn tương đối bên trong. Với CSS, class chức năng và thuộc tính dữ liệu ổn định thường dễ hiểu hơn đường dẫn nhiều lớp div. Tuy nhiên, độ ổn định cần quan sát từ tài liệu thực tế; không có quy tắc mọi class đều thay đổi hoặc mọi data attribute đều bền.
Hướng dẫn tìm kiếm bằng CSS và XPath mô tả các phương thức truy vấn trên document và node. Khi dùng XPath trong một item, tiền tố .// giúp tìm trong ngữ cảnh hiện tại. Bắt đầu bằng // có thể tìm rộng hơn điều anh em muốn và làm các bản ghi nhận cùng một trường đầu tiên.
# item is one product article from the selected NodeSet.
name_by_css = item.at_css('.name')
name_by_xpath = item.at_xpath('.//h2[@class="name"]')
puts name_by_css&.text
puts name_by_xpath&.text
Kiểm tra số lượng và trường trùng
Một selector tên trả nhiều phần tử có thể là dấu hiệu giao diện có bản desktop và mobile cùng trong HTML. Nếu lấy phần tử đầu mà không xem cấu trúc, dữ liệu có thể tình cờ đúng rồi sai sau thay đổi nhỏ. Hãy kiểm tra số phần tử mong đợi và chọn nguồn hiển thị phù hợp theo hợp đồng đã xác định.
Với mã sản phẩm, kiểm tra trùng trong cùng trang trước khi ghi kho. Trùng có thể đến từ bản ghi thật bị lặp, vùng sản phẩm gợi ý hoặc selector vượt khỏi container. Cần giữ thông tin vị trí hoặc URL nguồn đủ để lần lại, thay vì chỉ gọi uniq rồi che mất nguyên nhân.
Nếu một trường chứa nhiều text node, text sẽ gộp nội dung bên trong. Điều này có thể lẫn chữ chú thích như đã giảm giá hoặc hết hàng. Anh em nên chọn phần tử con cụ thể khi cấu trúc cho phép, sau đó kiểm tra chuỗi kết quả bằng fixture có đúng trường hợp chú thích đó.
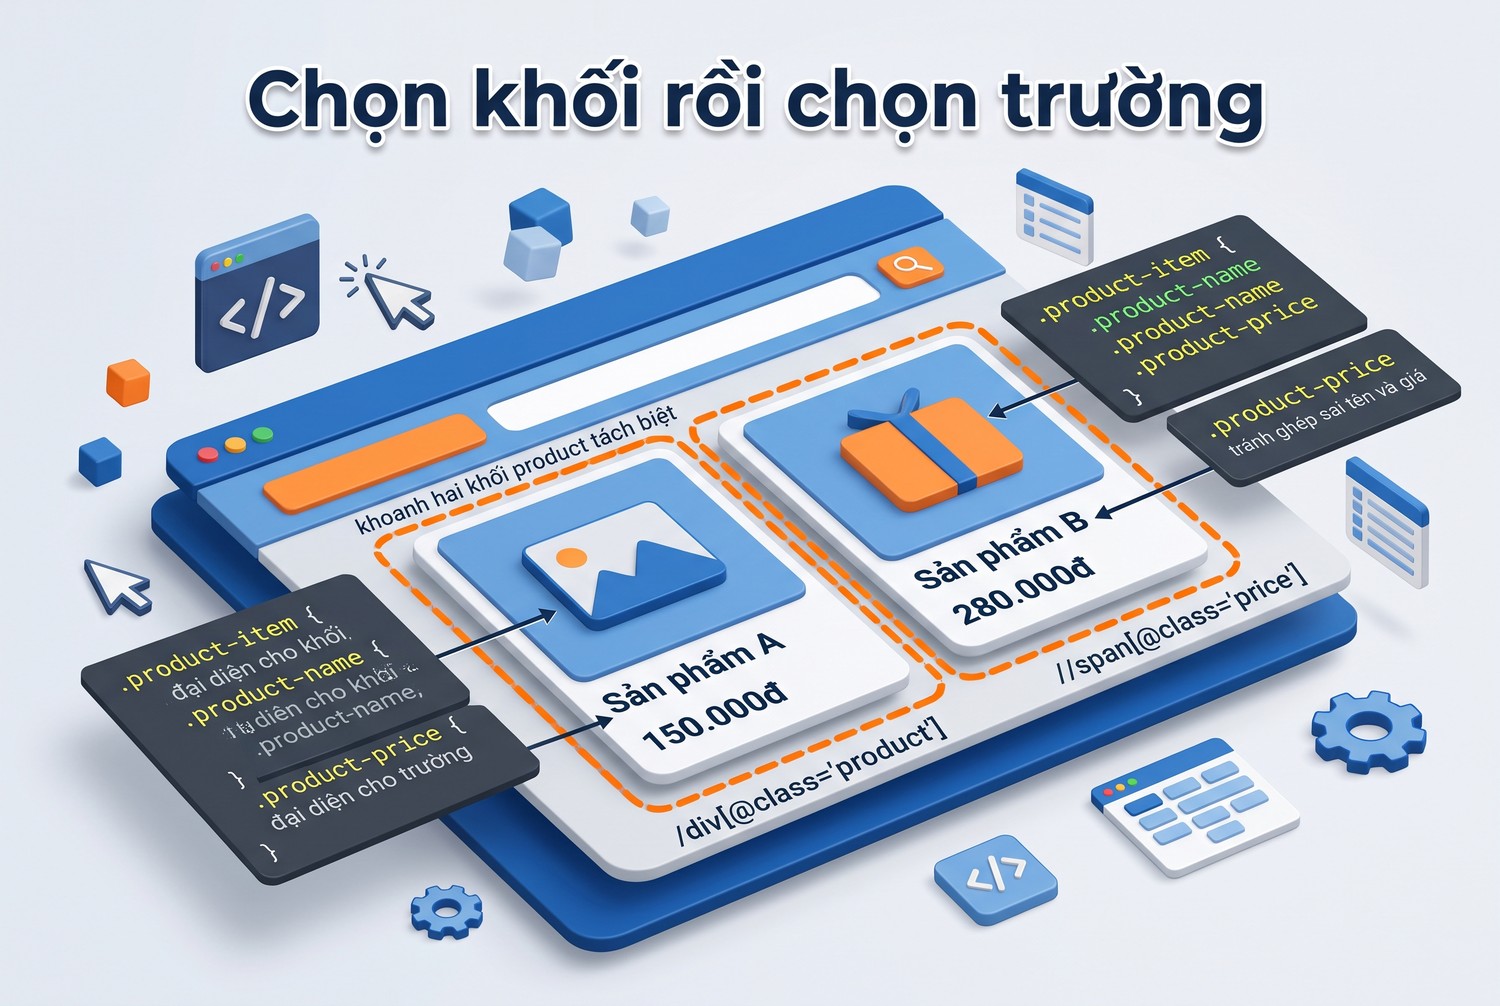
Chọn khối rồi chọn trường
Nokogiri web scraping với tải HTML qua proxy
Sau khi parser làm việc đúng với tệp, có thể thay đầu vào bằng body do HTTP client tải. Giữ nguyên hàm phân tích sẽ giúp nhìn rõ thay đổi chỉ nằm ở nguồn tài liệu. Proxy cần được cấu hình ở Net::HTTP hoặc client khác đang gửi request, không có một thiết lập proxy chung trên đối tượng Nokogiri document.
Kiểm tra HTTP trước khi dựng cây
Tài liệu proxy của Net::HTTP mô tả các trường địa chỉ cùng xác thực trong lúc tạo kết nối. Đoạn mã dưới minh họa nhận HTML qua HTTP proxy rồi đưa sang parser. Nó chưa đi theo redirect, chưa quản lý cookie đăng nhập và chỉ dùng URL HTTPS đã được cho phép.
require 'net/http'
require 'uri'
require 'openssl'
require 'nokogiri'

uri = URI(ENV.fetch('TARGET_URL'))
raise 'HTTPS URL required' unless uri.is_a?(URI::HTTPS)
client = Net::HTTP.new(uri.hostname, uri.port,
  ENV.fetch('PROXY_HOST'), Integer(ENV.fetch('PROXY_PORT')),
  ENV.fetch('PROXY_USER'), ENV.fetch('PROXY_PASSWORD'))
client.use_ssl = true
client.verify_mode = OpenSSL::SSL::VERIFY_PEER
client.open_timeout = 10
client.read_timeout = 20
client.max_retries = 0
request = Net::HTTP::Get.new(uri.request_uri)
response = client.start { |http| http.request(request) }
raise "HTTP #{response.code}" unless response.is_a?(Net::HTTPSuccess)
type = response['content-type'].to_s
raise 'Expected HTML' unless type.include?('text/html')
document = Nokogiri::HTML5.parse(response.body)
puts "product_blocks=#{document.css('article.product').length}"
URL thật cần chứa cấu trúc product tương ứng nếu muốn kết quả có ý nghĩa. Chạy đoạn này với một trang bất kỳ rồi thấy số không chưa chứng minh parser hỏng. Trước khi gọi mạng, anh em phải biết dấu hiệu nào trên trang được dùng để nhận diện đúng vùng dữ liệu.
Các ngưỡng timeout trong mẫu là lựa chọn hướng dẫn. Công việc có nhiều trang cần hạn tổng và giới hạn request riêng; đặt read_timeout không tự giới hạn toàn bộ thời gian của lô. Nếu body có thể lớn, cần thêm mức kích thước và cách đọc phù hợp trước khi giữ cả tài liệu trong bộ nhớ.
Không dùng proxy để sửa HTML thiếu JavaScript
Nếu nguồn trang chỉ chứa khung ứng dụng và JavaScript sẽ gọi API để lấy sản phẩm, Nokogiri không tự thực hiện bước đó. Anh em cần kiểm tra có endpoint dữ liệu được phép dùng hoặc một bước browser để lấy nội dung đã dựng. Đổi IP không tạo ra phần tử chưa tồn tại trong body.
Khi browser là cần thiết, vẫn có thể dùng Nokogiri để phân tích HTML đã lấy sau bước dựng trang. Tuy nhiên, phải ghi rõ tài liệu đến từ đâu và điều kiện nào chứng minh dữ liệu đã sẵn sàng. Nếu chỉ lưu ảnh giao diện mà không giữ HTML mẫu phù hợp, việc sửa parser về sau sẽ thiếu căn cứ.
Nếu cần mua proxy, anh em nên nêu rõ HTTP client đang dùng, giao thức và phạm vi URL cần kiểm tra. Sau khi nhận endpoint, hãy nghiệm thu bước tải riêng rồi so tài liệu nhận được với fixture; không lấy việc cài thành công Nokogiri làm bằng chứng gateway tương thích.
Nokogiri web scraping với mã hóa và chuẩn hóa trường
Dữ liệu đọc đúng thẻ vẫn có thể sai nếu ký tự bị giải mã nhầm hoặc giá bị đổi ý nghĩa. Đây là lớp lỗi dễ lọt vì JSON hay CSV xuất ra vẫn có cú pháp hợp lệ. Anh em cần định nghĩa cách giữ nguyên bản và cách chuẩn hóa cho từng trường dữ liệu.
Giữ bằng chứng trước khi đổi encoding
Khi tiếng Việt hiển thị sai, kiểm tra header Content-Type, khai báo charset trong HTML và byte gốc đã nhận. Đừng gọi force_encoding như bước sửa chung cho mọi lỗi vì nó chỉ thay cách Ruby gắn nhãn chuỗi, không tự chuyển byte từ bảng mã này sang bảng mã khác. Sửa nhầm có thể làm lỗi lặng thay vì hiện exception.
Một mẫu HTML nhỏ có các ký tự tiếng Việt, khoảng trắng đặc biệt và ký hiệu tiền tệ sẽ giúp kiểm tra việc giải mã. Lưu mẫu theo đúng byte nguồn và ghi kỳ vọng cho từng trường. Nếu parser được cấp chuỗi đã sai trước đó, thay CSS hay XPath không giải quyết được vấn đề mã hóa.
Khoảng trắng cũng cần xử lý theo ngữ cảnh. Với tên sản phẩm, gộp khoảng trắng liên tiếp thường phù hợp; với nội dung cần giữ xuống dòng, quy tắc đó có thể làm mất ý nghĩa. Đừng áp một hàm làm sạch cho mọi trường chỉ vì nó tạo ra chuỗi ngắn gọn hơn.
Giá và liên kết cần quy tắc riêng
Giá có dấu chấm phân cách hàng nghìn không nên được chuyển sang số bằng một lệnh to_f trực tiếp. Kết quả có thể chỉ đọc một phần chuỗi mà không báo lỗi. Hãy xác định tiền tệ, quy tắc dấu phân cách và trường hợp không có giá trước khi chuyển sang số nguyên hoặc kiểu thập phân phù hợp.
Liên kết tương đối cần được ghép với URL tài liệu có ý nghĩa. Nếu trang có thẻ base, ứng dụng phải quyết định có sử dụng giá trị đó hay chỉ chấp nhận một tập hostname nguồn. Không tự động xếp mọi URL thu được vào hàng đợi vì chúng có thể dẫn ra ngoài phạm vi được phép thu thập.
Với trường không có giá như liên hệ, giữ trạng thái riêng thay vì điền số không. Số không thường là giá trị nghiệp vụ hợp lệ, còn thiếu giá là thông tin khác. Hợp đồng dữ liệu rõ giúp người dùng cuối không đọc nhầm một sản phẩm chưa báo giá thành sản phẩm miễn phí.
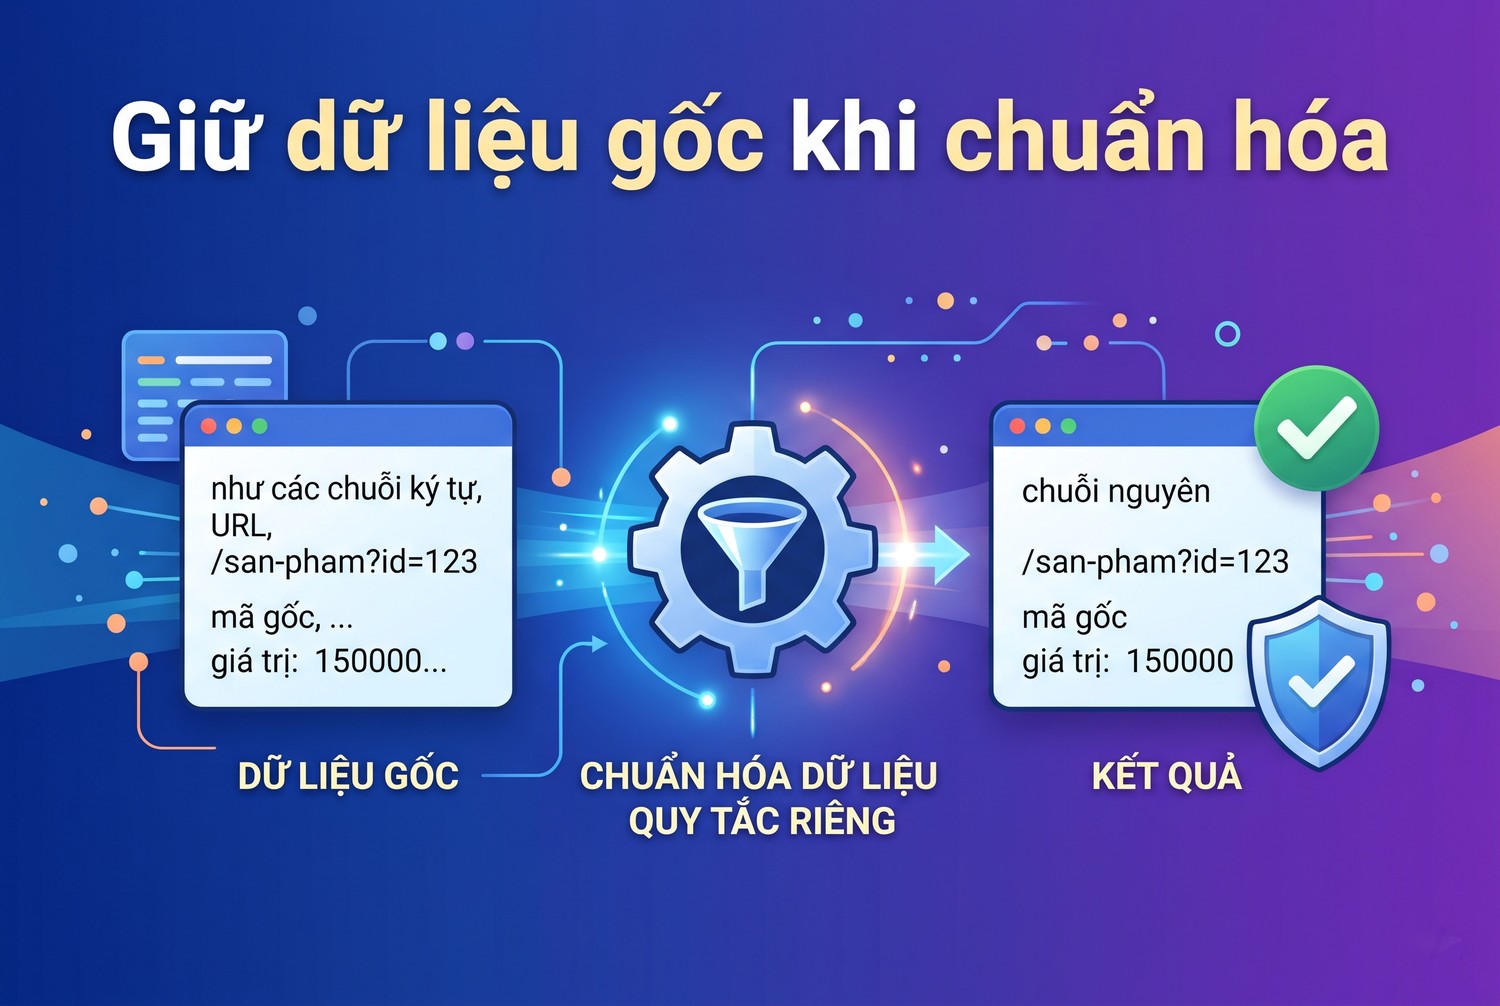
Giữ dữ liệu gốc khi chuẩn hóa
Nokogiri web scraping với JSON CSV và chất lượng đầu ra
Định dạng tệp cần phù hợp người nhận và cách xử lý sau đó. JSON giữ cấu trúc lồng tốt hơn, còn CSV phù hợp bảng phẳng để nhập vào công cụ bảng tính. Dù chọn loại nào, vẫn cần kiểm tra schema và trạng thái bản ghi trước khi tạo tệp cuối.
Lưu cấu trúc trước rồi xuất định dạng
Nên cho hàm parser trả về mảng hash có các khóa thống nhất, sau đó dùng một bước khác để xuất. Nhờ vậy, thay CSV sang JSON không buộc anh em sửa selector. Cấu trúc này cũng giúp kiểm tra dữ liệu độc lập với việc đường dẫn tệp có ghi được hay không.
Đối với CSV, dùng thư viện có xử lý dấu phẩy, dấu ngoặc kép và xuống dòng theo quy tắc. Việc nối chuỗi thủ công có thể làm một tên sản phẩm chứa dấu phẩy biến thành hai cột. Đầu ra nhìn đúng ở vài dòng đầu chưa chứng minh toàn bộ tệp hợp lệ khi nhập bằng công cụ khác.
require 'csv'
# rows is the validated array produced by the parser.
CSV.open('products.csv', 'w', encoding: 'UTF-8') do |csv|
  csv << %w[sku name price_raw url]
  rows.each do |row|
    csv << row.values_at(:sku, :name, :price_raw, :url)
  end
end
Mẫu trên chỉ xuất mảng đã kiểm tra và không minh họa mọi quy tắc an toàn của bảng tính. Nếu tệp được mở trong ứng dụng có diễn giải công thức, các trường văn bản từ nguồn ngoài cần có chính sách xử lý phù hợp. Giữ bản dữ liệu gốc riêng giúp không làm mất thông tin khi tạo bản dành cho người xem.
Kiểm tra tệp trước khi thay bản cũ
Hãy kiểm tra số dòng, tên cột, khóa bắt buộc và mã trùng trước khi công bố tệp kết quả. Với job định kỳ, ghi ra tệp tạm rồi chỉ thay bản đang dùng khi các điều kiện đạt. Nếu lần thu thập lỗi, cách làm này tránh ghi đè một bộ dữ liệu tốt bằng tệp rỗng.
Nhật ký nên tách số khối tìm được, số bản ghi đạt và số bị loại theo lý do. Chênh lệch giữa ba con số này thường hữu ích hơn tổng số URL đã mở. Một trang trả được HTML nhưng bị loại hết bản ghi là tín hiệu cần xem parser hoặc nguồn dữ liệu, không nên tính vào thành công của pipeline.
Anh em có thể xem lại vai trò Web Scraping proxy trong bước tải tài liệu. Chất lượng tệp đầu ra vẫn cần các kiểm tra riêng như phần này, vì proxy không xác nhận tên cột hay ý nghĩa của giá trị được parser trích ra.
Nokogiri web scraping với phân trang và thay đổi cấu trúc
Một trang danh mục đơn mới là phạm vi ban đầu. Khi thêm phân trang, ứng dụng cần biết URL tiếp theo đến từ đâu và lúc nào phải kết thúc. Không nên suy ra mọi website đều dùng page bằng cách cộng số trong query hoặc đều báo hết trang theo cùng một cách.
Giữ phạm vi và phát hiện vòng lặp
Nếu tài liệu có liên kết tiếp theo, hãy chọn đúng phần tử, ghép URL và kiểm tra hostname trước khi đưa vào hàng đợi. Lưu tập URL đã xử lý để nhận ra vòng lặp do trang trả cùng liên kết. Một giới hạn số trang giúp công việc dừng khi cấu trúc không còn như giả định ban đầu.
Không dùng số trang tối đa như bằng chứng đã lấy đủ dữ liệu. Sau mỗi lô, đối chiếu số bản ghi hợp lệ và dấu hiệu kết thúc mà website cung cấp nếu có. Khi không xác nhận được hoàn tất, báo trạng thái chưa đủ thay vì tự điền kết quả thành công chỉ vì vòng lặp đã dừng.
Các trang khác nhau có thể lặp sản phẩm do vị trí quảng bá hoặc thứ tự thay đổi. Nên dùng khóa nghiệp vụ phù hợp để nhận diện bản ghi, giữ nguồn lần thấy và thời điểm lấy. Xóa trùng chỉ theo tên có thể gộp nhầm hai mặt hàng, còn xóa theo URL chưa chuẩn hóa có thể bỏ sót trùng.
Chuẩn bị fixture cho lần website đổi giao diện
Một bộ fixture tốt có trang đầy đủ, thiếu giá, danh mục rỗng hợp lệ và tài liệu không phải trang dữ liệu. Không cần lưu toàn bộ nội dung nhạy cảm; giữ phần HTML tối thiểu thể hiện cấu trúc liên quan. Các fixture cần gắn với phiên bản parser để hiểu thay đổi nào đang được bảo vệ.
Khi một selector mới được đưa vào, chạy lại cả trường hợp cũ lẫn trường hợp vừa gây lỗi. Nếu chỉ sửa để một trang mới có dữ liệu, ứng dụng có thể làm hỏng các trang vẫn còn cấu trúc cũ. Trong thời gian website chuyển đổi, có thể cần nhiều mẫu có kiểm soát thay vì một selector rộng lấy mọi thứ.
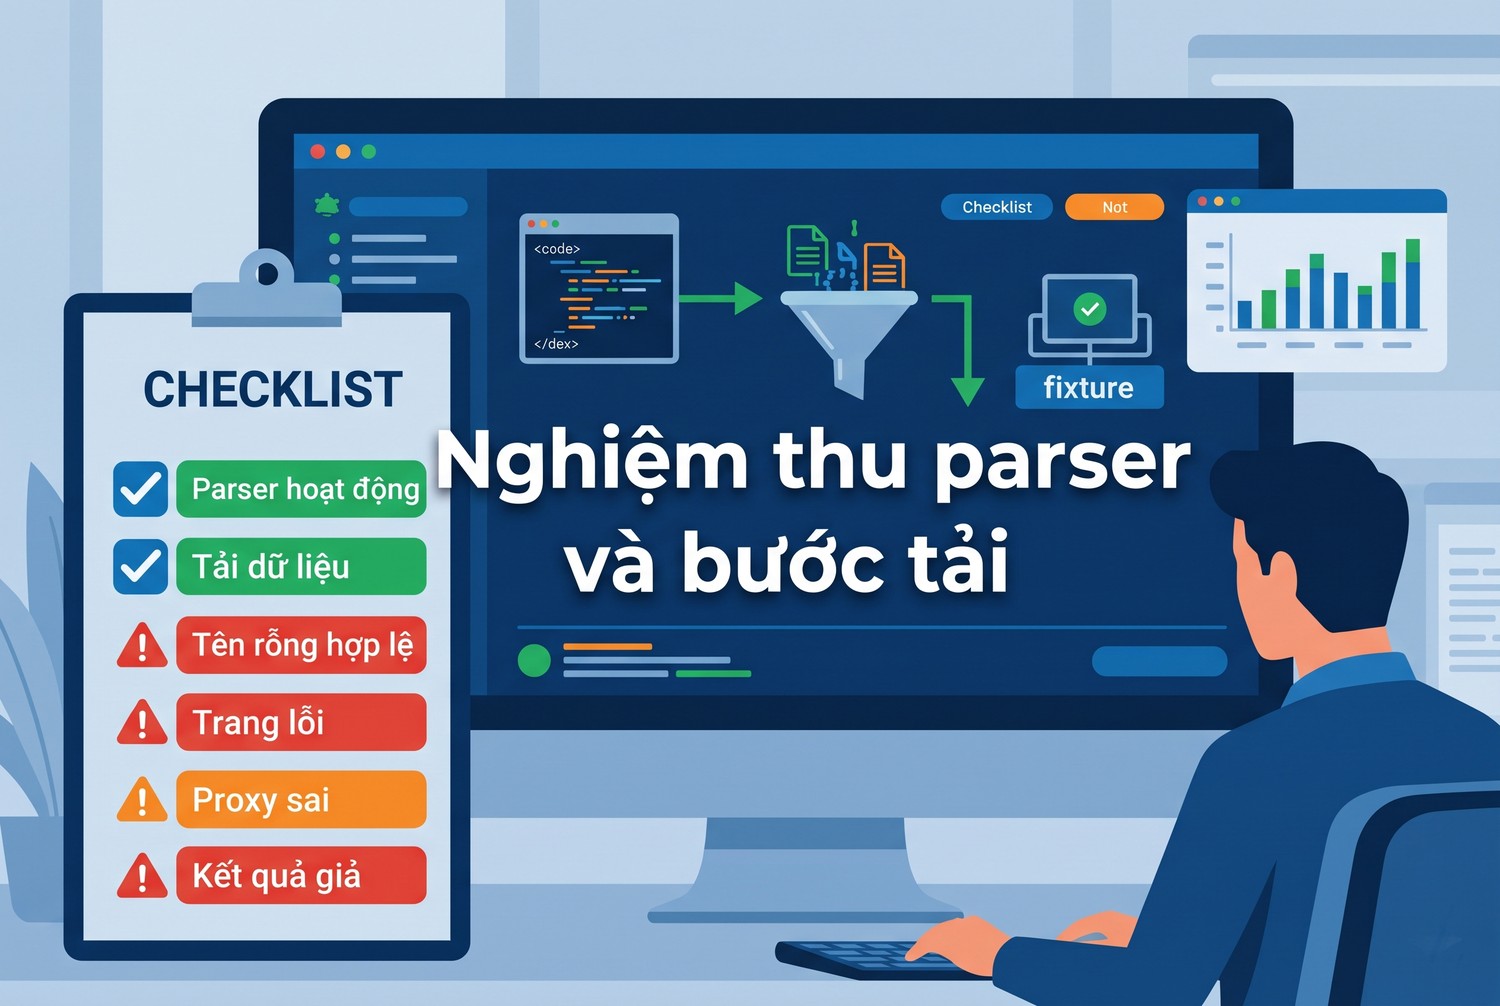
Nghiệm thu parser và bước tải
Nokogiri web scraping với nghiệm thu trước khi chạy định kỳ
Nghiệm thu nên diễn ra theo lớp để lỗi mới không che khuất lỗi cũ. Trước tiên kiểm tra parser bằng tệp, tiếp theo kiểm tra tải trang qua client, cuối cùng ghép hai phần. Phạm vi này cho phép anh em biết kết quả đã chứng minh điều gì và phần nào còn cần chạy trong môi trường triển khai.
Các kiểm tra có đầu vào rõ
- Với fixture chuẩn, xác nhận số bản ghi và từng trường khớp kỳ vọng đã định, không chỉ kiểm tra chương trình không ném lỗi.
- Với fixture thiếu tên, kiểm tra chương trình trả trạng thái dữ liệu không hợp lệ hoặc đưa bản ghi vào nhóm cần xem theo chính sách.
- Với danh mục rỗng hợp lệ, kiểm tra có dấu hiệu rỗng được chấp nhận và không bị nhầm thành lỗi mạng.
- Với trang lỗi hoặc trang đăng nhập, kiểm tra không xuất bản ghi sản phẩm giả từ các phần tử không liên quan.
- Với proxy sai cấu hình, kiểm tra lỗi xảy ra ở bước tải và không làm ghi đè tệp dữ liệu tốt trước đó.
Sau các phép thử, ghi đúng những gì đã chạy và những gì mới chỉ được đối chiếu tài liệu. Không đặt một dòng đạt cho proxy thương mại khi chưa có endpoint để thử. Hồ sơ trung thực giúp lần nghiệm thu tiếp theo biết cần bổ sung bằng chứng nào mà không phải kiểm tra lại từ đầu.
Lưu phiên bản và điều kiện dừng
Một lần chạy định kỳ cần lưu phiên bản parser, cấu hình đã che bí mật và mẫu lỗi phù hợp khi dữ liệu không đạt. Đặt ngưỡng dừng nếu nhiều trang liên tiếp không khớp cấu trúc hoặc cùng trả một trang lỗi. Việc dừng này bảo vệ chất lượng kho dữ liệu và tránh gọi lại vô ích trong khi nguồn đã thay đổi.
Khi thay gem hoặc runtime, chạy lại fixture trước rồi mới thử trang trực tiếp. Khi đổi proxy, giữ nguyên parser và tập URL thử để so đúng thành phần. Từng thay đổi có phạm vi rõ giúp kết luận dựa trên bằng chứng, thay vì diễn giải mọi khác biệt thành chất lượng IP.
Nokogiri web scraping tổng kết quy trình
Nokogiri web scraping cần tách tải HTML khỏi phân tích và kiểm tra từng bản ghi trước khi xuất dữ liệu. Anh em hãy bắt đầu bằng fixture, giữ giá trị gốc và chọn selector theo khối. Theo dõi Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam để trao đổi cấu hình mạng cho Nokogiri web scraping.


