
MLflow theo dõi dataset crawl: gắn digest, nguồn và URL vào run
MLflow theo dõi dataset crawl là cách ghi lại chính xác bộ dữ liệu cào từ web nào đã được dùng cho từng lần huấn luyện hay đánh giá model. Mỗi run trong MLflow mang theo tên dataset, nguồn, digest và một manifest URL, nên vài tuần sau vẫn trả lời được câu hỏi model này học từ snapshot nào. ProxyVN chạy thử với mlflow 3.17.2 ngày 03/11/2026: hai snapshot crawl, hai run, một bảng lineage, kèm vài chỗ MLflow không tự lo cho bạn. Bài ghi rõ phần đã chạy và phần chưa thử.
MLflow theo dõi dataset crawl: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra cần có và những gì bài không bàn tới.
Bài toán truy vết
Một nhóm cào giá sản phẩm mỗi ngày rồi huấn luyện lại model dự đoán giá. Tuần sau, chỉ số MAE xấu đi. Câu hỏi đầu tiên là dữ liệu đã đổi gì. Nếu không ai ghi lại run nào dùng snapshot nào, nhóm chỉ còn cách đoán.
MLflow có sẵn chỗ để ghi chuyện này. Ngoài tham số và metric, mỗi run có phần inputs chứa danh sách dataset đã dùng. Việc của bài là dùng phần đó đúng cách cho dữ liệu crawl, nơi nguồn là hàng trăm URL chứ không phải một tệp CSV tải từ Kaggle.
Đầu ra nghiệm thu
Đầu ra gồm hai run dùng hai dataset khác nhau, và một bảng lineage nối URL, snapshot, dataset và run. Từ một run bất kỳ, người kiểm tra phải tìm được manifest URL đã dùng. Từ một digest dataset, họ phải tìm được mọi run đã dùng nó.
Không dựng crawler, không dạy huấn luyện model
Bài không hướng dẫn viết crawler, không bàn thuật toán dự đoán giá. Model trong lab là một con số MAE ghi tay để có metric đi kèm run. Trọng tâm là phần dữ liệu: đặt tên, tính dấu vân tay, gắn vào run và truy ngược lại.
Ranh giới với bài về vector index
Lưu tài liệu crawl vào kho vector để tìm kiếm là việc khác. Ở đó câu hỏi là đoạn văn nào gần câu hỏi nhất. Ở đây câu hỏi là run nào dùng dữ liệu nào. Hai việc có thể cùng dùng một manifest URL, nhưng công cụ và đầu ra khác nhau.
Phiên bản đã khóa
Lab dùng mlflow 3.17.2, pandas 3.1.0, Python 3.12, backend lưu trữ là SQLite cục bộ. Không có máy chủ MLflow từ xa, không có Databricks. Mọi con số trong bài lấy từ lần chạy này. Phiên bản khác có thể in khác, nhất là phần digest.
Ai nên đọc
Người phụ trách pipeline dữ liệu crawl đã dùng MLflow để ghi metric nhưng chưa ghi dữ liệu. Người huấn luyện model trên dữ liệu web và từng gặp cảnh không biết model cũ học từ bản dữ liệu nào. Người kiểm tra chất lượng cần một quy trình để chấp nhận hay từ chối một run dựa trên nguồn dữ liệu của nó.
Gắn dataset hash và nguồn crawl vào run MLflow để truy vết thí nghiệm với MLflow theo dõi dataset crawl
Trước khi viết code, cần thống nhất ba khái niệm: dataset, digest và context.
Dataset trong MLflow là gì
Theo trang ML Dataset Tracking trong tài liệu MLflow, một dataset gồm tên, digest, nguồn, schema và profile. MLflow không chép dữ liệu vào kho của nó. Nó lưu thông tin mô tả dữ liệu, đủ để nhận ra lần sau bạn có dùng lại đúng bộ đó hay không.
Điều này quan trọng với dữ liệu crawl. Bạn không muốn MLflow giữ một bản sao vài gigabyte HTML. Bạn muốn nó giữ dấu vân tay và chỗ để tìm lại dữ liệu gốc.
Digest là dấu vân tay
Digest là chuỗi ngắn MLflow tính từ nội dung dataset. Hai DataFrame giống nhau cho cùng digest. Đổi một giá trị thì digest đổi. Trong lab, snapshot A có digest a2ffb32d. Đọc lại tệp manifest đó từ đĩa rồi tạo dataset lần nữa vẫn ra a2ffb32d.
Digest giúp tìm run theo dữ liệu. Nhưng nó có giới hạn, sẽ nói ở phần sau. Vì vậy bài dùng thêm một mã SHA-256 tự tính trên toàn bộ tệp manifest.
Nguồn là chỗ để tìm lại dữ liệu
Nguồn cho biết dữ liệu nằm ở đâu: đường dẫn tệp, bảng trong kho dữ liệu, hay URL tải về. MLflow lưu nguồn dưới dạng chuỗi JSON. Với pandas, bạn truyền tham số source khi gọi from_pandas.
Nguồn nên trỏ tới bản lưu trữ bất biến của snapshot, không trỏ tới thư mục đang bị ghi đè hằng ngày. Nếu nguồn là thư mục latest, ba tháng sau nó không còn chứa dữ liệu run cũ đã dùng.
Context nói dataset dùng vào việc gì
Khi gắn dataset vào run, bạn ghi context như training, validation hay evaluation. MLflow lưu context thành một tag tên mlflow.data.context. Cùng một snapshot có thể là tập huấn luyện của run này và tập đánh giá của run khác.
Manifest URL là cầu nối với crawl
Dataset cho model thường đã qua làm sạch, không còn cột URL. Muốn truy ngược về trang web gốc, cần một manifest: danh sách URL, thời điểm tải, mã trạng thái. Manifest được ghi thành artifact của run. Digest của dataset và SHA-256 của manifest cùng nằm trên run đó.
Tạo Dataset object có tên, nguồn và digest trong MLflow theo dõi dataset crawl
Phần này dựng dataset từ một snapshot crawl giả lập.
Snapshot giả lập
Lab tạo hai snapshot của một cửa hàng giả shop.example.vn. Snapshot A tải ngày 02/11 có 40 URL. Snapshot B tải ngày 03/11 có 37 URL, thiếu sản phẩm 5, 6 và 7. Cứ chín sản phẩm có một trang trả 404 và không có giá. Giá ở snapshot B cao hơn A 500 đồng mỗi sản phẩm.
Mỗi URL có tham số token, mô phỏng một API xuất dữ liệu đòi khóa trên URL. Đây là bẫy có chủ ý.
Làm sạch URL trước khi ghi bất cứ thứ gì
Hàm clean tách query của URL, thay giá trị các khóa token, key, apikey, sig bằng chữ REDACTED, rồi ghép lại. Manifest chỉ được ghi sau bước này. Lab kiểm tra lại cuối cùng: trong cả hai manifest không còn chuỗi token gốc nào.
def clean(u):
    s = urlsplit(u)
    q = [(k, "REDACTED" if k.lower() in ("token", "key", "apikey", "sig") else v)
         for k, v in parse_qsl(s.query)]
    return urlunsplit((s.scheme, s.netloc, s.path, urlencode(q), ""))
Tạo dataset từ DataFrame
Sau khi có manifest sạch, lab gọi mlflow.data.from_pandas với ba tham số: source trỏ tới bản lưu trữ của snapshot, name theo dạng shop-crawl cộng tên snapshot, và targets là cột price.
ds = mlflow.data.from_pandas(
    manifest, source=f"file:///crawl/{tag}/manifest.csv",
    name=f"shop-crawl-{tag}", targets="price")
Đối tượng ds có sẵn digest, schema và profile. Với snapshot A, profile ghi 40 dòng và 160 phần tử. Schema liệt kê bốn cột url, fetched_at, status, price.
Đặt tên dataset có quy ước
Tên nên chứa tên nguồn và mã snapshot, không chứa ngày giờ chạy huấn luyện. Lý do: cùng một snapshot có thể được dùng nhiều lần. Nếu tên đổi theo lần chạy, bạn không lọc được các run cùng dữ liệu bằng tên.
Lab thử đổi tên và nguồn của cùng một DataFrame. Digest vẫn là a2ffb32d. Nghĩa là digest chỉ phụ thuộc nội dung, tên và nguồn chỉ là nhãn.
Tự tính SHA-256 cho manifest
Song song với digest của MLflow, lab tính SHA-256 trên tệp manifest đã ghi ra đĩa. Snapshot A cho 2c3c591b27ab6552, snapshot B cho 6c1a9453da284cb1, chỉ in 16 ký tự đầu. Mã này đi vào tag của run và tag của dataset input.
Lý do cần thêm SHA-256 sẽ rõ ở phần thử giới hạn digest. Nói gọn: SHA-256 nhìn toàn bộ tệp, digest của MLflow thì không.
Nên đưa cột nào vào dataset
Dataset gắn vào run nên là đúng bảng mà model đọc, không phải toàn bộ dữ liệu thô. Nếu model chỉ dùng giá và mã sản phẩm, dataset chứa hai cột đó cộng cột URL đã làm sạch. HTML thô không cần nằm trong dataset. Nó nằm trong bản lưu trữ snapshot, được trỏ tới bằng nguồn.
Giữ cột URL trong dataset có lợi khi truy lỗi: từ một dự đoán sai, bạn tìm lại được trang gốc. Nếu không muốn đưa URL vào bảng huấn luyện, hãy giữ một cột mã dòng nối được với manifest.
Digest nhạy với những gì
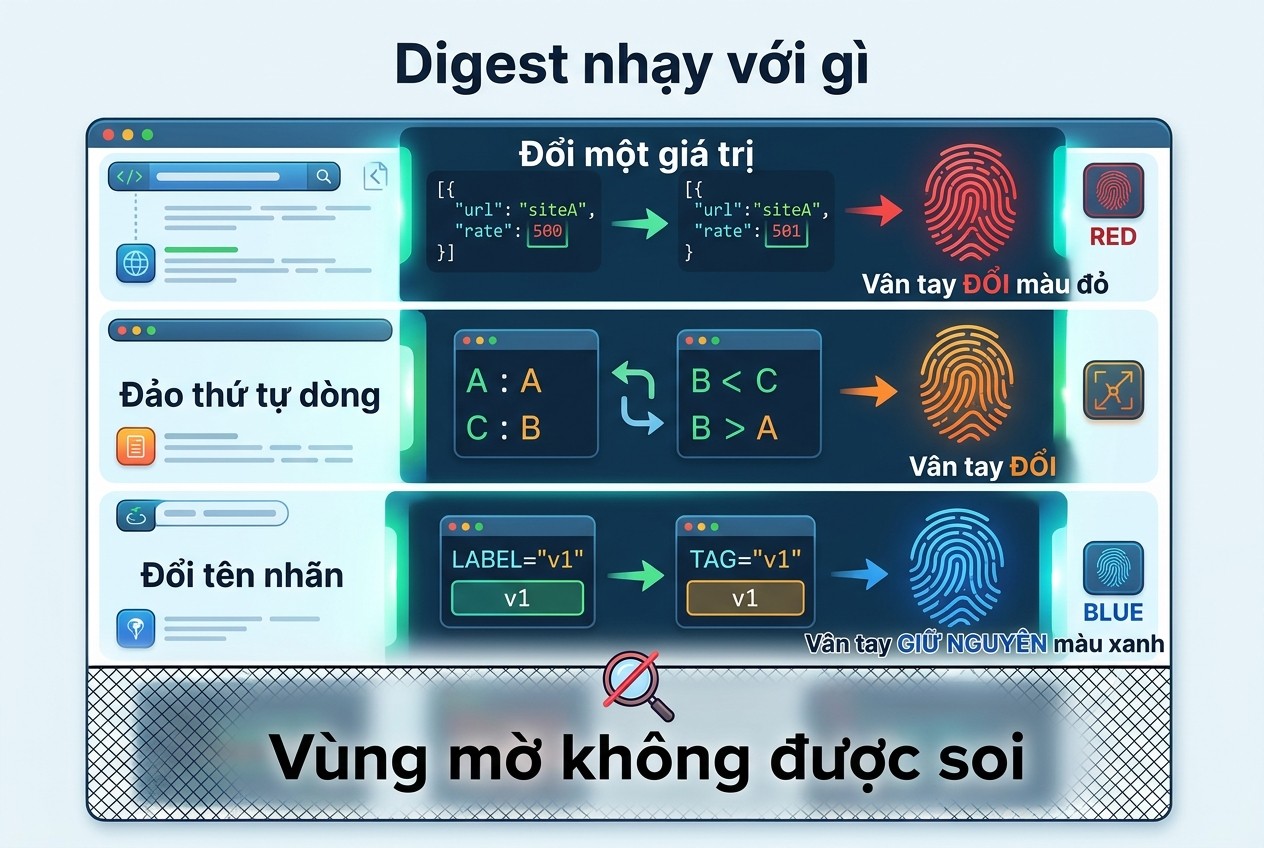
Digest nhạy với gì
Lab đổi giá của một dòng ở vị trí 30. Digest đổi từ a2ffb32d sang ec267eca. Lab đảo ngược thứ tự dòng mà không đổi giá trị nào. Digest đổi sang 4cabb532.
Kết quả thứ hai đáng chú ý. Hai crawler cho cùng tập URL nhưng thứ tự khác nhau sẽ tạo hai digest khác nhau. Muốn digest ổn định, hãy sắp xếp manifest theo URL trước khi tạo dataset.
Digest bỏ sót dữ liệu lớn
Lab nhân snapshot A lên 16.000 dòng rồi đổi giá ở dòng 15.000. Digest không đổi, vẫn là a95eb85d. Đổi giá ở dòng 5.000 thì digest đổi sang a315496c.
Với bản 3.17.2, digest của dataset pandas chỉ phản ánh phần đầu dữ liệu, khoảng mười nghìn dòng đầu theo lần thử này. Snapshot crawl vài trăm nghìn dòng có thể khác nhau ở phần đuôi mà digest vẫn trùng. Đây là lý do bài không dựa riêng vào digest.
Thay đổi |
Digest trước |
Digest sau |
|---|---|---|
Đổi giá dòng 30 (40 dòng) |
a2ffb32d |
ec267eca |
Đảo thứ tự dòng |
a2ffb32d |
4cabb532 |
Đổi tên và nguồn |
a2ffb32d |
a2ffb32d |
Đổi dòng 15.000 (16.000 dòng) |
a95eb85d |
a95eb85d |
Đổi dòng 5.000 (16.000 dòng) |
a95eb85d |
a315496c |
Gắn dataset vào run với context rõ ràng trong MLflow theo dõi dataset crawl
Có dataset rồi, bước tiếp theo là gắn nó vào run cùng các thông tin truy vết.
Gọi log_input
Trong khối start_run, lab gọi mlflow.log_input với dataset, context training và hai tag riêng: crawl_sha256 và snapshot. Tag ở đây gắn vào cặp run và dataset, không gắn vào run.
with mlflow.start_run(run_name=f"train-{tag}") as r:
    mlflow.log_input(ds, context="training",
                     tags={"crawl_sha256": sha[:16], "snapshot": tag})
    mlflow.set_tag("crawl_manifest_sha256", sha)
    mlflow.log_artifact(f"manifest_{tag}.csv", artifact_path="crawl")
Tag của run và tag của dataset input
Lab ghi SHA-256 ở hai chỗ. Bản đầy đủ là tag của run, tên crawl_manifest_sha256, dùng để tìm kiếm. Bản rút gọn 16 ký tự là tag của dataset input, hiện ngay cạnh dataset trong giao diện. Hai chỗ trùng thông tin nhưng phục vụ hai cách đọc khác nhau.
Ghi manifest thành artifact
Manifest được log vào thư mục crawl trong artifact của run. Đọc lại bằng MlflowClient.list_artifacts, run A có crawl/manifest_snap_A.csv, run B có crawl/manifest_snap_B.csv. Ai mở run đều tải được danh sách URL đã dùng.
Với snapshot lớn, manifest có thể nặng. Khi đó nên log manifest đã nén, hoặc chỉ log đường dẫn tới bản lưu trữ kèm SHA-256 để kiểm tra khi tải về.
Tham số cho con người đọc
Lab ghi thêm ba tham số: crawl_snapshot, rows và ok_rows. Run A có 40 dòng, 36 dòng trạng thái 200. Run B có 37 dòng, 33 dòng trạng thái 200. Người xem bảng so sánh run thấy ngay số dòng khác nhau mà không cần mở dataset.
Một run, cùng dataset, hai context
Lab gắn cùng một dataset ba lần vào một run: hai lần context training, một lần context eval. Đọc lại run chỉ thấy một dataset input với context training. Lần gắn thứ ba không tạo dòng mới và không đổi context.
Nghĩa là trong bản 3.17.2, muốn dùng cùng snapshot cho cả huấn luyện lẫn đánh giá trong một run, hãy tạo hai dataset với tên khác nhau, ví dụ thêm hậu tố train và eval. Nếu không, bạn chỉ thấy một context và có thể hiểu sai run đã làm gì.
Tên experiment theo nguồn crawl
Lab dùng một experiment tên crawl-price-model cho mọi snapshot của một cửa hàng. Khi có nhiều nguồn crawl, nên tách experiment theo bài toán, không theo nguồn. Nguồn đã nằm trong dataset, lọc được bằng dataset.name. Tách experiment theo nguồn làm khó việc so sánh run giữa hai nguồn cho cùng một model.
Gắn dataset trước khi huấn luyện
Thứ tự nên là: tạo dataset, log_input, rồi mới huấn luyện. Nếu huấn luyện lỗi giữa chừng, run vẫn còn thông tin dữ liệu để điều tra. Gắn ở cuối thì run lỗi mất luôn dấu vết dữ liệu.
Chạy hai run dùng hai snapshot nguồn với MLflow theo dõi dataset crawl
Phần này chạy thật hai run và đọc lại những gì MLflow lưu.
Lệnh chạy
Lab chạy một tệp Python duy nhất với backend sqlite:///mlruns.db và experiment crawl-price-model. Kết quả in ra:
snap_A run 11c28f7a mlflow digest a2ffb32d sha256 2c3c591b27ab6552 rows 40
snap_B run 167c744a mlflow digest f3a12e9e sha256 6c1a9453da284cb1 rows 37
digest lai snap_A: a2ffb32d
Hai digest khác nhau như dự kiến
Snapshot B thiếu ba URL và giá cao hơn, nên digest f3a12e9e khác a2ffb32d. SHA-256 cũng khác. Đây là kết quả mong đợi. Điều cần kiểm là digest có ổn định khi đọc lại cùng tệp không, và dòng thứ ba trả lời là có.
Metric đi kèm run
Run A ghi MAE 1234,5, run B ghi 1180,2. Hai con số này ghi tay, không đến từ model thật. Chúng chỉ để minh họa: khi so hai run trong giao diện, bạn thấy cột MAE đặt cạnh dataset và số dòng.
Nếu MAE của run B xấu đi thay vì tốt lên, lineage cho bạn điểm bắt đầu: B thiếu sản phẩm 5, 6, 7 và giá đổi đồng loạt. Có thể đó là nguyên nhân, cũng có thể không. Nhưng ít nhất bạn biết dữ liệu đã khác ở đâu.
Profile không phải bằng chứng đầy đủ
Profile của dataset chỉ ghi số dòng và số phần tử. Nó không cho biết có bao nhiêu trang 404 hay khoảng giá. Muốn ghi những con số đó, hãy log thành tham số hoặc metric, như lab làm với ok_rows.
Không có dữ liệu thô trong kho MLflow
Sau khi chạy, lab kiểm tra kho SQLite. Bảng datasets chỉ có tên, digest, nguồn, schema và profile. Không có giá trị giá nào được lưu. Dữ liệu thật chỉ có trong artifact manifest mà bạn tự log, và trong bản lưu trữ snapshot mà nguồn trỏ tới.
Chạy lại run cũ với cùng snapshot
Muốn tái hiện run A, người kiểm tra tải manifest từ artifact, tìm snapshot gốc theo nguồn, tính lại SHA-256 và so với tag. Khớp thì dữ liệu đúng là bộ cũ. Sau đó họ tạo lại dataset và so digest với a2ffb32d. Lab làm đúng bước này với snapshot A và digest khớp.
Nếu SHA-256 khớp mà digest lệch, nguyên nhân thường là thứ tự dòng hoặc kiểu dữ liệu đọc vào khác, ví dụ cột giá đọc thành số thực thay vì số nguyên. Ghi rõ cách đọc tệp trong mã huấn luyện để tránh chuyện này.
Hai run trong giao diện
Giao diện MLflow hiện cột Dataset ở danh sách run. Lab không mở giao diện web, chỉ đọc qua API. Trong bản 3.17.2, dữ liệu API trả về đủ để dựng lại cột đó, gồm tên, digest và context.
Truy ngược run về dataset và URL manifest mà không ghi secrets với MLflow theo dõi dataset crawl
Phần này đi chiều ngược lại: từ dataset tìm run, từ run tìm URL.
Đọc inputs của từng run
Lab dùng MlflowClient.search_runs để lấy mọi run trong experiment, rồi đọc run.inputs.dataset_inputs. Mỗi phần tử có dataset và danh sách tag.
train-snap_A | shop-crawl-snap_A | a2ffb32d | local | file:///crawl/snap_A/manifest.csv | snapshot snap_A, crawl_sha256 2c3c591b27ab6552, context training
train-snap_B | shop-crawl-snap_B | f3a12e9e | local | file:///crawl/snap_B/manifest.csv | snapshot snap_B, crawl_sha256 6c1a9453da284cb1, context training
Tìm run theo digest dataset
mlflow.search_runs hỗ trợ bộ lọc dataset.digest. Lọc theo a2ffb32d trả về đúng train-snap_A. Lọc theo dataset.context bằng training trả về cả hai run. Đây là cách trả lời câu hỏi snapshot này đã được dùng ở những đâu.
Tìm run theo SHA-256 manifest
Lọc tags.crawl_manifest_sha256 bằng mã đầy đủ của snapshot B trả về train-snap_B. Với dữ liệu lớn, nơi digest có thể trùng do chỉ nhìn phần đầu, đây là bộ lọc nên dùng.
Bảng lineage
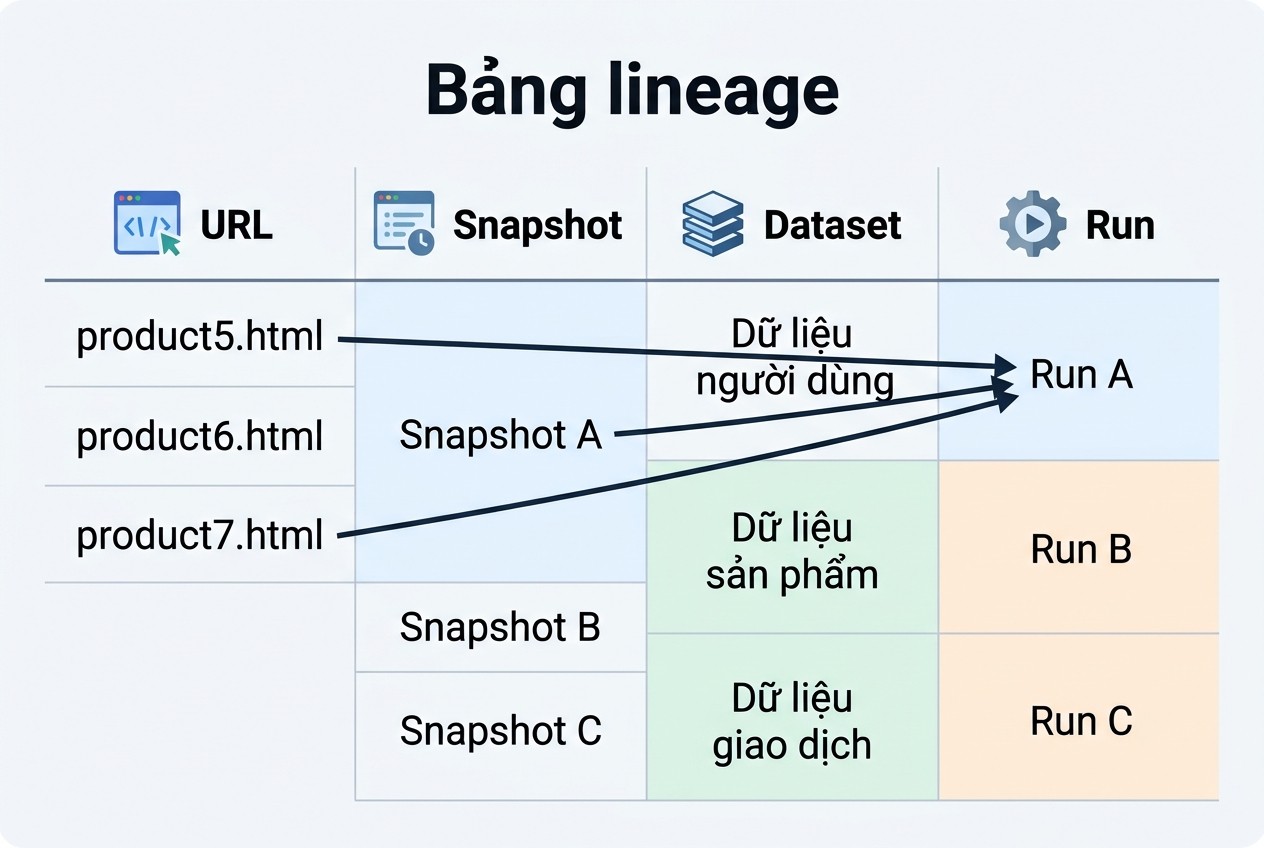
Bảng lineage
Ghép thông tin từ hai chiều, lab dựng được bảng lineage sau.
Run |
Dataset |
Digest |
SHA-256 manifest |
Số URL |
URL chỉ có ở A |
|---|---|---|---|---|---|
train-snap_A |
shop-crawl-snap_A |
a2ffb32d |
2c3c591b27ab6552 |
40 |
/p/5, /p/6, /p/7 |
train-snap_B |
shop-crawl-snap_B |
f3a12e9e |
6c1a9453da284cb1 |
37 |
không có |
Cột cuối lấy từ phép trừ tập URL giữa hai manifest. Lab in ra đúng ba URL sản phẩm 5, 6, 7, với token đã được thay bằng REDACTED.
Bẫy token trong nguồn
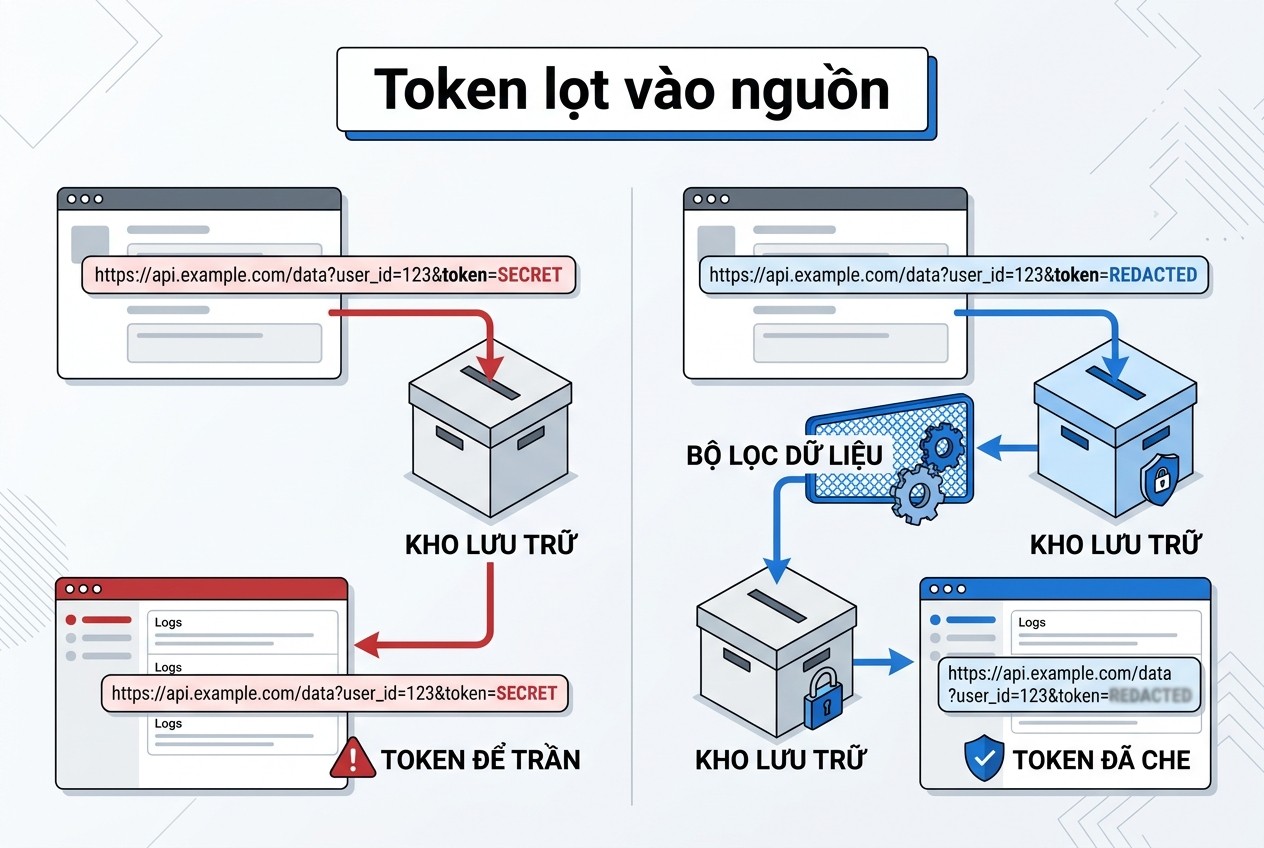
Token lọt vào nguồn
Lab thử tạo dataset với source là một URL API chứa token=SECRET123, rồi log vào run. Đọc lại, nguồn được lưu nguyên văn kèm token. MLflow không lọc secrets trong chuỗi nguồn.
Kho MLflow thường được nhiều người đọc. Token nằm trong nguồn dataset sẽ hiện trong giao diện, trong API, và trong mọi bản sao lưu của kho. Quy tắc của bài là làm sạch URL trước khi đưa vào bất kỳ tham số nào của MLflow: nguồn, tham số, tag, tên.
Bẫy token trong artifact
Manifest là artifact, nên nếu bạn log manifest chứa URL có token, token nằm trong kho artifact. Lab kiểm tra cuối cùng bằng cách tìm chuỗi token gốc trong cả hai manifest: không còn chuỗi nào. Nên giữ bước kiểm này trong quy trình, chạy trước log_artifact.
Khi snapshot gốc bị xóa
Nguồn chỉ là chuỗi trỏ tới dữ liệu. Nếu bản lưu trữ bị xóa, run vẫn còn digest, SHA-256 và manifest, nhưng không còn dữ liệu để huấn luyện lại. Lineage khi đó vẫn có giá trị: nó cho biết những URL nào đã dùng, và bạn có thể crawl lại để so. Có điều, trang web đã đổi nên kết quả crawl lại không bao giờ trùng snapshot cũ.
Cookie và header không thuộc về manifest
Ngoài token trên URL, crawler còn dùng cookie phiên và header xác thực. Những thứ này không bao giờ cần cho lineage. Manifest chỉ cần URL đã làm sạch, thời điểm tải, mã trạng thái và có thể là SHA-256 của nội dung trang.
Cấu hình proxy cũng là secret
Nếu crawler đi qua proxy có xác thực, chuỗi proxy thường chứa user và mật khẩu. Đừng log chuỗi đó thành tham số để ghi nhớ crawler đã dùng proxy nào. Nếu cần, chỉ log nhãn như vn-static hay không dùng proxy. Cách viết chuỗi proxy đúng định dạng có trong bài định dạng proxy.
Đầu ra nghiệm thu: hai run với dataset khác nhau và bảng lineage URL snapshot dataset run của MLflow theo dõi dataset crawl
Phần cuối gom kết quả thành bộ bàn giao và quy trình dùng hằng ngày.
Bộ bàn giao
Bộ bàn giao gồm kho mlruns.db với hai run, hai manifest đã làm sạch, bảng lineage ở trên và tệp lab.py chạy lại được. Người nhận chạy lại tệp, đối chiếu digest và SHA-256 với bảng. Khớp là đạt.
Tiêu chí đạt
Mỗi run có đúng một dataset input mỗi context, có tag SHA-256 đầy đủ, có artifact manifest. Tìm theo digest và theo SHA-256 đều ra đúng run. Không chuỗi secret nào xuất hiện trong nguồn, tham số, tag hay artifact.
Quy trình đề xuất cho mỗi snapshot
Bước một, crawler ghi snapshot vào chỗ lưu trữ bất biến, ví dụ thư mục mang ngày tải. Bước hai, dựng manifest, làm sạch URL, sắp xếp theo URL, tính SHA-256. Bước ba, tạo dataset với nguồn trỏ tới bản lưu trữ. Bước bốn, trong run, log_input trước, huấn luyện sau, log manifest làm artifact.
Khi nào cần proxy với MLflow theo dõi dataset crawl
MLflow ghi lineage ngay trên máy hoặc qua máy chủ tracking nội bộ, không cần proxy. Proxy chỉ liên quan tới bước crawl, xảy ra trước khi có dataset. Nếu máy chủ tracking nằm ngoài mạng công ty, client MLflow gọi qua HTTP và đọc biến môi trường HTTPS_PROXY như các thư viện Python khác.
Với bước crawl website được phép, có lúc cần IP tại Việt Nam để nhận đúng giá hiển thị cho người dùng trong nước. Khi đó anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Proxy không sửa lineage, không làm digest đáng tin hơn. Vai trò hợp lệ của proxy trong thu thập dữ liệu được giải thích ở bài Web Scraping proxy là gì.
Lưu giữ snapshot bao lâu
Thời gian giữ snapshot nên ít nhất bằng thời gian một model còn chạy thật. Model đang phục vụ người dùng mà snapshot huấn luyện đã mất thì không điều tra được khi có sự cố. Snapshot của run thử nghiệm bị bỏ có thể xóa sớm hơn, miễn là ghi chú lại trên run.
Khi xóa snapshot, hãy đặt tag trên run, ví dụ snapshot_deleted kèm ngày xóa. Người mở run sau này biết ngay không cần đi tìm dữ liệu.
Ghi nhãn proxy vào manifest
Nếu giá trả về phụ thuộc vùng IP, manifest nên có cột vùng tải, ví dụ VN hoặc SG. Hai snapshot cùng URL nhưng khác vùng là hai dataset khác nhau. Không có cột này, bạn có thể so hai run và tưởng giá thay đổi theo ngày, trong khi thật ra chỉ đổi vùng.
Chuẩn hóa trước khi tạo dataset
Dữ liệu crawl thường lẫn chuỗi giá có dấu chấm, đơn vị tiền, khoảng trắng. Nên chuẩn hóa kiểu dữ liệu trước khi tạo dataset, để schema MLflow ghi đúng kiểu. Cách dùng Pydantic cho bước này có trong bài Pydantic chuẩn hóa dữ liệu crawl.
Kiểm tra tự động trước khi log
Có thể biến các quy tắc của bài thành một hàm kiểm chạy trước log_input. Hàm này tìm các khóa token, key, sig trong mọi URL của manifest, kiểm manifest đã sắp xếp, và kiểm chuỗi nguồn không chứa dấu hỏi kèm tham số nhạy cảm. Có lỗi thì dừng, không tạo run. Cách này rẻ hơn nhiều so với việc dọn token khỏi kho MLflow sau khi đã lộ.
Quyền đọc kho MLflow
Kho MLflow thường mở cho cả nhóm dữ liệu. Nếu manifest chứa URL của trang cần đăng nhập, danh sách URL đó đã là thông tin nhạy cảm. Nên tách experiment chứa dữ liệu như vậy và giới hạn quyền đọc, hoặc chỉ log SHA-256 của manifest thay vì log nguyên tệp.
Những gì lab chưa thử
Lab chưa thử máy chủ tracking từ xa, chưa thử dataset dạng Spark hay Delta, chưa thử mlflow.evaluate với dataset gắn vào. Lab cũng chưa đo giới hạn digest chính xác bằng cách đọc mã nguồn, chỉ quan sát bằng hai lần đổi dòng. Ai dùng dữ liệu trên mười nghìn dòng nên tự lặp lại phép thử với phiên bản đang dùng.
Checklist MLflow theo dõi dataset crawl
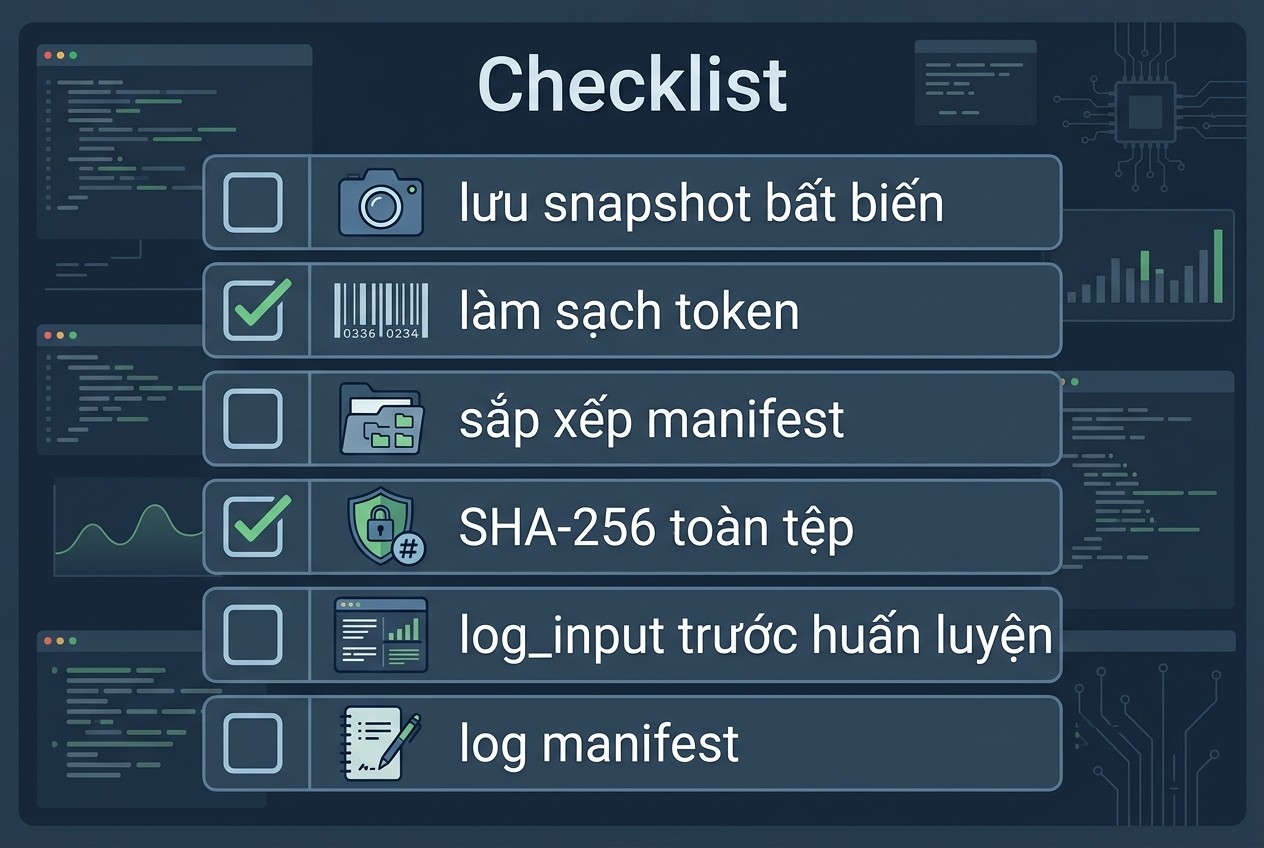
Checklist
- Snapshot lưu ở chỗ bất biến, nguồn dataset trỏ tới đó.
- URL làm sạch token, key, sig trước khi vào manifest.
- Manifest sắp xếp theo URL trước khi tính digest.
- SHA-256 toàn tệp ghi vào tag của run.
- Mỗi context dùng một dataset riêng tên.
- log_input chạy trước bước huấn luyện.
- Manifest log làm artifact, kiểm không còn secret.
- Chuỗi proxy và cookie không vào tham số hay tag.
Câu hỏi thường gặp về MLflow theo dõi dataset crawl
MLflow có lưu dữ liệu crawl không?
Không. MLflow lưu tên, digest, nguồn, schema và profile. Dữ liệu thật nằm ở chỗ nguồn trỏ tới hoặc trong artifact bạn tự log.
Digest có đủ để nhận ra snapshot không?
Với dữ liệu nhỏ thì đủ. Lab cho thấy với 16.000 dòng, đổi dòng 15.000 không làm digest đổi, nên cần thêm SHA-256 toàn tệp.
Vì sao đảo thứ tự dòng làm digest đổi?
Digest tính trên nội dung theo thứ tự hiện có. Sắp xếp manifest theo URL trước khi tạo dataset để digest ổn định.
Có thể dùng một dataset cho cả training và eval trong một run không?
Trong bản 3.17.2, gắn lần hai với context khác không tạo dòng mới. Hãy tạo hai dataset với hai tên khác nhau.
MLflow có tự che token trong nguồn không?
Không. Lab lưu nguồn chứa token và đọc lại nguyên văn. Phải làm sạch URL trước khi gọi from_pandas.
Theo dõi dataset có cần proxy không?
Không. Chỉ bước crawl hoặc lời gọi tới máy chủ tracking ngoài mạng công ty mới có thể cần.
MLflow theo dõi dataset crawl và những điều cần nhớ
MLflow theo dõi dataset crawl giúp trả lời model nào học từ snapshot nào, với điều kiện bạn gắn dataset đúng cách và không tin hết vào digest. Lab với hai snapshot cho thấy digest ổn định khi đọc lại, nhạy với thứ tự dòng, bỏ sót thay đổi ở phần đuôi dữ liệu lớn, và nguồn chứa token được lưu nguyên văn. Thêm SHA-256 toàn tệp, làm sạch URL, sắp xếp manifest là đủ để lineage đáng tin. Cần IP tĩnh cho bước crawl trước khi MLflow theo dõi dataset crawl, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


