
Lỗi proxy Crawl4AI: đọc thông báo lỗi và sửa đúng chỗ
Lỗi proxy Crawl4AI thường hiện ra dưới dạng một dòng thông báo dài, khó đoán nguyên nhân nằm ở proxy, ở trình duyệt hay ở website. ProxyVN dựng lại mười tình huống lỗi thật với Crawl4AI 0.9.5 qua một proxy có mật khẩu, ghi đúng thông báo nhận được và cách sửa. Bài dành cho anh em đã gắn proxy theo hướng dẫn nhưng crawler vẫn chạy không như mong đợi.
Lỗi proxy Crawl4AI thường gặp và cách đọc kết quả
Trước khi sửa lỗi, cần đọc đúng kết quả Crawl4AI trả về. Mỗi lần gọi arun trả về một đối tượng kết quả, và lỗi proxy có thể nằm ở ba chỗ khác nhau trong đối tượng đó.
Ba trường cần đọc
Trường success cho biết lần crawl có được coi là thành công không. Trường status_code là mã HTTP website trả về, rỗng nếu không tới được website. Trường error_message chứa thông báo lỗi chi tiết, thường kèm mã lỗi của trình duyệt như ERR_PROXY_CONNECTION_FAILED.
Ba trường này phải đọc cùng nhau. success bằng False với status 200 nghĩa là đã tải được trang nhưng Crawl4AI cho rằng trang đó là trang chặn, khác hẳn với success bằng False và status rỗng, tức không tới được website. Phần lớn người dùng chỉ nhìn success nên sửa nhầm chỗ.
Từ bản 0.9.x còn có thêm trường crawl_stats, ghi số lần thử, các proxy đã dùng và lý do lỗi của từng proxy. Trường này đặc biệt hữu ích khi dùng nhiều proxy, phần cuối bài sẽ dùng nó. Khi gỡ lỗi, mình in cả bốn trường cho mỗi trang thay vì chỉ in nội dung trích xuất, vì nội dung rỗng không nói được gì về nguyên nhân.
Bảng tra nhanh
Bảng dưới gom các tình huống mình tái hiện được, kèm thông báo nhận được và nguyên nhân. Các phần sau giải thích từng dòng và cách sửa.
Tình huống |
Thông báo nhận được |
Nguyên nhân |
|---|---|---|
Sai cổng hoặc proxy chết |
net::ERR_PROXY_CONNECTION_FAILED |
Không kết nối được tới proxy |
Sai mật khẩu |
net::ERR_HTTP_RESPONSE_CODE_FAILURE |
Proxy trả 407 |
Chuỗi proxy chưa mã hóa |
net::ERR_PROXY_CONNECTION_FAILED |
Tách sai địa chỉ proxy |
SOCKS5 có tài khoản |
Browser does not support socks5 proxy authentication |
Chromium không hỗ trợ |
Trang quá chậm |
Page.goto: Timeout ...ms exceeded |
Hết thời gian chờ |
Trang rất ngắn trả 200 |
Blocked by anti-bot protection: Near-empty content |
Bộ phát hiện chặn của Crawl4AI |
Trang 403, 503 dạng HTML |
Blocked by anti-bot protection: HTTP 403 ... |
Website chặn hoặc quá tải |
Bài này khác bài hướng dẫn cấu hình
ProxyVN đã có bài Crawl4AI proxy hướng dẫn cài đặt, gắn proxy theo request, xoay vòng và chạy bằng Docker. Bài này giả định anh em đã làm theo hướng dẫn đó và đang gặp lỗi.
Nếu chưa gắn proxy lần nào, đọc bài hướng dẫn trước. Nếu đã gắn mà crawler báo lỗi, chạy chậm bất thường hay dữ liệu trống, đọc tiếp bài này.
Chuẩn bị môi trường tái hiện lỗi proxy Crawl4AI
Để biết chắc mỗi thông báo lỗi ứng với nguyên nhân nào, mình dựng môi trường có thể cố ý gây ra từng lỗi. Cách này cũng là cách anh em nên dùng khi gỡ lỗi: thu hẹp về một trang thử và một proxy, rồi thay từng yếu tố.
Phiên bản đã dùng
Kiểm tra ngày 25/10/2026, môi trường thử gồm:
- Crawl4AI 0.9.5, bản mới nhất trên PyPI tại thời điểm thử, cài trong môi trường ảo Python 3.12.10.
- Playwright 1.64.1, thư viện mà Crawl4AI dùng để điều khiển trình duyệt.
- Microsoft Edge 156 ở chế độ headless, gọi qua tham số chrome_channel.
Tên lỗi trong bài là của nhân Chromium, nên Chrome hay Chromium do Playwright tải về cũng báo giống vậy. Với Firefox hay WebKit, mã lỗi có thể khác.
Site thử và proxy có ghi log
Site thử có một trang trả về địa chỉ IP người gọi và header Via, một trang danh sách sản phẩm, và một trang cố ý chờ 8 giây mới trả lời. Proxy thử yêu cầu tài khoản user1, mật khẩu p@ss#2026, thêm header Via vào mọi request đi qua và ghi log từng request.
Nhờ header Via, mình biết chắc trang tải về có đi qua proxy hay không. Nhờ log proxy, mình thấy được cả những request trình duyệt tự gửi mà code không yêu cầu.
Khung chạy từng tình huống
Đoạn dưới là khung mình dùng để chạy từng tình huống: mỗi lần mở trình duyệt mới, tải một URL với một cấu hình proxy, rồi in ba trường kết quả cùng thời gian chạy. Anh em có thể dùng lại khung này để thử proxy của mình.
import asyncio, json, time
from crawl4ai import AsyncWebCrawler, BrowserConfig, CacheMode, CrawlerRunConfig, ProxyConfig

async def run(url, proxy, page_timeout=60000):
    browser = BrowserConfig(headless=True, verbose=False)
    cfg = CrawlerRunConfig(cache_mode=CacheMode.BYPASS, proxy_config=proxy, page_timeout=page_timeout)
    t = time.perf_counter()
    try:
        async with AsyncWebCrawler(config=browser) as c:
            r = await c.arun(url=url, config=cfg)
        out = {"success": r.success, "status": r.status_code, "error": (r.error_message or "")[:200]}
    except Exception as e:
        out = {"exception": f"{type(e).__name__}: {str(e)[:200]}"}
    out["seconds"] = round(time.perf_counter() - t, 1)
    print(json.dumps(out, ensure_ascii=False))

asyncio.run(run("https://example.com/",
                ProxyConfig(server="http://ip-proxy:port", username="user", password="pass")))
Đặt cache_mode bằng BYPASS là bắt buộc khi gỡ lỗi. Nếu để bộ nhớ đệm bật, Crawl4AI có thể trả lại kết quả cũ đã lưu, và anh em sẽ tưởng proxy đang chạy trong khi request không hề được gửi đi.
Lỗi proxy Crawl4AI khi kết nối: sai cổng, sai mật khẩu, chuỗi proxy hỏng
Nhóm lỗi đầu tiên xảy ra trước khi tới được website. Trường status_code rỗng là dấu hiệu nhận biết nhóm này.
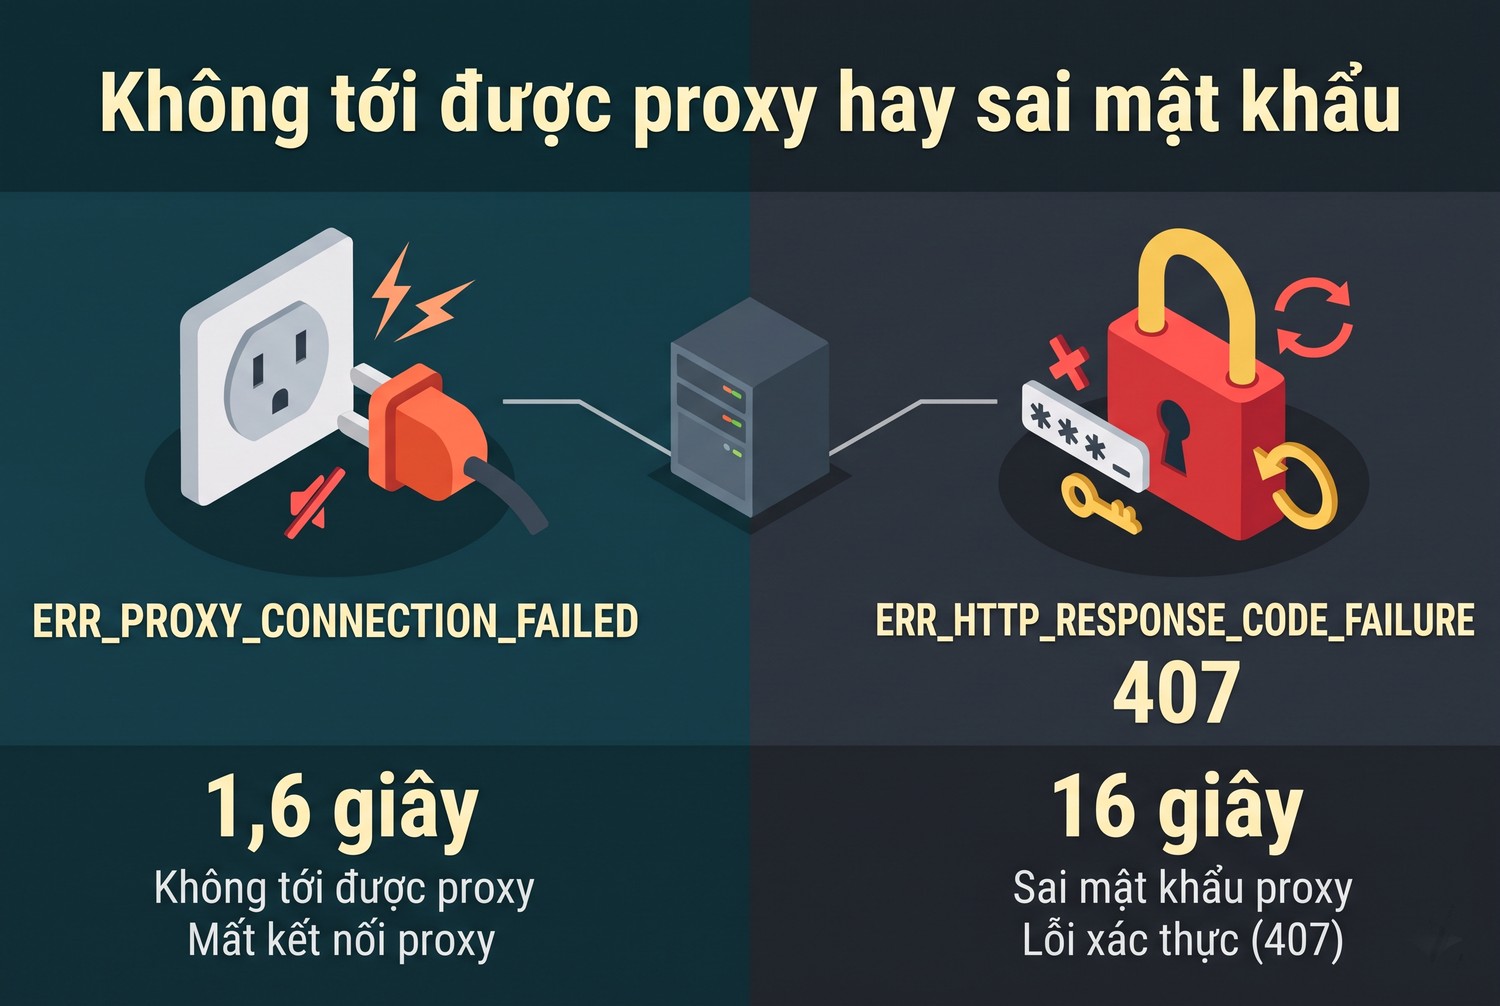
Không tới được proxy hay sai mật khẩu
ERR_PROXY_CONNECTION_FAILED: không tới được proxy
Mình đặt proxy với cổng không có gì lắng nghe. Sau 1,6 giây, Crawl4AI báo lỗi với thông báo Page.goto: net::ERR_PROXY_CONNECTION_FAILED. Lỗi này nghĩa là trình duyệt không mở được kết nối tới địa chỉ proxy.
Các nguyên nhân thường gặp là sai địa chỉ hoặc cổng, hay proxy đã hết hạn và nhà cung cấp tắt cổng. Cũng có thể tường lửa máy chủ chặn kết nối ra cổng đó, hoặc proxy chỉ cho phép IP đã đăng ký trong danh sách trắng. Cách kiểm nhanh nhất là gọi thử bằng curl từ đúng máy đang chạy Crawl4AI.
curl -x http://user:pass@ip-proxy:port https://api.ipify.orgNếu curl cũng lỗi, vấn đề nằm ở proxy hoặc mạng, không phải ở Crawl4AI. Nếu curl chạy được mà Crawl4AI lỗi, kiểm lại chuỗi proxy trong code. Bài lỗi ERR_MANDATORY_PROXY_CONFIGURATION_FAILED giải thích thêm một nhóm lỗi cấu hình proxy khác của Chromium.
ERR_HTTP_RESPONSE_CODE_FAILURE: sai mật khẩu
Với mật khẩu sai, thông báo là net::ERR_HTTP_RESPONSE_CODE_FAILURE, và lần chạy mất tới 16,1 giây trước khi báo lỗi. Log proxy cho thấy trình duyệt gửi lại nhiều lần, lần nào cũng nhận 407.
Thông báo này không nhắc gì tới mật khẩu, nên dễ bị hiểu nhầm là lỗi của website. Khi thấy mã lỗi này cùng status rỗng, việc đầu tiên là kiểm user và mật khẩu proxy. Thời gian chờ dài cũng là dấu hiệu: proxy chết báo lỗi gần như ngay, còn sai mật khẩu thì chậm hơn nhiều.
Chuỗi proxy chưa mã hóa làm hỏng địa chỉ
Crawl4AI có hàm ProxyConfig.from_string để đọc chuỗi proxy. Mình đưa vào chuỗi http://user1:p@ss#2026@127.0.0.1:8842 với mật khẩu viết thẳng. Kết quả là ERR_PROXY_CONNECTION_FAILED, vì hàm tách sai: địa chỉ máy chủ bị hiểu thành một chuỗi chứa ss#2026, mật khẩu chỉ còn chữ p.
Cùng proxy đó viết theo dạng ip:port:user:pass, tức 127.0.0.1:8842:user1:p@ss#2026, thì hàm tách đúng và trang tải về có header Via của proxy. Viết theo dạng URL nhưng mã hóa @ thành %40, dấu thăng thành %23 cũng chạy đúng.
Cách an toàn nhất là không ghép mật khẩu vào URL, mà truyền riêng qua username và password của ProxyConfig. Bài định dạng proxy hướng dẫn tách đúng từng phần của chuỗi nhà cung cấp gửi.
Request đầu tiên luôn nhận 407
Trong mọi lần chạy thành công, log proxy đều ghi request đầu tiên tới trang không có thông tin xác thực, proxy trả 407, rồi trình duyệt gửi lại kèm tài khoản. Đây là cách trình duyệt nhân Chromium làm việc với proxy có mật khẩu, không phải lỗi.
Anh em thấy một lượng 407 đều đặn trong thống kê của nhà cung cấp proxy thì không cần lo. Chỉ khi 407 lặp lại nhiều lần liên tiếp cho cùng một trang, như tình huống sai mật khẩu ở trên, mới là có vấn đề.
Lỗi proxy Crawl4AI do giao thức: SOCKS5 có mật khẩu và HTTPS
Nhóm lỗi thứ hai đến từ giới hạn của trình duyệt với từng loại giao thức proxy. Đây là những lỗi không sửa được bằng cách viết lại chuỗi proxy, mà phải đổi loại proxy hoặc đổi cách kết nối.
SOCKS5 có tài khoản không được hỗ trợ
Mình đặt server là socks5:// kèm username và password. Crawl4AI báo lỗi ngay ở bước tạo phiên trình duyệt, thông báo Browser does not support socks5 proxy authentication, sau 1,4 giây, chưa gửi request nào.
Lỗi này đến từ Playwright và trình duyệt nhân Chromium: chúng không gửi được tài khoản cho proxy SOCKS5. Có hai cách xử lý. Cách thứ nhất là dùng proxy HTTP có tài khoản thay cho SOCKS5. Cách thứ hai là dùng SOCKS5 xác thực bằng IP trong danh sách trắng, không cần mật khẩu. Bài proxy HTTP và SOCKS5 giải thích khác biệt giữa hai giao thức.
HTTPS đi qua đường hầm CONNECT
Với trang HTTPS, trình duyệt gửi lệnh CONNECT tới proxy để mở đường hầm mã hóa, rồi nói chuyện trực tiếp với website qua đường hầm đó. Mình tải trang example.com qua proxy thử, kết quả thành công với status 200 sau 7,9 giây, log proxy ghi CONNECT example.com:443.
Proxy không hỗ trợ CONNECT, thường là proxy nội bộ cấu hình chặt, sẽ làm mọi trang HTTPS lỗi trong khi trang HTTP vẫn chạy. Khi thấy lỗi chỉ xảy ra với HTTPS, kiểm proxy có cho phép CONNECT tới cổng 443 không. Lỗi chứng chỉ khi đi qua proxy thì xem thêm bài ERR_PROXY_CERTIFICATE_INVALID.
Địa chỉ nội bộ có đi qua proxy không
Mặc định, trình duyệt nhân Chromium không cho địa chỉ 127.0.0.1 và localhost đi qua proxy. Nhưng khi chạy thử Crawl4AI và Playwright 1.64.1 không thêm tham số gì, request tới 127.0.0.1 vẫn đi qua proxy, header Via có mặt. Playwright đã tự xử lý chuyện này khi khởi động trình duyệt có proxy.
Chi tiết này chỉ quan trọng khi anh em thử nghiệm với site chạy trên máy. Nếu thấy trang nội bộ tải được mà proxy không ghi log, kiểm tham số --proxy-bypass-list trong extra_args của BrowserConfig xem có ai đặt danh sách bỏ qua proxy không.
Lỗi proxy Crawl4AI giả: trang tải được vẫn bị đánh dấu chặn
Đây là nhóm lỗi dễ làm anh em mất thời gian nhất, vì proxy hoạt động bình thường nhưng kết quả vẫn báo thất bại.
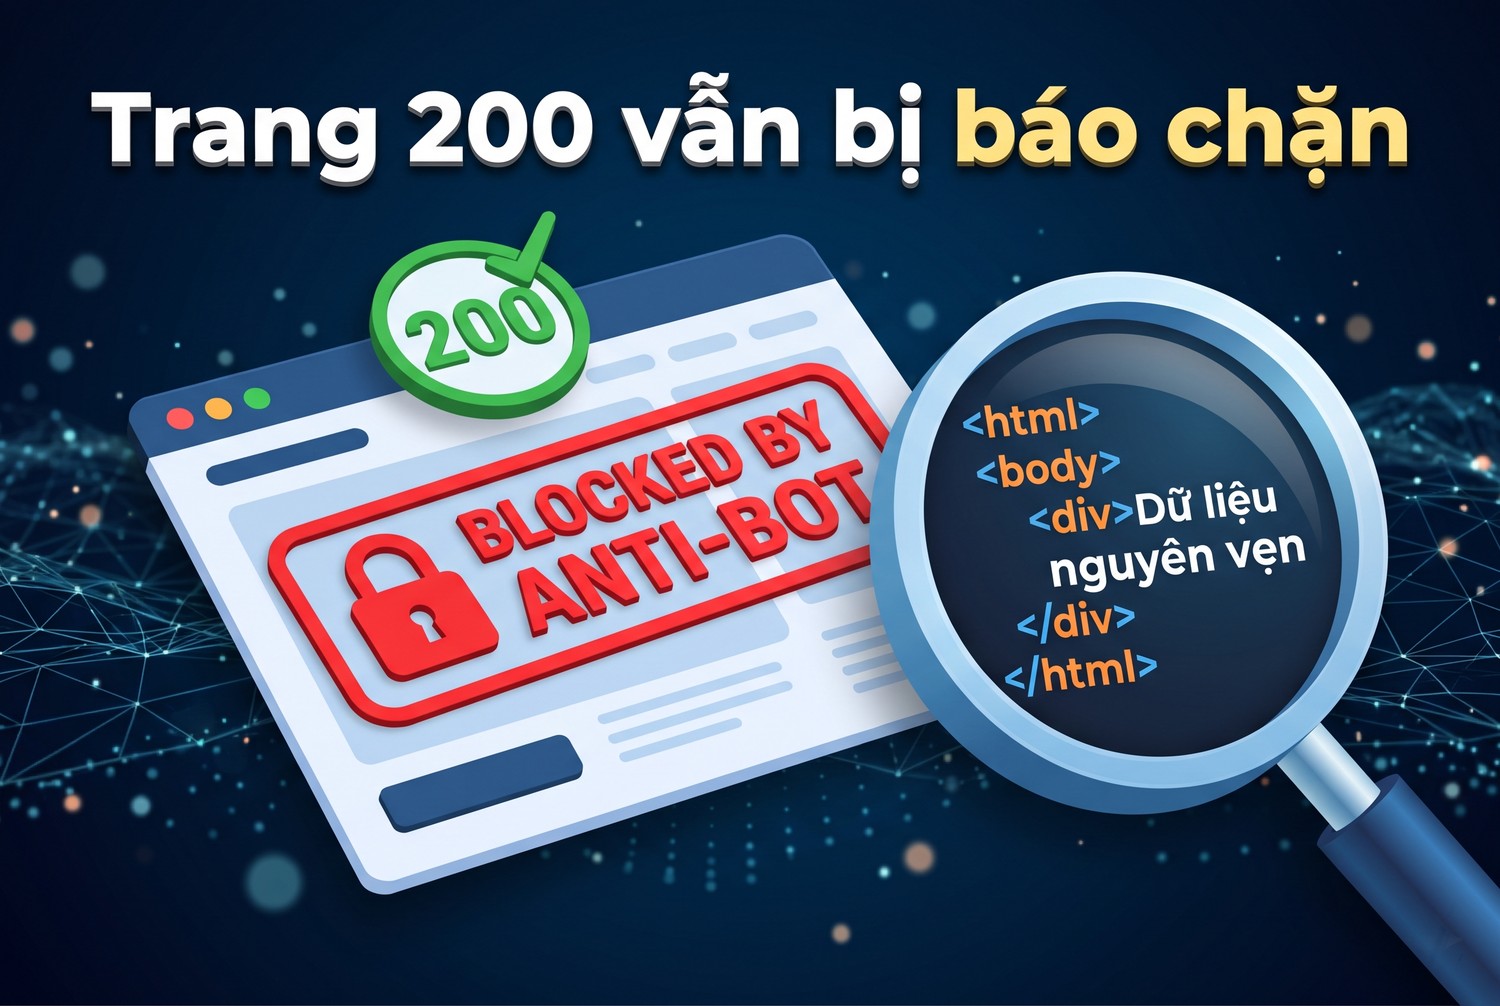
Trang 200 vẫn bị báo chặn
Trang ngắn bị coi là trang chặn
Lần chạy đầu tiên với cấu hình đúng, trang thử chỉ dài 92 byte. Header Via có mặt, tức đã đi qua proxy, status là 200, nhưng success lại là False với thông báo Blocked by anti-bot protection: Near-empty content (92 bytes) with HTTP 200.
Mình mở mã nguồn Crawl4AI 0.9.5 để tìm nguyên nhân. File antibot_detector.py có ngưỡng 100 byte: trang trả 200 mà nội dung dưới 100 byte và không giống dữ liệu JSON sẽ bị coi là trang chặn, vì nhiều hệ thống chống bot trả về trang trống. Trang thật ngoài đời hiếm khi ngắn như vậy, nhưng các API trả chữ thuần như trang hiển thị IP thì có.
Các quy tắc khác của bộ phát hiện chặn
Cũng trong file đó, Crawl4AI luôn coi mã 429 là bị giới hạn tốc độ. Mã 403 và 503 có nội dung HTML cũng luôn bị coi là chặn, kể cả khi đó là trang lỗi bình thường của website. Bộ phát hiện còn tìm các mẫu chữ đặc trưng của trang chặn trong nội dung.
Hệ quả thực tế: success bằng False chưa chắc là proxy hỏng. Đọc error_message, nếu bắt đầu bằng Blocked by anti-bot protection thì trang đã tải về, chỉ là bị đánh giá là trang chặn. Lúc đó mở trường html để xem nội dung thật trước khi đổi proxy.
Phân biệt chặn thật và chặn giả
Danh sách dưới là cách mình phân loại khi thấy thông báo Blocked by anti-bot protection:
- Near-empty content với trang vốn ngắn như API trả IP: chặn giả, dữ liệu vẫn nằm trong trường html.
- HTTP 403 với nội dung có chữ xác minh, Cloudflare hay captcha: chặn thật, cần đổi loại proxy hoặc giảm tốc độ.
- HTTP 429: gửi quá nhanh, giảm số trang chạy song song và tăng thời gian nghỉ.
- HTTP 503 kèm trang bảo trì của website: không phải chặn, website đang có sự cố, thử lại sau.
Với các trang mình biết chắc là ngắn, mình đọc thẳng trường html và tự kiểm nội dung, không dựa vào success. Với trang bình thường, success vẫn là tín hiệu tốt.
Trang tải xong nhưng dữ liệu trích xuất rỗng
Một dạng lỗi giả khác: success là True, status 200, nhưng nội dung trích xuất rỗng. Nguyên nhân thường không ở proxy mà ở chỗ trang chưa dựng xong khi Crawl4AI đọc. Thêm wait_for với bộ chọn CSS của phần tử cần lấy để Crawl4AI chờ phần tử đó xuất hiện.
Nếu đã có wait_for mà vẫn rỗng, mở trường html xem trang có phải là phiên bản khác dành cho vùng địa lý khác không. Proxy ở quốc gia khác có thể nhận giao diện khác, bộ chọn CSS viết cho giao diện Việt Nam sẽ không khớp.
Lỗi proxy Crawl4AI về thời gian chờ và lưu lượng
Nhóm cuối cùng không làm crawler dừng hẳn, nhưng làm nó chậm, tốn tiền hoặc thất bại ngẫu nhiên.
Timeout khi proxy chậm
Mình đặt page_timeout bằng 5 giây cho trang cố ý chờ 8 giây. Crawl4AI báo Page.goto: Timeout 5000ms exceeded sau 6,2 giây. Mặc định của page_timeout là 60 giây, đủ cho hầu hết trường hợp.
Proxy dân cư thường chậm hơn proxy datacenter vì đi qua kết nối nhà mạng. Nếu thấy timeout xảy ra ngẫu nhiên, không cố định ở trang nào, nguyên nhân thường là proxy chậm vào một số thời điểm. Tăng page_timeout và thêm cơ chế thử lại, hoặc chuyển sang proxy có độ trễ thấp hơn.
Trình duyệt tự gửi request ra ngoài
Log proxy ghi một chi tiết đáng chú ý: mỗi lần mở trình duyệt Edge, có 2 tới 3 kết nối CONNECT tới www.bing.com cổng 443, không do trang nào yêu cầu. Đó là request nền của chính trình duyệt, và chúng đi qua proxy như mọi request khác.
Với proxy tính tiền theo dung lượng, request nền làm tốn thêm một ít lưu lượng mỗi lần mở trình duyệt. Chromium do Playwright tải về thường có ít request nền hơn Edge. Giữ một trình duyệt chạy cho nhiều trang, thay vì mở trình duyệt mới cho mỗi trang, cũng giảm lượng request nền và tăng tốc đáng kể.
Thử lại có kiểm soát với max_retries
Tham số max_retries của CrawlerRunConfig mặc định bằng 0. Đọc mã nguồn bản 0.9.5, mình thấy tham số này dùng khi trang bị đánh dấu chặn hoặc mọi proxy trong danh sách đều lỗi. Khi đó Crawl4AI chạy lại cả danh sách proxy thêm đúng số lần này, mỗi lần ghi một dòng cảnh báo Anti-bot retry trong log.
Đặt max_retries bằng 1 hoặc 2 là đủ cho lỗi tạm thời. Đặt cao hơn với trang bị chặn thật chỉ làm tốn thời gian và lưu lượng proxy, vì website vẫn chặn. Khi đã thấy trang bị chặn lặp lại, đổi loại proxy hoặc giảm tốc độ hiệu quả hơn tăng số lần thử.
Mở trình duyệt mới cho mỗi trang
Khung chạy thử ở trên mở trình duyệt mới cho mỗi tình huống để các lần thử độc lập với nhau. Khi chạy thật, cách này chậm và tốn tài nguyên. Dùng một AsyncWebCrawler cho cả lô và gọi arun_many với danh sách URL sẽ nhanh hơn nhiều.
Proxy vẫn đặt được theo từng request qua CrawlerRunConfig, nên một trình duyệt dùng được nhiều proxy khác nhau. Đây là cách tài liệu Proxy & Security của Crawl4AI khuyến nghị, và cũng là cách giảm lỗi do khởi động trình duyệt quá nhiều lần.
Kiểm IP đi ra trước khi chạy lô
Cách chắc nhất để biết proxy hoạt động là cho Crawl4AI tải một trang trả về IP người gọi, rồi so với IP proxy. Đoạn dưới đọc thẳng trường html thay vì dựa vào success, vì trang trả IP chỉ có vài chục byte và sẽ bị bộ phát hiện chặn đánh dấu như đã nói ở phần trước.
import asyncio, re
from crawl4ai import AsyncWebCrawler, BrowserConfig, CacheMode, CrawlerRunConfig, ProxyConfig

async def ip_qua_proxy(proxy):
    cfg = CrawlerRunConfig(cache_mode=CacheMode.BYPASS, proxy_config=proxy)
    async with AsyncWebCrawler(config=BrowserConfig(headless=True, verbose=False)) as c:
        r = await c.arun(url="https://api.ipify.org", config=cfg)
    m = re.search(r"\d{1,3}(?:\.\d{1,3}){3}", r.html or "")
    return m.group(0) if m else None, r.status_code, (r.error_message or "")[:120]

print(asyncio.run(ip_qua_proxy(ProxyConfig.from_string("ip-proxy:port:user:pass"))))
Mình chạy đoạn này qua proxy thử, tải trang api.ipify.org thật. Kết quả lấy được IP, status 200, nhưng success là False với thông báo Structural: minimal_text on small page, trang chỉ 165 byte và 14 ký tự hiển thị. Đó đúng là kiểu đánh dấu chặn giả ở phần trước, nên đọc trường html là cách đúng. Với proxy thật, kết quả mong đợi là IP của proxy. Nếu ra IP máy chủ, proxy không được dùng; nếu ra None kèm thông báo lỗi, quay lại các nhóm lỗi kết nối ở phần trước.
Lưu bằng chứng để gỡ lỗi sau
Lỗi proxy hay xảy ra ngẫu nhiên, lúc có lúc không. Khi xảy ra trong lô vài nghìn trang, không ai nhớ được trang nào lỗi gì. Mình lưu cho mỗi trang lỗi bốn thứ: URL, proxy đã dùng, error_message đầy đủ và 2.000 ký tự đầu của html nếu có.
Với bốn thứ này, sau lô chạy chỉ cần gom theo error_message là thấy ngay lỗi nào chiếm nhiều nhất. Phần lớn trường hợp, chín phần mười số lỗi thuộc về một hai nguyên nhân, sửa xong là lô sau sạch hẳn.
Tự phục hồi lỗi proxy Crawl4AI bằng danh sách proxy dự phòng
Crawl4AI 0.9.5 có một tính năng ít người biết: proxy_config nhận cả một danh sách, và khi proxy đầu lỗi, Crawl4AI tự chuyển sang proxy tiếp theo. Mình đọc mã nguồn để tìm ra tính năng này rồi chạy thử.
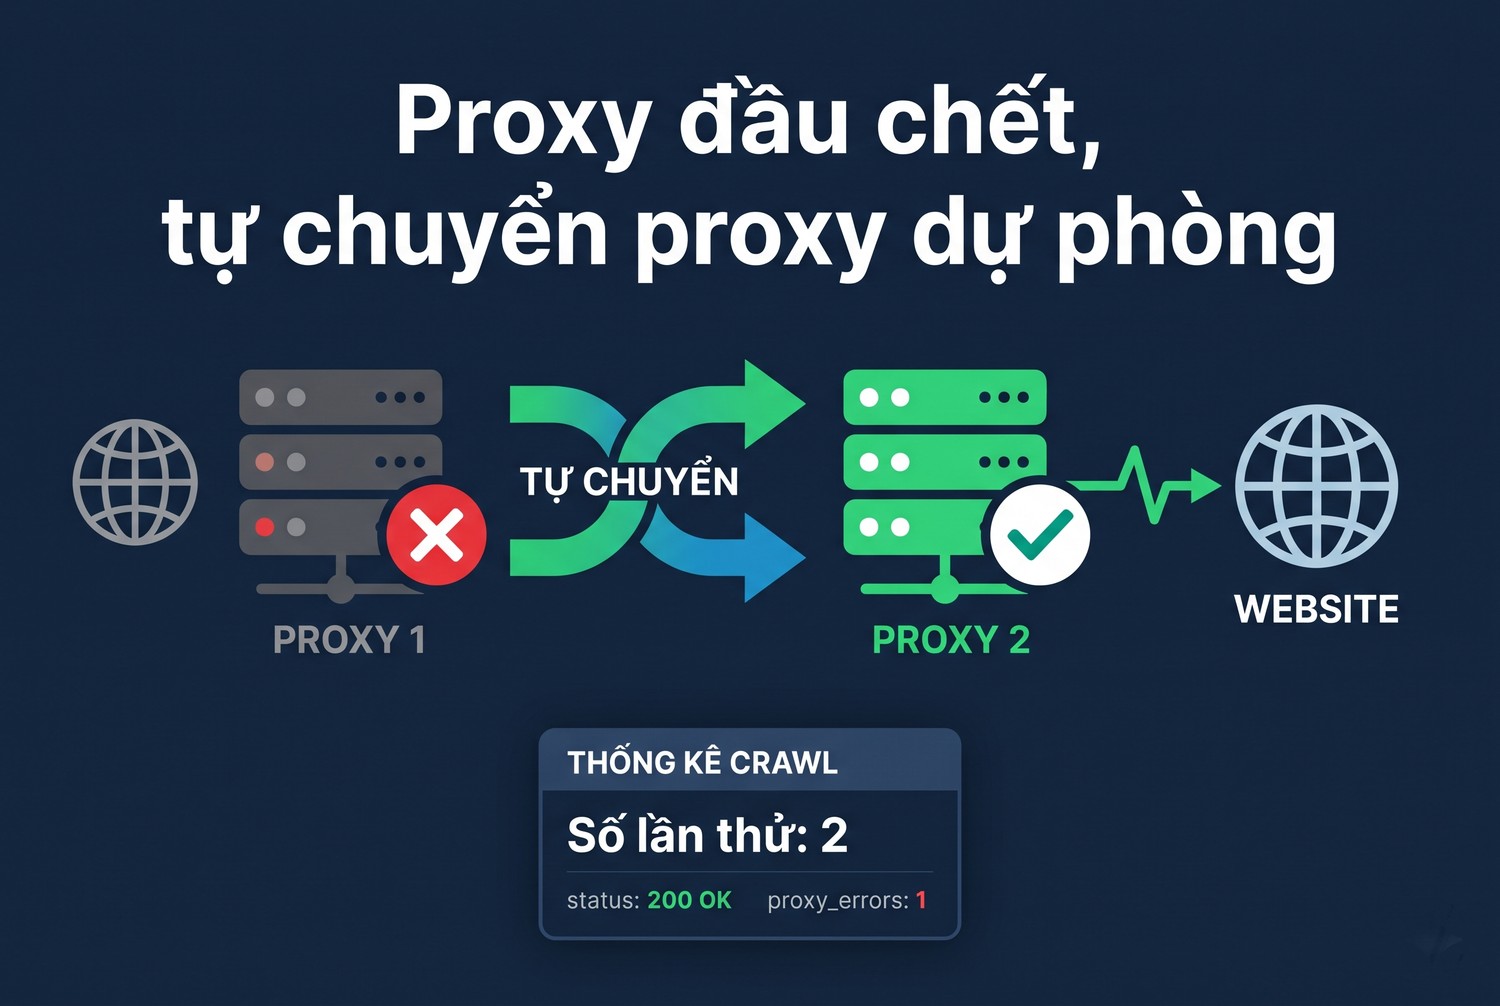
Proxy đầu chết, tự chuyển proxy dự phòng
Cấu hình danh sách proxy
Đoạn dưới đặt hai proxy: proxy đầu cố ý chết, proxy sau hoạt động bình thường. Tham số max_retries bằng 1 cho phép thử lại cả danh sách thêm một lượt nữa nếu mọi proxy đều thất bại.
import asyncio, json
from crawl4ai import AsyncWebCrawler, BrowserConfig, CacheMode, CrawlerRunConfig, ProxyConfig

async def main():
    run = CrawlerRunConfig(
        cache_mode=CacheMode.BYPASS,
        page_timeout=15000,
        proxy_config=[
            ProxyConfig(server="http://127.0.0.1:8899", username="user1", password="x"),          # proxy chết
            ProxyConfig(server="http://127.0.0.1:8842", username="user1", password="p@ss#2026"),  # proxy sống
        ],
        max_retries=1,
    )
    async with AsyncWebCrawler(config=BrowserConfig(headless=True, verbose=False)) as c:
        r = await c.arun(url="http://127.0.0.1:8841/products?page=1", config=run)
    print(r.success, r.status_code, json.dumps(r.crawl_stats, ensure_ascii=False, default=str))

asyncio.run(main())
Kết quả chạy
Kết quả là success True, status 200. Log của Crawl4AI ghi proxy đầu lỗi ERR_PROXY_CONNECTION_FAILED, rồi dòng Trying proxy 2/2 và tải thành công qua proxy thứ hai. Trường crawl_stats ghi attempts bằng 2 và danh sách proxies_used với lý do lỗi của từng proxy.
Trường crawl_stats là công cụ gỡ lỗi rất tốt. Lưu nó cùng kết quả mỗi trang, sau một lô chạy anh em sẽ thấy proxy nào hay lỗi, lỗi gì, để loại khỏi danh sách. Mã nguồn còn có giá trị đặc biệt ProxyConfig.DIRECT để đặt một mục không dùng proxy trong danh sách, nhưng mình không khuyên dùng vì nó làm lộ IP máy chủ khi mọi proxy đều lỗi.
Khi nào nên dùng danh sách dự phòng
Danh sách dự phòng hợp với lô crawl dài, nơi một proxy chết giữa chừng không nên làm hỏng cả lô. Với trang cần đăng nhập, cần cẩn thận: chuyển sang proxy khác giữa phiên có thể làm website đăng xuất tài khoản.
Danh sách dự phòng cũng không thay được việc kiểm proxy trước khi chạy. Proxy chết trong danh sách vẫn làm mỗi trang chậm thêm thời gian thử kết nối. Lọc proxy chết ra trước, dùng danh sách dự phòng cho những lỗi xảy ra trong lúc chạy.
Checklist phòng lỗi proxy Crawl4AI trước khi chạy thật
Phần lớn lỗi trong bài có thể phát hiện trước bằng vài bước kiểm đơn giản. Phần này gom các bước đó và cách chọn proxy phù hợp với Crawl4AI.
Chọn loại proxy hợp với Crawl4AI
Vì trình duyệt nhân Chromium không gửi tài khoản cho SOCKS5, proxy HTTP có user và password là lựa chọn ít rắc rối nhất với Crawl4AI. Website ít chống bot chạy ổn với proxy datacenter. Website có hệ thống chống bot, hay trả 403 dạng trang xác minh, cần proxy dân cư hoặc 4G.
Khi cần mua proxy Việt Nam cho Crawl4AI, ProxyVN có proxy dân cư tĩnh Viettel, VNPT, FPT, datacenter Việt Nam và proxy 4G, cấp user và password theo dạng ip:port:user:pass mà ProxyConfig.from_string đọc trực tiếp được. Chọn giao thức HTTP để tránh lỗi xác thực SOCKS5 của trình duyệt.
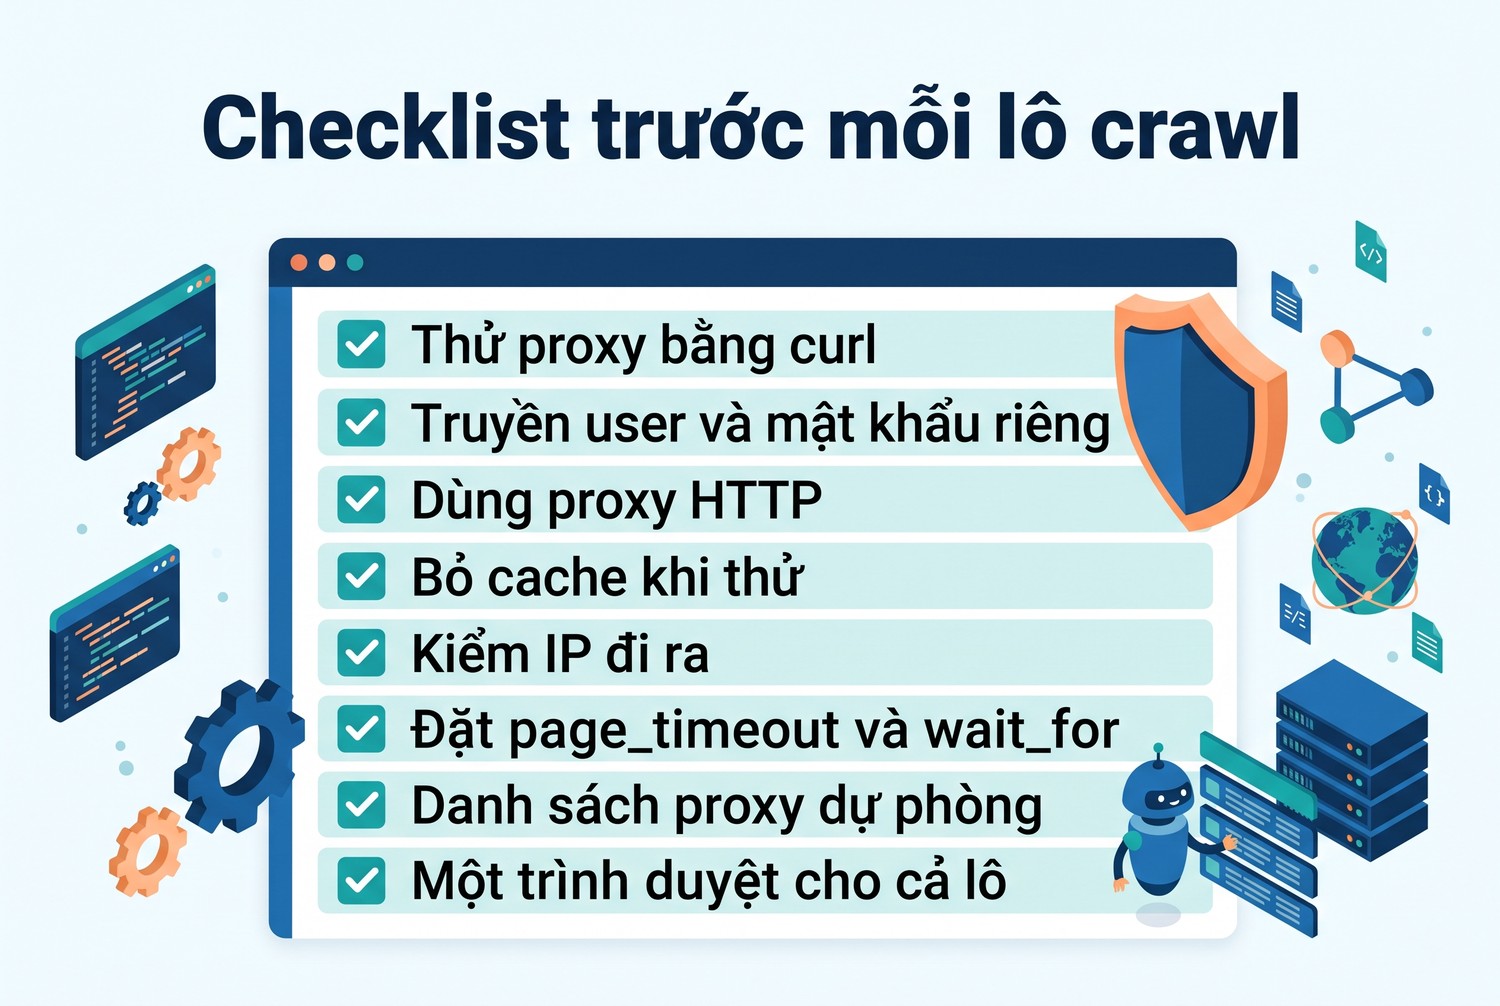
Checklist trước mỗi lô crawl
Danh sách dưới là các bước mình chạy trước mỗi lô crawl mới:
- Gọi thử proxy bằng curl từ đúng máy chạy Crawl4AI.
- Truyền user và mật khẩu qua ProxyConfig, không ghép thẳng vào URL; nếu dùng from_string thì dùng dạng ip:port:user:pass.
- Dùng proxy HTTP có tài khoản, hoặc SOCKS5 xác thực bằng IP.
- Đặt cache_mode bằng BYPASS khi thử nghiệm để chắc request thật sự được gửi.
- Tải một trang hiển thị IP, đọc thẳng trường html vì trang này ngắn và có thể bị đánh dấu chặn giả.
- Đặt page_timeout hợp với tốc độ proxy, thêm wait_for cho phần tử cần lấy.
- Dùng danh sách proxy dự phòng và lưu crawl_stats cho mỗi trang.
- Dùng một trình duyệt cho cả lô thay vì mở trình duyệt mới cho mỗi trang.
Đọc success, status_code và error_message cùng nhau. Mỗi tổ hợp ba giá trị trỏ tới một chỗ sửa khác nhau: proxy, giao thức, trình duyệt hay website.
Checklist trước mỗi lô crawl
Câu hỏi thường gặp
Crawl4AI báo lỗi nhưng curl qua cùng proxy vẫn chạy. Kiểm ba điều: chuỗi proxy trong code có bị tách sai do ký tự đặc biệt không, có đang dùng SOCKS5 kèm mật khẩu không, và trang có bị đánh dấu chặn giả không. Ba lỗi này đều chỉ xảy ra với trình duyệt, curl không gặp.
Lỗi chỉ xảy ra khi chạy nhiều trang cùng lúc. Thường là proxy giới hạn số kết nối đồng thời hoặc website giới hạn tốc độ theo IP. Giảm số trang chạy song song, thêm thời gian nghỉ, hoặc chia trang cho nhiều proxy. Bài proxy pool hướng dẫn chia proxy theo mục đích.
Trang tải được nhưng IP vẫn là IP máy chủ. Kiểm proxy có được đặt đúng chỗ không: proxy đặt trong CrawlerRunConfig áp dụng cho từng lần chạy, kiểm cả bộ nhớ đệm, vì kết quả cũ có thể được trả lại mà không gửi request nào. Tải một trang hiển thị IP với cache_mode BYPASS để chắc.
Chạy Crawl4AI trên máy chủ Linux có khác không. Mã lỗi vẫn của nhân Chromium nên giống như trong bài. Khác biệt thường gặp là máy chủ thiếu thư viện hệ thống cho trình duyệt, báo lỗi khi khởi động chứ không phải lỗi proxy. Chạy lệnh crawl4ai-doctor sau khi cài để kiểm môi trường trước, rồi mới gỡ lỗi proxy.
Có nên tắt bộ phát hiện chặn không. Mình không khuyên tắt, vì với trang thật nó giúp phát hiện proxy bị chặn sớm. Với vài trang vốn ngắn, chỉ cần đọc trường html trực tiếp thay vì dựa vào success.
Lỗi proxy Crawl4AI và những điều cần nhớ
Lỗi proxy Crawl4AI thường nằm ở bốn chỗ: kết nối tới proxy, giới hạn giao thức của trình duyệt, bộ phát hiện chặn và thời gian chờ. Đọc cùng lúc success, status_code, error_message để biết sửa chỗ nào. Cần proxy ổn định, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khi gặp lỗi proxy Crawl4AI.


