
LlamaIndex web scraping: nạp trang web vào index qua proxy
LlamaIndex web scraping là bước đưa nội dung trang web vào index để mô hình ngôn ngữ trả lời dựa trên tài liệu thật. Chỗ hay gây nhầm là không rõ request tải trang đi qua proxy ở tầng nào. Bài này, ProxyVN hướng dẫn hai cách nạp trang, cách kiểm chứng tuyến mạng, lưu index và cập nhật tài liệu khi nguồn thay đổi.
LlamaIndex web scraping gồm những thành phần nào
LlamaIndex là framework giúp nối dữ liệu riêng với mô hình ngôn ngữ. Trong luồng thu thập web, framework này không tự đi crawl cả website mà nhận tài liệu từ reader. Reader tải nội dung, đóng gói thành Document, rồi index chuyển Document thành các node có vector để truy vấn.
Tài liệu chính thức của LlamaIndex chia luồng làm việc thành các bước nạp, lập index, lưu trữ và truy vấn. Hiểu bốn bước này giúp anh em biết code của mình đang can thiệp vào đâu. Phần lớn vấn đề về proxy nằm ở bước nạp, không nằm ở bước lập index.
Reader, Document và Node
Reader là lớp đọc dữ liệu từ một nguồn, ví dụ trang web, tệp PDF hay cơ sở dữ liệu. Document là đơn vị tài liệu gồm văn bản và metadata. Node là các mảnh nhỏ được cắt ra từ Document để tạo vector. Một trang web thường thành một Document và nhiều Node.
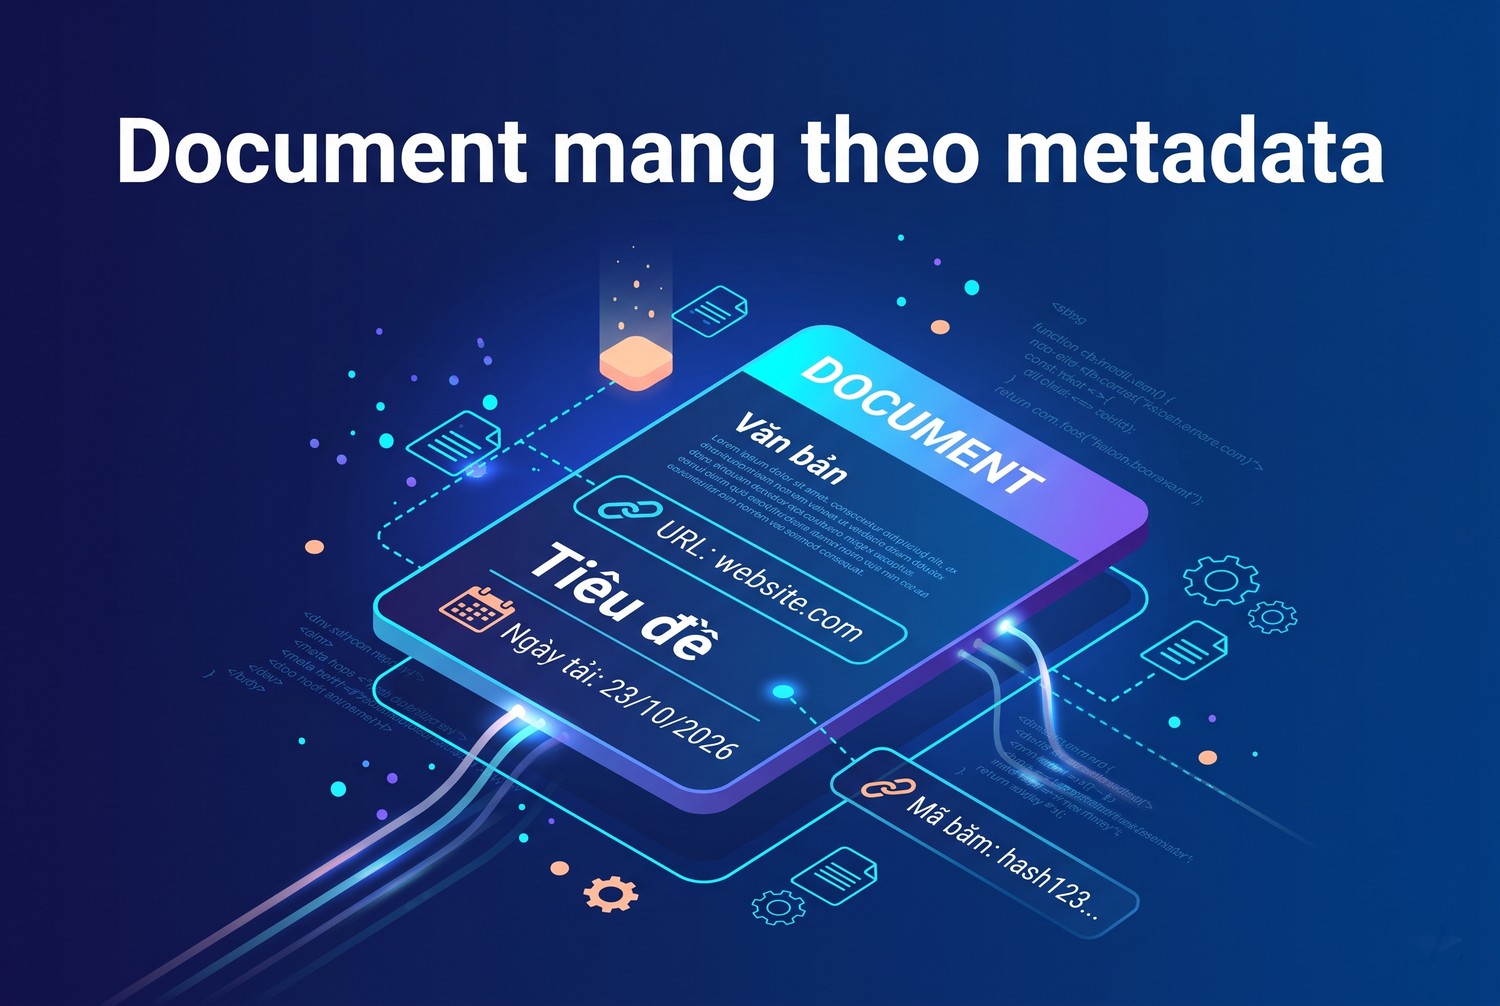
Metadata đi theo Document sẽ được truyền xuống từng Node. Vì vậy, URL nguồn và thời điểm tải nên được đặt vào metadata ngay từ đầu. Khi truy vấn, anh em đọc lại metadata để hiển thị nguồn cho người dùng.
Index và query engine
VectorStoreIndex là loại index phổ biến nhất, lưu vector của từng Node. Query engine nhận câu hỏi, tìm các Node gần nhất rồi gửi ngữ cảnh cho mô hình sinh câu trả lời. Mặc định, LlamaIndex dùng mô hình và embedding của OpenAI nên cần khoá API, trừ khi anh em cấu hình mô hình khác qua Settings.
Mỗi lần tạo vector hoặc gọi mô hình cũng là một kết nối ra mạng. Kết nối này đi tới nhà cung cấp mô hình, khác với kết nối tải trang. Proxy thu thập dữ liệu chỉ nên gắn vào kết nối tải trang, các kết nối còn lại để mặc định hoặc theo chính sách mạng của doanh nghiệp.
Tóm lại, LlamaIndex web scraping thực chất là chuyện của reader. Nắm được reader tải trang thế nào là nắm được proxy cần đặt ở đâu.
Chuẩn bị môi trường LlamaIndex web scraping
Môi trường lab cần LlamaIndex lõi, gói reader web và vài thư viện hỗ trợ tải, làm sạch trang. Nên dùng môi trường ảo riêng và ghi lại phiên bản, vì LlamaIndex thay đổi cấu trúc gói khá thường xuyên. Code ở bài này dùng cách import theo cấu trúc gói tách rời hiện hành.
Cài các gói cần thiết
Gói lõi llama-index đã kèm VectorStoreIndex và các lớp cơ bản. Reader web nằm trong gói riêng llama-index-readers-web. Requests và BeautifulSoup dùng cho hàm tải tự viết ở phần sau.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install llama-index llama-index-readers-web requests beautifulsoup4
python -m pip freeze > requirements-lock.txt
Nếu chạy ví dụ với OpenAI, đặt biến OPENAI_API_KEY trước khi chạy. Nếu dùng mô hình khác, cài gói tích hợp tương ứng và khai báo qua Settings. Trong bài, phần truy vấn chỉ minh họa luồng, không phụ thuộc nhà cung cấp cụ thể.
Đặt biến môi trường cho proxy
Lab dùng hai biến riêng: một biến cho hàm tải tự viết và bộ biến chuẩn HTTP_PROXY, HTTPS_PROXY cho reader dựng sẵn. Tách như vậy để anh em thấy rõ mỗi cách nạp đọc cấu hình từ đâu. Giá trị dưới đây là mẫu, cần thay bằng thông tin thật.
$env:SCRAPE_PROXY = 'http://USERNAME:PASSWORD@HOST:PORT'
$env:NO_PROXY = 'localhost,127.0.0.1'
Biến NO_PROXY liệt kê địa chỉ không đi qua proxy. Đặt localhost vào đây để các dịch vụ chạy cục bộ không bị đẩy ra ngoài. Nếu anh em có máy chủ vector nội bộ, cũng thêm địa chỉ của nó vào danh sách.
Chọn danh sách trang thử
Lô đầu tiên nên có ba tới năm trang công khai mà anh em đã đọc và biết rõ nội dung. Trang tài liệu kỹ thuật hoặc trang do anh em quản lý là lựa chọn phù hợp. Trước khi đưa vào danh sách, đọc điều khoản sử dụng và tệp robots.txt theo chuẩn RFC 9309.
Như vậy, môi trường đã sẵn thư viện, biến proxy và danh sách URL. Phần tiếp theo đi vào câu hỏi chính: request tải trang đi qua proxy ở tầng nào.
Proxy trong LlamaIndex web scraping nằm ở tầng HTTP nào
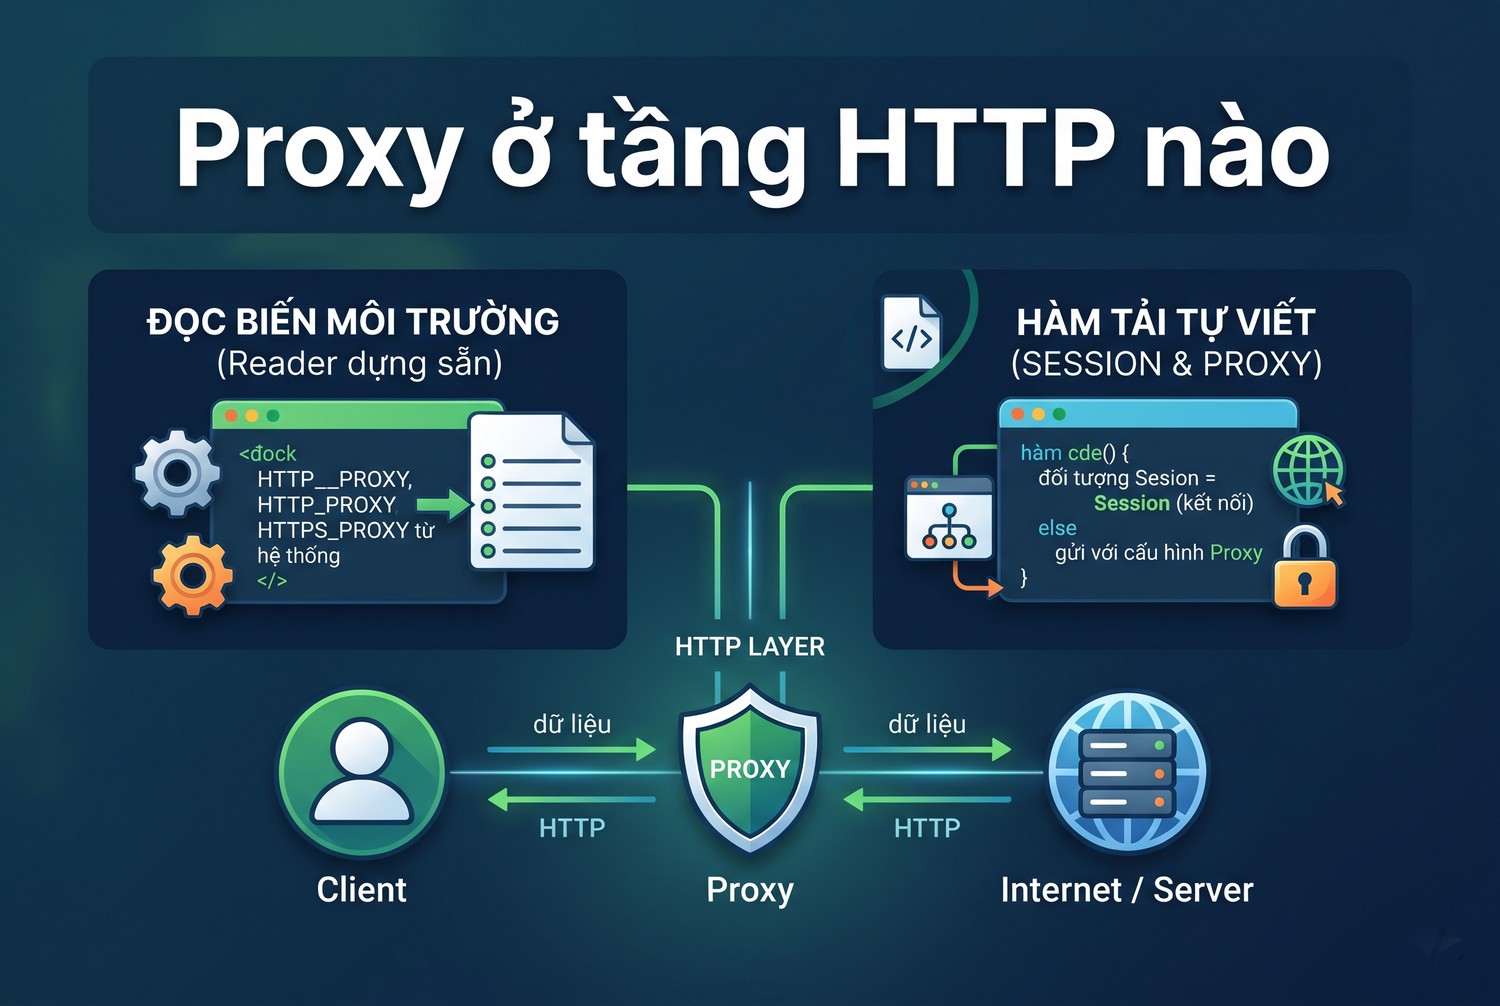
LlamaIndex không có một ô cấu hình proxy chung cho mọi reader. Mỗi reader dùng thư viện HTTP riêng, và thư viện đó quyết định cách đọc proxy. Đây là lý do cùng một máy, reader này đi qua proxy còn reader khác thì không.
Proxy ở tầng HTTP nào
Reader dựng sẵn đọc biến môi trường
SimpleWebPageReader trong gói reader web tải trang bằng Requests. Theo tài liệu proxy của Requests, khi không truyền proxies, thư viện đọc biến HTTP_PROXY và HTTPS_PROXY từ môi trường. Vì vậy, với reader dựng sẵn, cách gắn proxy đơn giản nhất là đặt biến môi trường trước khi chạy Python.
Nhược điểm là biến môi trường tác động lên mọi request dùng Requests trong tiến trình. Nếu thư viện gọi mô hình cũng dùng Requests hoặc tôn trọng biến này, lưu lượng gọi mô hình cũng đi qua proxy. Anh em cần cân nhắc điều này khi dùng proxy có tính phí theo băng thông.
Hàm tải tự viết kiểm soát rõ hơn
Cách thứ hai là tự tải trang bằng Session có proxy, làm sạch văn bản rồi tạo Document bằng tay. Cách này dài hơn vài dòng nhưng mọi cấu hình mạng nằm ngay trong code. Anh em biết chính xác request nào qua proxy, request nào không.
Hàm tải tự viết còn cho phép kiểm tra mã trạng thái, kiểu nội dung và độ dài văn bản trước khi tạo Document. Reader dựng sẵn thường trả về Document cả khi trang lỗi, khiến rác lọt vào index. Với dữ liệu cần trích nguồn, nên dùng hàm tải tự viết.
Bảng so sánh hai cách nạp
Bảng dưới tóm tắt khác biệt giữa reader dựng sẵn và hàm tải tự viết. Anh em chọn cách phù hợp theo quy mô và yêu cầu kiểm soát.
Tiêu chí |
Reader dựng sẵn |
Hàm tải tự viết |
|---|---|---|
Nơi đặt proxy |
Biến HTTP_PROXY, HTTPS_PROXY |
Session.proxies trong code |
Phạm vi ảnh hưởng |
Mọi request dùng Requests |
Chỉ request tải trang |
Kiểm tra mã trạng thái |
Hạn chế |
Tuỳ ý |
Metadata nguồn |
Tối thiểu |
Đầy đủ theo nhu cầu |
Số dòng code |
Ít |
Nhiều hơn vài chục dòng |
Bảng cho thấy reader dựng sẵn hợp với thử nhanh, còn hàm tự viết hợp với dữ liệu cần kiểm chứng. Phần sau trình bày cả hai để anh em so sánh trực tiếp.
Kiểm chứng request thật sự qua proxy
Cách kiểm chứng gọn nhất là gọi một trang trả về IP công khai trước và sau khi bật proxy. Nếu IP thay đổi theo đúng proxy, tuyến mạng đã đúng. Bước này nên chạy riêng trước lượt nạp, không trộn vào code tạo index.
import os
import requests

proxy = os.environ.get("SCRAPE_PROXY")
direct = requests.get("https://api.ipify.org", timeout=15).text
via = requests.get("https://api.ipify.org", timeout=15,
                   proxies={"http": proxy, "https": proxy}).text
print("direct:", direct)
print("proxy :", via)
Hai dòng in ra phải khác nhau. Nếu giống nhau, proxy chưa được áp dụng hoặc biến môi trường chưa có trong cửa sổ đang chạy. Nếu dòng thứ hai báo lỗi, xem lại thông tin đăng nhập và giao thức của proxy.
Kết lại, LlamaIndex web scraping qua proxy đúng hay sai được quyết định ở thư viện HTTP bên dưới reader. Kiểm chứng tuyến mạng trước giúp anh em không phải đoán.
Nạp trang bằng reader dựng sẵn trong LlamaIndex web scraping
Reader dựng sẵn là cách nhanh nhất để thử luồng từ trang web tới câu trả lời. Chỉ cần vài dòng code, anh em đã có index truy vấn được. Phần này dùng SimpleWebPageReader với proxy đặt qua biến môi trường.
Code nạp nhanh với SimpleWebPageReader
Đoạn code dưới đặt biến HTTPS_PROXY ngay trong tiến trình trước khi import reader. Cách đặt trong code chỉ để minh họa; khi triển khai, nên đặt ở môi trường chạy. Tham số html_to_text chuyển HTML sang văn bản để giảm rác trong index.
import os
os.environ["HTTP_PROXY"] = os.environ["SCRAPE_PROXY"]
os.environ["HTTPS_PROXY"] = os.environ["SCRAPE_PROXY"]

from llama_index.core import VectorStoreIndex
from llama_index.readers.web import SimpleWebPageReader

urls = [line.strip() for line in open("urls.txt", encoding="utf-8") if line.strip()]
docs = SimpleWebPageReader(html_to_text=True).load_data(urls)
for d in docs:
    print(len(d.text), d.metadata)

index = VectorStoreIndex.from_documents(docs)
print(index.as_query_engine().query("Tóm tắt nội dung chính của các trang"))
Dòng in độ dài văn bản giúp phát hiện trang trống hoặc trang chặn ngay sau khi tải. Nếu một Document chỉ có vài trăm ký tự, mở URL đó trên trình duyệt để xem chuyện gì xảy ra. Tham số html_to_text cần gói html2text; nếu báo thiếu, cài thêm bằng pip.
Giới hạn của cách nạp nhanh
Reader dựng sẵn tải lần lượt các URL mà không có khoảng nghỉ cấu hình được. Với danh sách dài, request dồn dập có thể nhận mã 429. Reader cũng không ghi mã trạng thái vào metadata, nên khó biết Document nào đến từ trang lỗi.
Thêm nữa, biến HTTPS_PROXY đặt trong tiến trình sẽ ảnh hưởng tới lần gọi embedding và mô hình nếu các thư viện đó tôn trọng biến môi trường. Muốn tách bạch, anh em thêm tên miền của nhà cung cấp mô hình vào NO_PROXY, hoặc chuyển sang hàm tải tự viết.
- Hợp với: thử nhanh vài trang, kiểm tra luồng end-to-end.
- Chưa hợp với: danh sách dài, dữ liệu cần trích nguồn, cần giới hạn tốc độ.
- Cần thêm: kiểm tra độ dài văn bản và loại bỏ Document rỗng trước khi lập index.
Như vậy, reader dựng sẵn là công cụ thử nghiệm tốt nhưng chưa đủ cho dữ liệu cần kiểm chứng. Phần tiếp theo xây hàm tải tự viết để khắc phục các giới hạn trên.
Hàm tải tự viết cho LlamaIndex web scraping có kiểm soát
Hàm tải tự viết gom ba việc: tải qua Session có proxy, kiểm tra phản hồi và tạo Document có metadata đầy đủ. Code dưới đây là ví dụ triển khai chung, anh em điều chỉnh selector theo cấu trúc trang mục tiêu.
Document mang theo metadata
Tải trang và làm sạch văn bản
Hàm fetch_page trả về một từ điển gồm URL cuối, mã trạng thái, tiêu đề và văn bản sạch. Các thẻ script, style, nav, footer bị loại trước khi lấy văn bản. Khoảng nghỉ delay giữ nhịp tải ổn định.
import os
import time
import hashlib
import requests
from bs4 import BeautifulSoup
from datetime import datetime, timezone
from llama_index.core import Document

def make_session():
    s = requests.Session()
    s.trust_env = False
    p = os.environ.get("SCRAPE_PROXY")
    if p:
        s.proxies.update({"http": p, "https": p})
    s.headers["User-Agent"] = "llamaindex-lab/0.1 (contact: you@example.com)"
    return s

def fetch_page(session, url, delay=2.0):
    time.sleep(delay)
    r = session.get(url, timeout=(10, 30))
    out = {"url": r.url, "status": r.status_code, "title": "", "text": ""}
    if r.ok and "html" in r.headers.get("Content-Type", ""):
        soup = BeautifulSoup(r.text, "html.parser")
        for t in soup(["script", "style", "nav", "footer", "header", "aside", "form"]):
            t.decompose()
        root = soup.find("main") or soup.find("article") or soup.body or soup
        out["title"] = soup.title.get_text(strip=True) if soup.title else ""
        lines = [x.strip() for x in root.get_text("\n").splitlines()]
        out["text"] = "\n".join(x for x in lines if len(x) > 30)
    return out
Dòng trust_env bằng False khiến Session bỏ qua biến môi trường HTTP_PROXY. Nhờ vậy, chỉ cấu hình trong code có hiệu lực, tránh trường hợp biến cũ còn sót làm request đi sai tuyến. Đây là chi tiết nhỏ nhưng hay gây nhầm khi máy có nhiều cấu hình mạng.
Tạo Document với metadata nguồn
Sau khi tải, hàm to_document tạo Document với id_ cố định theo URL. Id cố định giúp LlamaIndex nhận biết tài liệu đã có khi cập nhật. Metadata gồm URL, tiêu đề, mã trạng thái, thời điểm tải và mã băm văn bản.
def to_document(page):
    digest = hashlib.sha256(page["text"].encode("utf-8")).hexdigest()[:16]
    return Document(
        text=page["text"],
        id_=page["url"],
        metadata={
            "url": page["url"],
            "title": page["title"],
            "status": page["status"],
            "sha": digest,
            "fetched": datetime.now(timezone.utc).isoformat(),
        },
        excluded_embed_metadata_keys=["status", "sha", "fetched"],
    )

def load_pages(urls, min_chars=500):
    s = make_session()
    docs = []
    for u in urls:
        page = fetch_page(s, u)
        if page["status"] != 200 or len(page["text"]) < min_chars:
            print("skip", u, page["status"], len(page["text"]))
            continue
        docs.append(to_document(page))
    return docs
Tham số excluded_embed_metadata_keys loại các trường kỹ thuật khỏi phần văn bản dùng để tạo vector. Nếu không loại, chuỗi mã băm và thời gian sẽ bị trộn vào embedding, làm kết quả tìm kiếm kém chính xác. Tiêu đề và URL vẫn được giữ vì có giá trị ngữ nghĩa.
Kiểm tra trước khi lập index
Trước khi lập index, in số Document thu được và danh sách trang bị bỏ qua. Nếu tỷ lệ bỏ qua cao, dừng lại xem nguyên nhân. Lập index trên dữ liệu thiếu sẽ cho kết quả truy vấn lệch mà rất khó nhận ra.
- Trang trả 200 nhưng văn bản ngắn: thường là trang cần JavaScript hoặc trang chặn.
- Trang chuyển hướng tới URL khác: kiểm tra URL cuối có đúng nội dung mong muốn.
- Nhiều trang cùng mã băm: có thể cùng nhận một trang thông báo lỗi.
Ba dấu hiệu này đều có thể phát hiện chỉ bằng log của hàm load_pages. Đó là lợi thế chính của hàm tải tự viết so với reader dựng sẵn.
Lưu và truy vấn index trong LlamaIndex web scraping
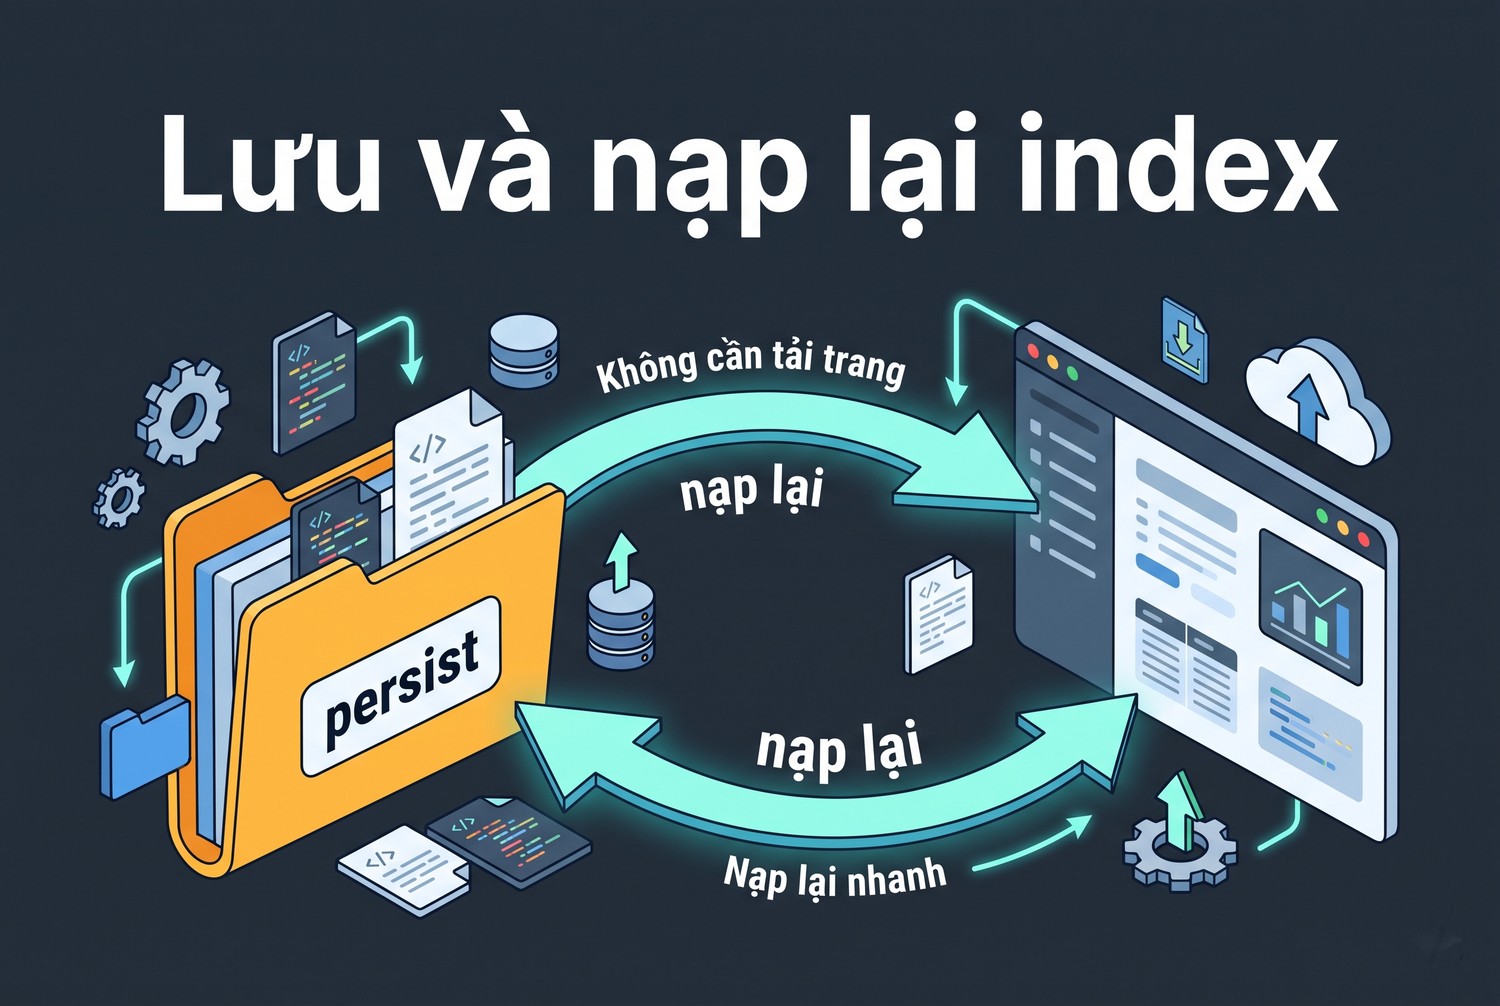
Lập index tốn thời gian và chi phí tạo embedding, nên cần lưu lại để không làm lại mỗi lần chạy. LlamaIndex hỗ trợ lưu index ra thư mục và nạp lại khi cần. Truy vấn sau đó chạy trên dữ liệu đã lưu, không cần tải trang lần nữa.
Lưu và nạp lại index
Lưu index ra thư mục
Sau khi tạo index từ danh sách Document, gọi persist trên storage_context để ghi ra đĩa. Lần sau, dùng load_index_from_storage để nạp lại. Thư mục lưu nên nằm ngoài thư mục code để không vô tình đưa lên kho mã nguồn.
from llama_index.core import VectorStoreIndex, StorageContext, load_index_from_storage

PERSIST = "./index_store"

def build_or_load(urls):
    if os.path.isdir(PERSIST):
        ctx = StorageContext.from_defaults(persist_dir=PERSIST)
        return load_index_from_storage(ctx)
    docs = load_pages(urls)
    index = VectorStoreIndex.from_documents(docs)
    index.storage_context.persist(persist_dir=PERSIST)
    return index
Hàm build_or_load kiểm tra thư mục lưu trước. Nếu đã có, nạp lại ngay mà không tải trang. Nếu chưa có, tải trang, lập index và lưu. Cách viết này giúp chạy thử nhiều lần mà không gửi request lặp lại tới website.
Truy vấn và hiển thị nguồn
Query engine trả về câu trả lời kèm danh sách source_nodes. Mỗi source node mang metadata của Document gốc, trong đó có URL. Anh em in URL và điểm tương đồng để người đọc kiểm tra.
index = build_or_load(urls)
engine = index.as_query_engine(similarity_top_k=4)
resp = engine.query("Các bước cấu hình được mô tả trong tài liệu là gì?")
print(resp)
for sn in resp.source_nodes:
    print(round(sn.score or 0, 3), sn.node.metadata.get("url"))
Tham số similarity_top_k quyết định số đoạn đưa vào ngữ cảnh. Giá trị lớn cho nhiều ngữ cảnh hơn nhưng dễ kéo đoạn lạc đề vào. Nên bắt đầu ở mức 3 tới 5 rồi điều chỉnh theo kết quả trên bộ câu hỏi đã biết đáp án.
Một câu trả lời không kèm source_nodes rõ ràng thì chưa nên đưa cho người dùng, dù nội dung nghe hợp lý tới đâu.
Đánh giá chất lượng truy vấn
Anh em chuẩn bị khoảng mười câu hỏi mà mình biết đáp án nằm ở trang nào. Chạy từng câu, ghi lại URL đứng đầu source_nodes và so với đáp án. Tỷ lệ khớp là chỉ số đơn giản nhưng phản ánh khá đúng chất lượng của khâu nạp và lập index.
Khi tỷ lệ thấp, kiểm tra theo thứ tự: văn bản sạch có chứa đáp án không, đoạn cắt có quá dài không, model embedding có hợp ngôn ngữ không. Chỉ đổi một yếu tố mỗi lần để biết yếu tố nào tạo khác biệt.
Cấu hình mô hình và embedding qua Settings
LlamaIndex dùng đối tượng Settings để khai báo mô hình sinh văn bản, mô hình embedding và cách cắt Node cho toàn bộ tiến trình. Nếu không khai báo, framework dùng giá trị mặc định của OpenAI. Khai báo rõ ngay đầu chương trình giúp anh em biết mỗi lượt chạy đang tốn phí ở đâu và gửi dữ liệu tới nhà cung cấp nào.
Phần cắt Node cũng nằm trong Settings qua các tham số chunk_size và chunk_overlap. Với trang tài liệu tiếng Việt, đoạn khoảng 512 tới 1.024 token là điểm khởi đầu hợp lý. Mỗi lần đổi kích thước đoạn, cần lập lại index vì Node cũ không còn tương ứng với cấu hình mới.
- Đổi model embedding: phải lập lại toàn bộ index, vector cũ không dùng chung được.
- Đổi kích thước đoạn: lập lại index để Node mới thay Node cũ.
- Đổi mô hình sinh văn bản: không cần lập lại index, chỉ ảnh hưởng câu trả lời.
Ghi ba thông số này vào tệp cấu hình cạnh thư mục lưu index. Khi xem lại kết quả cũ, anh em biết index đó được tạo với model và kích thước đoạn nào. Thiếu thông tin này, việc so sánh giữa các lần chạy gần như vô nghĩa.
Khi nào cần reader khác
Gói reader web còn nhiều lớp khác ngoài SimpleWebPageReader, ví dụ reader dùng BeautifulSoup hay Trafilatura để lấy phần nội dung chính. Mỗi lớp có cách tải và làm sạch riêng, và không phải lớp nào cũng dùng Requests. Trước khi dùng một reader mới, anh em đọc mã nguồn hoặc trang mô tả trên LlamaHub để biết nó tải trang bằng thư viện nào.
Nếu reader dùng thư viện khác Requests, cách đọc biến môi trường proxy có thể khác. Bước kiểm chứng bằng trang trả IP ở phần trên vẫn áp dụng được. Chạy lại bước đó mỗi khi đổi reader là cách đơn giản để không tin nhầm vào cấu hình.
Tóm lại, lưu index và hiển thị nguồn là hai việc không thể thiếu khi dùng LlamaIndex web scraping cho dữ liệu cần kiểm chứng. Thiếu chúng, mỗi lần chạy vừa tốn kém vừa khó tin.
Cập nhật tài liệu trong LlamaIndex web scraping
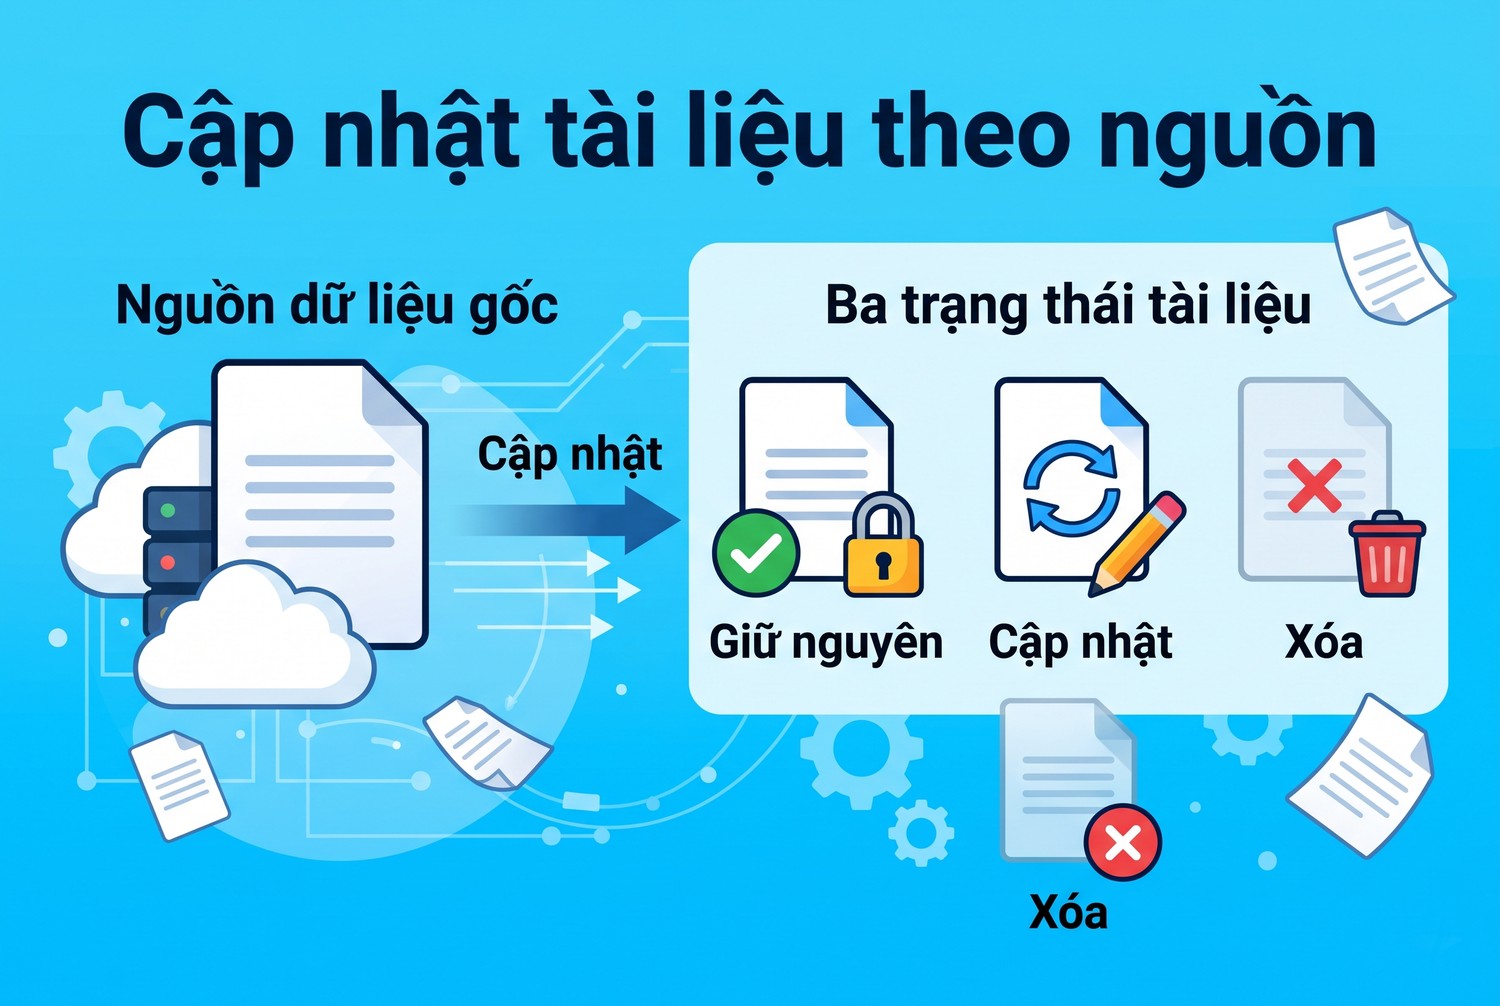
Trang web thay đổi theo thời gian, nên index cần được làm mới. LlamaIndex có cơ chế refresh dựa vào id của Document và nội dung băm. Nhờ id cố định theo URL đã đặt ở phần trước, việc cập nhật trở nên gọn.
Cập nhật tài liệu theo nguồn
Dùng refresh_ref_docs
Phương thức refresh_ref_docs nhận danh sách Document mới và so với tài liệu đã có trong index. Tài liệu mới được thêm, tài liệu có nội dung khác được cập nhật, tài liệu giống hệt được bỏ qua. Kết quả trả về là danh sách giá trị đúng sai cho biết tài liệu nào đã được làm mới.
def refresh(index, urls):
    fresh = load_pages(urls)
    changed = index.refresh_ref_docs(fresh)
    for d, c in zip(fresh, changed):
        print("updated" if c else "same", d.metadata["url"])
    index.storage_context.persist(persist_dir=PERSIST)
Sau khi refresh, nhớ gọi persist để ghi thay đổi ra đĩa. Nếu quên bước này, lần nạp sau vẫn dùng index cũ. Đây là lỗi hay gặp khi chuyển từ chạy tay sang chạy theo lịch.
Xoá tài liệu khi trang không còn
Khi một URL trả 404 hoặc bị loại khỏi danh sách nguồn, cần xoá tài liệu tương ứng khỏi index. Gọi delete_ref_doc với id là URL, kèm tham số xoá khỏi docstore. Nếu không xoá, mô hình vẫn có thể trích nội dung của trang đã không còn tồn tại.
Anh em nên giữ một tệp danh sách nguồn chính thức. Mỗi lượt cập nhật, so tệp này với danh sách id trong index để tìm tài liệu thừa. Cách làm thủ công nhưng minh bạch, dễ giải thích khi có người hỏi tại sao một nguồn biến mất.
Lên lịch cập nhật hợp lý
Tần suất cập nhật nên theo tốc độ thay đổi của nguồn. Trang tài liệu kỹ thuật kiểm tra hằng tuần là đủ, trang tin tức hoặc giá cần dày hơn. Dù chạy dày, vẫn giữ khoảng nghỉ giữa các request và giới hạn số trang mỗi lượt.
Khi cần chia nhiều nguồn cho nhiều tuyến proxy, bài proxy pool là gì trên blog ProxyVN trình bày cách nhóm proxy theo tác vụ. Còn để hiểu rõ hơn vai trò của proxy trong thu thập dữ liệu cho AI, anh em đọc bài web scraping dữ liệu AI bằng proxy.
Như vậy, cập nhật index là một quy trình có ba nhánh: thêm, sửa và xoá. Làm đủ cả ba nhánh mới giữ được index khớp với nguồn thật.
Xử lý lỗi thường gặp với LlamaIndex web scraping
Lỗi trong LlamaIndex web scraping chia làm hai nhóm lớn: lỗi khi tải trang và lỗi khi lập index hoặc truy vấn. Nhóm đầu liên quan tới proxy và website, nhóm sau liên quan tới mô hình và dữ liệu. Phân loại đúng giúp anh em không thay proxy khi vấn đề nằm ở khoá API.
Lỗi khi tải trang
Lỗi ProxyError kèm mã 407 cho thấy proxy yêu cầu xác thực mà thông tin gửi đi sai hoặc thiếu. Tài liệu MDN về mã 407 giải thích cơ chế này. Anh em kiểm tra lại tên đăng nhập, mật khẩu và việc mã hoá ký tự đặc biệt trong URL proxy.
ConnectTimeout nghĩa là không kết nối được tới proxy trong thời gian cho phép. Kiểm tra địa chỉ, cổng và việc proxy có còn hoạt động. Bài requests.exceptions.ProxyError liệt kê chi tiết các nguyên nhân và cách xử lý cho thư viện Requests.
- 403 từ website: xem lại điều khoản, User-Agent và tần suất tải.
- 429 từ website: tăng delay, đọc header Retry-After, giảm số trang mỗi lượt.
- SSLError qua proxy: kiểm tra proxy hỗ trợ CONNECT cho HTTPS.
- Văn bản rỗng: trang cần JavaScript, cân nhắc trình duyệt tự động.
Lỗi khi lập index hoặc truy vấn
Lỗi xác thực từ OpenAI hoặc nhà cung cấp khác không liên quan tới proxy thu thập. Kiểm tra khoá API và biến môi trường của nhà cung cấp. Nếu máy nằm sau proxy doanh nghiệp, kết nối tới nhà cung cấp mô hình có thể cần cấu hình riêng theo hướng dẫn của bộ phận IT.
Truy vấn trả lời lạc đề thường do văn bản sạch chứa nhiều rác hoặc đoạn cắt quá dài. Anh em in vài Node ngẫu nhiên trong index để xem nội dung thật. Nếu thấy menu và chân trang, quay lại hàm làm sạch để bổ sung thẻ cần loại.
Ghi log để dò lỗi nhanh
Mỗi lượt chạy nên ghi một tệp log gồm URL, mã trạng thái, độ dài văn bản, mã băm và kết quả refresh. Che thông tin đăng nhập proxy trước khi ghi. Khi có sự cố, log giúp anh em biết ngay lỗi nằm ở khâu tải, khâu làm sạch hay khâu index.
Tổng kết lại, phần lớn lỗi của LlamaIndex web scraping có thể nhận diện qua mã trạng thái và độ dài văn bản. Ghi đủ hai thông số này là đã giải quyết được nửa số trường hợp.
Checklist triển khai LlamaIndex web scraping
Trước khi chuyển lab thành công việc chạy định kỳ, anh em rà lại danh sách dưới. Mỗi mục tương ứng với một rủi ro đã nêu trong bài. Bỏ qua mục nào, rủi ro đó sẽ xuất hiện khi chạy thật.
Checklist kỹ thuật
Phần kỹ thuật tập trung vào tuyến mạng, chất lượng dữ liệu và khả năng chạy lại. Đây là những điểm quyết định index có đáng tin hay không.
- Đã kiểm chứng request tải trang đi qua proxy bằng trang trả IP.
- Session đặt trust_env bằng False để tránh biến môi trường cũ.
- Có khoảng nghỉ giữa các request và giới hạn số trang mỗi lượt.
- Document có id cố định theo URL và metadata đủ để trích nguồn.
- Trường kỹ thuật được loại khỏi phần tạo embedding.
- Index được lưu ra thư mục và nạp lại khi chạy tiếp.
- Có quy trình refresh, xoá tài liệu thừa và persist sau mỗi lượt.
Checklist vận hành
Phần vận hành liên quan tới quyền sử dụng dữ liệu và chi phí. Hai yếu tố này thường bị bỏ qua ở giai đoạn thử nghiệm nhưng quan trọng khi chạy lâu dài.
- Đã đọc điều khoản và robots.txt của từng nguồn.
- Biết rõ kết nối nào tốn phí: proxy theo băng thông, embedding theo token.
- Log đã che thông tin đăng nhập trước khi chia sẻ.
- Có bộ câu hỏi đánh giá cố định để so sau mỗi thay đổi.
Khi cần mua proxy tốc độ cao cho khâu tải trang, anh em có thể xem các gói datacenter hoặc dân cư tĩnh trên trang chủ ProxyVN, rồi chạy thử với vài URL trong danh sách trước khi nạp cả lô. Kết quả thử thật là căn cứ chọn gói tốt hơn mọi thông số quảng cáo.
LlamaIndex web scraping cho kết quả đáng tin khi anh em kiểm soát rõ tuyến tải trang, lưu đủ metadata và cập nhật index đều đặn. Hãy bắt đầu với vài trang đã biết nội dung rồi mở rộng dần. Cần trao đổi về kết nối, anh em nhắn Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam trước khi chạy LlamaIndex web scraping.


