
Kafka Connect HTTP source boundaries: chọn plugin, chốt offset
Kafka Connect HTTP source boundaries là việc vạch ranh giới giữa framework Connect, plugin HTTP và API nguồn, trước khi viết dòng cấu hình đầu tiên. Apache Kafka không phát hành sẵn connector đọc HTTP, nên plugin và license là quyết định riêng. ProxyVN đọc tài liệu, so ba plugin, chạy mô phỏng Python về offset, và ghi rõ chưa chạy Kafka hay plugin nào.
Kafka Connect HTTP source boundaries: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và giới hạn.
Bài toán cần giải
Một nhóm đã có Kafka và muốn đưa dữ liệu từ một API được phép vào topic. Người đề xuất nói Kafka Connect có sẵn. Khi bắt tay làm, họ không tìm thấy connector HTTP nào trong bản Apache Kafka. Các plugin trên mạng thì có cái thu phí, có cái lâu không cập nhật, có cái chỉ là sink.
Đầu ra nghiệm thu
Theo brief, đây là bài quyết định, chưa phải bài triển khai. Đầu ra là bản thiết kế connector được chọn, có license, offset contract, schema record và hành vi restart. Lab cài plugin thật chỉ làm sau khi plugin đã được xác minh, nên bài không có phần chạy plugin.
Ranh giới với bài khác
Bài không hướng dẫn cài Kafka, không dạy viết connector Java từ đầu, không nói về Kafka Streams. Bài cũng không hướng dẫn crawl trang web qua Connect. Connect hợp với API có cấu trúc. Crawler có render, xoay proxy và xử lý lỗi phức tạp nên đứng riêng và đẩy kết quả vào Kafka.
Giới hạn của lab
Nói rõ ngay. Lab không chạy Kafka, không chạy Connect, không chạy plugin nào. Máy lab không tải được phần mềm máy chủ. Phần chạy thật duy nhất là một script Python mô phỏng hợp đồng offset: API có updated_at và id, hàm poll trả record kèm offset, offset chỉ ghi sau mỗi lần flush.
Mô phỏng này chứng minh gì
Nó chứng minh một lập luận logic: với dữ liệu mẫu, offset thiết kế thế này thì mất bản ghi, thế kia thì trùng. Logic đó không phụ thuộc vào phần mềm. Nó không chứng minh plugin nào hoạt động ra sao, tần suất commit thật hay hiệu năng. Mọi nhận định về plugin trong bài đến từ tài liệu của plugin.
Ai nên đọc bài này
Người phụ trách dữ liệu đang chọn cách đưa API vào Kafka. Người đã thấy bản ghi mất hoặc trùng sau khi restart connector. Người cần viết đề xuất có lý do cho việc mua hay không mua plugin.
Khi nào không cần Connect
Nếu chỉ có một API nhỏ, một script Python với producer có thể đơn giản hơn. Connect đáng giá khi cần chạy nhiều connector, quản lý tập trung qua REST và để framework lo offset. Tự viết thì phải tự lo lưu offset, và đó đúng là phần dễ sai nhất.
Đánh giá connector framework và offset trong Kafka Connect HTTP source boundaries
Phần này tóm tắt tài liệu của Apache Kafka.
Connect là framework
Trang Overview của Kafka Connect mô tả đây là công cụ truyền dữ liệu giữa Kafka và hệ thống khác, với framework chung cho connector, chế độ standalone và distributed, REST API, và quản lý offset tự động. Trang này không nói về connector HTTP nào. Framework là khung, không phải connector.
Thứ Apache phát hành kèm
Trang User Guide dùng ví dụ connector FileStream để chạy thử. Tài liệu cũng nói phải thêm đường dẫn vào plugin.path để nạp plugin. Muốn đọc HTTP, phải tìm plugin bên ngoài hoặc tự viết. Đây là ranh giới đầu tiên cần nói với người đề xuất.
Ba tầng trách nhiệm
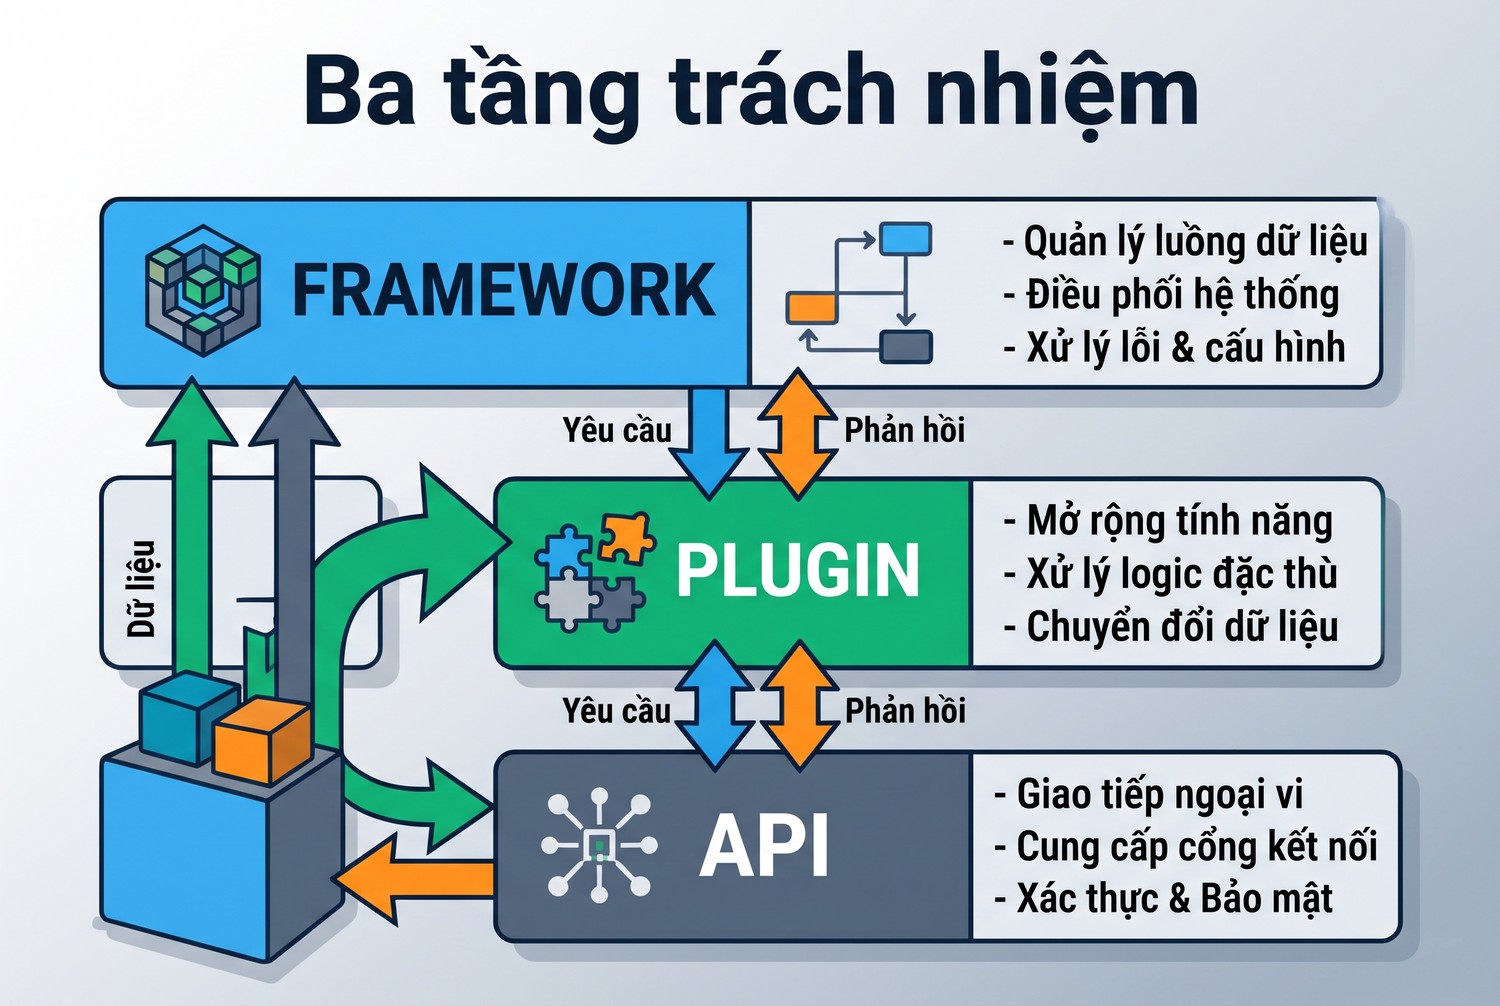
Ba tầng trách nhiệm
Khi có sự cố, biết tầng nào chịu trách nhiệm sẽ giúp tiết kiệm nhiều giờ. Bảng dưới vạch ranh giới theo tài liệu.
Tầng |
Lo việc gì |
Không lo việc gì |
|---|---|---|
Framework Connect |
Chạy task, lưu offset, REST API, phân phối task |
Hiểu API của anh em |
Plugin HTTP |
Gọi HTTP, phân trang, tạo record, tính offset |
Bảo đảm API trả đúng thứ tự |
API nguồn |
Cung cấp thứ tự, cursor, hạn mức |
Biết Kafka đã nhận tới đâu |
Source partition và source offset
Trang Connector Development Guide giải thích mỗi record từ source có stream ID và offset. Trong ví dụ tài liệu, sourcePartition là tên tệp, sourceOffset là vị trí trong tệp. Framework lưu định kỳ các offset đó. Với HTTP, chính anh em hoặc plugin phải định nghĩa hai thứ này.
Map<String, Object> sourcePartition = Collections.singletonMap("filename", filename);
Map<String, Object> sourceOffset = Collections.singletonMap("position", streamOffset);
records.add(new SourceRecord(sourcePartition, sourceOffset, topic, Schema.STRING_SCHEMA, line));
Đoạn trên chép từ tài liệu. Với HTTP, partition có thể là tên API cộng endpoint, offset là cursor.
Resume sau khi khởi động lại
Tài liệu nêu framework commit offset định kỳ, nên khi lỗi, task có thể khôi phục. Task đọc offset qua offsetStorageReader trong lúc khởi tạo rồi tiếp tục. Từ định kỳ là chìa khóa: có một khoảng record đã gửi nhưng offset chưa lưu. Khoảng đó tạo ra bản trùng.
Lưu offset ở đâu
Theo User Guide, standalone dùng tệp offset.storage.file.filename, distributed dùng topic offset.storage.topic, nên có nhiều partition, nhân bản và bật compaction. Môi trường thật nên dùng distributed. Mất tệp offset ở standalone nghĩa là connector bắt đầu lại từ đầu.
REST API quản lý offset
User Guide liệt kê endpoint offset: GET /connectors/{name}/offsets để đọc, DELETE để đặt lại, PATCH để sửa. Hai thao tác ghi yêu cầu connector ở trạng thái stopped, tức phải gọi PUT /connectors/{name}/stop trước. Với source connector, định dạng offset phụ thuộc connector.
curl -X PUT http://localhost:8083/connectors/shop-api/stop
curl http://localhost:8083/connectors/shop-api/offsets
Hai lệnh theo đúng đường dẫn trong tài liệu, tên shop-api là ví dụ, chưa chạy trong lab.
Exactly-once cho source
User Guide nêu Connect hỗ trợ exactly-once cho source connector từ phiên bản 3.3.0, nhưng phụ thuộc connector có hỗ trợ không, và phải bật ở cấp cluster. Tài liệu viết rõ khả năng này tùy từng connector. Đừng giả định plugin HTTP có. Với API bên ngoài, gọi HTTP lặp lại vẫn là gọi lặp lại.
Phân biệt source connector framework với plugin HTTP trong Kafka Connect HTTP source boundaries
Phần này đi qua ba plugin hay được nhắc tới.
Confluent HTTP Source
Trang HTTP Source Connector của Confluent nêu giao ít nhất một lần, có các chế độ offset gồm SIMPLE_INCREMENTING, CHAINING và CURSOR_PAGINATION. Về license, tài liệu ghi dùng thử 30 ngày không cần khóa, sau đó phải mua subscription. Đây là lựa chọn thương mại.
castorm kafka-connect-http
Dự án castorm/kafka-connect-http tự mô tả là connector Change Data Capture từ JSON/HTTP API vào Kafka. GitHub API ngày 04/11/2026 báo license Apache 2.0, lần push cuối tháng 8/2024, chưa lưu trữ. Maven Central hiển thị phiên bản 0.8.11 từ năm 2021. Đây là mã mở, nhưng nhịp cập nhật chậm.
Aiven HTTP connector
Dự án Aiven-Open/http-connector-for-apache-kafka có tên chung chung, nhưng README mở đầu là sink connector: gửi record từ Kafka ra HTTP. Hướng ngược với bài toán. Rất nhiều người tìm HTTP connector rồi cài nhầm loại này.
Bảng so sánh
Bảng dưới gom thông tin đọc được ngày 04/11/2026. Tình trạng dự án thay đổi theo thời gian, nên kiểm lại trước khi quyết định.
Tiêu chí |
Confluent HTTP Source |
castorm |
Aiven |
|---|---|---|---|
Hướng |
Source |
Source |
Sink, không phù hợp |
License |
Thương mại, thử 30 ngày |
Apache 2.0 |
Cần xem riêng |
Offset |
3 chế độ theo tài liệu |
Key và timestamp theo cấu hình |
Không áp dụng |
Hỗ trợ |
Theo subscription |
Cộng đồng |
Không áp dụng |
Rủi ro chính |
Chi phí, ràng buộc |
Cập nhật chậm, tương thích bản mới |
Sai hướng |
Tự viết connector
Lựa chọn thứ tư là viết SourceConnector bằng Java. Tài liệu có hướng dẫn đầy đủ, ví dụ FileStream ngắn. Anh em kiểm soát được offset, đổi lại phải tự bảo trì. Với một API có cursor rõ ràng, phần logic không lớn. Phần tốn công là retry, hạn mức, kiểm thử và đóng gói.
Tiêu chí loại nhanh
Trước khi đọc sâu, hỏi năm câu. Plugin là source hay sink. License có dùng được cho mục đích thương mại không. Có tương thích phiên bản Kafka đang chạy không. Hỗ trợ cách phân trang của API không. Có định nghĩa offset đủ cho API không. Một câu trả lời không là dừng.
Kiểm tra license đúng cách
Đừng chỉ nhìn huy hiệu trên README. Lab thử tải tệp LICENSE ở nhánh master của castorm và nhận 404, phải dùng GitHub API mới đọc được Apache 2.0. Với plugin thương mại, đọc điều khoản về số task, số cluster. Ghi ngày kiểm tra và đường dẫn vào tài liệu quyết định.
Kiểm tra độ hoạt động của dự án
Lần push cuối chỉ là một tín hiệu. Hãy xem issue về tương thích Kafka bản mới, ai trả lời, trả lời bao lâu. Một connector ổn định có thể ít đổi, nhưng API Connect đổi thì nó phải đổi theo. Trước khi chọn, chạy thử plugin trên đúng phiên bản Kafka của anh em.
Đọc connector license, cấu hình và offset contract của Kafka Connect HTTP source boundaries
Phần này đi vào hợp đồng offset, chỗ quyết định mất hay trùng dữ liệu.
Offset contract là gì
Offset contract là câu trả lời cho: từ giá trị offset này, API có trả đúng phần còn lại, không thiếu, không lặp không. Hợp đồng này nằm giữa plugin và API. Framework chỉ lưu giá trị, nó không biết giá trị đó có đủ tốt hay không.
Cách castorm dùng offset
README của castorm giải thích offset có các thuộc tính như key và timestamp. Key dùng để định danh bản ghi, phục vụ khử trùng và định tuyến partition. Timestamp dùng để khử trùng và sắp thứ tự. README cũng nêu vai trò của offset trong khử trùng khi có kết quả lặp lại giữa các request do cùng timestamp.
http.request.params=after=${offset.timestamp}
http.offset.initial=timestamp=2020-01-01T00:00:00Z
Hai dòng trên minh họa theo README, offset đi thẳng vào tham số request. Chưa chạy trong lab.
Cơ chế xác nhận của castorm
README đưa đoạn mã poll và commit. Task theo dõi các record đã được Kafka xác nhận qua một ConfirmationWindow, và offset tiến tới low watermark của các record đã xác nhận. Nghĩa là offset không tiến nhanh hơn phần đã ghi. Mô hình này tốt, nhưng khoảng trùng khi chết vẫn còn đó.
Các chế độ offset của Confluent
Tài liệu Confluent mô tả SIMPLE_INCREMENTING tăng offset theo số bản ghi, CHAINING lấy offset từ một trường trong phản hồi theo http.offset.json.pointer, CURSOR_PAGINATION dùng con trỏ trang kế tiếp theo http.next.page.json.pointer. Từng chế độ giả định API có hành vi tương ứng, và phải đối chiếu trước khi chọn.
API của anh em |
Chế độ gợi ý |
Điều cần kiểm tra |
|---|---|---|
Có offset, limit, dữ liệu chỉ thêm |
SIMPLE_INCREMENTING |
Dữ liệu không bị xóa, sắp xếp cố định |
Trả về con trỏ cho request sau |
CHAINING |
Con trỏ không hết hạn |
Có trường next page |
CURSOR_PAGINATION |
Hành vi ở trang cuối |
Chỉ có lọc theo updated_at |
Cần cursor ghép |
Trùng timestamp, xem mô phỏng |
Dữ liệu mẫu của mô phỏng
API mô phỏng có 9 bản ghi, mỗi trang 2 bản ghi. Điểm mấu chốt: có nhiều bản ghi cùng updated_at. Ba bản ghi 1, 2, 3 cùng mốc 100, hai bản ghi 5, 6 cùng mốc 102, hai bản ghi 8, 9 cùng mốc 104. Dữ liệu thật rất hay như vậy, do cập nhật theo lô.
Ca A: offset chỉ có timestamp
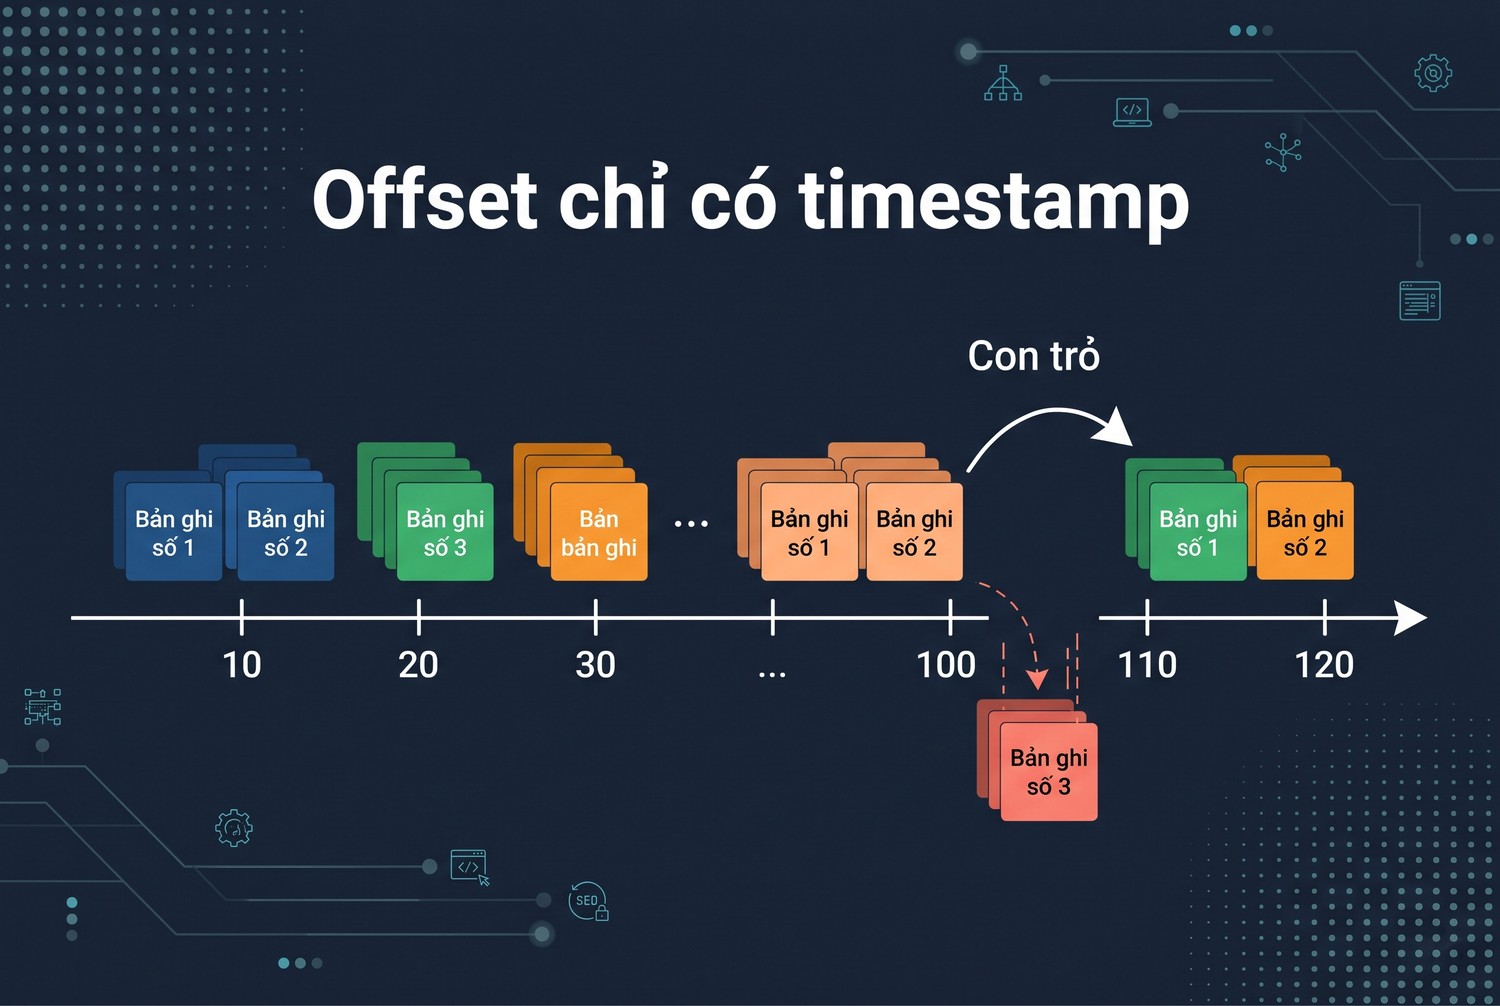
Offset chỉ có timestamp
Task lưu updated_at cuối, lần sau hỏi các bản ghi có updated_at lớn hơn. Trang đầu trả 1, 2, offset thành 100. Lần sau hỏi lớn hơn 100, nên bản ghi 3 bị bỏ qua vĩnh viễn.
A offset chi co updated_at, loc >: poll 4 | ghi 6 | thieu [3, 6, 9] | trung [] | offset cuoi 104Mất ba trên chín bản ghi, không có lỗi nào. Thiết kế offset sai làm mất dữ liệu trong im lặng, framework không thể biết.
Ca B: offset gồm timestamp và id
Task lưu cặp updated_at và id cuối cùng, hỏi các bản ghi lớn hơn cặp đó theo thứ tự từ điển. API phải hỗ trợ sắp xếp theo hai cột và lọc theo cặp.
def fetch_cursor(off):
    ts, i = off
    r = sorted([x for x in API if (x["updated_at"], x["id"]) > (ts, i)],
               key=lambda x: (x["updated_at"], x["id"]))
    return r[:PAGE]
Kết quả: 6 lần poll, đủ 9 bản ghi, không thiếu, không trùng.
Ca E: API không lọc được theo cặp
Nhiều API chỉ có tham số updated_since. Khi đó phải hỏi lớn hơn hoặc bằng, rồi loại các ID đã thấy ở đúng mốc đó. Offset phải chứa cả tập ID cùng timestamp cuối, ví dụ ts 104 và seen gồm 8, 9. Mô phỏng cũng ra đủ 9, không trùng.
{"ts": 104, "seen": [8, 9]}Cái giá là offset lớn lên nếu một mốc có quá nhiều bản ghi. Một lô cập nhật hàng chục nghìn dòng cùng giây sẽ làm offset rất nặng.
Bảng kết quả offset
Mọi dòng dưới đây là output của script mô phỏng trên 9 bản ghi.
Ca |
Thiết kế offset |
Ghi |
Thiếu |
Trùng |
|---|---|---|---|---|
A |
Chỉ updated_at, lọc lớn hơn |
6 |
3, 6, 9 |
Không |
B |
updated_at cộng id |
9 |
Không |
Không |
E |
Mốc thời gian cộng tập ID đã thấy |
9 |
Không |
Không |
Thứ API phải cam kết
Ca B chỉ đúng khi API sắp xếp ổn định, và không có bản ghi nào xuất hiện muộn với timestamp cũ. Nếu nguồn gán updated_at khi bắt đầu giao dịch, rồi giao dịch commit sau, bản ghi có thể lọt ra sau cursor. Anh em cần hỏi chủ API về điều này, hoặc lùi cursor một khoảng an toàn và chấp nhận trùng.
Câu hỏi nên gửi chủ API
Trước khi thiết kế offset, hãy có câu trả lời bằng văn bản cho vài câu. Kết quả có sắp xếp ổn định không. updated_at được gán lúc nào, có thể lùi không. Có trả bản ghi đã xóa không. Hạn mức theo phút và theo ngày là bao nhiêu. Cursor sống được bao lâu. Những câu này quyết định thiết kế nhiều hơn bất kỳ plugin nào.
Múi giờ và độ chính xác của timestamp
Timestamp chỉ chính xác tới giây làm nhiều bản ghi trùng mốc hơn hẳn so với mili giây. Múi giờ không ghi rõ thì so sánh sai ngay ở lần đầu. Offset nên lưu đúng chuỗi API trả về, đừng đổi định dạng, vì đổi qua đổi lại dễ mất phần lẻ của giây và bỏ sót bản ghi ở đúng mốc đó.
Lùi cursor có chủ ý
Khi không chắc về bản ghi đến muộn, nhiều nhóm lùi cursor vài phút mỗi lần hỏi. Cách này chấp nhận trùng để giảm nguy cơ mất, và hợp với thiết kế có key ổn định. Khoảng lùi phải lớn hơn thời gian giao dịch dài nhất ở phía nguồn. Lab không mô phỏng ca này, đây là kỹ thuật thường dùng.
Thiết kế schema record và hành vi restart của Kafka Connect HTTP source boundaries
Phần này xử lý chuyện trùng sau restart và dựng schema.
Khoảng hở giữa ghi và commit
Record được ghi vào topic trước, offset được lưu sau. Task chết giữa hai việc thì record đã nằm trong topic, nhưng offset còn cũ. Lần chạy sau đọc lại từ offset cũ, sinh trùng. Đó là ý nghĩa của at least once. Confluent ghi rõ giao ít nhất một lần.
Ca C và ca D
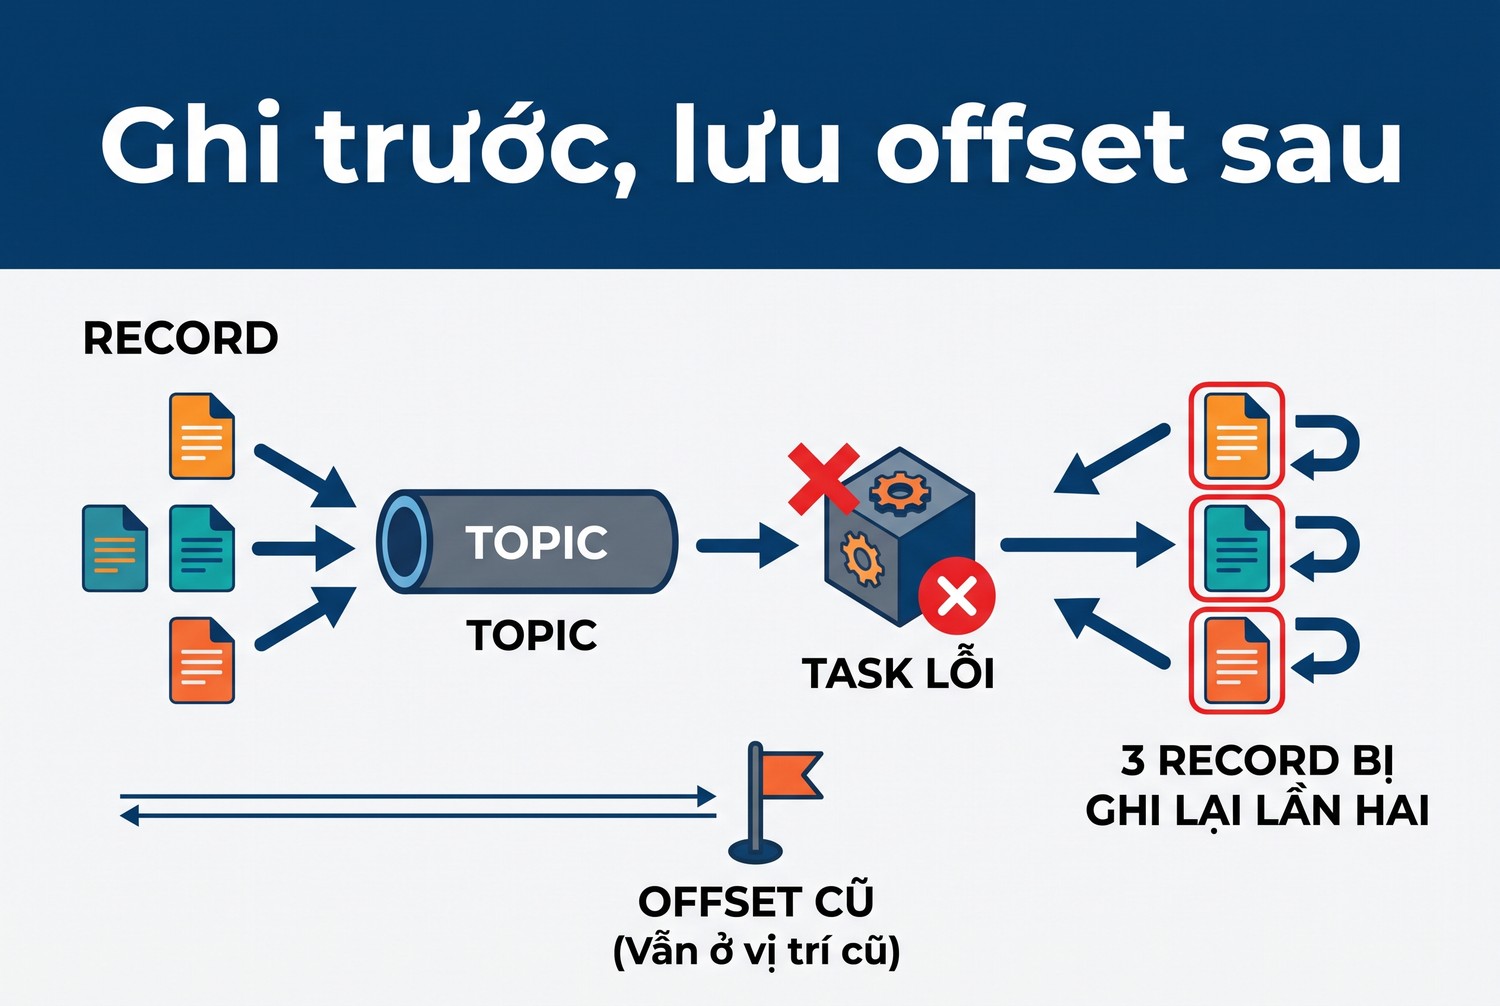
Ghi trước, lưu offset sau
Mô phỏng cho task chết sau lần poll thứ năm với hai tần suất flush. Flush thưa thì trùng nhiều hơn.
C nhu B, flush moi 3 poll, crash sau poll 5: poll 8 | ghi 12 | thieu [] | trung [7, 8, 9]
D nhu B, flush moi poll, crash sau poll 5: poll 7 | ghi 10 | thieu [] | trung [9]
Cả hai không mất bản ghi. Số bản trùng tăng theo khoảng thời gian giữa hai lần flush. Trong Connect thật, khoảng này gắn với cấu hình offset.flush.interval.ms của worker, lab chưa kiểm tra con số thật.
Key của record
Trùng không đáng sợ nếu record có key ổn định. Key nên là định danh nghiệp vụ, ví dụ tên nguồn ghép id. Consumer ghi đè theo key, hoặc topic bật compaction giữ giá trị mới nhất mỗi key. Ca H của mô phỏng chạy lại từ đầu, sinh lại 9 record nhưng vẫn chỉ 9 key.
Record cập nhật
Khi bản ghi cũ được sửa, updated_at mới đưa nó ra sau cursor. Ca F: id 2 được sửa ở mốc 105, chạy tiếp từ offset cũ nhận đúng một record mới với giá trị b2. Topic có cả bản cũ và bản mới của key đó. Consumer theo key sẽ thấy trạng thái mới nhất.
Xóa ở nguồn
Đây là giới hạn lớn của mô hình polling theo updated_at. Bản ghi bị xóa thì không xuất hiện trong kết quả nữa, nên không sinh record nào. Topic vẫn giữ bản cũ. Nếu nguồn có soft delete, trường deleted_at đi qua bình thường. Nếu xóa cứng, phải đối soát toàn bộ định kỳ hoặc xin API sự kiện xóa.
Schema của giá trị
Record nên có cấu trúc rõ ràng thay vì chuỗi JSON thô. Bọc dữ liệu API vào phong bì có nguồn, thời điểm tải, phiên bản schema. Khi API đổi trường, phần phong bì không đổi, consumer biết cách xử lý theo phiên bản.
{
  "key": "shop:2",
  "value": {
    "source": "shop-api",
    "endpoint": "/items",
    "schema_version": 1,
    "fetched_at": "2026-11-04T08:00:00Z",
    "payload": {"id": 2, "updated_at": 105, "v": "b2"}
  }
}
Mẫu trên là đề xuất của ProxyVN. Plugin cụ thể có cách ánh xạ riêng, phải đọc tài liệu plugin.
Định dạng partition và offset cần ghi vào thiết kế
Bản thiết kế phải viết ra dạng thật của hai đối tượng này, vì chúng là thứ anh em sẽ đọc và sửa bằng REST API khi cần phục hồi.
{"offsets": [{"partition": {"source": "shop-api", "endpoint": "/items"},
              "offset": {"updated_at": 104, "id": 9}}]}
Dạng trên khớp cấu trúc offsets trong User Guide, còn tên trường do connector quyết định.
Đặt lại offset khi cần
Khi muốn chạy lại, dừng connector rồi xóa hoặc sửa offset theo tài liệu. Chạy lại từ đầu sẽ gọi API rất nhiều, phải nghĩ tới hạn mức. Với key ổn định thì chỉ tốn thời gian, dữ liệu vẫn đúng. Không có key ổn định thì đừng bao giờ làm điều này trên topic đang có người đọc.
Task và phân chia công việc
Một connector có thể tạo nhiều task. Với HTTP, song song không tự đến: một API với một cursor chỉ có thể có một task. Muốn song song, chia theo endpoint hay theo tenant, mỗi phần có source partition riêng. Đừng đặt tasks.max cao rồi nghĩ sẽ nhanh hơn.
Hạn mức của API
Plugin gọi API theo chu kỳ. Quá nhanh thì nhận 429, quá chậm thì dữ liệu trễ. Cần biết plugin xử lý 429 thế nào: thử lại, dừng task, hay bỏ qua. README của castorm có phần Timer điều tiết tốc độ gọi. Đây là một mục phải có trong danh sách đánh giá.
Lỗi task và theo dõi
GET /connectors/{name}/status cho biết trạng thái connector và từng task, kèm lỗi. Task lỗi không tự khởi động lại mặc định, nên cần cảnh báo. Tài liệu có endpoint restart với includeTasks và onlyFailed. Giám sát phải nhìn cả độ trễ dữ liệu, vì task chạy mà API trả rỗng cũng là sự cố.
Chỉ chốt lab sau khi plugin được xác minh trong Kafka Connect HTTP source boundaries
Phần này nói về việc cần làm trước khi đầu tư lab thật.
Vì sao chưa làm lab plugin
Brief yêu cầu lab chỉ sau khi plugin cụ thể được xác minh. Dựng lab với plugin chưa chọn là phí công, kết quả không dùng lại được. Thứ cần chốt trước là license, phiên bản Kafka, cách phân trang của API. Sau đó lab mới có câu hỏi rõ ràng để trả lời.
Danh sách xác minh plugin
Khi đã chọn một plugin, kiểm tra từng dòng trên đúng phiên bản Kafka của anh em.
- Tải đúng bản phát hành, ghi lại mã băm.
- Đặt vào plugin.path, xem worker có nạp được không.
- Tạo connector với API thử, đọc GET status.
- Đọc GET offsets, đối chiếu với thiết kế.
- Kill worker giữa chừng, đếm bản trùng.
- Cho API trả 429 và 500, xem task phản ứng ra sao.
- Tạo dữ liệu cùng timestamp, kiểm tra có mất bản ghi không.
Bộ fixture nên dùng
Máy chủ thử nên có đủ các ca của mô phỏng: nhiều bản ghi cùng timestamp, bản ghi cũ được sửa, bản ghi bị xóa, trang rỗng ở giữa, lỗi tạm thời. Script mô phỏng trong bài có thể đổi thành máy chủ HTTP nhỏ cho mục đích này. So số bản ghi nhận được với bảng trong bài.
Kết quả mong đợi của lab thật
Lab thật đạt khi trả lời được ba câu: có mất bản ghi không, trùng tối đa bao nhiêu sau khi kill, phục hồi bằng REST API có đúng tài liệu không. Con số nào cũng được, miễn là đo trên hệ thống thật và ghi vào bản thiết kế.
Bảo mật khi gọi API
Khóa API không nên nằm thẳng trong cấu hình connector, vì GET config trả lại nguyên văn. User Guide có cơ chế config provider để lấy giá trị từ bên ngoài. Plugin khác nhau hỗ trợ khác nhau, nên kiểm tra lúc đánh giá. Lab không thử phần này.
Chỗ của proxy trong sơ đồ
Proxy thường không nằm trong Connect. Nếu API nguồn yêu cầu đi ra qua một IP cố định, cấu hình proxy phụ thuộc plugin, và phải đọc tài liệu của đúng plugin đã chọn. Với crawl trang web, nên để crawler riêng làm việc đó rồi đẩy vào Kafka. Với website được phép thu thập, có lúc cần IP tại Việt Nam để nhận đúng nội dung trong nước. Khi đó anh em có thể mua proxy giá rẻ tại trang chủ ProxyVN. Proxy không sửa được thiết kế offset. Vai trò của nó có ở bài Web Scraping proxy là gì, cách ghi chuỗi cấu hình ở bài định dạng proxy.
Đầu ra nghiệm thu của Kafka Connect HTTP source boundaries
Phần này là mẫu bản thiết kế.
Mẫu bản thiết kế
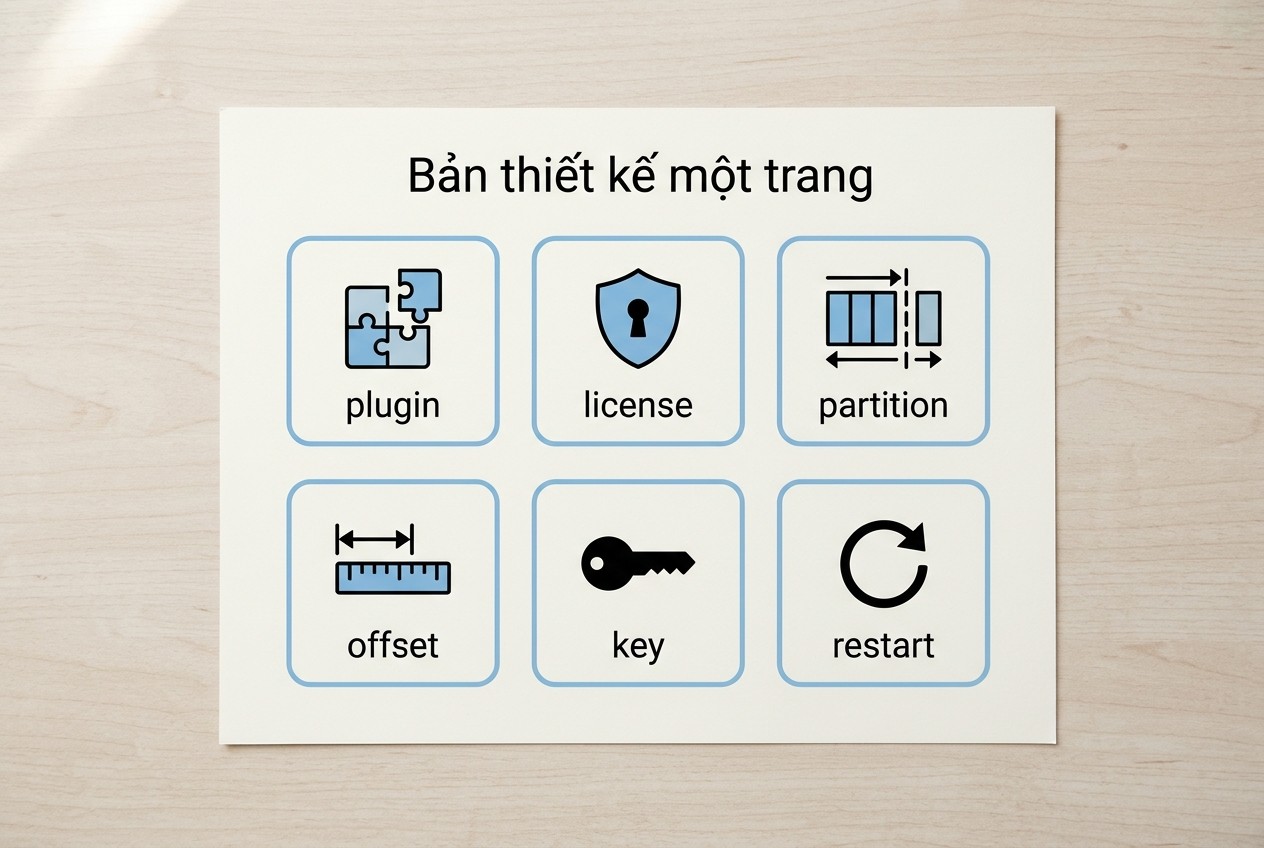
Bản thiết kế một trang
Bản thiết kế cần ngắn, mỗi mục trả lời một câu hỏi. Một trang là đủ.
Mục |
Nội dung cần điền |
|---|---|
API nguồn |
Endpoint, cách phân trang, hạn mức, quyền sử dụng dữ liệu |
Plugin |
Tên, phiên bản, license, ngày kiểm tra, người chịu trách nhiệm |
Source partition |
Dạng cụ thể, ví dụ source và endpoint |
Source offset |
Dạng cụ thể, API cam kết gì với giá trị đó |
Key của record |
Quy tắc sinh, có ổn định không |
Value |
Phong bì, schema version |
Restart |
Trùng tối đa bao nhiêu, consumer xử lý thế nào |
Xóa ở nguồn |
Có hay không, xử lý ra sao |
Phục hồi |
Lệnh dừng, đọc, sửa offset |
Chi phí vận hành của Connect
Connect là một cụm worker cần được theo dõi, nâng cấp, phân quyền. Còn có các topic nội bộ cho cấu hình, offset, trạng thái. Nếu nhóm đã chạy Connect cho việc khác thì thêm một connector khá rẻ. Nếu dựng mới chỉ để đọc một API, chi phí vận hành có thể lớn hơn việc tự viết một dịch vụ nhỏ.
Khi tự viết producer hợp lý hơn
Với API nhỏ, một dịch vụ Python đọc cursor từ cơ sở dữ liệu, gọi API, gửi Kafka, rồi lưu cursor sau khi nhận xác nhận từ producer là đủ. Các bẫy về offset trong bài vẫn áp dụng y nguyên. Khác biệt là anh em phải tự làm phần lưu trạng thái, theo dõi và khởi động lại mà Connect cho sẵn.
Những gì lab chưa chạy
Chưa chạy Kafka, Connect, plugin Confluent, plugin castorm, plugin Aiven. Chưa thử REST API, chưa thử exactly-once, chưa đo tần suất commit. Các lệnh curl và cấu hình trong bài là ví dụ từ tài liệu. Kết quả chạy duy nhất là script Python về logic offset.
Quyết định gợi ý
Quan điểm của ProxyVN: nếu API có cursor rõ ràng và nhóm viết được Java, một connector tự viết nhỏ dễ kiểm soát hơn. Nếu cần hỗ trợ và có ngân sách, xem Confluent. Dự án castorm phù hợp để thử nhanh, nhưng phải kiểm tra tương thích kỹ. Dù chọn gì, thiết kế offset vẫn là việc của anh em.
Kafka Connect HTTP source boundaries: câu hỏi thường gặp
Các câu dưới đây gom những điểm anh em hay hỏi.
Apache Kafka có sẵn HTTP source connector không?
Tài liệu Connect của Apache không có connector HTTP. Ví dụ đi kèm là FileStream. Phải dùng plugin bên ngoài hoặc tự viết.
Connector HTTP của Aiven dùng được để đọc API không?
Không. README ghi đó là sink connector, chiều từ Kafka ra HTTP. Chiều ngược với bài toán đọc API.
Offset chỉ gồm timestamp có đủ không?
Không đủ khi nhiều bản ghi trùng timestamp. Mô phỏng mất 3 trên 9 bản ghi mà không báo lỗi. Cần thêm id hoặc tập ID đã thấy.
Restart có gây trùng dữ liệu không?
Có. Record được ghi trước khi offset được lưu. Mô phỏng thấy 1 đến 3 bản trùng tùy tần suất flush. Dùng key ổn định để xử lý.
Connect có bắt được bản ghi đã xóa không?
Polling theo updated_at thì không, vì bản ghi đã xóa không xuất hiện. Cần soft delete, sự kiện xóa hoặc đối soát định kỳ.
Bài đã chạy plugin nào chưa?
Chưa. Bài là bản quyết định theo brief, lab plugin chỉ làm sau khi chọn plugin. Phần chạy thật chỉ là mô phỏng logic offset bằng Python.
Kafka Connect HTTP source boundaries và những điều cần nhớ
Kafka Connect HTTP source boundaries bắt đầu từ chỗ Apache không kèm HTTP source, nên plugin và license là quyết định riêng. Offset phải đủ để không mất bản ghi cùng timestamp, còn key ổn định lo phần trùng sau restart. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em xác minh plugin trước khi chốt Kafka Connect HTTP source boundaries.


