HTTP 300 Multiple Choices crawler: chọn đại diện có quy tắc
HTTP 300 Multiple Choices crawler là bài toán crawler nhận về một danh sách nhiều đại diện của cùng tài nguyên thay vì một trang, rồi phải quyết định có chọn hay không. Mã 300 rất hiếm, nên đa số crawler chưa từng có nhánh xử lý riêng cho nó. ProxyVN dựng một origin lab trả 300 có và không có Location, chạy requests, httpx, urllib và curl thật để xem ai dừng ai đi tiếp, rồi viết quy tắc chọn đại diện có log để nghiệm thu.
HTTP 300 Multiple Choices crawler: mục tiêu và phạm vi không lặp
Phần này chốt bài toán và ranh giới với các bài redirect đã có.
Bài toán cần giải
Một crawler báo cáo tài chính gặp URL trả 300. Có thư viện dừng lại, trả về body danh sách. Có công cụ lặng lẽ đi theo Location và tải bản tiếng Việt. Ở lần chạy khác, cùng URL nhưng không có Location, crawler lưu một trang danh sách JSON như thể đó là báo cáo. Dữ liệu lệch mà không ai biết.
Đầu ra nghiệm thu
Đầu ra là một origin lab trả 300 trong ba dạng: có Location, không Location, danh sách dạng HTML. Kèm theo là bảng hành vi của bốn client, và một tệp log quyết định ghi rõ crawler đã chọn đại diện nào, vì sao, hoặc vì sao dừng.
Ranh giới với bài redirect
Bài lỗi ERR_TOO_MANY_REDIRECTS nói về vòng chuyển hướng trên trình duyệt. Bài này không lặp 301, 302. Mã 300 thuộc nhóm 3xx nhưng ý nghĩa khác: server không chỉ một chỗ mới, mà đưa ra nhiều lựa chọn và nhờ client chọn. Đồng nhất 300 với redirect là nguồn gốc của mọi lỗi trong bài này.
Ranh giới với bài 406
Bài lỗi 406 Not Acceptable nói về thương lượng chủ động, server chọn theo header Accept rồi từ chối khi không có gì khớp. Mã 300 là thương lượng phản ứng: server không chọn, trả danh sách cho client chọn. Hai bài bổ sung cho nhau, bài này chỉ đứng ở phía client nhận 300.
Giới hạn của lab
Origin là máy chủ Python tự viết bằng http.server, nghe ở 127.0.0.1:9721. Danh sách đại diện, kích thước tệp và định dạng body do ProxyVN đặt. HTTP không định nghĩa định dạng chung cho danh sách này, nên API thật có thể trả cấu trúc khác. Thứ thật trong lab là hành vi của bốn client trên cùng phản hồi.
Ai nên đọc
Người viết crawler cho kho tài liệu có nhiều ngôn ngữ hoặc nhiều định dạng tải về. Người duy trì crawler gặp mã 300 trong log mà chưa biết xử lý sao. Người cần chứng minh dữ liệu đã lưu đúng là bản cần lấy, không phải bản server tình cờ chỉ tới.
Xử lý response 300 có nhiều đại diện trong HTTP 300 Multiple Choices crawler
Phần này tóm tắt chuẩn, chỉ giữ những ý ảnh hưởng tới crawler.
Định nghĩa trong RFC 9110
Theo RFC 9110 mục 15.4.1, mã 300 cho biết tài nguyên đích có nhiều hơn một đại diện, mỗi đại diện có định danh riêng cụ thể hơn. Server cung cấp thông tin về các lựa chọn để người dùng hoặc user agent chọn bằng cách gửi request tới một hoặc vài định danh đó.
Thương lượng phản ứng
RFC gọi đây là reactive negotiation. Với thương lượng chủ động, server chọn dựa trên Accept, Accept-Language. Với thương lượng phản ứng, server liệt kê, client chọn. Crawler vì vậy phải mang theo một quy tắc chọn, không thể giao hết cho server.
Location là tùy chọn
Location chỉ là gợi ý
Nếu server có lựa chọn ưu tiên, RFC nói server nên gửi Location chứa URI của lựa chọn đó. User agent có thể dùng Location để tự chuyển hướng. Từ "có thể" là điểm mấu chốt. Có Location không bắt client phải đi theo, không có Location cũng không có nghĩa là phản hồi hỏng.
Danh sách nằm trong body
Với method khác HEAD, server nên đưa vào body danh sách metadata của các đại diện kèm URI. User agent có thể tự chọn nếu hiểu media type của danh sách. RFC không định nghĩa định dạng chung cho danh sách. Thực tế, mỗi server tự chọn: HTML có liên kết, JSON riêng, hoặc thứ khác.
Link header là một lựa chọn
RFC có ghi chú: các đề xuất cũ như header URI và Alternates đã bị bỏ. Có thể truyền danh sách bằng header Link với quan hệ alternate theo RFC 8288, nhưng mức triển khai thấp. Origin lab gửi cả body JSON và Link, để client nào hiểu Link cũng thử được.
300 có thể được cache
RFC ghi 300 được cache theo heuristic, trừ khi method hoặc header cache nói khác. Với crawler đi qua proxy có cache, một phản hồi 300 cũ có thể được trả lại sau khi server đã đổi danh sách. Khi kết quả lạ, kiểm header Age và Cache-Control trước khi kết luận server sai.
Vì sao crawler hiếm gặp 300
Đa số website chọn thương lượng chủ động: đọc Accept-Language, cookie hoặc đường dẫn có mã ngôn ngữ rồi trả thẳng một trang. Mã 300 chỉ xuất hiện khi server được cấu hình để không tự chọn, hoặc khi việc chọn bị lỗi. Vì hiếm, crawler thường thiếu test cho nó, và lỗi chỉ lộ ra khi đã có dữ liệu sai trong kho.
Đại diện khác với bản sao
Các đại diện trong 300 là cùng một tài nguyên ở dạng khác nhau: ngôn ngữ, định dạng, độ nén. Chúng không phải các trang khác nhau có nội dung riêng. Crawler cần lưu chúng dưới cùng một khóa tài nguyên, kèm thuộc tính đại diện, để tránh đếm một báo cáo thành bốn báo cáo.
Bảng so sánh với các mã 3xx khác
Bảng dưới đặt 300 cạnh các mã crawler hay gặp, theo cách RFC 9110 phân nhóm.
Mã |
Ý nghĩa |
Location |
Client tự đi tiếp? |
|---|---|---|---|
300 |
Nhiều đại diện, client chọn |
Tùy chọn, là lựa chọn ưu tiên |
Không mặc định ở requests, httpx |
301, 308 |
Chuyển vĩnh viễn |
Nên có |
Có |
302, 307 |
Chuyển tạm |
Nên có |
Có |
303 |
Xem tài nguyên khác |
Có |
Có, đổi sang GET |
304 |
Dùng bản đã lưu |
Không |
Không, là phản hồi điều kiện |
Cột cuối là kết quả lab với hai thư viện Python, không phải quy định của RFC.
Tạo origin trả danh sách đại diện và tùy chọn Location cho HTTP 300 Multiple Choices crawler
Phần này dựng origin lab, chạy thật trên Python 3.12.10.
Bốn đại diện
Tài nguyên mẫu là báo cáo quý 3 năm 2026 với bốn đại diện: HTML tiếng Việt, HTML tiếng Anh, CSV tiếng Việt, PDF tiếng Việt 812.400 byte. Mỗi đại diện có type, lang và bytes.
ALTS = [
    {"href": "/bao-cao/2026-q3.vi.html", "type": "text/html", "lang": "vi", "bytes": 48211},
    {"href": "/bao-cao/2026-q3.en.html", "type": "text/html", "lang": "en", "bytes": 47002},
    {"href": "/bao-cao/2026-q3.csv", "type": "text/csv", "lang": "vi", "bytes": 9120},
    {"href": "/bao-cao/2026-q3.pdf", "type": "application/pdf", "lang": "vi", "bytes": 812400},
]
Con số kích thước là giá trị giả lập để kiểm quy tắc giới hạn dung lượng.
Vì sao dùng JSON cho danh sách
Lab chọn JSON vì dễ đọc bằng mã và có chỗ cho metadata như kích thước. Server thật cũng có thể dùng HTML, vì RFC nhắc tới định dạng siêu văn bản phổ biến. Lab có cả hai để bộ đọc phải xử lý theo content type, không mặc định một định dạng duy nhất.
Ba endpoint 300
Origin có ba đường dẫn trả 300. /r/co-location trả JSON kèm Location tới bản HTML tiếng Việt. /r/khong-location trả JSON không có Location. /r/html-list trả trang HTML liệt kê các liên kết có thuộc tính type và hreflang. Cả ba đều gửi header Link liệt kê bốn đại diện.
if p == "/r/co-location":
    self.send(300, json.dumps({"alternates": ALTS}), "application/json",
              [("Location", "/bao-cao/2026-q3.vi.html")] + links)
elif p == "/r/khong-location":
    self.send(300, json.dumps({"alternates": ALTS}), "application/json", links)
Origin còn có /r/redirect-302 để đối chiếu với redirect thông thường.
Ghi log phía server
Mỗi request tới origin được ghi method, đường dẫn và Accept. Log phía server là bằng chứng không thể chối: nếu client nói đã dừng ở 300 nhưng log có request tới tệp báo cáo, nghĩa là client đã đi tiếp.
HEAD cũng trả 300
RFC nói body danh sách dành cho method khác HEAD. Lab gửi HEAD tới /r/khong-location, nhận 300, không có body, header Link vẫn có bốn phần tử. Crawler kiểm nhanh bằng HEAD sẽ chỉ thấy Link, nên nếu muốn chọn được đại diện, crawler phải biết đọc Link hoặc gửi thêm GET.
Origin thật thường trả gì
Mã 300 hiếm ngoài đời. Ví dụ hay gặp là các máy chủ có tính năng thương lượng nội dung theo tệp, khi không chọn được biến thể sẽ trả danh sách. Một số hệ quản lý tài liệu và kho dữ liệu khoa học dùng 300 để chỉ nhiều định dạng tải về. Bài không khẳng định dịch vụ cụ thể nào dùng cấu trúc như lab.
Đặt tên đại diện rõ ràng
Đường dẫn đại diện trong lab mang sẵn ngôn ngữ và đuôi định dạng, như 2026-q3.vi.html. Điều này giúp người đọc log hiểu ngay đại diện nào được chọn. Với nguồn thật có URL đại diện khó đọc, bản ghi quyết định phải lưu kèm type và lang lấy từ danh sách, đừng chỉ lưu URL.
Không cần proxy ở bước này
Origin lab chạy trên máy cục bộ, crawler gọi thẳng. Hành vi trước mã 300 nằm ở thư viện client, không phụ thuộc đường mạng. Proxy chỉ cần khi tải từ website thật có giới hạn theo vùng, và ngay cả khi đó cũng không đổi cách client xử lý 300.
Quan sát client có tự đi theo Location hay dừng trong HTTP 300 Multiple Choices crawler
Phần này là kết quả chạy thật của bốn client.
requests dừng ở 300
requests dừng, curl đi tiếp
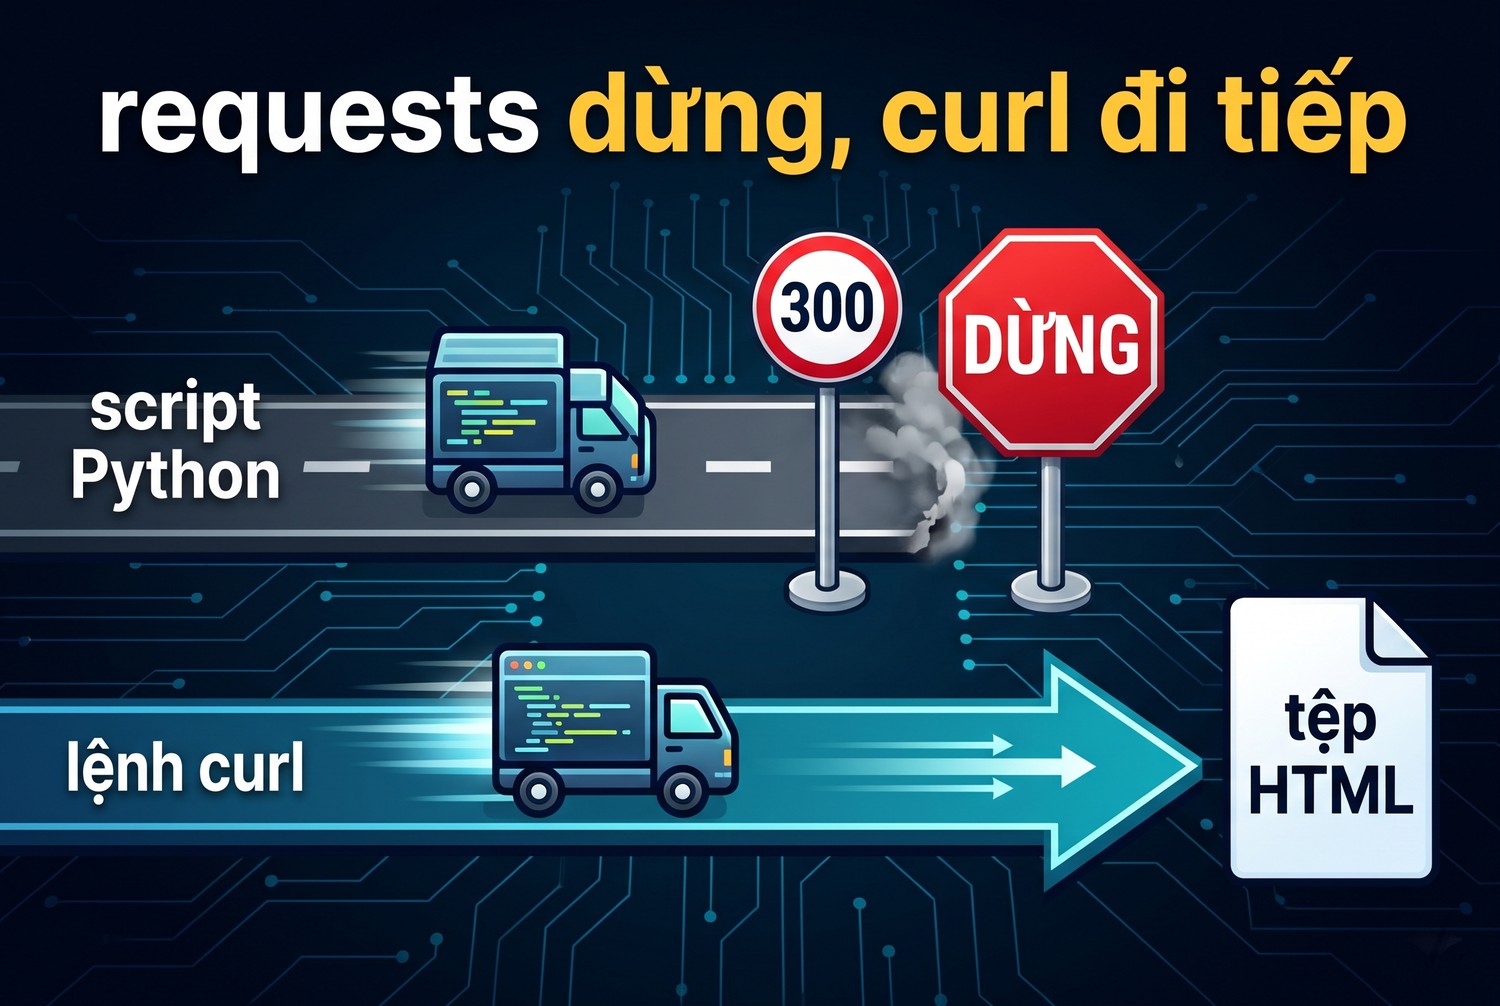
requests 2.34.2 mặc định allow_redirects bật. Với cả hai endpoint 300, requests trả status 300, history rỗng, is_redirect False, server chỉ thấy đúng một request. Với 302, requests đi tiếp, history [302], server thấy hai request.
/r/co-location     status=300 history=[] is_redirect=False server_thay=['/r/co-location']
/r/khong-location  status=300 history=[] is_redirect=False server_thay=['/r/khong-location']
/r/redirect-302    status=200 url_cuoi=/bao-cao/2026-q3.vi.html history=[302]
Lý do: requests chỉ đi theo các mã trong danh sách redirect của nó, và 300 không nằm trong danh sách đó, dù có Location.
httpx cũng dừng
httpx 0.28.1 với follow_redirects=True cho kết quả giống requests: 300 dừng, has_redirect_location False, 302 đi tiếp. Lưu ý httpx mặc định không đi theo redirect nào, theo tài liệu tương thích của httpx. Lab bật follow_redirects để so sánh công bằng.
urllib ném HTTPError
urllib.request trong Python 3.12.10 ném HTTPError 300 với /r/co-location. Server chỉ thấy một request. Với 302, urllib đi tiếp bình thường. Crawler viết bằng urllib phải bắt HTTPError, kiểm code 300 rồi đọc body từ đối tượng lỗi.
curl -L đi theo Location
curl 8.13.0 bản có sẵn trên Windows với -L xử lý khác. Với /r/co-location, curl trả 200, URL cuối là bản HTML tiếng Việt, một lần chuyển hướng. Với /r/khong-location, curl trả 300, không chuyển hướng.
/r/co-location     curl: 200 /bao-cao/2026-q3.vi.html 1 server_thay=['/r/co-location', '/bao-cao/2026-q3.vi.html']
/r/khong-location  curl: 300 /r/khong-location 0 server_thay=['/r/khong-location']
Đây là phát hiện quan trọng nhất của lab: cùng một URL, script Python và lệnh curl lấy về hai thứ khác nhau.
Session có đổi kết quả không
Lab dùng hàm get độc lập của requests. Một Session với cùng cấu hình mặc định cho kết quả như nhau, vì danh sách mã chuyển hướng không thuộc cấu hình phiên. Nếu dự án có lớp Session tùy biến ghi đè phương thức xử lý chuyển hướng, hãy chạy lại bốn ca của lab trên lớp đó trước khi tin bảng này.
Bảng hành vi
Bảng dưới gom kết quả của bốn client trên cùng origin.
Client |
300 có Location |
300 không Location |
302 |
|---|---|---|---|
requests 2.34.2 |
Dừng, 300 |
Dừng, 300 |
Đi tiếp, 200 |
httpx 0.28.1 follow |
Dừng, 300 |
Dừng, 300 |
Đi tiếp, 200 |
urllib Python 3.12 |
HTTPError 300 |
Chưa chạy riêng |
Đi tiếp, 200 |
curl 8.13.0 -L |
Đi theo Location, 200 |
Dừng, 300 |
Đi tiếp, 200 |
Hệ quả khi đổi công cụ
Đội dữ liệu hay thử nhanh bằng curl rồi viết script Python, hoặc ngược lại. Với 300 có Location, hai bên ra kết quả khác nhau mà không báo lỗi. Ai so checksum sẽ thấy lệch và mất thời gian tìm nguyên nhân ở proxy, ở cache, trong khi lý do nằm ở client.
Kiểm history sau mỗi request
Với requests và httpx, thuộc tính history cho biết các phản hồi chuyển hướng đã đi qua. Một phản hồi 200 có history chứa 300 là dấu hiệu có thứ gì đó đã tự chọn thay anh em. Lab không gặp trường hợp này với hai thư viện, nhưng một adapter hay plugin tự viết có thể làm vậy. Ghi history vào log để thấy ngay.
Lỗi ẩn khi bắt ngoại lệ chung
Crawler dùng urllib thường bọc request trong một khối bắt HTTPError rồi ghi "lỗi tải". Với 300, khối này nuốt mất danh sách đại diện vì body nằm trong đối tượng lỗi. Tách nhánh cho mã 300 trước nhánh lỗi chung, đọc body bằng phương thức read của đối tượng lỗi.
Không dựa vào hành vi mặc định
Hành vi mặc định có thể đổi giữa các phiên bản thư viện. Crawler nên tắt tự chuyển hướng ở bước đầu, đọc mã trạng thái, rồi tự quyết định. Lab dùng allow_redirects=False cho mọi request trong bước chọn đại diện.
Áp quy tắc chọn đại diện cho fixture đã định nghĩa trong HTTP 300 Multiple Choices crawler
Phần này viết quy tắc chọn và chạy trên năm tổ hợp.
Quy tắc phải viết trước
Brief của bài chốt một nguyên tắc: crawler không được tự chọn đại diện nếu không có quy tắc viết sẵn. Quy tắc trong lab gồm danh sách type chấp nhận theo thứ tự ưu tiên, danh sách ngôn ngữ, trần kích thước, và một cờ cho phép hay không cho phép đi theo Location khi không có gì khớp.
RULE = {"accept_types": ["text/csv", "text/html"], "lang": ["vi"], "max_bytes": 500_000}Trong ví dụ này crawler cần dữ liệu bảng, nên CSV đứng trước HTML.
Đọc danh sách từ body
Hàm chọn đọc danh sách theo content type của 300. JSON thì lấy khóa alternates. HTML thì duyệt các thẻ a, lấy href, type, hreflang bằng lxml. Danh sách HTML không có kích thước, nên điều kiện kích thước được bỏ qua với đại diện không rõ dung lượng.
if ct.startswith("application/json"):
    alts = json.loads(body)["alternates"]
elif ct.startswith("text/html"):
    from lxml import html as LH
    alts = [{"href": a.get("href"), "type": a.get("type"), "lang": a.get("hreflang"), "bytes": None}
            for a in LH.fromstring(body).iter("a")]
Định dạng danh sách của API thật có thể khác. Đây là phần anh em phải viết lại cho từng nguồn.
Lọc và ghi lý do loại
Mỗi đại diện được kiểm ba điều kiện. Đại diện bị loại thì ghi lý do cụ thể. Với /r/co-location, kết quả là hai đại diện đạt, hai bị loại.
('/bao-cao/2026-q3.vi.html', 'ok')
('/bao-cao/2026-q3.en.html', 'loai:lang')
('/bao-cao/2026-q3.csv', 'ok')
('/bao-cao/2026-q3.pdf', 'loai:type+size')
Bản PDF bị loại vì cả type lẫn kích thước. Bản tiếng Anh bị loại vì ngôn ngữ.
Chọn theo thứ tự ưu tiên
Trong các đại diện đạt, chọn cái có type đứng đầu danh sách ưu tiên. Lab chọn bản CSV, dù Location trỏ tới bản HTML. Quy tắc của crawler thắng lựa chọn ưu tiên của server, vì crawler biết mình cần dữ liệu bảng.
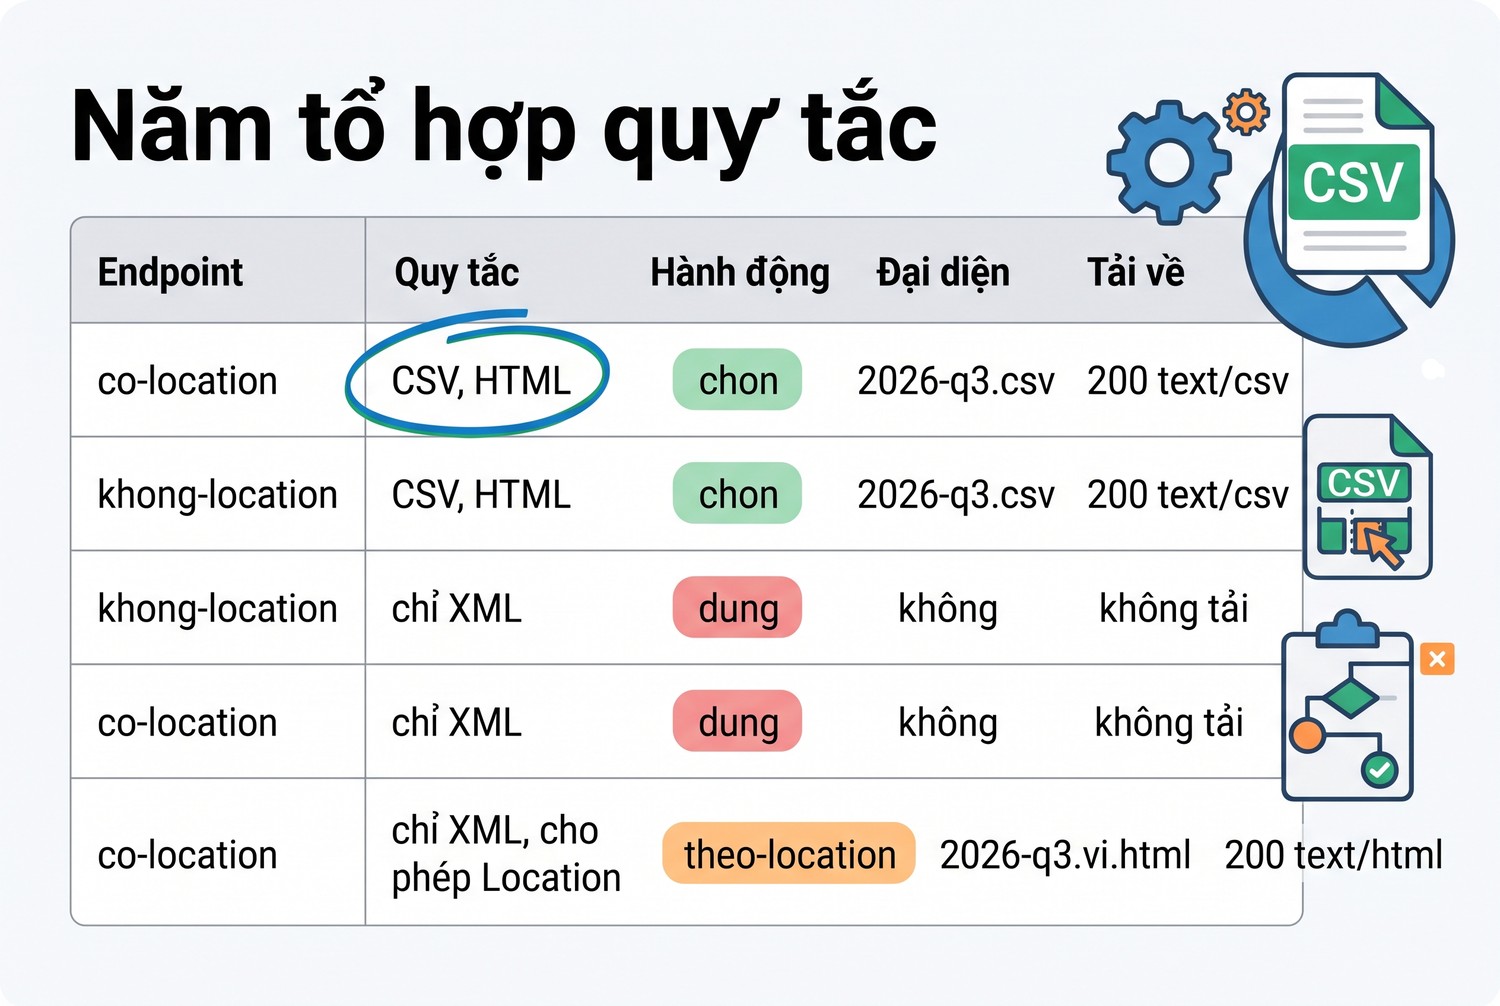
Năm tổ hợp
Năm tổ hợp quy tắc
Lab chạy năm tổ hợp giữa endpoint và quy tắc. Kết quả thật như bảng dưới.
Endpoint |
Quy tắc |
Hành động |
Đại diện |
Tải về |
|---|---|---|---|---|
co-location |
CSV, HTML |
chon |
2026-q3.csv |
200 text/csv |
khong-location |
CSV, HTML |
chon |
2026-q3.csv |
200 text/csv |
khong-location |
chỉ XML |
dung |
không |
không tải |
co-location |
chỉ XML |
dung |
không |
không tải |
co-location |
chỉ XML, cho phép Location |
theo-location |
2026-q3.vi.html |
200 text/html |
Thêm một tổ hợp với /r/html-list và quy tắc CSV, HTML: lab đọc danh sách từ thẻ a và cũng chọn bản CSV.
Khi không có gì khớp
Hai hướng đều hợp lý tùy mục đích. Dừng và lưu 300 cho người xem là hướng an toàn khi dữ liệu sai còn tệ hơn thiếu dữ liệu. Đi theo Location là hướng chấp nhận lựa chọn của server khi có còn hơn không. Lab mặc định dừng, chỉ đi theo Location khi quy tắc bật cờ fallback_location.
Ghi quy tắc vào cấu hình
Quy tắc chọn nên nằm trong tệp cấu hình theo nguồn, không viết cứng trong mã. Cùng một crawler có thể cần CSV ở nguồn này, PDF ở nguồn kia. Khi quy tắc thay đổi, chỉ sửa cấu hình và ghi phiên bản cấu hình vào bản ghi quyết định.
Hai đại diện cùng type
Khi hai đại diện cùng type và cùng ngôn ngữ, cần thêm tiêu chí phụ. Có thể chọn bản nhỏ hơn, bản có ngày mới hơn nếu danh sách có trường ngày, hoặc theo thứ tự xuất hiện. Ghi tiêu chí phụ vào quy tắc. Đừng để kết quả phụ thuộc thứ tự lặp ngẫu nhiên của một cấu trúc dữ liệu.
Đừng thử mọi đại diện
Một cách làm ngây thơ là tải hết bốn đại diện rồi chọn sau. Với báo cáo PDF 800KB và hàng nghìn tài nguyên, cách này nhân băng thông lên nhiều lần và tăng nguy cơ bị giới hạn tần suất. Quy tắc chọn trước khi tải là cách tiết kiệm nhất.
Ưu tiên lựa chọn của server khi nào
Có trường hợp anh em không có lý do để chọn khác server, ví dụ chỉ cần bất kỳ bản đọc được. Khi đó bật cờ cho phép đi theo Location và để danh sách ưu tiên rộng. Quyết định vẫn được ghi là theo-location, để sau này biết dữ liệu đến từ lựa chọn của server chứ không phải của crawler.
Quy tắc ngôn ngữ cần cụ thể
Thuộc tính hreflang có thể là vi, vi-VN, hoặc thiếu. Lab chỉ so chuỗi bằng nhau với vi. Với dữ liệu thật, chuẩn hóa về mã ngôn ngữ chính trước khi so, và quyết định rõ đại diện không có hreflang được coi là khớp hay không.
Lưu response300 và tài nguyên cuối để kiểm HTTP 300 Multiple Choices crawler không chọn sai
Phần này dựng bằng chứng nghiệm thu.
Bản ghi quyết định
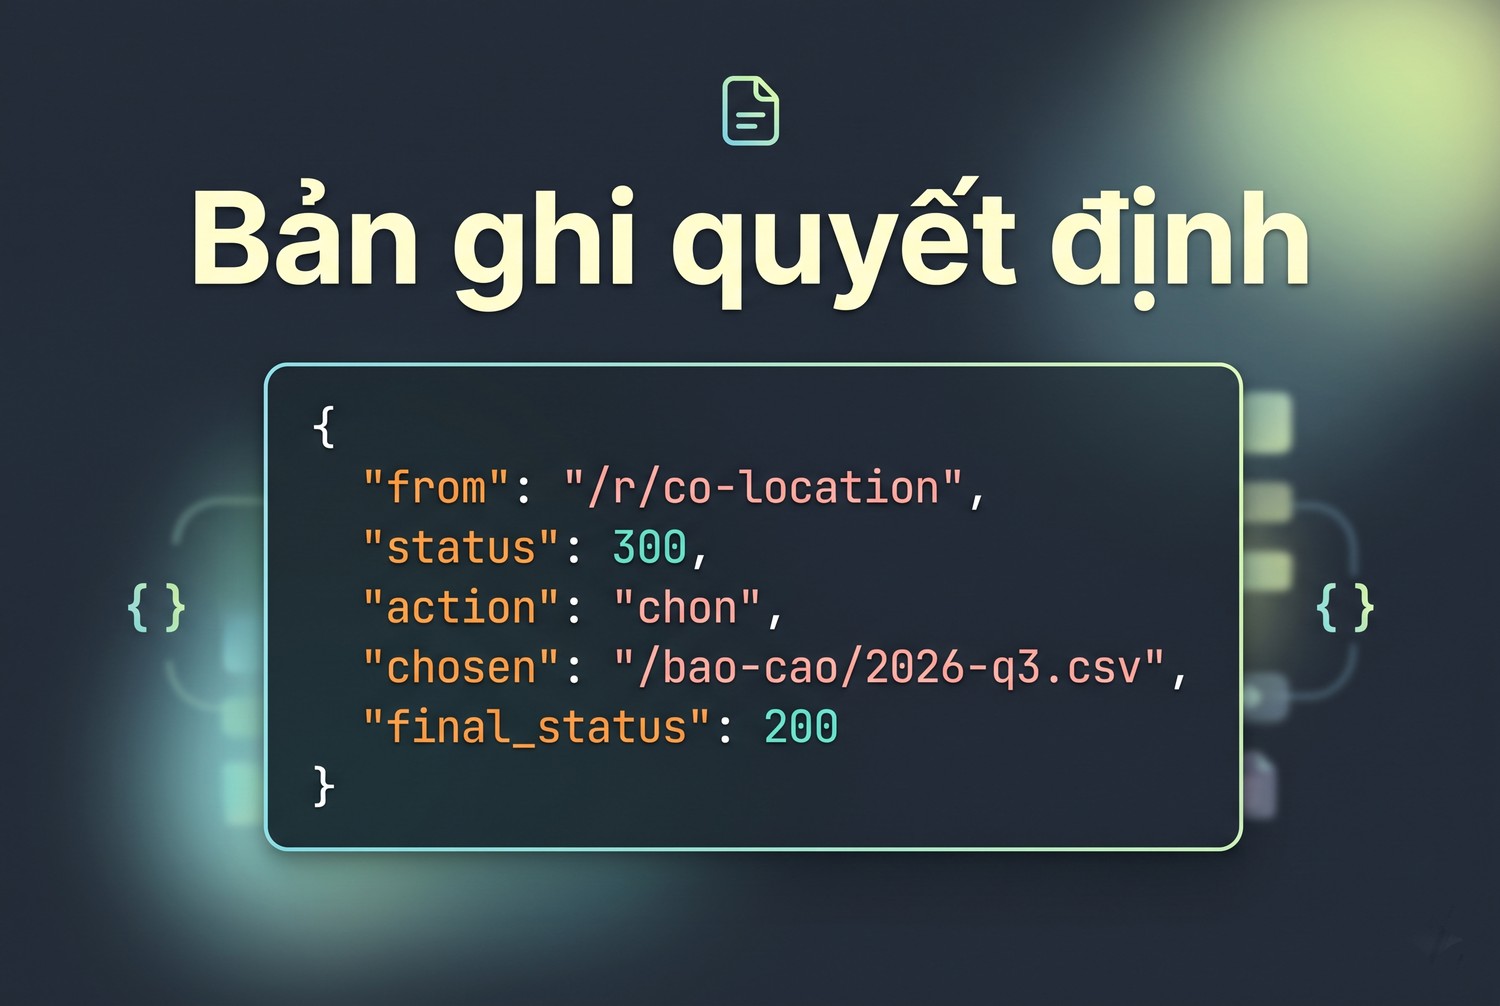
Bản ghi quyết định
Mỗi lần gặp 300, crawler ghi một bản ghi gồm URL gốc, mã, Location nếu có, nguồn danh sách và danh sách ứng viên kèm lý do. Bản ghi còn có hành động, đại diện đã chọn, mã và content type của lần tải cuối, cùng quy tắc đã áp. Đây là output thật của tổ hợp đầu tiên.
{"from": "http://127.0.0.1:9721/r/co-location", "status": 300,
 "location": "/bao-cao/2026-q3.vi.html", "source": "body-json",
 "action": "chon", "chosen": "/bao-cao/2026-q3.csv",
 "reason": "khop rule, uu tien theo accept_types",
 "final_status": 200, "final_type": "text/csv", "rule": ["text/csv", "text/html"]}
Lab ghi toàn bộ bản ghi ra decisions.json.
Mỗi tệp đã lưu từ một URL trả 300 phải trả lời được câu hỏi: ai đã chọn bản này, theo quy tắc nào.
Lưu nguyên body 300
Ngoài bản ghi, lưu nguyên body và header của phản hồi 300. Khi server đổi danh sách, có thể so lần trước với lần này. Body 300 thường nhỏ, lưu không tốn bao nhiêu.
Kiểm crawler không chọn sai
Phép kiểm đơn giản: với mỗi bản ghi có action là chon, content type của lần tải cuối phải nằm trong accept_types của quy tắc. Với action theo-location, ghi rõ là lựa chọn của server. Với action dung, không được có tệp đã lưu cho URL đó.
for d in decisions:
    if d["action"] == "chon":
        assert d["final_type"].split(";")[0] in d["rule"], d
    if d["action"] == "dung":
        assert "final_status" not in d, d
Đoạn kiểm này là ví dụ triển khai, chạy trên decisions.json của lab.
Kiểm lại theo lịch
Danh sách đại diện có thể đổi theo thời gian, ví dụ server thêm bản XLSX. Lên lịch gửi lại request tới URL trả 300 theo chu kỳ dài hơn lượt crawl thường, so danh sách mới với body đã lưu. Khi có đại diện mới khớp quy tắc tốt hơn, crawler ghi bản ghi mới và giữ bản cũ để đối chiếu.
Đếm 300 theo nguồn
Mã 300 hiếm, nên một nguồn bỗng có nhiều 300 là tín hiệu đáng xem. Có thể server vừa bật thương lượng nội dung, hoặc cấu hình hỏng khiến server không còn tự chọn được. Bộ đếm theo tên miền và theo hành động giúp phát hiện sớm.
Không ghi đè dữ liệu cũ
Khi quy tắc thay đổi, crawler có thể chọn đại diện khác cho cùng URL. Lưu đại diện mới cạnh bản cũ, có trường ghi quy tắc nào đã chọn. Ghi đè sẽ xóa dấu vết, và báo cáo so sánh qua các kỳ sẽ lệch mà không ai biết lý do.
Location trỏ sang host khác
Location hoặc href trong danh sách có thể trỏ sang tên miền khác, ví dụ kho lưu tệp riêng. Crawler nên kiểm host trước khi tải. Nếu nguồn cho phép tải từ host phụ, ghi danh sách host được phép vào quy tắc. Không tự đi theo host lạ chỉ vì nó xuất hiện trong 300.
Lưu theo URL gốc
Khóa lưu trữ nên là URL gốc trả 300, kèm thuộc tính của đại diện. Nếu lưu theo URL đại diện, lần chạy sau server đổi đường dẫn đại diện sẽ tạo bản ghi mới, và lịch sử bị cắt làm hai. URL gốc là thứ ổn định mà người dùng dẫn link tới.
Liên kết với log phía server
Trong lab, log phía server có 26 request sau khi chạy hết các ca. Mỗi quyết định chon hoặc theo-location tương ứng đúng một request tải đại diện. Với nguồn thật không có log phía server, bản ghi quyết định của crawler là bằng chứng duy nhất.
Đầu ra nghiệm thu của HTTP 300 Multiple Choices crawler
Phần này gom tiêu chí và giới hạn.
Danh sách kiểm tra
Crawler đạt khi mọi dòng dưới đây đúng.
- Tắt tự chuyển hướng ở bước đầu, đọc mã 300 riêng.
- Có quy tắc chọn viết sẵn, gồm type, ngôn ngữ, kích thước, cờ cho phép đi theo Location.
- Đọc được danh sách theo content type của 300, ghi nguồn danh sách.
- Mỗi ứng viên bị loại có lý do.
- Không có gì khớp thì dừng hoặc đi theo Location đúng theo cờ.
- Mỗi lần gặp 300 có một bản ghi quyết định và body 300 gốc.
- Không dùng chung kết quả giữa curl và script mà chưa so hành vi.
Những gì lab chưa chạy
Chưa thử website thật trả 300. Chưa đọc danh sách từ header Link, dù origin có gửi. Chưa thử 300 đi qua proxy có cache. Chưa thử HTTP/2. Hành vi của curl chỉ đúng với bản 8.13.0 trên Windows. Phần kiểm assert và đếm theo nguồn là ví dụ triển khai.
Đưa vào lịch chạy
Phép kiểm decisions.json nên chạy sau mỗi lượt crawl, như một bước trong pipeline. Lượt nào có bản ghi chọn sai type thì dừng bước nạp dữ liệu và báo người vận hành. Bước kiểm chỉ đọc tệp JSON, không gọi mạng, chạy trong chưa tới một giây với vài nghìn bản ghi.
Chạy lại với nguồn thật
Đổi base URL, giữ nguyên quy tắc, chạy bốn client như lab. So bảng hành vi với bảng trong bài. Chỗ nào khác, ghi lại phiên bản client và header thật của phản hồi.
Proxy ở đâu trong luồng
Proxy nằm ở tầng tải, giữa crawler và website. Quy tắc chọn đại diện chạy sau khi có phản hồi, không phụ thuộc IP. Khi tài liệu chỉ mở cho người dùng tại Việt Nam, anh em có thể mua proxy tại trang chủ ProxyVN để tải đúng nội dung trong nước. Proxy không chọn đại diện thay crawler. Vai trò của proxy có ở bài Web Scraping proxy là gì, cách ghi chuỗi cấu hình ở bài định dạng proxy.
HTTP 300 Multiple Choices crawler: câu hỏi thường gặp
Các câu dưới đây gom những điểm hay bị hỏi.
requests có tự đi theo 300 không?
Không, trong lab với requests 2.34.2. Dù có Location, requests trả 300 và dừng.
curl -L có đi theo 300 không?
Có khi có Location, theo lab với curl 8.13.0. Không có Location thì curl dừng ở 300.
300 có phải lỗi không?
Không. Đây là phản hồi hợp lệ, server mời client chọn. Coi nó là lỗi sẽ làm mất tài nguyên.
Nên tin Location hay quy tắc của mình?
Quy tắc của mình, nếu có đại diện khớp. Location chỉ là lựa chọn ưu tiên của server, RFC dùng từ có thể.
Danh sách đại diện có định dạng chuẩn không?
Không. RFC không định nghĩa. Mỗi server một kiểu, nên phải viết bộ đọc theo nguồn.
Có nên tải hết đại diện rồi chọn?
Không nên. Tốn băng thông và dễ chạm giới hạn tần suất. Chọn trước bằng metadata trong danh sách.
Proxy có thể đổi 300 thành mã khác không?
Proxy chuyển tiếp thông thường không đổi mã. Proxy có cache có thể trả lại 300 cũ. Lab chưa thử ca này.
Bài có chạy trên website thật không?
Không. Origin là máy chủ tự viết. Client là thật, nên bảng hành vi đúng với các phiên bản đã ghi.
HTTP 300 Multiple Choices crawler và những điều cần nhớ
HTTP 300 Multiple Choices crawler cần tắt tự chuyển hướng, đọc danh sách đại diện, áp quy tắc viết sẵn và ghi bản quyết định cho từng lần gặp 300. Đừng để curl và script lấy hai bản khác nhau mà không ai biết. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em giữ log quyết định của HTTP 300 Multiple Choices crawler.


