
Great Expectations cho dữ liệu crawl: suite và báo cáo theo lô
Great Expectations cho dữ liệu crawl là cách đặt các điều kiện chất lượng lên mỗi lô dữ liệu vừa cào về, rồi để công cụ chấm lô đó đạt hay không. Thay vì mở tệp CSV xem lướt, ta có một bộ expectation viết sẵn và một báo cáo nói rõ lô nào thiếu giá, giá nào vô lý, URL nào trùng. ProxyVN chạy thử với Great Expectations 1.24.1 ngày 03/11/2026 trên hai lô 200 dòng: một lô sạch và một lô cài sẵn lỗi. Bài ghi rõ con số thật và những chỗ dễ đọc sai trong báo cáo.
Great Expectations cho dữ liệu crawl: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và ranh giới với các công cụ kiểm dữ liệu khác.
Bài toán
Một crawler giá chạy mỗi sáng, ghi ra một tệp CSV vài nghìn dòng. Phần lớn ngày, tệp ổn. Có ngày website đổi giao diện, cột giá trống một nửa. Có ngày parser lấy nhầm giá trả góp, ra những con số nhỏ bất thường. Nếu không ai kiểm, dữ liệu lỗi đi thẳng vào báo cáo hay model.
Bài toán là chặn lô lỗi ở cửa, trước khi nó được dùng. Chặn bằng quy tắc viết sẵn, chạy tự động, có báo cáo đọc được.
Đầu ra nghiệm thu
Đầu ra gồm một expectation suite có điều kiện về tỷ lệ thiếu, phạm vi giá, đơn vị tiền, URL trùng và định dạng URL. Kèm theo là báo cáo chạy suite trên một lô cố ý sai, chỉ ra từng lỗi cùng dòng gây lỗi.
Ranh giới với Pandera và Pydantic
Pandera kiểm schema của DataFrame ngay trong mã Python, phù hợp khi muốn hàm từ chối dữ liệu sai kiểu. Pydantic kiểm từng bản ghi khi tạo đối tượng. Great Expectations làm việc ở mức lô: một suite chạy trên cả tệp, ra một kết quả có thống kê, lưu lại thành lịch sử.
Ba công cụ có thể cùng tồn tại. Pydantic chuẩn hóa từng bản ghi khi parse, Great Expectations chấm cả lô trước khi nạp kho. Bài chỉ bàn phần thứ hai.
Không phải bài về crawler
Bài không hướng dẫn viết crawler, không bàn cách tải trang. Hai lô trong lab được sinh bằng mã, có lỗi đặt đúng chỗ để kiểm từng expectation. Dữ liệu thật sẽ lộn xộn hơn, nhưng loại lỗi thì tương tự.
Phiên bản đã khóa
Lab dùng great_expectations 1.24.1, pandas 3.1.0, Python 3.12 trên Windows. API của Great Expectations đã đổi lớn từ bản 0.18 lên 1.x. Nhiều hướng dẫn cũ trên mạng dùng tên hàm không còn tồn tại. Mọi đoạn mã trong bài chạy được trên bản 1.24.1.
Ai nên đọc
Người vận hành pipeline crawl muốn có cổng chất lượng trước khi dữ liệu vào kho. Người phân tích từng bị một lô dữ liệu lỗi làm sai báo cáo và muốn phát hiện sớm. Người đã dùng Great Expectations bản cũ và cần cách viết mới cho bản 1.x.
Tạo expectation suite và báo cáo chất lượng theo lô crawl với Great Expectations cho dữ liệu crawl
Trước khi viết mã, cần nắm bốn khái niệm của Great Expectations bản 1.x.
Data Context
Data Context là gốc của mọi thứ: nơi lưu cấu hình nguồn dữ liệu, suite, định nghĩa validation và báo cáo. Lab dùng context dạng tệp, tạo một thư mục gx trong thư mục dự án. Lần chạy sau, context đọc lại thư mục này, nên suite và nguồn dữ liệu không phải khai báo lại.
Data Source, Data Asset và Batch Definition
Data Source mô tả nơi chứa dữ liệu, ở đây là một thư mục chứa tệp CSV. Data Asset là một loại dữ liệu trong nguồn đó, ở đây là các lô crawl. Batch Definition chỉ ra lô cụ thể nào sẽ được kiểm, ở đây là một đường dẫn tệp.
Cách chia này hợp với dữ liệu crawl: mỗi ngày một tệp, cùng cấu trúc. Asset giữ nguyên, Batch Definition trỏ tới tệp của ngày cần kiểm.
Expectation và Expectation Suite
Expectation là một điều kiện có thể kiểm, ví dụ cột giá không được rỗng. Suite là tập expectation dùng chung cho một loại dữ liệu. Theo trang Organize Expectations into Expectation Suites trong tài liệu chính thức, nên gom expectation vào suite theo mục đích kiểm tra để dễ quản lý và chạy lại.
Validation Definition
Validation Definition ghép một Batch Definition với một suite. Chạy nó ra một kết quả gồm trạng thái đạt hay không, thống kê và chi tiết từng expectation. Đây là đơn vị nhỏ nhất để tự động hóa.
Expectation đọc như câu tiếng Anh
Tên expectation được viết thành câu: ExpectColumnValuesToNotBeNull đọc là mong giá trị cột không rỗng. Cách đặt tên này giúp người không viết mã vẫn đọc được suite. Khi trao đổi với người dùng dữ liệu, có thể đưa họ danh sách tên expectation cùng tham số để họ duyệt ngưỡng.
Vì sao dùng mostly
Nhiều expectation nhận tham số mostly, là tỷ lệ tối thiểu số dòng phải đạt. Dữ liệu crawl hiếm khi sạch trăm phần trăm. Vài sản phẩm hết hàng không có giá là bình thường. mostly bằng 0,95 nghĩa là cho phép tới 5 phần trăm dòng vi phạm mà expectation vẫn đạt.
Chọn mostly là quyết định nghiệp vụ, không phải kỹ thuật. Cần hỏi người dùng dữ liệu xem bao nhiêu dòng thiếu giá thì lô hết dùng được.
Expectation không phải test đơn vị
Test đơn vị kiểm mã chạy đúng trên dữ liệu bạn tự chọn. Expectation kiểm dữ liệu thật mà mã đã tạo ra. Parser có thể qua mọi test đơn vị mà vẫn sinh lô lỗi khi website đổi giao diện. Hai loại kiểm bổ sung cho nhau, không thay thế nhau.
Lô tốt và lô cố ý sai
Lab sinh hai lô 200 dòng cùng cấu trúc: url, name, price, currency, fetched_at, status. Lô tốt không vi phạm quy tắc nào. Lô lỗi có 29 dòng thiếu giá, một giá bằng 0, một giá 12.900 tỷ, một dòng đơn vị USD, một cặp URL trùng và một URL tương đối.
Mỗi lỗi đặt ra để một expectation cụ thể phải bắt được. Nếu báo cáo không chỉ ra lỗi nào đó, nghĩa là suite có lỗ hổng.
Tạo Data Context và batch dữ liệu crawl mẫu cho Great Expectations cho dữ liệu crawl
Phần này dựng context, nguồn dữ liệu và hai định nghĩa lô.
Tạo context dạng tệp
import great_expectations as gx
ctx = gx.get_context(mode="file", project_root_dir=".")
Lệnh này trả về FileDataContext. Lần đầu nó tạo thư mục gx. Ai mở dự án sau đó chạy lại lệnh này và thấy đủ cấu hình cũ.
Khai báo nguồn và asset
ds = ctx.data_sources.add_pandas_filesystem("crawl", base_directory=".")
asset = ds.add_csv_asset("lo_crawl")
bd_tot = asset.add_batch_definition_path("lo_tot", "lo_tot.csv")
bd_loi = asset.add_batch_definition_path("lo_loi", "lo_loi.csv")
Nguồn tên crawl đọc tệp trong thư mục hiện tại bằng pandas. Asset lo_crawl gom các lô. Mỗi Batch Definition trỏ tới một tệp.
Định nghĩa lô cho tệp chưa có
Lab thử tạo Batch Definition cho tệp lo_khong_co.csv chưa tồn tại. Great Expectations báo PathNotFoundError ngay lúc định nghĩa. Nghĩa là không thể khai báo trước lô của ngày mai rồi chờ tệp xuất hiện.
Với pipeline chạy hằng ngày, nên tạo Batch Definition ngay sau khi crawler ghi xong tệp, hoặc dùng cách định nghĩa theo mẫu tên tệp có ngày tháng. Lab chưa thử cách thứ hai.
Context tạm cho thử nghiệm
Ngoài dạng tệp, Great Expectations có context tạm chỉ sống trong bộ nhớ. Nó tiện để thử nhanh một expectation mới mà không làm bẩn thư mục gx. Khi đã chốt suite, chuyển sang context dạng tệp để lưu lại. Lab dùng dạng tệp ngay từ đầu vì cần kết quả còn lại sau khi chạy.
Đặt tên lô có ngày
Trong lab, tên lô là lo_tot và lo_loi cho dễ đọc. Ngoài thực tế, tên nên chứa ngày crawl và nguồn, ví dụ shop_a_2026_11_03. Báo cáo lưu theo tên này. Ba tháng sau, nhìn tên là biết lô nào lỗi.
Lưu tệp gốc cạnh báo cáo
Great Expectations không chép dữ liệu vào thư mục của nó. Báo cáo chỉ giữ thống kê và mẫu dòng lỗi. Muốn xem lại cả lô, cần giữ tệp CSV gốc ở chỗ lưu trữ riêng. Lab giữ hai tệp cạnh thư mục gx.
Không đọc lại dữ liệu từ web
Kiểm chất lượng chạy trên tệp đã tải, không tải lại trang. Tải lại sẽ ra dữ liệu khác, và báo cáo không còn nói về lô đã dùng. Bước tải là bước riêng, ghi tệp có ngày, rồi mới tới bước kiểm.
Tổ chức Expectations vào suite theo mục tiêu chất lượng của Great Expectations cho dữ liệu crawl
Phần này viết suite sáu expectation, chia theo năm nhóm mục tiêu.
Sáu expectation
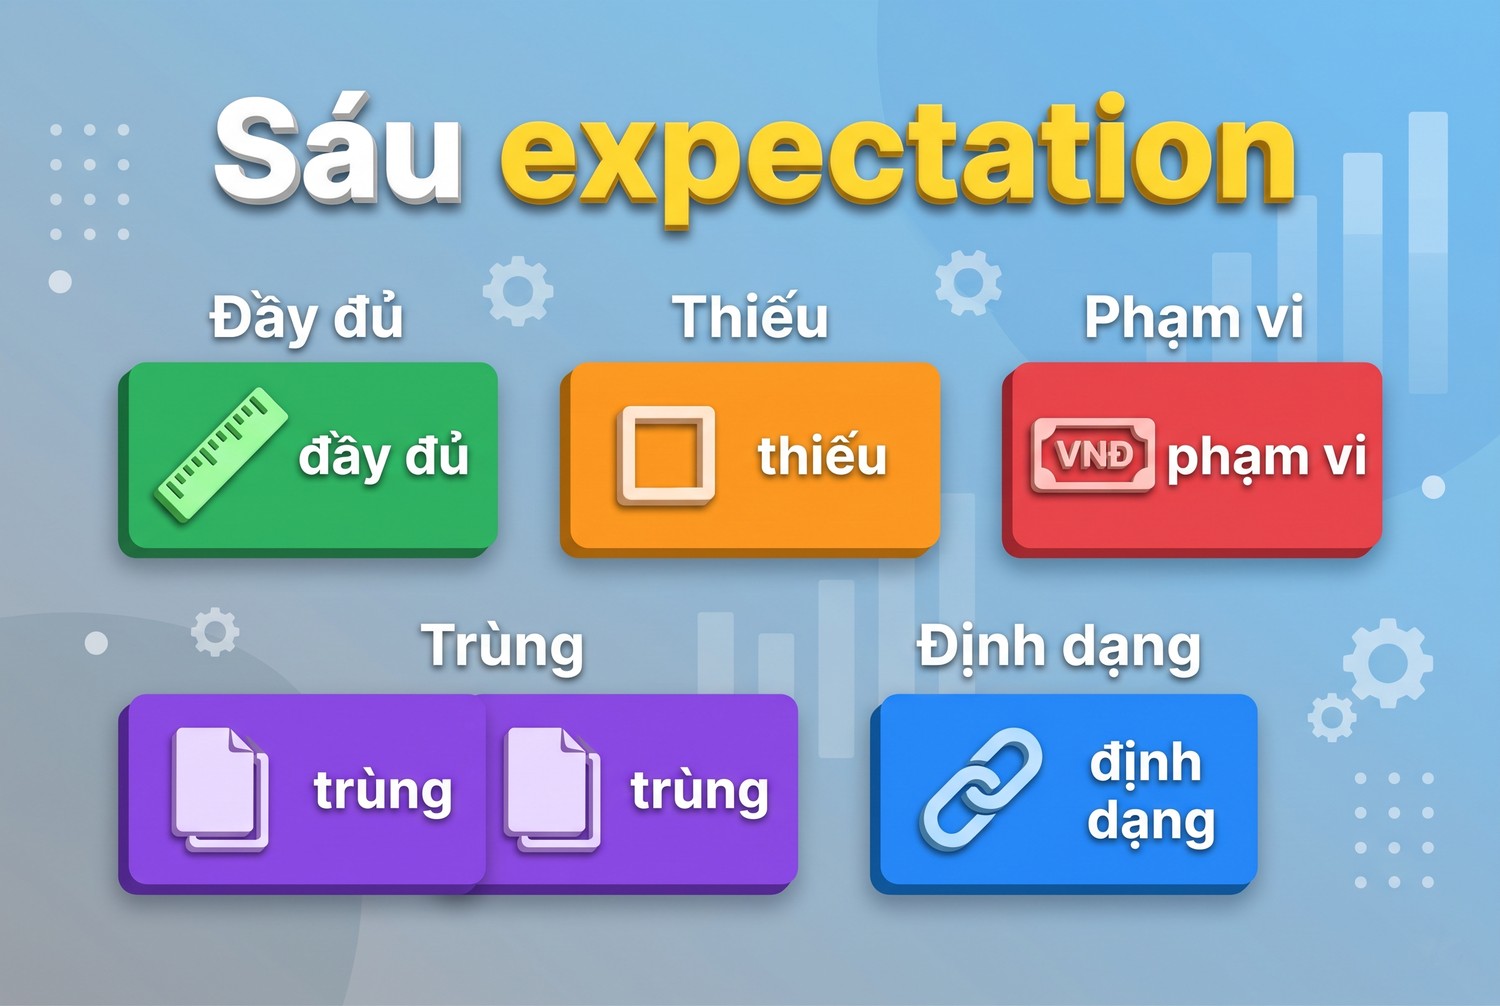
Sáu expectation
import great_expectations.expectations as gxe
suite = ctx.suites.add(gx.ExpectationSuite(name="crawl_quality"))
for e in [
    gxe.ExpectTableRowCountToBeBetween(min_value=150, max_value=10000, meta={"nhom": "day_du"}),
    gxe.ExpectColumnValuesToNotBeNull(column="price", mostly=0.95, meta={"nhom": "thieu"}),
    gxe.ExpectColumnValuesToBeBetween(column="price", min_value=1000, max_value=1_000_000_000, meta={"nhom": "pham_vi"}),
    gxe.ExpectColumnValuesToBeInSet(column="currency", value_set=["VND"], meta={"nhom": "pham_vi"}),
    gxe.ExpectColumnValuesToBeUnique(column="url", meta={"nhom": "trung"}),
    gxe.ExpectColumnValuesToMatchRegex(column="url", regex=r"^https://", meta={"nhom": "dinh_dang"}),
]:
    suite.add_expectation(e)
suite.save()
Nhóm đầy đủ
Số dòng phải nằm từ 150 tới 10.000. Ngưỡng dưới bắt trường hợp crawler dừng giữa chừng hay bị chặn, ra tệp chỉ vài chục dòng. Ngưỡng trên bắt trường hợp crawler lặp vô hạn trên phân trang. Cả hai đều là lỗi hay gặp với dữ liệu web.
Nhóm thiếu
Cột giá được phép rỗng tối đa 5 phần trăm. Đây là chỗ dùng mostly. Không đặt mostly thì một sản phẩm hết hàng cũng làm cả lô trượt, và người vận hành sẽ sớm bỏ qua cảnh báo.
Nhóm phạm vi
Giá phải từ 1.000 tới 1 tỷ đồng, đơn vị phải là VND. Ngưỡng dưới bắt giá 0 và giá bị cắt mất số không. Ngưỡng trên bắt giá dính chuỗi số khác, ví dụ mã sản phẩm bị ghép vào giá. Phạm vi nên lấy từ dữ liệu thật của vài tuần, không đoán.
Nhóm trùng và định dạng
URL phải duy nhất và phải bắt đầu bằng https. URL trùng thường do crawler theo cả trang danh mục lẫn trang tìm kiếm tới cùng sản phẩm. URL tương đối là dấu hiệu parser quên ghép với tên miền.
Dùng meta để gom nhóm
Mỗi expectation có trường meta tự do. Lab ghi tên nhóm vào đó. Khi đọc báo cáo, có thể gom lỗi theo nhóm để biết lô hỏng vì thiếu, vì sai phạm vi hay vì trùng. Great Expectations không dùng meta để chấm, chỉ lưu lại.
Kiểm cột thời gian tải
Lab chưa đặt expectation cho cột fetched_at. Ngoài thực tế, nên kiểm cột này không rỗng và nằm trong khoảng thời gian chạy crawler. Lô có thời gian tải từ tuần trước thường là lô cũ bị chép nhầm vào thư mục ngày mới. Lỗi này không làm hỏng cột giá, nên các expectation khác không bắt được.
Kiểm mã trạng thái
Cột status ghi mã HTTP khi tải trang. Có thể đặt expectation cột này chỉ chứa 200 với mostly bằng 0,98. Tỷ lệ 403 hay 429 tăng là dấu hiệu crawler bị chặn hoặc chạy quá nhanh. Bắt ở đây sớm hơn đợi cột giá trống.
Một suite cho nhiều nguồn
Nếu crawl nhiều website có cùng cấu trúc đầu ra, có thể dùng chung một suite. Nhưng ngưỡng phạm vi giá và số dòng thường khác nhau giữa các nguồn. Khi đó nên có suite chung cho định dạng và suite riêng cho phạm vi từng nguồn.
Chạy validation với batch cố ý thiếu hoặc sai phạm vi của Great Expectations cho dữ liệu crawl
Phần này chạy suite trên hai lô và đọc kết quả.
Lệnh chạy
vd = ctx.validation_definitions.add_or_update(
    gx.ValidationDefinition(name="v_lo_loi", data=bd_loi, suite=suite))
r = vd.run(result_format={"result_format": "COMPLETE",
                          "unexpected_index_column_names": ["url"]})
result_format COMPLETE yêu cầu trả về đầy đủ danh sách dòng lỗi. unexpected_index_column_names chỉ định cột dùng để nhận diện dòng, ở đây là url. Không có tham số này, báo cáo chỉ cho chỉ số dòng trong DataFrame, khó đối chiếu.
Lô tốt
Lô tốt đạt 6 trên 6 expectation, success_percent bằng 100. Mọi giá trị unexpected đều bằng 0. Đây là bước không được bỏ qua: nếu lô sạch cũng trượt, suite viết sai.
Lô lỗi: tổng quan
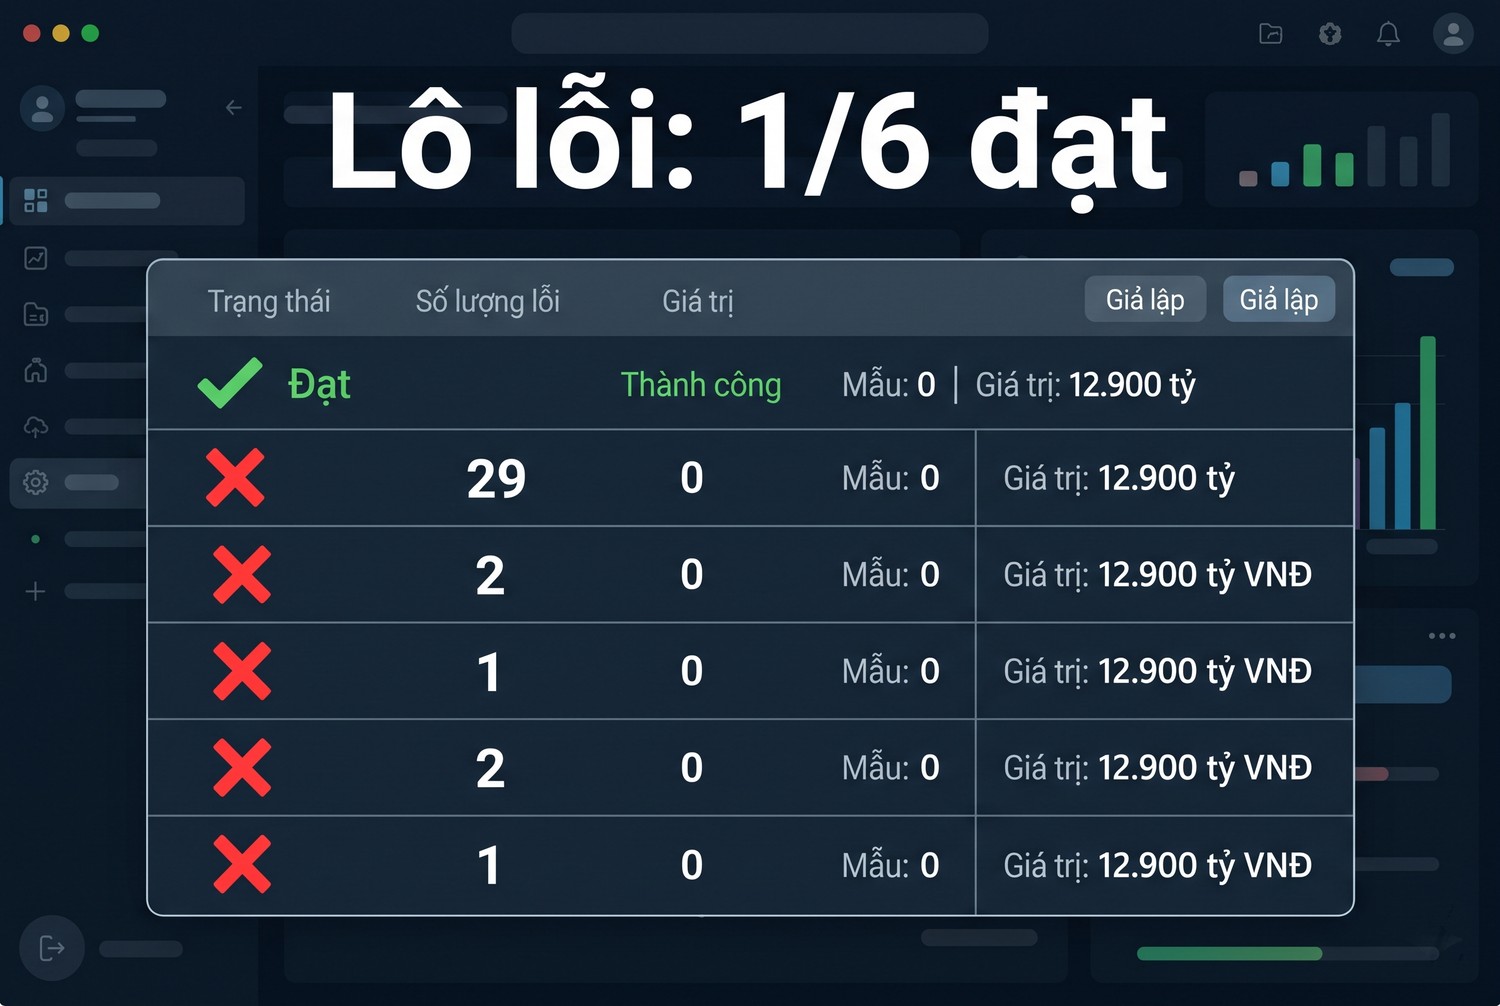
Lô lỗi: 1/6 đạt
Lô lỗi đạt 1 trên 6, success_percent khoảng 16,7. Chỉ expectation số dòng đạt, vì lô vẫn có 200 dòng. Năm expectation còn lại đều trượt, đúng như dự kiến.
Expectation |
Cột |
Kết quả |
Số dòng lỗi |
Phần trăm |
Mẫu |
|---|---|---|---|---|---|
row_count 150 tới 10.000 |
bảng |
đạt |
không áp dụng |
không áp dụng |
không |
not_be_null mostly 0,95 |
price |
trượt |
29 |
14,5 |
NaN |
be_between 1.000 tới 1 tỷ |
price |
trượt |
2 |
1,17 |
0; 12.900 tỷ |
be_in_set VND |
currency |
trượt |
1 |
0,5 |
USD |
be_unique |
url |
trượt |
2 |
1,0 |
/p/21 hai lần |
match_regex https |
url |
trượt |
1 |
0,5 |
/p/30 |
Thiếu giá 14,5 phần trăm
29 trên 200 dòng thiếu giá, vượt ngưỡng 5 phần trăm. Báo cáo ghi unexpected_count 29 và unexpected_percent 14,5. Mẫu lỗi là các giá trị NaN, không giúp gì nhiều. Muốn biết sản phẩm nào thiếu, phải đọc danh sách chỉ số kèm cột url.
Phần trăm phạm vi tính trên dòng có giá
Expectation phạm vi báo 2 dòng lỗi và 1,17 phần trăm, không phải 1 phần trăm. Lý do là phép chia dùng 171 dòng có giá, không dùng 200 dòng. Dòng rỗng được bỏ ra trước khi kiểm phạm vi.
Chi tiết này dễ làm người đọc nhầm. Nếu so phần trăm giữa hai expectation, nhớ rằng mẫu số có thể khác nhau.
Dòng gây lỗi kèm URL
Với expectation phạm vi, danh sách chỉ số trả về hai phần tử: giá 0 ở URL /p/3 và giá 12.900 tỷ ở URL /p/5. Người sửa parser mở đúng hai trang này là thấy vấn đề. Đây là giá trị lớn nhất của result_format COMPLETE.
URL trùng đếm cả hai dòng
Expectation duy nhất báo 2 dòng lỗi cho một cặp trùng. Mỗi dòng trong cặp đều bị tính. Nếu có ba dòng cùng URL, con số sẽ là 3. Muốn đếm số URL bị trùng thay vì số dòng, phải tự gom lại sau.
Mẫu lỗi bị giới hạn
Trường partial_unexpected_list chỉ chứa vài mẫu đầu, đủ để nhìn qua. Danh sách đầy đủ nằm ở unexpected_index_list khi dùng result_format COMPLETE. Với lô lớn có hàng nghìn dòng lỗi, danh sách này nặng. Nên dùng COMPLETE khi điều tra, và dùng mức tóm tắt cho lần chạy tự động hằng ngày.
Một lỗi, một expectation
Lab đặt mỗi lỗi để chỉ một expectation bắt được. Ngoài thực tế, một lỗi parser có thể làm trượt nhiều expectation cùng lúc. Ví dụ parser trả về chuỗi rỗng cho cả giá lẫn đơn vị tiền. Khi thấy nhiều expectation trượt cùng lúc, hãy tìm nguyên nhân chung trước khi sửa từng chỗ.
Đọc validation result và tách lỗi dữ liệu khỏi lỗi kết nối nguồn trong Great Expectations cho dữ liệu crawl
Phần này phân biệt hai loại thất bại: dữ liệu sai và không đọc được dữ liệu.
Trường exception_info
Mỗi kết quả expectation có trường exception_info. Ở cả hai lô, giá trị raised_exception đều là False. Nghĩa là expectation chạy được, chỉ có dữ liệu không đạt. Khi expectation không chạy được, ví dụ do tên cột sai, trường này mang thông tin lỗi.
Tệp bị xóa sau khi định nghĩa lô
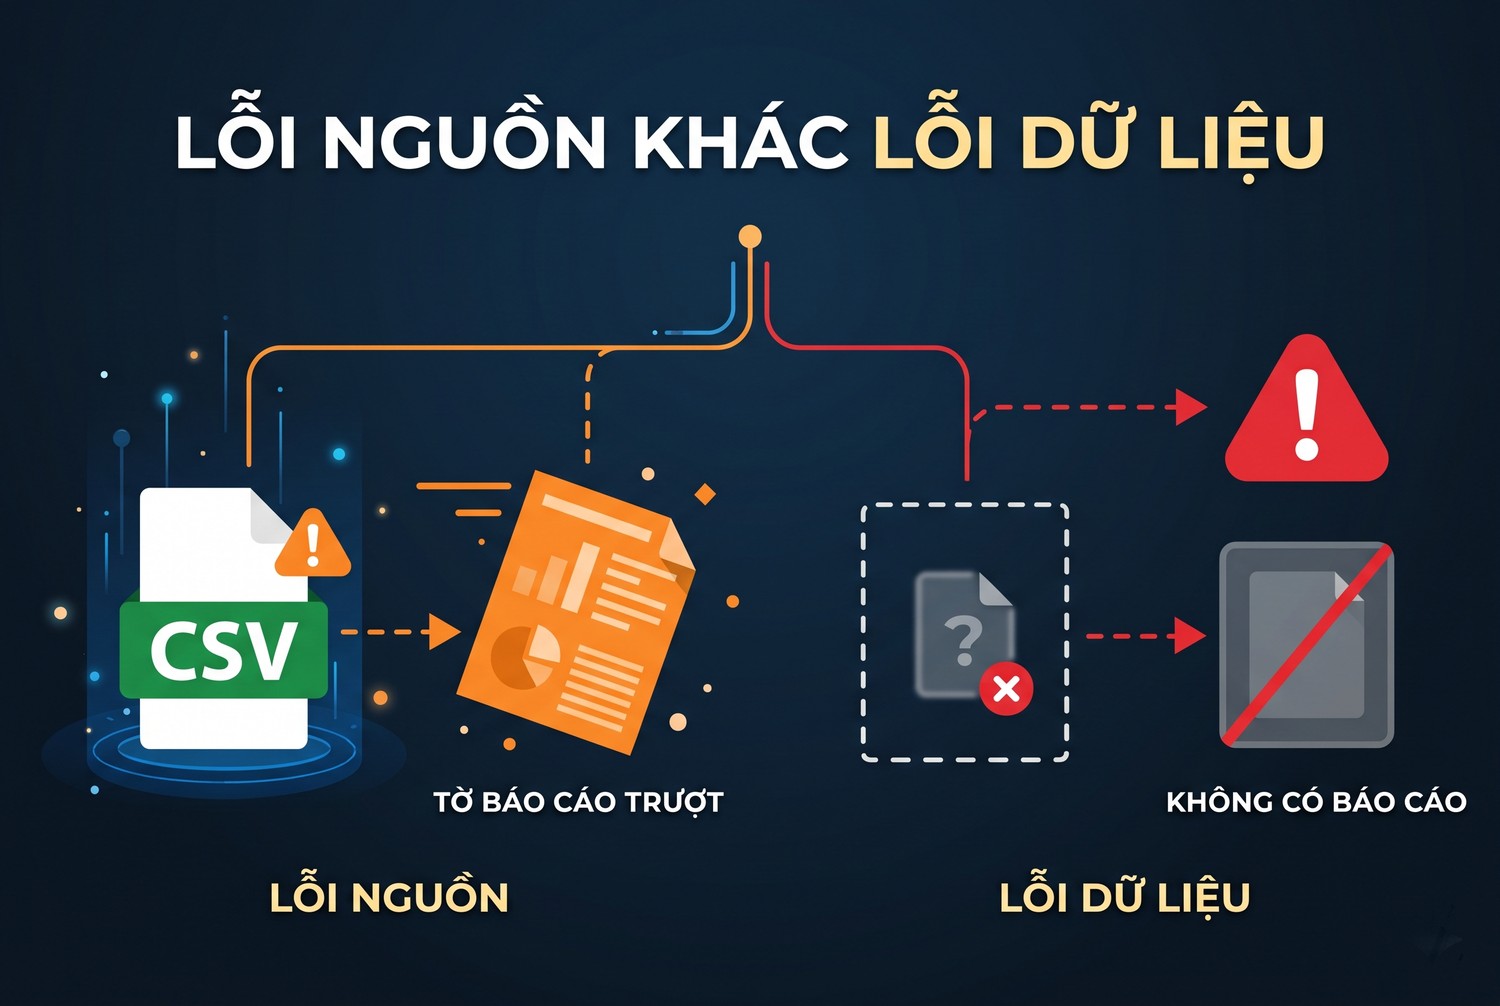
Lỗi nguồn khác lỗi dữ liệu
Lab tạo tệp lo_mat.csv, định nghĩa lô cho nó, rồi xóa tệp trước khi chạy validation. Lần chạy không ra kết quả trượt. Nó ném ngoại lệ NoAvailableBatchesError với nội dung No available batches found.
Đây là khác biệt quan trọng. Lô dữ liệu sai cho ra kết quả success bằng False, có báo cáo. Nguồn không đọc được làm cả lệnh chạy lỗi, không có báo cáo nào.
Xử lý hai loại thất bại khác nhau
Mã gọi validation nên bắt riêng ngoại lệ. Ngoại lệ nghĩa là bước trước hỏng: crawler không ghi tệp, tệp sai chỗ, quyền đọc sai. Kết quả trượt nghĩa là crawler có chạy nhưng dữ liệu kém. Hai loại cần gửi cho hai người khác nhau.
try:
    r = vd.run()
except Exception as e:
    bao_loi_nguon(type(e).__name__)
else:
    if not r.success:
        bao_loi_du_lieu(r.statistics)
Cột không tồn tại
Khi website đổi giao diện, parser có thể không còn ghi cột currency. Expectation trỏ tới cột không có sẽ không chạy được, và trường exception_info ghi lỗi thay vì kết quả trượt thông thường. Lab chưa cài lỗi này. Nên thêm expectation kiểm danh sách cột của bảng để bắt sớm, trước khi các expectation theo cột báo lỗi khó đọc.
Lỗi kết nối với nguồn qua mạng
Lab đọc tệp trên đĩa. Nếu nguồn là kho dữ liệu hay bucket trên mạng, lỗi mạng cũng rơi vào nhóm ngoại lệ chứ không phải kết quả trượt. Lab chưa thử nguồn qua mạng nên chưa biết tên ngoại lệ cụ thể. Nguyên tắc vẫn vậy: ngoại lệ là hạ tầng, trượt là dữ liệu.
Đọc thống kê
Trường statistics cho số expectation đã chạy, số đạt, số trượt và phần trăm. Đây là con số nên ghi vào hệ thống theo dõi mỗi ngày. Phần trăm đạt rơi đột ngột là dấu hiệu website nguồn đã đổi.
Ngưỡng cảnh báo và ngưỡng chặn
Không phải expectation nào trượt cũng cần chặn cả lô. URL trùng vài dòng có thể chỉ cần khử trùng rồi dùng tiếp. Thiếu giá 14,5 phần trăm thì nên chặn. Có thể chia suite thành hai: suite chặn chứa điều kiện bắt buộc, suite cảnh báo chứa điều kiện nên có. Lô trượt suite cảnh báo vẫn được nạp, kèm thông báo.
Báo cáo dạng web
Lệnh build_data_docs dựng một trang HTML tĩnh trong thư mục gx/uncommitted/data_docs. Trang liệt kê các lần chạy, mở từng lần thấy bảng expectation và mẫu lỗi. Trang này hợp để gửi cho người không đọc mã. Nó nằm trong thư mục uncommitted, nghĩa là không nên đưa vào kho mã.
Lịch sử theo ngày
Mỗi lần chạy Validation Definition, kết quả được lưu trong thư mục gx với dấu thời gian. Sau vài tuần, lịch sử này cho thấy nguồn nào hay lỗi, lỗi loại gì, vào ngày nào trong tuần. Thông tin đó giúp quyết định nên sửa parser nào trước và nên chạy crawler vào giờ nào.
Lưu kết quả dạng JSON
Lab ghi kết quả của mỗi lô ra tệp JSON bằng describe_dict. Tệp này dễ đọc bằng máy hơn trang HTML. Có thể nạp vào kho dữ liệu để thống kê tỷ lệ lỗi theo ngày, theo nguồn.
Không tin báo cáo cũ khi suite đã đổi
Nếu sửa ngưỡng trong suite, kết quả của các lần chạy trước không còn so được với lần chạy mới. Nên ghi phiên bản suite hoặc ngày sửa vào meta, và khi so lịch sử thì chỉ so các lần chạy cùng phiên bản.
Đầu ra nghiệm thu: suite với tỷ lệ thiếu phạm vi giá và báo cáo một batch cố ý sai của Great Expectations cho dữ liệu crawl
Phần cuối gom kết quả thành bộ bàn giao và quy trình hằng ngày.
Bộ bàn giao
Bộ bàn giao gồm thư mục gx chứa suite crawl_quality, hai tệp lô, hai tệp kết quả JSON, trang Data Docs và tệp lab.py. Người nhận chạy lại lab.py, phải thấy lô tốt đạt 6 trên 6 và lô lỗi đạt 1 trên 6 với đúng các con số trong bảng.
Tiêu chí đạt
Suite bắt được mọi lỗi đã cài trong lô lỗi. Lô tốt không bị báo sai. Mỗi dòng lỗi có URL để đối chiếu. Lỗi nguồn được tách khỏi lỗi dữ liệu.
Quy trình đề xuất mỗi ngày
Bước một, crawler ghi tệp có ngày vào chỗ lưu trữ. Bước hai, tạo Batch Definition cho tệp đó. Bước ba, chạy Validation Definition, bắt ngoại lệ riêng. Bước bốn, đạt thì nạp kho, trượt thì giữ lại và gửi báo cáo, ngoại lệ thì báo người vận hành crawler.
Khi nào cần proxy với Great Expectations cho dữ liệu crawl
Great Expectations chạy trên tệp đã có, không cần mạng và không cần proxy. Proxy chỉ liên quan tới bước crawl trước đó. Có những lỗi mà suite bắt được thật ra bắt nguồn từ bước tải: số dòng thấp bất thường vì bị chặn, giá rỗng vì nhận trang thử thách thay vì trang sản phẩm.
Với website được phép thu thập nhưng hiển thị giá theo vùng, có lúc cần IP tại Việt Nam để nhận đúng trang. Khi đó anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Proxy không sửa parser và không làm lô dữ liệu tốt hơn. Vai trò hợp lệ của proxy được phân tích ở bài Web Scraping proxy là gì.
Proxy làm đổi số dòng
Đổi proxy giữa hai ngày có thể làm số dòng thay đổi, vì một số trang chỉ hiện cho vùng nhất định. Expectation số dòng sẽ bắt được thay đổi lớn. Khi thấy số dòng nhảy mà không có lỗi parser nào, hãy kiểm cấu hình mạng của crawler trước khi kết luận website đã gỡ sản phẩm.
Thêm cột vùng tải
Nếu giá phụ thuộc vùng IP, lô nên có cột vùng tải. Có thể thêm expectation kiểm cột này chỉ có một giá trị. Lô trộn hai vùng thường do cấu hình proxy đổi giữa chừng, và giá trong lô sẽ không so được với nhau. Cách viết cấu hình proxy đúng có trong bài định dạng proxy.
Chuẩn hóa trước khi kiểm
Expectation phạm vi chỉ có nghĩa khi cột giá đã là số. Nếu giá còn là chuỗi có dấu chấm và chữ đồng, expectation sẽ báo lỗi kiểu thay vì lỗi phạm vi. Chuẩn hóa nên làm trước, ở bước parse. Cách dùng Pydantic cho việc này có trong bài Pydantic chuẩn hóa dữ liệu crawl.
Ai sửa khi lô trượt
Báo cáo chỉ có ích khi có người nhận. Lỗi thiếu giá và lỗi phạm vi thường do parser, gửi cho người viết crawler. Lỗi số dòng thấp có thể do bị chặn, gửi cho người vận hành hạ tầng. Ghi người phụ trách vào meta của từng expectation là cách đơn giản để báo cáo tự chỉ ra ai cần xem.
Những gì lab chưa thử
Lab chưa thử nguồn dữ liệu SQL hay bucket, chưa thử Checkpoint với hành động gửi thông báo, chưa thử định nghĩa lô theo mẫu tên tệp. Lab cũng chưa đo thời gian chạy với lô lớn. Hai lô 200 dòng chạy gần như tức thì, lô vài triệu dòng có thể khác.
Checklist Great Expectations cho dữ liệu crawl
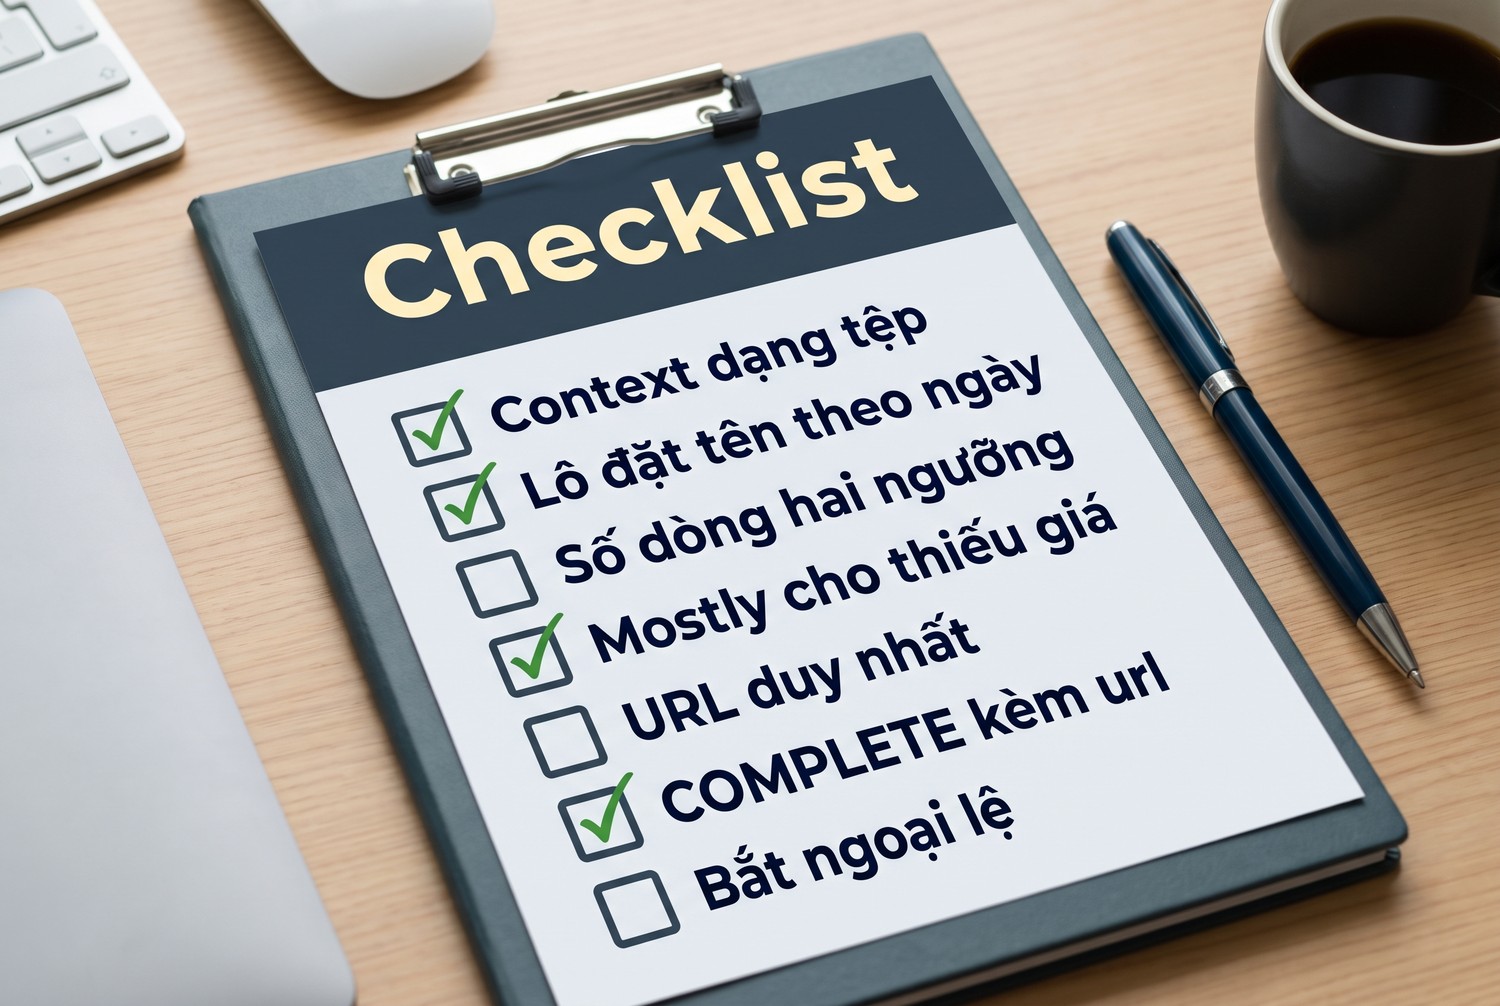
Checklist
- Context dạng tệp, đưa thư mục gx trừ uncommitted vào kho mã.
- Một asset cho mỗi loại lô crawl, lô đặt tên theo ngày và nguồn.
- Số dòng có cả ngưỡng dưới và ngưỡng trên.
- Thiếu giá dùng mostly theo yêu cầu nghiệp vụ.
- Phạm vi giá lấy từ dữ liệu thật vài tuần.
- URL duy nhất và có đủ tên miền.
- result_format COMPLETE kèm cột url.
- Bắt ngoại lệ riêng để tách lỗi nguồn khỏi lỗi dữ liệu.
Câu hỏi thường gặp về Great Expectations cho dữ liệu crawl
Great Expectations khác Pandera thế nào?
Pandera kiểm schema DataFrame trong mã. Great Expectations chấm cả lô theo suite và lưu báo cáo theo thời gian.
mostly nghĩa là gì?
Là tỷ lệ tối thiểu số dòng phải đạt. mostly bằng 0,95 cho phép 5 phần trăm dòng vi phạm.
Vì sao phần trăm lỗi phạm vi là 1,17 chứ không phải 1?
Vì expectation phạm vi chỉ tính trên 171 dòng có giá, bỏ qua dòng rỗng.
Tệp lô không tồn tại thì sao?
Định nghĩa lô cho tệp chưa có báo PathNotFoundError. Tệp bị xóa trước khi chạy làm validation ném NoAvailableBatchesError.
Có xem được dòng nào lỗi không?
Có. Dùng result_format COMPLETE kèm unexpected_index_column_names để nhận danh sách dòng lỗi theo URL.
Kiểm chất lượng có cần proxy không?
Không. Chỉ bước crawl trước đó mới có thể cần.
Great Expectations cho dữ liệu crawl và những điều cần nhớ
Great Expectations cho dữ liệu crawl biến cảm giác dữ liệu hôm nay có vẻ ổn thành một báo cáo có số liệu. Lab trên bản 1.24.1 cho thấy suite sáu expectation bắt đủ năm loại lỗi cài sẵn, báo cáo chỉ đúng URL gây lỗi, còn tệp nguồn mất thì ra ngoại lệ chứ không ra kết quả trượt. Nhớ rằng phần trăm lỗi phạm vi tính trên dòng có giá, và URL trùng đếm theo dòng. Cần IP tĩnh cho bước crawl trước khi chạy Great Expectations cho dữ liệu crawl, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


