
DSPy đánh giá trích xuất dữ liệu: metric theo trường và nhãn
DSPy đánh giá trích xuất dữ liệu là việc dùng khung đánh giá của DSPy để chấm một chương trình trích thông tin từ HTML, như tên sản phẩm, giá, đơn vị tiền và tình trạng hàng. Thay vì đọc vài kết quả rồi cảm thấy ổn, ta có một tập trang đã gán nhãn, một hàm metric chấm từng trường, và một con số so được giữa hai phiên bản. ProxyVN dựng tập 12 trang HTML gán nhãn tay, viết metric theo trường và chấm hai phiên bản chương trình với dspy 3.4.1 ngày 03/11/2026. Bài nói rõ phần nào chạy thật, phần nào chưa có model để chạy.
DSPy đánh giá trích xuất dữ liệu: mục tiêu và phạm vi không lặp
Phần đầu chốt bài toán, đầu ra và giới hạn.
Bài toán
Một nhóm dùng model ngôn ngữ để trích thông tin sản phẩm từ trang HTML đã tải về. Mỗi lần sửa prompt, ai đó mở vài trang, xem kết quả và nói bản mới tốt hơn. Không ai biết bản mới tốt hơn ở trường nào, và có làm hỏng trường nào khác không.
Bài toán là thay cảm giác bằng phép đo. Phép đo cần ba thứ: dữ liệu có đáp án, cách chấm từng trường, và quy trình chấm hai phiên bản trên cùng dữ liệu. DSPy có sẵn khung cho cả ba.
Đầu ra nghiệm thu
Đầu ra gồm bộ dữ liệu gán nhãn nhỏ và bảng điểm theo trường trước và sau một thay đổi. Bảng điểm phải cho biết mỗi trường đúng bao nhiêu trên tổng số trang, kèm danh sách từng lỗi cụ thể: trang nào, trường nào, đáp án là gì, chương trình trả gì.
Tách tải mạng khỏi đánh giá
Đánh giá chạy trên HTML đã lưu sẵn, không tải lại trang mỗi lần chấm. Lý do đơn giản: trang web thay đổi. Nếu tải lại, điểm thay đổi có thể do trang đổi giá chứ không do prompt tốt lên. Fixture cố định là điều kiện để so sánh có ý nghĩa.
Việc tải trang là bước riêng, chạy một lần, lưu HTML kèm URL và thời điểm. Chỉ bước đó cần mạng.
Ranh giới với các bài gần
Bài không hướng dẫn dùng model ngôn ngữ trích HTML nói chung, không so sánh model, không tối ưu prompt tự động bằng optimizer của DSPy. Trọng tâm là metric và bộ nhãn. Phần trích dữ liệu có cấu trúc từ JSON-LD được bàn kỹ hơn ở bài trích JSON-LD Product bằng Python.
Giới hạn của phép thử
Lab không có khóa API của nhà cung cấp model nào. Một lần gọi thật tới OpenAI qua dspy.LM với khóa giả trả lỗi LMAuthError, đúng như dự kiến. Vì vậy hai phiên bản chương trình được chấm trong bài là chương trình quy tắc viết bằng biểu thức chính quy, đóng vai chương trình trích xuất. Khung đánh giá, metric và bảng điểm đều chạy thật. Điểm số không nói gì về chất lượng của một model cụ thể.
Đánh giá extraction từ HTML fixture bằng metric trường dữ liệu trong DSPy đánh giá trích xuất dữ liệu
Phần này giải thích các khái niệm DSPy dùng trong bài.
Example, Prediction và metric
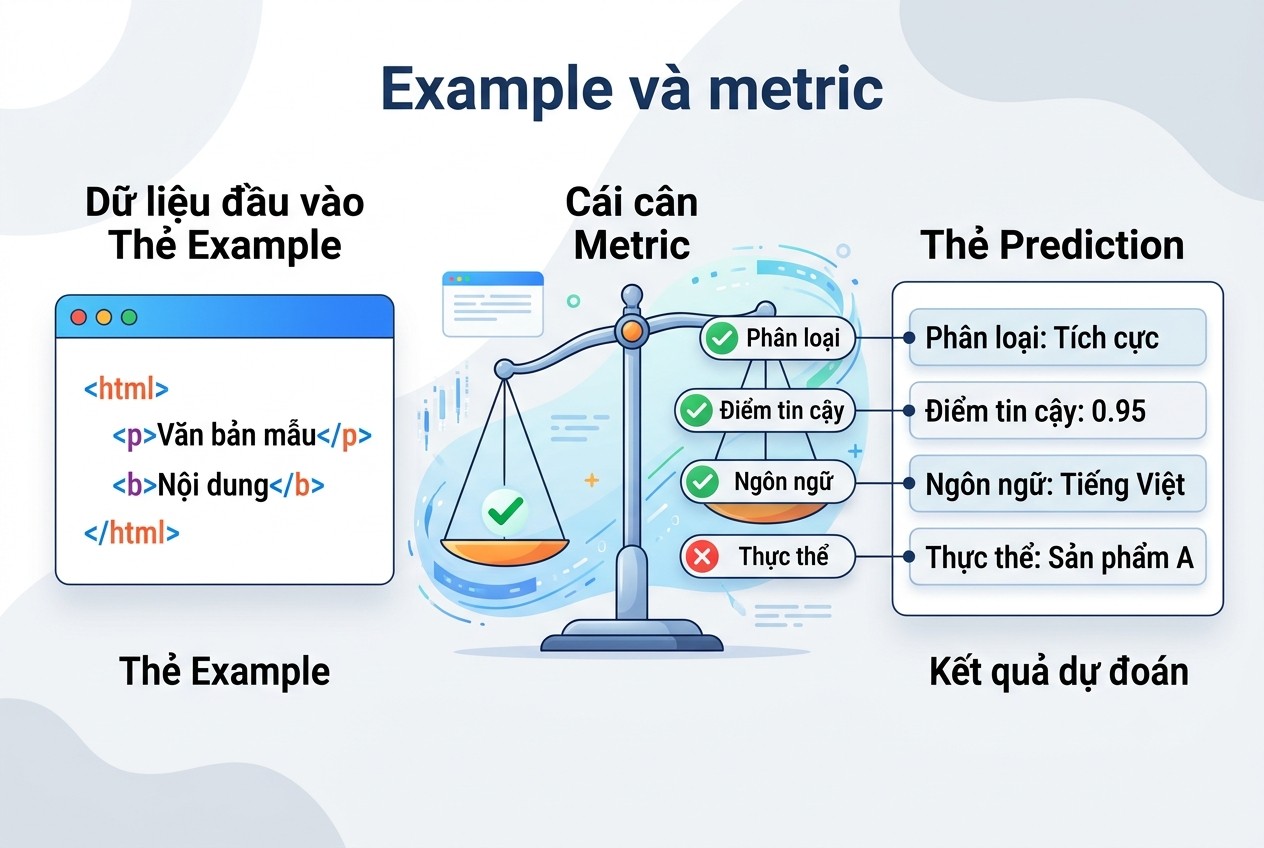
Example và metric
Theo trang Metrics trong tài liệu DSPy, metric là hàm nhận một ví dụ từ dữ liệu và đầu ra của chương trình, trả về một số đo chất lượng. Ví dụ là dspy.Example, chứa cả đầu vào lẫn đáp án. Đầu ra là dspy.Prediction, chứa các trường chương trình trả về. Metric so hai thứ này.
Tài liệu cũng mô tả tham số thứ ba là trace. Khi đánh giá, trace là None và metric thường trả về số thực. Khi tối ưu hay tự sinh ví dụ mẫu, trace có giá trị và metric nên trả về đúng hoặc sai.
Evaluate
dspy.Evaluate nhận devset là danh sách Example và metric. Gọi đối tượng Evaluate với một chương trình, nó chạy chương trình trên từng ví dụ, chấm bằng metric và trả về kết quả có thuộc tính score. Bản 3.4.1 còn có tham số num_threads, max_errors, failure_score, display_table, save_as_csv và save_as_json.
Chương trình là dspy.Module
Chương trình được chấm là một dspy.Module có phương thức forward. Với model thật, forward gọi dspy.Predict theo một signature. Trong lab, forward dùng biểu thức chính quy. Với Evaluate, hai loại này giống nhau: nhận html, trả Prediction có bốn trường.
Điểm này hữu ích ngoài phạm vi lab. Có thể đặt một chương trình quy tắc làm mốc so sánh. Nếu model đắt tiền không vượt được chương trình quy tắc trên tập nhãn, đó là thông tin đáng biết trước khi trả tiền.
Ai nên đọc
Người đang dùng model ngôn ngữ để trích dữ liệu từ trang web và muốn biết thay đổi prompt có thật sự giúp ích. Người phụ trách chất lượng dữ liệu cần một con số để chấp nhận hay từ chối một phiên bản mới. Người đã dùng DSPy cho hỏi đáp và muốn dùng lại khung đánh giá cho bài toán trích xuất có nhiều trường.
Signature mô tả hợp đồng đầu ra
Signature khai báo đầu vào html và bốn đầu ra: name kiểu chuỗi, price kiểu chuỗi hoặc None, currency kiểu chuỗi hoặc None, in_stock kiểu bool. Docstring của signature là chỉ dẫn cho model. Thay đổi prompt trong DSPy thường là thay docstring này, hoặc dùng with_instructions để tạo signature mới với chỉ dẫn khác.
Vì sao giá để kiểu chuỗi
Model trả về giá như nó thấy trên trang: 1.290.000đ, 2,150,000 ₫ hay $12.99. Ép model trả số nguyên dễ sinh lỗi làm tròn hoặc hiểu sai dấu chấm thập phân. Lab để price là chuỗi và chuẩn hóa trong metric. Cách này tách trách nhiệm: model đọc, metric quy đổi.
Tạo tập HTML fixture và nhãn chuẩn theo từng trường cho DSPy đánh giá trích xuất dữ liệu
Phần này mô tả 12 trang và cách gán nhãn.
Phiên bản lab
Thành phần |
Phiên bản |
|---|---|
Python |
3.12.10, venv riêng, Windows 10 |
dspy |
3.4.1 |
litellm |
1.106.6 |
Mười hai trang và cái bẫy của từng trang
Trang |
Đặc điểm |
Nhãn price |
|---|---|---|
p01 |
Giá dạng 1.290.000đ |
1290000 |
p02 |
Có giá gạch 450.000đ trước giá bán 390.000đ |
390000 |
p03 |
Giá ghi Liên hệ |
null |
p04 |
Giá 2,150,000 ₫, hết hàng |
2150000 |
p05 |
Giá đô la $12.99 |
12.99 |
p06 |
JSON-LD có giá, thân trang chỉ ghi 890k, h1 có đuôi quảng cáo |
890000 |
p07 |
Tên có khoảng trắng thừa, giá 65.000 VNĐ |
65000 |
p08 |
Dòng trả góp 450.000đ/tháng đứng trước giá thật |
5400000 |
p09 |
Ghi Tạm hết hàng |
1150000 |
p10 |
JSON-LD ghi OutOfStock, thân trang không ghi tình trạng |
259000 |
p11 |
Phí ship đứng sau giá |
890000 |
p12 |
Giá 199.000 đ có khoảng trắng, ghi Còn 2 sản phẩm |
199000 |
Nguyên tắc gán nhãn
Mỗi trang có bốn nhãn: name, price, currency, in_stock. Tên là tên sản phẩm, không gồm đuôi quảng cáo như Chính hãng. Giá là giá bán hiện tại người mua phải trả cho sản phẩm, không gồm giá gạch, giá trả góp hay phí ship. Trang ghi Liên hệ thì giá và đơn vị tiền là null. Tình trạng hàng là True nếu trang cho phép mua ngay.
Nguyên tắc phải viết ra trước khi gán nhãn, không phải sau khi thấy chương trình trả gì. Nhãn đặt theo kết quả chương trình sẽ khiến điểm cao một cách giả tạo.
Ai gán nhãn và gán bao lâu
Mười hai trang trong lab do một người gán tay theo nguyên tắc viết trước, chưa có người thứ hai đối chiếu. Với dữ liệu thật, nên có hai người gán độc lập một phần nhỏ, rồi so. Chỗ hai người gán khác nhau thường là chỗ nguyên tắc chưa rõ, ví dụ giá khuyến mãi chỉ áp dụng cho thành viên có tính là giá bán không.
Mỗi lần sửa nguyên tắc, rà lại các nhãn bị ảnh hưởng. Nhãn cũ theo nguyên tắc cũ là nguồn nhiễu khó phát hiện.
Nhãn lưu ở dạng chuẩn
Nhãn lưu giá dưới dạng số, đơn vị tiền theo mã ISO như VND hay USD, tình trạng dạng bool. Dạng chuẩn giúp metric chỉ phải chuẩn hóa đầu ra của chương trình, không phải chuẩn hóa cả hai phía. Tệp labels.json có 12 khóa p01 tới p12, mỗi khóa bốn trường.
Tạo Example từ tệp
import json, dspy
LAB = json.load(open("labels.json", encoding="utf-8"))
def page(i): return open(f"html/{i}.html", encoding="utf-8").read()
devset = [dspy.Example(html=page(i), pid=i, **lb).with_inputs("html")
          for i, lb in LAB.items()]
with_inputs đánh dấu html là đầu vào. Các trường còn lại, gồm pid và bốn nhãn, được coi là đáp án hoặc thông tin phụ. pid giúp lần ra trang khi đọc danh sách lỗi.
Tập nhỏ có giá trị riêng
Mười hai trang là quá ít để kết luận về chất lượng chung. Nhưng mỗi trang được chọn vì một cái bẫy cụ thể đã gặp ngoài thực tế. Tập nhỏ có chủ đích kiểu này giống bộ test hồi quy: nó không đo độ chính xác trung bình, nó kiểm từng tình huống khó có còn xử lý đúng không.
Lưu HTML kèm nguồn gốc
Fixture trong lab là HTML tự viết. Với dữ liệu thật, mỗi tệp HTML nên đi kèm URL gốc, thời điểm tải, mã trạng thái và mã băm nội dung. Khi một trang trong tập nhãn bị nghi gán nhãn sai, có thể quay lại đúng phiên bản HTML đã gán, không phải phiên bản hiện tại trên website.
Định nghĩa metric bỏ qua sai khác hình thức nhưng giữ lỗi nội dung trong DSPy đánh giá trích xuất dữ liệu
Phần này là trái tim của bài.
Metric theo trường
FIELDS = ["name", "price", "currency", "in_stock"]

def metric(example, pred, trace=None):
    s = [field_ok(f, example[f], pred[f]) for f in FIELDS]
    return all(s) if trace is not None else sum(s) / len(s)
Mỗi trường đúng được một phần tư điểm. Khi đánh giá, metric trả tỷ lệ trường đúng của một trang. Khi có trace, metric chỉ trả True nếu cả bốn trường đúng, theo cách dùng mà tài liệu mô tả cho việc chọn ví dụ mẫu.
Chuẩn hóa tên
Tên được chuẩn hóa Unicode về dạng NFC, gộp khoảng trắng liên tiếp, bỏ khoảng trắng đầu cuối và so không phân biệt hoa thường. Lab kiểm: nhãn Router AX3000 so với đầu ra có khoảng trắng thừa và chữ thường được tính là đúng.
Chuẩn hóa NFC quan trọng với tiếng Việt. Cùng một chữ có dấu có thể lưu ở dạng dựng sẵn hoặc dạng tổ hợp. Hai dạng hiển thị giống nhau nhưng so chuỗi thì khác. Không chuẩn hóa, metric sẽ chấm sai những trường đúng về nội dung.
Chuẩn hóa giá
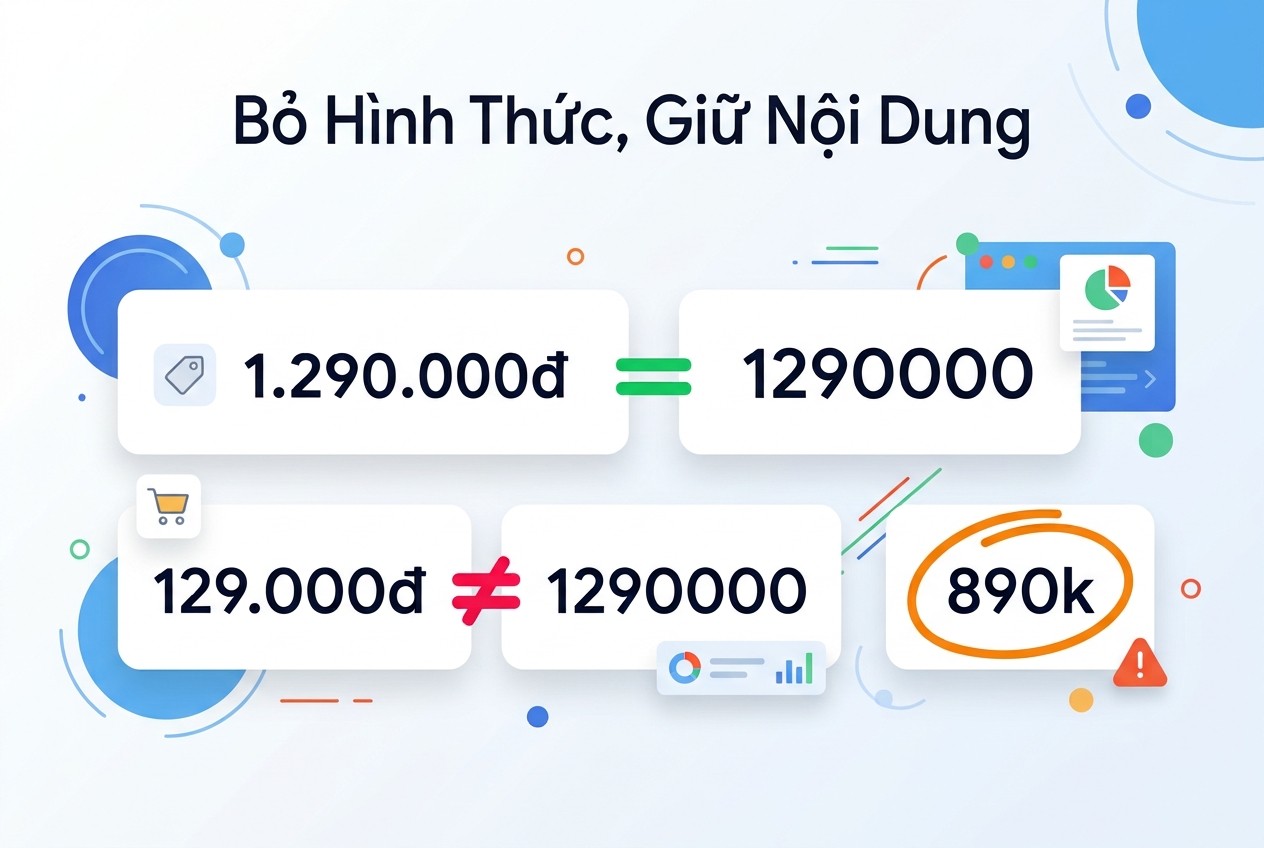
Bỏ hình thức, giữ nội dung
Hàm parse_price bỏ mọi ký tự không phải số, dấu chấm hay dấu phẩy. Nếu chuỗi còn lại có dạng nhóm ba chữ số ngăn bởi dấu chấm hoặc dấu phẩy, nó được coi là phân cách hàng nghìn. Ngược lại, dấu chấm là dấu thập phân. Chuỗi không có chữ số nào, như Liên hệ, thành None.
Quy tắc này đủ cho 12 trang của lab. Nó sẽ sai với giá kiểu châu Âu như 1.290,50. Metric cũng là code, và cũng cần bộ test riêng khi dữ liệu mở rộng sang định dạng mới.
Giữ lỗi nội dung
Bỏ qua hình thức không được biến thành bỏ qua nội dung. Lab kiểm một ca: nhãn 1290000 so với đầu ra 129.000đ. Đây là lỗi thiếu một chữ số, có thể do model đọc sai. Metric chấm sai, đúng như mong muốn. Giá trị lệch được chấp nhận chỉ là sai số dấu phẩy động dưới 0,005.
Đơn vị tiền và tình trạng hàng
Đơn vị tiền được quy về mã: đ, ₫ và VNĐ thành VND, ký hiệu đô la thành USD. Tình trạng hàng nhận bool, hoặc chuỗi true, yes, còn hàng. Hai trường này có ít dạng biểu diễn, nhưng vẫn cần chuẩn hóa vì model có thể trả chuỗi thay vì bool.
Metric cũng cần test
Mỗi quy tắc chuẩn hóa nên có ít nhất một ca kiểm: một ca hai giá trị khác hình thức phải bằng nhau, một ca khác nội dung phải khác nhau. Lab chạy hai ca: tên có khoảng trắng thừa và chữ thường được chấm đúng, giá thiếu một chữ số được chấm sai. Khi ai đó sửa metric để xử lý định dạng mới, các ca này bảo vệ hành vi cũ.
Không có test, metric dễ bị nới lỏng dần cho điểm đẹp. Một dòng chuẩn hóa quá tay, như bỏ mọi số 0 cuối, sẽ làm lỗi thiếu chữ số biến mất khỏi bảng điểm.
Đối chứng: metric so chuỗi nguyên văn
Để thấy tác dụng của chuẩn hóa, lab viết thêm metric so chuỗi nguyên văn giữa nhãn và đầu ra. Cùng chương trình, metric nguyên văn cho điểm thấp hơn hẳn, vì giá 1.290.000đ không bằng chuỗi 1290000. Con số ở phần sau cho thấy khoảng cách này.
Metric nguyên văn trừng phạt sai khác hình thức như lỗi thật. Dùng nó để so hai prompt, ta sẽ chọn prompt sinh định dạng giống nhãn, không phải prompt đọc đúng hơn.
Chấm baseline và một prompt thay đổi trên cùng tập kiểm bằng DSPy đánh giá trích xuất dữ liệu
Phần này là bảng điểm chính của lab.
Hai phiên bản chương trình
Baseline lấy tên từ thẻ h1, lấy giá là cụm giống giá đầu tiên trong văn bản trang, coi trang còn hàng nếu có chữ Còn. Bản sửa ưu tiên JSON-LD nếu có, lấy giá từ thẻ span cuối có class price, coi Liên hệ là không có giá, coi trang hết hàng nếu có cụm hết hàng.
Bản sửa mô phỏng đúng thay đổi mà một người sẽ viết vào prompt: ưu tiên dữ liệu có cấu trúc, bỏ giá gạch, giá trả góp và phí ship. Vì không có model, thay đổi được viết thành quy tắc. Khung chấm giữ nguyên.
Lệnh chấm
ev = dspy.Evaluate(devset=devset, metric=metric, num_threads=1)
print(ev(Baseline()).score, ev(Revised()).score)
Evaluate in ra dòng Average Metric kèm tổng điểm trên số ví dụ, và trả score dạng phần trăm.
Bảng điểm tổng
Phiên bản |
Metric theo trường |
Metric nguyên văn |
|---|---|---|
Baseline |
10,75/12, score 89,58 |
score 50,0 |
Bản sửa |
12/12, score 100,0 |
score 79,17 |
Metric nguyên văn cho baseline 50 điểm, thấp hơn gần 40 điểm so với metric theo trường. Phần chênh là lỗi hình thức, không phải lỗi đọc.
Bảng điểm theo trường
Trường |
Baseline |
Bản sửa |
|---|---|---|
name |
11/12 |
12/12 |
price |
9/12 |
12/12 |
currency |
12/12 |
12/12 |
in_stock |
11/12 |
12/12 |
Năm lỗi của baseline
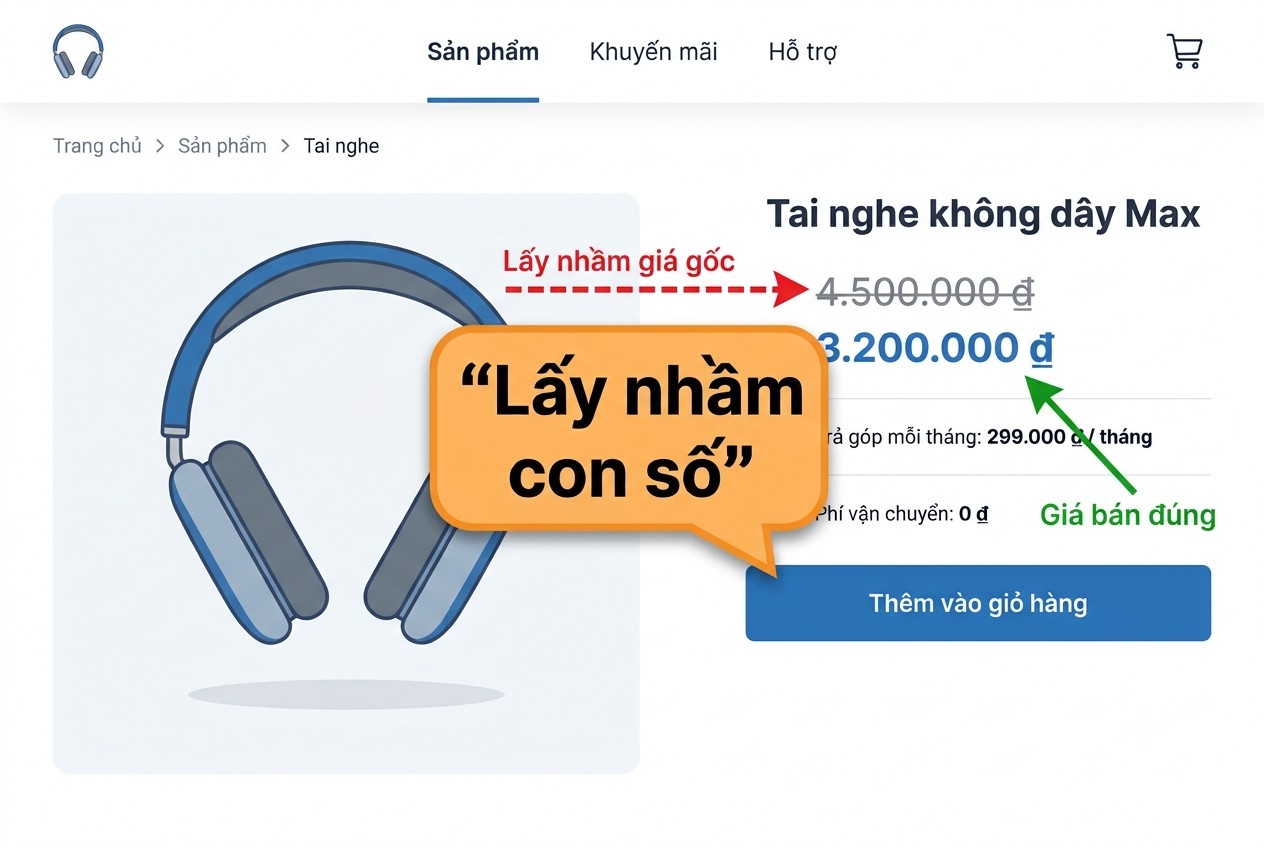
Lấy nhầm con số
Trang p02: lấy 450.000đ là giá gạch thay vì 390.000đ. Trang p06: tên có đuôi Chính hãng, giá đọc thành 890k, tình trạng thành hết hàng vì thân trang không có chữ Còn. Trang p08: lấy 450.000đ là tiền trả góp mỗi tháng thay vì giá 5.400.000đ.
Ba trong năm lỗi nằm ở trường price, và cả ba đều là lấy nhầm con số khác trên trang. Trang p06 gom ba lỗi vì thông tin đúng chỉ nằm trong JSON-LD.
Trang không có lỗi nói gì
Chín trang baseline xử lý đúng cả bốn trường: p01, p03, p04, p05, p07, p09, p10, p11 và p12. Đáng chú ý là p03 với giá Liên hệ: baseline không tìm thấy cụm giống giá nên trả None, trùng với nhãn. Đúng vì may, không phải vì hiểu. Nếu trang p03 có thêm dòng phí lắp đặt 100.000đ, baseline sẽ lấy con số đó.
Bảng điểm không phân biệt đúng vì hiểu với đúng vì may. Chỉ thêm trang có bẫy mới tách được hai loại này.
Lỗi 890k là lỗi gì
Trang p06 ghi giá chỉ 890k. Hàm chuẩn hóa không hiểu hậu tố k nên chấm sai. Có thể lập luận đây là lỗi hình thức, vì 890k đúng là 890.000. Lab chọn giữ nó là lỗi, vì chương trình phía sau cũng sẽ không hiểu 890k. Quyết định này nên ghi vào nguyên tắc chấm, để người khác không sửa metric cho điểm đẹp hơn.
Chỉ dẫn thay đổi trông thế nào trong DSPy
Lab dựng signature với chỉ dẫn gốc một câu, và signature thứ hai bằng with_instructions với chỉ dẫn dài hơn nêu ưu tiên JSON-LD, bỏ giá gạch, giá trả góp, phí ship. Dùng ChatAdapter để định dạng tin nhắn cho trang p02 mà không gọi model: tin nhắn hệ thống tăng từ 831 lên 1.027 ký tự, tin nhắn người dùng giữ 604 ký tự.
Phần chỉ dẫn nằm cuối tin nhắn hệ thống, sau mô tả từng trường đầu ra kèm ràng buộc kiểu. Với price kiểu chuỗi hoặc None, DSPy thêm ghi chú yêu cầu giá trị tuân theo JSON schema có anyOf string và null. Với in_stock, ghi chú yêu cầu giá trị True hoặc False.
Phân tích lỗi theo trường và giới hạn kết luận từ tập nhỏ trong DSPy đánh giá trích xuất dữ liệu
Phần này nói về những gì bảng điểm không chứng minh được.
Bản sửa được viết sau khi thấy lỗi
Bản sửa đạt 12/12 vì nó được viết sau khi đọc năm lỗi của baseline trên chính 12 trang này. Đây là quá khớp với tập kiểm. Điểm 100 nói rằng bản sửa xử lý được các bẫy đã biết, không nói gì về trang mới.
Cách đúng là chia dữ liệu: một phần để đọc lỗi và sửa, một phần giữ kín chỉ dùng để chấm cuối. Với 12 trang thì không đủ để chia. Khi tập nhãn lớn lên vài chục trang, tách ít nhất một phần ba làm tập giữ kín.
Mười hai trang không đủ cho phần trăm
Một trang sai làm điểm trường đổi 8 điểm phần trăm. Khác biệt một trang giữa hai phiên bản có thể do ngẫu nhiên, nhất là với model có nhiệt độ lớn hơn 0. Báo cáo nên ghi số trang đúng trên tổng, như 9/12, thay vì chỉ ghi 75 phần trăm.
Chạy lại nhiều lần với model thật
Chương trình quy tắc cho cùng kết quả mỗi lần chạy. Model thật thì không, kể cả với nhiệt độ thấp. Khi có model, chấm mỗi phiên bản vài lần và ghi khoảng dao động. Nếu khoảng dao động của hai phiên bản chồng lên nhau, chưa thể nói bản nào tốt hơn.
DSPy có cache cho lời gọi model. Khi chấm lặp để đo dao động, cần tắt cache hoặc đổi tham số, nếu không lần chạy sau chỉ đọc lại kết quả lần đầu.
Lỗi khi gọi model
Lời gọi thật với khóa giả ném LMAuthError với thông báo che bớt khóa và ghi rõ khóa đến từ tham số api_key truyền vào. Theo chữ ký của Evaluate bản 3.4.1, ví dụ bị lỗi được tính bằng failure_score, mặc định 0. max_errors giới hạn số lỗi trước khi dừng.
Hệ quả: một đợt chấm bị lỗi mạng hay hết hạn mức sẽ cho điểm thấp mà không phải do prompt kém. Luôn đọc số lỗi trong log trước khi đọc điểm. Lab không chạy Evaluate với model giả để tránh gửi hàng loạt request lỗi tới OpenAI.
Đọc lỗi theo trang, không chỉ theo điểm
Điểm tổng tăng từ 89,58 lên 100 trông đẹp. Danh sách lỗi theo trang mới cho biết điều gì đã thay đổi: ba lỗi giá, một lỗi tên, một lỗi tình trạng. Khi điểm tổng tăng nhưng có trang trước đúng nay sai, đó là hồi quy cần xem kỹ. Lab in danh sách lỗi của cả hai phiên bản để so từng dòng.
So với metric dùng model chấm
Một số người dùng chính model ngôn ngữ để chấm đầu ra, hỏi nó câu trả lời có đúng không. Với trường có đáp án rõ như giá hay tình trạng hàng, metric bằng code rẻ hơn, nhanh hơn và cho cùng kết quả mỗi lần chạy. Model chấm hợp hơn với trường mô tả tự do, nơi nhiều cách viết đều đúng. Bài toán trích sản phẩm của lab không cần đến nó.
Tăng tập nhãn theo lỗi thật
Mỗi khi phát hiện một trang trích sai trong dữ liệu thật, thêm trang đó vào tập nhãn với nhãn đúng. Tập nhãn lớn dần theo đúng những tình huống khó của chính website mình làm việc. Sau vài tháng, nó là tài sản có giá trị hơn bất kỳ prompt nào.
Đầu ra nghiệm thu: bộ dữ liệu gán nhãn nhỏ và bảng điểm theo trường trước/sau một thay đổi prompt của DSPy đánh giá trích xuất dữ liệu
Phần cuối gom bộ bàn giao và vai trò của proxy.
Bộ bàn giao
Bộ bàn giao gồm thư mục html với 12 tệp, tệp labels.json và tệp nguyên tắc gán nhãn. Kèm theo là mã metric với các ca kiểm metric, mã hai phiên bản chương trình, bảng điểm tổng, bảng điểm theo trường và danh sách lỗi theo trang. Kèm dòng ghi rõ: hai phiên bản là chương trình quy tắc, chưa chấm với model thật.
Ngưỡng nghiệm thu
Bộ đánh giá đạt khi metric có test cho từng quy tắc chuẩn hóa, có ít nhất một ca chứng minh metric giữ lỗi nội dung, và bảng điểm theo trường ghi dạng số đúng trên tổng. Thay đổi prompt chỉ được nhận khi không trường nào giảm và danh sách lỗi mới không có trang trước đây đúng.
Khi có khóa API
Thay forward của chương trình bằng dspy.Predict với signature gốc và signature có chỉ dẫn mới. Cấu hình dspy.LM với khóa thật. Chạy Evaluate với cùng devset và metric. Mọi phần còn lại của bài giữ nguyên, kể cả bảng điểm baseline quy tắc để làm mốc.
Khi nào cần proxy với DSPy đánh giá trích xuất dữ liệu
Đánh giá chạy trên HTML đã lưu, không cần mạng và không cần proxy. Proxy chỉ liên quan tới hai chỗ khác: bước tải HTML ban đầu, và lời gọi tới nhà cung cấp model nếu mạng công ty bắt đi qua proxy. dspy.LM dùng LiteLLM, đọc biến môi trường HTTPS_PROXY. Cách viết URL proxy có trong bài định dạng proxy.
Bước tải HTML từ website được phép đôi khi cần IP tại Việt Nam để nhận đúng phiên bản trang hiển thị cho người dùng trong nước. Khi đó anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Proxy không làm metric chính xác hơn và không sửa nhãn sai. Vai trò hợp lệ của proxy được phân tích trong bài Web Scraping proxy là gì.
Chuẩn hóa sau trích xuất
Metric chuẩn hóa để chấm. Dữ liệu đưa vào sử dụng cũng cần chuẩn hóa tương tự, với kiểu dữ liệu rõ ràng. Cách dùng Pydantic cho bước này có trong bài Pydantic chuẩn hóa dữ liệu crawl.
Checklist DSPy đánh giá trích xuất dữ liệu
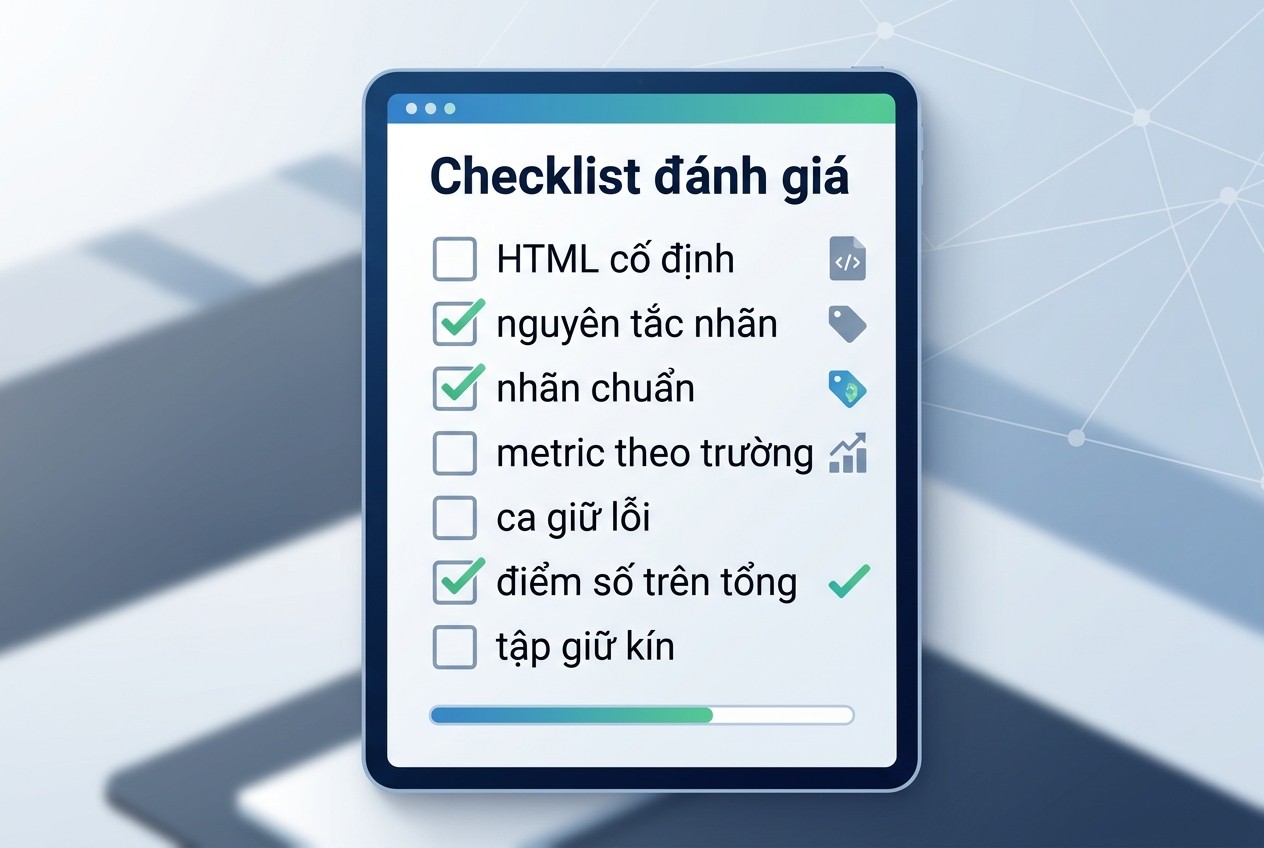
Checklist đánh giá
- Lưu HTML cố định, không tải lại khi chấm.
- Viết nguyên tắc gán nhãn trước khi gán.
- Lưu nhãn ở dạng chuẩn: số, mã tiền tệ, bool.
- Metric chấm theo trường, chuẩn hóa NFC, giá, đơn vị.
- Có ca kiểm chứng minh metric giữ lỗi nội dung.
- Ghi điểm dạng số đúng trên tổng, kèm danh sách lỗi theo trang.
- Tách tập giữ kín khi tập nhãn đủ lớn.
- Đọc số lỗi gọi model trước khi đọc điểm.
Câu hỏi thường gặp về DSPy đánh giá trích xuất dữ liệu
Metric trong DSPy là gì?
Hàm nhận Example và Prediction, trả số đo chất lượng. Khi có trace, thường trả đúng hoặc sai.
Có cần model ngôn ngữ để chạy Evaluate không?
Không. Evaluate chấm bất kỳ dspy.Module nào, kể cả chương trình quy tắc dùng làm mốc.
Vì sao không so chuỗi nguyên văn?
Lab cho thấy so nguyên văn làm baseline mất gần 40 điểm vì lỗi hình thức như dấu chấm hàng nghìn.
Mười hai trang có đủ không?
Đủ làm bộ test hồi quy cho các bẫy đã biết, không đủ để kết luận độ chính xác chung.
Gọi model lỗi thì điểm tính thế nào?
Evaluate tính bằng failure_score, mặc định 0. Đọc số lỗi trước khi đọc điểm.
Đánh giá có cần proxy không?
Không. Chỉ bước tải HTML hoặc lời gọi model qua mạng công ty mới có thể cần.
DSPy đánh giá trích xuất dữ liệu và những điều cần nhớ
DSPy đánh giá trích xuất dữ liệu chỉ có ý nghĩa khi tập nhãn cố định và metric chấm đúng thứ cần chấm. Lab cho thấy metric so nguyên văn làm điểm baseline rơi từ 89,58 xuống 50 vì lỗi hình thức, còn metric theo trường giữ đúng các lỗi lấy nhầm giá gạch và giá trả góp. Ghi điểm theo trường, đọc lỗi theo trang, đừng tin điểm 100 trên tập đã dùng để sửa. Cần IP tĩnh cho bước tải HTML trước khi DSPy đánh giá trích xuất dữ liệu, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


