
CrewAI web scraping: dựng crew nghiên cứu có tool tải web
CrewAI web scraping là cách giao việc đọc và tổng hợp trang web cho một nhóm agent, mỗi agent giữ một vai trò riêng. Điểm cần làm rõ là ai thật sự gửi request ra Internet và gửi bao nhiêu lần. Bài này, ProxyVN hướng dẫn viết tool tải trang qua proxy, giới hạn request, lưu nguồn cho từng task và dựng một crew nghiên cứu nhỏ.
CrewAI web scraping gồm những thành phần nào
CrewAI là framework Python để tổ chức nhiều agent làm việc cùng nhau theo một quy trình. Mỗi agent có vai trò, mục tiêu và bộ tool riêng. Task mô tả việc cần làm và kết quả mong đợi. Crew gom agent và task lại, quyết định thứ tự thực hiện.
Tài liệu chính thức của CrewAI mô tả bốn khái niệm này là nền tảng của mọi crew. Với bài toán thu thập web, phần quan trọng nhất là tool. Agent chỉ suy luận và quyết định gọi tool, còn tool mới thực hiện request HTTP thật.
Agent, Task và Crew
Agent được định nghĩa bằng role, goal và backstory. Ba trường này là văn bản hướng dẫn mô hình đóng vai. Ví dụ agent nghiên cứu có vai trò tìm và đọc tài liệu kỹ thuật, agent tổng hợp có vai trò viết báo cáo ngắn từ ghi chú của agent nghiên cứu.
Task gồm mô tả công việc, kết quả mong đợi và agent phụ trách. Kết quả của task trước có thể làm ngữ cảnh cho task sau. Crew chạy các task theo quy trình tuần tự hoặc phân cấp. Với lab, quy trình tuần tự dễ theo dõi hơn.
Tool là nơi mở kết nối mạng
Tool trong CrewAI là một hàm hoặc lớp có tên và mô tả, giống khái niệm tool ở các framework agent khác. Trang tài liệu về tools liệt kê các tool dựng sẵn và cách viết tool tùy chỉnh. Khi agent gọi tool tải trang, request đi từ máy anh em tới website.
Vì vậy, proxy cho CrewAI web scraping phải gắn vào tool, không gắn vào agent hay crew. Agent không có khái niệm proxy, nó chỉ biết gọi tool với tham số URL. Hiểu điều này giúp anh em không tìm nhầm chỗ cấu hình.
Tóm lại, CrewAI web scraping là chuyện thiết kế tool tốt và giao đúng tool cho đúng agent. Phần còn lại của framework lo việc điều phối.
Proxy trong CrewAI web scraping đặt ở đâu
Một crew có ít nhất hai loại kết nối ra mạng: kết nối tới nhà cung cấp mô hình ngôn ngữ và kết nối do tool tải trang mở ra. Hai loại kết nối có mục đích khác nhau. Proxy thu thập dữ liệu chỉ nên phục vụ loại thứ hai.
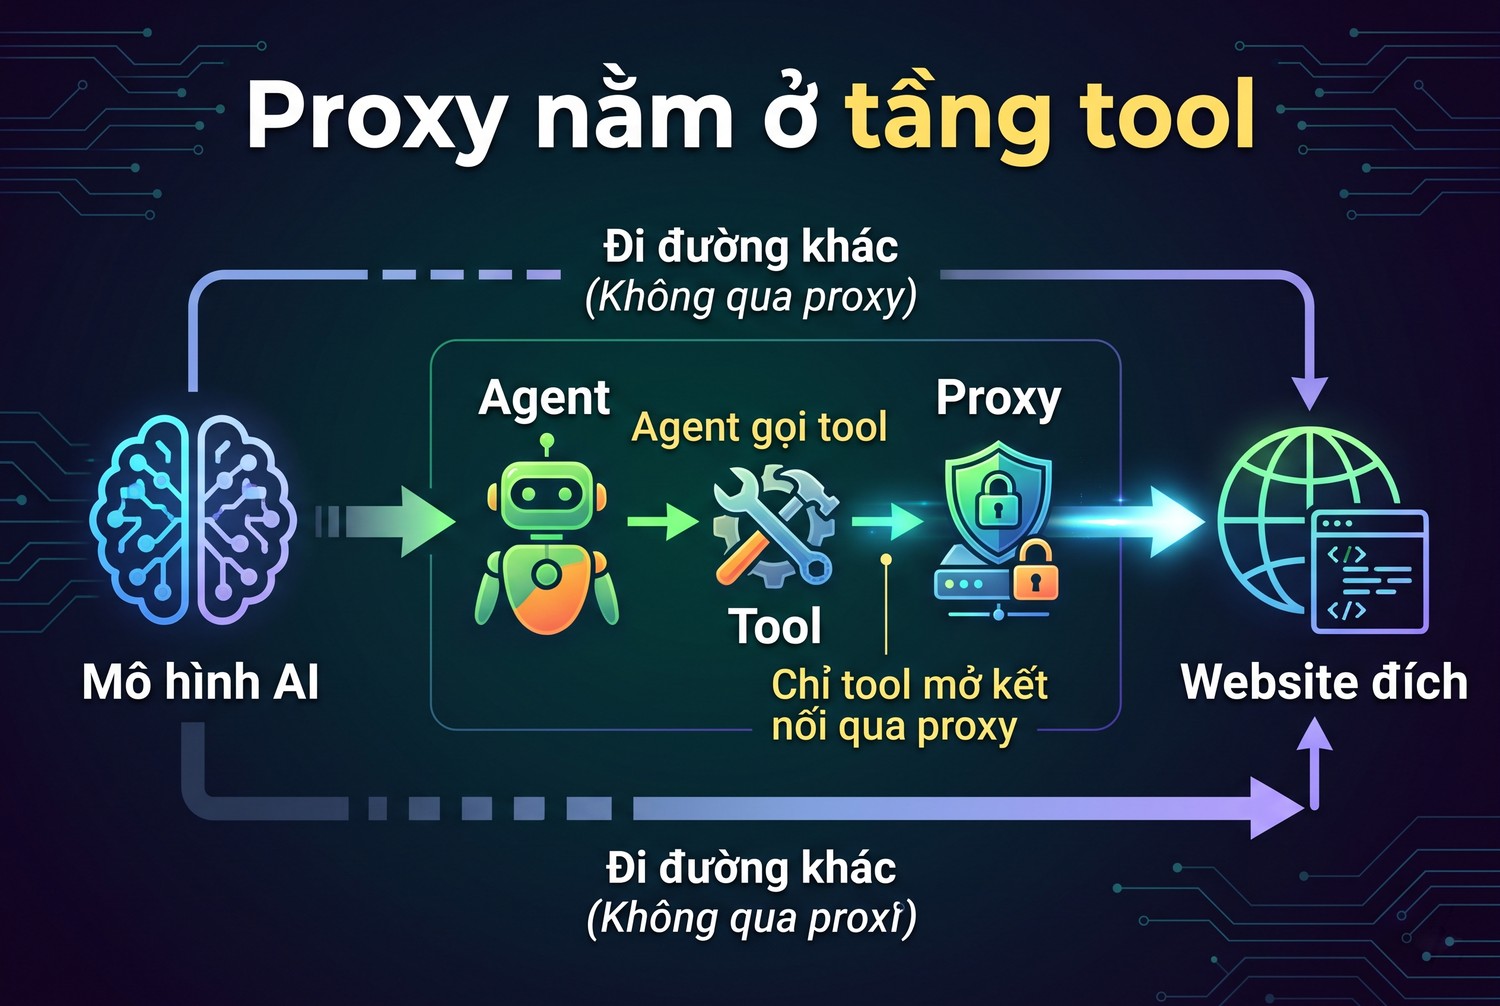
Proxy nằm ở tầng tool
Tool dựng sẵn đọc biến môi trường
Gói crewai-tools có ScrapeWebsiteTool để tải và trích văn bản từ một URL. Tool này dùng thư viện Requests ở bên dưới. Theo tài liệu proxy của Requests, khi không truyền proxy trong code, thư viện đọc biến HTTP_PROXY và HTTPS_PROXY từ môi trường.
Đặt biến môi trường là cách nhanh để tool dựng sẵn đi qua proxy. Nhưng biến này ảnh hưởng tới mọi request dùng Requests trong tiến trình, có thể bao gồm cả kết nối tới mô hình nếu thư viện của nhà cung cấp tôn trọng biến môi trường. Với proxy tính phí theo băng thông, đây là chi phí không mong muốn.
Tool tự viết kiểm soát tốt hơn
Cách thứ hai là viết tool riêng dùng Session có proxy và đặt trust_env bằng False. Khi đó, chỉ request tải trang đi qua proxy, mọi kết nối khác giữ nguyên. Tool tự viết còn cho phép đếm request, chèn khoảng nghỉ và ghi sổ nguồn.
Bảng dưới so sánh hai cách. Anh em chọn theo mức kiểm soát cần có và quy mô của crew.
Tiêu chí |
ScrapeWebsiteTool dựng sẵn |
Tool tự viết |
|---|---|---|
Đặt proxy |
Biến HTTP_PROXY, HTTPS_PROXY |
Session.proxies trong tool |
Ảnh hưởng tới kết nối mô hình |
Có thể có |
Không |
Đếm và giới hạn request |
Không có sẵn |
Tuỳ ý |
Ghi nguồn và thời điểm |
Không có sẵn |
Tuỳ ý |
Công sức viết |
Ít |
Thêm vài chục dòng |
Nhìn bảng, tool tự viết đáng công hơn khi crew cần chạy lặp lại hoặc kết quả cần trích nguồn. Tool dựng sẵn hợp với lần thử đầu để làm quen framework.
Kiểm chứng tuyến mạng
Trước khi giao tool cho agent, anh em chạy tool một lần với trang trả IP công khai. So kết quả với IP khi không dùng proxy. Nếu hai giá trị khác nhau, tuyến mạng đã đúng. Nếu giống nhau, biến hoặc cấu hình proxy chưa có hiệu lực trong tiến trình đang chạy.
Kết lại, proxy trong CrewAI web scraping thuộc về tool. Đặt đúng chỗ ngay từ đầu giúp tránh chi phí thừa và dễ dò lỗi hơn nhiều.
Chuẩn bị môi trường CrewAI web scraping
Lab cần CrewAI, Requests và BeautifulSoup. CrewAI yêu cầu phiên bản Python cụ thể theo từng bản phát hành, nên anh em kiểm tra trang tài liệu trước khi tạo môi trường. Ghi lại phiên bản đã cài để chạy lại về sau.
Cài thư viện
Các lệnh dưới chạy trên PowerShell. Gói crewai-tools chỉ cần nếu anh em muốn thử ScrapeWebsiteTool dựng sẵn; tool tự viết không phụ thuộc gói này.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install crewai crewai-tools requests beautifulsoup4
python -m pip freeze > requirements-lock.txt
CrewAI cập nhật khá nhanh và đôi khi đổi tên tham số. Khi một đoạn code mẫu báo lỗi tham số không tồn tại, việc đầu tiên là so phiên bản trong requirements-lock.txt với phiên bản mà tài liệu đang mô tả.
Biến môi trường cho mô hình và proxy
CrewAI cần cấu hình mô hình ngôn ngữ. Mặc định framework dùng mô hình của OpenAI qua biến OPENAI_API_KEY; anh em có thể khai báo mô hình khác qua lớp LLM theo hướng dẫn trong tài liệu. Proxy cho tool tải trang đặt ở biến riêng để không lẫn với cấu hình mô hình.
$env:OPENAI_API_KEY = 'YOUR_KEY'
$env:CREW_FETCH_PROXY = 'http://USERNAME:PASSWORD@HOST:PORT'
Các giá trị trên là mẫu. Nếu mật khẩu proxy chứa ký tự đặc biệt, mã hoá URL trước khi ghép. Không đưa khoá API hay mật khẩu vào ảnh chụp, tệp log hoặc kho mã nguồn.
Chốt giới hạn trước khi viết code
Crew có nhiều agent, mỗi agent có thể gọi tool nhiều lần. Nếu không có giới hạn, một câu hỏi đơn giản có thể dẫn tới hàng chục request tới website và hàng chục lần gọi mô hình. Anh em nên chốt trước ba con số: số request tối đa mỗi phút, số trang tối đa mỗi lần chạy và số vòng suy luận tối đa của mỗi agent.
Với lab, mười request mỗi phút, tám trang mỗi lần chạy và năm vòng suy luận mỗi agent là mức khởi đầu an toàn. Sau vài lần chạy, xem log để điều chỉnh. Như vậy, môi trường đã sẵn sàng và có giới hạn rõ trước khi crew đầu tiên chạy.
Viết tool tải trang cho CrewAI web scraping
Tool tải trang là thành phần quan trọng nhất trong lab. Nó nhận URL, tải qua proxy, kiểm tra phản hồi, làm sạch văn bản và ghi sổ nguồn. Code dưới là ví dụ triển khai chung, dùng lớp BaseTool của CrewAI.
Tool tải trang có bộ đếm
Code tool FetchPageTool
Lớp FetchPageTool khai báo tên, mô tả và schema đầu vào bằng Pydantic. Phương thức _run thực hiện request. Session dùng chung giữa các lần gọi để tái sử dụng kết nối tới proxy, giúp giảm thời gian bắt tay.
import os
import time
import hashlib
import requests
from datetime import datetime, timezone
from bs4 import BeautifulSoup
from pydantic import BaseModel, Field
from crewai.tools import BaseTool

SOURCES = []
MAX_PAGES = 8
MAX_CHARS = 6000

def _session():
    s = requests.Session()
    s.trust_env = False
    p = os.environ.get("CREW_FETCH_PROXY")
    if p:
        s.proxies.update({"http": p, "https": p})
    s.headers["User-Agent"] = "crewai-research-lab/0.1 (contact: you@example.com)"
    return s

class FetchInput(BaseModel):
    url: str = Field(..., description="URL đầy đủ của trang cần đọc")

class FetchPageTool(BaseTool):
    name: str = "fetch_page"
    description: str = "Tải nội dung chính của một trang web và trả về văn bản đã làm sạch kèm số nguồn."
    args_schema: type[BaseModel] = FetchInput

    def _run(self, url: str) -> str:
        if len(SOURCES) >= MAX_PAGES:
            return "LIMIT: đã tải đủ số trang cho lần chạy này"
        time.sleep(2)
        r = SESSION.get(url, timeout=(10, 30))
        if r.status_code != 200 or "html" not in r.headers.get("Content-Type", ""):
            return f"ERROR status={r.status_code} url={r.url}"
        soup = BeautifulSoup(r.text, "html.parser")
        for t in soup(["script", "style", "nav", "footer", "header", "aside", "form"]):
            t.decompose()
        root = soup.find("main") or soup.find("article") or soup.body or soup
        lines = [x.strip() for x in root.get_text("\n").splitlines()]
        text = "\n".join(x for x in lines if len(x) > 30)[:MAX_CHARS]
        title = soup.title.get_text(strip=True) if soup.title else ""
        SOURCES.append({
            "n": len(SOURCES) + 1, "url": r.url, "title": title,
            "sha": hashlib.sha256(text.encode("utf-8")).hexdigest()[:16],
            "fetched": datetime.now(timezone.utc).isoformat(),
        })
        return f"[S{len(SOURCES)}] {title}\n{r.url}\n\n{text}"

SESSION = _session()
Mỗi lần tải thành công, tool trả văn bản bắt đầu bằng mã nguồn dạng S1, S2. Agent được hướng dẫn ghi mã này khi dùng thông tin từ trang. Biến SOURCES giữ danh sách đầy đủ để in ra cuối lần chạy.
Giới hạn ngay trong tool
Biến MAX_PAGES chặn số trang mỗi lần chạy ngay trong tool. Đây là lớp giới hạn cứng, không phụ thuộc vào việc agent có tuân thủ hướng dẫn hay không. Khi vượt, tool trả thông báo rõ ràng để agent biết cần kết thúc nghiên cứu.
Khoảng nghỉ hai giây trước mỗi request giữ nhịp tải nhẹ nhàng cho website. Với website có tài liệu yêu cầu tốc độ cụ thể, anh em điều chỉnh theo đúng con số đó. Giới hạn trong tool là lớp bảo vệ cuối cùng, nên luôn có kể cả khi đã đặt giới hạn ở agent và crew.
Kiểm tra tool trước khi giao cho agent
Gọi trực tiếp tool với một URL đã biết nội dung để xem kết quả. Kiểm tra mã nguồn, tiêu đề và vài dòng đầu văn bản. Sau đó gọi với trang trả IP để xác nhận tuyến proxy.
tool = FetchPageTool()
print(tool.run(url="https://example.com/")[:300])
print(SESSION.get("https://api.ipify.org", timeout=15).text)
SOURCES.clear()
Dòng SOURCES.clear xoá các bản ghi thử để lần chạy crew thật bắt đầu từ S1. Bước kiểm tra này chỉ mất vài giây nhưng tránh được việc chạy cả crew rồi mới phát hiện tool lỗi. Tóm lại, tool tốt cần được thử độc lập trước khi đặt vào tay agent.
Dựng crew nghiên cứu cho CrewAI web scraping
Crew trong lab gồm hai agent: agent nghiên cứu dùng tool tải trang để đọc tài liệu, agent tổng hợp viết báo cáo từ ghi chú. Agent tổng hợp không có tool tải trang, nhờ đó số request ra ngoài chỉ phụ thuộc agent nghiên cứu. Đây là cách phân quyền đơn giản nhưng hiệu quả.
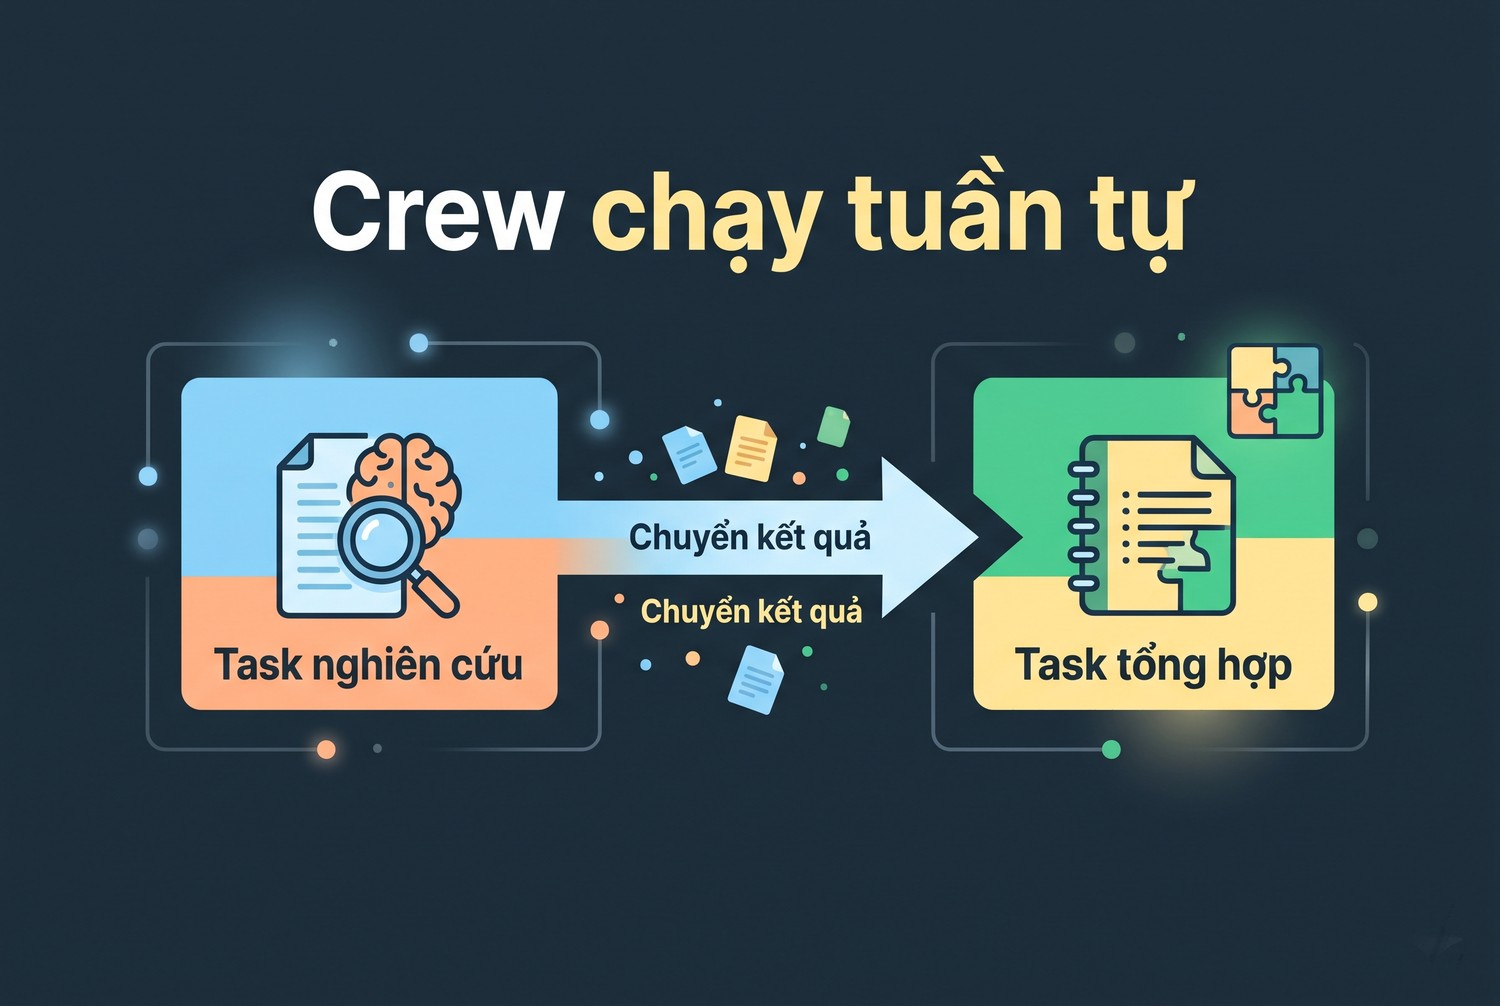
Crew chạy tuần tự
Định nghĩa agent và giới hạn vòng suy luận
Agent nghiên cứu nhận danh sách URL ban đầu qua mô tả task, không tự tìm kiếm trên Internet. Cách này giữ phạm vi thu thập trong danh sách anh em đã duyệt. Tham số max_iter giới hạn số vòng suy luận, còn max_rpm giới hạn số lần gọi mỗi phút.
from crewai import Agent, Task, Crew, Process

researcher = Agent(
    role="Nhà nghiên cứu tài liệu kỹ thuật",
    goal="Đọc các trang được giao và ghi chú thông tin chính xác kèm mã nguồn",
    backstory="Bạn chỉ dùng thông tin trong trang đã tải và luôn ghi mã nguồn dạng [S1].",
    tools=[FetchPageTool()],
    max_iter=5,
    max_rpm=10,
    verbose=True,
)

writer = Agent(
    role="Biên tập viên kỹ thuật",
    goal="Viết báo cáo ngắn, rõ ràng từ ghi chú nghiên cứu, giữ nguyên mã nguồn",
    backstory="Bạn không thêm thông tin ngoài ghi chú và không bỏ mã nguồn.",
    tools=[],
    max_iter=3,
    verbose=True,
)
Backstory của cả hai agent đều nhấn mạnh việc giữ mã nguồn. Mô hình đôi khi bỏ mã nguồn khi viết lại văn bản; lặp lại yêu cầu ở cả hai agent giảm khả năng này. Tham số verbose giúp anh em xem từng bước suy luận trong lúc thử.
Định nghĩa task với kết quả mong đợi rõ
Task nghiên cứu liệt kê URL được phép đọc và yêu cầu ghi chú dạng gạch đầu dòng có mã nguồn. Task tổng hợp nhận kết quả task nghiên cứu qua tham số context. Trường expected_output mô tả hình dạng kết quả để mô hình bám theo.
urls = [u.strip() for u in open("urls.txt", encoding="utf-8") if u.strip()]

research = Task(
    description=(
        "Đọc lần lượt các trang sau bằng tool fetch_page, không đọc trang khác:\n"
        + "\n".join(urls)
        + "\nGhi chú các thông tin về cấu hình proxy, mỗi ý kèm mã nguồn [S#]."
    ),
    expected_output="Danh sách gạch đầu dòng, mỗi dòng một ý và một mã nguồn.",
    agent=researcher,
)

report = Task(
    description="Viết báo cáo khoảng 300 chữ từ ghi chú, giữ nguyên mã nguồn sau mỗi ý.",
    expected_output="Báo cáo ngắn bằng tiếng Việt, có mã nguồn [S#] sau mỗi ý.",
    agent=writer,
    context=[research],
)

crew = Crew(agents=[researcher, writer], tasks=[research, report],
            process=Process.sequential, max_rpm=10)
result = crew.kickoff()
print(result)
for s in SOURCES:
    print(f"[S{s['n']}] {s['title']} - {s['url']} ({s['fetched']})")
Danh sách URL trong mô tả task là ranh giới thu thập. Agent có thể cố đọc trang ngoài danh sách nếu thấy liên kết trong nội dung. Để chặn cứng, anh em thêm kiểm tra trong tool: chỉ cho phép URL nằm trong tập đã duyệt.
Chặn URL ngoài danh sách
Thêm một tập ALLOWED trong tool và kiểm tra trước khi tải. URL không nằm trong tập trả về thông báo từ chối. Cách này biến danh sách URL từ lời dặn thành quy tắc kỹ thuật.
ALLOWED = set(urls)

def is_allowed(url):
    return url in ALLOWED
Gọi is_allowed ở đầu phương thức _run, trả về "DENIED" nếu URL không hợp lệ. Khi crew mở rộng, có thể đổi điều kiện sang kiểm tra theo tên miền thay vì từng URL. Như vậy, crew vừa có giới hạn số lượng, vừa có giới hạn phạm vi.
Giới hạn request trong CrewAI web scraping
Giới hạn request trong một crew nên có ba lớp: lớp crew, lớp agent và lớp tool. Mỗi lớp bảo vệ một khía cạnh khác nhau. Thiếu một lớp, các lớp còn lại vẫn có thể bị vượt trong tình huống bất ngờ.
Lớp crew và agent
Tham số max_rpm ở crew và agent giới hạn số lần gọi mô hình hoặc tool mỗi phút theo cơ chế của framework. Theo tài liệu về agents của CrewAI, max_iter giới hạn số vòng suy luận trước khi agent phải đưa ra câu trả lời. Hai tham số này chủ yếu kiểm soát chi phí mô hình và tránh vòng lặp vô hạn.
Giới hạn ở lớp này không phân biệt request tới website với các bước suy luận khác. Vì vậy, nó chưa đủ để bảo vệ website nguồn. Anh em cần thêm giới hạn ngay trong tool như đã viết ở phần trước.
Lớp tool và website
Lớp tool kiểm soát trực tiếp số request ra website: MAX_PAGES, khoảng nghỉ và tập URL được phép. Đây là lớp duy nhất biết chính xác request nào đi tới đâu. Nếu website trả mã 429, tool nên dừng hẳn với website đó trong lần chạy thay vì để agent thử lại.
Tài liệu MDN về mã 429 mô tả header Retry-After. Tool có thể đọc header này và ghi vào thông báo lỗi để agent biết cần dừng. Đổi proxy để vượt giới hạn tốc độ không phải cách xử lý đúng.
- Lớp crew: max_rpm chung cho toàn bộ crew.
- Lớp agent: max_iter và max_rpm theo từng agent.
- Lớp tool: số trang tối đa, khoảng nghỉ, tập URL được phép, dừng khi gặp 429.
Cache để tránh tải lại
Trong một lần chạy, agent có thể gọi tool với cùng URL nhiều lần, nhất là khi suy luận lặp lại. Cache đơn giản theo URL trong tool giúp lần gọi thứ hai trả kết quả ngay mà không gửi request mới. Cache chỉ cần tồn tại trong lần chạy là đủ cho lab.
Ba lớp giới hạn bổ sung cho nhau: crew giữ chi phí, agent giữ vòng suy luận, tool giữ website nguồn.
Tóm lại, giới hạn request trong CrewAI web scraping không thể giao hết cho framework. Lớp tool do anh em tự viết mới là lớp bảo vệ website nguồn hiệu quả nhất.
Chọn nguồn và phạm vi cho CrewAI web scraping
Chất lượng báo cáo của crew phụ thuộc nhiều vào danh sách URL ban đầu hơn là vào số agent. Một danh sách tốt gồm ít trang nhưng đúng nguồn chính thức và đúng chủ đề. Phần này bàn cách chọn nguồn trước khi giao cho crew.
Ưu tiên tài liệu gốc
Với câu hỏi kỹ thuật, tài liệu của chính nhà phát triển luôn đáng tin hơn bài tổng hợp. Agent đọc tài liệu gốc sẽ ghi đúng tên tham số, đúng phiên bản và đúng giới hạn. Bài tổng hợp từ bên thứ ba dễ chứa thông tin cũ hoặc diễn giải sai.
Anh em nên tách danh sách thành hai nhóm: tài liệu gốc và nguồn bổ sung. Trong mô tả task, yêu cầu agent đọc nhóm tài liệu gốc trước, chỉ đọc nhóm bổ sung khi thiếu thông tin. Cách sắp xếp này giảm số trang phải tải và tăng độ chính xác của ghi chú.
Kiểm tra quyền thu thập
Trước khi đưa một website vào danh sách, đọc điều khoản sử dụng và tệp robots.txt theo chuẩn RFC 9309. Robots.txt không phải hàng rào kỹ thuật, nhưng là tín hiệu rõ ràng về mong muốn của chủ website. Tôn trọng tín hiệu này là điều kiện để công việc thu thập kéo dài được lâu.
Một số website có API chính thức cho dữ liệu anh em cần. Khi có API, nên dùng API thay vì tải trang HTML. API ổn định hơn, ít tốn băng thông hơn và thường có điều khoản sử dụng rõ ràng. Tool gọi API có thể viết theo cùng mẫu với FetchPageTool.
- Có API chính thức: viết tool gọi API, không tải HTML.
- Không có API, robots.txt cho phép: dùng FetchPageTool với khoảng nghỉ hợp lý.
- Robots.txt hoặc điều khoản không cho phép: bỏ khỏi danh sách.
- Trang cần đăng nhập: không đưa vào crew nghiên cứu công khai.
Giữ danh sách nguồn dưới dạng tệp
Danh sách URL nên nằm trong tệp riêng như urls.txt, kèm ghi chú ngày duyệt và lý do chọn. Khi có người hỏi vì sao báo cáo dựa trên nguồn này, anh em có câu trả lời ngay. Tệp này cũng là đầu vào cho tập ALLOWED trong tool, nên chỉ cần sửa một chỗ khi đổi nguồn.
Tóm lại, chọn nguồn cẩn thận giúp CrewAI web scraping ít request hơn mà kết quả tốt hơn. Đây là bước rẻ nhất nhưng tác động lớn nhất tới chất lượng báo cáo.
Lưu nguồn và kiểm tra đầu ra CrewAI web scraping
Kết quả của crew chỉ có giá trị khi mỗi ý trong báo cáo truy được về trang đã tải. Phần này trình bày cách lưu nguồn ra tệp và kiểm tra mã nguồn trong báo cáo có khớp với danh sách đã tải hay không.
Lưu nguồn ra tệp
Sau mỗi lần chạy, ghi danh sách SOURCES và báo cáo cuối vào tệp JSON Lines với mã lần chạy riêng. Tệp này cho phép tra lại báo cáo cũ dựa trên những trang nào và tải lúc nào. Khi nội dung trang thay đổi, anh em so mã băm để biết báo cáo có cần cập nhật.
import json
import uuid

def save_run(result, path="crew_runs.jsonl"):
    run_id = uuid.uuid4().hex[:12]
    with open(path, "a", encoding="utf-8") as f:
        for s in SOURCES:
            f.write(json.dumps(dict(s, run=run_id), ensure_ascii=False) + "\n")
        f.write(json.dumps({"run": run_id, "report": str(result)}, ensure_ascii=False) + "\n")
    return run_id
Tệp crew_runs.jsonl chỉ lưu thông tin nguồn và báo cáo, không lưu toàn văn trang. Nếu cần lưu toàn văn để kiểm toán, ghi riêng theo mã băm để tránh trùng lặp. Nhớ che dữ liệu nhạy cảm trước khi lưu.
Kiểm tra mã nguồn trong báo cáo
Một hàm kiểm tra đơn giản tìm mọi mã dạng S và số trong báo cáo, rồi so với danh sách SOURCES. Mã không tồn tại là dấu hiệu agent tự tạo nguồn. Ý không có mã nào là dấu hiệu thông tin có thể đến từ kiến thức sẵn có của mô hình.
import re

def check_citations(report_text):
    used = {int(m) for m in re.findall(r"\[S(\d+)\]", report_text)}
    known = {s["n"] for s in SOURCES}
    return {"unknown": sorted(used - known), "unused": sorted(known - used)}
Kết quả gồm danh sách mã lạ và danh sách nguồn đã tải nhưng không được dùng. Nguồn không được dùng không phải lỗi, nhưng nếu nhiều thì có thể agent đã đọc trang không liên quan. Đây là gợi ý để thu hẹp danh sách URL ở lần chạy sau.
Đọc lại báo cáo bằng mắt người
Dù có kiểm tra tự động, báo cáo vẫn cần người đọc lại trước khi dùng. Chọn ngẫu nhiên hai tới ba ý, mở nguồn tương ứng và xác nhận thông tin có trong trang. Việc này mất vài phút nhưng phát hiện được lỗi mà kiểm tra tự động bỏ sót.
Như vậy, lưu nguồn và kiểm tra đầu ra là bước cuối để biến kết quả của crew thành tài liệu dùng được. Bỏ qua bước này, báo cáo nghe hay nhưng khó tin.
Xử lý lỗi khi chạy CrewAI web scraping
Lỗi trong crew có thể đến từ tool, từ mô hình hoặc từ cách điều phối. Log chi tiết với verbose bằng True giúp thấy rõ agent đã gọi tool gì, nhận kết quả gì. Dựa vào log, anh em phân loại lỗi trước khi sửa.
Lỗi trong tool tải trang
ProxyError với mã 407 cho thấy proxy từ chối xác thực; kiểm tra tên đăng nhập, mật khẩu và mã hoá ký tự đặc biệt. ConnectTimeout cho thấy không kết nối được tới proxy; kiểm tra địa chỉ, cổng và giao thức. Bài requests.exceptions.ProxyError trên blog ProxyVN liệt kê đủ các trường hợp.
Mã 403 hoặc 429 từ website nghĩa là request bị từ chối hoặc bị giới hạn. Xem lại điều khoản của website, giảm tốc độ và tôn trọng Retry-After. Nếu website không cho phép truy cập tự động, bỏ nguồn đó khỏi danh sách.
- ERROR status=0 hoặc ngoại lệ mạng: kiểm tra proxy trước.
- ERROR status=403: kiểm tra User-Agent và điều khoản website.
- ERROR status=429: dừng với website đó, đọc Retry-After.
- Văn bản rất ngắn: trang cần JavaScript, tool hiện tại không đọc được.
Lỗi hành vi của agent
Agent có thể gọi tool với URL không có trong danh sách, hoặc gọi lặp lại cùng URL. Tập ALLOWED và cache trong tool xử lý được cả hai. Nếu agent bỏ mã nguồn khi ghi chú, chỉnh backstory và expected_output để nhấn mạnh yêu cầu này.
Agent tổng hợp đôi khi thêm thông tin ngoài ghi chú. Kiểm tra bằng hàm check_citations sẽ cho thấy các ý không có mã nguồn. Khi gặp, giảm nhiệt độ của mô hình hoặc nhắc rõ trong mô tả task rằng không được thêm thông tin mới.
Lỗi kết nối tới mô hình
Lỗi xác thực hoặc hết hạn mức từ nhà cung cấp mô hình không liên quan tới proxy thu thập. Kiểm tra khoá API, gói đăng ký và biến môi trường. Nếu lỡ đặt HTTPS_PROXY toàn cục khi thử ScrapeWebsiteTool, gỡ biến này để kết nối mô hình trở về đường mặc định.
Tóm lại, phần lớn lỗi CrewAI web scraping lộ ra rõ trong log của tool. Ghi đủ thông tin ở tool là cách tiết kiệm thời gian nhất khi dò lỗi.
Checklist triển khai CrewAI web scraping
Trước khi chạy crew theo lịch hoặc cho nhiều người dùng, anh em rà lại danh sách dưới. Mỗi mục tương ứng với một rủi ro đã nêu trong bài.
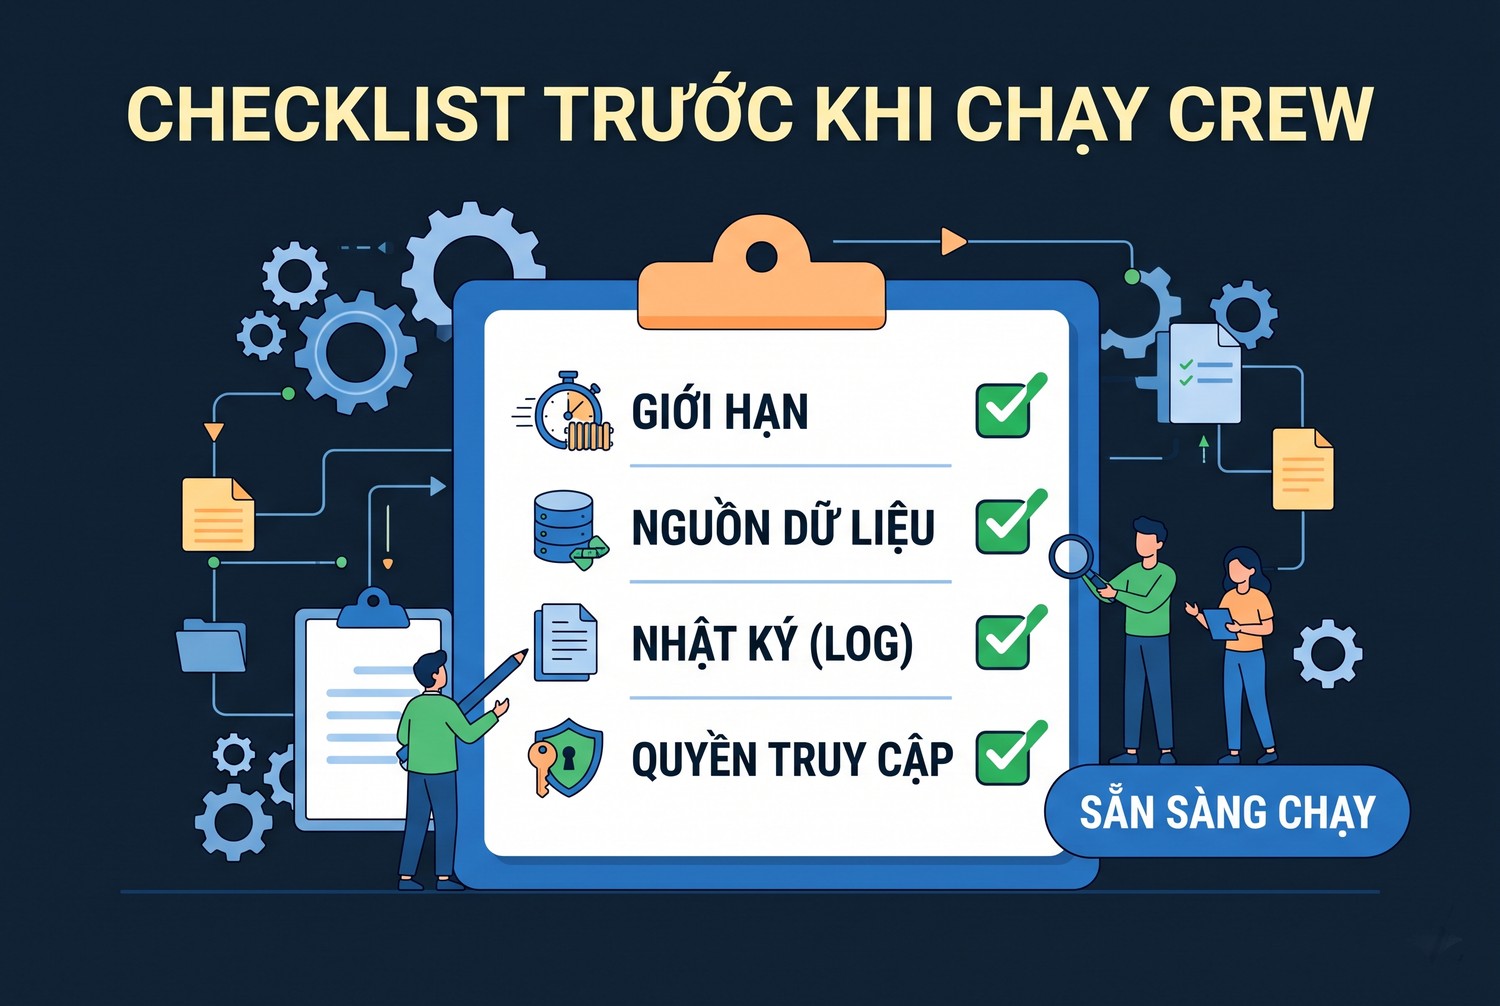
Checklist trước khi chạy crew
Checklist kỹ thuật
Phần kỹ thuật đảm bảo request đi đúng tuyến, đúng phạm vi và có giới hạn. Kiểm tra lại các mục này mỗi khi nâng cấp CrewAI hoặc đổi mô hình.
- Proxy chỉ gắn vào tool tải trang, Session đặt trust_env bằng False.
- Đã kiểm chứng IP qua proxy bằng trang trả IP công khai.
- Tool có MAX_PAGES, khoảng nghỉ, tập URL được phép và cache.
- Agent có max_iter và max_rpm, crew có max_rpm chung.
- Chỉ agent nghiên cứu có tool tải trang.
- Sổ nguồn được xoá trước mỗi lần chạy và lưu ra tệp sau khi chạy.
Checklist vận hành
Phần vận hành liên quan tới quyền sử dụng dữ liệu, chi phí và chất lượng báo cáo. Đây là các điểm thường bị bỏ qua khi lab chạy tốt ở lần đầu.
- Đã đọc điều khoản và robots.txt của từng website nguồn.
- Biết chi phí mô hình cho mỗi lần chạy crew.
- Có bước kiểm tra mã nguồn và đọc lại ngẫu nhiên báo cáo.
- Log đã che khoá API và thông tin đăng nhập proxy.
Khi cần mua proxy uy tín cho tool tải trang, anh em có thể xem các gói dân cư tĩnh hoặc datacenter đang hiển thị trên trang chủ ProxyVN, rồi chạy thử crew với vài URL trước khi mở rộng danh sách. Để hiểu thêm cách agent dùng proxy khi duyệt web, xem bài proxy cho AI agent tự động, còn phần thu thập dữ liệu cho AI có trong bài web scraping dữ liệu AI bằng proxy.
Mở rộng crew một cách có kiểm soát
Khi lab chạy ổn, anh em có thể thêm agent mới như agent kiểm tra sự thật hoặc agent dịch. Mỗi agent mới chỉ nên nhận đúng tool cần thiết. Agent không cần đọc web thì không giao tool tải trang, giữ số request ra ngoài dễ dự đoán.
Mỗi lần thêm agent hay task, chạy lại bộ URL thử và so số request, số nguồn được dùng và chất lượng báo cáo. Ghi kết quả vào bảng theo ngày. Sau vài lần, anh em sẽ có dữ liệu riêng để quyết định cấu trúc crew phù hợp với công việc của mình.
CrewAI web scraping hiệu quả khi proxy nằm trong tool, giới hạn có ở cả ba lớp và mọi ý trong báo cáo đều có mã nguồn. Hãy thử với vài URL đã duyệt, đọc log kỹ rồi mới mở rộng. Cần trao đổi về kết nối, anh em nhắn Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam trước khi chạy CrewAI web scraping.


