
Crawl Quora bằng Python: robots.txt, điều khoản và trích dẫn
Crawl Quora bằng Python nghe đơn giản, nhưng điều khoản dịch vụ và robots.txt của Quora gần như đóng mọi đường cho kịch bản đọc trang. Bài này, ProxyVN đọc lại ba mục điều khoản liên quan, viết bộ kiểm tra robots.txt theo RFC 9309, dựng sổ trích dẫn đúng điều kiện ghi nguồn và giới thiệu bộ dữ liệu cặp câu hỏi do chính Quora công bố.
Mục tiêu và phạm vi của crawl Quora bằng Python
Người tìm cách crawl Quora bằng Python thường có một trong ba mục tiêu. Đội nội dung muốn biết người dùng hỏi gì về một chủ đề để lên ý tưởng bài viết. Người viết muốn trích vài câu trả lời hay làm dẫn chứng. Người làm dữ liệu muốn một kho câu hỏi tiếng Anh để thử mô hình xử lý ngôn ngữ. Ba mục tiêu nghe giống nhau nhưng đòi hỏi ba cách làm khác nhau, và chỉ một trong số đó thật sự cần tới code.
Ba nhu cầu, ba đường đi
Với ý tưởng nội dung, thứ anh em cần là danh sách câu hỏi và cách người dùng diễn đạt, không cần toàn văn câu trả lời. Phần này làm tay trên trình duyệt kết hợp với công cụ nghiên cứu từ khoá là đủ, vì số câu hỏi đáng đọc cho một chủ đề thường chỉ vài chục. Bài proxy nghiên cứu thị trường trên blog ProxyVN có thêm gợi ý về cách nghiên cứu theo khu vực.
Với trích dẫn, Quora có giấy phép riêng cho phép đăng lại một phần nhỏ câu trả lời kèm điều kiện ghi nguồn. Đây là phần bài viết đầu tư nhiều code nhất: một sổ trích dẫn kiểm tra từng điều kiện trước khi đăng và nhắc việc khi có yêu cầu gỡ.
Với dữ liệu để huấn luyện và thử mô hình, Quora từng phát hành bộ dữ liệu cặp câu hỏi cho cộng đồng nghiên cứu bài toán câu hỏi trùng. Dùng bộ này đúng điều kiện tốt hơn nhiều so với tự gom dữ liệu từ trang, cả về pháp lý lẫn chất lượng.
Phạm vi kỹ thuật
Sau bài, anh em có bốn thành phần chạy được: hàm đọc robots.txt theo chuẩn RFC 9309, sổ trích dẫn SQLite có kiểm tra điều kiện, hàm xử lý yêu cầu ẩn danh hoặc gỡ bỏ, và hàm thống kê bộ dữ liệu cặp câu hỏi. Mọi khối code đều đã chạy trong lab với dữ liệu giả lập, mạng bị chặn trong lúc chạy.
Bài không có đoạn code nào tải trang câu hỏi, trang câu trả lời hay trang hồ sơ của Quora, kể cả qua trình duyệt tự động. Với Quora, câu hỏi đầu tiên không phải dùng thư viện nào mà là điều khoản cho phép làm gì. Tóm lại, crawl Quora bằng Python trong bài là bộ công cụ làm việc quanh dữ liệu Quora một cách hợp lệ, không phải bộ cào trang.
Điều khoản Quora và crawl Quora bằng Python
ProxyVN đọc Điều khoản dịch vụ của Quora ngày 23/10/2026, bản có hiệu lực từ 04/03/2024. Ba mục liên quan trực tiếp tới việc thu thập dữ liệu là 4.3, 4.4 và 4.5. Phần dưới diễn giải từng mục bằng tiếng Việt; anh em nên đọc nguyên văn tiếng Anh trước khi ra quyết định cho dự án của mình.
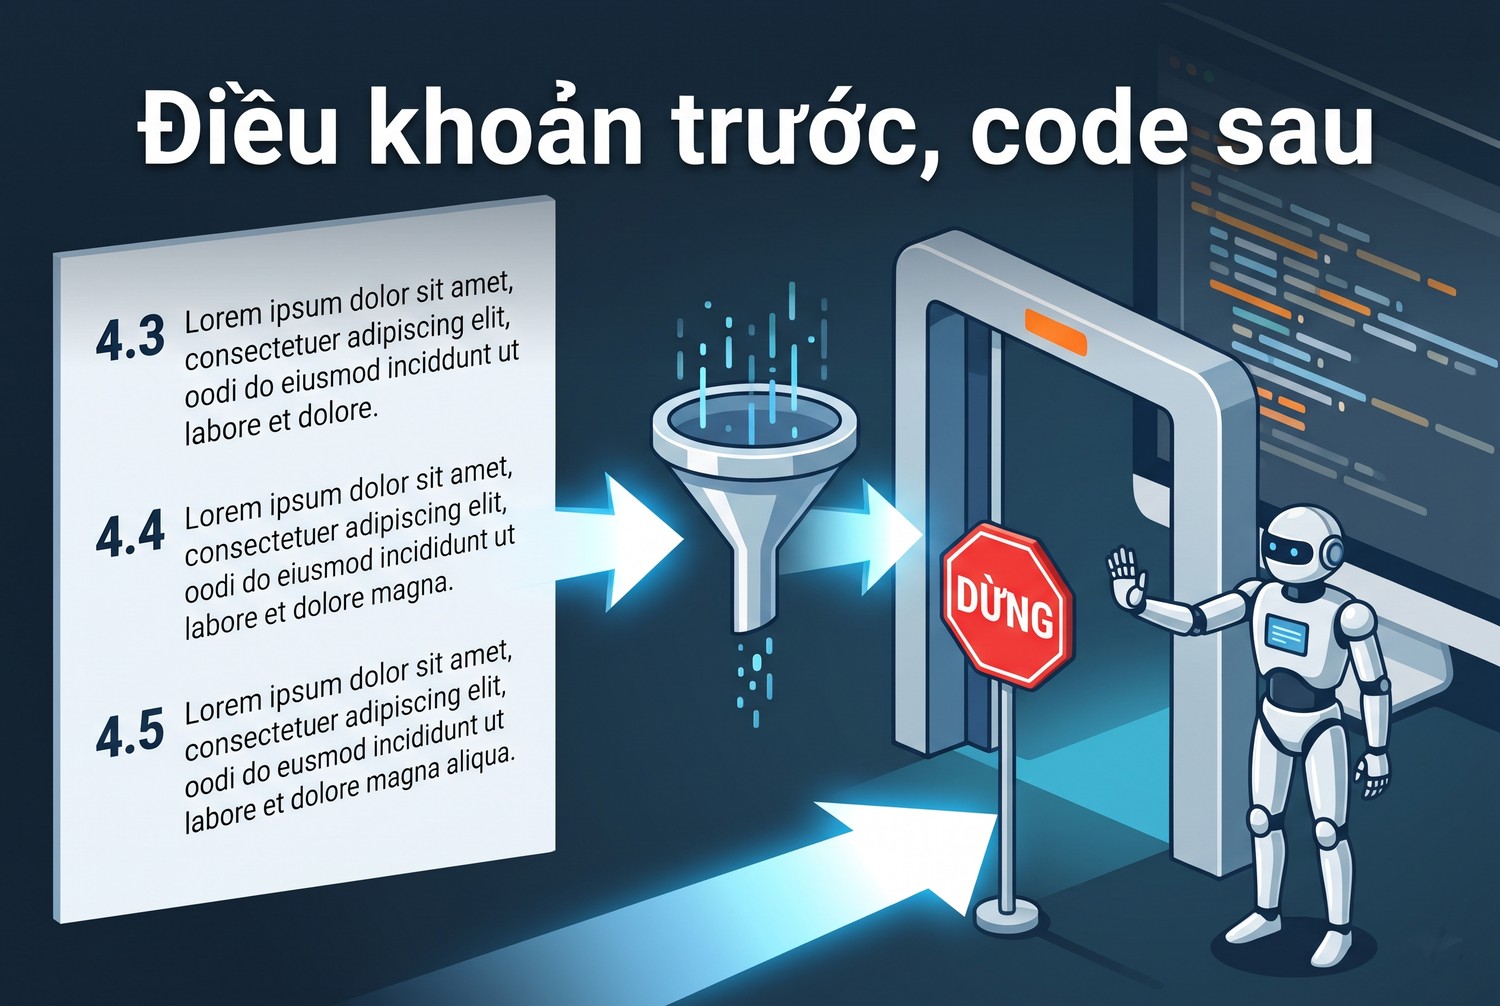
Điều khoản trước, code sau
Mục 4.4: các cách dùng bị hạn chế
Mục 4.4 cấm truy cập, tìm kiếm hoặc thu thập dữ liệu từ Quora, bằng phương tiện tự động hay cách khác, kể cả trí tuệ nhân tạo và học máy, cho bốn mục đích. Thứ nhất là tạo tác phẩm phái sinh từ nội dung của Quora. Thứ hai là huấn luyện hay phát triển AI, mô hình ngôn ngữ lớn hoặc thuật toán học máy. Thứ ba là xây dựng dịch vụ cạnh tranh với Quora. Thứ tư là các mục đích thương mại khác, trừ khi điều khoản cho phép hoặc Quora đồng ý bằng văn bản.
Cũng trong mục này, điều khoản cấm dùng Quora theo cách có thể gây gián đoạn hoặc quá tải nền tảng. Với người viết kịch bản, hai câu này gần như bao trọn những lý do thường gặp khi muốn cào Quora: gom câu trả lời làm nội dung, làm dữ liệu huấn luyện hoặc phục vụ một sản phẩm kinh doanh.
Mục 4.5: quyền crawl chỉ dành cho công cụ tìm kiếm
Mục 4.5 cấp quyền crawl có điều kiện cho đơn vị vận hành công cụ tìm kiếm, và quyền này vẫn chịu các hạn chế ở mục 4.4. Bốn điều kiện đi kèm là dùng header User-Agent mô tả rõ, luôn tuân thủ robots.txt, không làm ảnh hưởng tới hoạt động của nền tảng, và có thông tin liên hệ trong chuỗi User-Agent hoặc trên website của đơn vị.
Kịch bản nghiên cứu của một cá nhân hay một doanh nghiệp nhỏ không thuộc nhóm này. Nghĩa là không có điều khoản nào trao quyền crawl cho anh em, kể cả khi kịch bản chạy chậm, có User-Agent rõ ràng và chỉ đọc vài trang mỗi ngày.
Mục 4.3: giấy phép đăng lại một phần nhỏ
Điểm đáng chú ý nằm ở mục 4.3. Quora cấp cho người dùng giấy phép miễn phí, có thể thu hồi, mang tính cá nhân và không chuyển nhượng, để đăng lại một phần nhỏ của câu trả lời hoặc bài viết ở bất kỳ đâu trên web. Giấy phép đi kèm chín điều kiện, ProxyVN tóm tắt như sau:
- Nội dung được thêm lên Quora sau ngày 22/04/2010.
- Tác giả không đánh dấu nội dung là không cho tái bản.
- Không chỉnh sửa nội dung trích.
- Ghi tên Quora bằng chữ đọc được, kèm thẻ liên kết HTML trỏ về trang gốc trên quora.com, trên mọi trang có trích dẫn.
- Khi Quora hoặc tác giả yêu cầu, bỏ tên tác giả khỏi nội dung mà tác giả đã chuyển sang ẩn danh.
- Khi được yêu cầu, cố gắng cập nhật trích dẫn theo phiên bản mới nhất trên Quora.
- Khi được yêu cầu, cố gắng gỡ nội dung đã bị xoá hoặc đã bị đánh dấu không cho tái bản.
- Không dùng công cụ tự động để gom nội dung hay tạo tác phẩm phái sinh.
- Không dùng nội dung để huấn luyện hay phát triển AI, mô hình ngôn ngữ lớn hoặc thuật toán học máy.
Giấy phép này cũng cấm ngụ ý rằng Quora hay tác giả có liên kết, tài trợ hoặc bảo trợ cho trang của anh em khi chưa có văn bản cho phép. Bảng dưới gom ba mục và hệ quả trực tiếp cho người viết code.
Mục |
Nội dung chính |
Hệ quả cho kịch bản |
|---|---|---|
4.3 |
Đăng lại phần nhỏ, ghi nguồn, xử lý yêu cầu |
Sổ trích dẫn nhập tay, kiểm tra từng điều kiện |
4.4 |
Cấm thu thập cho phái sinh, AI, cạnh tranh, thương mại |
Không cào trang để làm nội dung hay dữ liệu |
4.5 |
Quyền crawl chỉ cho công cụ tìm kiếm |
Kịch bản cá nhân không có quyền crawl |
Kết lại, điều khoản Quora mở đúng một cánh cửa cho người viết: trích phần nhỏ, ghi nguồn đúng cách và chủ động xử lý yêu cầu. Phần lớn code trong bài xoay quanh cánh cửa đó.
Đọc robots.txt trước khi crawl Quora bằng Python
robots.txt không thay thế điều khoản, nhưng là tín hiệu kỹ thuật rõ nhất cho biết nền tảng muốn bot đi tới đâu. ProxyVN tải robots.txt của Quora ngày 23/10/2026, tệp dài 18.962 byte với 831 dòng, chia thành nhiều nhóm theo tên bot.
Quora chặn những gì
Đầu tệp có một đoạn thông báo: mọi crawler và bot, dù có được nêu tên bên dưới hay không, đều bị cấm dùng nội dung Quora để huấn luyện mô hình AI hoặc hệ thống học máy tương tự, trừ khi có thoả thuận cấp phép với Quora. Đơn vị vận hành công cụ tìm kiếm muốn crawl được mời liên hệ qua email.
Nhóm User-agent: * dành cho mọi bot không có tên riêng chỉ cho phép vài đường dẫn: trang chủ, các trang giới thiệu dưới /about, /challenges, /press, trang đăng nhập và trang đăng ký. Ngay sau đó là dòng Disallow: /, chặn mọi đường dẫn còn lại, gồm toàn bộ trang câu hỏi, câu trả lời, hồ sơ và tìm kiếm.
Một số bot có nhóm riêng bị chặn toàn bộ bằng Disallow: /, trong đó có Scrapy, GPTBot, ClaudeBot, PerplexityBot và Bytespider. Các công cụ tìm kiếm như Googlebot có nhóm riêng với danh sách chặn chi tiết hơn, phù hợp với mục 4.5 của điều khoản.
Tệp còn có một đoạn chú thích dài giải thích vì sao Quora chặn bot lưu trữ của Internet Archive. Người viết trên Quora thường chia sẻ quan điểm nhạy cảm, về sau có thể xoá hoặc chuyển câu trả lời sang ẩn danh, và bản lưu trữ sẽ làm lộ danh tính hoặc giữ lại nội dung họ muốn gỡ. Lý do này cũng giải thích vì sao sổ trích dẫn trong bài phải có cơ chế ẩn danh và gỡ bỏ ngay từ đầu.
urllib.robotparser đọc sai ký tự $
Python có sẵn module urllib.robotparser để đọc robots.txt. Khối dưới dùng một bản rút gọn, giữ đúng cấu trúc nhóm User-agent: * và nhóm Scrapy của Quora, rồi hỏi module xem năm đường dẫn có được phép không.
import urllib.robotparser

ROBOTS_SAMPLE = """\
User-agent: Scrapy
Disallow: /

User-agent: *
Allow: /$
Allow: /about$
Allow: /about/
Allow: /press$
Disallow: /
Disallow: /search?q=
"""

PATHS = ["/", "/about", "/about/tos", "/What-is-a-demo-question", "/search?q=proxy"]

def check_urllib(robots_text, agent):
    parser = urllib.robotparser.RobotFileParser()
    parser.parse(robots_text.splitlines())
    return {p: parser.can_fetch(agent, "https://www.quora.com" + p) for p in PATHS}

print("urllib, bot thường:", check_urllib(ROBOTS_SAMPLE, "MyResearchBot/1.0"))
print("urllib, Scrapy    :", check_urllib(ROBOTS_SAMPLE, "Scrapy"))
Kết quả lab trên Python 3.12.10: module trả False cho trang chủ và cho /about, dù robots.txt ghi rõ Allow: /$ và Allow: /about$. Module không hiểu ký tự $ đánh dấu cuối đường dẫn, nên hai dòng Allow này không khớp với đường dẫn nào và dòng Disallow: / quyết định kết quả. Với /about/tos, module trả True vì khớp tiền tố /about/. Trang câu hỏi và trang tìm kiếm đều bị chặn, còn Scrapy bị chặn ở cả năm đường dẫn.
Sai sót này không đổi kết luận với trang câu hỏi, nhưng cho thấy không nên tin module chuẩn khi robots.txt dùng ký tự đại diện. ProxyVN chạy lại khối trên với toàn văn robots.txt tải ngày 23/10/2026 và nhận đúng kết quả như bản rút gọn.
Bộ đọc theo RFC 9309
RFC 9309 quy định ký tự * khớp với chuỗi ký tự bất kỳ, ký tự $ đánh dấu cuối đường dẫn, quy tắc khớp dài nhất được áp dụng, và khi một dòng Allow với một dòng Disallow khớp dài bằng nhau thì Allow thắng. Bot chọn nhóm có tên khớp với tên sản phẩm của nó, không thấy thì dùng nhóm *. Hàm dưới cài đặt các quy tắc đó.
import re

def parse_groups(robots_text):
    groups, agents, rules, last_was_agent = [], [], [], False
    for raw in robots_text.splitlines():
        line = raw.split("#", 1)[0].strip()
        if ":" not in line:
            continue
        key, value = (x.strip() for x in line.split(":", 1))
        key = key.lower()
        if key == "user-agent":
            if agents and not last_was_agent:
                groups.append((agents, rules))
                agents, rules = [], []
            agents.append(value.lower())
            last_was_agent = True
        elif key in ("allow", "disallow"):
            rules.append((key, value))
            last_was_agent = False
    if agents:
        groups.append((agents, rules))
    return groups

def rule_regex(path):
    anchored = path.endswith("$")
    body = re.escape(path[:-1] if anchored else path).replace(r"\*", ".*")
    return re.compile(body + ("$" if anchored else ""))

def pick_rules(groups, agent):
    token = agent.split("/", 1)[0].lower()
    named = [rules for names, rules in groups if token in names]
    chosen = named or [rules for names, rules in groups if "*" in names]
    return [rule for rules in chosen for rule in rules]

def allowed(robots_text, agent, path):
    best_len, verdict = -1, True
    for kind, rule_path in pick_rules(parse_groups(robots_text), agent):
        if rule_path and rule_regex(rule_path).match(path):
            if len(rule_path) > best_len or (len(rule_path) == best_len and kind == "allow"):
                best_len, verdict = len(rule_path), kind == "allow"
    return verdict

for agent in ["MyResearchBot/1.0", "Scrapy"]:
    print("RFC 9309,", agent, {p: allowed(ROBOTS_SAMPLE, agent, p) for p in PATHS})
Với bộ đọc mới, bot không có tên riêng được phép ở /, /about và /about/tos, bị chặn ở trang câu hỏi và trang tìm kiếm. Scrapy vẫn bị chặn ở mọi nơi. ProxyVN chạy thêm hàm allowed với toàn văn robots.txt thật: nhóm * bị chặn ở trang câu hỏi, Googlebot được phép, đúng như phân tích ở phần trên.
Hàm này đủ cho việc kiểm tra một tệp đã tải về. Nó chưa xử lý mã hoá phần trăm trong đường dẫn và các trường hợp đặc biệt khác của chuẩn, nên chỉ dùng để tham khảo, không thay thế việc đọc điều khoản.
Tóm lại, robots.txt của Quora chặn mọi trang nội dung với bot không có tên riêng, và anh em cần bộ đọc theo RFC 9309 nếu muốn kiểm tra chính xác những dòng có ký tự đại diện.
Chuẩn bị môi trường cho crawl Quora bằng Python
Lab dùng Python 3.12 với các module có sẵn: csv, sqlite3, html, hashlib và urllib.parse. Thư viện Requests chỉ cần khi anh em tải robots.txt hoặc tệp dữ liệu công khai, không dùng để tải trang Quora.
Cài đặt
Các lệnh dưới tạo môi trường ảo trên Windows, cài Requests và khai báo biến môi trường cho proxy nếu mạng của anh em bắt buộc đi qua proxy.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install requests
$env:PROXY_URL = 'http://user:pass@host:port'
Khi ProxyVN dựng lab, phiên bản là Python 3.12.10 và Requests 2.34.2. Biến PROXY_URL có thể bỏ trống; phần cuối bài nói rõ khi nào cần tới nó.
Dữ liệu đầu vào nhập tay
Đầu vào của sổ trích dẫn là một tệp CSV do người viết điền khi đọc Quora trên trình duyệt. Mỗi dòng là một đoạn trích định dùng trong một bài cụ thể. Người viết tự chép đoạn trích, tự xem ngày đăng và tự kiểm tra tác giả có đánh dấu không cho tái bản hay không.
Việc nhập tay là chủ ý, không phải hạn chế kỹ thuật. Một điều kiện của giấy phép ở mục 4.3 cấm dùng công cụ tự động để gom nội dung, nên phần chọn và chép phải do người làm. Python chỉ kiểm tra, lưu và nhắc việc. Tệp CSV có năm cột:
- url: đường dẫn trang chứa câu trả lời, chép từ thanh địa chỉ của trình duyệt.
- excerpt: đoạn trích nguyên văn, không sửa chữ, không chèn dấu ba chấm vào giữa câu.
- posted_on: ngày đăng hiển thị trên trang, ghi theo dạng năm-tháng-ngày.
- not_for_reproduction: ghi yes nếu thấy tác giả đánh dấu không cho tái bản, ghi no nếu không thấy.
- used_in: slug của bài viết sẽ đặt trích dẫn.
Khối dưới tạo tám dòng mẫu và ghi ra dạng CSV giống tệp người viết điền.
import csv
import io

ROWS = [
    ("https://www.quora.com/What-is-a-demo-question/answer/Demo-Writer",
     "Latency depends more on the route than on the advertised speed.",
     "2023-05-14", "no", "bai-do-tre-proxy"),
    ("https://WWW.Quora.com/What-is-a-demo-question/answer/Demo-Writer/?share=1",
     "Latency depends more on the route than on the advertised speed.",
     "2023-05-14", "no", "bai-do-tre-proxy"),
    ("https://www.quora.com/How-should-a-small-team-log-network-changes/answer/Second-Demo",
     "We wrote every change into one shared sheet before touching the router.",
     "2021-09-03", "no", "bai-quan-ly-ip"),
    ("https://quora.com/Why-do-demo-servers-time-out/answer/Third-Demo",
     "Most of our timeouts came from DNS, not from the server itself.",
     "2024-02-10", "no", "bai-loi-timeout"),
    ("https://www.quora.com/Is-this-a-demo-question-from-2009/answer/Fourth-Demo",
     "An old answer written before the license date.", "2009-11-02", "no", "bai-loi-timeout"),
    ("https://www.quora.com/How-do-teams-share-a-demo-IP/answer/Fifth-Demo",
     "We kept one fixed IP per shared account.", "2024-06-01", "yes", "bai-ip-tinh"),
    ("https://example.com/forum/thread/42", "Not from Quora at all.", "2024-01-01", "no", "bai-ip-tinh"),
    ("https://www.quora.com/What-makes-a-demo-proxy-stable/answer/Sixth-Demo",
     "Stability came from boring habits. We tested each address before every session, "
     "wrote the result down, never shared one address between two people, checked the "
     "exit country every morning, replaced any address that failed twice in a row and "
     "kept notes for every change so the next person could follow the same steps "
     "without asking anyone (more)", "2025-08-30", "no", "bai-proxy-on-dinh"),
]

buf = io.StringIO()
writer = csv.writer(buf, lineterminator="\n")
writer.writerow(["url", "excerpt", "posted_on", "not_for_reproduction", "used_in"])
writer.writerows(ROWS)
SAMPLE_CSV = buf.getvalue()
print(SAMPLE_CSV.splitlines()[0])
print("Số dòng dữ liệu:", len(SAMPLE_CSV.splitlines()) - 1)
Tám dòng mẫu mô phỏng những tình huống hay gặp: hai dòng cùng một trích dẫn nhưng URL khác nhau ở tham số share, chữ hoa và dấu gạch chéo cuối, một nội dung đăng năm 2009, một nội dung bị đánh dấu không cho tái bản, một đường dẫn không thuộc Quora và một đoạn trích quá dài chép từ bản xem trước bị cắt. Toàn bộ URL và đoạn trích là giả lập, không lấy từ Quora.
Tóm lại, môi trường lab chỉ gồm thư viện chuẩn, Requests cho phần tải tệp công khai và một CSV do người viết tự điền.
Sổ trích dẫn khi crawl Quora bằng Python
Phần này là ví dụ triển khai do ProxyVN viết, đã chạy với dữ liệu mẫu ở trên. Sổ trích dẫn gồm hàm chuẩn hoá URL, hàm kiểm tra điều kiện và hai bảng SQLite: một bảng lưu những trích dẫn đạt yêu cầu, một bảng ghi các yêu cầu nhận được về sau.
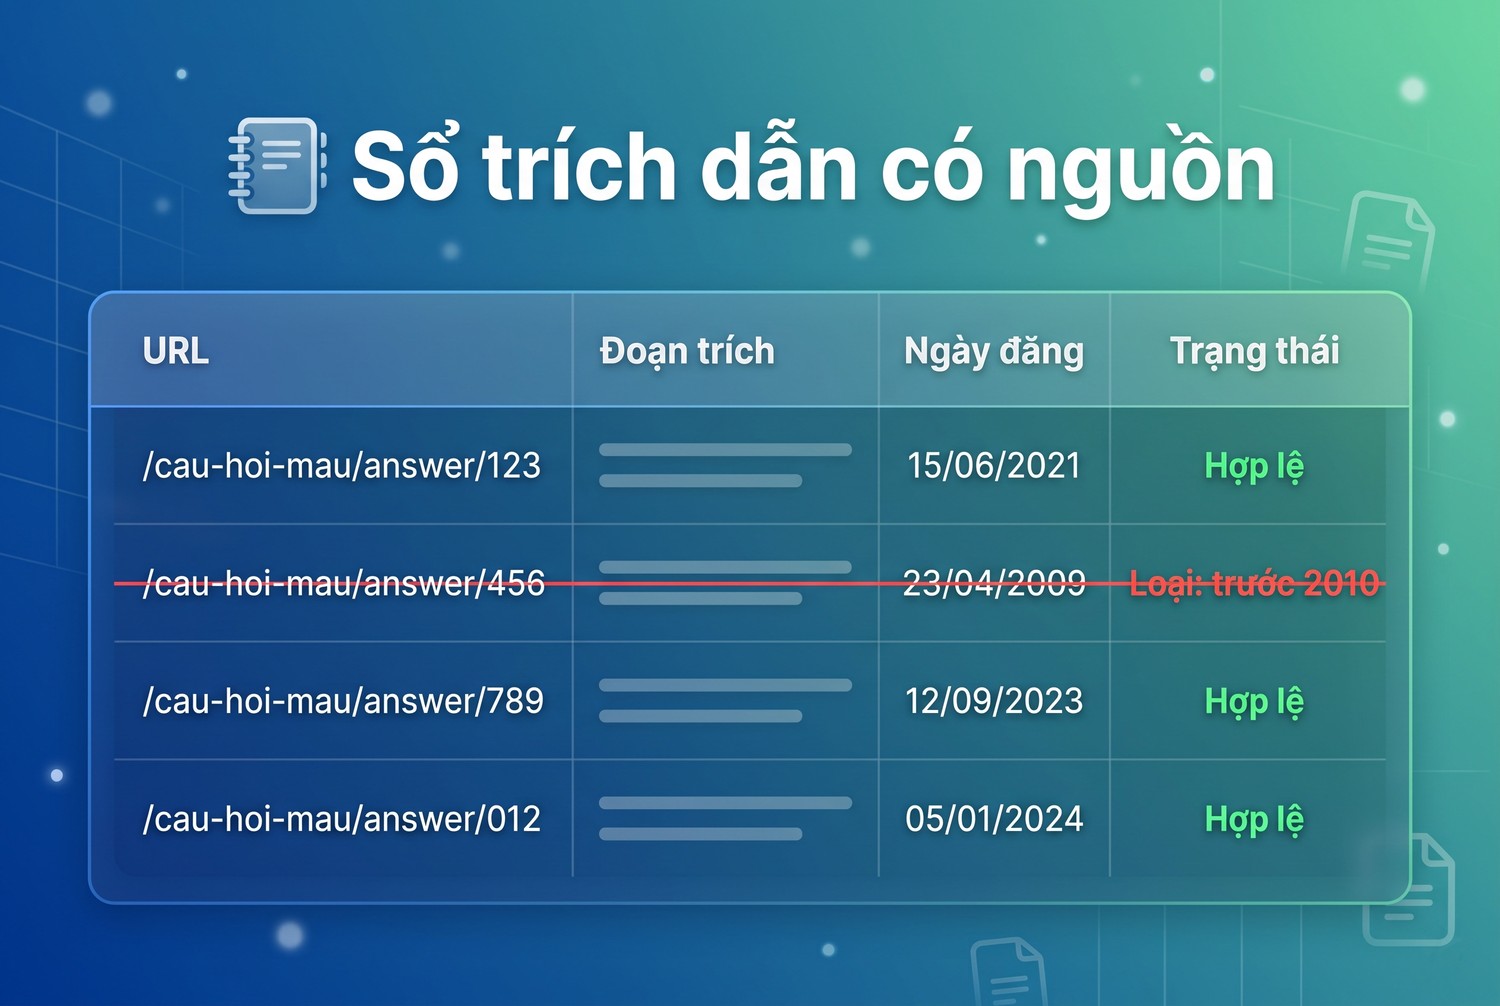
Sổ trích dẫn có nguồn
Chuẩn hoá URL Quora
Cùng một câu trả lời có thể mang nhiều URL: có hoặc không có www, thêm tham số share=1 khi người dùng bấm chia sẻ, thêm dấu gạch chéo cuối, viết hoa tên miền. Hàm normalize_quora_url đưa mọi biến thể về một dạng, bỏ phần truy vấn và phần neo, để việc chống trùng không bị đánh lừa bởi những khác biệt vô nghĩa này.
Hàm question_url tách phần /answer/ khỏi đường dẫn câu trả lời để lấy URL câu hỏi. Đường dẫn câu trả lời thường chứa tên hiển thị của tác giả, nên URL câu hỏi là phương án thay thế khi tác giả chuyển sang ẩn danh. Hàm check_row trả về bản ghi đã chuẩn hoá cùng danh sách vấn đề; danh sách rỗng nghĩa là dòng đạt.
import hashlib
from datetime import date
from urllib.parse import urlsplit, urlunsplit

LICENSE_START = date(2010, 4, 22)
MAX_WORDS, MAX_CHARS = 50, 320

def normalize_quora_url(url):
    parts = urlsplit(url.strip())
    host = (parts.hostname or "").lower()
    if host != "quora.com" and not host.endswith(".quora.com"):
        raise ValueError("không phải tên miền Quora")
    if host == "quora.com":
        host = "www.quora.com"
    path = parts.path.rstrip("/") or "/"
    return urlunsplit(("https", host, path, "", ""))

def question_url(url):
    parts = urlsplit(url)
    return urlunsplit((parts.scheme, parts.netloc, parts.path.split("/answer/", 1)[0], "", ""))

def check_row(row):
    try:
        url = normalize_quora_url(row["url"])
    except ValueError as err:
        return None, [str(err)]
    problems = []
    excerpt = row["excerpt"].strip()
    if len(excerpt.split()) > MAX_WORDS or len(excerpt) > MAX_CHARS:
        problems.append(f"đoạn trích {len(excerpt.split())} từ, vượt quy ước nội bộ")
    if excerpt.endswith("(more)") or "Continue Reading" in excerpt:
        problems.append("chép từ bản xem trước bị cắt")
    posted = date.fromisoformat(row["posted_on"].strip())
    if posted <= LICENSE_START:
        problems.append("đăng trước hoặc đúng 22/04/2010")
    if row["not_for_reproduction"].strip().lower() == "yes":
        problems.append("tác giả không cho tái bản")
    record = {"url": url, "question_url": question_url(url),
              "kind": "answer" if "/answer/" in url else "other", "excerpt": excerpt,
              "excerpt_sha": hashlib.sha256(excerpt.encode("utf-8")).hexdigest()[:16],
              "posted_on": posted.isoformat(), "used_in": row["used_in"].strip()}
    return record, problems
Ngưỡng tối đa 50 từ và 320 ký tự là quy ước nội bộ ProxyVN đặt ra. Điều khoản chỉ ghi "một phần nhỏ", không ghi con số, nên anh em có thể đặt ngưỡng chặt hơn tuỳ chính sách biên tập. Mốc 22/04/2010 lấy từ điều kiện đầu tiên của giấy phép; nội dung đăng đúng ngày đó cũng bị loại vì điều khoản ghi "sau" ngày này.
Hàm không cắt đoạn trích dài cho vừa ngưỡng. Cắt bớt là một kiểu chỉnh sửa, và người viết nên tự chọn lại câu cần trích thay vì để code quyết định.
Lưu vào SQLite và chạy mẫu
Bảng citations có ràng buộc UNIQUE trên bộ ba URL, mã băm đoạn trích và slug bài. Một trích dẫn dùng cho hai bài khác nhau được lưu thành hai dòng, vì khi có yêu cầu gỡ, anh em cần biết phải sửa những bài nào. Bảng requests ghi lại mọi yêu cầu nhận được cùng nguồn và ngày nhận.
import sqlite3

def open_ledger(path="quora_citations.db"):
    con = sqlite3.connect(path)
    con.execute("""CREATE TABLE IF NOT EXISTS citations (
        id INTEGER PRIMARY KEY, url TEXT, question_url TEXT, kind TEXT, excerpt TEXT,
        excerpt_sha TEXT, posted_on TEXT, used_in TEXT, accessed_on TEXT,
        status TEXT DEFAULT 'active', updated_at TEXT, UNIQUE (url, excerpt_sha, used_in))""")
    con.execute("""CREATE TABLE IF NOT EXISTS requests (
        citation_id INTEGER, action TEXT, source TEXT, received_at TEXT, note TEXT)""")
    return con

def import_csv(con, text, accessed_on):
    report = {"saved": 0, "duplicate": 0, "rejected": []}
    for row in csv.DictReader(io.StringIO(text)):
        record, problems = check_row(row)
        if problems:
            report["rejected"].append((row["url"][:48], problems))
            continue
        cur = con.execute("""INSERT OR IGNORE INTO citations (url, question_url, kind, excerpt,
            excerpt_sha, posted_on, used_in, accessed_on, updated_at)
            VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?)""",
            (record["url"], record["question_url"], record["kind"], record["excerpt"],
             record["excerpt_sha"], record["posted_on"], record["used_in"],
             accessed_on, accessed_on))
        report["saved" if cur.rowcount else "duplicate"] += 1
    con.commit()
    return report

con = open_ledger(":memory:")
report = import_csv(con, SAMPLE_CSV, "2026-10-23")
print("Lưu:", report["saved"], "| Trùng:", report["duplicate"])
for url, problems in report["rejected"]:
    print("Loại:", url, "->", "; ".join(problems))
Kết quả lab: 3 trích dẫn được lưu, 1 dòng trùng, 4 dòng bị loại. Dòng trùng là biến thể có tham số share, chữ hoa và dấu gạch chéo cuối, sau chuẩn hoá trở thành cùng URL với dòng đầu. Bốn dòng bị loại lần lượt vì đăng năm 2009, vì tác giả đánh dấu không cho tái bản, vì không thuộc tên miền Quora, và vì đoạn trích vừa dài 57 từ vừa kết thúc bằng dấu hiệu bản xem trước. Dòng có tên miền quora.com không có www vẫn được lưu bình thường dưới dạng www.quora.com.
Trong thực tế, người viết nhận báo cáo này ngay sau khi lưu CSV, sửa những dòng bị loại rồi chạy lại. Vì có ràng buộc UNIQUE, chạy lại nhiều lần không tạo dòng trùng.
Sổ trích dẫn không lưu tên tác giả thành cột riêng, không lưu hồ sơ, không lưu số lượt upvote hay số người theo dõi. Tóm lại, sổ trích dẫn biến các điều kiện của giấy phép thành những phép kiểm tra cụ thể, chạy trước khi bất kỳ đoạn trích nào xuất hiện trên bài.
Đăng trích dẫn đúng điều kiện khi crawl Quora bằng Python
Lưu đúng mới là nửa việc. Nửa còn lại là hiển thị trích dẫn trên bài theo đúng cách ghi nguồn mà giấy phép yêu cầu, và xử lý các yêu cầu ẩn danh, cập nhật, gỡ bỏ khi chúng tới.
Mẫu HTML ghi nguồn
Giấy phép yêu cầu ghi tên Quora bằng chữ đọc được và có thẻ a trỏ về trang gốc, trên mọi trang có trích dẫn. Hàm render_citation tạo khối trích dẫn và dòng ghi nguồn, dùng html.escape để đoạn trích có ký tự đặc biệt không làm hỏng HTML của bài.
import html

def render_citation(url, excerpt):
    return ("<blockquote>" + html.escape(excerpt) + "</blockquote>\n"
            '<p>Nguồn: một câu trả lời trên <a href="' + html.escape(url, quote=True)
            + '">Quora</a>.</p>')

url, excerpt = con.execute(
    "SELECT url, excerpt FROM citations WHERE status = 'active' ORDER BY id LIMIT 1").fetchone()
print(render_citation(url, excerpt))
Đầu ra là một thẻ blockquote chứa đoạn trích nguyên văn và một đoạn ghi nguồn có chữ Quora nằm trong thẻ a trỏ về URL đã chuẩn hoá. Khi đăng lên blog, anh em giữ nguyên khối này, không thêm câu nào ngụ ý Quora hay tác giả bảo trợ cho bài, và không dịch đoạn trích sang tiếng Việt ngay trong khối trích dẫn. Muốn giải thích bằng tiếng Việt thì viết thành đoạn riêng bên dưới, bằng lời của mình.
Xử lý yêu cầu ẩn danh, cập nhật và gỡ bỏ
Hàm apply_request ghi yêu cầu vào bảng requests rồi đổi trạng thái trích dẫn theo loại yêu cầu. Hàm trả về slug bài cần đăng lại, để biên tập viên biết phải sửa ở đâu. Ba loại yêu cầu được xử lý như sau:
- anonymize: thay URL câu trả lời bằng URL câu hỏi, bỏ phần đường dẫn có tên tác giả.
- update: đánh dấu needs_update; người viết mở trang gốc và chép lại đoạn trích mới bằng tay.
- delete: xoá nội dung đoạn trích, giữ lại dòng với trạng thái removed để còn lịch sử.
def apply_request(con, citation_id, action, source, received_at, note=""):
    con.execute("INSERT INTO requests VALUES (?, ?, ?, ?, ?)",
                (citation_id, action, source, received_at, note))
    if action == "anonymize":
        con.execute("UPDATE citations SET url = question_url, updated_at = ? WHERE id = ?",
                    (received_at, citation_id))
    elif action == "update":
        con.execute("UPDATE citations SET status = 'needs_update', updated_at = ? WHERE id = ?",
                    (received_at, citation_id))
    elif action == "delete":
        con.execute("UPDATE citations SET status = 'removed', excerpt = '', updated_at = ? "
                    "WHERE id = ?", (received_at, citation_id))
    con.commit()
    return [r[0] for r in con.execute("SELECT used_in FROM citations WHERE id = ?", (citation_id,))]

print("Cần đăng lại:", apply_request(con, 1, "anonymize", "tác giả", "2026-11-02"))
print("Cần đăng lại:", apply_request(con, 2, "delete", "quora", "2026-11-05"))
for row in con.execute("SELECT id, url, status, length(excerpt) FROM citations ORDER BY id"):
    print(row)
Lab mô phỏng hai yêu cầu. Yêu cầu ẩn danh cho trích dẫn số 1 đổi URL về dạng câu hỏi, không còn đoạn /answer/Demo-Writer. Yêu cầu gỡ cho trích dẫn số 2 làm rỗng đoạn trích, trạng thái chuyển sang removed. Mỗi lần, hàm in slug bài cần đăng lại, lần lượt là bai-do-tre-proxy và bai-quan-ly-ip.
Sau khi chạy hàm, biên tập viên mở bài tương ứng trong trang quản trị, thay khối trích dẫn cũ bằng khối mới do render_citation tạo, hoặc xoá khối nếu trích dẫn đã bị gỡ. Bước này làm tay để người biên tập đọc lại đoạn văn xung quanh, tránh để lại câu dẫn nhập trỏ tới một trích dẫn không còn.
Lịch soát lại định kỳ
Nhiều thay đổi không tới dưới dạng email mà thể hiện ngay trên Quora: tác giả xoá câu trả lời, sửa nội dung hoặc chuyển sang ẩn danh. Hàm due_for_review liệt kê trích dẫn chưa được xem lại trong 90 ngày, để người viết mở từng trang gốc kiểm tra bằng tay.
from datetime import timedelta

def due_for_review(con, today, every_days=90):
    cutoff = (today - timedelta(days=every_days)).isoformat()
    return con.execute("""SELECT id, url, used_in FROM citations
        WHERE status != 'removed' AND updated_at <= ? ORDER BY updated_at""",
        (cutoff,)).fetchall()

for row in due_for_review(con, date(2027, 2, 1)):
    print("Soát lại:", row)
Với ngày giả lập 01/02/2027, hàm liệt kê hai trích dẫn còn hiệu lực có lần cập nhật cuối trước 03/11/2026, trích dẫn đã gỡ không xuất hiện. Chu kỳ 90 ngày là đề xuất ban đầu; bài có lưu lượng cao hoặc trích dẫn về chủ đề nhạy cảm nên soát dày hơn. Sau mỗi lần soát, người viết cập nhật updated_at để dòng đó rời khỏi danh sách.
Tóm lại, đăng trích dẫn đúng điều kiện gồm khối HTML ghi nguồn chuẩn, bảng ghi yêu cầu và lịch soát lại, cả ba đều có người làm ở bước cuối.
Dữ liệu mở thay cho crawl Quora bằng Python
Nếu mục tiêu là dữ liệu cho mô hình xử lý ngôn ngữ, có một nguồn do chính Quora phát hành: bộ cặp câu hỏi trùng, công bố trên blog Data @ Quora. Đây là đường hợp lệ duy nhất ProxyVN tìm được để có dữ liệu Quora số lượng lớn; ProxyVN không tìm thấy tài liệu API công khai nào của Quora cho việc đọc câu hỏi và câu trả lời khi tra cứu ngày 23/10/2026.
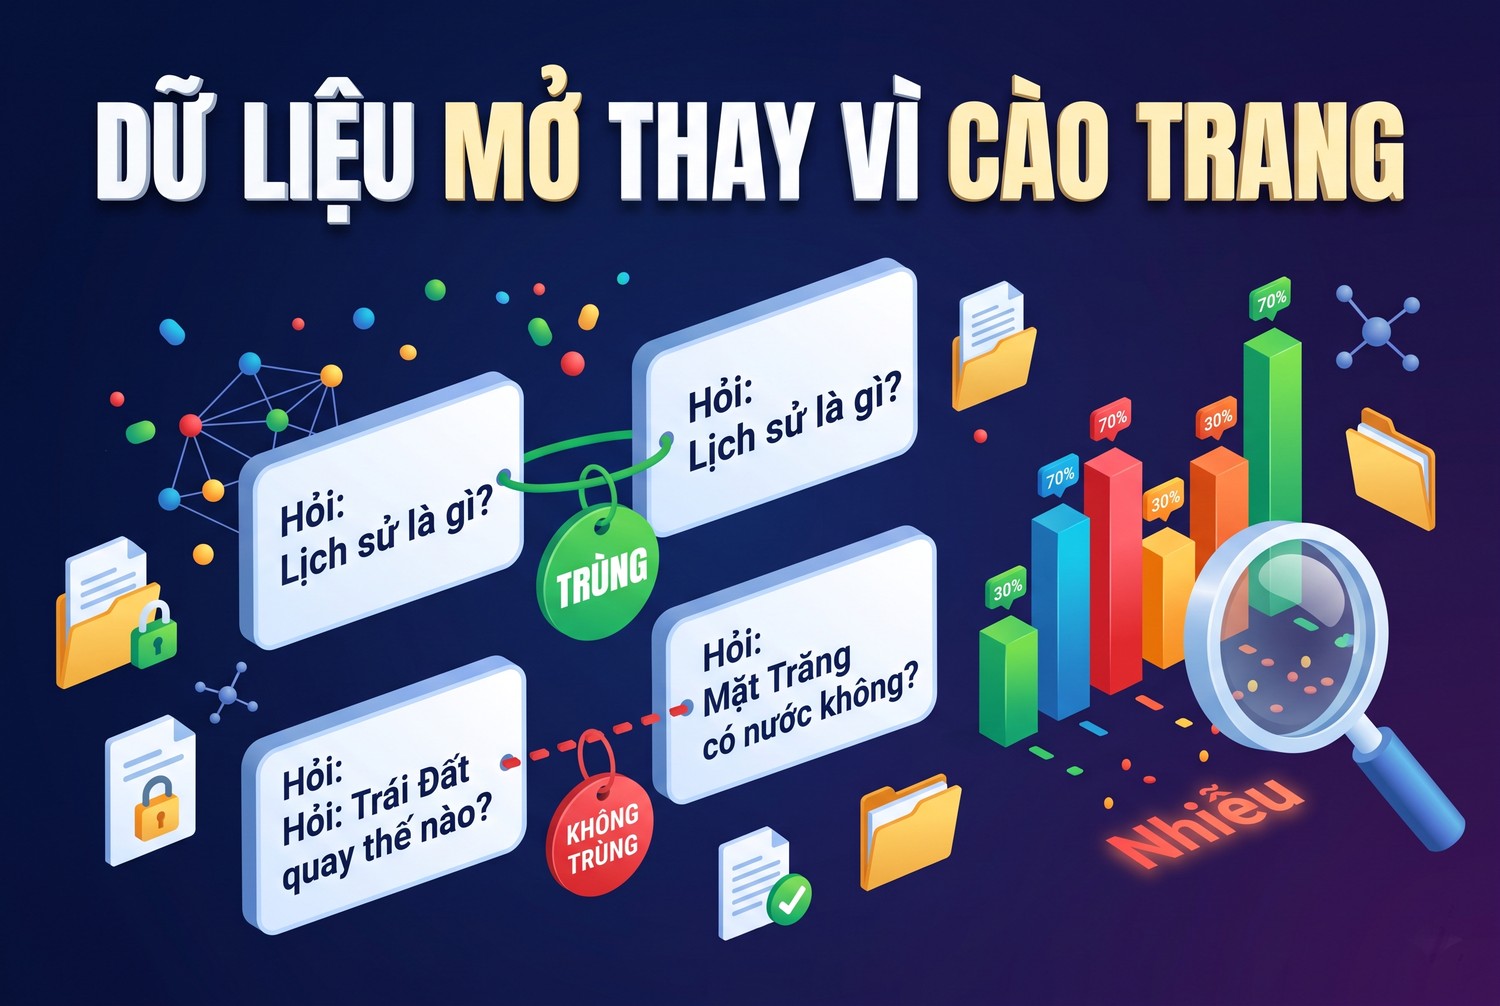
Dữ liệu mở thay vì cào trang
Bộ Question Pairs gồm gì
Theo bài công bố, bộ dữ liệu có hơn 400.000 dòng, mỗi dòng gồm mã của hai câu hỏi, toàn văn hai câu hỏi và một giá trị nhị phân cho biết cặp đó có thật sự trùng nghĩa không. Quora phát hành bộ này để cộng đồng huấn luyện và thử mô hình nhận diện câu hỏi trùng nghĩa, bài toán mà chính Quora gặp khi muốn mỗi câu hỏi chỉ có một trang.
Bài công bố nêu ba lưu ý. Quora đã bổ sung ví dụ không trùng, một phần lấy từ các cặp câu hỏi liên quan, vì cách lấy mẫu ban đầu cho ra quá nhiều cặp trùng. Phân bố câu hỏi không đại diện cho toàn bộ câu hỏi trên Quora, một phần do đã lọc bỏ câu hỏi có phần chi tiết quá dài. Nhãn có nhiễu, không bảo đảm đúng ở mọi dòng.
Về quyền dùng, bài công bố ghi bộ dữ liệu tuân theo điều khoản dịch vụ của Quora và cho phép dùng phi thương mại. Dự án thương mại cần liên hệ Quora trước. ProxyVN không tư vấn pháp lý; anh em đọc cả bài công bố lẫn điều khoản rồi tự đánh giá cho dự án của mình.
Kiểm tra tệp trước khi tải
Ngày 23/10/2026, ProxyVN gửi yêu cầu HEAD tới đường dẫn tệp trong bài công bố. Đường dẫn http chuyển hướng 301 sang https, máy chủ trả 200 với tệp dạng text/tab-separated-values dài 58.176.133 byte, Last-Modified ngày 06/03/2017. Đọc dòng đầu bằng một yêu cầu Range nhỏ cho thấy sáu cột: id, qid1, qid2, question1, question2, is_duplicate. ProxyVN không tải toàn bộ tệp trong lúc viết bài.
Hàm download_dataset dưới tải tệp theo luồng và so số byte nhận được với Content-Length, tránh trường hợp mạng đứt giữa chừng mà tệp thiếu vẫn được đem đi dùng. Session tắt trust_env để cấu hình proxy rõ ràng, và hàm masked che mật khẩu proxy trước khi ghi log.
import os
import requests

def make_session(proxy_url=None):
    session = requests.Session()
    session.trust_env = False
    session.headers["User-Agent"] = "dataset-download/1.0"
    if proxy_url:
        session.proxies = {"http": proxy_url, "https": proxy_url}
    return session

def masked(proxy_url):
    parts = urlsplit(proxy_url)
    if parts.password:
        return proxy_url.replace(":" + parts.password + "@", ":***@")
    return proxy_url

def download_dataset(session, dest="quora_duplicate_questions.tsv",
                     url="https://qim.fs.quoracdn.net/quora_duplicate_questions.tsv"):
    with session.get(url, stream=True, timeout=(10, 60)) as r:
        r.raise_for_status()
        expected = int(r.headers.get("Content-Length", 0))
        size = 0
        with open(dest, "wb") as f:
            for chunk in r.iter_content(1 << 16):
                f.write(chunk)
                size += len(chunk)
    if expected and size != expected:
        os.remove(dest)
        raise IOError(f"tải thiếu: {size}/{expected} byte")
    return size

session = make_session(os.environ.get("PROXY_URL"))
print("Có proxy:", bool(session.proxies))
print("Log:", masked("http://user:secret@203.0.113.10:8080"))
Trong lab, PROXY_URL để trống nên session đi trực tiếp, và hàm masked in chuỗi proxy mẫu với mật khẩu đã thay bằng dấu sao. Khi chạy thật, anh em gọi download_dataset(session) một lần, giữ tệp ở máy và không tải lại mỗi lần phân tích.
Thống kê và tìm nhãn đáng ngờ
Hàm profile_pairs đọc tệp TSV, đếm số cặp, tỉ lệ cặp trùng, số câu hỏi khác nhau, rồi liệt kê cặp có nhãn đáng ngờ theo hai quy tắc: chữ giống hệt sau chuẩn hoá nhưng nhãn 0, hoặc nhãn 1 nhưng độ trùng từ Jaccard dưới 0,2. Dữ liệu mẫu dưới là câu hỏi ProxyVN tự viết theo đúng sáu cột của tệp thật.
DATA_SAMPLE = "id\tqid1\tqid2\tquestion1\tquestion2\tis_duplicate\n" + "\n".join([
    "0\t1\t2\tHow do I learn Python fast?\tWhat is the fastest way to learn Python?\t1",
    "1\t3\t4\tWhat is a proxy server?\tWhat is a proxy server ?\t0",
    "2\t5\t6\tHow to cook rice?\tWhich laptop is best for students?\t0",
    "3\t1\t7\tHow do I learn Python fast?\tIs Python hard to learn for beginners?\t0",
    "4\t8\t9\tWhy is the sky blue?\tWhy does the sky look blue?\t1",
    "5\t10\t11\tWhat is DNS?\tHow does a VPN work?\t1",
]) + "\n"

def norm_q(text):
    return " ".join(re.sub(r"[^\w\s]", " ", text.lower()).split())

def jaccard(a, b):
    sa, sb = set(norm_q(a).split()), set(norm_q(b).split())
    return len(sa & sb) / len(sa | sb) if sa | sb else 0.0

def profile_pairs(tsv_text):
    rows = list(csv.DictReader(io.StringIO(tsv_text), delimiter="\t"))
    dup = sum(r["is_duplicate"] == "1" for r in rows)
    qids = {r["qid1"] for r in rows} | {r["qid2"] for r in rows}
    suspects = []
    for r in rows:
        score = jaccard(r["question1"], r["question2"])
        if norm_q(r["question1"]) == norm_q(r["question2"]) and r["is_duplicate"] == "0":
            suspects.append((r["id"], "trùng chữ nhưng nhãn 0"))
        elif r["is_duplicate"] == "1" and score < 0.2:
            suspects.append((r["id"], f"nhãn 1 nhưng Jaccard {score:.2f}"))
    return {"pairs": len(rows), "duplicate_ratio": round(dup / len(rows), 3),
            "unique_questions": len(qids), "suspects": suspects}

print(profile_pairs(DATA_SAMPLE))
Kết quả lab: 6 cặp, tỉ lệ trùng 0,5, 11 câu hỏi khác nhau, 3 cặp đáng ngờ. Cặp số 1 chỉ khác nhau một dấu cách trước dấu hỏi nhưng mang nhãn 0, đúng kiểu nhiễu mà bài công bố cảnh báo. Cặp số 5 có nhãn 1 dù hai câu hỏi về DNS và VPN không liên quan. Cặp số 0 cũng bị liệt kê với Jaccard 0,17 dù hai câu đúng là cùng ý: Jaccard chỉ đếm từ chung nên không nhận ra cách diễn đạt khác.
Ví dụ cuối cho thấy danh sách đáng ngờ là danh sách để người xem lại, không phải danh sách để tự động sửa nhãn. Với tệp thật hơn 400.000 dòng, anh em lấy mẫu vài trăm cặp trong danh sách này để ước lượng tỉ lệ nhiễu trước khi chia tập huấn luyện và tập kiểm tra.
Một lưu ý khi chia tập: cùng một câu hỏi có thể xuất hiện trong nhiều cặp, như câu hỏi mã 1 trong dữ liệu mẫu. Nếu chia ngẫu nhiên theo cặp, câu hỏi đó có thể nằm ở cả tập huấn luyện lẫn tập kiểm tra, làm điểm đánh giá cao hơn thực tế. Chia theo nhóm câu hỏi giúp tránh rò rỉ này.
Tóm lại, bộ Question Pairs là nguồn dữ liệu Quora hợp lệ cho nghiên cứu phi thương mại, với điều kiện kiểm tra tệp khi tải, soát nhãn nhiễu và chia tập cẩn thận.
Xử lý lỗi khi crawl Quora bằng Python
Lỗi trong dự án này ít đến từ máy chủ và nhiều đến từ dữ liệu nhập tay. Danh sách dưới gom những lỗi ProxyVN gặp hoặc dự đoán được khi chạy sổ trích dẫn và tải tệp dữ liệu.
Lỗi dữ liệu nhập tay
Mỗi dòng ghi một lỗi và cách sửa. Phần lớn có thể bắt bằng hàm check_row, phần còn lại cần người viết để ý khi chép.
- CSV mở bằng Excel rồi lưu lại có thể thêm ký tự BOM ở đầu tệp, làm tên cột đầu tiên thành url; đọc tệp bằng encoding utf-8-sig.
- Ngày đăng hiển thị dạng tương đối như vài năm trước không đổi được sang ngày cụ thể; người viết bấm vào mốc thời gian trên trang để xem ngày, không xác định được ngày thì không trích.
- Đoạn trích kết thúc bằng (more) hoặc Continue Reading là chép từ bản xem trước; mở câu trả lời đầy đủ rồi chép lại.
- Dấu ngoặc kép cong và dấu cách không ngắt làm mã băm khác nhau giữa hai lần chép cùng một câu; nếu thấy trùng bị lọt, chuẩn hoá khoảng trắng trước khi băm nhưng vẫn lưu nguyên văn.
- URL rút gọn hoặc URL chia sẻ từ ứng dụng điện thoại cần mở ra trình duyệt để lấy URL đầy đủ trước khi nhập.
Lỗi khi tải tệp
Phần tải chỉ áp dụng cho robots.txt và tệp dữ liệu công khai. Ba tình huống dưới là những gì ProxyVN ghi nhận khi kiểm tra ngày 23/10/2026.
- 301 khi gọi đường dẫn http của tệp dữ liệu: Requests tự theo chuyển hướng sang https, ghi URL cuối cùng vào log.
- Tải thiếu byte: hàm download_dataset xoá tệp dở và báo lỗi, chạy lại khi mạng ổn định.
- 403 từ quora.com: khi ProxyVN thử đọc trang điều khoản bằng công cụ tải tự động, máy chủ trả 403, trong khi mở bằng trình duyệt thì đọc bình thường. Gặp 403 với kịch bản thì dừng, không đổi User-Agent hay IP để thử lại.
Ghi log có ích
Mỗi lần nhập CSV, ghi số dòng lưu, trùng, loại và lý do loại. Mỗi yêu cầu ẩn danh, cập nhật hay gỡ được lưu trong bảng requests với nguồn và ngày nhận. Khi có tranh chấp về một trích dẫn, log này cho biết anh em đã làm gì và vào lúc nào. Log tải tệp ghi URL, mã trạng thái, số byte và proxy đã che mật khẩu.
Tóm lại, xử lý lỗi trong dự án Quora chủ yếu là giữ dữ liệu nhập tay sạch và dừng đúng lúc khi máy chủ từ chối.
Khi nào cần proxy cho crawl Quora bằng Python
Điều khoản và robots.txt của Quora gắn với mục đích và cách thu thập, không gắn với địa chỉ IP. Đổi sang IP khác không làm một kịch bản bị cấm trở thành được phép. Phần lớn công việc trong bài, kể cả tải bộ dữ liệu, chạy tốt với kết nối trực tiếp từ Việt Nam.
Tình huống proxy có ích
Tình huống phổ biến nhất là mạng công ty bắt buộc đi qua proxy để ra Internet. Hàm make_session ở phần dữ liệu mở nhận PROXY_URL từ biến môi trường và tắt trust_env, để kịch bản dùng đúng proxy được khai báo. Bài cài đặt Python proxy từ thư viện Requests có thêm chi tiết về cú pháp và cách thử kết nối.
Tình huống thứ hai là đội marketing ở Việt Nam quản lý tài khoản Quora hoặc Space của thương hiệu bằng tay. Một tài khoản đăng nhập từ một IP ổn định giúp lịch sử đăng nhập dễ theo dõi hơn so với việc đổi qua nhiều mạng khác nhau mỗi ngày. Đây là thao tác của người, trên tài khoản của chính doanh nghiệp.
Tình huống thứ ba là xem câu trả lời của thương hiệu hiển thị thế nào với người xem ở Mỹ, ví dụ khi đội marketing chạy chiến dịch nhắm thị trường đó. Thao tác này cũng làm tay trên trình duyệt, không cần kịch bản nào.
Tình huống không dùng proxy
Không dùng proxy xoay để tải trang câu hỏi, không dùng nhiều IP cho nhiều tài khoản đăng câu trả lời quảng cáo hay tăng upvote. Những việc này đi ngược điều khoản, dễ khiến tài khoản bị khoá và ảnh hưởng ngược tới thương hiệu.
Với Quora, proxy chỉ giải quyết chuyện đường mạng. Quyền dùng nội dung nằm ở điều khoản, và không IP nào thay đổi được điều đó.
Gói phù hợp
Nếu cần IP ổn định cho máy làm việc hoặc tài khoản thương hiệu, anh em có thể mua proxy dân cư tĩnh Viettel, VNPT, FPT hoặc datacenter Việt Nam trên trang chủ ProxyVN, hoặc chọn datacenter US khi cần góc nhìn người xem ở Mỹ. Kiểm tra IP đi ra trước khi đăng nhập tài khoản.
Với các dự án dữ liệu cho AI nói chung, bài web scraping dữ liệu AI bằng proxy bàn thêm về nguồn dữ liệu, còn bài proxy cho AI agent tự động nói về agent duyệt web. Với Quora, mọi gợi ý trong hai bài đó vẫn phải đặt dưới điều khoản đã phân tích ở trên.
Tóm lại, proxy trong dự án Quora là chuyện hạ tầng mạng và quản lý tài khoản bằng tay, không phải cách lấy thêm dữ liệu.
Checklist trước khi crawl Quora bằng Python chạy thật
Danh sách dưới gom các bước trong bài thành việc cần kiểm tra trước khi đưa sổ trích dẫn và phần phân tích dữ liệu vào dùng hằng ngày. Anh em chia theo ba nhóm để dễ phân công.
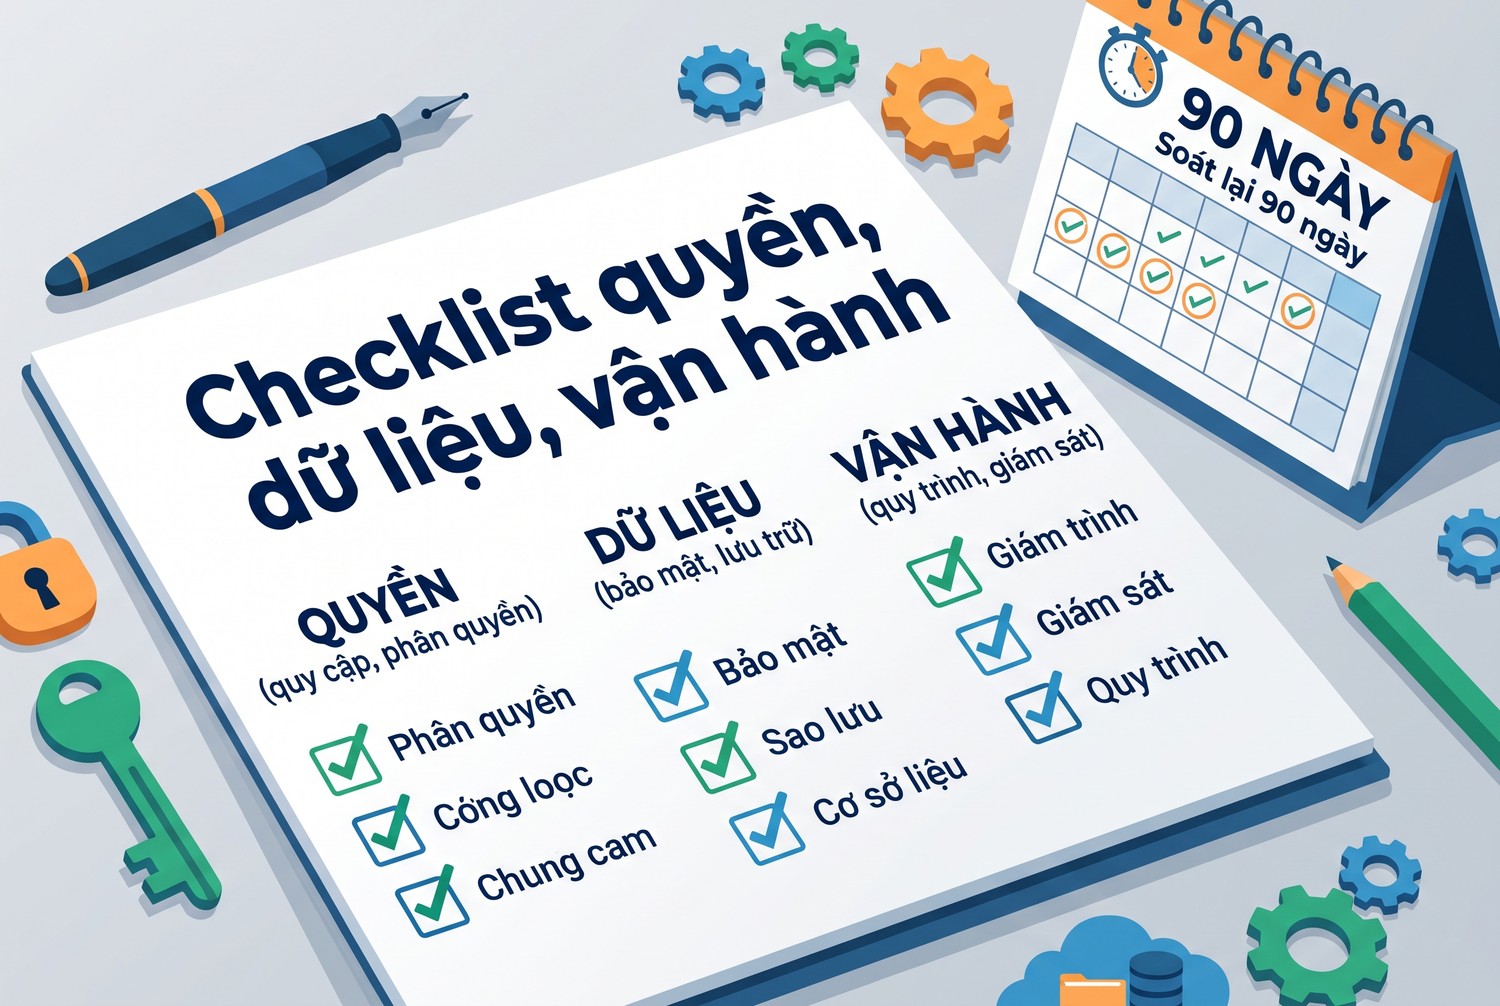
Checklist quyền, dữ liệu, vận hành
Nhóm quyền và điều khoản
Nhóm này xác định dự án đứng trên nền hợp lệ. Rà lại khi Quora cập nhật điều khoản; bản ProxyVN đọc có hiệu lực từ 04/03/2024.
- Đã đọc mục 4.3, 4.4, 4.5 của điều khoản và robots.txt, ghi ngày đọc.
- Không có đoạn code nào tải trang câu hỏi, câu trả lời hay hồ sơ Quora.
- Không dùng nội dung Quora để huấn luyện hay tinh chỉnh mô hình AI.
- Dùng bộ Question Pairs trong phạm vi phi thương mại, hoặc đã có văn bản đồng ý của Quora.
Nhóm dữ liệu
Nhóm này đảm bảo mỗi trích dẫn đủ điều kiện và truy được nguồn. Mỗi mục tương ứng một khối code trong bài.
- CSV do người viết tự điền, đọc bằng encoding utf-8-sig.
- URL được chuẩn hoá trước khi lưu, chống trùng theo URL, mã băm đoạn trích và slug bài.
- Đoạn trích nguyên văn, trong ngưỡng nội bộ, nội dung đăng sau 22/04/2010.
- Không lưu tên tác giả thành cột riêng, không lưu hồ sơ.
- Khối HTML ghi nguồn có chữ Quora và thẻ a trỏ về trang gốc.
Nhóm vận hành
Nhóm cuối giúp sổ trích dẫn dùng được lâu dài. Xem lại sau tháng đầu.
- Bảng requests ghi mọi yêu cầu ẩn danh, cập nhật, gỡ bỏ.
- Hàm due_for_review chạy định kỳ, người viết mở trang gốc kiểm tra bằng tay.
- Gặp 403 thì dừng, không đổi IP hay User-Agent để thử lại.
- Log không chứa mật khẩu proxy.
Kết luận cho checklist: sổ trích dẫn Quora tốt là sổ coi điều kiện ghi nguồn và yêu cầu của tác giả là một phần thiết kế, không phải thủ tục làm cho có.
Crawl Quora bằng Python đúng điều khoản là kiểm tra robots.txt theo RFC 9309, không cào trang câu hỏi, lưu trích dẫn nhập tay kèm ghi nguồn và xử lý yêu cầu ẩn danh hay gỡ bỏ, còn dữ liệu cho mô hình lấy từ bộ Question Pairs. Cần IP ổn định, anh em nhắn Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam trước khi crawl Quora bằng Python.


