
Crawl GitHub bằng Python: API, phân trang, hạn mức và SQLite
Crawl GitHub bằng Python hiệu quả nhất khi anh em đi qua REST API chính thức thay vì đọc HTML từng trang. API trả JSON có cấu trúc, có phân trang và báo rõ hạn mức còn lại. Bài này, ProxyVN hướng dẫn dùng token, đọc header Link, xử lý rate limit, lưu metadata repository vào SQLite rồi xuất CSV, kèm bộ dữ liệu giả để chạy thử.
Mục tiêu và phạm vi của crawl GitHub bằng Python
Trước khi viết dòng code nào, anh em nên ghi ra một câu: mình cần dữ liệu gì, cho việc gì. GitHub chứa hàng trăm triệu repository, nên một kịch bản không có phạm vi rõ sẽ chạy mãi mà không ra kết quả dùng được. Phạm vi hẹp giúp tính được số request, thời gian chạy và dung lượng lưu trữ.
Ba kiểu bài toán hay gặp
Kiểu thứ nhất là theo dõi một danh sách repository cố định, ví dụ các thư viện mà dự án đang phụ thuộc. Anh em cần biết số sao, ngày push gần nhất, giấy phép và việc repo có bị archive hay không. Kiểu này ít request, chạy định kỳ mỗi ngày là đủ.
Kiểu thứ hai là khảo sát một hệ sinh thái, ví dụ mọi repository có topic "web-scraping" viết bằng Python. Dữ liệu dùng để so sánh mức độ hoạt động hay xu hướng chọn thư viện. Kiểu này cần Search API và phải tính tới giới hạn số kết quả mỗi truy vấn.
Kiểu thứ ba là liệt kê toàn bộ repository của một tổ chức để kiểm kê nội bộ. Endpoint liệt kê theo tổ chức trả về danh sách có phân trang, không bị giới hạn kết quả như Search API. Đây là kiểu dễ làm đúng nhất cho người mới.
Những gì bài này không làm
Bài không hướng dẫn tải mã nguồn hàng loạt hay clone toàn bộ repository. Việc đó dùng git, không dùng API metadata, và tốn băng thông khác hẳn. Bài cũng không thu thập email hay thông tin liên hệ của lập trình viên.
Lý do nằm trong chính sách sử dụng chấp nhận được của GitHub. Văn bản này cho phép dùng thông tin công khai cho một số mục đích như nghiên cứu, nhưng cấm dùng dữ liệu để gửi thư rác hoặc bán thông tin cá nhân, kể cả cho nhà tuyển dụng hay trang việc làm. Metadata repository thì được, danh sách email lập trình viên để chào hàng thì không.
Tóm lại, crawl GitHub bằng Python nên bắt đầu từ một câu hỏi cụ thể và một danh sách trường dữ liệu cụ thể. Phạm vi rõ ràng quyết định gần như mọi lựa chọn kỹ thuật phía sau.
Ưu tiên API khi crawl GitHub bằng Python
GitHub có giao diện web đẹp, nhưng giao diện đó dành cho người đọc. HTML thay đổi theo đợt cập nhật giao diện, nhiều phần tải bằng JavaScript và không có cam kết ổn định nào cho người viết bộ phân tích. REST API thì có phiên bản, có tài liệu và có cơ chế báo lỗi rõ ràng.
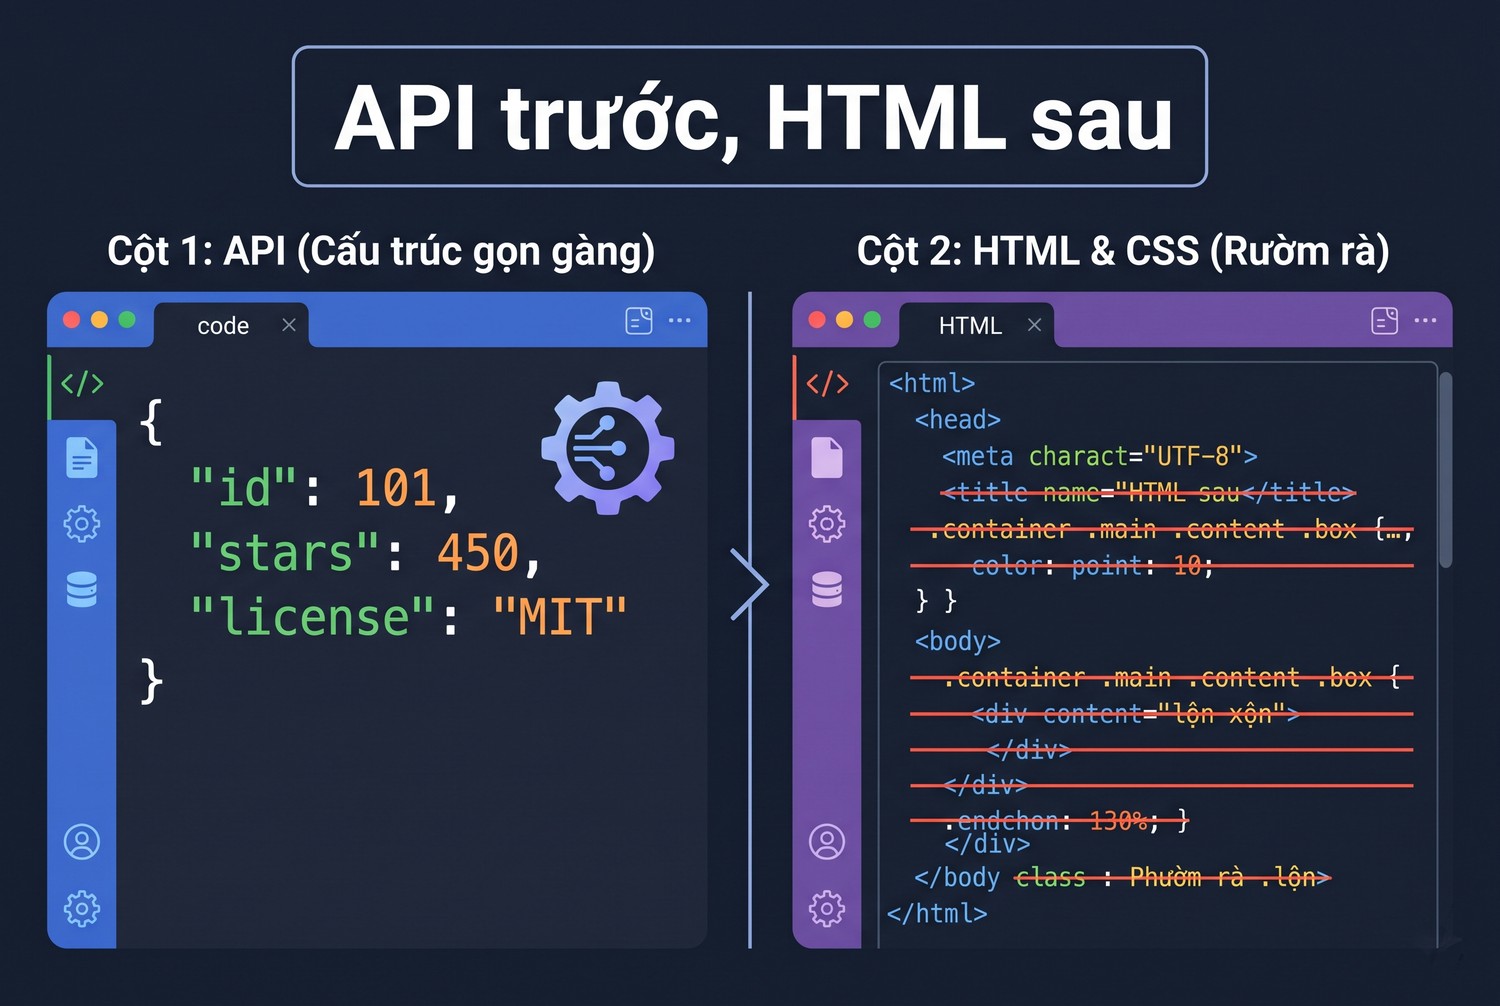
API trước, HTML sau
API trả đúng thứ anh em cần
Một lần gọi tới endpoint repository trả về hơn bảy mươi trường: id số, tên đầy đủ, mô tả, ngôn ngữ chính, số sao, số fork, giấy phép, topic, ngày tạo, ngày push. Muốn có cùng thông tin từ HTML, anh em phải tải trang, chọn đúng phần tử và chịu rủi ro bộ chọn bị gãy sau mỗi lần GitHub đổi giao diện.
Điểm quan trọng nhất là trường id. Đây là số nguyên gắn với repository suốt vòng đời, kể cả khi chủ sở hữu đổi tên hoặc chuyển repo sang tổ chức khác. Dùng id làm khoá chính giúp tránh trùng lặp khi một repo xuất hiện dưới hai cái tên ở hai lần chạy.
Phiên bản API và header bắt buộc
Tài liệu về phiên bản REST API cho biết anh em chỉ định phiên bản qua header X-GitHub-Api-Version. Thời điểm ProxyVN kiểm tra ngày 23/10/2026, có hai phiên bản được hỗ trợ là 2026-03-10 và 2022-11-28. Request không ghi phiên bản sẽ dùng mặc định 2022-11-28.
Code trong bài ghi rõ 2022-11-28 vì đây là phiên bản mà đa số ví dụ trên mạng đang dùng, và theo tài liệu vẫn được hỗ trợ tới tháng 3/2028. Khi nâng lên 2026-03-10, anh em đọc ghi chú thay đổi phá vỡ tương thích trước rồi mới đổi header. Ghi phiên bản cố định trong code giúp kịch bản không tự đổi hành vi khi GitHub ngừng hỗ trợ bản cũ.
Khi nào mới cần đọc HTML
Có vài thông tin chỉ hiển thị trên giao diện, ví dụ một số thống kê hiển thị theo cách riêng của trang. Trước khi quyết định đọc HTML, anh em nên tìm trong tài liệu REST và GraphQL thêm một lần nữa. Phần lớn trường hợp, dữ liệu đã có sẵn qua API, chỉ là nằm ở endpoint khác.
Nếu vẫn phải đọc trang, giữ tốc độ thấp, tôn trọng robots.txt và chỉ lấy đúng trường cần. Tuy vậy, với mục tiêu metadata repository như trong bài, API là đủ. Kết luận của phần này đơn giản: API trước, HTML là phương án cuối cùng.
Token, phân trang và hạn mức khi crawl GitHub bằng Python
Ba khái niệm này quyết định kịch bản chạy được bao xa trong một giờ. Hiểu sai một trong ba, kịch bản sẽ dừng giữa chừng với mã 403 hoặc âm thầm bỏ sót dữ liệu. Phần này đi qua từng khái niệm theo đúng tài liệu GitHub.
Hạn mức theo người dùng, không theo IP
Tài liệu rate limit của GitHub ghi rằng request không xác thực được 60 lần mỗi giờ. Request dùng personal access token được 5.000 lần mỗi giờ. GitHub App thuộc tổ chức dùng GitHub Enterprise Cloud có thể lên 15.000 lần mỗi giờ.
Con số 60 gắn với địa chỉ IP gửi request, còn con số 5.000 gắn với tài khoản sở hữu token. Đây là lý do đổi IP không giúp tăng hạn mức khi đã dùng token. Muốn chạy nhiều hơn, anh em tối ưu số request chứ không đổi proxy.
Ngoài hạn mức chính, GitHub còn có hạn mức phụ để chống lạm dụng. Tài liệu nêu ví dụ không quá 900 điểm mỗi phút cho REST và không quá 90 giây thời gian CPU trong 60 giây thực. Hạn mức phụ không có endpoint để kiểm tra, nên cách an toàn là gửi request tuần tự thay vì song song.
Mỗi phản hồi có các header x-ratelimit-limit, x-ratelimit-remaining, x-ratelimit-used và x-ratelimit-reset. Giá trị reset là thời điểm tính bằng giây epoch UTC, khi cửa sổ hạn mức mới bắt đầu. Kịch bản nên đọc các header này sau mỗi request để quyết định chạy tiếp hay chờ.
Khi vượt hạn mức, GitHub trả mã 403 hoặc 429. Nếu có header retry-after, phải chờ đúng số giây đó. Nếu remaining bằng 0, chờ tới thời điểm reset. Nếu không có cả hai, tài liệu khuyên chờ ít nhất một phút rồi tăng dần thời gian chờ theo cấp số nhân.
Phân trang bằng header Link
Tài liệu phân trang giải thích rằng khi kết quả nhiều trang, phản hồi có header link chứa URL của trang trước, trang sau, trang đầu và trang cuối. Anh em đi theo URL có rel="next" cho tới khi header này không còn. Tham số per_page điều chỉnh số mục mỗi trang, phần lớn endpoint cho tối đa 100.
Thư viện Requests đã phân tích sẵn header này vào thuộc tính links của phản hồi. Không cần tự viết biểu thức chính quy để tách URL. Cách đi theo link next cũng an toàn hơn tự tăng số trang, vì GitHub có thể đổi cách đánh số mà không báo trước.
Search API có luật riêng
Tài liệu Search API nêu ba giới hạn quan trọng. Mỗi truy vấn trả tối đa 1.000 kết quả. Request có xác thực được 30 lần mỗi phút với phần lớn endpoint tìm kiếm, riêng tìm code chỉ 10 lần. Truy vấn chạy quá lâu sẽ trả incomplete_results bằng true.
Giới hạn 1.000 kết quả nghĩa là truy vấn rộng như "language:python" sẽ không bao giờ trả đủ. Cách xử lý là chia truy vấn theo khoảng ngày tạo hoặc khoảng số sao, mỗi khoảng dưới 1.000 kết quả. Phần code bên dưới có hàm chia khoảng ngày cho việc này.
Bảng dưới gom các con số trên để anh em tra nhanh khi thiết kế. Các giá trị lấy từ tài liệu GitHub ngày 23/10/2026 và có thể đổi theo thời gian.
Loại request |
Hạn mức |
Tính theo |
Ghi chú |
|---|---|---|---|
Không xác thực |
60 lần/giờ |
Địa chỉ IP |
Chỉ hợp để thử nhanh |
Personal access token |
5.000 lần/giờ |
Tài khoản |
Đủ cho đa số dự án nhỏ |
GitHub App tổ chức Enterprise Cloud |
15.000 lần/giờ |
Bản cài đặt |
Cần quyền quản trị tổ chức |
Search API có xác thực |
30 lần/phút |
Tài khoản |
Tối đa 1.000 kết quả mỗi truy vấn |
Tìm code |
10 lần/phút |
Tài khoản |
Bắt buộc xác thực |
Như vậy, token là thứ đầu tiên cần có, phân trang theo link next là cách đọc dữ liệu đúng, và Search API cần chia nhỏ truy vấn. Ba điểm này là khung xương cho mọi đoạn code phía sau.
Môi trường và client cho crawl GitHub bằng Python
Lab dùng Python 3.12, thư viện Requests để gọi API và các module có sẵn sqlite3, csv để lưu dữ liệu. Không cần framework crawl nặng, vì API đã trả dữ liệu có cấu trúc. Môi trường gọn giúp anh em dễ đưa kịch bản lên máy chủ sau này.
Cài thư viện, token và dữ liệu thử
Các lệnh dưới chạy trên PowerShell trong một thư mục trống. Tệp requirements-lock.txt ghi lại đúng phiên bản đã cài để lần sau dựng lại môi trường y hệt.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install requests
python -m pip freeze > requirements-lock.txt
Khi ProxyVN dựng lab này, Requests ở phiên bản 2.34.2 trên Python 3.12.10. Nếu anh em dùng bản khác, code vẫn chạy được vì chỉ dùng phần API cơ bản của thư viện.
Vào phần Settings của tài khoản GitHub, chọn Developer settings, rồi tạo fine-grained personal access token. Với dữ liệu công khai, token chỉ cần quyền đọc mặc định, không cần cấp quyền ghi vào repository nào. Đặt hạn dùng ngắn, ví dụ 30 hoặc 90 ngày, để giảm rủi ro khi token bị lộ.
Token đặt trong biến môi trường, không ghi vào code và không đưa lên repository. Biến proxy là tuỳ chọn, chỉ cần khi mạng của anh em bắt buộc đi qua proxy hoặc khi muốn cố định IP ra ngoài.
$env:GITHUB_TOKEN = 'github_pat_xxxxxxxxxxxx'
$env:GH_PROXY = 'http://USERNAME:PASSWORD@HOST:PORT'
Các giá trị trên là mẫu. Trước khi gửi log cho đồng nghiệp, anh em xoá dòng chứa token và mật khẩu proxy.
Phần lớn lỗi trong kịch bản crawl nằm ở bước xử lý dữ liệu chứ không ở bước gọi mạng. Vì vậy, lab dùng hai trang phản hồi giả lập theo đúng cấu trúc JSON của GitHub để chạy thử trước. Anh em kiểm tra phân trang, chuẩn hoá, chống trùng và xuất CSV mà không tốn một request nào.
Khi bộ dữ liệu giả cho kết quả đúng, mới chuyển sang gọi API thật với số trang tối đa nhỏ. Thói quen này giúp tiết kiệm hạn mức và tránh làm bẩn cơ sở dữ liệu bằng bản ghi sai. Tóm lại, môi trường tốt gồm token đúng quyền, phiên bản thư viện được ghi lại và bộ dữ liệu thử.
Tạo Session có header chuẩn
Client là phần code gửi request, đọc hạn mức và tự chờ khi cần. Đây là ví dụ triển khai do ProxyVN viết dựa trên tài liệu GitHub, đã chạy với dữ liệu giả lập trong lab. Anh em có thể đặt toàn bộ vào một tệp github_lab.py.
Session gom các header dùng chung: kiểu dữ liệu nhận về, phiên bản API, User-Agent và token. Thuộc tính trust_env bằng False giúp Session bỏ qua biến proxy hệ thống, chỉ dùng proxy truyền vào hàm. Cách này tránh tình huống kịch bản đi qua một proxy cũ còn sót trong biến môi trường.
import os
import time
import json
import csv
import sqlite3
from datetime import date, datetime, timedelta, timezone
import requests

API = "https://api.github.com"
BASE_HEADERS = {
    "Accept": "application/vnd.github+json",
    "X-GitHub-Api-Version": "2022-11-28",
    "User-Agent": "proxyvn-github-lab/0.1",
}

def make_session(token=None, proxy=None):
    s = requests.Session()
    s.trust_env = False
    s.headers.update(BASE_HEADERS)
    if token:
        s.headers["Authorization"] = f"Bearer {token}"
    if proxy:
        s.proxies.update({"http": proxy, "https": proxy})
    return s
User-Agent nên chứa tên dự án để GitHub nhận diện được nguồn request. Tài liệu GitHub yêu cầu mọi request có User-Agent hợp lệ, request thiếu header này có thể bị từ chối.
Hàm gọi có hạn mức và phân trang
Hàm gh_get gửi request, kiểm tra mã trạng thái và tự chờ khi gặp giới hạn. Thời gian chờ tính theo đúng thứ tự tài liệu khuyên: retry-after trước, rồi x-ratelimit-reset, cuối cùng là chờ tăng dần. Sau một số lần thử, hàm dừng hẳn thay vì lặp vô hạn.
def wait_seconds(resp, attempt, now=None):
    now = now if now is not None else time.time()
    h = resp.headers
    if h.get("retry-after"):
        return int(h["retry-after"])
    if h.get("x-ratelimit-remaining") == "0" and h.get("x-ratelimit-reset"):
        return max(int(h["x-ratelimit-reset"]) - int(now), 0) + 1
    return 60 * (2 ** attempt)

def is_rate_limited(resp):
    if resp.status_code not in (403, 429):
        return False
    h = resp.headers
    return ("retry-after" in h or h.get("x-ratelimit-remaining") == "0"
            or "rate limit" in resp.text.lower())

def gh_get(session, url, params=None, etag=None, max_attempts=4, sleep=time.sleep):
    headers = {"If-None-Match": etag} if etag else {}
    for attempt in range(max_attempts):
        r = session.get(url, params=params, headers=headers, timeout=(10, 30))
        if not is_rate_limited(r):
            return r
        sleep(min(wait_seconds(r, attempt), 3600))
    raise RuntimeError(f"Vẫn bị giới hạn sau {max_attempts} lần thử: {url}")
Tham số sleep cho phép thay hàm chờ bằng hàm giả khi kiểm thử. Nhờ vậy, anh em kiểm tra được logic chờ mà không phải ngồi đợi một giờ.
Hàm paginate trả từng mục một theo kiểu generator. Với endpoint liệt kê, phản hồi là một mảng. Với Search API, phản hồi là object có khoá items. Hàm xử lý được cả hai, rồi đi theo URL next cho tới hết hoặc chạm số trang tối đa.
def paginate(session, url, params=None, max_pages=50, pause=0.5):
    pages = 0
    while url and pages < max_pages:
        r = gh_get(session, url, params=params)
        r.raise_for_status()
        data = r.json()
        if isinstance(data, dict) and data.get("incomplete_results"):
            print("Cảnh báo: kết quả tìm kiếm chưa đầy đủ", url)
        items = data["items"] if isinstance(data, dict) and "items" in data else data
        yield from items
        url = r.links.get("next", {}).get("url")
        params = None
        pages += 1
        time.sleep(pause)
Sau trang đầu, params đặt về None vì URL next đã chứa sẵn mọi tham số. Truyền lại params sẽ làm trùng tham số và có thể đưa về sai trang. Như vậy, ba hàm trong phần này là toàn bộ phần mạng của kịch bản, gọn và kiểm thử được.
Chuẩn hoá và lưu dữ liệu khi crawl GitHub bằng Python
Dữ liệu thô từ API có nhiều trường lồng nhau và nhiều giá trị rỗng. Bước chuẩn hoá chọn đúng trường cần, đổi về kiểu đơn giản và đặt tên cột ổn định. Bảng đích nên phẳng để mở được bằng Excel và truy vấn được bằng SQL.
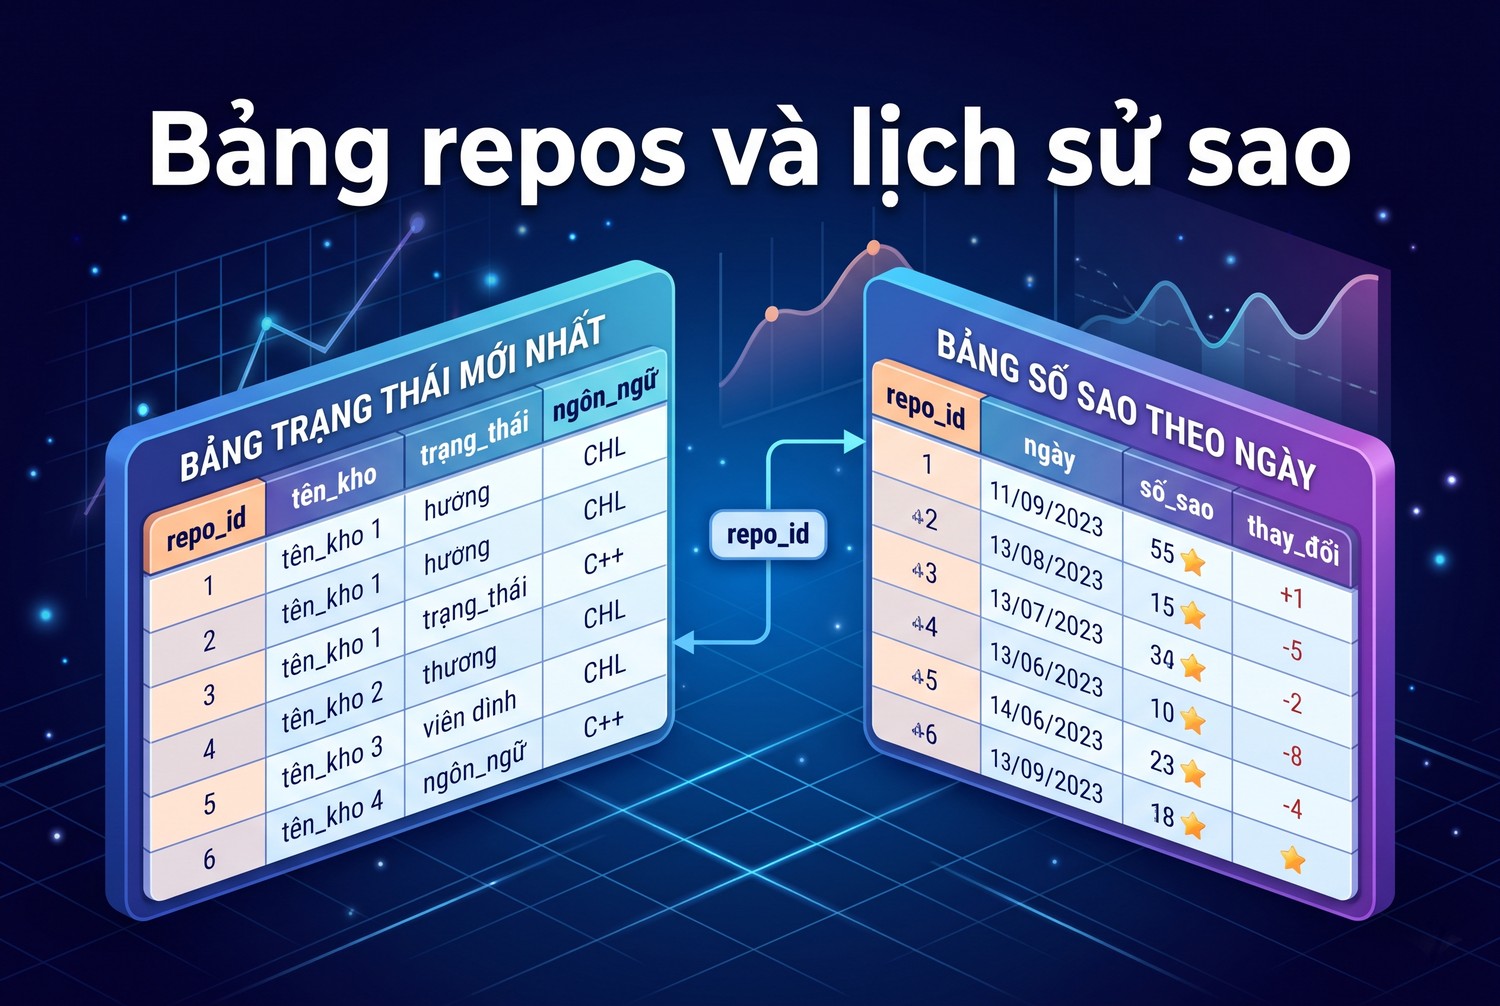
Bảng repos và lịch sử sao
Chọn trường và đặt schema
Schema dưới đây phục vụ bài toán theo dõi hệ sinh thái thư viện. Mỗi trường có lý do để giữ: id để chống trùng, full_name để đọc, pushed_at để đo mức hoạt động, license để kiểm tra pháp lý khi dùng thư viện. Trường owner chỉ giữ tên tài khoản, không giữ email hay thông tin hồ sơ.
FIELDS = ["repo_id", "full_name", "owner", "html_url", "description", "language",
          "stars", "forks", "open_issues", "license", "topics", "archived",
          "created_at", "pushed_at", "fetched_at"]

def normalize_repo(raw, fetched_at):
    lic = raw.get("license") or {}
    return {
        "repo_id": int(raw["id"]),
        "full_name": raw["full_name"],
        "owner": (raw.get("owner") or {}).get("login", ""),
        "html_url": raw["html_url"],
        "description": " ".join((raw.get("description") or "").split()),
        "language": raw.get("language") or "",
        "stars": int(raw.get("stargazers_count") or 0),
        "forks": int(raw.get("forks_count") or 0),
        "open_issues": int(raw.get("open_issues_count") or 0),
        "license": lic.get("spdx_id") or "",
        "topics": ",".join(sorted(raw.get("topics") or [])),
        "archived": int(bool(raw.get("archived"))),
        "created_at": raw.get("created_at") or "",
        "pushed_at": raw.get("pushed_at") or "",
        "fetched_at": fetched_at,
    }
Mô tả được gộp khoảng trắng để CSV không bị vỡ dòng. Topic được sắp xếp trước khi nối chuỗi, nhờ vậy hai lần chạy với cùng danh sách topic cho ra cùng một giá trị, dễ so sánh thay đổi.
Ghi vào SQLite với khoá chính là id
SQLite là lựa chọn hợp lý cho dự án vài chục nghìn bản ghi: không cần máy chủ, một tệp duy nhất, hỗ trợ cú pháp upsert. Tài liệu UPSERT của SQLite mô tả mệnh đề ON CONFLICT DO UPDATE, cho phép chèn mới hoặc cập nhật nếu khoá đã tồn tại.
def open_db(path="github_repos.db"):
    con = sqlite3.connect(path)
    cols = ", ".join(f"{f} TEXT" if f not in ("repo_id", "stars", "forks", "open_issues", "archived")
                     else f"{f} INTEGER" for f in FIELDS)
    con.execute(f"CREATE TABLE IF NOT EXISTS repos ({cols}, PRIMARY KEY (repo_id))")
    con.execute("""CREATE TABLE IF NOT EXISTS star_history (
        repo_id INTEGER, day TEXT, stars INTEGER, PRIMARY KEY (repo_id, day))""")
    return con

def upsert_repos(con, rows):
    placeholders = ", ".join("?" for _ in FIELDS)
    updates = ", ".join(f"{f}=excluded.{f}" for f in FIELDS if f != "repo_id")
    sql = (f"INSERT INTO repos ({', '.join(FIELDS)}) VALUES ({placeholders}) "
           f"ON CONFLICT(repo_id) DO UPDATE SET {updates}")
    con.executemany(sql, [[r[f] for f in FIELDS] for r in rows])
    con.executemany("INSERT OR REPLACE INTO star_history VALUES (?, ?, ?)",
                    [(r["repo_id"], r["fetched_at"][:10], r["stars"]) for r in rows])
    con.commit()
Bảng star_history giữ một dòng mỗi repo mỗi ngày. Bảng repos luôn chứa trạng thái mới nhất, còn bảng lịch sử cho phép vẽ đường tăng sao theo thời gian. Chạy kịch bản hai lần trong một ngày không sinh dòng trùng vì khoá chính gồm repo_id và ngày.
Xuất CSV cho người không dùng SQL
Nhiều người nhận dữ liệu chỉ cần mở bằng Excel. Hàm xuất dùng mã hoá utf-8-sig để Excel trên Windows hiển thị đúng tiếng Việt và ký tự đặc biệt trong mô tả.
def export_csv(con, path="github_repos.csv"):
    cur = con.execute(f"SELECT {', '.join(FIELDS)} FROM repos ORDER BY stars DESC")
    with open(path, "w", newline="", encoding="utf-8-sig") as f:
        w = csv.writer(f)
        w.writerow(FIELDS)
        w.writerows(cur.fetchall())
    return path
Tóm lại, schema phẳng, khoá chính là id số và bảng lịch sử tách riêng là ba quyết định giúp dữ liệu GitHub dùng được lâu dài. Chúng cũng giúp chống trùng mà không cần logic phức tạp.
Ví dụ tối thiểu crawl GitHub bằng Python với dữ liệu giả
Phần này ghép mọi hàm ở trên thành một lần chạy đầy đủ. Thay vì gọi GitHub thật, lab tạo một Session giả trả về hai trang JSON có header link y như API. Đầu vào, cách chạy và đầu ra mong đợi đều được ghi rõ để anh em đối chiếu.
Đầu vào là hai trang phản hồi
Trang một có hai repository và header link trỏ tới trang hai. Trang hai có một repository mới và lặp lại một repository của trang một, với số sao đã tăng. Tình huống lặp này mô phỏng việc danh sách thay đổi thứ tự trong lúc kịch bản đang phân trang, chuyện xảy ra thật khi dữ liệu được cập nhật liên tục.
class FakeResp:
    def __init__(self, payload, next_url=None, status=200, headers=None):
        self.payload, self.status_code = payload, status
        self.headers = headers or {"x-ratelimit-remaining": "4999"}
        self.links = {"next": {"url": next_url}} if next_url else {}
        self.text = json.dumps(payload)
    def json(self):
        return self.payload
    def raise_for_status(self):
        if self.status_code >= 400:
            raise requests.HTTPError(self.status_code)

def repo(i, name, stars, lang="Python"):
    return {"id": i, "full_name": name, "owner": {"login": name.split("/")[0]},
            "html_url": f"https://github.com/{name}", "description": "Demo  repo\n",
            "language": lang, "stargazers_count": stars, "forks_count": 1,
            "open_issues_count": 0, "license": {"spdx_id": "MIT"},
            "topics": ["scraping", "api"], "archived": False,
            "created_at": "2024-01-02T03:04:05Z", "pushed_at": "2026-10-20T08:00:00Z"}

PAGES = {
    f"{API}/orgs/demo/repos": FakeResp([repo(1, "demo/alpha", 10), repo(2, "demo/beta", 5)],
                                       next_url=f"{API}/orgs/demo/repos?page=2"),
    f"{API}/orgs/demo/repos?page=2": FakeResp([repo(3, "demo/gamma", 7, None),
                                               repo(1, "demo/alpha", 12)]),
}

class FakeSession:
    def get(self, url, params=None, headers=None, timeout=None):
        return PAGES[url]
Session giả chỉ cần phương thức get với cùng tham số như Requests. Các hàm gh_get và paginate không biết mình đang chạy với dữ liệu giả, đó là mục đích của cách thiết kế này.
Cách chạy và đầu ra mong đợi
Đoạn dưới chạy phân trang, chuẩn hoá, ghi SQLite và xuất CSV. Cuối cùng in số bản ghi và số sao của repo bị lặp để kiểm tra chống trùng.
now = datetime.now(timezone.utc).isoformat(timespec="seconds")
raw = list(paginate(FakeSession(), f"{API}/orgs/demo/repos", params={"per_page": 100}, pause=0))
rows = [normalize_repo(r, now) for r in raw]
con = open_db(":memory:")
upsert_repos(con, rows)
print("Bản ghi thô:", len(raw))
print("Bản ghi trong bảng:", con.execute("SELECT COUNT(*) FROM repos").fetchone()[0])
print("Sao của demo/alpha:", con.execute("SELECT stars FROM repos WHERE repo_id=1").fetchone()[0])
print("Đã xuất:", export_csv(con))
Khi ProxyVN chạy trong lab, kết quả là bốn bản ghi thô nhưng chỉ ba dòng trong bảng. Repo demo/alpha mang số sao 12, tức giá trị mới nhất đã ghi đè giá trị cũ. Repo demo/gamma có ngôn ngữ rỗng thay vì None, nên cột CSV không bị lẫn chữ None.
Chuyển sang API thật
Khi bộ dữ liệu giả cho kết quả đúng, anh em thay FakeSession bằng make_session với token thật. Đặt max_pages bằng 2 cho lần chạy đầu để chỉ tốn vài request. Endpoint liệt kê repository theo tổ chức có dạng /orgs/TÊN_TỔ_CHỨC/repos, nhận per_page tối đa 100.
def crawl_org(org, db_path="github_repos.db", max_pages=2):
    s = make_session(os.environ.get("GITHUB_TOKEN"), os.environ.get("GH_PROXY"))
    stamp = datetime.now(timezone.utc).isoformat(timespec="seconds")
    items = paginate(s, f"{API}/orgs/{org}/repos",
                     params={"per_page": 100, "type": "public"}, max_pages=max_pages)
    con = open_db(db_path)
    upsert_repos(con, [normalize_repo(r, stamp) for r in items])
    return con
Kết luận của phần ví dụ: chạy với dữ liệu giả trước, kiểm tra số dòng và giá trị chống trùng, rồi mới gọi API thật với số trang nhỏ. Thứ tự này rẻ hơn nhiều so với sửa dữ liệu sai sau khi đã chạy hàng nghìn request.
Tìm kiếm và cập nhật định kỳ khi crawl GitHub bằng Python
Khi phạm vi là cả một hệ sinh thái, anh em cần Search API và một chiến lược cập nhật. Hai vấn đề chính là giới hạn 1.000 kết quả mỗi truy vấn và chi phí làm mới dữ liệu hằng ngày. Phần này xử lý cả hai bằng code.
Chia truy vấn theo khoảng ngày tạo
Ý tưởng là thay một truy vấn rộng bằng nhiều truy vấn hẹp theo ngày tạo repository. Mỗi truy vấn hẹp trả ít hơn 1.000 kết quả nên đọc được hết. Hàm dưới sinh danh sách truy vấn theo từng khoảng số ngày cố định.
def date_windows(start, end, days=30):
    cur = start
    while cur <= end:
        stop = min(cur + timedelta(days=days - 1), end)
        yield cur, stop
        cur = stop + timedelta(days=1)

def search_queries(base_q, start, end, days=30):
    return [f"{base_q} created:{a.isoformat()}..{b.isoformat()}"
            for a, b in date_windows(start, end, days)]

qs = search_queries("topic:web-scraping language:python", date(2026, 1, 1), date(2026, 3, 31))
print(len(qs), qs[0])
Kết quả lab cho ba truy vấn cho quý một năm 2026, truy vấn đầu kết thúc bằng created:2026-01-01..2026-01-30. Nếu một khoảng vẫn trả total_count lớn hơn 1.000, anh em chia khoảng đó nhỏ hơn, ví dụ 7 ngày. Mỗi truy vấn tìm kiếm tốn một lượt trong hạn mức 30 lần mỗi phút, nên giữ khoảng nghỉ ít nhất hai giây giữa các trang.
Request có điều kiện bằng ETag
Với danh sách repository cố định cần làm mới hằng ngày, request có điều kiện giúp tiết kiệm hạn mức. Hướng dẫn thực hành tốt của GitHub ghi rằng phản hồi 304 Not Modified không tính vào hạn mức chính, nếu request có header Authorization hợp lệ.
def refresh_repo(session, con, full_name, etags):
    r = gh_get(session, f"{API}/repos/{full_name}", etag=etags.get(full_name))
    if r.status_code == 304:
        return "unchanged"
    r.raise_for_status()
    etags[full_name] = r.headers.get("etag")
    stamp = datetime.now(timezone.utc).isoformat(timespec="seconds")
    upsert_repos(con, [normalize_repo(r.json(), stamp)])
    return "updated"

PAGES[f"{API}/repos/demo/alpha"] = FakeResp({}, status=304)
print(refresh_repo(FakeSession(), con, "demo/alpha", {"demo/alpha": '"abc"'}))
Từ điển etags nên lưu xuống tệp JSON hoặc một bảng riêng trong SQLite để dùng lại giữa các lần chạy. Lab in ra unchanged với phản hồi 304 giả lập, nghĩa là bản ghi cũ được giữ nguyên và không tốn lượt nào.
Lịch chạy hợp lý
Repo được theo dõi chặt có thể làm mới mỗi ngày, phần còn lại mỗi tuần. Số sao hiếm khi đổi đáng kể trong vài giờ, nên chạy theo giờ chỉ tốn hạn mức mà không thêm thông tin. Anh em lên lịch bằng Task Scheduler trên Windows hoặc cron trên Linux.
Như vậy, chia truy vấn theo ngày giải bài toán 1.000 kết quả, còn ETag giải bài toán chi phí làm mới. Hai kỹ thuật này đủ cho phần lớn dự án theo dõi GitHub quy mô nhỏ và vừa.
Xử lý lỗi khi crawl GitHub bằng Python
Lỗi khi làm việc với GitHub API thường rơi vào bốn nhóm: xác thực, hạn mức, dữ liệu và mạng. Mỗi nhóm có mã trạng thái và cách sửa riêng. Ghi log từng request giúp phân loại nhanh thay vì đoán.
Bảng tra lỗi thường gặp
Danh sách dưới gom các lỗi ProxyVN gặp khi dựng lab và khi đọc tài liệu. Mỗi dòng ghi dấu hiệu và hướng xử lý.
- 401 Bad credentials: token sai, hết hạn hoặc bị thu hồi; tạo token mới và cập nhật biến môi trường.
- 403 kèm x-ratelimit-remaining bằng 0: hết hạn mức chính; chờ tới thời điểm reset.
- 403 hoặc 429 kèm thông báo secondary rate limit: gửi quá nhanh hoặc song song; chuyển sang tuần tự và tăng khoảng nghỉ.
- 404 với repository có thật: repo riêng tư mà token không có quyền, hoặc tên đã đổi; tra lại bằng id.
- 422 ở Search API: cú pháp truy vấn sai hoặc vượt quá trang thứ 1.000 kết quả.
- 410 Gone: phiên bản API trong header không còn được hỗ trợ.
Với lỗi 404 do đổi tên, GitHub thường chuyển hướng request tới tên mới. Requests tự đi theo chuyển hướng, nên anh em chỉ cần cập nhật full_name theo dữ liệu trả về. Khoá chính repo_id giữ nguyên nên không sinh bản ghi trùng.
Kiểm tra dữ liệu đầu ra
Sau mỗi lần chạy, chạy vài truy vấn kiểm tra đơn giản. Số dòng mới có hợp lý so với lần trước không, có repo nào số sao giảm mạnh bất thường không, có trường bắt buộc nào rỗng không. Phát hiện sớm giúp tránh xây báo cáo trên dữ liệu lỗi.
checks = {
    "thiếu html_url": "SELECT COUNT(*) FROM repos WHERE html_url = ''",
    "sao âm": "SELECT COUNT(*) FROM repos WHERE stars < 0",
    "trùng tên": "SELECT COUNT(*) FROM (SELECT full_name FROM repos GROUP BY full_name HAVING COUNT(*) > 1)",
}
for name, sql in checks.items():
    print(name, con.execute(sql).fetchone()[0])
Trong lab, cả ba kiểm tra đều trả 0. Khi chạy thật, bất kỳ con số nào khác 0 đều đáng xem lại trước khi xuất dữ liệu cho người khác.
Ghi log mà không lộ token
Log nên chứa URL, mã trạng thái, giá trị x-ratelimit-remaining và thời gian phản hồi. Không ghi header Authorization và không ghi chuỗi proxy có mật khẩu. Một dòng log mỗi request là đủ để truy ra nguyên nhân khi kịch bản dừng giữa đêm.
Log tốt là log đọc được sau một tuần mà vẫn hiểu chuyện gì đã xảy ra. Tóm lại, xử lý lỗi tốt bắt đầu từ việc phân biệt lỗi hạn mức với lỗi dữ liệu, và có log đủ chi tiết để làm việc đó.
Khi nào cần proxy cho crawl GitHub bằng Python
Với GitHub API có token, proxy không giúp tăng hạn mức vì hạn mức tính theo tài khoản. Đây là điểm nhiều bài hướng dẫn bỏ qua. Proxy chỉ có ý nghĩa trong một số tình huống mạng cụ thể.
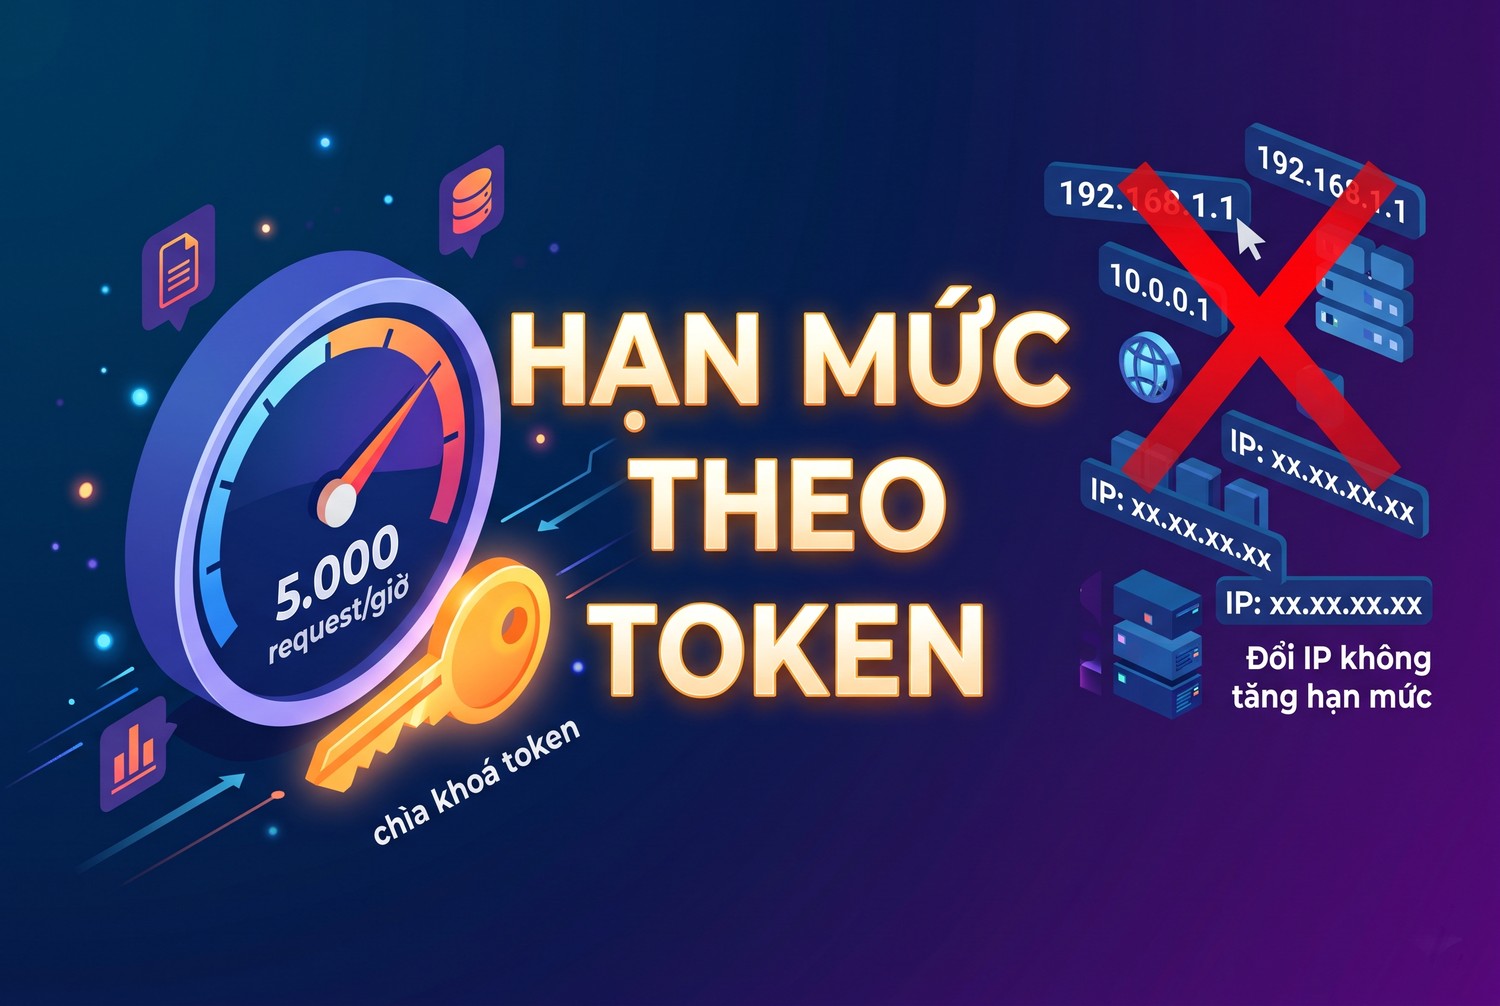
Hạn mức theo token
Tình huống proxy có ích
Tình huống đầu tiên là mạng doanh nghiệp bắt buộc mọi kết nối ra Internet đi qua proxy. Lúc này, tham số proxy trong make_session là cách khai báo rõ ràng, tránh phụ thuộc vào biến môi trường hệ thống. Nếu cần cấu hình proxy cho git và công cụ build cùng lúc, bài Git proxy trên blog ProxyVN hướng dẫn chi tiết.
Tình huống thứ hai là chạy kịch bản trên máy chủ dùng chung IP với nhiều dịch vụ khác. Một IP datacenter riêng cho tác vụ thu thập giúp tách lưu lượng và dễ theo dõi. Khi bị chặn hay bị cảnh báo, anh em biết ngay nguyên nhân thuộc về tác vụ nào.
Tình huống thứ ba là thử nghiệm không xác thực trên nhiều máy, nơi hạn mức 60 lần mỗi giờ tính theo IP. Tuy vậy, ProxyVN khuyên tạo token thay vì xoay IP, vì token cho hạn mức cao hơn nhiều và đúng với cách GitHub thiết kế.
Tình huống không nên dùng proxy
Không dùng proxy xoay để vượt hạn mức phụ hay để gửi request song song từ nhiều IP với cùng một token. Hạn mức phụ tồn tại để bảo vệ hệ thống, và hành vi này có thể dẫn tới việc token hoặc tài khoản bị hạn chế. Gửi tuần tự với khoảng nghỉ hợp lý luôn là lựa chọn đúng.
Với GitHub API, thứ giới hạn anh em là hạn mức của token, không phải địa chỉ IP. Tối ưu số request trước khi nghĩ tới proxy.
Chọn loại proxy phù hợp
Nếu cần proxy, datacenter là đủ cho API vì GitHub không phân biệt IP dân cư hay datacenter khi đã có token. Proxy HTTP có user và password khai báo trực tiếp trong chuỗi kết nối. Kiểm tra IP đi ra bằng một request tới trang trả IP công khai trước khi chạy kịch bản chính.
Khi cần mua proxy cho tác vụ này, anh em có thể xem các gói datacenter Việt Nam và datacenter US đang có trên trang chủ ProxyVN, sau đó chạy thử với max_pages nhỏ trước khi để kịch bản chạy định kỳ. Muốn hiểu bức tranh chung về thu thập dữ liệu cho AI và phân tích, đọc thêm bài web scraping dữ liệu AI bằng proxy.
Tóm lại, proxy cho GitHub API là công cụ mạng, không phải công cụ tăng hạn mức. Dùng đúng chỗ thì gọn, dùng sai chỗ thì rủi ro cho chính tài khoản của anh em.
Checklist trước khi crawl GitHub bằng Python chạy thật
Trước khi để kịch bản chạy theo lịch, anh em rà lại các mục dưới. Danh sách gom những điểm đã nêu trong bài thành bước kiểm tra cụ thể, chia làm hai nhóm kỹ thuật và tuân thủ.
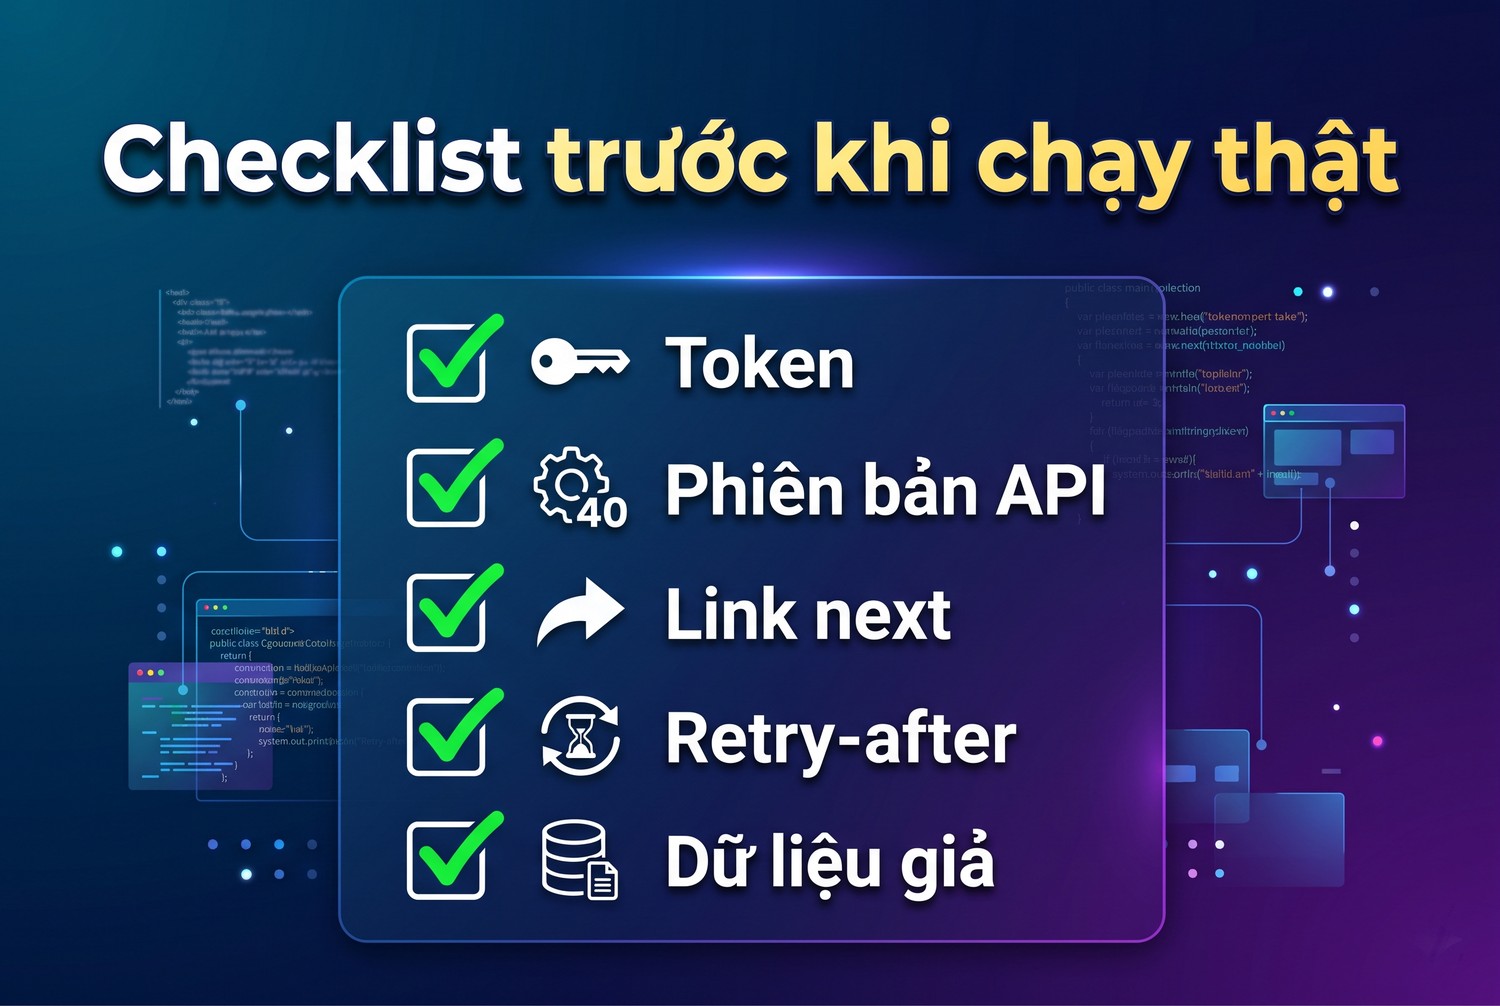
Checklist trước khi chạy thật
Nhóm kỹ thuật
Nhóm này đảm bảo kịch bản chạy ổn định và dữ liệu đúng. Mỗi khi nâng cấp thư viện hay đổi phiên bản API, rà lại toàn bộ.
- Có token fine-grained chỉ đọc, hạn dùng ngắn, đặt trong biến môi trường.
- Header ghi rõ X-GitHub-Api-Version và User-Agent có tên dự án.
- Phân trang theo link next, không tự tăng số trang.
- Hàm gọi đọc retry-after và x-ratelimit-reset trước khi thử lại.
- Request gửi tuần tự, có khoảng nghỉ, không song song.
- Truy vấn tìm kiếm được chia nhỏ để mỗi truy vấn dưới 1.000 kết quả.
- Khoá chính là repo_id, có bảng lịch sử riêng theo ngày.
- Đã chạy với dữ liệu giả và kiểm tra số dòng trước khi gọi API thật.
Nhóm tuân thủ
Nhóm này giúp dự án không vướng chính sách của GitHub và quy định về dữ liệu cá nhân. Bỏ qua nhóm này thì rủi ro không nằm ở code mà nằm ở cách dùng dữ liệu.
- Chỉ thu thập metadata repository cần cho mục tiêu đã ghi.
- Không lưu email, không xây danh sách liên hệ lập trình viên.
- Không dùng dữ liệu cho thư rác hoặc bán cho bên thứ ba.
- Ghi nguồn GitHub và thời điểm thu thập khi công bố số liệu.
Đánh giá sau tuần đầu
Sau một tuần chạy, xem lại log: tổng số request mỗi ngày, số lần chờ do hạn mức, tỷ lệ phản hồi 304. Nếu số lần chờ cao, giảm tần suất hoặc thu hẹp danh sách. Nếu tỷ lệ 304 cao, có thể giãn lịch làm mới cho nhóm repo ít thay đổi.
Con số thật từ log của chính anh em đáng tin hơn mọi ước tính ban đầu. Kết luận cho phần checklist: kịch bản tốt không phải kịch bản chạy nhanh nhất, mà là kịch bản chạy đều mỗi ngày mà không cần người trông.
Crawl GitHub bằng Python bền nhất khi đi qua REST API có token, đọc header hạn mức, phân trang theo link next và lưu theo id repository. Hãy chạy thử với dữ liệu giả, rồi mới mở rộng phạm vi. Cần trao đổi về kết nối, anh em nhắn Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam trước khi crawl GitHub bằng Python.


