
Crawl Eventbrite bằng Python: API v3, múi giờ và lịch cập nhật
Crawl Eventbrite bằng Python gọn nhất khi anh em dùng Eventbrite API v3 với token riêng, thay vì đọc trang sự kiện. API trả giờ bắt đầu theo cả UTC lẫn giờ địa phương, có phân trang bằng continuation và báo hạn mức rõ. Bài này, ProxyVN hướng dẫn lấy sự kiện công khai theo tổ chức, chuẩn hoá múi giờ, phát hiện thay đổi, lên lịch cập nhật và xuất lịch .ics.
Mục tiêu và phạm vi của crawl Eventbrite bằng Python
Dữ liệu sự kiện có vòng đời ngắn và hay đổi. Một hội thảo có thể dời giờ, đổi địa điểm, chuyển sang trực tuyến hoặc bị huỷ chỉ vài ngày trước khi diễn ra. Vì vậy, bài toán thu thập sự kiện không dừng ở việc lấy được danh sách mà còn phải giữ danh sách đó đúng theo thời gian.
Những nhu cầu hay gặp
Nhu cầu phổ biến nhất là gom lịch sự kiện của một nhóm tổ chức vào một trang lịch chung, ví dụ các cộng đồng công nghệ mà team quan tâm. Nhu cầu thứ hai là theo dõi sự kiện của chính tổ chức mình để đồng bộ sang hệ thống nội bộ. Nhu cầu thứ ba là nghiên cứu thị trường sự kiện theo chủ đề, mức giá và hình thức tổ chức.
Ba nhu cầu này có điểm chung: số lượng tổ chức theo dõi thường vài chục, không phải hàng triệu. Phạm vi nhỏ phù hợp với cách Eventbrite thiết kế API hiện tại, nơi dữ liệu được truy xuất theo tổ chức, theo địa điểm hoặc theo id sự kiện.
Phạm vi dữ liệu trong bài
Bài chỉ lấy thông tin sự kiện công khai: tên, đường dẫn, thời gian bắt đầu và kết thúc, múi giờ, trạng thái, hình thức trực tuyến hay trực tiếp, sự kiện miễn phí hay có phí và địa điểm. Bài không lấy danh sách người tham dự, đơn hàng hay thông tin người mua vé. Những dữ liệu đó thuộc về tổ chức sự kiện và cần quyền riêng.
Thông tin sự kiện công khai là dữ liệu dành cho người tham gia, thông tin người tham dự là dữ liệu cá nhân, hai thứ này không được trộn lẫn. Tóm lại, crawl Eventbrite bằng Python trong bài hướng tới một bảng lịch sự kiện đúng giờ và luôn mới, phục vụ một danh sách tổ chức xác định.
Thu thập sự kiện công khai khi crawl Eventbrite bằng Python
Trước khi viết code, cần biết Eventbrite cho phép lấy dữ liệu theo đường nào. Tài liệu API là nguồn trả lời chính xác nhất, và nó có vài điểm mà nhiều bài hướng dẫn cũ chưa cập nhật. Phần này đi qua các điểm đó.
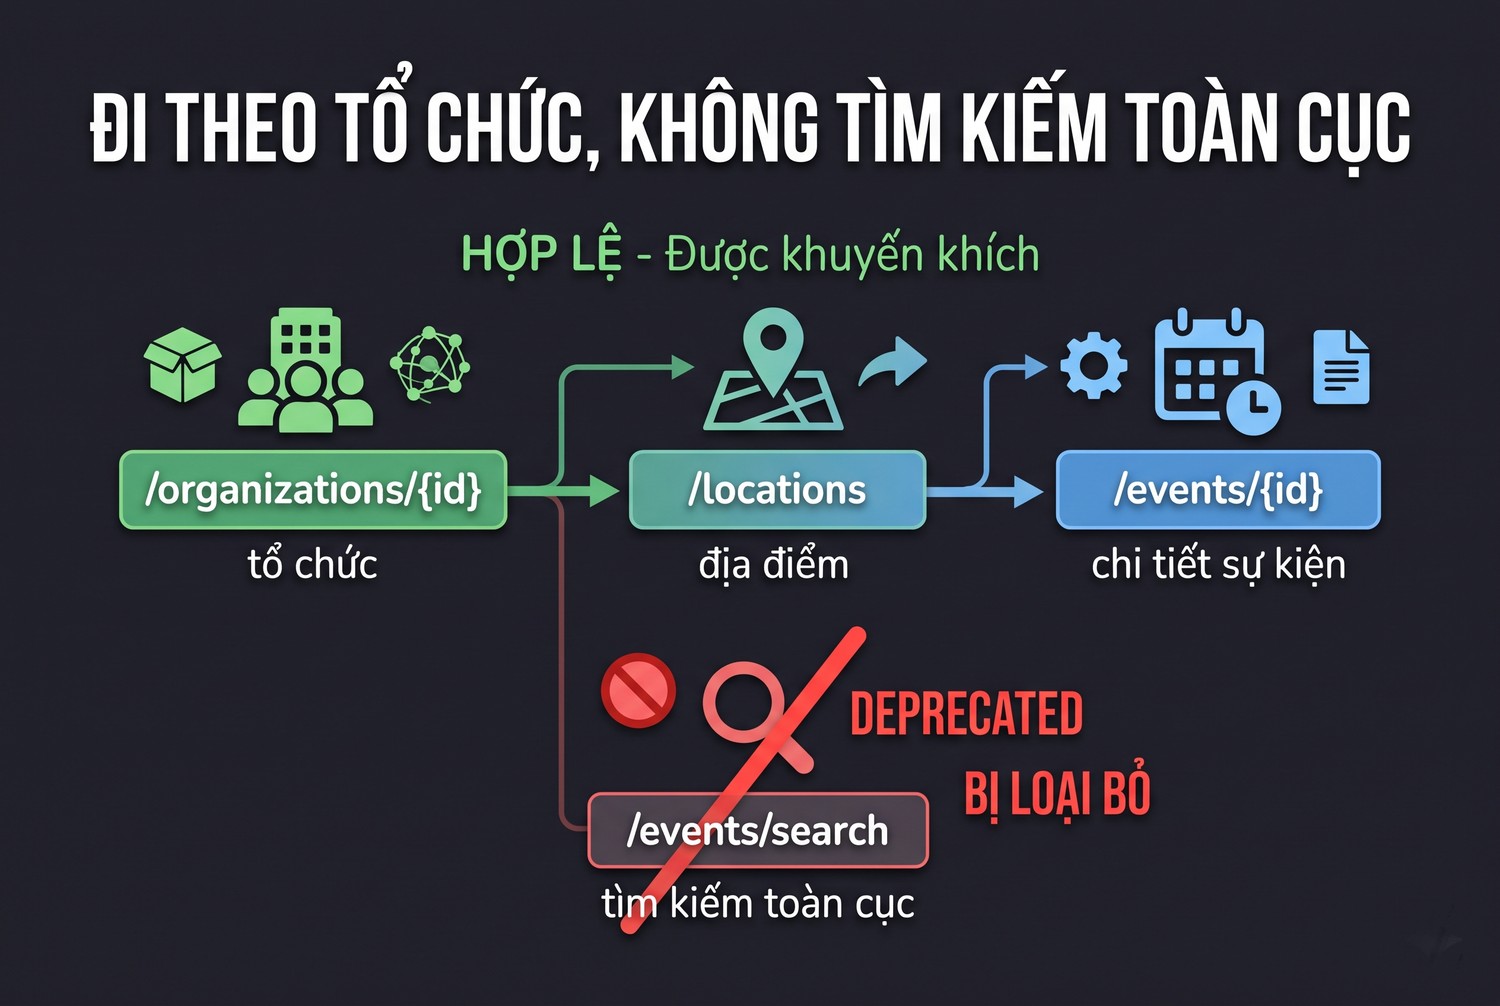
Đi theo tổ chức, không tìm kiếm toàn cục
API v3 và token cá nhân
Tài liệu Eventbrite API hướng dẫn lấy private token trong phần quản lý ứng dụng của tài khoản. Token gửi kèm request qua header Authorization dạng Bearer, hoặc qua tham số token trên URL. ProxyVN khuyên dùng header vì URL dễ lọt vào log của proxy và máy chủ trung gian.
Tài liệu cũng nhắc không đặt private token trong mã chạy phía trình duyệt và xoá token không còn dùng. Với kịch bản Python chạy trên máy chủ, token nằm trong biến môi trường là đủ an toàn cho phần lớn dự án nhỏ.
Tìm kiếm công khai đã ngừng
Điểm quan trọng nhất: endpoint tìm kiếm sự kiện toàn cục được tài liệu đánh dấu là deprecated. Nhiều bài hướng dẫn cũ vẫn dùng nó với tham số location.address hay location.within, nhưng đây không phải đường nên xây dự án mới. Khi ProxyVN đọc tài liệu ngày 23/10/2026, mục này vẫn hiển thị nhãn deprecated.
Thay vào đó, API cung cấp các endpoint liệt kê theo đối tượng cụ thể. Liệt kê sự kiện theo tổ chức có dạng /organizations/{organization_id}/events/, nhận các tham số như status, time_filter, order_by và page_size. Liệt kê theo địa điểm có dạng /venues/{venue_id}/events/ với tham số only_public. Lấy chi tiết một sự kiện dùng /events/{event_id}/.
Đọc trang web thì sao
Trang sự kiện công khai có thể chứa dữ liệu có cấu trúc, nhưng giao diện thay đổi theo thời gian và điều khoản sử dụng của Eventbrite áp dụng cho việc truy cập trang. Nếu dữ liệu cần thiết có trong API, không có lý do để đọc HTML. Khi buộc phải đọc trang, anh em đọc điều khoản trước, giữ tốc độ thấp và chỉ lấy đúng trang được phép.
Bảng dưới gom các đường truy cập và lúc nên dùng. Các endpoint lấy theo tài liệu Eventbrite ngày 23/10/2026.
Mục đích |
Endpoint |
Tham số chính |
Ghi chú |
|---|---|---|---|
Sự kiện của một tổ chức |
/organizations/{id}/events/ |
status, time_filter, page_size |
Đường chính cho bài này |
Sự kiện tại một địa điểm |
/venues/{id}/events/ |
only_public, start_date |
Hợp với lịch theo địa điểm |
Chi tiết một sự kiện |
/events/{id}/ |
expand=venue,organizer |
Dùng khi cần làm mới từng sự kiện |
Tìm kiếm toàn cục |
Search Events |
location.address |
Đã deprecated, không dùng cho dự án mới |
Kết lại, đường hợp lệ và ổn định để crawl Eventbrite bằng Python là API v3 theo tổ chức hoặc địa điểm. Anh em cần danh sách organization_id trước, rồi mới tới phần code.
Múi giờ và phân trang khi crawl Eventbrite bằng Python
Hai chi tiết kỹ thuật gây lỗi nhiều nhất với dữ liệu Eventbrite là cách biểu diễn thời gian và cách phân trang. Hiểu đúng hai chi tiết này từ đầu giúp tránh lịch lệch giờ và danh sách thiếu sự kiện.
Ba trường thời gian trong một object
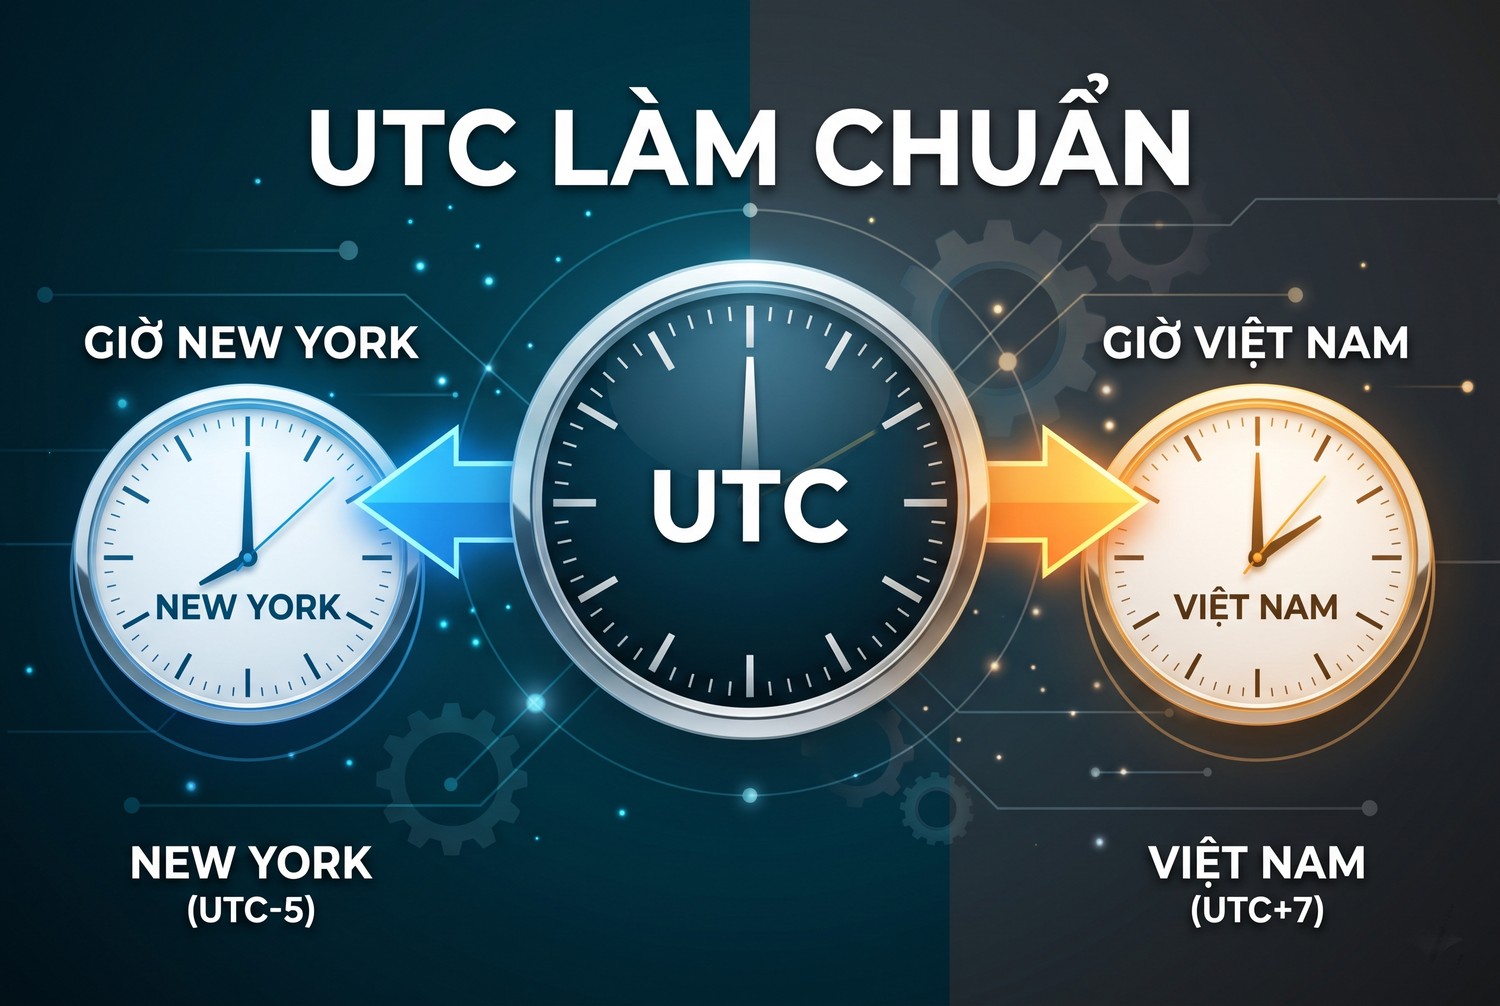
Theo tài liệu, trường start và end của sự kiện là object gồm ba khoá: timezone theo chuẩn Olson như America/Los_Angeles, utc là thời điểm theo UTC có chữ Z ở cuối, và local là thời điểm theo múi giờ của sự kiện, không kèm độ lệch. Ví dụ trong tài liệu ghi local 19:00 ngày 11/05/2018 tương ứng utc 02:00 ngày 12/05/2018.
Quy tắc ProxyVN áp dụng: lưu utc làm giá trị gốc để sắp xếp và so sánh, lưu timezone để hiển thị đúng giờ địa phương, còn local chỉ dùng để đối chiếu. Không bao giờ ghép local với một múi giờ đoán theo thành phố, vì nhiều thành phố có quy tắc giờ mùa hè.
Bẫy giờ mùa hè
Giờ mùa hè làm một số thời điểm địa phương xuất hiện hai lần hoặc không tồn tại. Ví dụ ở New York, rạng sáng Chủ nhật 01/11/2026 đồng hồ quay lùi một giờ, nên 01:30 giờ địa phương xảy ra hai lần. Nếu chỉ lưu local, anh em không biết sự kiện bắt đầu ở lần nào.
Trường utc giải quyết bài toán này vì UTC không có giờ mùa hè. Đây là lý do code bên dưới luôn lấy utc làm chuẩn và chỉ kiểm tra chéo với local.
Phân trang bằng continuation
Phản hồi dạng danh sách của Eventbrite có object pagination với các khoá như continuation và has_more_items. Tài liệu hướng dẫn: kiểm tra has_more_items, nếu là true thì gọi lại đúng request đó kèm tham số continuation lấy từ phản hồi trước. Khi hết dữ liệu, has_more_items chuyển thành false.
Cách này khác với phân trang theo số trang. Anh em không tự tăng số trang mà luôn dùng token mà API trả về. Token sai sẽ nhận lỗi 400 với mã BAD_CONTINUATION_TOKEN, theo bảng lỗi trong tài liệu.
Hạn mức mặc định
Bảng lỗi của tài liệu ghi mã 429 HIT_RATE_LIMIT khi vượt hạn mức theo giờ của token, với hạn mức mặc định 2.000 lần gọi mỗi giờ. Với vài chục tổ chức, mỗi tổ chức vài trang, con số này dư dả nếu kịch bản không gọi chi tiết từng sự kiện một cách thừa thãi.
Tóm lại, lưu utc làm chuẩn, đi theo continuation và tính số lần gọi theo hạn mức 2.000 mỗi giờ là ba quy tắc nền cho phần code.
Chuẩn bị môi trường cho crawl Eventbrite bằng Python
Lab dùng Python 3.12, Requests để gọi API, module zoneinfo có sẵn để xử lý múi giờ và sqlite3 để lưu. Trên Windows có một bước dễ bị bỏ qua liên quan tới dữ liệu múi giờ, phần dưới nói rõ.
Cài thư viện và gói tzdata
Module zoneinfo đọc cơ sở dữ liệu múi giờ của hệ điều hành. Linux và macOS có sẵn dữ liệu này, nhưng Windows thì không. Khi ProxyVN chạy thử trên Windows 10 với Python 3.12.10 cài mặc định, lệnh tạo ZoneInfo("America/Los_Angeles") báo lỗi ZoneInfoNotFoundError vì thiếu gói tzdata.
python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install requests tzdata
python -m pip freeze > requirements-lock.txt
Tài liệu module zoneinfo giải thích rằng khi hệ điều hành không có dữ liệu múi giờ, Python dùng gói tzdata bên thứ nhất trên PyPI. Phiên bản tzdata trong lab là 2026.5. Gói này cần cập nhật định kỳ vì quy tắc giờ mùa hè của các quốc gia có thể thay đổi.
Token và danh sách tổ chức
Token đặt trong biến môi trường. Danh sách organization_id đặt trong một tệp văn bản, mỗi dòng một id, để người không biết code cũng thêm bớt được.
$env:EVENTBRITE_TOKEN = 'YOUR_PRIVATE_TOKEN'
$env:EB_PROXY = 'http://USERNAME:PASSWORD@HOST:PORT'
Biến proxy là tuỳ chọn. Với API của Eventbrite, phần lớn trường hợp gọi trực tiếp là đủ, phần cuối bài bàn khi nào mới cần proxy.
Dữ liệu mẫu để chạy offline
Lab dựng hai trang phản hồi theo đúng cấu trúc tài liệu mô tả: object pagination có continuation, danh sách events với start và end gồm timezone, utc, local. Một sự kiện cố ý rơi vào khung giờ mùa hè ở New York để kiểm tra logic. Toàn bộ tên sự kiện và id là giả lập.
Chạy trên dữ liệu mẫu trước giúp kiểm tra chuẩn hoá và phát hiện thay đổi mà không tốn lượt gọi nào. Tóm lại, môi trường đúng cho dữ liệu sự kiện cần thêm tzdata trên Windows, token trong biến môi trường và bộ dữ liệu mẫu có ca khó.
Ví dụ tối thiểu crawl Eventbrite bằng Python
Phần này là ví dụ triển khai do ProxyVN viết theo tài liệu Eventbrite, đã chạy với dữ liệu mẫu trong lab. Code chia thành ba khối: gọi API có phân trang, chuẩn hoá sự kiện và chạy thử. Mỗi khối có đầu vào và đầu ra rõ ràng.
UTC làm chuẩn
Hàm lấy danh sách theo continuation
Hàm list_events nhận một hàm get để dễ thay bằng dữ liệu mẫu. Khi chạy thật, get là phương thức của Session có header Authorization. Mỗi vòng lặp đọc pagination, nếu has_more_items là true thì gửi lại request với continuation mới.
import os
import json
import time
import hashlib
import sqlite3
from datetime import datetime, timezone, timedelta
from zoneinfo import ZoneInfo
import requests

EB_API = "https://www.eventbriteapi.com/v3"

def eb_session(token, proxy=None):
    s = requests.Session()
    s.trust_env = False
    s.headers.update({"Authorization": f"Bearer {token}",
                      "User-Agent": "event-calendar-lab/0.1"})
    if proxy:
        s.proxies.update({"http": proxy, "https": proxy})
    return s

def list_events(get, org_id, max_pages=20, pause=1.0):
    params = {"status": "live,started,ended,canceled", "time_filter": "current_future",
              "expand": "venue", "page_size": 50}
    url = f"{EB_API}/organizations/{org_id}/events/"
    for _ in range(max_pages):
        r = get(url, params=params, timeout=(10, 30))
        if r.status_code == 429:
            time.sleep(int(r.headers.get("Retry-After", 300)))
            continue
        r.raise_for_status()
        data = r.json()
        yield from data.get("events", [])
        page = data.get("pagination", {})
        if not page.get("has_more_items"):
            return
        params = {**params, "continuation": page["continuation"]}
        time.sleep(pause)
Danh sách status trong ví dụ lấy cả sự kiện đã huỷ, vì bảng lịch cần biết sự kiện nào bị huỷ để gỡ khỏi lịch chung. Nếu chỉ lấy live, sự kiện bị huỷ sẽ biến mất khỏi kết quả và kịch bản không phân biệt được với sự kiện bị đổi tổ chức. Anh em kiểm tra danh sách giá trị status hợp lệ trong tài liệu trước khi chạy thật.
Chuẩn hoá sự kiện và kiểm tra chéo giờ
Hàm normalize_event lấy utc làm chuẩn, đổi sang giờ Việt Nam để tiện hiển thị cho team, và kiểm tra local có khớp với utc cộng múi giờ hay không. Dòng nào lệch được đánh dấu để xem lại thay vì bị bỏ qua.
VN = ZoneInfo("Asia/Ho_Chi_Minh")
TRACKED = ["name", "start_utc", "end_utc", "timezone", "status", "online", "is_free", "venue"]

def parse_utc(s):
    return datetime.fromisoformat(s.replace("Z", "+00:00"))

def check_local(block):
    tz = ZoneInfo(block["timezone"])
    expected = parse_utc(block["utc"]).astimezone(tz).replace(tzinfo=None)
    return expected == datetime.fromisoformat(block["local"])

def normalize_event(ev):
    start, end = ev["start"], ev["end"]
    venue = ev.get("venue") or {}
    addr = venue.get("address") or {}
    row = {
        "event_id": str(ev["id"]),
        "name": " ".join((ev.get("name") or {}).get("text", "").split()),
        "url": ev.get("url", ""),
        "start_utc": parse_utc(start["utc"]).isoformat(),
        "end_utc": parse_utc(end["utc"]).isoformat(),
        "timezone": start["timezone"],
        "start_vn": parse_utc(start["utc"]).astimezone(VN).strftime("%Y-%m-%d %H:%M"),
        "status": ev.get("status", ""),
        "online": int(bool(ev.get("online_event"))),
        "is_free": int(bool(ev.get("is_free"))),
        "venue": ", ".join(x for x in [venue.get("name"), addr.get("city"), addr.get("country")] if x),
        "local_ok": int(check_local(start) and check_local(end)),
    }
    row["fingerprint"] = hashlib.sha256(
        json.dumps([row[k] for k in TRACKED], ensure_ascii=False).encode("utf-8")).hexdigest()[:16]
    return row
Fingerprint là mã băm của các trường cần theo dõi. Hai lần thu cùng một sự kiện cho cùng fingerprint nghĩa là không có gì thay đổi. Fingerprint khác nghĩa là ít nhất một trường đã đổi, và bước lưu sẽ ghi lại thay đổi đó.
Chạy với hai trang dữ liệu mẫu
Dữ liệu mẫu gồm hai trang. Trang một có một sự kiện ở San Francisco và báo còn trang sau. Trang hai có một sự kiện ở New York bắt đầu lúc 01:30 sáng 01/11/2026, đúng thời điểm đồng hồ quay lùi.
def ev(i, name, tz, utc_start, local_start, hours=2, **kw):
    end_utc = parse_utc(utc_start) + timedelta(hours=hours)
    end_local = datetime.fromisoformat(local_start) + timedelta(hours=hours)
    return {"id": i, "name": {"text": name}, "url": f"https://www.eventbrite.com/e/{i}",
            "start": {"timezone": tz, "utc": utc_start, "local": local_start},
            "end": {"timezone": tz, "utc": end_utc.strftime("%Y-%m-%dT%H:%M:%SZ"),
                    "local": end_local.isoformat()},
            "status": kw.get("status", "live"), "online_event": kw.get("online", False),
            "is_free": kw.get("free", True),
            "venue": {"name": "Demo Hall", "address": {"city": kw.get("city", ""), "country": "US"}}}

PAGES = [
    {"events": [ev("1001", "Python Meetup", "America/Los_Angeles",
                   "2026-11-06T02:00:00Z", "2026-11-05T18:00:00", city="San Francisco")],
     "pagination": {"has_more_items": True, "continuation": "tok-2"}},
    {"events": [ev("1002", "Late Night Hack", "America/New_York",
                   "2026-11-01T06:30:00Z", "2026-11-01T01:30:00", hours=1, city="New York")],
     "pagination": {"has_more_items": False}},
]

class Resp:
    def __init__(self, data):
        self.data, self.status_code, self.headers = data, 200, {}
    def json(self):
        return self.data
    def raise_for_status(self):
        pass

def fake_get(url, params=None, timeout=None):
    return Resp(PAGES[1] if params.get("continuation") == "tok-2" else PAGES[0])

rows = [normalize_event(e) for e in list_events(fake_get, "demo-org", pause=0)]
for r in rows:
    print(r["event_id"], r["start_utc"], r["timezone"], "VN:", r["start_vn"], "local_ok:", r["local_ok"])
Kết quả trong lab: sự kiện 1001 bắt đầu 02:00 UTC ngày 06/11, tức 09:00 sáng cùng ngày giờ Việt Nam. Sự kiện 1002 bắt đầu 06:30 UTC, tức 13:30 giờ Việt Nam, local_ok bằng 1. Lý do khớp là 06:30 UTC ứng với lần thứ hai của 01:30 ở New York, sau khi đồng hồ đã quay về giờ chuẩn. Nếu dữ liệu chỉ có local, anh em không thể biết đó là lần thứ nhất hay thứ hai.
Tóm lại, ví dụ tối thiểu cho thấy phân trang theo continuation chạy đúng, giờ Việt Nam tính từ utc và kiểm tra chéo bắt được trường hợp giờ mùa hè.
Lịch cập nhật khi crawl Eventbrite bằng Python
Dữ liệu sự kiện thay đổi nhiều nhất trong vài ngày trước khi diễn ra. Lịch cập nhật hợp lý dành nhiều lượt gọi cho sự kiện sắp tới và ít lượt cho sự kiện còn xa. Phần này dựng bảng lưu trữ có lịch sử thay đổi và một hàm chia nhóm làm mới.
Lưu trạng thái hiện tại và nhật ký thay đổi
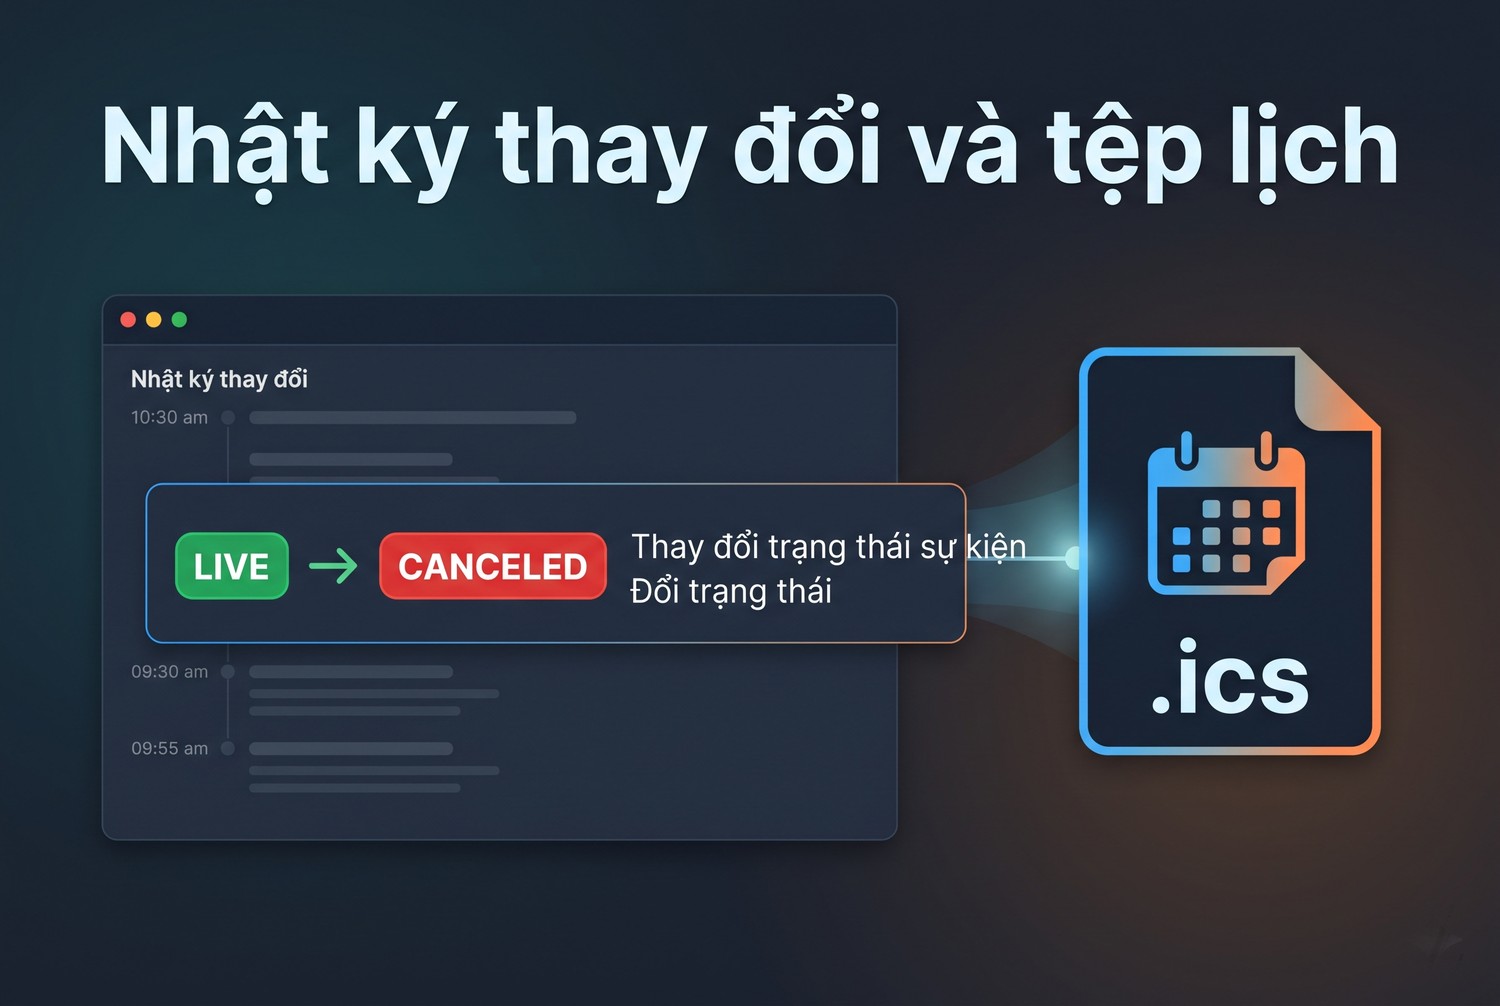
Bảng events giữ bản mới nhất của mỗi sự kiện, khoá chính là event_id. Bảng event_changes ghi lại mỗi lần fingerprint đổi, kèm trường nào đã đổi từ giá trị gì sang giá trị gì. Nhật ký này trả lời câu hỏi mà người dùng lịch hay hỏi: sự kiện này đổi giờ từ khi nào.
COLS = ["event_id", "name", "url", "start_utc", "end_utc", "timezone", "start_vn",
        "status", "online", "is_free", "venue", "local_ok", "fingerprint", "last_checked"]

def open_event_db(path="events.db"):
    con = sqlite3.connect(path)
    con.execute(f"CREATE TABLE IF NOT EXISTS events ({', '.join(COLS)}, PRIMARY KEY (event_id))")
    con.execute("""CREATE TABLE IF NOT EXISTS event_changes (
        event_id TEXT, changed_at TEXT, field TEXT, old TEXT, new TEXT)""")
    return con

def save_events(con, rows, now):
    changes = 0
    for r in rows:
        old = con.execute("SELECT * FROM events WHERE event_id=?", (r["event_id"],)).fetchone()
        r = {**r, "last_checked": now}
        if old:
            old = dict(zip(COLS, old))
            if old["fingerprint"] != r["fingerprint"]:
                for f in TRACKED:
                    if str(old[f]) != str(r[f]):
                        con.execute("INSERT INTO event_changes VALUES (?, ?, ?, ?, ?)",
                                    (r["event_id"], now, f, str(old[f]), str(r[f])))
                        changes += 1
        con.execute(f"INSERT OR REPLACE INTO events VALUES ({', '.join('?' for _ in COLS)})",
                    [r[c] for c in COLS])
    con.commit()
    return changes

con = open_event_db(":memory:")
save_events(con, rows, "2026-10-23T08:00:00+00:00")
PAGES[1]["events"][0]["status"] = "canceled"
rows2 = [normalize_event(e) for e in list_events(fake_get, "demo-org", pause=0)]
print("Số thay đổi:", save_events(con, rows2, "2026-10-24T08:00:00+00:00"))
print(con.execute("SELECT event_id, field, old, new FROM event_changes").fetchall())
Lab chạy hai lần: lần đầu không có thay đổi, lần hai sự kiện 1002 bị chuyển sang canceled. Kết quả in ra một thay đổi, trường status từ live sang canceled. Sự kiện 1001 không sinh dòng nhật ký vì fingerprint giữ nguyên.
Chia nhóm làm mới theo khoảng cách thời gian
Hàm dưới phân sự kiện vào ba nhóm theo thời gian còn lại trước giờ bắt đầu. Nhóm gần làm mới mỗi ngày, nhóm xa làm mới mỗi tuần, sự kiện đã kết thúc không cần làm mới nữa.
def refresh_tier(start_utc, now):
    delta = parse_utc(start_utc) - now
    if delta < timedelta(0):
        return "frozen"
    if delta <= timedelta(days=7):
        return "daily"
    return "weekly"

now = datetime(2026, 10, 30, tzinfo=timezone.utc)
for r in rows2:
    print(r["event_id"], refresh_tier(r["start_utc"], now))
Với mốc 30/10/2026, sự kiện 1002 diễn ra sau hai ngày nên rơi vào nhóm daily. Sự kiện 1001 bắt đầu sau bảy ngày hai giờ nên rơi vào nhóm weekly, dù chỉ vượt ngưỡng vài giờ, một ví dụ cho thấy ranh giới nhóm nên đặt rộng hơn một chút so với nhu cầu thật. Khi chạy thật, nhóm daily có thể làm mới bằng endpoint chi tiết /events/{id}/ nếu số lượng nhỏ, hoặc bằng cách gọi lại danh sách của tổ chức nếu nhiều sự kiện cùng tổ chức.
Ước lượng số lần gọi
Giả sử theo dõi 40 tổ chức, mỗi tổ chức hai trang kết quả. Một vòng làm mới toàn bộ tốn khoảng 80 lần gọi. Chạy bốn vòng mỗi ngày vẫn chỉ 320 lần, thấp xa so với hạn mức 2.000 mỗi giờ. Lịch cập nhật hợp lý giúp anh em không bao giờ phải nghĩ tới hạn mức.
Tóm lại, nhật ký thay đổi cho biết sự kiện đã đổi gì, còn lịch chia nhóm đảm bảo sự kiện sắp diễn ra luôn mới nhất mà không lãng phí lượt gọi.
Xuất lịch và kiểm tra đầu ra khi crawl Eventbrite bằng Python
Dữ liệu sự kiện chỉ có ích khi người dùng xem được trong công cụ quen thuộc. Định dạng iCalendar cho phép nhập vào Google Calendar, Outlook hay lịch trên điện thoại. Phần này xuất tệp .ics từ bảng events và chạy vài kiểm tra trước khi phát hành.
Nhật ký thay đổi và tệp lịch
Tạo tệp .ics từ bảng events
Chuẩn RFC 5545 định nghĩa định dạng iCalendar. Cách an toàn nhất là ghi DTSTART và DTEND theo UTC với hậu tố Z, để ứng dụng lịch tự đổi sang múi giờ của người xem. Sự kiện bị huỷ được ghi STATUS:CANCELLED để lịch của người đã nhập tự cập nhật.
def ics_time(iso):
    return datetime.fromisoformat(iso).astimezone(timezone.utc).strftime("%Y%m%dT%H%M%SZ")

def ics_escape(text):
    return text.replace("\\", "\\\\").replace(";", "\\;").replace(",", "\\,")

def export_ics(con, path="events.ics"):
    stamp = datetime.now(timezone.utc).strftime("%Y%m%dT%H%M%SZ")
    lines = ["BEGIN:VCALENDAR", "VERSION:2.0", "PRODID:-//event-calendar-lab//EN"]
    for eid, name, url, s, e, status in con.execute(
            "SELECT event_id, name, url, start_utc, end_utc, status FROM events ORDER BY start_utc"):
        lines += ["BEGIN:VEVENT", f"UID:eb-{eid}@event-calendar-lab", f"DTSTAMP:{stamp}",
                  f"DTSTART:{ics_time(s)}", f"DTEND:{ics_time(e)}",
                  f"SUMMARY:{ics_escape(name)}", f"URL:{url}",
                  "STATUS:" + ("CANCELLED" if status == "canceled" else "CONFIRMED"), "END:VEVENT"]
    lines.append("END:VCALENDAR")
    with open(path, "w", encoding="utf-8", newline="") as f:
        f.write("\r\n".join(lines) + "\r\n")
    return path, len(lines)

print(export_ics(con))
UID dựa trên event_id giúp ứng dụng lịch nhận ra đây là cùng một sự kiện khi tệp được nhập lại. Chuẩn yêu cầu dòng kết thúc bằng CRLF, vì vậy hàm ghi tệp với newline rỗng và tự nối bằng \r\n. Trong lab, tệp có 22 dòng cho hai sự kiện.
Kiểm tra trước khi phát hành lịch
Trước khi chia sẻ tệp lịch, chạy vài kiểm tra trên bảng events. Các kiểm tra dưới bắt những lỗi ProxyVN thấy hay gặp khi gom dữ liệu thời gian.
- Giờ kết thúc nhỏ hơn hoặc bằng giờ bắt đầu: dữ liệu lỗi hoặc chuẩn hoá sai.
- local_ok bằng 0: local không khớp utc, cần xem lại múi giờ.
- Sự kiện online nhưng venue có địa chỉ: kiểm tra lại trạng thái trực tuyến.
- Sự kiện quá khứ vẫn ở trạng thái live: có thể API chưa cập nhật hoặc lọc sai.
bad = con.execute("SELECT COUNT(*) FROM events WHERE end_utc <= start_utc OR local_ok = 0").fetchone()[0]
print("Dòng cần xem lại:", bad)
Dữ liệu mẫu cho kết quả 0. Khi chạy thật, mọi con số khác 0 cần được xem trước khi xuất lịch cho người khác.
Giữ đường dẫn gốc
Mỗi sự kiện trong lịch có trường URL trỏ về trang Eventbrite gốc. Người dùng muốn mua vé hay xem chi tiết sẽ đi tới trang của tổ chức sự kiện. Đây vừa là cách tôn trọng nguồn dữ liệu, vừa giúp lịch chung không phải sao chép mô tả dài.
Tóm lại, xuất .ics theo UTC, ghi trạng thái huỷ và giữ đường dẫn gốc là ba điều làm lịch tổng hợp đáng tin với người dùng cuối.
Xử lý lỗi khi crawl Eventbrite bằng Python
Lỗi với Eventbrite API có mã rõ ràng trong tài liệu, nên phần lớn có thể xử lý tự động. Phần còn lại là lỗi dữ liệu, cần kiểm tra bằng logic như ở phần trên. Ghi log mỗi lần gọi giúp phân biệt hai loại.
Bảng mã lỗi thường gặp
Danh sách dưới lấy từ bảng lỗi trong tài liệu Eventbrite và từ những tình huống hay gặp khi gọi API theo tổ chức. Mỗi dòng có hướng xử lý cụ thể.
- 400 BAD_CONTINUATION_TOKEN: continuation sai hoặc đã hết hạn; chạy lại từ trang đầu.
- 401 INVALID_AUTH: token sai hoặc bị thu hồi; tạo token mới.
- 403 NOT_AUTHORIZED: token không có quyền với tài nguyên; kiểm tra lại organization_id.
- 404: id tổ chức hoặc sự kiện không tồn tại; gỡ khỏi danh sách theo dõi.
- 429 HIT_RATE_LIMIT: vượt hạn mức theo giờ; chờ và giảm tần suất.
Với lỗi 429, hàm list_events ở trên chờ theo header Retry-After nếu có, mặc định 300 giây. Khi gặp lỗi này nhiều lần trong ngày, nguyên nhân thường là lịch làm mới quá dày, không phải do số tổ chức quá lớn.
Lỗi múi giờ trên máy chủ
Lỗi ZoneInfoNotFoundError xuất hiện khi máy chạy thiếu dữ liệu múi giờ, thường gặp với Windows hoặc container rút gọn. Cách sửa là cài tzdata trong môi trường ảo, như phần chuẩn bị đã nêu. Sau khi cập nhật hệ điều hành hay đổi image, chạy lại hàm check_local trên dữ liệu mẫu để chắc múi giờ vẫn đúng.
Ghi log có ích
Mỗi lần gọi ghi URL đã che token, mã trạng thái, số sự kiện nhận về và có continuation hay không. Nếu một tổ chức đột nhiên trả 0 sự kiện, log cho biết đó là do API hay do bộ lọc status. Log không ghi token là quy tắc bắt buộc, kể cả khi log chỉ lưu trên máy cá nhân.
Tóm lại, lỗi API của Eventbrite có mã rõ và cách xử lý rõ. Lỗi khó hơn là lỗi thời gian, và cách phòng tốt nhất là kiểm tra chéo utc với local cho mọi sự kiện.
Khi nào cần proxy cho crawl Eventbrite bằng Python
Với API có token, hạn mức tính theo token chứ không theo IP. Vì vậy proxy không giúp gọi được nhiều hơn. Phần lớn dự án lịch sự kiện chạy tốt khi gọi trực tiếp từ máy chủ.
Tình huống proxy hợp lý
Tình huống thường gặp nhất là mạng công ty bắt buộc đi qua proxy. Hàm eb_session nhận tham số proxy và tắt trust_env để cấu hình rõ ràng, không phụ thuộc vào biến hệ thống. Cách khai báo proxy trong Requests được tài liệu chính thức mô tả ở phần Proxies của Requests.
Tình huống thứ hai là kiểm tra trang sự kiện hiển thị thế nào với người xem ở khu vực khác, ví dụ ngôn ngữ hay đơn vị tiền tệ của trang thanh toán. Đây là việc kiểm tra thủ công vài trang, không phải thu thập hàng loạt. Proxy đặt tại khu vực tương ứng giúp thấy đúng giao diện người dùng ở đó.
Tình huống không dùng proxy
Không dùng proxy để gọi lại endpoint tìm kiếm đã deprecated, không dùng để đọc trang sự kiện hàng loạt khi điều khoản không cho phép và không dùng nhiều IP để lách hạn mức của token. Những việc này đi ngược cách Eventbrite thiết kế quyền truy cập.
Với dữ liệu sự kiện, cái cần giữ là đúng giờ và đúng trạng thái. Thêm IP không làm dữ liệu đúng hơn, chỉ có lịch cập nhật hợp lý mới làm được việc đó.
Chọn loại proxy và kiểm tra
Nếu mạng công ty cần proxy đi ra, một IP datacenter cố định là đủ cho API. Khi cần mua proxy cho kịch bản lịch sự kiện, anh em có thể xem các gói datacenter Việt Nam hoặc datacenter US trên trang chủ ProxyVN, rồi gửi một request kiểm tra IP trước khi đặt lịch chạy. Để hiểu thêm cách dùng proxy trong các dự án thu thập dữ liệu nói chung, xem bài web scraping proxy là gì trên blog ProxyVN.
Tóm lại, proxy cho Eventbrite API là lựa chọn về hạ tầng mạng. Dữ liệu đúng đến từ API chính thức, múi giờ chuẩn và lịch làm mới, không đến từ số lượng IP.
Checklist trước khi crawl Eventbrite bằng Python chạy thật
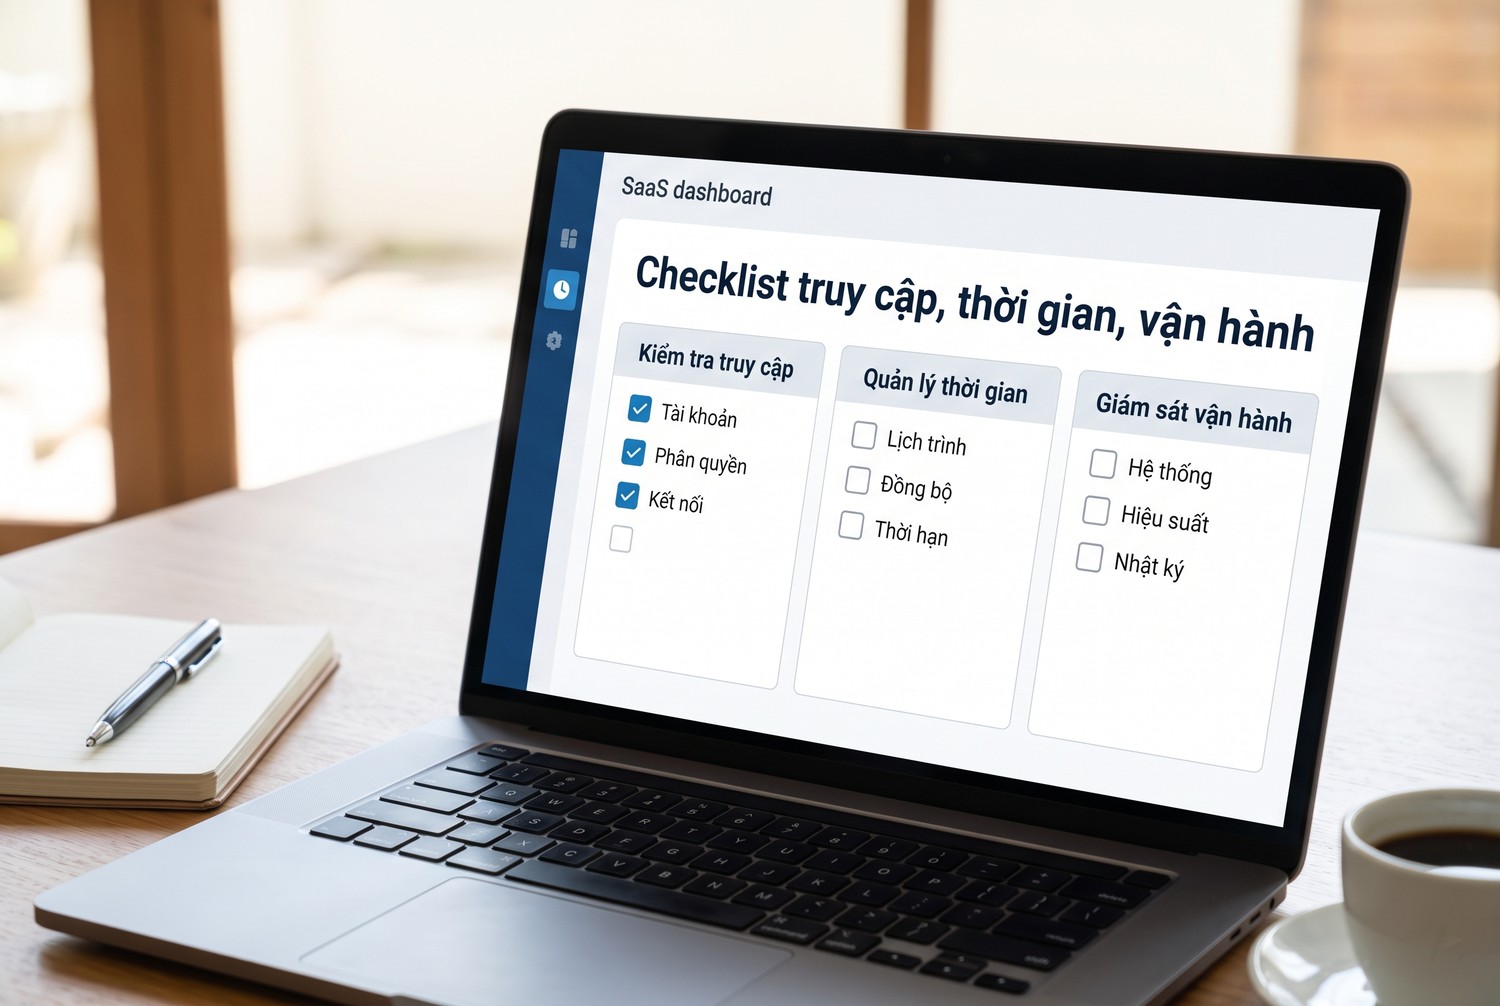
Trước khi để kịch bản chạy định kỳ và chia sẻ lịch cho người khác, anh em rà lại các mục dưới. Danh sách chia theo ba nhóm: truy cập, thời gian và vận hành.
Checklist truy cập, thời gian, vận hành
Nhóm truy cập
Nhóm này đảm bảo kịch bản dùng đúng kênh và đúng quyền. Một mục sai ở đây có thể làm dự án dừng hẳn.
- Token cá nhân nằm trong biến môi trường, gửi qua header Authorization.
- Dùng endpoint theo tổ chức hoặc địa điểm, không dùng tìm kiếm đã deprecated.
- Danh sách organization_id được duy trì trong tệp riêng.
- Không lấy dữ liệu người tham dự hay đơn hàng.
Nhóm thời gian
Nhóm này đảm bảo lịch hiển thị đúng giờ cho mọi người xem. Đây là phần dễ sai nhất với dữ liệu sự kiện quốc tế.
- Đã cài tzdata nếu chạy trên Windows hoặc container rút gọn.
- Lưu utc làm chuẩn, giữ timezone để hiển thị.
- Kiểm tra chéo local với utc, đánh dấu dòng lệch.
- Tệp .ics ghi giờ theo UTC có hậu tố Z.
Nhóm vận hành
Nhóm này giúp kịch bản chạy bền mà không cần người trông. Rà lại sau tuần đầu chạy thật.
- Lịch làm mới chia nhóm daily, weekly, frozen.
- Có nhật ký thay đổi cho từng sự kiện.
- Tổng số lần gọi mỗi giờ thấp hơn nhiều so với 2.000.
- Log không chứa token, có số sự kiện theo tổ chức.
Kết luận cho checklist: kịch bản lịch sự kiện tốt là kịch bản người dùng tin vào giờ hiển thị mà không phải tự kiểm tra lại trên trang gốc.
Crawl Eventbrite bằng Python đúng cách là gọi API v3 theo tổ chức, đi theo continuation, lưu giờ UTC làm chuẩn và ghi nhật ký mỗi lần sự kiện đổi giờ hay bị huỷ. Chạy thử với dữ liệu mẫu có ca giờ mùa hè trước. Cần hỗ trợ mạng, anh em nhắn Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam trước khi crawl Eventbrite bằng Python.


