Apache Iceberg snapshot crawl: đọc lại đúng phiên bản bảng
Apache Iceberg snapshot crawl là cách giữ từng phiên bản của bảng dữ liệu crawl, để hôm nay vẫn đọc lại được đúng những dòng mà báo cáo tuần trước đã dùng. Mỗi lần ghi thành công tạo một snapshot có ID riêng. ProxyVN chạy pyiceberg thật với catalog SQLite trên máy, ghi hai lượt crawl và một lượt sửa giá, đọc lại theo snapshot ID với số dòng cụ thể, rồi ghi rõ phần Spark chưa chạy.
Apache Iceberg snapshot crawl: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và những thứ bài không làm.
Bài toán cần giải
Một nhóm phân tích giá dùng bảng sản phẩm crawl hằng ngày. Thứ hai, báo cáo nói giá trung bình một ngành hàng giảm. Thứ tư, có người hỏi lại con số đó, nhưng bảng đã được ghi thêm hai lượt và sửa vài dòng. Nếu không đọc lại được đúng trạng thái bảng lúc thứ hai, không ai kiểm chứng được báo cáo.
Đầu ra nghiệm thu
Đầu ra gồm hai commit dữ liệu, mỗi commit có snapshot ID được lưu lại, và phép đọc bảng theo từng snapshot ID cho ra số dòng khớp với lúc ghi. Kèm theo là một sổ snapshot nối lượt crawl với snapshot ID, cùng các ca đọc thất bại cần biết.
Snapshot bảng khác bản lưu HTML
Snapshot của Iceberg là trạng thái của bảng đã parse: các dòng, các cột, tập tệp dữ liệu. Nó không phải bản lưu trang HTML gốc. Muốn giữ nhiều phiên bản HTML thô để parse lại, đó là việc của kho đối tượng có versioning, một chủ đề khác. Bài này chỉ nói về dữ liệu dạng bảng.
Ranh giới với bài Delta Lake
Delta Lake cũng có lịch sử phiên bản. Nhưng bài về Delta trong cụm này xử lý chuyện schema đổi khi crawler sinh thêm trường. Ở đây schema giữ nguyên, câu hỏi chỉ là đọc lại đúng phiên bản dữ liệu. Bài không so sánh hai định dạng bảng.
Giới hạn của lab
Nói rõ ngay. Lab không chạy Spark. Máy lab không có Spark, nên ProxyVN dùng pyiceberg 0.12.0, thư viện Python chính thức của dự án Iceberg, với catalog SQL lưu trên SQLite và kho tệp cục bộ. Cú pháp Spark trong bài chép từ tài liệu chính thức, chưa chạy thử.
Thứ gì thật trong lab
Pyiceberg, pyarrow 26.0.1, định dạng metadata, snapshot ID, tệp Parquet trên đĩa đều là thật. Không có máy chủ giả nào. Thứ khác với môi trường sản xuất là catalog SQLite một máy và kho tệp cục bộ thay cho kho đối tượng.
Ai nên đọc bài này
Người lưu kết quả crawl vào bảng Iceberg để phân tích. Người cần trả lời câu hỏi số liệu lúc đó là bao nhiêu. Người sắp bật dọn snapshot định kỳ mà chưa biết nó ảnh hưởng gì tới việc đọc lại.
Apache Iceberg snapshot crawl: quản lý snapshot bảng để đọc lại phiên bản
Phần này tóm tắt tài liệu chính thức về snapshot và độ tin cậy.
Mỗi lần ghi là một snapshot
Trang Reliability của Iceberg nêu mỗi lần ghi hoặc xóa tạo một snapshot mới, dùng lại phần lớn cây metadata của snapshot trước. Các snapshot hợp lệ nằm trong tệp metadata của bảng, cùng tham chiếu tới snapshot hiện tại.
Commit là phép thay nguyên tử
Tài liệu nêu commit thay đường dẫn tệp metadata hiện tại bằng một thao tác nguyên tử. Mọi thay đổi dữ liệu và metadata là nguyên tử, làm nền cho cách ly tuần tự. Người đọc luôn thấy một snapshot nhất quán mà không cần khóa.
Lịch sử và quay lui
Tài liệu nêu snapshot được giữ làm lịch sử, và bảng có thể quay lui nếu một job sinh dữ liệu sai. Với crawl, đây là lưới an toàn khi parser hỏng ghi hàng loạt giá bằng không. Lab không thử quay lui, chỉ thử đọc lại.
Snapshot ID là gì
Snapshot ID là số nguyên dài, do Iceberg sinh khi commit. Nó không tăng dần theo thời gian, nên không suy được thứ tự từ độ lớn. Muốn biết thứ tự, đọc lịch sử bảng hoặc trường parent của từng snapshot.
Bốn cách chọn phiên bản
Trang Queries nêu Spark đọc phiên bản cũ bằng snapshot-id, as-of-timestamp tính bằng mili giây, branch hoặc tag. Branch và tag không kết hợp được với as-of-timestamp. Pyiceberg có hàm tương ứng cho snapshot ID và thời điểm.
Cách chọn |
Spark |
pyiceberg |
Khi nào dùng |
|---|---|---|---|
Snapshot ID |
VERSION AS OF số |
scan(snapshot_id=...) |
Có sổ lưu ID |
Thời điểm |
TIMESTAMP AS OF |
snapshot_as_of_timestamp |
Chỉ biết giờ chạy |
Tag |
VERSION AS OF tên |
tham chiếu refs |
Mốc cần giữ lâu |
Branch |
VERSION AS OF tên |
tham chiếu refs |
Nhánh thử nghiệm |
Chọn theo ID hay theo thời gian
Theo thời điểm tiện khi chỉ biết báo cáo chạy lúc mấy giờ. Theo ID chính xác hơn, vì nhiều commit có thể sát nhau trong vài mili giây, như lab sẽ cho thấy. Báo cáo quan trọng nên ghi kèm snapshot ID ngay lúc tạo.
Tag tên số
Tài liệu cảnh báo nếu một tag hoặc branch có tên trùng với một snapshot ID, Spark sẽ chọn snapshot theo ID. Ví dụ tag tên 1 trỏ tới snapshot 2, đọc VERSION AS OF chuỗi 1 sẽ ra snapshot 1. Tài liệu khuyên đặt tên có tiền tố rõ, như snapshot-1.
Apache Iceberg snapshot crawl: tạo bảng fixture và lưu snapshot ID sau commit
Phần này dựng catalog, tạo bảng và ghi lượt crawl đầu tiên.
Catalog SQL trên SQLite
Pyiceberg hỗ trợ catalog SQL. Lab dùng SQLite trong thư mục lab và kho tệp cục bộ.
from pyiceberg.catalog.sql import SqlCatalog

cat = SqlCatalog("lab", uri="sqlite:///wh/catalog.db", warehouse="wh")
cat.create_namespace("crawl")
Trên Windows, lab gặp lỗi đường dẫn khi truyền warehouse dạng file với ba dấu gạch chéo: pyarrow ghép thành đường dẫn bắt đầu bằng gạch chéo trước ký tự ổ đĩa. Truyền đường dẫn thường với gạch chéo xuôi thì chạy.
Schema bảng sản phẩm
Bảng có bốn cột: page_id, url, price và crawl_run. Cột crawl_run ghi tên lượt crawl, để khi đọc một snapshot vẫn biết từng dòng đến từ lượt nào.
import pyarrow as pa

schema = pa.schema([("page_id", pa.string()), ("url", pa.string()),
                    ("price", pa.int64()), ("crawl_run", pa.string())])
t = cat.create_table("crawl.products", schema=schema)
print(t.current_snapshot())   # None
Bảng vừa tạo chưa có snapshot nào. Snapshot chỉ xuất hiện khi có dữ liệu được commit.
Commit 1: lượt crawl ngày đầu
Lượt đầu ghi năm sản phẩm p1 tới p5 bằng append. Ngay sau commit, lab đọc current_snapshot và lưu ID.
t.append(batch("run-01", [("p1", 100), ("p2", 200), ("p3", 300),
                          ("p4", 400), ("p5", 500)]))
s1 = t.current_snapshot()
print(s1.snapshot_id, s1.summary.operation)
Output thật: snapshot 1154371500126623950, thao tác append, total-records 5, một tệp dữ liệu mới.
Đọc summary
Mỗi snapshot có summary ghi số dòng thêm, số tệp thêm, tổng số dòng, tổng số tệp. Đây là bằng chứng rẻ nhất về những gì commit đã làm, không cần đọc tệp dữ liệu. Lab ghi summary vào log của lượt crawl.
commit 1: 1154371500126623950 Operation.APPEND {'added-data-files': '1', 'added-records': '5', 'total-records': '5', ...}Lưu ID ngay sau commit
Lấy current_snapshot ngay sau khi hàm ghi trả về. Nếu đợi tới cuối job, một tiến trình khác có thể đã commit thêm, và current_snapshot sẽ là của người khác. Với bảng có nhiều người ghi, đây là lỗi dễ mắc nhất.
Sổ snapshot
Lab ghi một sổ nhỏ ra tệp JSON: tên lượt crawl, snapshot ID, số dòng. Trong hệ thật, sổ này nằm cùng chỗ với lịch chạy crawl. Báo cáo nào dùng bảng thì ghi kèm snapshot ID lấy từ sổ.
Cột crawl_run vẫn cần
Snapshot cho biết bảng trông thế nào tại một thời điểm. Cột crawl_run cho biết từng dòng vào bảng từ lượt nào. Hai thông tin bổ sung cho nhau. Khi một snapshot chứa dòng từ ba lượt khác nhau, chỉ cột này mới tách được chúng.
Apache Iceberg snapshot crawl: ghi lô cập nhật với commit mới
Phần này ghi thêm lượt thứ hai và một lượt sửa giá, rồi xem lịch sử.
Commit 2: thêm sản phẩm mới
Lượt hai ghi thêm ba sản phẩm p6, p7, p8. Snapshot mới có parent là snapshot 1.
commit 2: 693021186723023223 parent 1154371500126623950 {'added-records': '3', 'total-data-files': '2', 'total-records': '8', ...}Commit 2 chỉ thêm một tệp dữ liệu. Tệp của commit 1 vẫn được dùng lại, đúng như tài liệu mô tả về việc tái sử dụng cây metadata.
Commit 3: sửa giá một sản phẩm
Lượt ba cập nhật giá p2 từ 200 xuống 180 bằng overwrite có điều kiện page_id bằng p2.
from pyiceberg.expressions import EqualTo

t.overwrite(batch("run-03", [("p2", 180)]),
            overwrite_filter=EqualTo("page_id", "p2"))
Kết quả: bảng vẫn có tám dòng, dòng p2 mang giá mới và crawl_run là run-03.
Overwrite sinh hai snapshot
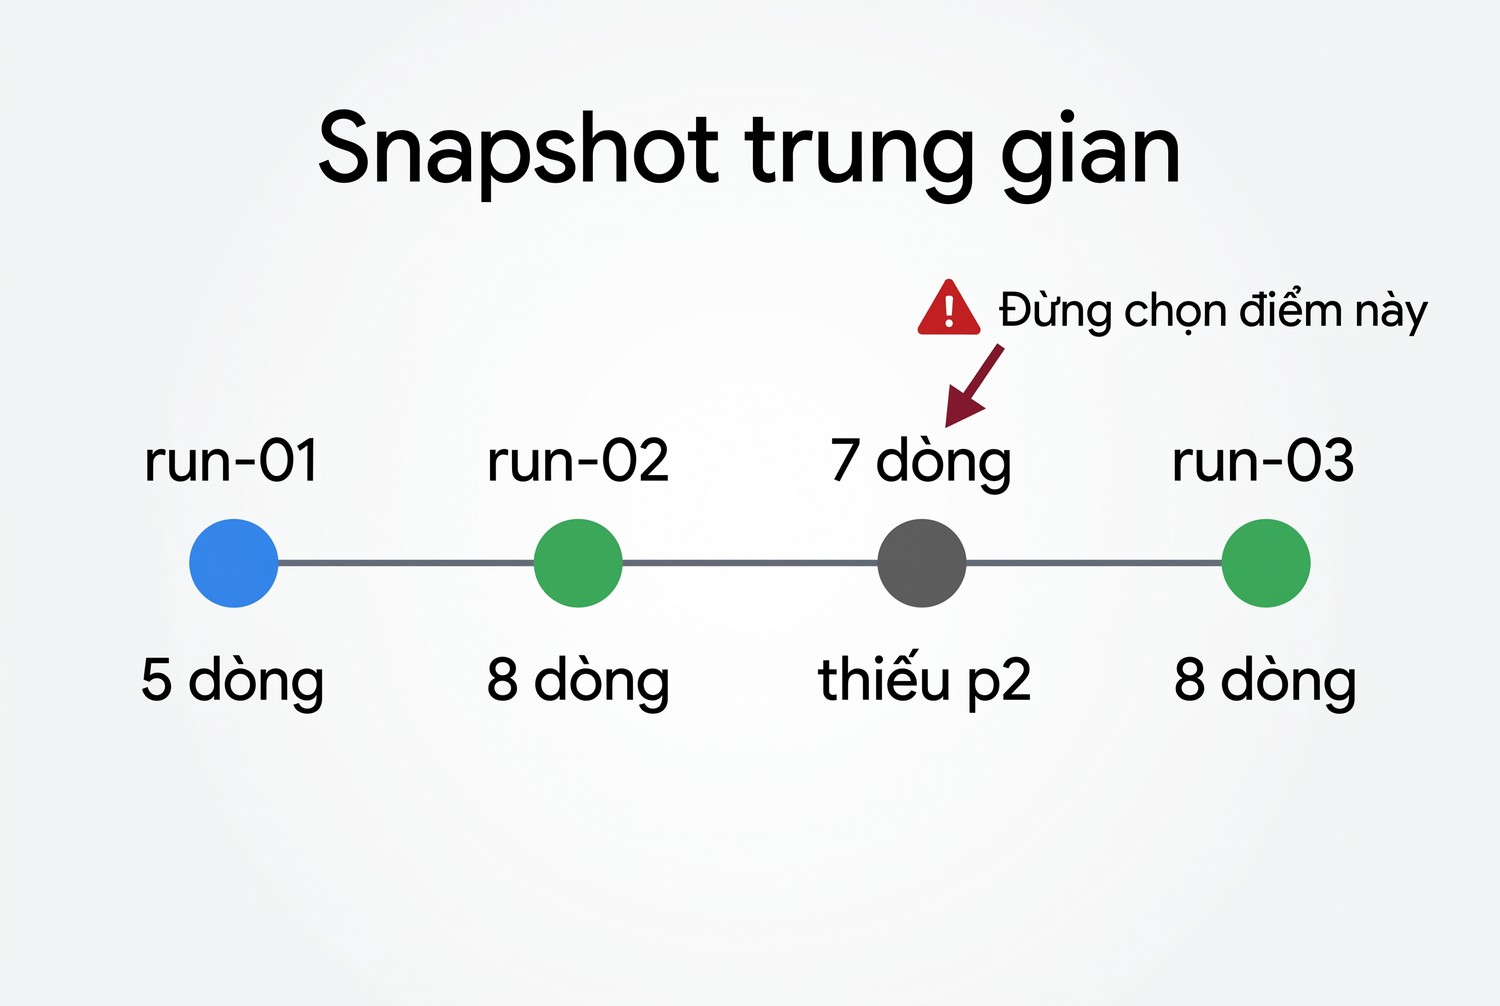
Đây là phát hiện quan trọng nhất của lab. Lịch sử có bốn snapshot, không phải ba.
inspect.snapshots: [(1154371500126623950, 'append', '5'), (693021186723023223, 'append', '8'),
                    (7291726878267222506, 'overwrite', '7'), (5335577291059413954, 'append', '8')]
Pyiceberg 0.12.0 thực hiện overwrite thành hai bước: xóa dòng khớp điều kiện, rồi thêm dòng mới. Snapshot ở giữa chỉ có bảy dòng, thiếu p2.
Hệ quả với việc đọc lại
Snapshot trung gian
Người đọc lịch sử và chọn nhầm snapshot ở giữa sẽ thấy bảng mất một sản phẩm. Nếu đọc theo thời điểm, khoảng giữa hai snapshot này trong lab chỉ hơn hai mươi mili giây, nhưng vẫn có thể rơi vào. Sổ snapshot nên ghi snapshot sau khi cả thao tác ghi đã xong, không ghi từng snapshot trong lịch sử.
Tách theo lượt bằng parent
Mỗi snapshot có parent. Lượt crawl ba bắt đầu từ snapshot 2 và kết thúc ở snapshot cuối, đi qua một snapshot trung gian. Sổ lưu cả snapshot đầu vào và snapshot kết quả của mỗi lượt sẽ giúp lần ngược khi có câu hỏi.
Lịch sử bảng
Hàm history trả danh sách snapshot ID và thời điểm theo mili giây. Lab dùng nó để xác nhận thứ tự commit.
1154371500126623950 1793863622283
693021186723023223 1793863623530
7291726878267222506 1793863623650
5335577291059413954 1793863623671
Thời điểm dạng mili giây từ mốc 1970. Hai dòng cuối cách nhau 21 mili giây, là hai bước của cùng một overwrite.
Tệp metadata và tệp dữ liệu
Sau ba thao tác ghi, thư mục metadata có bốn tệp metadata JSON, thư mục data có bốn tệp Parquet. Mỗi commit thêm một tệp metadata mới thay vì sửa tệp cũ. Đó là lý do đọc lại snapshot cũ không cần bản sao riêng của bảng.
Apache Iceberg snapshot crawl: đọc bảng theo snapshot và time travel
Phần này đọc lại từng phiên bản, đếm dòng và kiểm nội dung.
Đọc theo snapshot ID
Hàm scan nhận tham số snapshot_id. Lab đếm số dòng ở từng snapshot trong sổ.
def count(sid=None):
    return t.scan(snapshot_id=sid).to_arrow().num_rows

print(count(s1.snapshot_id), count(s2.snapshot_id), count(s3.snapshot_id), count())
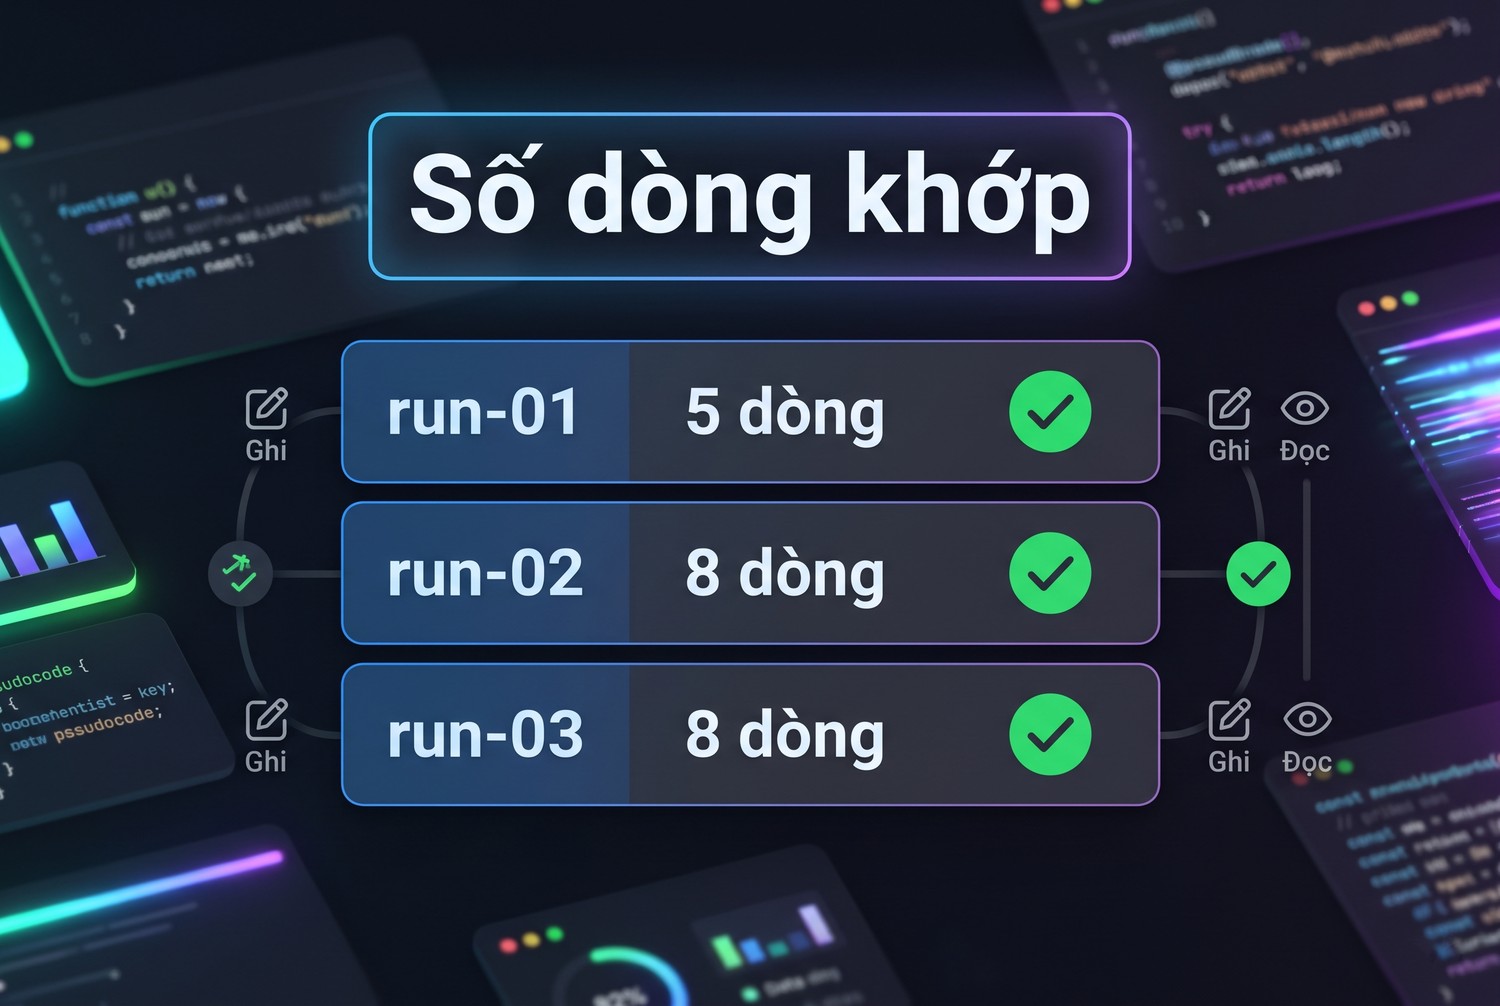
Kết quả: 5, 8, 8, 8. Snapshot 1 vẫn trả đúng năm dòng dù bảng đã qua ba lượt ghi.
Bằng chứng row count
Số dòng khớp
Bảng dưới là đầu ra nghiệm thu, lấy từ output thật.
Lượt |
Snapshot ID |
Thao tác |
Số dòng khi ghi |
Số dòng khi đọc lại |
|---|---|---|---|---|
run-01 |
1154371500126623950 |
append |
5 |
5 |
run-02 |
693021186723023223 |
append |
8 |
8 |
run-03 bước xóa |
7291726878267222506 |
overwrite |
7 |
Không đọc |
run-03 kết quả |
5335577291059413954 |
append |
8 |
8 |
Đọc nội dung, không chỉ đếm
Số dòng bằng nhau chưa nói nội dung bằng nhau. Snapshot 2 và snapshot cuối đều có tám dòng, nhưng giá p2 khác nhau.
p2 tai s2: [{'page_id': 'p2', 'price': 200, 'crawl_run': 'run-01'}]
p2 tai s3: [{'page_id': 'p2', 'price': 180, 'crawl_run': 'run-03'}]
Kiểm thêm một vài dòng mẫu theo khóa giúp bắt những thay đổi không làm đổi số dòng.
Đọc kèm bộ lọc
Hàm scan nhận cả row_filter lẫn snapshot_id trong cùng một lần gọi. Lab dùng cách này để lấy riêng dòng p2 ở hai snapshot. Với bảng lớn, lọc ngay lúc quét giúp không phải tải cả snapshot về bộ nhớ chỉ để xem vài dòng. Phép đối soát mẫu theo khóa nên viết theo cách này.
Lưu kết quả đọc lại
Khi đọc lại để trả lời một câu hỏi, lưu kết quả đọc ra tệp riêng kèm snapshot ID trong tên tệp. Lần sau có người hỏi tiếp, anh em không phải đọc lại, và nếu snapshot đã bị dọn thì vẫn còn bằng chứng. Tệp nhỏ, chi phí thấp.
Đọc theo thời điểm
Lab lấy thời điểm commit 1 cộng nửa giây, gọi snapshot_as_of_timestamp, nhận đúng snapshot 1. Phép này hợp lý khi khoảng giữa các commit đủ xa. Với commit sát nhau, đọc theo ID an toàn hơn.
Đọc từ tiến trình khác
Lab mở một catalog mới trỏ tới cùng SQLite và kho tệp, nạp lại bảng và đọc snapshot 1. Kết quả vẫn năm dòng. Phép thử này cho thấy snapshot ID trong sổ đủ để một job khác đọc lại, không cần đối tượng bảng trong bộ nhớ của job ghi.
Snapshot ID không tồn tại
Truyền một ID bịa ra, pyiceberg ném ValueError với thông báo không tìm thấy snapshot. Lỗi rõ ràng, xảy ra trước khi đọc dữ liệu. Mã đọc lại nên bắt lỗi này và báo về sổ, đừng âm thầm rơi về bản hiện tại.
Cú pháp Spark tương ứng
Tài liệu Queries đưa cú pháp SQL dưới đây. Lab không chạy Spark, các câu chép lại để anh em dùng khi bảng nằm trong hệ Spark.
SELECT * FROM prod.crawl.products VERSION AS OF 1154371500126623950;
SELECT * FROM prod.crawl.products TIMESTAMP AS OF '2026-11-05 08:00:00';
Trong DataFrame, dùng tùy chọn đọc snapshot-id hoặc as-of-timestamp. Tên catalog prod là ví dụ.
Khóa phiên bản engine
Cú pháp time travel phụ thuộc phiên bản Spark và Iceberg runtime. Ghi rõ phiên bản trong sổ snapshot cùng mã đọc lại. Khi nâng cấp, chạy lại một phép đọc snapshot cũ có đếm dòng, xem có khớp không trước khi tin.
Apache Iceberg snapshot crawl: đối soát row count và giữ metadata cho lần đọc lại
Phần này nói về những gì có thể làm mất khả năng đọc lại, và cách giữ.
Expire snapshot
Expire xong là mất
Pyiceberg có hàm expire_snapshots để dọn snapshot cũ, theo ID hoặc theo tuổi. Lab expire snapshot 1, rồi thử đọc lại.
t.maintenance.expire_snapshots().by_id(s1.snapshot_id).commit()
# doc s1 sau expire: ValueError Snapshot not found: 1154371500126623950
Sau khi expire, snapshot biến khỏi metadata. ID trong sổ không còn dùng được.
Tệp dữ liệu vẫn nằm trên đĩa
Lab đếm tệp trong thư mục data sau khi expire: vẫn bốn tệp. Pyiceberg 0.12.0 bỏ snapshot khỏi metadata nhưng không xóa tệp Parquet trong lab này. Dung lượng chưa được giải phóng, nhưng cũng không đọc lại được qua snapshot ID nữa. Việc dọn tệp mồ côi là bước riêng.
Tag giữ mốc quan trọng
Tag giữ mốc
Lab tạo tag audit-run-02 trỏ tới snapshot 2, rồi thử expire snapshot đó.
refs: {'main': 5335577291059413954, 'audit-run-02': 693021186723023223}
expire snapshot co tag: ValueError Snapshot with ID 693021186723023223 is protected and cannot be expired.
Tag là cách giữ một snapshot khỏi bị dọn. Báo cáo quan trọng nên được gắn tag ngay khi phát hành.
Đặt tên tag
Theo cảnh báo của tài liệu Queries, tên tag nên có tiền tố chữ, như audit-run-02 hay report-2026-11-05. Đừng đặt tag bằng số, vì có thể trùng một snapshot ID và đọc nhầm phiên bản.
Chính sách giữ snapshot
Một lượt crawl mỗi ngày, mỗi lượt vài snapshot, sau một năm là hơn một nghìn snapshot. Giữ hết làm metadata phình to. Chính sách hợp lý: expire theo tuổi, còn mọi snapshot được báo cáo dùng thì gắn tag. Sổ snapshot đánh dấu dòng nào đã có tag.
Đối soát định kỳ
Mỗi tuần, đọc lại vài snapshot trong sổ, so số dòng với số đã ghi. Nếu một snapshot đã expire mà sổ vẫn coi là đọc được, cập nhật sổ. Đối soát định kỳ phát hiện chính sách dọn đã chạy sai trước khi có người cần số liệu cũ.
Giữ catalog an toàn
Snapshot nằm trong metadata, metadata hiện tại được trỏ từ catalog. Mất catalog thì vẫn còn tệp metadata trên kho, nhưng việc dựng lại mất công. Với catalog SQLite như lab, sao lưu tệp cơ sở dữ liệu là đủ. Với catalog dùng chung, đó là việc của hệ thống catalog.
Ghi đồng thời
Tài liệu Reliability nêu commit nguyên tử và cách ly tuần tự. Nếu hai job cùng ghi, một job sẽ phải thử lại. Lab chỉ có một người ghi, không thử ca tranh chấp. Với crawl, giữ một tiến trình ghi duy nhất cho mỗi bảng là cách đơn giản để tránh rắc rối.
Apache Iceberg snapshot crawl: gắn snapshot vào quy trình báo cáo
Phần này nối kết quả lab với cách một nhóm dữ liệu làm việc hằng ngày.
Báo cáo nào cũng mang snapshot ID
Mỗi báo cáo dùng bảng crawl nên in snapshot ID ở chân trang hoặc trong phần ghi chú phương pháp. Người đọc hỏi lại thì có ngay điểm bắt đầu. Không có ID, người trả lời phải đoán báo cáo được chạy lúc nào, rồi đọc theo thời điểm, và có thể rơi vào snapshot trung gian như lab đã thấy.
Lấy ID ở bước nào của báo cáo
Job báo cáo nên tải bảng một lần, đọc current_snapshot, ghi ID lại, rồi mọi truy vấn trong job đều chạy với snapshot_id đó. Nếu mỗi truy vấn tự đọc bản hiện tại, một lượt crawl commit giữa chừng sẽ làm phần đầu và phần cuối báo cáo dựa trên hai phiên bản khác nhau.
Đọc nhất quán trong một job
Tài liệu Reliability nêu người đọc luôn thấy một snapshot nhất quán. Điều này đúng cho từng lần quét. Còn giữa các lần quét trong cùng một job, nếu không cố định snapshot ID, mỗi lần có thể thấy một snapshot khác. Cố định ID là việc của mã báo cáo, Iceberg không tự làm.
Lược đồ sổ snapshot
Sổ chỉ cần vài cột: tên lượt, snapshot đầu vào, snapshot kết quả, số dòng, thời điểm, tag nếu có, trạng thái còn đọc được hay đã expire. Lab ghi ba cột đầu ra tệp JSON. Trong hệ thật, sổ nằm trong cơ sở dữ liệu mà lịch chạy crawl cũng dùng.
Ai được ghi vào sổ
Chỉ job ghi bảng và job gắn tag được ghi vào sổ. Job báo cáo chỉ đọc sổ và ghi thêm tên báo cáo dùng snapshot nào. Phân quyền rõ giúp sổ không bị sửa tay, vì một dòng sai trong sổ còn nguy hiểm hơn không có sổ.
Khi lượt crawl thất bại giữa chừng
Nếu job crawl chết trước khi commit, bảng không đổi, không có snapshot mới. Đây là lợi ích của commit nguyên tử. Sổ ghi lượt đó thất bại, không có snapshot kết quả. Lượt sau bắt đầu từ snapshot hiện tại như bình thường.
Khi lượt crawl ghi dữ liệu sai
Parser hỏng có thể ghi cả trăm dòng giá bằng không, và commit vẫn thành công. Sổ snapshot cho biết snapshot nào là trạng thái tốt cuối cùng. Từ đó anh em quay lui về snapshot đó hoặc ghi một lượt sửa. Lab không thử quay lui, nhưng sổ là thứ cần có trước khi quay lui.
Kiểm nhanh sau mỗi commit
Sau mỗi lượt, so total-records trong summary với số dòng dự kiến. Lượt crawl bình thường thêm vài trăm sản phẩm. Một lượt làm tổng giảm mạnh hoặc tăng gấp đôi là dấu hiệu cần dừng các job phía sau. Summary có sẵn nên phép kiểm này gần như không tốn gì.
Snapshot và quyền dữ liệu
Snapshot cũ giữ nguyên dữ liệu cũ. Nếu một website yêu cầu gỡ dữ liệu, xóa dòng ở bản hiện tại chưa đủ, vì snapshot cũ vẫn chứa. Quy trình gỡ cần expire các snapshot liên quan và dọn tệp mồ côi. Điều này cần cân nhắc khi đặt chính sách giữ snapshot dài hạn.
Chi phí lưu trữ
Mỗi lượt sửa giá ghi tệp mới, tệp cũ vẫn được snapshot cũ tham chiếu. Giữ snapshot càng lâu, dung lượng càng lớn. Lab nhỏ nên không thấy, nhưng bảng crawl hằng ngày có thể tăng nhanh. Theo dõi tổng dung lượng kho song song với số snapshot.
Apache Iceberg snapshot crawl: đầu ra nghiệm thu và phần chưa chạy
Phần này gom tiêu chí đạt, tệp đầu ra và những gì còn phải kiểm.
Danh sách kiểm tra
Quy trình đạt khi mọi dòng dưới đây đúng.
- Mỗi lượt crawl ghi snapshot ID ngay sau khi thao tác ghi trả về.
- Sổ snapshot ghi snapshot kết quả của mỗi lượt, không ghi snapshot trung gian.
- Mỗi dòng có cột crawl_run để truy lượt.
- Đọc lại theo snapshot ID cho số dòng khớp lúc ghi.
- Kiểm thêm vài dòng mẫu theo khóa, không chỉ đếm.
- Báo cáo quan trọng gắn tag tên có tiền tố chữ.
- Chính sách expire không chạm snapshot có tag.
- Có đối soát định kỳ giữa sổ và metadata.
Tệp đầu ra của lab
Lab tạo thư mục kho với catalog SQLite, bốn tệp metadata, bốn tệp Parquet, và tệp snapshot_ledger.json với ba lượt. Toàn bộ chạy lại được bằng một lệnh, mỗi lần chạy sinh snapshot ID mới.
Những gì lab chưa chạy
Chưa chạy Spark, chưa thử cú pháp VERSION AS OF thật. Chưa dùng catalog REST, Hive hay Glue. Chưa thử ghi đồng thời, quay lui, dọn tệp mồ côi, branch. Kết quả overwrite hai bước là hành vi của pyiceberg 0.12.0, engine khác có thể ghi một snapshot.
Kiểm lại với engine khác
Nếu bảng được ghi bằng Spark, chạy cùng kịch bản: hai append, một overwrite có điều kiện, rồi đếm snapshot trong lịch sử. Nếu Spark ghi một snapshot cho overwrite, sổ đơn giản hơn. Nếu ghi hai, áp dụng đúng quy tắc của bài.
Proxy ở đâu trong luồng này
Proxy thuộc bước tải trang, trước khi có dữ liệu để ghi vào bảng. Iceberg, catalog và kho tệp nằm trong hạ tầng của anh em, không cần proxy. Với website được phép thu thập, có lúc cần IP Việt Nam để thấy đúng giá trong nước. Khi đó anh em có thể mua proxy tại trang chủ ProxyVN. Vai trò proxy có ở bài Web Scraping proxy là gì, cách ghi cấu hình ở bài định dạng proxy.
Nơi lưu tệp trước khi vào bảng
Dữ liệu trước khi vào Iceberg thường đi qua tệp Parquet trung gian. Bài Apache Parquet lưu dữ liệu crawl nói về bước đó. Iceberg thêm lớp quản lý phiên bản phía trên các tệp này.
Apache Iceberg snapshot crawl: câu hỏi thường gặp
Các câu dưới đây gom những điểm anh em hay hỏi.
Snapshot có phải bản sao toàn bộ bảng không?
Không. Mỗi snapshot dùng lại tệp dữ liệu của snapshot trước, chỉ thêm tệp mới. Lab thấy commit 2 chỉ thêm một tệp Parquet.
Vì sao lịch sử có nhiều snapshot hơn số lần ghi?
Vì một thao tác overwrite trong pyiceberg 0.12.0 tạo hai snapshot: xóa rồi thêm. Snapshot ở giữa thiếu dòng. Ghi sổ theo snapshot kết quả cuối cùng.
Đọc theo thời điểm có an toàn không?
An toàn khi các commit cách nhau đủ xa. Lab có hai snapshot cách nhau 21 mili giây. Báo cáo quan trọng nên lưu snapshot ID.
Expire xong có đọc lại được không?
Không. Lab nhận ValueError khi đọc snapshot đã expire. Gắn tag cho snapshot cần giữ, tag chặn expire.
Có cần Spark để dùng snapshot không?
Không bắt buộc. Pyiceberg đọc và ghi được trực tiếp, như lab. Spark cần khi dữ liệu lớn hoặc hệ thống đã dùng Spark.
Sổ snapshot nên lưu ở đâu?
Lưu cùng chỗ với lịch chạy crawl, thường là một bảng trong cơ sở dữ liệu vận hành. Đừng lưu sổ trong chính bảng Iceberg cần theo dõi, vì quay lui bảng sẽ kéo sổ quay lui theo. Lab lưu ra tệp JSON cho gọn.
Hai job cùng ghi một bảng có sao không?
Commit là nguyên tử, nên bảng không hỏng. Một job sẽ phải thử lại khi phát hiện bảng đã đổi. Lab chỉ có một người ghi nên không kiểm ca này. Giữ một tiến trình ghi cho mỗi bảng crawl giúp sổ snapshot đơn giản.
Có nên gắn tag cho mọi lượt crawl không?
Không cần. Tag dành cho mốc được báo cáo hoặc kiểm toán dùng. Gắn tag cho mọi lượt thì chính sách expire mất tác dụng, metadata và dung lượng tăng mãi. Lượt thường để expire theo tuổi.
Đọc snapshot cũ có chậm hơn bản hiện tại không?
Lab quá nhỏ để đo. Về cơ chế, đọc snapshot cũ cũng là đọc danh sách tệp mà snapshot đó trỏ tới, không cần dựng lại dữ liệu. Tốc độ phụ thuộc số tệp và kích thước tệp của snapshot đó.
Bài có chạy trên cụm thật không?
Không. Lab chạy pyiceberg thật trên một máy với catalog SQLite. Hành vi trên catalog dùng chung và engine khác cần kiểm lại.
Apache Iceberg snapshot crawl và những điều cần nhớ
Apache Iceberg snapshot crawl giúp đọc lại đúng phiên bản bảng, miễn là snapshot ID được lưu ngay sau khi ghi và không bị dọn mất. Hãy ghi sổ theo snapshot kết quả, kiểm số dòng lẫn nội dung, gắn tag cho mốc báo cáo. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em chạy thử Apache Iceberg snapshot crawl với engine đang dùng.


